Асинхронность
Сколько бы потоков ни было запущено, GIL пропускает через интерпретатор только один из них, а запускать больше одновременно вычисляющих процессов, чем ядер, не имеет смысла.
Существует класс задач, в которых процессор не является узким местом. Программа, скачивающая тысячу файлов или опрашивающая сотню приборов по сети, почти всё время ожидает. Запрос, отправленный по сети, ушёл, ответ не пришёл, работы нет. Выделять под каждое такое ожидание отдельный поток расточительно, поскольку поток, отданный под простой, требует памяти и переключений контекста, а полезной работы не выполняет.
Асинхронность поручает одному потоку тысячу ожиданий сразу: пока один запрос ожидает ответа, выполняется другой. Механику обеспечивают генераторы и корутины, разобранные в главе «Итераторы, генераторы и корутины»: планировщику необходима функция, способная приостановиться и продолжить с того же места.
Работа с разными типами задач
Долгое время природу нагрузки внутри программы можно было не учитывать, поскольку приложения писались большими и монолитными, а проблемы с производительностью решались грубой силой: добавленными потоками, дополнительными процессами или ещё одной машиной, установленной в стойку.
Сегодня одних процессов и потоков недостаточно, и выбор инструмента начинается с вопроса, чем занята программа. Задачи разделяют на три типа:
-
CPU bound-задачи. Задачи, требующие интенсивного использования процессора, среди которых сложные математические модели, обучение нейронных сетей, рендеринг графики и вычисление хешей.
-
I/O bound-задачи (non-RAM I/O bound). Задачи, в которых основная часть работы приходится на ввод/вывод информации I/O или input/output, относящиеся в основном к работе с файловой системой и с сетью.
-
Memory bound-задачи (RAM I/O bound). Задачи с интенсивной работой с оперативной памятью, возникающие, как правило, в сложных математических моделях. Из-за медленной работы с оперативной памятью всё больше моделей обрабатывается на видеокартах, устроенных иначе. Другим примером служит обработка огромного объёма данных в Map-Reduce-системах, например таких как Spark, выполняющаяся тем быстрее, чем больше оперативной памяти.
Подробнее об этом рассказано в англоязычных статьях о значении терминов CPU bound и I/O bound и о производительности.
Из-за массового перехода на микросервисы количество сетевого взаимодействия между системами многократно возросло, а вместе с ним и нагрузка, приходящаяся на базы данных. Проблемы работы с сетью или с доступом к БД относятся к I/O bound-задачам, сводящимся к ожиданию ответа на запрос, отправленный во внешнюю систему. Такой класс задач в монолитных системах решался пулом потоков, thread pool, которого с ростом сетевой нагрузки между множеством сервисов стало недостаточно.
Классическим ответом на I/O bound-нагрузку является добавление ресурсов, однако приобретать серверы вместо того, чтобы разбираться с кодом, способны лишь компании с большими бюджетами. В лаборатории этот путь закрыт, и остаётся писать код, рассчитанный на такую нагрузку.
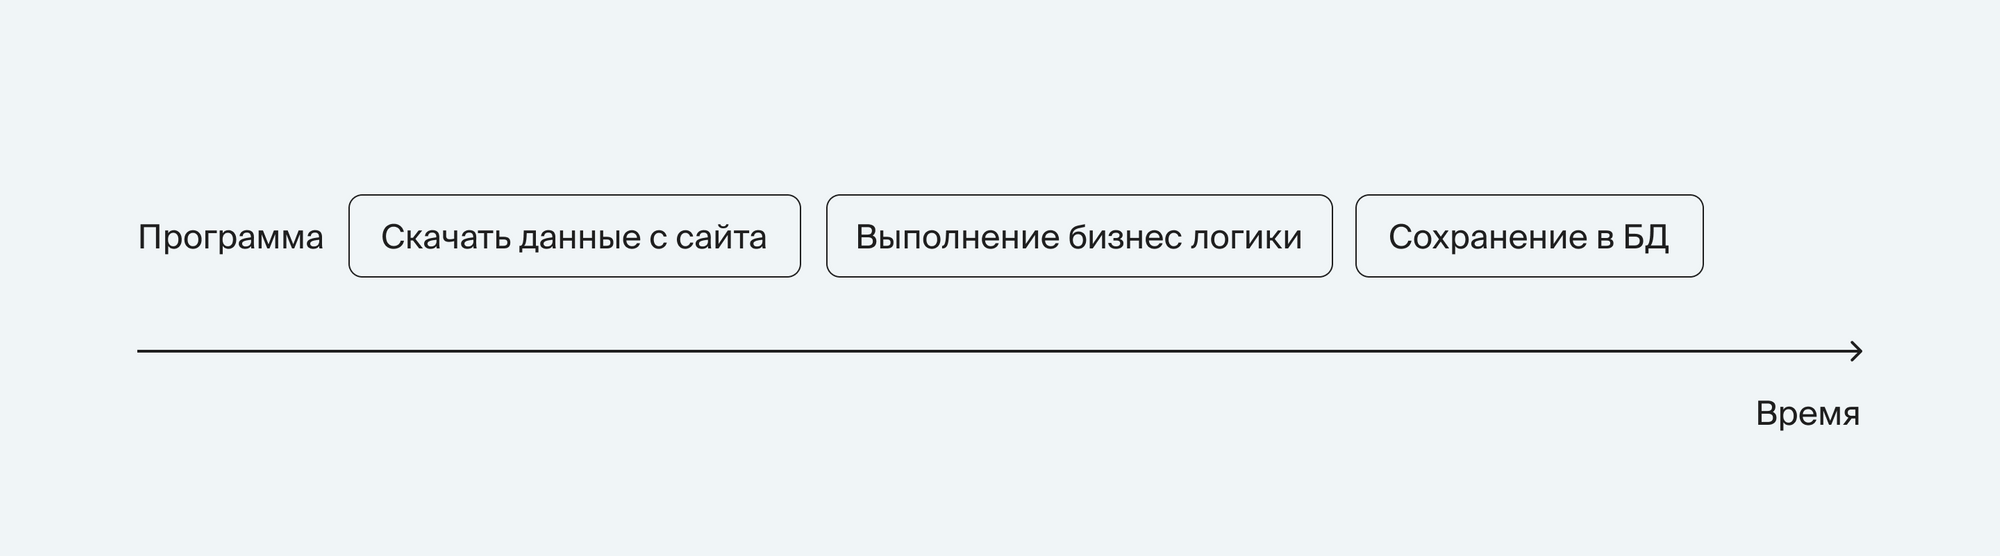
Рассмотрим приложение, обращающееся к некоторому сайту-агрегатору за данными по фильмам и сохраняющее полученное в БД (ссылка на сайт вымышленная):
import requests

def do_some_logic(data):
    pass

def save_to_database(data):
    pass

data = requests.get('https://data.aggregator.com/films')
processed_data = do_some_logic(data)
save_to_database(processed_data)
Код линейный, и пока запрос один, проблем нет, однако как только приложению приходится обслуживать многих клиентов одновременно, время ответа возрастает. Бо́льшую часть времени интерпретатор не выполняет ничего полезного, а ожидает запроса от клиента, ожидает ответа от внешнего сайта, ожидает записи, подтверждённой базой. А клиенты в это время ожидают его.
Схема выполнения программы:
Тип задачи в каждой ячейке:
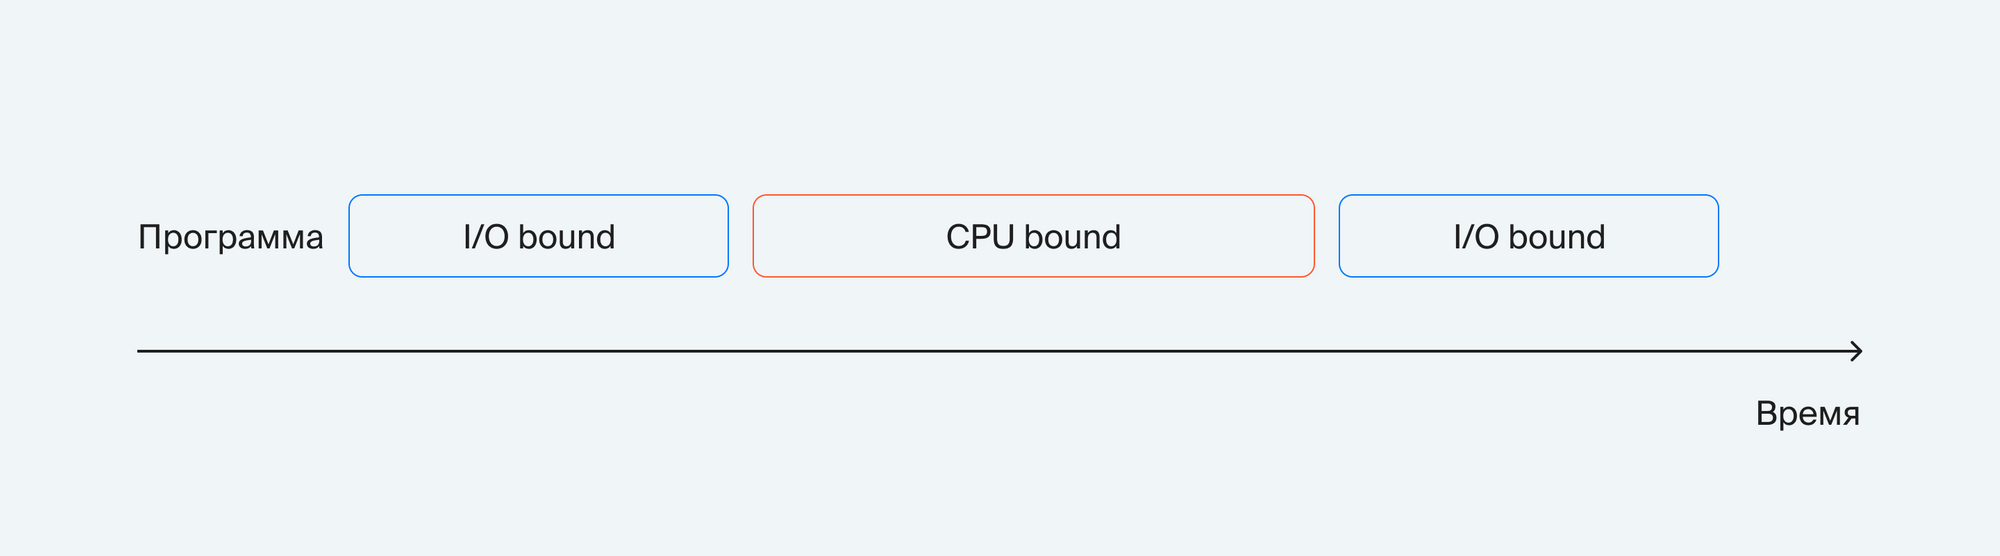
Интуитивно представляется, что время распределено между ячейками примерно поровну, однако в действительности картина иная:
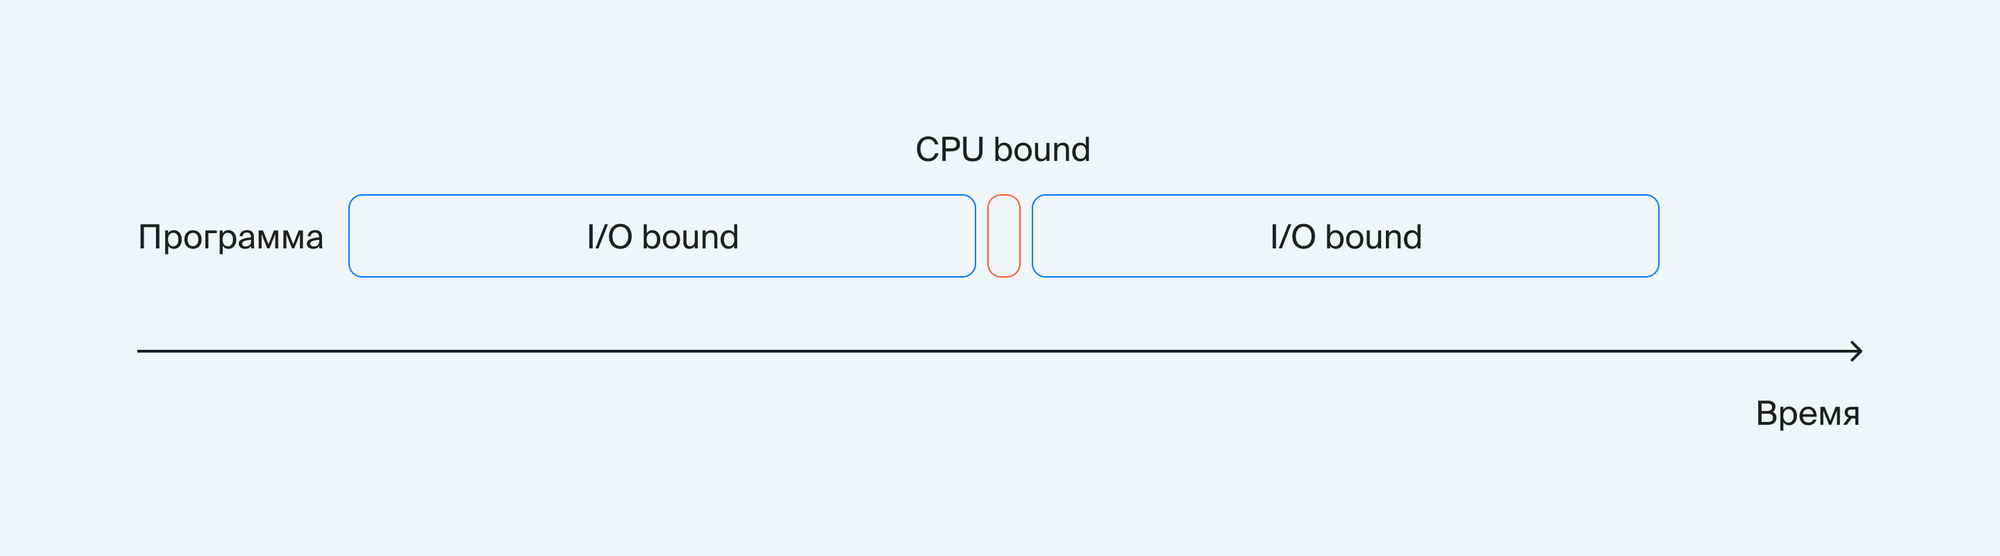
Бо́льшую часть времени программа ожидает ввода/вывода, а полезная работа теряется на этом фоне.
Код можно распараллелить на процессы и потоки. Это поможет, но ненадолго: расходы ресурсов сервера возрастут, а число процессов и потоков ограничено, поскольку закончится либо оперативная память под потоки, либо ядра под процессы. Добавляется GIL, пропускающий через интерпретатор только один поток за раз: массовый параллелизм на потоках он делает бессмысленным и добавляет собственные накладные расходы, пусть и небольшие.
Выполнение программы с потоками:
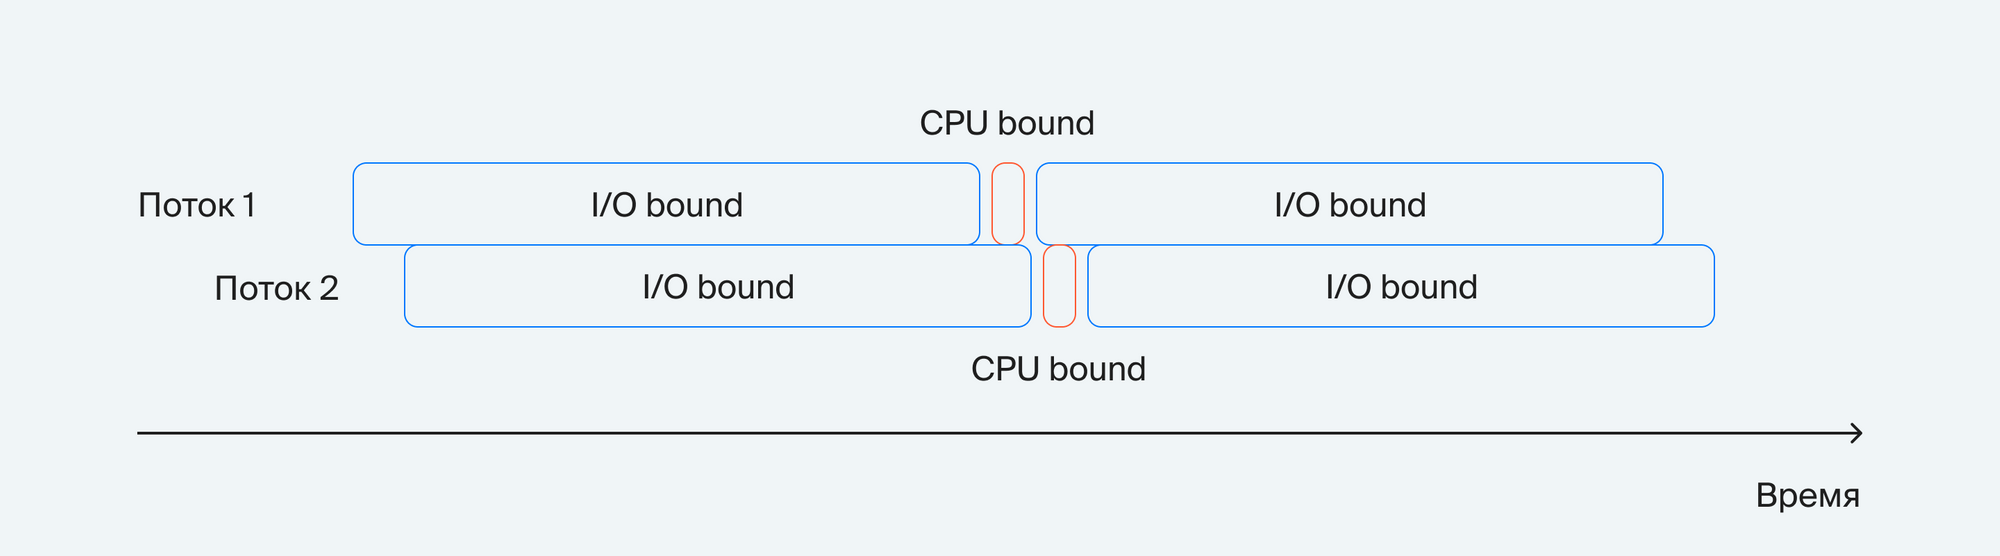
На I/O bound-задачах два потока работают почти вдвое лучше. Однако два потока, обращающиеся к одним и тем же данным, порождают проблему «состояния гонок», а многопоточный код требует от разработчика большей внимательности, чем линейный. Кроме того, создать неограниченное число потоков невозможно: памяти под каждый стек они потребляют несравнимо больше, чем корутины.
Интерпретатор по-прежнему бо́льшую часть времени ничего не выполняет, а лишь запрашивает у операционной системы, завершилась ли операция ввода-вывода, запущенная минуту назад. Процессы и потоки этого не меняют. Простаивать будет каждый из них, зато добавятся накладные расходы на переключение контекста и на память, выделенную под стеки, из-за чего положение может даже ухудшиться.
Решение состоит не в увеличении числа исполнителей, а в том, чтобы один исполнитель не простаивал. Эту задачу решает асинхронный код.
Event-loop
Цикл событий является ядром асинхронных программ в Python. Разберём простую реализацию, предложенную Дэвидом Бизли (David Beazley) в 2009 году: в ней отсутствуют конструкции, которыми с тех пор дополнились промышленные реализации, и устройство просматривается полностью. Код Бизли приведён к современной версии Python.
Архитектура цикла событий:
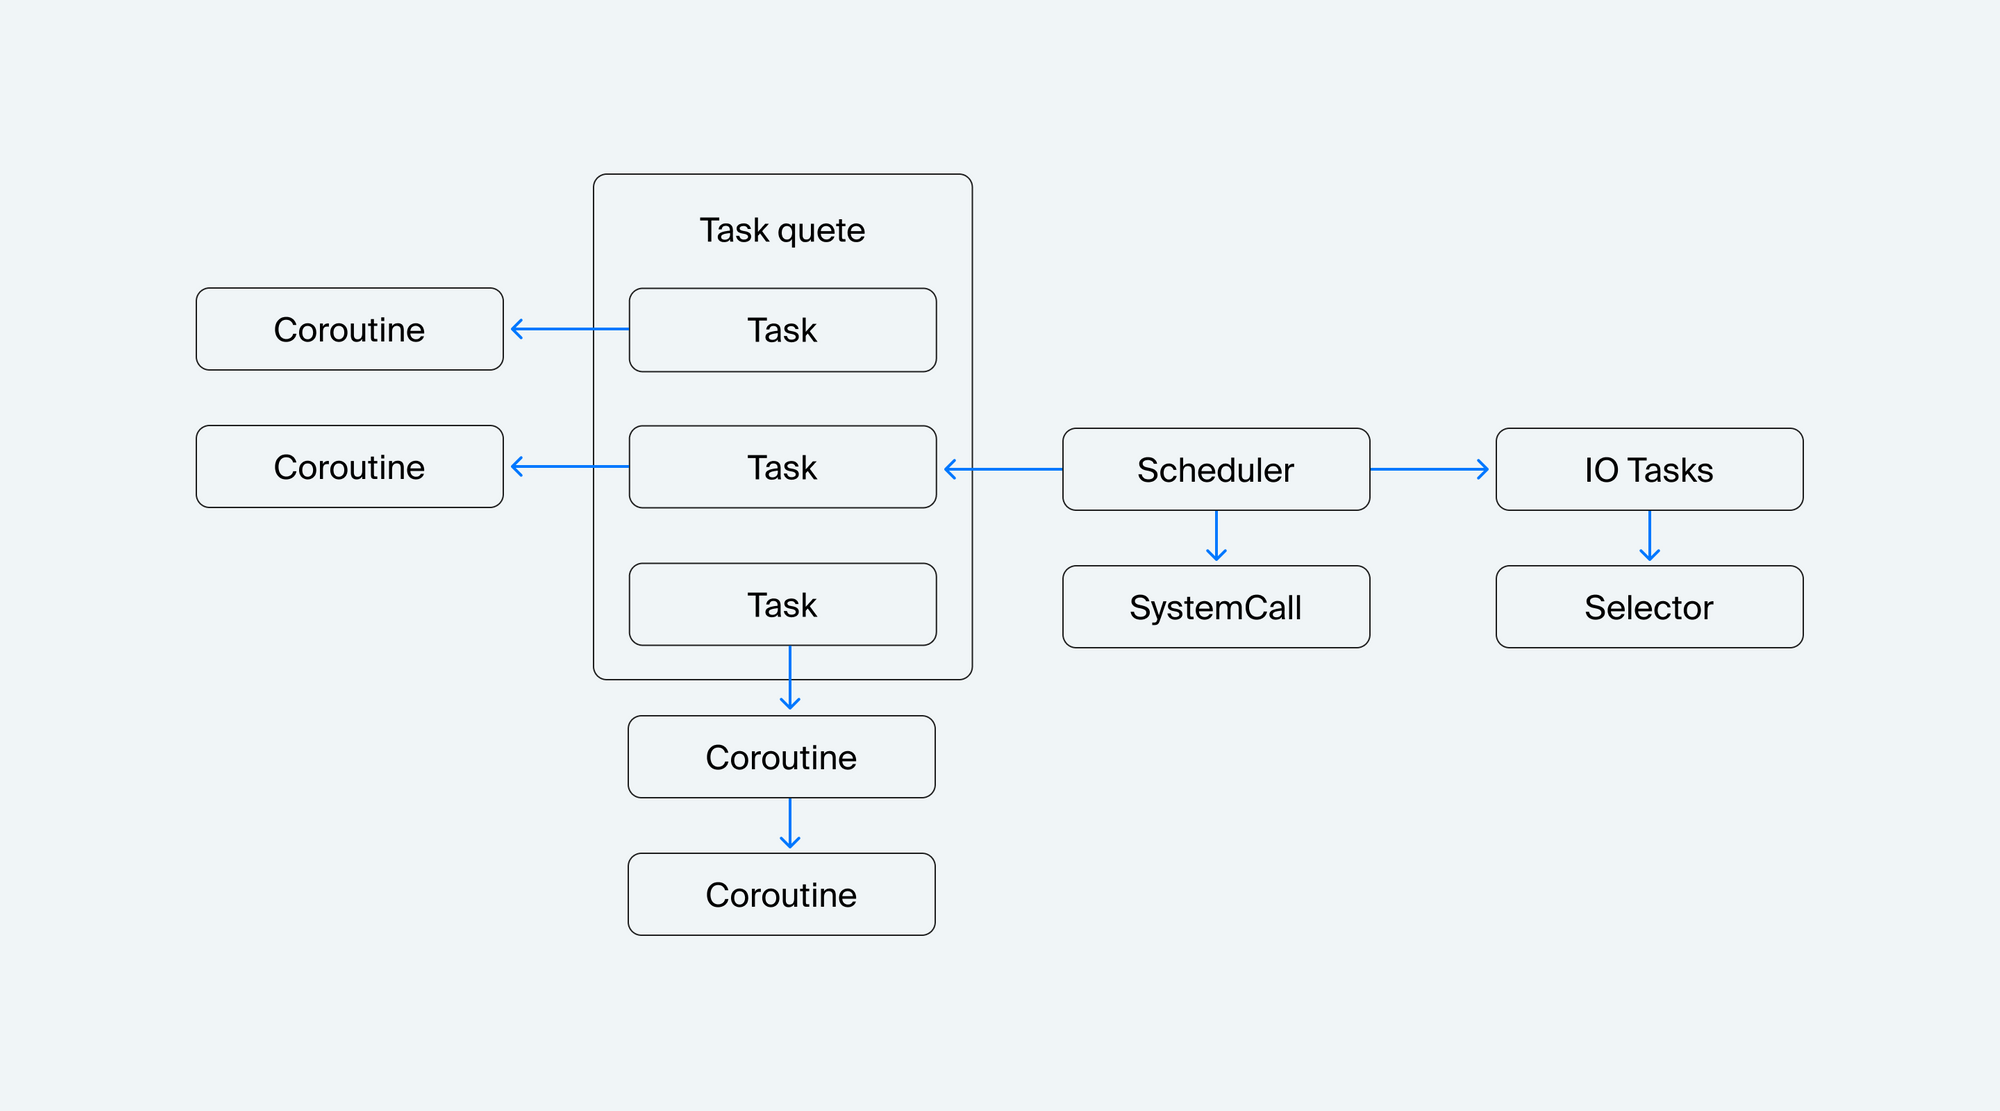
Рассмотрим блоки:
- Планировщик (Scheduler). Корень всей программы. Обрабатывает задачи, собранные в очереди, и следит за их правильным переключением между собой.
- Очередь задач (Task queue). Здесь накапливаются новые задачи, поставленные на исполнение.
- Задача (Task). Основной блок работы цикла событий. В задачах хранится информация о выполняемой корутине. Способна обрабатывать цепочку вложенных корутин.
- Корутина (Coroutine). Исполняемый код, которым оперирует планировщик задач.
- Системный вызов (SystemCall). Блоки кода, расширяющие функциональность планировщика.
- Корутина для выполнения работы с I/O (I/O-tasks). В планировщик добавляется специальная задача (Task), предназначенная для обработки I/O-событий от ОС.
- Селектор (Selector). Он принимает события от ОС и передаёт работу корутинам, ожидающим обработки I/O-сообщений.
Планировщик принимает задачи и справедливо обрабатывает накопленный список.
from __future__ import annotations

import logging
from typing import Generator
from queue import Queue


class Scheduler:
    def __init__(self):
        self.ready = Queue()
        self.task_map = {}

    def add_task(self, coroutine: Generator) -> int:
        new_task = Task(coroutine)
        self.task_map[new_task.tid] = new_task
        self.schedule(new_task)
        return new_task.tid

    def exit(self, task: Task):
        del self.task_map[task.tid]

    def schedule(self, task: Task):
        self.ready.put(task)

    def _run_once(self):
        task = self.ready.get()
        try:
            result = task.run()
        except StopIteration:
            self.exit(task)
            return
        self.schedule(task)

    def event_loop(self):
        while self.task_map:
            self._run_once()
Вся работа происходит в функции event_loop(), извлекающей задачи одну за другой. В функции _run_once() осуществляется обработка одной итерации цикла событий, где поочерёдно извлекаются и запускаются задачи, поставленные в очередь. Если задача не завершилась, то она возвращается в очередь self.ready. Выполненные задачи удаляет из планировщика функция exit().
Задачу добавляет функция add_task(): она принимает корутину и создаёт с ней задачу в планировщике. Уже созданную задачу ставит в планировщик функция schedule().
Устройство задачи:
import types
from typing import Generator, Union

class Task:
    task_id = 0

    def __init__(self, target: Generator):
        Task.task_id += 1
        self.tid = Task.task_id  # Task ID
        self.target = target  # Target coroutine
        self.sendval = None  # Value to send
        self.stack = []  # Call stack

    # Run a task until it hits the next yield statement
    def run(self):
        while True:
            try:
                result = self.target.send(self.sendval)

                if isinstance(result, types.GeneratorType):
                    self.stack.append(self.target)
                    self.sendval = None
                    self.target = result
                else:
                    if not self.stack:
                        return
                    self.sendval = result
                    self.target = self.stack.pop()

            except StopIteration:
                if not self.stack:
                    raise
                self.sendval = None
                self.target = self.stack.pop()
Задача представляет собой обёртку вокруг корутины. У каждой задачи есть свой id, учитываемый в планировщике в словаре task_map. По его заполненности планировщик определяет, остались ли невыполненные задачи.
Задача выполняет корутины методом run(). Пусть имеется корутина, вызывающая другую корутину, а та вызывает третью:
def square(x):
    yield x * x

def add(x, y):
    yield from square(x + y)

def main():
    result = yield add(1, 2)
    print(result)
    yield
Это несколько изменённый код Бизли из его выступления. Выполним эту цепочку корутин внутри Task.
task = Task(main())
task.run()
9
Аналогично выполняются и остальные корутины, вложенные в цепочку. Остаётся научить планировщик работать с вводом-выводом.
Для этого ему потребуется селектор, обёртка над механизмом операционной системы, способным ожидать событий одновременно на многих файловых дескрипторах, зарегистрированных программой.
import logging
from typing import Generator, Union
from queue import Queue
from selectors import DefaultSelector, EVENT_READ, EVENT_WRITE


logger = logging.getLogger(__name__)


class Scheduler:
    def __init__(self):
        self.ready = Queue()
        self.selector = DefaultSelector()
        self.task_map = {}

    def add_task(self, coroutine: Generator) -> int:
        new_task = Task(coroutine)
        self.task_map[new_task.tid] = new_task
        self.schedule(new_task)
        return new_task.tid

    def exit(self, task: Task):
        logger.info('Task %d terminated', task.tid)
        del self.task_map[task.tid]

    # I/O waiting
    def wait_for_read(self, task: Task, fd: int):
        try:
            key = self.selector.get_key(fd)
        except KeyError:
            self.selector.register(fd, EVENT_READ, (task, None))

        else:
            mask, (reader, writer) = key.events, key.data
            self.selector.modify(fd, mask | EVENT_READ, (task, writer))

    def wait_for_write(self, task: Task, fd: int):
        try:
            key = self.selector.get_key(fd)
        except KeyError:
            self.selector.register(fd, EVENT_WRITE, (None, task))

        else:
            mask, (reader, writer) = key.events, key.data
            self.selector.modify(fd, mask | EVENT_WRITE, (reader, task))

    def _remove_reader(self, fd: int):
        try:
            key = self.selector.get_key(fd)
        except KeyError:
            pass
        else:
            mask, (reader, writer) = key.events, key.data
            mask &= ~EVENT_READ
            if not mask:
                self.selector.unregister(fd)
            else:
                self.selector.modify(fd, mask, (None, writer))

    def _remove_writer(self, fd: int):
        try:
            key = self.selector.get_key(fd)
        except KeyError:
            pass
        else:
            mask, (reader, writer) = key.events, key.data
            mask &= ~EVENT_WRITE
            if not mask:
                self.selector.unregister(fd)
            else:
                self.selector.modify(fd, mask, (reader, None))

    def io_poll(self, timeout: Union[None, float]):
        events = self.selector.select(timeout)
        for key, mask in events:
            fileobj, (reader, writer) = key.fileobj, key.data
            if mask & EVENT_READ and reader is not None:
                self.schedule(reader)
                self._remove_reader(fileobj)
            if mask & EVENT_WRITE and writer is not None:
                self.schedule(writer)
                self._remove_writer(fileobj)

    def io_task(self) -> Generator:
        while True:
            if self.ready.empty():
                self.io_poll(None)
            else:
                self.io_poll(0)
            yield

    def schedule(self, task: Task):
        self.ready.put(task)

    def _run_once(self):
        task = self.ready.get()
        try:
            result = task.run()
        except StopIteration:
            self.exit(task)
            return
        self.schedule(task)

    def event_loop(self):
        self.add_task(self.io_task())
        while self.task_map:
            self._run_once()
Перед стартом цикла событий планировщик создаёт одну особую, бесконечную задачу io_task. Её бесконечный цикл забирает у селектора накопившиеся события и немедленно возвращает управление планировщику.
Если очередь задач пуста, селектор ожидает событий без таймаута, до появления новых. В противном случае таймаут равен 0, чтобы сразу забрать все события, накопленные операционной системой.
Поступившие из селектора события обрабатываются, а отработанные файловые дескрипторы удаляются. Одна и та же задача может ожидать присланных данных и одновременно пытаться записать свои, поэтому в поле data хранится кортеж (reader, writer).
event_loop предоставляет интерфейс для работы с сокетами, четыре метода:
wait_for_read,wait_for_write,_remove_reader,_remove_writer.
Эти методы позволяют работать с циклом событий, встроенным в ОС.
Основным назначением цикла событий является переключение корутин, а обращаются ли те к сети, к диску или ничего не ожидают, для него безразлично.
Остаётся конструкция SystemCall. Цикл событий напоминает работу ОС, и механизм прерываний, передающий управление наверх, заимствован у неё: в асинхронном коде прерывание обеспечивает yield. После переключения контекста может вызываться системная функция, запрошенная корутиной. Например, для создания новых задач:
class SystemCall:
    def handle(self, sched: Scheduler, task: Task):
        pass


class NewTask(SystemCall):
    def __init__(self, target: Generator):
        self.target = target

    def handle(self, sched: Scheduler, task: Task):
        tid = sched.add_task(self.target)
        task.sendval = tid
        sched.schedule(task)
В Scheduler добавляется фрагмент:
class Scheduler:
    ...
    def _run_once(self):
        task = self.ready.get()
        try:
            result = task.run()
            if isinstance(result, SystemCall):
                result.handle(self, task)
                return
        except StopIteration:
            self.exit(task)
            return
        self.schedule(task)
А в Task — условие при выполнении корутин:
import types
from typing import Generator, Union

class Task:
    ...
    def run(self):
        while True:
            try:
                result = self.target.send(self.sendval)
                if isinstance(result, SystemCall):
                    return result
                ...
NewTask предоставляет интерфейс для создания новых задач в цикле событий и абстрагирует клиентский код. Это эмуляция защищённой среды ОС, предоставляющей безопасные методы для работы с ядром, чтобы клиентский код не мешал другим программам, запущенным в системе. Аналогичным образом можно реализовать KillTask или WaitTask.
Последней проблемой являются блокирующие операции. Пока запущенная операция не завершится, цикл событий останавливается вместе с ней. Решается это на уровне сокетов: вызов socket.setblocking(False) переводит сокет в неблокирующий режим, и вместо ожидания он немедленно сообщает, что данных пока нет. Ожидать их будет селектор, сразу за всех.
Asyncio
asyncio является основной встроенной библиотекой для асинхронного программирования.
С версии Python 3.5 в языке присутствует синтаксис async/await. Он предоставляет «нативные» корутины — отдельную сущность языка, а не повторно использованный генератор. Благодаря разделению появились асинхронные генераторы, и асинхронный код стал работать быстрее.
Простая программа с async/await:
import random
import asyncio


async def func():
    r = random.random()
    await asyncio.sleep(r)
    return r


async def value():
    result = await func()
    print(result)


if __name__ == '__main__':
    asyncio.run(value())
Функция asyncio.run создаёт планировщик задач, устроенный по разобранным выше принципам, и закрывает его по завершении. Переключением между корутинами управляет await.
Основные функции asyncio:
gatherвыполняет переданный список корутин одновременно и дожидается результатов от всех.sleepприостанавливает корутину на определённое количество секунд.wait/wait_forдожидаются выполнения уже запущенной корутины.
Основные функции event_loop:
get_event_loopвозвращает цикл событий текущего потока, создавая его при необходимости. В новом коде вместо связкиget_event_loopиrun_until_completeиспользуется одна строкаasyncio.run(...).run_until_complete/runзапускают и проверяют асинхронные функции.shutdown_asyncgensкорректно завершает выполнение цикла событий и всех корутин; о ней часто забывают.call_soonставит обычную функцию (не корутину) в очередь на ближайшую итерацию цикла и не ожидает её выполнения. Поставленная таким образом функция может бесконечно переставлять саму себя.
Ключевым отличием asyncio от предложенной реализации является то, что asyncio работает на функциях обратного вызова, колбэках (callback). Этот механизм распределяет время между задачами справедливее. Каждая корутина встаёт в очередь и дожидается исполнения, тогда как в простом планировщике переключения не произойдёт, пока вся цепочка корутин не выполнится, а остальные задачи, поставленные в очередь, всё это время простаивают. Недостатком колбэков является callback hell, когда после вызова каждой функции необходимо вызвать ещё одну функцию и ещё одну:
func1.add_callback(
    func2.add_callback(
                func3.add_callback(func4)
        )
)
Синтаксис async/await позволяет этого избежать.
await func4()
await func3()
await func2()
await func1()
Это возможно благодаря классу Future, скрывающему колбэки и делающему код линейным. Создавать Future вручную в современном коде почти не приходится: это выполняют create_task и gather.
Асинхронные фреймворки
Поверх asyncio (а иногда и в обход него) сформировалась экосистема. Физику она необходима, когда вокруг готового расчёта требуется построить сервис: принимать данные с прибора, передавать результаты коллегам, обращаться к базе лаборатории. Ниже приведены три характерных представителя.
Twisted
Один из старейших асинхронных фреймворков, построенный на собственной реализации event-loop.
Основные концепции:
- Protocol, описание получения и отправки данных
- Factory, управление созданием объектов протокола
- Reactor, собственная реализация event-loop
- Deferred-объекты, цепочки обратных вызовов
Пример Deferred-объекта:
from twisted.internet import defer

def toint(data):
    return int(data)

def increment_number(data):
    return data + 1

def print_result(data):
    print(data)

def handleFailure(f):
    print("OOPS!")

def get_deferred():
    d = defer.Deferred()
    return d.addCallbacks(toint, handleFailure)\
           .addCallbacks(increment_number, handleFailure)\
           .addCallback(print_result)
Aiohttp
Асинхронные HTTP-клиент и сервер, построенные поверх asyncio.
Пример приложения:
import aiohttp
from aiohttp import web

async def get_phrase():
    async with aiohttp.ClientSession() as session:
        async with session.get('https://fish-text.ru/get',
                             params={'type': 'title'}) as response:
            result = await response.json(content_type='text/html; charset=utf-8')
            return result.get('text')

async def index_handler(request):
    return web.Response(text=await get_phrase())

async def response_signal(request, response):
    response.text = response.text.upper()
    return response

async def make_app():
    app = web.Application()
    app.on_response_prepare.append(response_signal)
    app.add_routes([web.get('/', index_handler)])
    return app

web.run_app(make_app())
FastAPI
Современный фреймворк для быстрой разработки API, построенный на Starlette и Pydantic.
Простой пример API:
from fastapi import FastAPI
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="Простые математические операции")

class Add(BaseModel):
    first_number: int = Field(title='Первое слагаемое')
    second_number: Optional[int] = Field(None, title='Второе слагаемое')

class Result(BaseModel):
    result: int = Field(title='Результат')

@app.post("/add", response_model=Result)
async def create_item(item: Add):
    return {
        'result': item.first_number + (item.second_number or 1)
    }
Резюме
Асинхронность не является универсальным ускорителем; это инструмент, предназначенный для задач, в которых программа ожидает. Для расчётов она бесполезна. Одна корутина, надолго занявшая процессор, остановит весь цикл событий вместе с очередью, накопленной к этому моменту: поток по-прежнему один.
Выбор инструмента определяется следующим образом:
- задача ожидает сеть, диск или прибор — применяется асинхронность, выигрыш может составлять десятки раз;
- задача вычисляет — применяются процессы (
multiprocessing), векторизация NumPy или компиляция, разобранные в предыдущих главах; - и то и другое — применяется цикл событий для ожиданий в сочетании с пулом процессов для расчётов через
loop.run_in_executor.
В асинхронном коде не должно быть блокирующих вызовов. Одна time.sleep() или синхронный запрос к базе останавливает не свою корутину, а всю программу.