Разработка и применение программного обеспечения в физических исследованиях
Вячеслав Федоров, ИЯФ СО РАН
Учебное пособие для студентов второго курса, обучающихся по направлению «Прикладная математика и физика».
Предмет книги
Программирование стало основным инструментом работы физика. Установка управляется кодом, данные обрабатываются кодом, результат в статье получен кодом. Качество этого кода определяет, можно ли доверять результату.
Обучение программированию осуществляется по остаточному принципу. На первом курсе студенту показывают синтаксис языка. О том, как организовать проект, как убедиться, что программа считает правильно, как обеспечить, чтобы через год в ней разобрался коллега, обычно не говорят. В результате появляются скрипты, работающие только у автора, только на его данных и только до первого изменения.
Программа, выполняющая некоторый расчёт, пишется за вечер. Чтобы посчитанному можно было доверять, а расчёт был воспроизводимым, требуется дисциплина. Этой дисциплине и посвящено настоящее пособие.
От общего курса программирования пособие отличается материалом, подобранным под задачи физического эксперимента: в нём разбираются работающие коды установок, а не учебные примеры.
Предполагается, что читатель знаком с основами программирования и с математическим аппаратом первого курса, то есть с анализом и линейной алгеброй. Всё остальное рассматривается по ходу изложения.
Результаты изучения пособия
В результате изучения пособия студент должен уметь:
- Пользоваться ИИ-помощниками и контролем версий. Языковые модели с пониманием того, где они помогают, а где вредят; Git как рабочий инструмент.
- Работать в GNU/Linux. Устройство системы, файловые системы, процесс загрузки, инструменты командной строки и диагностика неполадок: без этого минимума работа на вычислительном кластере невозможна.
- Владеть Python. Устройство объектов и коллекций, функции, декораторы, классы, генераторы и цена, скрытая за каждой операцией.
- Понимать алгоритмы и структуры данных. Это позволяет оценивать, справится ли расчёт с заданным объёмом данных, и выбирать подходящую структуру.
- Применять инженерные практики. Жизненный цикл программы, тестирование, превращение скрипта, написанного за вечер, в приложение, поддерживаемое годами, сети и базы данных.
- Обрабатывать и анализировать данные. NumPy, pandas, визуализация, классические алгоритмы машинного обучения и нейронные сети.
- Ускорять программы. Профилирование, многопоточность и GIL, асинхронность, вычисления на графических ускорителях.
- Читать чужой код. Разбор реальных программ, с помощью которых выполняются физические расчёты в институтах СО РАН, и одного веб-сервиса, взятого без физики, чтобы за ней не скрывалась архитектура, — вместе с заложенными в них компромиссами и с решениями, которые сегодня были бы приняты иначе.
Структура книги
Порядок частей продиктован зависимостями между ними.
Сначала рассматриваются инструменты: помощники на языковых моделях и контроль версий. Затем операционная система, от загрузки до устройства ядра, и контейнеры, основанные на его механизмах. Далее сам язык, его объекты, коллекции и классы, а следом алгоритмы и структуры данных, примеры для которых на этом языке и написаны. Инженерные практики идут после: жизненный цикл программы, требования к коду, сети, базы данных. Завершается пособие работой с данными эксперимента, ускорением расчётов, разбором реальных программ, написанных в институтах СО РАН, и заданиями для самостоятельной работы.
Читать пособие рекомендуется последовательно, поскольку главы опираются друг на друга. Если какая-либо тема требуется немедленно, достаточно воспользоваться оглавлением и перекрёстными ссылками.
Читать пособие без клавиатуры не рекомендуется. Каждый пример имеет смысл набрать самостоятельно, изменить и проанализировать результат. Задания в конце пособия предназначены именно для этого.
Интерпретация замеров времени
В пособии приведено много измерений вида «эта версия быстрее в сто раз» или «на миллионе элементов уходит две секунды».
Рассматривать следует отношения, а не секунды. Абсолютное время ничего не значит без указания машины, на которой оно получено: тот же код на ноутбуке пятилетней давности и на серверном процессоре даёт числа, отличающиеся в разы. Утверждение «Numba ускоряет этот цикл в сто раз» от процессора не зависит, а утверждение «эта функция считается 14 секунд» зависит. Все выводы в пособии построены на отношениях, и именно их целесообразно проверять, запуская код на собственной машине.
Одно и то же измерение, повторённое подряд, даёт разные числа, поскольку на результат влияют кеш процессора, сборщик мусора, фоновые процессы и троттлинг, снижающий частоту при нагреве. Поэтому замер повторяется многократно: %timeit в IPython показывает среднее и стандартное отклонение по семи прогонам, а timeit.repeat из стандартной библиотеки возвращает серию замеров, из которой берётся минимум. Единичного замера недостаточно: если два варианта различаются на десять процентов, а разброс составляет двадцать, измерение не даёт никакой информации. В экспериментальной физике число не приводят без погрешности и условий опыта; то же относится к производительности программ.
Электронная версия
Пособие поддерживается в актуальном состоянии в электронном виде, где собраны полные листинги, интерактивные графики и исправленные опечатки:
- Текст книги: https://phys-dev.github.io/soft-dev-book/
- Исходники и задания: https://github.com/phys-dev
Там же размещено приложение с экспресс-курсом по основам языка, NumPy и Matplotlib, в печатное издание не вошедшее: пересказывать документацию на бумаге нецелесообразно.
Замеченные ошибки и предложения направляются в issues репозитория; они будут учтены в следующем издании.
О себе
Меня зовут Федоров Вячеслав Васильевич. С 2018 года я работаю в Институте ядерной физики им. Г. И. Будкера СО РАН, с 2026 года — младшим научным сотрудником в секторе 5-13. Область моих научных интересов — моделирование динамики заряженных частиц в электромагнитных полях и разработка программ, обеспечивающих настройку ускорительных комплексов. Окончил НГУ по направлению «Физика».
В последние годы я участвую в пуско-наладочных работах на линейном ускорителе инжектора ЦКП «СКИФ»: измерение энергии и эмиттанса пучка, коррекция орбиты, автоматизация настройки оптики. Многие примеры пособия представляют собой упрощённые версии задач, решавшихся на этой установке.
Программы, разработанные в рамках этой работы, разобраны в пособии:
- REDPIC рассчитывает динамику пучка методом макрочастиц по релятивистской разностной схеме (№ 2023688768 от 25.12.2023);
- KENV осуществляет быстрый расчёт огибающей пучка по уравнению Капчинского—Владимирского (№ 2024611244 от 18.01.2024);
- SCAUT оркеструет эксперименты на ускорителях, объединяя управление, диагностику и моделирование в единой системе (№ 2025619977 от 21.04.2025); её слои разобраны в главе «От скрипта к приложению»;
- ACCUMULATOR является цифровым двойником установки, неотличимым от неё для остальных программ (№ 2026668488 от 07.07.2026);
- SAVA обеспечивает поддержку оператора в пультовой, связывая приборы, документацию и журнал смены на естественном языке (свидетельство пока не оформлено).
С 2021 по 2024 год я параллельно занимался разработкой коммерческого программного обеспечения: микросервисов для финансовой организации, модулей статического анализа кода, приложения, распознающего диагнозы в медицинских картах. Из этого опыта в пособие вошли главы про жизненный цикл программы, тестирование, непрерывную интеграцию и базы данных. В физической лаборатории этому обычно не учат, тогда как необходимость в этих навыках не меньше.
В 2017 и 2018 годах я разрабатывал на C++ программу инфракрасного датчика горизонта для сверхмалого космического аппарата НГУ «Норби», запущенного в 2020 году.
В НГУ я читаю лекции и веду семинары по применению Python в физических исследованиях и по основам искусственного интеллекта. Настоящее пособие выросло из этого курса.
Дополнительные сведения об авторе приведены на странице автора.
Применение ИИ для разработки ПО
Настоящая часть посвящена языковым моделям и построенным на них помощникам, существенно изменившим за последние годы повседневную работу программиста.
Обсуждение этих инструментов нередко сводится к одной из двух крайностей. Первая состоит в том, что код теперь пишет нейросеть и учиться незачем. Вторая объявляет всё это игрушкой, непригодной для серьёзных задач. Обе позиции опровергаются фактами. Инструмент уже установлен на машинах у большинства разработчиков, а результаты его применения измерены и опубликованы.
Поэтому изложение строится на измерениях. Рассматривается, откуда эти инструменты появились и почему появились только сейчас; что говорят об их влиянии на скорость работы данные, полученные в аккуратно поставленных экспериментах; как модель устроена внутри, в объёме, достаточном для понимания природы её ошибок; какие формы инструментов существуют и чем они отличаются; как одна такая форма выглядит вблизи, на примере самого распространённого плагина к редактору. Завершают раздел ответы на вопросы, задаваемые студентами чаще всего, включая вопрос, считается ли это списыванием, и глава про Git, без которого работа с ассистентом, переписывающим по десятку файлов за раз, представляет опасность.
Инструмент усиливает того, кто понимает, что делает, и подводит того, кто не понимает. Код, который студент не может объяснить, нельзя сдавать независимо от того, кем он написан: ответственность за строку, сгенерированную моделью, остаётся на подписавшем работу.
Слайды к главе. Материал главы и её разделов изложен также в первой половине лекции «ИИ и Git» с демонстрациями в терминале и в редакторе кода; слайды лекции доступны на сайте книги и в PDF.
Контекст и скорость изменений
Материал об ИИ в разработке устаревает быстрее, чем успевает быть дописан абзац. Поэтому в настоящей главе речь идёт не о конкретных моделях и ценах, а о том, что меняется медленно: как устроены эти инструменты, где они помогают и где вредят.
Маховик раскручивался давно
Нынешний бум растянут на десятилетие, однако до 2022 года происходящее почти не выходило за пределы исследовательских лабораторий:
- 2012 г. AlexNet выигрывает соревнование ImageNet, показав, что глубокие свёрточные сети, обученные на графических ускорителях, решают задачи компьютерного зрения лучше методов, накопленных за предыдущее десятилетие. Отсюда начинается современная эпоха глубокого обучения.
- 2014 г. Ян Гудфеллоу предлагает генеративно-состязательные сети (GAN), устроенные как пара соперников; впервые нейросети начинают убедительно порождать данные, а не только раскладывать готовые по классам.
- 2017 г. Статья «Attention Is All You Need» вводит архитектуру трансформера. Трансформер лежит в основе практически всех больших языковых моделей, выпущенных с тех пор, а попытки обойтись без него редки.
- 2018–2020 гг. Обнаруживаются законы масштабирования, связывающие качество модели с числом параметров, объёмом данных и вычислительным бюджетом: качество предсказуемо улучшается при их согласованном росте. Появляются GPT-2 и GPT-3.
- 2022 г. Выходит ChatGPT. Прорыв произошёл не в архитектуре, а в дообучении под диалог и в удобном интерфейсе, добавленном к модели, существовавшей и раньше. Этого оказалось достаточно, чтобы технология вышла за пределы сообщества, следившего за ней десять лет.
Между научной идеей и инструментом на рабочем столе пользователя проходят годы, и большая часть пути невидима снаружи. Трансформеру, на котором работает современный ассистент, к моменту выхода ChatGPT было уже пять лет.
Скорость распространения
Миллион пользователей ChatGPT набрал за пять дней. Instagram потребовалось около двух с половиной месяцев, Airbnb и Netflix — годы. Этой скоростью объясняется и объём инвестиций: сотни миллиардов долларов, вложенных в дата-центры и обучение моделей.
Инструмент, освоенный большинством коллег, становится частью профессионального минимума, подобно тому как это произошло с системой контроля версий двадцать лет назад. Отказ от него требует обоснования.
Оговорка о сингулярности
В обсуждениях ИИ часто встречается слово «сингулярность», обозначающее гипотетическую точку, после которой технологический рост становится неуправляемо быстрым. Руководители индустрии поддерживают эту риторику; Сэм Альтман в июне 2025 года написал:
Мы прошли горизонт событий; взлёт начался.
К подобным заявлениям целесообразно относиться с поправкой на то, что их авторы заинтересованы в притоке инвестиций. Речь идёт об инструменте с конкретными сильными и слабыми сторонами, который необходимо научиться применять по назначению, а не по рекламе.
Полезные ссылки
- Vaswani A. et al. Attention Is All You Need. Статья, с которой начались большие языковые модели.
- Блог Сэма Альтмана. Взгляд индустрии изнутри, с поправкой на интерес автора.
- Epoch AI. Независимая аналитика по темпам развития ИИ и вычислительным затратам, собранная по открытым источникам.
ИИ и разработчик
О том, что помощники на языковых моделях дают человеку, пишущему код, в настоящей главе предлагается судить по числам, измеренным в эксперименте, а не по впечатлениям.
Насколько это распространено
По опросу Stack Overflow 2024 года, охватившему десятки тысяч человек, около двух третей разработчиков уже применяли ИИ-инструменты в работе, и ещё примерно каждый седьмой собирался начать. В следующих выпусках опроса доля продолжает расти.
Тот же опрос показывает: инструментами пользуются охотно, однако коду, предлагаемому моделью, не доверяют и перепроверяют его.
Расхождение ощущений и измерений
В 2025 году организация METR провела эксперимент, поставленный со строгим контролем. Опытным разработчикам, годами ведущим проекты с открытым кодом, давали задачи в их собственных, хорошо знакомых им репозиториях, причём часть задач, выбранная случайным образом, решалась с ИИ-ассистентом, а часть без него. С ассистентом задачи выполнялись примерно на 19% медленнее. Сама цифра значит немного; важен знак, противоположный тому, чего ожидали и авторы, и участники.
Те же участники, опрошенные после эксперимента, были уверены, что ИИ ускорил их работу примерно на 20%. Ощущение разошлось с замером почти на 40 процентных пунктов.
Результат получен на экспертах в знакомом им коде, то есть в ситуации, где человек и так работает близко к максимуму своих возможностей, а ассистент лишь добавляет накладные расходы: прочитать предлагаемый фрагмент, проверить его и исправить. Это ничего не говорит о ситуации, где разработчик осваивает незнакомую библиотеку, пишет шаблонный код, повторяемый из проекта в проект, или работает на неродном языке программирования: там выигрыш реален.
Отсюда следуют два практических вывода:
- Ощущению ускорения верить нельзя. Чтобы узнать, помогает ли инструмент, необходимо провести измерение. Та же мысль приведена в главе про профилирование программ: интуиция, подсказывающая, где тратится время, ошибается систематически.
- Выигрыш зависит от того, насколько разработчик сам силён в задаче. Чем лучше он знает предметную область и написанный им же код, тем меньше даёт ассистент и тем важнее становится умение отличить дельное предложение от правдоподобного мусора, выданного с той же уверенностью.
Таким образом, ИИ представляет собой инструмент с очерченной областью применимости, а умение им пользоваться является отдельным навыком, осваиваемым так же, как осваиваются отладчик или система контроля версий.
Полезные ссылки
- Stack Overflow Developer Survey: раздел про ИИ. Ежегодные данные, собранные по десяткам тысяч анкет: чем пользуются разработчики.
- METR. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. Исследование, разобранное выше; рекомендуется к прочтению целиком, включая обсуждение ограничений.
Технические основы
Ниже приведён минимум сведений, без которого невозможно понять ни сильные стороны языковых моделей, ни их отказы, обусловленные самим устройством.
Принцип работы языковой модели
Большая языковая модель (LLM) решает одну задачу: предсказывает по имеющемуся тексту, какой фрагмент будет следующим. Всё остальное (диалог, генерация кода, объяснения) надстроено над этим механизмом.
Модель работает не со словами, а с токенами, то есть фрагментами текста, выделенными токенизатором. Английское слово в среднем занимает около одного токена, русское обычно два-три: кириллица, представленная в словарях моделей хуже, разбивается на более мелкие части. Один и тот же текст на русском обходится дороже и быстрее заполняет контекст, чем на английском.
Токены преобразуются в векторы и проходят через десятки слоёв трансформера. Ключевым механизмом внутри является внимание (attention): при обработке каждого токена модель взвешивает, насколько для него важен каждый из остальных. Это позволяет ей связывать определение функции, объявленной в начале файла, с её вызовом в конце.
Обучение состоит из двух этапов. Сначала модель в течение месяцев обрабатывает корпус текстов, собранных со всего интернета, и учится предсказывать продолжение, усваивая язык, факты и типовые приёмы программирования. Затем её дообучают следовать инструкциям и быть полезной в диалоге. Отсюда следуют два ограничения: модель не «знает» ничего после даты, на которой обрывается её обучающий корпус, и не имеет доступа к файлам пользователя, пока они не переданы ей явно.
Причины уверенных ошибок модели
Здесь заключена главная причина, по которой ИИ-ассистент не заменяет понимания.
Модель обучена порождать правдоподобное продолжение, а не истинное. Механизма проверки фактов у неё нет. Если правильный ответ ей неизвестен, она не сообщит об этом, а сгенерирует то, что выглядит как правильный ответ. Такие выдумки называют галлюцинациями; в программировании они принимают узнаваемые формы:
- аргумент функции, придуманный по аналогии: в документации его нет, однако «логично было бы иметь»;
- правдоподобная, но выдуманная ссылка на статью или страницу документации;
- формула с перепутанным коэффициентом, выглядящая уверенно;
- библиотека с осмысленным названием, которой не существует.
Несуществующая библиотека обнаруживается на первом же импорте. Перепутанный коэффициент в научном коде может остаться незамеченным. Программа запускается, выдаёт числа, числа попадают в отчёт, и никто не замечает, что формула была не та. Всё, что ассистент выдал про физику, численные методы и API библиотек, проверяется по документации и здравому смыслу. Код, в котором разработчик не разобрался, в проект не включается, кем бы он ни был написан.
Из чего складываются характеристики модели
- Размер. Число обучаемых параметров, от единиц миллиардов до триллионов. Чем модель больше, тем более тонкие зависимости она способна уловить, но тем дороже и медленнее её работа. Для простых задач небольшая модель отвечает быстрее и дешевле при том же результате.
- Контекстное окно. Число токенов, которое модель видит за раз, включая вопрос пользователя, приложенные файлы и собственный ответ. Это главный практический предел: в окно должен поместиться весь код, о котором задаётся вопрос, вместе с историей разговора. Чем ближе к пределу, тем хуже модель удерживает детали из середины контекста.
- Способность к рассуждению. Часть моделей обучена перед ответом порождать промежуточные шаги рассуждения. Такие модели сильнее в задачах, требующих многошагового вывода (математика, отладка), но отвечают дольше и стоят дороже.
По причине, оговорённой в начале раздела, названия моделей и цены здесь не приводятся. Сравнение по качеству, скорости и стоимости ведут независимые площадки, Artificial Analysis и OpenRouter.
Формулировка запросов к модели
Способы формулировать запрос называют промтингом:
- Zero-shot. Задать вопрос. Работает для типовых задач.
- Few-shot. Приложить один-два примера в нужном формате. Повышает шансы получить ответ по образцу.
- Chain-of-thought. Попросить рассуждать по шагам. Помогает там, где нужен многошаговый вывод; в «рассуждающих» моделях встроено по умолчанию.
Качество ответа определяется не изяществом формулировки, а тем, что модель видит. Если ей предоставлены нужный файл, сообщение об ошибке целиком, фрагмент документации, то и посредственный запрос даёт результат. Без них модель начинает додумывать недостающее. Этот подход, названный контекст-инжинирингом, важнее промтинга.
Агенты
Агентом называют языковую модель, помещённую в цикл и снабжённую инструментами чтения и записи файлов, запуска команд, поиска по репозиторию.
Цикл устроен следующим образом: модель получает задачу, выбирает инструмент, анализирует результат и по нему решает, что делать дальше, пока задача не решена. Этот цикл превращает чат в инструмент, способный самостоятельно найти ошибку в проекте, исправить код и запустить тесты.
Главный риск состоит в том, что агент выполняет команды в системе пользователя. Первое правило работы с агентом, к которому мы вернёмся в следующей главе: допускать его только в репозиторий под контролем версий.
Полезные ссылки
- Attention Is All You Need. Оригинальная статья о трансформере.
- Anthropic. Building Effective Agents. Разбор того, как устроены агентные системы и когда они оправданы.
- Artificial Analysis. Независимое сравнение моделей по качеству, скорости и цене.
Задание. Простейшую языковую модель предлагается реализовать самостоятельно: «Генерация текста на основе данных». Цепь Маркова, реализованная за вечер, показывает и откуда берётся связность, и откуда берутся выдумки.
Инструментарий
Инструменты меняются каждые несколько месяцев, поэтому важнее запомнить не названия, а три формы, в которых ИИ приходит в разработку.
Три формы инструментов
Первая, наиболее простая для входа, — плагин к редактору. Он устанавливается в привычную разработчику среду (VS Code, JetBrains, Neovim) и работает внутри неё, ничего не нарушая. Наиболее известный — GitHub Copilot; бесплатный тариф у него предусмотрен для всех, а для студентов бесплатен полный, о чём подробнее говорится в следующей главе.
Вторая форма — редактор, спроектированный вокруг ассистента: отдельная среда разработки, в которой модель видит проект целиком, а не только открытый файл. Большинство таких редакторов выросло из VS Code, поэтому переход почти не требует привыкания, а настройки и расширения переносятся. Примерами являются Cursor и Windsurf.
Третья форма — терминальный агент, работающий в командной строке в каталоге проекта. Он читает файлы, правит их, запускает тесты и разбирает вывод. Эта форма лучше остальных подходит для больших проектов и удалённых машин без графической оболочки — обычная ситуация для физика, работающего на кластере по SSH. Так работают Claude Code, Aider и Gemini CLI.
Границы между формами размываются: редакторы обзаводятся агентным режимом, а терминальные агенты, выросшие из простых скриптов, получают интеграцию с IDE. Выбор определяется тем, где ведётся работа.
Возможности инструментов
Набор возможностей у всех примерно одинаковый, различается глубина вмешательства в код:
- Автодополнение. Модель предлагает продолжение по ходу набора. Подсказка серым текстом выглядит правдоподобно, и её легко принять без чтения.
- Правка выделенного. Разработчик выделяет фрагмент кода и указывает, что с ним сделать, например «добавь обработку ошибок», «перепиши через генератор», «векторизуй этот цикл».
- Чат по проекту. Диалог, позволяющий сослаться на файлы. Подходит для вопроса «почему это падает» с приложенным трейсбеком.
- Агентный режим. Задача ставится целиком, а агент сам читает нужные файлы, вносит правки, запускает тесты и исправляется по упавшим.
Чем ниже по этому списку, тем больше инструмент делает сам, тем меньше контроля остаётся у разработчика и тем внимательнее необходимо проверять результат.
Правила проекта
Все зрелые инструменты читают из репозитория файл с правилами, описывающий, как принято писать код в проекте. Агент подмешивает его в каждый запрос, и повторять одно и то же не приходится.
Сюда записываются договорённости, принятые в группе:
- Код на Python 3.12, стиль — PEP 8, длина строки 79 символов.
- Единицы СИ везде, кроме энергии частиц: она в МэВ.
- Массивы обрабатываем векторизованно, циклов по элементам не пишем.
- Новый код сопровождается тестом в tests/.
- Данные экспериментов в репозиторий не коммитим.
Парным механизмом является файл игнорирования по образцу .gitignore. В него заносится всё, что не должно передаваться в модель: файлы с паролями и токенами, персональные данные, ещё не опубликованные сырые данные экспериментов и материалы, закрытые соглашением с институтом. Отправленное вернуть невозможно, а утёкший токен придётся перевыпускать.
MCP: подключение собственных инструментов к агенту
Model Context Protocol (MCP) — открытый протокол, предложенный Anthropic в конце 2024 года и принятый остальными участниками отрасли.
Инструментов, необходимых агенту, много: база данных, система управления задачами, архив системы управления установкой и документация, размещённая в вики. Клиентов, которым такой доступ нужен, тоже много. Без общего протокола пришлось бы писать интеграцию для каждой пары «клиент — инструмент», а число таких пар растёт как произведение двух растущих списков. MCP вводит единый интерфейс: инструмент, написанный один раз в виде MCP-сервера, доступен любому клиенту, поддерживающему протокол.
Сценарий для научной группы: поднять MCP-сервер, обращающийся к архиву телеметрии установки, и спрашивать у агента, что происходило с током в магнитах в ночь неудачного запуска, вместо того чтобы каждый раз писать разбор логов заново.
Меры предосторожности
Ниже приведены несколько правил, которых рекомендуется придерживаться с первого дня работы с агентами:
- Только под контролем версий. Всё, сделанное агентом, должно быть видно в
git diffи откатываться одной командой; о Git речь пойдёт в конце этой части. - Чтение перед принятием. Отказаться от непонятной правки дешевле, чем впоследствии искать в ней ошибку.
- Мелкими шагами. Задача «перепиши мне весь модуль» даёт результат, который невозможно вычитать в разумное время. Задача «вынеси этот кусок в функцию и добавь тест» проверяется легко.
- Запрет на разрушительные команды. Удаление файлов,
git pushи отправка чего-либо наружу остаются решением, принимаемым человеком, а не агентом. - Ответственность на разработчике. Автором кода считается человек, поставивший под ним коммит. Ссылка на то, что «так предложил ассистент», не работает ни в ревью, ни в статье.
Полезные ссылки
- Документация Model Context Protocol. Спецификация и серверы, написанные сообществом.
- Anthropic. Building Effective Agents. Когда агент оправдан, а когда достаточно запроса в чате.
- Aider. Терминальный агент с открытым исходным кодом, удобный для знакомства с этой формой работы.
GitHub Copilot
Для студента наиболее простым способом начала работы является плагин к редактору. Ниже рассматривается самый распространённый из таких плагинов, выбранный по двум причинам: он бесплатен без подписки (студенту предоставляется полная версия) и устанавливается в среду, уже используемую для работы.
Назначение GitHub Copilot
GitHub Copilot — плагин к редактору, дописывающий код за разработчиком. Он был создан компанией GitHub совместно с OpenAI; первая версия, выпущенная в 2021 году, опередила ChatGPT на полтора года.
Проще говоря. Copilot работает как автодополнение, видящее контекст всего файла, а не только набираемую строку.
Под тем же названием сегодня существуют чат по проекту, агентный режим, самостоятельно правящий файлы, отдельный агент для командной строки и автоматическое ревью пул-реквестов, то есть все три формы, рассмотренные в предыдущей главе. Начинать лучше с автодополнения: оно требует меньше всего доверия к модели, а к остальным формам можно перейти после того, как выработан навык чтения предложенного кода.
Польза для студентов
Попробовать его можно без подписок: бесплатный тариф предоставляется любому владельцу аккаунта GitHub и ограничен числом автодополнений и запросов в чат за месяц, а студенту, оформившему Student Developer Pack, предоставляется полный тариф без этих ограничений.
Польза от него на этапе обучения заключается в трёх вещах. Во-первых, не требуется каждый раз обращаться к документации за порядком аргументов: по контексту он предлагает правильный вызов, который запоминается после нескольких показов. Во-вторых, он помогает сдвинуться с мёртвой точки при работе с пустым файлом, когда неясно, с чего начать; даже небрежно набросанная заготовка даёт точку опоры. В-третьих, его предложения показывают, как принято писать на плохо знакомом языке. Для физика, раз в год правящего чужой код на C++, это заметное подспорье.
Всё сказанное работает только при условии, что предложенное читается. Принятое без чтения предложение представляет собой отложенную отладку.
Начало работы
Установка и настройка
-
Требования:
- Аккаунт на GitHub
- Тариф Copilot: бесплатный включается на любом аккаунте, полный активируется студенческим пакетом
- Поддерживаемая среда: VS Code, JetBrains, Visual Studio, Neovim и другие
-
Установка (на примере VS Code):
- установить расширение «GitHub Copilot» из встроенного магазина;
- авторизоваться через GitHub по запросу расширения;
- при желании активировать студенческий пакет в настройках аккаунта, чтобы снять ограничения бесплатного тарифа.
Активация студенческой подписки
- Перейти на education.github.com
- Подать заявку на Student Developer Pack
- Активировать Copilot в настройках аккаунта
Эффективное использование Copilot
Базовые приёмы работы
Единственным рычагом управления является контекст, поступающий модели на вход: открытый файл, соседние вкладки и комментарии разработчика.
-
Комментирование намерений:
# Напиши функцию для расчёта среднего значения списка # Copilot предложит: def calculate_average(numbers): return sum(numbers) / len(numbers) if numbers else 0 -
Создание шаблонов функций:
function calculateCircleArea(radius) { // Copilot предложит: return Math.PI * radius * radius; } -
Работа с библиотеками:
import numpy as np
# Создать массив из 10 случайных чисел от 1 до 100
# Copilot предложит:
arr = np.random.randint(1, 101, 10)
Продвинутые сценарии
Copilot справляется с однообразной работой вокруг уже написанного кода — тестами и переписыванием фрагментов, написанных наспех.
Генерация тестов:
# Функция сложения двух чисел
def add(a, b):
    return a + b

# Напиши тесты для этой функции
# Copilot предложит:
def test_add():
    assert add(2, 3) == 5
    assert add(-1, 1) == 0
    assert add(0, 0) == 0
Рефакторинг кода:
// Старый код
function processData(data) {
    let result = [];
    for (let i = 0; i < data.length; i++) {
        if (data[i].active) {
            result.push(data[i].value * 2);
        }
    }
    return result;
}

// Добавь комментарий: "Рефакторинг с использованием map и filter"
// Copilot предложит:
function processData(data) {
    return data
        .filter(item => item.active)
        .map(item => item.value * 2);
}
Примеры для учебных задач
Ниже приведены два примера на заданиях второго курса. Комментарий разработчика задаёт задачу, Copilot дописывает остальное; предложенное полезно сравнить с тем, что было бы написано самостоятельно.
Для курса по алгоритмам
# Реализуй быструю сортировку на Python
# Copilot предложит:
def quicksort(arr):
    if len(arr) <= 1:
        return arr
    pivot = arr[len(arr) // 2]
    left = [x for x in arr if x < pivot]
    middle = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]
    return quicksort(left) + middle + quicksort(right)
Для курса по физике
# Рассчитать траекторию движения тела под углом к горизонту
# Copilot предложит:
def calculate_trajectory(initial_velocity, angle_degrees, times):
    import math
    g = 9.81
    angle_rad = math.radians(angle_degrees)
    vx = initial_velocity * math.cos(angle_rad)
    vy = initial_velocity * math.sin(angle_rad)

    trajectory = []
    for t in times:
        x = vx * t
        y = vy * t - 0.5 * g * t**2
        if y < 0:
            break
        trajectory.append((x, y))
    return trajectory
Важные ограничения и предостережения
Типичные ошибки Copilot
Ошибки делятся на три вида, и все три обнаруживаются чтением.
Наиболее безобидной является неэффективность. Предложение решает задачу, но лишним проходом или лишней копией; на учебных объёмах это незаметно, на рабочих начинает мешать. Второй вид — устаревшие подходы. В обучающих данных старого кода больше, чем свежего, поэтому Copilot предлагает приёмы, от которых в библиотеке уже отказались, и сверяться приходится с документацией.
Наиболее опасным является выдумывание. Модель уверенно называет библиотеки, методы и аргументы, не существующие в природе, и выглядит это так же, как верный ответ. Помогает привычка запускать написанное. Метод, придуманный моделью, приводит к ошибке при первом же вызове, а неверная формула молча возвращает правдоподобное число.
Академическая честность
Правила на разных курсах различаются, и выяснять их необходимо заранее, а не на защите. Copilot является инструментом обучения, а не способом сдать задание, в котором студент не разобрался. Необходимо уточнить у преподавателя, что разрешено на его курсе, и разбирать сгенерированный код до того, как он попадёт в сдаваемую работу.
Лучшие практики для студентов
Пять рабочих привычек:
- Точная формулировка задачи. Чем конкретнее комментарий, тем ближе предложение к задуманному
- Чтение предложения целиком. Прежде всего рассматриваются граничные случаи: пустой список, деление на ноль, отсутствующий файл
- Проверка тестом, а не взглядом. Короткий тест на паре значений отвечает надёжнее самого внимательного чтения
- Передача шаблонной работы. Разбор аргументов командной строки, чтение форматов данных, однотипные графики
- Рассмотрение не только первого варианта. Copilot показывает одно решение из многих, и не всегда лучшее
Заключение
Copilot экономит время на том, что разработчик и так умеет: на шаблонном коде, на синтаксисе плохо знакомого языка, на первой заготовке в пустом файле. Понимания он не добавляет, оно остаётся работой самого разработчика.
Таким образом, Copilot следует использовать, чтобы углубить понимание, а не чтобы обойтись без него.
Вопросы и ответы
Ниже разобраны вопросы, задаваемые студентами чаще всего.
Какую модель выбрать для работы с кодом?
Имеет смысл посмотреть свежее сравнение на независимой площадке наподобие Artificial Analysis, отобрать две-три модели и прогнать на них собственные типичные задачи. Разница между лидерами рейтинга обычно меньше, чем разница между задачами пользователя и теми, на которых рейтинг составлялся.
Выбор определяют три параметра: качество на рассматриваемом типе задач, размер контекстного окна (поместится ли в него проект) и стоимость. Для рутины обычно достаточно модели поменьше и подешевле, тяжёлая нужна только для сложной отладки.
Сложно ли внедрить это в старый большой проект?
Сложность растёт с размером кодовой базы. Чем больше проект, тем меньшая его часть помещается в контекстное окно и тем важнее уметь показать модели нужные файлы. Помогают инструменты, умеющие искать по репозиторию самостоятельно; терминальные агенты, запущенные из корня проекта, справляются с этим обычно лучше, чем автодополнение в редакторе.
Начинать лучше не с кода, написанного предшественниками, а с того, чего в проекте не хватает, поручив ассистенту тесты к уже работающим функциям, docstring'и и README. Так становится видно, насколько модель понимает проект.
Может ли ИИ придумать что-то принципиально новое?
Модель сильна настолько, насколько задача похожа на то, что встречалось в обучающих данных. Она может неожиданно скомбинировать известные приёмы и подсказать подход, неизвестный исследователю, но нового метода не изобретёт. Её сильные стороны — скорость, объём и знание решений, накопленных сообществом, но не оригинальность.
Для научной работы это означает, что постановка задачи, выбор модели явления и физическая интерпретация результата остаются за исследователем.
Как начать применять это в научной работе?
Начинать следует с задач, в которых ошибку легко заметить, постепенно расширяя область применения:
- Шаблонный код. Разбор форматов данных, переименование файлов, конвертеры. Ошибка проявится сразу.
- Объяснение чужого кода. Ассистенту поручается разобрать скрипт, доставшийся от предшественника. Проверяется чтением исходника.
- Документация и тесты к собственному уже работающему коду. Тесты заодно проверят и сам код.
- Отладка. Прикладывается трейсбек целиком, а не пересказ, записанный по памяти.
- Автоматизация рутины вокруг расчётов: запуск серий, сбор результатов, сводные графики.
Физические формулы и численные схемы нельзя брать у ассистента без проверки. Ошибка в коэффициенте не приведёт к остановке программы, но испортит результат, посчитанный за ночь.
Можно ли пользоваться ИИ при выполнении заданий курса?
Можно и нужно, с одним условием. Студент обязан понимать каждую сдаваемую строку и уметь её объяснить. На защите задания будет задан вопрос, почему здесь сделано так. Отсутствие объяснения означает, что задание не засчитано, кем бы ни была написана сданная строка.
Git
Git — распределённая система контроля версий (version control system, VCS): она хранит историю изменений файлов, позволяет вернуться к любой прошлой версии и объединяет работу нескольких человек над одним проектом. Для научной работы Git является таким же обязательным инструментом, как Python или LaTeX.
Слайды к главе. Материал главы изложен также во второй половине лекции «ИИ и Git» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Назначение контроля версий
Рассмотрим типичную курсовую работу с расчётами:
processing.py
processing_new.py
processing_final.py
processing_final_v2.py
thesis_final_v2_FINAL(2).py
thesis_final_v2_FINAL(2)_fixed_mass.py
Через месяц требуется перегенерировать третий рисунок для статьи, и никто, включая автора, не помнит, каким из файлов он построен. При этом «финальная» версия даёт другой хвост распределения, поскольку правка константы, сделанная в процессе работы, осталась неучтённой.
Контроль версий решает три проблемы:
- История вместо множества файлов. В проекте хранится один
processing.py, а все его прошлые версии остаются в Git. К любой из них можно вернуться, любые две можно сравнить построчно. - Воспроизводимость расчётов. Каждое состояние проекта имеет уникальный идентификатор, хеш коммита. Если записать его рядом с результатом, через год код, построивший график, восстанавливается дословно. Запись «Рисунок 3 построен на коммите
a3f2c17» и является воспроизводимостью. - Совместная работа. Когда над обработкой данных работают три человека, Git объединяет их изменения и показывает, кто, что и зачем изменил. Пересылать архивы
code_v7_new.zipпо почте не требуется.
Репозиторий на сервере служит и резервной копией: после вечерней отправки изменений на сервер выход из строя диска ноутбука перестаёт быть катастрофой.
Устройство Git
Устройство Git основано на трёх идеях, из которых выводится почти всё поведение команд.
Снимки, а не различия
Git хранит не «патчи к предыдущей версии», а снимки (snapshots). Каждый коммит представляет собой состояние всего проекта в момент фиксации плюс метаданные: автор, дата, сообщение и ссылка на родительский коммит. Неизменившиеся файлы не копируются, Git ссылается на уже сохранённые объекты, и репозиторий не разрастается.
Каждый объект адресуется хешем SHA-1, строкой вида a3f2c17b... из git log; в командах достаточно первых 6–8 символов.
Три состояния
Файлы проекта находятся в трёх зонах:
рабочая директория  ──►  индекс (staging area)  ──►  репозиторий (.git)
  правишь файлы          git add: отбираешь           git commit:
                         изменения для коммита        фиксируешь снимок
- Рабочая директория (working directory) содержит обычные файлы, которые редактирует разработчик.
- Индекс (staging area) — промежуточная область перед коммитом. Командой
git addв неё помещаются изменения, которые войдут в следующий снимок. - Репозиторий находится в скрытой папке
.git, хранящей все коммиты. Коммит, недостижимый ни через ветку, ни через тег, сохраняется ещё около месяца записью вgit reflog, а затем удаляется сборщиком мусора, поэтому спасательный приём из справочной таблицы в конце главы действует ограниченное время.
Индекс кажется избыточным до тех пор, пока не потребуется зафиксировать часть накопленных правок: исправление формулы одним коммитом, эксперименты с графиками — другим.
Коммиты образуют граф
Каждый коммит ссылается на родителя, поэтому история образует направленный ациклический граф (DAG). Пока над проектом работает один человек, граф вырождается в цепочку; ветки заставляют его ветвиться, слияния — сходиться.
A ─── B ─── C ─────── F      main
       └── D ─── E ───┘      fft-filter
Ветка — подвижный указатель на коммит, файл размером 41 байт внутри .git; копия проекта не создаётся, поэтому ветки создаются мгновенно и без затрат. HEAD указывает на текущее положение в графе.
Базовый цикл работы
Разовая настройка
# имя и почта автора попадут в каждый коммит
git config --global user.name "Lev Landau"
git config --global user.email "l.landau@g.nsu.ru"

# называть главную ветку main, как принято на GitHub
git config --global init.defaultBranch main
Создать или склонировать репозиторий
# превратить текущую папку в репозиторий (появится скрытая папка .git)
git init

# или склонировать существующий проект с сервера
git clone https://github.com/nsu-phys/beam-dynamics.git
Путь правки: рабочий каталог, индекс, коммит
В цикле, описанном ниже, проходит почти вся повседневная работа.
git status                  # что изменилось? (спрашивай постоянно)

git add processing.py       # добавить файл в индекс
git add plots/              # можно папку целиком
git add -p                  # интерактивно, по кускам — очень полезно

git commit -m "Учтена поправка на температуру датчика"

git status                  # убедиться, что всё зафиксировано
git status показывает состояние всех трёх зон и подсказывает следующий шаг. На первых порах эту команду имеет смысл вызывать до и после каждой операции.
Просмотр истории и различий
git log                     # полная история с авторами и датами
git log --oneline           # по строчке на коммит
git log --oneline --graph --all   # весь граф с ветками, псевдографикой

git diff                    # что поменялось, но ещё не добавлено в индекс
git diff --staged           # что уже в индексе и войдёт в коммит
git diff a3f2c17 HEAD -- processing.py  # как файл изменился со старого коммита

git show a3f2c17            # что именно сделал этот коммит
.gitignore: исключение файлов из репозитория
Git отслеживает только явно добавленные файлы, однако git status перечисляет всё содержимое каталога, от кешей Python до гигабайтных файлов с данными. Файл .gitignore в корне проекта задаёт, что нужно игнорировать. Заготовка для научного проекта приведена ниже:
# байткод и кеши Python
__pycache__/
*.pyc
.ipynb_checkpoints/

# виртуальное окружение
.venv/

# данные измерений и результаты расчётов — им не место в git
data/
*.h5
*.root
*.npz

# тяжёлые артефакты: чекпойнты моделей, дампы
checkpoints/
*.ckpt

# мусор редакторов и ОС
.idea/
.vscode/
.DS_Store

# LaTeX-мусор
*.aux
*.synctex.gz
В репозитории хранится написанное вручную (код, тексты, конфигурации) и не хранится измеренное на установке или полученное расчётом. Сам .gitignore фиксируется в репозитории: правила исключений являются общими для всей группы.
Ветки
Ветка позволяет экспериментировать, не затрагивая работающий код: для проверки другого алгоритма фильтрации сигнала не требуется комментировать половину файла, достаточно создать ветку, названную по сути эксперимента.
git branch                    # список веток, звёздочка — текущая
git switch -c fft-filter      # создать ветку и переключиться на неё
# ...правишь и коммитишь сколько угодно...
git switch main               # вернуться на main: файлы мгновенно
                              # станут такими, какими были там
git switch появился в Git 2.23; в старых руководствах те же действия выполняются командами git checkout -b fft-filter и git checkout main.
Слияние
Когда эксперимент в ветке завершён успешно, ветка вливается обратно:
git switch main
git merge fft-filter          # влить коммиты fft-filter в main
git branch -d fft-filter      # удалить ненужный больше указатель
Если main с момента ветвления не изменялся, Git передвинет указатель вперёд (fast-forward). Если изменялся, будет создан коммит слияния с двумя родителями, и граф из приведённого выше рисунка сходится в одну линию.
Конфликты
Если в двух ветках изменены одни и те же строки, Git не будет выбирать версию самостоятельно и вставит в файл маркеры, размечающие оба варианта:
<<<<<<< HEAD
dt = 1e-12  # шаг интегрирования для жёсткой задачи
=======
dt = 5e-12  # компромисс между точностью и скоростью
>>>>>>> fft-filter
Конфликт является не ошибкой, а вопросом к разработчику. Необходимо отредактировать файл, оставив правильный вариант или скомбинировав оба, удалить маркеры и завершить слияние:
git add integrator.py         # пометить конфликт разрешённым
git commit                    # завершить merge
Если принято решение отказаться от слияния, вместо этих двух команд требуется одна:
git merge --abort # откатить слияние целиком
После git commit сливать уже нечего, и git merge --abort сообщит, что отменять нечего.
Чем мельче коммиты и чем чаще выполняется слияние веток, тем реже возникают конфликты и тем проще они разрешаются.
Удалённые репозитории
Пока коммиты находятся только на ноутбуке разработчика, нет ни резервной копии, ни совместной работы. Удалённый репозиторий (remote) хранит копию проекта на GitHub, GitLab или на институтской машине группы.
git remote -v                  # список удалённых репозиториев
# после git clone там уже есть origin — адрес, откуда клонировал

# привязать локальный репозиторий к созданному на GitHub
git remote add origin git@github.com:username/beam-dynamics.git

git push -u origin main        # отправить ветку main на сервер;
                               # -u запоминает связку, дальше просто git push

git fetch                      # скачать чужие коммиты, НЕ трогая рабочие файлы
git pull                       # fetch + merge: скачать и влить в текущую ветку
git push                       # отправить свои коммиты
git fetch безопасен всегда: он лишь обновляет локальные сведения о сервере, после чего можно просмотреть git log origin/main и изучить коммиты коллег. git pull объединяет fetch с немедленным слиянием. Типовой ритм работы: в начале сеанса выполняется git pull, по окончании — git push. Чем чаще выполняется синхронизация, тем меньше конфликтов.
Fork + pull request
В чужой репозиторий, будь то библиотека наподобие numpy или проект соседней лаборатории, напрямую отправлять коммиты нельзя. Стандартный механизм состоит из следующих шагов:
- Fork. Кнопкой на GitHub создаётся личная копия репозитория в аккаунте разработчика.
- Форк клонируется, создаётся ветка, фиксируется исправление.
- Ветка отправляется в форк.
- Открывается pull request (PR) — предложение включить коммиты в основной репозиторий, сопровождаемое описанием и дифом.
- Владельцы читают код, пишут замечания (code review), автор дополняет ветку новыми коммитами, и PR обновляется автоматически.
- Одобренный PR вливается в основной репозиторий.
По этой схеме работает весь open source и заметная часть открытой науки; исправление одной строки в документации scipy проходит тот же путь. Внутри своей группы обычно отправляют коммиты в общий репозиторий, однако правки всё равно оформляются ветками и PR ради ревью.
Хорошие практики
Коммиты следует делать атомарными, по одному логическому изменению на коммит. «Исправлена нормировка спектра» и «добавлен скрипт карты магнитного поля» — два коммита, а не один «изменил всякое». Атомарный коммит можно понять, откатить или перенести целиком, коммит со смешанными изменениями — нельзя. По той же причине желательно, чтобы проект в каждом коммите хотя бы запускался: тогда любая точка истории пригодна для поиска момента, в который возникла ошибка.
Не менее важно сообщение коммита. Слово fix не сообщает, что исправлено, где и почему; через полгода git log из fix, fix2 и wip превращается в длительные археологические раскопки. Диф и так покажет, что изменилось. Следует писать короткий заголовок с сутью изменения, не «поменял коэффициент», а «Увеличен шаг сетки: старый не помещался в память на кластере». По общепринятому соглашению заголовок укладывается в 50 символов и не превышает 72. Сообщение должно объяснять, зачем сделано изменение.
Git создан для текста и плохо работает с большими бинарными файлами. Каждый попавший в историю гигабайт останется в ней навсегда, и клонирование станет неприемлемо долгим. Сырые данные с установки, HDF5/ROOT-файлы, видео, обученные модели в репозиторий не помещают. Для версионирования больших файлов рядом с кодом существуют Git LFS (в git хранятся лишь ссылки, а содержимое находится на отдельном сервере) и DVC (Data Version Control, версионирующий данные и пайплайны обработки, а сами файлы размещающий в любом хранилище, будь то облако или сетевой диск группы). Пароли, токены и ключи фиксировать в репозитории недопустимо: удалить секрет из истории почти невозможно, а клоны коллег успевают разойтись.
Исправление ошибок
Зафиксированное в коммите почти невозможно потерять: Git скорее сохранит лишнее, чем удалит нужное. Ниже приведена справочная таблица по типовым ситуациям:
| Ситуация | Команда |
|---|---|
| Файл испорчен, требуется версия из последнего коммита | git restore file.py (незакоммиченные правки исчезнут!) |
| В индекс добавлено лишнее | git restore --staged file.py (убирает из индекса, правки останутся) |
| Опечатка в сообщении последнего коммита или забыт файл | git commit --amend (только пока не запушил) |
| Требуется «рассыпать» последний коммит обратно в правки | git reset --soft HEAD~1 (коммит исчез, изменения остались в индексе) |
| Удалить последний коммит вместе с изменениями | git reset --hard HEAD~1 (опасно, правки будут уничтожены) |
| Отменить уже запушенный коммит | git revert a3f2c17 (новый коммит с обратным изменением, история не переписывается) |
| Срочно нужна другая ветка, а правки не закончены | git stash прячет изменения, git stash pop возвращает |
| «Всё сломано, коммиты пропали» | git reflog, журнал последних положений HEAD; достаточно найти нужный хеш и вернуться командой git reset --hard <хеш> |
git reset --hard — одна из немногих команд, без предупреждения и необратимо уничтожающих незакоммиченную работу. Перед её выполнением необходимо вызвать git status и убедиться, что терять нечего. Историю переписывает и git rebase, переносящий коммиты ветки поверх другой так, как если бы они были сделаны там изначально: граф получается линейным и читаемым, однако перенесённые коммиты получают новые хеши, то есть прежних коммитов больше нет. Не следует переписывать историю (reset, --amend, rebase) в ветках, уже отправленных на сервер и полученных коллегами: им придётся разбираться с разошедшимся графом.
Полезные ссылки
- Введение в основы Git
- Создание алиасов команд
- Как просматривать историю изменений
- Один из подходов к созданию веток
- git rebase для начинающих
- Learn Git Branching, интерактивный тренажёр, в котором ветки, merge и rebase показаны на живом графе коммитов
- Oh Shit, Git!?!, короткие рецепты спасения из типичных ситуаций вида «всё сломано»
- Git Flight Rules, «лётные правила», большой сборник ответов, сгруппированных вокруг вопроса «что делать, если…»
Основы Linux
Под управлением Linux работают вычислительные кластеры, серверы установок и машины сбора данных, то есть практически всё оборудование, на котором выполняются физические расчёты. Независимо от того, ведётся ли разработка на ноутбуке с Windows или macOS, расчёт в итоге выполняется на такой машине. Рано или поздно наступает момент, когда он не запускается, заканчивается место на диске или процесс перестаёт отвечать, и разбираться с этим приходится самому исследователю.
В настоящей части рассматриваются инструменты, необходимые для повседневной работы в терминале, путь от включения питания до приглашения командной строки, организация хранения данных, сборка системы с нуля вручную, внутреннее устройство ядра (процессы, планировщик и память) и, наконец, контейнеры, построенные из этих механизмов ядра.
Часть не является справочником. Команды забываются за полгода, тогда как понимание устройства системы, сформированное однажды, сохраняется.
Слайды к главе. Материал части изложен также в трёх лекциях с демонстрациями в терминале: «Инструменты Linux», «Как организован Linux» (загрузка системы и файловые системы) и «Внутренности Linux»; слайды каждой из них встроены в соответствующие главы, а слайды лекции «Как организован Linux» доступны также на сайте книги и в PDF.
Инструменты Linux
Терминал является основным интерфейсом к системе, и от степени владения им зависит скорость всей повседневной работы. Разница между пользователем, знающим пять команд, и пользователем, знающим тридцать, измеряется часами: первый копирует файлы в графическом файловом менеджере и просматривает журнал вручную, второй выполняет те же действия одной командной строкой, набранной за несколько секунд.
Глава выстроена по нарастающей: сначала рассматривается обустройство рабочего места, затем основы командной строки, далее утилиты, необходимые каждый день, и, наконец, диагностика в ситуации, когда система работает не так, как ожидалось. Запоминать всё подряд не требуется: достаточно знать, что подходящий инструмент существует, а подробности всегда приведены в man.
Слайды к главе. Материал главы изложен также в лекции «Инструменты Linux» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Подготовка и окружение
Слепая печать
Первым навыком является умение печатать, не глядя на клавиатуру. Две вложенные недели окупаются годами: растёт скорость, растёт точность, а внимание постоянно остаётся на экране. В первые месяцы после переучивания скорость, набранная годами, снижается, и это является нормальным.
Инструменты для тренировки:
GNU Typist(gtypist), консольный тренажёр. Устанавливается черезapt-get install gtypistилиbrew install gtypist.monkeytype, современный онлайн-тренажёр.www.keybr.com, ещё один популярный онлайн-тренажёр.
Эмулятор терминала
Терминал, поставляемый в комплекте с системой, обычно способен только отображать текст. Полчаса, потраченные на установку полноценного эмулятора, окупаются быстро. Требуемые возможности:
- вкладки;
- разделение окна на панели;
- копирование в буфер обмена простым выделением текста;
- ссылки, открывающиеся по щелчку;
- плагины;
- темы, прозрачность и прочие мелочи, повышающие удобство работы.
Рекомендуемые терминалы:
- macOS:
iTerm2 - Linux:
Terminator,Kitty,Konsole - Windows 10/11:
Windows Terminal - Windows (условно-бесплатный):
MobaXterm(также включает SSH-клиент, X-сервер и сетевые инструменты).
Моноширинные шрифты
В моноширинном шрифте все символы имеют одинаковую ширину, поэтому колонки, выведенные командой, не смещаются, а отступы в коде различимы визуально. Хороший терминальный шрифт, кроме того, различает плохо отличимые символы, будь то ноль и заглавная O или единица и строчная l.
- Source Code Pro (Adobe)
- Inconsolata (Google)
- Anonymous Pro
Все три распространяются свободно и в большинстве дистрибутивов доступны в подключённых репозиториях.
Командные оболочки (Shell)
Оболочка представляет собой интерпретатор команд. Она разбирает набранную строку, находит нужную программу и запускает её, а терминал, отрисовывающий окно, лишь передаёт нажатия клавиш.
- bash (Bourne-Again SHell): универсальный стандарт. Присутствует на любой машине, доступной по ssh, поэтому переносимые скрипты пишутся под него.
- zsh (Z Shell): те же возможности плюс интеллектуальное автодополнение и богатая экосистема плагинов; настройку упрощает фреймворк
Oh My Zsh. Разумный выбор для собственной рабочей машины. - fish (Friendly Interactive SHell): подсказки по истории, подсветка и автодополнение работают сразу, без настройки. Платой является несовместимость с синтаксисом POSIX-оболочек: скрипт, написанный для bash, в fish не запустится.
Основы командной строки
Структура команд
Команда в оболочке почти всегда является именем исполняемого файла, а не встроенной конструкцией языка. Знание того, как оболочка находит этот файл и по каким соглашениям устроены флаги, позволяет без труда читать чужие скрипты.
- Оболочка ищет исполняемый файл по каталогам из переменной окружения
$PATHи запускает его системным вызовомexec. which <команда>илиtype <команда>показывают полный путь к исполняемому файлу команды. Флаг-aпоказывает все возможные пути в$PATH.- Флаги команд не стандартизированы, но существуют соглашения:
-v/--versionпоказывают версию.-h/--helpпоказывают справку.-y/-fпропускают подтверждение (yes/force).
Справка man
Основным источником информации является man (manual). Обращаться к нему следует раньше, чем к поисковой системе: в man описана версия утилиты, установленная в системе, а не та, о которой три года назад писали на форуме.
- Пейджер: По умолчанию для просмотра используется
less. Его можно изменить переменной окружения$MANPAGER(например,MANPAGER=cat). - Основные клавиши в
less:hвызывает помощь.PgUp,PgDown,↓,↑служат для навигации./KEYWORDзапускает поиск.nпереходит к следующему совпадению,Nк предыдущему.gпереносит в начало документа.Gпереносит в конец документа.
man <раздел> <команда>, напримерman 1 bash(справка по bash из раздела «пользовательские команды»).man -P 'less +/KEYWORD' bashоткрывает man с поиском по ключевому слову.
Управление процессами
Запущенной программой можно управлять из того же терминала. Все сочетания, перечисленные ниже, посылают процессу сигналы, устройство которых рассматривается в главе про внутреннее устройство Linux, а команды fg, bg и jobs определяют, на переднем плане процесс выполняется или в фоне.
Ctrl + Cпосылает сигналSIGINT(завершение процесса).Ctrl + \посылает сигналSIGQUIT(завершение с дампом памяти).Ctrl + Zпосылает сигналSIGTSTP(приостановка процесса).fgвозвращает приостановленный процесс на передний план.bgзапускает приостановленный процесс в фоновом режиме.jobsвыводит список задач текущей оболочки с их номерами.stty -aпоказывает настройки терминала и позволяет их изменить.
Управление вводом/выводом (I/O Redirection)
У каждой запущенной программы имеются три открытых потока, а перенаправление подменяет то, куда они ведут. На нём основаны конвейеры: вывод одной программы становится входом другой, и ни одна из них об этом не знает.
Вывод расчёта, запущенного на ночь, направляется так, чтобы результаты и ошибки попали в разные файлы: наутро сразу видно, была ли ошибка, и просматривать мегабайт накопленных чисел не придётся.
- Потоки данных:
stdin(0), стандартный вход.stdout(1), стандартный выход.stderr(2), стандартный вывод ошибок.
- Перенаправление:
команда > файлзаписываетstdoutв файл, перезаписывая его.команда >> файлдописываетstdoutв конец файла.команда 2> файлзаписываетstderrв файл.команда &> файлзаписываетstdoutиstderrв файл.команда 2>&1перенаправляетstderrвstdout.команда | другая_командапередаётstdoutпервой команды наstdinвторой.
- Специальные файлы:
/dev/null, «чёрная дыра»./dev/zero, источник нулей./dev/urandom, источник псевдослучайных чисел.
Полезные помощники
Ни один из этих приёмов не требует специального изучения: достаточно однократного применения.
- Автодополнение (completion): клавиша
TAB.- Одно нажатие дополняет команду или файл.
- Двойное нажатие показывает все возможные варианты.
- История команд (
~/.bash_history,~/.zsh_history):Ctrl + Rзапускает реверсивный поиск по истории.history | grep <ключевое_слово>ищет по истории.sudo !!выполняет предыдущую команду сsudo.!$подставляет последний аргумент предыдущей команды.
Ветвления, циклы и подоболочки (Subshell)
Оболочка является полноценным, хотя и неудобным, языком программирования. Циклов и условий достаточно, чтобы выполнить расчёт по сотне наборов параметров, заданных в файле, не открывая редактор. Как только скрипт превышает пару десятков строк, переписать его на Python оказывается дешевле, чем поддерживать.
;разделяет команды, выполняемые последовательно.- Циклы и условия:
while true; do ...; done for i in $(seq 1 10); do echo $i; done if [ "$(wc -l < file.txt)" -gt 3 ]; then ...; fi read, встроенная команда для чтения ввода в переменные.- Подстановка команд (command substitution):
$(команда)подставляет вывод команды в строку; сама команда выполняется в подоболочке, поэтому присвоенные в ней переменные наружу не передаются. - Подоболочка (subshell):
( команда; команда )— дочерняя копия оболочки со своими переменными и текущим каталогом, так чтоcdвнутри скобок родительский каталог не меняет. [является не элементом синтаксиса оболочки, а командой: в/usr/binрасположена одноимённая программа, хотя bash и zsh выполняют собственную встроенную. Отсюда и требование ставить пробелы вокруг скобок: без них это будет другое имя команды. Подробности:man [илиman test.
Полезные команды и утилиты
Ниже рассматриваются инструменты, необходимые почти в каждой рабочей задаче: поиск файлов, сохранение сессии при обрыве связи, редактирование конфигурации на удалённом сервере и обработка текстового потока.
Find и многопоточность
Связка find и xargs применяет команду ко всем файлам, удовлетворяющим условию. Флаг -P у xargs превращает её в простейший параллельный запуск с заданным числом одновременных процессов. Выигрыш растёт с числом процессов, пока задача ограничена процессором; на обработке, ограниченной диском, он выходит на насыщение заметно раньше.
findосуществляет мощный поиск файлов и директорий.- Пример:
find /etc -type f -name "nginx*"
- Пример:
xargsпередаёт результаты изstdinв аргументы другой команды.-P <N>запускает до N процессов параллельно.-n1передаёт по одному аргументу за раз.-0читает имена, разделённые нулевым байтом, — пара кfind -print0; без неё имена с пробелами будут разбиты на части.- Пример:
find /data -type f -print0 | xargs -0 -P10 -n1 md5sum
GNU parallelслужит более мощной альтернативойxargsдля параллельного выполнения.
Управление сессиями: screen и tmux
Расчёт, запущенный по ssh, завершается вместе с обрывом связи, а связь с кластером обрывается регулярно. screen и tmux решают эту проблему: сессия, отвязанная от терминала, продолжает работать на сервере, а пользователь подключается к ней и отключается в любой момент, в том числе с другой машины. На кластере с планировщиком долгий расчёт отправляют в очередь командой sbatch, а считать на узле входа правила большинства центров запрещают, и tmux там служит для интерактивной работы; планировщик рассмотрен в главе «Кластеры и воспроизводимое окружение для расчётов».
-
screen:screenсоздаёт новую сессию.Ctrl + A, Dотключает от сессии (detach).screen -lsвыводит список сессий.screen -r <session>подключает к сессии.
-
tmux(рекомендуется):tmuxсоздаёт сессию.Ctrl + B, Dотключает от сессии.tmux lsвыводит список сессий.tmux a -t <session>подключает к сессии.- Интеграция с
iTerm2:tmux -CC.
-
watch -d -n1 "команда"выполняет команду раз в секунду и подсвечивает меняющиеся значения.
Редактирование текста
Рано или поздно потребуется править конфигурацию на сервере без графической оболочки, поэтому необходимо владеть хотя бы одним консольным редактором. Выбор является вопросом вкуса, однако выйти из незнакомого редактора, открывшегося вместо привычного, обязан уметь каждый.
- Vim:
- Мощный редактор, присутствующий на любой машине, но с непривычным управлением, которое требует отдельного освоения.
vimtutor, встроенный интерактивный учебник на полчаса.- Основы:
iвключает режим вставки,ESCвозвращает в нормальный режим,:wqсохраняет и выходит,:q!выходит без сохранения. vimdiff file1 file2сравнивает файлы.
- Emacs: другой мощный редактор со своей философией и своими сторонниками.
- Git: система контроля версий, без которой сегодня не обходится ни один проект; ей посвящена отдельная глава. Для сообщения коммита git открывает редактор, заданный настройкой
core.editorили переменными окруженияVISUALиEDITOR. Если ничего не задано, в Ubuntu и Debian открывается системный редактор по умолчанию, обычноnano(подсказки клавиш показаны внизу экрана:Ctrl+Oсохраняет файл,Ctrl+Xвыходит), а в macOS и большинстве других систем —vi. Привычный редактор задаётся явно:git config --global core.editor vim.
Потоковая обработка текста
Каждая из этих утилит выполняет над текстовым потоком одну операцию, а соединяются они конвейером. Разбор журнала, извлечение колонки чисел, подсчёт уникальных значений укладываются в одну строку, набранную по ходу работы. Как только разбор перестаёт быть разовым и становится частью повторяемого конвейера обработки данных, его лучше переписать на Python: цепочку из пяти awk и sed через месяц невозможно ни прочитать, ни отладить.
grepфильтрует строки по регулярному выражению.awk, целый язык для обработки текста, основанный на колонках.sed, потоковый редактор, правящий текст на лету (замена, удаление строк и т.д.).cutизвлекает конкретные колонки.headиtailвыводят начало и конец файла, аtail -fпоказывает строки, дописываемые в настоящий момент.trзаменяет или удаляет символы.wcсчитает строки, слова и символы.sortсортирует строки.uniqотфильтровывает повторяющиеся строки.
Тренажёры: grepexercises, sedexercises, awkexercises (устанавливаются через pip).
Практика: The Command Line Murders, детективный квест, расследуемый исключительно командами в терминале: https://github.com/veltman/clmystery
Диагностика и поиск проблем
Последняя часть посвящена ситуации, когда система работает не так, как ожидалось: расчёт стал необъяснимо медленным, место на диске закончилось, сервис не отвечает.
Общий принцип диагностики состоит в движении сверху вниз по подсистемам (процессор, память, диск, сеть) с принятием на каждом шаге решения, здесь ли узкое место или дальше. Каждое предположение необходимо подтверждать измерением на работающей системе.
Методология и ресурсы
Карта инструментов, охватывающая всю систему целиком, составлена Бренданом Греггом (Brendan Gregg). На его сайте https://www.brendangregg.com/linuxperf.html приведены схемы, где каждая подсистема ядра подписана инструментами, которыми она измеряется. Схем четыре:
- Linux Observability Tools для наблюдения за работающей системой;
- Linux Static Performance Tools для сбора статической конфигурации, заданной до всякой нагрузки;
- Linux Benchmarking Tools для нагрузочного тестирования;
- Linux Tuning Tools для подстройки параметров ядра.
Первую, самую насыщенную, рекомендуется распечатать и разместить рядом с рабочим местом. У того же автора имеется книга «Systems Performance: Enterprise and the Cloud», справочник по всему, что в Linux измеримо.
Мини-топ полезных утилит
- Мониторинг процессов и системы:
topиhtopпоказывают процессы в интерактивном режиме.atopведёт расширенный мониторинг и позволяет записывать данные в файл.pidofнаходит PID по имени процесса.ps fauxw | lessдаёт подробный список запущенных процессов.
- Диски и файловая система:
df -hиdf -ihпоказывают место на дисках и inodes.du -sh /path/*показывает размер директорий.iostat -x 1выводит статистику ввода-вывода.
- Сеть:
ss -sиnetstat -ntlpвыводят статистику сокетов и открытые порты.ping,tracerouteиmtrдиагностируют сетевую связность.tcpdumpработает «сниффером», перехватывающим сетевые пакеты.ethtool eth0показывает настройки и статистику сетевого интерфейса.
- Прочее:
lsof -i:ПОРТпоказывает, какой процесс держит порт, аlsof -p $PID— какие файлы и сокеты открыл процесс.strace -fp $PIDиstrace $cmdтрассируют системные вызовы.dmesg -Tпоказывает сообщения ядра с проставленными временными метками.perf top -F99профилирует систему в реальном времени.curl— универсальный инструмент для работы с HTTP и сетью.
Заключение
Осваивать всё сразу не требуется. Рекомендуемый порядок следующий: сначала слепая печать и полноценный терминал, затем привычка обращаться к man вместо поисковой системы, затем tmux, позволяющий не терять работу на удалённой машине при обрыве связи, и уже после этого grep, awk и sed. Каждый следующий инструмент осваивается на реальной задаче, а не заранее и впрок.
Мерилом здесь является не число выученных команд, а то, сколько действий, прежде выполнявшихся вручную, теперь выполняется одной набранной строкой.
Задание. Долгий расчёт, переживающий закрытие сессии: «Работа с долгоиграющими процессами».
Задание. Обустройство рабочего места в терминале и выполнение набора упражнений: «Настройка окружения и работа с утилитами».
Процесс загрузки
Микропрограмма, записанная в чип материнской платы, инициализирует оборудование. Загрузчик отыскивает ядро и запускает его. Ядро разворачивает временную файловую систему, монтирует настоящую и передаёт управление первому процессу. Монтированием называется подключение файловой системы в общее дерево каталогов; подробно этот вопрос рассматривается в следующей главе. Каждое звено цепочки передаёт управление следующему и завершается.
Когда система не загружается, диагноз ставится по тому, в каком месте цепочка оборвалась. Экран с ошибкой загрузчика и паника ядра означают разные неисправности, и устраняются они по-разному.
Слайды к главе. Материал главы изложен также в первой части лекции «Как организован Linux» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
1. BIOS (Basic Input/Output System)
BIOS — микропрограмма, хранящаяся на чипе материнской платы (во FLASH-памяти). При включении питания процессор выполняет первую инструкцию по фиксированному адресу 0xFFFFFFF0 (reset vector), где и расположен код BIOS.
Первым делом BIOS проводит самотестирование, называемое POST (Power-On Self-Test): проверяет целостность собственной микропрограммы, инициализирует процессор, установленную память и чипсет, а затем запускает прошивки остальных устройств, видеокарты и сетевой карты. Пока видеокарта не инициализирована, выводить сообщение об ошибке некуда, поэтому о результатах POST сообщает встроенный в плату динамик. Один короткий сигнал означает успех, комбинации длинных и коротких указывают на конкретную неисправность; расшифровка, приведённая в документации к плате, у каждого производителя своя.
2. Загрузчик (Bootloader)
Задача загрузчика — найти, загрузить в оперативную память и передать управление ядру операционной системы.
Схемы загрузки
Схем две, и различаются они возможностями прошивки.
Старую схему составляют BIOS + MBR (Master Boot Record). BIOS способен только прочитать первые 512 байт диска и передать им управление. В них размещаются 446 байт первичного кода загрузчика, 64 байта таблицы разделов (не более четырёх первичных) и два байта сигнатуры 55 AA. Код из MBR отыскивает активный раздел, помеченный особым флагом, и загружает оттуда следующую ступень загрузчика, например GRUB2. Из размера полей в таблице разделов следует и главное ограничение схемы: диски больше 2 ТБ ей недоступны.
Современную схему составляют UEFI + GPT (GUID Partition Table). UEFI читает файловые системы, в первую очередь FAT32, и проверяет цифровую подпись, поставленную на загрузчик (Secure Boot). Размещать код в первых секторах диска не требуется, поскольку прошивка обращается к обычному FAT32-разделу, EFI System Partition, где загрузчики хранятся обычными файлами с расширением .efi наподобие grubx64.efi, а список загрузочных записей хранится в энергонезависимой памяти материнской платы (NVRAM). Таблица разделов GPT ограничений MBR не наследует.
Полезные команды:
- Просмотр UEFI-записей:
efibootmgr -v - Просмотр разделов:
fdisk -l
GRUB2 (Grand Unified Bootloader 2)
Самый распространённый загрузчик в Linux. Он показывает меню, в котором выбирается ядро или другая установленная система, загружает модули для работы с нужным оборудованием и файловыми системами и затем запускает выбранное ядро. Настройки хранятся в /boot/grub/grub.cfg, однако править этот файл вручную бессмысленно. Он собирается заново командой grub-mkconfig из /etc/default/grub и скриптов в /etc/grub.d/, и обновление ядра уничтожит ручную правку.
3. Ядро (Kernel)
Ядро Linux представляет собой сжатый исполняемый файл, расположенный обычно в каталоге /boot под именем vmlinuz-<версия>. Запуск осуществляется в три шага.
- GRUB загружает в оперативную память два файла: сжатый образ ядра и образ initramfs.
- Ядро распаковывается и запускается с параметрами командной строки, переданными загрузчиком (просмотреть их можно в
/proc/cmdline). - Ядро разворачивает в памяти временную корневую файловую систему, называемую initramfs.
Initramfs (Initial RAM File System)
Внутри содержатся драйверы, модули ядра, микрокод процессора и скрипты ранней загрузки, собранные в один архив, то есть всё, без чего до настоящего диска не добраться. Задача initramfs — смонтировать настоящий корень (/) и передать управление процессу init.
Промежуточная ступень необходима из-за замкнутого круга. Ядро должно смонтировать корень, но драйвер нужного контроллера или файловой системы может быть собран отдельным модулем, а модули, вынесенные из ядра, хранятся на этом корне. Замкнутый круг разрывает initramfs, содержащий всё необходимое, чтобы добраться до настоящего диска, даже если тот зашифрован или собран в RAID.
4. Init и systemd
Процесс с PID 1 (init или systemd) является прародителем всего, что работает в системе; ему же достаются осиротевшие процессы. Он запускает службы в правильном порядке, монтирует файловые системы по описанию, заданному в /etc/fstab, и следит за тем, что уже запущено.
systemd — самая распространённая сегодня реализация init. Всё, чем он управляет, описано однотипными объектами, называемыми юнитами (units). Юнитом может быть служба, точка монтирования, сокет или таймер, запускающий задачу по расписанию. Зависимости между ними показывает systemctl list-dependencies default.target, а повседневная работа сводится к двум утилитам: systemctl управляет юнитами, journalctl показывает их журналы.
Задание. Пройти загрузку вручную, от разметки диска до записи в
efibootmgr: «Установка Arch Linux вручную с RAID1 и UEFI».
Файловые системы
Диск выполняет всего две операции — чтение блока байтов по номеру и запись блока байтов по номеру. Ни файлов, ни каталогов, ни прав доступа, ни имён на нём нет; всё это является надстройкой, возводимой сверху файловой системой, которая знает, где что расположено.
Для физика, у которого данные эксперимента измеряются терабайтами, от выбора файловой системы и схемы дисков зависит, переживёт ли архив, собранный за годы, отказ оборудования.
Слайды к главе. Материал главы изложен также во второй части лекции «Как организован Linux» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
1. Немного о дисках
Классический жёсткий диск состоит из пластин, разделённых на дорожки и секторы (обычно по 512 байт или 4 КБ). У SSD пластин нет, но наружу он предоставляет всё тот же интерфейс из пронумерованных секторов одинакового размера. Файловая система этой разницы почти не замечает. Располагается она внутри раздела, описанного в таблице MBR или GPT.
2. Задачи файловой системы
ФС решает несколько задач:
- Индексация и поиск данных (через структуры наподобие inode).
- Управление свободным пространством, то есть учёт блоков, остающихся незанятыми.
- Контроль доступа (права, ACL).
- Оптимизация производительности (кеширование, дефрагментация*).
- Надёжность (журналирование).
*Дефрагментация менее критична для современных ФС (ext4, XFS, btrfs) и SSD.
3. Виды файловых систем
Все файловые системы Linux скрывает за единым интерфейсом, называемым VFS (Virtual File System). Благодаря ему open и read работают одинаково и на локальном ext4, и на сетевом NFS, и на псевдофайлах из /proc, а программе, вызывающей их, не требуется знать, с чем она имеет дело.
FAT (File Allocation Table)
FAT происходит из эпохи дискет; сегодня она применяется для флеш-накопителей, которые должны открываться на любом компьютере, и для EFI-раздела, с которого загружается установленная система.
- Плюсы: простая, читаемая всеми операционными системами.
- Минусы: журналирования нет, а размеры, заложенные в формат, ограничены: в FAT32 файл не больше 4 ГБ, а раздел штатными средствами Windows не отформатировать больше 32 ГБ.
- Происхождение чисел в названии: 12, 16 и 32 обозначают разрядность номера кластера в таблице размещения. Предельный размер тома получается умножением числа кластеров на размер кластера, но самих кластеров несколько меньше, чем даёт разрядность: несколько старших номеров занято служебными метками, зарезервированными под «конец файла» и «сбойный кластер». У FAT12 их 4084, а не 4096. У FAT32 под номер отведено 28 бит из 32, а старшие четыре не используются.
ext4 (Fourth Extended Filesystem)
Если файловая система не выбиралась сознательно, почти наверняка используется ext4: она устанавливается по умолчанию в большинстве дистрибутивов и подходит для расчётного узла общего назначения.
- Стандарт для Ubuntu, Debian и многих других дистрибутивов.
- Журналируемая, то есть повышающая надёжность записью метаданных операций в специальный журнал перед их выполнением.
- Использует экстенты (extents), описывающие непрерывный диапазон блоков, для более эффективного хранения больших файлов (вместо прямых и косвенных блоков).
- Иноды (inodes) хранят метаданные о файле (права, владелец, указатели, ведущие к данным). Их количество ограничено числом, заданным при создании ФС.
XFS
XFS создавалась для больших файлов и параллельного доступа с десятков узлов. Её применяют там, где на диск записываются многогигабайтные наборы наподобие архивов эксперимента и дампов, полученных при моделировании.
- Высокопроизводительная ФС, подходящая для работы с большими файлами.
- Использует B+-tree для индексации.
- Отложенная аллокация, улучшающая производительность.
- Иноды, создаваемые динамически, по мере необходимости.
- Стандарт для Red Hat Enterprise Linux.
btrfs (B-Tree File System)
Btrfs создаёт снимки состояния практически без затрат, что удобно на рабочей машине, где требуется откатываться к состоянию, сохранённому до обновления.
- Современная ФС с продвинутыми функциями.
- Copy-on-Write (CoW): при изменении файла данные записываются в новое место, а не перезаписываются старые. Это и обеспечивает дешёвые снапшоты (snapshots).
- Встроенная поддержка RAID и LVM-подобных функций.
- Субаллокация, обеспечивающая эффективную работу с маленькими файлами.
- Поддержка TRIM, сообщающего SSD об освободившихся блоках.
- Стандарт для openSUSE.
4. Конфигурирование файловой системы
Сильнее всего на скорость дисковых операций влияют кеширование и порядок, в котором накопленные запросы передаются на устройство.
-
Кеширование: прочитанные с диска страницы ядро хранит в page cache, откуда повторное чтение того же файла выполняется уже из памяти. Изменённые, но ещё не записанные на диск страницы называют «грязными» (dirty). Отдельного кеша для них нет: это состояние страниц внутри того же page cache. Сбрасывает их фоновый механизм, работающий по таймеру, а принудительно — вызов
sync. -
Планировщики ввода-вывода: определяют, в каком порядке запросы передаются на диск. Текущий и доступные приведены в
/sys/block/<device>/queue/scheduler. Начиная с ядра 5.0 остались только многоочередные планировщики:noneработает без переупорядочивания, как обычный FIFO. Обычно является лучшим выбором для NVMe-накопителей, которым перестановка запросов ничего не даёт.mq-deadlineследит за сроками выполнения запросов, не позволяя им зависать. Разумное значение по умолчанию для SATA-дисков и SSD.bfq«честно» распределяет полосу между процессами; полезен на настольной системе, где важна отзывчивость.kyberявляется простым планировщиком для быстрых устройств, ограничивающим задержки.
Старые одноочередные планировщики
cfq,deadlineиnoopиз ядра удалены, но их названия ещё встречаются в статьях.
Утилиты для работы с ФС:
mkfs,mke2fsсоздают ФС.tune2fsизменяет параметры ФС ext*.debugfsотлаживает ФС ext*.fsckпроверяет ФС и восстанавливает структуры, повреждённые сбоем.
5. Монтирование
В Linux нет букв дисков: любая файловая система подключается в общее дерево каталогов, растущее из корня, в выбранную точку монтирования наподобие /mnt, /home или /data. Пока раздел не смонтирован, данные на нём недоступны.
- Команды:
mount,umount. - /etc/fstab хранит описания файловых систем, монтируемых при загрузке автоматически.
# Пример строки в /etc/fstab UUID=ed465c6e-949a-41c6-8e8b-c8da348a3577 / ext4 defaults 0 1 - Параметры монтирования:
rw/ro(чтение и запись или только чтение),noatime(не обновлять время последнего доступа, что на архиве, состоящем из миллионов файлов, заметно экономит записи),acl(поддержка списков контроля доступа) и другие. - systemd.mount является альтернативой
fstab, построенной на юнитах systemd.
6. RAID (Redundant Array of Independent Disks)
RAID объединяет несколько физических дисков в один логический массив, видимый системе как обычный диск. Цель — либо пережить отказ диска без потери данных, либо сложить скорости нескольких дисков, работающих одновременно, а в некоторых уровнях и то и другое.
| Уровень | Принцип | Надёжность | Производительность | Ёмкость |
|---|---|---|---|---|
| RAID 0 | Striping (чередование) | Низкая | Высокая (чт/зап) | N |
| RAID 1 | Mirroring (зеркалирование) | Высокая | Высокая (чт) | 1 диск |
| RAID 5 | Чётность | Средняя | Высокая (чт) | N-1 |
| RAID 6 | Двойная чётность | Высокая | Высокая (чт) | N-2 |
| RAID 10 | Зеркалирование + чередование | Высокая | Высокая (чт/зап) | N/2 |
В колонке «Ёмкость» \(N\) обозначает число дисков в массиве (все одинакового размера). У RAID 1, сколько бы дисков ни было собрано в зеркало, полезная ёмкость равна ёмкости одного диска: остальные хранят копии записанного. Поэтому зеркало почти всегда собирают из двух дисков.
RAID резервным копированием не является. Массив защищает от отказа диска, но не от файла, удалённого по ошибке, не от шифровальщика и не от пожара в серверной. Всё перечисленное произойдёт на всех дисках одновременно.
Создание программного RAID в Linux:
Аппаратный контроллер не требуется: массив собирает ядро, а управляет им утилита mdadm.
# Пример создания RAID 1
mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/sdb /dev/sdc
mkfs.ext4 /dev/md0
mount /dev/md0 /mnt/raid
# Сохранение конфигурации
mdadm --detail --scan >> /etc/mdadm.conf   # в Debian/Ubuntu: /etc/mdadm/mdadm.conf
7. LVM (Logical Volume Manager)
LVM вводит между дисками и файловыми системами дополнительный слой, благодаря которому раздел перестаёт быть привязанным к части конкретного диска. Логический том можно увеличить, не переразмечая диск заново, можно собрать том больше любого из имеющихся дисков, а можно создать мгновенный снимок состояния, например перед перезаписью архива.
Понятий три, и они вкладываются друг в друга. Физическим томом (physical volume, PV) называют диск или раздел, отданный под управление LVM. Несколько физических томов объединяются в группу томов (volume group, VG), общий пул пространства всех дисков. Из группы, в свою очередь, выделяются логические тома (logical volume, LV), на которых и создаются файловые системы.
Порядок команд при создании:
pvcreate /dev/sdX1 /dev/sdY1передаёт разделы под управление LVM;vgcreate my_vg /dev/sdX1 /dev/sdY1собирает из этих физических томов группу;lvcreate -n my_vol -L 10G my_vgвыделяет из группы логический том на 10 ГБ;mkfs.ext4 /dev/my_vg/my_volсоздаёт на нём файловую систему.
Заключение
Файловая система выбирается под ожидаемую нагрузку. ext4 остаётся разумным значением по умолчанию, XFS применяют для больших файлов, Btrfs — там, где нужны снимки, откатывающие систему к сохранённому состоянию. Схема дисков продумывается до того, как на них будут записаны данные; переразмечать массив, заполненный терабайтами, значительно дороже, чем заранее потратить полчаса на планирование. Ни RAID, ни снимки не заменяют резервную копию, хранимую в другом месте.
Задание. Собрать зеркало из двух дисков и проверить, что система переживёт отказ любого из них: «Установка Arch Linux вручную с RAID1 и UEFI».
Установка Arch Linux
Сборку системы с нуля удобнее всего рассматривать на примере Arch Linux: мастер установки в нём отсутствует, и все действия, скрытые другими дистрибутивами за полосой прогресса, выполняются вручную.
Установка осуществляется на виртуальную машину в VirtualBox, где ошибки ничего не стоят, а результат воспроизводим. Сначала система собирается в режиме Legacy BIOS, затем рассматривается вариант с зеркальным RAID-массивом, собранным из двух дисков, а в конце машина переключается на UEFI и загрузчик перенастраивается.
Создание виртуальной машины
- В VirtualBox создаётся новая виртуальная машина.
- Вводится имя виртуальной машины, выбирается тип операционной системы Linux и версия Arch Linux (64-bit).
- Выделяется необходимое количество оперативной памяти (рекомендуется не менее 2 ГБ).
- Создаётся новый виртуальный жёсткий диск в формате VDI.
- Выделяется место на диске (рекомендуется не менее 20 ГБ).
- В настройках виртуальной машины выбирается Legacy BIOS (или SeaBIOS).
- Подключается ISO образ Arch Linux.
Установка Arch Linux с использованием Legacy BIOS
Последовательность действий, повторяющаяся у любого дистрибутива, включает разметку диска, создание файловых систем на разделах, их монтирование в нужном порядке, распаковку базовой системы, вход в неё и установку загрузчика.
-
Запустим виртуальную машину и загрузимся с ISO образа Arch Linux.
-
С помощью
cfdiskвыполним разметку диска (/dev/sda). Выберем таблицу разделов GPT и создадим три раздела:/dev/sda1: 1M, тип BIOS boot (кодEF02)/dev/sda2: 1G, тип EFI System (кодEF00), то есть ESP/dev/sda3: остальное пространство для корневой файловой системы
Первый раздел выглядит лишним, однако является обязательным. На диске с MBR GRUB размещает свою вторую ступень в промежутке, оставленном после загрузочной записи, а на GPT такого промежутка нет, и
grub-install --target=i386-pcоткажется работать с сообщением «embedding is not possible». В раздел BIOS boot GRUB и записывает вторую ступень; файловая система на нём не создаётся, он остаётся неразмеченным.Второй раздел на этом этапе не потребуется: при загрузке через BIOS прошивка не имеет представления об ESP. Он заведён на будущее: в конце главы эта машина будет переключена на UEFI, и переразмечать диск не придётся.
-
Создадим файловую систему на ESP разделе.
mkfs.fat -F32 /dev/sda2 -
Создадим файловую систему на корневом разделе.
mkfs.ext4 /dev/sda3 -
Смонтируем корневую файловую систему.
mount /dev/sda3 /mnt -
Создадим точку монтирования и смонтируем ESP.
mkdir /mnt/boot mount /dev/sda2 /mnt/boot -
Установим базовую систему.
pacstrap /mnt base linux linux-firmware -
Сгенерируем файл fstab.
genfstab -U /mnt >> /mnt/etc/fstab -
Перейдём в новую систему. Команда
arch-chrootподменяет корень файловой системы на/mnt, после чего все команды выполняются так, как если бы загрузка уже была произведена в устанавливаемую систему. Механика подмены корня рассматривается в главе про внутреннее устройство Linux.arch-chroot /mnt -
Установим загрузчик GRUB.
pacman -S grub grub-install --target=i386-pc /dev/sda grub-mkconfig -o /boot/grub/grub.cfg -
Установим пароль root.
passwd -
Выйдем из chroot-окружения и размонтируем файловые системы.
exit
umount -R /mnt
reboot
Установка Arch Linux на RAID1
Последовательность та же, но на зеркале из двух дисков. Отличий два: массив необходимо собрать до создания файловой системы, а initramfs — научить этот массив находить, иначе при первой же загрузке система не найдёт корень.
-
Добавим виртуальной машине второй диск такого же размера и загрузимся с установочного образа Arch Linux.
-
Подготовим диски.
cfdisk /dev/sda
cfdisk /dev/sdb
На каждом диске выберем таблицу GPT и создадим два раздела:
/dev/sda1размером 1M с типом BIOS boot (EF02) и/dev/sda2на всё остальное с типом Linux RAID (FD00); то же самое на/dev/sdb. Раздел BIOS boot необходим по той же причине, что и в предыдущем разделе, причём на обоих дисках, иначе после отказа первого диска машина со второго не загрузится. -
Создадим RAID1 массив.
mdadm --create --verbose /dev/md0 --level=1 --raid-devices=2 /dev/sda2 /dev/sdb2 -
Отформатируем RAID-массив.
mkfs.ext4 /dev/md0 -
Смонтируем файловую систему.
mount /dev/md0 /mnt -
Установим базовую систему.
pacstrap /mnt base linux linux-firmware mdadm -
Сгенерируем fstab.
genfstab -U /mnt >> /mnt/etc/fstab -
Выполним chroot в новую систему.
arch-chroot /mnt -
Настроим mdadm.
mdadm --detail --scan >> /etc/mdadm.conf -
Настроим mkinitcpio:
В файле
/etc/mkinitcpio.confнеобходимо добавитьmdadm_udevв списокHOOKS, обязательно раньшеfilesystems, иначе к моменту монтирования корня массив ещё не будет собран.HOOKS=(base udev autodetect modconf block mdadm_udev filesystems keyboard fsck) -
Пересоберём начальный RAM-диск.
mkinitcpio -P -
Установим GRUB.
pacman -S grub -
Установим GRUB на оба диска.
grub-install --target=i386-pc /dev/sda grub-install --target=i386-pc /dev/sdb -
Создадим конфигурацию GRUB.
grub-mkconfig -o /boot/grub/grub.cfg -
Перезагрузим систему.
exit
umount -R /mnt
reboot
Работоспособность зеркала проверяется сразу: выключить машину, отсоединить один диск, убедиться, что система загружается, затем вернуть его на место и повторить проверку со вторым диском.
Переключение на UEFI и настройка загрузчика
Вернёмся к машине из первой установки, размеченной на sda1, sda2 и sda3: EFI-раздел там уже заведён. Зеркало из предыдущего раздела для этого шага не подходит, поскольку ESP в нём отсутствует; связка RAID1 с UEFI собирается самостоятельно в задании.
Переустанавливать систему не потребуется: UEFI отличается от BIOS только тем, где расположен загрузчик и как прошивка его находит, поэтому достаточно разместить .efi-файл на EFI-разделе и зарегистрировать запись в NVRAM.
-
Остановим виртуальную машину.
-
В настройках виртуальной машины изменим BIOS на UEFI.
-
Запустим виртуальную машину и загрузимся с ISO образа Arch Linux.
-
Смонтируем корневую файловую систему и ESP.
mount /dev/sda3 /mnt mount /dev/sda2 /mnt/boot arch-chroot /mnt -
Установим пакеты, необходимые для загрузки с UEFI.
pacman -S grub efibootmgr dosfstools os-prober mtools -
Установим загрузчик GRUB с поддержкой UEFI.
grub-install --target=x86_64-efi --efi-directory=/boot --bootloader-id=GRUB
grub-mkconfig -o /boot/grub/grub.cfg
efibootmgr -v
В выводе efibootmgr -v должна появиться запись GRUB. Если она отсутствует, необходимо убедиться, что раздел с .efi-файлом смонтирован в /boot и отформатирован в FAT32.
Задание. Установка повторяется самостоятельно, но с зеркалированием диска и загрузкой через UEFI: «Установка Arch Linux вручную с RAID1 и UEFI».
Внутреннее устройство Linux
Без понимания того, что происходит внутри системы, первый же зависший расчёт или необъяснимо медленный ввод-вывод превращается в гадание.
Слайды к главе. Материал главы изложен также в лекции «Внутренности Linux» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Значение внутреннего устройства
Знание внутреннего устройства необходимо в четырёх ситуациях. Когда расчёт завис или исчерпал всю память, требуется ставить диагноз, а не перезапускать наугад. Если программа работает медленнее ожидаемого, необходимо знать, куда смотреть. При написании кода полезно представлять, во что обходится каждый системный вызов, сделанный в цикле. Наконец, вся современная облачная инфраструктура выросла из механизмов ядра Linux, поэтому без них разобраться в ней невозможно.
Облаком называют чужие компьютеры, расположенные в другом месте. Те же процессы, та же память, та же сеть, только в удалённом дата-центре и с чужим счётом за электричество.
Практическая ценность глубоких знаний
Быстрая диагностика проблем
Когда программа ведёт себя странно, вопрос состоит не в том, «что делать», а в том, «что спросить у системы»: чем процесс сейчас занят, куда уходит его время и в каком состоянии он застрял.
# Вместо случайного тыкания
strace -p <pid>                    # что делает процесс?
perf record -g <command>          # где тратится время?
cat /proc/<pid>/status            # в каком состоянии?
Служба периодически «зависала» на несколько минут и восстанавливалась сама; в top при этом не наблюдалось ни загрузки процессора, ни повышенного расхода памяти. Разгадка заключалась в состоянии процесса: ps показывал D, непрерываемое ожидание ввода-вывода. Служба писала на сетевой диск NFS, тот время от времени переставал отвечать, и процесс, пробуждаемый лишь ответом, ждал. Проблема устранялась не в коде, а тайм-аутами монтирования и числом попыток, разрешённых на повтор.
Эффективное программирование
Пока нет представления о цене обращения к ядру, оптимизировать нечего. Порядки величин следующие:
- системный вызов стоит около тысячи тактов процессора;
- переключение контекста, происходящее между процессами, стоит от тысячи до десяти тысяч тактов;
- промах по странице памяти занимает доли микросекунды, если страница уже загружена в память, и от сотен микросекунд на NVMe до единиц миллисекунд на диске, если её приходится читать.
Обращаться к ядру в тесном цикле нецелесообразно: данные накапливаются в буфере и передаются разом. Разница между write на каждое число и write на мегабайтный буфер измеряется порядками.
Облачные технологии
Контейнеры, оркестраторы, бессерверные вычисления представляют собой надстройки над механизмами ядра, которым посвящена глава. Docker использует те же cgroups и пространства имён, только удобно упакованные. Kubernetes управляет ими же, но в масштабе кластера из сотен машин, работающего годами. AWS Lambda — та же изоляция, доведённая до очень быстрого запуска.
1. Процессы
Детальное понимание процессов
Процесс как учётная единица
Привычное определение процесса как запущенной программы верно и бесполезно. Полезнее считать процесс учётной единицей, на которую ядро записывает всё, чем программа владеет, и всё, что о ней знает.
Процесс владеет четырьмя вещами: собственным виртуальным адресным пространством, набором открытых файловых дескрипторов, учётными данными и привилегиями (от чьего имени он работает) и маской сигналов вместе с обработчиками, назначенными на них. Этот набор ядро освобождает при завершении процесса, поэтому дескриптор, оставленный незакрытым, существует столько же, сколько сам процесс.
Ядро знает о процессе следующее: идентификаторы самого процесса и его родителя (PID и PPID), от какого пользователя и группы он запущен (UID и GID), с каким приоритетом его планировать, в каком состоянии он сейчас находится и сколько ресурсов уже израсходовано. Всё это расположено в файловой системе /proc, открытой для чтения.
Структура процесса в ядре
// Упрощенная task_struct (include/linux/sched.h)
struct task_struct {
    volatile long state;                    // состояние процесса
    void *stack;                           // указатель на стек
    struct mm_struct *mm;                  // память процесса
    struct files_struct *files;            // открытые файлы
    struct signal_struct *signal;          // сигналы
    // ... сотни полей
};
Всё перечисленное ядро предоставляет наружу через файловую систему /proc, позволяющую исследовать любой работающий процесс:
# Анализ конкретного процесса
ls -la /proc/1234/
cat /proc/1234/maps    # память процесса
cat /proc/1234/status  # состояние и лимиты
ls /proc/1234/fd/      # открытые файлы
Создание процессов: fork() и exec()
Механизм Copy-on-Write (CoW)
Системный вызов fork(), создающий копию текущего процесса, в наивной реализации копировал всю память родителя. Для расчёта, занявшего десять гигабайт, это означало те же десять гигабайт, скопированных впустую, притом что сразу после fork() дочерний процесс обычно вызывает exec() и вся скопированная память немедленно уничтожается.
Отсюда copy-on-write, копирование при записи. При fork() память не копируется. Страницы помечаются как доступные только для чтения, и оба процесса читают их из одного и того же физического места. Настоящая копия создаётся лениво, в тот момент, когда один из двух процессов пытается в страницу записать, и только для затронутой страницы. В типичном случае «породить процесс и сразу запустить в нём другую программу» копировать почти ничего не приходится.
pid_t pid = fork();
if (pid == 0) {
    // Дочерний процесс
    // Страницы памяти разделяются до первой записи
    execve("/bin/ls", args, env);
} else {
    // Родительский процесс
    waitpid(pid, &status, 0);
}
Потоки и процессы
Архитектурные различия
| Аспект | Процесс | Поток |
|---|---|---|
| Память | Изолированная | Разделяемая |
| Файлы | Отдельные таблицы | Общая таблица |
| Стоимость создания | Высокая | Низкая |
| Изоляция | Полная | Минимальная |
Практические сценарии использования
Выбор определяется тем, что для задачи важнее: изоляция, защищающая от чужих ошибок, или общая память.
Процессы применяются, когда падение одной части работы не должно приводить к падению остальных. Память у них раздельная, поэтому обработчик, завершившийся из-за собственной ошибки, уносит с собой только себя. По той же причине процессы необходимы, если части программы работают от разных пользователей и с правами, выданными по отдельности. Если расчёт предстоит распределить по нескольким машинам, выбора нет: потоки, существующие в общем адресном пространстве, за пределы одной машины не выходят.
Потоки применяются, когда частям работы требуется общее состояние, будь то разделяемый кеш, пул соединений или общий массив с данными. Обмен между ними не требует ни сериализации, ни копирования, задержка оказывается на порядки меньше, а кеш процессора, прогретый одним потоком, работает на всех сразу. Платой является необходимость самостоятельно следить за одновременным доступом к общим данным. В Python добавляется глобальная блокировка интерпретатора, которая рассматривается в главе про многопоточность.
Межпроцессное взаимодействие (IPC)
Сигналы как асинхронные уведомления
// Отправка сигнала
kill(pid, SIGTERM);

// Обработка сигнала
void handler(int sig) {
    // Асинхронно! Осторожно с shared state
}
signal(SIGTERM, handler);
Обработчик прерывает выполнение программы в произвольной точке, поэтому вызывать из него разрешено далеко не всё. Если сигнал придёт в середине malloc, повторный malloc из обработчика застанет кучу в противоречивом состоянии и окончательно её повредит. Безопасным является только список функций, оговорённый стандартом. Их называют async-signal-safe, и printf в него не входит. Обычная практика состоит в том, чтобы выставить в обработчике флаг и сразу вернуться, а содержательную работу выполнить в основном цикле программы.
SIGHUP получают процессы, привязанные к терминалу, когда сессия закрывается, и по умолчанию он их завершает. Поэтому долгий расчёт, запущенный по ssh, завершается вместе с разорванным соединением. Пережить закрытие сессии процесс может, если его отвязать от терминала: для этого служат nohup, setsid и встроенная в оболочку команда disown, а также screen и tmux из главы про инструменты Linux.
Каналы как односторонняя связь
# Неименованные каналы
ls -la | grep ".txt" | wc -l

# Именованные каналы (FIFO)
mkfifo mypipe
echo "data" > mypipe &
cat mypipe
Канал представляет собой буфер, выделенный в памяти ядра, по умолчанию около 64 КБ. Пока в буфере остаётся место, пишущая сторона не задерживается; когда буфер заполнен, write блокируется, пока читающая сторона не заберёт накопленное. Так работает конвейер команда | команда. Быстрый производитель, ограниченный медленным потребителем, сам замедляется до его скорости, и никакой явной синхронизации писать не приходится.
Разделяемая память и максимальная производительность
// Создание shared memory
int shm_id = shmget(key, size, IPC_CREAT | 0666);
void *ptr = shmat(shm_id, NULL, 0);

// Использование
memcpy(ptr, data, data_size);
Разделяемая память остаётся самым быстрым способом обмена, поскольку обмена как такового не происходит. Оба процесса работают с одними и теми же физическими страницами, отображёнными к ним обоим, записанные данные никуда не копируются, задержка сводится к обычному обращению в память. Для передачи больших массивов наподобие кадров, снятых с детектора, альтернативы практически нет.
Платой является то, что ядро больше ничем не помогает. Канал упорядочивает данные, а разделяемая память не гарантирует ничего. Один процесс пишет, другой в это же время читает, и на выходе получается смесь из недописанных значений. Синхронизацию (семафоры, блокировки, барьеры) приходится строить самостоятельно, и гонки, проявляющиеся раз в неделю, являются здесь самой обычной ошибкой.
Семафоры и координация доступа
// Бинарный семафор (мьютекс)
sem_wait(&mutex);
// Критическая секция
sem_post(&mutex);
На практике достаточно двух видов семафоров. Двоичный принимает значения 0 и 1 и работает как мьютекс, защищающий критическую секцию. Считающий хранит целое число и ограничивает число пользователей, одновременно допущенных к ресурсу; например, разрешает читать общий файл не более чем четырём потокам сразу.
Состояния процессов: полный цикл жизни
Детали каждого состояния
Основные буквы состояния в выводе ps:
R (running / runnable) означает, что процесс либо выполняется в настоящий момент, либо стоит в очереди планировщика и готов выполняться. Ограничивает его только доступность процессорного времени. Если расчёт долго находится в R, он считает.
S (interruptible sleep) означает, что процесс чего-то ожидает: завершения ввода-вывода, семафора, сигнала. Такое ожидание прерывается сигналом, то есть процесс, находящийся в нём, нормально завершается по kill. Для программ, больше ожидающих, чем считающих, S является обычным рабочим состоянием.
D (uninterruptible sleep) описывает ожидание внутри ядра, которое нельзя прервать: чаще всего ввода-вывода блочного устройства или сетевой файловой системы, реже — некоторых блокировок ядра; ожидание данных из сетевого сокета, напротив, относится к состоянию S. Оно не прерывается сигналом, включая kill -9. С ним сталкиваются, когда процесс «завис намертво» и не завершается ничем; чаще всего причиной является отказавший сетевой диск, смонтированный по NFS. Разбираться в таком случае приходится с устройством.
T (stopped) показывает, что процесс приостановлен сигналом SIGSTOP или SIGTSTP и продолжится по SIGCONT. Так работает нажатие Ctrl+Z в оболочке, и так же останавливают процесс отладчики, устанавливающие точку останова.
Z (zombie) означает, что процесс уже завершился, но родитель не забрал его код возврата. Ресурсы освобождены, осталась одна запись в таблице процессов ради кода возврата. Завершить зомби нельзя, он и так завершён; запись исчезнет, когда родитель вызовет wait, а если родитель этого не делает, то после его завершения. Осиротевших зомби забирает процесс init.
Практический мониторинг
Сводку по состояниям всех процессов система выдаёт одной строкой; с неё удобно начинать разбор: она сразу показывает, есть ли в системе процессы, застрявшие в D, или накопившиеся зомби.
# Понимание состояния процессов
ps aux | awk '{print $8}' | sort | uniq -c

# Поиск проблемных процессов
# Процессы в D состоянии
ps aux | awk '$8=="D" {print $0}'

# Zombie процессы
ps aux | awk '$8=="Z" {print $0}'
2. Планировщик
Эволюция планировщиков Linux
Задача планировщика состоит в том, чтобы на каждом переключении решить, какому из готовых процессов отдать процессор. Способ решения за тридцать лет менялся трижды, и всякий раз причиной была практика, достигшая предела возможностей.
O(N) планировщик (по 2.4 включительно)
// Псевдокод старого планировщика
for (each task in system) {
    calculate_goodness(task);
    if (goodness > max_goodness) {
        next_task = task;
        max_goodness = goodness;
    }
}
Первый планировщик при каждом переключении перебирал все процессы в системе и выбирал лучший по баллу. Пока процессов десятки, это незаметно, но на тысяче процессов сам выбор начинает занимать заметное время, а на многоядерной машине все ядра, кроме того, конкурируют за одну общую очередь.
O(1) планировщик (2.6.0–2.6.22)
Следующий планировщик устранил сплошной перебор. Процессы были разложены по очередям приоритетов, а сами очереди помечены битовой маской, благодаря которой поиск самого приоритетного непустого уровня стал делом одной инструкции. Отработавшие свой квант процессы складывались во вторую очередь, и когда первая пустела, очереди менялись местами. Время выбора перестало зависеть от числа процессов, а у каждого ядра появилась собственная очередь, и с этого момента Linux стал полноценно работать на многопроцессорных системах.
CFS (Completely Fair Scheduler) (2.6.23+)
// Основан на красно-чёрных деревьях
struct rb_root_cached {
    struct rb_root rb_root;
    struct rb_node *rb_leftmost;
};
Действующий сегодня планировщик (точнее, его прямой потомок) устроен иначе. Он не раздаёт кванты по приоритетам, а ведёт для каждого процесса счётчик, накапливающий уже полученное процессорное время, и всегда запускает тот процесс, которому досталось меньше всех. Все готовые процессы хранятся в красно-чёрном дереве, отсортированные по этому счётчику, и выбор следующего сводится к взятию самого левого узла.
Приоритеты и политики планирования
Политики реального времени
Для задач, где важна не общая пропускная способность, а гарантированное время реакции (управление установкой, сбор данных с жёстким тактом), в ядре предусмотрены две политики реального времени.
SCHED_FIFO не выделяет процессу квант времени вовсе. Получив процессор, процесс удерживает его, пока сам не отдаст или пока его не вытеснит процесс, обладающий более высоким приоритетом реального времени. Отсюда следует опасность: зациклившаяся программа с этой политикой занимает ядро навсегда, и обычные процессы, включая запущенную пользователем оболочку, до него уже не доберутся.
SCHED_RR отличается тем, что квант всё же существует, по умолчанию 100 мс. Процессы одинакового приоритета, стоящие в очереди, сменяют друг друга по кругу, поэтому один зациклившийся процесс не блокирует остальные. Эта политика безопаснее, и начинать лучше с неё.
Обычные политики
Всё остальное, а это практически все процессы, включая пользовательский расчёт, работает под политикой SCHED_NORMAL (она же SCHED_OTHER). Жёстких гарантий она не даёт, но и никого не лишает процессорного времени полностью. Приоритет плавающий, планировщик корректирует его сам. Процессу, который много спит в ожидании ввода, например реагирует на нажатия клавиш, достаётся небольшая прибавка, удерживающая систему отзывчивой. Процессу, который непрерывно считает, долю слегка урезают: своё он доберёт, пока остальные ждут.
Значения nice и приоритеты
# Установка nice значения
nice -n 10 ./long_running_task    # низкий приоритет
nice -n -20 ./critical_task       # высокий приоритет

# Изменение running процесса
renice -n 5 -p 1234
Шкала nice идёт от -20 до +19. Чем больше значение, тем ниже приоритет: процесс «вежливее» и охотнее уступает. Понижать себе приоритет может любой пользователь, а повышать, то есть уходить в отрицательные значения, разрешено только root.
CFS: внутреннее устройство
Ключевые концепции
Поведение планировщика определяется несколькими величинами.
Виртуальное время выполнения (vruntime) — счётчик, растущий у каждого процесса, пока тот занимает процессор. Скорость роста зависит от приоритета: у высокоприоритетного медленнее, у низкоприоритетного быстрее. Планировщик всегда выбирает процесс с наименьшим vruntime: «справедливым» считается тот, кому досталось меньше всех. Значение nice влияет на скорость накопления этого счётчика.
Целевой задержкой (target latency) называют срок, за который каждый готовый к выполнению процесс должен успеть получить процессор хотя бы раз. По умолчанию это 6 мс, умноженные на поправку по числу процессоров: единица плюс двоичный логарифм их числа, причём учитываются не более восьми. Получается от 6 мс на одном ядре до 24 мс на восьми и более. За отзывчивость интерфейса платят более частыми переключениями.
Минимальный квант (minimal granularity) задаёт нижнюю границу доли процесса. Готовых процессов бывает очень много, и честное деление целевой задержки на всех дало бы каждому доли микросекунды: система занималась бы одними переключениями. Поэтому квант не делают короче 0,75 мс с той же поправкой по числу процессоров, слегка нарушая справедливость.
Реализация на красно-чёрных деревьях
// Вставка процесса в дерево
struct sched_entity {
    struct rb_node run_node;
    u64 vruntime;
    // ...
};

// Быстрый поиск процесса с минимальным vruntime
struct task_struct *pick_next_task(struct rq *rq) {
    struct rb_node *left = rb_first_cached(&rq->tasks_timeline);
    return rb_entry(left, struct task_struct, se.run_node);
}
Вставка и удаление обходятся в O(log N), а процесс с наименьшим vruntime всегда находится в самом левом узле, причём указатель на него ядро хранит отдельно и обновляет по ходу работы, поэтому самая частая операция планировщика, выбор следующего процесса, выполняется за постоянное время.
Управление планировщиком на практике
Привязка к ядрам
# Привязка процесса к конкретным ядрам
taskset -c 0,1 ./application

# Просмотр текущей маски
taskset -p 1234

# Запуск с распределением по ядрам
numactl --cpunodebind=0,1 --membind=0,1 ./app
Критичный процесс, например управляющий установкой, изолируют на выделенных ядрах, чтобы остальная система ему не мешала. Долгий расчёт привязывают к одному ядру ради прогретого кеша: мигрируя между ядрами, процесс каждый раз начинает с холодного кеша и теряет на этом больше, чем выигрывает от свободного ядра. На многосокетных серверах привязку используют вместе с NUMA, чтобы процесс работал с той памятью, которая физически подключена к его сокету.
Настройка планировщика
Параметры планировщика доступны для просмотра и изменения через файловую систему, но за последние годы они переезжали дважды, поэтому путь зависит от версии ядра. Без измерений изменять их не рекомендуется: значения по умолчанию разумны, и проблема почти никогда не заключается в них.
На ядрах до 5.13 параметры располагались в /proc/sys/kernel/:
cat /proc/sys/kernel/sched_min_granularity_ns
cat /proc/sys/kernel/sched_latency_ns
echo 10000000 > /proc/sys/kernel/sched_latency_ns
В 5.13 они были вынесены из sysctl в отладочную файловую систему с сохранением прежних
имён. Такой вариант ещё встречается на завершающих поддержку LTS наподобие Ubuntu 22.04
с исходным ядром 5.15:
cat /sys/kernel/debug/sched/min_granularity_ns
cat /sys/kernel/debug/sched/latency_ns
С 6.6 CFS заменён на EEVDF, и параметры, названные под старый планировщик,
исчезли вместе с ним. С этим случаем столкнётся большинство читателей: в Ubuntu 24.04
установлено ядро 6.8, в Debian 13 — 6.12, оба с EEVDF, и старых имён
в отладочной файловой системе там нет. Ближайший по смыслу параметр называется base_slice_ns:
cat /sys/kernel/debug/sched/base_slice_ns
Какой из трёх случаев имеет место, показывает uname -r.
Мониторинг планировщика
При подозрении, что процесс не получает процессорного времени, лучше обращаться не к top, а к статистике планировщика. Там видно, сколько раз процесс вытесняли и сколько он в сумме простоял в очереди.
# Статистика переключений
cat /proc/1234/sched

# Очереди выполнения
cat /proc/sched_debug

# Профилирование
perf sched record ./application
perf sched latency
3. Прерывания
Архитектура прерываний в x86/x64
Аппаратные прерывания
Прерыванием устройство сообщает процессору о готовности и требует обработки. Источников в обычной машине немного: системные таймеры, сетевые карты, дисковые контроллеры и устройства, подключённые к шине USB. В лаборатории к ним добавляется всё, что установлено в крейте: АЦП, счётчики, генераторы задержек.
Драйвер регистрирует обработчик на номер прерывания, и ядро вызывает его каждый раз, когда устройство подаёт сигнал:
// Регистрация обработчика
request_irq(IRQ_NUMBER, handler, flags, name, dev);

// Обработчик прерывания
static irqreturn_t my_handler(int irq, void *dev_id) {
    // Быстрая обработка
    return IRQ_HANDLED;
}
Исключения процессора
Процессор прерывает и сам себя, встретив ситуацию, с которой не справляется в одиночку. Такие события делятся на три вида по тому, чем они заканчиваются. Отказ (fault) исправим: типичный пример — обращение к странице, отсутствующей в физической памяти; ядро подгружает её и повторяет ту же инструкцию. Ловушка (trap) вызывается намеренно, так работают точки останова в отладчике, и выполнение продолжается со следующей инструкции. Авария (abort) не исправляется: состояние потеряно безвозвратно.
Обработка прерываний: верхняя и нижняя половины
Верхняя половина
Пока выполняется обработчик прерывания, на этом ядре запрещены все прерывания (так с версии 2.6.35, прежде — только того же типа), а планировщик, распределяющий процессорное время, не работает вовсе. Обработчик обязан уложиться в микросекунды: подтвердить устройству получение, забрать данные из регистров, поставить остальное в очередь, разбираемую позже, и вернуться. Ничего блокирующего внутри быть не может: засыпает процесс, а обработчик выполняется вне какого-либо процесса.
// Типичный upper half
irqreturn_t eth_interrupt(int irq, void *dev_id) {
    struct net_device *dev = dev_id;
    disable_irq_nosync(dev->irq);
    schedule_work(&dev->tx_work);
    return IRQ_HANDLED;
}
Нижняя половина
Содержательную работу обработчик откладывает в нижнюю половину. Способов отложить три, и различаются они тем, насколько поздно и в каком контексте выполнится отложенное.
SoftIRQ — самый быстрый механизм, но встроенный в ядро статически. Набор мягких прерываний фиксирован (сеть, блочные устройства), и добавить собственное невозможно. Tasklet создаётся динамически и потому подходит для драйверов, написанных под собственное оборудование, но один и тот же tasklet никогда не выполняется на двух ядрах одновременно, что упрощает разработку и ограничивает масштабирование. Очередь работ (work queue) выполняется в контексте обычного процесса ядра, поэтому ей разрешено засыпать и выполнять блокирующие вызовы. За это платят задержкой, и очереди применяют для длительной работы.
// Work queue пример
DECLARE_WORK(my_work, my_work_function);

void my_work_function(struct work_struct *work) {
    // Медленная обработка
    process_packets();
    enable_irq(dev->irq);
}
Практическая работа с прерываниями
Мониторинг прерываний
# Статистика прерываний
cat /proc/interrupts

# Распределение прерываний по CPU
cat /proc/irq/*/smp_affinity

# Изменение привязки прерываний
echo 2 > /proc/irq/24/smp_affinity
Оптимизация обработки
Когда прерываний становится слишком много (на быстрой сетевой карте или скоростном АЦП их десятки тысяч в секунду), обработку настраивают.
Прерывания распределяют между ядрами процессора. По умолчанию все они могут поступать на нулевое ядро, которое перегружается, пока остальные простаивают. Вместо устаревшего механизма прерываний по выделенной линии используют MSI, где устройство сообщает о событии записью в память; это снимает ограничение на число линий и упрощает распределение. Для сетевых карт подбирают длину очередей: слишком короткая теряет пакеты на всплесках, слишком длинная увеличивает задержку. Включают объединение прерываний (coalescing): устройству разрешают накопить несколько событий и сообщить о накопленном разом, при этом число прерываний падает в разы ценой небольшой задержки.
4. Системные вызовы
Механизм системных вызовов
Переключение между пространствами
Программа не может обратиться к диску или сети напрямую. Всё, связанное с оборудованием, выполняет ядро, а программа запрашивает это системным вызовом. На уровне процессора запрос выглядит следующим образом: номер нужной операции и её аргументы раскладываются по регистрам, после чего выполняется одна специальная инструкция, переводящая процессор в режим ядра.
Пользовательское пространство → Пространство ядра:
; x86-64 системный вызов
mov rax, 1      ; номер syscall (write)
mov rdi, 1      ; fd (stdout)
mov rsi, buffer ; буфер
mov rdx, count  ; размер
syscall         ; переход в ядро
За инструкцией syscall стоят шесть шагов. Процессор сохраняет контекст пользовательского кода, то есть регистры и указатель, хранящий адрес инструкции, и переходит в режим ядра. Ядро проверяет переданные параметры, поскольку доверять пользовательской программе нельзя; адрес буфера может указывать куда угодно. Затем выполняется собственно операция, результат записывается туда, где его ожидает программа, и сохранённый контекст восстанавливается.
Отсюда следует стоимость системного вызова: сама операция может быть тривиальной, а сохранение, проверка и восстановление выполняются в любом случае.
Таблица системных вызовов
// Определение syscall (fs/read_write.c)
SYSCALL_DEFINE3(write, unsigned int, fd, const char __user *, buf,
                size_t, count)
{
    struct fd f = fdget_pos(fd);
    // ... обработка
    return ret;
}
Дескриптор, полученный от программы, напрямую не используется, а сначала преобразуется в проверенный объект ядра. Так устроен любой системный вызов: ни одному числу из пользовательского пространства ядро не доверяет.
Безопасность системных вызовов
Проверки доступа
Ядро проверяет две вещи: переданный указатель принадлежит адресному пространству вызывающего процесса, а не чужой или ядерной памяти, и у процесса есть право на запрошенную операцию.
// Проверка указателей из userspace
if (copy_from_user(kernel_buf, user_buf, size))
    return -EFAULT;

// Проверка прав доступа
if (!file_permission(file, MAY_READ))
    return -EPERM;
Права по возможностям (capabilities)
Исторически права проверялись просто: root (UID 0) может всё, остальные почти ничего. Программе, которой требуется одна привилегия, например открыть сетевой сокет на порту ниже 1024, приходилось выдавать полномочия root целиком. Современное ядро дробит права root на несколько десятков отдельных возможностей (capabilities) и проверяет конкретную из них.
// Вместо проверки UID == 0
if (!capable(CAP_SYS_ADMIN))
    return -EPERM;
Производительность системных вызовов
Измерение стоимости
#include <sys/time.h>

struct timeval start, end;
gettimeofday(&start, NULL);
// системный вызов
gettimeofday(&end, NULL);

long microseconds = (end.tv_sec - start.tv_sec) * 1000000
                  + (end.tv_usec - start.tv_usec);
Порядки величин необходимо помнить. Простой системный вызов наподобие getpid обходится в 0.1–1 микросекунду. Вызовы с вводом-выводом занимают от микросекунды до миллисекунды; разброс зависит от того, попал ли запрос в кеш или был направлен на диск. Переключение контекста между процессами стоит 1–10 микросекунд.
Обычное обращение в оперативную память занимает около сотни наносекунд. Отсюда следует правило: в тесном цикле системным вызовам не место; один write на каждое число превратит расчёт в сплошное ожидание.
Оптимизация
Оптимизация сводится к тому, чтобы выполнять системные вызовы реже.
Вызовы объединяют, заменяя десять write подряд одним writev, принимающим сразу список буферов. Файл отображают в память через mmap и далее работают с ним как с обычным массивом, без read и write; для больших файлов данных это является лучшим вариантом. Лишние вызовы устраняют: типичный случай — проверка существования файла перед открытием, хотя открытие и так вернёт ошибку. Для нескольких самых частых вызовов наподобие gettimeofday в Linux предусмотрен vDSO — фрагмент кода ядра, отображённый в память процесса, благодаря чему переключаться в режим ядра не приходится.
5. Память процесса
Виртуальная память: полная картина
Карта адресного пространства
Каждый процесс видит собственное адресное пространство и считает, что вся память принадлежит ему одному. Разложено оно всегда примерно одинаково: код в младших адресах, за ним инициализированные и неинициализированные данные, далее в сторону старших адресов растёт куча, навстречу ей — стек, между ними расположена область под библиотеки и разделяемую память, а старшие адреса отданы ядру. На схеме ниже адреса растут сверху вниз, поэтому стрелка кучи направлена вниз, а стрелка стека — вверх.
0x0000000000000000 ┌──────────────────────┐
                   │   Зарезервировано    │
                   │   (NULL-ptr guard)   │
0x0000000000400000 ├──────────────────────┤
                   │         Text         │
                   │   (код программы)    │
0x0000000000600000 ├──────────────────────┤
                   │         Data         │
                   │        (init)        │
0x0000000000601000 ├──────────────────────┤
                   │         BSS          │
                   │       (uninit)       │
0x0000000000800000 ├──────────────────────┤
                   │         Heap         │
                   │    (динамическая)    │
                   │          ↓           │
0x00007ffff0000000 ├──────────────────────┤
                   │     MMAP region      │
                   │     (библиотеки,     │
                   │     shared mem)      │
0x00007ffff7a00000 ├──────────────────────┤
                   │        Stack         │
                   │   (автоматические)   │
                   │          ↑           │
0x00007fffffffffff ├──────────────────────┤
                   │    неканоническая    │
                   │         дыра         │
0xffff800000000000 ├──────────────────────┤
                   │     Kernel space     │
                   │     (недоступно)     │
0xffffffffffffffff └──────────────────────┘
Управление памятью на практике
Анализ памяти процесса
Разбираться, куда ушла память процесса, приходится регулярно, обычно после того, как расчёт исчерпал всю память и был завершён системой. Три команды закрывают почти все вопросы: что отображено в адресное пространство, сколько из этого занято в действительности и как часто процесс промахивается мимо памяти.
# Детальная информация о памяти
pmap -XX 1234

# Статистика памяти
cat /proc/1234/smaps

# Page faults
ps -o min_flt,maj_flt,cmd -p 1234
Виды промахов по странице
Промахи по страницам бывают двух видов, и различаются они на три порядка по стоимости.
Малый промах (minor fault) происходит, когда нужная страница уже находится в физической памяти, но пока не прописана в таблицах страниц процесса, например разделяется с соседним процессом, читающим то же самое, или только что выделена. Ядру достаточно обновить таблицы, и обходится это дёшево.
Большой промах (major fault) означает, что страницы в памяти нет и её необходимо читать с диска. Это миллисекунды вместо микросекунд. Если ps или top показывают, что расчёт набирает большие промахи тысячами, значит, ему не хватает выделенной памяти и система перешла в подкачку. Оптимизировать код в этот момент бессмысленно, необходимо разбираться с памятью.
Проблемы с памятью и решения
Нехватка памяти и OOM killer
Когда память в системе заканчивается и освободить её больше нечем, ядро не возвращает ошибку, а выбирает жертву и завершает её. OOM killer работает в три шага. Ядро фиксирует нехватку памяти, начисляет каждому процессу «балл вредности» (главным образом по объёму занятой памяти) и завершает процесс с наибольшим баллом. Обычно это пользовательский расчёт, самый требовательный к памяти в системе.
Процесс исчезает без сообщения об ошибке, а в выводе dmesg остаётся строка Out of memory: Killed process. Балл корректируют вручную, защищая критичную службу или назначая заведомую жертву.
Управление OOM:
# Настройка политики OOM
echo -1000 > /proc/1234/oom_score_adj    # защитить процесс
echo 1000 > /proc/1234/oom_score_adj     # первый кандидат

# Ручной вызов OOM killer: НЕ на рабочей машине —
# ядро прямо сейчас убьёт живой процесс, выбрав его само.
# kernel.sysrq ограничивает только клавиатуру: root вызывает
# через /proc/sysrq-trigger любые функции SysRq
echo f > /proc/sysrq-trigger
Управление подкачкой
Подкачка является не запасной памятью, а способом выгрузить на диск страницы, давно не использовавшиеся. Расчётному узлу она скорее вредит: если рабочий набор перестал помещаться в оперативную память, подкачка замедлит всё в сотни раз, и машина будет выглядеть зависшей. Насколько охотно ядро выгружает страницы, задаёт параметр swappiness, установленный по умолчанию в 60; на сервере его снижают, на настольной машине оставляют без изменений.
# Мониторинг swap
swapon --show
free -h

# Настройка swappiness
echo 10 > /proc/sys/vm/swappiness    # меньше swap (сервер)
echo 60 > /proc/sys/vm/swappiness    # больше swap (десктоп)
Настройка под NUMA
На машинах с несколькими процессорными сокетами память разделена между ними, и обращение к «чужой» памяти, подключённой к соседнему сокету, обходится заметно дороже, чем к своей. Такая архитектура называется NUMA. Если расчёт занимает весь узел, ядро обычно распределяет всё разумно само. Когда на узле выполняется несколько задач одновременно, каждую необходимо привязывать к своему сокету вместе с её памятью, иначе они будут обращаться к памяти через шину между сокетами.
# Информация о NUMA
numactl --hardware

# Запуск с учетом NUMA
numactl --membind=0 --cpunodebind=0 ./application

# Статистика NUMA
cat /proc/1234/numa_maps
6. Изоляция
На рассматриваемых ниже механизмах ядра основан Docker из следующей главы.
Эволюция изоляции в Linux
От chroot до контейнеров
Идея контейнеров старше почти всех, кто ими сегодня пользуется. Каждый шаг добавлял к изоляции что-то одно:
- 1979,
chrootв UNIX: процессу подменяют корень файловой системы; - 2000, FreeBSD Jails: к файловой системе добавляется изоляция процессов и сети;
- 2001, Linux-VServer и 2004, Solaris Zones: те же идеи в других системах;
- 2008, LXC: в ядре Linux появляются пространства имён и cgroups, то есть всё необходимое;
- 2013, Docker: удобная упаковка поверх готовых механизмов ядра;
- 2014, Kubernetes: управление контейнерами в масштабе кластера.
Механизмы ядра были готовы за пять лет до Docker; революция 2013 года произошла в удобстве: появился простой способ описать образ одним файлом и передать его другому человеку.
Cgroups: управление ресурсами
Иерархия cgroups v2
Cgroups отвечают за вторую половину изоляции, не за то, что процесс видит, а за то, сколько он может потребить. Устроены они как дерево каталогов в /sys/fs/cgroup, где каждый каталог представляет группу процессов, а файлы внутри неё задают лимиты и хранят накопленные счётчики. Ограничение, установленное на узел дерева, действует на всё поддерево целиком.
/sys/fs/cgroup/
├── system.slice/          # системные службы
│   ├── ssh.service
│   └── docker.service
├── user.slice/            # пользовательские процессы
│   ├── user-1000.slice
│   └── user-1001.slice
├── kubepods.slice/        # Kubernetes pods
│   ├── pod1/
│   └── pod2/
└── cgroup.controllers     # доступные контроллеры
Контроллеры ресурсов
За каждый вид ресурса отвечает свой контроллер, а лимит устанавливается записью в файл.
Перед тем как устанавливать лимиты, группу необходимо создать и разрешить в ней нужные контроллеры, поскольку родитель передаёт их потомкам явно:
mkdir /sys/fs/cgroup/mygroup
echo "+cpu +memory +io" > /sys/fs/cgroup/cgroup.subtree_control
Без этих двух строк ни одна команда ниже не выполнится.
CPU:
# Ограничение CPU
echo "200000 1000000" > /sys/fs/cgroup/mygroup/cpu.max
# 200ms из каждых 1000ms

# CPU shares
echo 512 > /sys/fs/cgroup/mygroup/cpu.weight
Память:
# Лимит памяти
echo 1G > /sys/fs/cgroup/mygroup/memory.max

# SWAP лимит
echo 2G > /sys/fs/cgroup/mygroup/memory.swap.max

# убивать всю группу целиком, а не один процесс
echo 1 > /sys/fs/cgroup/mygroup/memory.oom.group
I/O:
# Ограничение дискового I/O
echo "8:0 rbps=1048576 wbps=1048576" > /sys/fs/cgroup/mygroup/io.max
Пространства имён: изоляция представлений
Виды пространств имён
Пространства имён отвечают за первую половину изоляции, подменяя процессу представление о системе. В своём PID-пространстве процесс видит себя первым номером и не подозревает о существовании остальных; в своём сетевом располагает собственными интерфейсами и портами. Видов пространств восемь, каждое подменяет что-то одно.
| Пространство | Что подменяет | Команда |
|---|---|---|
| PID | номера процессов | unshare --pid |
| Network | сетевые интерфейсы, порты, маршруты | unshare --net |
| Mount | смонтированные файловые системы | unshare --mount |
| UTS | имя узла и домена | unshare --uts |
| IPC | очереди сообщений и семафоры System V | unshare --ipc |
| User | идентификаторы пользователей и групп | unshare --user |
| Cgroup | видимый корень иерархии cgroups | unshare --cgroup |
| Time | системное время | unshare --time |
Пространства имён на практике
Команда unshare создаёт новые пространства имён и запускает в них процесс:
# Создание namespace и запуск процесса
sudo unshare --fork --pid --mount-proc bash

# В новом namespace:
ps aux    # видит только свои процессы
mount     # видит только свои mount points
До контейнера остаётся один шаг: предоставить процессу собственный корень файловой системы. Сверх этого Docker упаковывает корень в образ с метаданными и позволяет его скачивать и распространять.
# Создание root filesystem
mkdir /mycontainer
debootstrap stable /mycontainer

# Запуск в изоляции
unshare --fork --pid --mount-proc --net --uts --root=/mycontainer /bin/bash

# В контейнере:
hostname mycontainer
ip link set lo up
Заключение
При странном поведении программы правильнее не гадать, а запросить у системы, чем она занята. Если процесс завис, рассматривается его состояние; если расчёт замедлился, рассматриваются промахи по страницам и переключения контекста; если время уходит непонятно на что, рассматриваются системные вызовы, сделанные за секунду. Ядро сообщает о себе через /proc, /sys и perf.
Кроме того, необходимо помнить порядки величин. Обращение в память занимает наносекунды, системный вызов — микросекунды, чтение с диска — миллисекунды. Между соседними ступенями три порядка, и почти всякая оптимизация в конечном счёте сводится к тому, чтобы реже спускаться на ступень ниже.
Задания. Наблюдение за процессами и сигналами на практике: «Работа с долгоиграющими процессами».
straceиperf, здесь только названные, потребуются в задании «Настройка окружения и работа с утилитами».
Docker
Код, оторванный от окружения, ничего не воспроизводит: расчёт зависит ещё и от версии Python, набора библиотек, системных пакетов и десятка настроек, отсутствующих в репозитории. На этом стыке нарушается воспроизводимость чужих результатов.
Слайды к главе. Выпуск и откат приложения в контейнере, а также автоматический перезапуск после сбоя показаны в лекции «Жизненный цикл ПО» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
«У меня на машине работает»
Типичная ситуация выглядит следующим образом. Скрипт обработки данных, полученных на эксперименте, работает на ноутбуке автора, а при отправке коллеге завершается с ImportError. При запуске на кластере обнаруживается Python 3.8 вместо 3.12, системный numpy собран без нужных флагов, а права на установку пакетов есть только у администратора, находящегося в отпуске. Через два года рецензент просит воспроизвести график, напечатанный в статье, а автор уже не помнит версий библиотек, использовавшихся в то время.
Для физики это удар по воспроизводимости. Численный результат, не поддающийся повторению, стоит немногим больше, чем результат, которого нет. Виртуальные окружения и requirements.txt решают проблему частично: они фиксируют версии установленных Python-пакетов, но не версию самого Python, не системные библиотеки (BLAS, LAPACK, HDF5, компиляторы), не переменные окружения и не операционную систему. Создание виртуальных окружений и их наполнение рассматриваются в главе «От скрипта к приложению».
Docker упаковывает приложение вместе со всем его окружением, с интерпретатором, библиотеками, системными зависимостями и настройками, в единый образ. Собранный образ запускается одинаково на ноутбуке автора, на машине коллеги и на сервере в лаборатории, если у них одна архитектура процессора: контейнер использует ядро и процессор хоста, поэтому для машин на x86-64 и на ARM собирают многоплатформенный образ (docker buildx build --platform linux/amd64,linux/arm64).
Контейнеры vs виртуальные машины
Контейнер не является виртуальной машиной. Виртуальная машина эмулирует целый компьютер, несущий внутри полноценную гостевую операционную систему со своим ядром, а гипервизор транслирует её обращения к аппаратуре. Изоляция надёжная, но дорогая: каждая ВМ занимает гигабайты и стартует десятки секунд.
Контейнер представляет собой обычный процесс операционной системы, к которому ядро Linux применило два механизма. Namespaces (пространства имён) изолируют то, что процесс видит: у контейнера свои дерево процессов, сетевые интерфейсы и файловая система, и он считает себя единственным в системе. Cgroups (control groups) ограничивают то, что процесс потребляет, то есть отведённые ему память, процессорное время и дисковый ввод-вывод. Ядро при этом остаётся общим для всех контейнеров и хоста, поэтому контейнер стартует за доли секунды, а образ занимает от десятков до сотен мегабайт вместо гигабайт, занимаемых виртуальной машиной. Платой является несколько более слабая изоляция, чем у ВМ, что существенно для запуска чужого недоверенного кода и несущественно для упаковки собственных расчётов. Пространства имён и контрольные группы рассмотрены в предыдущей главе.
На macOS и Windows нативные Linux-контейнеры невозможны, поэтому Docker Desktop поддерживает лёгкую виртуальную машину с Linux, внутри которой работают контейнеры.
Образы и контейнеры
Существуют два центральных понятия:
- Образ (image) — неизменяемый шаблон: файловая система с установленными в неё программами плюс метаданные (какую команду запускать, какие порты открывать). В терминах программирования образ соответствует классу.
- Контейнер (container) — запущенный экземпляр образа, процесс со своим состоянием, объект этого класса. Из одного образа можно запустить произвольное число контейнеров.
Готовые образы скачиваются из реестра, по умолчанию из Docker Hub.
# скачать официальный образ Python 3.12 (slim — урезанный, без лишнего)
docker pull python:3.12-slim

# список локально скачанных образов
docker images
Запись python:3.12-slim читается как «репозиторий:тег», где тег означает версию. Если тег не указан, подставляется latest, и образ под этим тегом сегодня и через год окажется разным, а требуется воспроизводимость. То же относится к 3.12-slim: тег переносится на каждый новый выпуск Python 3.12.x и базового Debian. Неизменяемой ссылкой служит дайджест, python:3.12-slim@sha256:…; его показывает docker images --digests.
Запуск контейнера осуществляется следующим образом:
# запустить контейнер и выполнить в нём одну команду
docker run python:3.12-slim python -c "print('hello from container')"

# интерактивный запуск: -i — пробросить stdin, -t — выделить терминал
# получаем REPL питона внутри контейнера
docker run -it python:3.12-slim python

# а так можно попасть в шелл контейнера и осмотреться
docker run -it python:3.12-slim bash

# --rm — удалить контейнер сразу после завершения (не копить мусор)
docker run --rm -it python:3.12-slim bash
Внутри контейнера команда ls / показывает чужую файловую систему, pip install устанавливает пакет внутри контейнера, и после его удаления всё исчезает. Контейнеры эфемерны: всё ценное должно находиться либо в образе, либо в примонтированных томах (о них ниже).
Управление контейнерами:
docker ps               # запущенные контейнеры
docker ps -a            # все, включая остановленные
docker stop <id|имя>    # мягко остановить контейнер
docker rm <id|имя>      # удалить остановленный контейнер
docker rmi <образ>      # удалить образ
docker logs <id|имя>    # посмотреть, что контейнер писал в stdout/stderr
Вместо полного идентификатора можно указывать первые несколько символов или имя, выданное контейнеру самим Docker (или заданное через --name).
Проброс портов и томов
Контейнер изолирован, в том числе по сети и по файлам; изоляция нарушается в нужных местах двумя флагами.
Порты, -p хост:контейнер. Сервис внутри контейнера слушает свой порт, и снаружи он недоступен, пока порт не проброшен на хост.
Тома, -v путь_на_хосте:путь_в_контейнере. Каталог хоста монтируется внутрь контейнера, файлы видны с обеих сторон, а полученные результаты сохраняются после удаления контейнера.
Пример: Jupyter, запущенный в контейнере без единого pip install на собственной машине.
# jupyter/scipy-notebook — готовый образ с numpy, scipy, pandas, matplotlib
# -p 8888:8888          порт 8888 хоста -> порт 8888 контейнера
# -v ...:/home/jovyan/work   текущий каталог -> каталог work внутри контейнера
# тег фиксируем ради воспроизводимости, реестр указываем явно:
# образы jupyter в конце 2023 года переехали с Docker Hub на quay.io
docker run --rm \
    -p 8888:8888 \
    -v "$(pwd)":/home/jovyan/work \
    quay.io/jupyter/scipy-notebook:2024-05-27
В браузере открывается http://localhost:8888 по ссылке с токеном, выведенной контейнером в журнал, и работа ведётся в блокнотах, находящихся в текущем каталоге хоста. После удаления контейнера блокноты остаются, а окружение исчезает.
Dockerfile: свой образ для научного проекта
Расчётный код требует своего набора зависимостей; рецепт сборки образа описывается в файле Dockerfile. Пусть имеется проект моделирования динамики пучка.
beam-simulation/
├── Dockerfile
├── requirements.txt      # numpy, scipy, matplotlib с версиями
├── simulate.py           # основной расчёт
└── beamlib/              # свои модули
Содержимое requirements.txt:
numpy==2.1.3
scipy==1.14.1
matplotlib==3.9.2
Dockerfile:
# Базовый образ: официальный Python, slim-вариант без лишних пакетов.
# Версия Python зафиксирована тегом; точный образ закрепляет дайджест.
FROM python:3.12-slim

# Рабочий каталог внутри образа; все следующие команды выполняются в нём.
# Если каталога нет, он будет создан.
WORKDIR /app

# Сначала копируем ТОЛЬКО файл с зависимостями...
COPY requirements.txt .

# ...и устанавливаем их. --no-cache-dir не хранит кеш pip в образе,
# образ получается меньше.
RUN pip install --no-cache-dir -r requirements.txt

# Только теперь копируем весь остальной код проекта.
COPY . .

# Команда по умолчанию при запуске контейнера.
# Форма со скобками (exec form) запускает процесс напрямую, без оболочки.
CMD ["python", "simulate.py"]
Рассмотрим инструкции:
FROMзадаёт базовый образ. Всё, что содержится вpython:3.12-slim(Debian, Python, pip), достаётся готовым.WORKDIR /appобъявляет текущий каталог для последующихCOPY,RUN,CMD.COPY <откуда> <куда>копирует файлы из каталога проекта, называемого контекстом сборки, внутрь образа.RUNвыполняет команду во время сборки и сохраняет результат в образ. Здесь же устанавливаются системные пакеты наподобиеRUN apt-get update && apt-get install -y gfortran.CMDуказывает, что запускать при старте контейнера. Выполняется не при сборке, а приdocker run, и легко переопределяется командойdocker run мой-образ bash.
Слои и кеширование: отдельное копирование requirements.txt
Каждая инструкция Dockerfile создаёт слой — снимок изменений, внесённых ею в файловую систему. Образ представляет собой стопку слоёв, и Docker их кеширует: если инструкция и её входные файлы не изменились, слой берётся из кеша, а не пересобирается. Как только один слой изменился, все последующие пересобираются.
Код (simulate.py) правится по двадцать раз в день, а requirements.txt раз в месяц. Если бы COPY . . располагалась до установки зависимостей, любая правка, сделанная в коде, инвалидировала бы слой копирования, и Docker заново выполнял бы pip install со скачиванием numpy и scipy, что означает пять минут ожидания после каждой изменённой строки. В приведённом порядке слой с зависимостями зависит только от requirements.txt: при правке кода пересобирается лишь дешёвый COPY . ., и сборка занимает секунды. Правило: редко меняющееся выше, часто меняющееся ниже.
Файл .dockerignore устроен по образцу .gitignore: в нём перечисляются .git, __pycache__, данные и прочее, что не должно попадать в образ.
Сборка и запуск
# Собрать образ из Dockerfile в текущем каталоге (точка — контекст сборки).
# -t задаёт имя и тег.
docker build -t beam-simulation:0.1 .

# Тег можно навесить и потом (это просто ярлык на тот же образ)
docker tag beam-simulation:0.1 beam-simulation:latest

# Запуск: результаты пишем в примонтированный каталог,
# иначе они умрут вместе с контейнером
docker run --rm -v "$(pwd)/results":/app/results beam-simulation:0.1

# Переопределить CMD: запустить другой скрипт из того же образа
docker run --rm beam-simulation:0.1 python -m beamlib.diagnostics
Весь расчёт сводится к одной команде, воспроизводимой на любой машине с Docker.
Реестры: Docker Hub и ghcr.io
Передать образ коллеге можно файлом (docker save и docker load), однако стандартным путём является реестр (registry), устроенный как git-хостинг для образов. По умолчанию используется публичный Docker Hub, откуда был скачан python:3.12-slim. Второй популярный вариант, GitHub Container Registry (ghcr.io), удобен тем, что образы располагаются рядом с кодом проекта на GitHub и собираются автоматически через GitHub Actions.
Имя образа, отправляемого в реестр, должно включать аккаунт владельца, после чего выполняется docker push.
# тегируем образ под свой аккаунт на Docker Hub
docker tag beam-simulation:0.1 fuodorov/beam-simulation:0.1

docker login                            # авторизация (однократно)
docker push fuodorov/beam-simulation:0.1

# коллега на любой машине делает:
docker pull fuodorov/beam-simulation:0.1

# для ghcr.io всё то же, только префикс реестра в имени:
docker tag beam-simulation:0.1 ghcr.io/fuodorov/beam-simulation:0.1
docker push ghcr.io/fuodorov/beam-simulation:0.1
Docker Compose: несколько контейнеров
Система редко состоит из одного контейнера: типичный сценарий — приложение, записывающее результаты в базу данных PostgreSQL. Запускать оба контейнера вручную, настраивать сеть между ними, помнить порядок запуска и десяток флагов утомительно. Docker Compose описывает всю связку декларативно, в одном файле compose.yaml:
services:
  app:
    build: .                    # собрать образ из Dockerfile в текущем каталоге
    volumes:
      - ./results:/app/results  # результаты — на хост
    environment:
      DB_HOST: db               # имя сервиса работает как сетевое имя хоста
      DB_USER: physicist
      DB_PASSWORD: secret
    depends_on:
      db:
        condition: service_healthy  # приложение стартует, когда база начала принимать соединения

  db:
    image: postgres:16          # готовый образ с Docker Hub
    environment:
      POSTGRES_USER: physicist
      POSTGRES_PASSWORD: secret
      POSTGRES_DB: measurements
    healthcheck:                # проверка готовности, а не только запуска процесса
      test: ["CMD-SHELL", "pg_isready -h 127.0.0.1 -U physicist -d measurements"]
      interval: 2s
      retries: 15
    volumes:
      - pgdata:/var/lib/postgresql/data   # именованный том: данные переживут контейнер

volumes:
  pgdata:
Compose автоматически создаёт общую сеть, в которой контейнеры видят друг друга по именам сервисов, объявленным в файле, и приложение подключается к базе по адресу db:5432, без IP. Сам по себе depends_on ждёт только запуска контейнера базы, а не её готовности: при первом запуске PostgreSQL сначала создаёт кластер и базу, и приложение, подключившееся в это время, получает отказ в соединении. Условие service_healthy откладывает запуск приложения до первой успешной проверки healthcheck. Команда pg_isready с ключом -h 127.0.0.1 проверяет сервер по TCP, как и приложение: на время инициализации образ запускает временный сервер, доступный только через локальный сокет. Основные команды:
docker compose build      # только собрать образы, не запуская
docker compose up -d      # собрать и запустить всё; -d — в фоне
docker compose logs -f    # смотреть логи всех сервисов
docker compose ps         # какие сервисы подняты и какие порты опубликованы
docker compose down       # остановить и удалить контейнеры (тома останутся)
Одного файла в репозитории достаточно, чтобы любой член группы поднял всю инфраструктуру проекта одной командой.
Видимость портов снаружи и внутри
В примере выше наружу не опубликовано ничего: приложение и база взаимодействуют только между собой, по сети, созданной Compose. Чтобы открыть сервис пользователю или соседней машине, существуют два разных ключа.
services:
  nginx:
    image: nginx:1.27
    ports:
      - "80:80"     # опубликовать наружу: порт 80 хоста -> порт 80 контейнера
  backend:
    build: ./backend
    expose:
      - "8000"      # видно соседям по сети Compose и самому хосту по внутреннему адресу контейнера, но не из внешней сети
ports публикует порт на хост, и по нему в контейнер может обратиться любой, у кого
есть доступ к машине. expose не публикует ничего, а лишь помечает порт, на
котором сервис слушает, для соседей по той же сети. Обычная схема
рабочего стенда: снаружи опубликован единственный порт, а за ним стоит nginx,
раздающий статику фронтенда и перенаправляющий запросы к API на бэкенд по
имени сервиса. Такой nginx называется обратным прокси, и в его конфигурации
достаточно одной секции:
server {
    listen 80;
    location / {
        root /usr/share/nginx/html;     # собранный фронтенд
    }
    location /api/ {
        proxy_pass http://backend:8000/;   # backend — имя сервиса из compose.yaml
    }
}
Порт, не опубликованный наружу,
недоступен из сети: база данных и бэкенд остаются недосягаемыми для других машин,
даже если в них обнаружится уязвимость. Проверкой служит команда
docker compose ps: публикация должна присутствовать ровно у одного сервиса, а
curl localhost:8000 на хосте отвечать не должен.
Контейнеры в науке
Контейнер является ответом рецензенту, требующему воспроизвести результаты. Всё чаще к статье прикладывают не только код, но и собранный образ или хотя бы Dockerfile, помещённый в репозиторий. Одной команды docker run с опубликованным образом достаточно, чтобы читатель получил те же графики из тех же данных, с точностью до версий всех задействованных библиотек. Dockerfile воспроизводит окружение, только если базовый образ указан дайджестом (FROM python:3.12-slim@sha256:…), а версии пакетов зафиксированы: тег python:3.12-slim со временем начинает указывать на новую сборку. На суперкомпьютерах Docker обычно не устанавливают: его служба работает с правами root, а доступ к ней равносилен правам root на узле. Там используется Apptainer — под этим именем проект Singularity с 2021 года входит в Linux Foundation, а компания Sylabs развивает его ответвление SingularityCE. Apptainer спроектирован для HPC: он запускает контейнеры без прав root, совместим с MPI и GPU и собирает образы из образов Docker. Образ, собранный на рабочем компьютере, запускается и на кластере, если совпадает архитектура процессора (образ для x86-64 не запустится на узлах ARM), библиотека MPI в образе совместима с MPI и сетью кластера, а драйвер видеокарты подключается с хоста (ключ --nv); подробно Apptainer и запуск расчётов на кластере рассмотрены в главе «Кластеры и воспроизводимое окружение для расчётов».
Полезные ссылки
- Docker
- Docker CLI
- Виртуализация и контейнеризация
- Проникновение в Docker с примерами
- Оптимизация образов Docker
- Документация на docker network
- Docker: гибкая сеть без NAT на все случаи жизни
- Docker Compose
- Docker Compose CLI
Задание. Упаковать бэкенд и фронтенд в образы и связать их через
docker compose: «Деплой стартапа „Котики в мир“».
Устройство интерпретатора Python
… in December 1989, I was looking for a “hobby” programming project that would keep me occupied during the week around Christmas. My office … would be closed, but I had a home computer, and not much else on my hands.
Гвидо ван Россум, предисловие к «Programming Python» (1-е изд.)
Так, из «хобби на рождественские каникулы», родился язык, на котором сегодня основана значительная часть научных вычислений.
В настоящей части рассматривается внутреннее устройство языка. Настоящая глава описывает путь программы от исходного текста до исполнения: реализации языка, байт-код, модули и интерактивную оболочку. Затем рассматриваются объекты и память — то, что скрывается за именем переменной, — коллекции, собираемые из этих объектов, и стоимость операций над ними. Далее следуют функции и построенные на них итераторы с генераторами, обеспечивающие механизм отложенных вычислений. Завершают часть декораторы и классы, два способа наращивать поведение, не переписывая уже работающий код.
Когда обработка данных, полученных в эксперименте, занимает часы вместо минут, причина почти всегда состоит не в «медленном Python», а в неудачно выбранной структуре данных или лишнем копировании.
Слайды к главе. Материал главы изложен также в первой части лекции «Python. Начало», продолжение лекции относится к трём следующим главам; слайды лекции доступны на сайте книги и в PDF.
Язык и его реализации
Python — язык, описанный спецификацией (The Python Language Reference), и у него несколько реализаций. Эталонной и самой распространённой является CPython, написанный на C: именно он устанавливается с python.org и из пакетов дистрибутивов Linux. PyPy компилирует часто выполняемые участки программы в машинный код во время работы (JIT), поэтому циклы на чистом Python выполняются в нём в несколько раз быстрее. MicroPython работает на микроконтроллерах с сотнями килобайт памяти, GraalPy — на виртуальной машине GraalVM.
Всё, что далее в этой части говорится о кеше малых чисел, подсчёте ссылок, байт-коде и сборщике мусора, относится к CPython. Спецификация языка этих механизмов не требует и упоминает их только как детали реализации, поэтому программа, опирающаяся на них, может вести себя иначе в другой реализации и даже в другой версии CPython.
Путь исходного текста
CPython не исполняет исходный текст напрямую. Лексический анализатор разбивает текст на токены: имена, числа, строки, операторы, отступы. Синтаксический анализатор строит из токенов абстрактное синтаксическое дерево (AST). Компилятор обходит дерево и порождает байт-код — последовательность инструкций виртуальной стековой машины, упакованную вместе с таблицами констант и имён в объект кода. Этот объект исполняет цикл вычисления интерпретатора, по одной инструкции за шаг. Каждый этап доступен из самого Python: модули tokenize и ast, встроенная функция compile и модуль dis.
Байт-код функции печатает модуль dis; здесь и далее приведён вывод CPython 3.12.
import dis

def area(r):
    return 3.14159 * r ** 2

dis.dis(area)
  3           0 RESUME                   0

  4           2 LOAD_CONST               1 (3.14159)
              4 LOAD_FAST                0 (r)
              6 LOAD_CONST               2 (2)
              8 BINARY_OP                8 (**)
             12 BINARY_OP                5 (*)
             16 RETURN_VALUE
Первый столбец — номер строки исходного текста, второй — смещение инструкции в байтах. Инструкции берут операнды с вершины стека значений и кладут туда результат: LOAD_CONST загружает константу, LOAD_FAST — локальную переменную, BINARY_OP снимает два значения и кладёт результат операции, RETURN_VALUE возвращает вершину стека вызывающему коду. RESUME в начале функции служит точкой, в которой интерпретатор проверяет запросы трассировки. Выражения из одних констант компилятор вычисляет заранее: в байт-коде присваивания x = 2 * 3.14159 остаётся одна константа 6.28318.
С версии 3.11 интерпретатор адаптивный (PEP 659): во время работы он заменяет общие инструкции специализированными. Уже после двух вызовов area(1.0) функция dis.dis(area, adaptive=True) показывает вместо второго BINARY_OP инструкцию BINARY_OP_MULTIPLY_FLOAT, умножающую именно вещественные числа. Байт-код не входит в спецификацию языка: набор инструкций меняется от версии к версии, поэтому вывод dis в материалах о других версиях выглядит иначе.
Модули и файлы .pyc
Каждый файл .py является модулем. Инструкция import circle находит файл circle.py, создаёт объект модуля, заносит его в словарь sys.modules и выполняет файл сверху вниз; имена, определённые в файле, становятся атрибутами модуля: circle.area. Повторный import находит модуль в sys.modules и файл заново не выполняет. Байт-код импортированного модуля сохраняется в каталоге __pycache__ в файле с тегом версии интерпретатора (circle.cpython-312.pyc) и используется повторно, пока исходный файл не изменился; запускаемый сценарий компилируется при каждом запуске.
У импортированного модуля атрибут __name__ равен его имени, а у файла, запущенного как сценарий, — строке "__main__". На этом основана идиома, позволяющая одному файлу служить и сценарием, и библиотекой функций: код под условием выполняется при запуске файла и не выполняется при его импорте.
def main():
    ...

if __name__ == "__main__":
    main()
Модули ищутся по списку каталогов sys.path, и после встроенных в интерпретатор модулей первым просматривается каталог запускаемого сценария. Поэтому файл random.py или numpy.py, созданный рядом со сценарием, подменяет одноимённый модуль стандартной библиотеки или установленного пакета, и импорт завершается непонятной ошибкой вида AttributeError: module 'random' has no attribute 'randint'. Имя собственного файла выбирается так, чтобы не совпадать с именами модулей.
Интерактивная оболочка
Интерактивная оболочка (REPL, read–eval–print loop) читает строку, выполняет её и печатает значение выражения; приглашение ... означает, что оболочка ждёт продолжения блока. Для исследования объектов служат функции help, dir, type и id, а значение последнего выражения сохраняется в переменной _. Команда python3 -i run.py выполняет сценарий и оставляет оболочку открытой со всеми его переменными, что удобно для разбора ошибки. В Python 3.13 оболочка получила многострочное редактирование и цветные сообщения об ошибках, а IPython и блокноты Jupyter дополняют её сохранением кода, результатов и графиков.
Объекты и память
В настоящей главе рассматривается то, что скрывается за именем переменной: чем изменяемые объекты отличаются от неизменяемых, почему это различие проявляется в неожиданных местах, а также как устроены условные конструкции и циклы.
Слайды к главе. Материал главы изложен также во второй, третьей и четвёртой частях лекции «Python. Начало» (объекты в памяти, изменяемость, сборка мусора) с демонстрациями в интерактивной оболочке; слайды лекции доступны на сайте книги и в PDF.
Объекты в памяти
В Python объектом является всё: и число, и строка, и функция, и сам класс. Любой объект обладает тремя свойствами. Тип определяет набор действий, разрешённых с объектом (int, str, list). Значение представляет собой данные, хранящиеся внутри объекта (42, "hello"). Идентификатор является числом, которое не меняется на всё время жизни объекта и уникально среди объектов, существующих одновременно: после уничтожения объекта его идентификатор может достаться новому. В CPython это адрес объекта в памяти, получаемый функцией id().
s = "hello"
print(id(s))  # Выведет что-то вроде 4390213040
Ссылки, а не копии
Переменная в Python не «содержит» объект, а ссылается на него, поэтому присваивание одной переменной другой создаёт второе имя для того же объекта, а данные остаются на месте. Если объект изменён через одно имя, изменение будет видно и через второе.
a = [1, 2, 3]
b = a
b.append(4)
print(a)  # [1, 2, 3, 4] — изменился и a!
Сравнение is и ==
Оператор is проверяет, является ли это одним объектом, а == сравнивает значения. Два списка могут быть равны поэлементно и при этом оставаться разными объектами, расположенными в памяти по разным адресам.
x = [1, 2]
y = [1, 2]
print(x == y)  # True
print(x is y)  # False
Кеширование целых чисел
При запуске интерпретатор заранее создаёт объекты для небольших целых чисел (в CPython 3.10–3.14 это диапазон от −5 до 256, в 3.15 кеш расширен), и все переменные с такими значениями ссылаются на один и тот же заранее созданный объект.
a = 256
b = 256
print(a is b)  # True — это один и тот же закешированный объект
Для 257 результат зависит от того, каким образом запускается код.
c = 257
d = 257
print(c is d)
При запуске этого фрагмента в виде файла будет получено True, тогда как при вводе тех же трёх строк в интерактивной оболочке результатом окажется False.
Причина заключается не в кеше чисел, а в работе компилятора. Python компилирует файл целиком и объединяет одинаковые константы всех его функций, поэтому c и d получают ссылку на одну и ту же константу. В интерактивной оболочке каждая строка компилируется отдельно, общей таблицы нет, и создаются два разных объекта.
Тождественность объектов относится к деталям реализации, и опираться на неё нельзя. Она зависит от версии интерпретатора, от способа запуска (файл целиком или отдельные строки интерактивной оболочки) и от того, получено значение при компиляции или вычислено во время работы программы.
💡 Золотое правило: для сравнения значений необходимо использовать
==, аisприменять только для проверки наNone,TrueиFalse.
Изменяемые и неизменяемые объекты
Это основное деление объектов Python.
Неизменяемые (immutable)
К неизменяемым относятся int, float, str, tuple, bytes и bool. Однажды созданный объект хранит своё значение навсегда. Любая «модификация» создаёт новый объект, на который переставляется старое имя, в чём проще всего убедиться по идентификатору, меняющемуся после каждого +=.
s = "hello"
print(id(s))
s += "!"
print(id(s))  # ID изменился — это новый объект!
Изменяемые (mutable)
list, dict и set, напротив, изменяются на месте. Список после append остаётся тем же самым объектом, в котором лишь стало на один элемент больше, и все имена, ссылавшиеся на него, увидят добавленный элемент.
lst = [1, 2]
print(id(lst))
lst.append(3)
print(id(lst))  # ID остался прежним
Кортежи с изменяемыми элементами
Неизменяемость кортежа распространяется только на него самого: кортеж хранит ссылки, и неизменны именно они, поэтому подставить в ячейку другой объект нельзя. Сам же объект, на который указывает ссылка, о запрете ничего не знает.
t = ([1, 2], [3, 4])
t[0].append(3)
print(t)  # ([1, 2, 3], [3, 4]) — это допустимо!
Такой кортеж нельзя поместить в множество или использовать как ключ словаря, поскольку хеш кортежа складывается из хешей его элементов, а у списка хеша нет. Попытка завершится исключением TypeError: unhashable type: 'list' при вставке.
Строки и байты
Ниже рассматриваются два неизменяемых типа, которые начинающие разработчики часто путают.
Строки (str)
str хранит текст, то есть последовательность символов Unicode. Длина строки измеряется в символах, а не в байтах, и один символ может быть латинской буквой, кириллической, иероглифом или значком эмодзи. Способ размещения этих символов в памяти определяется интерпретатором.
Байты (bytes)
bytes хранит сырые данные, то есть последовательность чисел от 0 до 255: то, что находится в файле, приходит по сети или считывается с прибора. Понятие «символ» здесь отсутствует, есть только числа. Тип также является неизменяемым; его изменяемый вариант называется bytearray.
Автоматического перехода между ними нет, поскольку требуется кодировка, указывающая, каким набором байтов записан каждый символ. encode преобразует текст в байты, decode — байты в текст.
text = "привет"
encoded = text.encode('utf-8')  # str -> bytes
decoded = encoded.decode('utf-8')  # bytes -> str
Кириллица в UTF-8 занимает по два байта на символ, поэтому len(text) даст 6, а len(encoded) вернёт 12. Почти все UnicodeDecodeError возникают именно отсюда: байты читаются не в той кодировке, в которой были сохранены.
Условные конструкции
Базовый синтаксис
Ветвление в Python обходится без круглых и фигурных скобок: достаточно условия, двоеточия и блока, записанного с отступом.
temperature = 15
if temperature > 20:
    print("Наденьте футболку")
else:
    print("Лучше взять куртку")
Элегантные проверки
В условии не обязательно записывать сравнение, поскольку любой объект сам по себе истинен или ложен: пустая строка, пустой список, ноль и None ложны, всё остальное истинно. Поэтому if name: читается как «если имя есть» и заменяет if name != "":
name = input("Введите имя: ")
if name:  # False, если строка пустая
    print(f"Привет, {name}!")
else:
    print("Привет, незнакомец!")
Современный match (Python 3.10+)
Когда одну переменную необходимо сравнить с десятком значений, цепочка из elif становится нечитаемой, и для этого случая предусмотрен match, аналог switch из других языков. Ветви перебираются сверху вниз, вертикальная черта объединяет несколько вариантов в один случай, а case _ перехватывает всё, что не было перехвачено раньше.
http_status = 404
match http_status:
    case 200 | 201:
        print("Успех")
    case 401 | 403 | 404:
        print("Ошибка клиента")
    case 500 | 503:
        print("Ошибка сервера")
    case _:
        print("Неизвестный статус")
💡 Совет:
matchследует применять при сравнении одной переменной с несколькими значениями. Для сложных условий предпочтительнееif/elif/else.
Циклы
while
while повторяет тело, пока условие истинно, и требуется там, где число итераций заранее неизвестно, например пока значение не выйдет за заданную границу.
i = 1
while i < 1000:
    print(i)
    i *= 2
for и range
for в Python перебирает не индексы, а элементы; если необходим счётчик, его предоставляет range. С одним аргументом он отсчитывает от нуля, с тремя задаёт начало, границу и шаг. Правая граница в диапазон не входит.
for i in range(5):      # 0, 1, 2, 3, 4
    print(i)

for i in range(1, 10, 2):  # 1, 3, 5, 7, 9
    print(i)
enumerate для получения индекса
Когда вместе с элементом требуется и его номер, заводить отдельный счётчик не нужно: enumerate выдаёт пары «индекс, элемент», распаковываемые в заголовке цикла.
for idx, char in enumerate("abc"):
    print(f"Индекс: {idx}, Символ: {char}")
Ветка else в циклах
У циклов в Python есть ветка else, почти не встречающаяся в других языках. Она выполняется, если цикл завершился естественно, то есть перебрал всё до конца и ни разу не встретил break. Это готовый каркас для поиска: в теле цикла выполняется поиск с выходом по break, а в else записывается ветка «не найдено».
for i in range(5):
    if i == 10:
        break
else:
    print("Цикл завершился без break")
Производительность при работе со строками
Каждое += для строки создаёт новый объект и копирует в него всё накопленное ранее. На сотой итерации копируется сто символов, на стотысячной — сто тысяч, и в сумме получается квадратичное время вместо линейного.
result = ""
for _ in range(100000):
    result += "a"  # Создаёт новый объект на каждой итерации!
Следует сделать оговорку: если на строку не ссылается никто, кроме локальной переменной, интерпретатор дописывает её на месте, и в теле функции этот же цикл выполняется за линейное время, тогда как на уровне модуля, где на строку ссылается ещё и словарь глобальных имён, время растёт квадратично. Оптимизация опирается на счётчик ссылок, исчезает при любом лишнем имени и языком не гарантируется. Это необходимо учитывать при измерении через timeit: он оборачивает код в функцию, и квадратичный рост там не проявится.
Правильнее накапливать части в списке и объединить их один раз. Список изменяем, append ничего не копирует, а join заранее вычисляет итоговую длину, выделяет память один раз и переносит туда все части.
parts = []
for _ in range(100000):
    parts.append("a")
result = "".join(parts)  # Быстрое объединение
💡 Совет: для частых операций конкатенации рекомендуется использовать
list+join()для строк илиbytearrayдля байтов.
Сборка мусора
Память под объекты в Python освобождается автоматически, и обеспечивается это двумя механизмами.
Основной — подсчёт ссылок: у каждого объекта есть счётчик, показывающий, сколько имён и контейнеров на него ссылаются. Как только счётчик падает до нуля, объект уничтожается немедленно. Это быстро и предсказуемо, и в большинстве программ ничего сверх этого не требуется.
Слабым местом подсчёта ссылок являются циклические ссылки. Если объекты ссылаются друг на друга, их счётчики никогда не обнулятся, даже когда до них уже нельзя добраться из программы.
a = []
b = [a]
a.append(b)  # Теперь a и b ссылаются друг на друга
del a, b     # Объекты недостижимы, но ссылки остались
Для таких случаев предусмотрен второй механизм, поколенческий сборщик мусора. Он запускается периодически, находит группы объектов, ссылающихся друг на друга и недостижимых извне, и удаляет их целиком. Поколенческим он называется потому, что молодые объекты проверяются часто, а пережившие несколько проверок — редко: долгоживущий объект с большой вероятностью проживёт ещё.
Неочевидные особенности Python
1. Изменяемые аргументы по умолчанию
Наиболее известная ловушка языка. Значение по умолчанию, записанное в заголовке, вычисляется один раз, когда интерпретатор доходит до строки def, после чего список сохраняется между вызовами и накапливает всё помещённое в него.
def append_to(element, target=[]):  # так делать нельзя!
    target.append(element)
    return target

print(append_to(1))  # [1]
print(append_to(2))  # [1, 2] — тот же список!
Решение: по умолчанию указывается None, а пустой список создаётся внутри функции, заново при каждом вызове.
def append_to(element, target=None):
    if target is None:
        target = []
    target.append(element)
    return target
2. Ленивые логические операторы
and и or вычисляют правую часть только тогда, когда без неё нельзя обойтись. Если левый операнд and ложен, результат уже известен, и правая часть не вычисляется. Благодаря этому выражение if xs and xs[0] > 0 не приведёт к ошибке на пустом списке.
def expensive_call():
    print("Вызов выполнен!")
    return True

# expensive_call() не будет вызвана, т.к. первое условие False
if False and expensive_call():
    pass
3. Атрибуты функций
Функция также является объектом, и ей можно присвоить произвольный атрибут. На этом основаны декораторы, подсчитывающие вызовы или кеширующие результат на самой функции.
def my_func():
    pass

my_func.custom_attr = 42
print(my_func.custom_attr)  # 42
Заключение
Переменная представляет собой имя, привязанное к объекту, а не контейнер со значением. Отсюда следуют и общий список после двух присваиваний, и накопительный аргумент по умолчанию, и квадратичное время сборки строки через +=.
Таким образом, можно сформулировать четыре правила:
isприменяется только дляNone,TrueиFalse; во всех остальных случаях используется==.- Строки собираются через
join, а не через+=в цикле. - Значение по умолчанию не должно быть изменяемым объектом, вместо него указывается
None. - Прежде чем передать объект в стороннюю функцию, необходимо определить, изменяем он или нет.
Полезные материалы:
- Python Documentation
- Ned Batchelder — Facts and Myths about Python Names and Values
- Real Python — Python Memory Management
Коллекции
Коллекции составляют основу хранения и обработки данных в Python. В настоящей главе рассматриваются конкретные типы, встроенные в язык, и их устройство, тогда как сами структуры данных, дек и хеш-таблица в их общем виде, разбираются в части «Алгоритмы и структуры данных»; стоимость конкретных операций над списком, множеством и словарём оценивается в следующей главе. Выбор между ними определяет, будет программа выполняться секунды или часы.
Слайды к главе. Материал главы изложен также в пятой части лекции «Python. Начало» с демонстрациями в интерактивной оболочке; слайды лекции доступны на сайте книги и в PDF.
Понятие коллекции
Коллекцией в Python стандартная библиотека называет объект с тремя свойствами. Он является контейнером (Container), то есть отвечает на оператор in; он итерируемый (Iterable), и его элементы можно перебрать в цикле; он ограниченной длины (Sized), а значит знает, сколько в нём элементов, и отвечает на len().
Принадлежность к коллекциям проверяется через isinstance с абстрактным классом из стандартной библиотеки.
from collections.abc import Collection

# Проверим, является ли список коллекцией
print(isinstance([1, 2, 3], Collection))  # True
Любопытные исключения
- Числовой интервал служит контейнером: про любое число можно сказать, лежит оно внутри или нет. Однако перебрать все его точки нельзя, и длины, измеряемой в элементах, у него нет.
- Генератор итерируем, но заранее не знает, сколько элементов выдаст, и не способен отвечать на
in, не израсходовав себя.
Синтаксис @dataclass и магические методы, за которыми стоят операторы наподобие in, разбираются в главе «Классы»; здесь описывается собственный тип, отвечающий на in.
# Пример: Интервал как контейнер
from dataclasses import dataclass

@dataclass
class Interval:
    a: float
    b: float

    def __contains__(self, x):
        return self.a < x < self.b

interval = Interval(0, 1)
print(0.5 in interval)  # True — оператор in работает

# а вот длины у интервала нет и быть не может:
# len(interval) -> TypeError: object of type 'Interval' has no len()
Иерархия коллекций
Стандартная библиотека Python определяет абстрактные базовые классы (ABC), по которым коллекции и классифицируются:
   Container      Iterable       Sized          три независимых свойства
       |             |             |
       +-------------+-------------+
                     |
                 Collection        объект, обладающий всеми тремя
                     |
        +------------+------------+
        |            |            |
    Sequence        Set        Mapping
Container, Iterable и Sized представляют собой три независимых свойства, и объект может обладать любым их сочетанием. Генератор итерируем, но не знает своей длины; рассмотренный выше Interval, не позволяющий перебирать точки, остаётся контейнером. Collection объединяет все три свойства, потому и наследуется от всех трёх.
Ниже располагаются три семейства:
- Sequence (последовательности), где элементы упорядочены и доступны по индексу. Сюда относятся списки, кортежи и строки.
- Set (множества), где элементы уникальны, а порядка, связывающего их, нет. Это
setиfrozenset. - Mapping (отображения), хранящие пары «ключ, значение». Это словари.
Списки (list): универсальные и изменяемые
Список является наиболее часто используемой коллекцией и выбором по умолчанию, когда неясно, какой тип применить.
Неочевидные особенности инициализации
Умножение списка на число повторяет только ссылки. Если внутри находится изменяемый объект, все скопированные ссылки укажут на него же, и изменение через один индекс отразится во всех остальных. Классическая ошибка — матрица, у которой все строки одинаковые:
# Кажется, что это создаст матрицу 2x1
chunks = [[0]] * 2
chunks[0][0] = 42
print(chunks)  # [[42], [42]] Оба элемента ссылаются на один и тот же список!

# Правильный способ: включение создаёт новый список на каждой итерации
correct_chunks = [[0] for _ in range(2)]
correct_chunks[0][0] = 42
print(correct_chunks)  # [[42], [0]] — а вот теперь как надо
Тело включения выполняется на каждой итерации заново, и [0] создаёт новый список каждый раз.
Эффективные операции
Внутренне список устроен как динамический массив, и стоимость операций следует из этого устройства. append(item) и pop(), работающие с последним элементом, имеют амортизированную сложность O(1). insert(0, item) и pop(0) сдвигают все элементы и имеют сложность O(n). extend(iterable) выгоднее серии append(), поскольку один раз оценивает требуемый размер вместо наращивания списка по одному элементу.
Совет: При необходимости частых операций с обоих концов целесообразно использовать collections.deque (устройство дека и сравнительные измерения со списком приведены в главе «Основные структуры данных»).
Кортежи (tuple): неизменяемые и хешируемые
Неизменяемость даёт кортежу свойство, отсутствующее у списка: кортеж хешируем, а значит, подходит для ключей словаря и элементов множества. Пара координат, связка «прибор, канал», дата, записанная тремя числами, помещаются в кортеж и становятся ключом.
Распаковка кортежей
Распаковка разбирает кортеж на переменные одним присваиванием. Звёздочка слева от знака равенства собирает остаток в список, подчёркивание по соглашению помечает ненужное значение, а звёздочка в вызове функции работает в обратную сторону и раскладывает кортеж по аргументам.
# Распаковка с упаковкой «лишних» элементов в переменную
first, second, *rest = range(10)
print(first, second, rest)  # 0 1 [2, 3, 4, 5, 6, 7, 8, 9]

# Игнорирование ненужных значений
x, _, z = (1, 2, 3)

# Распаковка в аргументы функции
def greet(name, greeting):
    return f"{greeting}, {name}!"

person = ("Alice", "Hello")
print(greet(*person))  # "Hello, Alice!"
Именованные кортежи (namedtuple)
Через месяц смысл, вложенный в point[1], оказывается забытым. collections.namedtuple является фабрикой классов, создающей подтип кортежа с именованными полями. Полученный объект остаётся кортежем со всеми его свойствами, но к элементам можно обращаться по имени.
from collections import namedtuple

Point = namedtuple('Point', ['x', 'y'])
p = Point(10, y=20)
print(p.x, p.y)  # 10 20
print(p._asdict()) # {'x': 10, 'y': 20}
Метод _asdict() преобразует такой кортеж в словарь, что удобно для вывода и сериализации. Имена полей задаются пользователем, поэтому служебные методы помечаются подчёркиванием, чтобы они не столкнулись с полем, названным asdict.
Множества (set): уникальность и скорость
Множества реализованы как хеш-таблицы, рассматриваемые в главе «Хеш-функции», поэтому проверка вхождения (in) имеет среднюю сложность O(1), и время не зависит от размера множества.
Неочевидные применения множеств
Множество применяется не только ради уникальности, но и ради быстрой проверки принадлежности.
-
Удаление дубликатов из списка.
unique_list = list(set(duplicated_list)) -
Подсчёт элементов, встречающихся сразу в двух коллекциях.
common = set(list1) & set(list2) -
Фильтрация «мусора» при разборе данных.
valid_tags = {'python', 'tutorial', 'advanced'}
tags = ['python', 'beginner', 'advanced']
filtered_tags = [tag for tag in tags if tag in valid_tags]
# ['python', 'advanced']
Первый способ не сохраняет порядок. Если порядок важен, необходимо проходить по списку и вручную отмечать встреченные элементы в множестве; способ реализации показан в главе про сложность.
frozenset: неизменяемое множество
Обычные множества изменяемы и потому нехешируемы: вложить их в другое множество или сделать ключом словаря не удастся. Правило то же, что с кортежами и списками: хешируемо только то, что не изменяется. Неизменяемый вариант множества называется frozenset.
# Множество множеств? Нет.
# {set([1,2]), set([3,4])}  # TypeError: unhashable type: 'set'

# А так — можно.
fs1 = frozenset([1, 2])
fs2 = frozenset([3, 4])
meta_set = {fs1, fs2}  # Valid
Словари (dict): сердце Python
Словарь является наиболее нагруженной структурой в языке. На нём построены пространства имён модулей, атрибуты объектов и передача именованных аргументов. Начиная с Python 3.7 словарь гарантированно сохраняет порядок добавления элементов; ранее это было деталью реализации CPython 3.6, не оговорённой в языке.
Малоизвестные возможности словарей
-
Метод
setdefault()возвращает значение по ключу, а при отсутствующем ключе сначала помещает в словарь указанное значение, за один поиск по хеш-таблице вместо двух.data = {} # Классический, но неэффективный способ if 'key' not in data: data['key'] = [] data['key'].append(1) # Эффективный способ с setdefault data.setdefault('key', []).append(1) -
Метод
popitem()удаляет и возвращает пару(ключ, значение)в порядке LIFO (последним пришёл, первым ушёл). Полезен для обработки данных в обратном порядке. -
Словарные включения (Dict Comprehensions).
squares = {x: x*x for x in range(5)}
# {0: 0, 1: 1, 2: 4, 3: 9, 4: 16}
Коллекции из модуля collections
Для частых сценариев в стандартной библиотеке предусмотрены готовые надстройки над четырьмя базовыми типами. Counter, defaultdict и OrderedDict являются подклассами словаря, а deque поддерживает интерфейс последовательности, поэтому большая часть кода работает с ними без изменений. Исключения всё же есть: у дека нет срезов, а defaultdict создаёт ключ уже при чтении d[k].
-
defaultdict, словарь с фабричной функцией, отвечающей за недостающие ключи.from collections import defaultdict graph = defaultdict(list) graph['a'].append('b') # Не нужно проверять, есть ли ключ 'a' -
Counter, подкласс словаря, подсчитывающий хешируемые объекты.from collections import Counter words = ['apple', 'banana', 'apple', 'orange'] word_count = Counter(words) print(word_count.most_common(1)) # [('apple', 2)] -
deque, двусторонняя очередь, пополняемая с обоих концов. Подходит для очередей (FIFO) и стеков (LIFO).from collections import deque queue = deque([1, 2, 3]) queue.append(4) # O(1) queue.popleft() # O(1) — в отличие от списка! -
OrderedDict, словарь, сохраняющий порядок. В Python 3.7+ обычныйdictтакже упорядочен, но уOrderedDictесть дополнительные методы (move_to_end,popitem(last=True/False)).
Заключение
Выбор коллекции определяет эффективность и корректность программы. Это решение принимается в начале, когда переписывание ещё обходится дёшево.
- Список применяется, когда важен порядок и данные изменяются.
- Кортеж подходит, когда данные фиксированы или требуется хешируемый объект.
- Множество выбирается ради уникальности и быстрой проверки вхождения.
- Словарь уместен, когда у данных есть естественный ключ.
- Специализированные коллекции из модуля
collectionsнеобходимы тогда, когда стандартная четвёрка обрастает обвязкой из проверок и заглушек.
В следующей главе эти рекомендации переводятся в числа: во что обходится каждая операция и как измерить это самостоятельно.
Задание. Собрать словарь цепочек и сгенерировать по нему текст: «Генерация текста на основе данных».
Сложность операций с коллекциями
Здесь рассматривается, во что обходятся конкретные операции над списком, множеством и словарём и почему выбор структуры определяет больше, чем оптимизация кода. Сама O-нотация со всей строгостью разбирается далее, в главе «Введение в алгоритмы».
В настоящей главе оценивается стоимость каждой операции над коллекциями Python и обсуждается выбор структуры, соответствующей задаче.
Слайды к главе. Материал главы изложен также в шестой части лекции «Python. Начало» с замерами в терминале; слайды лекции доступны на сайте книги и в PDF.
В нотации O-большое описывается, как время выполнения алгоритма растёт вслед за размером входных данных.
Значение сложности
Ниже миллион чисел помещается в список и в множество, после чего в каждом из них выполняется поиск одного и того же значения оператором in. Синтаксис не отличается ни одним символом, отличается работа, выполняемая внутри:
from timeit import timeit
import random

# Сравним поиск в списке и множестве
large_list = list(range(1000000))
large_set = set(large_list)

# Ищем случайный элемент
target = random.randrange(1000000)

# Время поиска в списке (O(n))
list_time = timeit(lambda: target in large_list, number=1000)
# Время поиска в множестве (O(1))
set_time = timeit(lambda: target in large_set, number=1000)

print(f"Поиск в списке: {list_time:.4f} сек")
print(f"Поиск в множестве: {set_time:.4f} сек")
Разрыв составляет несколько порядков. Списку приходится перебирать элементы подряд, пока не будет найден нужный, — в среднем полмиллиона сравнений. Множество вычисляет от значения хеш и сразу обращается к ячейке, соответствующей этому хешу, обходясь одной операцией независимо от того, миллион там элементов или десять.
Сложность операций со списками
Константное время O(1)
my_list = [1, 2, 3, 4, 5]

# Эти операции выполняются за постоянное время
my_list.append(6)      # Добавление в конец
last = my_list.pop()   # Удаление с конца
element = my_list[2]   # Доступ по индексу
length = len(my_list)  # Получение длины
Почему O(1): список в Python устроен как динамический массив указателей. Он выделяет память с запасом, поэтому append записывает указатель в свободную ячейку и увеличивает счётчик длины, не перемещая остальные элементы.
Изредка запас исчерпывается, и списку приходится выделить больший блок памяти и скопировать туда все элементы, что стоит \( O(n) \). Однако поскольку размер увеличивается кратно, перевыделения происходят всё реже, и в среднем на одну операцию по-прежнему приходится константа. Такую усреднённую сложность называют амортизированной \( O(1) \).
Линейное время O(n)
my_list = [1, 2, 3, 4, 5]

# Эти операции требуют обхода или сдвига элементов
my_list.insert(0, 0)   # Вставка в начало → сдвиг всех элементов
my_list.remove(3)      # Поиск и удаление элемента
element in my_list     # Поиск элемента
my_list.index(4)       # Поиск индекса элемента
Почему O(n): при вставке в начало все элементы, следующие далее, приходится сдвигать на одну позицию. А in, remove и index проходят по списку с начала, сравнивая элементы: заранее известного места под значение у массива нет.
Медленный и быстрый код
Обе функции ниже удаляют дубликаты с сохранением порядка. Отличие в одной строке: первая проверяет item not in result по списку, вторая обращается к множеству seen. За строкой внутри цикла скрывается ещё один проход по всем элементам, превращающий линейный алгоритм в квадратичный.
# НЕЭФФЕКТИВНО: O(n²)
def remove_duplicates_slow(data):
    result = []
    for item in data:
        if item not in result:  # O(n) для каждого элемента!
            result.append(item)
    return result

# ЭФФЕКТИВНО: O(n)
def remove_duplicates_fast(data):
    seen = set()
    result = []
    for item in data:
        if item not in seen:    # O(1) проверка!
            seen.add(item)
            result.append(item)
    return result

# Тестируем на семи тысячах случайных чисел
import random
data = [random.randrange(7000) for _ in range(7000)]

slow_time = timeit(lambda: remove_duplicates_slow(data), number=1)
fast_time = timeit(lambda: remove_duplicates_fast(data), number=1)

print(f"Медленная версия: {slow_time:.4f} сек")   # 0.0520
print(f"Быстрая версия:   {fast_time:.4f} сек")   # 0.0002
Разница составляет двести пятьдесят раз, и растёт она вместе с объёмом. На семидесяти тысячах элементов медленная версия выполняется за 4.6 секунды против 2 миллисекунд у быстрой, то есть отстаёт почти в две тысячи раз. Время первой выросло в девяносто раз при десятикратном росте данных: это и есть квадратичность.
Следует отметить тонкость самого измерения. Если вместо случайных чисел подставить набор [1, 2, 2, 3, 4, 4, 5] * 1000, содержащий те же семь тысяч элементов, разница сократится до полутора раз вместо двухсот пятидесяти. Причина в том, что различных значений там всего пять. Список result, растущий только на новых значениях, не превысит пяти элементов, проверка item not in result пройдёт по пяти элементам вместо тысяч, и квадратичность не проявится.
Алгоритм проверяется на данных, приближенных к реальным. На неудачно подобранном наборе квадратичный код не вызывает подозрений, а проблема проявляется на реальных данных.
Сложность операций с множествами
В основе множества лежит хеш-таблица, рассмотренная в главе про хеш-функции, поэтому большинство операций имеют сложность O(1).
my_set = {1, 2, 3, 4, 5}

# O(1) операции
my_set.add(6)           # Добавление
my_set.remove(3)        # Удаление
4 in my_set             # Проверка вхождения
len(my_set)             # Длина

# операции над двумя множествами — сложность у каждой своя
s1 = {1, 2, 3}
s2 = {3, 4, 5}
union = s1 | s2         # объединение:  O(len(s1) + len(s2))
intersection = s1 & s2  # пересечение:  O(min(len(s1), len(s2)))
difference = s1 - s2    # разность:     O(len(s1))
Для построения объединения необходимо пройти оба множества целиком. Для пересечения достаточно перебрать элементы меньшего множества и проверить каждый в большем, причём проверка по хешу стоит константу. Поэтому пересечение множества из тысячи элементов с множеством из двух миллионов выполняется за десятки микросекунд, а объединение тех же двух занимает на три порядка дольше.
Интересный факт: при массовых коллизиях хешей операции с множеством вырождаются в O(n). На практике это почти не встречается, за исключением случаев, когда данные намеренно подобраны злоумышленником, знающим хеш-функцию.
Сложность операций со словарями
Словари также построены на хеш-таблицах, поэтому всё, что выполняется по ключу, стоит O(1). Любая операция, вынужденная просмотреть все значения, стоит O(n), сколь бы коротко она ни записывалась.
my_dict = {'a': 1, 'b': 2, 'c': 3}

# O(1) операции
my_dict['d'] = 4        # Вставка/обновление
value = my_dict['a']    # Доступ
del my_dict['b']        # Удаление
'a' in my_dict          # Проверка ключа

# O(n) операции
list(my_dict.keys())    # Создание списка ключей
list(my_dict.values())  # Создание списка значений
'value' in my_dict.values()  # Поиск по значениям
Вычисление сложности на практике
Метод 1. Анализ вложенных циклов
# O(n²) — квадратичная сложность
def find_pairs_quadratic(items):
    pairs = []
    for i in range(len(items)):          # O(n)
        for j in range(i + 1, len(items)):  # O(n)
            pairs.append((items[i], items[j]))  # O(1)
    return pairs

# O(n) — линейная сложность
def count_unique(items):
    seen = set()
    for item in items:                   # O(n)
        seen.add(item)                   # O(1)
    return len(seen)                     # O(1)
Сложности вложенных циклов перемножаются, а сложности участков, следующих подряд, складываются: один цикл по всем элементам даёт \( O(n) \), а цикл, вложенный в цикл, \( O(n^2) \). Оценивать следует не отступы, а суть: вызов item not in some_list внутри цикла также является скрытым вложенным циклом, хотя выглядит как одна строка.
Метод 2. Учёт дорогостоящих операций
Вложенные циклы видны сразу, а вызовы библиотечных функций остаются незаметными. sorted стоит \( O(n \log n) \), list(...) и sum(...) обходятся в \( O(n) \), min и max также в \( O(n) \). При разборе функции эти стоимости подставляются и складываются.
def process_data(data):
    result = []

    # Сортировка: O(n log n)
    sorted_data = sorted(data)           # O(n log n)

    # Поиск каждого элемента: O(n) × O(log n) = O(n log n)
    for target in sorted_data:           # O(n)
        # Бинарный поиск: O(log n)
        # (предположим, что у нас есть реализация)
        index = binary_search(sorted_data, target)
        result.append(index)

    return result

# Общая сложность: O(n log n) + O(n log n) = O(n log n)
Метод 3. Практическое измерение
Сложность можно измерить, выполнив операцию на входах разного размера и проследив, как растёт время. Одну быструю операцию измерить нельзя. Вставка в список занимает микросекунды, разрешение таймера и случайный шум того же порядка, и вместо зависимости будут получены помехи. Поэтому операция повторяется много раз, и это обеспечивает timeit.
from timeit import timeit

print(f"{'размер':>8} {'время, мкс':>12} {'отношение':>10}")
prev = None
for size in [10_000, 20_000, 40_000, 80_000, 160_000]:
    setup = f"data = list(range({size}))"
    # вставляем и тут же удаляем, чтобы список не рос за время замера
    t = timeit("data.insert(0, -1); data.pop(0)", setup=setup, number=2000) / 2000
    ratio = f"{t / prev:.1f}x" if prev else "—"
    print(f"{size:8} {t * 1e6:12.1f} {ratio:>10}")
    prev = t
  размер   время, мкс  отношение
   10000          4.4          —
   20000          8.0        1.8x
   40000         15.7        2.0x
   80000         33.1        2.1x
  160000         62.0        1.9x
Линейная сложность: удвоение размера удваивает время. В измерении важны две детали. Подготовка списка вынесена в setup, иначе в измеряемое время попало бы его создание. После каждой вставки элемент удаляется, иначе за две тысячи повторов растущий список исказил бы результат.
Если проделать то же самое с append, окажется, что время вызова не зависит от размера.
Практические правила для выбора коллекций
Область применения списков
Список является выбором по умолчанию. Он необходим, когда важен порядок элементов и доступ по индексу, когда данные добавляются и извлекаются с конца и когда повторяющиеся значения допустимы или осмысленны.
Список плохо приспособлен к работе с началом: insert(0, x) и pop(0), требующие сдвига всего хвоста, стоят \(O(n)\) каждая. На больших данных это превращается в квадратичное время; там требуется дек, рассмотренный в главе про структуры данных и приспособленный к работе с обоими концами.
Область применения множеств
Множество применяется ради проверки принадлежности. Она стоит \(O(1)\) против \(O(n)\) у списка. Фильтрация миллиона событий по списку разрешённых идентификаторов займёт минуты, а через множество — доли секунды. Попутно множество удаляет дубликаты и поддерживает объединение, пересечение и разность.
Множество не подходит в двух случаях: если важен порядок вставки, поскольку множество его не хранит; и если элементы нехешируемы, поскольку списки и словари в множество поместить нельзя.
Область применения словарей
Словарь необходим там, где у данных есть естественный ключ, будь то имя канала, номер события или дата измерения. Поиск по ключу стоит \(O(1)\), поэтому словарь заменяет перебор списка везде, где приходится искать запись, у которой поле равно заданному значению. На нём же удобно группировать, отводя под ключ категорию, а под значение список объектов, попадающих в неё.
С версии Python 3.7 словарь сохраняет порядок вставки. Поиск по значению словарь не поддерживает: такой поиск стоит \(O(n)\). Если он требуется часто, имеет смысл завести второй словарь с обратным отображением.
Оптимизация на практике
Если по коллекции многократно выполняется поиск, её лучше преобразовать в множество или словарь один раз до цикла. Построение множества имеет тот же порядок \( O(m) \), что и один линейный поиск, хотя и с большей константой, поэтому оно окупается после нескольких поисков: \( n \) проверок обходятся в \( O(n + m) \) вместо \( O(n \cdot m) \).
# ПЛОХО: O(n²)
def find_common_elements_slow(list1, list2):
    result = []
    for item in list1:           # O(n)
        if item in list2:        # O(m) - линейный поиск!
            result.append(item)
    return result

# ХОРОШО: O(n + m)
def find_common_elements_fast(list1, list2):
    set2 = set(list2)            # O(m) - создание множества
    result = []
    for item in list1:           # O(n)
        if item in set2:         # O(1) - поиск в хеш-таблице!
            result.append(item)
    return result
Некоторые правила сложности
- O(1) < O(log n) < O(n) < O(n log n) < O(n²) — эту иерархию необходимо запомнить.
- Особого внимания требуют вложенные циклы, дающие O(n²): внутренний цикл часто скрыт за вызовом наподобие
x in list. - Структура подбирается под операцию: множества и словари для поиска, списки для последовательного перебора, дек для работы с обоих концов.
Преждевременная оптимизация вредна: подбор констант в коде, выполняемом раз в сутки, является напрасной тратой времени. Однако выбор структуры данных к ней не относится: от него зависит, останется программа работоспособной на реальных данных или нет.
Задание. Решить задачи с разбором сложности: «Решение задач на Python и анализ сложности».
Функции
Функция является первым инструментом борьбы со сложностью: фрагмент логики, скрытый за именем, в дальнейшем не требуется удерживать в памяти.
Слайды к главе. Материал главы изложен также в первых четырёх частях лекции «Функции в Python» (функция как объект, аргументы, области видимости, функциональный стиль), продолжение лекции относится к главе «Декораторы и functools»; слайды лекции доступны на сайте книги и в PDF.
Синтаксис объявления функций
Базовый синтаксис
Имя функции в Python может содержать буквы, цифры и символ подчёркивания _, но не может начинаться с цифры. Буквы допускаются из любого алфавита (PEP 3131), однако принято использовать латиницу и английские слова: PEP 8 требует этого от стандартной библиотеки и рекомендует открытым проектам.
def foo():
    return 42

foo()  # возвращает 42
Оператор return не является обязательным, и функция, обходящаяся без него, возвращает None.
def foo():
    42

print(foo())  # выводит None
Если хотя бы одна ветвь функции возвращает значение, PEP 8 требует единообразия: остальные ветви также завершаются явным return, при необходимости return None, и тогда отсутствие результата видно как предусмотренное.
Документирование функций
Для документирования используются строковые литералы (docstring), расположенные первыми в теле функции.
def foo():
    """I return 42."""
    return 42
Документация доступна через атрибут __doc__ или функцию help().
foo.__doc__  # 'I return 42.'
help(foo)    # показывает документацию
Для научного кода принят формат строк документации NumPy: после краткого описания следуют разделы Parameters (имя, тип, смысл и единицы измерения каждого параметра), Returns (тип и смысл результата), Raises (возбуждаемые исключения) и Examples (вызовы с ожидаемым выводом в формате интерактивной оболочки). Так документированы NumPy, SciPy и Astropy, а генератор документации Sphinx с расширением numpydoc собирает из таких строк справочник.
def kinetic_energy(m, v):
    """Кинетическая энергия тела.

    Parameters
    ----------
    m : float
        Масса, кг.
    v : float
        Скорость, м/с.

    Returns
    -------
    float
        Энергия, Дж.

    Examples
    --------
    >>> kinetic_energy(2.0, 3.0)
    9.0
    >>> kinetic_energy(1.0, 1.0)
    0.5
    """
    return m * v ** 2 / 2
Раздел Examples проверяется автоматически. Модуль doctest находит в строках документации фрагменты, начинающиеся с >>>, выполняет их и сравнивает вывод с записанным. Команда python3 -m doctest phys.py ничего не выводит, если все примеры сошлись, а с ключом -v печатает подробный отчёт. Если в формуле пропущено деление на два, отчёт указывает на расхождение.
Failed example:
    kinetic_energy(2.0, 3.0)
Expected:
    9.0
Got:
    18.0
Пример с известным ответом (тело массой 2 кг при скорости 3 м/с обладает энергией 9 Дж) одновременно документирует функцию и проверяет её формулу. Вывод сравнивается как текст, поэтому для вещественных результатов подбирают точно представимые ответы, такие как 9.0 и 0.5, или печатают округлённое значение. Расхождение документации с кодом обнаруживается при очередном запуске doctest, и его включают в проверки проекта наравне с тестами.
Функция как объект
Инструкция def создаёт объект класса function и связывает его с именем. Функции в Python являются объектами первого класса: функцию связывают со вторым именем, хранят в списке или словаре, передают в аргументе другой функции и возвращают из функции. Интегратору scipy.integrate.quad(f, a, b) безразлично, как устроена переданная функция f, вычисляет ли она формулу или интерполирует таблицу: он лишь вызывает её в выбранных им точках.
Объект функции хранит сведения о ней в атрибутах.
| Атрибут | Содержимое |
|---|---|
__name__, __qualname__ | имя и полное имя с учётом вложенности |
__doc__ | строка документации |
__defaults__, __kwdefaults__ | значения параметров по умолчанию |
__code__ | объект кода: байт-код, имена локальных переменных |
__annotations__ | аннотации параметров и результата |
__closure__ | ячейки замыкания |
__globals__ | словарь глобальных имён модуля |
Аннотации типов
Параметры и результат функции снабжаются аннотациями: после имени параметра через двоеточие указывается тип, после списка параметров через стрелку — тип результата.
def mean(xs: list[float], w: list[float] | None = None) -> float:
    ...

mean.__annotations__
# {'xs': list[float], 'w': list[float] | None, 'return': <class 'float'>}
Синтаксис аннотаций появился в Python 3.0 (PEP 3107), их смысл как подсказок типов закрепил PEP 484 вместе с модулем typing (Python 3.5). С версии 3.9 встроенные коллекции указываются как list[float] без импорта из typing (PEP 585), с 3.10 объединение типов записывается через вертикальную черту: float | None (PEP 604). В Python 3.14 аннотации вычисляются отложенно, при первом обращении (PEP 649 и 749).
Интерпретатор аннотации сохраняет, но не проверяет. Вызов area("2") для функции area(r: float), возводящей радиус в квадрат, выполняется, и ошибка TypeError возникает уже внутри тела, на возведении строки в степень. Соответствие типов проверяют статические анализаторы mypy и pyright, а редакторы кода используют аннотации для подсказок. Единицы измерения аннотации не выражают, их по-прежнему указывают в документации.
Работа с аргументами
Позиционные и именованные аргументы
Аргументы могут передаваться двумя способами, свободно сочетаемыми в одном вызове. Позиционные разбираются по порядку, именованные — по имени параметра, поэтому их порядок роли не играет.
def min_of(x, y):
    return x if x < y else y

min_of(-5, 12)        # -5
min_of(x=-5, y=12)    # -5
min_of(y=12, x=-5)    # -5 (порядок не важен)
Функция названа min_of, а не min, чтобы не закрывать встроенную min (см. правило LEGB ниже). Позиционные аргументы следуют первыми. Запись min_of(x=-5, 12) недопустима и завершается ошибкой SyntaxError: positional argument follows keyword argument: интерпретатор не может определить, к какому параметру относится 12.
Упаковка позиционных аргументов
Произвольное количество аргументов принимает *args: звёздочка перед именем параметра собирает все лишние позиционные аргументы в кортеж под этим именем.
def min_of(*args):
    res = float("inf")
    for arg in args:
        if arg < res:
            res = arg
    return res

min_of(-5, 12, 13)  # -5
min_of()            # inf
При вызове без аргументов args представляет собой пустой кортеж, цикл не выполняется, и функция возвращает начальное значение, хотя минимума у пустого набора нет. Чтобы гарантировать хотя бы один аргумент, его выносят в отдельный обязательный параметр, расположенный перед *args.
def min_of(first, *args):
    res = first
    for arg in args:
        if arg < res:
            res = arg
    return res

min_of()  # TypeError: min_of() missing 1 required positional argument: 'first'
Распаковка аргументов
Звёздочка работает и в обратную сторону, разбирая в месте вызова готовую последовательность на отдельные аргументы. Подходит любой итерируемый объект: список, кортеж, множество или генератор.
xs = {-5, 12, 13}
min_of(*xs)           # -5
min_of(*[-5, 12, 13]) # -5
min_of(*(-5, 12, 13)) # -5
С Python 3.5 (PEP 448) звёздочек в одном вызове может быть несколько, и между ними допускаются обычные аргументы: min_of(*xs, 0, *ys).
Параметры после *args и значения по умолчанию
Всё, что записано в объявлении после *args, может быть передано только по имени, поскольку позиции для этих параметров уже исчерпаны. Таким образом оформляются необязательные настройки со значением по умолчанию, которое вызывающая сторона изменяет явно.
def bounded_min(first, *args, lo=float("-inf"), hi=float("inf")):
    res = None
    for arg in (first,) + args:
        if lo <= arg <= hi and (res is None or arg < res):
            res = arg
    return res

bounded_min(-5, 12, 13, lo=0, hi=255)  # 12
bounded_min(-5, lo=0, hi=255)          # None
Из трёх чисел в отрезок [0, 255] попадают 12 и 13, минимальное из них равно 12; значение −5 отброшено как выходящее за нижнюю границу, которую задаёт параметр lo. Если в отрезок не попадает ни одно число, функция возвращает None: любое число в качестве ответа было бы неотличимо от настоящего минимума.
Опасность изменяемых значений по умолчанию
Значение по умолчанию вычисляется один раз, при выполнении инструкции def, а не при каждом вызове, и хранится в атрибуте функции __defaults__. Для числа или строки это незаметно, но изменяемый объект, созданный однажды, окажется общим для всех вызовов и будет накапливать состояние между ними.
def unique(iterable, seen=set()):
    acc = []
    for item in iterable:
        if item not in seen:
            seen.add(item)
            acc.append(item)
    return acc

xs = [1, 1, 2, 3]
unique(xs)  # [1, 2, 3]
unique(xs)  # [] 😱
unique.__defaults__  # ({1, 2, 3},)
Второй вызов на тех же данных возвращает пустой список, поскольку множество seen уже содержит все числа с предыдущего вызова, что и показывает __defaults__. В объявлении указывается None, а настоящее множество создаётся внутри функции при каждом вызове.
def unique(iterable, seen=None):
    seen = set() if seen is None else set(seen)
    acc = []
    for item in iterable:
        if item not in seen:
            seen.add(item)
            acc.append(item)
    return acc

xs = [1, 1, 2, 3]
unique(xs)  # [1, 2, 3]
unique(xs)  # [1, 2, 3] ✅
Переданная коллекция копируется в новое множество, и объект вызывающей стороны не изменяется. Проверка is None надёжнее распространённой записи seen or []: оператор or подставляет значение по умолчанию вместо любого ложного значения. Настройка k = k or 1.0 без сообщения об ошибке превратит переданный коэффициент 0.0 в 1.0, а для массива NumPy из нескольких элементов завершится ошибкой ValueError, поскольку истинность такого массива не определена.
Только именованные параметры
Можно потребовать, чтобы некоторые аргументы передавались только по имени. Одиночная звёздочка без имени отделяет такие параметры, не собирая лишних позиционных аргументов (PEP 3102).
def flatten(xs, *, depth=None):
    pass

flatten([1, [2], 3], depth=1)  # ✅
flatten([1, [2], 3], 1)        # TypeError
Так оформляют настройки расчёта. По вызову integrate(g, 0, 1, 1e-6, 100) не понять, где допуск, а где число узлов, тогда как запись integrate(g, 0, 1, tol=1e-6, n=100) понятна без документации, а ошибочный позиционный вызов завершается TypeError.
Только позиционные параметры
Обратное ограничение задаёт косая черта: параметры, записанные до /, передаются только по позиции (PEP 570, Python 3.8). Имена таких параметров не входят в интерфейс функции и могут меняться без последствий для вызывающего кода; так объявлены многие встроенные функции, например len(obj, /).
def f(a, b, /, c, *args, d=1, **kw):
    return a, b, c, args, d, kw

f(1, 2, 3)                  # (1, 2, 3, (), 1, {})
f(1, 2, 3, 4, 5, d=6, e=7)  # (1, 2, 3, (4, 5), 6, {'e': 7})
f(1, 2, c=3)                # (1, 2, 3, (), 1, {})

def g(a, /):
    return a

g(a=1)  # TypeError: g() got some positional-only arguments passed as keyword arguments: 'a'
Сигнатура f содержит все виды параметров в обязательном порядке: только позиционные, обычные, *args, только именованные, **kw.
Упаковка именованных аргументов
Две звёздочки выполняют с именованными аргументами то же, что одна с позиционными, собирая в словарь всё, что не опознано по именам. Аналогично они работают и в вызове, раскладывая словарь по именам параметров, поэтому отдельный набор настроек передаётся целиком.
def runner(cmd, **kwargs):
    if kwargs.get("verbose", True):
        print("Logging enabled")

runner("mysqld", limit=42)                    # ✅
runner("mysqld", **{"verbose": False})        # ✅
options = {"verbose": False}
runner("mysqld", **options)                   # ✅
Имена args и kwargs являются соглашением, а не требованием языка: значение имеют только звёздочки. Сочетание обеих даёт универсальную обёртку def wrapper(*args, **kwargs): return f(*args, **kwargs), которая передаёт любые аргументы без изменений; на ней построены декораторы.
Распаковка и присваивание
Базовая распаковка
Распаковка работает в любом присваивании. Слева записывается структура, составленная из имён, справа располагается итерируемый объект, и Python раскладывает второе по первому, причём форма слева может повторять вложенность справа.
x, y, z = [1, 2, 3]           # ✅
x, y, z = {1, 2, 3}           # ✅ (но порядок не гарантирован!)
x, y, z = "xyz"               # ✅

# Распаковка вложенных структур
rectangle = (0, 0), (4, 4)
(x1, y1), (x2, y2) = rectangle
С множеством код выполнится, но число, попавшее в x, не определено, поскольку порядка у множества нет.
Расширенная распаковка (Python 3.0+)
Звёздочка слева от знака равенства собирает «всё остальное» в список (PEP 3132). Имя, помеченное ею, может располагаться в начале, в конце или в середине; Python сначала распределяет значения по обычным именам, а остаток, не разобранный ими, достаётся звёздочке.
first, *rest = range(1, 5)           # first=1, rest=[2, 3, 4]
first, *rest, last = range(1, 5)     # first=1, rest=[2, 3], last=4

# Можно использовать в любом месте
*_, (first, *rest) = [range(1, 5)] * 5
Имя со звёздочкой может получить и пустой список, тогда как обычные имена обязаны получить по значению. Если значений не хватает даже на них, возникает ошибка.
first, *rest, last = [42] # ValueError
Строка файла данных вида «время, номер канала, отсчёты» разбирается одним присваиванием: t, ch, *counts = line.split().
Распаковка в цикле for
Заголовок цикла также является присваиванием, поэтому распаковка работает и там. Элементы, следующие подряд, могут быть разной длины: обычные имена получат своё, а звёздочка соберёт остаток.
for a, *b in [range(4), range(2)]:
    print(b)
# Вывод:
# [1, 2, 3]
# [1]
Распаковка в литералах (Python 3.5+)
Звёздочки допускаются и внутри литералов коллекций (PEP 448): одна звёздочка раскладывает последовательность, две — словарь.
old, new = [1, 2], (3, 4)
points = [*old, *new]          # [1, 2, 3, 4]

defaults = {"n": 1000, "rule": "simpson"}
user = {"n": 10_000}
config = {**defaults, **user}  # {'n': 10000, 'rule': 'simpson'}
При совпадении ключей сохраняется значение из правого словаря, поэтому пользовательские настройки перекрывают значения по умолчанию; с Python 3.9 то же записывается как defaults | user.
Области видимости (Scopes)
Функции внутри функций
Функции в Python относятся к объектам первого класса, а потому их определяют внутри других функций, передают в аргументах, возвращают как результат. def, вложенный в def, представляет собой обычное присваивание, только локальное.
def wrapper():
    def identity(x):
        return x
    return identity

f = wrapper()
f(42)  # 42
Правило LEGB
Интерпретатор ищет имя в четырёх областях по порядку и останавливается на первой найденной:
- Local (локальная), имена, объявленные внутри самой функции.
- Enclosing (объемлющая), имена объемлющей функции, если эта вложена в другую.
- Global (глобальная), имена уровня модуля.
- Built-in (встроенная), имена, доступные всегда, например
len,printиmin.
min = 42  # global

def f(*args):
    min = 2  # enclosing
    def g():
        min = 4  # local
        print(min)
Здесь три разных min; g печатает свой, локальный. Если из g удалить строку с присваиванием, печататься начнёт min, объявленный в f; если удалить её и оттуда, будет напечатана глобальная 42. Поэтому переменные не называют именами встроенных функций: встроенный min, последнее звено цепочки, оказывается закрытым. Ошибка проявляется далеко от места присваивания: после len = 5 вызов len("abc") завершается ошибкой TypeError: 'int' object is not callable.
Замыкания и позднее связывание
Имя, которое функция не определяет сама, разрешается не при объявлении, а в момент вызова; это называется поздним связыванием. Функция f ниже не знает, откуда возьмётся i, и при каждом вызове обращается к значению, находящемуся под этим именем в текущий момент.
def f():
    print(i)

for i in range(4):
    f()
# Вывод:
# 0
# 1
# 2
# 3
Замыкания здесь ещё нет: i является обычным глобальным именем. Замыкание возникает, когда вложенная функция использует имя, взятое из объемлющей, и продолжает использовать его даже после того, как та завершилась.
def make_adder(step):
    def add(x):
        return x + step      # step взят из объемлющей функции
    return add

add5 = make_adder(5)
print(add5(10))                          # 15
print(add5.__closure__[0].cell_contents) # 5 — значение хранится в ячейке замыкания
Функция make_adder давно завершилась, её локальные переменные должны были исчезнуть, но step сохраняется благодаря add, ссылающейся на него. На этом механизме построены декораторы, рассматриваемые в главе «Декораторы и functools». Той же схемой пользуются для моделей с параметрами: фабрика make_gaussian(mu, sigma) возвращает функцию одной переменной x с закреплёнными параметрами распределения, пригодную для интегрирования и построения графика. Для подгонки curve_fit, наоборот, модель принимает подбираемые параметры аргументами: model(x, mu, sigma).
Позднее связывание и замыкания вместе образуют ловушку. Функции, созданные в цикле, захватывают переменную, а не значение, записанное в ней, и после цикла все они видят последнее значение.
funcs = [lambda: i for i in range(3)]
print([f() for f in funcs])          # [2, 2, 2], а не [0, 1, 2]

funcs = [lambda i=i: i for i in range(3)]
print([f() for f in funcs])          # [0, 1, 2]
Во втором варианте значение фиксируется аргументом по умолчанию, вычисляемым, в отличие от тела функции, сразу при её создании. Тот же результат дают functools.partial, закрепляющий значения аргументов в момент создания, и фабрика функций, создающая на каждый вызов отдельную ячейку замыкания. При переборе параметров физической модели ловушка не сопровождается сообщением об ошибке: список моделей, построенный в цикле лямбдами и вызываемый после цикла, вычисляет всё с последним значением параметра, и ошибка видна только по совпадению результатов. Лямбда, вызванная в той же итерации, например интеграл quad(lambda x: s * x, 0, 1) внутри цикла по s, вычисляется верно.
Присваивание и области видимости
Чтение имени возможно из любой внешней области, а присваивание всегда создаёт локальную переменную. Решение принимается при компиляции функции и распространяется на всё её тело, поэтому min += 1 завершается ошибкой не на присваивании, а на попытке прочитать локальную min, ещё не получившую значения; начиная с Python 3.11 сообщение звучит как cannot access local variable 'min' where it is not associated with a value, в прежних версиях — local variable 'min' referenced before assignment.
min = 42

def f():
    min += 1  # UnboundLocalError!
    return min
Оператор global
Чтобы изменять глобальную переменную, а не создавать одноимённую локальную, о намерении необходимо заявить явно.
min = 42

def f():
    global min
    min += 1
    return min

f()  # 43
f()  # 44
Многословность здесь намеренная: функция, изменяющая глобальное состояние, перестаёт быть предсказуемой, и её результат зависит от числа предыдущих вызовов. global используется только там, где без него нельзя обойтись.
Оператор nonlocal (Python 3+)
nonlocal выполняет то же самое, но для объемлющей функции, а не для модуля (PEP 3104). Именно он позволяет вложенной функции присвоить новое значение переменной той функции, в которую она вложена; на этом основаны счётчики и накопители внутри декораторов.
def cell(value=None):
    def get():
        return value
    def set(update):
        nonlocal value
        value = update
    return get, set

get, set = cell()
set(42)
get()  # 42
Две функции разделяют одну переменную value, существующую столько же, сколько они сами. Интерпретатор хранит её в ячейке, на которую ссылается кортеж get.__closure__; помимо get и set, к ней обращаются только через этот служебный атрибут, предназначенный для отладки: get.__closure__[0].cell_contents.
Функциональное программирование
Анонимные функции (lambda)
Функцию в одну строку, передаваемую в sorted или map, задаёт lambda. Её тело представляет собой одно выражение, и его значение становится результатом без return.
lambda arguments: expression

# Эквивалентно:
def <lambda>(arguments):
    return expression
Список параметров у лямбды такой же, как у обычной функции, со звёздочками и значениями по умолчанию.
lambda x: x ** 2
lambda foo, *args, bar=None, **kwargs: 42
Как только логика перестаёт умещаться в одну строку, ей дают имя через def. PEP 8 рекомендует всегда использовать def вместо присваивания лямбды имени: запись f = lambda x: ... ничем не лучше def f(x): ..., но у такой функции нет строки документации, а в трассировке ошибки вместо имени стоит <lambda>.
Функции map, filter, zip
Три встроенные функции покрывают три частые операции над последовательностью: преобразование каждого элемента, отбор нужных и одновременный проход по нескольким наборам. Все три ничего не вычисляют сразу, а возвращают ленивый объект, поэтому в примерах результат обёрнут в list. Такой объект является итератором и проходится один раз: второй list от того же объекта map вернёт пустой список.
map применяет функцию к каждому элементу, поступающему из источника.
list(map(lambda x: x % 7, [1, 9, 16, -1, 2, 5])) # [1, 2, 2, 6, 2, 5]
filter оставляет только элементы, для которых функция вернула истину. Если вместо функции передать None, фильтр отсеет всё ложное: нули, пустые коллекции и пустые строки.
list(filter(lambda x: x % 2 != 0, range(10)))  # [1, 3, 5, 7, 9]

# С None - оставляет только truthy значения
xs = [0, None, [], {}, set(), "", 42]
list(filter(None, xs))  # [42]
zip проходит по нескольким последовательностям параллельно и на каждом шаге возвращает кортеж, составленный из их элементов. Останавливается он по самой короткой, и лишние элементы длинных последовательностей теряются; с Python 3.10 параметр strict=True превращает несовпадение длин в ошибку ValueError.
list(zip("abc", range(3), [42j, 42j, 42j]))
# [('a', 0, 42j), ('b', 1, 42j), ('c', 2, 42j)]
Функцию в аргументе принимают и другие встроенные функции. sorted, min и max упорядочивают и выбирают элементы по функции-ключу key, а any и all прекращают перебор, как только результат известен. Модуль operator содержит готовые ключи: itemgetter выбирает элемент по индексу или ключу словаря, attrgetter — атрибут объекта.
from operator import itemgetter

events = [{"id": 1, "energy": 3.2}, {"id": 2, "energy": 7.9}]
max(events, key=itemgetter("energy"))  # {'id': 2, 'energy': 7.9}
Событие с наибольшей энергией найдено за один проход, без сортировки и промежуточного списка.
Включения коллекций
То же самое записывается через включения. Форма ниже читается как «взять x ** 2 для каждого x из range(10), если x нечётно». Второй пример показывает ту же операцию через map и filter. Два for подряд разворачивают вложенную структуру в плоский список; их порядок такой же, как во вложенных циклах.
[x ** 2 for x in range(10) if x % 2 == 1]  # [1, 9, 25, 49, 81]

# Эквивалент с map/filter:
list(map(lambda x: x ** 2, filter(lambda x: x % 2 == 1, range(10))))

# Вложенные включения:
nested = [range(5), range(8, 10)]
[x for xs in nested for x in xs]  # [0, 1, 2, 3, 4, 8, 9]
Тот же синтаксис применяется для множеств и словарей, отличаются только скобки. Фигурные скобки с одним выражением дают множество, и в первом примере совпавшие между собой остатки объединились; а с парой, разделённой двоеточием, получается словарь.
{x % 7 for x in [1, 9, 16, -1, 2, 5]}  # {1, 2, 5, 6}

date = {"year": 2014, "month": "September", "day": ""}
{k: v for k, v in date.items() if v}  # {'year': 2014, 'month': 'September'}

{x: x ** 2 for x in range(4)}  # {0: 0, 1: 1, 2: 4, 3: 9}
Во втором примере условие if v отбрасывает записи с пустым значением, и здесь действует та же истинность объектов, применяемая и в filter(None, ...).
map остаётся уместен с готовой функцией: list(map(float, fields)) короче включения [float(s) for s in fields]. Выражение-генератор в круглых скобках вычисляет значения по одному и не строит промежуточный список: sum(x * x for x in data) суммирует квадраты, не выделяя память под список квадратов. Генераторы рассматриваются в главе «Итераторы, генераторы и корутины».
Чистые функции
Чистой называют функцию, результат которой зависит только от аргументов и которая не имеет побочных эффектов: не изменяет аргументы, глобальные переменные и файлы. Такую функцию проще проверять, поскольку тест не требует подготовки окружения; её результат можно запомнить и не вычислять повторно, как делает functools.lru_cache; её вызовы выполняются параллельно без блокировок.
total = 0.0

def add_sample(x):     # нечистая: изменяет глобальное состояние
    global total
    total += x

def mean(xs):          # чистая
    return sum(xs) / len(xs)
Программа целиком из чистых функций не состоит: чтение данных и запись результатов являются побочными эффектами. Расчётное ядро удобно держать чистым, а ввод и вывод сосредоточить на его границе. Для моделирования со случайными числами это означает передачу генератора аргументом: функция, использующая глобальный генератор, даёт разные результаты при каждом запуске, а генератор numpy.random.default_rng(42), созданный с фиксированным зерном и переданный в функцию, делает расчёт воспроизводимым. Чистой такая функция не становится, поскольку каждый вызов меняет состояние генератора, но её результат определяется аргументами, включая генератор.
Параметры модели для интеграторов
Интеграторы, оптимизаторы и решатели SciPy ожидают функцию одной переменной (или вектора), а модель обычно зависит ещё и от параметров. Закрепить параметры можно несколькими способами.
import math
from functools import partial
from scipy.integrate import quad

def gauss(x, mu, sigma):
    return math.exp(-(x - mu) ** 2 / (2 * sigma ** 2))

quad(gauss, -5, 5, args=(0.0, 1.0))             # параметр args
quad(lambda x: gauss(x, 0.0, 1.0), -5, 5)       # лямбда
quad(partial(gauss, mu=0.0, sigma=1.0), -5, 5)  # partial
Многие функции SciPy (quad, minimize, solve_ivp) принимают дополнительные аргументы в параметре args и передают их вызываемой функции после основных переменных. Лямбда подставляет параметры при каждом вызове: литералы — как записаны, имена — по значению на момент вызова. functools.partial закрепляет значения при создании и, в отличие от лямбды, сериализуется модулем pickle, если сериализуемы исходная функция и закреплённые аргументы; это требуется при распараллеливании через multiprocessing, и сама функция при этом определяется в импортируемом модуле (см. главу «Многопоточность и GIL»). Замыкание или фабрика функций уместны, когда модель содержит собственную логику или состояние, но pickle их не сериализует.
Стоимость вызова функции
Вызов функции в Python имеет собственную стоимость: интерпретатор создаёт кадр, связывает аргументы и возвращает результат. Замеры python3 -m timeit на Python 3.12 для списка xs из 100 тысяч чисел и функции sq = lambda x: x * x показывают порядок этих затрат.
| Операция над 100 тысячами чисел | Время |
|---|---|
[x * x for x in xs] | 1,64 мс |
[sq(x) for x in xs] | 2,66 мс |
list(map(sq, xs)) | 3,10 мс |
цикл for с накоплением t += x | 1,17 мс |
sum(xs) | 0,25 мс |
Вызов функции добавил около 10 нс на элемент: 2,66 мс против 1,64 мс. Соотношение map и включения с вызовом зависит от версии интерпретатора: в других версиях map бывает быстрее. Встроенная sum в четыре-пять раз быстрее явного цикла, поскольку её цикл выполняется в функции на C, без исполнения байт-кода для каждого элемента. Отсюда не следует, что функций нужно избегать: 10 нс заметны только в цикле по миллионам элементов. Участок, на который приходится основное время работы, переносят во встроенные функции или в векторные операции NumPy, обрабатывающие весь массив одним вызовом; подробно это рассматривается в главе «Оптимизация средствами самого Python».
PEP 8 и стиль кода
Код читают чаще, чем пишут, и единый стиль экономит время всем участникам. PEP 8 является официальным соглашением о том, как выглядит код на Python; его соблюдение проверяют линтеры, например pycodestyle и ruff.
Базовые рекомендации
- 4 пробела для отступов, задающих структуру блока
- Максимум 79 символов в строке кода (72 символа для комментариев и строк документации)
lower_case_with_underscoresдля переменных и функцийUPPER_CASE_WITH_UNDERSCORESдля констант
Выражения и операторы
Пробелы вокруг операторов расставляются по приоритету, чтобы структура выражения была видна визуально. Тело if переносится на новую строку, поскольку однострочную запись труднее заметить при беглом чтении. Отрицание принадлежности записывается оператором not in, а не через not ... in: PEP 8 формулирует это правило для is not, а линтеры распространяют его и на in. Сравнение принято записывать в естественном порядке, с проверяемой переменной слева от значения. PEP 8 прямо этого не оговаривает, однако обратный порядок, так называемые условия Йоды, в Python не нужен: в C он защищает от случайного присваивания if (x = 5), а в Python присваивание = внутри условия является синтаксической ошибкой.
exp = -1.05
value = (item_value / item_count) * offset / exp
hypot2 = x*x + y*y

if bar:
    x += 1

if method == 'md5':
    pass

if key not in d:
    pass
Ниже приведены те же четыре конструкции в нерекомендуемой записи.
value = ( item_value/item_count )*offset/exp

if bar: x += 1

if 'md5' == method:
    pass

if not key in d:
    pass
Функции
В строке документации первая строка содержит краткое описание в одно предложение, затем следует пустая строка, затем при необходимости подробности. Кавычки тройные даже у однострочной записи, чтобы не изменять их, когда описание разрастётся.
def something_useful(arg, **options):
    """One-line summary.

    Optional longer description.
    """
    pass
Вокруг знака = у значения по умолчанию пробелы не ставятся, если параметр не аннотирован, и ставятся, если аннотирован; стрелка перед типом результата также окружается пробелами.
def scale(x, factor=2.0): ...
def scale(x: float, factor: float = 2.0) -> float: ...
Резюме
- Функция является объектом: её передают в аргументах, хранят и возвращают; аннотации документируют типы, но не проверяются
- Функции принимают произвольное количество позиционных (
*args) и именованных (**kwargs) аргументов; параметры до/передаются только по позиции, после*— только по имени - Синтаксис распаковки работает в вызовах функций, присваивании, циклах и литералах коллекций
- Имена ищутся по правилу LEGB: локальная, объемлющая, глобальная, встроенная область
- Присваивание создаёт локальную переменную; поведение, заданное по умолчанию, изменяется через
globalиnonlocal - Значение по умолчанию вычисляется один раз, при выполнении
def, поэтому изменяемым оно быть не должно - Для функций, созданных в цикле, значение фиксируют параметром по умолчанию,
partialили фабрикой - Python поддерживает элементы функционального программирования: lambda, map, filter, zip, включения коллекций
- Вызов функции стоит порядка 10 нс, что заметно только в циклах по миллионам элементов
- PEP 8 описывает, как должен выглядеть читаемый код, и правила, записанные в нём, проверяются линтерами
Итераторы, генераторы и корутины
В настоящей главе рассматриваются три родственных механизма языка, связанных одной идеей — не вычислять всё сразу. Итератор выдаёт элементы по одному, генератор позволяет приостанавливать выполнение функции и возвращаться в неё, а корутина, кроме того, принимает значения, переданные извне.
Эти механизмы позволяют обрабатывать файлы, не помещающиеся в память, и описывать бесконечные последовательности. Из генераторов выросла и асинхронность Python: первые корутины asyncio были генераторами, а нативные корутины async def используют тот же механизм приостановки функции. Сам asyncio рассматривается в главе, посвящённой асинхронности.
Слайды к главе. Материал главы изложен также в лекции «Итераторы, генераторы и корутины» (итераторы, генераторы, модуль itertools, сопрограммы, async и await) с демонстрациями в интерактивной оболочке; слайды лекции доступны на сайте книги и в PDF.
Итераторы
Устройство цикла for
Цикл for в Python не перебирает индексы: он получает у объекта итератор функцией iter и вызывает для него next, пока тот не сообщит об окончании исключением StopIteration. Исключение перехватывает сам цикл, поэтому в коде оно не видно. Тот же цикл, записанный явно:
xs = [1.5, 2.5, 4.0]

it = iter(xs)
while True:
    try:
        x = next(it)
    except StopIteration:
        break
    print(x)
Встроенные функции iter и next вызывают специальные методы __iter__ и __next__, как len вызывает __len__. По тому же протоколу работают распаковка, списковые включения, функции sum, max, sorted и list и конструкторы коллекций. В байт-коде цикл представлен двумя инструкциями: GET_ITER вызывает iter для перебираемого объекта, FOR_ITER на каждом шаге вызывает next и при окончании элементов переходит за конец цикла.
import dis

dis.dis('for x in xs: pass')
  0           0 RESUME                   0

  1           2 LOAD_NAME                0 (xs)
              4 GET_ITER
        >>    6 FOR_ITER                 2 (to 14)
             10 STORE_NAME               1 (x)
             12 JUMP_BACKWARD            4 (to 6)
        >>   14 END_FOR
             16 RETURN_CONST             0 (None)
Вывод получен в Python 3.12; набор инструкций меняется от версии к версии, но пара GET_ITER и FOR_ITER присутствует во всех.
Итерируемый объект и итератор
Протокол итерации разделяет две роли. Итерируемый объект (iterable) обладает методом __iter__, который при каждом вызове возвращает новый итератор. Итератор (iterator) обладает методом __next__, возвращающим следующий элемент или возбуждающим StopIteration, когда элементы закончились, и методом __iter__, возвращающим сам итератор. Итератор обязан быть и итерируемым, поэтому его можно передать в цикл for.
Встроенные коллекции — списки, кортежи, словари, множества, строки — являются итерируемыми объектами; файл, открытый функцией open, сам является итератором по строкам. По списку можно пройти сколько угодно раз, поскольку каждый цикл получает новый итератор, а по итератору — один раз: после первого прохода он исчерпан. Исчерпанный итератор обязан и дальше возбуждать StopIteration при каждом вызове next.
xs = [1.5, 2.5, 4.0]
it = iter(xs)
next(it), next(it)    # (1.5, 2.5)
next(it)              # 4.0
next(it)              # исключение StopIteration
iter(it) is it        # True: итератор возвращает самого себя
list(it), list(xs)    # ([], [1.5, 2.5, 4.0])
next(range(3))        # TypeError: 'range' object is not an iterator
Проверка isinstance(x, collections.abc.Iterator) отличает итератор от итерируемого объекта, у которого есть только __iter__.
Собственный итератор
Класс Linspace ниже — упрощённый аналог numpy.linspace: n равноотстоящих точек отрезка от a до b. Роли разделены явно: контейнер хранит параметры сетки и на каждый вызов __iter__ создаёт новый итератор, а обход выполняет класс LinspaceIterator.
class Linspace:
    def __init__(self, a, b, n):
        self.a, self.n = a, n
        self.h = (b - a) / (n - 1)

    def __iter__(self):
        return LinspaceIterator(self.a, self.h, self.n)

class LinspaceIterator:
    def __init__(self, a, h, n):
        self.a, self.h, self.n, self.i = a, h, n, 0   # состояние обхода

    def __iter__(self):
        return self                # итератор обязан быть итерируемым

    def __next__(self):
        if self.i == self.n:
            raise StopIteration
        self.i += 1
        return self.a + (self.i - 1) * self.h

grid = Linspace(0.0, 1.0, 5)
list(grid)    # [0.0, 0.25, 0.5, 0.75, 1.0]
list(grid)    # тот же результат: второй проход получает новый итератор
Счётчик i хранится в итераторе, а не в контейнере, поэтому каждый новый for начинает с первой точки, а по одной сетке можно пройти произвольное число раз. Точка вычисляется как a + i·h, а не прибавлением h к предыдущей: при накоплении ошибки округления складываются и растут с номером точки, а при умножении погрешность каждой точки остаётся в последних разрядах. Последняя точка и при умножении может отличаться от b в последнем знаке, поэтому numpy.linspace присваивает ей значение b явно.
Обе роли можно совместить в одном классе, где __iter__ возвращает self: кода при этом меньше, однако второй проход начнётся там, где закончился первый, и окажется пустым. Так устроены однопроходные объекты — файлы и генераторы; у контейнеров роли разделены. Без метода __iter__ сам итератор не является итерируемым: цикл for по контейнеру Linspace работает, поскольку у полученного итератора цикл вызывает только __next__, а цикл по объекту iter(grid) и передача его в list или zip завершаются TypeError.
Другие способы итерации
Кроме основного протокола, функция iter поддерживает ещё два способа получить итератор, а оператор in — свой порядок поиска.
| Механизм | Как работает | Применение |
|---|---|---|
__getitem__ | перебор индексов 0, 1, 2… до IndexError | старые классы-последовательности |
iter(f, граница) | вызовы f() до граничного значения | чтение блоками, опрос |
__contains__ | x in obj; без метода — перебор через __iter__ | проверка принадлежности |
Если у объекта нет __iter__, но есть __getitem__, функция iter создаёт итератор, запрашивающий элементы с индексами 0, 1, 2 и далее, пока __getitem__ не возбудит IndexError. Так перебирались последовательности до появления протокола итераторов, и этот путь сохранён для совместимости. collections.abc.Iterable такой объект итерируемым не признаёт, поэтому надёжная проверка — вызов iter(obj).
class Squares:
    def __getitem__(self, i):
        if i >= 4:
            raise IndexError(i)
        return i * i

list(Squares()), 9 in Squares()   # ([0, 1, 4, 9], True)
Функция iter с двумя аргументами принимает вызываемый объект и граничное значение: итератор вызывает функцию без аргументов и выдаёт результаты, пока не получит граничное значение. Двоичные файлы оцифровщиков и детекторов читаются так блоками фиксированного размера; границей служит пустая строка байтов, которую read возвращает в конце файла.
from functools import partial

with open('run042.dat', 'rb') as f:
    for block in iter(partial(f.read, 4096), b''):
        process(block)
Оператор in вызывает метод __contains__, а при его отсутствии перебирает объект через __iter__ или __getitem__, пока не найдёт равный элемент. Для итератора это означает расход элементов: после проверки в нём остаются только элементы после найденного.
it = iter(Linspace(0.0, 1.0, 5))
0.5 in it      # True
list(it)       # [0.75, 1.0]: элементы до 0.5 включительно израсходованы
Итераторы стандартной библиотеки
| Объект | Итератор? | Повторный обход |
|---|---|---|
list, tuple, str, dict, set | нет: итерируемый | да |
range(n) | нет: ленивая последовательность | да; есть len и индексы |
dict.keys(), values(), items() | нет: представления | да; текущее содержимое словаря |
open(path) | да | нет: позиция в файле |
map, filter, zip, enumerate, reversed | да | нет |
| генератор | да | нет |
range не хранит элементы, а вычисляет их и при этом остаётся последовательностью с длиной, индексами и проверкой in без перебора для целых чисел. Представления словаря отражают его текущее содержимое; изменение размера словаря во время обхода завершается RuntimeError: dictionary changed size during iteration. Функции map, filter, zip, enumerate и reversed возвращают итераторы и вычисляют элементы по запросу, поэтому их результат, использованный дважды, во второй раз пуст — частая ошибка при переносе кода с Python 2, где map и zip возвращали списки.
m = map(str, [1, 2])
list(m), list(m)                      # (['1', '2'], [])
list(zip([1, 2], [1], strict=True))   # ValueError: zip() argument 2 is shorter than argument 1
Функция zip останавливается на самой короткой последовательности; с Python 3.10 параметр strict=True превращает расхождение длин в ValueError. При объединении отметок времени и показаний zip(times, values, strict=True) защищает от молчаливого усечения рядов разной длины.
Генераторы
Генераторная функция
Писать два класса ради простого перебора избыточно. Функция, в теле которой встречается yield, при вызове не выполняет тело, а возвращает объект-генератор. Генератор — итератор: next запускает тело и выполняет его до ближайшего yield, значение yield становится результатом next, а функция приостанавливается. Генератор хранит кадр функции — локальные переменные и место остановки — между вызовами next; точку остановки задаёт yield. Следующий next продолжает выполнение с инструкции после yield.
def countdown(n):
    print('старт')
    while n > 0:
        yield n
        n -= 1
    return 'пуск'

g = countdown(3)    # тело не выполняется, ничего не печатается
next(g)             # печатает «старт», возвращает 3
next(g), next(g)    # (2, 1)
next(g)             # исключение StopIteration: пуск
Когда тело завершается, возбуждается StopIteration, и значение return, если оно есть, сохраняется в атрибуте value исключения; цикл for и функция list это значение не используют: list(countdown(3)) печатает «старт» и возвращает [3, 2, 1]. Генератор заменяет класс итератора: метод __iter__, написанный генератором, возвращает новый генератор при каждом вызове, и по контейнеру можно проходить многократно без отдельного класса.
class Linspace:
    def __init__(self, a, b, n):
        self.a, self.n = a, n
        self.h = (b - a) / (n - 1)

    def __iter__(self):
        for i in range(self.n):
            yield self.a + i * self.h
Генератор удобен там, где следующий элемент вычисляется по предыдущим, — шаги интегрирования, итерации метода Ньютона, последовательные приближения.
Состояния генератора
Генератор проходит четыре состояния, которые возвращает функция inspect.getgeneratorstate.
| Состояние | Когда наступает |
|---|---|
GEN_CREATED | после вызова генераторной функции: кадр создан, тело не выполнялось |
GEN_RUNNING | во время выполнения тела после next, send или throw |
GEN_SUSPENDED | после yield: локальные переменные и место остановки сохранены |
GEN_CLOSED | после return, исключения или вызова close |
import inspect

g = countdown(3)
inspect.getgeneratorstate(g)                       # 'GEN_CREATED'
next(g)                                            # печатает «старт», возвращает 3
inspect.getgeneratorstate(g), g.gi_frame.f_locals  # ('GEN_SUSPENDED', {'n': 3})
Состояние хранится в атрибутах объекта: gi_frame — кадр выполнения с локальными переменными f_locals и номером строки f_lineno, после завершения генератора gi_frame равен None; gi_running — признак выполнения; gi_yieldfrom — подгенератор, которому делегировано выполнение через yield from. Методы send, throw и close рассматриваются в разделе о корутинах; close у ещё не запущенного генератора переводит его в GEN_CLOSED сразу, без выполнения тела. Генератор не может запустить сам себя: next(g) внутри тела g завершается ValueError: generator already executing.
Генераторные выражения
Генераторное выражение — краткая форма генератора; от спискового включения его отличают круглые скобки вместо квадратных. Если выражение — единственный аргумент функции, вторые скобки не нужны.
squares = [x * x for x in range(100_000)]   # список строится сразу
lazy = (x * x for x in range(100_000))      # генератор, элементы по запросу
total = sum(x * x for x in range(100_000))  # скобки вызова служат скобками выражения
Списковое включение хранит все элементы, генератор не вычисляет ни одного, пока элемент не будет запрошен. Измерения на Python 3.12.3:
| Величина | Список | Генератор |
|---|---|---|
sys.getsizeof | 800 984 байта | 200 байт |
пик памяти при sum (tracemalloc) | 4,0 МБ | 464 байта |
| повторный обход | да | нет |
len и индексы | да | нет |
sys.getsizeof учитывает только сам список, то есть массив ссылок; объекты-числа добавляют ещё около 2,8 МБ, что и показывает пик памяти при суммировании. Размер генератора не зависит от длины последовательности, но зависит от версии Python: в 3.11 тот же генератор занимает 208 байт.
Первый источник выражения вычисляется сразу при его создании, а условие и остальные части выполняются при обходе. Поэтому изменение переменной после создания генератора влияет на результат:
data = [0, 2, 5, 12]
threshold = 1
g = (x for x in data if x > threshold)
threshold = 10
list(g)          # [12]: условие прочитало threshold в момент перебора
Суммы, средние и экстремумы по большим наборам удобно вычислять генераторными выражениями — без промежуточного списка в памяти.
Конвейер генераторов
Генераторы соединяются в конвейер: каждая стадия, кроме первой, принимает итерируемый объект и сама является генератором. Журнал захода, записывавшийся всю смену, может не помещаться в память целиком, но построчно читается так же просто, как список.
def read_lines(path):
    with open(path) as f:
        yield from f

def parse(lines):
    for line in lines:
        if not line.strip() or line.startswith('#'):
            continue           # пустые строки и комментарии пропускаются
        t, channel, value = line.split()
        yield float(t), channel, float(value)

def select(events, name):
    for t, channel, value in events:
        if channel == name:
            yield t, value

lines = read_lines('run042.log')
bpm = select(parse(lines), 'BPM01')
print(max(value for t, value in bpm))
read_lines читает журнал построчно, поскольку файл — итератор по строкам; parse пропускает пустые строки и комментарии и выдаёт разобранные события; select оставляет события одного канала; max потребляет результат. Элементы проходят конвейер по одному: max запрашивает событие у select, select — у parse, parse — строку у read_lines. В памяти одновременно находятся одна строка и одно событие, поэтому журнал любого размера обрабатывается с постоянным расходом памяти. Стадии независимы: их легко заменить, добавить проверку или пересчёт единиц, а parse и select проверяются по отдельности на списке строк вместо файла.
log = ['0.0 BPM01 1.2', '0.1 BPM02 0.7', '0.2 BPM01 1.4']
pipe = select(parse(log), 'BPM01')   # ничего не прочитано
next(pipe)                           # (0.0, 1.2)
next(pipe)                           # (0.2, 1.4): строка BPM02 отброшена
next(pipe, 'конец')                  # 'конец' вместо StopIteration
Файл закрывается, когда генератор read_lines завершится или будет закрыт; если обход прерван досрочно, файл остаётся открытым до вызова close или сборки мусора (раздел «Завершение генератора»).
Бесконечные последовательности
Генератор с бесконечным циклом описывает последовательность без конца: значения вычисляются, пока их запрашивают, а границу устанавливает читающая сторона. Генератор oscillator выдаёт состояния гармонического осциллятора с шагом dt по полунеявной схеме Эйлера: сначала обновляется скорость, затем координата по новой скорости.
import itertools, math

def oscillator(x, v, dt, w=1.0):
    t = 0.0
    while True:
        yield t, x, v
        v -= w * w * x * dt
        x += v * dt
        t += dt

states = oscillator(1.0, 0.0, 0.01)
list(itertools.islice(states, 3))   # три первых состояния
next(states)                        # четвёртое, t = 0.03: генератор продолжает с места остановки
next(t for t, x, v in oscillator(1.0, 0.0, 0.01) if x < 0)   # 1.5700000000000012
math.pi / 2                                                  # 1.5707963267948966
Условия остановки в генераторе нет: его задаёт вызывающий код. itertools.islice берёт заданное число состояний и больше не обращается к генератору, takewhile выдаёт состояния, пока выполняется условие, next с генераторным выражением возвращает первое состояние, удовлетворяющее условию, например первое пересечение нуля. takewhile при этом забирает из генератора и первый элемент, не прошедший условие, и этот элемент теряется. Список из бесконечного генератора построить нельзя: list(oscillator(...)) не завершится, а память будет расти, пока процесс не будет остановлен.
Координата впервые становится отрицательной при t = 1,57 при точном значении π/2 = 1,5708: расхождение меньше шага. Полунеявная схема точно сохраняет величину x² + v² − dt·x·v, поэтому x² + v² колеблется в узкой полосе около единицы: за 10 000 шагов отклонение не превышает dt/(2 − dt) ≈ 0,00503. У явной схемы Эйлера x² + v² на каждом шаге умножается на 1 + dt², и за те же 10 000 шагов выросла бы примерно в e раз. Так генератор разделяет схему интегрирования и условие остановки — по времени, по числу шагов или по событию.
Моменты времени, вычисляемые сложением t += dt, тоже накапливают ошибку округления: у itertools.count(0.0, 0.1) десятый шаг даёт 0.9999999999999999 вместо 1.0, и документация itertools рекомендует в таком случае умножение. Генератор моментов времени без накопления:
def clock(dt):
    """Бесконечная последовательность моментов времени с шагом dt."""
    for i in itertools.count():
        yield i * dt           # умножение, а не накопление t += dt

[round(t, 3) for t in itertools.islice(clock(0.02), 5)]   # [0.0, 0.02, 0.04, 0.06, 0.08]
Делегирование: yield from
Когда генератор лишь передаёт элементы другого итерируемого объекта, цикл for x in g: yield x записывается короче: yield from g. Рекурсивный обход двоичного дерева поиска в порядке возрастания выдаёт элементы левого поддерева, значение узла и элементы правого поддерева, а вложенные вызовы соединяются через yield from.
class Node:
    def __init__(self, value, left=None, right=None):
        self.value = value
        self.left, self.right = left, right

def walk(node):
    if node is not None:
        yield from walk(node.left)
        yield node.value
        yield from walk(node.right)

tree = Node(5, Node(3, Node(1)), Node(8))
list(walk(tree))     # [1, 3, 5, 8]
Конструкция yield from (PEP 380, Python 3.3) не сводится к сокращению цикла. Она передаёт во вложенный генератор значения, отправленные через send, и исключения, отправленные через throw, а значением самого выражения yield from становится результат return вложенного генератора:
def sub():
    yield 1
    yield 2
    return 'итог'

def outer():
    r = yield from sub()
    print('подгенератор вернул', r)

list(outer())   # печатает «подгенератор вернул итог», результат [1, 2]
Это позволяет разбивать сложный генератор на части, как функцию на подфункции. Рекурсивным генератором с yield from записывается обход любых деревьев — разбиений пространства (квадродеревья и октодеревья в задаче N тел), иерархий геометрии детектора.
Завершение генератора
| Ситуация | Результат |
|---|---|
return значение | StopIteration(значение): результат для yield from, не для for |
StopIteration в теле (PEP 479, Python 3.7) | RuntimeError: generator raised StopIteration |
next(g) внутри самого g | ValueError: generator already executing |
| досрочное прерывание обхода | выполнение finally и with при close() или сборке мусора |
До Python 3.7 исключение StopIteration, возникшее внутри тела генератора, — например, от вызова next у исчерпанного итератора, — молча завершало генератор, и ошибка терялась. PEP 479 изменил это поведение: такое исключение превращается в RuntimeError. Поэтому внутри генератора next вызывается со значением по умолчанию или в блоке try, а для завершения используется return.
def firsts(groups):
    for g in groups:
        yield next(iter(g))        # пустая группа: RuntimeError

list(firsts([[1], []]))   # RuntimeError: generator raised StopIteration

def firsts(groups):
    for g in groups:
        yield next(iter(g), None)

list(firsts([[1], []]))   # [1, None]
Генератор, обход которого прерван досрочно — оператором break или исключением у потребителя, — остаётся в состоянии GEN_SUSPENDED; его блоки finally и менеджеры контекста выполнятся при вызове close или при уничтожении объекта сборщиком мусора. В CPython это обычно происходит сразу после потери последней ссылки, в других реализациях — позже, поэтому ресурсы освобождают явно: g.close() или contextlib.closing(g).
Модуль itertools
Модуль itertools содержит ленивые итераторы, реализованные на C, — базовые средства обработки последовательностей без промежуточных списков. Все функции модуля возвращают итераторы, поэтому их результат однопроходный и может быть входом следующей функции.
Бесконечные итераторы и срезы
| Функция | Пример | Результат |
|---|---|---|
count(start, step) | count(0.0, 0.25) | 0.0, 0.25, 0.5, … |
cycle(it) | cycle('AB') | A, B, A, B, … |
repeat(x, n) | repeat(0, 3) | 0, 0, 0 |
islice(it, start, stop, step) | islice(count(), 2, 8, 2) | 2, 4, 6 |
takewhile(pred, it) | takewhile(lambda t: t < 1, ts) | до первого ложного условия |
dropwhile(pred, it) | dropwhile(lambda x: x < 3, [1, 4, 2, 5]) | 4, 2, 5 |
compress(it, mask) | compress('ABCD', [1, 0, 1, 0]) | A, C |
filterfalse(pred, it) | filterfalse(lambda x: x % 2, range(6)) | 0, 2, 4 |
count считает от start с шагом step, в том числе для вещественных чисел, но с вещественным шагом накапливает его сложением; cycle повторяет элементы источника по кругу, сохраняя их копию; repeat выдаёт одно значение заданное или бесконечное число раз. islice — аналог среза для любого итератора без отрицательных индексов, поскольку длина итератора неизвестна. takewhile останавливается на первом ложном условии, dropwhile пропускает элементы, пока условие истинно, а после первого неподходящего выдаёт всё остальное без проверки: это не фильтр.
Объединение и группировка
| Функция | Что делает |
|---|---|
chain(a, b), chain.from_iterable(xs) | последовательное соединение источников |
zip_longest(a, b, fillvalue=None) | соединение до конца самого длинного источника |
groupby(it, key) | группы соседних элементов с одним ключом |
pairwise(it) (Python 3.10) | соседние пары (a, b), (b, c), … |
batched(it, n) (Python 3.12) | кортежи по n элементов |
accumulate(it, func, initial=x) | накопленные суммы, бегущий максимум |
starmap(f, pairs) | f(*pair) для каждой пары |
tee(it, n) | n независимых копий одного итератора |
chain.from_iterable соединяет источники из итерируемого объекта, например из списка списков; распаковка chain(*xss) строит кортеж источников и на бесконечном источнике не завершится. groupby выдаёт пары «ключ, итератор группы» и объединяет только соседние элементы, поэтому для группировки по всему набору данные сначала сортируют по тому же ключу.
from itertools import groupby, pairwise, batched, accumulate

events = [('BPM02', 0.7), ('BPM01', 1.2), ('BPM01', 1.4), ('BPM02', 0.9)]
[name for name, _ in groupby(events, key=lambda e: e[0])]
# ['BPM02', 'BPM01', 'BPM02']: без сортировки BPM02 попал в две группы
for name, grp in groupby(sorted(events), key=lambda e: e[0]):
    print(name, [v for _, v in grp])   # BPM01 [1.2, 1.4] и BPM02 [0.7, 0.9]

times = [0.00, 0.12, 0.31, 0.39]
[round(b - a, 2) for a, b in pairwise(times)]   # [0.12, 0.19, 0.08]
list(batched(range(7), 3))                      # [(0, 1, 2), (3, 4, 5), (6,)]
list(accumulate([3, 1, 4, 1, 5], max))          # [3, 3, 4, 4, 5]
pairwise по отметкам времени даёт интервалы между событиями, accumulate — накопленную дозу или интеграл методом прямоугольников, batched — пакеты для записи в файл или отправки по сети. Вместо pairwise иногда пишут zip(xs, islice(xs, 1, None)); на списке это работает, а на итераторе даёт неверные пары, поскольку оба аргумента расходуют один итератор.
Комбинаторика
| Функция | Перебирает | Число вариантов |
|---|---|---|
product(A, B) | все пары (a, b) | len(A) * len(B) |
product(A, repeat=k) | кортежи длины k | n ** k |
permutations(A, k) | упорядоченные выборки | math.perm(n, k) |
combinations(A, k) | неупорядоченные выборки | math.comb(n, k) |
combinations_with_replacement(A, k) | выборки с повторением | math.comb(n + k - 1, k) |
Комбинаторные функции заменяют вложенные циклы: product выдаёт декартово произведение в лексикографическом порядке, где последний источник меняется быстрее всех. Число вариантов растёт быстро, поэтому его заранее оценивают функциями math.perm и math.comb (Python 3.8).
from itertools import product, combinations
import math

grid = list(product([1.0, 2.0], [0.1, 0.2, 0.3]))
len(grid), grid[:3]          # (6, [(1.0, 0.1), (1.0, 0.2), (1.0, 0.3)])
list(combinations('ABCD', 2))
# [('A', 'B'), ('A', 'C'), ('A', 'D'), ('B', 'C'), ('B', 'D'), ('C', 'D')]
math.comb(32, 2), sum(1 for _ in combinations(range(32), 2))   # (496, 496)
product перебирает сетку параметров моделирования — температуры и поля, энергии и углы — одним циклом без вложенности; combinations даёт пары детекторов для поиска совпадений: 32 детектора образуют 496 пар. Число повторов в product передаётся только именованным аргументом repeat: вызов product('ab', 2) завершается TypeError.
Рецепты и ограничения
Документация модуля содержит раздел рецептов — коротких функций, собранных из стандартных блоков: скользящее окно sliding_window, чередование источников roundrobin, удаление повторов unique_everseen и другие; многие из них вошли в сторонний пакет more-itertools. Скользящее среднее строится на deque ограниченной длины: очередь хранит последние n отсчётов, а старые вытесняются автоматически.
from collections import deque
from itertools import islice

def moving_average(xs, n):
    it = iter(xs)
    window = deque(islice(it, n - 1), maxlen=n)
    for x in it:
        window.append(x)
        yield sum(window) / n

list(moving_average([1, 2, 3, 4, 5], 3))   # [2.0, 3.0, 4.0]
Ограничения модуля следуют из ленивости:
product,permutationsиcombinationsчитают входные источники целиком и сохраняют их в кортежах ещё до выдачи первого результата, поэтому бесконечный итератор передавать в них нельзя;teeхранит элементы, пока их не прочитают все копии, и при большом отставании одной копии расходует память как список; исходный итератор послеteeне используется;- группа из
groupbyдействительна только до перехода к следующей: если её нужно сохранить, её сразу превращают в список; isliceне поддерживает отрицательные индексы.
Скользящее среднее и медиана — простейшие фильтры сигнала; для массивов NumPy среднее вычисляют свёрткой numpy.convolve, медиану — функцией scipy.signal.medfilt, а генератор подходит для потока, который не хранится целиком.
Корутины
Корутины (сопрограммы) выросли из генераторов: генератор, принимающий значения через send, хранит состояние между вызовами и обрабатывает поток входных данных. На том же механизме приостановки построена асинхронность, где один поток занимается другой работой, пока задача ожидает ответа от сети или прибора.
Метод send
Выражение yield справа от присваивания делает генератор двусторонним: x = yield result выдаёт result наружу, приостанавливает функцию и при возобновлении получает значение, переданное методом send. Вызов next(g) равносилен g.send(None). Перед первым send корутину запускают вызовом next, чтобы она дошла до первого yield: отправить значение в только что созданный генератор нельзя. Метод send возвращает следующее значение, выданное корутиной, поэтому один вызов и передаёт измерение, и возвращает обновлённый результат.
Корутина stats вычисляет среднее и дисперсию потока измерений по формулам Уэлфорда: на каждом шаге обновляются число отсчётов, среднее и сумма квадратов отклонений M2, а несмещённая оценка дисперсии равна M2/(n − 1).
def stats():
    n, mean, m2 = 0, 0.0, 0.0
    result = None
    while True:
        x = yield result
        n += 1
        d = x - mean
        mean += d / n
        m2 += d * (x - mean)
        result = n, mean, m2 / (n - 1) if n > 1 else 0.0

s = stats()
s.send(2.0)    # TypeError: can't send non-None value to a just-started generator
next(s)        # запуск до первого yield
s.send(2.0)    # (1, 2.0, 0.0)
s.send(4.0)    # (2, 3.0, 2.0)
s.send(6.0)    # (3, 4.0, 4.0)
Состояние хранится в локальных переменных генератора, а не в атрибутах объекта; эквивалентный класс с методом add длиннее, но при сложном состоянии нагляднее. Формулы Уэлфорда численно устойчивы: в отличие от формулы «среднее квадратов минус квадрат среднего», они не вычитают близкие большие числа и не теряют точность при большом постоянном смещении сигнала.
Тот же приём с аннотацией типов: тип Generator[тип выдачи, тип приёма, тип возврата] из collections.abc описывает корутину, выдающую None или результат, принимающую вклад и ничего не возвращающую. Корутина ниже вычисляет вклад с учётом сложных процентов; коэффициент роста вычисляется один раз — при первом next(coro), когда корутина доходит до первого yield, — и далее не меняется, а суммы вклада в неё можно передавать неограниченно.
from collections.abc import Generator
def cash_return_coro(percent: float,
years: int) -> Generator[float | None, float, None]:
value = (1 + percent / 100) ** years
result = None
while True:
try:
deposit = yield result
except GeneratorExit:
print('Выход из корутины')
raise
result = round(deposit * value, 2)
coro = cash_return_coro(5, 5)
next(coro) # запуск до первого yield
for item in [1000, 2000, 5000, 10000, 100000]:
print(coro.send(item)) # 1276.28, 2552.56, 6381.41, 12762.82, 127628.16
coro.close() # печатает «Выход из корутины»
Выражение deposit = yield result отдаёт наружу результат предыдущего шага и принимает следующий вклад, поэтому next(coro) нужен один раз — чтобы довести корутину до первого yield. Форма с двумя yield за оборот — один принимает вклад, другой отдаёт результат — требует вызова next после каждого send: если его пропустить, следующий вклад попадёт не в тот yield и потеряется без ошибки.
Методы throw и close
| Вызов | Что происходит в генераторе |
|---|---|
g.throw(exc) | исключение в точке yield; перехваченное — работа до следующего yield |
g.close() | GeneratorExit в точке yield; выполнение finally и завершение генератора |
yield после GeneratorExit | RuntimeError: generator ignored GeneratorExit |
g.throw(тип, значение, tb) | форма с тремя аргументами: устаревшая с Python 3.12 |
throw возбуждает исключение в точке, где генератор приостановлен, — так, будто его выбросила инструкция yield. Если генератор перехватывает исключение, он продолжает работу до следующего yield, и throw возвращает выданное значение; если нет, исключение выходит наружу из вызова throw. В счётчике ниже ValueError служит командой сброса.
def counter():
n = 0
try:
while True:
try:
yield n
n += 1
except ValueError:
n = 0
finally:
print('закрытие, n =', n)
c = counter()
next(c), next(c), next(c) # (0, 1, 2)
c.throw(ValueError) # 0: сброс без завершения генератора
next(c) # 1
c.close() # печатает «закрытие, n = 1»
next(c) # исключение StopIteration
close возбуждает в точке остановки GeneratorExit: генератор обязан завершиться — выполнить блоки finally и выйти. Если вместо этого он снова выполнит yield, возникнет RuntimeError: generator ignored GeneratorExit. Поэтому после перехвата GeneratorExit генератор не выполняет yield: исключение возбуждают повторно, как в cash_return_coro, или завершают генератор оператором return, а для освобождения ресурсов достаточно finally или with. CPython вызывает close и при уничтожении незавершённого генератора, поэтому файлы и соединения, открытые в теле генератора, закрываются и при прерванном обходе. Форма throw с тремя аргументами — тип, значение, трассировка — с Python 3.12 устарела: передаётся один аргумент — экземпляр или класс исключения.
yield from как канал
yield from соединяет вызывающий код с подгенератором напрямую: значения, выдаваемые подгенератором, проходят наружу, значения send и исключения throw — внутрь, а делегирующий генератор на это время приостановлен и лишь получает итоговый результат.
def averager():
total, n = 0.0, 0
while True:
x = yield
if x is None:
return total / n
total, n = total + x, n + 1
def collect(results, name):
while True:
results[name] = yield from averager()
results = {}
c = collect(results, 'BPM01')
next(c)
for x in (1.25, 1.5, 1.75):
c.send(x)
c.send(None) # конец серии
results # {'BPM01': 1.5}
Корутина averager принимает значения одной серии и по сигналу конца серии — значению None — возвращает среднее; делегирующий генератор collect записывает этот результат в словарь и начинает следующую серию. Для вызывающего кода два уровня неразличимы: он отправляет значения в collect, а они попадают в averager. Без yield from пришлось бы вручную перехватывать StopIteration, передавать send и throw и обрабатывать close. На такой передаче управления по цепочке вложенных генераторов была построена первая версия asyncio: корутины ожидали друг друга через yield from, пока в Python 3.5 не появился await.
Генератор как менеджер контекста
Декоратор contextlib.contextmanager превращает генератор с одним yield в менеджер контекста. Код до yield выполняется при входе в блок with и играет роль __enter__; значение yield связывается с переменной после as; код после yield выполняется при выходе из блока и играет роль __exit__.
import contextlib, time
@contextlib.contextmanager
def timer(label):
t0 = time.perf_counter()
try:
yield
finally:
dt = time.perf_counter() - t0
print(f'{label}: {dt:.2f} с')
with timer('сумма'):
s = sum(i * i for i in range(10**6)) # печатает «сумма: 0.04 с»; время зависит от машины
with timer('деление'):
1 / 0 # печатает «деление: 0.00 с», затем ZeroDivisionError выходит наружу
Если в блоке with возникает исключение, оно возбуждается в генераторе в точке yield, поэтому завершающий код помещается в finally — иначе при ошибке он не выполнится. Исключение, перехваченное в генераторе и не возбуждённое повторно, считается обработанным. Такой менеджер короче класса с методами __enter__ и __exit__ и подходит для однократных действий вокруг блока: замер времени этапов обработки, временная смена каталога или настроек, захват и освобождение ресурса. Менеджер из contextmanager применяется и как декоратор функции. В contextlib есть и готовые менеджеры: suppress подавляет указанные исключения, chdir (Python 3.11) временно меняет рабочий каталог, closing вызывает close по выходе, ExitStack собирает переменное число менеджеров; временный каталог создаёт tempfile.TemporaryDirectory.
От генераторов к async и await
Цикл событий на генераторах
Планировщик, переключающийся между задачами, записывается в десяток строк, если задачи — генераторы. Задача выполняет шаг работы и отдаёт управление инструкцией yield. Планировщик хранит очередь готовых задач, берёт первую, продвигает её вызовом next до следующего yield и ставит в конец очереди; завершившаяся задача возбуждает StopIteration и из очереди удаляется.
from collections import deque
def task(name, n):
for i in range(n):
print(name, 'шаг', i)
yield
def run(tasks):
queue = deque(tasks)
while queue:
t = queue.popleft()
try:
next(t)
except StopIteration:
continue
queue.append(t)
run([task('прибор A', 3), task('прибор B', 2)])
прибор A шаг 0
прибор B шаг 0
прибор A шаг 1
прибор B шаг 1
прибор A шаг 2
Две задачи чередуются, хотя поток один: переключение происходит только в точках yield, поэтому такая многозадачность называется кооперативной — задача, не дошедшая до yield, удерживает поток. В цикле событий asyncio задача, ожидающая данных, не возвращается в очередь сразу: она регистрирует ожидание у селектора операционной системы и снова становится готовой, когда данные пришли или истёк тайм-аут. Полная реализация такого планировщика разобрана в главе «Асинхронность».
async def и await
До Python 3.5 корутины asyncio были генераторами: они ожидали друг друга через yield from и помечались декоратором @asyncio.coroutine, удалённым в Python 3.11. PEP 492 ввёл нативные корутины: функция, объявленная через async def, при вызове возвращает объект типа coroutine, а await приостанавливает её до завершения ожидаемого объекта — другой корутины, задачи или Future. await допустим только внутри async def, а объект-корутину нельзя перебрать циклом for.
| Генераторная корутина | Нативная корутина (Python 3.5, PEP 492) |
|---|---|
def и yield | async def |
yield from future | await future |
@asyncio.coroutine, удалён в 3.11 | без декоратора |
loop.run_until_complete(main()) | asyncio.run(main()), Python 3.7 |
Ожидание приборов с разной задержкой показывает разницу между ожиданием и блокировкой:
import asyncio, time
async def poll(name, delay):
await asyncio.sleep(delay) # точка ожидания: управление у цикла событий
return name, delay
async def blocking(name, delay):
time.sleep(delay) # блокирующий вызов: цикл событий стоит
return name, delay
async def main(f):
t0 = time.perf_counter()
res = await asyncio.gather(f('A', 0.3), f('B', 0.5), f('C', 0.8))
print(res, round(time.perf_counter() - t0, 2))
asyncio.run(main(poll)) # [('A', 0.3), ('B', 0.5), ('C', 0.8)] 0.8
asyncio.run(main(blocking)) # [('A', 0.3), ('B', 0.5), ('C', 0.8)] 1.61
С await задержки перекрываются, и общее время равно наибольшей — 0,8 с; time.sleep не отдаёт управление циклу событий, и опросы выполняются по очереди за 1,6 с. Вызов poll('A', 0.3) без await ничего не выполняет: создаётся объект, а при его уничтожении выводится предупреждение RuntimeWarning: coroutine 'poll' was never awaited — признак забытого await. Задачи, тайм-ауты, группы задач и асинхронная итерация рассматриваются в главе «Асинхронность».
Выбор средства
| Задача | Средство |
|---|---|
| перебор данных по одному элементу | итератор, генератор |
| конвейер обработки потока | цепочка генераторов, itertools |
| состояние, меняющееся по входным данным | корутина с send или класс |
| действия до и после блока | contextlib.contextmanager |
| ожидание сети и приборов | asyncio: gather, TaskGroup, timeout |
| расчёт на всех ядрах | multiprocessing, NumPy, numba |
| блокирующие вызовы и файлы в асинхронном коде | asyncio.to_thread |
Итоги
Таким образом, цикл for получает итератор функцией iter и вызывает next, пока тот не возбудит StopIteration; итерируемый объект выдаёт новый итератор на каждый проход, а сам итератор однопроходный. Функция с yield возвращает генератор, выполняемый по шагам: между вызовами локальные переменные и место остановки хранятся в кадре, а return завершает генератор и передаёт значение в StopIteration. Генераторные выражения и конвейеры генераторов обрабатывают данные по одному элементу, поэтому расход памяти не зависит от объёма данных. Модуль itertools даёт ленивые бесконечные итераторы, срезы, объединение, группировку и комбинаторику. Методы send, throw и close превращают генератор в корутину, а yield from соединяет её с подгенератором и возвращает его результат. Нативные корутины async def и await выполняет цикл событий, переключая задачи в точках ожидания.
Для самостоятельного изучения рекомендуются документация модуля itertools с разделом рецептов, PEP 380 (yield from), PEP 479 (StopIteration внутри генератора) и PEP 492 (async и await).
Декораторы и модуль functools
Одна и та же обвязка повторяется от функции к функции, будь то измерение времени, запись вызова в журнал, проверка аргументов или кеширование результата. Логика везде своя, обвязка одна, а копировать её приходится в каждую функцию. Декораторы позволяют добавить поведение к функции, не затрагивая её тело.
В настоящей главе рассматривается устройство декоратора изнутри, способы передачи ему аргументов, возникающие при этом ловушки, а также готовые декораторы из модуля functools.
Слайды к главе. Материал главы изложен также в пятой и шестой частях лекции «Функции в Python» (декораторы и модуль functools) с демонстрациями в интерактивной оболочке; слайды лекции доступны на сайте книги и в PDF.
Синтаксис декораторов
Декоратор представляет собой вызываемый объект, чаще всего функцию, принимающий другую функцию и возвращающий новую (или любой другой объект). Символ @ перед определением является синтаксическим сахаром, не добавляющим возможностей, но выносящим имя декоратора на видное место перед функцией.
@decorator
def foo(x):
return 42
Эквивалентно:
def foo(x):
return 42
foo = decorator(foo)
После применения декоратора имя foo ссылается на результат вызова decorator(foo). Эквивалентность практическая: выражение после @ вычисляется до создания функции, а имя foo с исходной функцией не связывается ни в какой момент. Декоратор выполняется один раз, вместе с инструкцией def, то есть при импорте или запуске модуля, а не при каждом вызове функции. Синтаксис @ появился в Python 2.4 (PEP 318); с версии 3.9 после @ допускается любое выражение, а не только имя или вызов (PEP 614).
В научном коде декораторы встречаются постоянно: @numba.njit компилирует функцию в машинный код, @functools.lru_cache запоминает результаты, @pytest.fixture объявляет подготовку данных для тестов.
Устройство простого декоратора
Рассмотрим устройство на примере декоратора trace, печатающего каждый вызов функции. Декоратор получает исходную функцию в func и определяет новую, inner; та принимает аргументы в самом общем виде *args, **kwargs, применимом к любой функции; inner выполняет свою работу, передаёт управление оригиналу и возвращает полученный результат. Наружу декоратор возвращает inner.
def trace(func):
def inner(*args, **kwargs):
print(func.__name__, args, kwargs)
return func(*args, **kwargs)
return inner
func остаётся доступной внутри inner даже после завершения trace: это замыкание, рассмотренное в главе про функции.
Применим его.
@trace
def identity(x):
"I do nothing useful."
return x
identity(42) # Вывод: identity (42,) {} → 42
Проблема атрибутов функции
Побочный эффект заключается в том, что после декорирования имя identity ссылается уже не на исходную функцию, а на inner со всеми её атрибутами. Документация, имя и сигнатура берутся теперь от обёртки, и help не покажет ничего полезного.
identity.__name__ # 'inner'
help(identity) # Справка о inner, а не identity
Помимо неудобства при отладке, это нарушает работу всего, что опирается на имена функций, от автоматически собираемой документации до фреймворков, ищущих обработчики по имени.
Спасение через functools.wraps
functools.wraps является декоратором, копирующим в обёртку метаданные оригинала: __module__, __name__, __qualname__, __doc__ и __annotations__ (с Python 3.12 также __type_params__). Словарь атрибутов оригинала __dict__ дописывается в словарь обёртки, а ссылка на исходную функцию помещается в __wrapped__. При написании собственного декоратора над внутренней функцией всегда ставится @functools.wraps(func).
import functools
def trace(func):
@functools.wraps(func)
def inner(*args, **kwargs):
print(func.__name__, args, kwargs)
return func(*args, **kwargs)
return inner
Теперь identity.__name__ и help(identity) возвращают данные оригинала, а inspect.signature(identity), следуя по ссылке __wrapped__, показывает сигнатуру (x) вместо (*args, **kwargs). Та же ссылка позволяет вызвать исходную функцию в обход декоратора, а inspect.unwrap снимает всю цепочку обёрток. Ещё одно следствие касается сериализации: без wraps декорированную функцию нельзя передать модулю pickle, поскольку обёртка называется trace.<locals>.inner, а с wraps можно, что важно для передачи функций в процессы multiprocessing.
Декораторы с аргументами
Иногда декоратор необходимо настроить, например указать trace, куда выводить. Здесь появляется третий уровень вложенности. Запись @trace(sys.stderr) означает два действия: сначала вызывается trace(sys.stderr), и только полученный результат применяется к функции как декоратор, а значит, trace возвращает декоратор, который уже возвращает обёртку.
import sys
def trace(handle):
def decorator(func):
@functools.wraps(func)
def inner(*args, **kwargs):
print(func.__name__, args, kwargs, file=handle)
return func(*args, **kwargs)
return inner
return decorator
@trace(sys.stderr)
def identity(x):
return x
Эквивалентно:
decorator = trace(sys.stderr)
identity = decorator(identity)
Декораторы с опциональными аргументами
Два декоратора, приведённых выше, несовместимы по способу применения: один записывается как @trace, другой только как @trace(...). Чтобы работали оба варианта, декоратор анализирует переданное ему значение. Если получена func, декоратор применён без скобок и необходимо сразу возвращать обёртку. Если ничего не получено, вызов выполнен со скобками, и вернуть необходимо декоратор, применяемый следующим шагом.
def trace(func=None, *, handle=sys.stdout):
if func is None:
return lambda func: trace(func, handle=handle)
if not callable(func):
raise TypeError("настройки trace передаются по имени: trace(handle=...)")
@functools.wraps(func)
def inner(*args, **kwargs):
print(func.__name__, args, kwargs, file=handle)
return func(*args, **kwargs)
return inner
Использование:
@trace
def foo(): ...
@trace(handle=sys.stderr)
def bar(): ...
Звёздочка делает handle параметром, передаваемым только по имени, и настройка записывается как @trace(handle=sys.stderr). От ошибочной записи @trace(sys.stderr) звёздочка не защищает: файловый объект, переданный позиционно, всё равно попадает в func. Без проверки декоратор принял бы файл за декорируемую функцию и вернул бы обёртку, а уже при декорировании, когда эта обёртка получит identity вместо аргументов, возникла бы ошибка AttributeError с сообщением, не указывающим на причину. Проверка callable(func) превращает эту ситуацию в понятный TypeError.
Значение sys.stdout по умолчанию вычисляется при выполнении def, поэтому перенаправление contextlib.redirect_stdout, выполненное позже, печать trace не затрагивает: она уходит в исходный поток. Если это важно, по умолчанию указывают handle=None, а sys.stdout подставляют при вызове.
Полезные декораторы на практике
Декоратор @timethis для замера времени
Декоратор для измерения времени выполняет функцию n_iter раз и печатает лучший результат, а не средний. Среднее искажается любой случайной помехой наподобие переключения задач операционной системой, а минимум показывает, на что код способен в отсутствие помех. По той же причине в стандартной библиотеке предусмотрен timeit.repeat, возвращающий список измерений, из которого берётся min. Сам timeit.timeit минимума не вычисляет и возвращает суммарное время всех запусков, которое приходится самостоятельно делить на их число.
import time
def timethis(func=None, *, n_iter=100):
if func is None:
return lambda func: timethis(func, n_iter=n_iter)
@functools.wraps(func)
def inner(*args, **kwargs):
print(func.__name__, end=" ... ")
acc = float("inf")
for i in range(n_iter):
tick = time.perf_counter()
result = func(*args, **kwargs)
acc = min(acc, time.perf_counter() - tick)
print(acc)
return result
return inner
Декоратор @once для однократного вызова
Существует работа, которая выполняется один раз, сколько бы раз функция ни вызывалась: чтение конфигурации, установка соединения, разбор большого справочника. @once запоминает результат первого вызова и в дальнейшем возвращает сохранённое значение.
Хранить состояние декоратор мог бы в замыкании, но здесь оно размещено на inner: функция также является объектом и допускает произвольные атрибуты. Флаг при этом виден извне, и some_func.called покажет, вызывалась функция или нет.
def once(func):
@functools.wraps(func)
def inner(*args, **kwargs):
if not inner.called:
inner.result = func(*args, **kwargs)
inner.called = True
return inner.result
inner.called = False
return inner
Для функции без аргументов то же поведение даёт готовый @functools.cache (Python 3.9), рассматриваемый ниже.
Декоратор @memoized и мемоизация
Мемоизация представляет собой запоминание результата отдельно для каждого набора аргументов. Функция ведёт словарь «аргументы → результат» и ничего не вычисляет повторно, если ответ уже сохранён. Ключом служит кортеж из позиционных аргументов и отсортированных именованных; сортировка необходима, чтобы f(a=1, b=2) и f(b=2, a=1) попали в одну ячейку.
def memoized(func):
cache = {}
mark = object() # разделитель позиционных и именованных аргументов
@functools.wraps(func)
def inner(*args, **kwargs):
key = args + (mark,) + tuple(sorted(kwargs.items()))
if key not in cache:
cache[key] = func(*args, **kwargs)
return cache[key]
return inner
Между двумя частями ключа стоит особый объект-разделитель mark. Без него вызовы f(1, ("a", 2)) и f(1, a=2) дали бы одинаковый ключ (1, ("a", 2)) и получили бы один результат на двоих; так же, отдельным маркером, разделяет части ключа и functools.lru_cache.
Ключом словаря может быть только хешируемый объект, поэтому такая мемоизация приведёт к ошибке, если в функцию передать список, словарь или множество. Ради универсальности аргументы сериализуют, например через pickle, но тогда теряется скорость. На практике проще применять мемоизацию только к функциям с простыми аргументами и использовать готовый functools.lru_cache, рассматриваемый ниже.
Декоратор @deprecated для устаревших функций
Когда функцию планируется удалить, её сначала помечают устаревшей. Она ещё работает, но при каждом вызове выдаёт предупреждение; при фильтре по умолчанию оно выводится один раз для каждой строки, из которой функция вызвана. Это даёт пользователям библиотеки время переписать код.
import warnings
def deprecated(func):
@functools.wraps(func)
def inner(*args, **kwargs):
warnings.warn(
f"{func.__name__} устарела и будет удалена",
category=DeprecationWarning,
stacklevel=2, # показать строку вызывающего кода, а не эту
)
return func(*args, **kwargs)
return inner
Предупреждение должно выдаваться при вызове функции, поэтому warnings.warn располагается внутри inner. Если вынести его в тело декоратора, предупреждение сработает один раз при импорте модуля и больше никогда: пользователь получит сообщение об устаревшей функции, возможно даже не вызванной им, а при настоящих вызовах не получит ничего.
Аргумент stacklevel=2 переводит указатель со строки внутри декоратора на ту, где функция вызвана, и относит предупреждение к модулю вызывающего кода. Без него место вызова по предупреждению найти невозможно, а при фильтре по умолчанию предупреждение не выводится вовсе.
DeprecationWarning по умолчанию скрыт везде, кроме кода модуля __main__ (PEP 565, Python 3.7). Чтобы увидеть его в собственном коде, интерпретатор запускают с ключом -W default или добавляют строку warnings.simplefilter("always", DeprecationWarning); ключ -W error::DeprecationWarning превращает такие предупреждения в исключения, что удобно в тестах.
С Python 3.13 стандартная библиотека содержит готовый декоратор warnings.deprecated (PEP 702). Он выдаёт то же предупреждение при вызове и вдобавок сообщает об устаревании статическим анализаторам типов.
from warnings import deprecated
@deprecated("old_api устарела, её заменяет new_api")
def old_api(): ...
Контрактное программирование с декораторами
Контрактное программирование состоит в том, чтобы описывать в самой функции условия, требуемые от входа, и обещания, даваемые на выходе. Проверка, добавленная декоратором рядом с объявлением, видна сразу, а тело функции свободно от проверок. Запишем два декоратора, @pre для предусловия и @post для постусловия. Оба принимают проверяющую функцию и текст сообщения: pre проверяет аргументы до вызова, post — результат после.
def pre(cond, message):
def decorator(func):
@functools.wraps(func)
def inner(*args, **kwargs):
assert cond(*args, **kwargs), message
return func(*args, **kwargs)
return inner
return decorator
def post(cond, message):
def decorator(func):
@functools.wraps(func)
def inner(*args, **kwargs):
result = func(*args, **kwargs)
assert cond(result), message
return result
return inner
return decorator
Использование:
import math
@pre(lambda x: 0 < x < 1, "argument must be a fraction")
@post(lambda r: r < 0, "log of a fraction must be negative")
def log_fraction(x):
return math.log(x)
Предусловие на физический смысл аргумента (доля в интервале от 0 до 1, положительная масса, температура выше абсолютного нуля) останавливает расчёт на входе функции с понятным сообщением, а не порождает nan, обнаруживаемый только в итоговом графике.
assert полностью исключается из кода, если интерпретатор запущен с ключом -O. Для контрактов внутри собственной программы это подходит: при отладке проверка выполняется, а в рабочем режиме не выполняется, и остаётся лишь вызов обёртки. Чтобы убрать и его, декоратор возвращает функцию без обёртки: return inner if __debug__ else func. Данные, поступившие извне, проверять через assert нельзя, там необходим явный raise.
Цепочки декораторов
Декораторов на одной функции может быть несколько, и их порядок важен.
@deco1
@deco2
def foo(): ...
Применяются они снизу вверх, ближайший к def — первым.
foo = deco1(deco2(foo))
Сами выражения после @ вычисляются сверху вниз, что заметно у декораторов с аргументами, а полученные декораторы применяются снизу вверх. При вызове управление передаётся в обратную сторону: сначала во внешний deco1, затем во внутренний deco2 и только потом в саму функцию. Поэтому @functools.lru_cache располагают выше проверок, чтобы попадание в кеш не расходовало время на валидацию, а @timethis располагают ниже, чтобы он измерял саму функцию, а не работу декораторов, применённых сверху.
Декораторы стандартной библиотеки
Большая часть декораторов, встречающихся на практике, уже есть в стандартной библиотеке.
| Декоратор | Назначение |
|---|---|
@functools.lru_cache, @functools.cache | мемоизация |
@property, @classmethod, @staticmethod | методы классов |
@dataclasses.dataclass | класс данных |
@contextlib.contextmanager | менеджер контекста из генератора |
@atexit.register | вызов при завершении интерпретатора |
@warnings.deprecated("…") (Python 3.13) | пометка устаревших функций |
@typing.overload | варианты сигнатуры для анализаторов типов |
Декоратор применяется и к классу (PEP 3129): он получает класс и возвращает класс. Так устроен @dataclass, дописывающий по аннотациям полей методы __init__, __repr__ и __eq__; классы рассматриваются в главе «Классы».
Модуль functools
Рекурсия и предел глубины
Мемоизация особенно полезна для рекурсивных функций. Каждый рекурсивный вызов создаёт кадр стека со своими аргументами и локальными переменными, и кадры накапливаются, пока рекурсия не дойдёт до базового случая. Интерпретатор ограничивает глубину: sys.getrecursionlimit() по умолчанию возвращает 1000, и более глубокая рекурсия завершается ошибкой RecursionError.
def depth(n):
return 0 if n == 0 else 1 + depth(n - 1)
depth(900) # 900
depth(5000) # RecursionError: maximum recursion depth exceeded
Предел поднимается функцией sys.setrecursionlimit, но это откладывает проблему, а не решает её. Хвостовую рекурсию Python не оптимизирует; это сознательное решение, сохраняющее полную трассировку ошибок. Поэтому глубокая рекурсия переписывается циклом, при необходимости со своим стеком в списке. Предел на практике достигается там, где глубина рекурсии равна размеру данных: рекурсивный поиск связного кластера на решётке (перколяция, кластерный алгоритм Вольфа для модели Изинга) или обход графа в глубину на решётке 100 × 100 легко превышает 1000 уровней, а итеративный обход со стеком из списка такого ограничения не имеет. Сама рекурсия рассмотрена в главе «Рекурсия и сортировки», обход графа в глубину — в главе «Графы».
Другая проблема рекурсии заключается в повторных подзадачах: наивная функция для чисел Фибоначчи вычисляет одни и те же значения экспоненциально много раз.
def fib(n):
return n if n < 2 else fib(n - 1) + fib(n - 2)
Мемоизация с ограничением через lru_cache
Готовая замена рассмотренному выше @memoized. Кеш ограничен по размеру, и при переполнении из него вытесняется запись, к которой дольше всего не обращались, — так расшифровывается LRU, least recently used. Благодаря ограничению кеш не занимает всю память в долго работающей программе.
@functools.lru_cache(maxsize=128)
def expensive_func(x):
return x * x
С Python 3.8 декоратор записывается и без скобок, @functools.lru_cache, с размером по умолчанию 128. Значение maxsize=None снимает ограничение, и так поступают только для функций с заведомо небольшим числом различных аргументов; с Python 3.9 то же записывается короче: @functools.cache. Метод cache_info() показывает число попаданий и промахов, cache_clear() очищает кеш, а параметр typed=True хранит аргументы разных типов, например 1 и 1.0, раздельно. Если попаданий почти нет, кеш только расходует память.
Ограничение то же, что у самописного варианта: аргументы обязаны быть хешируемыми, поэтому функцию от массива NumPy так не кешируют. В отличие от @memoized, именованные аргументы в ключе не сортируются, и вызовы f(a=1, b=2) и f(b=2, a=1) могут занять две записи кеша.
Кеш превращает экспоненциальную рекурсию для чисел Фибоначчи в линейную, поскольку каждое значение вычисляется однажды. Предел глубины мемоизация при этом не снимает: fib(2000) с пустым кешем завершается RecursionError, поэтому таблицу значений заполняют по возрастанию n или считают циклом.
@functools.cache
def fib(n):
return n if n < 2 else fib(n - 1) + fib(n - 2)
fib(32) # 2178309
fib.cache_info() # CacheInfo(hits=30, misses=33, maxsize=None, currsize=33)
Без кеша вычисление fib(32) на Python 3.12 заняло около 0,15 с, с кешем — около 70 мкс.
Частичное применение через partial
partial закрепляет часть аргументов и возвращает новую функцию, которой закреплённые аргументы передавать уже не требуется. Это замена лямбде там, где необходимо донастроить готовую функцию перед передачей дальше.
f = functools.partial(sorted, key=lambda x: x[1])
f([('a', 4), ('b', 2)]) # [('b', 2), ('a', 4)]
int2 = functools.partial(int, base=2)
int2("1010") # 10
int2.keywords # {'base': 2}
У partial три преимущества перед лямбдой. Значения аргументов закрепляются в момент создания, поэтому ловушки позднего связывания нет. Объект partial сериализуется модулем pickle, если сериализуемы исходная функция и закреплённые аргументы, и потому передаётся в процессы через multiprocessing.Pool.map, где лямбда вызывает ошибку сериализации; исходная функция при этом определяется в импортируемом модуле, а не в ячейке блокнота (см. главу «Многопоточность и GIL»). Атрибуты func, args и keywords показывают, что именно закреплено. Интегратор quad ожидает функцию одной переменной, а функция Планка зависит от частоты и температуры: partial(planck, T=5800.0) закрепляет температуру.
С Python 3.14 объект functools.Placeholder позволяет закрепить не только первые позиционные аргументы: на его месте остаётся пропуск, заполняемый при вызове.
Обобщённые функции и singledispatch
Когда функция должна вести себя по-разному для разных типов, обычно применяется цепочка из isinstance. Она работает, но её приходится править всякий раз, когда появляется новый тип. С singledispatch базовая функция объявляется один раз, а реализации для конкретных типов регистрируются отдельно, в том числе из другого модуля.
@functools.singledispatch
def pack(obj):
raise TypeError(f"Unsupported type: {type(obj)}")
@pack.register(int)
def _(obj):
return b"I" + hex(obj).encode("ascii")
@pack.register(list)
def _(obj):
return b"L" + b",".join(map(pack, obj))
Выбор реализации выполняется по типу первого аргумента, отсюда «single» в названии, причём с учётом наследования: для True выбирается реализация для int, поскольку bool является подклассом int. Зарегистрированные функции названы _, поскольку обращаться к ним напрямую не требуется: вызываться всегда будет базовая pack.
С Python 3.7 тип указывается и аннотацией первого параметра регистрируемой функции, без аргумента у register; с Python 3.11 в такой аннотации допускается объединение типов. Для методов классов предусмотрен functools.singledispatchmethod (Python 3.8).
@pack.register
def _(obj: str):
return b"S" + obj.encode("utf-8")
Свёртка последовательности через reduce
reduce сворачивает последовательность в одно значение, беря первые два элемента, применяя к ним функцию, а к полученному результату применяя её же со следующим элементом, и так до конца. Необязательный третий аргумент задаёт начальное значение, которое ставится перед элементами и возвращается для пустой последовательности; без него свёртка пустой последовательности завершается ошибкой TypeError.
functools.reduce(lambda acc, x: acc * x, [1, 2, 3, 4]) # 24
В функциональных языках это базовая конструкция, а в Python она применяется редко: явный цикл читается лучше, а для наиболее частых свёрток предусмотрены готовые sum, min, max, any, all и появившаяся в Python 3.8 math.prod, для которой math.prod([1, 2, 3, 4]) даёт те же 24. Встроенная sum для чисел с плавающей точкой с Python 3.12 выполняет компенсированное суммирование и точнее свёртки через сложение: sum([0.1] * 10) даёт 1.0, а functools.reduce(operator.add, [0.1] * 10) — 0.9999999999999999.
Другие средства functools
Остальные средства модуля относятся к классам, обёрткам и сортировке. total_ordering достраивает все операции сравнения класса по __eq__ и одному из методов __lt__, __le__, __gt__, __ge__; cached_property (Python 3.8) вычисляет атрибут при первом обращении и запоминает значение; partialmethod и singledispatchmethod являются вариантами partial и singledispatch для методов; cmp_to_key переводит функцию сравнения старого стиля в функцию-ключ.
Заключение
Декоратор добавляет функции поведение, не затрагивая её тело, и тем самым не позволяет одной и той же обвязке распространяться по всей программе.
Таким образом, на практике потребуется следующее:
- Собственный декоратор всегда начинается с
@functools.wraps(func)над внутренней функцией. - Декоратор выполняется один раз, вместе с инструкцией
def, а обёртка — при каждом вызове функции. - Декоратор с аргументами представляет собой функцию, возвращающую декоратор; уровней вложенности становится три.
- Декоратор с необязательными настройками принимает их только по имени и проверяет, что первый аргумент является вызываемым объектом: звёздочка сама по себе не защищает от записи
@deco(x). - В цепочке декораторов ближайший к
defприменяется первым, а при вызове срабатывает последним. - Прежде чем писать собственную реализацию, следует обратиться к
functools:cache,lru_cache,partial,singledispatchиtotal_orderingпокрывают большую часть потребностей.
Дополнительные материалы:
- Python Decorator Library
- PEP 443 – Single-dispatch generic functions
- PEP 318 – Decorators for Functions and Methods
- PEP 702 – Marking deprecations using the type system
Классы
Класс связывает данные с операциями, определёнными над ними, и вместо разрозненных переменных и обрабатывающих их функций получается один объект, отвечающий за своё состояние. От Java и C++ Python отличается тем, что не скрывает механику: ссылка на экземпляр передаётся методу явным первым аргументом self, а не появляется в теле сама собой.
ООП в Python не является обязательным. Модуль, составленный из десятка функций, представляет собой полноценную программу, и оборачивать её в класс только ради класса не требуется. Классы применяются тогда, когда у данных появляется состояние, которое необходимо поддерживать согласованным, или когда одну и ту же операцию требуется выполнять по-разному для объектов разного вида, обрабатываемых единым кодом.
Слайды к главе. Материал главы изложен также в лекции «Классы в Python» (классы и экземпляры, методы и свойства, наследование, магические методы, дескрипторы, метаклассы) с демонстрациями в интерактивной оболочке; слайды лекции доступны на сайте книги и в PDF.
Базовые понятия
Определение класса
Метод __init__ вызывается сразу после создания объекта и задаёт начальное состояние; всё, записанное в self, становится атрибутом конкретного экземпляра, которым и пользуются остальные методы.
class Counter:
"""I count. That is all."""
def __init__(self, initial=0): # начальное состояние
self.value = initial # запись атрибута
def increment(self):
self.value += 1
def get(self):
return self.value # чтение атрибута
# Использование
c = Counter(42)
c.increment()
print(c.get()) # 43
Тело класса выполняется вместе с инструкцией class, обычно один раз, при импорте модуля: функции, объявленные в нём, становятся методами, а остальные присвоенные имена — атрибутами класса. Имена классов по PEP 8 записываются в стиле CapWords (Counter, MeasurementSeries).
Создание экземпляра: __new__ и __init__
Название «конструктор», закрепившееся за __init__, строго говоря неверно, поскольку объект к этому моменту уже создан. Вызов класса выполняется в два шага: метод __new__ получает те же аргументы, что и вызов, и создаёт объект, а затем __init__ заполняет заготовку, полученную от него. Разница проявляется при наследовании от неизменяемого типа наподобие int, float или tuple, у которого изменять уже нечего, и вся работа переносится в __new__.
class PositiveFloat(float):
def __new__(cls, value):
if value <= 0:
raise ValueError("нужно > 0")
return super().__new__(cls, value)
PositiveFloat(2.5) + 1 # 3.5
PositiveFloat(-1) # ValueError: нужно > 0
Объект проверен при создании и участвует в арифметике как обычное число, но результат арифметики — уже обычный float, и проверка на него не действует: PositiveFloat(2.5) - 3 даёт -0.5. Аргументы передаются в super().__new__ только тогда, когда их потребляет базовый класс: float.__new__ принимает значение, а object.__new__ с лишними аргументами завершается TypeError.
Специфика Python
Первым параметром обычного метода следует self, то есть экземпляр, на котором метод вызван, причём указывать его приходится вручную, в соответствии с правилом «явное лучше неявного». Методы класса и статические методы, рассматриваемые ниже, получают вместо экземпляра класс или ничего.
Модификаторов доступа наподобие private и protected в Python нет, вместо них действует соглашение об именовании.
public_attributeсоставляет часть публичного интерфейса, и его использование допустимо;_internal_attributeявляется внутренним, извне к нему не обращаются;__private_attributeозначает то же самое, но с дополнительной защитой от случайного переопределения, выполненного в подклассе.
Только за двойным подчёркиванием стоит механизм, встроенный в язык. Компилятор переписывает имя, помеченное таким образом, добавляя к нему имя класса, вследствие чего __private внутри класса Counter превращается в _Counter__private. Искажение лексическое: внутри тела класса self.__private и Counter.__private одинаково становятся _Counter__private. Механизм предназначен для предотвращения коллизий, а не для сокрытия данных, так что базовый класс и подкласс, объявив по атрибуту __cache, не столкнутся. Доступ к «приватному» атрибуту при этом сохраняется через полное имя. Имена с двумя подчёркиваниями с обеих сторон, такие как __init__, зарезервированы для специальных методов и не искажаются.
Атрибуты классов и экземпляров
Атрибуты в Python бывают двух видов, и путаница между ними приводит к трудноуловимым ошибкам.
Атрибуты экземпляра
Атрибут экземпляра появляется в результате присваивания, выполненного к self, и принадлежит только этому объекту. Создавать его не обязательно в __init__, поскольку присвоить атрибут можно и извне, уже созданному объекту.
class Noop:
def __init__(self):
self.some_attribute = 42
noop = Noop()
noop.other_attribute = 100500 # динамическое добавление
Эта свобода следует из того, что атрибуты хранятся в обычном словаре, и у неё есть оборотная сторона: опечатка в имени не вызовет ошибки. Строка noop.som_attribute = 0 без предупреждения создаст новый атрибут, а старый останется прежним.
Атрибуты класса
Атрибут, объявленный в теле класса, принадлежит самому классу и является одним на все его экземпляры. Это подходит для общих сущностей: настроек, констант, реестра созданных объектов.
class Counter:
all_counters = [] # атрибут класса
def __init__(self, initial=0):
Counter.all_counters.append(self)
self.value = initial
# Также можно добавлять атрибуты после определения
Counter.some_other_attribute = 42
Ловушка та же, что с изменяемыми аргументами по умолчанию: список all_counters создаётся один раз, при выполнении инструкции class. Если бы он был задуман как список, заведённый у каждого счётчика отдельно, все экземпляры разделяли бы один. Здесь общий список необходим, однако при объявлении изменяемого атрибута класса проверяется, должен ли он быть общим. Кроме того, такой реестр удерживает созданные счётчики, и они не освобождаются никогда; реестр, не удерживающий объекты, строится на weakref.WeakSet.
При чтении c.value интерпретатор ищет имя сначала в словаре экземпляра, затем в словаре класса, затем в базовых классах в порядке разрешения методов; исключения из этой схемы составляют дескрипторы, рассматриваемые в конце главы. Присваивание через экземпляр, напротив, всегда пишет в словарь экземпляра: c.all_counters = [] создаст у c собственный атрибут, заслоняющий атрибут класса, а del c.all_counters снова откроет атрибут класса.
Словарь атрибутов
Все атрибуты экземпляра хранятся в обычном словаре __dict__, благодаря которому и работает динамическое добавление. В него можно заглянуть и просмотреть поля, имеющиеся у объекта.
noop = Noop()
noop.some_attribute = 42
print(noop.__dict__) # {'some_attribute': 42}
print(vars(noop)) # тот же словарь
# Имя атрибута, вычисляемое во время выполнения
cfg = {"gain": 2.5, "threshold": 0.1}
for name, value in cfg.items():
setattr(noop, name, value)
getattr(noop, "gain") # 2.5
getattr(noop, "offset", 0.0) # значение по умолчанию вместо AttributeError
hasattr(noop, "threshold") # True
Встроенная vars() с аргументом возвращает __dict__ объекта, тот же словарь, а не копию, а без аргументов — словарь текущего локального пространства имён. Для имени атрибута, вычисляемого во время выполнения, применяются getattr, setattr, hasattr и delattr; прямая запись в __dict__ обходит свойства и __setattr__ и нужна редко, например внутри самого __setattr__. Параметры моделирования, прочитанные из файла настроек, переносятся в объект именно так, и имена при этом сверяются со списком допустимых: опечатка в файле создала бы лишний атрибут без сообщения об ошибке.
__slots__ для оптимизации
За гибкость приходится платить памятью: словарь атрибутов на объекте с двумя полями занимает больше самих полей. С Python 3.11 он создаётся лишь при первом обращении к __dict__, поэтому плата меньше, чем в прежних версиях, но при миллионах объектов, по одному на событие, зарегистрированное в эксперименте, она по-прежнему ощутима.
__slots__ фиксирует набор допустимых атрибутов заранее, благодаря чему интерпретатор обходится без словаря и размещает значения по ячейкам, отведённым при создании объекта.
class Event:
__slots__ = ("time", "energy") # фиксирует набор атрибутов
def __init__(self, time, energy):
self.time = time
self.energy = energy
e = Event(0.1, 511.0)
e.charge = -1 # AttributeError: 'Event' object has no attribute 'charge'
Замер модулем tracemalloc для 100 тысяч объектов с двумя полями, сложенных в список, вместе с 8 байтами ссылки из списка даёт в Python 3.12 88 байт на обычный объект, 152 байта после обращения к его __dict__ и 56 байт со __slots__; в 3.11 обычный объект занимает 96 байт. Скорость доступа при этом почти не меняется: в измерении из главы «Оптимизация средствами самого Python» разница оказалась в пределах шума. Взамен теряется динамика: атрибут, отсутствующий в списке, добавить не удастся, слабые ссылки работают, только если '__weakref__' указан в слотах, а подкласс без собственного __slots__ снова получает словарь. Начинать с __slots__ нецелесообразно; его добавляют тогда, когда профилировщик покажет, что память расходуется именно здесь. Для массовых числовых данных объекты заменяются массивами NumPy: событие из двух float64 в структурированном массиве занимает 16 байт вместе со значениями.
Методы
Методы и связывание
Метод представляет собой функцию, хранящуюся в атрибуте класса, и получить её можно двумя путями. Через класс получается обычная функция, требующая экземпляр, переданный явно. Через экземпляр получается связанный метод, в котором объект уже подставлен в self, и передавать его повторно не требуется.
class SomeClass:
def do_something(self):
print("Doing something.")
# Через класс — обычная функция (в Python 2 — несвязанный метод)
function = SomeClass.do_something
instance = SomeClass()
function(instance) # экземпляр передаётся явно
# Через экземпляр — связанный метод
bound_method = instance.do_something
bound_method() # self уже привязан
bound_method.__self__ is instance # True
Связанный метод представляет собой полноценный объект: его помещают в переменную, передают в map или регистрируют как обработчик события, а ссылку на свой экземпляр (__self__) и функцию (__func__) он хранит в себе. Создаётся он при каждом обращении: instance.do_something is instance.do_something даёт False. В Python 2 обращение через класс давало особый тип, проверявший тип первого аргумента и не пропускавший посторонние объекты; в Python 3 это обычная функция. Само связывание выполняет протокол дескрипторов, рассматриваемый ниже.
Методы класса и статические методы
Помимо обычных методов, класс может содержать методы, связанные не с экземпляром, а с самим классом, и методы, не связанные ни с чем.
class Particle:
def __init__(self, mass, v=0.0):
self.mass, self.v = mass, v
@classmethod
def from_momentum(cls, mass, p):
return cls(mass, v=p / mass) # нерелятивистский случай, v << c
@staticmethod
def gamma(v, c=299_792_458.0):
return 1 / (1 - (v / c) ** 2) ** 0.5
class Electron(Particle):
pass
e = Electron.from_momentum(9.109e-31, 2.7e-24)
type(e).__name__ # 'Electron'
Декоратор classmethod делает метод, первым аргументом которого приходит класс, а не экземпляр. Типичное применение — альтернативные конструкторы, как dict.fromkeys и datetime.fromtimestamp: поскольку cls — фактический класс вызова, подкласс получает объект своего типа. Декоратор staticmethod убирает привязку совсем: метод получает только переданные аргументы и является функцией, помещённой в пространство имён класса, потому что относится к нему по смыслу. Альтернативные конструкторы удобны для чтения данных разных форматов: Spectrum.from_csv(path) и Spectrum.from_hdf5(path) разбирают каждый свой формат и вызывают общий __init__.
Свойства (Properties)
Публичный атрибут иногда необходимо защитить проверкой или вычислять при обращении. В языках со строгой инкапсуляцией на этот случай заранее пишутся геттеры и сеттеры для всех полей. В Python атрибут остаётся атрибутом, а когда потребуется, за ним размещаются методы без изменения кода, использующего его.
Это обеспечивает декоратор @property: метод, помещённый под ним, вызывается при чтении, метод под @имя.setter при записи, метод под @имя.deleter при удалении. Извне всё выглядит как обычное присваивание.
class BigDataModel:
def __init__(self):
self._params = []
@property
def params(self):
return self._params
@params.setter
def params(self, new_params):
if any(p <= 0 for p in new_params):
raise ValueError("параметры должны быть положительны")
self._params = new_params
@params.deleter
def params(self):
del self._params
model = BigDataModel()
model.params = [0.1, 0.5, 0.4]
print(model.params) # [0.1, 0.5, 0.4]
Присваивание model.params = [...] выглядит как запись в обычное поле, но проходит через проверку в сеттере. assert для такой проверки не годится: при запуске интерпретатора с ключом -O он удаляется вместе с проверкой. Свойство без сеттера доступно только для чтения, и присваивание завершается AttributeError; с Python 3.11 сообщение звучит как property 'params' of 'BigDataModel' object has no setter. Интерфейс не меняется, а поведение за ним может меняться произвольно. Производные величины — kT, плотность, давление — удобно оформлять свойствами: они вычисляются из состояния и всегда с ним согласованы. Значение, которое трудоёмко вычислять и которое после этого не меняется, вычисляется один раз декоратором functools.cached_property (Python 3.8): результат первого обращения сохраняется в словаре экземпляра. Внутренне свойства построены на дескрипторах, рассматриваемых ниже.
Классы данных
Значительная часть классов в расчётном коде — записи с именованными полями: результат измерения, параметры прогона, конфигурация детектора. Для них __init__, __repr__ и __eq__ пишутся однообразно, и эту работу выполняет декоратор dataclass (Python 3.7, PEP 557), строящий методы по аннотированным полям.
from dataclasses import dataclass, field
@dataclass(frozen=True, slots=True)
class Measurement:
value: float
error: float = 0.0
unit: str = "м"
@dataclass
class Run:
number: int
events: list[int] = field(default_factory=list)
m = Measurement(9.81, 0.02)
m # Measurement(value=9.81, error=0.02, unit='м')
m == Measurement(9.81, 0.02) # True
m.value = 10 # FrozenInstanceError: cannot assign to field 'value'
Run(1).events is Run(2).events # False
| Параметр | Что даёт |
|---|---|
| по умолчанию | __init__, __repr__, __eq__ по полям |
frozen=True | запрет присваивания полям и __hash__ |
order=True | сравнения <, <=, >, >= по кортежу полей |
slots=True (3.10) | __slots__: без словаря и без новых атрибутов |
field(default_factory=list) | свой изменяемый объект у каждого экземпляра |
Изменяемое значение по умолчанию запрещено: объявление events: list = [] завершается ValueError с подсказкой применить default_factory. Аннотации при этом не проверяются: Measurement("9.81") создаётся без ошибки. От опечатки в имени поля защищает не всякий класс данных: лишний именованный аргумент при создании объекта даёт TypeError, но присваивание run.evnets = [1] у обычного @dataclass создаёт новый атрибут, и ошибку дают только slots=True или frozen=True. dataclass является декоратором класса, а не метаклассом: методы дописываются к готовому классу, а при slots=True декоратор возвращает новый класс со __slots__. Для неизменяемых записей без методов есть также typing.NamedTuple.
Наследование
Базовое наследование
Подкласс получает всё, объявленное у родителя, и добавляет своё. Если метода нет у подкласса, интерпретатор поднимается по цепочке наследования и ищет его выше. OtherCounter не определяет __init__, поэтому при создании работает родительский.
class Counter:
def __init__(self, initial=0):
self.value = initial
class OtherCounter(Counter):
def get(self):
return self.value
oc = OtherCounter() # вызывает Counter.__init__
print(oc.get()) # вызывает OtherCounter.get
Принадлежность объекта классу проверяется функцией isinstance(oc, Counter), учитывающей наследование, а не сравнением type(oc) == Counter, которое для экземпляра подкласса даёт False; issubclass(OtherCounter, Counter) проверяет отношение самих классов. Родителей, в отличие от многих языков, может быть несколько, и чем сложнее иерархия, тем труднее определить, чей метод, найденный по цепочке, будет вызван.
Переопределение методов и super()
Чаще подкласс не заменяет метод родителя целиком, а надстраивает над ним своё и передаёт управление выше, а ссылку на реализацию, унаследованную от родителя, предоставляет super().
class Counter:
all_counters = []
def __init__(self, initial=0):
self.__class__.all_counters.append(self)
self.value = initial
def increment(self):
self.value += 1
def get(self):
return self.value
class OtherCounter(Counter):
def __init__(self, initial=0):
self.initial = initial
super().__init__(initial) # вызов родительского __init__
Запись Counter.__init__(self, initial) вместо super() является распространённой ошибкой, и разница проявится при множественном наследовании. super() обращается не к родителю, а к следующему классу в порядке разрешения методов класса того объекта, у которого вызван метод (type(self).__mro__): у ThreadSafeCounter из раздела о примесях за примесью следует Counter, хотя примесь о нём не знает. Имя родителя, указанное явно, эту цепочку разрывает. Форма без аргументов работает благодаря неявной ячейке __class__, которую компилятор создаёт для функций, объявленных в теле класса; ручная запись super(self.__class__, self) при трёх уровнях наследования уходит в бесконечную рекурсию.
Множественное наследование
Порядок, в котором интерпретатор перебирает классы в поисках метода, называется MRO, то есть method resolution order, и вычисленный порядок доступен у любого класса.
class A:
def f(self):
print("A.f")
class B:
def f(self):
print("B.f")
class C(A, B):
pass
print(C.mro()) # порядок разрешения методов
C().f() # A.f (согласно MRO)
Здесь f находится в A, поскольку A стоит первым в списке родителей, перечисленных в скобках. Порядок, выстраиваемый здесь, вычисляет алгоритм C3, предложенный для языка Dylan и используемый в Python с версии 2.3, и он обеспечивает три гарантии. Подкласс всегда следует раньше своих родителей; порядок, в котором родители перечислены, сохраняется; каждый класс иерархии встречается в списке единожды. MRO вычисляется при создании класса, и если требования противоречат друг другу, Python откажется создавать класс.
class D(A, C): # C — подкласс A, но указан после него
pass
# TypeError: Cannot create a consistent method resolution
# order (MRO) for bases A, C
Классы-примеси
Примесью (mixin) называют класс, не предназначенный для самостоятельного использования и не описывающий сущность, а только добавляющий к чужому поведению одну черту, будь то блокировка, журналирование или кеширование. Ниже примесь оборачивает операции счётчика в блокировку, захватываемую на время вызова.
import threading
class ThreadSafeMixin:
def __init__(self, *args, **kwargs):
self._lock = threading.Lock()
super().__init__(*args, **kwargs)
def get_lock(self):
return self._lock
def increment(self):
with self.get_lock():
super().increment()
def get(self):
with self.get_lock():
return super().get()
class ThreadSafeCounter(ThreadSafeMixin, Counter):
pass
Всё это работает благодаря super() и порядку разрешения методов. Примесь стоит перед Counter в списке родителей, поэтому её increment перехватывает вызов первым, а super().increment(), расположенный внутри, передаётся дальше по цепочке, в настоящий счётчик. ThreadSafeMixin не наследуется от Counter и ничего о нём не знает: следующий класс в MRO определяется в момент, когда собирается ThreadSafeCounter. Замок при этом необходим и при GIL: self.value += 1 выполняется несколькими инструкциями байт-кода, и переключение потоков между ними возможно. Аналогичным образом устроены socketserver.ThreadingMixIn и значительная часть Django.
Композиция вместо наследования
Наследование выражает отношение «является»: электрон — частица, и любой код, работающий с частицей, обязан работать и с электроном (принцип подстановки Лисков). Если же объект лишь использует другой — детектор состоит из каналов, ускоритель — из магнитов и резонаторов, — это композиция: объект хранит другие объекты в атрибутах и поручает им работу.
class Channel:
def __init__(self, number, gain):
self.number, self.gain = number, gain
class Detector:
def __init__(self, channels):
self.channels = list(channels) # содержит, а не является
def total_gain(self):
return sum(c.gain for c in self.channels)
Композицию проще понимать и тестировать, её части заменяются независимо, а глубокие иерархии наследования связывают классы жёстко. Признак неудачного наследования — подкласс, отключающий унаследованные методы или меняющий их смысл, как квадрат, унаследованный от прямоугольника с независимо изменяемыми сторонами.
Декораторы классов
Декоратор применяется не только к функциям: класс также является объектом, и его можно пропустить через функцию, возвращающую нечто другое. Классическим примером служит синглтон, где класс подменяется функцией, создающей экземпляр при первом вызове и в дальнейшем возвращающей тот же самый.
import functools
def singleton(cls):
instance = None
@functools.wraps(cls)
def inner(*args, **kwargs):
nonlocal instance
if instance is None:
instance = cls(*args, **kwargs)
return instance
return inner
@singleton
class Noop:
"I do nothing at all."
print(Noop() is Noop()) # True
Проверка Noop() is Noop() сравнивает два живых объекта. Распространённая запись id(Noop()) == id(Noop()) ничего не доказывает: первый временный объект уничтожается до создания второго, его адрес переиспользуется, и для обычного класса такое сравнение тоже даёт True. Цена синглтона в таком виде — класс подменён функцией, поэтому isinstance(x, Noop) и наследование от Noop больше не работают.
Декораторы классов появились в Python 2.6 и 3.0 (PEP 3129) и потеснили метаклассы: многое, ради чего раньше писался метакласс, теперь выполняется одной функцией. Наиболее известным примером является @dataclass, рассмотренный выше.
Магические методы
Магическими (или специальными) методами называют методы, чьи имена окружены двойными подчёркиваниями. Напрямую их не вызывают, поскольку за каждым стоит синтаксическая конструкция или встроенная функция. Определение нужного метода позволяет объекту вести себя как встроенный, то есть складываться, сравниваться, печататься, попадать в множество.
| Запись | Вызов |
|---|---|
len(x) | x.__len__() |
x + y | x.__add__(y), иначе y.__radd__(x) |
x == y, x < y | x.__eq__(y), x.__lt__(y) |
x[i], x[i] = v | x.__getitem__(i), x.__setitem__(i, v) |
for v in x | iter(x), то есть x.__iter__() |
x(...) | x.__call__(...) |
repr(x), str(x), f"{x:.2f}" | x.__repr__(), x.__str__(), x.__format__(".2f") |
if x | x.__bool__(), иначе x.__len__() |
hash(x) | x.__hash__() |
Неявный вызов ищет специальный метод у типа объекта, минуя словарь экземпляра: метод, присвоенный экземпляру (obj.__len__ = ...), на len(obj) не влияет.
Управление атрибутами
Первая группа перехватывает работу с атрибутами. __getattr__ вызывается только тогда, когда обычный поиск завершился AttributeError, и в нём подставляется значение вместо ошибки. __setattr__ и __delattr__, напротив, перехватывают любую запись и любое удаление.
class Settings:
def __init__(self, **values):
object.__setattr__(self, "_values", values)
def __getattr__(self, name):
# Вызывается, если обычный поиск не нашёл атрибут
values = self.__dict__.get("_values", {})
if name in values:
return values[name]
raise AttributeError(name)
def __setattr__(self, name, value):
# Вызывается при записи любого атрибута
raise AttributeError("настройки только для чтения")
def __delattr__(self, name):
# Вызывается при удалении любого атрибута
raise AttributeError("настройки только для чтения")
cfg = Settings(gain=2.5, threshold=0.1)
print(cfg.gain) # 2.5
hasattr(cfg, "offset") # False
cfg.gain = 3 # AttributeError: настройки только для чтения
Для неизвестного имени __getattr__ обязан бросать AttributeError, а не возвращать значение и не бросать другое исключение: на этом основаны hasattr, getattr со значением по умолчанию, копирование copy и сериализация pickle. Поскольку __getattr__ вызывается и тогда, когда AttributeError возникла внутри геттера свойства, он может маскировать ошибку в свойстве. Запись внутри __setattr__ выполняется через object.__setattr__ или super().__setattr__, иначе self.name = value снова вызовет метод и приведёт к бесконечной рекурсии; по той же причине __getattr__ читает служебное поле через self.__dict__: у объекта, созданного копированием без вызова __init__, этого поля ещё нет. Переопределять __getattribute__, перехватывающий доступ ко всем атрибутам, а не только к отсутствующим, не рекомендуется. Готовый объект с доступом к значениям через точку — types.SimpleNamespace.
Операторы сравнения
Вторая группа отвечает за сравнение, и методов в ней шесть, но записывать все шесть не требуется: декоратор @functools.total_ordering достроит остальные по __eq__ и любому одному из методов, задающих упорядочивание.
import functools
@functools.total_ordering
class Counter:
def __init__(self, value):
self.value = value
def __eq__(self, other):
if not isinstance(other, Counter):
return NotImplemented
return self.value == other.value
def __lt__(self, other):
if not isinstance(other, Counter):
return NotImplemented
return self.value < other.value
c1, c2 = Counter(1), Counter(2)
print(c1 < c2) # True
print(c1 >= c2) # False (достроено из __lt__ и __eq__)
print(c1 == 1) # False: сравнение с объектом другого типа
Для объекта чужого типа методы возвращают NotImplemented, и интерпретатор пробует отражённую операцию второго операнда, а при неудаче сравнивает объекты на равенство по идентичности; без этой проверки Counter(1) == 1 завершилось бы AttributeError. __ne__ по умолчанию обращает результат __eq__, а при отсутствии __gt__ интерпретатор пробует отражённое c2 < c1, поэтому без total_ordering не выводятся только <= и >=.
Определение __eq__ отключает хеширование: интерпретатор присваивает __hash__ = None, и объект не попадёт ни в множество, ни в ключи словаря. Причина та же, что у изменяемых коллекций: равные объекты обязаны иметь равные хеши, а хеш по умолчанию основан на идентичности объекта и с новым равенством не согласован. Если объект должен оставаться хешируемым, __hash__ определяется явно и вычисляется из тех же полей, что участвуют в сравнении, причём только для объектов, которые после создания не меняются: объект, изменившийся после помещения в множество, поиск в нём не находит.
Строковое представление
Третья группа отвечает за текстовое представление. __repr__ предназначен для программиста: он должен быть однозначным и в идеале выглядеть как выражение, воссоздающее объект. __str__ предназначен для человека, просматривающего вывод программы. Если __str__ не определён, Python использует __repr__, поэтому начинают именно с него.
class Counter:
def __init__(self, initial=0):
self.value = initial
def __repr__(self):
return f"Counter({self.value})"
def __str__(self):
return f"Counted to {self.value}"
def __format__(self, format_spec):
return self.value.__format__(format_spec)
c = Counter(42)
print(repr(c)) # Counter(42)
print(str(c)) # Counted to 42
print(f"{c:b}") # 101010 (бинарное представление)
Третий метод, __format__, отвечает за подстановку в f-строку со спецификатором, а здесь он передаёт полученный спецификатор дальше в целое число, поэтому {c:b} печатает значение счётчика в двоичном виде.
__repr__ имеет смысл определять у любого класса, существующего дольше пары строк, иначе при отладке объекты печатаются как <__main__.Counter object at 0x7f3a…>.
Арифметические операторы и NotImplemented
Арифметические операторы вызывают методы __add__, __sub__, __mul__, __truediv__, __pow__ и другие. Класс величины с погрешностью ниже складывает погрешности независимых величин в квадратуре и масштабирует погрешность при умножении на точное число.
import math
class Measured:
def __init__(self, value, error):
self.value, self.error = value, error
def __repr__(self):
return f"Measured({self.value!r}, {self.error!r})"
def __add__(self, other):
if not isinstance(other, Measured):
return NotImplemented
error = math.hypot(self.error, other.error)
return Measured(self.value + other.value, error)
def __mul__(self, k):
if not isinstance(k, (int, float)):
return NotImplemented
return Measured(self.value * k, abs(k) * self.error)
__rmul__ = __mul__
a, b = Measured(1.5, 0.3), Measured(2.5, 0.4)
a + b # Measured(4.0, 0.5)
2 * a # Measured(3.0, 0.6): отражённый __rmul__
a + 1 # TypeError: unsupported operand type(s) for +: 'Measured' and 'int'
Если левый операнд не умеет работать с правым, метод возвращает специальное значение NotImplemented, и интерпретатор пробует отражённый метод правого операнда: для a + b это b.__radd__(a). Если и он вернул NotImplemented, возникает TypeError. Поэтому для неподходящего типа возвращается NotImplemented, а не бросается исключение: другой тип сохраняет возможность обработать операцию. Отражённый метод вызывается, только если типы операндов различны; если правый операнд — экземпляр подкласса и переопределяет отражённый метод, этот метод вызывается первым. __rmul__ нужен, чтобы работало 2 * a: умножение int на Measured не определено. Для составного присваивания a += b ищется __iadd__, а без него выполняется __add__ с созданием нового объекта; унарные операции — __neg__, __pos__, __abs__.
Зависимость величин класс не учитывает: a + a даёт погрешность σ√2, хотя верно 2σ, как у 2 * a. Учёт корреляций и производных для нелинейных функций реализован в пакете uncertainties.
Протоколы коллекций
Коллекции определяются протоколами — наборами методов. Спектр ниже определяет два метода и уже ведёт себя как последовательность.
class Spectrum:
def __init__(self, counts):
self._counts = list(counts)
def __len__(self):
return len(self._counts)
def __getitem__(self, i):
if isinstance(i, slice):
return type(self)(self._counts[i])
return self._counts[i]
s = Spectrum([3, 5, 8, 2])
len(s), s[2] # (4, 8)
list(s), 8 in s # ([3, 5, 8, 2], True)
list(reversed(s)) # [2, 8, 5, 3]
type(s[1:3]).__name__ # 'Spectrum'
__len__ даёт функцию len и, при отсутствии __bool__, истинность: пустая коллекция ложна. __getitem__ даёт индексирование, а получив объект slice, — срезы; здесь срез возвращает новый спектр, а не список. Двух методов достаточно, чтобы объект перебирался в цикле for (интерпретатор вызывает __getitem__ с индексами 0, 1, 2 и так далее до IndexError), проверялся оператором in и разворачивался функцией reversed. Современный протокол перебора — метод __iter__, возвращающий итератор (глава «Итераторы, генераторы и корутины»); __contains__ ускоряет проверку in, если ответ получается без перебора, а __setitem__ и __delitem__ дают запись и удаление элементов. Наследование от collections.abc.Sequence добавит index, count и __reversed__ по тем же двум методам и сделает объект последовательностью для isinstance; без него isinstance(s, Sequence) даёт False.
Другие полезные магические методы
__call__ делает экземпляр вызываемым: g(x) выполняет g.__call__(x).
import math
class Gaussian:
def __init__(self, mu, sigma):
self.mu, self.sigma = mu, sigma
def __call__(self, x):
z = (x - self.mu) / self.sigma
return math.exp(-z * z / 2)
g = Gaussian(0.0, 2.0)
g(2.0) # 0.6065306597126334
callable(g) # True
Такой объект подходит везде, где ожидается функция, — в интеграторе scipy.integrate.quad, оптимизаторе или в sorted как ключ, — и, в отличие от замыкания, хранит параметры в именованных атрибутах, имеет repr и может иметь другие методы. На __call__ основаны и декораторы, реализованные классами. __bool__ задаёт, что объект означает в условии if; без него Python обращается к __len__, и объект нулевой длины оказывается ложным, а объект без обоих методов истинен всегда. __hash__ определяет, как объект попадает в множества и словари; хеш по умолчанию выводится из идентичности объекта, и писать его вручную для этого не требуется.
Дескрипторы
Свойство решает задачу для одного атрибута одного класса, а проверка на положительность требуется десяткам полей в разных классах. Дескриптор выносит логику доступа в отдельный класс, откуда её можно переиспользовать.
Базовый дескриптор
Дескриптор представляет собой объект, класс которого определяет хотя бы один из методов __get__, __set__ или __delete__. Помещённый в атрибут класса, он перехватывает обращение к этому атрибуту у всех экземпляров: чтение obj.x вызывает __get__(obj, type(obj)), обращение через класс — __get__(None, cls), запись — __set__, удаление — __delete__. Метод __set_name__ (Python 3.6, PEP 487) вызывается при создании класса и сообщает дескриптору имя, под которым он записан.
class Positive:
def __set_name__(self, owner, name):
self.public, self.name = name, "_" + name
def __get__(self, obj, objtype=None):
if obj is None:
return self
return getattr(obj, self.name)
def __set__(self, obj, value):
if value <= 0:
raise ValueError(f"{self.public}: ожидается > 0")
setattr(obj, self.name, value)
class Particle:
mass = Positive()
lifetime = Positive()
def __init__(self, mass, lifetime):
self.mass, self.lifetime = mass, lifetime
muon = Particle(0.1057, 2.2e-6)
muon.lifetime = -1 # ValueError: lifetime: ожидается > 0
vars(muon) # {'_mass': 0.1057, '_lifetime': 2.2e-06}
Проверка написана один раз, защищённых ею полей два, и добавление третьего требует одной строки. Обращение через класс, Particle.mass, передаёт obj = None, и по соглашению возвращается сам дескриптор.
Дескрипторы данных определяют __set__ или __delete__, дескрипторы не данных — только __get__. От этого зависит порядок поиска при чтении атрибута:
- дескриптор данных в классе или его базовых классах;
- запись в словаре экземпляра;
- дескриптор не данных или обычный атрибут класса;
- метод
__getattr__, если он определён, иначеAttributeError.
Поэтому дескриптор данных, например свойство, нельзя заслонить записью в словарь экземпляра, а дескриптор не данных — можно. Через дескрипторы в Python реализовано почти всё, связанное с атрибутами: и @property, и @staticmethod, и @classmethod, и сама привязка методов к экземпляру. Обычная функция — дескриптор не данных, её __get__ возвращает связанный метод, поэтому функция, хранящаяся в классе, при обращении через экземпляр оказывается связанным методом, а атрибут экземпляра с тем же именем её заслоняет. Встроенные функции вроде len дескрипторами не являются: после A.length = len вызов A().length() метода не даёт.
Хранение данных в дескрипторах
Хранить значение в самом дескрипторе нельзя: он один на весь класс, а экземпляров много, и значения, записанные ими, затирали бы друг друга. Дескриптор Positive хранит значение в атрибуте экземпляра с подчёркиванием; другой вариант — запись в словаре экземпляра под меткой поля.
class Proxy:
def __init__(self, label):
self.label = label
def __get__(self, instance, owner):
if instance is None:
return self
try:
return instance.__dict__[self.label]
except KeyError:
raise AttributeError(self.label) from None
def __set__(self, instance, value):
instance.__dict__[self.label] = value
def __delete__(self, instance):
del instance.__dict__[self.label]
class Something:
attr = Proxy("attr")
some = Something()
some.attr = 42
print(some.attr) # 42
У каждого экземпляра значение своё, и существует оно столько же, сколько сам экземпляр. Отсутствующее значение даёт AttributeError, а не KeyError, иначе hasattr и getattr со значением по умолчанию завершались бы ошибкой. Вариант со словарём «экземпляр → значение», заведённым внутри дескриптора, хуже по двум причинам: он требует хешируемых объектов и удерживает их, не позволяя сборщику мусора удалить, если не применить weakref.WeakKeyDictionary. Ключ id(instance) вместо самого экземпляра не помогает: после удаления объекта тот же адрес получает новый объект вместе с чужим значением.
Имя поля приходится дублировать в Proxy("attr"); начиная с Python 3.6 от этого избавляет метод __set_name__, как в Positive.
Встроенные дескрипторы
Три реализации ниже сокращены, но передают устройство, заложенное в интерпретатор.
# @property реализован через дескрипторы
class property:
def __init__(self, fget=None, fset=None, fdel=None):
self.fget, self.fset, self.fdel = fget, fset, fdel
def __get__(self, instance, owner):
if instance is None:
return self
if self.fget is None:
raise AttributeError("свойство без геттера")
return self.fget(instance)
def __set__(self, instance, value):
if self.fset is None:
raise AttributeError("свойство без сеттера")
self.fset(instance, value)
def __delete__(self, instance):
if self.fdel is None:
raise AttributeError("свойство без делитера")
self.fdel(instance)
# @staticmethod и @classmethod тоже используют дескрипторы
class staticmethod:
def __init__(self, method):
self.__method = method
def __get__(self, instance, owner):
return self.__method
class classmethod:
def __init__(self, method):
self.__method = method
def __get__(self, instance, owner):
if owner is None:
owner = type(instance)
return self.__method.__get__(owner, type(owner))
property — дескриптор данных даже без сеттера: запись в свойство только для чтения завершается AttributeError, а не создаёт атрибут экземпляра. Вся разница между @staticmethod и @classmethod заключается в их __get__. Статический метод возвращает исходную функцию без привязки, поэтому self в нём отсутствует. Метод класса привязывает функцию к классу, и первым аргументом приходит сам класс. Аналогично, только к экземпляру, привязываются обычные методы.
Метаклассы
Поскольку класс является объектом, у него также есть тип. Типом обычного класса служит type, а метаклассом называют класс, экземплярами которого оказываются другие классы; обычно это подкласс type. Сам type — метакласс по умолчанию, и type(type) — снова type. Если обычный класс описывает, как устроены его объекты, то метакласс описывает, как устроены сами классы.
Требуются они редко: почти всё, ради чего раньше писались метаклассы, сегодня выполняется декоратором, применённым к классу, или методом __init_subclass__. На метаклассах построены abc.ABCMeta, enum.EnumType (до Python 3.11 — EnumMeta), модели Django и pydantic, где поля, объявленные в классе, описываются декларативно.
Создание класса
Инструкция class выполняется в несколько шагов, и каждый даёт точку вмешательства:
- выбор метакласса — наиболее производного из указанного аргументом
metaclassи метаклассов базовых классов, при их отсутствии —type; - вызов метода метакласса
__prepare__(name, bases), возвращающего словарь для пространства имён тела; - выполнение тела класса в этом словаре;
- вызов метакласса
metaclass(name, bases, namespace): его__new__создаёт объект класса,__init__донастраивает; - внутри
type.__new__— вызов__set_name__у дескрипторов и__init_subclass__у ближайшего базового класса; - применение декораторов класса к готовому классу и связывание имени.
Создание классов через type()
Без инструкции class тот же класс создаётся вызовом type с тремя аргументами: именем, родителями и словарём атрибутов.
# Эквивалентно class Something: attr = 42
name, bases, attrs = "Something", (), {"attr": 42}
Something = type(name, bases, attrs)
some = Something()
print(some.attr) # 42
Так классы строят программно, например по описанию таблицы или конфигурации. Эквивалентность неполная: методы, переданные в type() извне, не могут вызывать super() без аргументов, поскольку ячейку __class__ компилятор создаёт только для функций, объявленных в теле класса.
__init_subclass__
Метод __init_subclass__ (Python 3.6, PEP 487) вызывается у базового класса при создании каждого подкласса и получает именованные аргументы из строки объявления. Так строится реестр подклассов, позволяющий выбрать реализацию по строке из файла конфигурации, проверяются обязательные атрибуты, задаются настройки, — без метакласса.
class Reader:
registry = {}
def __init_subclass__(cls, /, name=None, **kwargs):
super().__init_subclass__(**kwargs)
if name is not None:
Reader.registry[name] = cls
class CsvReader(Reader, name="csv"): ...
class Hdf5Reader(Reader, name="hdf5"): ...
class GzipCsvReader(CsvReader): ... # без имени — в реестр не попадает
sorted(Reader.registry) # ['csv', 'hdf5']
reader = Reader.registry["hdf5"]()
Значение None по умолчанию позволяет объявлять промежуточные подклассы без имени: если бы параметр name был обязательным, объявление GzipCsvReader завершилось бы TypeError.
Базовый метакласс
Метакласс перехватывает создание класса, а его метод __new__ получает всё, из чего класс будет собран, то есть имя, кортеж родителей и словарь, составленный из тела класса, и может изменить или проверить полученное до создания класса.
class Meta(type):
def __new__(mcls, name, bases, ns):
print("создаётся", name, list(ns))
return super().__new__(mcls, name, bases, ns)
class Detector(metaclass=Meta):
gain = 2.5
# создаётся Detector ['__module__', '__qualname__', 'gain']
class Tracker(Detector):
pass
# создаётся Tracker ['__module__', '__qualname__']
Метакласс наследуется: подкласс Tracker создан тем же Meta, хотя не указывает его. Если у базовых классов разные метаклассы, не связанные наследованием, возникает TypeError: metaclass conflict. В Python 3.13 в пространстве имён класса появились также служебные __firstlineno__ и __static_attributes__, и печать в примере длиннее.
Второй метод, __prepare__, выбирает, в чём накапливать тело класса, пока оно выполняется. С версии 3.6 (PEP 520) обычный словарь и без него сохраняет порядок объявления атрибутов, поэтому собственное отображение нужно не ради порядка, а для контроля присваиваний: так enum запрещает повторное имя члена перечисления, и объявление RED дважды завершается TypeError: 'RED' already defined as 1. После создания класса пространство имён копируется в обычный словарь, и возможности собственного отображения доступны лишь внутри __new__.
Модуль abc для абстрактных базовых классов
Абстрактный базовый класс описывает интерфейс: перечисляет методы, обязательные для наследника, и может содержать общий алгоритм, опирающийся на них. Ниже базовый класс реализует общий цикл интегрирования run, а подклассы — только шаг схемы; такой приём называется шаблонным методом.
from abc import ABC, abstractmethod
class Integrator(ABC):
@abstractmethod
def step(self, f, t, y, h): ...
def run(self, f, y0, t0, t1, n):
h, t, y = (t1 - t0) / n, t0, y0
for _ in range(n):
y, t = self.step(f, t, y, h), t + h
return y
class Euler(Integrator):
def step(self, f, t, y, h):
return y + h * f(t, y)
Integrator() # TypeError
Euler().run(lambda t, y: -y, 1.0, 0.0, 1.0, 1000) # 0.36769542477096373
Пока хотя бы один абстрактный метод не реализован, экземпляр не создаётся. Ошибка TypeError возникает при создании экземпляра, а не при первом обращении к недостающему методу, тогда как неполный подкласс объявляется без ошибки: так допускаются промежуточные абстрактные классы, а нереализованные абстрактные методы наследуются абстрактными. Текст ошибки зависит от версии; в Python 3.12 он звучит как Can't instantiate abstract class Integrator without an implementation for abstract method 'step'. Схема Эйлера на отрезке [0, 1] за 1000 шагов даёт 0,36770 при точном значении exp(−1) ≈ 0,36788, как и ожидается для схемы первого порядка; схемы Рунге — Кутты и Верле (для уравнений движения q'' = a(q)) реализуют тот же метод step, и сравнение их точности на одной задаче сводится к замене объекта-интегратора.
Отдельной конструкции interface, как в Java, в Python нет: интерфейсы описываются обычными классами с метаклассом abc.ABCMeta, проще всего — наследованием от готового abc.ABC. Метод register объявляет виртуальный подкласс для isinstance без проверки методов. Структурную проверку без наследования даёт typing.Protocol (Python 3.8, PEP 544): анализатор типов принимает любой объект с нужными методами.
Модуль collections.abc
Абстрактные классы для самих коллекций уже написаны и находятся в collections.abc, и это те же Container, Iterable, Sequence и Mapping, рассмотренные в главе «Коллекции». Наследование даёт две выгоды: интерпретатор сначала проверит, что реализовано всё обязательное, а затем сам добавит остальное. Реализация у MutableMapping пяти методов даёт готовые get, pop, popitem, setdefault, update, clear, items, keys, values, проверку in и сравнение.
from collections import deque
from collections.abc import MutableMapping
class MemorizingDict(MutableMapping):
def __init__(self, *args, **kwargs):
self._data = {}
self._history = deque(maxlen=10)
self.update(*args, **kwargs) # через __setitem__, с историей
def __getitem__(self, key):
return self._data[key]
def __setitem__(self, key, value):
self._history.append(key)
self._data[key] = value
def __delitem__(self, key):
del self._data[key]
def __iter__(self):
return iter(self._data)
def __len__(self):
return len(self._data)
def get_history(self):
return self._history
Написано пять обязательных методов и один собственный, а в результате получается полноценный словарь, запоминающий десять последних записанных ключей, включая ключи из конструктора: update из MutableMapping записывает их через __setitem__. Он пройдёт isinstance(d, MutableMapping) и будет принят функциями, работающими с любым отображением, например str.format_map; json.dumps принимает только dict, и для него выполняется dict(d).
Наследоваться ради той же задачи напрямую от dict ненадёжно: методы dict, реализованные на C, не вызывают переопределённый __setitem__, и конструктор, update и setdefault записывают ключи в обход истории. Для собственных отображений поэтому берут collections.abc.MutableMapping или collections.UserDict.
Заключение
Большая часть этого инструментария в повседневной практике не потребуется: собственный метакласс за студенческую практику, скорее всего, не понадобится ни разу, собственный дескриптор — в лучшем случае однажды. Рассматриваются они потому, что почти всё, кажущееся в Python магией, оказывается одним из этих механизмов.
В повседневной работе достаточно немногого:
- Класс необходим там, где есть состояние, которое требуется поддерживать согласованным. Если состояния нет, достаточно функции.
- Для записи с именованными полями достаточно
@dataclass. - Атрибут остаётся атрибутом; свойство добавляется тогда, когда за ним потребовалась логика.
__repr__определяется сразу, а методы сравнения и арифметики возвращаютNotImplementedдля чужих типов.- В переопределённых методах родитель вызывается через
super(), а не по имени класса. - Прежде чем строить иерархию наследования, целесообразно проверить, не решается ли задача композицией: объект, содержащий другой объект, почти всегда проще объекта, унаследованного от него.
- Реестр подклассов строится через
__init_subclass__; метакласс нужен лишь для изменения самого создания класса.
Язык одинаково принимает и модуль из десяти функций, и иерархию классов; выбор определяется задачей, а не привычкой, сформированной в других языках.
Роль алгоритмов в работе физика
Устройство Python было рассмотрено в предыдущем разделе, однако за ним стоит фундамент, переживающий и смену языка, и смену моды, — базовые знания computer science.
Алгоритмическая грамотность представляет собой умение заранее оценить, выполним ли расчёт за приемлемое время. Миллион событий детектора, обрабатываемый алгоритмом за \(O(n^2)\), приводит к триллиону операций, и NumPy, написанный на C, уменьшает лишь константу, но не порядок роста: расчёт сократится с часов до десятков минут, тогда как алгоритм \(O(n \log n)\) выполнит ту же работу меньше чем за секунду. Удачно выбранная структура данных сокращает время счёта на порядки, причём чаще, чем низкоуровневая оптимизация.
Слайды к главе. Материал первых трёх глав раздела изложен также в лекции «Алгоритмы и сложность» (алгоритм и O-нотация, время и память, память и массивы, списки и очереди, стек вызовов и рекурсия, сортировки) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Слайды к главе. Материал глав о хеш-функциях, деревьях и графах изложен также в лекции «Хеши, деревья и графы» (хеш-таблицы и хеш-функции, деревья и деревья поиска, кучи, графы, кратчайшие пути и остов) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
В настоящем разделе рассматриваются:
- Введение в алгоритмы, где вводится понятие алгоритма и разбирается оценка сложности, не привязанная к конкретной машине;
- Основные структуры данных, где разобраны массивы, списки, стеки, очереди и деки и показано, как они представлены в Python;
- Рекурсия и сортировки, где разобраны сортировка слиянием, быстрая сортировка и сортировка подсчётом;
- Хеш-функции, объясняющие, почему словарь ищет в среднем за \(O(1)\) и как устроены хеш-таблицы;
- Деревья, иерархические структуры, дополненные деревьями поиска и кучами;
- Графы, их представления, обходы и классические задачи, решаемые обходом.
Материал построен на разборе задач: сначала излагается необходимая теория, затем приводятся задачи с решениями, расписанными на Python. Рекомендуется сперва попытаться решить задачу самостоятельно и только после этого обращаться к разбору.
Введение в алгоритмы
Одна из основных задач, возникающих при работе с алгоритмами, состоит в оценке эффективности написанной программы и в поиске наиболее экономичного подхода. Самое простое и поверхностное решение заключается в том, чтобы написать программу, измерить время её выполнения, а недостаточно быструю переписать.
Слайды к главе. Свойства алгоритма и проблема останова, линейный и бинарный поиск, O-нотация и оценка сложности по виду кода и измерением изложены также в первой части лекции «Алгоритмы и сложность» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Линейный поиск
Дан массив целых чисел длины \(N\). Требуется найти в нём заданное число \(x\) и вернуть его индекс. Если \(x\) в массиве не встречается, необходимо вернуть -1.
def find_element(numbers, x):
for i in range(len(numbers)):
if numbers[i] == x:
return i
return -1
Можно утверждать, что время работы алгоритма в худшем случае пропорционально размеру массива. На математическом языке это формулируется так: «Вычислительная сложность алгоритма линейно зависит от размера входных данных».
Вычислительная сложность представляет собой количество элементарных операций, совершаемых алгоритмом. Под входными данными понимается всё, поданное алгоритму на вход; в рассматриваемой задаче это массив numbers и число x, а размер входа примерно равен N. Линейная зависимость описывается формулой \(y = kx+b\).
Бинарный поиск
В массиве, упорядоченном по возрастанию, нужное число находится гораздо быстрее.
Допустим, что поиск ведётся по словарю из 100 страниц. Объём рассматриваемой части книги будет каждый раз уменьшаться вдвое до тех пор, пока не останется всего одна страница. Делить словарь из 100 страниц пополам можно не более 7 раз, а значит, для нахождения нужного слова достаточно просмотреть не более 7 страниц.
Этот алгоритм называется бинарным поиском, а также: двоичный поиск, метод деления пополам, дихотомия. Время его работы логарифмически зависит от размера входных данных.
def binary_search(arr, x):
mid, low, high = 0, 0, len(arr) - 1
while low <= high:
mid = (high + low) // 2
if arr[mid] < x:
low = mid + 1
elif arr[mid] > x:
high = mid - 1
else:
return mid
return -1
Бинарный поиск в сравнении с линейным
Запустим оба поиска на одних и тех же данных и рассмотрим, как меняется измеренное время работы с ростом массива.
Будем искать элемент, стоящий в самом конце, что даёт худший случай для линейного поиска:
| Размер массива | Линейный поиск | Бинарный поиск |
|---|---|---|
| 10 | 0,2 мкс | 0,14 мкс |
| 100 | 0,9 мкс | 0,23 мкс |
| 1 000 | 11,2 мкс | 0,37 мкс |
| 10 000 | 122,1 мкс | 0,50 мкс |
| 100 000 | 1 281,6 мкс | 0,59 мкс |
| 1 000 000 | 12 340,3 мкс | 0,69 мкс |
При увеличении массива в 10 раз линейный поиск замедляется также примерно вдесятеро: 11 мкс, 122 мкс, 1,3 мс, 12 мс. Бинарный же поиск за пять порядков роста замедлился всего впятеро, с 0,14 до 0,69 мкс.
Именно так выглядит разница между \(O(n)\) и \(O(\log n)\) на практике. На миллионе элементов бинарный поиск быстрее линейного почти в восемнадцать тысяч раз, и чем больше накопленных данных, тем этот разрыв шире. На машине стенда лекции (CPython 3.12.3, ARM64) те же функции на миллионе элементов работают 12,2 мс и 0,72 мкс, отношение составляет около 17 тысяч. На той же машине функция bisect.bisect_left из стандартной библиотеки, написанная на C, выполняет бинарный поиск ещё в 9 раз быстрее функции на Python: при одинаковой сложности константа реализации остаётся существенной.
Измерение может быть воспроизведено самостоятельно:
from timeit import timeit
n = 1_000_000
setup = f"from __main__ import find_element, binary_search; arr = list(range({n})); x = {n} - 1"
print(timeit("find_element(arr, x)", setup=setup, number=1000) / 1000)
print(timeit("binary_search(arr, x)", setup=setup, number=1000) / 1000)
Сложность алгоритма. O-нотация
Для того чтобы говорить о скорости алгоритма, не привязываясь к конкретной машине, была введена O-нотация — запись, показывающая, как растёт число операций с ростом входных данных. Формально \(f(n) = O(g(n))\), если существуют постоянная \(c > 0\) и порог \(n_0\), начиная с которого \(f(n) \le c \cdot g(n)\). Константы и коэффициенты в оценке не учитываются: если алгоритм совершает \(5\cdot n+3\) операций, его сложность равна \(O(n)\), поскольку \(5n + 3 \le 6n\) при \(n \ge 3\). Отброшенные константы, однако, определяют применимость алгоритма при конкретных размерах данных: асимптотически лучший алгоритм может проигрывать на практике, если его константа велика, а выигрыш от асимптотики растёт медленно.
Кроме линейной и логарифмической, при оценке времени работы алгоритмов часто встречаются следующие зависимости:
- Квадратичная зависимость \(O(n^2)\).
- Кубическая зависимость \(O(n^3)\).
- Экспоненциальная зависимость \(O(2^n)\).
- Константная зависимость \(O(1)\). Встречаются и случаи, когда время работы алгоритма не зависит от размера входных данных, а число выполняемых операций остаётся постоянным.
Слайды к главе. Оценка времени исполнения, пространственная сложность, краевые случаи, задача о частом символе и поиск простых чисел изложены также во второй части лекции «Алгоритмы и сложность»; слайды лекции доступны на сайте книги и в PDF.
Оценка времени исполнения
Тактовая частота современного процессора составляет около 2,5 ГГц: за секунду проходит 2,5 миллиарда тактов.
Подобно тому как метроном задаёт ритм музыки, специальный генератор тактовой частоты задаёт ритм, в котором работают процессор и микросхемы компьютера. Тактовая частота не совпадает с числом инструкций в секунду, однако в первом приближении можно считать, что один такт соответствует одной инструкции.
Предположим, что обработка каждой итерации цикла занимает один такт процессора. Возьмём \(10^9\) итераций, тогда:
$$ t = \frac{10^9 [\text{итер}] \cdot 1 [\frac{\text{такт}}{\text{итер}}]}{2{,}5 \cdot 10^9 [\frac{\text{такт}}{\text{с}}]} = 0{,}4 [\text{с}] $$
Количество инструкций в программе может немного отличаться в зависимости от процессора или от использованного компилятора. Существуют команды, которым требуется несколько тактов, а другие инструкции, напротив, выполняются за доли такта.
Даже при желании узнать константы в оценке временной сложности сделать это не удалось бы: пришлось бы учесть слишком много нюансов. Это ещё одна причина пользоваться O-нотацией и опускать константы, что не мешает уменьшать константу, сокращая число действий.
Чтобы оценить, во сколько раз ошибается такая оценка, измерим, сколько секунд займёт пустой цикл, выполненный миллиард раз.
# Python
import time
time_start = time.time()
i = 0
while i < 1000000000:
# Do nothing
i += 1
time_finish = time.time()
time_span = time_finish - time_start
print(time_span, 'seconds')
27.69246792793274 seconds
// CPP
#include <chrono>
#include <iostream>
int main() {
using namespace std::chrono;
auto time_start = high_resolution_clock::now();
int i = 0;
while (i < 1000000000) {
// Do nothing
++i;
}
auto time_finish = high_resolution_clock::now();
auto time_span = duration_cast<duration<double>>(time_finish - time_start);
std::cout << time_span.count() << " seconds\n";
return 0;
}
Каждая итерация цикла состоит из трёх действий: прибавить единицу, проверить условие и переместиться обратно к началу цикла, — и три миллиарда команд при одной команде за такт заняли бы около 1,2 с. Сборка без оптимизации (c++ -O0 loop.cpp) выполняется быстрее: на процессоре ARM64 — за 0,2–0,5 с в зависимости от компилятора, поскольку современное ядро выполняет несколько команд за такт и работает на частоте выше 2,5 ГГц. С -O2 компилятор обнаруживает, что i далее нигде не используется, удаляет цикл целиком и печатает почти ноль; чтобы этого не происходило, счётчик объявляют volatile. Одного использования результата для этого недостаточно: если конечное значение счётчика вычислимо заранее, как здесь \(i = 10^9\), компилятор подставляет его без выполнения цикла. Это классическая ловушка микробенчмарков на компилируемых языках. Аналогичная программа на Python выполняется около 28 секунд: вывод выше получен на CPython 3.11 с процессором ARM64, а на машине стенда лекции (CPython 3.12.3, ARM64) замер на \(10^7\) итерациях даёт в пересчёте те же 28 с. Это примерно в 60–120 раз медленнее сборки без оптимизации на той же машине, в зависимости от компилятора. Так происходит, поскольку код, написанный на языках низкого уровня, почти один к одному транслируется в инструкции процессору, а каждая итерация цикла на Python выполняется сотнями машинных инструкций интерпретатора.
Пространственная сложность алгоритма
Вычислительная (или временнáя) сложность показывает, насколько экономно алгоритм расходует процессорное время. Второй характеристикой является объём оперативной памяти. Программы, не помещающиеся в неё, зависают и мешают работе остальных, а часто и не доводят вычисление до конца.
Если программам не хватает оперативной памяти, операционная система использует файл подкачки, или swap-раздел (от англ. swap, «подкачивать»), расположенный во внешней памяти (на жёстком диске или на SSD-диске): она переносит редко используемые страницы памяти из небольшой, но быстрой оперативной памяти на большой, но медленный диск и возвращает их обратно по мере обращения к ним. Это очень медленный процесс. Из-за него программы, вышедшие за пределы оперативной памяти, простаивают в ожидании диска и замедляются на порядки, даже если у них небольшая временна́я сложность. Более того, они могут вытеснять из памяти другие программы, замедляющиеся следом. Если запущенные на компьютере программы заняли не только всю оперативную память, но и файл подкачки, то какая-то из программ завершится аварийно.
Каждый объект в программе занимает некоторый объём памяти, а для хранения всех созданных объектов может потребоваться значительное пространство. Особого внимания требуют массивы, строки и прочие контейнеры, размер которых не фиксирован и зависит от входных данных. Пространственной сложностью алгоритма называется зависимость объёма потребляемой памяти от входных данных. Как и в случае с временной сложностью, в первую очередь представляет интерес не точный объём занятой памяти, а асимптотика, то есть скорость роста без учёта констант и коэффициентов.
Взаимосвязь пространственной и временной сложности алгоритма
Сохранённая вспомогательная информация позволяет тратить меньше времени: память обменивается на скорость. Этот выбор бывает непростым: либо хранить больше данных и меньше вычислять, либо вычислять медленнее, зато уложиться в отведённую память.
Тестирование программы
Код, разделённый на функции, удобно тестировать: для каждой выделенной функции пишутся юнит-тесты.
Необходимо продумать краевые случаи — входные данные, на которых программы отказывают чаще всего:
| тип теста | строки | числа | набор данных/массивы |
|---|---|---|---|
| самый маленький тест | пустая строка | 0 или минимальное отрицательное число для задачи | пустой набор данных |
| самый большой тест | самая длинная строка по условию | самое большое положительное число для задачи | набор данных максимального размера |
| особые случаи | строки со строчными и заглавными буквами строки с кириллицей и латиницей | положительное/отрицательное число ноль чётное и нечётное число вещественное число | набор с одинаковыми элементами отсортированные наборы неотсортированные наборы |
Задача
Дана строка (UTF-8). Требуется найти самый часто встречающийся в ней символ.
Решение 1
Переберём все позиции в строке, для каждой из них ещё раз пройдём по всей строке и на каждом совпадении прибавим к счётчику единицу. Останется найти максимальное из накопленных значений счётчика.
s = 'ababa'
ans = ''
anscnt = 0
for i in range(len(s)):
nowcnt = 0
for j in range(len(s)):
if s[i] == s[j]:
nowcnt += 1
if nowcnt > anscnt:
ans = s[i]
anscnt = nowcnt
print(ans)
a
Решение 2
Переберём символы, встречающиеся в строке, для каждого пройдём по всем позициям и на каждом совпадении прибавим к счётчику единицу. Снова найдём максимальное из полученных значений счётчика.
s = 'ababa'
ans = ''
anscnt = 0
for now in sorted(set(s)):
nowcnt = 0
for j in range(len(s)):
if now == s[j]:
nowcnt += 1
if nowcnt > anscnt:
ans = now
anscnt = nowcnt
print(ans)
a
Порядок обхода множества строк меняется от запуска к запуску вместе со случайной солью хеша, выбираемой интерпретатором, поэтому при равных частотах символы перебираются в отсортированном порядке: иначе ответ решения не был бы детерминированным.
Решение 3
Заведём словарь, в котором ключом служит символ, а значением — число его вхождений. Если символ встретился впервые, для него создаётся элемент словаря со значением ноль, после чего к созданному элементу прибавляется единица.
s = 'ababa'
ans = ''
anscnt = 0
symcnt = {}
for now in s:
if now not in symcnt:
symcnt[now] = 0
symcnt[now] += 1
if symcnt[now] > anscnt:
ans = now
anscnt = symcnt[now]
print(ans)
a
Сравнение сложности
Обозначим через \(N\) длину строки, а через \(K\) количество различных символов.
| Решение | Время | Дополнительная память |
|---|---|---|
| 1 | \(O(N^2)\) | \(O(1)\) |
| 2 | \(O(NK)\) | \(O(K)\) |
| 3 | \(O(N)\) | \(O(K)\) |
Память здесь учитывается дополнительная, сверх самой входной строки: в противном случае все три решения одинаково требовали бы \(O(N)\), и сравнивать было бы нечего. Первое не хранит ничего, кроме счётчиков; второе строит множество различных значений, встреченных в строке, а третье — словарь тех же значений, вследствие чего оба и требуют \(O(K)\).
Значение алгоритмов для программиста
- Знание алгоритмов способствует эффективному решению задач, встречающихся в работе
- Дополнительная готовность к собеседованию
- Общая когнитивная тренировка
Свойства алгоритмов
Алгоритмом называется конечная последовательность точных инструкций, приводящая к результату за конечное число шагов, и от такой последовательности требуется шесть свойств.
Дискретность означает, что алгоритм распадается на отдельные шаги, выполняемые по одному и в определённом порядке, а не сливается в одно неделимое действие. Детерминированность — что на одних и тех же входных данных получается один и тот же результат при любом числе запусков алгоритма. Понятность — что каждый шаг посилен исполнителю и не допускает двоякого толкования, вследствие чего инструкция «посолить по вкусу» в алгоритм не годится. Завершаемость — что работа заканчивается за конечное число шагов, а не продолжается бесконечно. Массовость — что алгоритм написан для целого класса входных данных, а не для единственного набора, ради которого он составлялся. Результативность — что на выходе получается ответ, пусть даже им окажется сообщение о том, что решения нет.
Оценка сложности по виду кода
Чаще всего сложность видна в структуре кода, и несколько признаков покрывают большинство случаев:
- Цикл, проходящий по всему массиву, означает линейную сложность
- При вложенном цикле необходимо считать суммарное число итераций внутреннего цикла, а не глубину вложенности. Часто получается произведение длин, но не всегда: у решета Эратосфена два вложенных цикла, а работает оно за \( O(n \log\log n) \)
- Деление пополам, повторяющееся на каждом шаге, означает логарифмическую сложность
- Полный перебор, охватывающий все комбинации, означает экспоненциальную сложность
- Оценку по коду подтверждает измерение: если время растёт как \(N^k\), то при удвоении \(N\) оно возрастает в \(2^k\) раз, а в логарифмических осях зависимость изображается прямой с наклоном \(k\); двух-трёх замеров с удвоением \(N\) достаточно, чтобы отличить линейный алгоритм от квадратичного
Алгоритмически неразрешимые проблемы
Проблема останова
Существуют задачи, для которых доказано, что решающего их алгоритма не существует; самая известная из них формулируется следующим образом. Пусть даны алгоритм \(A\) и входные данные \(N\); требуется алгоритм, который по этой паре определяет, остановится ли \(A\) на входе \(N\) или будет работать бесконечно. Такого алгоритма не существует, и доказывается это от противного: из предполагаемого распознавателя строится программа, которая поступает наоборот его предсказанию — зацикливается, если распознаватель отвечает «остановится», и останавливается в противном случае, — и эта программа подаётся на вход самой себе.
Ресурсы
- https://tproger.ru/digest/competitive-programming-practice/
- Введение в анализ сложности: https://habr.com/ru/post/196560/
- Гейл Макдауэлл «Карьера программиста»
Бонус. Задача. Поиск простых чисел
Классическая задача: требуется проверить число на простоту, а затем найти все простые числа до заданного. Простейшая проверка выполняется перебором всех возможных делителей.
def is_prime(n):
if n < 2:
return False
i = 2
while i < n:
if n % i == 0:
return False
i = i + 1
return True
Эту задачу можно решить быстрее, поскольку делители, превышающие \(\sqrt n\), проверять необязательно.
def is_prime(n):
if n < 2:
return False
i = 2
while i * i <= n:
if n % i == 0:
return False
i = i + 1
return True
С помощью функции is_prime(n) можно найти все простые числа, не превосходящие \(n\).
Для этого заведём пустой массив smaller_primes и будем проверять на простоту все числа, не превышающие \(n\). Если число простое, добавим его в массив smaller_primes, где в конце работы алгоритма и будет содержаться искомый ответ.
def get_smaller_primes(n):
smaller_primes = []
for num in range(2, n + 1):
if is_prime(num):
smaller_primes.append(num)
return smaller_primes
Для практики этот способ слишком медленный: делители для каждого числа перебираются заново. Гораздо быстрее работает решето Эратосфена, известное ещё с древности.
Алгоритм состоит в следующем:
- Выписываются все целые числа от 0 до \(n\). Сразу отмечается, что 0 и 1 не простые (на соответствующих позициях записывается
False). - Заводится переменная \(\mathrm{num}\), равная первому не рассмотренному простому числу. Изначально она равна 2.
- Числа в списке от \(2 \cdot \mathrm{num}\) до \(n\) с шагом, равным \(\mathrm{num}\), помечаются составными. Например, для 2 значением
Falseпомечаются чётные числа 4, 6, 8 и так далее. - Далее переменной \(\mathrm{num}\) присваивается следующее простое число, то есть следующее не рассмотренное число в списке. Для этого достаточно увеличивать \(\mathrm{num}\) с шагом 1, пропуская числа, отмеченные как составные. На первом найденном простом числе достаточно остановиться.
- Два предыдущих шага повторяются, пока это возможно.
В коде это выглядит следующим образом:
def eratosthenes(n):
if n < 2:
return [False] * (n + 1)
numbers = list(range(n + 1))
numbers[0] = numbers[1] = False
for num in range(2, n):
if numbers[num]:
for j in range(2 * num, n + 1, num):
numbers[j] = False
return numbers
eratosthenes(9)
[False, False, 2, 3, False, 5, False, 7, False, False]
Простые числа остались на своих местах, а на позициях, занятых составными числами, стоит False. Ветвь if n < 2 обрабатывает самый маленький тест из таблицы краевых случаев: без неё вызов eratosthenes(0) обращается к элементу numbers[1] списка из одного элемента и завершается исключением IndexError.
Алгоритм можно ускорить. Для каждого простого числа \(p\) начнём отмечать составными числа начиная с \(p^2\): всё, лежащее ниже, к этому моменту уже рассмотрено. Внешний цикл при этом достаточно вести до \(\sqrt{n}\): у простых чисел, больших \(\sqrt{n}\), квадрат превосходит \(n\), и отмечать им нечего.
Получится следующий код:
import math
def eratosthenes_effective(n):
if n < 2:
return [False] * (n + 1)
numbers = list(range(n + 1))
numbers[0] = numbers[1] = False
for num in range(2, math.isqrt(n) + 1):
if numbers[num]:
for j in range(num * num, n + 1, num):
numbers[j] = False
return numbers
Рассмотрим подробно пример работы алгоритма для \(n = 15\).
0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 # Запишем числа от 0 до 15
False False 2 3 4 5 6 7 8 9 10 11 12 13 14 15 # Отметим, что 0 и 1 не простые
num = 2 # Пометим все числа, кратные 2, начиная с 4, значением False
False False 2 3 False 5 False 7 False 9 False 11 False 13 False 15
num = 3 # Пометим все числа, кратные 3, начиная с 9, значением False
False False 2 3 False 5 False 7 False False False 11 False 13 False False
num = 5 # Алгоритм можно завершить, так как num**2 больше 15.
# Все числа, кратные 5 и не превосходящие 15, уже отмечены.
Решето Эратосфена работает за \(O(n \log(\log n))\): для простого \(p\) внутренний цикл выполняет около \(n/p\) отметок, а сумма величин, обратных простым числам, не превосходящим \(n\), растёт как \(\log(\log n)\). Доказательство последнего опирается на нетривиальные факты из теории чисел.
Существует метод решения задачи нахождения всех простых чисел, не превосходящих \(n\), требующий \(O(n)\) операций. Он называется линейным решетом и помечает каждое число как составное только один раз.
Как и прежде, числа перебираются в порядке возрастания, только в отличие от классического решета Эратосфена найденные составные числа не вычёркиваются. Вместо этого для каждого числа \(x\) записывается наименьший простой делитель \(p\). В программе записанный делитель помещается в ячейку массива \(\mathrm{lp}[x]\) (от англ. least prime). Если число простое, его наименьшим простым делителем служит оно само, а если составное, его наименьший простой делитель \(p\) уже встречался раньше. Более того, ранее встречалось и число \(i\), такое, что \(x = i \cdot p\). На шаге \(i\) необходимо пометить число \(x\) как составное и указать его наименьший простой делитель. Каждое число будет помечено только один раз, на шаге \(i = x/p\). Число \(i\) может быть выбрано только одним способом, поскольку у любого числа существует только один наименьший простой делитель \(p\).
Алгоритм состоит в следующем:
- Для каждого числа
iвlp[i]хранится минимальный простой делитель этого числа. Заводится массивlpдлиныn + 1, а также массивprimes, в который складываются найденные простые числа. - Числа
iперебираются по возрастанию. - Если
lp[i] = 0, значит, числоiпростое, и его необходимо добавить в массивprimes. - Рассматриваются все простые числа
p, не превосходящиеlp[i]. Обновляетсяlp[p * i] = p.
def get_least_primes_linear(n):
lp = [0] * (n + 1)
primes = []
for i in range(2, n + 1):
if lp[i] == 0:
lp[i] = i
primes.append(i)
for p in primes:
x = p * i
if (p > lp[i]) or (x > n):
break
lp[x] = p
return primes, lp
get_least_primes_linear(8)
([2, 3, 5, 7], [0, 0, 2, 3, 2, 5, 2, 7, 2])
Линейное решето выполняет меньше операций, но это ещё не означает выигрыша во времени. При \(n = 10^6\) решето Эратосфена делает 2 122 048 отметок, а линейное — 921 501 запись, по одной на каждое составное число, однако на машине стенда лекции (CPython 3.12.3, ARM64) первое занимает 60 мс, а второе — 66 мс: каждая итерация линейного решета дороже, и константа перекрывает выигрыш асимптотики.
Резюме
- От алгоритма требуется шесть свойств: дискретность, детерминированность, понятность, завершаемость, массовость и результативность.
- O-нотация описывает, как растёт время работы с ростом объёма данных, отбрасывая константы. Отброшенные множители зависят от процессора и компилятора, характер роста — нет; однако при конкретных размерах данных именно константы решают, какой алгоритм быстрее.
- На миллионе элементов линейный поиск занимает около 12 мс, а бинарный — меньше микросекунды. На больших данных выбранный алгоритм значит больше, чем любая микрооптимизация.
- Пространственная сложность оценивается аналогично, и между временем и занятой памятью почти всегда приходится выбирать.
- Прежде чем оптимизировать, необходимо измерить. Оценка сложности показывает, чего следует ожидать, но реальное время определяется измерением.
Задание. Требуется решить задачи и оценить сложность полученных решений: «Решение задач на Python и анализ сложности».
Основные структуры данных
Скорость программы определяется не только числом операций, выполняемых алгоритмом: не меньшее значение имеет то, как данные расположены в памяти.
В настоящей главе сначала рассматривается устройство оперативной памяти и стоимость хранения простых значений, затем — собираемые из них структуры: массивы постоянного и переменного размера, связные списки, стек, очередь и дек. Для каждой структуры выясняется, какие операции она выполняет быстро, какие медленно и почему.
Выбор между списком и деком, сделанный при обработке данных эксперимента, меняет время расчёта на порядок, и никакой код, написанный поверх неудачной структуры, этого не компенсирует.
Слайды к главе. Представление базовых типов, объекты Python и сборка мусора, массивы постоянного размера и динамические массивы, реаллокация и амортизация изложены также в третьей части лекции «Алгоритмы и сложность» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Оперативная память и представление данных
Эффективность программы оценивается по тому, как она расходует ресурсы компьютера, главными из которых являются процессорное время и оперативная память. К ограниченным ресурсам относятся также пропускная способность сетевых подключений, время работы жёсткого диска и прочие ресурсы, разделяемые между всеми запущенными процессами.
Пространственную сложность, введённую в предыдущей главе, разложим на составляющие и рассмотрим, из чего она складывается на уровне памяти.
Устройство оперативной памяти
Оперативная память, или ОЗУ, служит программе черновиком для вычислений: в неё можно записывать и перезаписывать информацию, а записанное — считывать обратно.
Оперативной памяти в компьютере на порядки меньше, чем места на диске, — десятки гигабайт против терабайтов, — и записанные данные исчезают из неё сразу после завершения работы программы. Поэтому она не подходит для длительного хранения информации, зато работает в сотни раз быстрее SSD и во многие тысячи раз быстрее обыкновенного жёсткого диска.
Оперативная память разбита на ячейки размером в 1 байт, и у каждой ячейки есть свой порядковый номер, называемый «адресом» (отдельные биты внутри ячейки адресов не имеют). Процессор, работающий с оперативной памятью напрямую, обращается к данным по адресам почти так же, как программа обращается к переменным по имени.
Чтобы понять, сколько памяти потребляет программа, необходимо выяснить, сколько места занимают отдельные созданные объекты. В разных языках программирования занятый объём может отличаться, но основные принципы остаются общими. Рассмотрение начнём с языка C++, позволяющего использовать память эффективно, гибко и предсказуемо.
Представление базовых типов данных в ОП
Наименьшая ячейка имеет размер в 1 байт, состоящий из 8 бит. Каждый бит принимает одно из двух значений: 0 или 1. Восемь бит позволяют закодировать \(2^8 = 256\) вариантов, поэтому в такую ячейку можно записать, например, целое число, лежащее в промежутке от 0 до 255.
Если считать записанные числа номерами символов, то в 1 байт умещается один символ ASCII (тип char): латиница, цифры и основные знаки препинания занимают меньше 128 кодов. Для кириллицы места уже не хватает: в однобайтовых кодировках наподобие CP1251 она размещена в верхней половине таблицы, а в UTF-8, принятом сегодня по умолчанию, каждая русская буква занимает два байта — отсюда расхождение между len(text) и len(text.encode()), о котором шла речь в главе «Объекты и память».
Самый распространённый тип целых чисел int занимает 4 байта и позволяет закодировать числа от −2 147 483 648 до 2 147 483 647.
Границы легко вычислить. В 4 байтах содержится 32 бита, то есть \(2^{32}\) различных комбинаций. В дополнительном коде, которым представлены целые со знаком, старший бит отвечает за знак: \(2^{31} = 2;147;483;648\) комбинаций отведены отрицательным числам от \(-2^{31}\) до \(-1\), ещё \(2^{31}\) — неотрицательным от 0 до \(2^{31} - 1\). Ноль занимает один из неотрицательных кодов, поэтому положительных чисел на одно меньше, чем отрицательных.
Если числа не превышают по модулю два миллиарда, этого типа достаточно. Всего значений около четырёх миллиардов, но половина из них отрицательные. Если точно известно, что переменная не может быть отрицательной, подходит тип беззнаковых целых unsigned int, хранящий числа от 0 до 4 294 967 295.
Вещественные (то есть дробные) числа чаще всего кодируются типом double, «числами с плавающей точкой», занимающими 8 байт. Восьми байт хватает и на очень большие числа, такие как \(\pm10^{308}\), и на близкие к нулю, например \(\pm10^{-308}\).
Диапазон, однако, не то же самое, что точность. Под мантиссу, цифровую часть числа, из восьми байт отведено 52 бита, и ещё один старший бит подразумевается, поэтому точность составляет 53 двоичных разряда, или примерно шестнадцать значащих десятичных цифр; всё, что за них не поместилось, отбрасывается округлением. Расстояние от единицы до следующего представимого числа называется машинным эпсилон и равно \(2^{-52} \approx 2{,}2\cdot10^{-16}\); добавка, которую единица ещё различает при округлении к ближайшему, вдвое меньше: 1 + 1.2e-16 != 1, хотя \(1{,}2\cdot10^{-16}\) меньше эпсилон. Шаг между соседними представимыми числами не постоянен, а растёт вместе с самим числом, оставаясь относительным. Отсюда 0.1 + 0.2 != 0.3: ни одна из этих дробей в двоичной записи не конечна, и сумма отклоняется от ответа на последние биты. Отсюда же следует и потеря точности при вычитании близких величин: старшие цифры, которыми они совпадали, взаимно уничтожаются, и от разности остаётся столько верных цифр, сколько их было в различающейся младшей части.
Составные типы данных
Подсчитаем, сколько памяти потребуется для хранения массива, составленного из 10 строк по 20 символов каждая.
Во-первых, потребуется хранить сам текст. Это займёт $$10; \text{строк} \cdot (20; \frac{\text{символов}}{\text{строка}}) \cdot (1;\frac{\text{байт}}{\text{символ}}) = 200; \text{байт}$$ Этого было бы достаточно, если бы строки располагались в памяти друг за другом, но выполнять с ними операции в таком случае было бы сложно.
Поэтому в массивы (и в другие составные структуры) зачастую помещаются не сами объекты, а только указатели на них, то есть адреса ячеек, отведённых под эти объекты в оперативной памяти.
Во многих других языках каждый объект в программе записан в специальную «обёртку», содержащую, помимо данных, вспомогательную информацию. Из-за такой обвязки в Python даже короткие целые числа занимают не 4 байта, а почти 30. Для хранения строки требуется около 40 байт служебных данных (в CPython 3.12 — 40 байт у строк из символов ASCII и 56 у остальных, в 3.11 — 48 и 72), а для хранения массива и того больше. Объекты в таких языках ведут себя как строки из примера выше: они могут находиться в произвольном месте памяти, и любое обращение к ним осуществляется по сохранённому адресу.
Подсчитаем, сколько памяти расходует массив, собранный из 10 чисел в Python, и на что она уходит:
import sys
print(sys.getsizeof(42)) # => 28 байт занимает короткое целое число
print(sys.getsizeof([])) # => 56 байт занимает пустой массив
print(sys.getsizeof([42])) # => 64 = (56 + 8) байт занимает массив с одним элементом.
print(sys.getsizeof([1,2,3,4,5,6,7,8,9,10])) # => 136 = (56 + 8*10) байт занимает массив
# с десятью элементами.
# числа 1-10 берутся из кеша малых целых;
# десять различных больших чисел
# добавили бы ещё 280 = (28 * 10) байт
56 байт уходит на сам массив и по 8 байт на адрес каждого элемента. Если числа различны и не попадают в кеш малых целых (от −5 до 256), к этому добавляется ещё по 28 байт на каждое число, и массив из десяти чисел занимает 56 + (8 + 28) * 10 байт = 416 байт против 40 байт в C++; числа из кеша хранятся в одном экземпляре, и тогда на список приходится лишь 136 байт — заголовок и ссылки. Размеры приведены для CPython 3.11 и 3.12 на 64-битной платформе; в 3.9 тот же литерал из десяти чисел занимает 152 байта.
Освобождение памяти
Если программа перестала пользоваться объектом, это ещё не означает, что занимаемая им память освобождена. В языке C++ необходимо следить за тем, чтобы выделенная память освобождалась. Встроенные контейнеры наподобие std::vector сами выделяют память при создании и отдают её обратно, когда переменная, хранящая контейнер, выходит из области видимости.
В большинстве других языков за освобождение памяти отвечает сборщик мусора, время от времени находящий объекты, до которых программа больше не может добраться ни через переменные, ни через другие объекты; такие объекты уничтожаются, даже если ссылаются друг на друга. CPython сочетает два механизма: объект, на который не осталось ни одной ссылки, подсчёт ссылок уничтожает сразу, а циклические структуры обнаруживает отдельный сборщик циклов, модуль gc.
Сборка мусора является трудоёмкой операцией, поэтому некоторые языки откладывают её до тех пор, пока свободное пространство не подойдёт к концу. Например, программы на Java (если их специально не ограничить при запуске) часто сталкиваются с высоким потреблением памяти из-за множества старых, уже неиспользуемых объектов, сохраняемых до очередной сборки.
Массивы постоянного размера
Структурой данных называется способ организации информации в памяти, позволяющий выполнять с ней определённый набор операций, например быстро искать или изменять сохранённые значения.
Самый простой тип массивов имеет фиксированный размер и хранит элементы одного и того же типа. Например, в созданный массив из десяти целых чисел нельзя добавить ещё один элемент или записать объект неподходящего типа. Такие массивы встречаются в языке C как int numbers[10], а в C++ как std::array<int, 10> numbers.
С массивами фиксированного размера можно выполнить только две операции:
- получить значение элемента по заданному индексу,
- перезаписать значение по указанному индексу.
Обе операции выполняются за \(O(1)\).
Устройство массива
Массив представляет собой набор однотипных данных, расположенных в памяти друг за другом, поэтому он всегда занимает один непрерывный участок. Адрес выделенного участка программа получает в момент создания массива от распределителя памяти — функции malloc и её аналогов — или от указателя стека.
В начале выделенного участка памяти находится нулевой элемент, сразу за ним первый и далее по порядку, друг за другом, без пропусков. Зная адрес элемента, его можно прочитать или записать. Непрерывное расположение даёт и преимущество, не видное в O-нотации: процессор загружает память строками кеша по 64–128 байт, и последовательный проход по массиву использует каждую загруженную строку целиком.
Пусть имеется массив numbers из 10 целых чисел типа int, адрес нулевого элемента которого равен 1000. Адрес следующего элемента равен адресу начала плюс размер элемента в байтах. Каждое число занимает по 4 байта, и нулевой элемент займёт байты 1000, 1001, 1002, 1003. Следовательно, элемент с индексом 1 будет записан по адресу 1004.
Сложность вставки и удаления в динамических массивах
Динамические массивы иногда называют «векторами», потому что в C++ они реализуются классом std::vector. В Python динамический массив скрыт за классом list, и, несмотря на название, это не список, а массив.
Сложность вставки в динамический массив
Не всегда заранее известно, какая длина массива понадобится, поэтому необходима возможность дописывать элементы в уже созданный массив во время выполнения программы.
Элемент можно вставить в любое место массива; вставка в начало и в конец являются частными случаями. Худший случай — вставка в начало, поскольку все лежащие правее элементы приходится сдвинуть на одну позицию, а это \(O(n)\). Добавление в конец — лучший случай: сдвигать ничего не нужно, и стоимость операции составляет \(O(1)\), пока в выделенном участке есть свободное место.
Сложность удаления из динамического массива
При удалении, как и при вставке, приходится сдвигать все элементы, стоящие правее затронутой ячейки: при добавлении — на один вправо, при удалении — на один влево. Стоимость та же: \(O(n)\) при работе с началом массива и \(O(1)\) при работе с концом.
Реаллокация в динамических массивах
Расширить массив на месте удаётся не всегда: если за его пределами в памяти уже записаны данные соседних объектов, расширение перезаписало бы их.
Поэтому при нехватке места программа производит реаллокацию: выделяет новый участок памяти и переносит туда накопленное содержимое. Если же за участком свободно, функция realloc расширяет его без копирования, и оценка, приведённая ниже, описывает худший случай.
Выделение памяти является долгой операцией, а копирование обходится ещё дороже: пройти придётся по всем записанным элементам, а это \(O(n)\). Возникает вопрос, почему добавление в конец массива при этом стоит \(O(1)\).
Рассмотрим программу, добавляющую в массив тысячу элементов по одному за раз:
values = []
for i in range(1000):
values.append(i)
Операцию append() можно представить как две: реаллокацию и присваивание значения элементу массива. Операции присваивания учитывать не будем: их число равно количеству добавляемых элементов и оптимизации не поддаётся. Время же реаллокаций зависит от выбранного подхода.
Если бы реаллокация происходила при каждом добавлении элемента, сложность оказалась бы квадратичной.
Во-первых, чтобы не приходилось на каждом шаге выделять дополнительную память, необходимо держать запас свободного места в массиве. Например, если увеличивать размер сразу на 100 элементов, программа будет запрашивать память в 100 раз реже. Однако такая программа всё ещё работает за \(O(n^2)\), хотя и с небольшой константой при квадратичном члене.
Таким образом, у массива появляются два разных размера: size (количество занятых ячеек) и capacity (ёмкость выделенного участка), причём size ≤ capacity.
Во-вторых, чтобы сделать сложность алгоритма линейной, необходимо увеличивать размер не на фиксированное количество элементов (арифметическая прогрессия), а в заданное число раз (геометрическая прогрессия).
Пусть изначальная ёмкость массива равна 1, а при каждой реаллокации она удваивается. Тогда на первой реаллокации копируется 1 элемент, на второй — 2, на третьей — 4, затем 8, 16, 32, 64, 128, 256 и 512, после чего накопленная ёмкость равна 1024.
Общее число копирований к моменту добавления 1000-го элемента: \(S = 1 + 2 + 4 + \cdots + 512 = 1024 - 1\).
В общем случае, если необходимо добавить \(n\) элементов, где \(2^k \lt n \le 2^{k+1}\), последнее копирование затронет \(2^k\) элементов. Запишем сумму получившейся геометрической прогрессии: \(S = \sum_{i=0}^k 2^i = 2^{k+1} - 1 = 2 \cdot 2^k - 1 \le 2\cdot n\).
Следовательно, общее количество копирований при реаллокациях линейно зависит от числа добавленных элементов. В общем случае при росте ёмкости в \(r\) раз на один элемент приходится меньше \(r/(r-1)\) копирований. Список CPython растёт не вдвое, а примерно в 1,125 раза: новая ёмкость вычисляется как newsize + (newsize >> 3) + 6 с округлением вниз до кратного четырём. Копирований при этом больше — не больше девяти на элемент вместо двух, — но их число по-прежнему линейно зависит от числа элементов, а запас ёмкости у больших списков составляет до 12,5 %.
Слайды к главе. Связный список, стек, очередь и дек, сравнение списка и дека и выбор структуры изложены также в четвёртой части лекции «Алгоритмы и сложность»; слайды лекции доступны на сайте книги и в PDF.
Связные списки
Элементы массива в памяти компьютера расположены последовательно. Чтобы вставить или удалить элемент из начала массива, требуется \(O(n)\) операций, потому что передвинуть придётся каждый элемент, стоящий следом.
Структурой, не требующей при вставке или удалении сдвигать остальные элементы, является связный список (англ. linked list); он присутствует в стандартных библиотеках многих языков: std::list в C++, LinkedList в Java.
В языке Python list остаётся динамическим массивом, хотя и обозначен словом «список».
Устройство связного списка
В связном списке у каждого элемента, помимо его значения, есть ссылка на следующий элемент списка, за исключением последнего, ссылающегося в никуда. В зависимости от языка программирования ссылка в никуда может представлять собой объект None, нулевой указатель или аналогичную сущность. У связного списка определяют точку старта, называемую «головой списка».
Достоинства и недостатки связного списка
Элементы связного списка располагаются в памяти произвольно, а не подряд, как в массиве. Это удобно, когда элементов много и разместить накопленные данные единым блоком не удаётся.
Платой за это является доступ по индексу: элементы лежат вразброс, и до нужного приходится идти от головы списка, перебирая все звенья по дороге, а это \(O(n)\) операций.
Двигаться по односвязному списку можно только в одном направлении. Отсюда ещё один недостаток: быстро удалить элемент не удастся, потому что неизвестно, какой элемент на него ссылается. В худшем случае поиск предыдущего звена, хранящего эту ссылку, потребует \(O(n)\) операций, тогда как вставка элемента после текущего выполняется быстро.
Структура данных стек
Стек работает по принципу LIFO (англ. last in, first out, «последним пришёл, первым ушёл»). Извлечь можно только элемент, положенный последним.
На стеке реализована кнопка «назад» в браузере: одно нажатие возвращает на предыдущую страницу, следующее — на открытую перед ней.
Отмена последних операций в текстовых редакторах также реализована на стеке.
Наглядной моделью служит стопка книг в коробке: взять можно только верхнюю, а отложив её — следующую сверху. Из стека также извлекается только верхний, положенный последним, элемент.
Интерфейс стека
В отличие от массивов и связных списков, стек представляет собой прежде всего удобный интерфейс к данным, а не способ их физического хранения. Стек реализует следующие методы:
push(item)добавляет элемент на вершину стека;pop()возвращает элемент с вершины стека и удаляет его;size()возвращает размер стека (количество лежащих в нём элементов).
Иногда присутствуют дополнительные операции:
peek()илиtop()возвращает элемент с вершины стека, не удаляя его;isEmpty()определяет, пуст ли стек.
Обычно стек реализуют на массиве. Если элементов очень много и выделить под них единый блок памяти невозможно, предпочтительнее связный список.
Реализация стека
Стек на основе массива: в конструкторе создаётся пустой массив, а методы push() и pop() его изменяют:
class Stack:
def __init__(self):
self.items = []
def push(self, item):
self.items.append(item)
def pop(self):
return self.items.pop()
def peek(self):
return self.items[-1]
def size(self):
return len(self.items)
stack = Stack()
stack.push('apple')
stack.push('banana')
stack.push('orange')
print(stack.pop()) # orange
Структуры данных: очередь и дек
Очередь, в отличие от стека с его LIFO, работает по принципу FIFO (англ. first in, first out): первым извлекается элемент, добавленный раньше всех.
Бытовые очереди подчиняются тому же правилу:
- Кассир в магазине обслуживает покупателей по одному, и покупатель будет обслужен не раньше, чем все вставшие в очередь до него.
- На горячей линии, когда все операторы заняты, автомат также ставит звонящих в очередь.
Такие сценарии моделируются структурой данных очередь.
Интерфейс очереди
Как и стек, очередь задаёт интерфейс взаимодействия с данными, гарантирующий набор методов, но не способ их хранения. Очередь принято реализовывать так, чтобы и вставка, и удаление элемента стоили \(O(1)\).
Методы очереди:
push(item)добавляет элемент в конец очереди;pop()берёт элемент из начала очереди и удаляет его;peek()берёт элемент из начала очереди без удаления;size()возвращает количество элементов в очереди.
Дек: очередь с двумя концами
Очередь пропускает элементы только в одну сторону: вход через хвост, выход через голову. Дек (deque, от double-ended queue, двусторонняя очередь) позволяет добавлять и удалять элементы с любого конца, и обе операции выполняются за \(O(1)\).
Аналогией служит колода карт в руках: карту можно взять или подложить сверху или снизу, а извлечь из середины, не нарушив колоду, не удастся.
Интерфейс дека объединяет стек и очередь:
append(item)добавляет элемент в конец;appendleft(item)добавляет в начало;pop()берёт элемент с конца и удаляет;popleft()берёт с начала и удаляет.
Дек обобщает обе структуры: работа с одним концом даёт стек, вход с одного конца и выход с другого — очередь. Отдельного класса простой очереди для однопоточного кода в Python нет, её роль выполняет дек; классы queue.Queue и queue.SimpleQueue из стандартной библиотеки решают другую задачу — обмен данными между потоками, — и queue.Queue внутри содержит тот же дек.
В стандартной библиотеке дек находится в модуле collections:
from collections import deque
buf = deque()
buf.append(1) # [1]
buf.append(2) # [1, 2]
buf.appendleft(0) # [0, 1, 2]
print(buf.popleft()) # 0, забрали из начала
print(buf.pop()) # 2, забрали с конца
print(buf) # deque([1])
Преимущества дека перед списком
Список в Python поддерживает и insert(0, x), и pop(0); разница заключается в стоимости. Список устроен как динамический массив, его элементы лежат в памяти подряд; чтобы вставить элемент в начало, необходимо сдвинуть все остальные на одну позицию вправо, а это \(O(n)\) на каждую вставку. Дек устроен как цепочка связанных между собой блоков по 64 ссылки, и добавление к любому его концу не затрагивает уже уложенные элементы.
Замер на Apple M4, заполнение структуры с начала:
N | list | deque | отношение
1000 | 0.19 мс | 0.015 мс | 13x
10000 | 13.09 мс | 0.122 мс | 107x
100000 | 1358.53 мс | 1.364 мс | 996x
Важны не сами числа, а последний столбец. Отношение растёт вместе с \(N\), и это является признаком разной алгоритмической сложности. Если бы дек был просто реализован эффективнее, выигрыш оставался бы постоянным. Здесь же на тысяче элементов разница тринадцатикратная, на ста тысячах — тысячекратная, потому что время списка растёт как \(O(n^2)\), а время дека как \(O(n)\). На машине стенда лекции (CPython 3.12.3, ARM64) тот же замер дал отношения 7, 48 и 406: абсолютные значения зависят от машины и версии интерпретатора, а рост отношения с \(N\) сохраняется.
Задача из обработки эксперимента: с детектора поступает поток отсчётов, и на каждом шаге необходимо держать скользящее окно из последней тысячи значений, например чтобы вычислять по нему бегущее среднее. Реализация на списке:
buf = []
for x in data:
buf.append(x)
if len(buf) > 1000:
buf.pop(0) # удаление из начала — O(n)
У дека ограничение длины встроено в конструктор, и при переполнении он сам удаляет элемент, лежащий на противоположном конце.
buf = deque(maxlen=1000)
for x in data:
buf.append(x) # старое значение уходит само, O(1)
На потоке из 200 000 отсчётов первый вариант отработал за 21 мс, а второй за 2 мс: порядок, выигранный одной строкой в выборе структуры данных.
Дек платит за это доступом по индексу. У списка элементы лежат подряд, поэтому lst[50000] вычисляется арифметикой по адресу за \(O(1)\). У дека до середины приходится добираться по блокам, перебирая сцепленные звенья, и это \(O(n)\). В том же замере обращение к середине заняло 0,005 мкс у списка против 0,525 мкс у дека, то есть примерно в сто раз дольше.
Правило выбора, работающее почти всегда: если нужен произвольный доступ по индексу — список; если нужны быстрые операции с обоими концами, а середина лишь пробегается целиком — дек. insert(0, x) или pop(0) внутри цикла почти наверняка означают, что требуется дек.
Слайды к главе. Стек вызовов и его кадры, пределы глубины рекурсии и их зависимость от версии Python, замена рекурсии циклом изложены также в пятой части лекции «Алгоритмы и сложность»; слайды лекции доступны на сайте книги и в PDF.
Стек вызовов
Код программы разделён на функции: базовые объединяются в сложные, а те в ещё более сложные, и вся программа представима как одна функция, вызывающая множество других.
Устройство стека вызовов
Допустим, написана программа на C++. Первой вызывается функция main(), в которой вызывается функция A. Она вызывает функцию B, которая, в свою очередь, вызывает C.
Стек вызовов написанной программы выглядит следующим образом:
вершина стека
┌──────────────┐
│ C │ ← выполняется сейчас
├──────────────┤
│ B │ вызвала C
├──────────────┤
│ A │ вызвала B
├──────────────┤
│ main() │ вызвала A
└──────────────┘
дно
После возврата из функции управление должно вернуться туда, откуда эта функция была вызвана. Для этого при вызове в стеке сохраняется адрес инструкции, ожидающей выполнения после возврата.
Пример: функция приветствует пользователя по имени и выдаёт гороскоп на сегодня, для простоты один и тот же для всех.
def say_hello(name):
print(f"Привет, {name}")
print_horoscope(name.upper())
print(f"Пока, {name}, хорошего дня!")
def print_horoscope(name):
print(f"{name}! Сегодня подходящий день для прогулок в парке и изучения рекурсии")
say_hello('Гоша')
В разных частях программы переменная name хранит разные значения: при входе в say_hello() в ней записано 'Гоша', в print_horoscope() — 'ГОША', а после возврата в say_hello() снова 'Гоша'.
Для этого программа хранит локальные переменные на том же стеке: на вершине лежит структура с локальными переменными, аргументами функции и адресом возврата, называемая кадром стека (англ. stack frame); ниже она для наглядности называется блоком. Проследим, как меняется стек в этом примере.
Работа стека: шаг за шагом
Первая команда программы — вызов say_hello(), под который на стеке выделяется блок памяти.
┌────────────────────┐
│ say_hello() │ ← выделен блок под вызов
└────────────────────┘
В блок записывается адрес возврата — адрес инструкции, следующей сразу за местом вызова функции.
Туда же помещаются аргументы, с которых начинается набор локальных переменных. Здесь один аргумент name = 'Гоша', других локальных переменных нет.
┌────────────────────┐
│ say_hello() │
│ адрес возврата │
│ name = 'Гоша' │
└────────────────────┘
Первая инструкция say_hello() выводит «Привет, Гоша».
Затем метод upper() возвращает строку 'ГОША', и она становится параметром print_horoscope().
Вызовы print() и upper() на схеме не показаны, хотя они также помещаются на стек при вызове и снимаются с него после завершения.
При вызове print_horoscope() с параметром 'ГОША' выделяется новый блок памяти с параметрами, адресом возврата и местом под локальные переменные. Он ложится поверх блока say_hello() — та же стопка книг в коробке, только из блоков памяти.
┌────────────────────┐
│ print_horoscope() │ ← новый блок лёг сверху
│ адрес возврата │
│ name = 'ГОША' │
├────────────────────┤
│ say_hello() │
│ адрес возврата │
│ name = 'Гоша' │
└────────────────────┘
Первая инструкция print_horoscope() выводит «ГОША! Сегодня подходящий день для прогулок в парке и изучения рекурсии».
Инструкций в print_horoscope() больше нет, и управление возвращается по адресу, записанному в её блоке. Блок снимается со стека, и на вершине снова оказывается блок say_hello(), в котором переменная name по-прежнему хранит 'Гоша'.
┌────────────────────┐
│ say_hello() │ ← верхний блок снят,
│ адрес возврата │ name снова 'Гоша'
│ name = 'Гоша' │
└────────────────────┘
Затем исполняется инструкция say_hello(), следующая за вызовом print_horoscope(), и выводит «Пока, Гоша, хорошего дня!»
Это последняя инструкция say_hello(), поэтому происходит возврат из функции, и её блок освобождается.
┌────────────────────┐
│ │ ← стек пуст
└────────────────────┘
Рекурсия. Переполнение стека вызовов
Функции, вызывающие сами себя с изменёнными аргументами, называются рекурсивными, и они также используют стек вызовов.
Здесь речь идёт о цене, которую рекурсия платит стеком; как рекурсия записывается, из чего складываются рекурсивный и базовый случаи и какие ошибки при этом типичны, рассматривается далее, в главе «Рекурсия и сортировки».
Факториал
Факториал натурального числа можно вычислить как произведение всех натуральных чисел от 1 до n: \(n! = 1 \cdot 2 \cdot ... \cdot (n-1) \cdot n\)
Рекурсия и стек вызовов
Рекурсивная функция вычисления факториала:
def factorial(n):
if n == 1 or n == 0:
return 1
return n * factorial(n - 1)
Вызов factorial(3):
Погружение: Возврат:
┌──────────────┐ ┌──────────────┐
│ factorial(1) │ вернёт 1 │ 1 │
├──────────────┤ ├──────────────┤
│ factorial(2) │ ждёт │ 2 * 1 = 2 │
├──────────────┤ ├──────────────┤
│ factorial(3) │ ждёт │ 3 * 2 = 6 │
└──────────────┘ └──────────────┘
Пока рекурсия погружается, стек растёт: каждый вызов ожидает результата следующего. После базового случая стек разбирается в обратном порядке, и каждый уровень домножает полученное значение на своё n.
При каждом вызове на стеке создаётся новый набор локальных переменных, поэтому переменная n в каждом вызове своя, и одноимённые переменные одной и той же функции не конфликтуют. Обычными средствами языка обратиться к n другого уровня рекурсии нельзя; прочитать её позволяют лишь средства интроспекции, например модуль inspect, которым пользуется демонстрация лекции.
Чтобы хранить локальные переменные и адрес возврата на каждом уровне рекурсии, потребуется \(O(d)\) памяти на стеке, где d — глубина рекурсии. При вычислении факториала \(n!\) глубина равна n, поэтому приведённая выше функция расходует \(O(n)\) памяти на стеке.
Если эта память закончится, а рекурсивные вызовы продолжатся, стек вызовов переполнится, и программа аварийно завершит работу.
Ограничений два. Первое устанавливает сам Python: по умолчанию около тысячи вложенных вызовов, далее RecursionError, а поднять порог можно через sys.setrecursionlimit. Второе — стек операционной системы, обычно 8 МБ; достичь его можно, только сняв первое. Здесь важна версия. По Python 3.10 включительно каждый вызов питоновской функции рекурсивно вызывал функцию интерпретатора на C и расходовал стек C, поэтому глубже нескольких десятков тысяч вызовов рекурсию довести было нельзя: на CPython 3.9 со стеком 8 МБ глубина 30 000 проходит, а на 50 000 процесс завершается аварийно. Начиная с 3.11 вызов одной питоновской функции из другой обходится без рекурсии на C, и чистая рекурсия с поднятым порогом доходит до миллиона уровней, расходуя память кучи. Однако когда цепочка вызовов уходит через C (например, через __repr__), стек C расходуется на каждом уровне. В 3.11 такая рекурсия на глубине в несколько десятков тысяч уровней переполняет стек (англ. stack overflow), а в 3.12 её ограничивает отдельный механизм, и вместо аварийного завершения возникает RecursionError. В одних языках при переполнении стека возникает исключение «Stack Overflow», в других ошибка «Segmentation Fault».
factorial(10_000) # завершится исключением RecursionError
Предотвращение переполнения стека
Приёмы против переполнения стека:
- Иногда рекурсию можно заменить циклом. Например, факториал переписывается следующим образом:
def factorial(n):
accumulator = 1
i = n
while i > 1:
accumulator *= i
i -= 1
return accumulator
- Другой способ — собственный стек, эмулирующий стек вызовов, но без ограничений встроенного.
Объёмом памяти под стек вызовов можно управлять.
В некоторых языках — непосредственно во время работы программы: в Python функция sys.setrecursionlimit() задаёт максимальную глубину рекурсии, а sys.getrecursionlimit() возвращает текущее значение; фактический предел определяется памятью и, для вызовов через код на C, размером стека потока.
В Java и JavaScript размер стека вызовов задаётся настройками виртуальной машины при запуске и во время работы не меняется.
Иногда размер стека вызовов можно изменить на уровне операционной системы.
import sys
print(sys.getrecursionlimit()) # 1000
Как выбор структуры сказывается на работающем сервисе, показано в главе «Работа с базами данных»: там одна задача переложена в четыре хранилища, от текстового файла до кеша.
Резюме
Сводная таблица для выбора структуры под задачу:
| Структура | Доступ по индексу | Вставка в конец | Вставка в начало | Поиск |
|---|---|---|---|---|
| Массив постоянного размера | \(O(1)\) | нет | нет | \(O(n)\) |
Динамический массив (list) | \(O(1)\) | \(O(1)^*\) | \(O(n)\) | \(O(n)\) |
| Связный список | \(O(n)\) | \(O(n)^{**}\) | \(O(1)\) | \(O(n)\) |
Дек (deque) | \(O(n)\) | \(O(1)\) | \(O(1)\) | \(O(n)\) |
\(^*\) Амортизированно: изредка происходит реаллокация, но в среднем на каждый добавленный элемент приходится константа.
\(^{**}\) В том виде, в каком список описан выше, с одной только головой: чтобы добавить элемент в конец, приходится пройти весь список. Если хранить ещё и ссылку на хвост, вставка в конец становится \(O(1)\), и так устроены реализации, принятые в стандартных библиотеках.
Универсальной структуры не существует, существует подходящая под задачу. Если элементы постоянно добавляются и снимаются с обоих концов, а в коде используется список, программа платит \(O(n)\) там, где могла бы платить \(O(1)\).
Ни одна из рассмотренных структур не позволяет быстро искать по значению, все дают \(O(n)\). Как обойти это ограничение, рассматривается в следующих главах, посвящённых хеш-таблицам и деревьям поиска.
Рекурсия и сортировки
Настоящая глава начинается с рекурсии, для многих первого трудного места в программировании, после чего рекурсия применяется к самой изученной задаче информатики — сортировке.
Слайды к главе. Рекурсивный и базовый случаи, замена рекурсии циклом и явным стеком, рекурсивный перебор вариантов изложены также в пятой части лекции «Алгоритмы и сложность» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Введение. Примеры задач на рекурсию
Пусть требуется найти файл Kormen.pdf в папке C:\books\, заполненной вложенными подпапками, без поиска, встроенного в файловый менеджер. Возможны два варианта.
Первый — обычный обход списком:
Обходим папки списком, вручную запоминая, куда ещё не заходили:
очередь: [C:\books]
→ зашли в C:\books, нашли подпапки: algo, physics, math
очередь: [algo, physics, math]
→ зашли в algo, нашли подпапку: sorting
очередь: [physics, math, sorting]
→ зашли в physics … и так далее, пока не найдётся файл или не опустеет очередь
Второй — тот же поиск, записанный рекурсивно:
найти(C:\books)
├── найти(algo)
│ └── найти(sorting) ──▶ Kormen.pdf найден!
├── найти(physics) ← не вызывается: файл уже найден
└── найти(math) ← не вызывается
На каждом уровне погружения рекурсия добавляет в стек вызовов, рассмотренный в предыдущей главе, очередной блок, хранящий локальные переменные текущего вызова. Найдя нужный файл, функция останавливает углубление и начинает по цепочке, от одного уровня к другому, возвращать полученный результат программе, вызвавшей её первой.
Рекурсия не ускоряет работу программы, а, наоборот, может её замедлить. Алгоритмы, реализованные через обычные циклы, часто исполняются быстрее своих рекурсивных аналогов. Зато рекурсия экономит время программиста: код, написанный рекурсивно, получается компактным и понятным, в нём труднее допустить ошибку, а изменения вносятся в него проще, чем в цикл, нагруженный счётчиками.
Рекурсивный и базовый случаи
Любая корректно работающая рекурсия состоит из двух обязательных частей:
- рекурсивного случая, запускающего прямой ход рекурсии и её углубление;
- базового случая, который в нужный момент останавливает это углубление и запускает обратный ход рекурсии.
Рекурсивный случай
Рассмотрим заготовку функции, строящей лестницу из n ступеней:
функция stairs_builder(n):
построить 1 ступеньку
print("Осталось построить {n - 1} ступеней.")
stairs_builder(n - 1)
Вызов функцией самой себя с изменёнными параметрами, stairs_builder(n - 1), и есть рекурсивный случай. Однако программа, написанная таким образом, не остановится сама: рекурсия, лишённая условия остановки, будет углубляться, пока не исчерпает стек вызовов или не упрётся в предел глубины; в Python предел срабатывает примерно через тысячу вызовов, и программа завершается исключением RecursionError.
На каждом следующем уровне рекурсии число непостроенных ступеней n уменьшается на 1. Но после n = 0 функция, не знающая базового случая, не остановит работу, а вызовется со значением −1, затем с −2 и так далее. При неограниченных ресурсах лестница строилась бы вечно.
Базовый случай
У любой рекурсивной функции должен быть базовый случай, то есть условие, обрывающее цепочку рекурсивных вызовов. Необходимо определить, что происходит в базовом случае и какое значение возвращается наверх.
Рекурсия в stairs_builder() должна остановиться, когда построено заданное количество ступеней, то есть когда счётчик, уменьшаемый на каждом уровне, дойдёт до n = 0. Это и есть базовый случай.
функция stairs_builder(n):
if n == 0:
return
построить 1 ступеньку
print("Осталось построить {n - 1} ступеней.")
stairs_builder(n - 1)
Правильное построение рекурсии
Чтобы решить задачу рекурсивным методом, необходимо определить два случая, дополняющих друг друга: базовый и рекурсивный.
Рекурсивный случай сводит задачу, поставленную для большого набора данных, к задаче с меньшим набором, а задачу с большим значением аргумента — к задаче с уменьшенным значением.
Базовый случай описывает ситуацию, требующую остановки: результат, возвращаемый функцией здесь, вычисляется явно, без обращения к рекурсивным вызовам.
Частой ошибкой в рекурсии является зацикливание, обычно из-за пропущенного базового случая. Другой распространённой причиной ухода в бесконечный цикл являются параметры, неверно изменённые в рекурсивном случае.
Например, если функция вызывает саму себя, не меняя значение параметра, то даже при заданном базовом случае до него дело не дойдёт. Необходимо убедиться, что при любом наборе параметров, поданном на вход, функция рано или поздно сведётся к одному из базовых случаев.
В большинстве случаев программа, ушедшая в бесконечную рекурсию, не будет работать вечно, а завершится с ошибкой переполнения стека вызовов или с ошибкой сегментации (англ. segmentation fault): каждый вызов, добавленный в стек, расходует память, а она ограничена. Поведение программы зависит и от самого алгоритма, и от используемого компилятора. Подробнее об этом можно прочитать в статье про оптимизацию хвостовой рекурсии (англ. tail call optimization). CPython такой оптимизации не выполняет: хвостовая рекурсия расходует стек так же, как обычная.
Разбор задач. Рекурсивный перебор вариантов
Рекурсия часто применяется для генерации объектов, устроенных единообразно: числовых или скобочных последовательностей.
Генерация последовательностей из 0 и 1
Рассмотрим генерацию всех последовательностей длины n, составленных из нулей и единиц.
Функция принимает число n и строку prefix, накапливающую уже выбранные символы. Вызовем её со значением prefix, равным пустой строке, чтобы далее дописывать в неё 0 и 1. В каждом рекурсивном вызове n означает, сколько символов ещё не дописано. Рекурсия останавливается, когда n = 0: строка, собранная к этому моменту, готова, и это базовый случай рекурсии.
В рекурсивном случае функция вызывает себя дважды, но с разными параметрами: в первый раз к строке prefix приписывается цифра 0, а во второй 1. Значение n, переданное вниз, каждый раз уменьшается на 1, а prefix удлиняется на один символ. Таким образом рекурсия уходит на n уровней в глубину, и каждый её лист отвечает одной построенной последовательности.
Решение этой задачи удобно представлять в виде бинарного дерева, растущего вниз от пустой строки. Переход влево соответствует приписыванию 0, переход вправо — приписыванию 1. Пройдя от корня по всем ветвям, получим все последовательности длины 3, составленные из 0 и 1.
«»
┌─────┴─────┐
0 1
┌──┴──┐ ┌──┴──┐
00 01 10 11
┌─┴─┐ ┌─┴─┐ ┌─┴─┐ ┌─┴─┐
000 001 010 011 100 101 110 111
Рекурсия часто используется для перебора вариантов. Пусть имеется n различных предметов, каждый из которых может быть взят или отложен в сторону. Тогда наборов, собираемых из них, ровно \(2^n\). Пронумеруем предметы числами от 1 до \(n\) и опишем набор строкой, где предмет, взятый в набор, помечен цифрой 1, а отложенный — цифрой 0. Таким образом, задача перебора вариантов сводится к уже рассмотренной задаче генерации последовательностей.
def generate(n, prefix):
if n == 0:
print(prefix)
return
generate(n - 1, prefix + '0')
generate(n - 1, prefix + '1')
generate(3, '')
000
001
010
011
100
101
110
111
Время перебора растёт как \(2^n\). В демонстрации лекции на машине стенда (CPython 3.12.3, ARM64) одна конфигурация обходится примерно в 63 нс, и полный перебор при \(n = 40\) занял бы около 19 часов, а при \(n = 64\) — около 37 000 лет; ускорение в тысячу раз позволяет добавить лишь десять разрядов.
Слайды к главе. Устойчивость и ключ, сортировки слиянием и быстрая, встроенная сортировка Python и сортировка подсчётом изложены также в шестой части лекции «Алгоритмы и сложность»; слайды лекции доступны на сайте книги и в PDF.
Алгоритмы сортировки. Знакомство
Двоичный поиск, рассмотренный в главе про алгоритмы, также рекурсивен по своей природе, поскольку сводит задачу к вдвое меньшей. Сортировки представляют собой алгоритмы, упорядочивающие данные самых разных типов.
Сортировки среди нас
В смартфоне контакты, записанные вперемешку, показываются по алфавиту, а расписание автобусов составляется по времени их отправления. Поисковая система выдаёт список ответов, ранжированный по степени их релевантности запросу.
Роль сортировок в решении задач
Во многих задачах работать с отсортированными данными удобнее, чем с неупорядоченными. Например:
- найти элемент в массиве быстрее чем за \(O(n)\), воспользовавшись бинарным поиском, возможно только на отсортированных данных;
- таблицу «10 лучших студентов курса» проще собрать из списка, упорядоченного не по алфавиту, а по среднему баллу.
Нередко сортировка становится узким местом всего решения, поэтому необходимо знать, как массив, полученный на вход, сортируется наиболее эффективно.
Лучшей сортировки в общем случае не существует: для данных разной природы и ограничений, наложенных задачей, выигрывают разные алгоритмы.
Выбор алгоритма сортировки
Сравним два алгоритма, решающих одну и ту же задачу:
- один работает быстро, но требует \(O(n)\) дополнительной памяти;
- другой алгоритм медленнее, но ему требуется лишь \(O(1)\) дополнительной памяти.
Пусть в компании стоят старые серверы, свободной памяти на которых почти не осталось. На одном из них лежат данные об удовлетворённости жизнью, собранные по всем городам страны. Для ежемесячного отчёта их необходимо отсортировать и выбрать названия 100 городов с самыми довольными жителями. Отчёт требуется сдать через неделю.
В этом случае предпочтительнее более медленный алгоритм, но эффективный по памяти.
Другая ситуация: команде поручено сделать стенд, показывающий удовлетворённость жителей страны в реальном времени. Под эту задачу был приобретён новый мощный сервер. Каждую секунду на вход программы поступает обновлённый массив со значениями индекса, измеренными по всем городам. Алгоритм должен составить «Топ-5 самых довольных городов» и обновлять этот список без задержек.
Здесь предпочтительнее более быстрый алгоритм, но требующий больше памяти.
При решении задачи имеющиеся ресурсы оцениваются по трём обстоятельствам:
- Срочность ответа. Если результат сортировки нужен не срочно, подходит более медленный алгоритм, зато не требующий лишней памяти.
- Объём данных, поступающих на вход. Если в массиве всего 1000 элементов, то любой алгоритм сортировки упорядочит их за неощутимое время. На 5 000 000 элементов разница между алгоритмами становится решающей.
- Объём доступной памяти. Если свободного места хватает на вторую копию массива, можно собирать отсортированный массив в выделенной памяти, а не переставлять элементы в исходном.
Устойчивость сортировок
Сортировку, сохраняющую взаимный порядок элементов с равным значением сравниваемого признака, называют устойчивой (англ. stable sort). Если же равные элементы могут поменяться местами, сортировку называют неустойчивой. Разница важна, когда данные сортируют несколько раз подряд по разным ключам: устойчивая сортировка сохраняет результат, полученный на предыдущем проходе, а неустойчивая его перемешивает.
Сортировка по ключу
Признак, по которому элементы сравниваются, называют «ключом сортировки». Сортировка по ключу уже применялась выше, когда города упорядочивались по индексу удовлетворённости, посчитанному для каждого из них.
С точки зрения алгоритма сортировки меняется только один этап — операция, сравнивающая элементы.
Обычно функция сортировки принимает вспомогательным аргументом функцию, задающую порядок элементов. Два распространённых способа:
- В одном варианте передаётся функция одного аргумента
key(object). Она даёт значение ключа для каждого объекта, и объекты попарно сравниваются по вычисленным ключам. - В другом варианте передаётся функция двух аргументов
less(object_1, object_2), сравнивающая два объекта напрямую: она возвращаетtrue, если первый должен стоять раньше второго, иfalseв противном случае. Такую функцию называют «компаратор» (англ. compare, «сравнивать»).
Компаратор задаёт порядок гибче, чем ключ: сортировку по любому ключу легко переписать через компаратор:
функция less(object_1, object_2):
return key(object_1) < key(object_2)
Обратное преобразование выполняет обёртка functools.cmp_to_key; однако компаратор вызывается на каждом сравнении и не всякий компаратор задаёт корректный порядок, поэтому обычно проще пользоваться функцией, вычисляющей ключ сортировки.
Способ передачи компаратора либо функции вычисления ключа в функцию сортировки, встроенную в конкретный язык, описан в её документации.
Сортировка слиянием
Сортировка слиянием (англ. merge sort) работает за \(O(n \log n)\) даже в худшем случае.
Принцип работы сортировки слиянием
Алгоритм складывается из трёх действий, повторяемых на каждом уровне:
- Массив разбивается на две части примерно одинакового размера.
- Если в подмассиве, полученном при разбиении, больше одного элемента, то для него рекурсивно запускается тот же алгоритм, начиная с первого шага.
- Два упорядоченных массива соединяются в один.
Условием остановки рекурсии служит массив из одного элемента, уже отсортированный по определению: это базовый случай.
Разбиение: Слияние:
[5 2 9 1] [1 2 5 9]
┌────┴────┐ ┌────┴────┐
[5 2] [9 1] [2 5] [1 9]
┌─┴─┐ ┌─┴─┐ ┌─┴─┐ ┌─┴─┐
[5] [2] [9] [1] [5] [2] [9] [1]
Дерево алгоритма сортировки слиянием: массив разбивается на части примерно равной длины. Каждая часть сортируется рекурсивно, после чего части, приведённые в порядок, объединяются в единый массив
Ниже приведены сначала слияние, собирающее из двух упорядоченных массивов один, затем сама сортировка, состоящая из разбиения и рекурсивного вызова:
def merge(left, right):
# Идём по обоим массивам сразу, каждый раз забирая меньший из головных элементов
merged = []
i, j = 0, 0
while i < len(left) and j < len(right):
# При равенстве берём элемент из левой части: этим и держится устойчивость
if right[j] < left[i]:
merged.append(right[j])
j += 1
else:
merged.append(left[i])
i += 1
# Хвост, оставшийся от одного из массивов, дописываем целиком
merged.extend(left[i:])
merged.extend(right[j:])
return merged
def merge_sort(nums):
# Массив из одного элемента уже отсортирован: это базовый случай
if len(nums) <= 1:
return nums
middle = len(nums) // 2
left = merge_sort(nums[:middle])
right = merge_sort(nums[middle:])
return merge(left, right)
Сложность алгоритма
Сортировка слиянием даже в худшем случае работает за \(O(n \log n)\).
На каждом шаге прямого хода рекурсии массив разбивается на две примерно равные по размеру части, и разбиение продолжается до тех пор, пока длина массива не станет равной 1. Следовательно, каждый элемент, попадающий в такую цепочку, будет задействован примерно в \(\log_2 n\) вызовах рекурсивной функции.
Иначе можно сказать, что глубина рекурсии составляет \(O(\log n)\). Глубиной рекурсии называют максимальную глубину стека вызовов, достигаемую за время её работы.
На каждом шаге обратного хода рекурсии выполняется слияние двух отсортированных массивов, а оно выполняется одним проходом. Следовательно, на каждом уровне рекурсии затрачивается \(O(n)\) операций: сколько бы частей там ни было, вместе они содержат все \(n\) чисел, распределённых по ним при разбиении.
Общая сложность алгоритма \(O(n \log n)\).
Пространственная сложность алгоритма
Слияние собирает результат в новом массиве, куда копируются элементы объединяемых частей в правильном порядке. В приведённой реализации срезы и слитые списки создаются заново на каждом уровне, так что за время работы выделяется \(O(n\log{n})\) памяти.
Однако одновременно существуют только списки текущей ветви рекурсии: \(n/2 + n/4 + \ldots < n\) элементов и результат слияния, а списки уже завершённых ветвей освобождаются. Поэтому дополнительная память составляет \(O(n)\).
Устойчивость алгоритма
Сортировка слиянием устойчива. При равенстве элементов в двух сливаемых массивах приоритет отдаётся элементу, лежащему в левой половине. Так происходит на каждом уровне, вплоть до объединения двух последних половин в целый массив. Поэтому равные элементы в массиве, собранном алгоритмом, стоят друг относительно друга так же, как и в исходном.
Быстрая сортировка
Быстрая сортировка (англ. quick sort) опирается на стратегию «разделяй и властвуй».
Стандартные библиотеки разных языков сделали разный выбор алгоритма сортировки: в распространённых реализациях C++ std::sort — интроспективная сортировка, то есть быстрая, переходящая в пирамидальную на неудачных входах (стандарт с C++11 требует лишь \(O(n \log n)\) сравнений), а в Python sorted() и list.sort() — Timsort, гибрид сортировки слиянием и вставками, устойчивый и использующий уже упорядоченные фрагменты: на упорядоченном входе он выполняет всего \(n - 1\) сравнений, а с версии 3.11 порядок слияний выбирается по правилу powersort. Автором быстрой сортировки был Чарльз Хоар, поэтому в честь него quick sort иногда называют сортировкой Хоара.
Принцип работы алгоритма
Любой алгоритм, построенный по этой стратегии, состоит из трёх шагов:
- разделение данных на части меньшего размера;
- рекурсивный вызов алгоритма для полученных частей;
- объединение результатов.
В merge sort шаг разделения прост, а шаг объединения нетривиален. В быстрой сортировке наоборот: разделение на части сложнее, зато части, отсортированные рекурсивно, объединяются дописыванием одного массива после другого.
- Возьмём исходный массив:
[7 2 9 4 3 8 1]
- Выберем какое-нибудь число, например 4, и назовём его опорным. Все элементы, меньшие опоры, переложим в один массив, все большие — в другой, а саму опору (и равные ей) оставим посередине:
[2 3 1] 4 [7 9 8]
меньше опора больше
- Отсортируем каждую из частей рекурсивно.
- Соединим левую часть с правой.
Получен отсортированный массив:
[1 2 3] 4 [7 8 9] ──▶ [1 2 3 4 7 8 9]
Число, назначенное опорой, было выбрано произвольно.
Выбор опорного элемента
Если взять опорой максимум, разбиение выродится: слева окажется весь массив, справа пусто. Длина, уменьшенная всего на единицу, даст \(n\) уровней рекурсии, а работы на каждом линейно. Итого \(O(n^2)\), не лучше наивных квадратичных сортировок.
Следовательно, опора должна делить массив примерно пополам. Разумной эвристикой служит элемент, взятый из середины: на отсортированном или почти отсортированном массиве (а такие входы часты) он даёт ровное разбиение. Однако под любое простое фиксированное правило (первый или средний элемент, медиана трёх элементов) можно подобрать массив, вырождающий разбиение, и в олимпиадных тестах такие массивы появляются намеренно. Гарантию \(O(n \log n)\) даёт выбор опоры точной медианой, найденной за линейное время, однако константа такого алгоритма велика, и на практике выбирают случайную опору или интроспективную сортировку.
При опоре, выбранной случайно, плохое разбиение зависит не от массива, а от жребия. Гарантии это по-прежнему не даёт: при очень неудачной череде жребиев быстрая сортировка отработает за \(O(n^2)\). Однако вероятность такого исхода исчезающе мала, а в среднем получается \(O(n \log n)\).
Разбиение раскладывает массив на три части: меньшие опоры, равные ей и превосходящие её, — а сама сортировка рекурсивно упорядочивает крайние части и соединяет их со средней:
import random
def partition(nums, pivot):
# Раскладываем элементы по трём массивам, сравнивая каждый с опорой
less, equal, greater = [], [], []
for num in nums:
if num < pivot:
less.append(num)
elif num > pivot:
greater.append(num)
else:
equal.append(num)
return less, equal, greater
def quick_sort(nums):
# Массив из нуля или одного элемента уже отсортирован: это базовый случай
if len(nums) <= 1:
return nums
# Опору выбираем случайно, чтобы входные данные не могли выродить разбиение
pivot = random.choice(nums)
less, equal, greater = partition(nums, pivot)
return quick_sort(less) + equal + quick_sort(greater)
Равные опоре элементы, собранные отдельно, попадают на своё место сразу и в рекурсию больше не передаются; без этой предосторожности массив из одинаковых чисел привёл бы алгоритм к бесконечной рекурсии.
Сложность быстрой сортировки
Разбиение массива вокруг опоры выполняется одним проходом за \(O(n)\) операций. Если опора, выбираемая на каждом шаге, делит массив примерно пополам, уровней рекурсии будет \(O(\log n)\), и на каждом суммарно затрачивается \(O(n)\), откуда и получается \(O(n \log n)\) в среднем. При вырожденных разбиениях уровней становится \(n\), и сложность возрастает до \(O(n^2)\).
Схема с тремя новыми массивами стоит \(O(n)\) дополнительной памяти, и от этой платы на практике избавляются. Разбиение выполняют на месте: поддерживается граница «меньших», массив проходится одним проходом, и очередной элемент, меньший опоры, меняется местами с элементом на границе, а в конце опора ставится на место границы.
Памяти такой быстрой сортировке почти не требуется: сверх исходного массива расходуется только стек вызовов, \(O(\log n)\) при удачных разбиениях. Этим она и выигрывает у сортировки слиянием, требующей вспомогательный массив на \(n\) элементов.
Разбиение на месте устойчивостью не обладает: элементы перебрасываются через весь массив, и два равных могут поменяться местами. Схема с тремя новыми массивами, приведённая выше, порядок равных сохраняет, поскольку раскладывает элементы в исходном порядке; в демонстрации лекции она сохранила порядок во всех 1000 испытаниях, а разбиение на месте — ни в одном. Поэтому там, где исходный порядок равных элементов важен, применяют сортировку слиянием, схему с тремя массивами или дописывают в ключ номер, присвоенный элементу изначально.
Сортировка подсчётом
Отсортировать быстрее чем за \(O(n \log n)\) возможно, но лишь для узкого класса задач, устроенных особым образом.
Принцип работы алгоритма
Дан массив чисел:
nums = [5, 7, 1, 0, 1, 5, 11, 1]
Требуется отсортировать его по неубыванию. Известно, что числа в нём обозначают номера месяцев, то есть лежат в диапазоне от 0 до 11.
Заведём массив из 12 элементов, заполненный нулями.
months = [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
Теперь пройдём по массиву nums и для каждого числа увеличим на 1 счётчик, отвечающий этому месяцу:
months[5] += 1
months[7] += 1
months[1] += 1
months[0] += 1
months[1] += 1
months[5] += 1
months[11] += 1
months[1] += 1
Получим:
months = [1, 3, 0, 0, 0, 2, 0, 1, 0, 0, 0, 1]
Теперь пройдём по массиву months и допишем в nums столько копий каждого номера, сколько единиц накоплено в счётчике, отвечающем этому месяцу:
nums = []
for i in range(len(months)):
for j in range(months[i]):
nums.append(i)
Получим:
nums = [0, 1, 1, 1, 5, 5, 7, 11]
Код для случая, когда значения элементов лежат в полуинтервале от 0 до k:
def counting_sort(nums, k):
# Создаём массив из k элементов, заполненный нулями
counts = [0] * k
# Проходим по массиву nums и увеличиваем соответствующий элемент в массиве counts
for num in nums:
counts[num] += 1
# Проходим по массиву counts и добавляем в массив nums столько элементов, сколько встречается в counts
nums = []
for i in range(len(counts)):
for j in range(counts[i]):
nums.append(i)
return nums
Алгоритм сортировки подсчётом использует \(O(k)\) дополнительной памяти на счётчики и \(O(n)\) на выходной массив, где \(k\) — длина диапазона значений, которые могут встретиться в массиве. Память, выделенная под вспомогательный массив, и есть плата за скорость. Чтобы создать этот массив, необходимо знать диапазон возможных значений. В примере потребовался дополнительный массив всего из 12 элементов.
Элементы здесь ни разу не сравниваются друг с другом, поэтому сортировка подсчётом и обходит границу \(O(n \log n)\), доказанную для сортировок сравнением: такая сортировка должна различить все \(n!\) перестановок входа, а каждое сравнение даёт не более одного бита информации, поэтому в худшем случае ей необходимо не менее \(\log_2(n!) \approx n \log_2 n - 1{,}44n\) сравнений, при \(n = 1000\) — около 8529. Работает она за \(O(n + k)\), и выигрыш сохраняется, только пока \(k\) сопоставимо с \(n\). Сортировать таким способом миллион чисел, разбросанных по диапазону до миллиарда, бессмысленно: массив, заведённый под счётчики, окажется в тысячу раз длиннее исходного.
Устойчивость алгоритма
Приведённая реализация восстанавливает массив из одних счётчиков: она годится для чисел, но записи, привязанные к ключам, не переносит вовсе. Для чисел разницы нет: две единицы неотличимы друг от друга. Если же ключ — номер месяца, взятый у записи с фамилией, записи необходимо переносить целиком и сохранять порядок попавших в один месяц, а для этого нужен устойчивый вариант.
Устойчивый вариант вычисляет по массиву счётчиков префиксные суммы — позиции, с которых начинаются блоки значений в выходном массиве, — а затем проходит исходный массив слева направо и ставит каждый элемент на очередное место его блока, сдвигая границу блока на единицу вперёд; так элементы с равными ключами выписываются в исходном порядке. Можно пройти массив и справа налево, но тогда префиксные суммы должны указывать концы блоков, а граница уменьшается перед каждой записью.
Резюме
- Рекурсия складывается из базового случая, останавливающего спуск, и рекурсивного, сводящего задачу к меньшей; без базового случая происходит переполнение стека.
- Сортировка слиянием работает за \(O(n \log n)\) даже в худшем случае и устойчива, но требует \(O(n)\) дополнительной памяти под вспомогательный массив.
- Быстрая сортировка в среднем также \(O(n \log n)\) и почти не требует памяти, зато на неудачных разбиениях деградирует до \(O(n^2)\); разбиение на месте порядок равных элементов не сохраняет, а схема с тремя новыми массивами сохраняет ценой \(O(n)\) памяти.
- Опору в быстрой сортировке следует выбирать случайно: любое простое фиксированное правило можно обойти массивом, подобранным намеренно.
- Сортировка подсчётом не сравнивает элементы вовсе, благодаря чему обходит границу \(O(n \log n)\), но применима лишь на небольшом диапазоне значений и требует \(O(k)\) памяти на счётчики и \(O(n)\) на результат.
- Устойчивость является критерием выбора: она необходима всякий раз, когда данные сортируют несколько раз подряд по разным ключам.
- Собственную сортировку в рабочем коде писать незачем, потому что встроенная почти всегда быстрее и лучше отлажена; знать, как она устроена, необходимо, чтобы понимать, чего от неё ожидать.
Хеш-функции
Основным достоинством массива является мгновенный доступ по номеру, вычисленному заранее. Однако искать нередко приходится не по номеру, а по имени, будь то название города, идентификатор события, записанного детектором, или имя файла, сохранённого на диске.
Последовательный перебор всех элементов является слишком медленным. Номер ячейки, отведённой под пару «ключ — значение», можно вычислять непосредственно из ключа. Эту задачу решают хеш-функции, на которых построены словари и множества.
В настоящей главе рассматривается, каким образом ключ преобразуется в номер корзины, почему различные ключи иногда попадают в одну корзину, как разрешаются столкновения ключей и за счёт чего словарь обеспечивает сложность \(O(1)\) в среднем.
Слайды к главе. Ассоциативный массив, хеш-таблица, коллизии, коэффициент заполнения и перехеширование, поисковый индекс изложены также в первой части лекции «Хеши, деревья и графы» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Понятие отображения
В интерфейсе массива, рассмотренном в главе про структуры данных, имеются две основные операции:
get(index: int) -> valueвозвращает значениеvalueиз ячейки с индексомindex;set(index: int, value: ValueType)записывает значениеvalueв ячейку с индексомindex.
Каждая из этих операций выполняется за \(O(1)\). Однако у массивов есть ограничение, накладываемое устройством памяти: в ячейках можно расположить объекты любого типа, а индексы могут быть только целыми числами.
В программе часто требуется получить объект не по порядковому номеру, а по другому признаку, например по названию, или, в терминологии программистов, получить значение (англ. value) по ключу (англ. key).
Пусть заданы множество городов и множество стран, причём одному городу отвечает единственная страна.
города страны
────── ──────
Новосибирск ──┐
Москва ──┼───▶ Россия
Казань ──┘
Минск ─────▶ Беларусь
Астана ─────▶ Казахстан
Требуется написать программу-справочник, определяющую по городу страну. Если справочник будет пополняться, потребуется функция, добавляющая новую пару «город, страна».
Здесь город служит ключом, а страна — значением: каждому городу отвечает одна страна, а на страну может указывать любое количество городов.
Сопоставление, устроенное так, что каждому объекту первого множества (множество городов) отвечает единственный объект второго (множество стран), называется «отображением» (англ. map).
Отображение — другое название математического термина «функция», или «функциональная зависимость». Чаще всего функции отображают числа на оси X в числа на оси Y: для каждого числа из области определения можно выписать другое число — значение функции в этой точке.
Массивы также представляют собой частный случай отображения, сопоставляющий целому числу произвольное значение. Например, массив ["яблоко", "груша", "яблоко"] возвращает по числам 0 и 2 строку яблоко, а по числу 1 строку груша.
Для работы с отображениями необходима похожая на массив структура данных, позволяющая получать и сохранять значения:
get(key: KeyType) -> valueвозвращает значениеvalueпо ключуkey;set(key: KeyType, value: ValueType)записывает значениеvalueпо ключуkey.
Однако вместо целочисленного индекса она должна допускать ключ произвольного типа.
Интерфейс, описывающий две этих операции, называют Map, а любую структуру, которая его реализует, называют «ассоциативным массивом» (англ. associative array).
Ассоциативные массивы
В большинстве языков программирования ассоциативные массивы встроены в язык.
Чаще всего их называют так же, как интерфейс, то есть Map, «отображение», или используют производные от слова «хеш-таблица»: Hash, HashMap, HashTable и даже просто Table. Эти названия подчёркивают способ реализации интерфейса отображения. Встречаются и другие: в Python ассоциативные массивы называют «словарями» (англ. dictionary).
Существует два распространённых способа реализовать (имплементировать) отображение в памяти: хеш-таблицы, которым посвящена настоящая глава, и деревья поиска, рассматриваемые в следующей. В некоторых языках имеются обе реализации: в Java это HashMap и TreeMap, а в C++ — std::unordered_map и std::map.
Во многих языках предусмотрен отдельный синтаксис для создания ассоциативного массива. В Python отображение реализовано типом dict, встроенным в интерпретатор.
Наивная реализация ассоциативного массива
Простейший способ реализовать ассоциативный массив — завести обыкновенный массив или список пар (key, value).
Для получения элемента по ключу осуществляется проход по всем элементам списка, находится пара с подходящим ключом и возвращается её значение. Для сохранения значения ищется пара с указанным ключом и изменяется хранимое в ней значение, а если пара не найдена, новая пара добавляется в конец массива.
class NaiveMap:
def __init__(self):
self.pairs = []
def get(self, key):
for stored_key, value in self.pairs:
if stored_key == key: # пара с указанным ключом найдена
return value
return None
def set(self, key, value):
for i, (stored_key, _) in enumerate(self.pairs):
if stored_key == key: # пара с указанным ключом найдена
# обновить значение в найденной паре
self.pairs[i] = (key, value)
return
# пара с заданным ключом не найдена
self.pairs.append((key, value))
Такая реализация является медленной: на поиск элемента уходит в среднем \(O(n)\) операций.
Хеш-таблица и хеш-функция
Хеш-таблица (англ. hash table) — способ реализации ассоциативного массива, при котором данные хранятся в виде пар (key, value), разложенных по ячейкам обыкновенного массива. Эти ячейки называются корзинами (англ. bucket) и пронумерованы. Номер корзины зависит от ключа, поэтому можно ввести функцию, которая вычисляет этот номер непосредственно по ключу, без перебора.
Принцип работы хеш-функции и хеш-таблицы
Если ключей всего три, номер корзины можно определить несколькими условными операторами. Однако при большом числе ключей функция из таких проверок разрастётся и будет работать медленно, а каждый добавленный ключ потребует новой строки.
Эта проблема решается хешированием, для которого необходима хеш-функция.
Хеш-функцией (англ. hash function) называют функцию, преобразующую входные данные в целое число, причём для объектов разного типа применяются разные хеш-функции. Число, полученное на выходе, называется «хешем» или «хеш-суммой» (англ. hash, hash code или digest).
Пусть у каждой буквы алфавита есть индекс, равный её порядковому номеру. Хеш-функция может возвращать индекс первой буквы ключа. Тогда для яблока функция вернёт 33, для груши 4, а для сливы 19.
ключ первая буква хеш
──── ──────────── ───
яблоко я 33
груша г 4
слива с 19
Поскольку хеш является целым числом, он пригоден на роль номера корзины без преобразований, необходимых в общем случае. Информация о грушах хранится в корзине 4: чтобы получить или обновить число груш на складе, достаточно обратиться к этой ячейке. Запоминать номера ячеек не требуется: хеш-функция вычислит их в любой момент.
корзины
┌────┬───────────────────┐
│ 4 │ груша: 120 кг │ ← сюда попадает «груша»
├────┼───────────────────┤
│ 19 │ слива: 45 кг │
├────┼───────────────────┤
│ 33 │ яблоко: 300 кг │
└────┴───────────────────┘
Другой пример хеш-функции — сумма номеров всех букв названия. Тогда для «яблоко» она даст 92, для «груша» 70, а для «слива» 46.
Многие хеш-функции возвращают очень большие числа: миллионы, миллиарды и более. Поэтому хеш редко используется непосредственно как номер ячейки: сначала по ключу определяется хеш, а затем из хеша выводится номер корзины.
Пусть корзин \( M = 11 \), а хеш вычисляется второй функцией — суммой номеров букв. Для «груши» она даёт 70, и остаток \( 70 \bmod 11 = 4 \):
ключ ──[хеш-функция]──▶ хеш ──[% M]──▶ номер корзины ──▶ значение
«груша» 70 70 % 11 = 4 120 кг
Число корзин здесь отличается от приведённого на рисунке выше: там номером служил сам хеш по первой букве, и корзин требовалось не менее тридцати четырёх. Остаток позволяет поддерживать таблицу любого удобного размера независимо от того, какие числа возвращает хеш-функция.
Отображение из ключа в значение разделилось на три независимых отображения. 1. Сначала хеш-функция отображает ключ в число, то есть в хеш. 2. Затем полученный хеш преобразуется в индекс корзины. 3. Наконец, в массиве корзин по индексу находится нужная корзина; в ней лежит значение.
Коллизии
Ситуация, при которой хеш-функция для разных входных данных возвращает одно и то же значение, называется «коллизией».
Например, и у «арбуза», и у «абрикоса» хеш, вычисленный по первой букве, равен 1, и оба ключа указывают на одну корзину.
Коллизии возникают у всех хеш-функций, поэтому в любой хеш-таблице должен быть предусмотрен способ их разрешения. Таких способов два.
При методе цепочек в корзине лежит не одна пара, а связный список всех пар, относимых к этому номеру. Вычисляется корзина, после чего перебирается её список. При открытой адресации пара помещается в ближайшую свободную корзину, например в следующую по порядку; поиск идёт по правилу, выбранному при вставке, пока не встретится нужный ключ или пустая ячейка. Поэтому удалённую пару при открытой адресации нельзя просто стереть: ячейку помечают как удалённую, иначе оборвётся последовательность проб для ключей, вставленных позже. Открытую адресацию используют словарь и множество CPython.
В обоих случаях стоимость операции зависит от числа ключей, делящих одну корзину. Пока хеш-функция распределяет ключи равномерно, а корзин достаточно, цепочки остаются короткими, и поиск, вставка и удаление стоят в среднем \(O(1)\). Если же коллизий много, хеш-таблица вырождается в список пар, с которого начиналось рассмотрение, и поиск снова обходится в \(O(n)\).
Коэффициент заполнения и перехеширование
Условие «корзин достаточно» выражается числом. Отношение количества ключей в таблице к количеству корзин называют коэффициентом заполнения (англ. load factor): пока он мал, цепочки коротки и почти все корзины пусты. Если каждый из \(n\) ключей попадает в любую из \(M\) корзин с равной вероятностью, пустой остаётся доля корзин около \(e^{-n/M}\), а успешный поиск в методе цепочек просматривает в среднем \(1 + n/(2M)\) пар: сам ключ и половину остальных ключей его корзины. Даже при коэффициенте, равном единице, пустует примерно треть корзин, а на поиск уходит полтора сравнения, поэтому методу цепочек такое заполнение не страшно. При открытой адресации, напротив, с приближением коэффициента к единице число проб растёт неограниченно, и порог для неё выбирают заметно меньше единицы.
Как только коэффициент превышает порог, выбранный реализацией (в CPython у словаря это две трети, у множества — три пятых), заводится новый массив корзин, в несколько раз больший прежнего, и все ключи раскладываются по нему заново: номер корзины вычисляется по модулю \(M\), а \(M\) изменилось. Эту перестройку называют перехешированием (англ. rehashing).
Стоит она \(O(n)\), но происходит редко и с каждым разом всё реже, поскольку таблица растёт не на одну корзину, а кратно. Та же арифметика рассмотрена в главе «Основные структуры данных» под заголовком «Реаллокация в динамических массивах»: редкие дорогие перестройки, распределённые по множеству дешёвых операций, дают амортизированную \(O(1)\). В CPython 3.12 таблица словаря при перестройке растёт вдвое: перестройки происходят при добавлении 6-го, 11-го, 22-го, 43-го ключа и далее, когда заполнение таблицы из 8, 16, 32, 64 ячеек превышает две трети; таблица множества растёт вчетверо, пока в нём не больше 50 000 элементов.
Слайды к главе. Метод деления и число корзин, метод умножения, полиномиальный хеш строк, свойства хеш-функций, функция hash() и криптографические хеши изложены также во второй части лекции «Хеши, деревья и графы»; слайды лекции доступны на сайте книги и в PDF.
Выбор размера хеш-таблицы и вычисление номера корзины
Вычисление номера корзины методом деления
Простейший способ получить номер корзины \(\mathrm{bucket}(k)\) для целого ключа \(k\) — взять остаток от деления \(k\) на число корзин \(M\). Остаток от деления обозначается \(k \bmod M\) и произносится «\(k\) по модулю \(M\)». В языках программирования остаток вычисляется оператором %.
Любое целое число \(k\) может быть представлено в форме \(k = j\cdot M + r\), где все числа целые, а \(r \in[0,M)\). Число \(r\) и называется остатком.
Остатки от деления на \(M\) лежат в диапазоне от \(0\) до \((M-1)\) — это те же числа, что служат номерами корзин в хеш-таблице длины \(M\).
В разных языках программирования остаток от деления по-разному работает с отрицательными числами (см. подробности), не всегда так, как математическая операция взятия по модулю. Например, выражение \(-13 \bmod 5\) в одних языках даст \(2\), в других \(-3\). Если этого не учесть, можно получить отрицательный номер корзины.
Выбор числа корзин
Если номер корзины вычисляется методом деления, в качестве \(M\) лучше брать простое число, то есть делящееся без остатка только на себя и на 1.
Ключи могут быть распределены неравномерно не только в двоичной и десятичной системах счисления: существует много других закономерностей, и не все они заметны при беглом рассмотрении.
Чем больше делителей у \(M\), тем чаще закономерности в ключах приводят к коллизиям; у простого числа делителей всего два, поэтому простое \(M\) уменьшает число столкновений. Например, номера пятого канала каждой платы из 64 каналов имеют вид \(64k + 5\): при \(M = 64\) все 1000 таких ключей попадают в одну корзину, при \(M = 1000\), имеющем с 64 общий делитель 8, — в 125 корзин, а при простом \(M = 1009\) занимают 1000 корзин, то есть коллизий нет вовсе.
Для любого числа корзин можно построить вырожденную последовательность ключей, дающую много коллизий. Однако если делителей у M много, велика вероятность встретить такую последовательность случайно, а при большом простом M это маловероятно.
Эта рекомендация относится к методу деления со слабой хеш-функцией. Распространённые реализации используют таблицы размером \(2^k\), у которых остаток вычисляется маской младших битов: словарь и множество CPython подмешивают старшие биты хеша при пробировании, HashMap в Java перемешивает хеш операцией h ^ (h >>> 16), а метод умножения, рассмотренный ниже, работает и при \(M = 2^k\).
Вычисление номера корзины методом умножения
Другой распространённый способ вычисления номера ячейки — метод умножения. Целое число обозначим на этот раз буквой \(h\), чтобы подчеркнуть, что это хеш ключа. Пусть количество корзин равно \(M\), а также зададим константу \(\alpha \in (0,1)\).
Тогда \(\mathrm{bucket}(h) = \left [ M \cdot \left \lbrace h \cdot \alpha \right \rbrace \right ]\) , где \(\left [ x \right ]\) обозначает целую часть числа \(x\), а \(\left \lbrace x \right \rbrace\) его дробную часть.
Алгоритм построения хеш-функции, опирающийся на метод умножения:
- Хеш ключа \(h\) домножается на выбранную константу \(\alpha\).
- От результата берётся дробная часть. Получается значение из диапазона \([0,1)\). Числа для разных ключей окажутся равномерно рассеяны.
- Полученное значение домножается на размер таблицы \(M\). Числа получаются распределёнными в диапазоне \([0, M)\)
- От результата берётся целая часть. С равными вероятностями получаются числа от \(0\) до \((M-1)\) — номера корзин. Равномерно заполняемые корзины дают меньше коллизий.
Дональд Кнут предложил брать в качестве \(\alpha\) число, обратное золотому сечению: последовательные ключи при этом рассеиваются по корзинам наиболее равномерно. $$ \displaystyle \alpha = \phi^{-1} = \left ( \frac{\sqrt 5 -1}{2} \right ) = 0.6180339887... $$
При любом \(\alpha\) дробные части чисел \(k\alpha\) для последовательных \(k\) делят отрезок \([0, 1)\) на промежутки не более трёх различных длин (теорема о трёх расстояниях); при \(\alpha = \phi^{-1}\) эти длины различаются меньше всего, а каждая следующая точка попадает в один из наибольших промежутков и делит его в золотом отношении.
Свойства хеш-функций
Не любая функция подходит на роль хеш-функции. Требуется функция, принимающая на вход данные и возвращающая число, отвечающее индексу корзины.
Хеш, вычисляемый за небольшое число операций, позволяет быстро находить место объекта в хеш-таблице: искать его, добавлять или удалять.
Например, пусть требуется выяснить стоимость товара в магазине. Если функция потратит на вычисление позиции элемента больше времени, чем ушло бы на перебор всех товаров на полках, применять её не имеет смысла.
Функция, преобразующая ключ в индекс корзины, должна обладать следующими свойствами:
- Детерминизм. Для одного и того же ключа функция всегда возвращает одинаковое значение. Если внутри используется случайное число, повторный вызов может вернуть новый индекс ячейки, и данные из хеш-таблицы окажутся недоступны. Например, взятие числа по модулю другого числа детерминировано: результат, вычисленный дважды, не изменится.
- Эффективность. Хеш-функция, вызываемая на каждой операции, должна вычисляться быстро. Сложность операции поиска складывается из сложности вычисления хеша и сложности поиска данных по хешу.
- Ограниченность. Результат функции должен принадлежать диапазону, задаваемому размером хеш-таблицы. Поэтому обычно сначала вычисляется хеш-функция, возвращающая произвольное число, а затем результат берётся по модулю \(M\), равного размеру хеш-таблицы. Тогда любой ключ окажется в интервале от \(0\) до \(M-1\), и обращения к индексу, не отвечающему ни одной из корзин, не произойдёт.
- Равномерность. Данные должны быть распределены по хеш-таблице равномерно, то есть каждое выходное значение равновероятно: при запуске функции для каждого элемента большого списка разных объектов получится примерно равное число ответов на каждое значение от \(0\) до \(M-1\). В противном случае в некоторые ячейки запись будет производиться чаще, чем в остальные, и обращение к таблице замедлится. Пример неравномерной функции — среднесуточная температура по городу и дате: большую часть времени она держится на одном уровне, а аномальные морозы или жара случаются редко.
Хеширование применяется и в других задачах: для хранения паролей, проверки неизменности файла при передаче, проверки подлинности сообщений в сети (HMAC, электронная подпись). Для них выделяют ещё несколько свойств.
- Лавинность. При незначительном изменении входных данных выходное значение должно меняться значительно. При хешировании паролей функция, лишённая лавинности, взламывается проще. Если злоумышленнику известно, что \(h(aa) = 22\), а \(h(bb) = 33\), то он может предположить такой \(password\), что \(h(password) = 44\). Перебрав небольшое число вариантов, он подберёт пароль по его хешу.
- Необратимость. Невозможно восстановить ключ по значению функции. Например, при регистрации на сайте к паролю пользователя применяется хеш-функция, и полученный хеш записывается в базу данных. Каждый раз, когда пароль вводится заново, к нему применяется та же функция, и новый хеш совпадёт с записью в базе, если введён исходный пароль. Даже получив доступ к базе, злоумышленник не должен иметь возможности восстановить пароль по украденным хешам.
Хеш-функция при этом не шифрует сообщения: зашифрованное сообщение расшифровывается обратно, а хеш необратим, и шифрование выполняют отдельные алгоритмы, например AES. Для контрольных сумм и проверки подлинности применяют SHA-256 и более новые функции: для MD5 и SHA-1, встречающихся в старых программах, построены коллизии (для SHA-1 — в 2017 году), и для защиты от подделки они непригодны.
Хранение паролей требует большего, чем однократное применение хеш-функции. Быструю криптографическую функцию злоумышленник, получивший базу, перебирает со скоростью миллиардов паролей в секунду, а одинаковые пароли дают одинаковые хеши. Поэтому к паролю перед хешированием приписывают случайную соль, хранимую рядом с хешем, и применяют намеренно медленную функцию: в стандартной библиотеке Python это hashlib.pbkdf2_hmac и hashlib.scrypt, а Argon2 и bcrypt доступны в пакетах argon2-cffi и bcrypt. Рекомендуемые параметры, например 600 000 итераций PBKDF2-HMAC-SHA256, сведены в OWASP Password Storage Cheat Sheet.
Построение хеш-функций для строк
Хеш-функции для строк вычисляются «полиномиальным хешированием» (от слова «полином», то есть многочлен). Хеш строки \(s\) вычисляется по формуле: $$ h(s)=\left(s_{1} q^{n-1}+s_{2} q^{n-2}+\cdots+s_{n-1} q+s_{n}\right) \bmod R $$ Здесь \(s_i\) обозначает код \(i\)-го символа (например, ASCII-код), \(n\) — длину строки, а \(R\) и \(q\) — выбранные константы.
Все вычисления производятся по модулю большого числа \(R\), поскольку для длинных строк сумма в скобках не помещается в целочисленный тип: в большинстве языков программирования произойдёт переполнение. В языках с «длинной арифметикой» переполнения не случится, однако с ростом чисел вычисления будут замедляться.
Выбор числа \(R\) зависит от типа переменной, отведённой под хеши. Например, для беззнаковых 4-байтовых целых чисел удобно выбрать \(R=2^{32}\), а для 8-байтовых можно взять \(R=2^{64}\).
Выбор величины \(q\) важен и для длинных строк. При \(R = 2^{32}\) чётное \(q\) обнуляет старшие степени, и хеш перестаёт зависеть от начала строки: при \(q = 256\) уже \(q^4 = 2^{32}\) обращается в ноль, остаются лишь четыре последних символа, и все десять тысяч имён файлов от run_0000.dat до run_9999.dat получают один и тот же хеш. Поэтому \(q\) берут нечётным, а ради универсальности — большим простым числом.
Номер корзины получается как остаток от деления хеша на число корзин. Чем меньше общих делителей у \(q\), \(M\) и \(R\), тем реже коллизии. В качестве \(R\) выше было условлено использовать \(2^{32}\), поэтому любое нечётное число взаимно просто с \(R\).
Число \(M\) меняется вслед за размером хеш-таблицы, ещё не известным в момент вычисления хеша, поэтому нельзя гарантировать, что заданное заранее \(q\) и число корзин \(M\) окажутся взаимно простыми. Однако большое простое \(q\) делает нетривиальные общие делители маловероятными, поскольку у простого числа нет делителей, кроме него самого и единицы. \(M\) обычно также выбирают простым, поэтому общие делители появятся, только когда \(M=q\).
Реализация хеш-таблицы на цепочках
Возьмём одиннадцать корзин — число простое и небольшое, чтобы коллизии были заметны, — а хеш будем вычислять суммой номеров букв, как в примере со складом:
ALPHABET = 'абвгдеёжзийклмнопрстуфхцчшщъыьэюя'
def letters_hash(key):
# Хеш — сумма номеров букв, входящих в ключ
return sum(ALPHABET.index(letter) + 1 for letter in key)
class HashMap:
def __init__(self, buckets_count=11):
# В каждой корзине лежит список пар: это и есть метод цепочек
self.buckets = [[] for _ in range(buckets_count)]
def _bucket(self, key):
# Хеш превращается в номер корзины остатком от деления
return self.buckets[letters_hash(key) % len(self.buckets)]
def get(self, key):
# Перебираем цепочку, привязанную к корзине, а не всю таблицу
for stored_key, value in self._bucket(key):
if stored_key == key:
return value
return None
def set(self, key, value):
bucket = self._bucket(key)
for i, (stored_key, _) in enumerate(bucket):
if stored_key == key:
bucket[i] = (key, value)
return
bucket.append((key, value))
У «груши» сумма номеров букв равна 70, и остаток \( 70 \bmod 11 = 4 \), а у «яблока» сумма 92, и остаток \( 92 \bmod 11 = 4 \) — тот же. Это коллизия: два ключа делят одну корзину и хранятся в ней списком:
warehouse = HashMap()
warehouse.set('груша', 120)
warehouse.set('яблоко', 300)
print(letters_hash('груша') % 11) # 4
print(letters_hash('яблоко') % 11) # 4
print(warehouse.buckets[4]) # [('груша', 120), ('яблоко', 300)]
print(warehouse.get('яблоко')) # 300
Собственная хеш-функция потребовалась здесь только ради наглядности. В реальном коде хеш строки вычисляет встроенная hash, и номер корзины получается тем же остатком:
bucket_index = hash('груша') % 11
Результат этого выражения от запуска к запуску различается: для строк Python подмешивает в хеш случайную соль, выбираемую при запуске интерпретатора. Это сделано для защиты от атак, при которых сервер получает ключи, подобранные под одну корзину, и на работу словаря внутри одного процесса не влияет: там хеш, вычисленный дважды, совпадает сам с собой.
Функция hash устроена по-разному для разных типов. Хеш целого числа соли не содержит и равен самому числу, взятому по модулю простого числа \(2^{61} - 1\): hash(42) равно 42, hash(2**61) — единице, а hash(-1) равно −2, поскольку значение −1 в C-интерфейсе интерпретатора обозначает ошибку. Строки и байты хешируются функцией SipHash со случайной солью (PEP 456); начиная с Python 3.11 по умолчанию применяется вариант SipHash-1-3, до этого — SipHash-2-4, что показывает sys.hash_info.algorithm. Переменная окружения PYTHONHASHSEED позволяет зафиксировать соль, например для воспроизведения ошибки. Из-за соли порядок обхода множества строк меняется от запуска к запуску, и алгоритм, выбирающий первый из равных при переборе такого множества, недетерминирован; словарь же начиная с Python 3.7 гарантированно хранит порядок вставки.
Ключом словаря и элементом множества может служить только хешируемый объект, хеш которого не меняется за время его жизни. Изменяемые контейнеры list, dict и set не хешируются: изменение списка, уже лежащего ключом в словаре, изменило бы его хеш, и ключ стал бы ненаходимым, поэтому hash([1, 2]) возбуждает TypeError. Хешируемость при этом не совпадает с неизменяемостью: кортеж хешируется, только если хешируемы все его элементы, а экземпляры собственных классов по умолчанию хешируются по идентичности, хотя их атрибуты можно менять.
Поисковый индекс
Основной принцип хеш-таблиц состоит в том, что элемент следует искать там, куда он был положен. Это правило часто применяют для быстрого поиска по данным, накопленным заранее.
Пусть разрабатывается программа для чтения с поиском по тексту: пользователь вводит слово или строку, а программа показывает их позиции в тексте.
Её можно реализовать хеш-таблицей, в которой ключами будут строки, а значениями — массивы позиций.
Отображение, которое ставит каждому объекту в соответствие его расположение, называют «поисковым индексом».
Хеш-таблица должна находить позиции любой подстроки, а значит, в неё необходимо заранее добавить все подстроки текста. Если подстроки в таблице нет, нет её и в тексте.
Позиция при этом получается сразу, однако такой способ расточителен по памяти. Подстрок в тексте столько, сколько способов выбрать две границы: \(N\cdot(N+1)/2\), где \(N\) — длина текста. Следовательно, в хеш-таблицу требуется добавить \(O(N^2)\) пар (key, value). Поскольку ключами служат сами подстроки, каждая пара займёт в среднем \(O(N)\) памяти, а всего — \(O(N^3)\).
Поэтому для больших текстов реализация, построенная на подстроках, неприменима.
На практике индексируют не все подстроки, а слова, разделённые пробелами. Текст разбивается на слова, и в хеш-таблицу помещаются пары из слова и списка его позиций. Таких пар \(O(N)\), памяти требуется линейное количество, а поиск по целому слову остаётся мгновенным. Так устроены поисковые системы и полнотекстовый поиск в базах данных, только вместо списка позиций там хранятся более сложные структуры.
Резюме
- Хеш-таблица превращает поиск по ключу в вычисление: хеш-функция вычисляет по ключу число, остаток от деления этого числа на количество корзин даёт номер ячейки, а далее работает обычный массив.
- Коллизии неизбежны у любой хеш-функции, и разрешаются они либо методом цепочек, когда в корзине хранится список пар, либо открытой адресацией, когда пара помещается в ближайшую свободную ячейку.
- Ожидаемая \(O(1)\) обеспечивается двумя условиями: хеш-функция распределяет ключи равномерно, а корзин достаточно. Второе обеспечивается перехешированием, стоящим \(O(n)\) на редких перестройках и потому не ухудшающим среднюю стоимость.
- От хеш-функции требуются детерминизм, эффективность, ограниченность и равномерность, а от криптографической — дополнительно лавинность и необратимость.
- Если номер корзины вычисляется остатком от деления, число корзин выбирают простым, чтобы закономерности, скрытые во входных ключах, не приводили раз за разом в одну ячейку; реализации с размером таблицы \(2^k\), например словарь CPython, перемешивают биты хеша.
- Строки хешируются полиномиально по модулю большого числа \(R\); основание \(q\) выбирают нечётным, то есть взаимно простым с \(R = 2^{32}\), а ради универсальности — большим простым.
- Поисковый индекс представляет собой ту же хеш-таблицу, где ключом служит слово, а значением — список его позиций; на нём основан и полнотекстовый поиск в базах данных.
Деревья
В массиве, связном списке, стеке и очереди элементы выстроены друг за другом. Однако файловая система на диске, структура HDF5-файла с результатами измерений, иерархия объёмов детектора в Geant4, дерево вызовов, собранное профилировщиком, устроены как иерархии. Для их описания существует отдельная структура данных — дерево.
Деревья уже встречались в предыдущих главах. В главе про рекурсию дерево вариантов помогало понять генерацию последовательностей из нулей и единиц, а сортировка слиянием изображалась как дерево вызовов, порождённых рекурсией. В настоящей главе деревья рассматриваются как структура данных, у которой есть свой интерфейс и своя цена операций.
Слайды к главе. Определения, двоичное дерево и класс Node, обходы в глубину и в ширину, k-d дерево и октодерево изложены также в третьей части лекции «Хеши, деревья и графы» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Понятие дерева
Деревом называют набор узлов (вершин), соединённых рёбрами, в котором выполнены три условия:
- есть один выделенный узел, корень (англ. root);
- у каждого узла, кроме корня, в точности один родитель (англ. parent);
- от корня до любого узла можно дойти по рёбрам, причём единственным способом, ведущим туда.
В терминах следующей главы дерево представляет собой связный граф без циклов. В программировании, в отличие от ботаники, дерево изображают корнем вверх.
Основная терминология:
- потомками (детьми) узла называют узлы, которым он приходится родителем;
- листом (англ. leaf) называется узел без потомков;
- внутренний узел имеет хотя бы одного потомка;
- поддерево составляют узел вместе со всеми его потомками, потомками потомков и так далее; каждый узел можно считать корнем собственного поддерева, подвешенного под ним;
- глубина узла равна числу рёбер, пройденных на пути от корня до узла (у корня глубина 0);
- уровень объединяет узлы одной глубины;
- высота дерева равна наибольшей глубине, найденной среди всех узлов.
Глубину и высоту иногда измеряют не в рёбрах, а в узлах, и тогда все числа на единицу больше. Оба соглашения встречаются в литературе, поэтому в задачах необходимо уточнять, что именно считается. Ниже, в разборе задачи про максимальную глубину, она считается в узлах, как требует условие.
Главным свойством дерева является рекурсивность. Дерево складывается из корня и поддеревьев, каждое из которых само является деревом. Поэтому почти все алгоритмы для деревьев записываются рекурсивно и сводятся к тому, чтобы обработать корень, а затем рекурсивно обработать его поддеревья. Базовый случай — пустое дерево.
Двоичные деревья и класс Node
Двоичным (бинарным) деревом называют дерево, в котором у каждого узла не больше двух потомков, различаемых как левый и правый. На двоичных деревьях построены деревья поиска и кучи, а любое дерево общего вида сводится к двоичному.
В Python узел дерева описывается классом со ссылками на потомков, как элемент связного списка, только ссылок теперь две:
class Node:
def __init__(self, value, left=None, right=None):
self.value = value # данные, хранящиеся в узле
self.left = left # ссылка на левого потомка (или None)
self.right = right # ссылка на правого потомка (или None)
Соберём дерево из пяти узлов:
5
/ \
3 8
/ \
1 4
root = Node(5, Node(3, Node(1), Node(4)), Node(8))
Всё дерево представлено одной ссылкой на корень, от которого достижим любой узел. Пустое дерево — None. Поэтому функции, работающие с деревьями, принимают корень и первым делом проверяют, не равен ли он None; это и есть базовый случай рекурсии.
Обходы дерева
Обойти дерево значит побывать в каждом узле по одному разу. В отличие от массива, у дерева есть несколько естественных порядков обхода. Они делятся на два семейства: обходы в глубину (DFS, англ. depth-first search), уходящие вниз по ветви, и обход в ширину (BFS, англ. breadth-first search), идущий по уровням.
Обходы в глубину
Обход в глубину сначала уходит по ветви до самого низа и только потом возвращается. Рекурсивная реализация тривиальна, а три классических варианта отличаются лишь моментом обработки самого узла относительно его поддеревьев:
def preorder(root): # корень -> левое -> правое
if root is None:
return
print(root.value) # обрабатываем узел до потомков
preorder(root.left)
preorder(root.right)
def inorder(root): # левое -> корень -> правое
if root is None:
return
inorder(root.left)
print(root.value) # обрабатываем узел между потомками
inorder(root.right)
def postorder(root): # левое -> правое -> корень
if root is None:
return
postorder(root.left)
postorder(root.right)
print(root.value) # обрабатываем узел после потомков
Для дерева, изображённого выше, preorder выведет 5 3 1 4 8, inorder выдаст 1 3 4 5 8, а postorder даст порядок 1 4 3 8 5.
Pre-order подходит для копирования и сериализации сверху вниз: сначала создаётся узел, затем его потомки. Post-order применяется для удаления и для вычислений снизу вверх, когда результат в узле зависит от значений, вычисленных в поддеревьях; так находят высоту, размер поддеревьев, значение арифметического выражения, разобранного в дерево. In-order выдаёт элементы дерева поиска в отсортированном порядке.
Обход в ширину
Обход в ширину идёт по уровням: сначала корень, затем все узлы глубины 1, затем глубины 2 и так далее. Естественной реализацией служит очередь из главы о базовых структурах; рекурсивная запись тоже возможна — обходом в глубину, раскладывающим узлы по спискам уровней, — но очередь проще:
from collections import deque
def level_order(root):
if root is None:
return
queue = deque([root])
while queue:
node = queue.popleft() # берём узел из начала очереди
print(node.value)
if node.left: # и ставим его потомков в конец
queue.append(node.left)
if node.right:
queue.append(node.right)
Для того же дерева получится 5 3 8 1 4, по уровням. Любой обход посещает каждый узел по одному разу (обход в глубину вдобавок проходит по каждому ребру дважды, вниз и обратно), поэтому все они работают за \( O(n) \), где \( n \) — число узлов. Дополнительной памяти требуется \( O(h) \) на стек рекурсии у DFS (где \( h \) — высота дерева) и до \( O(n) \) на очередь у BFS, вмещающую самый широкий уровень.
Слайды к главе. Поиск, вставка и удаление в дереве поиска, высота и сбалансированность, число деревьев поиска изложены также в четвёртой части лекции «Хеши, деревья и графы»; слайды лекции доступны на сайте книги и в PDF.
Двоичное дерево поиска
Двоичным деревом поиска (англ. binary search tree, BST) называют двоичное дерево, в каждом узле которого выполняется свойство порядка: все значения в левом поддереве строго меньше значения узла, а все значения в правом строго больше.
Свойство порядка превращает поиск в аналог двоичного поиска по отсортированному массиву. Искомый ключ сравнивается с корнем: если он меньше — переход налево, если больше — направо; на каждом шаге происходит спуск на уровень ниже с отбрасыванием целого поддерева, заведомо не содержащего ключа:
def find(root, key):
while root is not None and root.value != key:
root = root.left if key < root.value else root.right
return root # узел с ключом key или None, если ключа нет
При вставке спуск выполняется так же, как при поиске, а новый узел подвешивается там, где спуск достиг None:
def insert(root, key):
if root is None:
return Node(key) # нашли свободное место
if key < root.value:
root.left = insert(root.left, key)
elif key > root.value:
root.right = insert(root.right, key)
return root # корень поддерева; равный ключ не вставляется
Поиск, вставка и удаление стоят \( O(h) \), поскольку проходят один путь от корня вниз. In-order-обход дерева поиска выдаёт ключи по возрастанию: сначала всё меньшее (левое поддерево), затем узел, затем всё большее. Получается структура, обеспечивающая одновременно быстрый поиск, вставку, удаление и перебор по порядку. Ни отсортированный массив с его медленной вставкой, ни хеш-таблица, лишённая порядка, этого не обеспечивают.
Сбалансированность
Эффективность BST определяется высотой \( h \), задающей цену любой операции. Если вставлять ключи в случайном порядке, высота растёт как \( O(\log n) \), хотя и с множителем больше единицы. Средняя глубина узла близка к \( 2 \ln n \approx 1{,}39 \log_2 n \), а высота, согласно работам Л. Девруа и Б. Рида, растёт как \( 4{,}311 \ln n - 1{,}953 \ln \ln n \), то есть асимптотически примерно как \( 3 \log_2 n \); при \( n = 10^5 \) высота случайного дерева составляет около \( 2{,}4 \log_2 n \). Но если вставить ключи 1, 2, 3, ..., n по порядку, каждый новый узел уйдёт направо, и дерево выродится в цепочку высоты \( n - 1 \). Все операции станут линейными, а рекурсивная вставка из листинга выше на таком входе исчерпает предел глубины рекурсии Python уже на тысяче ключей; для вырожденных деревьев вставку записывают циклом.
Дерево называется сбалансированным, если его высота составляет \( h = O(\log n) \), а значит, все операции работают за \( O(\log n) \). Строгий вариант — условие АВЛ-дерева: у каждого узла высоты левого и правого поддеревьев отличаются не больше чем на единицу, что даёт \( h < 1{,}44 \log_2(n + 2) \); красно-чёрное дерево поддерживает более слабое условие и гарантирует \( h \le 2 \log_2(n + 1) \).
Сохранять сбалансированность при любых вставках и удалениях позволяют самобалансирующиеся деревья (АВЛ-дерево, красно-чёрное дерево), выполняющие после каждой операции небольшие локальные перестройки, называемые поворотами. На красно-чёрных деревьях построены TreeMap в Java и std::map в распространённых реализациях C++, упомянутые в главе про хеш-таблицы; к сбалансированным относятся и B-деревья индексов баз данных, рассмотренные в главе «Базы данных». В стандартной библиотеке Python дерева поиска нет, поскольку обычно достаточно dict, set и модуля bisect для отсортированного списка.
Слайды к главе. Куча в массиве, приоритетная очередь и модуль heapq, пирамидальная сортировка изложены также в пятой части лекции «Хеши, деревья и графы»; слайды лекции доступны на сайте книги и в PDF.
Куча
Куча (англ. heap) представляет собой структуру данных для задач, в которых требуется быстро находить максимум (или минимум) в наборе элементов, меняющемся в процессе работы. В невозрастающей куче (max-heap) выполняется основное свойство кучи: значение любого узла не меньше значений его потомков. Следовательно, в корне всегда находится максимум. В min-heap наоборот, в корне минимум.
В отличие от дерева поиска, куча не упорядочивает элементы полностью: между левым и правым поддеревьями никакого порядка нет. Взамен куча всегда остаётся почти полным двоичным деревом. Все уровни, кроме последнего, заполнены целиком, а последний заполняется слева направо по мере роста. Такое дерево не бывает вырожденным, и его высота всегда \( O(\log n) \).
Куча в массиве
Почти полное дерево хранится без ссылок, в обычном массиве, с узлами, выписанными по уровням:
Куча: Массив:
9 [9, 7, 8, 3, 1, 4]
/ \ 0 1 2 3 4 5
7 8
/ \ /
3 1 4
У узла с индексом \( i \) потомки лежат в ячейках \( 2i + 1 \) и \( 2i + 2 \), а родитель в ячейке \( \lfloor (i-1)/2 \rfloor \). Классы и указатели не требуются: любой массив чисел уже представляет собой дерево, разложенное по уровням.
Куча основана на двух операциях, называемых просеиванием:
- просеивание вверх (sift up): элемент, дописанный в конец массива, меняется местами с родителем, пока он больше родителя;
- просеивание вниз (sift down): корень, ставший меньше потомков, меняется местами с бóльшим из них и опускается, пока свойство кучи не восстановится.
Оба просеивания проходят не больше одного пути от корня до листа, то есть стоят \( O(\log n) \). На них строится приоритетная очередь: добавление элемента за \( O(\log n) \), просмотр максимума за \( O(1) \), извлечение максимума (последний элемент переставляется в корень и просеивается вниз) за \( O(\log n) \).
В Python куча реализована модулем heapq как min-heap над обычным списком, передаваемым в функции модуля; начиная с Python 3.14 модуль содержит и функции для max-heap (heappush_max, heappop_max и другие):
import heapq
distances = [5.2, 1.1, 3.7, 0.4]
heapq.heapify(distances) # превращает список в кучу за O(n)
heapq.heappush(distances, 2.6) # добавление за O(log n)
print(heapq.heappop(distances)) # 0.4 — минимум, за O(log n)
Функция heapify строит кучу за \( O(n) \), а не за \( O(n \log n) \): внутренние узлы просеиваются вниз начиная с последнего, и большинство из них, лежащих у самого дна, опускается лишь на один-два уровня. Функции heapq.nlargest и heapq.nsmallest отбирают \( k \) наибольших или наименьших элементов из \( n \), поддерживая кучу из \( k \) элементов, за \( O(n \log k) \) времени и \( O(k) \) памяти: так из миллиона событий выбирают десять самых энергичных без сортировки всего набора.
Если требуется max-heap, в версиях Python до 3.13 включительно в куче хранят элементы с обратным знаком. Этот приём применяется в следующей главе, в алгоритме, строящем остовное дерево.
Пирамидальная сортировка
Куча даёт ещё один способ сортировать за \( O(n \log n) \), пирамидальную сортировку (англ. heap sort). Она состоит из двух этапов:
- Превратить массив в max-heap, просеяв вниз все внутренние узлы, начиная с последнего и заканчивая корнем.
- Повторять \( n - 1 \) раз: обменять корень (текущий максимум) с последним элементом ещё не отсортированной части и просеять новый корень вниз. Снятые максимумы один за другим встают в конец массива на окончательные места.
Дополнительной памяти heap sort, в отличие от сортировки слиянием, не требует: всё происходит в исходном массиве. Неудачных входов у него, в отличие от быстрой сортировки, не бывает: любой массив обрабатывается за \( O(n \log n) \). Платой являются неустойчивость и большая константа: просеивание обращается к далеко отстоящим ячейкам массива, кеш процессора работает хуже, и на практике heap sort обычно заметно медленнее quick sort. Полная реализация рассматривается ниже в задачах.
Деревья в физических задачах
Ниже приведены три типичных сюжета из вычислительной физики.
Поиск соседей и k-d деревья. В молекулярной динамике, методе SPH или при кластеризации точек, измеренных в эксперименте, постоянно требуется выяснять, какие частицы находятся рядом с выбранной. Перебор всех пар стоит \( O(N^2) \). k-d дерево (k-dimensional tree) рекурсивно делит пространство плоскостями пополам, и запрос ближайших соседей точки выполняется в среднем за \( O(\log N) \), если размерность пространства мала, как у координат частиц; при десятках измерений k-d дерево почти не выигрывает у перебора. В SciPy оно уже реализовано:
import numpy as np
from scipy.spatial import KDTree
points = np.random.default_rng(0).random((100_000, 3)) # частицы в кубе
tree = KDTree(points) # построение за O(N log N)
dist, idx = tree.query(points[0], k=10) # 10 ближайших соседей
neighbors = tree.query_ball_point(points[0], r=0.05) # все соседи в радиусе
Гравитационная задача N тел и октодеревья. Прямое суммирование сил между \( N \) телами требует \( O(N^2) \) операций на шаг, что для галактики из миллиардов звёзд неприемлемо. Алгоритм Барнса — Хата строит октодерево (англ. octree): куб пространства, вмещающий всю систему, рекурсивно делится на 8 октантов, пока в каждом листе не останется по частице. Для далёкой группы частиц незачем суммировать вклады по одной, достаточно слагаемого от её суммарной массы, приложенной в центре масс и записанной в узле дерева. Критерий: если угловой размер ячейки \( s/d \) меньше порога \( \theta \), ячейка не раскрывается. Сложность снижается до \( O(N \log N) \), и такие деревья вместе с более сложным быстрым мультипольным методом работают внутри современных астрофизических кодов наподобие GADGET.
Иерархические данные. Формат HDF5, стандарт де-факто для больших численных данных, устроен как дерево: группы содержат подгруппы и датасеты, как каталоги и файлы (строго говоря, как корневой ориентированный граф: жёсткие ссылки позволяют включить один объект в несколько групп). Деревом являются и геометрия детектора в Geant4 из объёмов, вложенных в объёмы, и символьное выражение в SymPy, где узлами служат операции, а листьями — переменные и константы. Иерархия почти наверняка означает, что в основе лежат дерево и рекурсивные обходы.
Разбор задач
Во всех задачах, где на вход подаётся корень, используется класс Node, описанный выше. Каждую задачу рекомендуется сначала решить самостоятельно; все они собраны в тренажёре.
Задача 1. Максимальная глубина
Условие. Дан корень двоичного дерева. Требуется найти его максимальную глубину, то есть наибольшее число узлов, лежащих на пути от корня до листа (включая корень и лист).
Идея решения. Глубина дерева равна глубине более глубокого из поддеревьев плюс единица за сам корень. Базовый случай — пустое дерево глубины 0.
def max_depth(root):
# Базовый случай: пустое дерево не добавляет к глубине ничего
if root is None:
return 0
# Более глубокое из поддеревьев плюс сам корень
return 1 + max(max_depth(root.left), max_depth(root.right))
Сложность. По времени \( O(n) \), так как каждый узел посещается один раз. По памяти \( O(h) \) на стек рекурсии, где \( h \) — высота дерева.
Задача 2. Сбалансированное дерево
Условие. Требуется определить, сбалансировано ли двоичное дерево, то есть отличаются ли у каждого узла высоты поддеревьев, расположенных слева и справа, не больше чем на единицу.
Идея решения. Прямолинейное решение: в каждом узле сравнивать высоты поддеревьев, вычисленные функцией из предыдущей задачи. Но тогда высота каждого узла будет вычисляться заново на каждом уровне выше него, и в худшем случае получится \( O(n^2) \).
Лучше совместить оба вычисления в одном обходе. Пусть функция возвращает высоту поддерева, а для несбалансированного поддерева значение-сигнал -1, немедленно передаваемое наверх без дальнейших проверок.
def check_height(root):
"""Высота поддерева или -1, если оно несбалансировано."""
if root is None:
return 0
left = check_height(root.left)
if left == -1: # слева уже нашли дисбаланс
return -1
right = check_height(root.right)
if right == -1: # справа уже нашли дисбаланс
return -1
if abs(left - right) > 1: # дисбаланс в текущем узле
return -1
return 1 + max(left, right)
def is_balanced(root):
return check_height(root) != -1
Сложность. По времени \( O(n) \): один post-order-обход, высота каждого узла вычисляется однократно. По памяти \( O(h) \) на стек рекурсии.
Задача 3. Дерево поиска
Условие. Требуется проверить, является ли двоичное дерево деревом поиска: значения, лежащие в левом поддереве каждого узла, строго меньше значения узла, а в правом строго больше.
Идея решения. Частая ошибка — проверять только соседние узлы: left.value < node.value < right.value. Этого недостаточно:
Дерево поиска: Не дерево поиска:
5 5
/ \ / \
3 8 3 8
/ \ / \
1 4 1 6
В правом дереве узел 6 больше своего родителя 3, и локально условие выполнено. Однако 6 находится в левом поддереве корня 5, а значит, обязан быть меньше 5. Условие является глобальным: каждый узел ограничен всеми своими предками.
Будем спускаться по дереву и передавать вниз интервал разрешённых узлу значений \( (\text{low}, \text{high}) \). При переходе налево ужесточается верхняя граница значением узла, при переходе направо — нижняя.
def is_bst(root, low=float('-inf'), high=float('inf')):
if root is None:
return True
# Значение узла обязано лежать строго внутри интервала предков
if not (low < root.value < high):
return False
return (is_bst(root.left, low, root.value) # слева всё < root.value
and is_bst(root.right, root.value, high)) # справа всё > root.value
Альтернатива: выполнить in-order-обход и проверить, что выданные им значения идут строго по возрастанию. Для дерева поиска это является критерием.
Сложность. По времени \( O(n) \), по памяти \( O(h) \) на стек рекурсии.
Задача 4. Сколько существует деревьев поиска
Условие. Требуется определить, сколько различных двоичных деревьев поиска можно построить из всех чисел от 1 до \( n \). Число \( n \) не превосходит 20.
Идея решения. Выберем корнем число \( k \). Тогда числа \( 1, \dots, k-1 \) обязаны попасть в левое поддерево, а \( k+1, \dots, n \) в правое, причём каждое из поддеревьев само является деревом поиска. Число деревьев из \( m \) последовательных чисел зависит только от \( m \), поэтому получаем рекуррентность
\[ C_n = \sum_{k=1}^{n} C_{k-1} C_{n-k}, \qquad C_0 = 1. \]
Это числа Каталана, которые также считают правильные скобочные последовательности и блуждания из \( 2n \) шагов \( \pm 1 \), которые не опускаются ниже нуля и заканчиваются в нуле (пути Дика); без условия возврата в ноль получилось бы другое число, \( \binom{2n}{n} \). Для них известна замкнутая формула
\[ C_n = \frac{1}{n+1} \binom{2n}{n} = \frac{(2n)!}{n! (n+1)!}. \]
from math import comb
def count_bst(n):
# Число Каталана: C(2n, n) / (n + 1), деление всегда нацело
return comb(2 * n, n) // (n + 1)
Если формула неизвестна, ответ вычисляется по рекуррентности динамическим программированием:
def count_bst_dp(n):
counts = [1] + [0] * n # counts[0] = 1: пустое дерево одно
for size in range(1, n + 1):
for root in range(1, size + 1):
# root - 1 чисел уходит налево, size - root — направо
counts[size] += counts[root - 1] * counts[size - root]
return counts[n]
Вычисления необходимо вести в целых числах. Наивное fac(2*n) / (fac(n) * fac(n+1)) возвращает float с 53 битами мантиссы, хотя частное двух целых Python вычисляет точно и округляет один раз. Пока \( C_n < 2^{53} \), то есть до \( n = 30 \), округление даёт точное значение, а \( C_{31} > 2^{53} \) в float уже не представимо, и наивная формула занижает его на единицу. Если же перевести факториалы во float до деления, как в языках без длинной арифметики, ошибки округления вносят перевод \( 40! \approx 8{,}16 \cdot 10^{47} \), умножение и деление, и ответ неверен уже при \( n = 20 \), внутри условия задачи: получается 6564120419.999999, и int даёт 6564120419 вместо 6564120420. Целочисленный вариант ничем не сложнее.
Сложность. Формула с биномиальным коэффициентом требует \( O(n) \) умножений; вариант с динамическим программированием обходится в \( O(n^2) \) операций и \( O(n) \) памяти.
Задача 5. Удаление узла из дерева поиска
Условие. Дано дерево поиска с уникальными целыми ключами. Требуется удалить узел с заданным ключом так, чтобы дерево осталось корректным деревом поиска, и вернуть корень изменённого дерева. Если ключа нет, дерево возвращается нетронутым. Создавать новые узлы нельзя, сложность должна быть \( O(h) \).
Идея решения. Спускаемся к удаляемому узлу, как при обычном поиске. Далее возможны три случая:
- Если у узла нет потомков, он убирается, и родитель начинает ссылаться на
None. - При одном потомке он подвешивается на место удаляемого узла.
- При двух потомках находится преемник, минимальный узел правого поддерева (переход направо, затем налево, пока есть левый потомок). Преемник больше всего левого поддерева и меньше остального правого, поэтому может встать на освободившееся место. Он вырезается со старого места, где у него нет левого потомка и работает случай 1 или 2, и переставляется наверх.
def remove(root, key):
if root is None: # ключа в дереве нет
return None
if key < root.value: # ищем слева
root.left = remove(root.left, key)
elif key > root.value: # ищем справа
root.right = remove(root.right, key)
else: # нашли узел с ключом key
if root.left is None: # случаи 1 и 2: нет левого потомка
return root.right
if root.right is None: # случай 2: нет правого потомка
return root.left
# Случай 3: ищем преемника — минимум правого поддерева
parent, succ = root, root.right
while succ.left is not None:
parent, succ = succ, succ.left
# Вырезаем преемника со старого места...
if parent.left is succ:
parent.left = succ.right
else:
parent.right = succ.right
# ...и ставим его на место удаляемого узла
succ.left = root.left
succ.right = root.right
return succ
return root
Сложность. По времени \( O(h) \), поскольку спуск к узлу и спуск к преемнику вместе образуют один путь от корня вниз. По памяти \( O(h) \) на рекурсию поиска (её несложно переписать циклом до \( O(1) \)).
Задача 6. Пирамидальная сортировка
Условие. По результатам соревнования дан список участников: логин, число решённых задач \( P \) и штраф \( F \). Требуется отсортировать таблицу: выше стоит участник, у которого больше решённых задач; при равенстве тот, у кого меньше штраф; если и штрафы равны, тот, чей логин идёт раньше по алфавиту. Кучу необходимо реализовать самостоятельно, встроенными сортировками и heapq пользоваться нельзя.
Ввод: Вывод:
5 gena
alla 4 100 timofey
gena 6 1000 alla
gosha 2 90 gosha
rita 2 90 rita
timofey 4 80
Идея решения. Это сортировка по составному ключу (см. раздел о сортировке по ключу в главе о сортировках). Подберём ключ так, чтобы обычное сравнение кортежей «меньше» означало «выше в таблице»: число решённых задач берётся с минусом (чем больше задач, тем меньше ключ), а штраф и логин остаются как есть:
def sort_key(user):
login, solved, penalty = user
return (-solved, penalty, login)
Остаётся отсортировать массив по этому ключу пирамидальной сортировкой. Строим max-heap в исходном массиве, затем раз за разом переставляем максимум, то есть худшего из оставшихся участников, в конец неотсортированной части:
def sift_down(items, start, end):
"""Просеивает элемент start вниз внутри items[start:end + 1]."""
root = start
while True:
child = 2 * root + 1 # левый потомок
if child > end: # потомков нет — дно кучи
break
# Из двух потомков выбираем большего
if child + 1 <= end and sort_key(items[child]) < sort_key(items[child + 1]):
child += 1
if sort_key(items[root]) < sort_key(items[child]):
items[root], items[child] = items[child], items[root]
root = child # спускаемся за элементом дальше
else:
break # свойство кучи восстановлено
def heap_sort(items):
n = len(items)
# Этап 1: строим кучу — просеиваем все внутренние узлы справа налево
for start in range((n - 2) // 2, -1, -1):
sift_down(items, start, n - 1)
# Этап 2: снимаем максимум с вершины кучи в конец массива
for end in range(n - 1, 0, -1):
items[0], items[end] = items[end], items[0]
sift_down(items, 0, end - 1)
def main():
n = int(input())
users = []
for _ in range(n):
login, solved, penalty = input().split()
users.append((login, int(solved), int(penalty)))
heap_sort(users)
print('\n'.join(user[0] for user in users))
if __name__ == '__main__':
main()
После этапа 1 худший по ключу участник стоит в корне кучи, в ячейке 0. Обмен с последним элементом ставит его на окончательное место, а однократное просеивание вниз восстанавливает кучу в укоротившейся части массива. В итоге массив отсортирован по возрастанию ключа, и лучшие участники стоят в начале.
Сложность. Построение кучи занимает \( O(n) \), поскольку низкие узлы просеиваются на малую глубину, а затем выполняются \( n - 1 \) просеиваний по \( O(\log n) \). Итого \( O(n \log n) \) по времени в худшем случае и \( O(1) \) дополнительной памяти: сортировка выполняется на месте. В рабочем коде достаточно sorted(users, key=sort_key).
Резюме
- Дерево является рекурсивной структурой из корня и поддеревьев, каждое из которых само дерево. Базовый случай алгоритмов для него — пустое дерево
None. - Обходы в глубину (pre-, in-, post-order) записываются рекурсией, обход в ширину — очередью, в которой лежат узлы текущего и следующего уровней; все стоят \( O(n) \).
- Дерево поиска обеспечивает поиск, вставку и удаление за \( O(h) \); чтобы высота \( h \) была \( O(\log n) \), дерево должно быть сбалансированным.
- Куча укладывается в массив как почти полное дерево, отдаёт максимум за \( O(1) \), вставку и извлечение за \( O(\log n) \); на ней построены приоритетная очередь и heap sort.
- В физических расчётах деревья ускоряют поиск соседей (k-d деревья), задачу N тел (октодеревья Барнса — Хата) и хранят иерархические данные в HDF5.
В следующей главе допускаются циклы и произвольные связи. В результате получается самая общая структура данных — граф.
Графы
Дерево — структура удобная, но частная: у каждого узла в точности один родитель, а между любыми двумя узлами проложен единственный путь. Реальные связи устроены так не всегда.
Города соединены дорогами, причём из каждого можно выехать несколькими маршрутами. Атомы в молекуле связаны в кольца, а узлы электрической цепи соединяются проводниками, образующими контуры. Компьютеры в сети связаны друг с другом множеством путей. Всё это описывается самой общей структурой — графом.
К графам сводится множество практических задач, на первый взгляд не имеющих к ним отношения.
Слайды к главе. Определения, способы хранения графа, обходы в глубину и в ширину, компоненты связности и перколяция изложены также в шестой части лекции «Хеши, деревья и графы» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Определения
Граф \( G = (V, E) \) складывается из множества вершин \( V \) (англ. vertices) и множества рёбер \( E \) (англ. edges), каждое из которых соединяет пару вершин.
Основные разновидности:
- Неориентированный граф имеет рёбра, не снабжённые направлением: если из \( u \) можно попасть в \( v \), то и обратно тоже (дороги с двусторонним движением).
- Ориентированный граф (орграф, англ. directed graph) снабжает рёбра направлением, и ребро \( (u, v) \), проведённое в одну сторону, не означает существования ребра \( (v, u) \) (односторонние улицы, ссылки между веб-страницами, зависимости, связывающие задачи).
- Взвешенный граф приписывает каждому ребру число: длину дороги, сопротивление проводника, пропускную способность канала, энергию связи.
Терминология:
- смежными называются вершины, соединённые ребром;
- степень вершины равна числу рёбер, инцидентных ей (в орграфе различают входящую и исходящую степени);
- путь есть последовательность вершин, в которой соседние соединены рёбрами;
- цикл представляет собой путь, начинающийся и заканчивающийся в одной вершине;
- связный граф позволяет добраться из любой вершины до любой другой;
- компонента связности составляет максимальную связную часть графа;
- петля соединяет вершину с самой собой, а кратными рёбрами называются несколько рёбер, проведённых между одной парой вершин.
Дерево есть связный неориентированный граф, не содержащий циклов, у которого рёбер на одно меньше, чем вершин. Граф без циклов, но не обязательно связный, называется лесом.
Способы хранения графа
От способа хранения зависят объём памяти и сложность операций; основных вариантов два.
Матрица смежности
Квадратная таблица \( n \times n \), где на пересечении \( i \)-й строки и \( j \)-го столбца стоит единица (или вес ребра), если ребро, ведущее из \( i \) в \( j \), существует, и ноль в противном случае. У неориентированного графа матрица симметрична.
n = 5
matrix = [[0] * n for _ in range(n)] # граф без рёбер
def add_edge_matrix(matrix, u, v, directed=False):
"""Добавляет ребро в матрицу смежности (вершины нумеруются с нуля)."""
matrix[u][v] = 1
if not directed:
matrix[v][u] = 1
Проверка наличия ребра между \( u \) и \( v \) выполняется за \( O(1) \). Однако памяти требуется \( O(n^2) \) независимо от числа рёбер, а перебор всех соседей вершины требует \( O(n) \), поскольку приходится просмотреть всю строку, даже если сосед всего один.
Список смежности
Для каждой вершины хранится список соседей, связанных с ней ребром.
from collections import defaultdict
graph = defaultdict(list)
def add_edge_list(graph, u, v, directed=False):
"""Добавляет ребро в список смежности."""
graph[u].append(v)
if not directed:
graph[v].append(u)
Памяти требуется \( O(n + m) \), где \( m \) — число рёбер, а перебор соседей занимает время, пропорциональное их количеству. Платой является проверка конкретного ребра за \( O(\deg u) \) вместо \( O(1) \).
Выбор между ними. Для плотного графа, где число рёбер сравнимо с \( n^2 \), применяется матрица, для разреженного, где рёбер порядка \( n \), — список. Реальные графы почти всегда разреженные: у человека в социальной сети сотни друзей, а не миллионы, у атома в молекуле единицы связей. По умолчанию выбирается список смежности.
| Операция | Матрица смежности | Список смежности |
|---|---|---|
| Память | \( O(n^2) \) | \( O(n + m) \) |
| Проверить ребро \( (u,v) \) | \( O(1) \) | \( O(\deg u) \) |
| Перебрать соседей \( u \) | \( O(n) \) | \( O(\deg u) \) |
| Добавить ребро | \( O(1) \) | \( O(1) \) |
Третий способ, список рёбер, представляет собой перечень пар вершин. Для обходов он неудобен, зато подходит алгоритмам, перебирающим рёбра целиком, наподобие алгоритма Краскала, и в таком виде граф обычно поступает на вход.
Обходы графа
Обходом называется систематическое посещение всех вершин, достижимых из стартовой. У графа, в отличие от дерева, есть циклы, поэтому появляется обязательный элемент, множество посещённых вершин. Без него обход зациклится.
Поиск в глубину (DFS)
Из текущей вершины обход уходит как можно дальше вглубь, а когда идти больше некуда, возвращается и пробует другое направление. Это тот же обход в глубину, что и на деревьях, только с проверкой на повторное посещение.
def dfs_recursive(graph, vertex, visited=None):
"""Рекурсивный обход в глубину. Возвращает вершины в порядке обхода."""
if visited is None:
visited = set()
visited.add(vertex)
order = [vertex]
for neighbour in sorted(graph[vertex]):
if neighbour not in visited:
order.extend(dfs_recursive(graph, neighbour, visited))
return order
Рекурсивная запись удобна для чтения, но опасна на практике. Глубина рекурсии в Python по умолчанию ограничена примерно 1000, и если путь обхода длиннее тысячи вершин, например на цепочке из ста тысяч вершин, программа завершится с RecursionError. Поэтому DFS реализуют итеративно, заменяя стек вызовов явным стеком:
def dfs_iterative(graph, start):
"""Итеративный обход в глубину через явный стек."""
visited = set()
order = []
stack = [start]
while stack:
vertex = stack.pop()
if vertex in visited:
continue
visited.add(vertex)
order.append(vertex)
# соседей кладём в обратном порядке, чтобы снимать по возрастанию
for neighbour in sorted(graph[vertex], reverse=True):
if neighbour not in visited:
stack.append(neighbour)
return order
Проверка if vertex in visited стоит после снятия со стека, а не только перед добавлением. Одна и та же вершина попадает в стек по нескольку раз от разных соседей, поэтому отсеивать её необходимо в момент обработки.
Поиск в ширину (BFS)
Сначала посещаются все соседи стартовой вершины, затем соседи соседей и так далее, по расходящимся кругам. От DFS отличие в двух местах: вместо стека используется очередь, а вершина помечается посещённой в момент постановки в очередь.
from collections import deque
def bfs(graph, start):
"""Обход в ширину. Возвращает вершины в порядке обхода."""
visited = {start}
order = []
queue = deque([start])
while queue:
vertex = queue.popleft() # берём из начала очереди
order.append(vertex)
for neighbour in sorted(graph[vertex]):
if neighbour not in visited:
visited.add(neighbour) # помечаем сразу при добавлении
queue.append(neighbour)
return order
В BFS вершина помечается посещённой в момент добавления в очередь, иначе она успеет попасть туда несколько раз.
Оба обхода работают за \( O(n + m) \): каждая вершина обрабатывается один раз, а каждое ребро просматривается один раз в ориентированном графе и дважды в неориентированном. Вызов sorted внутри приведённого обхода добавляет \( O(m \log n) \) и присутствует там ради воспроизводимого вывода. В рабочем коде списки смежности сортируют один раз заранее, как в задачах в конце главы. Выбор между двумя обходами определяется задачей:
- BFS посещает вершины в порядке возрастания расстояния, отсчитанного от старта, поэтому он находит кратчайшие пути в невзвешенном графе;
- DFS естественно записывается через рекурсию и применяется для поиска циклов, топологической сортировки, компонент связности и анализа структуры графа.
Слайды к главе. Кратчайшие пути, топологическая сортировка и минимальное остовное дерево изложены также в седьмой части лекции «Хеши, деревья и графы»; слайды лекции доступны на сайте книги и в PDF.
Кратчайшие пути
В невзвешенном графе кратчайший путь находит BFS, попутно запоминая расстояние и предка каждой вершины.
def bfs_shortest_paths(graph, start):
"""Расстояния (в рёбрах) и предки на кратчайших путях от start."""
dist = {start: 0}
parent = {start: None}
queue = deque([start])
while queue:
vertex = queue.popleft()
for neighbour in graph[vertex]:
if neighbour not in dist:
dist[neighbour] = dist[vertex] + 1
parent[neighbour] = vertex
queue.append(neighbour)
return dist, parent
Путь восстанавливается проходом от конечной вершины по ссылкам parent до старта и разворотом полученного списка.
Если рёбра взвешенные, BFS уже не подходит, так как путь, составленный из трёх коротких рёбер, может оказаться короче одного длинного. Здесь применяется алгоритм Дейкстры, являющийся жадным: поддерживаются текущие оценки расстояний, и на каждом шаге берётся ещё не обработанная вершина с наименьшей оценкой, уже не подлежащей улучшению, после чего предпринимается попытка улучшить оценки её соседей; эта операция называется релаксацией.
import heapq
def dijkstra(graph, start):
"""Кратчайшие расстояния во взвешенном графе с неотрицательными весами.
graph — список смежности вида {вершина: [(сосед, вес), ...]}.
"""
dist = {start: 0}
heap = [(0, start)] # приоритетная очередь (расстояние, вершина)
while heap:
d, vertex = heapq.heappop(heap)
if d > dist.get(vertex, float("inf")):
continue # устаревшая запись, вершина уже обработана
for neighbour, weight in graph[vertex]:
new_dist = d + weight
if new_dist < dist.get(neighbour, float("inf")):
dist[neighbour] = new_dist
heapq.heappush(heap, (new_dist, neighbour))
return dist
Куча, рассмотренная в главе про деревья, обеспечивает сложность \( O(m \log n) \). Приведённая реализация не уменьшает ключ записи, уже лежащей в куче, а кладёт в кучу новую запись; устаревшая запись, расстояние в которой больше текущей оценки, при извлечении пропускается. Веса обязаны быть неотрицательными: иначе вершина, уже снятая с кучи, может получить лучшую оценку, и оценка сложности перестаёт выполняться; для графов с отрицательными рёбрами применяют алгоритм Беллмана — Форда, который требует \( O(nm) \) и обнаруживает циклы отрицательного веса.
Топологическая сортировка
Пусть ориентированный граф описывает зависимости: ребро \( u \to v \) означает «\( u \) должно быть выполнено раньше \( v \)». Компиляция модулей, порядок расчётных этапов в пайплайне, установка пакетов ставят одну и ту же задачу — выстроить вершины в линию так, чтобы все рёбра шли слева направо. Это и есть топологическая сортировка, возможная тогда и только тогда, когда в графе нет циклов, иначе зависимости противоречивы.
Простейший способ — DFS: вершина добавляется в результат после всех потомков, а список в конце разворачивается. Чтобы обнаружить цикл, вершины различают тремя цветами: не посещённая, находящаяся в обработке и обработанная. Вершина, встреченная повторно, пока она ещё в обработке, лежит на текущем пути обхода, и ребро в неё замыкает цикл.
def topological_sort(graph, vertices):
"""Топологическая сортировка; при цикле возбуждает ValueError."""
WHITE, GRAY, BLACK = 0, 1, 2 # не посещена, в обработке, обработана
color = {vertex: WHITE for vertex in vertices}
order = []
def visit(vertex):
color[vertex] = GRAY
for neighbour in graph[vertex]:
if color[neighbour] == GRAY: # вершина на текущем пути
raise ValueError(f"цикл через вершину {neighbour}")
if color[neighbour] == WHITE:
visit(neighbour)
color[vertex] = BLACK
order.append(vertex) # добавляем на выходе из вершины
for vertex in vertices:
if color[vertex] == WHITE:
visit(vertex)
return order[::-1] # разворачиваем
На графе \( a \to b \to c \to a \) функция возбуждает ValueError: цикл через вершину a; без проверки цвета она вернула бы порядок ['a', 'b', 'c'], нарушающий ребро \( c \to a \), без какой-либо ошибки. Рекурсивная функция visit к тому же исчерпает предел рекурсии на цепочке длиннее тысячи вершин. Без рекурсии обходится алгоритм Кана: он подсчитывает для каждой вершины число входящих рёбер, ставит в очередь вершины без входящих рёбер и, снимая вершину, уменьшает счётчики её соседей; если в итоге упорядочены не все вершины, в графе есть цикл. Оба способа требуют \( O(n + m) \).
В стандартной библиотеке начиная с Python 3.9 есть класс graphlib.TopologicalSorter, который при цикле возбуждает исключение graphlib.CycleError. Он принимает словарь, сопоставляющий вершине её предшественников, то есть рёбра в нём записаны в обратную сторону по сравнению со списками смежности; переданные без разворота списки смежности дали бы обратный порядок без какой-либо ошибки.
from graphlib import TopologicalSorter, CycleError
deps = {"b": ["a"], "c": ["b"]} # вершина -> её предшественники
print(list(TopologicalSorter(deps).static_order())) # ['a', 'b', 'c']
deps["a"] = ["c"] # a зависит от c: цикл
try:
list(TopologicalSorter(deps).static_order())
except CycleError as err:
print("цикл:", err.args[1]) # цикл: ['b', 'c', 'a', 'b']
Минимальное остовное дерево
Остовным деревом (англ. spanning tree) связного графа называется подмножество рёбер, связывающее все вершины и не содержащее циклов, то есть дерево, натянутое на все \( n \) вершин и собранное из \( n-1 \) ребра. Минимальным остовным деревом (MST) называется то, у которого суммарный вес рёбер наименьший. Классическая постановка требует соединить все дома оптоволокном, затратив минимум кабеля.
Два классических алгоритма, оба жадные:
- Алгоритм Прима наращивает дерево из одной вершины: на каждом шаге добавляется самое лёгкое ребро, ведущее из уже построенной части наружу. Удобно реализуется через кучу, сложность \( O(m \log n) \). По существу это алгоритм Дейкстры, только вместо расстояния от старта минимизируется вес одного ребра.
- Алгоритм Краскала исходит от рёбер: сортирует их все по весу и добавляет по очереди те, которые не образуют цикл. Проверка на цикл выполняется структурой «система непересекающихся множеств» (DSU): с сокращением путей и объединением по рангу её операции выполняются амортизированно почти за \( O(1) \), и сложность определяется сортировкой рёбер, \( O(m \log m) \).
Если в алгоритме Прима заменить «минимальное ребро» на «максимальное», получится максимальное остовное дерево; эта задача рассматривается в конце главы.
Графы в физических задачах
- Электрические цепи. Схема представляет собой граф из узлов и ветвей. Законы Кирхгофа записываются через матрицу инцидентности, а число независимых контурных уравнений равно \( m - n + 1 \), то есть количеству рёбер, не вошедших в остовное дерево: каждое такое ребро вместе с путём по остову замыкает свой независимый контур, хотя эти контуры не обязаны совпадать с ячейками схемы.
- Модель Изинга и перколяция. Спины на решётке служат вершинами, а взаимодействия соседей рёбрами. Алгоритмы кластерного обновления (Свендсена — Ванга, Вольфа) сводятся к поиску компонент связности, а перколяция — вопрос о существовании компоненты, соединяющей края решётки; на квадратной решётке, узлы которой заняты независимо с вероятностью \( p \), такая компонента в пределе бесконечной решётки появляется при \( p > p_c \approx 0{,}5927 \).
- Молекулы и структуры. Атомы и химические связи образуют граф, а поиск колец в молекуле сводится к поиску циклов. На этом же представлении работают графовые нейронные сети, предсказывающие свойства веществ.
- Марковские цепи и графы состояний. Состояния системы становятся вершинами, а переходы, снабжённые вероятностями, взвешенными рёбрами орграфа.
- Трассировка и планирование. Разводка кабелей на установке, маршрут манипулятора, план эксперимента сводятся к задачам о кратчайшем пути или об остовном дереве.
Для практических расчётов реализовывать алгоритмы вручную не обязательно: готовые собраны в библиотеке NetworkX.
import networkx as nx
# граф-решётка 4 x 4 — например, узлы двумерной модели Изинга
lattice = nx.grid_2d_graph(4, 4)
print(nx.number_connected_components(lattice)) # компоненты связности
print(nx.shortest_path(lattice, (0, 0), (3, 3))) # кратчайший путь
mst = nx.minimum_spanning_tree(lattice) # остовное дерево
Разбираться в устройстве алгоритмов всё равно необходимо: библиотека не подскажет, что поставленная задача сводится к поиску компонент связности.
Разбор задач
Задачи рекомендуется сначала решить самостоятельно; они собраны в тренажёре.
Во всех задачах вершины нумеруются с единицы, а граф подаётся на вход списком рёбер: в первой строке числа \( n \) и \( m \), задающие количество вершин и рёбер, далее \( m \) строк с парами вершин.
Задача 1. Построить список смежности
Условие. Дан ориентированный граф, заданный списком рёбер. Требуется построить его список смежности: для каждой вершины \( i \) вывести число исходящих рёбер, а затем номера вершин, в которые они ведут, в порядке возрастания.
Идея решения. Прямая реализация определения. Заведём список списков и пройдём по рёбрам, добавляя конец каждого ребра в список его начала. Сортировка выполняется один раз в конце.
n, m = map(int, input().split())
graph = [[] for _ in range(n + 1)] # вершины нумеруются с единицы
for _ in range(m):
u, v = map(int, input().split())
graph[u].append(v) # граф ориентированный: только u -> v
for vertex in range(1, n + 1):
neighbours = sorted(graph[vertex])
print(len(neighbours), *neighbours)
Сложность. По времени \( O(n + m \log n) \), поскольку чтение рёбер стоит \( O(m) \), а сортировка списков смежности даёт в сумме \( \sum_i d_i \log d_i \le m \log n \). По памяти \( O(n + m) \).
Задача 2. Перевести список рёбер в матрицу смежности
Условие. Дан ориентированный граф, заданный списком рёбер. Требуется вывести его матрицу смежности \( n \times n \): на пересечении \( i \)-й строки и \( j \)-го столбца стоит единица, если существует ребро, ведущее из \( i \) в \( j \).
Идея решения. Заведём нулевую матрицу и расставим единицы. Единственная тонкость заключается в том, что матрицу нельзя создавать через [[0] * n] * n. В этом случае получится \( n \) ссылок на один и тот же список, и запись в одну строку изменит все разом; устройство этой ловушки рассмотрено в главе про объекты и память.
n, m = map(int, input().split())
matrix = [[0] * n for _ in range(n)] # именно так, а не [[0] * n] * n
for _ in range(m):
u, v = map(int, input().split())
matrix[u - 1][v - 1] = 1 # переходим к нумерации с нуля
for row in matrix:
print(*row)
Сложность. По времени \( O(n^2 + m) \), поскольку один вывод матрицы уже стоит \( O(n^2) \); по памяти \( O(n^2) \).
Задача 3. Обход в глубину
Условие. Задан неориентированный граф. Требуется обойти с помощью DFS все вершины, достижимые из заданной вершины \( s \), и вывести их в порядке обхода. Соседи каждой вершины рассматриваются в порядке возрастания номеров.
Идея решения. Итеративный DFS со стеком, поскольку граф может содержать до \( 10^5 \) вершин, и на длинном пути обхода, например на цепочке, рекурсия, ограниченная тысячей кадров, с этим не справится. Чтобы соседи обрабатывались по возрастанию, поместим их в стек в обратном порядке: снимается всегда последний положенный.
n, m = map(int, input().split())
graph = [[] for _ in range(n + 1)]
for _ in range(m):
u, v = map(int, input().split())
graph[u].append(v)
graph[v].append(u) # граф неориентированный
start = int(input())
for neighbours in graph:
neighbours.sort(reverse=True) # сортируем один раз заранее
visited = [False] * (n + 1)
stack, order = [start], []
while stack:
vertex = stack.pop()
if visited[vertex]: # вершина могла попасть в стек несколько раз
continue
visited[vertex] = True
order.append(vertex)
for neighbour in graph[vertex]:
if not visited[neighbour]:
stack.append(neighbour)
print(*order)
Сложность. По времени \( O(n + m) \) плюс сортировка списков смежности, выполненная заранее; по памяти \( O(n + m) \).
Задача 4. Обход в ширину
Условие. Постановка та же, но обход выполняется в ширину.
Идея решения. Заменим стек на deque и будем снимать элементы с начала; соседей отсортируем уже по возрастанию, а вершину, добавляемую в очередь, сразу пометим посещённой.
from collections import deque
n, m = map(int, input().split())
graph = [[] for _ in range(n + 1)]
for _ in range(m):
u, v = map(int, input().split())
graph[u].append(v)
graph[v].append(u)
start = int(input())
for neighbours in graph:
neighbours.sort()
visited = [False] * (n + 1)
visited[start] = True
queue, order = deque([start]), []
while queue:
vertex = queue.popleft() # берём из начала очереди
order.append(vertex)
for neighbour in graph[vertex]:
if not visited[neighbour]:
visited[neighbour] = True # помечаем сразу при добавлении
queue.append(neighbour)
print(*order)
Сложность. Та же, что и у DFS: \( O(n + m) \) по времени и памяти. Коды двух обходов различаются контейнером, порядком перебора соседей и моментом пометки вершины.
Задача 5. Компоненты связности
Условие. Дан неориентированный граф. Требуется найти его компоненты связности: вывести их количество, а затем вершины каждой компоненты по возрастанию. Компоненты упорядочены по номеру первой вершины.
Идея решения. Запустим обход из каждой ещё не посещённой вершины: всё, собранное обходом за один запуск, и есть одна компонента. Если перебирать стартовые вершины по возрастанию, компоненты автоматически получатся в нужном порядке.
n, m = map(int, input().split())
graph = [[] for _ in range(n + 1)]
for _ in range(m):
u, v = map(int, input().split())
graph[u].append(v)
graph[v].append(u)
visited = [False] * (n + 1)
components = []
for vertex in range(1, n + 1):
if visited[vertex]:
continue
component, stack = [], [vertex] # новая компонента
while stack:
current = stack.pop()
if visited[current]:
continue
visited[current] = True
component.append(current)
stack.extend(graph[current])
components.append(sorted(component))
print(len(components))
for component in components:
print(*component)
Сложность. По времени \( O(n + m) \) плюс сортировка найденных компонент, по памяти \( O(n + m) \). Заметим, что внешний цикл по вершинам, вопреки первому впечатлению, не делает алгоритм квадратичным: каждая вершина обрабатывается по одному разу, а цикл лишь ищет стартовые точки.
Задача 6. Самая дорогая сеть
Условие. Дан взвешенный неориентированный граф. Требуется найти вес максимального остовного дерева — набора рёбер, связывающего все вершины и имеющего наибольший суммарный вес. Если граф несвязен, дерева, натянутого на все вершины, не существует.
Идея решения. Алгоритм Прима, в котором на каждом шаге выбирается не минимальное, а максимальное ребро. Модуль heapq до версии 3.13 включительно реализует лишь min-heap, поэтому в кучу помещается вес со знаком минус: «минимальный» элемент кучи окажется максимальным по модулю.
Начнём с первой вершины и поместим в кучу все рёбра, исходящие из неё. Затем на каждом шаге будем извлекать самое тяжёлое ребро; если оно ведёт в новую вершину, добавим её в остов, прибавим вес к ответу и поместим в кучу её рёбра. Если после завершения цикла в остов вошли не все вершины, значит, граф несвязен.
import heapq
def add_vertex(vertex, graph, added, heap):
"""Добавляет вершину в остов и кладёт её рёбра в кучу."""
added[vertex] = True
for neighbour, weight in graph[vertex]:
if not added[neighbour]:
heapq.heappush(heap, (-weight, neighbour)) # минус: нужен max-heap
n, m = map(int, input().split())
graph = [[] for _ in range(n + 1)]
for _ in range(m):
u, v, weight = map(int, input().split())
graph[u].append((v, weight))
graph[v].append((u, weight))
added = [False] * (n + 1)
added[0] = True # нулевой вершины не существует
heap, total = [], 0
add_vertex(1, graph, added, heap) # растим остов из первой вершины
in_tree = 1 # сколько вершин уже в остове
while in_tree < n and heap:
weight, vertex = heapq.heappop(heap)
if not added[vertex]: # ребро внутрь остова пропускаем
total += -weight
add_vertex(vertex, graph, added, heap)
in_tree += 1
print(total if in_tree == n else "Oops! I did it again")
Сложность. По времени \( O(m \log n) \), поскольку каждое ребро попадает в кучу не более одного раза, а операции с кучей стоят \( O(\log n) \). По памяти \( O(n + m) \).
Резюме
- Граф является самой общей структурой, описывающей связи; дерево и список — его частные случаи.
- Разреженные графы хранятся списком смежности, занимающим \( O(n+m) \) памяти, а плотные матрицей смежности: \( O(n^2) \), зато проверка ребра за \( O(1) \).
- DFS и BFS отличаются контейнером для вершин — стеком или очередью — и моментом пометки вершины, и оба работают за \( O(n + m) \).
- BFS находит кратчайшие пути в невзвешенном графе, а алгоритм Дейкстры во взвешенном с неотрицательными весами за \( O(m \log n) \).
- Посещённые вершины необходимо помечать: в отличие от дерева, у графа есть циклы, и без пометок обход не завершится.
- Компоненты связности, топологическая сортировка и остовные деревья — три классических применения обходов, к которым сводится множество практических задач.
Жизненный цикл программного обеспечения
Язык и алгоритмы составляют лишь половину дела. Вторая половина начинается там, где программа перестаёт быть личным черновиком, написанным за один вечер. Ею пользуются коллеги, на полученных ею результатах строятся статьи, а поддерживать её приходится годами, отвечая на письма людей, никогда не видевших автора.
Жизненный цикл программного обеспечения (ПО) охватывает всё происходящее с программой, от разговора, в котором задача только формулируется, до дня, когда её снимают с поддержки. Каждая стадия закрывает вопрос, иначе возникающий позже и по другой цене: чего от программы требуют, как она устроена, работает ли она и кто устраняет её сбои в нерабочее время.
Слайды к главе. Материал главы изложен также в лекции «Жизненный цикл ПО» (анализ и проектирование, разработка, тестирование, релиз, CI/CD, сопровождение) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Основные стадии жизненного цикла
Жизненный цикл ПО принято делить на стадии; в настоящей главе их семь:
- Анализ. Выясняется, что именно требуется построить.
- Проектирование. Определяется, как это будет устроено.
- Разработка. Пишется код.
- Тестирование. Проверяется, что получилось именно задуманное.
- Релиз. Продукт доводится до пользователя.
- Сопровождение. Работающая система наблюдается и поддерживается.
- Завершение жизненного цикла. Продукт снимается с поддержки.
Стадии повторяются циклами. В каскадной модели они проходят один раз строго по порядку, в итеративных моделях цикл короткий и повторяется много раз: каждая итерация заканчивается работающей версией, а требования уточняются по опыту её использования. Современная разработка почти всегда итеративна. Пропущенная стадия не исчезает: её вопрос возникает позже и обходится дороже, и ошибку в требованиях, найденную при тестировании, приходится исправлять во всех слоях, построенных поверх неё. У научного кода цикл короче, а роль заказчика, аналитика и приёмщика играет сам разработчик.
Анализ и планирование
На этапе анализа собираются требования к будущему продукту и сводятся в документ — спецификацию требований к программному обеспечению (Software Requirements Specification, SRS).
Спецификация требований
Структуру спецификации задавал стандарт IEEE 830-1998. В 2011 году его заменил стандарт ISO/IEC/IEEE 29148 (действующая редакция — 2018 года), однако основное содержание документа сохранилось. Спецификация состоит из трёх частей:
- Введение: назначение документа и продукта, его границы, термины и ссылки.
- Общее описание: место продукта среди других систем, основные функции, пользователи, окружение, ограничения и допущения.
- Конкретные требования: внешние интерфейсы и форматы данных, функции, производительность, проектные ограничения и атрибуты качества — надёжность, точность, сопровождаемость.
Сроки и бюджет в спецификацию не включают: это требования к проекту, а не к продукту, и они фиксируются в плане работ. В отечественной практике документ с требованиями называют техническим заданием. Его содержание для программ устанавливает ГОСТ 19.201-78, для автоматизированных систем — ГОСТ 34.602-2020; техническое задание на систему, кроме требований к ней, определяет состав и этапы работ, порядок контроля и приёмки.
Ключевые задачи этапа анализа
Кроме сбора требований, этап включает постановку целей, планирование работ, распределение ресурсов и согласование сроков и бюджета. В научной группе все эти задачи умещаются в один разговор с руководителем и полстраницы заметок: что вычисляется, из каких данных, с какой точностью, в каком виде и к какому сроку нужен результат. Первый этап итогового проекта курса представляет собой именно такой документ на одну-две страницы.
Этим этапом пренебрегают из ощущения, что «и так всё понятно». Цена ошибки здесь самая высокая из всех стадий: неверно понятое требование обнаруживается на защите, когда переделывать некогда, и увлекает за собой все написанные поверх него страницы.
Проектирование
Из требований выводится устройство системы: деление на части (модули, сервисы, хранилища) и интерфейсы между ними — форматы данных, программные интерфейсы, протоколы. Решения этого этапа переживают весь написанный впоследствии код. Переписать отдельную функцию дёшево; изменить деление на части в собранной системе почти невозможно.
Первый вопрос проектирования — нужен ли код вообще. Каждая строка кода требует сопровождения, поэтому задача, решаемая настройкой существующего инструмента, готовой библиотекой или ручной операцией, решена лучше всего.
Design-review
Прежде чем писать код, замысел, оформленный на паре страниц, показывают коллегам. Design-review отвечает на два вопроса: стоит ли вообще это делать и хорошо ли спроектирована система. На разборе обсуждаются:
- что планируется сделать;
- мотивация, то есть цели, заказчики и пользователи;
- сравнение с уже существующими аналогами;
- план работ (roadmap).
Самым полезным пунктом в науке является третий: инструмент, уже написанный другой группой, обнаруживается нередко, и полчаса поиска могут сэкономить месяцы работы. Разбор окупается и после запуска. Система, построенная без него, при первом отказе может оказаться без графиков, оповещений и журналов в привычном для коллег месте, и поиск причины займёт больше времени, чем само исправление.
Security-review
Второй разбор, посвящённый безопасности, необходим всегда, но особенно там, где ошибка обходится дорого: когда поднимается новый сервис, выставленный в сеть; когда система распоряжается деньгами; когда через неё проходят закрытые или персональные данные; когда пишется собственная аутентификация или собственное разграничение прав.
Проверка паролей, написанная самостоятельно, остаётся типичной уязвимостью лабораторных сервисов. Сделанная за один вечер, она затем годами пропускает внутрь кого угодно, поэтому проверку доступа поручают готовым средствам, например SSH и единому входу организации. Разбор не заканчивается запуском: сервис со временем начинает обрабатывать новые данные, и хранилище, одобренное для открытых данных, оказывается открытым и для закрытых.
MVP (Minimum Viable Product)
Минимально жизнеспособный продукт — самая маленькая версия, которой уже можно пользоваться и которая удовлетворяет первых потребителей. Смысл заключается в том, чтобы как можно раньше получить отзыв и выяснить, тот ли продукт создаётся, вместо того чтобы полгода разрабатывать полную версию по непроверенным требованиям. По отзывам пользователей уточняются требования следующей версии, и цикл повторяется.
Для лабораторного инструмента MVP обычно выглядит так: одна команда, один формат входных файлов, никаких настроек. Она вычисляет задуманное, и её можно передать коллеге. Форматы, настройки и отчёты добавляются, когда выяснится, что они действительно нужны.
Разработка
Интерес здесь представляет не сам код, а то, как несколько человек работают над одним проектом, не затирая сделанное друг другом.
Системы контроля версий
Система контроля версий (VCS) хранит историю изменений с указанием того, кто, что и когда правил, и позволяет вернуться к любому прошлому состоянию. Решать эту задачу начали в 1960-х программой IEBUPDTE, затем появились SCCS в 1970-х, RCS и CVS в 1980-х, Subversion и Git в 2000-х.
Поколения различаются тем, где хранится история. Централизованные системы (CVS, Subversion) хранят её на сервере, и без связи с ним нельзя ни просмотреть историю, ни сделать коммит. Распределённые системы (Git, Mercurial) дают каждому участнику полную копию репозитория со всей историей, поэтому работать можно без сети, а синхронизироваться впоследствии.
Стандартом де-факто является Git, написанный Линусом Торвальдсом в 2005 году для разработки ядра Linux, когда команда лишилась бесплатного доступа к использовавшейся до того проприетарной системе BitKeeper. Главной его особенностью является дешёвое ветвление. Ветка — указатель на коммит, поэтому её создание ничего не копирует, и ветвиться и сливать можно постоянно. Команда git switch -c feature создаёт ветку и переключается на неё (прежняя форма — git checkout -b feature), а git merge feature сливает её изменения в текущую ветку. Если обе ветки изменили одни и те же строки, возникает конфликт слияния: Git помечает спорные строки, а решение принимает человек. Устройству Git и повседневным командам посвящена отдельная глава.
Вокруг ветвления сложились схемы работы:
- Git Flow держит две постоянные ветки, main и develop, и заводит на время ветки функций, релизов и срочных исправлений, которые удаляются после слияния. Схема подходит для продуктов с редкими версионированными релизами.
- GitHub Flow проще: основная ветка всегда находится в рабочем состоянии, каждая задача делается в короткой ветке и вливается через pull request после ревью.
- GitLab Flow дополняет GitHub Flow ветками окружений или долгоживущими ветками релизов, через которые изменения проходят по стендам.
- Магистральная разработка (trunk-based development) сокращает жизнь веток до дня и опирается на непрерывную интеграцию и feature-флаги.
Выбор определяется тем, как часто выходят релизы и сколько версий одновременно поддерживается. Научной группе почти всегда достаточно самой простой схемы, GitHub Flow.
Ревью кода
Pull request (или merge request) — предложение влить в общую ветку сделанные разработчиком изменения. Он решает три задачи: делает правку видимой для всей команды, предоставляет место для обсуждения до того, как код попал в основную ветку, и служит точкой, к которой привязываются автоматические проверки.
Ревью, занимающее полчаса, полезно даже в группе из двух человек. Свежий взгляд обнаруживает и ошибки, и места, кажущиеся очевидными автору, но не читателю. Ревью распространяет знание о проекте между участниками, и написанное перестаёт быть понятным одному человеку. Лучше всего ревью работает на небольших изменениях: pull request на пятьдесят строк читают внимательно, а на две тысячи — лишь просматривают. Ревью не заменяет тесты и линтер, а дополняет их: машина проверяет форму, человек — смысл, а в научном коде ещё и физику — единицы измерения, знаки, предельные случаи.
Споры о форме снимают единые требования к коду: стиль определяется соглашением, а не вкусом автора, и проверяют его линтер и форматтер. Хук pre-commit в каталоге .git/hooks запускает проверки перед каждым коммитом и не даёт зафиксировать код, который их не проходит. Хук обходится ключом --no-verify и не копируется при клонировании, поэтому проверки на сервере он не заменяет; общий для всех участников набор хуков описывают файлом .pre-commit-config.yaml фреймворка pre-commit.
Монорепозиторий
Монорепозиторий хранит код нескольких проектов вместе, под общей системой сборки и тестирования. Это упрощает управление зависимостями (все компоненты всегда согласованной версии), облегчает работу через границы команд и позволяет вносить сквозные изменения одним коммитом, а не пятью, разложенными по репозиториям. Платой являются разросшийся репозиторий и более сложные инструменты сборки, проверяющие только затронутые части. Монорепозитории используют крупные компании, в том числе Яндекс и Google; большинство открытых проектов живёт в отдельных репозиториях.
В монорепозитории удобно хранить и копии сторонних зависимостей: сборка не зависит от того, что удалят или подменят в чужом репозитории. В 2016 году автор пакета left-pad из одиннадцати строк удалил его из npm, и на несколько часов перестали собираться тысячи проектов; в 2024 году в библиотеку xz один из сопровождающих внёс бэкдор, попадавший в сборку через архивы релизов. Копия защищает только при закреплённых версиях и проверке каждого обновления.
Лаборатории разумно держать в одном репозитории всё, что выпускается и версионируется вместе, и разносить части, развивающиеся независимо.
Тестирование
Проверка вручную после каждой правки быстро становится невыполнимой. Автоматические тесты позволяют один раз описать требуемое поведение и в дальнейшем проверять его одной командой.
Проверки удобно выстроить пирамидой по цене и частоте запуска. Классическая пирамида тестов (М. Кон, 2009) состоит из модульных, интеграционных и сквозных тестов через интерфейс пользователя; в основание часто кладут статический анализ, не запускающий программу. Внизу проверки дешёвые и быстрые: их много, и они запускаются на каждое изменение. Вверху — дорогие и медленные: их мало, и они запускаются перед релизом. Нагрузочные тесты стоят особняком: они проверяют не правильность, а производительность.
Статический анализ
Самая дешёвая проверка не запускает программу. Анализатор читает исходный код и ищет в нём ошибки, отклонения от стиля и уязвимости: неиспользуемые переменные и импорты, опечатки в именах, сравнение с None через ==, голые except; по аннотациям типов mypy находит передачу значения не того типа. По сути это автоматизированная часть ревью, но не его замена. В отчёты о качестве попадают и метрики: цикломатическая сложность и доля дублированных строк. Туда же попадает покрытие тестами, однако получают его иначе, выполняя тесты под coverage.py (coverage run -m pytest, а с плагином pytest-cov — pytest --cov): узнать, какие строки выполнялись, не выполнив их, нельзя.
Анализатор, встроенный в редактор и в CI, в дальнейшем работает самостоятельно. Набор его правил задают в pyproject.toml явно: правила по умолчанию меняются от версии к версии, и в ruff 0.16 из них исключены, например, проверки сравнения с None и импорта со звёздочкой.
«Самое важное, что я сделал как программист за последние годы, — начал агрессивно применять статический анализ кода» — Джон Кармак, 2011
Модульные тесты
Модульный тест (unit test) проверяет одну функцию или класс, отделённые от всего остального. Их пишут много, они выполняются за секунды и запускаются на каждое изменение, поэтому ошибка, внесённая правкой, обнаруживается сразу.
Для научного кода это самая ценная разновидность тестов. Формулу проверяют на случаях с известным ответом, в предельных случаях и на инвариантах. Рассмотрим модуль physics.py с релятивистскими формулами:
"""Релятивистские формулы для пучка."""
import math
C = 299_792_458.0 # скорость света, м/с
def gamma(v):
"""Лоренц-фактор частицы со скоростью v, м/с."""
if not 0 <= v < C:
raise ValueError("ожидается 0 <= v < c")
return 1 / math.sqrt(1 - (v / C) ** 2)
def kinetic_energy(m, v):
"""Кинетическая энергия, Дж: масса m в кг, скорость v в м/с."""
return (gamma(v) - 1) * m * C**2
Тесты к нему лежат в файле test_physics.py:
import pytest
from physics import C, gamma, kinetic_energy
@pytest.mark.parametrize(
"beta, expected", [(0.0, 1.0), (0.6, 1.25), (0.8, 5 / 3)]
)
def test_gamma_known_values(beta, expected):
assert gamma(beta * C) == pytest.approx(expected)
def test_gamma_rejects_light_speed():
with pytest.raises(ValueError):
gamma(C)
def test_kinetic_energy_classical_limit():
m, v = 1.0, 1e3 # скорость много меньше c
assert kinetic_energy(m, v) == pytest.approx(m * v**2 / 2, rel=1e-6)
Декоратор parametrize прогоняет один тест на нескольких наборах данных, pytest.raises проверяет, что функция отвергает недопустимый вход, а pytest.approx сравнивает вещественные числа с допуском. Подробнее pytest рассмотрен в главе «От скрипта к приложению».
Тест предельного случая не проходит: при скорости 1000 м/с функция возвращает 500 006,9 Дж вместо 500 000. Ошибка не в физике, а в арифметике. Величина \(\gamma - 1 \approx 5{,}6 \cdot 10^{-12}\) получается вычитанием близких чисел, и из шестнадцати значащих цифр двойной точности в ней остаётся около пяти. Математически равная запись \((\gamma - 1) mc^2 = mv^2 \gamma^2 / (\gamma + 1)\) близкие числа не вычитает:
def kinetic_energy(m, v):
"""Кинетическая энергия, Дж: масса m в кг, скорость v в м/с."""
return m * v**2 * gamma(v) ** 2 / (gamma(v) + 1)
С ней проходят все пять тестов. Тест предельного случая обнаружил ошибку, которую не видно на релятивистских скоростях; проверенная однажды, формула остаётся проверенной и после того, как через полгода её начнут оптимизировать.
Разработка через тестирование (TDD)
В примере выше тесты написаны к готовому коду. Разработка через тестирование (test-driven development, TDD), описанная К. Беком (2002), меняет порядок работы. Сначала пишется тест, фиксирующий требование, и он не проходит, поскольку кода ещё нет; затем пишется простейший код, с которым тест проходит; затем при проходящих тестах код приводится в порядок (рефакторинг), в частности из него убирается дублирование, допущенное ради быстрого прохождения теста (принцип DRY рассмотрен в главе «Требования к коду»). Цикл «красный — зелёный — рефакторинг», названный по цвету отчёта о тестах, повторяется для каждого требования. Тест, написанный до кода, проверяет требование, а не реализацию, тогда как тест, составленный по готовому коду, нередко принимает за норму то, что код делает, вместе с его ошибками.
Рассмотрим функцию, проверяющую адреса приборов в файле конфигурации. Требование сформулируем так: адрес IPv4 записывается четырьмя десятичными числами от 0 до 255 через точку, без ведущих нулей (адресация рассмотрена в главе «Компьютерные сети»). Тесты составлены по пунктам требования и лежат в файле test_ipv4.py:
import pytest
from ipv4 import is_ipv4
VALID = ("8.8.8.8", "192.0.2.10", "255.255.255.255")
INVALID = ("", "a.b.c.d", "256.1.1.1", "8.8.8.8.8")
# три числа, ведущий нуль, шестнадцатеричная запись, одно число
STRICT = ("8.8.8", "010.0.0.1", "0x08080808", "134744072")
@pytest.mark.parametrize("text", VALID)
def test_valid(text):
assert is_ipv4(text)
@pytest.mark.parametrize("text", INVALID + STRICT)
def test_invalid(text):
assert not is_ipv4(text)
Первая реализация в модуле ipv4.py поручает разбор адреса стандартной функции socket.inet_aton:
import socket
def is_ipv4(text):
"""Проверяет, является ли строка text адресом IPv4."""
try:
socket.inet_aton(text)
except OSError:
return False
return True
python3 -m pytest -q --tb=no
.......FFFF [100%]
=========================== short test summary info ============================
FAILED test_ipv4.py::test_invalid[8.8.8] - AssertionError: assert not True
FAILED test_ipv4.py::test_invalid[010.0.0.1] - AssertionError: assert not True
FAILED test_ipv4.py::test_invalid[0x08080808] - AssertionError: assert not True
FAILED test_ipv4.py::test_invalid[134744072] - AssertionError: assert not True
4 failed, 7 passed in 0.01s
Ключи -q и --tb=no сокращают отчёт до строки хода выполнения, перечня непрошедших тестов и итога. Очевидные случаи реализация проходит, строгие — нет. Функция inet_aton разбирает адрес по правилам, унаследованным от BSD Unix: в записи из трёх чисел последнее занимает два младших байта, и 8.8.8 означает 8.8.0.8; число с ведущим нулём читается как восьмеричное, и 010.0.0.1 превращается в 8.0.0.1; строки 0x08080808 и 134744072 представляют собой адрес 8.8.8.8, записанный целиком одним числом, шестнадцатеричным и десятичным. Поэтому проверка пропустила бы и опечатку 192.0.2 вместо 192.0.2.10: inet_aton читает её как адрес 192.0.0.2. Документация Python к тому же оговаривает, что набор допустимых строк зависит от реализации библиотеки C. Разбор, соответствующий требованию, выполняет класс ipaddress.IPv4Address; ведущие нули он отвергает начиная с Python 3.9.5:
import ipaddress
def is_ipv4(text):
"""Проверяет, является ли строка text адресом IPv4."""
try:
ipaddress.IPv4Address(text)
except ipaddress.AddressValueError:
return False
return True
С новой реализацией та же команда показывает, что проходят все одиннадцать тестов:
........... [100%]
11 passed in 0.00s
Тест, написанный по требованию, обнаружил ошибку при первом запуске, а тест, составленный по результатам готовой функции, скорее всего закрепил бы 8.8.8 как допустимый адрес. Считать ли такую запись адресом — вопрос спецификации, а не тестирования: inet_aton её принимает, а сформулированное выше требование отвергает. Таким образом, тест лишь фиксирует выбранную спецификацию, и выбирают её до написания тестов.
Разработка через тестирование не даёт выигрыша, пока требование неизвестно. В исследовательском скрипте, будь то первый взгляд на новые данные или пробная подгонка, код меняется быстрее, чем к нему успевают написать тесты, и тест сохранил бы случайное промежуточное состояние. Тесты пишут, когда результат исследования становится требованием: формулой с известными предельными случаями, форматом файла, функцией, которую вызывают повторно.
Интеграционные и функциональные тесты
Модуль может работать правильно сам по себе и отказывать в связке с другими. Интеграционные тесты проверяют взаимодействие компонентов между собой и с внешними системами: базой данных, файловым хранилищем, чужим API за сетью. Они медленнее модульных и требуют поднятого окружения, поэтому их пишут меньше. Типичный пример: модуль чтения возвращает энергию в килоэлектронвольтах, а модуль подгонки ожидает мегаэлектронвольты. Модульные тесты каждого из них проходят, а ошибку в тысячу раз обнаруживает только интеграционный тест, проверяющий модули вместе.
Функциональные тесты проверяют, что программа делает записанное в требованиях, с точки зрения работающего с ней человека: через пользовательский или программный интерфейс, вручную или автоматически (для веб-интерфейсов — средствами вроде Selenium). У лабораторного инструмента сквозной функциональный тест обычно один. Он берёт снятый с установки эталонный файл, выполняет всю обработку от начала до конца и сравнивает итоговые числа с заведомо правильными.
Нагрузочное тестирование
Нагрузочные тесты проверяют, как система ведёт себя под поданной снаружи нагрузкой: измеряют производительность, проверяют поведение на пиках и восстановление после них и служат основой планирования ресурсов. Профили различаются по характеру нагрузки и по времени испытания; в таблице приведены названия, принятые в документации инструментов, например k6.
| Профиль | Что проверяет |
|---|---|
| Load testing | выдерживает ли система ожидаемую штатную нагрузку |
| Stress testing | что происходит за пределами расчётной нагрузки |
| Spike testing | переживает ли система резкий всплеск и как восстанавливается после него |
| Soak (endurance) testing | нет ли утечек памяти и деградации при штатной нагрузке в течение часов и дней |
| Breakpoint testing | где предел системы при постепенном росте нагрузки |
Общим словом performance testing называют все испытания производительности. Перед замером подают небольшой прогревающий поток запросов (warm-up), наполняющий кеши, иначе первые минуты измерений искажены. Это актуально и для физика: программа, быстро считающая на прогретых кешах, на первом запуске ведёт себя иначе. Для нагрузки используют JMeter, Siege, Яндекс.Танк, на Python — locust. Нагрузку подают на отдельное окружение, а не на рабочую систему, и обращения к внешним сервисам заменяют заглушками: иначе тест нарушит работу коллег или будет воспринят чужим сервисом как атака.
Релиз
Главной заботой при выкатке является возможность быстро откатиться в случае поломки.
Стратегии развёртывания
Существуют стратегии выкатки, каждая из которых по-своему страхует от неудачного релиза:
- Blue-green. Поддерживаются две одинаковые среды. Новая версия выкатывается на неактивную, проверяется, и трафик переключается одним действием. Откат — переключение обратно. Плата — удвоенные ресурсы, а схема общей базы данных должна подходить обеим версиям.
- Canary. Новая версия сначала показывается небольшой доле пользователей. Если число ошибок и потребление ресурсов не выросли, доля увеличивается. Проблема затрагивает немногих, а откат быстрый, но выкатка медленнее.
- Rolling update. Экземпляры приложения заменяются постепенно, по одному или группами, и сервис всё это время продолжает отвечать. Сколько экземпляров может быть недоступно одновременно и сколько добавляется сверх нормы, задают параметры выкатки (в Kubernetes —
maxUnavailableиmaxSurge). - A/B-тестирование. Контролируемый эксперимент: пользователи случайным образом делятся на группы, каждая получает свою версию, и решение принимается по заранее выбранной метрике с проверкой статистической значимости. От канареечной выкатки его отличает цель — выбор лучшего варианта, а не безопасность выпуска.
Крупные сервисы сочетают канареечную выкатку, постепенную замену, feature-флаги и A/B-эксперименты.
Контейнеры
Выпуск удобно оформлять образом контейнера (см. главу «Docker»). Образ содержит приложение вместе со средой выполнения — интерпретатором, библиотеками, системными файлами — и после сборки не меняется. Тег образа служит версией: выкатка — запуск контейнера из нового тега, откат — запуск из предыдущего, и старый образ хранится готовым к повторному запуску. Тег при этом остаётся изменяемой ссылкой: его можно перенести на другой образ, а базовый python:3.12-slim обновляется с каждым выпуском 3.12.x. Неизменяемой ссылкой служит дайджест (python:3.12-slim@sha256:…). Образ работает на любой машине с той же архитектурой процессора; для разных машин собирают многоплатформенный образ (docker buildx build --platform linux/amd64,linux/arm64).
Feature-флаги
Feature-флаг — переключатель, включающий или выключающий функциональность без изменения кода и без новой выкатки. Недописанную функцию можно держать в основной ветке выключенной, включить её для десяти пользователей, а при проблемах выключить за секунду вместо отката всего релиза. Флаг служит и аварийным выключателем: при сбое им отключают функцию, создающую лишнюю нагрузку. Флаги копятся, поэтому флаг, включённый для всех пользователей, удаляют вместе со старой ветвью кода, а навсегда выключенный — вместе с неиспользуемой новой.
Версии и теги
Релиз получает номер версии, по которому его можно найти, установить и сослаться на него. Семантическое версионирование (SemVer) записывает версию тремя числами MAJOR.MINOR.PATCH: старшее увеличивается при несовместимом изменении интерфейса, среднее — при новых возможностях с сохранением совместимости, младшее — при исправлении ошибок. Версия фиксируется в Git аннотированным тегом: git tag -a v1.5.0 отмечает коммит, из которого собран релиз, а git describe показывает, сколько коммитов прошло с последнего тега. Список изменений между версиями ведут в файле CHANGELOG.
В статье указывают версию или хеш коммита кода, которым получен результат. Архив релиза с DOI, например через интеграцию GitHub с Zenodo, позволяет сослаться на код и воспроизвести расчёт спустя годы.
Момент выпуска
Мораторий на выкатки (change freeze) — период с запрещёнными выкатками: перед большой конференцией, во время набора данных на установке, в новогодние праздники, когда некому устранять неполадки. От него отличается feature freeze — этап цикла выпуска, после которого в версию принимают только исправления ошибок: в CPython он наступает с первой бета-версией. Релизные окна — заранее оговорённые промежутки, в которые выкатки разрешены, чтобы в этот момент на месте были люди, способные разобраться с последствиями.
CI/CD
Перечисленные проверки выполняет конвейер CI/CD. Без него разработчики занимаются сборкой и ручным тестированием вместо разработки, под давлением сроков тестирование пропускают, а при ручной выкатке легко ошибиться. За тремя похожими аббревиатурами скрываются три степени автоматизации.
Непрерывная интеграция (CI) — минимальный уровень. Код хранится в системе контроля версий, каждый push запускает сборку, модульные тесты и статический анализ, изменения проходят ревью. Поломка обнаруживается через минуты после появления, а не через недели.
Непрерывная поставка (CD, Continuous Delivery) добавляет хранение собранных дистрибутивов в централизованном хранилище и автоматическое развёртывание на тестовые среды. Система в любой момент готова к выкатке и ожидает решения человека.
Непрерывное развёртывание (CD, Continuous Deployment): прошедшие все проверки изменения попадают в продакшен без участия человека. Это требует уверенности в тестах.
Научной группе обычно достаточно первого уровня — конвейера, запускающего на каждый push тесты и линтер; он требует одного файла в репозитории. Конвейеры исполняют GitHub Actions, GitLab CI, Jenkins, TeamCity.
Устройство реального конвейера
Ниже в обновлённом виде приведён конвейер научной библиотеки REDPIC, кода для расчёта динамики пучка, которому отведена отдельная глава; в репозитории библиотеки он записан на более старых версиях действий. Конвейер написан для GitHub Actions и состоит из трёх файлов в каталоге .github/workflows.
Первый файл, check.yml, проверяет качество кода. Он запускается на push в основную ветку, затрагивающий файлы Python, и на каждый pull request в неё. Работа выполняется на чистой виртуальной машине и начинается с подготовки: получить исходники и установить нужную версию Python.
name: Check
on:
push:
branches: [master]
paths: ["**.py"]
pull_request:
branches: [master]
jobs:
check:
runs-on: ubuntu-latest
strategy:
matrix:
python-version: ["3.10", "3.11", "3.12"]
steps:
- name: Checkout sources
uses: actions/checkout@v7
- name: Set up Python
uses: actions/setup-python@v7
with:
python-version: ${{ matrix.python-version }}
Блок strategy.matrix задаёт матричную сборку. Один и тот же набор шагов выполняется на нескольких версиях Python, и если библиотека перестала работать на 3.12, но работает на 3.10, это выясняется сразу. Для библиотеки, передаваемой незнакомым людям, такая проверка обязательна: разработчик не управляет тем, какой Python установлен у пользователя.
Анализаторов два, поскольку обнаруживают они разное. flake8 следит за стилем и очевидными ошибками, pylint анализирует глубже и сообщает о сомнительных конструкциях; в новых проектах первый обычно заменяют на ruff. Шаги продолжают список steps той же работы:
- name: Install deps
run: |
python -m pip install --upgrade flake8 pylint
python -m pip install -r requirements.txt
- name: Run flake8
run: python -m flake8 redpic tests setup.py
- name: Run pylint
run: python -m pylint redpic tests setup.py
Проверяется не только код библиотеки, но и tests с setup.py. Тесты также являются кодом, и приходят в негодность они не реже основного.
Второй файл, test.yml, устроен так же, но вместо анализаторов устанавливает pytest и выполняет тесты:
- name: Run functional test
run: python -m pytest tests/functional/src
Любой шаг, завершившийся с ненулевым кодом, окрашивает проверку pull request в красный цвет. Запретить слияние с красной проверкой позволяет правило защиты основной ветки, в котором проверка отмечена обязательной.
Третий файл, release.yml, выпускает релиз. Он запускается только на поставленный автором тег версии. Первая работа собирает пакет, отправляет его в PyPI, где он становится доступен по pip install redpic, и прикладывает архив исходников к релизу на GitHub:
name: Release
on:
push:
tags: ["*.*.*"]
jobs:
library:
runs-on: ubuntu-latest
permissions:
contents: write # создание релиза на GitHub
id-token: write # публикация в PyPI без токена
steps:
- uses: actions/checkout@v7
- uses: actions/setup-python@v7
with:
python-version: "3.12"
- name: Build distributions
run: |
python -m pip install --upgrade build twine
python -m build
python -m twine check --strict dist/*
- name: Publish distribution to PyPI
uses: pypa/gh-action-pypi-publish@release/v1
- name: Upload Release Asset (sdist) to GitHub
uses: softprops/action-gh-release@v3
with:
files: dist/*.tar.gz
Блок permissions перечисляет права, которые получает работа; без него токен работы в новых репозиториях может только читать. Право id-token: write нужно для доверенной публикации (Trusted Publishing): PyPI принимает пакет от конвейера, заранее зарегистрированного на сайте, и токен PyPI в репозитории не хранится.
Ещё две работы того же файла собирают руководство и документацию. PDF-версия руководства прикладывается к релизу, а документация, собранная Sphinx из исходников, публикуется на GitHub Pages:
manual:
needs: library
runs-on: ubuntu-latest
permissions:
contents: write
steps:
- uses: actions/checkout@v7
- name: Compile LaTeX document
uses: xu-cheng/latex-action@v4
with:
root_file: main.tex
working_directory: manual/
- name: Upload Release Asset (pdf) to GitHub
uses: softprops/action-gh-release@v3
with:
files: manual/main.pdf
docs:
needs: library
runs-on: ubuntu-latest
permissions:
contents: write
steps:
- uses: actions/checkout@v7
- uses: actions/setup-python@v7
with:
python-version: "3.12"
- name: Build docs
run: |
python -m pip install -r docs/requirements.txt
python -m sphinx docs docs/_build/html
- name: Push documentation to GitHub Pages
uses: peaceiris/actions-gh-pages@v4
with:
github_token: ${{ secrets.GITHUB_TOKEN }}
publish_dir: docs/_build/html
Пароли и токены в конвейере никогда не записываются открытым текстом: они помещаются в хранилище секретов репозитория и подставляются по имени, например ${{ secrets.PYPI_API_TOKEN }}, если пакет публикуется по токену. Исключение составляет secrets.GITHUB_TOKEN: этот токен GitHub выдаёт каждой работе сам, с правами из блока permissions. Секрет, закоммиченный в репозиторий, считается скомпрометированным навсегда: история git хранит всё, и удаление следующим коммитом ничего не исправляет.
Каждое чужое действие — код, выполняемый в конвейере разработчика с доступом к его секретам. Неизменяемой ссылкой на действие служит только полный хеш коммита: тег, как и ветку, может перенести на другой коммит любой, получивший доступ к репозиторию действия (так в марте 2025 года были подменены теги действия tj-actions/changed-files). Мажорные теги вида @v7 переносятся на каждый новый выпуск по замыслу; в примере для краткости указаны именно они, а в рабочем конвейере действия сторонних авторов надёжнее закреплять полным хешем коммита с комментарием о версии, обновлять который помогает Dependabot. Запись вида @master означает «взять из чужой ветки то, что там находится сегодня». @release/v1 в примере — также ветка, однако PyPA поддерживает её под стабильные выпуски и сама рекомендует такую запись.
Одного тега в git достаточно, чтобы появилась новая версия библиотеки, устанавливаемая через pip, с собранной документацией и PDF-руководством, приложенным к релизу. Ни одного действия вручную, а следовательно, ни одной возможности пропустить шаг.
Это главный аргумент в пользу CI/CD в науке. Релиз, собираемый вручную, рано или поздно окажется собран не из того коммита, без одного теста или с забытым файлом, и обнаружится это через полгода, когда результат уже опубликован.
Задание. Выступить в роли рецензента: «Ревью чужого кода».
Сопровождение
Работающую систему необходимо наблюдать: собирать метрики и логи, следить за ними и вовремя замечать сигналы о неполадках. Метрики показывают задержки, долю ошибок и нагрузку, логи позволяют восстановить, что происходило перед сбоем, а трассировки — проследить запрос через несколько сервисов. Вместе их называют наблюдаемостью (observability); подробно она рассмотрена в главе «Наблюдаемость», а практика эксплуатации — в книге Google «Site Reliability Engineering» [23].
В зрелых командах вокруг этого выстраивается набор практик: назначенные дежурства с порядком реагирования на инциденты; разбор каждого сбоя без поиска виноватых, с поиском причин и мер, исключающих повторение; feature-флаги для быстрого выключения проблемной функции; регулярные учения на случай отказов. Chaos engineering — намеренное внесение отказов в работающую систему ради проверки того, что она их переживает: выяснять, что план не работает, лучше в контролируемых условиях, чем во время аварии.
Для лабораторного сервиса минимум следующий: программа ведёт журнал, перезапускается после сбоя, а об отказе кто-то узнаёт раньше, чем это обнаружат пользователи. Перезапуск обеспечивает, например, политика контейнера docker run --restart on-failure. Причину отказа он не устраняет: о перезапуске должен узнать человек, а причину разбирают по журналу.
Завершение жизненного цикла
Рано или поздно программу перестают поддерживать: её заменяет новая система, исчезает задача или некому её сопровождать. Об этом объявляют заранее, называя сроки, дают пользователям время и путь перехода на замену, а данные выгружают в формате, переживающем сам сервис. Инфраструктуру отключают, не оставляя забытых серверов и открытых портов.
В науке этот этап игнорируется чаще, чем где бы то ни было. Код к статье, заброшенный сразу после публикации, встречается повсеместно, а от него зависит, сможет ли кто-то воспроизвести результат через пять лет. Минимум, который необходимо оставлять после себя, — работающий репозиторий с README, зафиксированными версиями зависимостей и архивом релиза.
Резюме
Таким образом, семь стадий сохраняются, даже если код пишется в одиночку: кто-то должен понять, что нужно построить; продумать устройство; написать; проверить; довести до пользователей; сопровождать; а когда придёт время, закрыть, оставив после себя работающий репозиторий.
Разница между научной группой и большой компанией заключается в масштабе церемоний. Заказчиком, аналитиком, тестировщиком и дежурным оказывается один и тот же человек. Стадии пропускают обычно по незнанию. Ценой являются потерянные данные, невоспроизводимые результаты и код, в котором через год не разберётся даже автор.
Требования к коду на Python
Требования к коду на Python, действующие в этой книге, рекомендуется соблюдать и в собственных проектах.
Слайды к главе. Требования к коду и их автоматическая проверка (линтер, форматтер, хук pre-commit) изложены также в лекции «Жизненный цикл ПО» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Требования следующие:
- Строгое соответствие PEP 8.
- Длина строки — 79 символов.
- Импорты корректно отсортированы, неиспользуемых импортов нет.
- Отступы делаются в 4 пробела.
- Переносы строк выполнены с правильными отступами.
- Обратные слеши для переносов не используются.
- Консистентность (одинаковые кавычки, одинаковые способы решения одинаковых задач).
- Отсутствие закомментированного кода и стандартных комментариев-заглушек (
# Create your views here.и т. п.). - Комментарии к функциям оформлены как docstring в соответствии с Docstring Conventions, то есть начинаются с заглавной буквы, заканчиваются точкой и содержат описание того, что делает функция.
- Комментарии к коду краткие и информативные.
- Длинные куски кода логически разделены пустыми строками, как абзацы в тексте.
- Нет лишних операций.
- Нет лишних
else(если вifпроисходитreturn/raise); используется guard block. - В репозитории нет лишних файлов наподобие
__pycache__и.vscode, попадающих туда по невнимательности. - Исполняемый код в
.py-файлах закрыт конструкциейif __name__ == "__main__":. - Для неизменяемых последовательностей данных предпочтительны кортежи, а не списки.
- В f-строках используется только подстановка переменных, без логических и арифметических операций, вызовов функций и прочей динамики, мешающей читать шаблон.
- Имена переменных, выбранные по смыслу, записаны по-английски; однобуквенных имён нет (кроме счётчиков в коротких циклах и общепринятых математических обозначений).
- Функции и методы названы глаголами или глагольными фразами (
get_data,compute_energy), а классы существительными (Particle,FieldSolver); функция-формула, возвращающая величину, допускает имя этой величины, какmeanиexpв NumPy. - Магические числа вынесены в именованные константы.
Большинство перечисленных пунктов проверяются автоматически линтерами и форматтерами
ruff,flake8,black,isort, работающими в редакторе. Если они настроены в редакторе и в CI, следить за этими правилами вручную почти не требуется.blackиruff formatпо умолчанию форматируют по 88 символов, а не по 79, поэтому длину необходимо задать явно вpyproject.toml([tool.black] line-length = 79,[tool.ruff] line-length = 79), иначе форматтер и линтер будут предъявлять к коду противоречащие требования. Набор правил линтера также задают явно ([tool.ruff.lint] select = [...]): правила по умолчанию меняются от версии к версии, и вruff0.16 из них исключены, например, проверки сравнения сNoneи импорта со звёздочкой. Проверки удобно запускать хукомpre-commitперед каждым коммитом, а в CI — на каждый push.
Принципы проектирования
Перечисленные требования касаются формы кода, и большую их часть проверяет линтер. Устройство кода — какие фрагменты выделены в функции и где хранится общее для них знание — линтер не оценивает: его обсуждают на ревью, опираясь на принципы, сложившиеся в инженерной практике; каждый из них представляет собой эвристику с границами применимости, а не механическое правило. Принципы проектирования классов и модулей, известные под аббревиатурой SOLID, подробно изложены в книге Р. Мартина [13]; ниже рассмотрены принципы, применимые к любому коду, включая скрипты обработки данных.
Принцип DRY
Принцип DRY (Don't Repeat Yourself, «не повторяйся») сформулирован Э. Хантом и Д. Томасом в книге «Программист-прагматик» (1999): каждое знание должно иметь в системе единственное, однозначное и авторитетное представление. Знанием здесь являются не строки кода, а факты о задаче: коэффициенты калибровки, формула, формат файла. Рассмотрим типичный случай. Калибровка энергетической шкалы спектрометра скопирована в скрипт построения спектра и в скрипт подгонки пиков; после перекалибровки коэффициенты исправляют только в одном из них, и для одного и того же пика скрипты дают разные энергии, что обнаруживается, когда перестают сходиться рисунок и таблица статьи. Функция channel_to_energy в отдельном модуле, который импортируют оба скрипта, исключает такое расхождение и позволяет вносить новую калибровку в одном месте.
Граница принципа определяется тем же понятием знания. Одинаковый код может выражать разные знания, например окно сглаживания, совпадающее сегодня у двух детекторов разной конструкции. Объединив такой код, получим связь, которой нет в задаче: при замене одного детектора правка общего кода изменит обработку данных другого. Р. Мартин называет такие совпадения случайным дублированием [13]. Вторую опасность представляет преждевременная абстракция: общая функция, написанная по одному-двум случаям, обрастает флагами и ветвлениями при первом же случае, который в неё не укладывается, а исправить неудачную абстракцию труднее, чем позднее объединить одинаковые фрагменты. Практическую меру задаёт правило трёх, которое М. Фаулер приводит в книге «Рефакторинг» (1999) со слов Д. Робертса: однократное повторение допускается, а при третьем появлении фрагмента общий код выносится в функцию, когда уже видно, что у случаев общего и чем они различаются.
Принципы KISS и YAGNI
Принцип KISS (Keep it simple, stupid; аббревиатуру связывают с авиаконструктором К. Джонсоном) требует выбирать самое простое из решений, удовлетворяющих задаче. Каждая лишняя ветвь кода нуждается в тестах и сопровождении, а ошибки в редко исполняемых ветвях обнаруживаются позже всего. Характерным примером является «универсальный» загрузчик, распознающий по содержимому файлы HDF5, ROOT, FITS и несколько видов текстовых таблиц, тогда как установка пишет файлы одного формата. Загрузчик единственного формата занимает несколько строк, проверяется тестом на одном файле-образце и сообщает о неожиданном файле ошибкой, а не пытается прочитать его иначе.
Принцип YAGNI (You Aren't Gonna Need It, «это не понадобится») происходит из экстремального программирования: возможность реализуется, когда она потребовалась, а не когда её появление только предполагается. Скрипту для однократной обработки одного сеанса измерений не требуется система конфигурации с иерархией файлов YAML, переопределением через переменные окружения и проверкой схемы: достаточно трёх констант в начале файла. Конфигурацию вводят, когда скрипт становится инструментом группы (глава «От скрипта к приложению») и уже известно, какие параметры действительно меняются; тот же довод лежит в основе минимально жизнеспособного продукта (глава «Жизненный цикл ПО»). Границу принципа М. Фаулер (2015) проводит так: YAGNI относится к предполагаемым возможностям, а не к усилиям, облегчающим изменение кода, поэтому тесты, ясные имена и деление на функции работой «на будущее» не являются.
Противоположную крайность называют BDUF (Big Design Up Front): систему проектируют целиком и во всех подробностях до начала разработки. Экстремальное программирование такой подход отвергает, однако, как показывает М. Фаулер в статье «Is Design Dead?» (2000), речь идёт о равновесии предварительного проектирования и рефакторинга: деление на части и интерфейсы обсуждают с коллегами заранее (разделы «Проектирование» и «Design-review» главы «Жизненный цикл ПО»), а подробности уточняют по ходу работы. К тому же ряду относится правило о преждевременной оптимизации (глава «Причины низкой скорости Python»).
Комментарии в коде
Что делает код, сообщают имена и сама запись; комментарий объясняет, почему код написан именно так: зачем формула записана в необычном виде, какую ошибку сторонней библиотеки обходит фрагмент, какое ограничение прибора он учитывает. Комментарий, пересказывающий строку, дублирует знание, уже выраженное кодом: при правке кода его забывают исправить, и он начинает противоречить коду, а такой комментарий, согласно PEP 8, хуже отсутствующего. В следующем фрагменте комментарий сообщает причину решения, которую из кода не восстановить:
import numpy as np
PRETRIGGER_SAMPLES = 100
def subtract_baseline(waveform):
"""Вычитает из осциллограммы базовую линию."""
# Базовая линия АЦП дрейфует с температурой, поэтому она оценивается
# в каждом событии по отсчётам до триггера, а не берётся из калибровки.
baseline = np.mean(waveform[:PRETRIGGER_SAMPLES])
return waveform - baseline
Комментарий «среднее первых ста отсчётов» к той же строке повторял бы код. Если же без комментария непонятно, что делает фрагмент, его проще переписать: вынести в функцию с говорящим именем, заменить число именованной константой. Предупреждение «не менять» надёжнее заменить тестом, а закомментированный код удаляют: сохранность прежних версий обеспечивает история системы контроля версий.
Задание. Применить этот список к чужому коду и оставить замечания: «Ревью чужого кода».
От скрипта к приложению
Типичная история начинается с файла analysis.py на пятьдесят строк, написанного вечером перед семинаром: загрузить осциллограммы, вычесть базовую линию, найти пик, построить график. Скрипт работает, график попадает в отчёт.
Дальнейшее развитие событий, как правило, выглядит следующим образом:
- через полгода в скрипте, разросшемся до 800 строк, появляются калибровка, три формата входных файлов и ветка
if experiment == "march":; - рядом лежат
analysis_new.py,analysis_final.pyиanalysis_final_v2_REAL.py, и никто не помнит, чем они отличаются; - пути к данным (
/home/vasya/data/2026-03-12/) и параметры установки зашиты в код, и перед каждым запуском их правят в исходнике; - на другой машине скрипт не запускается, и начинается выяснение версий numpy;
- приходит новый студент, и автору скрипта приходится полчаса объяснять, какие строки закомментировать, чтобы «просто посчитать спектр».
Одноразовый скрипт является нормальным жанром. Проблемы начинаются, когда код, написанный на один раз, незаметно становится многоразовым: его использует вся группа, на него ссылаются в статьях, а устроен он по-прежнему как черновик.
Разница между скриптом и приложением заключается не в количестве строк, а в свойствах:
- приложение устанавливается на чистую машину одной-двумя командами;
- его запускают, не открывая исходники в редакторе, и запуск описан в README;
- оно внятно сообщает об ошибках и ведёт журнал, сохраняющийся после завершения запуска;
- его можно изменять, не опасаясь незаметно нарушить физику, поскольку за этим следят тесты;
- в нём способен разобраться другой человек или сам автор через полгода.
Глава про жизненный цикл ПО рассматривала разработку сверху. В настоящей главе весь путь проходится на одном примере: скрипт обработки осциллограмм превращается в пакет beamtool для всей группы.
В примерах встретится NumPy: loadtxt читает таблицу чисел из файла, argmax возвращает индекс максимума, trapezoid вычисляет интеграл методом трапеций. Устройство массивов разбирается в главе «NumPy и pandas»; здесь важна обвязка вокруг библиотеки.
Структура проекта
Любой файл .py представляет собой модуль, пригодный для импорта. Каталог с файлом __init__.py является пакетом, набором модулей под общим именем. Как только код перестаёт помещаться в один файл, его раскладывают по модулям по смыслу: чтение данных отдельно, формулы отдельно, графики отдельно. На один модуль приходится одна зона ответственности.
Типовая структура:
beamtool/ # корень git-репозитория
├── pyproject.toml # метаданные проекта и зависимости
├── README.md # что это, как поставить, как запустить
├── .gitignore
├── configs/
│ └── default.toml # параметры обработки по умолчанию
├── src/
│ └── beamtool/ # сам пакет
│ ├── __init__.py
│ ├── io.py # чтение и запись данных
│ ├── physics.py # формулы и численные методы
│ ├── plotting.py # вся работа с matplotlib
│ └── cli.py # интерфейс командной строки
└── tests/
├── test_io.py
└── test_physics.py
Это src-layout: пакет расположен в каталоге src/. Существует и плоский вариант (flat layout), при котором beamtool/ лежит в корне репозитория; для небольших проектов допустим и он. Преимущество src-layout заключается в том, что пакет нельзя случайно импортировать из рабочего каталога, минуя установку, и тесты проверяют именно то, что получит пользователь.
Сырые данные с установки в репозиторий не помещают: git плохо переносит гигабайты бинарных файлов, а история изменений для них бессмысленна. Данные хранятся на сервере или дисках группы, в репозитории остаются путь к ним в конфигурации и небольшие файлы-образцы для тестов (tests/data/). Каталоги data/, .venv/, __pycache__/ и файлы *.log необходимо добавить в .gitignore до первого коммита, иначе в историю попадут два гигабайта данных.
Виртуальные окружения и зависимости
Системным Python пользуются все программы на машине, и обновление библиотеки ради одного проекта нарушает работу другого. Поэтому у каждого проекта должно быть своё виртуальное окружение — набор пакетов, изолированный от системного.
cd beamtool
python -m venv .venv
source .venv/bin/activate # в Windows: .venv\Scripts\activate
pip install numpy matplotlib
Окружение является расходным материалом: повреждённое окружение удаляется вместе с каталогом .venv и создаётся заново за минуту. Это работает только при условии, что список зависимостей хранится в репозитории. Способов записать его два.
Классический способ — файл requirements.txt, список, передаваемый команде pip install -r requirements.txt.
numpy==2.1.3
matplotlib==3.9.2
Современный способ — секция dependencies в pyproject.toml, едином файле с метаданными проекта (он рассматривается в разделе про упаковку). Для нового проекта предпочтительнее pyproject.toml; requirements.txt остаётся как точный слепок собранного окружения.
Режимов закрепления версий два. В библиотеке, устанавливаемой другими, версии ограничивают мягко (numpy>=2.0), чтобы не конфликтовать с чужими зависимостями. В приложении для обработки данных важнее воспроизводимость: pip freeze > requirements.txt фиксирует всё окружение до последней цифры, что позволяет через год пересоздать его и повторить расчёт из статьи. Обновление той же scipy иногда изменяет численные результаты в последних знаках, а для науки это является основанием зафиксировать версии жёстко.
Вместо связки venv + pip можно использовать менеджер проектов, poetry или uv. Они выполняют те же действия: окружение, зависимости и lock-файл с точными версиями, но одной командой и с автоматическим разрешением конфликтов; uv, написанный на Rust, к тому же работает на порядок быстрее pip. Начинать следует с venv и pip, чтобы понимать механику, а переход на менеджеры целесообразен тогда, когда становится ясно, какую рутину они устраняют.
Точки входа
Модуль должен переживать импорт без побочных эффектов: при import beamtool.cli ничего не должно вычисляться, отрисовываться и записываться на диск. Исполняемый код закрывается стандартной конструкцией:
if __name__ == "__main__":
main()
Переменная __name__ равна "__main__" только у файла, запущенного как программа, а не импортированного. Это уже входило в наши требования к коду; следующий шаг — интерфейс командной строки, чтобы параметры передавались аргументами, а не правкой исходника. В стандартной библиотеке для этого предусмотрен модуль argparse:
"""Интерфейс командной строки beamtool."""
import argparse
from pathlib import Path
import numpy as np
def parse_args() -> argparse.Namespace:
"""Разбирает аргументы командной строки."""
parser = argparse.ArgumentParser(
prog="beamtool",
description="Обработка осциллограмм: базовая линия, пик, заряд.",
)
parser.add_argument(
"--input", type=Path, required=True,
help="входной CSV-файл с колонками time, voltage",
)
parser.add_argument(
"--output", type=Path, required=True,
help="файл для записи результатов",
)
parser.add_argument(
"--plot", action="store_true",
help="показать график после обработки",
)
parser.add_argument(
"--baseline-points", type=int, default=100,
help="сколько первых точек считать базовой линией",
)
return parser.parse_args()
def main() -> None:
"""Точка входа приложения."""
args = parse_args()
time, voltage = np.loadtxt(
args.input, delimiter=",", skiprows=1, unpack=True)
# Базовая линия — среднее по первым точкам до прихода сигнала.
baseline = voltage[:args.baseline_points].mean()
signal = voltage - baseline
peak_index = int(np.argmax(signal))
area = float(np.trapezoid(signal, time))
np.savetxt(
args.output,
[[time[peak_index], signal[peak_index], area]],
delimiter=",",
header="peak_time,peak_voltage,area",
)
if args.plot:
# Ленивый импорт: без --plot matplotlib даже не загружается,
# и скрипт работает на сервере без дисплея.
from beamtool.plotting import show_signal
show_signal(time, signal, peak_index)
if __name__ == "__main__":
main()
Запуск: python -m beamtool.cli --input shot_042.csv --output results.csv --plot. Команда заработает после установки пакета в окружение (pip install -e ., см. раздел про упаковку); до установки при src-layout запуск осуществляется командой PYTHONPATH=src python -m beamtool.cli …. Дополнительно предоставляется --help: argparse самостоятельно генерирует справку, проверяет обязательные аргументы и приводит типы к объявленным. Пользователю не требуется открывать код, а значит, он не сможет случайно его повредить.
Для интерфейсов с подкомандами (как git commit, git push) существуют сторонние библиотеки click и typer, решающие ту же задачу декораторами и аннотациями типов. Однако argparse из стандартной библиотеки достаточно на долгое время, и он всегда доступен.
Конфигурация
Магические числа и пути в коде являются основным источником хаоса в лабораторных скриптах. Порог дискриминатора, частота дискретизации АЦП, путь к данным меняются от запуска к запуску и, будучи зашитыми в исходник, требуют правки кода. История в git превращается в набор записей «поменял порог обратно», а воспроизводимость теряется, потому что никто не помнит, с какими параметрами получен график из статьи.
Код отвечает на вопрос «как считать», конфигурация — «что и с какими параметрами». Вынесенные параметры помещают в конфигурационный файл; удобным форматом является TOML, читаемый стандартной библиотекой (Python 3.11+).
# configs/default.toml
[detector]
sampling_rate_hz = 2.5e9 # частота дискретизации АЦП
impedance_ohm = 50.0
[analysis]
baseline_points = 100 # точек на оценку базовой линии
peak_threshold_v = 0.05 # порог отбора событий
import tomllib
with open("configs/default.toml", "rb") as f:
config = tomllib.load(f)
threshold = config["analysis"]["peak_threshold_v"]
YAML устроен аналогично (требуется пакет pyyaml); достаточно выбрать один формат и придерживаться его. Конфигурация в репозитории образует историю параметров обработки: видно, кем, когда и на сколько сдвинут любой порог.
Для того, что зависит от конкретной машины или является секретным, используют переменные окружения:
import os
data_dir = os.environ.get("BEAMTOOL_DATA_DIR", "/data/beam")
Пароли и токены, например доступ к базе данных группы (о них в главе про базы данных), не попадают ни в код, ни в git. Допустимы только переменные окружения или локальный файл .env, добавленный в .gitignore. Общепринятый приоритет источников: значения по умолчанию → конфигурационный файл → переменные окружения → аргументы командной строки; каждый следующий уровень перекрывает предыдущий.
Логирование вместо print
print пригоден для кратковременной отладки. Далее возникают проблемы: отладочный вывод, разбросанный по коду, нельзя отключить, не удаляя его; у сообщений нет ни времени, ни уровня важности; всё уходит в консоль и исчезает вместе с закрытым окном. Когда же ночная обработка останавливается с ошибкой на 3742-м файле из 5000, необходим журнал, сохранивший, что происходило, с какими файлами и когда.
Всё это обеспечивает logging из стандартной библиотеки. У сообщений пять уровней (DEBUG, INFO, WARNING, ERROR, CRITICAL) и глобальный порог, определяющий, что показывать. Настройка, пишущая одновременно в консоль и в файл:
import logging
logger = logging.getLogger(__name__)
def setup_logging(logfile: str = "beamtool.log") -> None:
"""Включает вывод логов в консоль и в файл одновременно."""
logging.basicConfig(
level=logging.INFO,
format="%(asctime)s %(levelname)-8s %(name)s: %(message)s",
handlers=[
logging.StreamHandler(),
logging.FileHandler(logfile, encoding="utf-8"),
],
)
Использование в коде:
logger.info("Загружен файл %s: %d точек", path, n_points)
logger.warning("Пик ниже порога %.3f В, файл пропущен", threshold)
logger.error("Не удалось разобрать файл %s", path, exc_info=True)
getLogger(__name__) в каждом модуле создаёт именованный логгер, и в журнале видно, какой модуль пишет. Флаг --verbose в CLI может понижать порог до DEBUG, не затрагивая код: вызовы logger.debug остаются в программе всегда, а при пороге INFO их записи даже не создаются. exc_info=True добавляет к сообщению полный traceback, так что наутро в журнале обнаружится не только «файл пропущен», но и причина.
Журнал службы, который читают не только люди, но и программы, записывают структурированно — одной строкой JSON на событие с полями времени, уровня и идентификатора запроса. Такой журнал, смена порога без перезапуска и журнал systemd рассмотрены в главе «Наблюдаемость».
Обработка ошибок
Главным принципом научного кода является fail fast: при обнаружении некорректных данных программа должна останавливаться сразу и явно. Тихий NaN проходит через все стадии обработки и превращается в правдоподобный, но неверный график. Остановившуюся программу исправляют; красивую кривую с ошибкой отправляют в статью.
Python сообщает об ошибках исключениями, и разработчик может определять собственные: это обычные классы, наследуемые от Exception.
import numpy as np
class BeamtoolError(Exception):
"""Базовый класс ошибок beamtool."""
class InvalidSignalError(BeamtoolError):
"""Сигнал не пригоден для обработки."""
def find_peak(signal: np.ndarray) -> int:
"""Возвращает индекс максимума сигнала."""
if signal.size == 0:
raise InvalidSignalError("пустой сигнал")
if not np.all(np.isfinite(signal)):
raise InvalidSignalError("в сигнале есть NaN или inf")
return int(np.argmax(signal))
Собственные классы отделяют ожидаемые ошибки от дефектов кода. На верхнем уровне, в main(), перехватывается except BeamtoolError, и некорректный файл в пачке из тысячи оказывается штатной ситуацией: запись в журнал и переход к следующему. KeyError или TypeError, напротив, означают дефект в самом коде; такое исключение должно пройти наружу с полным traceback, чтобы его исправили.
Худшее, что можно сделать с исключением, — подавить его:
# Так делать нельзя: ошибка исчезает бесследно,
# а в результатах молча появляется дыра.
try:
result = process(path)
except Exception:
pass
Исключение следует перехватывать только там, где известно, что с ним делать, а в остальных местах не перехватывать.
Тесты
Научному коду тесты необходимы в большей степени, чем сайтам и мессенджерам. Главный риск здесь не «программа остановилась с ошибкой», а «программа выдала правдоподобное, но неверное число». Особенно опасны рефакторинги формул: выражение «слегка упростили», потеряли двойку в знаменателе, все результаты сместились, а код работает без единой ошибки. Тесты фиксируют поведение, и любое изменение, сдвинувшее численный результат, обнаруживается немедленно, что является защитой от регрессий.
Стандартом де-факто является pytest: тесты лежат в tests/test_*.py, называются test_* и состоят из обычных assert. Рассмотрим функцию из beamtool:
# src/beamtool/physics.py
ELECTRON_REST_ENERGY_MEV = 0.511
def lorentz_gamma(kinetic_energy_mev: float) -> float:
"""Возвращает лоренц-фактор по кинетической энергии электрона."""
if kinetic_energy_mev < 0:
raise ValueError("кинетическая энергия отрицательна")
return 1.0 + kinetic_energy_mev / ELECTRON_REST_ENERGY_MEV
И тесты к ней:
# tests/test_physics.py
import pytest
from beamtool.physics import lorentz_gamma
def test_gamma_at_rest():
# Покоящийся электрон: гамма-фактор равен единице.
assert lorentz_gamma(0.0) == pytest.approx(1.0)
def test_gamma_one_mev():
assert lorentz_gamma(1.0) == pytest.approx(2.9569, abs=1e-4)
def test_negative_energy_rejected():
with pytest.raises(ValueError):
lorentz_gamma(-1.0)
Команда pytest в корне проекта самостоятельно находит и выполняет все тесты. Сравнивать float через == нельзя из-за ошибок округления в последних знаках; pytest.approx сравнивает с заданным допуском, абсолютным (abs=) или относительным (rel=).
В первую очередь тестируют функции-формулы на входах с известным ответом (аналитические пределы, симметрии, законы сохранения), парсеры форматов данных на файлах-образцах из tests/data/, граничные случаи (пустой сигнал, один отсчёт, отрицательная энергия). Для численных методов решатель прогоняют на упрощённой задаче с аналитическим решением и сравнивают результаты.
Типизация
Аннотации типов присутствовали во всех примерах выше:
def rebin(spectrum: np.ndarray, factor: int = 2) -> np.ndarray:
"""Огрубляет спектр, суммируя соседние каналы."""
n_bins = spectrum.size // factor * factor
return spectrum[:n_bins].reshape(-1, factor).sum(axis=1)
Во время выполнения Python их не проверяет: аннотации представляют собой документацию, читаемую машиной. Редактор подсказывает атрибуты и обнаруживает опечатки, а статический анализатор mypy командой mypy src/ находит несоответствия до запуска: в одном месте передан str вместо Path, в другом функция может вернуть None, а вызывающий код об этом не знает. Аннотировать имеет смысл хотя бы функции публичного интерфейса пакета, а mypy добавить в CI рядом с линтерами.
Документация
Docstring у каждой публичной функции сообщает, что она делает, что принимает, что возвращает и в каких единицах (перепутанные мэВ и МэВ не обнаружит ни один тайпчекер). README в корне репозитория отвечает на три вопроса: что это за проект, как его установить, как запустить, и содержит один работающий пример команды; это первое, что увидит коллега, и часто единственное, что он прочтёт. Когда проект вырастает, из docstring'ов и markdown-файлов собирают сайт документации при помощи mkdocs или sphinx; документация хранится в том же репозитории и обновляется вместе с кодом, а не в отдельном текстовом документе на сетевом диске.
Упаковка и распространение
Центральным файлом современного Python-проекта является pyproject.toml.
[project]
name = "beamtool"
version = "0.1.0"
description = "Обработка осциллограмм с датчиков пучка"
requires-python = ">=3.11"
dependencies = [
"numpy>=2.0",
"matplotlib>=3.9",
]
[project.scripts]
beamtool = "beamtool.cli:main"
[build-system]
requires = ["setuptools>=68"]
build-backend = "setuptools.build_meta"
Установка в окружение в режиме разработки:
pip install -e .
Флаг -e (editable) устанавливает пакет ссылкой на рабочий каталог, и правки видны сразу, без переустановки. После установки работают импорты from beamtool.physics import ... из любого места, в том числе из тестов. Секция [project.scripts] создаёт в окружении консольную команду, и функция main() из cli.py вызывается как beamtool --input shot_042.csv --output results.csv.
Коллегам из группы достаточно git-репозитория: pip install git+https://github.com/mygroup/beamtool устанавливает пакет со всеми объявленными зависимостями. Команда python -m build собирает wheel-файл в dist/, который можно приложить к релизу на GitHub или передать на машину без интернета. Публикация на PyPI через twine upload (или uv publish) требуется, когда инструментом предполагают пользоваться незнакомые автору люди; для внутренних инструментов группы она не обязательна.
Рост приложения в систему
Всё сказанное выше относится к одному инструменту, выполняющему одну функцию. Рано или поздно возникает задача, которую одним инструментом не решить, например провести эксперимент целиком: выставить токи магнитов, дождаться стабилизации, снять показания с десятка датчиков, вычислить результат, определить дальнейшее направление, повторить, и так сотни раз подряд, ночью, без человека у пульта.
Такую программу нельзя писать «плоско». Рассмотрим, как устроена библиотека SCAUT, оркеструющая эксперименты на линейном ускорителе инжектора ЦКП «СКИФ». Она согласованно управляет всеми компонентами установки, от магнитов до детекторов.
Ключевой идеей является разделение на слои: процедура сканирования обращается к оборудованию только через слой абстракции, а тот — к протоколу только через слой коммуникации; нижний слой о верхних не знает. Данные и анализ подключаются к процедуре сканирования: она сохраняет результаты и вызывает функции анализа через обработчики событий.
Интерфейс эксперимента что именно сканируем и в каких пределах
│
Управление сканированием планировщик точек, обработчики событий, обработка аварий
│ │
│ ├── Данные сериализация, метаданные эксперимента, хранилище
│ └── Анализ визуализация, статистика, постобработка
│
Абстракция оборудования «мотор» и «датчик» — независимо от того, какой прибор стоит за ними
│
Коммуникация EPICS, Tango, OPC UA — или расчётная модель вместо оборудования
Наиболее ценной границей является абстракция оборудования. Верхние слои оперируют понятиями «мотор» (нечто, принимающее заданное значение) и «датчик» (нечто, у чего значение можно запросить). Что стоит за мотором, источник питания квадруполя, шаговый двигатель экрана или регулятор фазы СВЧ, для процедуры сканирования безразлично. Добавление нового прибора не требует правок в логике эксперимента: пишется новый адаптер, и всё выше него остаётся нетронутым.
Ниже расположен слой коммуникации, отделяющий протокол от смысла. Ускорительными комплексами управляют разные системы — EPICS и Tango, а промышленные приборы часто доступны по стандарту OPC UA, — и код эксперимента не должен знать, что находится внизу: в SCAUT протокол задают функции чтения и записи, передаваемые процедуре сканирования. На место реального оборудования можно подставить расчётную модель. Тот же сценарий эксперимента, не изменённый ни в одной строке, прогоняется сначала на модели пучка, а потом на установке. Ошибка в логике сканирования обнаруживается на модели, где она ничего не стоит, а не в смену, где она стоит пучкового времени всей группы.
За то, чтобы результат сохранился после эксперимента, отвечает слой данных. Кроме измерений сохраняются метаданные: когда, кем, при каких настройках и какой версией кода они получены. Без этого через полгода из архива нельзя извлечь ничего, кроме массива чисел неизвестного происхождения.
Процедура сканирования всегда проходит одни и те же шесть этапов:
- Инициализация. Проверить, что оборудование на связи, и запомнить исходные значения управляемых параметров.
- Планирование. Построить последовательность точек в пространстве параметров.
- Выполнение. На каждом шаге выставить параметры и снять данные.
- Обработка событий. Вызвать пользовательские функции анализа.
- Сериализация. Сохранить результаты и метаданные.
- Завершение. Вернуть оборудование в исходное состояние, сформировать отчёт.
Первый и последний пункты выглядят формальностью до первого ночного прогона, прервавшегося на середине. Если инициализация не проверила связь с прибором, эксперимент отработает четыре часа, записав в файл одни нули. Если завершение не выполнилось, магниты остаются на токах последней точки скана, а прибор с монопольным доступом не подключится к следующему запуску, пока соединение удерживает незавершившийся процесс. Поэтому в SCAUT обработка событий, возврат моторов к исходным значениям и сохранение данных выполняются в блоке finally, то есть и после ошибки, и после прерывания пользователем.
Принцип формулируется так: границы проводят там, где ожидаются изменения. Оборудование на установке меняется, поэтому необходим слой его абстракции. Протоколы управления в разных лабораториях разные, отсюда отдельный слой коммуникации. Чаще всего меняется способ анализа данных, и потому анализ, отделённый от сбора, можно переписывать, не затрагивая остального. Слой, за которым ничего не меняется, только мешает, и вводить его «на будущее» не следует.
Слайды к главе. Устройство библиотеки SCAUT, её слои и сканирование с возвратом моторов в блоке
finallyразобраны также в четвёртой части лекции «Разбор реальных кодов»; слайды лекции доступны на сайте книги и в PDF.
Здесь рассмотрено устройство одной программы. Когда она превращается в несколько процессов на разных машинах — экземпляры за балансировщиком, очередь между сбором и обработкой, общая база, — появляются частичные отказы, повторы и согласование данных; им посвящена глава «Системный дизайн».
Чек-лист: скрипт стал приложением
- Код разложен по модулям со смыслом: ввод-вывод, физика, графика, CLI.
-
Проект устанавливается на чистую машину командами
git cloneиpip install -e .. -
Зависимости с версиями записаны в
pyproject.toml, точный слепок собранного окружения можно получить и восстановить. - Запуск не требует открывать исходники, все параметры передаются через аргументы CLI и конфигурационный файл.
- Пути, калибровки и пороги хранятся в конфигурации, а не в коде; секретов в репозитории нет.
-
Вместо
printиспользуетсяlogging, и после ночного прогона остаётся журнал, размеченный временем и уровнями. - Некорректные данные вызывают внятную ошибку сразу, а не тихий NaN, всплывающий в результатах.
-
Ключевые формулы покрыты тестами;
pytestпроходит перед каждым коммитом. -
Публичные функции аннотированы типами и снабжены docstring;
mypyне выдаёт замечаний. - README отвечает на вопросы «что это», «как поставить», «как запустить».
-
Файл
analysis_final_v2_REAL.pyудалён, поскольку версии хранятся в git, а не в именах файлов.
Нет необходимости выполнять всё в первый же вечер. Структура, окружение и git необходимы сразу, они почти ничего не стоят. Конфигурация, логирование и CLI появляются у скрипта, запускаемого чаще раза в неделю. Тесты приходят, как только результатам начинают доверять другие люди. Превращение скрипта в приложение является не событием, а привычкой: вынести константу в конфигурацию, превратить обнаруженный дефект в тест. Сети и хранилище результатов рассматриваются в следующих главах, а собственный сервис и его развёртывание — в главах «Веб-технологии» (сервис на FastAPI и nginx перед ним) и «Docker» (Compose и обратный посредник nginx), в разборе «Асинхронное API для кинотеатра» и в главе «Системный дизайн».
Задание. Довести чужой недописанный проект до состояния, в котором его можно развернуть: «Деплой стартапа „Котики в мир“».
Компьютерные сети
Разбираться в сетях физику приходится потому, что почти любые данные, необходимые для работы, сегодня получаются через сеть. Установка отдаёт телеметрию по TCP, каталог наблюдений находится за HTTP-интерфейсом, расчёт запускается на кластере по SSH, а результаты отправляются на сервер группы. Когда что-либо из этого перестаёт работать, место разрыва быстро находит тот, кто представляет путь от программы до провода.
В настоящей главе рассматривается устройство сети ниже прикладного уровня: слои и адреса, маршрутизация, транспортные протоколы UDP и TCP, контроль перегрузок и средства проверки каждого уровня. Прикладные протоколы — система доменных имён, HTTP и TLS — и работа с сетью из Python рассмотрены в следующей главе, «Веб-технологии».
Вызов requests.get('https://api.example.org/runs', timeout=5) выглядит как одна операция, однако за ним стоят пять шагов на разных уровнях сети, и каждый из них может завершиться ошибкой.
| Шаг | Протокол | Чем проверить |
|---|---|---|
имя api.example.org превращается в IP-адрес | DNS | dig, запрос к DNS поверх HTTPS |
| ядро выбирает маршрут к этому адресу | IP | ip route get, tracepath |
| открывается соединение с портом 443 сервера | TCP | ss, tcpdump |
| поверх соединения устанавливается шифрованный канал | TLS | openssl, curl -v |
| по каналу уходит запрос и приходит ответ | HTTP | curl -v, requests |
Представление о пути запроса целиком позволяет отличить отсутствие маршрута от неразрешённого имени, закрытый порт от ошибки сервера и медленный канал от медленной программы. Маршрут и соединение TCP рассматриваются в настоящей главе, разрешение имени, шифрование и обмен по HTTP — в главе «Веб-технологии».
Листинги главы выполнены на одной машине — виртуальной машине под Ubuntu 24.04 с ядром Linux 6.8, iproute2 6.1, tcpdump 4.99 и Python 3.12, на которой записаны демонстрации лекции «Введение в веб»; выводы опыта с CUBIC и BBR взяты из записи этой демонстрации. Учебные сети построены внутри машины из сетевых пространств имён и получают адреса из диапазонов, отведённых для документации, а серверы слушают петлевой адрес 127.0.0.1, поэтому на другой машине выводы те же, кроме времени, случайных номеров портов, адресов MAC и номеров последовательности.
Слайды к главе. Материал этой главы и главы «Веб-технологии» изложен также в лекции «Введение в веб» (слои и адреса, маршрутизация, транспорт, DNS, HTTP и TLS, клиент на Python, собственный сервис) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Сетевые модели: OSI и TCP/IP
Слайды к главе. Слои сети, инкапсуляция заголовков, адреса IPv4 и IPv6, MAC-адреса и ARP изложены также в первой части лекции «Введение в веб» с демонстрацией учебной сети из двух узлов; слайды лекции доступны на сайте книги и в PDF.
Сеть устроена слоями. Каждый слой решает свою узкую задачу и пользуется услугами слоя, лежащего ниже, ничего не зная о его внутреннем устройстве. Приложение формулирует задачу «отправить эти байты на такой-то адрес» и не учитывает ни маршрутов, ни того, медный там кабель или оптика. Благодаря такому разделению Wi-Fi был изобретён без переписывания браузеров и протокола IP.
Классическая модель OSI, созданная как эталонная, насчитывает семь уровней. В таблице указан и уровень более компактной модели TCP/IP, к которому относится каждый из них.
| № | Уровень OSI | Чем занимается | Уровень TCP/IP | Единица данных |
|---|---|---|---|---|
| 7 | Прикладной | протоколы приложений: HTTP, DNS, SSH | прикладной | сообщение |
| 6 | Представления | кодировки, сжатие, шифрование | прикладной | сообщение |
| 5 | Сеансовый | управление сеансами связи | прикладной | сообщение |
| 4 | Транспортный | доставка между процессами: TCP, UDP, QUIC | транспортный | сегмент TCP, датаграмма UDP |
| 3 | Сетевой | адресация и маршрутизация между сетями: IP, ICMP | межсетевой | пакет |
| 2 | Канальный | передача между соседними узлами: Ethernet, Wi-Fi | сетевого доступа | кадр |
| 1 | Физический | биты через провод или эфир | сетевого доступа | бит |
Названия единиц данных представляют собой устоявшееся соглашение, а не часть стандарта: в модели OSI единица любого уровня называется блоком данных протокола этого уровня, а в спецификации IP (RFC 791) пакет называется датаграммой.
Интернет построен по модели TCP/IP из четырёх уровней: сетевого доступа (в RFC 1122 он называется канальным, link layer), межсетевого, транспортного и прикладного. Физический и канальный уровни OSI в ней объединены в первый, а три верхних слиты в один прикладной. Протоколы стека TCP/IP разнесены по уровням OSI условно: стек создавался параллельно с моделью и в неё в точности не укладывается; так, TLS шифрует данные приложения, но работает поверх TCP и целиком не помещается ни на один уровень. Далее мы рассмотрим уровни этой модели снизу вверх.
Инкапсуляция
Каждый уровень добавляет к данным свой заголовок. HTTP-запрос приложения становится полезной нагрузкой сегмента TCP, в заголовке которого записаны порты, номера последовательности и флаги. Сегмент вкладывается в пакет IP с адресами отправителя и получателя и счётчиком TTL, а пакет — в кадр Ethernet с MAC-адресами соседних узлов и контрольной суммой FCS в конце.
┌──────────┬──────┬───────┬───────────────────┬─────┐
│ Ethernet │ IP │ TCP │ HTTP: GET /runs … │ FCS │
└──────────┴──────┴───────┴───────────────────┴─────┘
└ данные приложения ┘
└─────── сегмент TCP ───────┘
└──────────── пакет IP ────────────┘
└────────────────── кадр Ethernet ──────────────────┘
Получатель снимает заголовки в обратном порядке. Маршрутизатор на пути разбирает только кадр и пакет: он отбрасывает старый кадр, строит новый для следующего участка и уменьшает TTL на единицу, а заголовок TCP и данные не трогает. Поэтому MAC-адреса меняются на каждом участке пути, а IP-адреса отправителя и получателя сохраняются до тех пор, пока их вместе с портами TCP не подменит трансляция адресов NAT, рассмотренная ниже.
Уровень сетевого доступа
Самый нижний уровень отвечает на вопрос «как физически доставить биты соседнему узлу».
Физический уровень
Средой передачи здесь являются витая пара и коаксиальный кабель, оптоволокно (одномодовое для дальних линий, многомодовое для коротких), радио в виде Wi-Fi по стандарту 802.11, Bluetooth и сотовой связи. Уровень преобразует единицы и нули в сигнал и обратно.
Среду передачи характеризуют скорость, полоса пропускания, затухание сигнала и помехоустойчивость. Проблемы на этом уровне: перебитый кабель, наводка от силового шкафа, некачественно обжатый коннектор, растянутый сверх нормы сегмент. В лаборатории они дают заметную долю жалоб на медленную сеть, поэтому диагностику начинают снизу, с проверки физического подключения: при отсоединённом кабеле ip link показывает у интерфейса флаг NO-CARRIER — отсутствие несущей.
Канальный уровень
Уровнем выше принятые биты собираются в кадры (frames) и передаются между устройствами, находящимися внутри одной локальной сети. Здесь работают Ethernet (стандарт IEEE 802.3) и Wi-Fi (IEEE 802.11), а для соединений «точка-точка» — PPP.
У каждого сетевого интерфейса есть 48-битный MAC-адрес. У физической сетевой карты его задаёт производитель (первые три байта образуют код производителя), у виртуальных интерфейсов — пар veth, мостов, контейнеров и виртуальных машин — он выбирается случайно, а современные операционные системы при подключении к Wi-Fi часто подставляют случайный адрес вместо заводского. Программа знает IP-адрес получателя, а кадр отправляется на MAC-адрес следующего узла: самого получателя, если он находится в той же сети, иначе шлюза. Соответствие между адресами выясняет протокол ARP: узел рассылает широковещательный вопрос «у кого адрес 192.0.2.20?» и запоминает ответ в таблице соседей. В IPv6 ту же задачу решает протокол обнаружения соседей NDP. В институтских сетях встречается VLAN, представляющая собой логическое разделение одной физической сети на независимые сегменты, не видящие друг друга, чтобы, например, сеть управления установкой не пересекалась с офисной.
Состояние этого уровня позволяют просмотреть следующие команды.
ip -br link # интерфейсы, их состояние и MAC-адреса
ip -s link show eth0 # счётчики кадров, в том числе ошибки и отброшенные
ethtool eth0 # скорость, дуплекс, наличие несущей
ethtool -S eth0 # подробная статистика драйвера
ip neigh # таблица соседей: IP-адреса и MAC-адреса
Утилиты ifconfig, arp и netstat из пакета net-tools устарели, и современные дистрибутивы, в том числе Ubuntu, по умолчанию их не устанавливают: их заменяют ip и ss из пакета iproute2. Имя eth0 в примерах условно; в современных дистрибутивах интерфейсы называются по расположению устройства, например enp0s1 или ens3.
Учебная сеть из двух узлов
Рассмотрим работу канального уровня на учебной сети, для которой достаточно одной машины. Сетевое пространство имён представляет собой механизм ядра Linux, дающий процессам собственный набор интерфейсов, адресов и маршрутов (см. главу «Внутреннее устройство Linux»); оно играет роль отдельной машины, а пара виртуальных интерфейсов veth соединяет два пространства подобно кабелю. Адреса взяты из диапазона 192.0.2.0/24, отведённого для документации, поэтому учебная сеть не пересекается с настоящей. Здесь и далее команды, создающие пространства имён и перехватывающие пакеты, выполняются от имени root, например в оболочке, открытой командой sudo -i; ключ -n a команды ip и префикс ip netns exec a выполняют команду в пространстве a.
$ cat lan.sh
# Два узла одной сети: пространства имён a и b, соединённые парой veth
ip netns add a
ip netns add b
ip link add va netns a type veth peer name vb netns b
ip -n a addr add 192.0.2.10/24 dev va
ip -n b addr add 192.0.2.20/24 dev vb
ip -n a link set va up
ip -n b link set vb up
$ sh lan.sh
$ ip -n a -br link
lo DOWN 00:00:00:00:00:00 <LOOPBACK>
va@if2 UP c2:4a:45:2f:6e:af <BROADCAST,MULTICAST,UP,LOWER_UP>
$ ip -n a -br addr
lo DOWN
va@if2 UP 192.0.2.10/24 fe80::c04a:45ff:fe2f:6eaf/64
$ ip netns exec a ping -c 2 192.0.2.20
PING 192.0.2.20 (192.0.2.20) 56(84) bytes of data.
64 bytes from 192.0.2.20: icmp_seq=1 ttl=64 time=0.081 ms
64 bytes from 192.0.2.20: icmp_seq=2 ttl=64 time=0.080 ms
--- 192.0.2.20 ping statistics ---
2 packets transmitted, 2 received, 0% packet loss, time 1008ms
rtt min/avg/max/mdev = 0.080/0.080/0.081/0.000 ms
$ ip -n a neigh
192.0.2.20 dev va lladdr b2:b5:3f:8e:8d:30 REACHABLE
В пространстве a есть только петлевой интерфейс lo и конец пары va со случайным MAC-адресом; кроме адреса 192.0.2.10/24, у него есть локальный адрес IPv6, который интерфейс назначил себе сам. Эхо-запрос ping до соседа проходит за десятую долю миллисекунды, а после него в таблице соседей появляется MAC-адрес узла b, полученный по ARP. Пространство имён удаляется командой ip netns del a вместе со своими интерфейсами; процессы, запущенные в нём, перед этим необходимо завершить.
Сетевой уровень
Канальный уровень доставляет кадры только внутри одной локальной сети. Чтобы достичь машины, находящейся в другом городе, необходим уровень выше, сетевой, с главным протоколом IP.
IP задаёт адреса интерфейсов и формат пакета. Каждый узел на пути пересылает пакет дальше по своей таблице маршрутов, а заполняют таблицы администратор или протоколы маршрутизации, например OSPF внутри организации и BGP между организациями. Сообщения о недоставке и эхо-запросы ping передаёт сопутствующий протокол ICMP.
Адресация IPv4
IPv4 задаёт 32-битный адрес, записываемый четырьмя десятичными октетами, например 192.0.2.10. Всего таких адресов около четырёх миллиардов, и они давно распределены. Отсюда трансляция адресов (NAT) в большинстве домашних и многих институтских сетей: машины внутри получают частные адреса, а наружу выходят под общим публичным адресом маршрутизатора, который подменяет в пакетах адрес и порт отправителя. Провайдеры добавляют к этому ещё и общий NAT на адресах 100.64.0.0/10. Долгосрочным решением служит IPv6.
Запись вида 192.0.2.0/24 называется префиксом. Число после косой черты — длина префикса, то есть количество старших битов адреса, отведённых под номер сети; оставшиеся биты нумеруют узлы. Сеть 192.0.2.0/24 содержит 256 адресов, различающихся последним октетом, но узлам из них можно назначить 254: первый адрес обозначает саму сеть, а последний служит широковещательным. Модуль ipaddress стандартной библиотеки позволяет выполнять арифметику адресов и префиксов.
import ipaddress
net = ipaddress.ip_network('192.0.2.0/24')
print(net.num_addresses, net.netmask, net.broadcast_address)
print(len(list(net.hosts())), ipaddress.ip_address('192.0.2.200') in net)
print(ipaddress.ip_address('192.0.2.10').is_private, ipaddress.ip_address('192.0.2.10').is_global)
addr = ipaddress.ip_address('2001:0db8:85a3:0000:0000:8a2e:0370:7334')
print(addr)
print(addr.exploded)
256 255.255.255.0 192.0.2.255
254 True
True False
2001:db8:85a3::8a2e:370:7334
2001:0db8:85a3:0000:0000:8a2e:0370:7334
Часть диапазонов зарезервирована для особых целей.
| Диапазон | Назначение |
|---|---|
10.0.0.0/8 (16,7 млн адресов), 172.16.0.0/12 (1 млн), 192.168.0.0/16 (65 536) | частные сети (RFC 1918): в интернете не маршрутизируются и повторяются в разных организациях |
100.64.0.0/10 | общий NAT провайдера (RFC 6598) |
127.0.0.0/8 | петлевой интерфейс, сама машина |
169.254.0.0/16 | локальные адреса канала, которые узел назначает себе сам, не получив адреса (RFC 3927) |
192.0.2.0/24, 198.51.100.0/24, 203.0.113.0/24 | примеры в документации (RFC 5737) |
RFC 1918 не закрепляет диапазоны за организациями определённого размера; домашние маршрутизаторы обычно берут подсеть из последнего. Адреса документации не встречаются в настоящих сетях, поэтому именно они выбраны для учебных сетей этой главы. Атрибут is_private модуля ipaddress истинен не только для диапазонов RFC 1918, но и для петлевых адресов, адресов документации и других диапазонов, которые реестр IANA относит к неглобальным: адрес 192.0.2.10 в выводе выше он тоже назвал частным.
Адресация IPv6
IPv6 решает проблему нехватки адресов. Адрес занимает 128 бит и записывается восемью группами по четыре шестнадцатеричные цифры, например 2001:0db8:85a3:0000:0000:8a2e:0370:7334. Ведущие нули в каждой группе опускаются, а одну непрерывную цепочку нулевых групп заменяет двойное двоеточие, и записанный выше адрес превращается в 2001:db8:85a3::8a2e:370:7334, как в выводе ipaddress. Двойное двоеточие допускается в адресе один раз, иначе запись стала бы неоднозначной; канонический вид — строчные буквы и самая длинная цепочка нулевых групп, заменённая на ::, — установлен RFC 5952. Для документации отведён префикс 2001:db8::/32 (RFC 3849), петлевой адрес записывается как ::1, локальные адреса канала начинаются с fe80::, а аналогом частных сетей служат уникальные локальные адреса fc00::/7 (RFC 4193).
Маршрутизация
Слайды к главе. Таблица маршрутов, выбор самого длинного префикса, правила маршрутизации и диагностика пути изложены также во второй части лекции «Введение в веб» с демонстрацией учебной сети с маршрутизатором; слайды лекции доступны на сайте книги и в PDF.
Маршрутизация отвечает на вопрос «куда отправить принятый пакет дальше». Каждый узел, включая рабочий компьютер, хранит таблицу маршрутов и для каждого пакета выбирает подходящую строку.
Таблица маршрутов
Строка таблицы сопоставляет префикс сети со способом доставки: напрямую через интерфейс, если сеть к нему подключена, или через шлюз, которым является соседний маршрутизатор. Так выглядит таблица узла a учебной сети, построенной в конце раздела:
$ ip -n a route
default via 192.0.2.1 dev va
192.0.2.0/24 dev va proto kernel scope link src 192.0.2.10
198.51.100.128/25 via 192.0.2.254 dev va
Из всех строк, под которые подходит адрес, выбирается строка с самым длинным префиксом, а при равной длине — с меньшей метрикой. Маршрут default, он же 0.0.0.0/0, подходит под любой адрес и срабатывает последним. Пакет к соседу 192.0.2.20 уходит прямо в интерфейс va, пакет к 198.51.100.200 подходит под /25 и уходит через шлюз 192.0.2.254, хотя маршрут по умолчанию тоже подходит, а всё остальное уходит через 192.0.2.1. Какой маршрут ядро выберет для конкретного адреса, показывает ip route get; пакетов команда не отправляет.
$ ip -n a route get 198.51.100.200
198.51.100.200 via 192.0.2.254 dev va src 192.0.2.10 uid 0
cache
$ ip -n a route get 198.51.100.10
198.51.100.10 via 192.0.2.1 dev va src 192.0.2.10 uid 0
cache
Когда сервер соседнего корпуса не отвечает, а машины своей комнаты доступны, проверку начинают с ip route get и адреса сервера: команда показывает, через какой шлюз и интерфейс уйдёт пакет. При маршруте по умолчанию путь формально есть до любой сети, поэтому причиной чаще оказываются неверный шлюз, отсутствие маршрута обратно у удалённой стороны или фильтрация пакетов на пути.
Задача о выборе маршрута
Рассмотрим правило самого длинного префикса на таблице из пяти строк, где префиксы разной длины перекрываются.
default via 192.0.2.1
64.0.0.0/4 via 192.0.2.2
128.0.0.0/1 via 192.0.2.19
192.0.2.0/25 via 192.0.2.9
192.0.2.48 via 192.0.2.17
Префикс /n задаёт число старших битов, которые должны совпасть с адресом, поэтому для каждого адреса найдём все подходящие строки и выберем из них самую длинную.
| Адрес | Подходящие строки | Выбранная строка |
|---|---|---|
| 192.0.2.48 | default, /1, /25, /32 | 192.0.2.48 via 192.0.2.17: точный адрес |
| 192.0.2.100 | default, /1, /25 | 192.0.2.0/25 via 192.0.2.9 |
| 200.1.2.3 | default, /1 | 128.0.0.0/1 via 192.0.2.19 |
| 10.1.1.1 | default | default via 192.0.2.1 |
Строка 192.0.2.48 без длины префикса означает маршрут к одному узлу, /32, конкретнее любого другого. Адрес 192.0.2.100 подходит и под 128.0.0.0/1, поскольку первый октет 192 в двоичной записи равен 11000000 и начинается с единицы, и под 192.0.2.0/25, охватывающую адреса от 0 до 127 в последнем октете; выбирается более длинный префикс /25. Адрес 200.1.2.3 тоже начинается с единичного бита и уходит по строке /1, а 10.1.1.1 не подходит ни под одну строку, кроме default. Префикс 64.0.0.0/4 охватывает адреса от 64.0.0.0 до 79.255.255.255: четыре старших бита адреса должны совпасть с 0100, — и ни один из четырёх адресов под него не подходит. Проверить ответы позволяет само ядро: запишем ту же таблицу в пространство имён q с интерфейсом-заглушкой dummy и спросим ip route get.
$ cat quiz.sh
# Таблица маршрутов задачи о выборе маршрута в пространстве имён q
ip netns add q
ip -n q link add d0 type dummy
ip -n q addr add 192.0.2.10/24 dev d0
ip -n q link set d0 up
ip -n q route add default via 192.0.2.1
ip -n q route add 64.0.0.0/4 via 192.0.2.2
ip -n q route add 128.0.0.0/1 via 192.0.2.19
ip -n q route add 192.0.2.0/25 via 192.0.2.9
ip -n q route add 192.0.2.48 via 192.0.2.17
$ sh quiz.sh
$ ip -n q route
default via 192.0.2.1 dev d0
64.0.0.0/4 via 192.0.2.2 dev d0
128.0.0.0/1 via 192.0.2.19 dev d0
192.0.2.0/25 via 192.0.2.9 dev d0
192.0.2.0/24 dev d0 proto kernel scope link src 192.0.2.10
192.0.2.48 via 192.0.2.17 dev d0
$ for a in 192.0.2.48 192.0.2.100 200.1.2.3 10.1.1.1; do ip -n q route get $a | head -1; done
192.0.2.48 via 192.0.2.17 dev d0 src 192.0.2.10 uid 0
192.0.2.100 via 192.0.2.9 dev d0 src 192.0.2.10 uid 0
200.1.2.3 via 192.0.2.19 dev d0 src 192.0.2.10 uid 0
10.1.1.1 via 192.0.2.1 dev d0 src 192.0.2.10 uid 0
К пяти строкам задачи ядро добавило шестую, 192.0.2.0/24: сеть, подключённую к интерфейсу d0. На ответы она не влияет, поскольку у адресов 192.0.2.48 и 192.0.2.100 есть более длинные подходящие префиксы.
Правила и несколько таблиц
Таблица маршрутов в Linux не одна. Какую использовать для конкретного пакета, определяют правила маршрутизации; так выглядят правила по умолчанию в новом пространстве имён:
$ ip -n q rule
0: from all lookup local
32766: from all lookup main
32767: from all lookup default
Правила просматриваются по возрастанию номера приоритета — меньший номер означает более высокий приоритет. Сначала пакет ищется в таблице local с адресами самой машины, затем в main — обычной таблице, которую показывает ip route, — и в пустой таблице default. Поэтому правило самого длинного префикса действует внутри одной таблицы: пакет на собственный адрес машины уходит в петлевой интерфейс по таблице local, хотя в main есть маршрут по умолчанию.
Для машины в двух разных подсетях достаточно одной таблицы main. Отдельные таблицы и правила нужны, когда путь зависит не только от адреса назначения, но и от адреса отправителя, входящего интерфейса или метки пакета. Типичный случай — компьютер на установке, подключённый к институтской сети и к сети управления: ответы с адреса сети установки должны уходить через её шлюз. По маршруту по умолчанию они ушли бы в институтскую сеть, и её фильтры отбросили бы их как пакеты с чужим адресом отправителя. Скрипт rule.sh строит такую машину в пространстве имён p с двумя интерфейсами-заглушками:
$ cat rule.sh
# Машина в двух сетях: институтской 192.0.2.0/24 и сети установки 203.0.113.0/24
ip netns add p
ip -n p link add inst0 type dummy
ip -n p link add ctl0 type dummy
ip -n p addr add 192.0.2.10/24 dev inst0
ip -n p addr add 203.0.113.10/24 dev ctl0
ip -n p link set inst0 up
ip -n p link set ctl0 up
ip -n p link set lo up
ip -n p route add default via 192.0.2.1
# пакеты с адреса сети установки — через её шлюз, по отдельной таблице 100
ip -n p route add default via 203.0.113.1 table 100
ip -n p rule add from 203.0.113.0/24 lookup 100
$ sh rule.sh
$ ip -n p rule
0: from all lookup local
32765: from 203.0.113.0/24 lookup 100
32766: from all lookup main
32767: from all lookup default
$ ip -n p route get 198.51.100.7
198.51.100.7 via 192.0.2.1 dev inst0 src 192.0.2.10 uid 0
cache
$ ip -n p route get 198.51.100.7 from 203.0.113.10
198.51.100.7 from 203.0.113.10 via 203.0.113.1 dev ctl0 table 100 uid 0
cache
$ ip -n p route get 192.0.2.10
local 192.0.2.10 dev lo table local src 192.0.2.10 uid 0
cache <local>
Пакет к адресу 198.51.100.7 по умолчанию уходит через институтский шлюз, а тот же пакет с адресом отправителя из сети установки — через шлюз 203.0.113.1 по таблице 100; пакет на собственный адрес 192.0.2.10 попадает в таблицу local и уходит в lo. Таким образом, путь пакета определяет не только адрес назначения, но и правило, выбравшее таблицу.
Диагностика пути
Когда маршрут есть, а пакеты не доходят, необходимо выяснить, где они теряются. Команда ping проверяет доступность адресата и измеряет время туда и обратно. Каждый маршрутизатор уменьшает поле TTL пакета на единицу и отбрасывает пакет, когда оно доходит до нуля, сообщая об этом отправителю сообщением ICMP. На этом основаны traceroute и tracepath: они отправляют пакеты с растущим TTL и перечисляют узлы пути. Утилита traceroute в современных дистрибутивах часто не установлена; tracepath из пакета iputils работает без прав root и заодно определяет MTU — наибольший размер пакета, проходящего участок без фрагментации. Утилита mtr делает то же непрерывно и подсчитывает потери на каждом узле.
ip route get 198.51.100.10 # какой маршрут выберет ядро; пакеты не отправляются
ping -c 4 198.51.100.10 # доступность и время туда и обратно
tracepath -n 198.51.100.10 # узлы пути и MTU пути
mtr -n -r -c 100 198.51.100.10 # отчёт по 100 пробам на каждом узле
Значение TTL в ответе ping тоже информативно: Linux отправляет пакеты с TTL 64, и ответ с ttl=63 означает один маршрутизатор на пути. Отчёт mtr позволяет показать сетевым администраторам, на каком переходе начинается разрыв; значимы при этом потери, сохраняющиеся до последнего узла. Потери только на промежуточном маршрутизаторе обычно означают, что он ограничивает частоту ответов ICMP, а не теряет транзитные пакеты.
Учебная сеть с маршрутизатором
Скрипт net.sh строит три пространства имён: узел a в сети 192.0.2.0/24, узел b в сети 198.51.100.0/24 и маршрутизатор r с интерфейсами в обеих сетях. Маршрутизатором r делает параметр ядра net.ipv4.ip_forward, разрешающий пересылку пакетов между интерфейсами.
$ cat net.sh
# Две сети и маршрутизатор r между ними: 192.0.2.0/24 и 198.51.100.0/24
for ns in a r b; do ip netns add $ns; done
ip link add va netns a type veth peer name ra netns r
ip link add vb netns b type veth peer name rb netns r
ip -n a addr add 192.0.2.10/24 dev va
ip -n r addr add 192.0.2.1/24 dev ra
ip -n r addr add 198.51.100.1/24 dev rb
ip -n b addr add 198.51.100.10/24 dev vb
for d in "a va" "r ra" "r rb" "b vb"; do ip -n ${d% *} link set ${d#* } up; done
ip netns exec r sysctl -qw net.ipv4.ip_forward=1
ip -n b route add default via 198.51.100.1
$ sh net.sh
$ ip -n a route
192.0.2.0/24 dev va proto kernel scope link src 192.0.2.10
$ ip netns exec a ping -c 1 198.51.100.10
ping: connect: Network is unreachable
$ ip -n a route add default via 192.0.2.1
$ ip netns exec a ping -c 2 198.51.100.10
PING 198.51.100.10 (198.51.100.10) 56(84) bytes of data.
64 bytes from 198.51.100.10: icmp_seq=1 ttl=63 time=0.099 ms
64 bytes from 198.51.100.10: icmp_seq=2 ttl=63 time=0.108 ms
--- 198.51.100.10 ping statistics ---
2 packets transmitted, 2 received, 0% packet loss, time 1051ms
rtt min/avg/max/mdev = 0.099/0.103/0.108/0.004 ms
$ ip netns exec a tracepath -n 198.51.100.10
1?: [LOCALHOST] pmtu 1500
1: 192.0.2.1 0.066ms
1: 192.0.2.1 0.006ms
2: 198.51.100.10 0.010ms reached
Resume: pmtu 1500 hops 2 back 2
$ ip -n a route add 198.51.100.128/25 via 192.0.2.254
В таблице узла a сначала есть только подключённая сеть, поэтому ping до 198.51.100.10 сразу завершается сообщением Network is unreachable: ядро не знает, куда отправить пакет. После добавления маршрута по умолчанию через r ответ приходит с ttl=63 — на один маршрутизатор меньше начальных 64, а tracepath показывает путь из двух узлов и MTU 1500. Более конкретный маршрут 198.51.100.128/25 через 192.0.2.254 действует для адресов от .128 до .255, а 198.51.100.10 по-прежнему уходит через маршрут по умолчанию; шлюза 192.0.2.254 в сети нет, и ip route get этого не замечает, поскольку пакетов не отправляет. Таблица узла a после последней команды и выбор маршрута для адресов 198.51.100.200 и 198.51.100.10 приведены в начале раздела.
Транспортный уровень
Слайды к главе. Порты и сокеты, UDP и TCP, рукопожатие в перехвате tcpdump и контроль перегрузок с опытом CUBIC и BBR на линии с потерями изложены также в третьей части лекции «Введение в веб» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
IP доставляет пакет до машины, однако на ней работают десятки программ. Какой из них предназначены данные, указывает номер порта — первая задача транспортного уровня. Вторая — надёжность доставки; здесь выбирают из двух протоколов в зависимости от того, что дороже: потеря данных или задержка.
Порты и сокеты
Порт представляет собой 16-битное число от 1 до 65 535. Сервер слушает известный порт: 22 — SSH, 53 — DNS, 80 и 443 — HTTP и HTTPS, 5432 — PostgreSQL. Порты ниже 1024 считаются привилегированными: в Linux занять их по умолчанию может только процесс root или процесс с правом CAP_NET_BIND_SERVICE, а границу задаёт параметр ядра net.ipv4.ip_unprivileged_port_start. Клиенту ядро выдаёт временный порт из диапазона net.ipv4.ip_local_port_range, а параметр net.ipv4.tcp_syn_retries задаёт число повторов запроса на соединение.
$ sysctl net.ipv4.ip_local_port_range net.ipv4.ip_unprivileged_port_start net.ipv4.tcp_syn_retries
net.ipv4.ip_local_port_range = 32768 60999
net.ipv4.ip_unprivileged_port_start = 1024
net.ipv4.tcp_syn_retries = 6
Соединение TCP однозначно задаётся четвёркой: адрес и порт клиента, адрес и порт сервера. Поэтому к одному порту сервера одновременно подключаются тысячи клиентов: их соединения различаются адресами и временными портами. Программа работает с соединением через сокет, представляющий собой объект ядра, которому в процессе соответствует файловый дескриптор, а в Python — объект socket.socket. Сокет бывает и без IP: локальный сокет AF_UNIX представлен файлом, и через него, например, клиент PostgreSQL по умолчанию подключается к серверу на той же машине.
Чтобы проверить, слушает ли программа порт, достаточно команды ss -tln; с ключом -p она показывает и процессы, которым принадлежат сокеты (процессы других пользователей видны только с sudo). Адрес 127.0.0.1 в колонке Local Address означает, что сервер доступен только с самой машины, 0.0.0.0 — со всех её интерфейсов IPv4. Для встроенного в Python веб-сервера, который раздаёт каталог www с файлом hello.txt и слушает петлевой адрес, вывод выглядит так; знак & запускает сервер в фоне, а останавливается он командой kill с номером задания, например kill %1:
$ python3 -m http.server 8000 --bind 127.0.0.1 --directory www >/dev/null 2>&1 &
$ ss -tln 'sport = :8000'
State Recv-Q Send-Q Local Address:Port Peer Address:PortProcess
LISTEN 0 5 127.0.0.1:8000 0.0.0.0:*
Попытка соединения может завершиться двумя разными ошибками, и различие между ними позволяет определить, где искать причину. Если порт не слушает ни один процесс, ядро адресата сразу отвечает сегментом RST, и клиент получает отказ Connection refused. Если же пакеты по пути или на входе адресата отбрасывает межсетевой экран, ответа нет вовсе, и попытка завершается по тайм-ауту; без явного ограничения ядро Linux повторяет запрос на соединение шесть раз с удваивающейся паузой, начиная с 1 с, то есть около двух минут. Воспроизведём оба случая на учебной сети из двух узлов, построенной скриптом lan.sh: на узле b запустим сервер на порту 8000, а межсетевому экрану nftables поручим отбрасывать пакеты к порту 8001. Клиент conn.py по очереди соединяется с портами 8000, 8001 и 8002 узла b, ограничив ожидание двумя секундами.
import socket
for port in (8000, 8001, 8002):
try:
with socket.create_connection(('192.0.2.20', port), timeout=2) as s:
print(port, 'соединение', s.getsockname(), '->', s.getpeername())
except OSError as err:
print(port, type(err).__name__, err)
$ cat fw.sh
# Узел b из lan.sh: сервер на порту 8000, порт 8001 закрыт межсетевым экраном
ip netns exec b python3 -m http.server 8000 --bind 192.0.2.20 >/dev/null 2>&1 &
ip netns exec b nft add table inet fw
ip netns exec b nft add chain inet fw input '{ type filter hook input priority 0; }'
ip netns exec b nft add rule inet fw input tcp dport 8001 drop
$ sh fw.sh
$ ip netns exec a python3 conn.py
8000 соединение ('192.0.2.10', 57004) -> ('192.0.2.20', 8000)
8001 TimeoutError timed out
8002 ConnectionRefusedError [Errno 111] Connection refused
Вывод показывает и четвёрку соединения: клиент получил от ядра временный порт, а сервер принял соединение на порту 8000. Порт 8001 не ответил за отведённые 2 с, порт 8002 сразу ответил отказом. Таким образом, отказ указывает на адресата, у которого порт никто не слушает, а тайм-аут — на фильтр по пути или на входе адресата.
UDP: быстро и без гарантий
UDP не устанавливает соединения, не подтверждает доставку, не следит за порядком приходящих датаграмм и не борется с перегрузками. Датаграмма может потеряться, прийти дважды или обогнать предыдущую, и протокол об этом не узнает.
Зато у UDP минимальные накладные расходы и задержка. Поэтому на нём работают запросы DNS (повторить запрос проще, чем поддерживать соединение; большие ответы и передача зон идут по TCP), голосовая и видеосвязь, онлайн-игры. Потерянный фрагмент там уже не нужен: пока его запрашивают повторно, разговор уходит вперёд. Видео по запросу и большинство трансляций, напротив, передаются по HTTP поверх TCP или QUIC. На UDP построен и сам QUIC, транспорт HTTP/3, заново реализующий надёжную доставку и шифрование. Для физика существенно, что о потере пакетов телеметрии UDP не сообщает: пропуски выявляет только номер пакета, записанный в самих данных.
TCP: надёжно, но дороже
TCP доставляет поток байтов в исходном порядке, без пропусков и дубликатов либо сообщает приложению об ошибке: соединение разрывается по тайм-ауту или сбрасывается сегментом RST. Ценой являются установление соединения, подтверждения, повторные передачи и контроль перегрузок. 16-битная контрольная сумма TCP пропускает часть искажений, поэтому целостность важных данных проверяют на уровне приложения: средствами TLS или хешем файла.
Соединение открывается тройным рукопожатием:
- клиент отправляет серверу сегмент
SYNсо своим случайным начальным номером последовательности x; - сервер отвечает сегментом
SYN-ACK— своим начальным номером y и подтверждением x + 1; - клиент подтверждает его сегментом
ACK, и соединение установлено.
В сегментах SYN и SYN-ACK стороны сообщают и параметры соединения: наибольший размер сегмента MSS, множитель окна, поддержку выборочных подтверждений SACK и метки времени. Данные клиент отправляет сразу после SYN-ACK, вместе с подтверждением или следом за ним, поэтому рукопожатие обходится в одно время туда и обратно (RTT); этой задержки нет у UDP. TCP Fast Open (RFC 7413) при повторных соединениях передаёт данные уже в SYN, а QUIC совмещает установление соединения с рукопожатием TLS.
Гарантии TCP обеспечивают поля его заголовка; в скобках указана длина поля в битах.
| Порт отправителя (16) | Порт получателя (16) |
| Номер последовательности (32) |
| Номер подтверждения (32) |
| Смещение (4) | Резерв (4) | Флаги (8) | Окно (16) |
| Контрольная сумма (16) | Указатель срочности (16) |
| Параметры: MSS, множитель окна, SACK, метки времени (0–320) |
Номер последовательности является номером первого байта сегмента в потоке. Номер подтверждения — номер следующего ожидаемого байта: всё, что идёт до него, получено. Окно сообщает, сколько ещё байтов готов принять получатель с учётом множителя из параметров (RFC 7323), и тем самым управляет потоком. Отправитель держит в пути не больше меньшего из двух окон: окна получателя и собственного окна перегрузки, рассмотренного ниже. Смещение данных — длина заголовка в 32-битных словах, от 20 до 60 байт. Флаги отмечают назначение сегмента: SYN — установление соединения, ACK — подтверждение, PSH — данные, которые получатель передаёт приложению без задержки, FIN — закрытие, RST — сброс.
Закрывается соединение сегментами FIN с каждой стороны. Сторона, закрывшая соединение первой, ещё 60 с держит его в состоянии TIME_WAIT, чтобы запоздавшие сегменты не попали в новое соединение с той же четвёркой адресов и портов.
Различия двух транспортных протоколов сведены в таблицу.
| Свойство | UDP | TCP |
|---|---|---|
| соединение | нет | рукопожатие перед данными |
| доставка | без гарантий | подтверждения и повторы |
| порядок | не сохраняется | сохраняется |
| единица передачи | датаграмма | поток байтов |
| применение | DNS, голосовая и видеосвязь, QUIC | HTTP/1.1 и HTTP/2, SSH, почта |
Рукопожатие в перехвате tcpdump
Рассмотрим весь обмен в перехвате пакетов. Сервер из раздела о портах продолжает работать. Запрос к нему запишем в файл req.txt: стартовая строка, заголовок Host и пустая строка, каждая строка заканчивается парой символов \r\n (устройство запроса HTTP рассмотрено в главе «Веб-технологии»). Утилита tcpdump записывает в файл сегменты с портом 8000 на петлевом интерфейсе lo, а утилита nc открывает соединение, отправляет файл запроса и выводит ответ, пока сервер не закроет соединение.
$ printf 'GET /hello.txt HTTP/1.1\r\nHost: localhost\r\n\r\n' > req.txt
$ tcpdump -i lo -U -w hs.pcap 'tcp port 8000' 2>/dev/null &
$ nc 127.0.0.1 8000 < req.txt
HTTP/1.0 200 OK
Server: SimpleHTTP/0.6 Python/3.12.3
Date: Sat, 03 Oct 2026 03:51:25 GMT
Content-type: text/plain
Content-Length: 13
Last-Modified: Sat, 03 Oct 2026 03:51:23 GMT
pulse 4.2 mA
$ ss -tan 'sport = :8000'
State Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0 5 127.0.0.1:8000 0.0.0.0:*
TIME-WAIT 0 0 127.0.0.1:8000 127.0.0.1:47054
После остановки перехвата командой kill разберём записанный файл; параметры TCP из строк удалены фильтром sed, чтобы строки умещались на странице.
$ tcpdump -r hs.pcap -nn -t 2>/dev/null | sed -E 's/, options \[[^]]*\]//'
IP 127.0.0.1.47054 > 127.0.0.1.8000: Flags [S], seq 4126516469, win 65495, length 0
IP 127.0.0.1.8000 > 127.0.0.1.47054: Flags [S.], seq 2648559322, ack 4126516470, win 65483, length 0
IP 127.0.0.1.47054 > 127.0.0.1.8000: Flags [.], ack 1, win 512, length 0
IP 127.0.0.1.47054 > 127.0.0.1.8000: Flags [P.], seq 1:45, ack 1, win 512, length 44
IP 127.0.0.1.8000 > 127.0.0.1.47054: Flags [.], ack 45, win 512, length 0
IP 127.0.0.1.8000 > 127.0.0.1.47054: Flags [P.], seq 1:187, ack 45, win 512, length 186
IP 127.0.0.1.47054 > 127.0.0.1.8000: Flags [.], ack 187, win 511, length 0
IP 127.0.0.1.8000 > 127.0.0.1.47054: Flags [P.], seq 187:200, ack 45, win 512, length 13
IP 127.0.0.1.47054 > 127.0.0.1.8000: Flags [.], ack 200, win 511, length 0
IP 127.0.0.1.8000 > 127.0.0.1.47054: Flags [F.], seq 200, ack 45, win 512, length 0
IP 127.0.0.1.47054 > 127.0.0.1.8000: Flags [F.], seq 45, ack 201, win 512, length 0
IP 127.0.0.1.8000 > 127.0.0.1.47054: Flags [.], ack 46, win 512, length 0
Буквы в квадратных скобках — флаги сегмента: S — SYN, . — ACK, P — PSH, F — FIN. Первые три строки составляют рукопожатие: SYN клиента с временного порта, SYN-ACK сервера и ACK клиента. Затем идут запрос с флагом PSH — 44 байта файла req.txt, — его подтверждение сервером, два сегмента ответа — заголовки длиной 186 байт и тело длиной 13 байт — и их подтверждения. Последними идут FIN сервера, который закрывает соединение первым, поскольку встроенный сервер отвечает по HTTP/1.0 и соединение не поддерживает, FIN клиента, подтверждающий FIN сервера, и последнее подтверждение сервера; утилита nc без ключа -N сама соединение не закрывает и ждёт, пока его закроет сервер. Номера seq и ack после рукопожатия tcpdump показывает относительными, отсчитанными от начальных номеров сторон: seq 1:45 означает байты запроса с первого по 44-й, а ack 45 — что сервер получил их все и ожидает 45-й. Команда ss сразу после запроса показывает соединение сервера в состоянии TIME-WAIT: закрыл его первым сервер.
Контроль перегрузок
TCP не знает пропускной способности пути заранее и определяет её опытным путём, регулируя окно перегрузки — объём данных, отправленных без подтверждения. В начале соединения окно растёт вдвое за каждое время туда и обратно; это медленный старт, который продолжается до первой потери или до порога. Дальше алгоритмы различаются:
- Tahoe (1988) после любой потери возвращается к медленному старту с одного сегмента;
- Reno (1990) при трёх повторных подтверждениях вдвое уменьшает окно и продолжает передачу (быстрое восстановление), а к медленному старту возвращается только по тайм-ауту (RFC 5681);
- CUBIC (RFC 9438) после потери уменьшает окно лишь до 0,7 прежнего и наращивает его по кубической функции времени: быстро вдали от прежнего максимума и осторожно вблизи него, независимо от RTT. Это алгоритм по умолчанию в Linux, Windows и системах Apple;
- BBR (Google, 2016) строит модель пути — полосу узкого места и минимальную задержку — и не принимает случайную потерю за признак перегрузки, поэтому выигрывает на длинных путях с потерями. В основной ветке ядра Linux находится первая версия алгоритма; в общем узком месте с малым буфером она вытесняет соседние потоки CUBIC.
Для алгоритмов, уменьшающих окно вдвое при каждой потере, установившуюся скорость позволяет оценить формула Матиса:
$$ v \approx \frac{\mathrm{MSS}}{\mathrm{RTT}} \cdot \frac{C}{\sqrt{p}}, \qquad C = \sqrt{3/2} \approx 1{,}22, $$
где \(p\) — доля потерянных пакетов. Размер сегмента выводится из MTU: 1500 − 20 байт заголовка IP − 20 байт заголовка TCP = 1460 байт, а с метками времени в каждом сегменте — 1448. Оценим скорость для линии с RTT 50 мс и потерями 1 %: при MSS 1448 байт получим 1448 / 0,05 · 1,22 / 0,1 ≈ 353 КБ/с, независимо от полосы канала. Формула является оценкой для Reno и подобных ему алгоритмов, а не пределом скорости любого TCP: опыт ниже показывает BBR при тех же потерях в 25 раз быстрее. Поэтому файл, копируемый между корпусами института медленнее, чем позволяет канал, нередко упирается не в «плохую сеть», а в реакцию алгоритма на редкие потери при большой задержке. Другая частая причина — окно получателя и буферы сокетов меньше произведения полосы на задержку: при 100 Мбит/с и RTT 30 мс в пути должно находиться около 375 КБ данных. Окно перегрузки, RTT и алгоритм каждого соединения показывает команда ss -ti.
Опыт: CUBIC и BBR на линии с потерями
Влияние алгоритма на скорость покажем на учебной линии с задержкой и потерями. Скрипт netem.sh строит цепочку из трёх пространств имён: клиент a в сети 192.0.2.0/24, сервер b в сети 198.51.100.0/24 и маршрутизатор r между ними. Дисциплина очереди netem на интерфейсе r, обращённом к клиенту, задерживает на 50 мс каждый пакет, уходящий к клиенту, и случайно теряет 1 % таких пакетов; в обратную сторону пакеты идут без задержки. Укрупнение пакетов TSO, GSO и GRO на виртуальных интерфейсах выключено, чтобы потеря касалась одного пакета, а не пачки. В пространстве b встроенный сервер раздаёт файл случайных данных размером 8 МиБ.
# Клиент a — маршрутизатор r — сервер b; на r задержка 50 мс и потери 1 %
for ns in a r b; do ip netns add $ns; done
ip link add va netns a type veth peer name ra netns r
ip link add vb netns b type veth peer name rb netns r
ip -n a addr add 192.0.2.10/24 dev va
ip -n r addr add 192.0.2.1/24 dev ra
ip -n r addr add 198.51.100.1/24 dev rb
ip -n b addr add 198.51.100.10/24 dev vb
for d in "a va" "r ra" "r rb" "b vb"; do ip -n ${d% *} link set ${d#* } up
ip netns exec ${d% *} ethtool -K ${d#* } tso off gso off gro off; done
ip netns exec r sysctl -qw net.ipv4.ip_forward=1
ip -n a route add default via 192.0.2.1
ip -n b route add default via 198.51.100.1
tc -n r qdisc add dev ra root netem delay 50ms loss 1%
mkdir -p www && head -c 8M /dev/urandom > www/data.bin
ip netns exec b python3 -m http.server 8000 -d www >/dev/null 2>&1 &
Скрипт get.sh скачивает файл из пространства a и печатает время:
curl -s -o /dev/null -w '%{time_total} с\n' http://198.51.100.10:8000/data.bin
$ sh netem.sh
$ ip netns exec a ping -c 4 -q 198.51.100.10
PING 198.51.100.10 (198.51.100.10) 56(84) bytes of data.
--- 198.51.100.10 ping statistics ---
4 packets transmitted, 4 received, 0% packet loss, time 3009ms
rtt min/avg/max/mdev = 50.148/63.712/101.371/21.750 ms
$ ip netns exec b sysctl net.ipv4.tcp_congestion_control
net.ipv4.tcp_congestion_control = cubic
$ for i in 1 2 3; do ip netns exec a sh get.sh; done
23.651585 с
22.971182 с
25.421624 с
$ ip netns exec b sysctl -w net.ipv4.tcp_congestion_control=bbr
net.ipv4.tcp_congestion_control = bbr
$ for i in 1 2 3; do ip netns exec a sh get.sh; done
0.938207 с
0.904590 с
0.986031 с
Время туда и обратно составило 50 мс; первый эхо-запрос ждал ещё и ответа ARP от r, который netem тоже задержал, поэтому максимум равен 101 мс, а среднее — 64 мс. Алгоритм задаётся у отправителя данных, то есть у сервера в b, параметром net.ipv4.tcp_congestion_control его пространства имён, а новое соединение получает алгоритм, действующий в момент установления. При CUBIC, выбранном в Linux по умолчанию, файл скачивается за 23,0–25,4 с со скоростью 0,33–0,37 МБ/с, в среднем 0,35 МБ/с, — почти точно столько, сколько даёт оценка Матиса, 353 КБ/с: окно уменьшается при каждой потере. BBR при тех же потерях скачивает файл за 0,90–0,99 с со скоростью 8,5–9,3 МБ/с, в среднем в 25 раз быстрее, поскольку окно из-за каждой потери не уменьшает. Таким образом, на линии со случайными потерями скорость определяет не полоса канала, а алгоритм контроля перегрузок. Дисциплину netem и алгоритм BBR реализуют модули ядра sch_netem и tcp_bbr, которые загружаются при первом использовании.
Наблюдение за соединениями
Состояние соединений и сами пакеты показывают следующие команды.
ss -tn # установленные и закрывающиеся соединения TCP
sudo ss -tlnp # слушающие порты и процессы
ss -ti # окно перегрузки, RTT и алгоритм соединений
sudo tcpdump -ni any 'tcp port 443' # все интерфейсы, без разрешения имён
sudo tcpdump -ni eth0 host 192.0.2.20 # обмен с одним узлом
sudo tcpdump -i lo -w dump.pcap 'port 8000' # запись в файл для разбора позже
tcpdump -r dump.pcap -nn -A # чтение файла с выводом содержимого
Ключ -n утилиты tcpdump отключает разрешение адресов в имена, чтобы перехват сам не порождал запросов DNS, а -nn — ещё и номеров портов. Псевдоинтерфейс any слушает все интерфейсы сразу, но без неразборчивого режима. Фильтр на языке BPF отбирает нужное: host, port, tcp, udp и их сочетания через and, or и not. Файл .pcap открывает Wireshark, который позволяет построить графики окна TCP, найти повторные передачи и измерить задержки. Для HTTPS перехват показывает только записи TLS, а содержимое запросов видно лишь в открытом HTTP. Для перехвата необходимы права root, а выполняется он только в своей сети или с разрешения её владельца: пакеты содержат чужие данные.
Резюме
Таким образом, запоминать необходимо не столько детали протоколов, сколько идею слоёв: каждый уровень пользуется услугами нижнего и ничего не знает о его устройстве. Поэтому один и тот же код на requests одинаково работает и по Wi-Fi, и по оптике. Маршрут пакета определяет самый длинный подходящий префикс в таблице, выбранной правилами, а выбор ядра показывает ip route get. TCP обеспечивает надёжную доставку ценой рукопожатия и контроля перегрузок, и на линии со случайными потерями скорость определяет алгоритм контроля перегрузок: BBR сохраняет её там, где CUBIC её теряет.
Когда что-либо не работает, уровни проверяются в порядке цены проверки, а не строго снизу вверх: сначала самое дешёвое и самое частое. Разрешение имени помещено в таблице на второе место по этой причине: оно проверяется одной командой, а нарушается чаще прочего, хотя уровень у него прикладной; DNS рассматривается в главе «Веб-технологии».
| Что проверяем | Уровень | Чем смотреть |
|---|---|---|
| Физическое подключение интерфейса | физический, канальный | ip link, ethtool |
| Разрешение имени | прикладной (DNS) | dig, nslookup |
| Маршрут и прохождение пакетов | сетевой | ip route get, ping, tracepath, mtr |
| Открытый порт и слушающий его процесс | транспортный | ss -tlnp; отказ или тайм-аут соединения |
| Содержимое ответа сервера | прикладной | curl -v; tcpdump — для открытого HTTP и для проверки прохождения пакетов |
Бессмысленно отлаживать код запроса, если имя сервера не разрешается, и проверять DNS, если не поднят сетевой интерфейс.
Упражнения
- Дополнить таблицу задачи о выборе маршрута строкой
192.0.2.64/26 via 192.0.2.33, предсказать маршруты адресов 192.0.2.48, 192.0.2.70 и 192.0.2.100 и проверить предсказание командойip route getв пространстве имён. - Повторить опыт с CUBIC и BBR при задержке 10 мс и потерях 0,1 %, оценить скорость CUBIC по формуле Матиса и сравнить оценку с измеренной.
- Перехватить
tcpdumpрукопожатие запроса HTTPS и найти в нём сообщение ClientHello с именем сервера; устройство TLS рассматривается в главе «Веб-технологии».
Полезные ссылки
- J. Kurose, K. Ross. Computer Networking: A Top-Down Approach, 9-е изд. — Pearson, 2026, учебник по сетям, построенный сверху вниз, от приложений к каналу;
- RFC 9293 (TCP), RFC 5681 (контроль перегрузок TCP) и RFC 9438 (CUBIC), первоисточники по транспортному уровню;
- M. Mathis, J. Semke, J. Mahdavi, T. Ott. The Macroscopic Behavior of the TCP Congestion Avoidance Algorithm // ACM SIGCOMM Computer Communication Review, 1997, т. 27, № 3 — статья с оценкой скорости TCP при потерях;
- N. Cardwell, Y. Cheng, C. S. Gunn, S. H. Yeganeh, V. Jacobson. BBR: Congestion-Based Congestion Control // ACM Queue, 2016, т. 14, № 5 — описание алгоритма BBR;
- страницы руководства ip-route(8), ip-netns(8), tc-netem(8) и tcpdump(1), справочник по командам главы.
Поверх адресов, маршрутов и соединений TCP работают прикладные протоколы — DNS, HTTP и TLS; им и работе с сетью из Python посвящена следующая глава, «Веб-технологии».
Веб-технологии
Почти всё сетевое взаимодействие программ в работе физика происходит на прикладном уровне. Каталог наблюдений и база публикаций отвечают на запросы HTTP данными в JSON, таблица параметров установки нередко существует только как веб-страница, а журнал запусков удобно открыть коллегам в виде небольшого веб-сервиса, к которому они обращаются из своих скриптов.
В настоящей главе рассматриваются прикладные протоколы — система доменных имён, HTTP и TLS — и работа с ними из Python: сокет, библиотеки requests и httpx, скрапинг страниц и обращение к API, а также собственный веб-сервис на FastAPI, перед которым работает nginx. Адреса, маршруты, порты и протокол TCP, поверх которых работают эти протоколы, рассмотрены в главе «Компьютерные сети».
Листинги главы выполнены на той же машине, что и листинги главы «Компьютерные сети», — виртуальной машине под Ubuntu 24.04 с Python 3.12, requests 2.34, httpx 0.28, FastAPI 0.142, uvicorn 0.54, curl 8.5 и nginx 1.31, на которой записаны демонстрации лекции «Введение в веб»; выводы повтора запроса и асинхронных запросов взяты из этих записей. Серверы слушают петлевой адрес 127.0.0.1, поэтому на другой машине выводы те же, кроме времени и случайных номеров портов, а также ответов серверов в интернете. Пример с публичным API INSPIRE-HEP выполнен на рабочем компьютере под Python 3.11 с той же версией requests.
Прикладной уровень
Слайды к главе. DNS и DNS поверх HTTPS, устройство URL, запрос и ответ HTTP, методы и коды состояния, TLS и собственный сертификат изложены также в четвёртой части лекции «Введение в веб» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
На прикладном уровне работают сами программы и их протоколы: DNS переводит имена в адреса, HTTP переносит данные, TLS их шифрует.
DNS: из имён в адреса
Компьютеры адресуют друг друга числами, а люди — именами. Связь между ними обеспечивает система доменных имён (DNS), представляющая собой распределённую базу с иерархией зон. Рассмотрим путь запроса: программа обращается к рекурсивному резолверу: провайдера, институтскому или публичному, например 1.1.1.1. Тот при необходимости опрашивает корневой сервер, получает от него адреса серверов зоны com, от них — адреса серверов домена example.com, и уже авторитетный сервер домена сообщает искомую запись. Ответ кешируется на время TTL, указанное в записи, поэтому повторный запрос резолвер обслуживает из кеша, а изменение записи распространяется не мгновенно, а по мере истечения TTL в кешах.
программа ──► рекурсивный резолвер ──► корневой сервер : серверы зоны com
(кеш на время TTL) ──► сервер зоны com : серверы example.com
──► сервер example.com : запись A
Чаще всего встречаются следующие типы записей.
| Тип | Что содержит |
|---|---|
A / AAAA | адрес IPv4 / IPv6 для имени |
CNAME | псевдоним, отсылающий к другому имени |
MX | почтовые серверы домена с приоритетами |
TXT | произвольный текст; используется для проверки владения доменом и правил почты SPF |
DNS является самым частым источником жалоб «ничего не работает». Прежде чем искать ошибку в собственной программе, необходимо проверить командой dig example.com или nslookup example.com, разрешается ли имя.
Обычные запросы DNS идут по UDP открытым текстом, и любой узел на пути может их прочитать или подменить. DNS поверх HTTPS (DoH) передаёт тот же вопрос внутри HTTPS. Стандартный вид, который используют браузеры, описан в RFC 8484: запрос и ответ передаются двоичным сообщением DNS с типом application/dns-message. Резолверы Cloudflare и Google предлагают, кроме того, собственный формат с ответом в JSON, удобный для программ; воспользуемся им из Python.
import requests
DOH = 'https://1.1.1.1/dns-query'
TYPES = {1: 'A', 5: 'CNAME', 15: 'MX', 28: 'AAAA'}
for name, rtype in [('example.com', 'A'), ('www.github.com', 'A'), ('gmail.com', 'MX')]:
r = requests.get(DOH, params={'name': name, 'type': rtype},
headers={'Accept': 'application/dns-json'}, timeout=5)
r.raise_for_status()
for rec in r.json()['Answer']:
print(rec['name'], rec['TTL'], TYPES[rec['type']], rec['data'])
example.com 252 A 104.20.23.154
example.com 252 A 172.66.147.243
www.github.com 3569 CNAME github.com.
github.com 29 A 140.82.121.4
gmail.com 277 MX 10 alt1.gmail-smtp-in.l.google.com.
gmail.com 277 MX 40 alt4.gmail-smtp-in.l.google.com.
gmail.com 277 MX 20 alt2.gmail-smtp-in.l.google.com.
gmail.com 277 MX 5 gmail-smtp-in.l.google.com.
gmail.com 277 MX 30 alt3.gmail-smtp-in.l.google.com.
В каждой строке — имя, оставшееся время жизни записи в кеше резолвера в секундах, тип и значение. Имя www.github.com оказалось псевдонимом: запись CNAME указывает на github.com, и резолвер сразу добавил его адрес. У gmail.com пять почтовых серверов с приоритетами от 5 до 40; отправитель почты пробует сначала сервер с наименьшим числом.
Сама программа разрешает имя функцией socket.getaddrinfo, которая пользуется тем же механизмом, что и все программы системы: файлом /etc/hosts и резолвером. В отличие от socket.gethostbyname, работающей только с IPv4, она возвращает адреса обоих семейств. В стандартной установке Ubuntu файл /etc/hosts сопоставляет имени localhost только адрес 127.0.0.1, а петлевой адрес IPv6 записан под именем ip6-localhost:
import socket
for name in ('localhost', 'ip6-localhost'):
for family, _, _, _, addr in socket.getaddrinfo(name, 8000, proto=socket.IPPROTO_TCP):
print(name, family.name, addr)
localhost AF_INET ('127.0.0.1', 8000)
ip6-localhost AF_INET6 ('::1', 8000, 0, 0)
URL: адрес ресурса
Адрес, вводимый в браузер, устроен по единой схеме (RFC 3986).
схема://хост:порт/путь?запрос#фрагмент
https://api.example.org:443/v1/runs?limit=10#top
Каждая часть предназначена своему уровню. Схема https означает HTTP поверх TLS. Имя хоста DNS превращает в IP-адрес. Порт указывает транспортному уровню программу, слушающую на сервере, и обычно опускается: для https подразумевается 443, для http — 80. Путь и параметры запроса адресуют конкретный ресурс и передаются серверу. Фрагмент после решётки на сервер не отправляется и нужен только браузеру, чтобы прокрутить страницу к нужному месту. Первая часть называется схемой, а не протоколом, потому что не все адреса относятся к вебу: ftp://ftp.example.org/files, mailto:user@example.org, file:///home/user/data.csv.
Символы, недопустимые в адресе, кодируются процентами: байт записывается знаком % и двумя шестнадцатеричными цифрами, пробел — как %20, а кириллица — байтами своей кодировки UTF-8. В параметрах запроса, собранных по правилам HTML-форм, пробел записывается знаком +; так поступает и requests. Разбор и сборку адресов обеспечивает модуль urllib.parse.
from urllib.parse import quote, urlsplit
import requests
u = urlsplit('https://api.example.org:443/v1/runs?limit=10#top')
print(u.scheme, u.hostname, u.port, u.path, u.query, u.fragment)
print(quote('/data/ток 1.csv'))
req = requests.Request('GET', 'https://api.example.org/v1/runs',
params={'q': 'beam current', 'limit': 10}).prepare()
print(req.url)
https api.example.org 443 /v1/runs limit=10 top
/data/%D1%82%D0%BE%D0%BA%201.csv
https://api.example.org/v1/runs?q=beam+current&limit=10
HTTP: обмен с сервером
На HTTP основано почти всё сетевое взаимодействие программ. Клиент отправляет запрос, сервер отвечает. Состояния между запросами протокол не хранит, каждый запрос самодостаточен. В HTTP/1.1 запрос и ответ представляют собой текст; HTTP/2 (RFC 9113) и HTTP/3 (RFC 9114) передают те же поля в двоичных кадрах, а смысл сообщений у всех версий общий (RFC 9110).
HTTP-запрос и ответ
Запрос состоит из стартовой строки с методом, путём и версией протокола, заголовков вида «имя: значение», пустой строки и необязательного тела. Строки разделяются парой символов CR LF, которые cat -A показывает как ^M$. В HTTP/1.1 обязателен заголовок Host: на одном адресе работает много сайтов, и сервер выбирает нужный по имени. Именно так устроен файл req.txt, созданный командой printf при разборе рукопожатия TCP в главе «Компьютерные сети»; отправим его тому же серверу, который раздаёт каталог www с файлом hello.txt и запущен там же командой python3 -m http.server 8000 --bind 127.0.0.1 --directory www. Утилита nc открывает TCP-соединение с портом 8000 и передаёт файл как есть.
$ cat -A req.txt
GET /hello.txt HTTP/1.1^M$
Host: localhost^M$
^M$
$ nc 127.0.0.1 8000 < req.txt
HTTP/1.0 200 OK
Server: SimpleHTTP/0.6 Python/3.12.3
Date: Sat, 03 Oct 2026 03:51:39 GMT
Content-type: text/plain
Content-Length: 13
Last-Modified: Sat, 03 Oct 2026 03:51:23 GMT
pulse 4.2 mA
Ответ устроен так же: статусная строка с версией и кодом, заголовки, пустая строка и тело, длину которого задаёт Content-Length, здесь — 13 байт. Встроенный сервер отвечает версией HTTP/1.0 на запрос HTTP/1.1 и после ответа закрывает соединение. Ключ -v утилиты curl показывает обмен с обеих сторон: строки со знаком > — отправленный запрос, со знаком < — полученный ответ.
$ curl -sv http://127.0.0.1:8000/nope 2>&1 | grep -E '^[<>] '
> GET /nope HTTP/1.1
> Host: 127.0.0.1:8000
> User-Agent: curl/8.5.0
> Accept: */*
>
< HTTP/1.0 404 File not found
< Server: SimpleHTTP/0.6 Python/3.12.3
< Date: Sat, 03 Oct 2026 03:51:39 GMT
< Connection: close
< Content-Type: text/html;charset=utf-8
< Content-Length: 335
<
Методы
Первое слово запроса — метод, он сообщает серверу, что требуется сделать с ресурсом.
| Метод | Действие | Безопасный | Идемпотентный |
|---|---|---|---|
GET | получить ресурс | да | да |
HEAD | получить только заголовки | да | да |
POST | отправить данные, создать ресурс | нет | нет |
PUT | создать или заменить ресурс целиком | нет | да |
PATCH | изменить часть ресурса | нет | не обязательно |
DELETE | удалить ресурс | нет | да |
Безопасный метод не меняет состояния сервера, поэтому GET и HEAD можно выполнять без опасений, а их ответы разрешено кешировать. Идемпотентный метод при повторе оставляет сервер в том же состоянии, что и один запрос, хотя ответ может отличаться: повторный DELETE того же ресурса получает 404, потому что ресурса уже нет. Поэтому клиенты и посредники автоматически повторяют после обрыва связи только идемпотентные запросы (RFC 9110, разд. 9.2.2). С POST так поступать нельзя: повторённый запрос создаст вторую запись. PATCH идемпотентен, только если так устроен сервер.
Коды состояния
Самым информативным в ответе является трёхзначный код в статусной строке. Достаточно помнить значение первой цифры:
| Код | Смысл | Типичные представители |
|---|---|---|
1xx | информационные | 100 Continue |
2xx | успех | 200 OK, 201 Created, 204 No Content |
3xx | перенаправление или указание взять сохранённую копию | 301 Moved Permanently, 302 Found, 304 Not Modified |
4xx | ошибка клиента | 400 Bad Request, 401 Unauthorized, 403 Forbidden, 404 Not Found, 408 Request Timeout, 422 Unprocessable Content, 429 Too Many Requests |
5xx | ошибка сервера | 500 Internal Server Error, 502 Bad Gateway, 503 Service Unavailable, 504 Gateway Timeout |
Отметим смысл наиболее частых кодов. Код 201 сообщает, что ресурс создан, 204 — что запрос выполнен и тела в ответе нет. При перенаправлении клиент идёт по адресу из заголовка Location, а 304 не перенаправляет: он отвечает на условный запрос и сообщает, что копия, сохранённая у клиента, ещё действительна. Код 401 означает, что требуется аутентификация, а 403 — что доступ запрещён, даже если клиент предъявил свои данные. Код 422 (прежнее название — Unprocessable Entity) означает, что запрос понят, но данные не прошли проверку. Коды 502 и 504 возвращает промежуточный сервер, когда сервер за ним ответил некорректно или не ответил вовсе.
Повтор имеет смысл при временных ошибках — 408, 429, 502, 503, 504 и обрыве соединения — и только для идемпотентных запросов либо запросов с ключом идемпотентности, по которому сервер распознаёт повторённый запрос. Пауза перед повтором растёт экспоненциально и со случайным разбросом, чтобы клиенты, получившие отказ одновременно, не повторяли запросы тоже одновременно, а число попыток ограничено; при 429 и 503 выжидают столько, сколько сервер указал в заголовке Retry-After. Остальные коды 4xx и 5xx, например 400, 404, 422, 500 и 501, требуют исправить запрос или сервер: повтор того же запроса их не устранит. Повторы, ключи идемпотентности и выбор пауз подробно рассматриваются в главе «Системный дизайн».
TLS: буква S в HTTPS
Обычный HTTP передаёт всё открытым текстом, включая пароли и токены, и любой узел на пути видит и может изменить содержимое. Протокол TLS, являющийся преемником SSL, обеспечивает шифрование соединения и проверку подлинности сервера по сертификату. Сертификат связывает имя сайта с открытым ключом и подписан удостоверяющим центром. Клиент проверяет подписи по цепочке промежуточных сертификатов до корневого, которому он доверяет; список доверенных корневых сертификатов поставляется с операционной системой или с библиотекой. Так клиент убеждается, что взаимодействует именно с тем сервером, за который тот себя выдаёт.
Версии SSL 2.0 и 3.0 запрещены (RFC 6176, RFC 7568), TLS 1.0 и 1.1 выведены из употребления в 2021 году (RFC 8996); применяются TLS 1.2 и 1.3. Версия 1.3 (RFC 8446) устанавливает защищённый канал за одно время туда и обратно. Удостоверяющий центр Let's Encrypt выдаёт сертификаты бесплатно и автоматически по протоколу ACME (RFC 8555), поэтому HTTPS стал нормой и для небольших сервисов.
Поверх TLS работают и новые версии HTTP. HTTP/2 передаёт много запросов одновременно в одном соединении, каждый в своём потоке, тогда как HTTP/1.1 в постоянном соединении передаёт их только по очереди. Однако все потоки HTTP/2 идут по одному соединению TCP, и потеря одного сегмента задерживает выдачу приложению всех следующих за ним данных. HTTP/3 работает поверх QUIC на UDP: потоки в нём доставляются независимо друг от друга, а установление соединения совмещено с рукопожатием TLS.
Собственный сертификат
Внутренний сервис лаборатории часто работает с сертификатом, не подписанным публичным центром: самоподписанным или выданным центром сертификации организации. Покажем работу с таким сертификатом на примере: скрипт mkcert.sh создаёт ключ на эллиптической кривой P-256 и самоподписанный сертификат для имени localhost сроком на сутки; владелец и издатель такого сертификата совпадают.
$ cat mkcert.sh
# Самоподписанный сертификат для localhost на сутки
openssl req -x509 -newkey ec -pkeyopt ec_paramgen_curve:P-256 -nodes -days 1 \
-subj /CN=localhost -addext subjectAltName=DNS:localhost \
-keyout key.pem -out cert.pem 2>/dev/null
$ sh mkcert.sh
$ openssl x509 -in cert.pem -noout -subject -issuer -enddate
subject=CN = localhost
issuer=CN = localhost
notAfter=Oct 4 03:48:39 2026 GMT
Команда openssl s_server поднимает TLS-сервер на порту 8443 с простой страницей состояния. Запрос curl без дополнительных параметров завершается с кодом выхода 60: сертификат не подписан ни одним доверенным центром, и проверка подлинности не проходит. Ключ --cacert указывает файл с сертификатом, которому клиент доверяет, и соединение устанавливается: в журнале curl видны версия TLSv1.3, шифр TLS_AES_256_GCM_SHA384, обмен ключами X25519 и владелец сертификата CN=localhost.
$ openssl s_server -accept 8443 -cert cert.pem -key key.pem -www -quiet &
$ curl -s https://localhost:8443/; echo "код выхода $?"
код выхода 60
$ curl -sv --cacert cert.pem https://localhost:8443/ -o /dev/null 2>&1 | grep -E 'SSL connection|subject:|^< HTTP'
* SSL connection using TLSv1.3 / TLS_AES_256_GCM_SHA384 / X25519 / id-ecPublicKey
* subject: CN=localhost
< HTTP/1.0 200 ok
Из Python шифрование добавляется обёрткой поверх обычного сокета. Контекст ssl.create_default_context включает проверку сертификата и имени сервера, а аргумент cafile добавляет к доверенным свой сертификат.
import socket
import ssl
context = ssl.create_default_context(cafile='cert.pem')
with socket.create_connection(('localhost', 8443)) as sock:
with context.wrap_socket(sock, server_hostname='localhost') as tls:
print(tls.version(), tls.cipher()[0])
tls.sendall(b'GET / HTTP/1.1\r\nHost: localhost\r\nConnection: close\r\n\r\n')
reply = b''
while chunk := tls.recv(4096):
reply += chunk
print(reply.split(b'\r\n', 1)[0])
TLSv1.3 TLS_AES_256_GCM_SHA384
b'HTTP/1.0 200 ok'
В requests тот же приём обеспечивает аргумент verify='cert.pem' или переменная окружения REQUESTS_CA_BUNDLE с путём к файлу сертификатов центра организации.
import requests
URL = 'https://localhost:8443/'
try:
requests.get(URL, timeout=5)
except requests.exceptions.SSLError as err:
print(type(err).__name__, 'CERTIFICATE_VERIFY_FAILED' in str(err))
r = requests.get(URL, verify='cert.pem', timeout=5)
print(r.status_code, r.reason)
SSLError True
200 ok
Аргумент verify=False отключает проверку целиком: шифрование остаётся, но защиты от подмены сервера больше нет, и любой узел на пути может выдать себя за сервер. В рабочем коде такая настройка недопустима: для внутреннего сервиса достаточно доверить клиенту конкретный сертификат или центр сертификации организации, как показано выше.
Клиент на Python
Слайды к главе. HTTP через сокет, requests с тайм-аутом и повтором, работа с API, скрапинг страниц и асинхронные запросы httpx изложены также в пятой части лекции «Введение в веб» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Соберём сначала HTTP-запрос вручную: это позволяет увидеть, что протокол представляет собой текст, записанный в открытое TCP-соединение. В дальнейшем достаточно готовых библиотек: requests для обычных запросов и httpx там, где требуется асинхронность.
HTTP через сокет
Функция socket.create_connection открывает соединение, sendall отправляет строки запроса, а recv в цикле читает ответ, пока сервер не закроет соединение. Одного вызова recv недостаточно: он возвращает только те байты, которые уже пришли, а сервер отправляет заголовки и тело отдельными сегментами, как видно в перехвате tcpdump в главе «Компьютерные сети», так что одиночный recv нередко получает одни заголовки. Заголовок Connection: close просит сервер закрыть соединение после ответа; без него сервер HTTP/1.1 держит соединение открытым, и цикл не завершится. Сервер — тот же http.server с файлом hello.txt.
import socket
with socket.create_connection(('127.0.0.1', 8000)) as sock:
sock.sendall(b'GET /hello.txt HTTP/1.1\r\n'
b'Host: localhost\r\n'
b'Connection: close\r\n'
b'\r\n')
reply = b''
while chunk := sock.recv(4096): # b'' означает, что сервер закрыл соединение
reply += chunk
head, body = reply.split(b'\r\n\r\n', 1)
print(head.decode().splitlines()[0])
print(body)
HTTP/1.0 200 OK
b'pulse 4.2 mA\n'
Для полноценного клиента пришлось бы найти конец заголовков, дочитать тело по Content-Length или по блокам при Transfer-Encoding: chunked, учесть кодировку, обработать перенаправления, сжатие и шифрование. Поэтому сокеты остаются для собственных протоколов, например для телеметрии установки или текстовых команд SCPI, которыми управляют осциллографами и генераторами, а HTTP поручают библиотеке.
Библиотека requests
requests берёт на себя соединения, перенаправления, кодировки и разбор JSON. Параметры запроса задаёт словарь params, тело в JSON — аргумент json, а метод raise_for_status превращает ответ с кодом 4xx или 5xx в исключение HTTPError.
import requests
r = requests.get('http://127.0.0.1:8000/hello.txt', timeout=5)
print(r.status_code, r.headers['Content-Type'], r.encoding)
print(r.text, end='')
r = requests.get('http://127.0.0.1:8000/nope', timeout=5)
print(r.status_code, r.reason)
try:
r.raise_for_status()
except requests.HTTPError as err:
print(err)
200 text/plain ISO-8859-1
pulse 4.2 mA
404 File not found
404 Client Error: File not found for url: http://127.0.0.1:8000/nope
Отметим, что аргумент timeout обязателен: по умолчанию requests ждёт ответа сколь угодно долго, и зависший сервер останавливает ночной сбор данных навсегда. Кодировка ISO-8859-1 в выводе выбрана потому, что сервер не указал charset в заголовке Content-Type, а для текстовых типов без charset именно её предписывала прежняя редакция стандарта HTTP/1.1 (RFC 2616); к чему это приводит на русских страницах, показано в разделе о скрапинге.
Объект requests.Session хранит общие заголовки между запросами и переиспользует открытое TCP-соединение, что позволяет выполнить серию обращений к одному серверу заметно быстрее, чем столько же отдельных вызовов requests.get.
Тайм-аут и повтор
Повтор с растущей паузой обеспечивает адаптер сессии с объектом Retry из библиотеки urllib3, на которой построен requests. Адаптер повторяет запрос при сбоях соединения и при кодах из списка status_forcelist, удваивает паузу между попытками и учитывает заголовок Retry-After, которым сервер сообщает, сколько ждать, — по умолчанию для кодов 413, 429 и 503. При backoff_factor=0.5 паузы перед повторами составляют 0, 1, 2 и 4 с; аргумент backoff_jitter добавляет к каждой случайную добавку, а total ограничивает число попыток. По умолчанию Retry повторяет только идемпотентные методы — GET, HEAD, PUT, DELETE, OPTIONS и TRACE, — а POST не повторяет. Для сбора данных подходит, например, Retry(total=5, backoff_factor=0.5, backoff_jitter=0.5, status_forcelist=[408, 429, 502, 503, 504]).
Проверим поведение клиента на ненадёжном сервере. Скрипт flaky.py построен на http.server: путь /data на первые два запроса отвечает 503 Service Unavailable, а /slow отвечает только через 3 с.
"""Ненадёжный сервер: /data дважды отвечает 503, затем 200; /slow отвечает через 3 с."""
import json
import time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
hits = 0
class Handler(BaseHTTPRequestHandler):
def do_GET(self):
global hits
if self.path == "/slow":
time.sleep(3)
if self.path == "/data":
hits += 1
if hits <= 2:
self.send_error(503, "Service Unavailable")
return
body = json.dumps({"pressure_nPa": 41.7, "hits": hits}).encode()
self.send_response(200)
self.send_header("Content-Type", "application/json")
self.send_header("Content-Length", str(len(body)))
self.end_headers()
self.wfile.write(body)
ThreadingHTTPServer(("127.0.0.1", 8000), Handler).serve_forever()
Клиент retry.py сначала запрашивает /slow с тайм-аутом 1 с, а затем /data — через сессию с адаптером Retry, допускающим четыре повтора при коде 503.
"""Клиент с таймаутом и повтором запроса при 503."""
import time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry
URL = "http://127.0.0.1:8000"
try:
requests.get(f"{URL}/slow", timeout=1)
except requests.Timeout as err:
print("таймаут 1 с:", type(err).__name__)
session = requests.Session()
retry = Retry(total=4, backoff_factor=0.5, status_forcelist=[503])
session.mount("http://", HTTPAdapter(max_retries=retry))
start = time.perf_counter()
r = session.get(f"{URL}/data", timeout=2)
print(r.status_code, r.json(), f"за {time.perf_counter() - start:.1f} с")
$ python3 flaky.py 2>server.log &
$ python3 retry.py
таймаут 1 с: ReadTimeout
200 {'pressure_nPa': 41.7, 'hits': 3} за 1.0 с
$ cat server.log
127.0.0.1 - - [02/Oct/2026 12:23:18] code 503, message Service Unavailable
127.0.0.1 - - [02/Oct/2026 12:23:18] "GET /data HTTP/1.1" 503 -
127.0.0.1 - - [02/Oct/2026 12:23:18] code 503, message Service Unavailable
127.0.0.1 - - [02/Oct/2026 12:23:18] "GET /data HTTP/1.1" 503 -
127.0.0.1 - - [02/Oct/2026 12:23:19] "GET /data HTTP/1.1" 200 -
Запрос к /slow прервался исключением ReadTimeout через секунду, вместо того чтобы ждать. Запрос к /data завершился ответом 200 с третьей попытки: первый повтор выполнен сразу, второй — через секунду, и всё заняло около одной секунды; журнал сервера подтверждает два ответа 503 и один 200. Без повтора та же программа завершилась бы ошибкой на первом же отказе. В коде, работающем ночью без присмотра, тайм-аут задаётся у каждого запроса, а временные ошибки повторяются с нарастающей случайной паузой и ограниченным числом попыток — только для идемпотентных запросов, — чтобы временный отказ сервера не стоил ночи работы.
Веб-скрапинг
Не у всякого источника есть интерфейс, удобный для программ. Таблицы параметров установок, архивы наблюдений, списки публикаций и расписания смен часто существуют только как веб-страницы, и данные приходится извлекать разбором разметки.
Библиотека BeautifulSoup
Разбирать HTML регулярными выражениями бесполезно: разметка вложенная и часто некорректная. BeautifulSoup строит из страницы дерево и позволяет искать в нём по тегам, атрибутам и селекторам CSS. Рассмотрим разбор на учебном сайте: каталог site состоит из страницы magnets.html с таблицей токов и полей магнитов канала, журнала смены в каталоге private и файла robots.txt, запрещающего роботам обход этого каталога:
User-agent: *
Disallow: /private/
<!doctype html>
<html lang="ru"><head><meta charset="utf-8"><title>Магнитная система канала</title></head>
<body>
<h1>Магнитная система канала</h1>
<table id="magnets">
<tr><th>Элемент</th><th>Ток, А</th><th>Поле, Тл</th></tr>
<tr><td>QD1</td><td>112.5</td><td>0.214</td></tr>
<tr><td>QF1</td><td>98.0</td><td>0.187</td></tr>
<tr><td>BM1</td><td>410.0</td><td>1.230</td></tr>
<tr><td>QD2</td><td>101.2</td><td>0.193</td></tr>
</table>
<p>Обновлено <span class="date">2026-10-02</span>. <a href="/private/log.html">Журнал смены</a></p>
</body></html>
Скрипт scrape.py сначала читает robots.txt модулем urllib.robotparser стандартной библиотеки, затем загружает страницу с заголовком User-Agent, называющим программу и адрес автора, и разбирает таблицу.
"""Разбор таблицы со страницы с учётом robots.txt."""
from urllib import robotparser
import requests
from bs4 import BeautifulSoup
BASE = "http://127.0.0.1:8000"
AGENT = "phys-dev-scraper/1.0 (student@example.org)"
robots = robotparser.RobotFileParser(BASE + "/robots.txt")
robots.read()
for path in ("/magnets.html", "/private/log.html"):
print(path, "разрешено" if robots.can_fetch(AGENT, BASE + path) else "запрещено")
page = requests.get(BASE + "/magnets.html", headers={"User-Agent": AGENT}, timeout=5)
print("кодировка по заголовку:", page.encoding)
print("как текст:", repr(BeautifulSoup(page.text, "html.parser").title.get_text()[:12]))
soup = BeautifulSoup(page.content, "html.parser") # байты: кодировку берёт из <meta>
print("как байты:", soup.title.get_text())
for tr in soup.select("table#magnets tr")[1:]:
name, current, field = (td.get_text(strip=True) for td in tr.find_all("td"))
print(f"{name:5} {float(current):7.1f} А {float(field):7.3f} Тл")
$ python3 -m http.server 8000 --bind 127.0.0.1 --directory site >/dev/null 2>&1 &
$ python3 scrape.py
/magnets.html разрешено
/private/log.html запрещено
кодировка по заголовку: ISO-8859-1
как текст: 'Ð\x9cагниÑ\x82'
как байты: Магнитная система канала
QD1 112.5 А 0.214 Тл
QF1 98.0 А 0.187 Тл
BM1 410.0 А 1.230 Тл
QD2 101.2 А 0.193 Тл
Страница таблицы разрешена для обхода, журнал смены — запрещён. Сервер не указал charset в заголовке Content-Type, поэтому requests выбрал кодировку ISO-8859-1, и заголовок страницы, разобранный из page.text, превратился в набор знаков; функция repr показывает среди них и непечатаемые управляющие символы вида \x9c. Байты page.content BeautifulSoup декодирует сам, по тегу <meta charset="utf-8"> страницы, и получает правильный заголовок «Магнитная система канала». Таким образом, разбору передают байты, а не текст.
Корректный скрапинг
Скрапингом легко навредить и себе, и чужому серверу. Правила следующие:
- Необходимо ознакомиться с
robots.txt, файлом в корне сайта, где владелец указывает, что разрешено обходить роботам, а что нет. Технически он ничего не запрещает — это договорённость, но нарушать её не принято. - Между запросами необходимы паузы. Сотня запросов в секунду с одного адреса неотличима от атаки и приводит к блокировке; для чужого сайта разумен темп не выше запроса в секунду.
- Программа должна представляться в заголовке
User-Agent, указывая, что это за программа и как связаться с её автором: администратору, читающему журналы, это упрощает работу, а автору снижает вероятность блокировки. - Ошибки должны обрабатываться. Сеть ненадёжна, и код должен переживать тайм-аут,
503и изменившуюся вёрстку, а не завершаться посреди ночного сбора данных. - Скачанное кешируется. Повторный запуск разбора не должен снова загружать те же страницы: так и быстрее, и корректнее по отношению к серверу.
Если у сайта есть API, лучше пользоваться им, а не разбором HTML: вёрстка меняется без предупреждения, объявленный интерфейс — гораздо реже.
Работа с API
Если у источника есть API, взаимодействие ведётся на языке данных: запрос с параметрами, ответ в JSON, оговорённый набор полей вместо вёрстки, переделываемой при каждой смене дизайна. Как сервисы договариваются между собой и что в таком договоре нарушается, когда сервисов становится много, подробно рассмотрено у Клеппмана [16].
Публичные API
Устроены такие интерфейсы одинаково независимо от того, что они отдают, курсы валют, каталог наблюдений или библиографию: адрес сервиса, словарь параметров и, если требуется, ключ доступа. Рассмотрим в качестве примера базу публикаций по физике высоких энергий INSPIRE-HEP, отдающую записи без ключа. Запрос находит статьи коллабораций ATLAS и CMS об открытии бозона Хиггса по их номерам в arXiv, а параметр fields оставляет в ответе только нужные поля.
import requests
API = 'https://inspirehep.net/api/literature'
params = {'q': 'arxiv:1207.7214 or arxiv:1207.7235',
'fields': 'collaborations,publication_info,author_count'}
r = requests.get(API, params=params, timeout=10)
r.raise_for_status()
data = r.json()
print(f"записей: {data['hits']['total']}, размер ответа: {len(r.content)} Б")
for hit in data['hits']['hits']:
meta = hit['metadata']
pub = meta['publication_info'][0]
print(meta['collaborations'][0]['value'], meta['author_count'],
pub['journal_title'], pub['journal_volume'], pub['page_start'], pub['year'])
записей: 2, размер ответа: 2692 Б
ATLAS 2932 Phys.Lett.B 716 1 2012
CMS 2900 Phys.Lett.B 716 30 2012
Без параметра fields одна запись статьи ATLAS со списком из 2932 авторов занимает 1,1 МБ, а с ним ответ на обе статьи — 2,7 КБ. Сервис ограничивает частоту запросов квотой: каждому IP-адресу разрешено 15 запросов за 5 с, а превысивший её клиент получает ответ 429 Too Many Requests. Отклонённые запросы тоже засчитываются в квоту, поэтому после такого ответа выжидают не меньше 5 с. Цикл по тысячам записей замедляют паузой, а постраничную выдачу (параметры size и page) перебирают по одной странице за запрос.
Ключи доступа и OAuth
Многие сервисы выдают доступ только по ключу. Ключ является личным паролем пользователя к сервису, и в коде ему не место: его хранят в переменной окружения или в конфигурации вне репозитория.
Когда речь идёт о личных данных пользователя, простого ключа недостаточно. OAuth описывает схему, при которой пользователь не передаёт программе свой пароль. Вместо него сервис выдаёт ей токен, ограниченный по правам и по времени и отзываемый в любой момент. Токен прикладывается к каждому запросу в заголовке Authorization, и удобнее всего задать его один раз в сессии; адрес архива в примере условный.
import os
import requests
class ApiClient:
def __init__(self, base_url, token):
self.base_url = base_url
self.session = requests.Session()
self.session.headers['Authorization'] = f'Bearer {token}'
def get_runs(self, page=1):
r = self.session.get(f'{self.base_url}/runs', params={'page': page}, timeout=10)
r.raise_for_status()
return r.json()
client = ApiClient('https://archive.example.org/api', os.environ['ARCHIVE_TOKEN'])
runs = client.get_runs(page=2)
Формат JSON
JSON (JavaScript Object Notation) представляет собой текстовый формат обмена данными, почти взаимно однозначно соответствующий словарям и спискам Python: объекты, списки, строки, числа, true, false и null.
import json
record = {'run': 7, 'energy': 5.5, 'currents': [40.1, 39.8], 'ok': True}
text = json.dumps(record) # сериализация: словарь -> строка JSON
print(text)
print(json.loads(text) == record) # десериализация: строка JSON -> словарь
{"run": 7, "energy": 5.5, "currents": [40.1, 39.8], "ok": true}
True
В стандарте JSON нет ни NaN, ни бесконечностей. json.dumps по умолчанию запишет их как NaN и Infinity, однако это уже не JSON, и чужой разборщик на такой строке завершится ошибкой; аргумент allow_nan=False превращает такую запись в исключение у отправителя.
import json
record = {'run': 7, 'pressure': float('nan'), 'note': None}
print(json.dumps(record))
try:
json.dumps(record, allow_nan=False)
except ValueError as err:
print('ValueError:', err)
{"run": 7, "pressure": NaN, "note": null}
ValueError: Out of range float values are not JSON compliant: nan
Пропуски в измерениях надёжнее кодировать явным null. FastAPI по той же причине отвечает кодом 500 на словарь со значением NaN, возвращённый обработчиком, а поле модели Pydantic со значением NaN записывает в ответ как null.
Асинхронные запросы
Скачать тысячу файлов из архива по одному означает тысячу раз дождаться ответа сервера. Почти всё время такой программы уходит на ожидание сети: процессор простаивает, канал загружен на проценты. Асинхронный код держит много запросов в обработке одновременно и разбирает ответы по мере поступления.
Библиотека httpx повторяет интерфейс requests и поддерживает оба режима, синхронный httpx.Client и асинхронный httpx.AsyncClient, так что при переходе код почти не переписывается. Поведение по умолчанию у неё строже: ожидание ограничено 5 с (у requests тайм-аута по умолчанию нет), по перенаправлениям клиент переходит только с аргументом follow_redirects=True, а пул клиента держит не больше 100 соединений. HTTP/2 включается пакетом httpx[http2] и аргументом http2=True.
Оценим выигрыш от асинхронности на сервисе slow.py на FastAPI, отвечающем на каждый запрос через 0,2 с. Ожидание в asyncio.sleep не занимает процессор, поэтому сервис обслуживает много запросов одновременно.
"""Медленный сервис: каждый ответ готовится 0,2 с."""
import asyncio
from fastapi import FastAPI
app = FastAPI()
@app.get("/delay")
async def delay():
await asyncio.sleep(0.2)
return {"ok": True}
Скрипт fetch.py отправляет ему 20 запросов сначала по очереди, а затем асинхронно, не больше десяти одновременно.
"""20 запросов к медленному сервису: по очереди и асинхронно, не больше 10 одновременно."""
import asyncio
import time
import httpx
URL = "http://127.0.0.1:8001/delay"
N = 20
start = time.perf_counter()
with httpx.Client() as client:
codes = [client.get(URL).status_code for _ in range(N)]
print(f"по очереди: {time.perf_counter() - start:.2f} с, ответы {set(codes)}")
async def main():
limit = asyncio.Semaphore(10)
async with httpx.AsyncClient() as client:
async def one():
async with limit:
return (await client.get(URL)).status_code
return await asyncio.gather(*(one() for _ in range(N)))
start = time.perf_counter()
codes = asyncio.run(main())
print(f"асинхронно: {time.perf_counter() - start:.2f} с, ответы {set(codes)}")
$ uvicorn slow:app --port 8001 --log-level warning &
$ python3 fetch.py
по очереди: 4.13 с, ответы {200}
асинхронно: 0.47 с, ответы {200}
По очереди двадцать запросов заняли 4,13 с — двадцать ожиданий по 0,2 с подряд и немного накладных расходов. Асинхронно — 0,47 с: запросы прошли двумя волнами по десять, и каждая заняла около 0,2 с. Таким образом, выигрыш определяется отношением времени ожидания к времени обработки и ограничен семафором.
Параллелизм необходимо ограничивать явно. Сто одновременных запросов ускоряют сбор данных в десятки раз, тысяча выглядит для чужого сервера как атака. Ограничение требуется и самому клиенту: запрос, ждущий свободного соединения из пула дольше тайм-аута, завершается исключением httpx.PoolTimeout. Так, из 800 запросов, одновременно запущенных без семафора к сервису с задержкой ответа 1 с, ответ получили около 300, а около 500 завершились этим исключением. Семафор устраняет обе проблемы: лишние задачи ждут у семафора, а не в пуле соединений.
Последний стабильный выпуск httpx — 0.28.1 (декабрь 2024 года). В 2026 году сопровождение проекта под именем httpx2 приняла компания Pydantic; интерфейс сохранён, а Starlette 1.7 уже рекомендует httpx2 для своего тестового клиента. Устройство async и await рассматривается в главе «Асинхронность».
Собственный веб-сервис
Слайды к главе. REST, сервис на FastAPI с проверкой данных, документация /docs и nginx перед приложением изложены также в шестой части лекции «Введение в веб» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Собственный веб-сервис необходим, когда данные или расчёт должны быть доступны другим программам: журнал запусков установки, архив измерений, расчёт по запросу. Коллеги читают такой журнал из своих скриптов, а не просят выгрузку.
REST: ресурсы и методы
Распространённым стилем таких интерфейсов является REST: ресурс задаётся существительным в пути, например /runs и /runs/2, действие — методом HTTP, а результат — кодом состояния. Для журнала запусков интерфейс выглядит так:
| Запрос | Действие | Ответ |
|---|---|---|
POST /runs | создать запуск | 201 Created |
GET /runs?min_energy=3 | список с фильтром | 200 OK |
GET /runs/2 | один запуск | 200 или 404 |
PUT /runs/2 | заменить запуск целиком | 200 или 404 |
DELETE /runs/2 | удалить запуск | 204 No Content или 404 |
Такой интерфейс понятен без документации и одинаково вызывается из Python, curl и браузера. Обращение к несуществующему запуску возвращает 404, поэтому повторный DELETE отвечает иначе, чем первый, но остаётся идемпотентным: состояние сервера после него то же. В разделе «Одна задача в четырёх хранилищах» главы «Работа с базами данных» те же четыре операции — чтение, добавление, замена и удаление — реализованы для учебного списка записей поверх четырёх хранилищ; журнал запусков здесь хранится в SQLite.
Сервис на FastAPI
FastAPI позволяет построить веб-сервис из обычных функций Python с аннотациями типов. Декоратор связывает функцию с методом и путём, параметры пути и строки запроса извлекаются по аннотациям функции, а тело запроса описывается моделью Pydantic с типами и ограничениями полей: энергия пучка положительна, ток неотрицателен. Если пришедшие данные не проходят проверку, FastAPI сам отвечает кодом 422 со списком ошибок, и функция не вызывается. Рассмотрим журнал запусков целиком:
"""Журнал запусков установки: REST-сервис на FastAPI поверх SQLite."""
import sqlite3
from fastapi import FastAPI, HTTPException, Response
from pydantic import BaseModel, Field
app = FastAPI(title="Журнал запусков")
DB = "runs.db"
def sql(query, args=()):
"""Один запрос в своей транзакции: commit при успехе, rollback при ошибке."""
con = sqlite3.connect(DB)
try:
with con:
cur = con.execute(query, args)
return cur.fetchall(), cur.lastrowid, cur.rowcount
finally:
con.close()
sql("CREATE TABLE IF NOT EXISTS runs (id INTEGER PRIMARY KEY, energy REAL, current REAL)")
class Run(BaseModel):
energy: float = Field(gt=0, description="энергия пучка, МэВ")
current: float = Field(ge=0, description="ток пучка, мА")
def as_dict(r):
return {"id": r[0], "energy": r[1], "current": r[2]}
@app.post("/runs", status_code=201)
def create(run: Run):
_, new_id, _ = sql("INSERT INTO runs (energy, current) VALUES (?, ?)", (run.energy, run.current))
return {"id": new_id, **run.model_dump()}
@app.get("/runs")
def runs(min_energy: float = 0):
rows, _, _ = sql("SELECT * FROM runs WHERE energy >= ?", (min_energy,))
return [as_dict(r) for r in rows]
@app.get("/runs/{run_id}")
def one(run_id: int):
rows, _, _ = sql("SELECT * FROM runs WHERE id = ?", (run_id,))
if not rows:
raise HTTPException(404, "нет такого запуска")
return as_dict(rows[0])
@app.put("/runs/{run_id}")
def replace(run_id: int, run: Run):
_, _, n = sql("UPDATE runs SET energy = ?, current = ? WHERE id = ?", (run.energy, run.current, run_id))
if n == 0:
raise HTTPException(404, "нет такого запуска")
return {"id": run_id, **run.model_dump()}
@app.delete("/runs/{run_id}", status_code=204)
def delete(run_id: int):
_, _, n = sql("DELETE FROM runs WHERE id = ?", (run_id,))
if n == 0:
raise HTTPException(404, "нет такого запуска")
return Response(status_code=204)
Каждая операция с базой открывает своё соединение SQLite и выполняет запрос в рамках отдельной транзакции: блок with con фиксирует её при успехе и откатывает при исключении. Обычные, не асинхронные, обработчики FastAPI выполняет в пуле потоков, поэтому отдельное соединение на каждый запрос безопасно и при параллельных запросах. Приложение запускает сервер ASGI uvicorn; аргумент app:app означает объект app из модуля app.py. Проверим сервис из curl; переменные U и J сокращают команды.
$ uvicorn app:app --port 8000 >uv.log 2>&1 &
$ U=localhost:8000/runs; J='Content-Type: application/json'
$ curl -s -X POST $U -H "$J" -d '{"energy": 2.0, "current": 100}'; echo
{"id":1,"energy":2.0,"current":100.0}
$ curl -s -X POST $U -H "$J" -d '{"energy": 5.5, "current": 40}'; echo
{"id":2,"energy":5.5,"current":40.0}
$ curl -s "$U?min_energy=3"; echo
[{"id":2,"energy":5.5,"current":40.0}]
$ curl -s -X PUT $U/2 -H "$J" -d '{"energy": 5.5, "current": 42}'; echo
{"id":2,"energy":5.5,"current":42.0}
$ curl -s -o /dev/null -w '%{http_code}\n' -X DELETE $U/1
204
$ curl -s -o /dev/null -w '%{http_code}\n' -X DELETE $U/1
404
$ curl -s $U/1; echo
{"detail":"нет такого запуска"}
$ curl -s -X POST $U -H "$J" -d '{"energy": -1, "current": "много"}' | jq -c '.detail[] | [.loc[1], .msg]'
["energy","Input should be greater than 0"]
["current","Input should be a valid number, unable to parse string as a number"]
$ grep HTTP uv.log
INFO: 127.0.0.1:53754 - "POST /runs HTTP/1.1" 201 Created
INFO: 127.0.0.1:53760 - "POST /runs HTTP/1.1" 201 Created
INFO: 127.0.0.1:53776 - "GET /runs?min_energy=3 HTTP/1.1" 200 OK
INFO: 127.0.0.1:53786 - "PUT /runs/2 HTTP/1.1" 200 OK
INFO: 127.0.0.1:53794 - "DELETE /runs/1 HTTP/1.1" 204 No Content
INFO: 127.0.0.1:53802 - "DELETE /runs/1 HTTP/1.1" 404 Not Found
INFO: 127.0.0.1:53816 - "GET /runs/1 HTTP/1.1" 404 Not Found
INFO: 127.0.0.1:53818 - "POST /runs HTTP/1.1" 422 Unprocessable Entity
Запуски получили идентификаторы 1 и 2, фильтр min_energy=3 оставил второй, PUT заменил его данные. Первый DELETE удалил запуск 1 и ответил 204 без тела, второй — 404: запуска уже нет. Запрос с отрицательной энергией и током «много» до функции не дошёл: FastAPI ответил 422 и перечислил обе ошибки. Журнал uvicorn показывает каждый запрос с методом, путём и кодом состояния.
Документация интерфейса
Из тех же аннотаций и описаний полей FastAPI строит описание интерфейса в формате OpenAPI по адресу /openapi.json и интерактивную документацию по адресам /docs и /redoc; воспользуемся ими.
$ curl -s localhost:8000/openapi.json | jq -c '.paths | map_values(keys)'
{"/runs":["get","post"],"/runs/{run_id}":["delete","get","put"]}
$ curl -s localhost:8000/openapi.json | jq -c '.components.schemas.Run.properties.energy'
{"type":"number","exclusiveMinimum":0.0,"title":"Energy","description":"энергия пучка, МэВ"}
$ curl -s -o /dev/null -w '%{http_code}\n' localhost:8000/docs
200
В схеме поля energy ограничение gt=0 записано как exclusiveMinimum, а описание взято из аргумента description функции Field. Страница /docs (Swagger UI) перечисляет пять операций с методами и путями, модель Run с полями energy и current и схемы ошибок проверки. Каждую операцию можно развернуть и выполнить прямо из браузера: кнопка Try it out открывает поля для ввода, а Execute отправляет запрос и показывает ответ вместе с эквивалентной командой curl. По машиночитаемому описанию /openapi.json строятся клиенты на других языках.
nginx перед приложением
Перед приложением обычно ставят обратный прокси-сервер (reverse proxy), чаще всего nginx. Он принимает соединения клиентов, завершает TLS, раздаёт статические файлы, ограничивает частоту запросов и передаёт запросы к API приложению, а при нескольких копиях приложения распределяет между ними нагрузку. Приложение при этом слушает только внутренний адрес, и клиент обменивается данными только с nginx. Конфигурация ниже отвечает на корневой путь сама, а пути с префиксом /api/ передаёт приложению на порту 8000.
server {
listen 8080;
location /api/ {
proxy_pass http://127.0.0.1:8000/;
proxy_set_header X-Forwarded-For $remote_addr;
}
location / {
return 200 "nginx: статика, /api/ — приложению\n";
}
}
Если в адресе директивы proxy_pass указан путь, здесь — одна косая черта, nginx заменяет им часть пути запроса, совпавшую с location: запрос /api/runs уходит приложению как /runs. Без пути, в записи proxy_pass http://127.0.0.1:8000;, запрос ушёл бы с исходным путём /api/runs. Решает именно указанный путь: proxy_pass http://127.0.0.1:8000/v1/; превратил бы /api/runs в /v1/runs. Заголовок X-Forwarded-For передаёт приложению адрес настоящего клиента, иначе в журнале приложения все запросы будут от nginx.
Запустим nginx в контейнере из образа nginx:alpine с сетью хоста, подключив файл конфигурации томом (см. главу «Docker»).
$ uvicorn app:app --port 8000 >uv.log 2>&1 &
$ docker run -d --rm --name proxy --network host -v $PWD/nginx.conf:/etc/nginx/conf.d/default.conf:ro nginx:alpine >/dev/null
$ J='Content-Type: application/json'
$ curl -s localhost:8080/
nginx: статика, /api/ — приложению
$ curl -s -X POST localhost:8080/api/runs -H "$J" -d '{"energy": 2.0, "current": 100}'; echo
{"id":1,"energy":2.0,"current":100.0}
$ curl -s -D - -o /dev/null localhost:8080/api/runs | grep -i -E '^(HTTP|server)'
HTTP/1.1 200 OK
Server: nginx/1.31.6
$ curl -s -D - -o /dev/null localhost:8000/runs | grep -i -E '^(HTTP|server)'
HTTP/1.1 200 OK
server: uvicorn
$ docker logs proxy 2>&1 | grep HTTP
127.0.0.1 - - [03/Oct/2026:03:49:25 +0000] "GET / HTTP/1.1" 200 54 "-" "curl/8.5.0" "-"
127.0.0.1 - - [03/Oct/2026:03:49:25 +0000] "POST /api/runs HTTP/1.1" 201 37 "-" "curl/8.5.0" "-"
127.0.0.1 - - [03/Oct/2026:03:49:25 +0000] "GET /api/runs HTTP/1.1" 200 39 "-" "curl/8.5.0" "-"
$ grep HTTP uv.log
INFO: 127.0.0.1:0 - "POST /runs HTTP/1.1" 201 Created
INFO: 127.0.0.1:0 - "GET /runs HTTP/1.1" 200 OK
INFO: 127.0.0.1:60440 - "GET /runs HTTP/1.1" 200 OK
Ответ на запрос /api/runs пришёл от приложения, но с заголовком Server: nginx/1.31.6: заголовок Server приложения nginx клиенту не передаёт и подставляет свой, тогда как прямой запрос к uvicorn получает server: uvicorn. В журнале nginx записаны все три запроса с исходными путями, а в журнале приложения — пути без префикса /api. Адрес клиента 127.0.0.1:0 в журнале uvicorn взят из заголовка X-Forwarded-For: номера порта заголовок не содержит, поэтому записан ноль, а для прямого запроса в журнале указан настоящий порт клиента.
Uvicorn по умолчанию доверяет заголовку X-Forwarded-For в запросах с петлевого адреса, то есть от посредника на той же машине. Поэтому существенно, кто этот заголовок формирует:
$ curl -s -H 'X-Forwarded-For: 203.0.113.5' localhost:8000/runs >/dev/null
$ curl -s -H 'X-Forwarded-For: 203.0.113.5' localhost:8080/api/runs >/dev/null
$ grep HTTP uv.log | tail -2
INFO: 203.0.113.5:0 - "GET /runs HTTP/1.1" 200 OK
INFO: 127.0.0.1:0 - "GET /runs HTTP/1.1" 200 OK
$ docker rm -f proxy >/dev/null
Прямой запрос с поддельным заголовком записан в журнал под чужим адресом 203.0.113.5, а тот же заголовок, присланный через nginx, заменён настоящим адресом соединения: директива proxy_set_header перезаписывает его. Таким образом, приложение за посредником слушает только внутренний адрес, недоступный клиентам напрямую, а адресу из заголовка доверяет лишь тогда, когда заголовок сформировал посредник. В цепочке из нескольких посредников вместо $remote_addr используют переменную $proxy_add_x_forwarded_for, дописывающую адрес к уже пришедшему заголовку.
Такая схема — nginx снаружи, приложение на внутреннем порту — лежит в основе задания курса, приведённого в конце главы. В Compose наружу публикуется только порт nginx, а приложение доступно лишь соседям по сети Compose (см. раздел о видимости портов в главе «Docker»).
Резюме
Таким образом, на прикладном уровне программа сначала превращает имя сервера в адрес средствами DNS, затем по соединению TCP обменивается с сервером сообщениями HTTP, а TLS обеспечивает шифрование этого обмена и проверку подлинности сервера. Запрос и ответ HTTP/1.1 представляют собой текст: метод, путь и заголовки в запросе, код состояния и заголовки в ответе. Безопасные и идемпотентные методы допускают повтор, а повторять имеет смысл только временные ошибки — 408, 429, 502, 503, 504 и обрыв соединения — с нарастающей паузой и ограниченным числом попыток. Сертификат внутреннего сервиса добавляется к доверенным явно, а не отключением проверки.
Из инструментов Python достаточно трёх: requests с тайм-аутом и повтором для обычных запросов, httpx там, где требуется асинхронность, и FastAPI для собственного сервиса, перед которым работает nginx. Сокеты необходимы для понимания того, что происходит под библиотеками, и для собственных протоколов приборов. Порядок проверки уровней при неисправности приведён в резюме главы «Компьютерные сети»: разрешение имени проверяется одним из первых, а содержимое ответа сервера — последним, командой curl -v.
Упражнения
- Написать клиент к публичному API, например к INSPIRE-HEP, с тайм-аутом, повтором временных ошибок и паузой между запросами, при которой не превышается квота сервиса.
- Добавить к журналу запусков метод
PATCHи фильтр по току и проверить их через страницу/docs. - Поставить журнал запусков за nginx с шифрованием: подключить сертификат из раздела о TLS директивами
listen 8443 ssl,ssl_certificateиssl_certificate_keyи проверить запрос командойcurl --cacert cert.pem.
Полезные ссылки
- J. Kurose, K. Ross. Computer Networking: A Top-Down Approach, 9-е изд. — Pearson, 2026, учебник по сетям, начинающийся с прикладного уровня;
- MDN Web Docs: HTTP, справочник по методам, заголовкам и кодам состояния;
- RFC 9110 (семантика HTTP), RFC 8446 (TLS 1.3) и RFC 8484 (DNS поверх HTTPS), первоисточники по протоколам главы;
- документация requests, httpx, FastAPI и nginx;
- INSPIRE REST API, описание запросов, полей и квоты базы INSPIRE-HEP.
Задание. Поставить перед приложением nginx и выяснить, почему запрос не доходит: «Деплой стартапа „Котики в мир“».
Базы данных
Файлов для хранения данных достаточно до тех пор, пока накопленное не потребовалось нескольким людям одновременно.
В настоящей главе рассматриваются задачи, которые берёт на себя система управления базами данных, и различия таких систем, затем реляционная модель и язык SQL на примере SQLite, индексы и планы запросов. Работа с базами из программ на Python, транзакции и одновременный доступ, эксплуатация и нереляционные хранилища рассматриваются в следующей главе, «Работа с базами данных». Сквозным примером обеих глав служит журнал измерений установки — кампании, заходы и точки, снятые с датчиков. Скрипт, заполняющий журнал синтетическими данными, приведён в разделе об SQL, и большинство листингов работает с ним.
Листинги главы выполнены на одной машине — виртуальной машине под Python 3.12 со встроенной библиотекой SQLite 3.45, на которой записаны демонстрации лекции «Базы данных». PostgreSQL 17 работал на ней в контейнере Docker, а программы на Python подключались к нему драйвером psycopg 3.3. Консоли sqlite3 на машине нет, поэтому запросы к SQLite выполнены модулем sqlite3 из Python. Времена выполнения зависят от машины и меняются от запуска к запуску, тогда как планы запросов, числа строк и значения воспроизводятся.
Слайды к главе. Назначение СУБД, реляционная модель и SQL, индексы и планы запросов изложены также в первых трёх частях лекции «Базы данных» с демонстрациями в терминале, а остальные части лекции относятся к главе «Работа с базами данных»; слайды лекции доступны на сайте книги и в PDF.
Назначение СУБД
Ограничения хранения в файлах
Хранение данных в лаборатории почти всегда развивается по одному сценарию. Сначала появляется result.csv. Затем result_final.csv, result_final_v2.csv и папка 2026-08-20/ с двадцатью файлами, названными по энергии пучка, номеру захода и фамилии оператора. Через год накапливаются десятки гигабайт CSV-файлов, и вопрос «показать все измерения канала BPM01 при энергии выше 10 МэВ» превращается в вечер работы со скриптом, рекурсивно обходящим папки и разбирающим имена файлов.
Файлы и папки не справляются с четырьмя задачами. Первая из них — одновременный доступ. Скрипт сбора данных записывает файл, а исследователь в этот момент открывает его для анализа и читает недописанную строку; два процесса, пишущие в один файл одновременно, оставляют его повреждённым. Вторая — целостность. CSV не проверяет ничего: в столбец с температурой попадает строка "error", порядок столбцов от файла к файлу различается, а измерение ссылается на заход, удалённый кем-то вместе с папкой. Третья — поиск. Чтобы найти точки одного канала одного захода, приходится читать все файлы целиком; на миллионах записей это занимает минуты, тогда как при правильно организованных данных тот же запрос выполняется за миллисекунды. Четвёртая — восстановление. Сбой посреди записи оставляет файл в промежуточном состоянии, а вернуть по ошибке удалённую папку неоткуда.
Все четыре задачи решает СУБД — система управления базами данных. Она берёт на себя хранение, разграничивает одновременный доступ, проверяет данные при записи, восстанавливает базу после сбоя и предоставляет язык запросов, на котором описывается, что требуется найти, а не как перебирать файлы. Каждой задаче соответствует свой механизм: типы, ключи, язык SQL и индексы рассматриваются в этой главе, а транзакции, журнал и резервные копии — в главе «Работа с базами данных».
| Задача | Средство СУБД |
|---|---|
| одновременный доступ | транзакции, блокировки, версии строк |
| целостность | типы, ключи, ограничения NOT NULL и UNIQUE |
| поиск | язык SQL и индексы |
| восстановление | журнал упреждающей записи (WAL) и резервные копии |
Кроме того, СУБД отделяет хранение от логики программ: с одной базой работают скрипт сбора данных, программа анализа и веб-сервис, и ни одна из них не обязана знать, как данные разложены по диску.
Виды нагрузки
Системы управления базами данных различаются прежде всего нагрузкой, под которую они построены. OLTP (online transaction processing, обработка транзакций в реальном времени) представляет собой множество коротких операций, каждая из которых читает или меняет несколько строк: запись нового захода, оплата в интернет-магазине. Ответ нужен за миллисекунды, а данные должны оставаться согласованными при тысячах одновременных клиентов. OLAP (online analytical processing, аналитическая обработка) — это редкие тяжёлые запросы, которые просматривают миллионы и миллиарды строк ради нескольких чисел, например статистика параметров пучка за сезон; ответ допустимо ждать секунды. Временные ряды сочетают обе черты: непрерывный поток мелких вставок «метка времени — значение» и аналитические запросы по окнам времени.
| Нагрузка | Запросы | Пример | Типичные СУБД |
|---|---|---|---|
| OLTP | много коротких транзакций по нескольку строк | запись захода, оплата в магазине | PostgreSQL, MySQL, SQLite |
| OLAP | редкие тяжёлые запросы по миллиардам строк | статистика архива пучка за сезон | ClickHouse, DuckDB |
| временные ряды | поток точек «время — значение», агрегаты по окнам | давление в вакуумной камере, температуры, токи магнитов | InfluxDB, TimescaleDB |
В ускорительной установке встречаются все три вида: журнал запусков представляет собой OLTP, анализ архива за сезон — OLAP, а система медленного контроля (slow control), опрашивающая сотни датчиков вакуума, температуры и токов каждую секунду годами, — временные ряды. От профиля нагрузки зависит устройство системы. OLTP-базы хранят таблицу по строкам и поддерживают транзакции, аналитические хранят данные по столбцам, что ускоряет агрегацию по нескольким столбцам миллиардов строк. Использовать систему не по назначению можно, но дорого: аналитика на PostgreSQL упирается в полное чтение больших таблиц, а частые мелкие вставки в ClickHouse перегружают его фоновые слияния.
Различия СУБД
Вместо перечня сотен систем удобнее несколько признаков, по которым они различаются: объём данных, вид нагрузки, язык запросов, транзакции и репликация. Таблица сравнивает по этим признакам четыре системы, которые часто встречаются вместе.
| SQLite | PostgreSQL | ClickHouse | Valkey, Redis | |
|---|---|---|---|---|
| Объём | файл до сотен ГБ | терабайты на сервер | петабайты на кластере | объём памяти |
| Нагрузка | встроенная OLTP | OLTP | OLAP | ключ — значение |
| Язык | SQL | SQL | диалект SQL | команды GET, SET, SCAN |
| Транзакции | ACID, сериализуемые | ACID, уровни изоляции | атомарная вставка блока | MULTI/EXEC без отката |
| Репликация | нет встроенной | физическая и логическая | таблицы Replicated, ClickHouse Keeper | асинхронная на реплики |
SQLite хранит базу в одном файле и уместна до сотен гигабайт, хотя формат допускает файл до 281 ТБ; PostgreSQL обслуживает терабайты на одном сервере, ClickHouse — петабайты на кластере, а Valkey и Redis ограничены оперативной памятью. PostgreSQL почти полностью соответствует стандарту SQL, у ClickHouse собственный диалект, а у Valkey вместо языка запросов набор команд, и фильтрацию по значениям выполняет приложение. SQLite и PostgreSQL обеспечивают все гарантии транзакций, обозначаемые аббревиатурой ACID и рассматриваемые в следующей главе. В ClickHouse привычных транзакций нет, но вставка блока строк в одну партицию таблицы семейства MergeTree атомарна; Valkey выполняет каждую команду атомарно, а группу команд MULTI/EXEC — подряд, без вклинивания чужих запросов, но без отката. Встроенной репликации у SQLite нет: начиная с версии 3.47 в поставку входит утилита sqlite3_rsync для разовой синхронизации копии, а непрерывную репликацию обеспечивают сторонние средства. PostgreSQL поддерживает физическую и логическую репликацию, ClickHouse реплицирует таблицы семейства Replicated с координацией через ClickHouse Keeper, Valkey передаёт изменения репликам асинхронно. Ни одна система не превосходит остальные по всем признакам, и систему выбирают по нагрузке и объёму: SQLite не заменит кластер, а кластер ради сотни мегабайт не разворачивают.
Встраиваемая и клиент-серверная архитектура
По архитектуре СУБД делятся на встраиваемые и клиент-серверные. SQLite представляет собой библиотеку, которая работает внутри процесса программы: обращение к базе — вызов функции, без сети и отдельного сервиса, а вся база — файл на локальном диске, рядом с которым в режиме журнала WAL лежат служебные файлы -wal и -shm. Поэтому SQLite не требует установки и настройки, но права доступа к базе сводятся к правам на файл, а работать с ней одновременно надёжно могут только процессы одной машины.
PostgreSQL является сервером. Главный процесс принимает соединения на порту 5432 и для каждого клиента порождает отдельный серверный процесс; процессы координируются через общую память, где лежат буферы страниц, блокировки и сведения о транзакциях. Модель «процесс на соединение» надёжна и прозрачна: утечка памяти в одном сеансе исчезает вместе с процессом, а зависший сеанс виден в списке процессов вместе с типом выполняемой команды. Ценой является дорогое соединение: открыть его заметно дороже, чем выполнить простой запрос (оценка приведена в главе «Работа с базами данных»), а число одновременных соединений ограничено параметром max_connections, по умолчанию равным 100. Программы, открывающие соединение на каждый запрос, ставят перед сервером пул соединений, например PgBouncer: в транзакционном режиме он выдаёт серверное соединение клиенту на время одной транзакции и тем самым позволяет тысячам клиентов работать через десятки серверных процессов.
Для опытов сервер удобно запускать в контейнере Docker (см. главу «Docker»). Пароль lab годится только для учебного контейнера, принимающего соединения на петлевом интерфейсе 127.0.0.1. Параметр -c передаёт настройку серверу; модуль pg_stat_statements понадобится в разделе о мониторинге следующей главы, где используется тот же контейнер.
docker run -d --rm --name pg -e POSTGRES_PASSWORD=lab -p 127.0.0.1:5432:5432 \
postgres:17-alpine -c shared_preload_libraries=pg_stat_statements
alias psql='docker exec -i pg psql -U postgres' # клиент psql внутри контейнера
Серверные процессы перечисляет представление pg_stat_activity. Откроем к серверу три соединения из Python (драйвер psycopg рассматривается в следующей главе) и выведем список процессов:
import psycopg
DSN = "host=127.0.0.1 user=postgres password=lab"
clients = [psycopg.connect(DSN) for _ in range(3)] # три открытых соединения
with psycopg.connect(DSN) as conn:
rows = conn.execute("SELECT pid, backend_type, state FROM pg_stat_activity "
"ORDER BY backend_type, pid").fetchall()
for pid, backend_type, state in rows:
print(pid, backend_type, state or "")
68 autovacuum launcher
65 background writer
64 checkpointer
84 client backend idle
85 client backend idle
86 client backend idle
87 client backend active
69 logical replication launcher
67 walwriter
Каждому из четырёх соединений, трём простаивающим (idle) и одному выполняющему запрос (active), соответствует отдельный процесс client backend со своим номером; остальные процессы представляют собой фоновые службы сервера, к которым относятся автоочистка, запись журнала и контрольные точки. Текст выполняемого запроса показывает столбец query того же представления.
Реляционная модель
Слайды к главе. Реляционная модель, нормализация, создание таблиц с ограничениями, выборка, соединение и агрегация изложены также во второй части лекции «Базы данных» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Реляционная модель, предложенная Эдгаром Коддом в 1970 году, до сих пор считается основной. Данные укладываются в таблицы, называемые в теории отношениями (relations). Строка таблицы содержит запись об одном объекте, а столбец задаёт атрибут, наделённый фиксированным типом. Порядок строк в таблице не определён: упорядоченными они приходят только при явной сортировке в запросе.
Спроектируем схему для типичного эксперимента. Имеются измерительные кампании, внутри каждой находятся заходы (runs), различающиеся параметрами установки, а внутри каждого захода — точки измерений, снятые с датчиков.
experiments ──< runs ──< measurements
(1) (N) (N)
Таблица experiments описывает кампанию: её название, установку и дату начала. Таблица runs описывает заход: его кампанию, номер, энергию пучка и оператора. Таблица measurements описывает отдельную точку: её заход, канал, время и значение. Знак ──< читается как связь «один ко многим»: у одной кампании много заходов, а у одного захода много снятых точек.
Ключи и связи
Первичным ключом (primary key) называется столбец или набор столбцов, однозначно идентифицирующий строку. Обычно им является суррогатный целочисленный id, выдаваемый базой самостоятельно.
Внешним ключом (foreign key) называется столбец, ссылающийся на первичный ключ другой таблицы. Столбец runs.experiment_id хранит id кампании, и таким образом строки связываются между собой. СУБД следит за валидностью ссылки: нельзя вставить заход с experiment_id = 42, если кампании с таким id нет, и нельзя удалить кампанию, на которую ссылаются заходы. SQLite выполняет эту проверку только после команды PRAGMA foreign_keys = ON, о которой речь пойдёт ниже.
Связь «многие ко многим» (например, публикации и авторы) выражается через промежуточную таблицу, снабжённую двумя внешними ключами, и отдельного механизма для неё не требуется.
Нормализация
Соблазнительно поместить всё в одну широкую таблицу, повторяя в каждой строке измерения название кампании, энергию и фамилию оператора:
| Заход | Кампания | E, МэВ | Оператор | t, с | Сигнал |
|---|---|---|---|---|---|
| 31 | Ресурсные испытания | 20,0 | Петрова | 0,00 | 0,406 |
| 31 | Ресурсные испытания | 20,0 | Петрова | 0,01 | 0,403 |
| 31 | Ресурсные испытания | 20,0 | Петрова | 0,02 | 0,402 |
Такая схема работает до первой правки. Если в фамилии оператора обнаружилась опечатка, обновлять приходится миллион строк, а при сбое скрипта на середине данные остаются противоречивыми. Это явление называется аномалиями обновления.
Нормализацией называется устранение дублирования, при котором каждый факт хранится один раз, а всё остальное на него ссылается. Формально она описывается нормальными формами. Первая нормальная форма (1НФ) требует атомарных значений без повторяющихся групп: не список каналов в одной ячейке, а отдельная строка на канал. Вторая и третья (2НФ и 3НФ) сводятся к мнемонике: неключевые атрибуты зависят «от ключа, от всего ключа и ни от чего, кроме ключа». Энергия является свойством захода, а не точки измерения, следовательно, ей место в runs. Название установки принадлежит кампании, поэтому оно хранится в experiments.
Обратный процесс — денормализация — также бывает осмысленным. Для тяжёлой аналитики иногда специально собирают широкую таблицу, чтобы не соединять разложенные данные в каждом запросе; так данные часто перекладывают в аналитическую СУБД. Однако проектирование всегда начинают с нормализованной схемы.
Основы SQL на примере SQLite
SQL (Structured Query Language) — декларативный язык для реляционных баз. Пользователь описывает нужный результат, а СУБД самостоятельно решает, как его получить.
Изучение ведётся на SQLite, встраиваемой СУБД без сервера: вся база лежит в одном файле, а драйвер входит в стандартную библиотеку Python (модуль sqlite3). При этом SQLite остаётся полноценной реляционной СУБД с транзакциями, работающей с базами в десятки и сотни гигабайт. Для лабораторных данных этого достаточно.
Консоль SQLite запускается командой sqlite3 lab.db, которая создаёт файл базы, если его ещё нет; сама консоль устанавливается отдельно, в Ubuntu — пакетом sqlite3. Начиная с Python 3.12, без установки доступна консоль модуля: python3 -m sqlite3 lab.db открывает интерактивный сеанс, а python3 -m sqlite3 lab.db "запрос" выполняет один запрос и печатает строки результата кортежами Python. Служебных команд консоли sqlite3, таких как .tables, в ней нет, и их заменяет запрос к системной таблице sqlite_master. Запросы этого раздела выполнены именно так. Просмотреть базу в графическом интерфейсе позволяет программа DB Browser for SQLite.
CREATE TABLE: создание таблиц
Приписки после типов задают ограничения, соблюдаемые базой самостоятельно, независимо от поведения прикладного кода. Схема журнала сохранена в файле schema.sql:
CREATE TABLE experiments (
id INTEGER PRIMARY KEY, -- первичный ключ, база выдаёт сама
name TEXT NOT NULL UNIQUE, -- название кампании, без повторов
setup TEXT, -- описание установки
started_at TEXT NOT NULL -- дата в ISO 8601: '2026-08-20'
);
CREATE TABLE runs (
id INTEGER PRIMARY KEY,
experiment_id INTEGER NOT NULL REFERENCES experiments(id), -- внешний ключ
run_number INTEGER NOT NULL,
energy_mev REAL NOT NULL, -- энергия пучка в заходе, МэВ
operator TEXT,
started_at TEXT NOT NULL, -- момент начала в UTC: '2026-08-20T03:15:00Z'
UNIQUE (experiment_id, run_number) -- номер захода уникален внутри кампании
);
CREATE TABLE measurements (
id INTEGER PRIMARY KEY,
run_id INTEGER NOT NULL REFERENCES runs(id),
channel TEXT NOT NULL, -- имя канала: 'BPM01', 'T_magnet', ...
t REAL NOT NULL, -- время от начала захода, с
value REAL NOT NULL -- измеренное значение
);
Ограничения NOT NULL, UNIQUE и внешние ключи обеспечивают целостность, отсутствовавшую у CSV: попытка записать некорректные данные завершится ошибкой, а не порчей, обнаруживаемой через полгода. Первичный ключ уникален и по стандарту не может быть пустым. В SQLite столбец INTEGER PRIMARY KEY совпадает с внутренним номером строки rowid и заполняется автоматически, а первичный ключ другого типа из-за давней ошибки, сохранённой ради совместимости, допускает NULL, если столбец не объявлен NOT NULL, а таблица — не STRICT и не WITHOUT ROWID.
Внешние ключи SQLite проверяет только при явно включённой проверке, и включать её необходимо в каждом новом соединении:
PRAGMA foreign_keys = ON;
Без этой строки вставка ссылки на несуществующую кампанию проходит без ошибки, и база незаметно накапливает нарушенные связи. Проверим это на пустой базе со схемой журнала:
import sqlite3
with open("schema.sql", encoding="utf-8") as f:
schema = f.read()
INSERT = ("INSERT INTO runs (experiment_id, run_number, energy_mev, started_at) "
"VALUES (42, 1, 12.5, '2026-08-20T03:15:00Z')") # кампании 42 нет
for pragma in ("OFF", "ON"):
con = sqlite3.connect(":memory:")
con.executescript(schema)
con.execute(f"PRAGMA foreign_keys = {pragma}")
try:
con.execute(INSERT)
print(f"foreign_keys = {pragma}: заход записан")
except sqlite3.IntegrityError as e:
print(f"foreign_keys = {pragma}: {e}")
foreign_keys = OFF: заход записан
foreign_keys = ON: FOREIGN KEY constraint failed
PostgreSQL и MySQL с движком InnoDB проверяют внешние ключи по умолчанию. Однако MySQL без предупреждения игнорирует объявленные ключи в таблицах MyISAM, а дамп, созданный утилитой mysqldump, начинается с команды SET FOREIGN_KEY_CHECKS=0, которая на время его загрузки снимает проверку и в InnoDB.
Другая особенность SQLite — динамическая типизация: тип столбца лишь указывает предпочтительный способ хранения, и в столбец REAL можно записать строку. Таблицы с ключевым словом STRICT, появившиеся в версии 3.37, обеспечивают строгую проверку типов:
import sqlite3
con = sqlite3.connect(":memory:")
con.execute("CREATE TABLE loose (temperature REAL)")
con.execute("CREATE TABLE strict (temperature REAL) STRICT")
con.execute("CREATE TABLE channels (name TEXT PRIMARY KEY, unit TEXT)")
con.execute("INSERT INTO loose VALUES ('error')")
print(con.execute("SELECT temperature, typeof(temperature) FROM loose").fetchone())
for sql in ("INSERT INTO strict VALUES ('error')",
"INSERT INTO channels VALUES (NULL, 'мА')",
"INSERT INTO channels VALUES (NULL, 'В')"):
try:
con.execute(sql)
print("принято:", sql)
except sqlite3.IntegrityError as e:
print("отказ: ", e)
('error', 'text')
отказ: cannot store TEXT value in REAL column strict.temperature
принято: INSERT INTO channels VALUES (NULL, 'мА')
принято: INSERT INTO channels VALUES (NULL, 'В')
Строка 'error' сохранилась в столбце температуры с типом text, таблица STRICT её отвергла, а в таблицу каналов с ключом name TEXT PRIMARY KEY легли две строки с пустым ключом. Поэтому естественный ключ в SQLite объявляют NOT NULL явно, а для новых таблиц, где важны типы, используют STRICT.
Отдельного внимания требует время. Момент начала захода в схеме хранится строкой ISO 8601 в UTC с суффиксом Z: строка местного времени без смещения при переводе часов и при обмене данными между площадками даёт повторы и пропуски меток. Рассмотрим ночь перевода часов в Женеве, где расположен ЦЕРН:
from datetime import datetime, timezone
from zoneinfo import ZoneInfo
geneva = ZoneInfo("Europe/Zurich")
for utc in ("2026-10-25T00:30:00", "2026-10-25T01:30:00"): # два разных момента
moment = datetime.fromisoformat(utc).replace(tzinfo=timezone.utc)
local = moment.astimezone(geneva)
print(f"{utc} UTC = {local:%Y-%m-%d %H:%M} в Женеве, смещение {local:%z}")
2026-10-25T00:30:00 UTC = 2026-10-25 02:30 в Женеве, смещение +0200
2026-10-25T01:30:00 UTC = 2026-10-25 02:30 в Женеве, смещение +0100
Два момента, разделённые часом, записываются одной и той же местной меткой «02:30», и без смещения восстановить порядок событий невозможно. В PostgreSQL для таких данных предназначен тип timestamptz: он хранит момент времени в UTC, а при выводе переводит его в часовой пояс сеанса.
CREATE TABLE shots (id int PRIMARY KEY, started_at timestamptz NOT NULL);
INSERT INTO shots VALUES (1, '2026-08-20 10:15:00+07'); -- время со смещением
SET TIME ZONE 'UTC';
SELECT started_at FROM shots;
SET TIME ZONE 'Europe/Zurich';
SELECT started_at FROM shots;
$ psql < tz.sql
CREATE TABLE
INSERT 0 1
SET
started_at
------------------------
2026-08-20 03:15:00+00
(1 row)
SET
started_at
------------------------
2026-08-20 05:15:00+02
(1 row)
Момент, записанный как 10:15 по времени UTC+7, хранится как 03:15 UTC и в сеансе с поясом Europe/Zurich выводится как 05:15 по летнему времени Женевы.
INSERT: вставка данных
Заполняемые базой столбцы перечислять не требуется: id она выдаст очередной. experiment_id для захода необходимо указать, иначе неизвестно, к какой кампании он относится.
INSERT INTO experiments (name, setup, started_at)
VALUES ('Калибровка датчиков положения', 'стенд ЛИУ', '2026-08-20');
INSERT INTO runs (experiment_id, run_number, energy_mev, operator, started_at)
VALUES (1, 1, 12.5, 'Иванов', '2026-08-20T03:15:00Z');
-- несколько строк одним запросом
INSERT INTO measurements (run_id, channel, t, value) VALUES
(1, 'BPM01', 0.0, 0.412),
(1, 'BPM01', 0.1, 0.418),
(1, 'T_magnet', 0.0, 42.3);
Последняя форма, со списком кортежей после VALUES, вставляет группу строк одним запросом и, значит, одной транзакцией. Тысяча отдельных INSERT, каждый из которых фиксируется сам по себе (так работает консоль sqlite3), выполняется на два порядка медленнее; внутри одной транзакции разница исчезает, что показывает опыт в разделе о транзакциях следующей главы.
Журнал для примеров
Дальнейшие примеры работают с журналом, который заполняет синтетическими данными скрипт make_lab.py. В журнале две кампании и 41 заход, из которых последний оставлен без измерений; в каждом из остальных сорока заходов с пяти каналов снято по 5000 точек с частотой 100 Гц, всего миллион строк. Энергия пучка растёт от 5 МэВ в первом заходе до 25 МэВ в последнем с шагом 0,5 МэВ. Сигнал датчиков положения BPM в модели задан пропорциональным энергии с коэффициентом 0,02 на мегаэлектронвольт, к нему добавлены медленное колебание с амплитудой 0,01 и шум; у настоящего датчика сигнал отражает положение пучка, а от энергии зависит через дисперсию орбиты. Температура магнита медленно растёт, ток пучка экспоненциально спадает. Скрипт использует модуль sqlite3, подробно рассматриваемый в следующей главе, и записывает весь журнал одной транзакцией.
"""Создаёт lab.db по схеме schema.sql и заполняет журнал миллионом измерений."""
import math
import os
import random
import sqlite3
import time
from datetime import datetime, timedelta, timezone
N_RUNS = 41 # последний заход — без измерений
CHANNELS = ["BPM01", "BPM02", "BPM03", "T_magnet", "I_beam"]
POINTS = 5000 # точек на канал в заходе, 100 Гц
START = {1: datetime(2026, 8, 20, 1, tzinfo=timezone.utc), # начало кампаний, UTC
2: datetime(2026, 9, 1, 1, tzinfo=timezone.utc)}
def points(run_id, energy):
"""Точки захода: сигнал BPM задан пропорциональным энергии, T растёт, ток спадает."""
for channel in CHANNELS:
for i in range(POINTS):
t = i / 100
if channel.startswith("BPM"):
v = 0.02 * energy + 0.01 * math.sin(t) + random.gauss(0, 0.002)
elif channel == "T_magnet":
v = 40 + 0.05 * energy + 0.001 * t
else:
v = 100 * math.exp(-t / 500)
yield run_id, channel, t, round(v, 5)
if os.path.exists("lab.db"):
os.remove("lab.db")
random.seed(1) # те же данные при каждом запуске
con = sqlite3.connect("lab.db")
con.execute("PRAGMA foreign_keys = ON")
with open("schema.sql", encoding="utf-8") as f:
con.executescript(f.read())
start = time.perf_counter()
with con: # весь журнал — одна транзакция
con.execute("INSERT INTO experiments (name, setup, started_at) VALUES "
"('Калибровка датчиков положения', 'стенд ЛИУ', '2026-08-20'), "
"('Ресурсные испытания', 'стенд ЛИУ', '2026-09-01')")
for n in range(1, N_RUNS + 1):
experiment = 1 if n <= 30 else 2
k = n - 1 if experiment == 1 else n - 31 # номер захода в кампании
started = START[experiment] + timedelta(days=k // 10, hours=k % 10)
energy = 5 + 0.5 * (n - 1)
cur = con.execute(
"INSERT INTO runs (experiment_id, run_number, energy_mev, operator, started_at) "
"VALUES (?, ?, ?, ?, ?)",
(experiment, n, energy, random.choice(["Иванов", "Петрова"]),
started.strftime("%Y-%m-%dT%H:%M:%SZ")))
if n != N_RUNS:
con.executemany("INSERT INTO measurements (run_id, channel, t, value) "
"VALUES (?, ?, ?, ?)", points(cur.lastrowid, energy))
elapsed = time.perf_counter() - start
total = con.execute("SELECT count(*) FROM measurements").fetchone()[0]
con.close()
print(f"{total} измерений за {elapsed:.1f} с; lab.db = {os.path.getsize('lab.db') / 2**20:.1f} МиБ")
1000000 измерений за 0.8 с; lab.db = 33.4 МиБ
Миллион строк для СУБД немного, но этого уже достаточно, чтобы увидеть разницу между полным просмотром таблицы и поиском по индексу. Список таблиц, который в консоли sqlite3 выводит команда .tables, даёт запрос к sqlite_master:
$ python3 -m sqlite3 lab.db "SELECT name FROM sqlite_master WHERE type = 'table'"
('experiments',)
('runs',)
('measurements',)
SELECT: выборка
Вопрос, требовавший вечера работы со скриптом-обходчиком папок, записывается в несколько строк:
-- первые три точки канала BPM01 первого захода, по возрастанию времени
SELECT t, value
FROM measurements
WHERE run_id = 1 AND channel = 'BPM01'
ORDER BY t
LIMIT 3;
(0.0, 0.09673)
(0.01, 0.09858)
(0.02, 0.10112)
-- десять последних заходов с энергией выше 10 МэВ
SELECT run_number, energy_mev, started_at
FROM runs
WHERE energy_mev > 10
ORDER BY started_at DESC
LIMIT 10;
(41, 25.0, '2026-09-02T01:00:00Z')
(40, 24.5, '2026-09-01T10:00:00Z')
(39, 24.0, '2026-09-01T09:00:00Z')
(38, 23.5, '2026-09-01T08:00:00Z')
(37, 23.0, '2026-09-01T07:00:00Z')
(36, 22.5, '2026-09-01T06:00:00Z')
(35, 22.0, '2026-09-01T05:00:00Z')
(34, 21.5, '2026-09-01T04:00:00Z')
(33, 21.0, '2026-09-01T03:00:00Z')
(32, 20.5, '2026-09-01T02:00:00Z')
WHERE фильтрует строки, ORDER BY сортирует отобранное (DESC задаёт убывание), LIMIT ограничивает результат. Звёздочка SELECT * возвращает все столбцы, что удобно в консоли, однако в скриптах нужные столбцы перечисляются явно: тогда смысл запроса не меняется при добавлении столбца в таблицу. Сортировка меток started_at как строк корректна, поскольку все они записаны в одном формате и в одном часовом поясе.
Части запроса записываются в одном порядке, а логически выполняются в другом: сначала FROM и JOIN формируют строки, затем WHERE отбирает их, GROUP BY и HAVING группируют, SELECT вычисляет столбцы результата, а ORDER BY и LIMIT сортируют и обрезают. Поэтому по стандарту псевдоним столбца, введённый в SELECT, нельзя использовать в WHERE: на запрос SELECT energy_mev * 1000 AS energy_kev FROM runs WHERE energy_kev > 24000 PostgreSQL отвечает ошибкой column "energy_kev" does not exist. SQLite в качестве расширения стандарта такой запрос выполняет, и при переносе в PostgreSQL его придётся исправить.
JOIN: соединение таблиц
Нормализация разложила данные по трём таблицам, а JOIN собирает разложенное обратно. Соединение сопоставляет строки по условию, обычно «внешний ключ равен первичному»:
-- точки канала BPM01 захода 31 вместе с энергией и названием кампании
SELECT e.name, r.run_number, r.energy_mev, m.t, m.value
FROM measurements AS m
JOIN runs AS r ON r.id = m.run_id
JOIN experiments AS e ON e.id = r.experiment_id
WHERE m.channel = 'BPM01' AND r.run_number = 31
ORDER BY m.t
LIMIT 2;
('Ресурсные испытания', 31, 20.0, 0.0, 0.40551)
('Ресурсные испытания', 31, 20.0, 0.01, 0.40252)
AS m задаёт псевдоним, избавляющий от длинных имён. Без ORDER BY запрос вернул бы две первые строки в порядке хранения, и совпадение этого порядка с порядком по времени не гарантировано. Кроме обычного (внутреннего) JOIN существует LEFT JOIN, сохраняющий строки левой таблицы даже при отсутствии пары справа и заполняющий столбцы правой таблицы значением NULL. Таким образом находят заходы без измерений:
-- заходы без единого измерения
SELECT r.run_number
FROM runs AS r
LEFT JOIN measurements AS m ON m.run_id = r.id
WHERE m.id IS NULL;
(41,)
GROUP BY: агрегация
Агрегатные функции (COUNT, AVG, SUM, MIN, MAX) сворачивают отобранную группу строк в одно число, а GROUP BY задаёт признак группировки:
-- сводка по заходам: число точек и статистика сигнала BPM01
SELECT r.run_number,
r.energy_mev,
COUNT(*) AS n_points,
ROUND(AVG(m.value), 4) AS mean_value,
MIN(m.value) AS min_value,
MAX(m.value) AS max_value
FROM measurements AS m
JOIN runs AS r ON r.id = m.run_id
WHERE m.channel = 'BPM01'
GROUP BY r.id
HAVING COUNT(*) >= 100 -- без слишком коротких заходов
ORDER BY r.energy_mev DESC
LIMIT 3;
(40, 24.5, 5000, 0.49, 0.47509, 0.50626)
(39, 24.0, 5000, 0.48, 0.46358, 0.49628)
(38, 23.5, 5000, 0.47, 0.45421, 0.48687)
HAVING фильтрует после группировки, по вычисленным агрегатам; WHERE отбирает строки до неё. Отметим, что в списке SELECT при группировке допустимы столбцы группировки, агрегаты и столбцы, однозначно определяемые первичным ключом группы: r.run_number и r.energy_mev определяются ключом r.id, поэтому запрос корректен и по стандарту, и в PostgreSQL. Средний сигнал растёт на 0,01 на каждые 0,5 МэВ, как и заложено в модели, а разброс от минимума до максимума, около 0,03, складывается из колебания с амплитудой 0,01 и шума. Главное практическое следствие состоит в том, что агрегация выполняется там, где лежат данные, и в программу приходит сводка из нескольких строк вместо миллиона точек.
Индексы и планы запросов
Слайды к главе. Устройство B-дерева, цена и выбор индекса, планировщик и статистика, планы запросов в SQLite и PostgreSQL изложены также в третьей части лекции «Базы данных» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
B-дерево
Без индекса запрос с WHERE заставляет базу просматривать всю таблицу, строку за строкой: это полный просмотр, SCAN в плане SQLite и Seq Scan в PostgreSQL. Индекс представляет собой дополнительную структуру, обычно B-дерево, в которой значения индексируемых столбцов хранятся упорядоченными вместе со ссылками на строки таблицы: в SQLite ссылкой служит номер строки rowid, в PostgreSQL — адрес версии строки. Индекс позволяет находить строки по значению столбца за логарифмическое время, наподобие предметного указателя в книге. Каждый узел дерева представляет собой страницу размером в несколько килобайт с сотнями ключей. Оценим глубину дерева: при ветвлении порядка ста первые три уровня вмещают сто, десять тысяч и миллион ключей, поэтому для миллиона строк дереву достаточно трёх-четырёх уровней, и поиск сводится к спуску от корня к листу. Ключи в листьях упорядочены, поэтому диапазон значений читается подряд, от листа к соседнему, и строки выдаются уже упорядоченными; в PostgreSQL соседние страницы каждого уровня к тому же связаны ссылками, а SQLite переходит к следующему листу через родительский узел.
Оценим выигрыш на журнале. Скрипт plan.py печатает план запроса, который возвращает команда EXPLAIN QUERY PLAN, и медиану времени пяти выполнений:
"""План запроса из файла .sql и медиана времени пяти выполнений."""
import sqlite3
import statistics
import sys
import time
sql = open(sys.argv[1], encoding="utf-8").read()
con = sqlite3.connect("lab.db")
for row in con.execute("EXPLAIN QUERY PLAN " + sql):
print("план:", row[3])
times = []
for _ in range(5):
start = time.perf_counter()
rows = con.execute(sql).fetchall()
times.append((time.perf_counter() - start) * 1000)
print(f"строк: {len(rows)}, первая: {rows[0]}")
print(f"время: {statistics.median(times):.2f} мс (медиана из 5)")
Запрос q1.sql считает средний сигнал канала BPM01 захода 7:
SELECT round(avg(value), 4) FROM measurements
WHERE run_id = 7 AND channel = 'BPM01';
$ python3 plan.py q1.sql
план: SCAN measurements
строк: 1, первая: (0.16,)
время: 19.27 мс (медиана из 5)
$ du -m lab.db
34 lab.db
$ python3 -m sqlite3 lab.db "CREATE INDEX idx_m_run_channel ON measurements (run_id, channel)"
$ du -m lab.db
50 lab.db
$ python3 plan.py q1.sql
план: SEARCH measurements USING INDEX idx_m_run_channel (run_id=? AND channel=?)
строк: 1, первая: (0.16,)
время: 0.26 мс (медиана из 5)
Без индекса план — SCAN measurements, полный просмотр миллиона строк. С индексом план меняется на SEARCH ... USING INDEX, и тот же запрос выполняется в 74 раза быстрее, а результат, средний сигнал 0,16, не меняется. Индекс занял 16 МиБ, почти половину объёма таблицы. Время поиска почти не зависит от размера таблицы: число прочитанных страниц растёт как логарифм числа строк.
Индекс по нескольким столбцам упорядочен сначала по первому столбцу, затем по второму, как телефонный справочник по фамилии и имени. Индекс (run_id, channel) ускоряет поиск по run_id и по паре run_id и channel, а по одному channel — только перебором значений run_id, пропуском (skip scan): SQLite выбирает такой план после сбора статистики, если значений первого столбца немного, PostgreSQL — начиная с версии 18.
Цена и выбор индекса
Индекс не бесплатен. Он занимает место: в опыте выше индекс по двум столбцам увеличил файл на 16 МиБ. Каждая вставка, изменение и удаление обновляет все индексы таблицы, поэтому таблица с десятком индексов пишется заметно медленнее, и индексы строят под частые запросы, а не на все столбцы подряд. Индекс эффективен, когда условие отбирает малую долю строк; если же под условие попадает большая часть таблицы, чтение строк вразброс по индексу обходится дороже последовательного чтения всей таблицы, и планировщик выбирает полный просмотр.
Порядок столбцов определяет, какие запросы ускоряются. Рассмотрим запрос q2.sql, который выбирает 5000 точек того же канала, упорядоченных по времени:
SELECT t, value FROM measurements
WHERE run_id = 7 AND channel = 'BPM01'
ORDER BY t;
$ python3 plan.py q2.sql
план: SEARCH measurements USING INDEX idx_m_run_channel (run_id=? AND channel=?)
план: USE TEMP B-TREE FOR ORDER BY
строк: 5000, первая: (0.0, 0.15967)
время: 2.04 мс (медиана из 5)
$ python3 -m sqlite3 lab.db "CREATE INDEX idx_m_run_channel_t ON measurements (run_id, channel, t)"
$ python3 plan.py q2.sql
план: SEARCH measurements USING INDEX idx_m_run_channel_t (run_id=? AND channel=?)
строк: 5000, первая: (0.0, 0.15967)
время: 1.72 мс (медиана из 5)
$ python3 -m sqlite3 lab.db "DROP INDEX idx_m_run_channel"
Строки находятся по индексу, но индекс (run_id, channel) не содержит столбца t, и для сортировки строится временное B-дерево (USE TEMP B-TREE FOR ORDER BY). Индекс (run_id, channel, t) отдаёт точки канала сразу упорядоченными по времени, а прежний индекс становится избыточным: его роль выполняет начало нового, и его удаляют, чтобы не замедлять запись. Индекс, содержащий все столбцы, нужные запросу, называется покрывающим: таблицу при таком запросе не читают вовсе.
Первичный ключ и ограничение UNIQUE индексируются автоматически. Столбцы внешних ключей в SQLite и PostgreSQL индексируют вручную, если их не покрывает индекс, начинающийся с того же столбца; MySQL создаёт такой индекс сам. Без индекса на measurements.run_id удаление захода при включённой проверке внешних ключей просматривает все измерения. План такой проверки показывает тот же EXPLAIN QUERY PLAN:
import sqlite3
con = sqlite3.connect("lab.db")
con.execute("PRAGMA foreign_keys = ON")
for sql in ("DELETE FROM experiments WHERE id = 1", "DELETE FROM runs WHERE id = 41"):
print(sql)
for row in con.execute("EXPLAIN QUERY PLAN " + sql):
print(" ", row[3])
DELETE FROM experiments WHERE id = 1
SEARCH experiments USING INTEGER PRIMARY KEY (rowid=?)
SEARCH runs USING COVERING INDEX sqlite_autoindex_runs_1 (experiment_id=?)
DELETE FROM runs WHERE id = 41
SEARCH runs USING INTEGER PRIMARY KEY (rowid=?)
SEARCH measurements USING COVERING INDEX idx_m_run_channel_t (run_id=?)
Ссылки на удаляемую кампанию ищутся по индексу sqlite_autoindex_runs_1, который создало ограничение UNIQUE (experiment_id, run_number), а ссылки на удаляемый заход — по новому индексу (run_id, channel, t). До создания индексов вторая строка плана удаления захода имела вид SCAN measurements. Таким образом, индексы строят под реальные частые запросы, а их использование проверяют планом.
Планировщик и статистика
Один и тот же запрос можно выполнить многими способами: прочитать таблицу целиком или спуститься по индексу, соединить таблицы вложенным циклом, хешированием или слиянием, в том или ином порядке. Планировщик перебирает варианты и выбирает самый дешёвый по оценке стоимости в условных единицах. В PostgreSQL чтение страницы подряд оценивается в одну условную единицу, чтение страницы вразброс — в четыре, обработка строки — в 0,01; эти веса задаются параметрами seq_page_cost, random_page_cost и cpu_tuple_cost. Оценка зависит от селективности условия, то есть доли строк, которые оно отберёт, а её планировщик берёт из статистики: числа строк, числа различных значений, самых частых значений и гистограммы распределения.
Статистику собирает команда ANALYZE. В PostgreSQL её запускает фоновая автоочистка, когда изменилась заметная доля таблицы, по умолчанию десятая часть строк; статистику столбца показывает представление pg_stats. SQLite собирает статистику только по команде ANALYZE или PRAGMA optimize и хранит её в таблице sqlite_stat1, где для индекса записаны число строк и среднее число строк на одно значение каждого начального набора столбцов ключа. После сбора статистики запрос по одному каналу, без условия на заход, переходит от полного просмотра к пропуску по индексу:
SELECT round(avg(value), 4) FROM measurements
WHERE channel = 'BPM01';
$ python3 plan.py skip.sql
план: SCAN measurements
строк: 1, первая: (0.295,)
время: 29.20 мс (медиана из 5)
$ python3 -m sqlite3 lab.db "ANALYZE"
$ python3 -m sqlite3 lab.db "SELECT tbl, idx, stat FROM sqlite_stat1"
('measurements', 'idx_m_run_channel_t', '1000000 25000 5000 1')
('runs', 'sqlite_autoindex_runs_1', '41 21 1')
('experiments', 'sqlite_autoindex_experiments_1', '2 1')
$ python3 plan.py skip.sql
план: SEARCH measurements USING INDEX idx_m_run_channel_t (ANY(run_id) AND channel=?)
строк: 1, первая: (0.295,)
время: 11.42 мс (медиана из 5)
Строка 1000000 25000 5000 1 означает, что в индексе миллион строк, на одно значение run_id приходится 25 000 строк, на пару run_id и channel — 5000, а на полный ключ — одна. Значений run_id всего сорок, и планировщик перебирает их, для каждого спускаясь по индексу к нужному каналу (ANY(run_id)): запрос выполняется в 2,6 раза быстрее полного просмотра. Средний сигнал 0,295 соответствует модели: 0,02 · 14,75 МэВ, где 14,75 МэВ — средняя энергия сорока заходов.
Когда данные меняются быстрее, чем обновляется статистика, например после массовой загрузки, план опирается на устаревшую картину, и запрос, выполнявшийся за миллисекунды, начинает занимать секунды. Покажем это в уменьшенном виде на скрипте stats.py: в таблице users 200 000 пользователей, все из Москвы, по городу построен индекс, а запрос считает москвичей старше 30 лет.
"""Статистика планировщика SQLite: один и тот же запрос до и после ANALYZE."""
import os
import random
import sqlite3
import time
if os.path.exists("users.db"):
os.remove("users.db")
random.seed(1)
con = sqlite3.connect("users.db")
con.execute("CREATE TABLE users (id INTEGER PRIMARY KEY, city TEXT, age INTEGER, bio TEXT)")
with con: # 200 000 пользователей, все из Москвы
con.executemany("INSERT INTO users (city, age, bio) VALUES ('Москва', ?, ?)",
((random.randint(18, 80), "x" * 100) for _ in range(200_000)))
con.execute("CREATE INDEX idx_city ON users (city)")
SQL = "SELECT count(*) FROM users WHERE city = ? AND age > 30"
def show(stage, city):
plan = con.execute("EXPLAIN QUERY PLAN " + SQL, (city,)).fetchone()[3]
start = time.perf_counter()
n = con.execute(SQL, (city,)).fetchone()[0]
ms = (time.perf_counter() - start) * 1000
print(f"{stage}, город {city}:")
print(f" {plan:44s} {n:6d} строк {ms:6.2f} мс")
def stat():
print(" sqlite_stat1:", *con.execute("SELECT idx, stat FROM sqlite_stat1").fetchone())
show("без статистики", "Москва")
con.execute("ANALYZE")
stat()
show("после ANALYZE", "Москва")
with con: # 200 000 жителей 2000 других городов
con.executemany("INSERT INTO users (city, age, bio) VALUES (?, ?, ?)",
((f"Город-{random.randint(1, 2000)}", random.randint(18, 80), "y" * 100)
for _ in range(200_000)))
con.execute("INSERT INTO users (city, age, bio) VALUES ('Новосибирск', 40, 'z')")
show("статистика устарела", "Новосибирск")
con.execute("ANALYZE")
stat()
show("ANALYZE в том же соединении", "Новосибирск")
con.close()
con = sqlite3.connect("users.db")
show("новое соединение", "Новосибирск")
без статистики, город Москва:
SEARCH users USING INDEX idx_city (city=?) 158623 строк 13.31 мс
sqlite_stat1: idx_city 200000 200000
после ANALYZE, город Москва:
SCAN users 158623 строк 9.21 мс
статистика устарела, город Новосибирск:
SCAN users 1 строк 14.42 мс
sqlite_stat1: idx_city 400001 200
ANALYZE в том же соединении, город Новосибирск:
SCAN users 1 строк 14.64 мс
новое соединение, город Новосибирск:
SEARCH users USING INDEX idx_city (city=?) 1 строк 0.01 мс
Без статистики SQLite считает индекс полезным и выбирает поиск по нему: 158 623 строки за 13,3 мс. ANALYZE записывает в sqlite_stat1 строку 200000 200000 — на одно значение города приходятся все строки, — и планировщик переходит к полному просмотру, который оказывается быстрее, 9,2 мс: индекс вёл к чтению всех строк по номерам вразброс. Затем в таблицу добавляются 200 000 жителей двух тысяч других городов и один житель Новосибирска, а статистика не обновляется. Планировщик по-прежнему считает город неселективным и ради одной строки просматривает всю таблицу за 14,4 мс.
Повторный ANALYZE записывает новую статистику 400001 200, то есть 200 строк на город, и соединение сразу перечитывает её, однако план в нём остался прежним. Причина — особенность SQLite версий 3.45–3.49. Первый ANALYZE, обнаружив в индексе единственное значение при числе строк больше ста, пометил idx_city как непригодный для поиска по равенству; повторный ANALYZE эту отметку не снимает, и она сохраняется в соединении до нового чтения схемы. Новое соединение читает схему заново и выбирает индекс: та же строка находится за 0,01 мс. В SQLite 3.50 и новее отметка удалена, и повторный ANALYZE меняет план и в том же соединении, так что Python, собранный с такой библиотекой, уже в строке «ANALYZE в том же соединении» покажет поиск по индексу. Вывод от версии не зависит: после массовой загрузки статистику собирают сразу, а в SQLite 3.45–3.49 долго работающая программа после этого переоткрывает соединение.
EXPLAIN ANALYZE в PostgreSQL
В PostgreSQL план показывает команда EXPLAIN, а с ключом ANALYZE запрос ещё и выполняется, и к каждому узлу плана добавляются фактические числа. План представляет собой дерево узлов: нижние узлы читают таблицы полным просмотром Seq Scan, по индексу Index Scan или через битовую карту страниц Bitmap Heap Scan, узлы выше соединяют, сортируют и агрегируют; читают план от вложенных узлов к внешним. Главное в выводе — сравнение оценки планировщика rows с фактическим числом строк actual rows: расхождение на порядок указывает на устаревшую статистику или на условие, которое планировщик оценить не может. Ключ BUFFERS показывает, сколько страниц по 8 КиБ прочитано из общего кеша (hit) и с диска (read); в PostgreSQL 18 он включён по умолчанию. Execution Time — время выполнения на сервере без передачи результата клиенту.
Перейдём к PostgreSQL и повторим в нём опыт с индексом. Скрипт fill.sql создаёт таблицу measurements и заполняет её миллионом строк заход за заходом и канал за каналом, как в журнале SQLite, только каналы здесь идут по алфавиту, а к сигналу добавлен равномерный шум без колебания; затем ANALYZE собирает статистику.
\timing on
CREATE TABLE measurements (
id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
run_id int NOT NULL,
channel text NOT NULL,
t real NOT NULL,
value real NOT NULL);
INSERT INTO measurements (run_id, channel, t, value)
SELECT r, c, i / 100.0, 0.02 * (4.5 + 0.5 * r) + random() / 500
FROM generate_series(1, 40) r,
unnest(ARRAY['BPM01', 'BPM02', 'BPM03', 'T_magnet', 'I_beam']) c,
generate_series(0, 4999) i
ORDER BY r, c, i;
ANALYZE measurements;
$ psql < fill.sql
Timing is on.
CREATE TABLE
Time: 2.039 ms
INSERT 0 1000000
Time: 2292.181 ms (00:02.292)
ANALYZE
Time: 37.061 ms
Запрос explain.sql выполняется с ключами ANALYZE и BUFFERS, а оценки стоимости и время каждого узла отключены ради краткости вывода:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF)
SELECT avg(value) FROM measurements
WHERE run_id = 7 AND channel = 'BPM01';
$ psql < explain.sql
QUERY PLAN
--------------------------------------------------------------------------------
Finalize Aggregate (actual rows=1 loops=1)
Buffers: shared hit=7353
-> Gather (actual rows=3 loops=1)
Workers Planned: 2
Workers Launched: 2
Buffers: shared hit=7353
-> Partial Aggregate (actual rows=1 loops=3)
Buffers: shared hit=7353
-> Parallel Seq Scan on measurements (actual rows=1667 loops=3)
Filter: ((run_id = 7) AND (channel = 'BPM01'::text))
Rows Removed by Filter: 331667
Buffers: shared hit=7353
Planning:
Buffers: shared hit=85 read=1
Planning Time: 0.213 ms
Execution Time: 16.411 ms
(16 rows)
$ psql -c 'CREATE INDEX m_run_ch ON measurements (run_id, channel)'
CREATE INDEX
$ psql < explain.sql
QUERY PLAN
----------------------------------------------------------------------------
Aggregate (actual rows=1 loops=1)
Buffers: shared hit=38 read=7
-> Index Scan using m_run_ch on measurements (actual rows=5000 loops=1)
Index Cond: ((run_id = 7) AND (channel = 'BPM01'::text))
Buffers: shared hit=38 read=7
Planning:
Buffers: shared hit=115 read=1
Planning Time: 0.268 ms
Execution Time: 0.359 ms
(9 rows)
Без индекса план представляет собой параллельный полный просмотр: два дополнительных процесса (Workers Launched: 2) и основной разбирают страницы таблицы диапазонами по мере готовности; actual rows=1667 loops=3 означает в среднем 1667 строк на каждый из трёх процессов, и каждый отбрасывает в среднем 331 667 строк. Всего из кеша прочитано 7353 страницы, и запрос выполняется за 16,4 мс. С индексом план — Index Scan: прочитано 45 страниц, 38 из кеша и 7 с диска, а время выполнения — 0,36 мс, в 46 раз меньше. Страниц прочитано в 160 раз меньше, поскольку точки одного канала одного захода лежат в таблице рядом, и индекс ведёт прямо к ним; если бы строки вставлялись вразброс, точки канала оказались бы на разных страницах, и чтение по индексу обошлось бы дороже.
Если в узле сортировки появляется строка Sort Method: external merge Disk: ..., сортировке не хватило памяти work_mem — по умолчанию 4 МБ на каждый узел сортировки, а хеш-таблице вдвое больше (hash_mem_multiplier = 2), — и запрос пишет временные файлы. EXPLAIN ANALYZE действительно выполняет запрос, поэтому изменяющие команды проверяют внутри транзакции, которую затем откатывают: BEGIN; EXPLAIN ANALYZE DELETE ...; ROLLBACK;. Подсказок планировщику в ядре PostgreSQL нет, их добавляют расширения, и относятся к ним настороженно: закреплённый план опирается на прошлые предположения о данных.
Резюме
СУБД берёт на себя то, с чем не справляются папки с файлами: одновременный доступ, целостность данных, быстрый поиск и восстановление после сбоев. Схема с первичными и внешними ключами и ограничениями служит документацией, которую база проверяет при каждой записи; в SQLite для этого необходимы команда PRAGMA foreign_keys = ON в каждом соединении и, где важны типы, таблицы STRICT, а время записывается в UTC. SQL описывает нужный результат, оставляя способ его получения планировщику. Индекс на основе B-дерева заменяет просмотр миллиона строк спуском по трём-четырём страницам, однако занимает место и замедляет запись, поэтому индексы строят под частые запросы и проверяют их использование планом. Таким образом, скорость запроса определяется схемой, индексами и статистикой, по которой планировщик выбирает план, и после массовой загрузки статистику собирают заново. Работа с базами из программ на Python, транзакции, резервные копии, репликация и выбор хранилища рассматриваются в главе «Работа с базами данных».
Полезные ссылки
- Документация SQLite
- Документация PostgreSQL 17
- SQLBolt, интерактивный учебник SQL с упражнениями
- PostgreSQL Tutorial
- Use The Index, Luke — руководство М. Винанда по индексам и планам запросов
- Рогов Е. В. PostgreSQL 18 изнутри
- DB Browser for SQLite
Работа с базами данных
В настоящей главе рассматривается работа с базами данных из программ и их эксплуатация. Глава продолжает главу «Базы данных», где изложены назначение СУБД, реляционная модель, язык SQL и индексы, и использует её сквозной пример — журнал измерений lab.db, который заполняет скрипт make_lab.py, — а также сервер PostgreSQL в контейнере pg, запущенный там же вместе с псевдонимом psql. Последовательно рассматриваются драйверы sqlite3 и psycopg и защита от SQL-инъекций, транзакции и одновременный доступ, выбор между SQLite, PostgreSQL и MySQL, ORM SQLAlchemy, резервные копии, репликация, масштабирование и мониторинг, нереляционные хранилища и выбор СУБД, затем учебный сервис в четырёх хранилищах, связка баз данных с pandas и порядок перехода лаборатории от файлов к базе. Опыты главы продолжают опыты главы «Базы данных»: журнал содержит построенные там индексы и статистику, а в PostgreSQL лежит таблица measurements из опыта с EXPLAIN ANALYZE.
Листинги главы выполнены на той же машине, что и листинги главы «Базы данных», — виртуальной машине под Python 3.12 со встроенной библиотекой SQLite 3.45, SQLAlchemy 2.1, psycopg 3.3, pandas 3.0 и Flask 3.1, на которой записаны демонстрации лекции «Базы данных»; PostgreSQL 17 и Redis 8 работали на ней в контейнерах Docker. Консоли sqlite3 на машине нет, и запросы к SQLite выполнены модулем sqlite3 из Python. Времена выполнения зависят от машины и меняются от запуска к запуску, тогда как планы запросов, числа строк и значения воспроизводятся.
Тот же SQL из Python
Слайды к главе. Интерфейс DB-API на примере модулей sqlite3 и psycopg, параметры запросов и SQL-инъекции, ORM SQLAlchemy, pandas и форматы файлов изложены также в пятой части лекции «Базы данных» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Модуль sqlite3
Модуль sqlite3, входящий в стандартную библиотеку, устанавливать не требуется. Драйверы баз данных в Python следуют общему интерфейсу DB-API, описанному в PEP 249: функция connect возвращает соединение, метод execute выполняет запрос с параметрами, fetchone и fetchall или итерация по курсору возвращают строки кортежами, commit и rollback управляют транзакцией. Поэтому код для SQLite и PostgreSQL выглядит почти одинаково. Рассмотрим скрипт сбора данных, записывающий точки в отдельную базу daq.db:
import random
import sqlite3
def read_adc():
"""Опрос АЦП; здесь сигнал датчика положения имитируется генератором."""
return round(random.gauss(0.41, 0.002), 4)
random.seed(1)
# открывается (или создаётся) файл базы; ":memory:" — временная база в памяти
con = sqlite3.connect("daq.db")
# в SQLite проверка внешних ключей по умолчанию выключена
con.execute("PRAGMA foreign_keys = ON")
cur = con.cursor() # курсор выполняет запросы и отдаёт результаты
# таблица создаётся, если её ещё нет (текст запроса — тот же SQL)
cur.execute("""
CREATE TABLE IF NOT EXISTS measurements (
id INTEGER PRIMARY KEY,
run_id INTEGER NOT NULL,
channel TEXT NOT NULL,
t REAL NOT NULL,
value REAL NOT NULL
)
""")
# одиночная вставка: значения передаются кортежем, в запросе — знаки вопроса
cur.execute(
"INSERT INTO measurements (run_id, channel, t, value) VALUES (?, ?, ?, ?)",
(1, "BPM01", 0.0, 0.412),
)
# массовая вставка: executemany принимает любой итерируемый объект
points = [(1, "BPM01", i / 10, read_adc()) for i in range(1, 1000)]
cur.executemany(
"INSERT INTO measurements (run_id, channel, t, value) VALUES (?, ?, ?, ?)",
points,
)
con.commit() # изменения фиксируются на диске
# выборка: по курсору можно итерироваться, каждая строка — кортеж
for t, value in cur.execute(
"SELECT t, value FROM measurements WHERE channel = ? AND t < ? ORDER BY t",
("BPM01", 0.3),
):
print(t, value)
con.close()
0.0 0.412
0.1 0.4126
0.2 0.4129
Для небольших выборок удобны cur.fetchone() и cur.fetchall(), однако итерация по курсору экономнее: строки читаются по мере надобности и не накапливаются в памяти все сразу. Повторный запуск скрипта добавит в таблицу ещё тысячу точек, поскольку CREATE TABLE IF NOT EXISTS существующую таблицу не пересоздаёт.
Драйвер psycopg
Для PostgreSQL в новом коде используют драйвер psycopg третьей версии (pip install "psycopg[binary]"), заменяющий psycopg2: он передаёт параметры серверу отдельно от текста запроса, умеет работать асинхронно и поддерживает конвейерную отправку команд. Отличий от sqlite3 два. Знак параметра — %s вместо ?. Конструкция with psycopg.connect(...) as conn: при выходе из блока фиксирует транзакцию и закрывает соединение, тогда как with con: в sqlite3 только завершает транзакцию, оставляя соединение открытым. Для массовой загрузки вместо тысяч INSERT используют команду COPY, которой psycopg передаёт строки потоком; это самый быстрый способ загрузить данные в PostgreSQL.
import psycopg
DSN = "host=127.0.0.1 user=postgres password=lab"
points = [(7, "BPM01", i / 100, round(0.16 + 1e-4 * i, 4)) for i in range(5000)]
with psycopg.connect(DSN) as conn: # при выходе: COMMIT и закрытие
conn.execute("DROP TABLE IF EXISTS points")
conn.execute("CREATE TABLE points (run_id int, channel text, t float8, value float8)")
with conn.cursor().copy(
"COPY points (run_id, channel, t, value) FROM STDIN"
) as copy:
for row in points:
copy.write_row(row) # строки уходят серверу потоком
rows = conn.execute(
"SELECT t, value FROM points WHERE run_id = %s AND t < %s ORDER BY t",
(7, 0.03),
).fetchall()
print(rows)
[(0.0, 0.16), (0.01, 0.1601), (0.02, 0.1602)]
Соединение с PostgreSQL обслуживает отдельный серверный процесс, и открыть его дорого. Оценим, во что обходится соединение на каждый запрос, по сравнению с одним постоянным соединением и с пулом psycopg_pool.ConnectionPool из пакета psycopg-pool:
import time
import psycopg
from psycopg_pool import ConnectionPool
DSN = "host=127.0.0.1 user=postgres password=lab"
N = 200
def per_query(func):
"""Среднее время одного вызова, мс."""
start = time.perf_counter()
for _ in range(N):
func()
return (time.perf_counter() - start) / N * 1000
def new_connection(): # соединение на каждый запрос
with psycopg.connect(DSN) as conn:
conn.execute("SELECT 1").fetchone()
conn = psycopg.connect(DSN, autocommit=True) # одно соединение на всю работу
pool = ConnectionPool(DSN, min_size=2, max_size=4, open=True)
def from_pool(): # соединение из пула, затем обратно
with pool.connection() as c:
c.execute("SELECT 1").fetchone()
print(f"новое соединение {per_query(new_connection):6.2f} мс на запрос")
print(f"одно соединение {per_query(lambda: conn.execute('SELECT 1').fetchone()):6.2f} мс на запрос")
print(f"пул соединений {per_query(from_pool):6.2f} мс на запрос")
pool.close()
новое соединение 3.15 мс на запрос
одно соединение 0.07 мс на запрос
пул соединений 0.19 мс на запрос
Открытие соединения, включающее сетевое рукопожатие, проверку пароля и запуск серверного процесса, обходится в 3 мс, в 45 раз дороже самого запроса. Пул держит соединения открытыми и выдаёт их на время блока with pool.connection(); по выходе из блока он фиксирует транзакцию и возвращает соединение в пул. Разница с одним соединением объясняется именно транзакцией: соединение из пула работает без автофиксации, и запрос обрамляют команды BEGIN и COMMIT, а с параметром kwargs={"autocommit": True} пул отвечает так же быстро, как одно соединение. Таким образом, сервис открывает соединения один раз на процесс — пулом в самой программе или посредником PgBouncer перед сервером, — а не на каждый запрос.
Параметризованные запросы и SQL-инъекции
В примерах выше значения подставлялись через знаки вопроса, а не f-строками, и причиной этого является безопасность. Пусть имя канала приходит извне: из формы на веб-странице, из аргумента командной строки или из присланного файла.
channel = input("Канал: ")
# ТАК ДЕЛАТЬ НЕЛЬЗЯ: запрос склеивается из чужого текста
cur.execute(f"SELECT t, value FROM measurements WHERE channel = '{channel}'")
Если пользователь введёт ' OR '1'='1, итоговый запрос превратится в ... WHERE channel = '' OR '1'='1', где условие всегда истинно, фильтр исчезает, а наружу уходит вся таблица. Ввод вида '; DROP TABLE measurements; -- в драйвере, исполняющем несколько команд подряд, уничтожит таблицу. Это явление называется SQL-инъекцией, одной из самых старых и до сих пор распространённых уязвимостей (см. xkcd про школьника Bobby Tables).
Параметризованный запрос неуязвим по построению: текст запроса и данные передаются драйверу раздельно, и введённая строка остаётся строкой при любом содержимом:
# правильно: запрос отдельно, данные отдельно
cur.execute("SELECT t, value FROM measurements WHERE channel = ?", (channel,))
Проверим оба способа на копии журнала inject.db (cp lab.db inject.db): последний опыт удаляет таблицу, и ставить его на рабочем журнале нельзя. Скрипт получает имя канала аргументом командной строки и считает точки запросом, склеенным f-строкой, и запросом с параметром:
"""SQL-инъекция: запрос, склеенный из строки, против запроса с параметром."""
import sqlite3
import sys
con = sqlite3.connect("inject.db") # копия журнала: cp lab.db inject.db
channel = sys.argv[-1]
unsafe = f"SELECT count(*) FROM measurements WHERE channel = '{channel}'"
print("склеено: ", unsafe)
if sys.argv[1] == "--script": # executescript выполняет все операторы
con.executescript(unsafe)
tables = con.execute("SELECT name FROM sqlite_master WHERE type = 'table'")
print("таблицы: ", [row[0] for row in tables])
sys.exit()
try:
print("склейка: ", con.execute(unsafe).fetchone()[0], "строк")
except sqlite3.Error as e:
print("склейка: ", f"{type(e).__name__}: {e}")
safe = "SELECT count(*) FROM measurements WHERE channel = ?"
print("параметр:", con.execute(safe, (channel,)).fetchone()[0], "строк")
$ python3 inject.py BPM01
склеено: SELECT count(*) FROM measurements WHERE channel = 'BPM01'
склейка: 200000 строк
параметр: 200000 строк
$ python3 inject.py "' OR '1'='1"
склеено: SELECT count(*) FROM measurements WHERE channel = '' OR '1'='1'
склейка: 1000000 строк
параметр: 0 строк
$ python3 inject.py "'; DROP TABLE measurements; --"
склеено: SELECT count(*) FROM measurements WHERE channel = ''; DROP TABLE measurements; --'
склейка: ProgrammingError: You can only execute one statement at a time.
параметр: 0 строк
$ python3 inject.py --script "'; DROP TABLE measurements; --"
склеено: SELECT count(*) FROM measurements WHERE channel = ''; DROP TABLE measurements; --'
таблицы: ['experiments', 'runs', 'sqlite_stat1']
Для обычного ввода оба способа возвращают 200 000 строк. Ввод ' OR '1'='1 превращает склеенный запрос в условие, истинное для всех строк, и запрос возвращает 1 000 000 — все измерения всех каналов, — а запрос с параметром ищет канал с именем ' OR '1'='1 и находит 0 строк. Ввод с точкой с запятой и DROP TABLE в методе execute не срабатывает: модуль sqlite3 отказывается выполнять больше одного оператора и выдаёт ProgrammingError. Это свойство драйвера, а не защита: тот же ввод, переданный в executescript, который выполняет операторы подряд, удаляет таблицу measurements, и в базе остаются только experiments, runs и служебная таблица статистики sqlite_stat1, созданная командой ANALYZE в главе «Базы данных».
Значения передаются только через параметры, всегда, даже если данные собственные. Параметром может быть лишь значение, но не имя таблицы или столбца; имена, подставляемые динамически, необходимо проверять по белому списку. Вторая линия защиты — права: сервис подключается к базе от роли, которой разрешены только нужные операции с нужными таблицами, и команда DROP TABLE от его имени не выполнится.
Транзакции и ACID
Слайды к главе. Гарантии ACID и цена фиксации, уровни изоляции, блокировки и журнал WAL в SQLite и многоверсионность в PostgreSQL изложены также в четвёртой части лекции «Базы данных» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Транзакция представляет собой группу запросов, выполняемую как единое целое: применяются либо все, либо ни один. Её гарантии описывает аббревиатура ACID. Атомарность (atomicity) означает неделимость транзакции: сбой, случившийся на середине, откатывает всё сделанное. Согласованность (consistency) требует, чтобы база переходила из одного корректного состояния в другое, не нарушая ограничений — ключей, NOT NULL, UNIQUE. Изолированность (isolation) скрывает от параллельных транзакций промежуточные состояния друг друга; насколько строго, задаёт уровень изоляции, рассматриваемый ниже. Долговечность (durability) сохраняет подтверждённые командой COMMIT данные даже при внезапном отключении питания, поскольку до ответа клиенту изменения записываются в журнал на диске.
Заход и снятые в нём точки необходимо записывать в базу вместе: заход без точек и точки без захода одинаково бессмысленны.
import sqlite3
def save_run(con, run_row, points):
"""Сохраняет заход и все его измерения одной транзакцией."""
cur = con.cursor()
try:
cur.execute("INSERT INTO runs (experiment_id, run_number, energy_mev, started_at) "
"VALUES (?, ?, ?, ?)", run_row) # неявно открывает транзакцию
run_id = cur.lastrowid
cur.executemany("INSERT INTO measurements (run_id, channel, t, value) "
"VALUES (?, ?, ?, ?)", [(run_id, ch, t, v) for ch, t, v in points])
con.commit()
except sqlite3.Error:
con.rollback()
raise
Модуль sqlite3 открывает транзакцию неявно перед первой изменяющей командой, commit её фиксирует, rollback откатывает. Ту же пару обеспечивает конструкция with con:, подтверждающая транзакцию при выходе из блока и откатывающая её при исключении; соединение она, в отличие от файла в конструкции with open, не закрывает. Проверим функцию на журнале:
con = sqlite3.connect("lab.db")
con.execute("PRAGMA foreign_keys = ON")
count = "SELECT (SELECT count(*) FROM runs), (SELECT count(*) FROM measurements)"
print("до: ", con.execute(count).fetchone())
save_run(con, (2, 42, 25.0, "2026-09-02T10:00:00Z"), [("BPM01", 0.0, 0.5), ("BPM01", 0.01, 0.51)])
print("после 42: ", con.execute(count).fetchone())
try: # вторая точка без значения: NOT NULL нарушен на середине транзакции
save_run(con, (2, 43, 25.5, "2026-09-02T11:00:00Z"), [("BPM01", 0.0, 0.5), ("BPM01", 0.01, None)])
except sqlite3.IntegrityError as e:
print("ошибка: ", e)
print("после 43: ", con.execute(count).fetchone(), "| заход 43:",
con.execute("SELECT count(*) FROM runs WHERE run_number = 43").fetchone()[0])
try: # то же через with con: — commit при успехе, rollback при исключении
with con:
con.execute("INSERT INTO runs (experiment_id, run_number, energy_mev, started_at) "
"VALUES (2, 44, 26.0, '2026-09-02T12:00:00Z')")
con.execute("INSERT INTO runs (experiment_id, run_number, energy_mev, started_at) "
"VALUES (2, 44, 26.0, '2026-09-02T12:00:00Z')") # UNIQUE нарушен
except sqlite3.IntegrityError as e:
print("with con: ", e)
print("после 44: ", con.execute(count).fetchone(), "| соединение открыто:",
con.execute("SELECT 1").fetchone() == (1,))
до: (41, 1000000)
после 42: (42, 1000002)
ошибка: NOT NULL constraint failed: measurements.value
после 43: (42, 1000002) | заход 43: 0
with con: UNIQUE constraint failed: runs.experiment_id, runs.run_number
после 44: (42, 1000002) | соединение открыто: True
Заход 42 с двумя точками записан, и счётчики стали 42 и 1 000 002. У второй точки захода 43 значение пустое: первая точка вставилась, вторая нарушила ограничение NOT NULL, и rollback откатил всю транзакцию — счётчики прежние, а самого захода 43 в таблице нет. Тот же результат даёт with con:, внутри которой заход 44 вставляется дважды: второй раз нарушает ограничение UNIQUE на паре кампании и номера захода, транзакция откатывается, а соединение остаётся открытым.
Долговечность требует времени: каждая фиксация ждёт, пока диск подтвердит запись. Оценим цену фиксации на скрипте bulk.py, который вставляет 1000 строк четырьмя способами; соединение открыто в режиме автофиксации, в котором каждый оператор вне явной транзакции фиксируется сам:
"""Цена фиксации: 1000 точек четырьмя способами (SQLite, режим журнала по умолчанию)."""
import os
import sqlite3
import sys
import time
N = int(sys.argv[1]) if len(sys.argv) > 1 else 1000
SCHEMA = "CREATE TABLE m (run_id INTEGER, channel TEXT, t REAL, value REAL)"
ROWS = [(1, "BPM01", i / 10, 0.4 + i * 1e-4) for i in range(N)]
INSERT = "INSERT INTO m VALUES (?, ?, ?, ?)"
def fresh(path="bulk.db"):
for suffix in ("", "-journal", "-wal", "-shm"):
if os.path.exists(path + suffix):
os.remove(path + suffix)
con = sqlite3.connect(path, isolation_level=None) # автофиксация каждого оператора
con.execute(SCHEMA)
return con
def commit_each(con):
for row in ROWS:
con.execute(INSERT, row) # каждая вставка фиксируется отдельно
def one_transaction(con):
con.execute("BEGIN")
for row in ROWS:
con.execute(INSERT, row)
con.execute("COMMIT")
def executemany(con):
con.execute("BEGIN")
con.executemany(INSERT, ROWS)
con.execute("COMMIT")
def multi_values(con):
step = 32766 // 4 # предел числа параметров в одном запросе
for k in range(0, N, step):
chunk = ROWS[k:k + step]
sql = "INSERT INTO m VALUES " + ", ".join(["(?, ?, ?, ?)"] * len(chunk))
con.execute(sql, [x for row in chunk for x in row])
print(f"SQLite {sqlite3.sqlite_version}, {N} строк")
for func in (commit_each, one_transaction, executemany, multi_values):
con = fresh()
start = time.perf_counter()
func(con)
elapsed = time.perf_counter() - start
count = con.execute("SELECT count(*) FROM m").fetchone()[0]
con.close()
print(f"{func.__name__:16s} {elapsed * 1000:9.1f} мс ({count} строк)")
SQLite 3.45.1, 1000 строк
commit_each 654.8 мс (1000 строк)
one_transaction 1.8 мс (1000 строк)
executemany 1.5 мс (1000 строк)
multi_values 2.0 мс (1000 строк)
Когда каждая вставка фиксируется отдельно, тысяча строк записывается за 0,65 с: тысяча фиксаций означает тысячу ожиданий подтверждения от диска. Те же вставки в рамках одной транзакции занимают 1,8 мс, через executemany — 1,5 мс, многострочным VALUES — 2,0 мс: важна не форма запроса, а число фиксаций. Таким образом, скрипт сбора данных записывает точки группами и фиксирует их раз в несколько секунд, а не после каждой точки.
Уровни изоляции
Полная изоляция, при которой параллельные транзакции дают тот же результат, что и выполненные по очереди, дорога, поэтому стандарт SQL определяет четыре уровня изоляции через аномалии, допустимые на каждом из них. Грязное чтение — транзакция видит незафиксированные изменения другой. Неповторяемое чтение — повторный запрос той же строки внутри транзакции возвращает другое значение, потому что другая транзакция успела её изменить и зафиксировать. Фантомы — повторный запрос по условию возвращает новые строки. Аномалия сериализации — результат параллельных транзакций невозможно получить ни при каком порядке их последовательного выполнения.
| Уровень | Грязное чтение | Неповторяемое чтение | Фантомы | Аномалия сериализации |
|---|---|---|---|---|
| READ UNCOMMITTED | возможно | возможно | возможны | возможна |
| READ COMMITTED | нет | возможно | возможны | возможна |
| REPEATABLE READ | нет | нет | возможны | возможна |
| SERIALIZABLE | нет | нет | нет | нет |
Таблица показывает минимальные требования стандарта; реализации бывают строже. PostgreSQL по умолчанию работает на уровне READ COMMITTED, где каждый оператор видит данные, зафиксированные к его началу. На уровне REPEATABLE READ вся транзакция видит снимок на момент первого запроса, и фантомов в PostgreSQL на нём тоже нет, а READ UNCOMMITTED ведёт себя как READ COMMITTED. MySQL с движком InnoDB по умолчанию использует REPEATABLE READ, а SQLite обеспечивает сериализуемость, разрешая в каждый момент одну пишущую транзакцию. За строгость платят: на уровнях REPEATABLE READ и SERIALIZABLE PostgreSQL может прервать транзакцию ошибкой сериализации, и приложение обязано повторить её целиком. Поведение обоих уровней показывает опыт в конце раздела.
Блокировки и журнал WAL в SQLite
SQLite разграничивает доступ блокировками всего файла базы. В режиме журнала по умолчанию, DELETE, транзакция перед изменением страницы копирует её прежнее содержимое в файл lab.db-journal, а новые страницы записывает в lab.db при фиксации; при сбое прежние страницы восстанавливаются из журнала. Чтобы зафиксировать транзакцию, писателю нужна исключительная блокировка, и он ждёт, пока не закончатся все читающие транзакции; новые читатели, в свою очередь, ждут окончания фиксации.
В режиме WAL, который включает команда PRAGMA journal_mode=WAL, новые версии страниц дописываются в файл lab.db-wal, а основной файл не меняется до контрольной точки, которая переносит страницы обратно. Читатель видит снимок базы на момент начала своей транзакции, и режим WAL обеспечивает чтение одновременно с записью: график строится, пока скрипт сбора пишет данные. Писатель в обоих режимах один: вторая пишущая транзакция ждёт освобождения блокировки время timeout, по умолчанию 5 с в модуле sqlite3, и затем получает ошибку database is locked. Транзакцию, которая будет писать, начинают командой BEGIN IMMEDIATE, чтобы ждать блокировку сразу, а не посреди работы. Режим WAL запоминается в файле базы, но требует, чтобы все процессы работали на одной машине: на сетевом диске (NFS, SMB) он неприменим.
Скрипт locks.py открывает к одной базе два соединения с явным управлением транзакциями и временем ожидания блокировки 0,5 с: соединение A пишет, B читает.
"""Два соединения к одной базе SQLite: блокировки в режиме журнала DELETE и в WAL."""
import os
import sqlite3
import sys
import time
MODE = sys.argv[1]
for f in ("locks.db", "locks.db-wal", "locks.db-shm", "locks.db-journal"):
if os.path.exists(f):
os.remove(f)
setup = sqlite3.connect("locks.db")
mode = setup.execute(f"PRAGMA journal_mode={MODE}").fetchone()[0]
setup.execute("CREATE TABLE m (run_id INTEGER, value REAL)")
setup.execute("INSERT INTO m VALUES (1, 0.41)")
setup.commit()
setup.close()
# isolation_level=None: транзакции открываются и завершаются явно
a = sqlite3.connect("locks.db", isolation_level=None, timeout=0.5) # пишет
b = sqlite3.connect("locks.db", isolation_level=None, timeout=0.5) # читает
def rows(con):
return con.execute("SELECT count(*) FROM m").fetchone()[0]
def attempt(sql_con, sql):
start = time.perf_counter()
try:
sql_con.execute(sql)
result = "ok"
except sqlite3.OperationalError as e:
result = str(e)
return f"{result} ({time.perf_counter() - start:.2f} с)"
print("journal_mode =", mode)
a.execute("BEGIN IMMEDIATE")
a.execute("INSERT INTO m VALUES (2, 0.42)")
print(f"1. A: BEGIN IMMEDIATE, INSERT A видит {rows(a)}, B видит {rows(b)}")
print(f"2. B: INSERT, пока пишет A {attempt(b, 'INSERT INTO m VALUES (3, 0.43)')}")
print(f"3. A: COMMIT {attempt(a, 'COMMIT')}, B видит {rows(b)}")
b.execute("BEGIN")
print(f"4. B: BEGIN, SELECT B видит {rows(b)}")
a.execute("BEGIN IMMEDIATE")
a.execute("INSERT INTO m VALUES (4, 0.44)")
print(f"5. A: INSERT, COMMIT при чтении B {attempt(a, 'COMMIT')}, B видит {rows(b)}")
b.execute("COMMIT")
if a.in_transaction:
print(f"6. B: COMMIT; A: повторный COMMIT {attempt(a, 'COMMIT')}, B видит {rows(b)}")
else:
print(f"6. B: COMMIT B видит {rows(b)}")
print("файлы:", " ".join(sorted(f for f in os.listdir(".") if f.startswith("locks.db"))))
$ python3 locks.py delete
journal_mode = delete
1. A: BEGIN IMMEDIATE, INSERT A видит 2, B видит 1
2. B: INSERT, пока пишет A database is locked (0.54 с)
3. A: COMMIT ok (0.01 с), B видит 2
4. B: BEGIN, SELECT B видит 2
5. A: INSERT, COMMIT при чтении B database is locked (0.53 с), B видит 2
6. B: COMMIT; A: повторный COMMIT ok (0.01 с), B видит 3
файлы: locks.db
$ python3 locks.py wal
journal_mode = wal
1. A: BEGIN IMMEDIATE, INSERT A видит 2, B видит 1
2. B: INSERT, пока пишет A database is locked (0.53 с)
3. A: COMMIT ok (0.01 с), B видит 2
4. B: BEGIN, SELECT B видит 2
5. A: INSERT, COMMIT при чтении B ok (0.00 с), B видит 2
6. B: COMMIT B видит 3
файлы: locks.db locks.db-shm locks.db-wal
В режиме DELETE незафиксированная строка A соединению B не видна, а попытка B вставить свою строку ждёт 0,5 с и завершается ошибкой database is locked: писатель может быть только один. После фиксации A соединение B видит две строки. Затем B открывает читающую транзакцию, A вставляет ещё строку, и его COMMIT через 0,5 с тоже получает database is locked: фиксации мешает открытое чтение. Транзакция A при этом не теряется: после COMMIT в B повторный COMMIT в A проходит, и B видит три строки. В режиме WAL второй писатель по-прежнему получает отказ, но COMMIT при открытом чтении B проходит сразу, а B до конца своей транзакции видит снимок с двумя строками и лишь в новой транзакции видит три. Рядом с базой появляются файлы locks.db-wal и locks.db-shm.
Многоверсионность в PostgreSQL
PostgreSQL изолирует транзакции не блокировками на чтение, а многоверсионностью (multiversion concurrency control, MVCC). UPDATE не меняет строку на месте: он записывает новую версию строки, а у старой отмечает в служебном поле xmax номер изменившей транзакции; у каждой версии в поле xmin записан номер создавшей её транзакции. Каждый запрос работает со снимком — сведениями о том, какие транзакции были зафиксированы к его началу, — и по xmin и xmax решает, какую из версий видеть. Поэтому читатели не ждут писателей, а писатели не ждут читателей; ждать друг друга приходится только транзакциям, изменяющим одну и ту же строку. Откат дёшев: транзакция лишь помечается прерванной, а её версии становятся невидимыми.
Покажем, как версии строки видны на разных уровнях изоляции. Скрипт mvcc.py открывает два сеанса. Сеанс A работает в режиме автофиксации, в котором каждая команда составляет отдельную транзакцию, а сеанс B начинает транзакцию на заданном уровне изоляции и читает строку вместе с полями xmin и xmax.
"""Два сеанса PostgreSQL: версии строки и уровень изоляции читателя."""
import sys
import psycopg
LEVEL = sys.argv[1] # READ COMMITTED или REPEATABLE READ
DSN = "host=127.0.0.1 user=postgres password=lab"
ROW = "SELECT xmin, xmax, energy FROM runs WHERE id = 1"
a = psycopg.connect(DSN, autocommit=True) # A: каждая команда — своя транзакция
b = psycopg.connect(DSN, autocommit=True) # B: транзакция открывается явно
a.execute("DROP TABLE IF EXISTS runs")
a.execute("CREATE TABLE runs (id int PRIMARY KEY, energy real)")
a.execute("INSERT INTO runs VALUES (1, 5.0)")
def show(who, con):
xmin, xmax, energy = con.execute(ROW).fetchone()
print(f"{who:26s} xmin={xmin} xmax={xmax} energy={energy}")
print("уровень изоляции B:", LEVEL)
b.execute(f"BEGIN ISOLATION LEVEL {LEVEL}")
show("B: BEGIN, SELECT", b)
a.execute("UPDATE runs SET energy = 5.5 WHERE id = 1")
show("A: UPDATE зафиксирован", a)
show("B: тот же SELECT", b)
try:
b.execute("UPDATE runs SET energy = energy + 1 WHERE id = 1")
b.execute("COMMIT")
show("B: свой UPDATE, COMMIT", b)
except psycopg.errors.SerializationFailure as e:
print(f"{'B: свой UPDATE':26s} {e.diag.message_primary}")
b.execute("ROLLBACK")
$ python3 mvcc.py "READ COMMITTED"
уровень изоляции B: READ COMMITTED
B: BEGIN, SELECT xmin=747 xmax=0 energy=5.0
A: UPDATE зафиксирован xmin=748 xmax=0 energy=5.5
B: тот же SELECT xmin=748 xmax=0 energy=5.5
B: свой UPDATE, COMMIT xmin=749 xmax=0 energy=6.5
$ python3 mvcc.py "REPEATABLE READ"
уровень изоляции B: REPEATABLE READ
B: BEGIN, SELECT xmin=752 xmax=0 energy=5.0
A: UPDATE зафиксирован xmin=753 xmax=0 energy=5.5
B: тот же SELECT xmin=752 xmax=753 energy=5.0
B: свой UPDATE could not serialize access due to concurrent update
На уровне READ COMMITTED сеанс B сначала видит версию с xmin=747; после того как A изменил строку и зафиксировал изменение, тот же запрос в той же транзакции B возвращает новую версию, xmin=748 и energy=5.5. Это неповторяемое чтение. Собственный UPDATE в B прибавляет единицу к последнему зафиксированному значению, и после фиксации значение равно 6,5. На уровне REPEATABLE READ сеанс B после изменения в A продолжает видеть старую версию: xmin=752 и xmax=753, то есть версия уже удалена транзакцией 753, но снимок B взят до её фиксации. Когда B пытается изменить эту строку, PostgreSQL отвечает ошибкой could not serialize access due to concurrent update: изменение по устаревшему снимку потеряло бы обновление из A, и транзакцию B необходимо повторить. Номера транзакций зависят от предыстории сервера и при повторе опыта будут другими.
Обратная сторона многоверсионности — мёртвые версии, которые не видит уже ни один снимок. Их убирает команда VACUUM, обычно запускаемая автоочисткой. Долгая транзакция или забытый открытый сеанс держат старый снимок, и VACUUM не может удалить версии, которые этот снимок ещё видит. Покажем это на таблице из 100 000 строк с отключённой автоочисткой; число живых и мёртвых версий и размер файла считает функция pgstattuple одноимённого расширения:
import psycopg
DSN = "host=127.0.0.1 user=postgres password=lab"
a = psycopg.connect(DSN, autocommit=True)
a.execute("CREATE EXTENSION IF NOT EXISTS pgstattuple")
a.execute("DROP TABLE IF EXISTS runs_log")
a.execute("CREATE TABLE runs_log (id int PRIMARY KEY, energy real) "
"WITH (autovacuum_enabled = off)") # автоочистка не вмешивается
a.execute("INSERT INTO runs_log SELECT i, 5.0 FROM generate_series(1, 100000) AS i")
def state(stage):
live, dead, size = a.execute(
"SELECT tuple_count, dead_tuple_count, table_len FROM pgstattuple('runs_log')"
).fetchone()
print(f"{stage:28s} живых {live:6d}, мёртвых {dead:6d}, файл {size / 2**20:.1f} МиБ")
state("после вставки")
b = psycopg.connect(DSN, autocommit=True)
b.execute("BEGIN ISOLATION LEVEL REPEATABLE READ") # долгая транзакция
b.execute("SELECT count(*) FROM runs_log").fetchone() # снимок взят
a.execute("UPDATE runs_log SET energy = energy + 0.5")
state("после UPDATE всех строк")
a.execute("VACUUM runs_log")
state("VACUUM при открытом снимке")
b.execute("COMMIT")
a.execute("VACUUM runs_log")
state("VACUUM после COMMIT в B")
a.execute("VACUUM FULL runs_log")
state("VACUUM FULL")
после вставки живых 100000, мёртвых 0, файл 3.5 МиБ
после UPDATE всех строк живых 100000, мёртвых 100000, файл 6.9 МиБ
VACUUM при открытом снимке живых 100000, мёртвых 100000, файл 6.9 МиБ
VACUUM после COMMIT в B живых 100000, мёртвых 0, файл 6.9 МиБ
VACUUM FULL живых 100000, мёртвых 0, файл 3.5 МиБ
UPDATE всех строк удвоил файл: новые версии записаны рядом со старыми. VACUUM при открытом снимке B не удалил ни одной мёртвой версии, после завершения транзакции B удалил все, но файл остался прежнего размера. Обычный VACUUM освобождает место внутри файла, и следующие изменения займут его, а уменьшает файл, лишь когда освободились страницы в самом его конце; сжимает таблицу VACUUM FULL, переписывая её под исключительной блокировкой. При частых изменениях и долгих транзакциях таблица и её индексы разрастаются, и простой запрос начинает читать тысячи мёртвых версий ради одной живой. Поэтому долгие транзакции необходимо находить по столбцам xact_start и backend_xmin представления pg_stat_activity и завершать.
SQLite, PostgreSQL или MySQL
Три реляционные СУБД, чаще всего встречающиеся в лаборатории, различаются не языком запросов (SQL везде почти один и тот же), а тем, кто и каким образом получает доступ к базе.
| SQLite | PostgreSQL | MySQL / MariaDB | |
|---|---|---|---|
| Архитектура | встраиваемая библиотека, вся база в одном файле | клиент-серверная, процесс на соединение | клиент-серверная, поток на соединение |
| Установка | не нужна, есть в Python | отдельный сервис | отдельный сервис |
| Одновременная запись | одна пишущая транзакция в каждый момент | много клиентов | много клиентов |
| Изоляция по умолчанию | сериализуемая | READ COMMITTED | REPEATABLE READ |
| Типизация | динамическая, строгая в таблицах STRICT | строгая, богатая (массивы, JSONB, диапазоны) | строгая, скромнее |
| Права доступа | нет (права на файл) | пользователи, роли, гранулярные права | пользователи и права |
| Сильная сторона | нулевая настройка, переносимость | функциональность и расширения (PostGIS, TimescaleDB) | распространённость в веб-хостинге |
| Типичный случай | локальные данные, прототипы, базы до десятков и сотен ГБ на локальном диске | серверное приложение, общая база группы | веб-проекты, унаследованные системы |
Если данные лежат на локальном диске и работают с ними один исследователь и его скрипты, то выбирается SQLite. Если база нужна нескольким людям или сервисам по сети, если в неё пишут одновременно и требуются права доступа, то предпочтительнее PostgreSQL: сегодня это выбор по умолчанию для серверной СУБД, а его внутреннее устройство подробно описано в книге Е. Рогова «PostgreSQL 18 изнутри» [17], которая свободно распространяется в электронном виде. MySQL чаще достаётся как данность вместе с унаследованным проектом или хостингом, чем выбирается осознанно для новой системы.
ORM: SQLAlchemy
SQL в виде строк внутри Python-кода не проверяется до запуска, результаты приходят кортежами, а логика, связывающая объект с его окружением, оказывается распределённой по запросам. ORM (Object-Relational Mapping) отображает таблицы на классы, строки на объекты, а внешние ключи на атрибуты-связи. Стандартом де-факто в Python является SQLAlchemy. Во второй версии модели описываются аннотациями Mapped и функцией mapped_column, запросы строятся функцией select, а выполняются в сеансе Session, который отслеживает изменённые объекты и при commit превращает их в INSERT и UPDATE. Пример работает с отдельной базой orm.db: модели описывают только часть столбцов схемы журнала, и вставка в lab.db нарушила бы ограничения NOT NULL её таблиц.
import sys
from sqlalchemy import ForeignKey, create_engine, event, select
from sqlalchemy.orm import (
DeclarativeBase, Mapped, Session, mapped_column, relationship, selectinload,
)
class Base(DeclarativeBase):
pass
class Run(Base):
__tablename__ = "runs"
id: Mapped[int] = mapped_column(primary_key=True)
energy_mev: Mapped[float]
# связь «один ко многим»: у захода — список измерений
measurements: Mapped[list["Measurement"]] = relationship(
back_populates="run"
)
class Measurement(Base):
__tablename__ = "measurements"
id: Mapped[int] = mapped_column(primary_key=True)
run_id: Mapped[int] = mapped_column(ForeignKey("runs.id"))
channel: Mapped[str]
value: Mapped[float]
run: Mapped[Run] = relationship(back_populates="measurements")
# отдельная база примера; адрес можно передать аргументом
engine = create_engine(sys.argv[1] if len(sys.argv) > 1 else "sqlite:///orm.db")
Base.metadata.drop_all(engine) # пример начинается с пустой базы
Base.metadata.create_all(engine) # таблицы создаются по классам
with Session(engine) as session:
# объекты вместо INSERT: связи расставляются сами
for energy in (8.0, 12.5, 15.0):
run = Run(energy_mev=energy)
run.measurements.append(Measurement(channel="BPM01", value=0.03 * energy))
session.add(run)
session.commit()
# запрос вместо SELECT ... JOIN: сразу нужные столбцы обеих таблиц
stmt = (select(Measurement.channel, Measurement.value, Run.energy_mev)
.join(Run).where(Run.energy_mev > 10.0))
print(stmt.compile(engine))
for channel, value, energy in session.execute(stmt):
print(channel, round(value, 4), energy)
SELECT measurements.channel, measurements.value, runs.energy_mev
FROM measurements JOIN runs ON runs.id = measurements.run_id
WHERE runs.energy_mev > ?
BPM01 0.375 12.5
BPM01 0.45 15.0
Перед результатом печатается SQL, который построил select: соединение JOIN с условием по внешнему ключу и параметр ? драйвера sqlite3. Запрос выбирает сразу нужные столбцы обеих таблиц. Если же выбрать объекты, select(Measurement).join(Run), и в цикле обращаться к m.run.energy_mev, соединение послужит только отбору строк: связь Measurement.run по умолчанию загружается лениво, и обращение к ней для каждого нового захода выполняет отдельный запрос SELECT ... FROM runs WHERE runs.id = ?. Это проблема N+1: один запрос за списком и по запросу на каждый его элемент. Число запросов к базе подсчитывает обработчик события before_cursor_execute; продолжение того же скрипта обходит заходы и обращается к их измерениям:
# число запросов к базе при обходе связей
queries = []
event.listen(engine, "before_cursor_execute",
lambda *args: queries.append(args[2]))
for options in ([], [selectinload(Run.measurements)]):
queries.clear()
with Session(engine) as session:
for run in session.scalars(select(Run).options(*options)):
len(run.measurements) # обращение к связи
print("selectinload:" if options else "ленивая загрузка:", len(queries), "запроса")
ленивая загрузка: 4 запроса
selectinload: 2 запроса
При ленивой загрузке обращение к связи measurements у каждого из трёх заходов выполняет отдельный запрос, всего их четыре — один за заходами и три за точками; опция selectinload позволяет обойтись двумя запросами: за заходами и затем за всеми их точками одним запросом с условием IN. Явное соединение join заполняет связь, только если указать опцию contains_eager.
Смена SQLite на PostgreSQL сводится к замене адреса в create_engine и установке драйвера (pip install "psycopg[binary]"); для простых моделей остальной код не меняется, а различия типов и поведения проявляются на сложных схемах. Тот же скрипт работает с отдельной базой orm, созданной в контейнере командой docker exec pg createdb -U postgres orm:
$ python3 orm_demo.py postgresql+psycopg://postgres:lab@127.0.0.1/orm
SELECT measurements.channel, measurements.value, runs.energy_mev
FROM measurements JOIN runs ON runs.id = measurements.run_id
WHERE runs.energy_mev > %(energy_mev_1)s
BPM01 0.375 12.5
BPM01 0.45 15.0
ленивая загрузка: 4 запроса
selectinload: 2 запроса
Текст SQL тот же, отличается только запись параметра: %(energy_mev_1)s в стиле psycopg.
ORM оправдан в приложении с десятком связанных таблиц и развивающейся схемой (накопленные миграции удобно вести инструментом Alembic), при командной разработке и множестве типовых операций «создать-прочитать-обновить-удалить». Чистый SQL предпочтителен для аналитических запросов с многоуровневыми агрегатами и оконными функциями (SQL здесь лаконичнее ORM-конструкций), для массовых загрузок и разовых скриптов. ORM не освобождает от знания SQL: он генерирует тот же SQL, и когда запрос выполняется медленно, разбираться приходится со сгенерированным текстом; для этого достаточно включить create_engine(..., echo=True) и просмотреть запросы, уходящие в базу.
Эксплуатация
Слайды к главе. Резервные копии и их восстановление, журнал WAL и восстановление на момент времени, репликация, масштабирование, мониторинг, нереляционные хранилища и выбор СУБД изложены также в шестой части лекции «Базы данных» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Раздел посвящён эксплуатации созданной базы: резервным копиям и восстановлению, журналу WAL и репликации, масштабированию и мониторингу.
Резервные копии
Резервная копия защищает от того, от чего транзакции не защищают: от ошибочной команды DROP TABLE или DELETE без WHERE, сбоя диска, потери машины. Копирование файла базы SQLite командой cp корректно, только когда к базе никто не подключён. В режиме WAL подтверждённые транзакции до контрольной точки лежат в отдельном файле, и копия одного основного файла их теряет. Согласованную копию работающей базы обеспечивает метод Connection.backup() из Python или команда VACUUM INTO. Рассмотрим разницу на процессе сбора данных writer.py, который переводит базу wal.db в режим WAL, записывает и фиксирует 500 строк и продолжает работать с открытым соединением:
"""Пишущий процесс: база в режиме WAL, 500 зафиксированных строк, соединение открыто."""
import signal
import sqlite3
import sys
import time
signal.signal(signal.SIGTERM, lambda *args: sys.exit(0)) # kill — штатное завершение
con = sqlite3.connect("wal.db")
con.execute("PRAGMA journal_mode=WAL")
con.execute("CREATE TABLE m (t REAL, value REAL)")
with con: # транзакция зафиксирована
con.executemany("INSERT INTO m VALUES (?, ?)", [(i / 10, 0.4) for i in range(500)])
try:
while True: # процесс сбора данных работает
time.sleep(1)
finally:
con.close() # последнее соединение: контрольная точка, файл -wal удаляется
Копию методом backup() делает скрипт backup.py:
"""Онлайн-копия базы SQLite: Connection.backup()."""
import sqlite3
import sys
src = sqlite3.connect(sys.argv[1])
dst = sqlite3.connect(sys.argv[2])
src.backup(dst) # согласованная копия, включая страницы из -wal
dst.close()
src.close()
Сеанс в терминале:
$ python3 writer.py &
$ sleep 1; wc -c wal.db*
4096 wal.db
32768 wal.db-shm
28872 wal.db-wal
65736 total
$ C="SELECT count(*) FROM m"
$ cp wal.db copy.db; python3 -m sqlite3 copy.db "$C"
OperationalError (SQLITE_ERROR): no such table: m
$ python3 backup.py wal.db bak.db; python3 -m sqlite3 bak.db "$C"
(500,)
$ python3 -m sqlite3 wal.db "VACUUM INTO 'into.db'"; python3 -m sqlite3 into.db "$C"
(500,)
$ kill %1; sleep 1; wc -c wal.db*
20480 wal.db
$ cp wal.db copy2.db; python3 -m sqlite3 copy2.db "$C"
(500,)
Основной файл занимает 4096 байт — одну страницу с заголовком, — а данные лежат в файле wal.db-wal. Копия основного файла открывается как база без таблиц: подтверждённые данные в неё не попали. Connection.backup() и VACUUM INTO делают согласованные копии с 500 строками. После завершения писателя его соединение закрывается штатно: последнее соединение выполняет контрольную точку, журнал переносится в основной файл, который вырастает до 20 480 байт, файлы -wal и -shm исчезают, и простая копия тоже содержит 500 строк.
Для PostgreSQL есть два способа. Утилита pg_dump создаёт логическую копию одной базы — SQL-команды или сжатый архив, который восстанавливает pg_restore, — на момент начала копирования; её можно развернуть и на более новой версии сервера. Утилита pg_basebackup снимает физическую копию файлов всего сервера, а вместе с непрерывным архивом журнала WAL позволяет восстановиться на любой момент времени. Рассмотрим первый способ на таблице measurements из опыта с EXPLAIN ANALYZE в главе «Базы данных»:
$ psql -c 'BEGIN' -c 'DROP TABLE measurements' -c 'ROLLBACK'
BEGIN
DROP TABLE
ROLLBACK
$ psql -c 'SELECT count(*) FROM measurements'
count
---------
1000000
(1 row)
$ docker exec pg pg_dump -U postgres -Fc > lab.dump; wc -c lab.dump
8678593 lab.dump
$ psql -c 'DROP TABLE measurements'
DROP TABLE
$ docker exec pg createdb -U postgres restored
$ docker exec -i pg pg_restore -U postgres -d restored < lab.dump
$ psql -d restored -c 'SELECT count(*) FROM measurements'
count
---------
1000000
(1 row)
Первая команда открывает транзакцию, удаляет таблицу и откатывает транзакцию: в PostgreSQL даже изменения схемы транзакционны, и после ROLLBACK таблица на месте со всем миллионом строк. Затем pg_dump записывает логическую копию базы в сжатом формате custom в файл lab.dump размером около 8,3 МиБ. Команда DROP TABLE без транзакции выполняется с автофиксацией, и таблица удалена безвозвратно. Восстановление идёт в отдельную базу restored, где сначала проверяют данные. Нужную таблицу затем возвращают в рабочую базу командой pg_restore -t measurements, однако этот ключ восстанавливает только определение и данные таблицы: первичный ключ, индексы и последовательность для столбца id записаны в архиве отдельными элементами, список которых выводит pg_restore -l.
Хранят копии по правилу «три-два-один»: три копии на двух видах носителей, одна из них — вне здания. Главное правило — копия без проверенного восстановления копией не считается: восстановление репетируют по инструкции на отдельной машине и проверяют, что данные на месте, а инструкцию пишут так, чтобы её выполнил дежурный ночью, а не только автор.
Журнал WAL, восстановление на момент и реплики
Журнал упреждающей записи (write-ahead log, WAL) является основой надёжности PostgreSQL: каждое изменение сначала записывается в журнал, и только потом меняются файлы таблиц, поэтому после сбоя сервер восстанавливается, проигрывая журнал от последней контрольной точки. Тот же журнал решает ещё три задачи.
Для восстановления на любой момент необходимы базовая физическая копия и непрерывный архив сегментов WAL: ночная копия и архив журнала возвращают таблицу, ошибочно удалённую вечером, в состояние за секунду до команды. Это восстановление на момент времени (point-in-time recovery, PITR). Архив включают параметры основного сервера archive_mode и archive_command, базовую копию снимает pg_basebackup, а для восстановления необходимо положить в каталог копии файл recovery.signal и задать команду чтения архива restore_command и момент recovery_target_time. Отрепетируем восстановление на отдельном сервере в контейнере. Каталог $P на машине с Docker, принадлежащий пользователю с номером 70 (так в образе обозначен пользователь postgres), служит хранилищем архива и копий; команды выполняются от имени root.
$ P=$PWD/pitr; mkdir -p $P/wal; chown -R 70:70 $P
$ docker run -d --name pitr -e POSTGRES_PASSWORD=lab -v $P:/pitr postgres:17-alpine \
-c archive_mode=on -c archive_command='cp %p /pitr/wal/%f' > /dev/null
$ until docker exec pitr pg_isready -h 127.0.0.1 -q; do sleep 0.5; done
$ docker exec -u postgres pitr pg_basebackup -D /pitr/base -X stream -c fast
$ alias pq='docker exec -i -u postgres pitr psql -X -q'
$ pq -c "CREATE TABLE runs_log AS SELECT i AS id FROM generate_series(1, 1000) AS i"
$ pq -At -c "SELECT now()"
2026-10-03 03:45:54.2944+00
$ sleep 1; pq -c "DROP TABLE runs_log"
$ pq -At -c "SELECT pg_walfile_name(pg_switch_wal())"
000000010000000000000004
Сервер с архивом создаёт таблицу runs_log из 1000 строк, запоминается момент времени, через секунду таблица удаляется, а функция pg_switch_wal() закрывает текущий сегмент журнала, чтобы он попал в архив. Затем копия разворачивается в новый каталог, и на ней запускается второй сервер:
$ docker rm -f -v pitr > /dev/null
$ cp -a $P/base $P/restore; touch $P/restore/recovery.signal
$ cat >> $P/restore/postgresql.auto.conf << EOF
restore_command = 'cp /pitr/wal/%f %p'
recovery_target_time = '2026-10-03 03:45:54.2944+00'
recovery_target_action = 'promote'
EOF
$ docker run -d --name pitr2 -e PGDATA=/pitr/restore -v $P:/pitr postgres:17-alpine > /dev/null
$ sleep 5; docker logs pitr2 2>&1 | grep -E 'point-in-time|stopping|new timeline|archive recovery' | sed 's/.*LOG: //'
starting point-in-time recovery to 2026-10-03 03:45:54.2944+00
recovery stopping before commit of transaction 740, time 2026-10-03 03:45:55.352384+00
selected new timeline ID: 2
archive recovery complete
$ docker exec -u postgres pitr2 psql -X -c "SELECT count(*) FROM runs_log"
count
-------
1000
(1 row)
Восстановление остановилось перед фиксацией транзакции 740, то есть перед командой DROP TABLE, сервер перешёл на новую линию времени (timeline) и вернул таблицу со всеми 1000 строками. Параметр recovery_target_action = 'promote' переводит сервер в обычный режим сразу после достижения цели. По умолчанию сервер останавливается на паузе, чтобы данные можно было проверить до продвижения, однако таблицу, которую удаляла незавершённая транзакция, на паузе держит её блокировка: в первом запуске опыта, без этого параметра, запрос к runs_log ждал её освобождения, которое наступает только после продвижения сервера вызовом pg_wal_replay_resume().
Если передавать журнал потоком на другой сервер, получается физическая реплика, представляющая собой побайтовую копию всего сервера, доступную только для чтения; она требует той же основной версии PostgreSQL и той же архитектуры и служит для резервирования и разгрузки чтения. Логическая репликация расшифровывает журнал в изменения строк выбранных таблиц и передаёт их подписчику, который может работать на другой версии PostgreSQL; так переходят на новую версию с минимальным простоем, а сторонние средства логического декодирования тем же способом перекладывают изменения в аналитическую систему. Реплика не заменяет резервную копию: ошибочный DROP TABLE доходит до неё за доли секунды.
Масштабирование
Один сервер PostgreSQL на современном оборудовании годами обслуживает базу лаборатории и даже института, и масштабирование начинают с дешёвых шагов. Пул соединений, например PgBouncer, позволяет тысячам клиентов работать через десятки серверных процессов. Реплики разгружают основной сервер от чтения: отчёты и графики строятся по реплике, хотя она может отставать на доли секунды. Секционирование делит большую таблицу на части по диапазону, например временной ряд датчиков по месяцам, и позволяет удалять данные старше срока хранения одной командой вместо медленного DELETE, а запросу за неделю — читать одну секцию.
CREATE TABLE readings (
ts timestamptz NOT NULL,
channel text NOT NULL,
value real NOT NULL
) PARTITION BY RANGE (ts);
CREATE TABLE readings_2026_08 PARTITION OF readings
FOR VALUES FROM ('2026-08-01') TO ('2026-09-01');
CREATE TABLE readings_2026_09 PARTITION OF readings
FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');
INSERT INTO readings
SELECT ts, 'P_vacuum', 1e-7 * (1 + random())
FROM generate_series(timestamptz '2026-08-01', '2026-09-30 23:59', '1 min') AS ts;
EXPLAIN (COSTS OFF)
SELECT avg(value) FROM readings
WHERE ts >= '2026-09-20' AND ts < '2026-09-27';
DROP TABLE readings_2026_08; -- август удаляется одной командой
SELECT count(*) FROM readings;
$ psql < part.sql
CREATE TABLE
CREATE TABLE
CREATE TABLE
INSERT 0 87840
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------
Aggregate
-> Seq Scan on readings_2026_09 readings
Filter: ((ts >= '2026-09-20 00:00:00+00'::timestamp with time zone) AND (ts < '2026-09-27 00:00:00+00'::timestamp with time zone))
(3 rows)
DROP TABLE
count
-------
43200
(1 row)
План запроса за неделю сентября содержит только секцию readings_2026_09: условие на ts исключило августовскую секцию ещё при планировании. Августовские данные удалены командой DROP TABLE без перебора строк, и в таблице осталось 43 200 минутных отсчётов сентября.
Шардирование распределяет данные по нескольким серверам по ключу; запросы внутри одного шарда остаются быстрыми, а соединения и транзакции между шардами дороги, поэтому небольшие справочники копируют на каждый шард или денормализуют. Встроенное шардирование есть у ClickHouse, MongoDB и YDB, а в PostgreSQL его добавляет расширение Citus или реализует само приложение. Если заранее ясно, что данные не поместятся на один сервер, шардирование закладывают с самого начала: переделка работающей базы в десятки терабайт отнимает месяцы работы целой команды. Репликация, шардирование и кеширование подробнее рассматриваются в главе «Системный дизайн».
Мониторинг
СУБД наблюдают как любое приложение, но с поправкой на её особенности. Первая группа показателей — ресурсы: процессор, память, свободное место и число свободных индексных дескрипторов (inode) на диске, число операций ввода-вывода в секунду; диск для базы чаще всего оказывается узким местом. Вторая группа — запросы: их число в секунду, задержки по перцентилям p50 и p99, а не по среднему, которое скрывает медленные запросы, и распределение по типам; рост доли чтений указывает на отказ кеша перед базой, лавина UPDATE — на ошибку в приложении. Третья группа — ошибки. Под нагрузкой они в журнале бывают всегда, например при обрыве соединения клиентом, поэтому тревогу поднимают по превышению порога, а не по каждой записи. Необходимы и нижние пороги: если нагрузка на базу снизилась до нуля, это авария, хотя ни один верхний порог не превышен, — например, данные удалены, и запросам стало нечего делать.
Специфические признаки PostgreSQL дают системные представления. Самые дорогие запросы показывает расширение pg_stat_statements, загруженное при запуске контейнера в главе «Базы данных»:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
-- самые дорогие запросы с запуска сервера
SELECT calls, round(total_exec_time) AS total_ms,
left(regexp_replace(query, '\s+', ' ', 'g'), 45) AS query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 5;
$ psql < monitor.sql
CREATE EXTENSION
calls | total_ms | query
-------+----------+-----------------------------------------------
1 | 2276 | INSERT INTO measurements (run_id, channel, t,
1 | 1127 | COPY public.measurements (id, run_id, channel
1 | 710 | COPY public.measurements (id, run_id, channel
1 | 146 | UPDATE runs_log SET energy = energy + $1
1 | 100 | CREATE INDEX m_run_ch ON measurements (run_id
(5 rows)
Расширение складывает статистику по нормализованному тексту запроса, в котором константы заменены параметрами $1, $2 и так далее. С запуска сервера, то есть за время опытов этой главы и главы «Базы данных», больше всего времени заняли заполнение таблицы скриптом fill.sql из опыта с EXPLAIN ANALYZE и команды COPY, которыми pg_dump и pg_restore переносят данные, а затем UPDATE всех строк в опыте с разрастанием таблицы и создание индекса m_run_ch.
Число мёртвых версий строк по таблицам показывает представление pg_stat_user_tables, отставание реплик — pg_stat_replication:
-- мёртвые версии строк по таблицам
SELECT relname, n_live_tup, n_dead_tup
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC;
Счётчики этих представлений обновляются асинхронно и являются оценками; точные числа даёт функция pgstattuple из опыта с разрастанием таблицы. Если выделенного администратора баз данных нет, первым вариантом рассматривают управляемую СУБД облачного провайдера, который берёт на себя копии, обновления и мониторинг.
Нереляционные базы данных
Под конкретные профили нагрузки существуют специализированные базы, объединяемые общим названием «NoSQL». Их устройство и цена каждого компромисса подробно рассмотрены у Клеппмана [16].
Проще всех устроено хранилище пар «ключ → значение» Redis и его открытое ответвление Valkey. Данные располагаются в оперативной памяти, и операции занимают доли миллисекунды. Типичные роли: кеш (результат тяжёлого запроса или расчёта помещается под ключ с заданным временем жизни), очереди задач между процессами (Redis служит брокером очередей Celery), счётчики и уведомления по подписке (pub/sub). По умолчанию Redis периодически сохраняет снимок данных на диск; журнал всех записей (AOF) включается отдельно и сокращает потерю данных при сбое примерно до секунды, а для чистого кеша сохранение отключают. Команды выполняются в одном потоке, поэтому KEYS со звёздочкой, перебирающая все ключи, на время перебора блокирует сервер для всех клиентов, а перебор ведут командой SCAN. В 2024 году Redis сменил лицензию на несвободную, и сообщество под эгидой Linux Foundation продолжило открытый проект под названием Valkey; в 2025 году Redis 8 вышел и под свободной лицензией AGPLv3. Redis отвечает за скорость и не является главным хранилищем истины; типичные приёмы собраны у Карлсона [19].
Сервер для опытов запускается в контейнере так же, как PostgreSQL:
docker run -d --rm --name redis -p 127.0.0.1:6379:6379 redis:8-alpine
alias redis-cli='docker exec -i redis redis-cli'
$ redis-cli CONFIG GET save
save
3600 1 300 100 60 10000
$ redis-cli CONFIG GET appendonly
appendonly
no
$ redis-cli SET todos:page:0 '{"result": []}' EX 60
OK
$ redis-cli TTL todos:page:0
60
$ redis-cli INCR runs:counter
1
$ redis-cli SCAN 0 MATCH 'todos:page:*'
0
todos:page:0
Настройка save по умолчанию сохраняет снимок через час после первого изменения, через пять минут после ста изменений и через минуту после десяти тысяч, а appendonly no означает, что журнал AOF выключен. Ключ, записанный с параметром EX 60, живёт 60 секунд, INCR атомарно увеличивает счётчик, а SCAN перебирает ключи по шаблону порциями, не блокируя сервер надолго: первым числом он возвращает курсор следующей порции, и ноль означает, что перебор завершён.
Там, где у записей нет общей структуры, применяют документные базы наподобие MongoDB. Единицей хранения является документ — вложенная структура наподобие JSON; документы собираются в коллекции, и жёсткой схемы нет, поэтому соседние документы могут иметь разные поля. Это удобно для разнородных метаданных, меняющих структуру от записи к записи. Схему MongoDB по умолчанию не навязывает, и проверяет её код; правила можно задать и в самой базе валидатором $jsonSchema на коллекции, который отклоняет или помечает нарушающие их документы. Практические следствия рассмотрены в руководстве по MongoDB [18].
Телеметрию установки (давление в вакуумной камере, токи магнитов, температуры), приходящую с сотен датчиков каждую секунду годами, в ускорительной технике называют slow control и хранят в базах временных рядов. InfluxDB предназначена для потока «метка времени → значение» с тегами. Такие базы позволяют автоматически прореживать и удалять устаревшие данные (retention policies), быстро агрегировать по окнам времени («среднее за каждую минуту последних суток») и стыкуются с Grafana для панелей мониторинга. В мире PostgreSQL то же обеспечивает расширение TimescaleDB, построенное на секционировании по времени. От системы мониторинга программ такой архив отличается назначением: он хранит значения каналов для физического анализа годами, а Prometheus хранит состояние служб недели или месяцы; разграничение рассмотрено в разделе «Наблюдаемость физической установки» главы «Наблюдаемость».
Наконец, для аналитики на миллиардах записей созданы колоночные базы, самой известной из которых является ClickHouse. Она хранит данные не по строкам, а по столбцам. Значения одного столбца располагаются рядом, хорошо сжимаются, и запрос «среднее value по миллиарду строк» читает с диска только нужные столбцы, укладываясь в секунды на обычном сервере вместо часов; диалект SQL привычный. Колоночные базы рассчитаны на дозапись и анализ. Вставляют данные крупными партиями: каждая вставка создаёт на диске новый кусок, который затем сливается с соседними, и поток вставок по одной строке приводит к ошибке Too many parts. Точечные UPDATE и DELETE в ClickHouse есть в лёгкой форме, но частые правки отдельных строк остаются дорогими.
Выбор хранилища: пример реальной системы
Система хранения данных ускорительного комплекса использует сразу три базы. Такой подход называется полиглотным хранением (polyglot persistence): под каждый профиль данных выбирается своё хранилище.
В PostgreSQL помещается всё, что должно быть строгим: пользователи и их роли, конфигурация ускорителя и его элементов, метаданные экспериментов (что за эксперимент, когда, кто ответственный), расписание работы установки и журнал событий. Структура этих данных известна заранее, меняется редко, а целостность критична: если запись эксперимента ссылается на несуществующего оператора, это ошибка, обнаруживать которую должна база, а не код. Здесь необходимы схема, внешние ключи и ACID-транзакции.
В MongoDB помещается всё разнородное: результаты измерений, данные пучка (траектории, размеры, интенсивность), временные ряды параметров, результаты моделирования и оптимизации. У этих данных нет единой схемы: каждый новый тип эксперимента приносит свой набор полей. Требование миграции базы под каждую новую методику приводит к тому, что данные складывают мимо базы, в файлы на рабочем столе.
Redis хранит недолго живущее: кеш частых запросов, текущие состояния устройств, сессии пользователей веб-интерфейса, очереди сообщений между компонентами. Значение тока магнита в текущий момент запрашивается сотни раз в секунду, и обращаться за ним в дисковую базу бессмысленно. Потеря этих данных при перезапуске неприятна, но не катастрофична: истина хранится в двух других базах.
Выбор сводится к одному признаку на каждую базу.
| Признак данных | Подходящая база |
|---|---|
| Структура известна заранее, а нарушение связей недопустимо | PostgreSQL |
| Структура меняется от записи к записи | MongoDB |
| Данные нужны очень быстро, а их потеря допустима | Redis |
Цена полиглотного хранения: как только данные распределяются по трём базам, исчезает транзакция, охватывающая их все, и одним атомарным действием уже нельзя записать эксперимент в PostgreSQL вместе с его результатами в MongoDB. Согласованность необходимо обеспечивать вручную, распределёнными транзакциями или компенсирующими действиями, откатывающими то, что успело записаться. Эта сложность оправдана, только когда профили данных действительно различны.
Выбор СУБД
Выбор СУБД начинают с вопроса, насколько технология «скучна» в смысле эссе Д. Маккинли «Choose Boring Technology» (2015): система, которая работает десятилетиями, имеет известные ошибки, документацию, сотни специалистов и платную поддержку, реже приводит к неожиданностям, чем новая база с несколькими выпусками. Далее проверяют, есть ли резервное копирование с восстановлением на момент времени и насколько просто проверить восстановление. Оценивают объём и рост данных: если ясно, что один сервер не справится, нужна система со встроенным шардированием или заранее спланированное собственное. Разные нагрузки разводят по разным системам: транзакционная база для записи и аналитическая копия для отчётов проще в эксплуатации, чем одна система для всего. Ищут описания неудач, а не только успехов: если в блоге разработчиков одни победы, а на форумах только вопросы о подключении, о слабых местах системы известно мало, и первым с ними столкнётся сам пользователь. Проверяют безопасность по умолчанию: у FoundationDB, например, сетевой доступ к порту без настроенного TLS даёт полные права, а встроенная авторизация помечена в документации как экспериментальная.
В студенческом проекте целесообразно начинать с одной базы. Данные одного исследователя и его скриптов хранит SQLite, общую базу группы — PostgreSQL. Одна PostgreSQL закрывает потребности лабораторного сервиса на годы вперёд, а для документов в ней есть тип JSONB, индексируемый по полям внутри документа. Вторую базу заводят не потому, что так делают в больших системах, а когда первая измеримо перестала справляться с конкретным профилем нагрузки.
Одна задача в четырёх хранилищах
Рассмотрим учебный сервис, список записей с операциями «прочитать страницу», «добавить», «изменить», «удалить», и переложим его последовательно в четыре хранилища: текстовый файл со строками произвольной длины, файл с записями фиксированной длины, реляционную базу и кеш поверх неё.
Код почти не меняется от варианта к варианту; меняется то, где лежат данные и во что обходится каждая операция. Сложность операций рассматривалась в главе «Основные структуры данных».
Сервис написан на микрофреймворке Flask: декоратор @app.route привязывает функцию к URL и методу, объект request даёт доступ к параметрам и телу запроса, а словарь, возвращённый функцией, Flask отдаёт клиенту как JSON. Изменение и удаление несуществующей записи во всех вариантах отвечает кодом 404 Not Found (коды ответа HTTP рассмотрены в главе «Веб-технологии»). Заголовочная часть общая для всех вариантов и далее не повторяется; варианты с базой и кешем добавляют к ней пул соединений и клиент Redis. Все четыре варианта проверены тестовым клиентом Flask 3.1 (app.test_client()) с PostgreSQL и Redis в контейнерах.
import json
import os
from flask import Flask, Response, request
app = Flask(__name__)
FILE_PATH = 'data.txt'
PAGE_SIZE = 20
ELEMENT_SIZE = 64
FILL_CHAR = b'\0' # заполнитель, которого нет в тексте записей
Наивное решение. GET
Самый прямолинейный вариант — обычный текстовый файл, по строке на запись; запись с символом перевода строки разорвала бы файл на две строки, поэтому вариант годится только для однострочного текста. Чтобы отдать одну страницу, приходится прочитать весь файл, а при изменении и удалении ещё и переписать его заново: \(O(n)\) на каждую операцию. Пустой файл создаётся при запуске, чтобы чтение до первой записи не завершалось ошибкой.
open(FILE_PATH, 'a').close() # пустой файл, если его ещё нет
@app.route('/', methods=['GET'])
def paginated_get():
page = int(request.args.get('page', '0'))
first = page * PAGE_SIZE
last = first + PAGE_SIZE
result = []
with open(FILE_PATH, 'r') as f:
for i, line in enumerate(f.readlines()[first:last]):
result.append({'id': first + i, 'data': line.rstrip('\n')})
return {"result": result}
Наивное решение. POST
@app.route('/', methods=['POST'])
def post():
data = request.json['data']
with open(FILE_PATH, 'a') as f:
f.write(data + '\n')
return {}, 201
Наивное решение. PUT
Номер записи совпадает с номером строки, и запись с номером за концом файла не существует: сервис отвечает 404, а не завершается исключением IndexError.
@app.route('/<int:data_id>', methods=['PUT'])
def put(data_id):
data = request.json['data']
with open(FILE_PATH, 'r') as f:
new_data = f.readlines()
if not 0 <= data_id < len(new_data):
return {}, 404
new_data[data_id] = data + '\n'
with open(FILE_PATH, 'w') as f:
f.writelines(new_data)
return {}, 204
Наивное решение. DELETE
@app.route('/<int:data_id>', methods=['DELETE'])
def delete(data_id):
with open(FILE_PATH, 'r') as f:
new_data = f.readlines()
if not 0 <= data_id < len(new_data):
return {}, 404
del new_data[data_id]
with open(FILE_PATH, 'w') as f:
f.writelines(new_data)
return {}, 204
Фиксированные записи. GET
Если отвести каждой записи одинаковое число байт, файл превращается в массив, и нужная запись читается сразу, переходом к её смещению через seek(). Зато удаление дорожает: хвост файла за ней приходится сдвигать вручную. Запись, длинная для отведённых 64 байт, сдвинула бы все последующие, поэтому вставка и изменение проверяют длину и отвечают 400 Bad Request. Заполнитель — нулевой байт: в отличие от пробела, он не встречается в тексте и не срезается вместе с пробелами самой записи. Страница у конца файла содержит столько записей, сколько их осталось.
open(FILE_PATH, 'a').close() # пустой файл, если его ещё нет
def count():
"""Число записей в файле."""
return os.path.getsize(FILE_PATH) // ELEMENT_SIZE
@app.route('/', methods=['GET'])
def paginated_get():
page = int(request.args.get('page', '0'))
first = page * PAGE_SIZE
result = []
with open(FILE_PATH, 'rb') as f:
f.seek(first * ELEMENT_SIZE)
data = f.read(PAGE_SIZE * ELEMENT_SIZE) # у конца файла записей меньше
for i in range(len(data) // ELEMENT_SIZE):
record = data[i * ELEMENT_SIZE:(i + 1) * ELEMENT_SIZE]
result.append({"id": first + i,
"data": record.rstrip(FILL_CHAR).decode('utf-8')})
return {"result": result}
Фиксированные записи. POST
@app.route('/', methods=['POST'])
def post():
raw = str(request.json['data']).encode('utf-8')
if len(raw) > ELEMENT_SIZE:
return {"error": f"запись длиннее {ELEMENT_SIZE} байт"}, 400
with open(FILE_PATH, 'ab') as f:
f.write(raw.ljust(ELEMENT_SIZE, FILL_CHAR))
return {}, 201
Фиксированные записи. PUT
@app.route('/<int:data_id>', methods=['PUT'])
def put(data_id):
raw = str(request.json['data']).encode('utf-8')
if len(raw) > ELEMENT_SIZE:
return {"error": f"запись длиннее {ELEMENT_SIZE} байт"}, 400
if data_id >= count():
return {}, 404
with open(FILE_PATH, 'r+b') as f:
f.seek(data_id * ELEMENT_SIZE)
f.write(raw.ljust(ELEMENT_SIZE, FILL_CHAR))
return {}, 204
Фиксированные записи. DELETE
@app.route('/<int:data_id>', methods=['DELETE'])
def delete(data_id):
if data_id >= count():
return {}, 404
with open(FILE_PATH, 'r+b') as f:
point = data_id * ELEMENT_SIZE
while True: # хвост файла сдвигается на одну запись
f.seek(point + ELEMENT_SIZE)
next_record = f.read(ELEMENT_SIZE)
f.seek(point)
if not next_record:
f.truncate()
break
f.write(next_record)
point += ELEMENT_SIZE
return {}, 204
Реляционная база. GET
База данных скрывает эту механику за индексами: поиск по ключу, вставку и удаление она выполняет за логарифмическое время, как структуры данных из главы «Основные структуры данных». Записи хранятся в таблице todos базы lab (docker exec pg createdb -U postgres lab):
CREATE TABLE todos (
id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
todo text NOT NULL
);
Соединения с сервером открывает пул один раз на процесс, а каждый обработчик берёт соединение на время своего блока with, по выходе из которого транзакция фиксируется.
from psycopg_pool import ConnectionPool
# соединения открываются один раз на процесс и затем переиспользуются
pool = ConnectionPool('host=localhost dbname=lab user=postgres password=lab',
open=True)
@app.route('/', methods=['GET'])
def paginated_get():
page = int(request.args.get('page', '0'))
with pool.connection() as conn: # при выходе — COMMIT и возврат в пул
rows = conn.execute(
'SELECT "id", "todo" FROM "todos" ORDER BY "id" OFFSET %s LIMIT %s',
(page * PAGE_SIZE, PAGE_SIZE),
).fetchall()
return {"result": [{"id": row[0], "data": row[1]} for row in rows]}
Постраничная выдача через OFFSET линейна по номеру страницы: чтобы отдать страницу с большим номером, база проходит и отбрасывает все предыдущие строки. На восстановленной копии таблицы measurements из раздела о резервных копиях разница хорошо видна:
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF)
SELECT id, value FROM measurements ORDER BY id OFFSET 900000 LIMIT 20;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF)
SELECT id, value FROM measurements WHERE id > 900000 ORDER BY id LIMIT 20;
$ psql -d restored < offset.sql
QUERY PLAN
---------------------------------------------------------------------------------------
Limit (actual rows=20 loops=1)
-> Index Scan using measurements_pkey on measurements (actual rows=900020 loops=1)
Planning Time: 0.204 ms
Execution Time: 57.325 ms
(4 rows)
QUERY PLAN
-----------------------------------------------------------------------------------
Limit (actual rows=20 loops=1)
-> Index Scan using measurements_pkey on measurements (actual rows=20 loops=1)
Index Cond: (id > 900000)
Planning Time: 0.037 ms
Execution Time: 0.028 ms
(5 rows)
Для страницы со смещением 900 000 база прочитала по индексу 900 020 строк и отбросила все, кроме двадцати, а выборка по ключу прочитала ровно 20 строк: 57,3 мс против 0,028 мс. Поэтому длинные списки листают выборкой по ключу, WHERE "id" > %s ORDER BY "id" LIMIT %s, где параметром служит последний id предыдущей страницы.
Реляционная база. POST
@app.route('/', methods=['POST'])
def post():
data = str(request.json['data'])
with pool.connection() as conn:
new_id = conn.execute(
'INSERT INTO "todos" ("todo") VALUES (%s) RETURNING "id"', (data,)
).fetchone()[0]
return {"id": new_id}, 201
Реляционная база. PUT
Число изменённых строк сообщает атрибут rowcount курсора: ноль означает, что записи с таким id нет.
@app.route('/<int:data_id>', methods=['PUT'])
def put(data_id):
data = str(request.json['data'])
with pool.connection() as conn:
cur = conn.execute(
'UPDATE "todos" SET "todo" = %s WHERE "id" = %s', (data, data_id)
)
if cur.rowcount == 0: # такой записи нет
return {}, 404
return {}, 204
Реляционная база. DELETE
@app.route('/<int:data_id>', methods=['DELETE'])
def delete(data_id):
with pool.connection() as conn:
cur = conn.execute('DELETE FROM "todos" WHERE "id" = %s', (data_id,))
if cur.rowcount == 0:
return {}, 404
return {}, 204
Кеш. GET
Наконец, самые частые запросы можно не доводить до базы: готовый ответ помещается в Redis и в следующий раз отдаётся из оперативной памяти. Клиент Redis, как и пул, создаётся один раз на процесс и сам держит пул соединений. Ключи страниц получают префикс todos:page:, чтобы сброс затрагивал только их, а не сессии и очереди, которые в полиглотной системе лежат в том же Redis. Ответ из кеша отдаётся с типом application/json, как и ответы остальных вариантов.
import redis
from psycopg_pool import ConnectionPool
TTL = 60
pool = ConnectionPool('host=localhost dbname=lab user=postgres password=lab',
open=True)
cache = redis.Redis(host='localhost', port=6379) # один клиент на процесс
def page_key(page):
return f'todos:page:{page}'
def drop_pages(first=0):
"""Сбрасывает закешированные страницы с номером first и дальше."""
stale = [key for key in cache.scan_iter(match='todos:page:*')
if int(key.rsplit(b':', 1)[1]) >= first]
if stale:
cache.delete(*stale)
@app.route('/', methods=['GET'])
def paginated_get():
page = int(request.args.get('page', '0'))
cached_page = cache.get(page_key(page))
if cached_page is not None:
return Response(cached_page, mimetype='application/json')
with pool.connection() as conn:
rows = conn.execute(
'SELECT "id", "todo" FROM "todos" ORDER BY "id" OFFSET %s LIMIT %s',
(page * PAGE_SIZE, PAGE_SIZE),
).fetchall()
result = json.dumps({"result": [{"id": row[0], "data": row[1]} for row in rows]})
cache.set(page_key(page), result, ex=TTL)
return Response(result, mimetype='application/json')
Обратная сторона кеша: клиент, выполнивший POST или PUT, не увидит собственной правки, пока не истечёт TTL, и чем длиннее время жизни ключа, тем дольше сервис отдаёт устаревшее. Поэтому каждая изменяющая операция обязана сбрасывать затронутые ключи, и трудность заключается в том, чтобы определить, какие именно: правка обесценивает ту страницу, на которой находится запись, а вставка и удаление сдвигают нумерацию и обесценивают всё последующее. Ключи ищет команда SCAN (метод scan_iter), а не KEYS, которая на время перебора блокирует сервер; другой способ — номер версии в имени ключа, увеличиваемый при каждом изменении, после чего старые страницы просто истекают.
У кеша есть и две тонкости, которых этот вариант не решает. Первая — лавина промахов: когда истекает популярная страница, все запросы, пришедшие до её повторного заполнения, одновременно идут в базу. Защитой служит один загрузчик, когда страницу читает из базы только первый запрос, а остальные ждут его результата, или выдача устаревшего значения, пока свежее загружается. Вторая — гонка со сбросом: чтение, начавшееся до изменения, может положить в кеш устаревшую страницу уже после того, как изменение сбросило её ключ, и такая страница проживёт до истечения TTL. Оба явления подробно разобраны в главе «Системный дизайн»; в опыте той главы 50 одновременных промахов без защиты обращаются к базе 50 раз, а с одним загрузчиком — один.
Кеш. POST
Вставка попадает в конец списка, однако выяснять, где он заканчивается, дороже, чем сбросить все страницы.
@app.route('/', methods=['POST'])
def post():
data = str(request.json['data'])
with pool.connection() as conn:
new_id = conn.execute(
'INSERT INTO "todos" ("todo") VALUES (%s) RETURNING "id"', (data,)
).fetchone()[0]
drop_pages()
return {"id": new_id}, 201
Кеш. PUT
Правка не сдвигает нумерацию, поэтому номер страницы вычисляется по числу записей, лежащих перед изменённой, и сбрасывается один ключ. Сброс выполняется после выхода из блока with, то есть после фиксации: страница, сброшенная до фиксации, могла бы снова попасть в кеш со старыми данными.
@app.route('/<int:data_id>', methods=['PUT'])
def put(data_id):
data = str(request.json['data'])
with pool.connection() as conn:
cur = conn.execute(
'UPDATE "todos" SET "todo" = %s WHERE "id" = %s', (data, data_id)
)
if cur.rowcount == 0:
return {}, 404
before = conn.execute(
'SELECT count(*) FROM "todos" WHERE "id" < %s', (data_id,)
).fetchone()[0]
cache.delete(page_key(before // PAGE_SIZE)) # после COMMIT
return {}, 204
Кеш. DELETE
После удаления всё последующее сдвигается на одну позицию вперёд, поэтому устаревают и страница удалённой записи, и каждая следующая за ней.
@app.route('/<int:data_id>', methods=['DELETE'])
def delete(data_id):
with pool.connection() as conn:
before = conn.execute(
'SELECT count(*) FROM "todos" WHERE "id" < %s', (data_id,)
).fetchone()[0]
cur = conn.execute('DELETE FROM "todos" WHERE "id" = %s', (data_id,))
if cur.rowcount == 0:
return {}, 404
drop_pages(before // PAGE_SIZE)
return {}, 204
Pandas и базы данных
Функция read_sql в pandas выполняет запрос и возвращает DataFrame, а to_sql записывает DataFrame в таблицу. Функция read_sql принимает соединение sqlite3 или объект SQLAlchemy; для PostgreSQL используют create_engine с адресом postgresql+psycopg://.... Журнал для этого раздела создан заново скриптом make_lab.py из главы «Базы данных», без индексов.
"""read_sql и to_sql: агрегация в базе, сводка в pandas, результат обратно в таблицу."""
import sqlite3
import numpy as np
import pandas as pd
con = sqlite3.connect("lab.db")
df = pd.read_sql(
"""SELECT r.run_number, r.energy_mev, AVG(m.value) AS mean_signal, COUNT(*) AS n
FROM measurements AS m JOIN runs AS r ON r.id = m.run_id
WHERE m.channel = 'BPM01' GROUP BY r.id""", con)
print(df.head(3))
k, b = np.polyfit(df.energy_mev, df.mean_signal, 1)
print(f"строк в DataFrame: {len(df)}; сигнал = {k:.4f} * E + {b:.4f}")
df.to_sql("run_summary", con, if_exists="replace", index=False)
print(con.execute("SELECT sql FROM sqlite_master WHERE name = 'run_summary'").fetchone()[0])
run_number energy_mev mean_signal n
0 1 5.0 0.099996 5000
1 2 5.5 0.110061 5000
2 3 6.0 0.120023 5000
строк в DataFrame: 40; сигнал = 0.0200 * E + 0.0000
CREATE TABLE "run_summary" (
"run_number" INTEGER,
"energy_mev" REAL,
"mean_signal" REAL,
"n" INTEGER
)
Фильтрация и агрегация выполнены в базе, и в pandas пришли 40 строк сводки вместо миллиона точек; подгонка прямой методом наименьших квадратов восстановила заложенный в модели наклон 0,0200 на мегаэлектронвольт с нулевым смещением. Таблицу run_summary функция to_sql создала сама, со столбцами по типам DataFrame, но без первичного ключа и ограничений: для постоянных данных схему описывают вручную, а to_sql дописывает строки в готовую таблицу. Тяжёлую фильтрацию и агрегацию передают базе (SQL с WHERE и GROUP BY), а в pandas загружают свёрнутый результат: память и время расходуются на порядки экономнее, чем при чтении всех данных и фильтрации в DataFrame. Связка «SQL-запрос → DataFrame → график» даёт простейшее приложение для визуализации данных; построение графиков рассматривается в главах про обработку и визуализацию данных.
Формат хранения выбирают по способу доступа. Оценим размеры файлов и время чтения: скрипт formats.py выгружает миллион измерений журнала в CSV и Parquet и сравнивает чтение с SQLite, беря медиану трёх запусков; для Parquet нужен пакет pyarrow.
"""Миллион измерений в CSV, SQLite и Parquet: размер файла и время чтения."""
import os
import sqlite3
import statistics
import time
import pandas as pd
import pyarrow
con = sqlite3.connect("lab.db")
ALL = "SELECT run_id, channel, t, value FROM measurements"
ONE = ALL + " WHERE run_id = 7 AND channel = 'BPM01'"
df = pd.read_sql(ALL, con)
df.to_csv("m.csv", index=False)
df.to_parquet("m.parquet", index=False)
db_size = os.path.getsize("lab.db") # размер до создания индекса
con.execute("CREATE INDEX idx_m_run_channel ON measurements (run_id, channel)")
print(f"pandas {pd.__version__}, pyarrow {pyarrow.__version__}, строк: {len(df)}")
def ms(func):
times = []
for _ in range(3):
start = time.perf_counter()
func()
times.append((time.perf_counter() - start) * 1000)
return statistics.median(times)
def csv_one():
d = pd.read_csv("m.csv") # прочитать всё, затем отфильтровать
return d[(d.run_id == 7) & (d.channel == "BPM01")]
FILTER = [("run_id", "==", 7), ("channel", "==", "BPM01")]
ROWS = [
("CSV", os.path.getsize("m.csv"), lambda: pd.read_csv("m.csv"), csv_one),
("SQLite", db_size, lambda: pd.read_sql(ALL, con), lambda: pd.read_sql(ONE, con)),
("Parquet", os.path.getsize("m.parquet"), lambda: pd.read_parquet("m.parquet"),
lambda: pd.read_parquet("m.parquet", filters=FILTER)),
]
print(f"{'формат':8s} {'МиБ':>6s} {'всё, мс':>9s} {'один канал, мс':>15s}")
for name, size, full, one in ROWS:
print(f"{name:8s} {size / 2**20:6.1f} {ms(full):9.0f} {ms(one):15.1f}")
pandas 3.0.6, pyarrow 25.0.1, строк: 1000000
формат МиБ всё, мс один канал, мс
CSV 22.5 119 113.9
SQLite 33.4 672 3.3
Parquet 4.5 17 15.2
CSV является форматом обмена: его читает любая программа, но он хранит текст, а не типы, и для выборки одного канала читается целиком. SQLite подходит для журнала, который пополняется по записи и читается выборочно: всю таблицу модуль sqlite3 отдаёт медленно, поскольку строки проходят через Python по одной, зато 5000 строк одного канала одного захода находятся по индексу за несколько миллисекунд. Parquet хранит таблицу по столбцам со сжатием и статистикой групп строк, поэтому занимает в пять раз меньше CSV и быстро читается целиком; при фильтре он пропускает группы строк, где нужного значения заведомо нет, но здесь весь файл умещается в одну группу, и фильтр почти не ускоряет чтение. Таким образом, Parquet является форматом архива для анализа.
SQL-запросы прямо к файлам Parquet и CSV, без загрузки в базу, выполняет встраиваемая аналитическая СУБД DuckDB (pip install duckdb); для запроса к файлу достаточно указать его имя в предложении FROM:
import duckdb
rows = duckdb.sql("""
SELECT run_id, round(avg(value), 4) AS mean_signal, count(*) AS n
FROM 'm.parquet'
WHERE channel = 'BPM01'
GROUP BY run_id
ORDER BY run_id DESC
LIMIT 3
""").fetchall()
print(rows)
[(40, 0.49, 5000), (39, 0.48, 5000), (38, 0.47, 5000)]
Строка на отсчёт годится для медленных каналов журнала, но не для осциллограмм и изображений с АЦП на мегагерцах: миллион строк журнала соответствует всего 40 заходам по 50 с при 100 Гц. Такие массивы хранят в файлах HDF5 или Parquet либо массивом в одной строке, а в базе держат метаданные и путь к файлу. Рассмотрим осциллограммы тока цилиндра Фарадея по 20 000 отсчётов при частоте оцифровки 100 МГц, по одной на заход (пакет h5py):
import sqlite3
import h5py
import numpy as np
rng = np.random.default_rng(7)
t = np.arange(20_000) / 100e6 # 20 000 отсчётов АЦП на 100 МГц, с
con = sqlite3.connect("lab.db")
con.execute("PRAGMA foreign_keys = ON")
con.execute("""CREATE TABLE IF NOT EXISTS waveforms (
run_id INTEGER NOT NULL REFERENCES runs(id),
channel TEXT NOT NULL,
file TEXT NOT NULL, -- файл HDF5 с осциллограммой
dataset TEXT NOT NULL, -- путь к массиву внутри файла
rate_hz REAL NOT NULL)""")
with h5py.File("waveforms.h5", "w") as f, con:
for run_id, energy in con.execute("SELECT id, energy_mev FROM runs").fetchall():
name = f"run{run_id:03d}/fcup" # ток с цилиндра Фарадея, мА
pulse = 0.4 * energy * np.exp(-((t - 100e-6) / 20e-6) ** 2)
pulse += rng.normal(0, 0.05, t.size)
f.create_dataset(name, data=pulse.astype(np.float32), compression="gzip")
con.execute("INSERT INTO waveforms VALUES (?, 'FCUP', 'waveforms.h5', ?, 100e6)",
(run_id, name))
# поиск — по метаданным в базе, массив — из файла
file, dataset = con.execute(
"SELECT w.file, w.dataset FROM waveforms AS w JOIN runs AS r ON r.id = w.run_id "
"WHERE r.run_number = 31").fetchone()
with h5py.File(file) as f:
pulse = f[dataset][:]
print(dataset, pulse.shape, pulse.dtype, f"максимум {pulse.max():.2f} мА")
run031/fcup (20000,) float32 максимум 8.11 мА
Поиск по-прежнему выполняет SQL — здесь по номеру захода, — а сам массив читается из файла HDF5 одним обращением, со сжатием и без разбиения на строки.
С чего начать в своей лаборатории
Рецепт перехода от тысячи CSV к одной базе включает следующие шаги:
-
Завести один файл
lab.dbи описать схему по образцу журнала из главы «Базы данных». Минимально необходимы таблицы видаexperiments,runs,measurementsс первичными и внешними ключами иNOT NULLна важных полях; время записывается в UTC. Схема служит документацией, проверяющей сама себя. -
Импортировать накопленные CSV одним скриптом:
from pathlib import Path import sqlite3 import pandas as pd con = sqlite3.connect("lab.db") frames = [] for csv_path in sorted(Path("data").rglob("*.csv")): # порядок обхода задан явно df = pd.read_csv(csv_path) df["source_file"] = str(csv_path) # происхождение данных frames.append(df) raw = pd.concat(frames, ignore_index=True) # объединение всех столбцов raw.to_sql("measurements_raw", con, if_exists="replace", index=False) print(len(raw), "строк:", ", ".join(raw.columns))Файлы обходятся в отсортированном порядке, собираются в один
DataFrameи записываются одним вызовомto_sql. Дописывать каждый файл отдельно (if_exists="append") нельзя: если в каком-то файле есть столбец, которого не было в первом, загрузка обрывается на середине ошибкойtable measurements_raw has no column named ..., а какой файл окажется первым, зависит от порядка обхода. На трёх пробных файлах, в последнем из которых есть лишний столбецtemperature, скрипт печатает:7 строк: channel, t, value, source_file, temperatureВ строках из файлов без этого столбца
temperatureравнаNULL. Далее «сырую» таблицу можно разложить по нормализованной схеме SQL-запросами. -
Новые данные записывать сразу в базу, применяя в скрипте сбора
executemanyгруппами точек иcommitраз в несколько секунд, а не файл на каждый заход. -
Включить
PRAGMA journal_mode=WAL: в этом режиме SQLite позволяет читать базу (строить графики) параллельно с записью. Режим сохраняется в самой базе, но работает, только когда все процессы на одной машине: на сетевом диске (NFS, SMB) WAL неприменим. Пишущая транзакция по-прежнему одна. -
Просматривать данные удобно в DB Browser for SQLite, а резервную копию делает
Connection.backup()из Python или командаVACUUM INTO 'backup.db'; простое копирование файла допустимо, только когда к базе никто не подключён, а в режиме WAL — вместе с файлом-wal. Восстановление из копии проверяют заранее.
Когда данными начнёт пользоваться вся группа с нескольких машин, схема переносится в PostgreSQL; SQL и почти весь код при этом остаются прежними, меняются знак параметра, драйвер и тип времени — timestamptz вместо строки.
Полезные ссылки
- Модуль sqlite3 в стандартной библиотеке Python
- Документация psycopg 3
- Документация SQLAlchemy 2.1
- Резервное копирование и восстановление в документации PostgreSQL 17
- Рогов Е. В. PostgreSQL 18 изнутри
- Документация Valkey
- Документация DuckDB
Задание. Собрать и развернуть всё вместе, приложение, контейнеры, сеть и базу: «Деплой стартапа».
Системный дизайн
Программа, которой пользуется группа, со временем превращается в систему. Рядом с ней появляются база данных, общая для нескольких программ, очередь между сбором и обработкой, второй экземпляр сервиса и балансировщик перед обоими. Поведение такой системы определяется уже не только кодом, но и тем, как её части ведут себя под нагрузкой и при отказах. Одна программа либо работает, либо нет; система из нескольких программ отказывает по частям, и каждая часть отказывает по-своему: один экземпляр отвечает медленно, другой завис, очередь переполнилась, а повторы клиентов после кратковременного сбоя многократно умножили нагрузку.
В настоящей главе рассматривается системный дизайн — выбор устройства системы по требованиям, записанным числами. Последовательно разобраны запись требований, масштабирование, отказоустойчивость, работа с данными, наблюдаемость и сопровождение, а в завершение перечисленные приёмы применены к проекту системы сбора данных физической установки. Глава продолжает раздел «Рост приложения в систему» главы «От скрипта к приложению» и опирается на главы «Компьютерные сети», «Веб-технологии», «Базы данных», «Работа с базами данных» и «Docker».
Хорошо спроектированную систему описывают четырьмя свойствами. Масштабируемость — способность сохранять заданные показатели, прежде всего задержку и долю ошибок, при росте нагрузки за счёт добавления ресурсов. Отказоустойчивость — способность продолжать обслуживание, пусть и с ухудшением, при отказе машины, процесса, сети или зависимости. Наблюдаемость — возможность по журналам, метрикам и трассировкам понять, что происходит внутри работающей системы. Сопровождаемость — возможность изменять систему, выкатывать новые версии и откатывать неудачные быстро и предсказуемо. Свойства конкурируют за один бюджет: каждая копия, повышающая отказоустойчивость, требует затрат, а каждый новый компонент усложняет сопровождение.
Сквозным примером главы служит архив измерений установки: оцифровщики непрерывно записывают в него данные, а сотрудники и их скрипты читают запуски и графики по HTTP. Каждое типовое решение имеет цену: балансировщик добавляет сетевой переход, реплика базы отстаёт от главной, кеш может отдать устаревшее значение, повтор создаёт дополнительную нагрузку. Поэтому решения принимаются по числам — сколько запросов в секунду, какая задержка допустима, какая доля ответов может быть неуспешной. Числа же показывают, когда сложное устройство не требуется: лабораторному сервису с десятью пользователями одна программа и одна база подходят лучше распределённой системы.
Листинги главы выполнены на виртуальной машине под Python 3.12 с FastAPI 0.142, uvicorn 0.54, httpx 0.28 и nginx 1.31 — той же, на которой записаны демонстрации лекции «Архитектура и системный дизайн»; числа демонстраций приведены по их записям. Клиент и сервис на этой машине делят два ядра, поэтому пропускная способность и задержки на другой машине будут иными, а распределение запросов по экземплярам, коды ответов и счётчики — теми же.
Слайды к главе. Требования в числах, масштабирование, отказоустойчивость, работа с данными, наблюдаемость и проект системы сбора данных изложены также в лекции «Архитектура и системный дизайн» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Требования в числах
Слайды к главе. Функциональные и нефункциональные требования, нагрузка и перцентили задержки, SLI, SLO и SLA, бюджет ошибок и «девятки» изложены также в первой части лекции «Архитектура и системный дизайн» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Проектирование начинается не со схемы, а с требований. Функциональные требования перечисляют, что система делает: принимает данные с оцифровщиков, выдаёт запуск по номеру, строит график канала за интервал. Нефункциональные требования описывают, насколько хорошо она это делает, и записываются числами: нагрузка и её пики, допустимая задержка, доля успешных ответов, объём и срок хранения данных, стоимость. Архитектуру определяют именно нефункциональные требования: один и тот же набор функций для десяти пользователей и для ста тысяч запросов в секунду реализуется совершенно разными системами. Структура спецификации требований рассмотрена в главе «Жизненный цикл ПО»; здесь важно, что каждое требование к качеству получает число.
| Требование | Пример для архива измерений |
|---|---|
| функциональное | выдача запуска по номеру, график канала за интервал |
| нагрузка | запись 4 МБ/с непрерывно, чтение — 50 запросов/с в пике |
| задержка | p99 выдачи запуска меньше 300 мс |
| доступность | 99,9 % успешных ответов за 30 дней |
| сохранность | ни одного потерянного измерения |
| стоимость | три машины и диски на год записи |
Требование без числа проверить нельзя: «быстро» превращается в перцентиль задержки, «надёжно» — в долю успешных ответов за окно времени. В требования входит и цена: каждая дополнительная девятка доступности кратно увеличивает число машин, площадок и объём работы.
Нагрузка и задержка
Нагрузку описывают числом запросов в секунду (rps), причём важно не только среднее за сутки, но и пик: у архива измерений он приходится на утро после ночной смены, когда скрипты обработки запускаются одновременно. Задержка представляет собой не одно число, а распределение, и описывают её перцентилями. Медиана p50 — время, которого не превышает половина запросов, p95 и p99 — время, которого не превышают 95 и 99 % запросов. Среднее для этого непригодно: несколько очень медленных ответов сдвигают его, но не показывают, насколько велика задержка именно этих ответов. Разницу показывает модель сервиса, у которого 4 % запросов обращаются к медленному диску:
import random
import statistics
rng = random.Random(14)
# 96 % запросов обслуживаются около 20 мс, 4 % обращаются к медленному диску
lat = [rng.gauss(200, 5) if rng.random() < 0.04 else rng.gauss(20, 2)
for _ in range(10_000)]
q = statistics.quantiles(lat, n=100, method='inclusive') # q[k - 1] — k-й
print(f'среднее {statistics.fmean(lat):.1f} мс, p50 {q[49]:.1f} мс')
print(f'p95 {q[94]:.1f} мс, p99 {q[98]:.1f} мс, максимум {max(lat):.1f} мс')
среднее 26.8 мс, p50 20.1 мс
p95 24.5 мс, p99 203.3 мс, максимум 215.4 мс
Функция statistics.quantiles с n=100 возвращает 99 точек разбиения, и k-й перцентиль равен элементу с индексом k − 1. Метод inclusive считает наименьшее и наибольшее значения выборки нулевым и сотым перцентилями и не выходит за пределы наблюдённых значений; метод по умолчанию, exclusive, предполагает, что в генеральной совокупности встречаются и более крайние значения. Среднее, 26,8 мс, больше медианы, но о медленных ответах ничего не сообщает: их показывает только p99, равный 203,3 мс.
Хвост распределения затрагивает многих пользователей. Оценим, как часто страница, для построения которой выполняется 20 запросов, получает хотя бы один ответ медленнее p99. Вероятность того, что все 20 ответов быстрее p99, равна \(0{,}99^{20} \approx 0{,}82\), поэтому медленный ответ встречается примерно на каждой пятой странице: \(1 - 0{,}99^{20} \approx 0{,}18\). Таким образом, требования к задержке записывают по p95 или p99, а не по среднему.
Нагрузку, задержку и число одновременно обрабатываемых запросов связывает закон Литтла: среднее число запросов в системе равно интенсивности потока, умноженной на среднее время пребывания запроса, \(L = \lambda W\). При \(\lambda = 100\) запросов/с и \(W = 30\) мс в работе одновременно находятся в среднем \(L = 3\) запроса. Если сервис способен обрабатывать одновременно четыре запроса, его ёмкость ограничена значением \(4/W\), и поток выше ёмкости приводит к неограниченному росту очереди и задержки.
Открытая и замкнутая модель нагрузки
Поведение задержки у границы ёмкости показывает демонстрация к лекции. Сервис svc.py на FastAPI пропускает к работе не больше четырёх запросов одновременно (семафор asyncio); обычный запрос длится 20 мс, а каждый двадцать пятый, то есть 4 % запросов, — 200 мс. Найдём ёмкость сервиса; для этого достаточно закона Литтла. Среднее время обработки равно \(0{,}96 \cdot 20 + 0{,}04 \cdot 200 = 27{,}2\) мс, и по закону Литтла четыре одновременных запроса обслуживаются с темпом около \(4 / 0{,}0272 \approx 147\) запросов/с. Генератор aload.py на httpx отправляет запросы по расписанию с заданной частотой, не дожидаясь ответов, и подаёт каждую частоту в течение 4 с:
| Частота, запросов/с | Запросов | Среднее, мс | p50, мс | p95, мс | p99, мс | Максимум, мс | Ошибок |
|---|---|---|---|---|---|---|---|
| 50 | 200 | 30 | 22 | 27 | 203 | 205 | 0 |
| 100 | 400 | 29 | 22 | 32 | 202 | 203 | 0 |
| 140 | 560 | 32 | 23 | 35 | 208 | 214 | 0 |
| 160 | 640 | 267 | 265 | 499 | 563 | 696 | 0 |
| 200 | 800 | 799 | 792 | 1545 | 1621 | 1819 | 0 |
До 140 запросов/с медиана составляет 22–23 мс, среднее — 29–32 мс, а p99 — 202–208 мс: медленные 4 % не видны в медиане, слегка сдвигают среднее и полностью определяют p99. При 160 запросах/с, всего на 9 % выше ёмкости, медиана вырастает до 265 мс, а при 200 — до 792 мс с максимумом 1819 мс: запросы приходят быстрее, чем обслуживаются, и очередь растёт всё время теста. Ошибок нет ни в одном прогоне — перегрузка проявляется задержкой задолго до отказов.
Генератор aload.py реализует открытую модель нагрузки: моменты отправки задаёт расписание, как у независимых пользователей. Генераторы замкнутого типа с постоянным числом одновременных запросов, как ab, wrk или клиент hit.py из остальных демонстраций лекции, отправляют следующий запрос только после ответа на предыдущий. При перегрузке такой генератор замедляется вместе с сервером и не учитывает ожидания запросов, которые не успел отправить, поэтому занижает хвост распределения. Эту ошибку измерения называют coordinated omission, и задержку у границы ёмкости измеряют генератором с расписанием. Профили нагрузочных испытаний, прогрев и отдельное окружение для них рассмотрены в разделе «Нагрузочное тестирование» главы «Жизненный цикл ПО».
SLI, SLO и SLA
Требования к качеству обслуживания записывают тремя связанными понятиями из практики эксплуатации Google, Site Reliability Engineering [23].
| Термин | Что это | Пример для архива |
|---|---|---|
| SLI | измеряемый показатель | доля ответов без ошибки сервера; доля выдач запуска быстрее 300 мс |
| SLO | цель для SLI за окно времени | 99,9 % успешных ответов за 30 дней |
| SLA | договор с последствиями нарушения | ниже 99,5 % — возврат части оплаты |
| бюджет ошибок | 1 − SLO | 0,1 % запросов за 30 дней |
SLI (service level indicator, индикатор уровня обслуживания) представляет собой измеряемую величину: доля ответов без ошибки сервера, доля запросов быстрее 300 мс, задержка поступления данных в архив. SLO (service level objective, цель уровня обслуживания) — требуемое значение индикатора за окно времени, например 99,9 % успешных ответов за скользящие 30 дней. SLA (service level agreement, соглашение об уровне обслуживания) — договор с внешним заказчиком, в котором записаны последствия нарушения; его порог обычно мягче внутреннего SLO, чтобы команда успевала отреагировать до нарушения договора. Доступность распределённого сервиса считают не по времени работы машины, а по запросам: машина может работать, а пользователи — получать ошибки.
Разность между единицей и SLO называют бюджетом ошибок: при 99,9 % это 0,1 % запросов за окно, которые можно потратить на выкатки, эксперименты и аварии. Бюджет расходуется на всё сразу, и когда он исчерпан, выкатки приостанавливают до восстановления. Для архива измерений индикаторов несколько: доля успешных чтений, доля выдач запуска быстрее 300 мс и задержка поступления измерения в архив, которая не должна превышать 10 с после его снятия.
Девятки и составные системы
Доступность часто называют числом девяток: 99,9 % — три девятки, 99,99 % — четыре. Каждому уровню соответствует допустимое время простоя, равное произведению бюджета ошибок на длительность окна. Таблицу вычисляет скрипт демонстрации nines.py:
| SLO | Год | 30 дней | Неделя | Сутки |
|---|---|---|---|---|
| 99 % | 3 д 15 ч 36 мин | 7 ч 12 мин | 1 ч 40 мин 48 с | 14 мин 24 с |
| 99,9 % | 8 ч 45 мин 36 с | 43 мин 12 с | 10 мин 5 с | 1 мин 26 с |
| 99,95 % | 4 ч 22 мин 48 с | 21 мин 36 с | 5 мин 2 с | 43,2 с |
| 99,99 % | 52 мин 34 с | 4 мин 19 с | 1 мин | 8,6 с |
| 99,999 % | 5 мин 15 с | 25,9 с | 6,0 с | 0,9 с |
При 99,99 % допустимый простой за 30 дней составляет 4 мин 19 с — меньше, чем занимает одна неудачная выкатка с откатом.
Доступность составной системы вычисляется по правилам теории надёжности. Если запрос проходит последовательно через несколько сервисов и успешен только при успехе каждого, доступности перемножаются, \(A = A_1 A_2 A_3\), и цепочка оказывается хуже каждого звена. Если же работают копии и отказ наступает, только когда отказали все, перемножаются вероятности отказа: \(A = 1 - (1 - A_1)(1 - A_2)\). Запишем обе формулы и бюджет ошибок в коде:
import math
slo = 99.9 # цель, %
budget = 1 - slo / 100 # доля неуспешных запросов
print(f'простой за 30 дней: {budget * 30 * 24 * 60:.1f} мин')
chain = math.prod([0.999, 0.999, 0.999]) # три звена последовательно
copies = 1 - math.prod([1 - 0.99, 1 - 0.99]) # две независимые копии
print(f'цепочка {chain:.6f}, копии {copies:.6f}')
простой за 30 дней: 43.2 мин
цепочка 0.997003, копии 0.999900
Цепочка из трёх сервисов по 99,9 % даёт 99,7 %, две копии по 99 % — 99,99 %. Формула для копий верна только при независимых отказах: две копии на одном диске, в одной стойке или обновлённые одной выкаткой отказывают вместе и ведут себя как одна. В той же демонстрации бюджет пересчитан в запросы: при 100 000 запросов/с за 30 дней приходит около \(2{,}59 \cdot 10^{11}\) запросов, и при SLO 99,99 % неуспешными допустимо около \(2{,}59 \cdot 10^{7}\) из них.
Масштабирование
Слайды к главе. Вертикальное и горизонтальное масштабирование, сервисы без состояния, алгоритмы балансировки и консистентное хеширование изложены также во второй части лекции «Архитектура и системный дизайн» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Когда сервис перестаёт справляться с нагрузкой, его мощность наращивают двумя способами.
| Вертикальное | Горизонтальное | |
|---|---|---|
| ресурс | процессоры и память машины | число экземпляров |
| доработка | не нужна | сервис без состояния |
| предел | самая большая машина | общие зависимости, бюджет |
| отказ машины | остановка всего сервиса | потеря доли мощности |
| изменение | обычно с перезапуском | по одному экземпляру, без простоя |
Вертикальное масштабирование даёт той же машине больше процессоров и памяти. Доработка программы не нужна, но предел задан самой большой доступной машиной, а сама машина остаётся единой точкой отказа. Изменение размера виртуальной машины обычно требует её перезапуска; квоту процессора работающего контейнера Docker команда docker update --cpus 2 <контейнер> меняет без перезапуска. Горизонтальное масштабирование добавляет одинаковые экземпляры за балансировщиком: рост ограничен бюджетом и общими зависимостями, например базой, отказ одного экземпляра снимает лишь часть мощности, а новые версии выкатываются по одному экземпляру без простоя. Платой является доработка сервиса, который не должен хранить состояние в себе, и сетевой переход через балансировщик.
Для Python граница между двумя способами проходит внутри машины. Из-за глобальной блокировки интерпретатора процесс обычной сборки CPython выполняет байт-код только в одном потоке за раз и при вычислениях на чистом Python загружает не больше одного ядра (глава «Многопоточность и GIL»). Поэтому многоядерную машину загружают несколько процессов, как это делают uvicorn --workers и gunicorn. Свободнопоточная сборка, официально поддерживаемая с Python 3.14, снимает это ограничение, но используемой по умолчанию пока не стала.
В демонстрации к лекции сервис cpu.py выполняет на каждый запрос около 10 мс вычислений на чистом Python в обычной функции-обработчике, которую FastAPI запускает в пуле потоков. Клиент отправляет 300 запросов, по восемь одновременно, открывая новое соединение на каждый запрос. Сервер uvicorn с одним рабочим процессом обрабатывает их за 4,9 с — 62 запроса/с при медиане 118 мс: восемь запросов делят одно ядро, а цикл вместе с обработкой HTTP занимает около 16 мс процессора на запрос. С ключом --workers 2 uvicorn открывает слушающий сокет в родительском процессе и передаёт его двум рабочим процессам, а новые соединения между ними распределяет ядро ОС: 142 и 158 запросов за 2,4 с, 126 запросов/с при медиане 57–61 мс. На двух ядрах второй процесс удвоил пропускную способность. Новое соединение на каждый запрос понадобилось потому, что постоянное соединение закрепляется за процессом, который его принял, и восемь постоянных соединений распределились бы по процессам неравномерно.
Сервисы без состояния
Горизонтально масштабируется прежде всего сервис без состояния: всё, что должно пережить запрос, — сессии пользователей, загруженные файлы, результаты расчётов — хранится вне процесса, в базе, общем кеше или хранилище файлов. Тогда любой экземпляр обслуживает любой запрос, экземпляры можно добавлять, убирать и перезапускать, а балансировщик может направить следующий запрос на любой из них. Словарь в памяти процесса нарушает это свойство: результат, записанный одним экземпляром, не виден другому и пропадает при перезапуске. Для физика типичным примером служит сервис расчётов: исполнитель берёт задание параметрического скана, считает и записывает результат в общее хранилище, и исполнители взаимозаменяемы.
Сервисы с состоянием — базы данных, кеши, брокеры очередей — масштабируются иначе: новую копию базы сначала наполняют данными, что при нескольких терабайтах занимает часы, а холодный кеш ещё не снимает нагрузку с базы. Даже балансировщик, не хранящий данных приложения, имеет рабочее состояние — открытые соединения, счётчики активных соединений и результаты проверок работоспособности, — и у каждого экземпляра балансировщика оно своё.
Балансировка нагрузки
Балансировщик распределяет запросы между экземплярами, и способ выбора экземпляра зависит от характера нагрузки.
| Алгоритм | Как выбирает экземпляр | Когда подходит |
|---|---|---|
| round robin | по очереди, с учётом весов | одинаковые короткие запросы |
| least connections | с наименьшим числом активных соединений | запросы разной длительности |
| hash | по ключу: пользователь, адрес страницы, номер запуска | привязка, локальный кеш экземпляра |
| random two | лучший из двух случайных | несколько балансировщиков |
Round robin отправляет запросы по очереди, а веса учитывают неравные машины: сервер с весом 2 получает вдвое больше запросов. Алгоритм подходит для одинаково коротких запросов, но не учитывает скорость экземпляров: медленный получает ту же долю. Least connections выбирает экземпляр с наименьшим числом активных соединений и тем самым снижает нагрузку на медленный. Хеш по ключу — пользователю, адресу страницы, номеру запуска — отправляет одинаковые ключи на один экземпляр, что позволяет использовать его локальный кеш. Выбор лучшего из двух случайных экземпляров почти так же хорош, как least connections, но не требует точного общего счётчика и подходит, когда балансировщиков несколько. Балансировщик транспортного уровня, L4 в модели OSI (глава «Компьютерные сети»), распределяет соединения TCP, не разбирая HTTP, а балансировщик прикладного уровня, L7, разбирает запрос и может выбирать экземпляр по пути, заголовку или cookie, но тратит на это больше процессора, прежде всего на завершение TLS.
В nginx группа экземпляров описывается блоком upstream, а алгоритм — директивой внутри него:
upstream app {
zone app 64k; # состояние группы — общее для рабочих процессов
least_conn; # или hash $arg_user consistent;
server 127.0.0.1:8001 weight=2;
server 127.0.0.1:8002;
server 127.0.0.1:8003;
}
server {
listen 127.0.0.1:8080;
location / { proxy_pass http://app; }
}
Директива zone размещает состояние группы в разделяемой памяти и тем самым обеспечивает общие для рабочих процессов nginx очередь и счётчики; без неё каждый рабочий процесс ведёт свою очередь round robin и свои счётчики соединений. Выбор лучшего из двух случайных задаётся директивой random two;: из двух случайно выбранных экземпляров nginx по умолчанию берёт тот, у которого меньше активных соединений. В главах «Веб-технологии» и «Docker» nginx служит обратным посредником перед единственным бэкендом; блок upstream превращает его в балансировщик.
В демонстрации к лекции за nginx в контейнере работают три экземпляра FastAPI, отвечающие своим именем; второй из них, app2, отвечает через 200 мс, остальные — через 10 мс. Клиент отправляет 300 запросов, по 12 одновременно. Round robin делит запросы поровну, по 100, весь прогон занимает 2,0 с (148 запросов/с), а медиана у app2 равна 202 мс: медленный экземпляр задерживает каждый третий запрос. С least_conn экземпляры получают 144, 12 и 144 запроса, и прогон занимает 0,6 с (465 запросов/с): медленный экземпляр дольше занят и реже оказывается наименее загруженным. С hash $arg_user каждый из восьми пользователей при всех своих запросах попадает на один и тот же экземпляр.
Консистентное хеширование
Когда экземпляр или шард выбирают по хешу ключа, важно, что происходит при изменении их числа. Простейший способ — остаток от деления хеша на число узлов — при переходе от N к N + 1 узлам меняет узел почти для всех ключей: переезжает доля \(N/(N+1)\), при переходе с четырёх узлов на пять — 80 %. Получим эту долю. Ключ остаётся на месте, только если остатки от деления хеша на N и на N + 1 совпадают; на каждом отрезке из \(N(N+1)\) последовательных значений хеша таких значений N, поэтому на месте остаётся доля \(1/(N+1)\) ключей, а переезжает \(N/(N+1)\). Для кеша это означает одновременный промах почти по всем ключам, для шардов базы — перенос почти всех данных.
Консистентное хеширование размещает на кольце значений хеша и узлы, и ключи; ключ принадлежит первому узлу по ходу кольца. Новый узел с одной точкой на кольце забирает ключи только с одной дуги, в среднем долю \(1/(N+1)\), а остальные ключи остаются на месте. Чтобы дуги были равномерными, каждый узел ставят на кольцо во многих точках, и тогда новый узел забирает понемногу ключей у каждого из прежних. Рандеву-хеширование достигает того же иначе: для ключа вычисляется хеш пары «узел, ключ» для каждого узла, и выбирается узел с наибольшим значением.
import bisect
import hashlib
def h(s):
"""Стабильный хеш: одинаков в любом процессе и на любой машине."""
return int.from_bytes(hashlib.md5(s.encode()).digest()[:8], 'big')
class Ring:
"""Консистентное хеширование: vnodes точек на кольце для каждого узла."""
def __init__(self, nodes, vnodes=100):
self.points = sorted((h(f'{n}#{v}'), n)
for n in nodes for v in range(vnodes))
self.hashes = [p for p, _ in self.points]
def __call__(self, key):
# первая точка по ходу кольца; за последней следует первая
i = bisect.bisect(self.hashes, h(key)) % len(self.points)
return self.points[i][1]
def by_mod(nodes): # остаток от деления
return lambda key: nodes[h(key) % len(nodes)]
def rendezvous(nodes): # наибольший хеш пары «узел, ключ»
return lambda key: max(nodes, key=lambda n: h(f'{n}:{key}'))
Функция h построена на MD5 и одинакова в любом процессе и на любой машине; криптографическая стойкость здесь не требуется, достаточно равномерности. Скрипт демонстрации shard.py теми же функциями распределяет 100 000 ключей вида run-000123 по четырём шардам и считает, сколько ключей сменят шард при добавлении пятого:
| Способ | Ключей на шард, наименьшее | Ключей на шард, наибольшее | Переехало при 4 → 5 |
|---|---|---|---|
| остаток от деления | 24 890 | 25 230 | 80,0 % |
| кольцо, 100 точек на узел | 23 749 | 26 014 | 20,0 % |
| рандеву | 24 897 | 25 114 | 20,1 % |
Остаток от деления распределяет ключи равномерно, но переносит 80,0 % ключей. Кольцо со ста точками на узел переносит 20,0 % — ровно ту долю, которую должен забрать новый шард, — но распределяет ключи менее равномерно. Рандеву-хеширование сочетает равномерность и малый перенос. В nginx консистентный хеш включается словом consistent в директиве hash, например hash $arg_user consistent;.
Встроенная функция hash() для распределения ключей непригодна: начальное значение хеша строк выбирается при запуске интерпретатора, если не задана переменная окружения PYTHONHASHSEED.
for i in 1 2; do python3 -c "print(hash('run-000123'))"; done
for i in 1 2; do PYTHONHASHSEED=0 python3 -c "print(hash('run-000123'))"; done
-6807953549254101815
7991815127659032150
-6516832473932046442
-6516832473932046442
Два первых запуска дают разные числа, два последних — одинаковые. Потомок, созданный вызовом fork, наследует начальное значение родителя (так создаёт рабочие процессы gunicorn), а рабочие процессы uvicorn --workers запускаются методом spawn, то есть новыми интерпретаторами: на той же машине два рабочих процесса uvicorn вернули для одной строки разные значения hash(), а с PYTHONHASHSEED=0 — одинаковые. Поэтому для распределения ключей используют стабильный хеш, как функцию h выше.
Отказоустойчивость
Слайды к главе. Резервирование и кворум, проверки работоспособности, тайм-ауты и дедлайн, повторы, идемпотентность и автомат защиты изложены также в третьей части лекции «Архитектура и системный дизайн» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Отказ в распределённой системе является обычным событием, а не исключением: машина перезагружается, процесс зависает, сеть теряет пакеты, зависимость отвечает медленно. Задача отказоустойчивости — не допустить, чтобы частичный отказ стал полным.
Резервирование и кворум
Отказоустойчивость начинается с резервирования: экземпляров на один больше, чем требуется для пиковой нагрузки (схема N + 1), чтобы отказ одного не перегружал остальные. Копии разносят по доменам отказа — разным машинам, стойкам, линиям питания и площадкам: три реплики на одной машине переживут отказ процесса, но не отказ диска или питания.
Когда копии хранят данные и должны договориться, например о том, какая из них главная, применяется кворум: решение принимает большинство, \(\lfloor N/2 \rfloor + 1\) узлов.
| Узлов | Кворум | Переживает отказов |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
Три узла переживают отказ одного, пять — двух; отметим, что четыре узла переживают отказ тоже только одного, поэтому число узлов берут нечётным. Без большинства система обязана остановить запись: иначе после разрыва связи две половины выберут по главному узлу и начнут расходиться; это состояние называют split brain. По той же причине две площадки не обеспечивают автоматического переключения при разрыве связи между ними: добавляют третью, хотя бы со свидетелем, который не хранит данных и только голосует.
Проверки работоспособности
Чтобы перестать отправлять запросы отказавшему экземпляру, балансировщику необходимо узнать об отказе. Активная проверка периодически опрашивает служебный адрес, например /health, и исключает экземпляр после нескольких неудач подряд; она есть в HAProxy, Kubernetes и коммерческой версии nginx, но не в открытой. Пассивная проверка следит за настоящими запросами: в nginx экземпляр, давший max_fails неудач за время fail_timeout, исключается на fail_timeout, после чего получает пробный запрос. По умолчанию max_fails=1 и fail_timeout=10s.
upstream app {
server 127.0.0.1:8001 max_fails=1 fail_timeout=10s;
server 127.0.0.1:8002 max_fails=1 fail_timeout=10s;
server 127.0.0.1:8003 max_fails=1 fail_timeout=10s;
}
server {
listen 127.0.0.1:8080;
location / {
proxy_pass http://app;
proxy_read_timeout 1s; # ответа ждать не дольше 1 с
proxy_next_upstream error timeout; # когда пробовать соседа
}
}
Неудачный запрос nginx повторяет на соседнем экземпляре по правилам директивы proxy_next_upstream, по умолчанию — при ошибке соединения и тайм-ауте. Запросы с неидемпотентными методами POST, LOCK и PATCH nginx на соседа не передаёт, если запрос уже был отправлен экземпляру: повтор мог бы выполнить действие дважды.
В демонстрации к лекции к этой конфигурации подключены три экземпляра, а в журнал nginx добавлены адреса и коды всех попыток. Процесс app2 остановлен сигналом STOP: он не отвечает, но ядро продолжает принимать его соединения — так выглядит зависший процесс. Из трёх запросов POST, распределённых по очереди, запрос к app2 через 1,0 с, по истечении proxy_read_timeout, завершается кодом 504: уже отправленный POST nginx соседу не передаёт. После этой неудачи app2 исключён на 10 с, и шесть запросов GET делят app1 и app3 по три без задержек, за 0,1 с. Через 10 с app2 получает пробный запрос GET; nginx ждёт ответа 1 с и, не дождавшись, повторяет запрос на app1, так что клиент получает ответ 200, но примерно через секунду: шесть запросов занимают уже 1,1 с. Журнал nginx показывает обе ситуации:
POST / HTTP/1.1 504 up=127.0.0.1:8002 st=504
GET / HTTP/1.1 200 up=127.0.0.1:8002, 127.0.0.1:8001 st=504, 200
Завершённый процесс ведёт себя иначе: его порт закрыт, ядро сразу отклоняет соединение, запрос ещё не отправлен, и nginx передаёт соседу даже POST. Тот же опыт с процессом app2, завершённым сигналом TERM (в демонстрациях лекции его нет), дал на три запроса POST три ответа 200, а запрос, адресованный app2, записан в журнал с двумя попытками:
POST / HTTP/1.1 200 up=127.0.0.1:8002, 127.0.0.1:8003 st=502, 200
Журнал ошибок nginx содержит для этого запроса сообщение connect() failed (111: Connection refused); неудача соединения тоже засчитывается в max_fails, и app2 исключается на fail_timeout.
Сама точка входа тоже резервируется: несколько адресов в DNS, плавающий адрес по протоколу VRRP, который соседняя машина забирает себе при отказе, или anycast — один адрес, анонсируемый из нескольких мест сети. Содержание /health требует отдельного решения: проверка только того, что процесс жив, пропустит экземпляр, потерявший соединение с базой, а проверка всех зависимостей при отказе базы снимет все экземпляры сразу.
Тайм-ауты и дедлайн
Каждому сетевому вызову необходим тайм-аут: без него зависший сервис бесконечно удерживает вызывающего, его потоки и соединения, и отказ распространяется вверх по цепочке. Значения тайм-аутов в цепочке необходимо согласовать. Пусть nginx ждёт ответа gateway 10 с, gateway ждёт сервис articles 30 с, а articles ждёт базу 60 с. Клиент получит ответ 504 через 10 с, а gateway и articles продолжат работу, результат которой уже никому не нужен, и под нагрузкой такие запросы накапливаются. Отсюда правило: тайм-аут вызываемого меньше тайм-аута вызывающего на запас сетевых расходов. Одинаковые значения на всех уровнях не помогают, поскольку внутренний и внешний тайм-ауты срабатывают одновременно.
Надёжнее передавать по цепочке дедлайн, который представляет собой остаток времени, отведённого на запрос, например в заголовке. Каждый уровень вычитает потраченное время, а получив исчерпанный бюджет, прекращает работу. Передают именно остаток, а не абсолютный момент, потому что часы разных машин расходятся; так устроены дедлайны gRPC.
import time
def get_with_deadline(client, url, deadline):
"""Запрос с остатком бюджета; deadline — момент по time.monotonic()."""
left = deadline - time.monotonic() # остаток бюджета, с
if left <= 0:
raise TimeoutError('бюджет исчерпан')
return client.get(url, timeout=left,
headers={'X-Deadline-Ms': str(int(1000 * left))})
Здесь client — клиент httpx. Принимающий сервис вычисляет собственный дедлайн как сумму time.monotonic() и полученного остатка, а вызывая следующий уровень, передаёт остаток за вычетом небольшого запаса. Монотонные часы не зависят от перевода системного времени, поэтому дедлайн внутри процесса отсчитывают по ним.
В демонстрации к лекции скрипт deadline.py поднимает в рамках одного процесса цепочку из двух серверов, gateway и articles. Времена в демонстрации меньше, чем в примере выше, но соотношение то же — каждый уровень ждёт дольше вызывающего: клиент ждёт ответа 1 с, gateway ждёт articles 6 с, собственный тайм-аут articles — 60 с, а его работа занимает 3 с и выполняется частями по 0,1 с. Без дедлайна клиент через 1,0 с прекращает ждать с ошибкой TimeoutError, а articles доделывает работу, и gateway отвечает 200 через 3,1 с — ответ, который никто не прочтёт. С дедлайном в заголовке X-Deadline-Ms клиент так же получает отказ через 1,0 с, но gateway в тот же момент прекращает ждать и отвечает 504, а articles, обнаружив исчерпанный бюджет, прерывает работу через 1,0 с вместо 3. Для клиента разницы нет, но дедлайн позволяет системе не выполнять работу впустую.
Само значение тайм-аута выбирают по распределению задержки вызываемого сервиса: тайм-аут на уровне p99,9 означает одну ложную отмену на тысячу запросов. Так поступают в Amazon: сначала выбирают допустимую долю ложных тайм-аутов, например 0,1 %, а затем берут соответствующий перцентиль задержки вызываемого сервиса.
Повторы
Повтор неудачного запроса помогает пережить кратковременный сбой, но при перегрузке усиливает её. Если повторяет каждый уровень цепочки, попытки перемножаются: по две попытки на трёх уровнях дают до \(2^3 = 8\) запросов к последнему сервису, а в примере М. Брукера три попытки на каждом из пяти уровней увеличивают нагрузку на базу в \(3^5 = 243\) раза. Поэтому повторяют в одной точке стека, а число повторов ограничивают. В практике Google на один запрос приходится не больше трёх попыток, а повторы составляют не больше 10 % всех запросов клиента [23]: при полном отказе зависимости нагрузка на неё растёт не почти втрое, а лишь в 1,1 раза.
Пауза между попытками растёт экспоненциально и выбирается случайно в пределах от нуля до текущей границы: иначе клиенты, одновременно получившие отказ, одновременно и повторят запросы, создав новый пик. Повторяют только временные ошибки — тайм-аут, обрыв соединения, коды 429, 502, 503 и 504 с учётом заголовка Retry-After — и только идемпотентные операции, поскольку тайм-аут не означает, что действие не выполнено. Коды состояния HTTP и повтор запросов клиентом requests рассмотрены в главе «Веб-технологии»; здесь запишем повтор с бюджетом в общем виде:
import random
import time
class RetryBudget:
"""Бюджет повторов клиента: повторов не больше доли ratio от запросов."""
def __init__(self, ratio=0.1, reserve=10):
self.ratio, self.reserve = ratio, reserve
self.tokens = reserve # запас на редкие сбои
def request(self): # каждый запрос пополняет счёт
self.tokens = min(self.reserve, self.tokens + self.ratio)
def allow_retry(self): # каждый повтор тратит единицу
if self.tokens >= 1:
self.tokens -= 1
return True
return False
def call_with_retries(call, budget=None, attempts=3, base=0.05, cap=1.0):
"""Не больше attempts попыток; пауза случайна в пределах, растущих вдвое."""
if budget:
budget.request()
for attempt in range(attempts):
try:
return call()
except (TimeoutError, ConnectionError): # только временные ошибки
last = attempt == attempts - 1
if last or (budget and not budget.allow_retry()):
raise
time.sleep(random.uniform(0, min(cap, base * 2 ** attempt)))
Бюджет представляет собой ведро жетонов: каждый запрос добавляет в него 0,1 жетона, каждый повтор расходует один, а запас в десять жетонов покрывает редкие сбои. Проверим бюджет на зависимости, отказавшей полностью (листинг выше сохранён в файле retry.py):
from retry import RetryBudget, call_with_retries
def outage(budget, n=1000):
"""n запросов к зависимости, отказавшей полностью; число её вызовов."""
calls = 0
def broken():
nonlocal calls
calls += 1
raise ConnectionError('зависимость недоступна')
for _ in range(n):
try:
call_with_retries(broken, budget, base=0)
except ConnectionError:
pass
return calls
print('без бюджета:', outage(None))
print('с бюджетом 10 %:', outage(RetryBudget()))
без бюджета: 3000
с бюджетом 10 %: 1109
Без бюджета каждый из 1000 запросов делает три попытки, и зависимость получает 3000 вызовов. С бюджетом повторов 109 — десять из запаса и по одному на каждые десять запросов, — и нагрузка растёт в 1,11 раза, что согласуется с оценкой из практики Google. Бюджет, таким образом, позволяет пережить редкие сбои и не умножает нагрузку при полном отказе. Нулевая пауза (base=0) выбрана только для того, чтобы опыт не длился минутами.
В демонстрации к лекции скрипт backoff.py печатает паузы трёх клиентов перед шестью повторами: граница растёт вдвое от 0,1 до 1,6 с и ограничена 2 с, а пауза выбирается случайно в её пределах, поэтому перед пятым повтором клиенты ждут 0,79, 1,34 и 1,00 с. Скрипт chain.py поднимает цепочку из трёх серверов на Python, названных nginx, gateway и articles, причём articles на каждый запрос отвечает 503. При двух попытках на каждом уровне до articles доходит 8 запросов, при трёх — 27, а если повторяет только gateway — 2.
Идемпотентность
Операция идемпотентна, если повторное выполнение оставляет систему в том же состоянии, что и однократное; ответ на повтор может отличаться: повторный DELETE получает 404. По стандарту HTTP (RFC 9110) идемпотентны методы чтения GET и HEAD, замена ресурса целиком PUT и удаление DELETE, поэтому их можно повторять после обрыва.
| Операция | Повтор безопасен |
|---|---|
| GET, HEAD — чтение | да |
| PUT — замена ресурса целиком | да |
| DELETE — удаление | да |
| POST — создание записи, списание | нет, без ключа операции |
| «выставить ток 10 А» | да |
| «увеличить ток на 1 А» | нет |
POST, создающий запись или выполняющий списание, при повторе создаст вторую запись. Чтобы сделать его идемпотентным, достаточно ключа операции: клиент создаёт уникальный ключ один раз на логическую операцию, а не на попытку, и передаёт его во всех попытках, например в заголовке Idempotency-Key, принятом в платёжных API (черновик стандарта IETF с этим заголовком истёк, и стандартом он не стал). Сервер, увидев известный ключ, возвращает сохранённый ответ, не повторяя действия; ключ обеспечивает однократность действия при любом числе попыток. Рассмотрим сервис платежей, у которого каждый третий ответ задержан на секунду, — так моделируется ответ, не дошедший до клиента вовремя:
import asyncio
from typing import Annotated
from fastapi import FastAPI, Header
app = FastAPI()
payments = [] # выполненные списания
responses = {} # ключ операции -> сохранённый ответ
attempts = 0 # число принятых запросов POST
@app.post('/pay')
async def pay(payment: dict,
idempotency_key: Annotated[str | None, Header()] = None):
global attempts
attempts += 1
if idempotency_key in responses:
result = responses[idempotency_key] # повтор: списания нет
else:
payments.append(payment['amount'])
result = {'payment': len(payments)}
if idempotency_key:
responses[idempotency_key] = result
if attempts % 3 == 0: # каждый третий ответ задержан
await asyncio.sleep(1.0)
return result
@app.get('/payments')
async def report():
return {'attempts': attempts, 'count': len(payments),
'sum': sum(payments)}
FastAPI сопоставляет параметр idempotency_key заголовку Idempotency-Key: подчёркивание заменяется дефисом, а регистр в именах заголовков не различается. Клиент ждёт ответа 0,3 с, повторяет запрос при ошибке транспорта — тайм-ауте или обрыве соединения — со случайной паузой и создаёт ключ один раз на платёж:
import random
import sys
import time
import uuid
import httpx
URL = 'http://127.0.0.1:8010'
def pay(client, payment, use_key=True, attempts=4):
key = str(uuid.uuid4()) # один ключ на операцию
headers = {'Idempotency-Key': key} if use_key else {}
for attempt in range(attempts):
try:
return client.post(f'{URL}/pay', json=payment, headers=headers)
except httpx.TransportError: # тайм-аут, обрыв соединения
time.sleep(random.uniform(0, 0.1 * 2 ** attempt))
raise RuntimeError('попытки исчерпаны')
use_key = '--no-key' not in sys.argv
with httpx.Client(timeout=0.3) as client:
for _ in range(10):
pay(client, {'amount': 100}, use_key)
time.sleep(1.1) # дождаться задержанных ответов
report = client.get(f'{URL}/payments').json()
print('с ключом: ' if use_key else 'без ключа:', report)
Сервис из первого листинга сохранён в файле pay_api.py, клиент — в pay_client.py. Сервис запускался командой uvicorn pay_api:app --port 8010 заново перед каждым из двух прогонов клиента, python3 pay_client.py --no-key и python3 pay_client.py:
без ключа: {'attempts': 14, 'count': 14, 'sum': 1400}
с ключом: {'attempts': 14, 'count': 10, 'sum': 1000}
Десять платежей по 100 потребовали 14 попыток. Без ключа сервис записал 14 платежей на сумму 1400: каждый повтор после задержанного ответа списал деньги ещё раз. С ключом при тех же 14 попытках записано 10 платежей на 1000: повтор с известным ключом получил сохранённый ответ. Та же картина получена в демонстрации к лекции со скриптом pay.py. Ответы 4xx и 5xx httpx исключениями не считает, поэтому функция pay повторяет только ошибки транспорта; повтор по кодам 503 и 429 добавляется проверкой status_code.
Словарь responses в листинге — состояние в памяти процесса, и со вторым экземпляром сервиса защита перестала бы работать: повтор, попавший на соседний экземпляр, списал бы деньги снова. В рабочей системе ключ и ответ хранятся в общей базе и записываются в той же транзакции, что и само списание, а уникальность ключа обеспечивает ограничение UNIQUE; тогда и два одновременных повтора не выполнят действие дважды. Ключи хранят ограниченное время, например сутки, за которые повторы заведомо закончатся.
Тот же принцип применим к управлению установкой. Команда «выставить ток квадруполя 10 А» идемпотентна и может безопасно повторяться до подтверждения, а «увеличить ток на 1 А» при потерянном ответе и повторе изменит ток на 2 А. Поэтому программы управления повторяют уставку с проверкой прочитанного значения. В библиотеке SCAUT, рассмотренной в главе «От скрипта к приложению», функция установки мотора записывает уставку, выжидает заданную паузу и читает значение обратно, повторяя запись, пока прочитанное значение не попадёт в допуск, но не больше заданного числа попыток.
Автомат защиты и деградация
Когда вызываемый сервис отказал, повторы и даже обычные запросы мешают ему восстановиться и занимают ресурсы вызывающего ожиданием тайм-аутов. Автомат защиты (circuit breaker) представляет собой шаблон из книги М. Найгарда «Release It!» [25]: он ставится на стороне вызывающего и имеет три состояния. В закрытом состоянии запросы проходят, а неудачи считаются; после нескольких неудач подряд автомат открывается и в течение заданной паузы сразу возвращает ошибку или заглушку, не обращаясь к сервису. По истечении паузы автомат переходит в полуоткрытое состояние и пропускает один пробный настоящий запрос: при успехе закрывается, при неудаче снова открывается.
class Breaker:
def __init__(self, threshold=3, open_for=1.0):
self.threshold, self.open_for = threshold, open_for
self.state, self.failures, self.opened_at = "closed", 0, 0.0
def call(self, now, func):
if self.state == "open":
if now - self.opened_at < self.open_for:
return "заглушка" # быстрый отказ
self.state = "half-open" # пробный запрос
if func(now):
self.state, self.failures = "closed", 0
return "ответ"
self.failures += 1
if self.state == "half-open" or self.failures >= self.threshold:
self.state, self.opened_at = "open", now
return "ошибка"
Время now передаётся явно, что позволяет проверить автомат в модельном времени. Скрипт демонстрации breaker.py с этим классом подаёт на gateway 10 запросов в секунду, а сервис articles недоступен первые 2,5 с; печатаются смены результата и состояния:
0.0 с ошибка -> closed
0.2 с ошибка -> open
0.3 с заглушка -> open
1.2 с пробный запрос: ошибка -> open
1.3 с заглушка -> open
2.2 с пробный запрос: ошибка -> open
2.3 с заглушка -> open
3.2 с пробный запрос: ответ -> closed
запросов к gateway 40, до articles дошло 13 (без автомата было бы 40)
После третьей неудачи подряд, в 0,2 с, автомат открывается, и до 1,2 с запросы получают заглушку. Пробные запросы в 1,2 и 2,2 с неудачны, а пробный запрос в 3,2 с успешен, и автомат закрывается. Из 40 запросов до articles дошло 13.
Применение автомата имеет цену. По опыту Amazon он вносит в систему режимы, которые трудно проверить заранее, и может задержать восстановление, поэтому там предпочитают ограничивать повторы локально, ведром жетонов, — именно так устроен бюджет повторов в листинге выше; в AWS SDK такое ограничение действует с 2016 года.
Вместе с автоматом применяют деградацию функциональности: вместо ошибки 504 пользователь получает страницу без отказавшего блока, последнюю сохранённую версию данных или ответ 503 с заголовком Retry-After. Для архива измерений это означает, что при недоступности сервиса построения графиков страница запуска показывает таблицу и последний сохранённый график, а не ошибку.
Данные
Слайды к главе. Репликация и отставание реплик, шардирование, CAP и PACELC, кеширование и инвалидация, очереди и обратное давление изложены также в четвёртой части лекции «Архитектура и системный дизайн» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Сервис без состояния масштабируется добавлением экземпляров. Базы, кеши и очереди хранят состояние, и с ними так поступить нельзя: копии должны содержать одни и те же данные, а их согласование имеет цену. Подробно эти вопросы рассмотрены у Клеппмана [16].
Репликация
Репликация решает задачу так: запись принимает одна главная база, а изменения передаются репликам, которые обслуживают чтение; в PostgreSQL изменения передаются по журналу упреждающей записи (WAL). Устройство журнала, физическая и логическая репликация и восстановление на момент времени рассмотрены в разделе «Эксплуатация» главы «Работа с базами данных». Реплики позволяют масштабировать чтение: если данные читают в сотни раз чаще, чем пишут, добавление реплик снимает нагрузку с главной базы. Для метаданных архива это означает запись в главную базу, а поиск и графики — с реплик.
По умолчанию потоковая репликация PostgreSQL асинхронна: главная база подтверждает запись, не дожидаясь реплики, и реплика отстаёт, обычно меньше чем на секунду. Отсюда два следствия. Чтение с реплики сразу после записи может не увидеть только что записанное, поэтому для гарантии «читать свои записи» такие чтения направляют в главную базу. При отказе главной базы реплику повышают до главной, и транзакции, не успевшие до неё дойти, теряются. Синхронная репликация подтверждает запись только после её сохранения на реплике — без потерь, но медленнее и с остановкой записи при недоступности реплики. Переключение выполняет автоматика, например Patroni для PostgreSQL, принимающая решение по кворуму.
Шардирование и секционирование
Когда объём данных или поток записи превышает возможности одной машины, данные делят на части — шарды, каждая из которых хранится на своей машине со своими репликами. Шард определяется ключом, и выбор ключа является главным решением.
| Ключ | Достоинство | Недостаток |
|---|---|---|
| время | интервал читается с одного шарда | вся текущая запись — в последний шард |
| хеш номера запуска | нагрузка равномерна | интервал времени — со всех шардов |
| канал, затем время | канал за интервал — на одном шарде | популярный канал перегружает свой шард |
Деление по времени удобно для архива измерений: выборка за интервал читается с одного шарда, но вся текущая запись приходится на последний. Хеш номера запуска распределяет нагрузку равномерно, но выборка за интервал времени требует обращения ко всем шардам. Составной ключ «канал, время» размещает данные одного канала вместе, но популярный канал перегружает свой шард. При добавлении шардов данные перераспределяются, и консистентное хеширование ограничивает перенос долей \(1/(N+1)\). Запросы и транзакции, затрагивающие несколько шардов, дороже или вовсе недоступны, а смена ключа означает перенос всех данных, поэтому ключ выбирают заранее, по главным запросам.
К шардированию приходят не сразу. Секционирование таблицы внутри одной базы — PARTITION BY RANGE в PostgreSQL или расширение TimescaleDB для временных рядов — решает многие задачи архива без распределённой системы: оно позволяет запросу за интервал читать только нужные секции, а устаревшие секции удалять целиком. Секционирование временного ряда по месяцам с планом запроса показано в том же разделе «Эксплуатация» главы «Работа с базами данных».
CAP, PACELC и кворумы
Хранилище с несколькими копиями при разрыве сети неизбежно выбирает между согласованностью и доступностью. Теорема CAP, сформулированная Э. Брюером и доказанная С. Гилбертом и Н. Линч, утверждает: при разрыве сети (P), разделяющем копии, система либо отказывает части запросов, сохраняя согласованность (C), либо отвечает на все, рискуя выдать устаревшие данные (A). Разрыв сети является не выбором, а условием эксплуатации, поэтому выбирать приходится между C и A. Расширение PACELC, предложенное Д. Абади, добавляет обычный режим: и без разрыва (E) приходится выбирать между задержкой (L) и согласованностью (C), поскольку синхронное подтверждение от нескольких копий увеличивает задержку, а асинхронное допускает расхождение копий.
Кворумы позволяют настраивать этот выбор. Пусть данные хранятся в N копиях, запись ждёт подтверждения W копий, а чтение опрашивает R копий и берёт новейшее значение. Если \(R + W > N\), множества копий, участвовавших в записи и в чтении, пересекаются хотя бы в одной копии, и чтение видит последнюю подтверждённую запись. При N = 3 и W = R = 2 любые две копии из трёх имеют общую, и система переживает отказ одной копии и при записи, и при чтении. Так устроены Cassandra и подобные системы с уровнями согласованности ONE, QUORUM и ALL.
Таким образом, для каждой части данных архива решают, допустимо ли устаревание и насколько. График канала может отставать на секунду, а номер нового запуска должен быть единственным, поэтому его выдаёт одна главная база.
Кеширование
Кеш хранит результаты дорогих операций ближе к потребителю, и уровней у него несколько: браузер и CDN, кеш nginx, память процесса приложения, общий кеш наподобие Redis. Распространённая схема — cache-aside: приложение сначала ищет значение в кеше, при промахе читает базу и помещает результат в кеш со сроком жизни, а при записи обновляет базу и удаляет ключ из кеша. Так устроены кеш страниц в Redis в разделе «Одна задача в четырёх хранилищах» главы «Работа с базами данных» и сервисный слой в разборе «Асинхронное API для кинотеатра».
Удаление ключа при записи называют инвалидацией, и оно является самым трудным местом схемы: сброс может не дойти, а чтение, начавшееся до записи, может поместить в кеш устаревшее значение уже после сброса. Срок жизни ограничивает время, в течение которого такая ошибка видна. Вторая опасность — лавина промахов: когда истекает срок жизни популярного ключа, все экземпляры одновременно идут за ним в базу. Защитой служит один загрузчик, пока остальные ждут его результата, или выдача устаревшего значения на время обновления; в nginx это директивы proxy_cache_lock и proxy_cache_use_stale. Третья опасность — холодный старт: после перезапуска кеша вся нагрузка приходится на базу, и база должна её выдерживать, иначе кеш прогревают постепенно. Локальный кеш процесса быстрее всех, но у каждого экземпляра он свой и теряется при перезапуске.
Ниже приведён кеш со сроком жизни и одним загрузчиком из демонстрации к лекции:
import threading
import time
class Cache:
"""Кеш со сроком жизни; single_flight — один загрузчик при промахе."""
def __init__(self, ttl, single_flight=False):
self.ttl, self.single_flight = ttl, single_flight
self.data, self.lock = {}, threading.Lock()
def get(self, key, loader):
item = self.data.get(key)
if item and item[1] > time.monotonic():
return item[0] # попадание
if not self.single_flight:
value = loader(key) # каждый промах — в базу
else:
with self.lock: # остальные ждут первого
item = self.data.get(key)
if item and item[1] > time.monotonic():
return item[0]
value = loader(key)
self.data[key] = (value, time.monotonic() + self.ttl)
return value
def invalidate(self, key):
self.data.pop(key, None)
При промахе без защиты каждый поток идёт в базу сам; в режиме одного загрузчика потоки ждут замок и после него проверяют кеш повторно, так что в базу идёт только первый. Замок здесь один на весь кеш; в рабочем коде целесообразно заводить замок на каждый ключ, чтобы промахи по разным ключам не ждали друг друга. В демонстрации «база» представлена словарём с током квадруполя Q1, чтение которого занимает 200 мс. Функция с декоратором functools.lru_cache первое чтение выполняет за 200,1 мс, второе — за 0,0 мс. Затем в базу записывается 12,0 А: кеш без сброса продолжает отдавать 10,0 А, а после удаления ключа — 12,0 А. Наконец, срок жизни ключа истекает, и 50 потоков одновременно запрашивают его: без защиты в базу идут все 50, с одним загрузчиком — один, а время в обоих случаях равно 0,21 с.
Очереди
Очередь между частями системы развязывает их во времени: источник отдаёт работу и продолжает свою, обработчики разбирают её в своём темпе, а кратковременный пик нагрузки сглаживается. Между процессами и машинами очередь реализует брокер сообщений — Kafka, RabbitMQ, Redis Streams. Важнейшим параметром очереди является предел длины. Неограниченная очередь не защищает от перегрузки, а откладывает её проявление: если поток стабильно выше ёмкости обработчиков, очередь и время ожидания растут без предела, пока не кончится память.
Полная ограниченная очередь оставляет два допустимых варианта. Обратное давление: источник ждёт места и сам замедляется до ёмкости обработчиков; такой режим обеспечивает сохранность всех данных, но источник должен уметь ждать. Сброс нагрузки: лишнее отклоняется сразу, например ответом 429 или 503, и источник сохраняет темп ценой потерь. В очереди asyncio оба варианта записываются несколькими строками; ниже — фрагмент источника из скрипта демонстрации queue_demo.py:
if shed:
try:
q.put_nowait(item)
except asyncio.QueueFull:
dropped += 1 # сброс
else:
await q.put(item) # ждёт места: давление
Скрипт моделирует систему сбора: источник выдаёт 100 измерений в секунду в течение 3 с, два обработчика тратят по 30 мс на измерение.
| Очередь | Выдача, с | Обработано через, с | Длина по секундам | Наибольшее ожидание, с | Сброшено |
|---|---|---|---|---|---|
| без предела | 3,0 | 4,8 | 36, 71, 108 | 1,74 | 0 |
maxsize=10, давление | 4,6 | 4,8 | 10, 10, 10 | 0,20 | 0 |
maxsize=10, сброс | 3,0 | 3,2 | 10, 9, 10 | 0,16 | 98 |
Оценим ожидаемое. Ёмкость обработчиков равна \(2 / 0{,}03 \approx 67\) измерениям в секунду, поэтому без предела очередь растёт примерно на 33 измерения в секунду и к концу выдачи достигает около ста; в опыте её длина по секундам равна 36, 71 и 108, а последнее измерение обработано через 4,8 с. С ожиданием выдача растягивается до 4,6 с, очередь всё время полна, но ожидание не превышает 0,20 с и ничего не потеряно. Со сбросом источник сохраняет темп, 3,0 с, и короткое ожидание, 0,16 с, ценой 98 сброшенных измерений из 300, что близко к оценке \(300 - 3 \cdot 67 - 10 \approx 90\): за 3 с обработчики принимают около двухсот измерений, а ещё десять помещаются в очередь.
Брокеры обычно гарантируют доставку «хотя бы один раз»: после сбоя сообщение может прийти повторно, поэтому обработчик делают идемпотентным. Для системы сбора данных измерения сбрасывать нельзя — их необходимо хранить в буфере на диске и передавать давление источнику, — а запросы просмотра графиков при перегрузке можно отклонить.
Сопровождение
Слайды к главе. Журналы, метрики и трассировки, монолит и микросервисы, сетка сервисов и защита от перегрузки изложены также в пятой части лекции «Архитектура и системный дизайн» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Работающую систему наблюдают, изменяют и защищают от перегрузки. Общие практики сопровождения — дежурства, разбор инцидентов, chaos engineering — перечислены в разделе «Сопровождение» главы «Жизненный цикл ПО»; здесь рассматривается то, что относится к системе из нескольких частей.
Журналы, метрики и трассировки
Наблюдаемость обеспечивают три вида сигналов.
| Сигнал | Вопрос | Инструменты |
|---|---|---|
| журналы | что случилось с этим запросом? | logging, Loki, Elasticsearch |
| метрики | сколько, как быстро, сколько ошибок? | Prometheus, Grafana |
| трассировки | где запрос провёл время? | OpenTelemetry, Jaeger |
Журналы отвечают на вопрос, что случилось с конкретным запросом, и нужны для расследования. Метрики представляют собой числа во времени — запросы в секунду, доля ошибок, перцентили задержки, заполнение диска; по ним строят графики и оповещения. Трассировки показывают путь одного запроса через все сервисы и время на каждом участке. Связывает сигналы идентификатор запроса: nginx на входе вычисляет переменную $request_id и передаёт её приложению заголовком, и все записи о запросе в журналах всех сервисов содержат одно значение. Стандартный формат передачи контекста трассировки — заголовок traceparent из рекомендации W3C Trace Context, реализуемый библиотеками OpenTelemetry.
log_format rid '$request_id $status $request_time';
server {
listen 127.0.0.1:8080;
access_log /var/log/nginx/access.log rid;
location / {
proxy_set_header X-Request-ID $request_id;
proxy_pass http://127.0.0.1:8001;
}
}
Два запроса к этой конфигурации с экземпляром на порту 8001, возвращающим полученный заголовок, дают ответы
X-Request-ID: 4badfddfc135bb0bca59af9adff8b580
X-Request-ID: cad908e5677252cc248aec77bf34a97b
и строки журнала nginx с теми же идентификаторами:
4badfddfc135bb0bca59af9adff8b580 200 0.004
cad908e5677252cc248aec77bf34a97b 200 0.001
Формату журнала дано собственное имя. В образе nginx:alpine основной файл /etc/nginx/nginx.conf уже объявляет формат main и лишь затем подключает файлы каталога conf.d, поэтому та же конфигурация с именем main не проходит проверку nginx -t:
nginx: [emerg] duplicate "log_format" name "main" in /etc/nginx/conf.d/default.conf:1
Директива log_format только объявляет формат, а журнал пишется в нём, когда формат назван в директиве access_log.
Книга Google SRE рекомендует для каждого сервиса следить за четырьмя сигналами: задержкой, трафиком, ошибками и насыщением [23]. Оповещение должно требовать действия человека и срабатывать по симптому, а не по причине: по скорости расходования бюджета ошибок, а не по загрузке процессора. В качестве начальных порогов рекомендуется вызывать дежурного, если за час израсходовано 2 % бюджета на 30 дней или за шесть часов — 5 %, и заводить заявку, если за трое суток израсходовано 10 % [24]. Определим, что означают эти пороги. В 30 днях 720 ч, и при равномерном расходе за час тратится 1/720 бюджета; 2 % за час соответствуют скорости расходования \(0{,}02 \cdot 720 = 14{,}4\), при которой бюджет иссякнет за 50 ч. Для 5 % за шесть часов скорость равна \(0{,}05 \cdot 120 = 6\), для 10 % за трое суток — \(0{,}1 \cdot 10 = 1\): заявку заводят, когда бюджет расходуется ровно с той скоростью, при которой его хватит лишь до конца окна.
Типы метрик и экспортёры, хранение в Prometheus, трассировка OpenTelemetry, панели и правила оповещения по скорости расходования бюджета с их тестами рассмотрены в главе «Наблюдаемость».
Монолит и микросервисы
| Монолит | Микросервисы | |
|---|---|---|
| выкатка | целиком | по сервису |
| масштабирование | целиком | по сервису |
| отказ части | общий процесс | частичный, через сеть |
| данные | одна транзакция | согласование между базами |
| команды | одна | несколько независимых |
| цена старта | низкая | сеть, наблюдаемость, выкатка |
Монолит представляет собой одну программу, которая выкатывается и масштабируется целиком; микросервисы — набор небольших сервисов, каждый со своей базой, выкатываемых и масштабируемых независимо. Выбор между ними — вопрос организации команды не меньше, чем техники. Монолит дешевле на старте: вызов функции вместо сетевого запроса, одна транзакция вместо согласования нескольких баз, одна выкатка. Его проблемы появляются с ростом: десяток команд мешает друг другу в одном коде, а выкатка целого становится рискованной. Микросервисы снимают эти проблемы ценой всего, о чём шла речь в разделе об отказоустойчивости, — частичных отказов, тайм-аутов и повторов, — а также затрат на наблюдаемость и согласование данных.
Распространённый совет — начинать с модульного монолита, в котором модули имеют чёткие интерфейсы, как слои SCAUT в главе «От скрипта к приложению» или слои сервиса в разборе «Асинхронное API для кинотеатра», и выделять сервис, когда граница модуля действительно мешает выкатке или масштабированию. Известен и обратный путь: в 2023 году команда Prime Video перенесла мониторинг качества видео из набора распределённых компонентов в одно приложение и сократила затраты на инфраструктуру более чем на 90 %. Группе из пяти человек с одной установкой достаточно монолита с модулями сбора, хранения и веб-интерфейса.
Сетка сервисов
Когда сервисов десятки, тайм-ауты, повторы, балансировку, шифрование и метрики неудобно реализовывать в каждом из них. Сетка сервисов (service mesh) выносит эти функции из кода в посредника, который запускается рядом с каждым экземпляром, — это уровень данных (data plane). Сервис обращается к соседу через локального посредника, а тот выбирает экземпляр, повторяет запрос, соблюдает тайм-ауты, шифрует соединение взаимным TLS и собирает метрики. Уровень управления (control plane) знает топологию системы и раздаёт посредникам адреса экземпляров, правила и сертификаты; его отказ не останавливает работающих посредников, они продолжают работу с последней полученной конфигурацией.
Первой реализацией был Linkerd в 2016 году, наиболее известная — Istio на основе посредника Envoy, с 2020 года управляемая одним процессом istiod. Цена — два посредника на пути каждого вызова и потребляемые ими ресурсы: по данным проекта Istio для версии 1.24, около 0,2 vCPU и 60 МБ памяти на тысячу запросов в секунду у каждого посредника; режим ambient заменяет посредника у каждого экземпляра общим посредником на узле. Для трёх-пяти сервисов сетка избыточна: для тех же задач достаточно библиотеки клиента и nginx.
Ограничение частоты и сброс нагрузки
Перегрузка приходит не только от атаки: наплыв пользователей после публикации данных, собственный нагрузочный тест, запущенный не на том сервере, скрипт коллеги без паузы между запросами. Ограничение частоты отклоняет запросы сверх заданного темпа до дорогой обработки. В nginx его реализует модуль limit_req по алгоритму «дырявого ведра»: каждый клиент, определяемый ключом, например адресом, получает темп r запросов в секунду и запас b на залп, а с параметром nodelay ведро ведёт себя как ведро жетонов и пропускает залп сразу. По умолчанию nginx отвечает на лишние запросы кодом 503, который клиент примет за отказ сервера, поэтому код меняют на 429 Too Many Requests. Заголовок Retry-After, подсказывающий клиенту, когда повторить, limit_req сам не добавляет: его задаёт директива add_header, а для кода 429 — только с параметром always.
map $status $retry_after { # заголовок только у отказов 429
429 1;
default "";
}
limit_req_zone $binary_remote_addr zone=perip:10m rate=5r/s;
upstream app {
server 127.0.0.1:8001;
server 127.0.0.1:8002;
server 127.0.0.1:8003;
}
server {
listen 127.0.0.1:8080;
location / {
limit_req zone=perip burst=10 nodelay; # запас на залп — 10
limit_req_status 429; # по умолчанию — 503
add_header Retry-After $retry_after always;
proxy_pass http://app;
}
}
Блок map вычисляет значение заголовка по коду ответа: для 429 — одна секунда, для остальных кодов — пустая строка, а заголовок с пустым значением nginx не добавляет. Из залпа в 12 одновременных запросов к этой конфигурации 11 получили ответ 200 без заголовка, а последний — такой ответ:
HTTP/1.1 429 Too Many Requests
Server: nginx/1.31.6
Date: Sat, 03 Oct 2026 03:50:28 GMT
Content-Type: text/html
Content-Length: 169
Connection: keep-alive
Retry-After: 1
Без параметра always заголовок получили только ответы 200, а ответ 429 остался без него; строка add_header Retry-After 1 always; без блока map добавляет заголовок ко всем ответам, включая успешные.
В демонстрации к лекции та же конфигурация без заголовка ограничивает каждый адрес пятью запросами в секунду с запасом в десять. Из залпа в 30 одновременных запросов 11 получают ответ 200 — один в счёт темпа и десять в счёт запаса, — а 19 получают 429. Поток 20 запросов в секунду в течение 4 с пропускает 15 запросов в первую секунду и ровно по 5 в каждую следующую. Журнал ошибок nginx содержит 69 записей limiting requests — по одной на каждый отклонённый запрос, 19 из залпа и 50 из потока.
Сброс нагрузки применяет тот же принцип внутри сервиса: перегруженный сервис отклоняет часть запросов сразу и вовремя отвечает остальным, а не отвечает всем с задержкой в секунды. От объёмных атак на канал ограничение частоты в nginx не защищает: их отсекают до сервиса — у провайдера, в CDN, распределением адреса через anycast. Межсетевые экраны прикладного уровня отклоняют запросы с признаками атак, а капча отделяет автоматические запросы от людей.
Сопровождаемость
Сопровождаемость — свойство системы, позволяющее изменять её и управлять ею без чрезвычайных усилий. Первое правило — простота: каждый компонент представляет собой ещё одну часть, которая может отказать и которую необходимо обновлять, поэтому кеш, очередь или второй тип базы добавляют, когда без них измеримо хуже, а не на будущее. Второе — знакомые технологии: новую базу или брокер сначала проверяют под нагрузкой на тестовом контуре, а не вводят в работу по одной прочитанной статье. Третье — управляемая выкатка: конвейер CI/CD, постепенная выкатка с оповещениями о её ходе и откат одной командой, рассмотренные в главе «Жизненный цикл ПО». Четвёртое — изоляция контуров: тестовый контур не пишет в рабочую базу, а разные группы пользователей или установки обслуживаются разными экземплярами, чтобы ошибка или наплыв в одном контуре не затрагивали другой.
Зеркалирование рабочих запросов в тестовый контур позволяет проверить новую версию на настоящей нагрузке, но опасно для запросов с побочным действием — писем, списаний, команд оборудованию. Новую версию программы сбора данных поэтому сначала проверяют на стенде с моделью установки, а затем выпускают в смену с готовым откатом.
Проектирование системы сбора данных
Слайды к главе. Проект системы сбора данных установки — требования, оценки, схема, отказы и реакции — изложен также в шестой части лекции «Архитектура и системный дизайн»; слайды лекции доступны на сайте книги и в PDF.
Применим сказанное к задаче, знакомой физику, — системе сбора данных установки. Порядок проектирования тот же, что и в главе: требования, оценки, схема, отказы и наблюдаемость.
Требования и оценки
Функциональные требования: принимать данные с оцифровщиков, хранить их в архиве, выдавать выборку канала за интервал времени и строить графики. Нефункциональные требования записываются числами. Поток: 200 каналов по 10 кГц и 2 байта на отсчёт, непрерывно. Сохранность: ни одно измерение не теряется при отказе одной машины; это требование важнее скорости чтения. Чтение: двадцать сотрудников и их скрипты, до 50 запросов/с в пике, p99 выборки канала меньше секунды, доступность чтения 99,9 % за 30 дней. Стоимость: три машины и диски на год записи.
rate = 200 * 10_000 * 2 # байт/с: каналы × частота × байт на отсчёт
day = rate * 86_400 / 1e12 # ТБ в сутки
year = day * 365 # ТБ в год
samples = 200 * 10_000 * 86_400 # отсчётов в сутки
print(rate / 1e6, round(day, 2), round(year), f'{samples:.3g}')
4.0 0.35 126 1.73e+11
Оценим следствия. Поток 4 МБ/с даёт около 0,35 ТБ в сутки и 126 ТБ в год, а с двумя копиями архива — 252 ТБ; отсюда требования к дискам и вопрос о сжатии и прореживании старых данных, который тоже относится к требованиям. В сетевых единицах 4 МБ/с составляют 32 Мбит/с, около 3 % пропускной способности сети 1 Гбит/с, так что сеть между машинами даже с учётом копий узким местом не станет. Хранение каждого отсчёта отдельной строкой реляционной таблицы означало бы почти 173 млрд строк в сутки; поэтому отсчёты хранят блоками в файлах, а в базе — только метаданные. Приближённая оценка до выбора технологий отсеивает неподходящие решения.
Схема
Схема разделяет путь записи и путь чтения, потому что требования к ним разные:
Путь записи
Оцифровщики ─4 МБ/с─▶ Приёмники ×2 ─────▶ Очередь ──────────▶ Писатели ×2 ──────▶ Архив
200 каналов буфер на диске брокер, 3 узла файлы по часам HDF5, 2 копии
│
└──▶ Метаданные
PostgreSQL и реплика
Путь чтения
Сотрудники ────50 запросов/с────▶ nginx ──────────▶ API ×2 ────▶ Метаданные и архив
скрипты, браузер лимит и FastAPI
балансировка │
└──▶ Кеш графиков, Redis
Рассмотрим путь записи. Оцифровщики отправляют данные двум приёмникам. Каждый приёмник сначала пишет поток в буфер на локальном диске, который позволяет пережить кратковременный отказ следующих звеньев, а затем передаёт его в очередь — брокер сообщений на трёх узлах, хранящий сообщения с репликацией. Брокер переживает отказ одного узла: кворум из двух оставшихся продолжает работу. Именно брокер определяет число машин: на двух машинах одна несла бы два узла из трёх, и с её отказом пропал бы кворум, а трёх машин с одним узлом на каждой достаточно. Писатели забирают данные из очереди, складывают их в файлы HDF5 по часам и каналам в архив с двумя копиями и регистрируют каждый файл в метаданных. Запись идемпотентна — например, каждый блок измерений несёт номер, и писатель пропускает блок, уже записанный в архив, — поэтому повторная доставка сообщения не создаёт дубликатов. Метаданные — запуски, каналы, интервалы и пути к файлам — хранятся в PostgreSQL с репликой.
Путь чтения начинается с сотрудников и их скриптов, которые обращаются к nginx. Nginx ограничивает частоту запросов и распределяет их между двумя экземплярами API на FastAPI без состояния. API находит файлы по метаданным, читает нужные интервалы из архива и помещает построенные графики в кеш Redis. Метрики и журналы всех компонентов собираются отдельно и на схеме не показаны.
Отказы и реакции
Последний шаг проектирования — пройти по схеме и для каждого компонента ответить на вопрос, что произойдёт при его отказе и какое требование окажется под угрозой.
| Отказ | Реакция системы | Требование под угрозой |
|---|---|---|
| приёмник | приём вторым приёмником, буфер в оцифровщике | сохранность |
| узел очереди | работа кворума из двух оставшихся узлов | сохранность |
| писатель | ожидание данных в очереди, второй писатель | сохранность |
| заполнение диска | оповещение за 7 суток по прогнозу | сохранность |
| главная база | повышение реплики, пауза регистрации файлов | доступность |
| экземпляр API | исключение в nginx, повтор GET на соседе | доступность |
| наплыв запросов | ответ 429 от limit_req, графики из кеша | задержка |
Отказ приёмника не теряет данных: второй приёмник продолжает приём, а оцифровщик хранит данные в буфере на время переключения. Отказ писателя задерживает появление данных в архиве, но не теряет их: они ждут в очереди, пока их не заберёт второй писатель. Заполнение диска является медленным отказом, о котором оповещают заранее, по прогнозу заполнения. Отказ главной базы метаданных приостанавливает регистрацию новых файлов до повышения реплики, а чтение продолжается. Отказ экземпляра API скрывает nginx, повторяя запросы GET на соседнем экземпляре, а наплыв запросов чтения ограничивает limit_req, пока графики отдаются из кеша. Каждая реакция проверяется опытом — нагрузочным тестом, остановкой экземпляра, переполнением очереди, — так же, как в демонстрациях к лекции.
Наблюдаемость и резервная копия
Наблюдаемость замыкает проект. Индикаторами уровня обслуживания служат задержка поступления измерений в архив, длина очереди, доля успешных и доля быстрых чтений, а оповещения срабатывают по расходу бюджета ошибок и по прогнозу заполнения дисков.
Две копии архива защищают от отказа диска и машины, но не от ошибочного удаления или порчи файлов программой: вторая копия повторит ошибку. Поэтому архиву необходима резервная копия на другой площадке с регулярной проверкой восстановления, а требования к ней записывают числами — допустимой потерей данных (RPO, recovery point objective) и временем восстановления (RTO, recovery time objective). Оценим время восстановления годового архива: 126 ТБ по сети 1 Гбит/с передаются за \(126 \cdot 10^{12} \cdot 8 / 10^{9} \approx 1{,}0 \cdot 10^{6}\) с, то есть почти за 12 суток. Если допустимое время восстановления меньше, восстановление планируют по частям — сначала метаданные и данные последних запусков — или закладывают более быстрый канал. Резервные копии базы метаданных и восстановление PostgreSQL на момент времени рассмотрены в разделе «Эксплуатация» главы «Работа с базами данных».
Пройденный порядок универсален: требования, оценки, схема, отказы и наблюдаемость.
Упражнения
- Записать SLO 99,5 % для собственного сервиса и вычислить допустимый простой и число неуспешных запросов за 30 дней.
- Нагрузить свой сервис генератором с расписанием, найти его ёмкость и выяснить, как растёт задержка за её пределом.
- Поставить три экземпляра сервиса за nginx, сравнить round robin с весами и
least_connи остановить один экземпляр сигналом STOP. - Спроектировать архив данных своей установки: оценить поток и объём, нарисовать схему и составить таблицу отказов.
В итоговом проекте курса по той же последовательности удобно описать предполагаемый путь решения в документе первого этапа: требования с числами, оценки нагрузки и объёма данных и схему.
Резюме
Таким образом, проектирование системы начинается с требований, записанных числами: нагрузки в запросах в секунду, перцентиля задержки, цели уровня обслуживания и бюджета ошибок. Масштабирование горизонтально, если сервис не хранит состояние в себе, а алгоритм балансировки выбирают по характеру запросов: round robin — для одинаковых, least connections — для разной длительности, хеш — для привязки. Отказы переживают резервирование с кворумом, проверки работоспособности, согласованные тайм-ауты или передача дедлайна и повторы с бюджетом и случайной паузой; повторяют только идемпотентные операции, а автомат защиты и заглушка дают отказавшей зависимости восстановиться. Реплики, шарды, кеш и очередь решают задачи данных, и каждое решение имеет свою цену: отставание реплики, перенос данных при смене ключа, устаревание кеша, выбор между давлением и сбросом в очереди.
Компонент добавляется тогда, когда расчёт или замер показывает, что без него хуже. Лабораторному сервису обычно достаточно одной программы и одной базы; системный дизайн позволяет заметить момент, когда этого перестаёт хватать, и выбрать следующее решение по числам.
Полезные ссылки
- Site Reliability Engineering и The Site Reliability Workbook, книги Google о практике эксплуатации в свободном доступе [23, 24]: SLO, бюджет ошибок, оповещения, защита от перегрузки;
- документация nginx: ngx_http_upstream_module (балансировка и пассивные проверки), ngx_http_proxy_module (тайм-ауты и повтор на соседнем экземпляре) и ngx_http_limit_req_module (ограничение частоты);
- M. Brooker. Timeouts, retries, and backoff with jitter — статья из Amazon Builders' Library о тайм-аутах, повторах и случайной паузе;
- M. Fowler. CircuitBreaker — заметка об автомате защиты;
- W3C Trace Context — формат заголовка
traceparent.
Наблюдаемость
Служба, которую разработчик запустил и проверил вручную, со временем начинает работать без него: ночью, в выходные, под нагрузкой, которой не было при отладке. Отказ такой службы обнаруживается либо её собственными средствами, либо пользователями — сменой установки, которая не может открыть данные последнего запуска, или скриптом обработки, который всю ночь получал пустые ответы. Разница между этими случаями измеряется часами простоя и потерянными данными.
Термин «наблюдаемость» заимствован из теории управления: в работе Р. Калмана 1960 года система называется наблюдаемой, если её внутреннее состояние можно восстановить по выходным сигналам за конечное время. В эксплуатации программ смысл тот же. Программа является наблюдаемой, если по тому, что она сообщает о себе, — по журналам, метрикам и трассировкам — можно понять, что происходит внутри неё, в том числе в ситуации, которую никто заранее не предусмотрел [52]. Мониторинг в узком смысле отвечает на заранее заданные вопросы: работает ли служба, не заполнен ли диск. Наблюдаемость позволяет задавать новые вопросы к уже собранным данным, не выпуская новую версию программы.
В настоящей главе рассматриваются четыре задачи: запись журналов, сбор метрик, трассировка запросов и оповещение дежурного. Последовательно разобраны журналы, метрики и их хранение в Prometheus, трассировки OpenTelemetry, построение панелей и правила оповещений по целям уровня обслуживания, а в завершение перечисленные приёмы применены к программам физической установки. Глава продолжает раздел «Журналы, метрики и трассировки» главы «Системный дизайн», где введены три вида сигналов, идентификатор запроса и пороги скорости расходования бюджета ошибок, и раздел «Логирование вместо print» главы «От скрипта к приложению». Действия при уже случившемся отказе рассмотрены в следующей главе, «Поиск неисправностей».
Сквозным примером главы служат две программы ускорительного комплекса. Служба вакуумной системы опрашивает контроллер вакуумметров и сообщает давление в секторах, а архив измерений выдаёт данные запусков сотрудникам и их скриптам по HTTP. Листинги главы выполнены под Python 3.11 с prometheus-client 0.26.0 и opentelemetry-sdk 1.45.0, команда jq — в версии 1.7.1. Демонстрации лекции «Наблюдаемость» записаны на виртуальной машине под Ubuntu 24.04 с Python 3.12, Prometheus 3.15 и node_exporter 1.12; на ней выполнены приведённые в главе команды journalctl и promtool и проверены конфигурация и правила Prometheus, а числа со ссылкой на демонстрацию к лекции взяты из этих записей.
Слайды к главе. Составляющие простоя, журналы, метрики, сбор и хранение, трассировки, панели и оповещения изложены также в лекции «Наблюдаемость» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Зачем наблюдать
Слайды к главе. Составляющие простоя, цена надёжности, симптомы и причины и средние времена восстановления изложены также в первой части лекции «Наблюдаемость» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Из чего складывается простой
Время, в течение которого служба не выполняет свою функцию, складывается из нескольких отрезков. Обнаружение длится от начала отказа до первого сигнала о нём — оповещения или сообщения пользователя. Реакция — от сигнала до момента, когда дежурный приступил к работе. Локализация — от начала работы до момента, когда найден отказавший компонент. Восстановление — от найденной причины до возобновления работы. В отрасли эти отрезки обозначают сокращениями MTTD, MTTA и MTTR (среднее время обнаружения, подтверждения и восстановления), причём буква R в разных организациях означает то восстановление работы, то устранение причины. После восстановления наступает холодная фаза: разбор причин и меры, исключающие повторение.
Наблюдаемость сокращает первые три отрезка. Без метрик и оповещений обнаружение определяется тем, когда пользователь заметит отказ и сообщит о нём; без журналов и трассировок локализация превращается в перебор компонентов. Восстановление же зависит в основном от того, как устроены выкатка и откат версий.
Средние значения этих отрезков плохо подходят для оценки работы и её изменений [54]. Распределение длительностей инцидентов сильно скошено вправо и близко к логнормальному: большинство инцидентов короткие, а немногие длятся во много раз дольше. Инцидентов же за квартал обычно единицы или десятки, и среднее определяется одним-двумя долгими случаями. Оценим этот эффект моделированием. Пусть длительности простоев установки распределены логнормально с медианой 27 мин, за квартал случается от 8 до 14 инцидентов, а начиная с пятого квартала процесс улучшен так, что длительность каждого инцидента уменьшается на 20 %. В одной реализации средние по кварталам улучшенного периода составили 33, 45, 51 и 25 мин против 29, 27, 15 и 21 мин до улучшения; среднее седьмого квартала, 51 мин при медиане 11 мин, определил один инцидент длительностью 218 мин. Среди 10 000 повторений опыта в 30 % случаев среднее за кварталы 7–8 оказалось не лучше среднего за кварталы 1–2. Таким образом, при десятке событий в квартал тренд среднего неотличим от случайных колебаний. Тот же недостаток, как показано в отчёте [54], имеют медиана и другие сводные показатели, поэтому инциденты разбирают по отдельности, а для оценки изменения выбирают величину, которую оно затрагивает непосредственно, например время обнаружения, или показатели уровня обслуживания, рассмотренные в разделе об оповещениях.
Надёжность требует затрат. Основной способ её повышения представляет собой резервирование, и каждая дополнительная девятка доступности в десять раз уменьшает допустимый простой: при 99,9 % за сутки допускается \(24 \cdot 3600 \cdot 0{,}001 = 86{,}4\) с, или 1 мин 26 с. Не каждой программе необходимы три девятки. Ночной пересчёт калибровок, отложенный на час, ничего не нарушает, а выдача данных смене во время сеанса требует большего. Цели уровня обслуживания и таблица девяток приведены в разделе «SLI, SLO и SLA» главы «Системный дизайн».
Симптомы и причины
Симптом представляет собой то, что видит пользователь: ошибки, долгие ответы, устаревшие данные. Причина объясняет симптом: переполненный диск, исчерпанная память, отставшая реплика базы. Для смены установки симптом выглядит так: «запуск 42 не открывается в архиве», а причина может состоять в том, что реплика базы метаданных отстала на час. Симптомов немного, и каждый из них означает, что пользователи уже пострадали; причин много, и большая часть из них к симптомам не приводит.
Различают два способа наблюдения [23]. Чёрный ящик проверяет службу снаружи так же, как пользователь: запрашивает страницу и измеряет время ответа. Такая проверка обнаруживает отказ, который уже случился, в том числе отказ сети или балансировщика, невидимый изнутри службы. Белый ящик опирается на сведения, которые служба сообщает о себе: счётчики запросов, длину очередей, время обращения к базе. Он позволяет заметить приближение отказа — рост очереди или заполнение диска — и указывает, в каком компоненте искать причину. Отсюда вытекает правило, принятое в книге Google SRE: дежурного вызывают по симптомам, а причины выводят на панели, которые дежурный просматривает, когда симптом уже обнаружен; исключение составляют несомненные и неминуемые причины, например почти заполненный диск [23].
Журналы
Слайды к главе. Структурированная запись, уровни и порог, контекст запроса, журнал systemd и цена хранения изложены также во второй части лекции «Наблюдаемость» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Журнал представляет собой последовательность записей о событиях: служба запущена, вакуумметр не ответил, запрос завершился ошибкой. Каждая запись относится к моменту времени и содержит уровень важности, источник и сообщение. Журнал отвечает на вопрос, что произошло с конкретным запросом или циклом работы, и служит основным материалом расследования. Основы модуля logging — логгер на модуль, уровни, вывод в консоль и файл — изложены в разделе «Логирование вместо print» главы «От скрипта к приложению»; здесь рассматривается журнал службы, который читают не только люди, но и программы.
Структурированная запись
Строка вида WARNING vacuum: VG04 6.2e-06 Pa above threshold удобна человеку, но программа извлекает из неё давление и имя датчика регулярным выражением, которое перестаёт работать при первом изменении формулировки, а многострочная трассировка стека в таком журнале распадается на отдельные записи. Структурированный журнал записывает каждое событие одной строкой JSON с постоянным набором полей: время, уровень, сообщение и поля самого события. Отбор записей по полям выполняется без разбора текста — утилитой jq или системами хранения журналов Loki и Elasticsearch.
import contextvars
import json
import logging
import sys
cycle = contextvars.ContextVar("cycle", default=0) # номер цикла опроса
class JsonFormatter(logging.Formatter):
def format(self, record):
doc = {"t": self.formatTime(record, "%H:%M:%S"), "lvl": record.levelname,
"cyc": cycle.get(), **getattr(record, "fields", {}), "msg": record.getMessage()}
return json.dumps(doc, ensure_ascii=False, separators=(",", ":"))
handler = logging.StreamHandler(sys.stdout)
handler.setFormatter(JsonFormatter())
log = logging.getLogger("vacuum")
log.addHandler(handler)
log.setLevel(logging.INFO)
cycle.set(3)
log.info("норма", extra={"fields": {"vg": "VG01", "p": 2.0e-07}})
log.warning("выше порога", extra={"fields": {"vg": "VG04", "p": 6.2e-06}})
log.debug("коды АЦП", extra={"fields": {"vg": "VG04", "adc": [2045, 2046]}})
{"t":"14:27:38","lvl":"INFO","cyc":3,"vg":"VG01","p":2e-07,"msg":"норма"}
{"t":"14:27:38","lvl":"WARNING","cyc":3,"vg":"VG04","p":6.2e-06,"msg":"выше порога"}
Форматтер собирает словарь из полей записи и сериализует его функцией json.dumps: параметр ensure_ascii=False сохраняет кириллицу читаемой, а separators убирает лишние пробелы. Поля события передаются аргументом extra — модуль logging превращает ключи этого словаря в атрибуты записи, и форматтер читает атрибут fields. Номер цикла опроса берётся из контекстной переменной, о которой сказано ниже. Отладочная запись при пороге INFO не выводится. Если вывод службы сохранён в файл vacuum.json, записи выше уровня INFO с нужными полями отбирает одна команда:
jq -c 'select(.lvl != "INFO") | {t, vg, p, msg}' vacuum.json
{"t":"14:27:38","vg":"VG04","p":0.0000062,"msg":"выше порога"}
Утилита jq выводит то же число в десятичной записи. Состав полей согласуют для всех служб системы: одинаковые имена времени, уровня и идентификатора запроса позволяют объединить журналы нескольких программ в один поток и отбирать записи одним выражением. Трассировку стека при исключении записывают в одно поле: стандартный форматтер получает её текст методом formatException, а форматтер JSON помещает этот текст в отдельный ключ, и запись остаётся одной строкой.
Уровни и порог
Модуль logging определяет пять уровней: DEBUG (10), INFO (20), WARNING (30), ERROR (40) и CRITICAL (50). Порог, заданный логгеру или обработчику, отсекает записи с уровнем ниже порога. Вызов log.debug() при пороге INFO завершается сразу после сравнения уровней: запись не создаётся, а сообщение не форматируется, если аргументы переданы отдельно (log.debug("коды %s", adc)), а не подставлены заранее в f-строку. Сами аргументы при этом вычисляются до вызова, поэтому дорогое вычисление, требуемое только для отладочной записи, выполняют под проверкой log.isEnabledFor(logging.DEBUG). Отладочные вызовы, таким образом, остаются в коде службы, а их сообщения выводятся, только когда порог понижен до DEBUG.
Для службы обычно выбирают порог INFO. Отладочный порог необходим во время расследования, и включать его требуется без перезапуска: перезапуск сбрасывает именно то состояние, в котором проявляется неисправность, — заполненную очередь, зависшее соединение с прибором. Распространённый способ состоит в обработчике сигнала, который переключает порог работающего процесса:
import logging
import os
import signal
import sys
logging.basicConfig(stream=sys.stdout, level=logging.INFO, format="%(levelname)-7s %(message)s")
log = logging.getLogger("vacuum")
pending = [] # отметки обработчика сигнала
def on_usr1(signum, frame):
"""Меняет порог и оставляет отметку; запись в журнал — уже в основном цикле."""
root = logging.getLogger()
root.setLevel(logging.DEBUG if root.level == logging.INFO else logging.INFO)
pending.append(signum)
signal.signal(signal.SIGUSR1, on_usr1)
for c in range(1, 5):
if c == 3:
os.kill(os.getpid(), signal.SIGUSR1) # в работе сигнал посылает администратор: kill -USR1 PID
while pending:
pending.pop()
log.warning("порог журнала: %s", logging.getLevelName(logging.getLogger().level))
log.debug("цикл %d: коды АЦП %s", c, [2040 + c, 2051 - c])
log.info("цикл %d: давление в норме", c)
INFO цикл 1: давление в норме
INFO цикл 2: давление в норме
WARNING порог журнала: DEBUG
DEBUG цикл 3: коды АЦП [2043, 2048]
INFO цикл 3: давление в норме
DEBUG цикл 4: коды АЦП [2044, 2047]
INFO цикл 4: давление в норме
Обработчик сигнала только меняет порог и оставляет отметку, а сообщение о смене порога записывает основной цикл. Python выполняет обработчик в главном потоке между инструкциями байт-кода, и запись из обработчика может прервать незавершённую запись в тот же поток вывода; документация модуля logging прямо предупреждает, что из асинхронных обработчиков сигналов журнал может быть недоступен. В работающей системе сигнал посылают командой kill -USR1 с идентификатором процесса, а службе systemd — командой systemctl kill -s USR1 с именем службы. Повторный сигнал возвращает порог INFO.
Объём записей ограничивают и другими средствами: трассировку стека повторяющейся ошибки выводят один раз за интервал с числом повторений, а частое однотипное событие заменяют счётчиком — метрикой, рассмотренной в следующем разделе.
Контекст запроса
Отдельная запись редко объясняет отказ; объясняет его цепочка записей одного запроса или цикла, проходящая через несколько функций, потоков и служб. Цепочку связывает идентификатор, присутствующий во всех её записях: номер цикла опроса, идентификатор запроса, назначенный nginx на входе в систему (раздел «Журналы, метрики и трассировки» главы «Системный дизайн»), или идентификатор трассы OpenTelemetry, рассмотренный ниже.
Передавать идентификатор аргументом через все функции неудобно. Модуль contextvars позволяет хранить его в контекстной переменной: значение, установленное методом set, видно всему коду текущего контекста, а форматтер читает его методом get, как в листинге выше. Задачи asyncio получают копию контекста в момент создания, поэтому идентификаторы параллельно обрабатываемых запросов не смешиваются; функция asyncio.to_thread переносит контекст в рабочий поток сама. Новый поток, созданный модулем threading, в обычной сборке Python начинает работу с пустым контекстом, и значение необходимо передавать явно: функция contextvars.copy_context() возвращает копию текущего контекста, а её метод run выполняет в ней функцию потока. Начиная с Python 3.14 ту же копию можно передать параметром context конструктора threading.Thread.
Журнал службы systemd
Программе не требуется самой управлять файлами журнала: ей достаточно писать записи в стандартный вывод. Методология The Twelve-Factor App рассматривает журнал как поток событий: приложение выводит его, а сбор, хранение и ротацию обеспечивает среда выполнения. Для службы systemd такой средой является journald: стандартный вывод и поток ошибок службы по умолчанию попадают в системный журнал, где каждая запись получает поля _PID, _SYSTEMD_UNIT, PRIORITY и другие. Уровень записи journald определяет по префиксу <N> в начале строки (параметр SyslogLevelPrefix, по умолчанию включён): 3 означает ошибку, 4 — предупреждение, 6 — информационное сообщение, 7 — отладку. Префикс удаляется из текста сообщения и сохраняется в поле PRIORITY.
import logging
import sys
SYSLOG = {logging.DEBUG: 7, logging.INFO: 6, logging.WARNING: 4, logging.ERROR: 3, logging.CRITICAL: 2}
class PrefixFormatter(logging.Formatter):
"""Префикс <N> в начале строки journald читает как уровень syslog и убирает из сообщения."""
def format(self, record):
return f"<{SYSLOG[record.levelno]}>{super().format(record)}"
handler = logging.StreamHandler(sys.stdout)
handler.setFormatter(PrefixFormatter("%(name)s: %(message)s"))
log = logging.getLogger("vacuum")
log.addHandler(handler)
log.setLevel(logging.INFO)
log.info("цикл %d завершён", 1)
log.error("цикл %d: %s не отвечает", 2, "VG06")
log.warning("цикл %d: %s давление %.1e Па выше порога", 4, "VG04", 7.5e-06)
<6>vacuum: цикл 1 завершён
<3>vacuum: цикл 2: VG06 не отвечает
<4>vacuum: цикл 4: VG04 давление 7.5e-06 Па выше порога
Записи службы затем отбирают средствами journalctl по полям, а не по тексту: ключ -p warning оставляет уровни от emerg до warning, а вывод в формате JSON передаёт поля записи программе. В демонстрации к лекции сценарий journal_svc.py с тем же форматтером запущен как временная служба systemd; кроме приведённых строк он сообщает о завершении каждого из шести циклов. После завершения службы команды отбора дали следующий вывод:
systemd-run -q -u l19-vacuum --collect python3 $PWD/journal_svc.py
journalctl -u l19-vacuum -p warning -S -1min -o cat
journalctl -u l19-vacuum -p 4 -S -1min -o json | jq -r .PRIORITY
vacuum: цикл 2: VG06 не отвечает
vacuum: цикл 4: VG04 давление 7.5e-06 Па выше порога
3
4
В выводе нет ни префиксов, ни записей уровня INFO: journald убрал префиксы из текста и сохранил уровни в поле PRIORITY, по которому ключ -p отбирает записи, — в виде имени уровня (warning) или его номера (4). Ключ -S -1min ограничивает вывод записями за последнюю минуту.
Контейнер Docker аналогично передаёт стандартный вывод драйверу журналов — по умолчанию json-file, который без параметров max-size и max-file журнал не ротирует, — а в Kubernetes среда выполнения записывает вывод контейнеров в файлы на узле, откуда их обычно забирает агент, запущенный на каждом узле. Во всех случаях программа пишет в стандартный вывод, а куда попадёт запись, решает среда.
Объём и срок хранения
У службы без собственных данных журнал обычно является главным потребителем дискового пространства, и его объём оценивают заранее как произведение числа записей в сутки, среднего размера записи и срока хранения. Оценим три политики записи для службы сбора данных с 200 каналами, оцифровываемыми с частотой 10 Гц. Средняя запись JSON того же вида, что в листинге выше, занимает 85 байт и сжимается gzip в 12,2 раза:
| Политика записи | Записей в сутки | В сутки | За год | За год со сжатием |
|---|---|---|---|---|
| каждый отсчёт канала | \(1{,}73 \cdot 10^{8}\) | 14,6 ГБ | 5,3 ТБ | 438,9 ГБ |
| каждый цикл опроса раз в секунду | 86 400 | 7,3 МБ | 2,7 ГБ | 219,4 МБ |
| только изменения состояния | около 1000 | 84,7 кБ | 30,9 МБ | 2,5 МБ |
Таким образом, отсчёты каналов являются данными и хранятся в архиве измерений, а журнал предназначен для событий. Срок хранения и ротацию задаёт среда: journald ограничивает объём журнала параметром SystemMaxUse (по умолчанию 10 % файловой системы, но не более 4 ГиБ), для файлов журнала применяют logrotate, а записи старше нескольких недель хранят сжатыми или удаляют. Сам конвейер доставки журналов тоже может отказать незаметно, поэтому за ним наблюдают метрикой — числом принятых записей в минуту: падение этого числа до нуля означает отказ доставки, а не исчезновение событий.
Метрики
Слайды к главе. Модель данных Prometheus, типы метрик, экспортёр, метки и кардинальность, гистограммы и оценка квантилей изложены также в третьей части лекции «Наблюдаемость» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Метрика представляет собой число, которое служба сообщает о себе и которое наблюдается во времени: число обработанных запросов, длительность ответа, давление в секторе, заполнение диска. В отличие от журнала, метрика не описывает отдельные события, а сводит их в число, поэтому объём её хранения почти не зависит от нагрузки: счётчик запросов занимает одинаковое место при десяти и при десяти тысячах запросов в секунду. По метрикам строят графики и оповещения. Фактическим стандартом для метрик служб стала модель Prometheus [51]; её текстовый формат экспозиции, на основе которого создана спецификация OpenMetrics, читают и другие системы, например VictoriaMetrics и OpenTelemetry Collector.
Модель данных и формат
Временной ряд в Prometheus определяется именем метрики и набором меток — пар «имя — значение»; отсчёт ряда состоит из метки времени с точностью до миллисекунды и числа с плавающей точкой двойной точности. Ряды vacuum_pressure_pascals{sector="ring",gauge="VG02"} и vacuum_pressure_pascals{sector="linac",gauge="VG01"} относятся к одной метрике, но хранятся отдельно. Prometheus сам опрашивает службы: раз в заданный интервал он запрашивает у каждой цели адрес /metrics и получает текст в формате экспозиции. Строки # HELP и # TYPE описывают метрику и её тип, а каждая следующая строка содержит имя, метки в фигурных скобках и значение.
Значения выражают в базовых единицах, перечисленных в руководстве Prometheus по именованию метрик: в секундах, а не миллисекундах, в байтах, а не мегабайтах, в метрах, вольтах и амперах, а температуру — в градусах Цельсия. Давления в этом перечне нет, и по тому же правилу его выражают в паскалях. Единицу указывают суффиксом имени во множественном числе (_seconds, _bytes, _pascals), а имя накопительного счётчика оканчивается на _total. Базовые единицы позволяют складывать и делить метрики разных служб без пересчёта, а суффикс сообщает единицу каждому, кто читает выражение в файле правил или подпись графика, и исключает совпадение имён метрик, выраженных в разных единицах.
Типы метрик
Библиотеки инструментирования Prometheus предлагают четыре основных типа метрик. Сам сервер хранит все типы, кроме нативных гистограмм, о которых сказано ниже, как обычные ряды чисел, а тип определяет прежде всего то, какими функциями метрику обрабатывают в запросах.
| Тип | Поведение | Пример | Типичная обработка |
|---|---|---|---|
| counter (счётчик) | только растёт, обнуляется при перезапуске | запросы, ошибки, срабатывания триггера | rate, increase |
| gauge (мгновенное значение) | растёт и убывает | давление, длина очереди, память | значение, max_over_time |
| histogram (гистограмма) | счётчики попаданий в корзины | длительность запроса | histogram_quantile |
| summary (сводка) | квантили, вычисленные службой | длительность запроса | только по одному экземпляру |
События считают счётчиком, а не мгновенным значением. Рассмотрим модель системы сбора данных: триггер срабатывает 50 раз в секунду, на 70-й секунде происходит вспышка 400 срабатываний в секунду длительностью 3 с, на 90-й секунде служба перезапускается, а Prometheus опрашивает её раз в 15 с.
def increase(samples):
"""Приращение счётчика по отсчётам опроса: уменьшение значения означает перезапуск."""
return sum(cur - prev if cur >= prev else cur for prev, cur in zip(samples, samples[1:]))
rate = [400 if 70 <= t < 73 else 50 for t in range(120)] # срабатываний триггера за секунду t
counter, total = [], 0
for t, n in enumerate(rate):
if t == 90:
total = 0 # служба перезапущена
total += n
counter.append(total)
scrapes = range(14, 120, 15) # опрос раз в 15 с
samples = [counter[t] for t in scrapes]
print("отсчёты счётчика:", samples)
print("последний минус первый:", samples[-1] - samples[0])
print("с учётом сброса:", increase(samples), " на самом деле:", sum(rate[15:120]))
print("мгновенное значение в опросах:", {rate[t] for t in scrapes}, " максимум:", max(rate))
отсчёты счётчика: [750, 1500, 2250, 3000, 4800, 5550, 750, 1500]
последний минус первый: 750
с учётом сброса: 6300 на самом деле: 6300
мгновенное значение в опросах: {50} максимум: 400
Разность последнего и первого отсчётов показывает 750 срабатываний вместо 6300: перезапуск обнулил счётчик. Функция increase учитывает сброс: уменьшение значения означает, что счётчик начат заново, и новое значение целиком является приращением. Так же поступают функции rate и increase языка запросов PromQL; кроме того, они экстраполируют приращение до границ окна, поэтому их результат бывает дробным. События между последним опросом и перезапуском при этом теряются, но в модели перезапуск происходит сразу после опроса. Мгновенное значение «срабатываний за последнюю секунду» в моменты опроса всегда равно 50, и вспышка между опросами не видна, тогда как счётчик учитывает каждое событие независимо от того, когда его прочитали. Обратная ошибка состоит в счётчике для убывающей величины: если число занятых соединений оформить счётчиком, функция rate воспримет каждое его уменьшение как перезапуск.
Гистограмма и сводка описывают распределение величины, чаще всего длительности запросов. Гистограмма хранит счётчики попаданий в корзины, и квантиль по ним вычисляет Prometheus; сводка вычисляет квантили в самой службе. Различие существенно при нескольких экземплярах службы и рассмотрено ниже, в разделе о квантилях.
Экспортёр
Служба на Python выставляет метрики библиотекой prometheus_client. Для собственного кода достаточно прямого инструментирования: объекты Counter, Gauge и Histogram изменяются в местах событий, например REQS.labels(code="200").inc(), а библиотека отдаёт их текущие значения. Если же метрики берутся из другой системы — контроллера, прибора, внешнего API, — пишут экспортёр: программу, которая при каждом обращении Prometheus опрашивает источник и переводит ответ в формат экспозиции. Руководство Prometheus по написанию экспортёров предписывает синхронный опрос: экспортёр не запускает собственных таймеров, а читает источник в момент запроса /metrics и при каждом запросе создаёт метрики заново, а не обновляет глобальные объекты прямого инструментирования. Тогда возраст данных совпадает с моментом опроса, а отказ источника виден сразу; кроме того, два одновременных опроса не мешают друг другу, а ряд исчезнувшего датчика не остаётся в ответе. В prometheus_client синхронный опрос реализуется собственным коллектором — классом с методом collect, который возвращает семейства метрик.
import random
import urllib.request
from prometheus_client import CollectorRegistry, start_http_server
from prometheus_client.core import CounterMetricFamily, GaugeMetricFamily
GAUGES = {"VG01": "linac", "VG02": "ring", "VG03": "ring"}
rng = random.Random(19)
def read_gauge(name):
"""Модель контроллера; в службе здесь запрос к прибору или к EPICS с тайм-аутом."""
if name == "VG03" and rng.random() < 0.5:
raise TimeoutError(name)
return float(f"{rng.lognormvariate(-15.4, 0.3):.3e}")
class VacuumCollector:
def __init__(self):
self.errors = dict.fromkeys(GAUGES, 0)
def collect(self): # вызывается при каждом запросе /metrics
p = GaugeMetricFamily("vacuum_pressure_pascals", "Давление", labels=["sector", "gauge"])
for gauge, sector in GAUGES.items():
try:
p.add_metric([sector, gauge], read_gauge(gauge))
except TimeoutError:
self.errors[gauge] += 1
yield GaugeMetricFamily("vacuum_up", "Контроллер ответил", value=1 if p.samples else 0)
yield p
err = CounterMetricFamily("vacuum_gauge_errors", "Неудачные чтения", labels=["gauge"])
for gauge, n in self.errors.items():
err.add_metric([gauge], n)
yield err
registry = CollectorRegistry()
registry.register(VacuumCollector())
server, _ = start_http_server(9101, addr="127.0.0.1", registry=registry)
text = urllib.request.urlopen("http://127.0.0.1:9101/metrics", timeout=5).read().decode()
print("\n".join(line for line in text.splitlines() if line.startswith(("# TYPE", "vacuum"))))
server.shutdown()
# TYPE vacuum_up gauge
vacuum_up 1.0
# TYPE vacuum_pressure_pascals gauge
vacuum_pressure_pascals{gauge="VG01",sector="linac"} 3.133e-07
vacuum_pressure_pascals{gauge="VG02",sector="ring"} 2.095e-07
# TYPE vacuum_gauge_errors_total counter
vacuum_gauge_errors_total{gauge="VG01"} 0.0
vacuum_gauge_errors_total{gauge="VG02"} 0.0
vacuum_gauge_errors_total{gauge="VG03"} 1.0
Коллектор регистрируется в собственном реестре, и функция start_http_server запускает в отдельном потоке HTTP-сервер, который при каждом запросе вызывает метод collect. Вакуумметр VG03 в этом опросе не ответил: ряда давления для него нет, а счётчик неудачных чтений увеличился. Отсутствие ряда точнее отражает состояние, чем нуль или последнее известное значение: нулевое давление выглядело бы как идеальный вакуум, а повтор старого значения скрыл бы отказ датчика. Метрика vacuum_up сообщает, ответил ли контроллер хотя бы по одному датчику. Руководство описывает два способа сообщить о неудачном опросе источника: ответ /metrics с кодом ошибки 5xx и метрику вида <экспортёр>_up со значением 0 или 1; второй способ удобнее, когда часть метрик доступна и при отказе источника, как счётчики ошибок в листинге. Суффикс _total библиотека добавила к имени счётчика сама.
Из того же принципа вытекают и остальные требования к экспортёру. Обращение к источнику необходимо ограничивать тайм-аутом, меньшим тайм-аута опроса Prometheus (по умолчанию 10 с), иначе при зависшем приборе каждый опрос завершается отказом цели. Длительность опроса источника выставляют отдельной метрикой, например vacuum_scrape_duration_seconds. Руководство по инструментированию добавляет правило о моментах времени: момент события выставляют значением в секундах времени Unix, а не временем, прошедшим с события, — время старта процесса, а не время работы, и время последней успешной калибровки, а не её возраст. Прошедшее время Prometheus вычисляет сам выражением time() - metric, а метрика не требует обновления.
Метки и кардинальность
Каждая комбинация значений меток образует отдельный временной ряд, который Prometheus хранит в памяти и на диске, и число таких комбинаций называют кардинальностью метрики. Метки с ограниченным набором значений — метод HTTP, шаблон маршрута, код ответа, сектор — безопасны. Метка с неограниченным набором значений — путь запроса с номером запуска, адрес клиента, имя пользователя — создаёт новый ряд для каждого нового значения. Демонстрация к лекции показывает масштаб на модели из 20 000 запросов к архиву: счётчик с метками метода, шаблона маршрута и кода ответа даёт 9 рядов и ответ /metrics размером 2 КиБ, а тот же счётчик с полным путём вместо шаблона маршрута — 11 945 рядов и 2051 КиБ. Документация Prometheus рекомендует держать кардинальность метрик ниже 10, а метрик с большей кардинальностью иметь во всей системе лишь несколько; метрику, кардинальность которой превышает 100 или может её превысить, предлагается перепроектировать — сократить число измерений или перенести анализ из мониторинга в систему обработки данных общего назначения. Номер запуска, таким образом, является полем записи журнала или атрибутом трассы, а не меткой метрики.
Гистограммы и квантили
Задержку описывают перцентилями (раздел «Нагрузка и задержка» главы «Системный дизайн»), но служба не может хранить длительность каждого запроса. Гистограмма Prometheus хранит счётчики попаданий в корзины с заданными верхними границами le: ряд _bucket{le="0.3"} содержит число запросов длительностью не более 0,3 с, ряд _bucket{le="+Inf"} — число всех запросов; дополнительно хранятся сумма длительностей _sum и их число _count. Корзины накопительные: каждая включает все меньшие. Функция histogram_quantile находит корзину, в которую попадает искомый ранг, и интерполирует внутри неё линейно, предполагая равномерное распределение наблюдений по корзине. Ошибка оценки поэтому ограничена шириной корзины, а при попадании ранга в корзину +Inf функция возвращает верхнюю границу последней конечной корзины. Следующий листинг повторяет этот расчёт и сравнивает корзины prometheus_client по умолчанию с корзинами, сгущёнными около цели 300 мс.
import bisect
import random
import statistics
DEFAULT = [.005, .01, .025, .05, .075, .1, .25, .5, .75, 1.0, 2.5, 5.0, 7.5, 10.0]
NEAR_SLO = [.01, .02, .03, .05, .1, .2, .25, .3, .35, .4, .6, 1.0]
def sample(n, cold, seed):
"""Задержки выдачи запуска, с: доля cold читает холодный файл."""
rng = random.Random(seed)
return [rng.gauss(0.31, 0.05) if rng.random() < cold else rng.gauss(0.020, 0.003) for _ in range(n)]
def buckets(xs, bounds):
"""Накопительные счётчики корзин le, как ряды _bucket; последняя корзина +Inf."""
xs = sorted(xs)
return [bisect.bisect_right(xs, b) for b in bounds] + [len(xs)]
def histogram_quantile(q, bounds, counts):
"""Корзина, в которую попал ранг, и линейная интерполяция внутри неё."""
rank = q * counts[-1]
i = bisect.bisect_left(counts, rank)
if i == len(bounds): # ранг в корзине +Inf
return bounds[-1]
lo, below = (0.0, 0) if i == 0 else (bounds[i - 1], counts[i - 1])
return lo + (bounds[i] - lo) * (rank - below) / (counts[i] - below)
def p99(xs, bounds=None):
if bounds is None:
return 1000 * statistics.quantiles(xs, n=100, method="inclusive")[98]
return 1000 * histogram_quantile(0.99, bounds, buckets(xs, bounds))
xs = sample(20_000, 0.05, 1)
print(f"p99 точно {p99(xs):.0f} мс, по корзинам по умолчанию {p99(xs, DEFAULT):.0f} мс, "
f"с границей 300 мс {p99(xs, NEAR_SLO):.0f} мс")
a, b = sample(18_000, 0.01, 2), sample(2_000, 0.30, 3) # два экземпляра службы
merged = [i + j for i, j in zip(buckets(a, NEAR_SLO), buckets(b, NEAR_SLO))]
print(f"p99 экземпляров {p99(a, NEAR_SLO):.0f} и {p99(b, NEAR_SLO):.0f} мс, "
f"среднее {(p99(a, NEAR_SLO) + p99(b, NEAR_SLO)) / 2:.0f} мс")
print(f"p99 по сумме гистограмм {1000 * histogram_quantile(0.99, NEAR_SLO, merged):.0f} мс, "
f"точно {p99(a + b):.0f} мс")
p99 точно 354 мс, по корзинам по умолчанию 447 мс, с границей 300 мс 356 мс
p99 экземпляров 48 и 410 мс, среднее 229 мс
p99 по сумме гистограмм 342 мс, точно 340 мс
Модель описывает выдачу запусков архивом: 95 % запросов обслуживаются около 20 мс, а 5 % читают холодный файл около 310 мс. Точный p99 равен 354 мс. Корзины по умолчанию дают оценку 447 мс: соседние границы 0,25 и 0,5 с охватывают почти весь хвост распределения, и интерполяция внутри широкой корзины завышает p99 на 93 мс. Корзины, сгущённые около цели уровня обслуживания, дают 356 мс. Граница корзины на пороге цели позволяет, кроме того, вычислить долю запросов быстрее 300 мс без интерполяции — как отношение счётчика _bucket{le="0.3"} к _count; в демонстрации к лекции эта доля совпала с точной (96,92 %), а корзины по умолчанию дали 96,23 %. Таким образом, границы корзин выбирают по целям уровня обслуживания, а не оставляют по умолчанию.
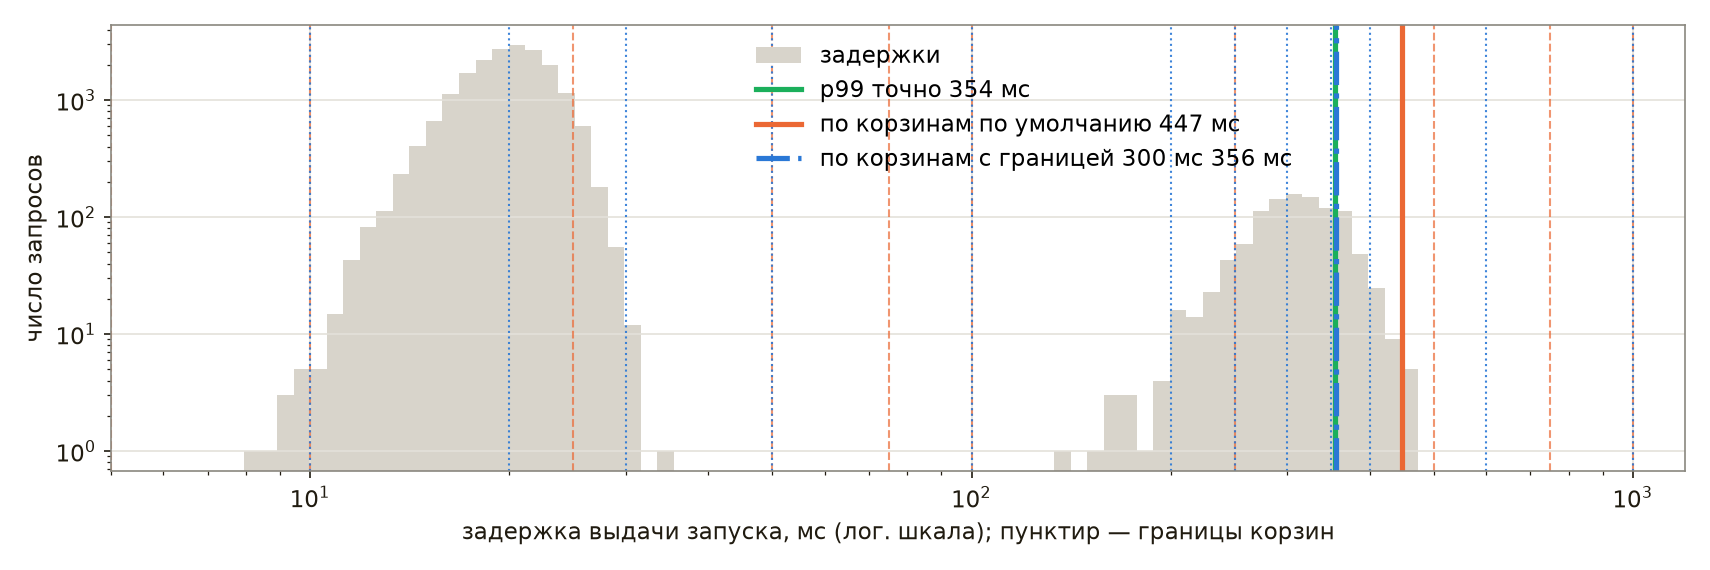
Вторая часть листинга моделирует два экземпляра службы: нагруженный, получивший 18 000 запросов с 1 % холодных чтений, и малонагруженный, получивший 2000 запросов, из которых 30 % холодные. Их p99 равны 48 и 410 мс, и среднее этих значений, 229 мс, не имеет отношения к p99 всех запросов, равному 340 мс. Счётчики корзин, напротив, складываются, и квантиль по сумме гистограмм, 342 мс, близок к точному. В PromQL ему соответствует выражение histogram_quantile(0.99, sum by (le) (rate(archive_request_duration_seconds_bucket[5m]))). Сводка вычисляет квантили внутри каждого экземпляра, и объединить их корректно нельзя, поэтому для служб с несколькими экземплярами выбирают гистограмму.
Рассмотренные гистограммы называют классическими. Prometheus поддерживает также нативные гистограммы: их корзины задаются экспоненциальной схемой, не требуют выбора границ при инструментировании и всегда совместимы при сложении. Документация рекомендует нативные гистограммы там, где их поддерживает библиотека инструментирования, — на момент написания главы это библиотеки для Go и Java. Класс Histogram библиотеки prometheus_client 0.26 выставляет классические гистограммы, и для служб на Python выбор границ корзин остаётся задачей разработчика.
Сбор и хранение
Слайды к главе. Опрос и отправка метрик, Prometheus, язык запросов PromQL и метрики заданий без постоянного процесса изложены также в четвёртой части лекции «Наблюдаемость» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Опрос и отправка
Метрики доставляются в хранилище двумя способами. При опросе (pull) хранилище само обращается к службам по списку целей. Список задают в конфигурации или получают из реестра — Kubernetes, Consul, файла, который обновляет другая программа. Неудачный опрос сам является сигналом: Prometheus записывает для каждой цели ряд up со значением 1 после успешного опроса и 0 после неудачного, а также длительность опроса и число полученных отсчётов. Частоту опроса, а с ней и нагрузку на службы задаёт хранилище; объём же каждого ответа определяет служба, и метрика с неограниченными метками перегружает Prometheus и при опросе. Для защиты в задании опроса задают предел числа отсчётов sample_limit: при его превышении опрос целиком считается неудачным. При отправке (push) службы или агенты на машинах сами передают данные хранилищу, как это делают Telegraf с InfluxDB или агенты OpenTelemetry по протоколу OTLP. Отправка подходит для короткоживущих процессов и для сетей, в которых хранилище не может обратиться к службам, например из-за трансляции адресов; зато отсутствие данных в этом случае не отличается от отсутствия событий без отдельной проверки.
Между источником и хранилищем данные передают напрямую или через шину сообщений, например Kafka. Прямая запись проще, но при недоступности хранилища данные теряются или накапливаются в памяти агента. Шина хранит данные, пока хранилище недоступно, и позволяет нескольким потребителям читать один поток, но добавляет компонент, который сам нуждается в наблюдении, и задержку доставки. На том же пути обычно обогащают данные метками (имя машины, площадка) и отбрасывают лишнее, пока его объём не попал в хранилище.
Prometheus и PromQL
Конфигурация Prometheus перечисляет интервалы опроса и вычисления правил, файлы правил и задания опроса с целями. Конфигурация демонстраций к лекции опрашивает четыре цели на одной машине раз в 5 с:
# Prometheus стенда лекции «Наблюдаемость»: все цели на 127.0.0.1, опрос раз в 5 с.
global:
scrape_interval: 5s
evaluation_interval: 5s
rule_files:
- rules.yml
scrape_configs:
- job_name: prometheus
static_configs:
- targets: ["127.0.0.1:9090"]
- job_name: node
static_configs:
- targets: ["127.0.0.1:9100"]
- job_name: vacuum
static_configs:
- targets: ["127.0.0.1:9101"]
- job_name: archive
static_configs:
- targets: ["127.0.0.1:8403"]
В записи демонстрации команда promtool check config prometheus.yml подтвердила корректность конфигурации вместе с подключённым файлом правил, а вскоре после запуска Prometheus все четыре цели находились в состоянии up.
Опрошенные ряды Prometheus записывает в локальную базу временных рядов: свежие отсчёты хранит в памяти и в журнале упреждающей записи, а каждые два часа сбрасывает их на диск сжатым блоком, который затем объединяется с соседними. По умолчанию данные хранятся 15 суток, а сжатый отсчёт занимает в среднем 1–2 байта. Оценим объём для установки, службы которой выставляют 10 000 рядов при опросе раз в 15 с. За сутки каждый ряд получает \(24 \cdot 3600 / 15 = 5760\) отсчётов, все ряды — \(5{,}76 \cdot 10^{7}\), что при 1,5 байта на отсчёт составляет около 86 МБ в сутки и 1,3 ГБ за 15 суток. Для хранения в течение лет Prometheus передаёт данные во внешнее хранилище (параметр remote_write), например VictoriaMetrics или Thanos.
Данные читают языком запросов PromQL. Ряды выбирают по имени и меткам селектором, например archive_requests_total{code=~"5.."}; диапазон [5m] превращает каждый ряд в набор отсчётов за пять минут, а функции и операторы агрегации сводят эти наборы в числа. Ниже приведены выражения, которые встречаются в любой системе наблюдения; строки, начинающиеся знаком #, PromQL считает комментариями.
# цели, не ответившие на последний опрос
up == 0
# запросов в секунду по кодам ответа
sum by (code) (rate(archive_requests_total[5m]))
# доля ответов с ошибкой сервера
sum(rate(archive_requests_total{code=~"5.."}[5m])) / sum(rate(archive_requests_total[5m]))
# p99 длительности по всем экземплярам
histogram_quantile(0.99, sum by (le) (rate(archive_request_duration_seconds_bucket[5m])))
# наибольшее давление за 10 минут
max_over_time(vacuum_pressure_pascals[10m])
# разделы, которые при текущем темпе заполнятся в ближайшие 4 часа
predict_linear(node_filesystem_avail_bytes[6h], 4 * 3600) < 0
# время с последней успешной калибровки, с
time() - calib_last_success_timestamp_seconds
Функция rate вычисляет среднюю скорость роста счётчика в секунду за окно с поправкой на сбросы; окно выбирают длительностью не менее нескольких интервалов опроса, чтобы в него попадало несколько отсчётов. Оператор sum by сворачивает ряды по выбранным меткам: доля ошибок архива имеет смысл по службе в целом, а не по отдельному экземпляру. Функция predict_linear строит линейную регрессию по отсчётам окна и продолжает её на заданное время вперёд. Для графиков, где важны пики, применяют max_over_time, а не усреднение: среднее за окно сглаживает короткий выброс, что рассмотрено в разделе о панелях.
В демонстрации к лекции Prometheus опрашивал модель службы архива, обслуживающую 40 запросов в секунду, и запрос частоты по кодам ответа через минуту после запуска вернул следующий результат:
promtool query instant http://127.0.0.1:9090 'sum by (code) (rate(archive_requests_total[1m]))'
{code="200"} => 39.199999999999996 @[1791101791.773]
{code="500"} => 0.7999999999999999 @[1791101791.773]
Для каждого ряда выведены значение и момент вычисления в секундах времени Unix, а последние знаки значений представляют собой погрешность вычислений с плавающей точкой. Ошибкой завершаются 2 % запросов модели, а p99 по гистограмме, вычисленный выражением из этого списка с окном 1 мин, равен 0,46 с. Выражение max by (gauge) (vacuum_pressure_pascals) в той же демонстрации вернуло два ряда давления из трёх: вакуумметр VG03 в последнем опросе не ответил, и его ряда в этот момент нет.
Задания без постоянного процесса
Ночная калибровка датчиков положения пучка или расчёт на кластере работают минуты и завершаются, и их итог — успех и время завершения — исчезает вместе с процессом раньше, чем Prometheus успевает его опросить. Итог такого задания записывают в файл формата экспозиции в каталог, который читает node_exporter — экспортёр Prometheus, выставляющий метрики машины (каталог задаёт параметр --collector.textfile.directory). Файл необходимо писать во временный и затем переименовывать, иначе экспортёр может прочитать его наполовину; функция write_to_textfile библиотеки prometheus_client делает это сама.
import os
import tempfile
from prometheus_client import CollectorRegistry, Gauge, write_to_textfile
registry = CollectorRegistry()
last = Gauge("calib_last_success_timestamp_seconds", "Последняя успешная калибровка BPM", registry=registry)
channels = Gauge("calib_channels", "Число откалиброванных каналов BPM", registry=registry)
channels.set(40) # здесь выполняется калибровка
last.set(1_791_000_000) # 03.10.2026 04:00 UTC; в задании — last.set_to_current_time()
textfile_dir = tempfile.mkdtemp() # в работе — каталог --collector.textfile.directory
path = os.path.join(textfile_dir, "calib.prom")
write_to_textfile(path, registry) # запись во временный файл и атомарное переименование
print(open(path, encoding="utf-8").read(), end="")
# HELP calib_last_success_timestamp_seconds Последняя успешная калибровка BPM
# TYPE calib_last_success_timestamp_seconds gauge
calib_last_success_timestamp_seconds 1.791e+09
# HELP calib_channels Число откалиброванных каналов BPM
# TYPE calib_channels gauge
calib_channels 40.0
Главная метрика задания — момент последнего успешного завершения. Оповещение по ней формулируется как отсутствие успеха дольше заданного срока, например 26 ч для ежесуточного задания, и срабатывает, если задание завершилось ошибкой, не запустилось или зависло. Выключенную машину это правило не обнаруживает: вместе с ней останавливается node_exporter, ряд метрики пропадает, и выражение оповещения не возвращает ничего. Для этого случая необходимо отдельное оповещение — по ряду up самого node_exporter или по выражению с функцией absent, которое срабатывает при отсутствии ряда. В демонстрации к лекции время успешной калибровки зафиксировано на 03.10.2026 04:00 UTC, и в момент записи выражение max(time() - calib_last_success_timestamp_seconds) / 3600 дало 28,3 ч, то есть больше порога 26 ч.
Второй способ — сервер Pushgateway, которому задание отправляет метрики перед завершением. Документация Prometheus допускает его по существу только для итогов пакетных заданий уровня службы, не связанных с определённой машиной, а для заданий, связанных с машиной, рекомендует textfile collector. При опросе многих экземпляров через Pushgateway он становится единой точкой отказа и узким местом, лишает Prometheus проверки экземпляров по ряду up и хранит отправленные ряды, пока их не удалят явно.
Трассировки
Слайды к главе. Трасса и спан, заголовок
traceparent, OpenTelemetry и сэмплирование изложены также в пятой части лекции «Наблюдаемость» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Журнал описывает отдельные события, метрика — их число и распределение, но ни то, ни другое не показывает, на что ушло время конкретного медленного запроса, прошедшего через несколько служб. Этот вопрос решает трассировка.
Трасса и спан
Трасса представляет собой дерево операций, выполненных при обработке одного запроса. Каждая операция — спан — имеет имя, моменты начала и конца, атрибуты (например, номер запуска или размер ответа), события и статус. Спан несёт три идентификатора: собственный span_id, идентификатор трассы trace_id, общий для всех спанов запроса, и идентификатор родительского спана; у корневого спана родителя нет. Связь между разными трассами, например между отправкой сообщения в очередь и его обработкой, оформляют ссылкой (span link). Трассу отображают «водопадом» — полосами спанов на оси времени с отступами по глубине вложенности.
Контекст трассы передаётся между службами вместе с запросом. Рекомендация W3C Trace Context определяет HTTP-заголовок traceparent из четырёх полей: версии, 32 шестнадцатеричных цифр trace_id, 16 цифр span_id вызывающего спана и флагов. Младший бит флагов (sampled) означает, что вызывающая сторона, возможно, записала данные трассы. Служба, получившая запрос, извлекает контекст из заголовка и открывает свои спаны как потомков вызывающего.
OpenTelemetry
OpenTelemetry является открытым проектом, который определяет программный интерфейс (API) и его реализацию (SDK) для трассировок, метрик и журналов, протокол передачи OTLP и Collector — промежуточную службу приёма, обработки и пересылки сигналов. Хранилищем OpenTelemetry не является: трассы принимают системы Jaeger, Grafana Tempo, Zipkin и другие, и смена хранилища не требует изменения кода. Разделение API и SDK позволяет библиотекам зависеть только от API, а настраивать SDK — провайдер, процессор и экспортёр — один раз в программе, которая их использует. В SDK для Python трассировки и метрики имеют статус стабильных, а журналы находятся в разработке.
Рассмотрим передачу контекста от шлюза к архиву измерений. Чтобы листинг выполнялся без сети, запрос заменён вызовом функции, а заголовки — словарём.
import random
from opentelemetry.propagate import extract, inject
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import SimpleSpanProcessor
from opentelemetry.sdk.trace.export.in_memory_span_exporter import InMemorySpanExporter
from opentelemetry.sdk.trace.id_generator import IdGenerator
class SeededIds(IdGenerator): # повторяемые идентификаторы для книги
def __init__(self, seed):
self.rng = random.Random(seed)
def generate_span_id(self):
return self.rng.getrandbits(64)
def generate_trace_id(self):
return self.rng.getrandbits(128)
exporter = InMemorySpanExporter()
provider = TracerProvider(id_generator=SeededIds(42))
provider.add_span_processor(SimpleSpanProcessor(exporter))
tracer = provider.get_tracer("archive")
def archive_get_run(headers):
"""Обработчик архива: контекст трассы берётся из заголовков входящего запроса."""
with tracer.start_as_current_span("archive GET /runs/{id}", context=extract(headers)):
with tracer.start_as_current_span("db.query runs"):
pass
with tracer.start_as_current_span("read_hdf5"):
pass
with tracer.start_as_current_span("gateway GET /runs/{id}"):
headers = {}
inject(headers) # заголовок для исходящего запроса к архиву
print("traceparent:", headers["traceparent"])
archive_get_run(headers)
for s in sorted(exporter.get_finished_spans(), key=lambda s: s.start_time):
parent = f"{s.parent.span_id:016x}" if s.parent else "корень".ljust(16)
print(f"{s.context.trace_id:032x}"[:8], f"{s.context.span_id:016x}", parent, s.name)
traceparent: 00-bdd640fb06671ad11c80317fa3b1799d-3eb13b9046685257-01
bdd640fb 3eb13b9046685257 корень gateway GET /runs/{id}
bdd640fb 23b8c1e9392456de 3eb13b9046685257 archive GET /runs/{id}
bdd640fb 1a3d1fa7bc8960a9 23b8c1e9392456de db.query runs
bdd640fb bd9c66b3ad3c2d6d 23b8c1e9392456de read_hdf5
Провайдер трассировок TracerProvider настраивается один раз при старте программы. В листинге генератор идентификаторов имеет фиксированное зерно, чтобы вывод повторялся, а экспортёр хранит законченные спаны в памяти; в службе применяются случайные идентификаторы и экспортёр OTLP, передающий спаны в Collector. Функция inject записывает текущий контекст в словарь заголовков, а extract восстанавливает его на стороне архива. Поэтому спан архива получил родителем спан шлюза, его потомки — спан архива, а все четыре спана — общий trace_id. В настоящем запросе между шлюзом и архивом находился бы ещё спан клиента HTTP: автоматическая инструментация библиотек urllib, requests и httpx открывает его и вызывает inject сама, а команда opentelemetry-instrument подключает такую инструментацию без изменения кода программы. Генератор с тем же зерном применён и в демонстрации к лекции, поэтому trace_id в ней тот же, а span_id в заголовке другой: там шлюз до обращения к архиву открывает ещё спаны проверки прав и клиентского запроса, и заголовок несёт идентификатор клиентского спана, 1a3d1fa7bc8960a9, который в листинге получил спан запроса к базе.
В демонстрации к лекции те же службы обмениваются настоящими HTTP-запросами, а шлюз открывает для вызова архива клиентский спан. Водопад на рисунке построен по спанам записанного прогона: из 52,8 мс обработки запроса 47,4 мс приходится на обращение к архиву, а в нём 34,8 мс занимает чтение файла HDF5 и 11,2 мс — запрос к базе метаданных; проверка прав в шлюзе длится 5,1 мс. Чтение файла составляет 66 % времени запроса, и ускорять, таким образом, необходимо его, а не шлюз; этот вывод получен по одной трассе без отдельных замеров каждого участка.
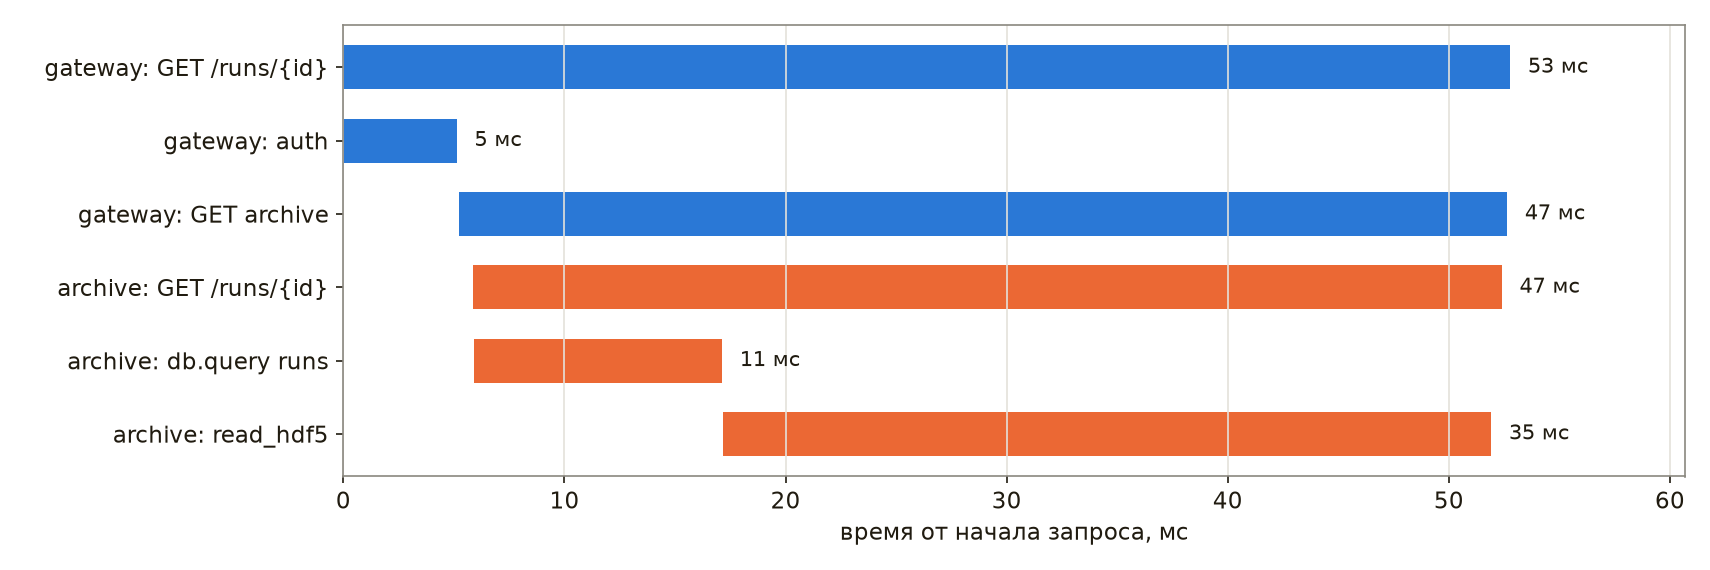
Трассировку связывают с журналами: фильтр журнала добавляет к каждой записи trace_id текущего спана из контекста, который возвращает вызов trace.get_current_span().get_span_context(), и по идентификатору из медленной трассы находятся все записи этого запроса во всех службах. Пакет opentelemetry-instrumentation-logging добавляет те же поля к записям через фабрику записей модуля logging; эта возможность включается явно — параметром инструментатора или переменной окружения OTEL_PYTHON_LOG_CORRELATION.
Сэмплирование и цена
Каждый спан требует памяти, времени на запись атрибутов и передачи в хранилище, и при большой нагрузке сохраняют только часть трасс. При сэмплировании в голове (head sampling) решение принимается при создании корневого спана. Сэмплер TraceIdRatioBased принимает его детерминированно по значению trace_id, поэтому все службы, получившие тот же контекст, принимают одинаковое решение, а сэмплер по умолчанию, ParentBased с корневым ALWAYS_ON, сохраняет все корневые спаны и для остальных повторяет решение родителя. В спецификации OpenTelemetry сэмплер TraceIdRatioBased объявлен устаревшим в пользу составного ProbabilitySampler, однако в SDK для Python 1.45 составные сэмплеры находятся в экспериментальном модуле. В демонстрации к лекции из 10 000 трасс при долях 1, 0,1 и 0,01 сохранено 10 000, 1000 и 98. Такой способ дёшев, но решение принимается до того, как известен исход запроса, и редкие ошибочные запросы сохраняются с той же вероятностью, что и обычные. При сэмплировании в хвосте (tail sampling) решение принимается по всем или большинству спанов трассы, обычно процессором tail sampling в Collector: он сохраняет все трассы с ошибками и медленные, а из остальных — заданную долю, но для этого ему необходимо буферизовать спаны на время принятия решения.
Наблюдение не должно нарушать работу самой службы. Процессор BatchSpanProcessor передаёт спаны пакетами из ограниченной очереди (по умолчанию 2048 спанов, параметр OTEL_BSP_MAX_QUEUE_SIZE); при её переполнении SDK для Python 1.45 вытесняет из очереди самые старые спаны и пишет предупреждение «Queue full, dropping», а программа продолжает работу. Тот же принцип применяют к журналам и метрикам: недоступность хранилища не должна останавливать службу.
К трём сигналам добавляют четвёртый — профили: непрерывное сэмплирующее профилирование показывает, какие функции расходуют процессорное время в работающей службе; в OpenTelemetry сигнал профилей находится в разработке. Профилировщик py-spy рассмотрен в главе «Причины низкой скорости Python», системы непрерывного профилирования — Grafana Pyroscope и Parca — хранят профили во времени, а применение профилировщика к зависшей или медленной службе разобрано в главе «Поиск неисправностей».
Панели и методы анализа
Слайды к главе. Методы RED и USE, золотые сигналы, правила построения панелей и систематические ошибки восприятия изложены также в шестой части лекции «Наблюдаемость» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Собранные метрики просматривают на панелях с графиками; набор панелей одной системы называют дашбордом, и наиболее распространённым инструментом их построения является Grafana. Метрик у системы сотни, графиков на экране — десятки, поэтому отбирают метрики не по доступности, а по методу.
RED, USE и золотые сигналы
Для служб, обрабатывающих запросы, применяют метод RED, предложенный Т. Уилки в 2015 году: частота запросов (rate), число неудачных запросов (errors) и распределение длительности (duration). Для ресурсов — процессора, памяти, дисков, сети — применяют метод USE Б. Грегга [53]: загрузка (utilization) — доля времени, в течение которого ресурс занят; насыщение (saturation) — объём дополнительной работы, которую ресурс не может обслужить сразу и которая обычно ждёт в очереди; ошибки (errors) — число событий отказа. Четыре золотых сигнала книги Google SRE — задержка, трафик, ошибки и насыщение — объединяют оба взгляда [23]. Метод задаёт порядок анализа: для каждой службы сначала просматривают три графика RED, а для каждого ресурса машины — три вопроса USE, и только затем переходят к остальным метрикам.
| Ресурс | Загрузка | Насыщение | Ошибки |
|---|---|---|---|
| процессор | доля времени вне простоя | очередь готовых к выполнению задач | — |
| память | доля занятой памяти | обмен со swap, ожидание памяти | завершения процессов при нехватке памяти |
| диск | доля времени, когда выполняется ввод-вывод | средняя длина очереди | ошибки в журнале ядра |
| сеть | байты в секунду относительно пропускной способности | отброшенные пакеты | ошибки приёма |
По метрикам node_exporter эти величины вычисляют следующие выражения:
# процессор: загрузка и насыщение
1 - avg without (cpu) (rate(node_cpu_seconds_total{mode="idle"}[5m]))
rate(node_pressure_cpu_waiting_seconds_total[5m])
# память: загрузка, насыщение и завершения процессов при нехватке памяти
1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes
rate(node_pressure_memory_waiting_seconds_total[5m])
increase(node_vmstat_oom_kill[1h])
# диск: загрузка и средняя длина очереди
rate(node_disk_io_time_seconds_total[5m])
rate(node_disk_io_time_weighted_seconds_total[5m])
# сеть: загрузка приёма, отброшенные пакеты и ошибки приёма
rate(node_network_receive_bytes_total[5m]) / node_network_speed_bytes
rate(node_network_receive_drop_total[5m])
rate(node_network_receive_errs_total[5m])
Ряды node_pressure_* берутся из механизма PSI (pressure stall information) ядра Linux, который сообщает долю времени, в течение которого хотя бы часть задач ожидала процессор, память или ввод-вывод; насыщение этот механизм измеряет непосредственно, тогда как средняя загрузка (load average) в Linux учитывает и процессы, ожидающие диск. Загрузка диска, близкая к 100 %, для массива из нескольких дисков или твердотельного накопителя с параллельными очередями ещё не означает предела, и насыщение оценивают по длине очереди и времени ожидания.
Метод RED в демонстрации к лекции применён к модели службы архива, которая обработала за 5 с 200 запросов. Два снимка /metrics дают частоту 40 запросов в секунду, долю ошибок 2,0 % и по гистограмме p50 18 мс, p95 25 мс и p99 460 мс. Холодное чтение в модели длится 310 мс, и завышение p99 вновь объясняется шириной корзины от 0,3 до 0,5 с, тогда как доля запросов быстрее 0,3 с, 95,0 %, вычисляется по границе корзины точно.
Панели RED той же модели по данным Prometheus показаны на рисунке. Данные получены в отдельном прогоне модели на той же виртуальной машине, на которой записаны демонстрации: служба обслуживала 40 запросов в секунду, а в течение двух минут моделировалось замедление базы архива, при котором обычный запрос длился 120 мс вместо 15, а ошибкой завершался каждый двадцатый запрос вместо каждого пятидесятого. Prometheus опрашивал службу раз в 5 с, все скорости вычислены функцией rate за 1 мин, поэтому края эпизода на графиках растянуты. Доля ошибок в эпизоде выросла с 2 до 5 %, медиана длительности — с 18 до 153 мс, а p99 всё время оставался равным 460 мс: хвост распределения определяют холодные чтения, и замедление обычных запросов квантиль 0,99 не показывает. Поэтому на панели длительности выводят несколько квантилей, а не один p99. Медиана в эпизоде, в свою очередь, завышена интерполяцией: настоящие 120 мс лежат в корзине от 0,1 до 0,2 с. Пунктир на средней панели отмечает бюджет ошибок цели 99,9 %, то есть 0,1 %: модель всё время расходует его в 20 раз быстрее допустимого, что сказывается на правилах оповещения, рассмотренных ниже.
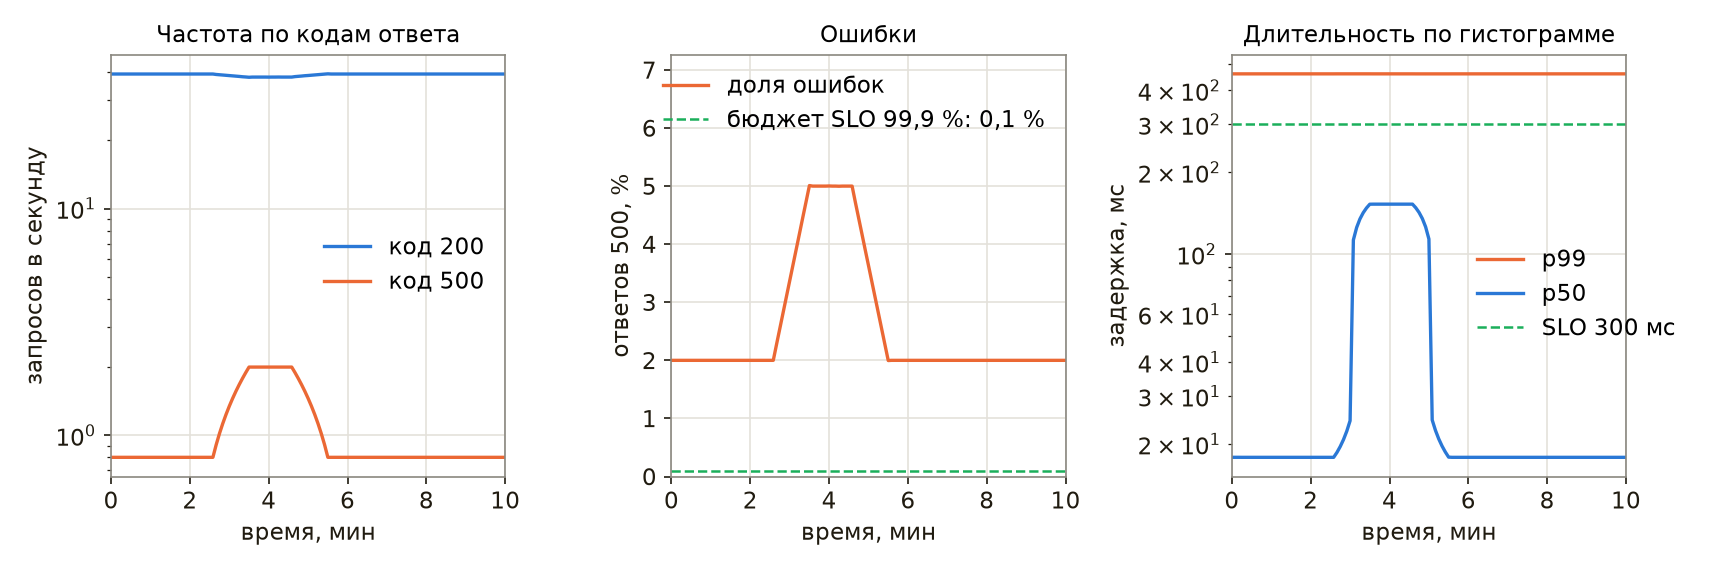
Правила построения панелей
Каждая панель отвечает на определённый вопрос, и вопрос этот записывают в её заголовок вместе с единицами и окном усреднения. Панели располагают сверху вниз — от функции, которую видит пользователь, к компонентам, — и слева направо по пути запроса: балансировщик, служба, база. Величину, меняющуюся на порядки, показывают в логарифмическом масштабе: давление в вакуумной камере меняется от \(10^{-7}\) Па в норме до \(10^{-4}\) Па при натекании, и на линейной шкале значения рабочего диапазона неотличимы от нуля. Из сотни рядов показывают десять наибольших (topk), а не все. Цвет используют сдержанно: красный и зелёный — только для состояния, причём с дублированием формой или подписью, поскольку красно-зелёное нарушение цветовосприятия встречается примерно у 8 % мужчин. Панель, которая постоянно показывает «No data», либо исправляют, либо удаляют: она приучает не доверять остальным.
Отдельный источник ошибок представляет собой окно усреднения. Рассмотрим сутки записи вакуумметра с фоном около \(2 \cdot 10^{-7}\) Па и натеканием, при котором давление на 3 минуты поднимается до \(5 \cdot 10^{-5}\) Па при пороге защиты \(10^{-5}\) Па. График с шагом 1 мин показывает пик полностью, со средним за 5 мин — \(3{,}0 \cdot 10^{-5}\) Па, а со средним за 1 ч — \(2{,}7 \cdot 10^{-6}\) Па, то есть ниже порога; график за сутки одной точкой показывает \(3{,}0 \cdot 10^{-7}\) Па. Максимум за шаг (max_over_time) во всех случаях сохраняет значение \(5{,}0 \cdot 10^{-5}\) Па. Grafana увеличивает шаг при выборе более длинного интервала времени, поэтому одна и та же панель за час и за неделю может давать противоположные выводы о превышении порога. Для величин, у которых важны пики, на панелях показывают максимум за шаг, а среднее подписывают как среднее.
Систематические ошибки восприятия
Человек, просматривающий панели во время отказа, подвержен тем же систематическим ошибкам мышления, что и в любой другой работе. Привязка к прошлому случаю («в прошлый раз было то же самое») заставляет искать знакомую причину и не замечать новой. Эвристика доступности переоценивает частоту ярких, недавно пережитых отказов. Совпадение всплесков на соседних панелях воспринимается как причинная связь, хотя оба графика могут отражать третью причину или расходиться на минуты, незаметные при мелком масштабе. Первую и последнюю из этих ошибок — привязку к причинам прошлых отказов и поиск ложных корреляций, которые на деле являются совпадениями или следствиями общей причины, — книга Google SRE называет среди типичных ошибок устранения неисправностей [23]; способы их обхода рассмотрены в главе «Поиск неисправностей».
Оповещения
Слайды к главе. Индикаторы и цели уровня обслуживания, скорость расходования бюджета ошибок, правила Prometheus с тестами, организация дежурства и наблюдаемость физической установки изложены также в седьмой части лекции «Наблюдаемость» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Панели просматривают, когда уже известно, что что-то не так; узнать об этом позволяет оповещение. Для оповещения, которое вызывает дежурного, необходимы два условия: оно сообщает о симптоме, затрагивающем пользователей, и требует действия человека. Оповещение без необходимого действия приучает дежурного не реагировать на оповещения вообще.
Индикаторы и цели
Определения индикатора (SLI), цели (SLO) и соглашения (SLA) об уровне обслуживания, бюджета ошибок и девяток даны в разделе «SLI, SLO и SLA» главы «Системный дизайн». Для оповещений существенно, что индикатор удобно записывать как долю хороших событий среди всех [24]: долю ответов без ошибки сервера, долю выдач запуска быстрее 300 мс, долю минут, в течение которых последнее измерение в архиве не старше 10 с. Последний индикатор, свежесть данных, для системы сбора данных часто важнее задержки ответа: архив, быстро выдающий данные часовой давности, для смены установки не работает. Цель задают на скользящем окне; в качестве окна общего назначения книга SRE Workbook рекомендует четыре недели, в которые всегда входит одинаковое число выходных. Внешнее соглашение, если оно есть, делают мягче внутренней цели, чтобы нарушение цели обнаруживалось раньше нарушения соглашения.
Скорость расходования бюджета
Оповещение по мгновенной доле ошибок либо срабатывает на каждый кратковременный всплеск, либо, при высоком пороге, пропускает долгий отказ средней силы. Книга SRE Workbook предлагает оповещать по скорости расходования бюджета ошибок — отношению доли ошибок в окне к допустимой доле \(1 - \mathrm{SLO}\) [24]. Скорость 1 означает, что бюджет будет израсходован ровно к концу окна цели, а скорость 14,4 при окне цели 30 дней — что 2 % месячного бюджета расходуются за час. Рекомендуемая конфигурация для цели 99,9 % вызывает дежурного при скорости больше 14,4 в окнах 1 ч и 5 мин или больше 6 в окнах 6 ч и 30 мин и заводит заявку при скорости больше 1 в окнах 3 сут и 6 ч. Короткое окно составляет 1/12 длинного и проверяет, что бюджет расходуется по-прежнему: благодаря ему оповещение снимается вскоре после окончания инцидента, а не сохраняется, пока длинное окно не очистится. Происхождение порогов 14,4, 6 и 1 разобрано в разделе «Журналы, метрики и трассировки» главы «Системный дизайн».
Оценим время обнаружения. Пусть с момента \(t = 0\) доля ошибок постоянна и равна \(e\). В окне длительностью \(W\) при \(t < W\) средняя доля ошибок равна \(e t / W\), и правило с порогом \(k\) срабатывает, когда \(e t / W > k (1 - \mathrm{SLO})\), то есть при
\[ t > \frac{k (1 - \mathrm{SLO}) W}{e}. \]
Для \(e = 2\) %, \(k = 14{,}4\) и \(W = 60\) мин получим \(t > 43{,}2\) мин; при полном отказе (\(e = 1\)) то же правило срабатывает менее чем через минуту, а при \(e = 1{,}44\) % и ниже не срабатывает никогда — такой отказ оставлен правилу с окном 6 ч. Проверим правила на модели суток работы архива с тремя инцидентами: час с 2 % ошибок, семь часов длительного отказа с 0,8 % ошибок и пятиминутный всплеск с 10 % ошибок.
from fractions import Fraction
BUDGET = 1 - Fraction("0.999") # допустимая доля ошибок при SLO 99,9 %
DAY = 24 * 60
history = 3 * DAY # трое суток без ошибок перед моделируемыми сутками
bad = [Fraction(0)] * (history + DAY) # доля ошибок в каждой минуте
for start, end, ratio in ((120, 180, "0.02"), (600, 1020, "0.008"), (1200, 1205, "0.1")):
bad[history + start:history + end] = [Fraction(ratio)] * (end - start)
prefix = [Fraction(0)]
for v in bad:
prefix.append(prefix[-1] + v)
def burn(m, window):
"""Скорость расходования бюджета в окне из window минут, заканчивающемся минутой m."""
lo = max(0, m - window + 1)
return (prefix[m + 1] - prefix[lo]) / (m + 1 - lo) / BUDGET
rules = {"вызов: 1 ч и 5 мин, 14,4": (60, 5, Fraction("14.4")),
"вызов: 6 ч и 30 мин, 6": (360, 30, 6), "заявка: 3 сут и 6 ч, 1": (3 * DAY, 360, 1)}
for name, (long, short, k) in rules.items():
fired = [m - history for m in range(history, len(bad)) if burn(m, long) > k and burn(m, short) > k]
first = f"{fired[0] // 60:02d}:{fired[0] % 60:02d}" if fired else "—"
print(f"{name:25} первое срабатывание {first}, минут в состоянии: {len(fired)}")
вызов: 1 ч и 5 мин, 14,4 первое срабатывание 02:43, минут в состоянии: 18
вызов: 6 ч и 30 мин, 6 первое срабатывание 14:30, минут в состоянии: 157
заявка: 3 сут и 6 ч, 1 первое срабатывание 16:30, минут в состоянии: 450
Доли ошибок хранятся точными дробями (Fraction), а суммы по окнам вычисляются через префиксные суммы. Дроби исключают ошибку округления в пограничном случае: в 14:29 скорость за 6 ч равна ровно 6, и условие «больше 6» ещё не выполнено, тогда как при вычислениях с плавающей точкой результат сравнения зависел бы от последнего знака. Первый инцидент обнаружен в 02:43, через 43 минуты после начала, в согласии с оценкой; оповещение снято после 18 минут в 03:01, когда скорость в окне 1 ч ещё равна 19,3, но в окне 5 мин опустилась до 12 — так работает короткое окно. Длительный отказ со скоростью 8 правилу 14,4 не виден вовсе: его вызывает правило 6 в 14:30, через четыре с половиной часа, а в 16:30 к нему добавляется заявка. Пятиминутный всплеск со скоростью 100 новых оповещений не вызывает: он израсходовал 1,2 % месячного бюджета, и вызывать из-за него дежурного ночью нецелесообразно, тогда как первые два инцидента израсходовали 2,8 и 7,8 %. Заявка, заведённая в 16:30, во время всплеска ещё открыта, и всплеск её продлевает: без него она оставалась бы открытой до 22:13, а с ним открыта до конца суток — отсюда 450 минут в выводе.
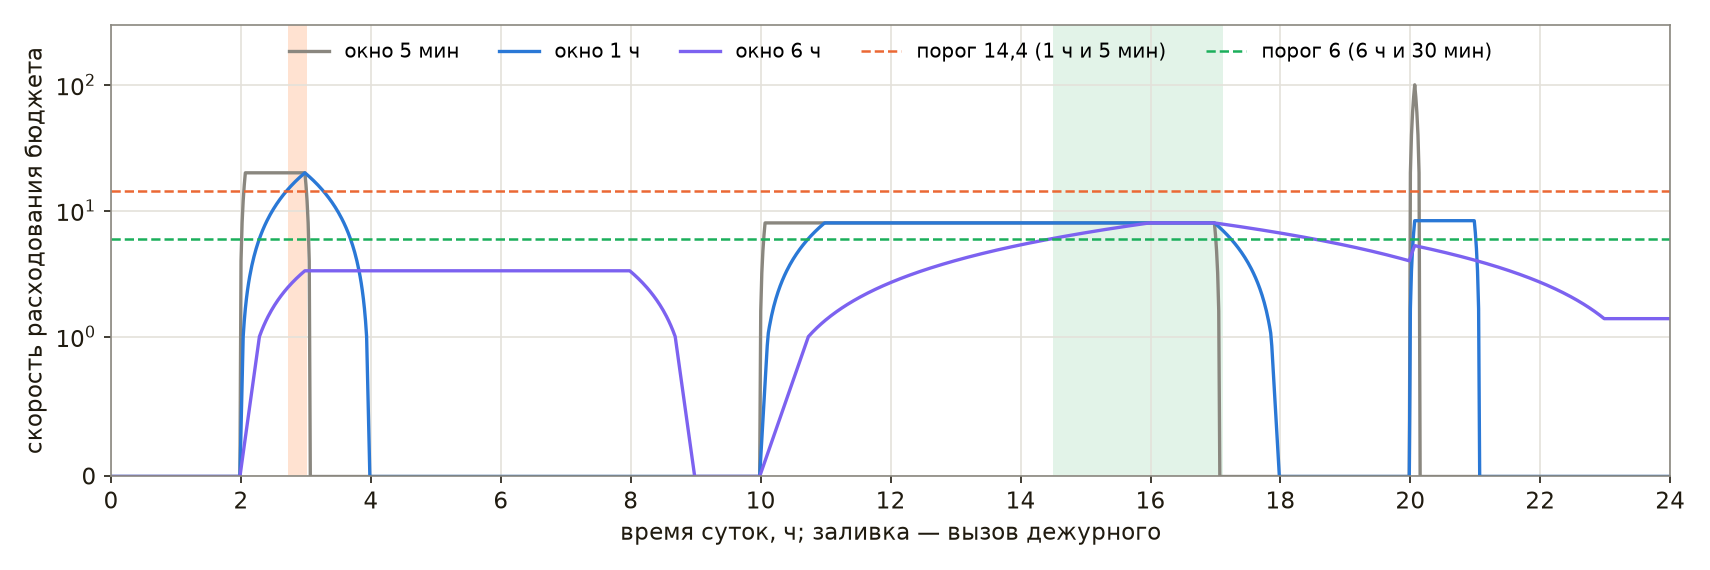
Правила Prometheus и их тесты
Prometheus вычисляет правила двух видов. Правило записи (recording rule) периодически вычисляет выражение и сохраняет результат как новый ряд; имя ряда по соглашению имеет вид «уровень:метрика:операции», где уровень обозначает метки, по которым агрегирован результат, метрика — исходное имя без суффикса _total, а операции — применённые функции, начиная с последней; так, в книге SRE Workbook доля ошибок за час называется job:slo_errors_per_request:ratio_rate1h. Имена правил демонстрации к лекции сокращены: первая часть, archive, называет службу, а не уровень агрегации; правила приведены в том виде, в каком они проверены. Правило оповещения (alerting rule) переводит оповещение в состояние «ожидание», когда выражение возвращает непустой результат, и в состояние «срабатывание», если результат сохраняется в течение интервала for; правило без параметра for, как в приведённом ниже фрагменте правил архива, срабатывает при первом же вычислении:
groups:
- name: archive-slo
rules:
- record: archive:error_ratio:rate5m
expr: sum(rate(archive_requests_total{code=~"5.."}[5m])) / sum(rate(archive_requests_total[5m]))
- record: archive:error_ratio:rate1h
expr: sum(rate(archive_requests_total{code=~"5.."}[1h])) / sum(rate(archive_requests_total[1h]))
- alert: ArchiveErrorBudgetBurnFast
expr: archive:error_ratio:rate1h > 14.4 * 0.001 and archive:error_ratio:rate5m > 14.4 * 0.001
labels:
severity: page
annotations:
summary: "Архив расходует бюджет ошибок быстрее 14.4 нормы"
runbook_url: "https://wiki.example.org/runbooks/archive-errors"
Второе правило бюджета, ArchiveErrorBudgetBurnSlow, для окон 6 ч и 30 мин с порогом 6 устроено так же. Правила, как и код, проверяют тестами. Утилита promtool из поставки Prometheus проверяет синтаксис командой promtool check rules rules.yml, а командой promtool test rules rules_test.yml вычисляет правила на синтетических рядах и сравнивает сработавшие оповещения с ожидаемыми. Ряды задаются компактной записью: 0+600x180 означает 181 отсчёт от 0 с шагом 600, 0x60 12+12x119 — 61 нулевой отсчёт, а затем 120 отсчётов от 12 с шагом 12.
rule_files:
- rules.yml
evaluation_interval: 1m
tests:
- interval: 1m
input_series:
- series: 'archive_requests_total{code="200"}'
values: '0+600x180'
- series: 'archive_requests_total{code="500"}'
values: '0x60 12+12x119'
alert_rule_test:
- eval_time: 95m
alertname: ArchiveErrorBudgetBurnFast
exp_alerts: []
- eval_time: 115m
alertname: ArchiveErrorBudgetBurnFast
exp_alerts:
- exp_labels:
severity: page
exp_annotations:
summary: "Архив расходует бюджет ошибок быстрее 14.4 нормы"
runbook_url: "https://wiki.example.org/runbooks/archive-errors"
С 61-й минуты служба отвечает ошибкой на 12 запросов из 612 в минуту, то есть доля ошибок равна 1,96 %, и по оценке из предыдущего раздела правило должно сработать примерно через 44 минуты. Через 35 минут доля ошибок в окне 1 ч ещё ниже порога 1,44 %, и оповещения нет, а через 55 минут она его превышает. Тест фиксирует это поведение: изменение порога или выражения, нарушающее его, обнаруживается до выкатки правил, а не во время ночного отказа.
Полный файл правил демонстрации к лекции содержит четыре правила записи и шесть правил оповещения; для него команда promtool check rules сообщает «SUCCESS: 10 rules found», а promtool test rules с тремя группами тестов — «SUCCESS». В работающем Prometheus той же демонстрации оба правила бюджета архива находятся в состоянии срабатывания: модель архива отвечает ошибкой на 2 % запросов, то есть расходует бюджет цели 99,9 % со скоростью 20, что выше обоих порогов. Это свойство модели, а не неисправность, и правила поступают так, как должны. Сработало и правило устаревшей калибровки из раздела о заданиях, а правила отказа экспортёра, превышения давления и заполнения диска остались неактивными; последнее, DiskWillFillIn4h, применяет тот же прогноз predict_linear на 4 ч к корневому разделу с окном 1 ч.
Сработавшие оповещения Prometheus передаёт службе Alertmanager. Она группирует оповещения одной природы в одно сообщение, подавляет зависимые оповещения при срабатывании корневого (недоступность коммутатора делает недоступными все экспортёры за ним), позволяет заранее отключить оповещения на время плановых работ и направляет сообщения получателям по меткам: severity: page — дежурному на телефон, severity: ticket — в систему заявок.
Дежурство и инструкции
Текст оповещения сообщает, что произошло, где, при каком пороге и каково текущее значение, и содержит ссылку на инструкцию (runbook) с первыми действиями. Во многих командах дежурят по расписанию основной и запасной дежурные, и для каждого оповещения определена эскалация: если основной дежурный не подтвердил оповещение за заданное время, вызывается запасной, затем руководитель. Книга Google SRE ограничивает нагрузку двумя инцидентами за двенадцатичасовую смену: на один инцидент — поиск причины, устранение и последующую работу, включая отчёт и исправление ошибок, — уходит в среднем шесть часов [23]. Рутинная реакция, повторяющаяся из раза в раз, является поводом для автоматизации, а не для нового оповещения: если по оповещению о заполнении диска каждый раз удаляют старые журналы, ротацию журналов настраивают так, чтобы оповещение не возникало.
Цепочку оповещения проверяют целиком, как и резервную копию. На учениях выключают экспортёр и убеждаются, что сообщение дошло до дежурного; постоянно срабатывающее контрольное оповещение позволяет внешней системе заметить, что сам Prometheus или Alertmanager перестал работать. Действия при сработавшем оповещении, роли участников инцидента и разбор его причин рассмотрены в главе «Поиск неисправностей».
Наблюдаемость физической установки
На ускорительном комплексе существуют две системы, которые обе называют мониторингом, но которые решают разные задачи. Архив физических величин — EPICS Archiver Appliance или база временных рядов slow control, описанная в главе «Работа с базами данных», — хранит значения каналов системы управления для физического анализа: годами, как правило без прореживания, с возможностью восстановить состояние установки в любой момент сеанса. Мониторинг программ — Prometheus с его оповещениями — хранит состояние служб недели или месяцы, и прореживание старых данных для него допустимо. Тревоги по физическим величинам (давление выше порога, перегрев магнита) обрабатывает система тревог управления установкой и показывает оператору смены, а оповещения о состоянии программ направляются дежурному разработчику. Смешение этих систем приводит к ошибкам в обе стороны: каналы с частотой 10 Гц Prometheus не сохраняет без потерь, поскольку опрашивает цели раз в несколько секунд или реже, а срок хранения в недели бесполезен для физики; состояние же программ в архиве каналов не обеспечено ни оповещениями, ни языком запросов к нему.
Метрики, которые программы системы управления выставляют для мониторинга, отвечают на вопросы о самих программах:
- связь с контроллером или сервером каналов — метрика вида
vacuum_up; - длительность цикла опроса и число пропущенных циклов;
- число ошибок чтения по каналам и доля каналов без связи;
- отставание записи в архив — разность времени последнего записанного отсчёта и текущего времени;
- заполнение дисков архива с прогнозом
predict_linear; - длина очереди между сбором и записью.
Свежесть данных является для системы сбора данных главным индикатором уровня обслуживания: доля минут, в течение которых последний отсчёт в архиве не старше 10 с, прямо отвечает на вопрос смены, видит ли она текущее состояние установки. Устаревшее значение канала само должно быть отличимо от актуального: в EPICS для этого служат статус и тревога канала, и пример службы, возвращающей вместо отказа прежнее число, разобран в главе «Цифровой двойник ускорителя».
Для лабораторной службы достаточно небольшого минимума наблюдаемости: структурированный журнал в стандартный вывод, /metrics с метриками RED и _up для каждого источника, внешняя проверка доступности и одно оповещение по скорости расходования бюджета или по свежести данных. Остальное добавляют, когда разбор очередного инцидента показывает, какого сигнала не хватило.
Упражнения
- Перевести журнал собственной программы на одну строку JSON на событие с полем идентификатора цикла или запроса и отобрать утилитой jq записи одного цикла.
- Написать экспортёр для прибора или расчёта своей группы с опросом в методе
collect, метрикой_upи базовыми единицами в именах и проверить его ответ командойcurl. - Выбрать границы корзин гистограммы длительности собственной службы так, чтобы одна из них совпадала с целью уровня обслуживания, и сравнить оценку p99 с точным значением.
- Записать для своей службы правило оповещения по скорости расходования бюджета и тест к нему и проверить их командами
promtool check rulesиpromtool test rules. - Поднять Prometheus и node_exporter, построить панели USE для машины и RED для службы, затем остановить экспортёр и убедиться, что оповещение дошло.
Резюме
Наблюдаемость позволяет понять по внешним сигналам, что происходит внутри работающей системы, и тем самым сокращает время обнаружения и локализации отказа. Журнал фиксирует события и пишется структурированно — одна строка JSON на событие с идентификатором запроса, — в стандартный вывод, с порогом, который меняется без перезапуска. Метрика сводит события в числа: события считают счётчиком, текущее состояние выражают мгновенным значением, задержки — гистограммой с границами корзин на целях уровня обслуживания; метки ограничивают по кардинальности, а данные внешних систем выставляет экспортёр, опрашивающий источник в момент запроса. Prometheus опрашивает цели, хранит ряды и вычисляет выражения PromQL, а трассировка OpenTelemetry показывает путь отдельного запроса через службы и время на каждом участке.
Таким образом, система наблюдения строится от вопросов к сигналам: панели отвечают на вопросы методов RED и USE, а оповещения вызывают дежурного только по симптомам и по скорости расходования бюджета ошибок, причём правила проверяются тестами так же, как код. Для физической установки мониторинг программ дополняет архив физических величин, но не заменяет его.
Полезные ссылки
- Site Reliability Engineering, главы «Monitoring Distributed Systems» и «Being On-Call», и The Site Reliability Workbook, главы «Monitoring» и «Alerting on SLOs» [23, 24];
- документация Prometheus: модель данных, типы метрик, именование, инструментирование, гистограммы и сводки, написание экспортёров, когда применять Pushgateway, правила оповещения, тесты правил, Alertmanager;
- prometheus_client — библиотека метрик для Python;
- документация OpenTelemetry для Python и описание сэмплирования;
- W3C Trace Context — формат заголовка
traceparent; - B. Gregg. The USE Method и T. Wilkie. The RED Method — методы выбора метрик;
- The Twelve-Factor App: Logs — журнал как поток событий;
- systemd-journald и journalctl — системный журнал Linux;
- Š. Davidovič. Incident Metrics in SRE — о непригодности средних MTTR и других сводных показателей для оценки тренда [54].
Поиск неисправностей
Отказ уже произошёл: архив отвечает ошибками, ночная обработка не завершилась, память службы растёт с каждым часом. Средства наблюдения, рассмотренные в главе «Наблюдаемость», сообщили о симптоме, и теперь необходимо найти причину и восстановить работу, причём восстановить по возможности раньше, чем причина будет найдена. Поиск неисправностей представляет собой процесс выявления и устранения причины, по которой система ведёт себя не так, как ожидается. В распределённой системе он осложняется тем, что частей много, отказывают они по отдельности, а их часы показывают разное время.
Поиск неисправностей нередко считают врождённым талантом, однако книга Google SRE рассматривает его как навык, которому можно научиться и научить [23]. Та же книга выделяет две его составляющие: общий метод, по которому выдвигаются и проверяются гипотезы, и знание устройства конкретной системы. К ним добавляются инструменты, позволяющие проверить гипотезу на работающей системе. В настоящей главе последовательно рассмотрены особенности отказов распределённых систем, метод поиска, инструменты для работающего процесса на Python и Linux, управление инцидентом и разбор его причин, а в завершение — три учебных случая в формате упражнения «колесо неудачи». Глава опирается на главы «Инструменты Linux» (раздел «Диагностика и поиск проблем»), «Внутреннее устройство Linux» (процессы и их состояния), «Причины низкой скорости Python» (профилировщики) и «Системный дизайн» (тайм-ауты, повторы, очереди).
Листинги и сеансы оболочки главы, если не оговорено иное, выполнены на macOS под Python 3.11. Сеансы и результаты команд Linux — /proc, strace, ss, py-spy, perf и systemd — взяты из записей демонстраций к лекции, сделанных на виртуальной машине с Ubuntu 24.04 (процессор ARM64, два ядра, Python 3.12.3, systemd 255); из тех же записей взяты и числа, приведённые со ссылкой на демонстрации к лекции.
Слайды к главе. Отказы распределённых систем, метод поиска, инструменты процесса, управление инцидентом, разбор причин и три учебных случая изложены также в лекции «Поиск неисправностей» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Отказы распределённой системы
Слайды к главе. Частичные отказы, расхождение часов и заблуждения о сети изложены также в первой части лекции «Поиск неисправностей» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Частичные отказы и разные часы
Программа на одной машине либо работает, либо нет. Система из многих машин отказывает частично: один экземпляр службы отвечает медленно, одна зона недоступна, одна реплика базы отстала, а остальные части работают. Общего состояния, которое можно было бы рассмотреть целиком, у такой системы нет, и картину отказа собирают из журналов и метрик разных машин.
Сборку картины осложняют часы. Протокол NTP обычно поддерживает время машин с точностью до десятков миллисекунд при синхронизации через интернет и лучше миллисекунды в локальной сети при благоприятных условиях, а асимметричные маршруты и перегрузка сети дают ошибку в 100 мс и более. Протокол PTP (IEEE 1588) с аппаратными метками времени обеспечивает в локальной сети точность лучше микросекунды, а основанная на нём система White Rabbit, разработанная ЦЕРН, GSI и их партнёрами для синхронизации ускорительных комплексов, — доли наносекунды. Поэтому записи разных машин, разделённые миллисекундами, по меткам времени упорядочить нельзя, а машина с неисправной синхронизацией может разойтись с остальными на секунды. Рассмотрим запрос, который проходит шлюз, архив и базу метаданных; часы архива отстают на 1,5 с, а часы базы спешат на 12 мс.
OFFSET = {"gw": 0.000, "archive": -1.500, "db": 0.012} # насколько часы машины впереди настоящих, с
# настоящее время от начала запроса, с; машина; номер родительского события; текст
EVENTS = [(0.000, "gw", None, "GET /runs/42"),
(0.004, "archive", 0, "запрос метаданных"),
(0.010, "db", 1, "SELECT runs: ожидание блокировки"),
(1.010, "db", 2, "lock timeout, ERROR"),
(1.013, "archive", 3, "ошибка базы, ответ 500"),
(1.016, "gw", 4, "ответ 500 пользователю")]
logged = sorted((t + OFFSET[host], host, text) for t, host, parent, text in EVENTS)
print("по меткам журналов:")
for t, host, text in logged:
print(f" {t:7.3f} {host:8} {text}")
order, seen = [], set()
while len(order) < len(EVENTS): # событие идёт после своего родителя
for i, (t, host, parent, text) in enumerate(EVENTS):
if i not in seen and (parent is None or parent in seen):
seen.add(i)
order.append(host)
print("по связям «родитель — потомок»:", " → ".join(order))
по меткам журналов:
-1.496 archive запрос метаданных
-0.487 archive ошибка базы, ответ 500
0.000 gw GET /runs/42
0.022 db SELECT runs: ожидание блокировки
1.016 gw ответ 500 пользователю
1.022 db lock timeout, ERROR
по связям «родитель — потомок»: gw → archive → db → db → archive → gw
При сортировке по меткам журналов архив обращается к базе за полторы секунды до прихода запроса и отвечает ошибкой раньше, чем база сообщила о превышении времени ожидания блокировки, — причиной отказа кажется архив. Порядок по связям «родитель — потомок», которые записывает трассировка (глава «Наблюдаемость»), от часов не зависит и показывает действительную цепочку: база не дождалась блокировки, архив передал ошибку дальше. Таким образом, хронологию инцидента строят по идентификаторам запросов и связям спанов, а метки времени разных машин сравнивают, только зная смещение их часов относительно источника точного времени; в Linux его показывают команды chronyc tracking (служба chrony) и timedatectl timesync-status (служба systemd-timesyncd).
Заблуждения о сети
Ошибки проектирования распределённых систем часто сводятся к восьми заблуждениям о сети. Семь из них сформулировал П. Дойч в Sun Microsystems в 1994 году, а восьмое около 1997 года добавил Дж. Гослинг: сеть надёжна; задержка равна нулю; пропускная способность бесконечна; сеть безопасна; топология не меняется; администратор один; передача данных бесплатна; сеть однородна. Заблуждения оставляют следы в коде: запрос без тайм-аута, служба без аутентификации «за межсетевым экраном», передача массивов целиком там, где достаточно выборки, адрес, сохранённый в программе без учёта времени жизни записи DNS.
Рассмотрим первое заблуждение на примере клиента, который отправляет 12 запросов архиву через пул из четырёх потоков. Запросы к запуску 13 зависают на 3 с: архив ждёт недоступную базу.
import threading
import time
import urllib.request
from concurrent.futures import ThreadPoolExecutor
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
class Archive(BaseHTTPRequestHandler):
def do_GET(self):
time.sleep(3.0 if self.path == "/runs/13" else 0.05) # запуск 13: база не отвечает
try:
self.send_response(200)
self.end_headers()
except OSError: # клиент уже ушёл по тайм-ауту
pass
def log_message(self, *args):
pass
server = ThreadingHTTPServer(("127.0.0.1", 8501), Archive)
server.daemon_threads = True
threading.Thread(target=server.serve_forever, daemon=True).start()
paths = ["/runs/13" if i in (1, 3, 5, 7) else f"/runs/{i}" for i in range(12)]
def fetch(path, timeout):
try:
urllib.request.urlopen("http://127.0.0.1:8501" + path, timeout=timeout).read()
return "ok"
except OSError: # TimeoutError — подкласс OSError
return "ошибка"
for timeout in (None, 0.5):
t0 = time.monotonic()
with ThreadPoolExecutor(4) as pool: # четыре рабочих потока
results = list(pool.map(lambda p: fetch(p, timeout), paths))
print(f"тайм-аут {timeout}: успешно {results.count('ok')}, ошибок {results.count('ошибка')}, "
f"всего {time.monotonic() - t0:.1f} с")
server.shutdown()
тайм-аут None: успешно 12, ошибок 0, всего 3.2 с
тайм-аут 0.5: успешно 8, ошибок 4, всего 0.7 с
Без тайм-аута все запросы в итоге успешны, но четыре зависших запроса занимают все четыре потока пула, и последние быстрые запросы ждут их освобождения: обработка занимает 3,2 с вместо десятых долей секунды. Та же модель в демонстрации к лекции подсчитывает и запросы, завершённые за первую секунду: без тайм-аута их 4 из 12, а с тайм-аутом — все 12. Для службы, которая обращается к архиву по запросам пользователей, это означает, что отказ одной зависимости останавливает обслуживание всех пользователей. С тайм-аутом 0,5 с зависшие запросы завершаются ошибкой, а вся пачка обрабатывается за 0,7 с. Поэтому тайм-аут необходим каждому сетевому вызову; согласование тайм-аутов по цепочке служб и повторы рассмотрены в разделе «Тайм-ауты и дедлайн» главы «Системный дизайн» и в разделе «Тайм-аут и повтор» главы «Веб-технологии».
Метод
Слайды к главе. Знание системы, цикл «гипотеза — проверка — вывод», типичные ошибки рассуждения, поиск последнего изменения и деление системы пополам изложены также во второй части лекции «Поиск неисправностей» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Знание системы
Неисправность системы, устройство которой неизвестно, приходится искать перебором. Поэтому подготовка к отказу начинается задолго до него: со схемы системы, на которой показаны все части и интерфейсы между ними, — балансировщики, экземпляры служб в разных зонах, база с репликами, очереди, — и с представления о нормальном поведении каждой части. Графики «как обычно» позволяют сразу заметить, что изменилось. Полезную подготовку дают и мысленные эксперименты: что увидит пользователь, если откажет реплика базы, и какие метрики при этом изменятся. Каждую такую гипотезу проверяют на стенде или на учениях, пока отказа нет.
Гипотеза, проверка, вывод
В книге Google SRE поиск неисправности описан как цикл [23]. Он начинается с отчёта о проблеме: оповещения или сообщения пользователя, в котором описаны ожидаемое и фактическое поведение и, если возможно, способ воспроизведения. Второй этап составляет сортировка (triage) — оценка серьёзности и решение, что делать в первую очередь: восстанавливать работу или искать причину. Исследование собирает сведения о состоянии системы по метрикам, журналам и трассировкам. Диагностика выдвигает гипотезу о причине, а проверка подтверждает или опровергает её; цикл повторяется, пока не останется одна причина, после чего наступает этап устранения: причину подтверждают, устраняют и описывают в разборе инцидента. По существу это гипотетико-дедуктивный метод, знакомый каждому экспериментатору: из наблюдений выводится гипотеза, из гипотезы — проверяемое следствие, и опыт либо подтверждает следствие, либо отвергает гипотезу.
Гипотезу необходимо формулировать вместе со способом проверки и ожидаемым результатом: «если обработка замедлилась из-за диска, то процессорное время программы заметно меньше реального, и это покажет команда time». Без ожидаемого результата любое вмешательство — перезапуск, увеличение пула, смена параметра — превращается в попытку наугад, а его исход ничего не доказывает. Отрицательный результат проверки тоже является результатом: опровергнутая гипотеза сужает область поиска. Каждую гипотезу и результат её проверки записывают в документ инцидента, чтобы ни сам дежурный, ни его сменщик не проверяли одно и то же дважды.
Типичные ошибки рассуждения
Поиск замедляют типичные ошибки, перечисленные в той же книге [23]. Первая состоит во внимании к несущественным симптомам и неверном понимании смысла метрик: график, который выглядит необычно, не обязательно связан с отказом. Вторая — в непонимании того, как изменить систему, её входные данные или окружение, чтобы проверка была безопасной и действительно что-то доказывала. Третья — в маловероятных теориях и в привязке к причинам прошлых отказов: то, что однажды уже случалось, вспоминается первым, но повторяется не всегда. Четвёртая — в поиске ложных корреляций: совпадение двух событий во времени ещё не означает причинной связи, и оба события могут быть следствиями третьего. В примере книги потеря пакетов в кластере и отказы его дисков вызваны общей причиной — перебоем питания, хотя ни одно из этих событий не вызывает другое.
От первых двух ошибок защищают знание системы и опыт, от третьей — напоминание о том, что не все отказы одинаково вероятны и что при прочих равных предпочтительно более простое объяснение. К перечню книги добавляется ещё одна ошибка — одновременные вмешательства: если одновременно изменить два параметра, нельзя установить, какое из изменений подействовало. Та же книга отмечает, что активная проверка сама меняет систему и может исказить результаты следующих проверок, а изменения, внесённые систематически и записанные, позволяют затем вернуть систему в исходное состояние [23].
Поиск последнего изменения
По наблюдению книги Google SRE, работающая система обладает инерцией: она продолжает работать, пока на неё не подействует внешнее изменение — новая версия, изменённая конфигурация, иной характер нагрузки [23]. По оценке той же книги, около 70 % отказов вызваны изменениями в работающей системе, и основными мерами защиты в ней названы автоматизированные постепенная выкатка, быстрое обнаружение проблем и безопасный откат. Отсюда два следствия. Первое действие при отказе после выкатки — откат, который восстанавливает работу, не дожидаясь понимания причины. Если же последнее изменение неизвестно или изменений много, виновное находят делением пополам. Команда git bisect представляет собой двоичный поиск по истории версий: она проверяет середину интервала между заведомо исправной и неисправной версиями и за каждую проверку отбрасывает половину кандидатов.
Рассмотрим репозиторий конфигурации службы реконструкции событий из 32 выпусков. Служба выполняет вычисления и работает на 16-ядерных машинах, поэтому число рабочих потоков больше четырёх на ядро, то есть больше 64, считается ошибкой конфигурации. Проверку выполняет небольшой скрипт check_config.py, который возвращает код 0 для годной конфигурации и 1 для ошибочной:
import sys
import tomllib
CORES, PER_CORE = 16, 4 # машины 16-ядерные, работа ограничена процессором
path = sys.argv[1] if len(sys.argv) > 1 else "reco.toml"
with open(path, "rb") as f:
cfg = tomllib.load(f)
workers = cfg["workers"]
if not 1 <= workers <= CORES * PER_CORE:
print(f"{path}: workers = {workers}, допустимо 1…{CORES * PER_CORE} — конфигурация отклонена")
sys.exit(1)
print(f"{path}: выпуск {cfg['release']}, workers = {workers} — годна")
Последний выпуск, 1.32, проверку не проходит, а первый заведомо исправен. Начало поиска задаёт команда git bisect start с неисправной и исправной версиями, а команда git bisect run сама переключается между версиями и запускает проверку, считая код 0 признаком исправной версии, а коды от 1 до 127, кроме 125, — признаком неисправной; версию с кодом 125, которую проверить нельзя, команда пропускает:
$ git log --oneline | head -3
00f1569 Release 1.32
11565da Release 1.31
1d9ce96 Release 1.30
$ python3 ../check_config.py; echo "код $?"
reco.toml: workers = 4000, допустимо 1…64 — конфигурация отклонена
код 1
$ git bisect start HEAD HEAD~31
Bisecting: 15 revisions left to test after this (roughly 4 steps)
[57ce2dc841ad9dfe671e4528f1468985159ab417] Release 1.16
$ git bisect run python3 ../check_config.py
running 'python3' '../check_config.py'
reco.toml: выпуск 1.16, workers = 40 — годна
Bisecting: 7 revisions left to test after this (roughly 3 steps)
[cda0ce6ed3870544cb0b07894a3d6e2a5db35707] Release 1.24
running 'python3' '../check_config.py'
reco.toml: workers = 4000, допустимо 1…64 — конфигурация отклонена
Bisecting: 3 revisions left to test after this (roughly 2 steps)
[2ccafe37e136ab909206751fa777073a98150d21] Release 1.20
running 'python3' '../check_config.py'
reco.toml: workers = 4000, допустимо 1…64 — конфигурация отклонена
Bisecting: 1 revision left to test after this (roughly 1 step)
[129c123985b8b95768819daa4a6f83bf24112ddd] Release 1.18
running 'python3' '../check_config.py'
reco.toml: выпуск 1.18, workers = 40 — годна
Bisecting: 0 revisions left to test after this (roughly 0 steps)
[641fd25f60d2d506f44a68f2e6f1f1c3793659ef] Better
running 'python3' '../check_config.py'
reco.toml: workers = 4000, допустимо 1…64 — конфигурация отклонена
641fd25f60d2d506f44a68f2e6f1f1c3793659ef is the first bad commit
commit 641fd25f60d2d506f44a68f2e6f1f1c3793659ef
Author: dev <dev@example.org>
Date: Thu Jul 9 12:00:00 2026 +0700
Better
reco.toml | 4 ++--
1 file changed, 2 insertions(+), 2 deletions(-)
bisect found first bad commit
$ git bisect reset
Previous HEAD position was 641fd25 Better
Switched to branch 'main'
Пять проверок — выпуски 1.16, 1.24, 1.20, 1.18 и 1.19 — находят коммит с сообщением «Better», в котором число потоков стало 4000 вместо 40; последовательный перебор тридцати одного кандидата потребовал бы до тридцати проверок. Рабочую копию к исходной ветке возвращает команда git bisect reset. Тот же скрипт, включённый в проверку перед выкаткой, не пропустил бы ошибочную конфигурацию вовсе.
Поиск сверху вниз и деление пополам
Если изменение не найдено, систему делят на части с чёткими интерфейсами — HTTP, вызов процедуры, запрос к базе — и для каждого интерфейса определяют ожидаемое поведение. Части проверяют последовательно, от одного конца цепочки к другому: сверху вниз, от того, что видит пользователь, к компонентам, а для конвейера данных — по потоку данных, от источника к потребителю. В очень больших системах последовательный обход слишком долог, и применяют деление пополам: проверка середины цепочки сразу отбрасывает половину частей [23].
Каждый уровень проверяют запросом его собственного протокола. Ответ на ping показывает лишь то, что машина отвечает на пакеты ICMP: балансировщик, возвращающий ошибку 500, на ping отвечает исправно. Состояние службы HTTP показывает запрос HTTP с кодом ответа и временем. Три запроса к учебному серверу — к существующему запуску, к несуществующему и к порту, на котором служба не запущена, — дают три разных ответа:
$ curl -sS -o /dev/null -w '%{http_code} %{time_total}\n' http://127.0.0.1:8405/runs/42
200 0.004133
$ curl -sS -o /dev/null -w '%{http_code} %{time_total}\n' http://127.0.0.1:8405/runs/43
404 0.000965
$ curl -sS -o /dev/null -w '%{http_code} %{time_total}\n' http://127.0.0.1:8406/runs/42
curl: (7) Failed to connect to 127.0.0.1 port 8406 after 0 ms: Couldn't connect to server
000 0.000224
Код 200 и время около 4 мс (curl выводит его в секундах) означают, что уровень работает; код 404 — что служба работает, но запрошенного объекта нет; код 000 с ошибкой соединения — что на порту никто не принимает соединений, и поиск продолжают уровнем ниже: запущена ли служба, слушает ли она нужный адрес. Если ошибки идут только из одной зоны или с одного экземпляра, разбиение графиков по зонам и экземплярам позволяет сразу сузить поиск до них.
Вопросы к работающему процессу
Слайды к главе. Профилирование медленного скрипта и работающей службы, стеки потоков зависшего процесса, снимки памяти, ожидание в ядре и служба, которая не запускается, изложены также в третьей части лекции «Поиск неисправностей» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Когда поиск сузился до одного процесса, гипотезу проверяют вопросом к самому процессу. Вопрос выбирают по симптому:
| Симптом | Гипотеза | Инструмент |
|---|---|---|
| медленная работа при занятом процессоре | алгоритм, лишняя работа | time, cProfile, py-spy, perf |
| зависание при свободном процессоре | блокировка, ожидание сети или диска | faulthandler, py-spy dump, /proc/PID/wchan, strace |
| рост памяти | удержание объектов ссылками | tracemalloc, /proc/PID/status |
| отказ при запуске | конфигурация, окружение, права | код возврата, systemctl, journalctl |
Во всех случаях предпочтительны инструменты, которые не требуют перезапуска: перезапуск уничтожает именно то состояние процесса, которое необходимо исследовать. Если работу всё же приходится восстанавливать перезапуском, стеки потоков и журналы сохраняют до него.
Медленная работа при занятом процессоре
Ночная обработка, склеивающая события двух файлов детектора и выбрасывающая повторы, по жалобам пользователей стала заметно медленнее. Модель обработки:
import random
import sys
import time
def load(seed, n):
"""Номера событий из файла детектора (модель): часть номеров повторяется."""
rng = random.Random(seed)
return [rng.randrange(4 * n) for _ in range(n)]
def dedup_slow(events):
seen = []
for e in events:
if e not in seen: # поиск в списке: O(n) на каждое событие
seen.append(e)
return seen
def dedup_fast(events):
seen, out = set(), []
for e in events:
if e not in seen: # поиск в множестве: O(1) в среднем
seen.add(e)
out.append(e)
return out
t0 = time.perf_counter()
events = load(1, 12000) + load(2, 12000)
dedup = dedup_fast if sys.argv[1:] == ["fast"] else dedup_slow
unique = dedup(events)
print(f"событий {len(events)}, уникальных {len(unique)}, {dedup.__name__}: {time.perf_counter() - t0:.3f} с")
Первая гипотеза — медленный диск. Если программа ждёт ввода-вывода, её процессорное время заметно меньше реального, и для проверки достаточно команды time; для второй гипотезы, об алгоритме, профиль cProfile показывает, в какой функции проходит время. Программа сохранена в файле slow.py:
$ time python3 slow.py
событий 24000, уникальных 18822, dedup_slow: 0.696 с
real 0m0.713s
user 0m0.706s
sys 0m0.005s
$ python3 -m cProfile -s tottime slow.py | head -9
событий 24000, уникальных 18822, dedup_slow: 0.708 с
148979 function calls (148947 primitive calls) in 0.710 seconds
Ordered by: internal time
ncalls tottime percall cumtime percall filename:lineno(function)
1 0.693 0.693 0.694 0.694 slow.py:12(dedup_slow)
24000 0.005 0.000 0.012 0.000 random.py:284(randrange)
24000 0.005 0.000 0.006 0.000 random.py:235(_randbelow_with_getrandbits)
$ python3 slow.py fast
событий 24000, уникальных 18822, dedup_fast: 0.004 с
Время пользователя, 0,706 с, почти равно реальному, 0,713 с: программа вычисляет, а не ждёт, и гипотеза о диске отвергнута. Профиль относит 0,693 с из 0,710 к функции dedup_slow, которая для каждого события ищет его в списке уже встреченных. Поиск в списке требует времени, пропорционального длине списка, и вся обработка становится квадратичной по числу событий (глава «Сложность операций с коллекциями»). Множество обеспечивает ту же проверку в среднем за постоянное время, и функция dedup_fast обрабатывает те же 24 000 событий за 0,004 с.
Профиль службы, которую нельзя перезапустить, снимают снаружи. Сэмплирующий профилировщик py-spy читает стеки интерпретатора из памяти работающего процесса: команда py-spy top --pid PID показывает функции, в которых процесс проводит время, py-spy record записывает профиль в виде flame graph, а py-spy dump --pid PID печатает текущие стеки всех потоков. Подключение к уже работающему процессу в Linux обычно требует прав root или ослабления ограничения ptrace (параметр ядра kernel.yama.ptrace_scope); процесс, запущенный самим py-spy командой вида py-spy record -- python3 slow.py, профилируется и без них. Команда py-spy dump, выполненная в демонстрации к лекции через 0,3 с после запуска slow.py, показала единственный поток в состоянии active+gil внутри функции dedup_slow, то есть ту же причину, что и профиль cProfile.
Системный профилировщик perf видит функции Python начиная с версии 3.12, если интерпретатор запущен с ключом -X perf или с переменной окружения PYTHONPERFSUPPORT=1 либо программа сама включила поддержку вызовом sys.activate_stack_trampoline("perf"). Поддержка доступна только в Linux и не для всех архитектур; её наличие показывает переменная HAVE_PERF_TRAMPOLINE в выводе python3 -m sysconfig. Отчёт perf report по записи perf record -g той же программы, запущенной с ключом -X perf, в демонстрации к лекции содержит кадры py::dedup_slow и py::<module> с путём к файлу программы. В Python 3.15 в стандартную библиотеку входит сэмплирующий профилировщик profiling.sampling (PEP 799), который также подключается к работающему процессу. Применение профилировщиков к ускорению расчётов разобрано в главе «Причины низкой скорости Python».
Зависание при свободном процессоре
Служба перестала отвечать, а процессор она не загружает. Наиболее вероятные гипотезы — взаимная блокировка потоков или ожидание сети без тайм-аута. Проверкой служат стеки всех потоков: модуль faulthandler стандартной библиотеки печатает их по сигналу, для чего обработчик необходимо зарегистрировать заранее (в Windows функция faulthandler.register недоступна). В модели службы поток архивирования берёт блокировку журнала запусков, а затем калибровок, поток калибровки — в обратном порядке:
import faulthandler
import os
import signal
import sys
import threading
import time
faulthandler.register(signal.SIGUSR1, file=sys.stdout, all_threads=True) # стеки всех потоков по SIGUSR1
runs_lock, calib_lock = threading.Lock(), threading.Lock()
def archiver():
with runs_lock:
time.sleep(0.1)
with calib_lock: # журнал запусков → калибровки
pass
def calibrator():
with calib_lock:
time.sleep(0.1)
with runs_lock: # калибровки → журнал запусков: обратный порядок
pass
for f in (archiver, calibrator):
threading.Thread(target=f, name=f.__name__, daemon=True).start()
time.sleep(0.5)
os.kill(os.getpid(), signal.SIGUSR1) # в работе сигнал посылает администратор: kill -USR1 PID
Запуск программы, сохранённой в файле deadlock.py, с отбором строк стеков, относящихся к ней (команда sed сокращает пути к файлам):
$ python3 deadlock.py | grep -B1 'deadlock.py' | sed 's#"/.*/#"#'
Thread 0x000000016d213000 (most recent call first):
File "deadlock.py", line 22 in calibrator
--
Thread 0x000000016c207000 (most recent call first):
File "deadlock.py", line 15 in archiver
--
Current thread 0x00000001f8372180 (most recent call first):
File "deadlock.py", line 29 in <module>
Поток калибровки ожидает в строке 22 захвата блокировки журнала запусков, поток архивирования — в строке 15 захвата блокировки калибровок, а главный поток находится в строке 29, где он отправил себе сигнал. Каждый из двух потоков удерживает блокировку, которую ждёт другой, и гипотеза о взаимной блокировке подтверждена. Исправление состоит в едином порядке захвата блокировок во всей программе; захват с тайм-аутом (lock.acquire(timeout=…)) не устраняет ошибку, но превращает зависание в обнаружимую ошибку.
Если обработчик заранее не зарегистрирован, те же стеки снаружи показывает команда py-spy dump --pid PID, которая выводит и имена потоков. В демонстрации к лекции она показала потоки archiver и calibrator в состоянии idle на строках захвата второй блокировки, а главный поток, который в программе демонстрации ожидает завершения обоих потоков, — в методе join. Функция faulthandler.dump_traceback_later позволяет устроить сторожевой таймер: если операция не завершилась за заданное время, процесс сам печатает стеки, а после успешного завершения операции таймер отменяют функцией faulthandler.cancel_dump_traceback_later.
Рост памяти
Память службы выдачи графиков растёт с каждым часом работы. Утечка памяти в программе на Python обычно представляет собой не потерю памяти, а удержание ненужных объектов ссылками, поэтому гипотеза формулируется так: объекты удерживает код службы, например кеш без ограничения размера. Проверкой служит модуль tracemalloc, который запоминает, где выделен каждый блок памяти интерпретатора; разность двух снимков, сделанных с интервалом, показывает, где выделена выросшая память.
import linecache
import random
import tracemalloc
rng = random.Random(6)
_cache = {}
def render(run, channel, window):
"""«График» из 50 точек; в настоящей службе — изображение PNG."""
return [float(i * run % 97) for i in range(50)]
def plot(run, channel, window):
key = (run, channel, window)
if key not in _cache:
_cache[key] = render(run, channel, window) # кеш без ограничения размера
return _cache[key]
def serve(n):
for _ in range(n):
plot(rng.randint(1, 5000), rng.randint(1, 40), rng.choice((60, 600, 3600)))
tracemalloc.start(3) # хранить три кадра стека каждого выделения
serve(2000)
before = tracemalloc.take_snapshot()
for r in range(1, 4):
serve(2000)
print(f"раунд {r}: выделено {tracemalloc.get_traced_memory()[0] / 2**20:.1f} МиБ")
top = tracemalloc.take_snapshot().compare_to(before, "traceback")[0]
print(f"наибольший прирост {top.size_diff / 2**20:+.1f} МиБ, {top.count_diff:+d} блоков; стек выделения:")
for frame in reversed(top.traceback): # от места выделения к вызывающим
source = linecache.getline(frame.filename, frame.lineno).split("#")[0].strip()
print(f" строка {frame.lineno}: {source}")
раунд 1: выделено 6.9 МиБ
раунд 2: выделено 10.3 МиБ
раунд 3: выделено 13.7 МиБ
наибольший прирост +9.5 МиБ, +309764 блоков; стек выделения:
строка 11: return [float(i * run % 97) for i in range(50)]
строка 11: return [float(i * run % 97) for i in range(50)]
строка 17: _cache[key] = render(run, channel, window)
Каждые 2000 запросов добавляют около 3,4 МиБ, и рост не прекращается. Наибольший прирост между снимками, 9,5 МиБ в 309 764 блоках, приходится на функцию render, а цепочка вызовов показывает, что эти блоки выделены при заполнении словаря _cache в строке 17: их и удерживает кеш. Строка 11 повторяется потому, что в Python 3.11 включение списка выполняется в собственном кадре стека; начиная с версии 3.12 (PEP 709) такой кадр не создаётся, и в демонстрации к лекции под Python 3.12 цепочка состоит из трёх разных строк — выделения в функции render, присваивания в кеш и вызова из цикла обслуживания запросов. Ключей вида «запуск, канал, окно» неограниченно много, и кеш растёт вместе с числом различных запросов. Исправление — кеш с ограниченным размером, например functools.lru_cache(maxsize=1024): в демонстрации к лекции с ним объём выделенной памяти остаётся равным 1,9 МиБ во всех раундах. Модуль tracemalloc учитывает выделения через распределители памяти Python и те, о которых расширение сообщает само, как NumPy о буферах массивов; память, которую библиотеки на C выделяют без участия интерпретатора, видна лишь в полном объёме памяти процесса (строка VmRSS файла /proc/PID/status).
Ожидание ответа
Если стеки показывают, что поток ожидает завершения чтения из сокета или файла, следующий вопрос задают ядру. В Linux файловая система /proc позволяет увидеть состояние процесса и место ожидания без какой-либо подготовки. Строка State файла /proc/PID/status содержит состояние процесса: S — прерываемое ожидание события, D — непрерываемое ожидание, обычно ввода-вывода. Файл /proc/PID/wchan содержит имя функции ядра, в которой процесс спит, файл /proc/PID/syscall — номер выполняемого системного вызова, его аргументы и значения указателя стека и счётчика команд, а каталог /proc/PID/fd — открытые файлы и сокеты. Команда ss -tnp показывает соединения TCP вместе с процессами и дескрипторами, которым они принадлежат, а strace -p PID — системные вызовы процесса начиная с момента подключения. Состояния процессов и файловая система /proc рассмотрены в главе «Внутреннее устройство Linux».
Рассмотрим программу blocked.py из демонстраций к лекции. Она устроена так же, как листинг в конце раздела, но без тайм-аута: поток той же программы играет роль архива, принимает соединение на порту 8502, читает запрос и не отвечает, а главный поток ждёт ответа в вызове recv. Сеанс записан на виртуальной машине с Ubuntu 24.04 и процессором ARM64; команды выполнены от имени root, поскольку чтение /proc/PID/syscall и подключение strace требуют права трассировать процесс:
$ python3 blocked.py & P=$!; sleep 1
[1] 103008
PID 103008: запрос отправлен, жду ответа без тайм-аута
$ grep State /proc/$P/status; cat /proc/$P/wchan; echo
State: S (sleeping)
wait_woken
$ cat /proc/$P/syscall; ls -l /proc/$P/fd | grep socket
207 0x5 0xa657120 0x400 0x0 0x0 0x0 0xfffff1d70370 0xe9d077d6e428
lrwx------ 1 root root 64 Oct 4 15:57 3 -> socket:[237623]
lrwx------ 1 root root 64 Oct 4 15:57 4 -> socket:[237316]
lrwx------ 1 root root 64 Oct 4 15:57 5 -> socket:[237624]
$ ss -tnp | grep 8502 | tr -s ' '
ESTAB 0 0 127.0.0.1:42790 127.0.0.1:8502 users:(("python3",pid=103008,fd=5))
ESTAB 0 0 127.0.0.1:8502 127.0.0.1:42790 users:(("python3",pid=103008,fd=4))
$ timeout 2 strace -p $P
strace: Process 103008 attached
recvfrom(5, strace: Process 103008 detached
<detached ...>
Процесс находится в состоянии S, обычном для ожидания сети, и спит в функции ядра wait_woken: ожидание прерываемо, и процессор не расходуется. Файл /proc/PID/syscall начинается с номера вызова 207, которым на архитектуре ARM64 обозначается recvfrom (на x86-64 этот вызов имеет номер 45); далее следуют шесть аргументов — дескриптор 5, адрес буфера, длина 0x400, то есть 1024 байта, и три нулевых значения — и значения указателя стека и счётчика команд. Дескрипторы 3, 4 и 5 являются сокетами, а ss показывает, что дескриптор 5 — клиентское соединение с портом 8502, второй конец которого, дескриптор 4, принадлежит тому же процессу; дескриптор 3 — слушающий сокет архива. Клиентский сокет создан раньше, чем архив принял соединение, но получил номер 5: ядро Linux резервирует номер дескриптора за будущим соединением уже в момент вызова accept, а поток архива вызвал accept до создания клиентского сокета. Поэтому принадлежность дескриптора определяют по выводу ss, а не по тексту программы. Наконец, strace застаёт процесс внутри незавершённого вызова recvfrom(5, и отключается по истечении двух секунд, а py-spy dump в той же демонстрации показывает в главном потоке строку программы с вызовом recv. Таким образом, процесс ждёт ответа архива на порту 8502 и без тайм-аута будет ждать его неограниченно долго.
Средняя загрузка (load average) в Linux учитывает не только готовые к выполнению задачи, но и задачи в состоянии D: ожидание диска и сетевой файловой системы, а также некоторые блокировки в ядре. Как показал Б. Грегг, это изменение внесено в Linux ещё в 1993 году намеренно, чтобы средняя загрузка отражала спрос на все ресурсы системы, а не только на процессор. Поэтому рост средней загрузки при свободном процессоре указывает на непрерываемые ожидания, а процесс в состоянии S, как в этом примере, её не увеличивает.
Найденную причину — чтение без тайм-аута — устраняют тайм-аутом на каждую сетевую операцию. В листинге служба принимает соединение и не отвечает, а клиент задаёт тайм-аут при создании соединения:
import socket
import threading
import time
server = socket.create_server(("127.0.0.1", 8502)) # служба принимает соединение и не отвечает
accepted = []
threading.Thread(target=lambda: accepted.append(server.accept()), daemon=True).start()
sock = socket.create_connection(("127.0.0.1", 8502), timeout=0.5) # тайм-аут соединения и каждого чтения
sock.sendall(b"GET /runs/42\n")
t0 = time.monotonic()
try:
sock.recv(1024)
except TimeoutError:
print(f"ответа нет {time.monotonic() - t0:.1f} с: TimeoutError")
ответа нет 0.5 с: TimeoutError
Тайм-аут, переданный функции socket.create_connection, устанавливается на сокет до соединения и поэтому действует и на установление соединения, и на каждую последующую операцию с сокетом. Без него вызов recv ждал бы ответа неограниченно долго, а процесс, как в сеансе выше, находился бы в состоянии S, не загружая процессор.
Отказ при запуске
Служба, которая не запускается, обычно сообщает причину сама — кодом возврата и последними строками журнала. Для понятного сообщения достаточно проверять конфигурацию при старте, а не при первом запросе, и завершаться с явным кодом:
import logging
import os
import sys
logging.basicConfig(stream=sys.stderr, level=logging.INFO, format="%(levelname)s %(message)s")
log = logging.getLogger("archive")
root = os.environ.get("ARCHIVE_DIR", "/srv/archive")
if not os.path.isdir(root): # проверка при старте, а не при первом запросе
log.error("ARCHIVE_DIR=%s: каталог не найден, служба не запущена", root)
sys.exit(78) # EX_CONFIG из sysexits.h: ошибка конфигурации
runs = sorted(f for f in os.listdir(root) if f.endswith(".h5"))
log.info("каталог %s, запусков %d", root, len(runs))
Запуск программы, сохранённой в файле archive_start.py, с ошибкой в имени каталога и с правильным каталогом:
$ ARCHIVE_DIR=/srv/archve python3 archive_start.py; echo "код $?"
ERROR ARCHIVE_DIR=/srv/archve: каталог не найден, служба не запущена
код 78
$ ARCHIVE_DIR=archive python3 archive_start.py; echo "код $?"
INFO каталог archive, запусков 2
код 0
Код 78 соответствует константе EX_CONFIG из заголовочного файла sysexits.h — ошибке конфигурации. Для службы systemd код завершения и состояние юнита выводят команды systemctl status и systemctl show, а сообщение самой службы — команда journalctl -u с именем юнита, поскольку поток ошибок службы попадает в системный журнал. Служба архива с той же проверкой запущена в демонстрации к лекции командой systemd-run как временный юнит l20-archive с переменной окружения ARCHIVE_DIR=/tmp/l20rec/archve:
$ systemctl show -p ActiveState,Result,ExecMainStatus l20-archive
Result=exit-code
ExecMainStatus=78
ActiveState=failed
$ journalctl -u l20-archive -o cat -S -1min | tail -3
ERROR ARCHIVE_DIR=/tmp/l20rec/archve: каталог не найден, служба не запущена
l20-archive.service: Main process exited, code=exited, status=78/CONFIG
l20-archive.service: Failed with result 'exit-code'.
Юнит находится в состоянии failed с результатом exit-code, а свойство ExecMainStatus содержит код завершения главного процесса, 78; в журнале systemd сам расшифровывает его как 78/CONFIG. Первая строка журнала — сообщение самой службы, и оно сразу указывает на причину. После исправления имени каталога служба запустилась, и запрос curl к ней вернул список запусков ["run0041.h5", "run0042.h5"]. Принцип немедленного отказа (fail fast) превращает отказ при первом запросе пользователя, часы спустя после выкатки, в отказ при запуске, который виден сразу и указывает на причину.
Управление инцидентом
Слайды к главе. Первые действия при отказе, оценка последствий, роли участников и документ инцидента изложены также в четвёртой части лекции «Поиск неисправностей»; слайды лекции доступны на сайте книги и в PDF.
Инцидент представляет собой отказ, для устранения которого недостаточно действий одного дежурного: требуются согласованная работа нескольких человек, сообщения пользователям и запись хода работ. Метод и инструменты предыдущих разделов при этом остаются прежними, но добавляются вопросы организации: кто принимает решения, кто сообщает пользователям о ходе работ, где записываются действия.
Первые минуты
Первое побуждение при крупном отказе — начать искать причину. Книга Google SRE рекомендует ему не следовать и сначала восстановить работу системы настолько, насколько это возможно в сложившихся обстоятельствах: перевести запросы с отказавшего кластера на исправные, сбросить часть запросов, чтобы не допустить каскадного отказа, или отключить отдельные подсистемы и тем снизить нагрузку [23]. Поиск причины может занять часы, а пользователи всё это время остаются без обслуживания; кроме того, поспешные действия в состоянии тревоги порождают новые ошибки. Восстановление, как отмечает та же книга, не отменяет сохранения свидетельств: журналы, стеки потоков и снимки состояния снимают до перезапуска, иначе причину придётся устанавливать по памяти участников. Если отказ последовал за выкаткой, первым действием является откат. Откат невозможен, если новая версия необратимо изменила данные, например схему базы; поэтому изменения схемы проводят в два этапа — сначала расширение, совместимое со старой и новой версиями программы, и лишь после выкатки удаление старого, — и тогда откат программы остаётся безопасным. Необратимые действия во время инцидента, такие как удаление данных, выполняют только после создания копии.
Масштаб последствий
Одновременно с восстановлением оценивают масштаб: сколько пользователей и какие функции затронуты, все ли зоны отказали или одна. Масштаб определяет срочность и подсказывает меры, которые снимают последствия до того, как найдена причина: вывести отказавшую зону из балансировки, отключить функцию, переключить запросы на резервную площадку, добавить экземпляры. Те же сведения позже определяют, нужен ли подробный разбор инцидента.
Роли
При инциденте, в котором участвуют несколько человек, книга Google SRE выделяет четыре роли [23]. Командир инцидента владеет общей картиной, распределяет задачи по необходимости и приоритету и ведёт живой документ инцидента, что книга называет его важнейшей обязанностью; роли, которые он никому не передал, командир исполняет сам. Операционная работа — изменения в системе, причём во время инцидента систему изменяет только эта группа. Коммуникации — регулярные сообщения участникам и заинтересованным лицам о ходе работ, а при необходимости и поддержание документа инцидента. Планирование — поддержка остальных: заявки на последующие задачи, смена дежурных, учёт того, чем система отклонилась от обычного состояния, чтобы после инцидента вернуть её обратно. Командование передаётся явно, с подтверждением принявшего.
Объявлять инцидент та же книга рекомендует рано: лучше быстро найти простое исправление и закрыть уже объявленный инцидент, чем запускать процедуру через несколько часов после начала разрастающейся проблемы. Событие считается инцидентом, если выполнено хотя бы одно из условий: для устранения необходимо привлечь вторую команду; отказ заметен пользователям; проблема не решена после часа сосредоточенного анализа. В группе из трёх человек роли совмещаются, но совмещаются явно: должно быть известно, кто принимает решения и кто сообщает о ходе работ.
Документ инцидента
Все действия записываются по ходу работы в общий документ, доступный участникам: время, кто, что сделал и что увидел, выдвинутые гипотезы и результаты их проверки. Документ позволяет новому участнику войти в работу без дополнительных вопросов к остальным, предотвращает повторные проверки и является основой последующего разбора. Подойдёт любой общий документ или канал в мессенджере: любая форма записи лучше её отсутствия. Образец документа приведён в приложении «Example Incident State Document» книги Google SRE [23]; кроме хронологии, в нём записаны распределение ролей, текущее состояние и критерии завершения инцидента. Пример начала документа для отказа архива из главы «Наблюдаемость»:
Инцидент: архив отвечает ошибкой 500 на выдачу запусков
Командир: А.; изменения в системе: Б.; сообщения смене: В.
Начало: 02:00 (по графику ошибок); объявлен: 02:43 (оповещение о бюджете ошибок)
Последствия: 2 % запросов с ошибкой, смена не открывает запуски 41–42
Критерий завершения: ошибок меньше 0,1 % запросов в течение 30 мин
Хронология:
02:43 оповещение ArchiveErrorBudgetBurnFast, дежурный подтвердил
02:47 ошибки только в зоне B; гипотеза: отказ экземпляров зоны B
03:00 зона B выведена из балансировки, ошибок нет
03:01 оповещение снято
Гипотезы: реплика базы зоны B отстала — проверяется (отставание WAL)
Задачи после инцидента: —
Инцидент на установке
Смена ускорительного комплекса действует по тем же правилам. Роль командира исполняет начальник смены, документом инцидента служит электронный журнал смены, а сообщения экспериментаторам о ходе работ соответствуют роли коммуникаций. Правила, выработанные эксплуатацией установок, — сначала перевести установку в безопасное состояние, затем искать причину; не менять два параметра одновременно; записывать каждое действие с временем — совпадают с правилами эксплуатации программ. Ту же аналогию из авиации приводит книга Google SRE: первая обязанность пилота при отказе — продолжать управлять самолётом и благополучно посадить его, а поиск неисправности вторичен [23]. Программная служба установки, отказавшая во время сеанса, разбирается теми же людьми и по тому же журналу, что и отказ оборудования.
Разбор инцидента
Слайды к главе. Разбор инцидента без поиска виноватых, структура отчёта и измерение инцидентов изложены также в пятой части лекции «Поиск неисправностей»; слайды лекции доступны на сайте книги и в PDF.
Разбор без поиска виноватых
Разбор инцидента (postmortem) представляет собой письменный отчёт об инциденте: его последствиях, действиях по их смягчению и устранению, корневых причинах и задачах, предотвращающих повторение. Книга Google SRE называет безобвинительный разбор основой культуры SRE: он выявляет способствующие причины инцидента, не обвиняя человека или команду, и исходит из того, что каждый участник действовал с добрыми намерениями и правильно в меру тех сведений, которые у него были [23]. Обоснование практическое: если за ошибку наказывают, участники скрывают подробности, и организация лишается сведений, необходимых для исправления системы. Такой подход пришёл из здравоохранения и авиации, где ошибка может стоить жизни. Ошибка человека рассматривается в нём как следствие устройства системы — отсутствия проверки, неудобного интерфейса, непротестированной процедуры: изменить людей нельзя, а изменить системы и процессы можно.
Случаи, в которых разбор обязателен, книга советует определить заранее и приводит типичные поводы: простой или ухудшение обслуживания, заметные пользователям, сверх установленного порога; потеря данных любого объёма; вмешательство дежурного (откат, переключение запросов); время устранения сверх порога; отказ мониторинга, когда проблема обнаружена вручную. Кроме того, разбор может запросить любой заинтересованный участник [23].
Структура отчёта
Шаблон разбора, приведённый в книге Google SRE, содержит краткое описание, последствия, корневые причины, триггер, способ устранения, способ обнаружения, задачи с типом, владельцем и номером заявки, уроки и хронологию [23]. Различие корневой причины и триггера существенно: причина — скрытый дефект, существовавший до инцидента, триггер — событие, которое его проявило; в примере книги триггером скрытой ошибки стал внезапный рост трафика. В первом учебном случае ниже триггером стал небольшой рост нагрузки, а причиной — число потоков 4000 вместо 40 в конфигурации, выкаченной двумя неделями раньше. Устранение триггера ничего не исправляет: следующий рост нагрузки приведёт к тому же отказу. Уроки записывают в трёх разделах: что прошло хорошо, что прошло плохо и где повезло. Последний раздел предназначен для случаев, когда худшего исхода удалось избежать лишь благодаря случайности, на которую в следующий раз рассчитывать нельзя. Хронологию разбора составляют по документу инцидента, дополняя её другими событиями.
По каждому инциденту записывают также время обнаружения и локализации и источник обнаружения — оповещение или сообщение пользователя. Как показано в главе «Наблюдаемость», средние значения этих отрезков за квартал при малом числе инцидентов не позволяют судить о тренде [54]; полезнее разбирать каждый случай отдельно и следить, чтобы отказы обнаруживались мониторингом, а не пользователями.
Тренировка: «колесо неудачи»
Слайды к главе. Правила упражнения и три учебных случая с демонстрациями изложены также в шестой части лекции «Поиск неисправностей»; слайды лекции доступны на сайте книги и в PDF.
Навык поиска неисправностей тренируют до настоящего отказа. Для этого в книге Google SRE описано регулярное, нередко еженедельное упражнение «колесо неудачи» (Wheel of Misfortune), которое представляет собой ролевой разбор аварии [23]. Ведущий заранее готовит сценарий — часто по прошлому отказу, а иногда по возможному отказу новой функции — и назначает двух участников основным и запасным дежурными. В рамках упражнения ведущий объявляет оповещение, дежурные говорят, что сделали бы для восстановления работы и поиска причины, и запрашивают графики, журналы и результаты команд, а ведущий сообщает, что эти графики и команды показали бы; остальные участники наблюдают. В течение 30–60 минут дежурные ищут причину, а ведущий при необходимости возвращает их от ложных следов к существу дела. Упражнение проверяет не знание правильного ответа, а порядок действий: восстановление, сужение поиска, гипотезы с ожидаемым результатом. Для группы физиков сценарием служит отказ собственной установки или её программ. Ниже разобраны три случая; в каждом гипотезы проверялись по порядку, и каждый закончился уроками для системы, а не для людей.
Случай 1: ошибки после выкатки
Служба реконструкции событий выполняет вычисления по запросам, работает на 16-ядерных машинах в трёх зонах и обслуживает каждый запрос отдельным потоком из пула. Пользователи получают ошибку 500 от балансировщика. Журнал балансировщика показывает, что ошибки отдают экземпляры одной зоны, на которую недавно выкатился новый выпуск; выпуск откатывают, и ошибок становится меньше, но их доля остаётся выше цели. Зону выводят из балансировки, однако её нагрузка переходит на две другие зоны, и ошибки растут и там, хотя новый выпуск на них не выкатывался. Метрики пула показывают, что заняты все 4000 потоков. Следующее действие — увеличение пула до 16 000 потоков — только ухудшает положение: средняя загрузка растёт, все 16 процессорных ядер заняты, причём в основном системным временем, то есть работой ядра операционной системы, а не кодом службы. Уменьшение пула до 8000 потоков улучшает положение, а до 16, по числу ядер, снижает долю ошибок ниже цели.
Работа службы ограничена процессором, и ядер не прибавилось: пропускная способность определяется шестнадцатью ядрами и от числа потоков не зависит. Оценим последствия по закону Литтла из главы «Системный дизайн»: среднее число запросов, одновременно находящихся в обработке, равно произведению пропускной способности на среднее время пребывания запроса в службе. При неизменной пропускной способности увеличение числа одновременно обрабатываемых запросов в той же пропорции увеличивает время каждого из них, а планирование и переключение тысяч потоков отнимает у полезной работы ещё и процессорное время.
Рассмотрим поведение пула при вычислительной нагрузке на демонстрации к лекции. Пачка из 40 запросов, каждый из которых около 20 мс процессорного времени вычисляет хеши SHA-256, приходит одновременно и обрабатывается на двух ядрах пулами из 2, 8 и 40 потоков; модуль hashlib освобождает GIL при хешировании больших буферов, поэтому потоки вычисляют параллельно. Во всех трёх случаях пачка обработана за 0,41–0,42 с, и 99-й перцентиль задержки запроса остался на уровне 415–424 мс, но медиана задержки выросла с 218 до 252 и 365 мс, а число вынужденных переключений контекста — со 146 до 506 и 537.
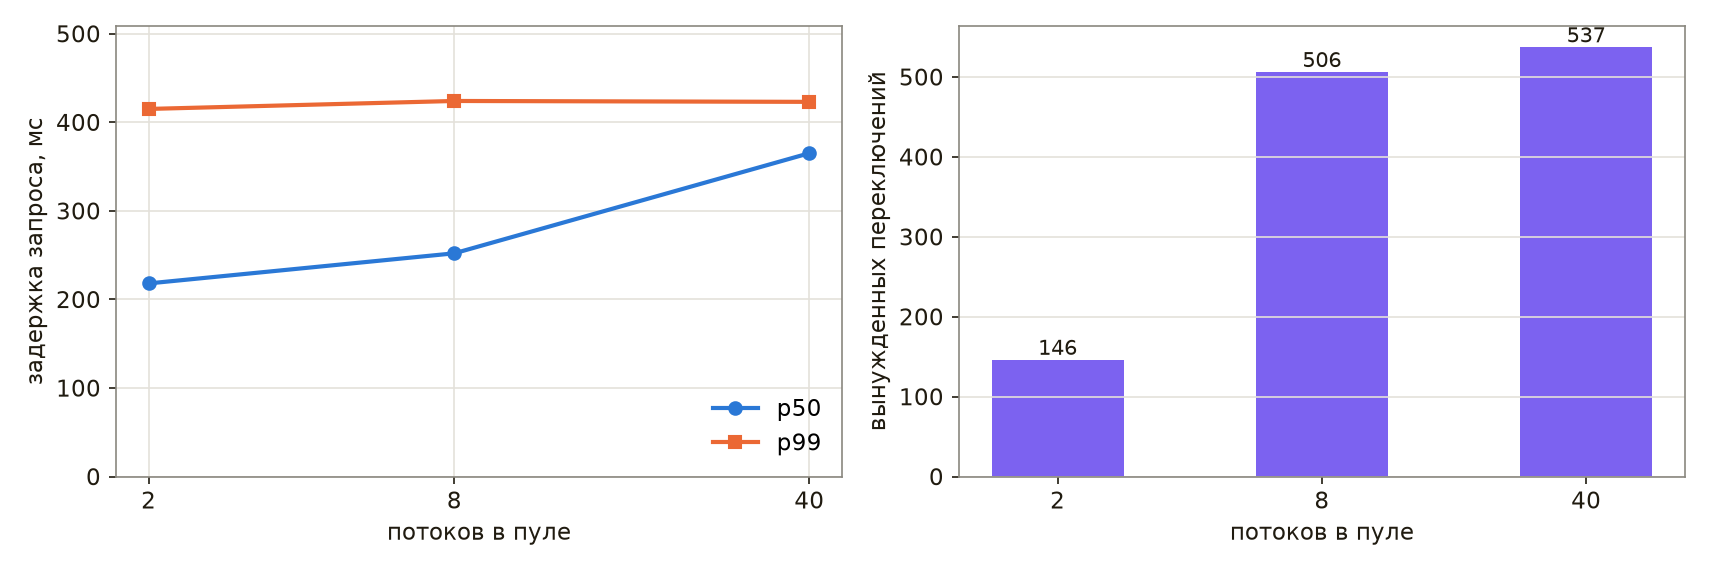
При числе потоков, равном числу ядер, запросы обслуживаются по очереди, и половина из них завершается в первой половине пачки; при потоке на запрос все запросы делят процессор и почти все завершаются к её концу. Системное время в модели остаётся пренебрежимо малым: переключения сорока потоков обходятся дёшево, а в разобранном случае потоков было в сотни раз больше. Если служба в основном ждёт сеть или диск, процессор не ограничивает пропускную способность, и необходимое число исполнителей оценивают по тому же закону Литтла как произведение потока запросов на время обработки.
Разбор показал, что две недели назад в конфигурацию вместо 40 потоков попало число 4000, а автор изменения сам одобрил свой запрос на слияние с сообщением «Better». Триггером отказа стал небольшой рост нагрузки, корневой причиной — ошибка в конфигурации, которую никто не проверял. Уроки случая: проверка конфигурации с пределами перед выкаткой (скрипт check_config.py из раздела «Поиск последнего изменения»); обязательное ревью другим разработчиком; постепенная выкатка, при которой рост системного времени заметен уже на первых машинах; системное время процессора по зонам — на панели, а не в оповещении, поскольку дежурного вызывают по симптому, доле ошибок. Решение увеличить пул вчетверо было принято без формулировки ожидаемого результата и без указания, на какие графики смотреть, то есть без гипотезы.
Случай 2: отказ в доступе из одной зоны
Служба выдачи доступа к данным эксперимента проверяет короткоживущие токены пользователей. Новые токены записываются на главный сервер базы, а проверяются по реплике той зоны, в которой обслуживается запрос; если реплика отстала, свежего токена на ней ещё нет, и служба отвечает 403. Пользователи получают ответ 403, хотя выпусков за неделю не было, а сеть исправна. Графики по зонам, построенные после первого случая, показывают, что доля ответов 403 растёт только в одной зоне, и эту зону выводят из балансировки: последствия сняты, хотя причина не найдена. В базе этой зоны отставание воспроизведения журнала WAL на реплике растёт линейно, а на соседней реплике близко к нулю. На сервере реплики процессор и память свободны, места на диске достаточно, чтение быстрое, а запись идёт медленно. Массив RAID 10 из четырёх дисков пишет каждый блок данных на оба диска зеркальной пары и ждёт медленного из них, а чтение может обслужить исправный диск, поэтому деградирующий диск проявляется именно при записи. Для самого массива столбец %util утилиты iostat предела не показывает: по справочной странице iostat(1), для устройств, обслуживающих запросы параллельно, таких как RAID-массивы и современные SSD, это число не отражает предела производительности. Показательнее среднее время записи w_await каждого диска массива: у трёх дисков оно составляет 5–10 мс, у четвёртого — 800 мс. Диск выводят из массива, и реплика догоняет главный сервер.
Оповещение по абсолютному порогу времени записи здесь бесполезно: у шпиндельных дисков это время растёт под любой дневной нагрузкой. Модель из демонстраций к лекции воспроизводит сутки записи четырёх дисков массива, один из которых с 13:00 деградирует. Порог 20 мс, превышенный пять минут подряд, срабатывает днём на всех четырёх дисках, между 12:46 и 13:50, а на трёх исправных дисках за сутки насчитывается 262 пересечения порога снизу вверх. Правило «время записи диска больше трёх медиан его соседей по массиву в течение пяти минут» позволяет отличить деградацию от дневного роста нагрузки и срабатывает только для деградирующего диска, в 15:02; в 15:00 его время записи составляло 80,9 мс против 17,2–21,1 мс у соседей.
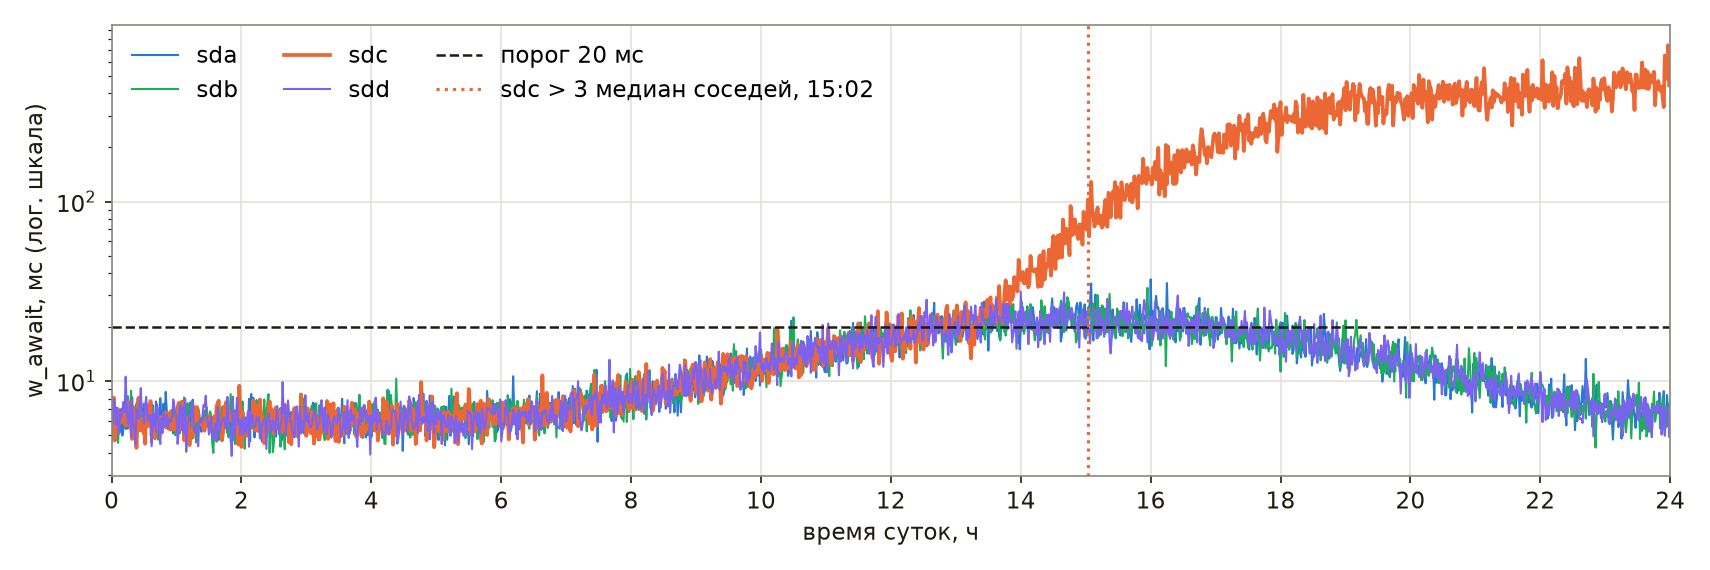
Показатели SMART такой отказ могут и не выдать: в исследовании более ста тысяч дисков, проведённом в Google, более чем у 36 % отказавших дисков все показатели SMART, кроме температуры, оставались нулевыми, и авторы заключили, что построить по одним показателям SMART модель, предсказывающую отказ отдельного диска, вряд ли удастся [55]. Сравнение с соседями знакомо физикам по одинаковым датчикам одного участка: показание вакуумметра, отличающееся от соседних в несколько раз, подозрительнее показания, превысившего абсолютный порог вместе со всеми. Уроки случая: оповещение об отставании реплики; правило аномалии дисков относительно соседей; сквозная проверка пользовательского сценария — вход и получение данных, — которая обнаружила бы ответы 403 до обращений пользователей; приложение, которое не читает из отставшей реплики.
Случай 3: отравленное сообщение
Конвейер обработки событий устроен так: события оцифровщиков поступают в очередь Kafka, потребитель разбирает заголовок каждого события, записывает событие в поисковый индекс и фиксирует смещение (offset) прочитанного. Смена сообщает, что новые события в индексе не находятся. Запись в индекс снизилась почти до нуля, а запись в очередь продолжается, следовательно, проблема находится между ними. Потребитель загружает процессор: он завершается с ошибкой разбора, перезапускается с последнего зафиксированного смещения и снова завершается на том же событии. Журнал потребителя содержит ошибку разбора незнакомого поля заголовка: оцифровщик с новой прошивкой прислал событие нового формата. Такое сообщение, которое потребитель не может обработать и на котором останавливается вся очередь, называют отравленным (poison message). Исправить разбор может только разработчик, который недоступен, поэтому проблемное событие сохраняют, а смещение потребителя сдвигают вручную на одно сообщение, и отставание начинает сокращаться.
Масштаб отказа показывает модель из демонстраций к лекции. События поступают со скоростью 100 в секунду, потребитель способен обрабатывать до 150 событий в секунду, перезапуск занимает 2 с, а событие нового формата приходит на 20-й секунде. Без защиты потребитель перезапускается 20 раз за 40 с, не продвигаясь, и отставание растёт на 1000 событий каждые 10 с, достигая 4000 к 60-й секунде. Если событие после трёх неудачных попыток откладывается в отдельную очередь недоставленных сообщений (dead letter queue), потребитель перезапускается дважды; отставание достигает 420 событий на 24-й секунде и к 33-й секунде исчезает.
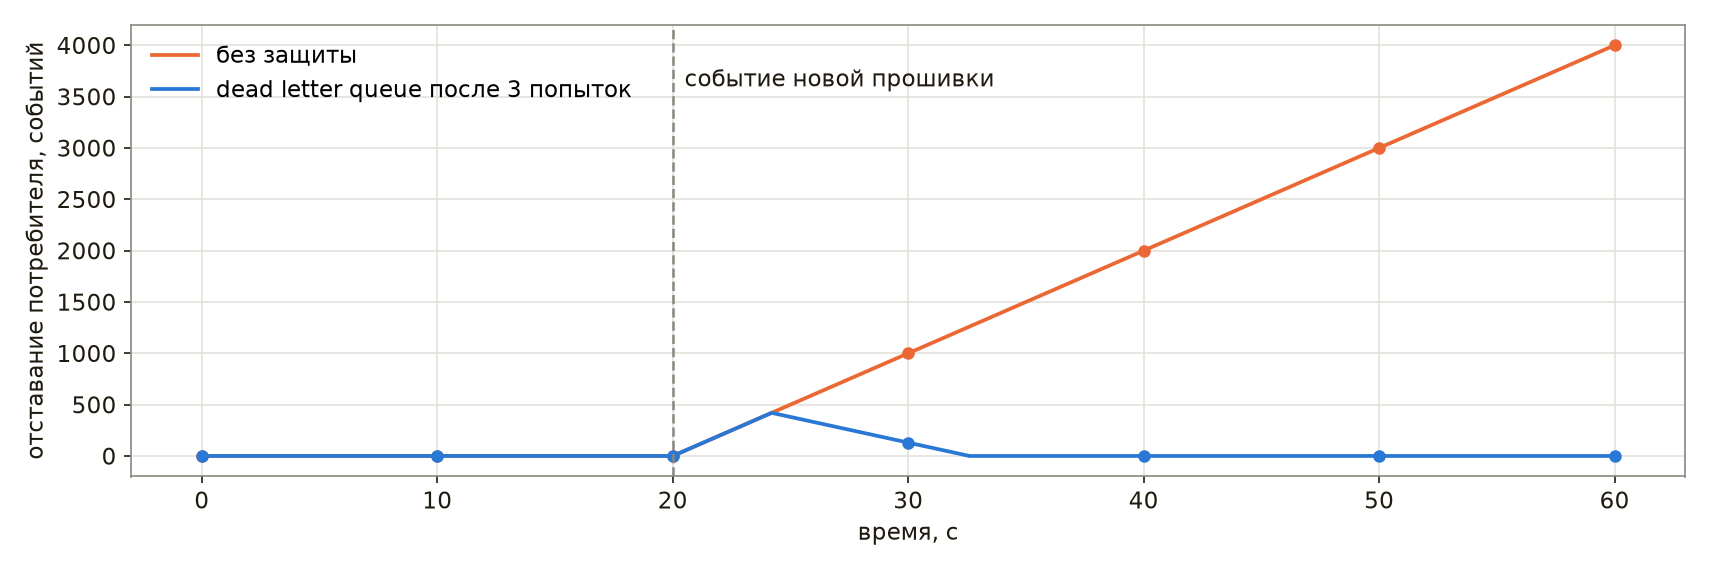
Схема обработки с ограниченным числом попыток умещается в несколько строк:
import json
queue = [json.dumps({"fw": 2, "event": i}) for i in range(6)]
queue.insert(3, json.dumps({"fw": 3, "event": 0})) # событие оцифровщика с новой прошивкой
MAX_ATTEMPTS = 3
def parse(raw):
msg = json.loads(raw)
if msg["fw"] != 2:
raise ValueError(f"неизвестный формат заголовка fw={msg['fw']}")
return msg["event"]
offset, attempts, indexed, dlq = 0, 0, [], []
while offset < len(queue):
try:
indexed.append(parse(queue[offset]))
except ValueError as e:
attempts += 1
print(f"смещение {offset}, попытка {attempts}: {e}")
if attempts < MAX_ATTEMPTS:
continue # повтор того же сообщения
dlq.append(queue[offset]) # отложить для разбора человеком
offset, attempts = offset + 1, 0 # зафиксировать смещение
print("проиндексировано:", indexed)
print("в очереди недоставленных:", dlq)
смещение 3, попытка 1: неизвестный формат заголовка fw=3
смещение 3, попытка 2: неизвестный формат заголовка fw=3
смещение 3, попытка 3: неизвестный формат заголовка fw=3
проиндексировано: [0, 1, 2, 3, 4, 5]
в очереди недоставленных: ['{"fw": 3, "event": 0}']
В Amazon SQS очередь недоставленных сообщений задаётся политикой повторной доставки (redrive policy): сообщение, полученное потребителями больше заданного числа раз (maxReceiveCount), переносится в неё. В Kafka для обычных групп потребителей такую очередь реализует код потребителя, коннекторы-приёмники Kafka Connect или, начиная с версии 4.2, обработчики исключений Kafka Streams. Группы с разделяемым чтением (share groups, KIP-932), готовые к промышленному использованию с той же версии, сами ведут счётчик доставок каждой записи и после пяти неудачных попыток (значение по умолчанию) перестают выдавать её потребителям. Уроки случая: очередь недоставленных сообщений и оповещение о её росте; оповещение об отставании потребителя; индикатор свежести, которым является время последней записи в индекс по каждому шарду; запасной план, проверяемый на учениях, иначе в момент отказа он не сработает.
Упражнения
- Провести в группе упражнение «колесо неудачи» по сценарию отказа своей установки или программы: ведущий, основной и запасной дежурные, 30 минут.
- Найти и исправить взаимную блокировку, утечку памяти и ожидание без тайм-аута в программах этой главы, сформулировав для каждой гипотезу, способ проверки и ожидаемый результат.
- Написать разбор учебного инцидента по шаблону книги Google SRE, используя хронологию из раздела «Частичные отказы и разные часы».
- Добавить в свою службу обработчик
faulthandlerпо сигналу SIGUSR1 и проверку конфигурации при старте с кодом завершения 78.
Резюме
Поиск неисправностей является методом, а не искусством: каждая гипотеза о причине формулируется вместе со способом проверки и ожидаемым результатом, отрицательный результат сужает поиск, а одновременно меняется только один параметр. Отказ распределённой системы частичен, и хронологию собирают по идентификаторам запросов и связям спанов, а не по часам разных машин. Около 70 % отказов, по оценке книги Google SRE, вызваны изменениями, поэтому первым действием служит откат, а среди многих изменений виновное находит деление пополам. Работающий процесс отвечает на вопросы без перезапуска: профиль показывает, где тратится процессорное время, стеки потоков — где процесс ждёт, снимки tracemalloc — где выделена удерживаемая память, /proc и strace — чего процесс ждёт от ядра, а код возврата и журнал — почему служба не запустилась.
Таким образом, при инциденте сначала восстанавливают работу и снимают последствия, затем ищут причину; роли командира, исполнителей и коммуникаций распределяют явно, а действия записывают в общий документ. Безобвинительный разбор отделяет корневую причину от триггера и превращает инцидент в задачи, которые исправляют систему, а упражнение «колесо неудачи» позволяет отработать порядок действий до настоящего отказа.
Полезные ссылки
- Site Reliability Engineering, главы «Effective Troubleshooting», «Emergency Response», «Managing Incidents», «Postmortem Culture: Learning from Failure», «Accelerating SREs to On-Call and Beyond» и приложения «Example Incident State Document» и «Example Postmortem» [23];
- Fallacies of distributed computing — восемь заблуждений о сети;
- документация Python: faulthandler, tracemalloc, профилировщики и поддержка perf;
- py-spy — сэмплирующий профилировщик для работающих процессов Python;
- git bisect — поиск изменения делением пополам;
- B. Gregg. Linux Load Averages: Solving the Mystery — что учитывает средняя загрузка в Linux;
- справочные страницы iostat(1), strace(1), ss(8) и proc(5);
- Amazon SQS: dead-letter queues и KIP-932: Queues for Kafka — очереди недоставленных сообщений и счётчик доставок;
- E. Pinheiro, W.-D. Weber, L. A. Barroso. Failure Trends in a Large Disk Drive Population — статистика отказов дисков и показателей SMART [55].
Научные библиотеки Python
Python является языком общего назначения: стандартная библиотека даёт модули math, cmath, statistics и random, но не массивы и не линейную алгебру. Всё остальное, ради чего его применяет физик, сосредоточено в библиотеках, и набор их невелик.
Порядок изложения следует зависимостям. NumPy предоставляет быстрый многомерный массив, на котором основано всё остальное, и вместе с pandas, предназначенным для работы с таблицами, обеспечивает хранение и первичную обработку данных. SciPy надстраивает над массивом численные методы: интегрирование, решение уравнений, оптимизацию, подгонку кривых, обработку сигналов, преобразование Фурье. Почти всё, что физику приходится вычислять, там уже реализовано и проверено. Далее рассматривается построение графиков, где Matplotlib остаётся основным инструментом, а HoloViews устроен иначе: в нём описывается, какие данные имеются, а не способ их отрисовки, и библиотека сама выбирает подходящий вид графика, делая его интерактивным.
Завершается раздел машинным обучением, для которого всё перечисленное служит фундаментом.
Слайды к главе. NumPy, pandas и SciPy, с которых начинается раздел, изложены также в лекции «NumPy, pandas и SciPy» (устройство массива, индексация и векторные операции, типы и файлы, таблицы, группировка и временные ряды, численные методы) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Устройство языка — объекты, коллекции, функции и классы — рассматривалось в разделе «Язык Python». Здесь язык считается известным.
Читателю, не знакомому с базовым синтаксисом, рекомендуется начать с электронной версии. В неё входят главы с основами языка, с NumPy и с Matplotlib, не вошедшие в печатное издание: их место заняли темы, которые нельзя прочитать в документации за десять минут. В печатном издании NumPy разобран в следующей главе вместе с pandas, а Matplotlib — в главе про визуализацию.
Почти весь код этой части набран в блокноте Jupyter — странице, разбитой на ячейки, где каждая ячейка выполняется отдельно и оставляет результат под собой, а имена, введённые в одной ячейке, сохраняются и доступны следующим. Строки, начинающиеся со знака процента, являются не кодом Python, а магическими командами IPython, оболочки, на которой работает блокнот. Одиночный % действует на строку, в которой стоит, так что %timeit sorted(data) измерит время этого вызова; двойной %%, поставленный первой строкой ячейки, распространяется на неё целиком, и %%timeit измерит всё написанное ниже. %load_ext подключает расширение IPython: с его помощью включается, например, построчный профилировщик, рассматриваемый в части «Ускорение расчётов». В обычном скрипте, запущенном через python file.py, ни одна из этих строк не работает, поэтому при переносе кода отсюда в файл их необходимо удалить.
NumPy и pandas
Физик обращается к языку программирования ради данных, поэтому начать целесообразно с инструментов, приспособленных для быстрых вычислений над ними. В настоящей главе рассматриваются две библиотеки: NumPy, предоставляющая многомерный массив чисел одного типа, и pandas, предоставляющая таблицу с именованными столбцами разных типов. Все примеры выполнены в IPython на одной машине — виртуальной машине с двумя ядрами под Python 3.12 с NumPy 2.5 и pandas 3.0, на которой записаны демонстрации лекции «NumPy, pandas и SciPy».
Слайды к главе. Устройство массива, индексация, векторные операции, типы элементов и чтение файлов изложены также в первых трёх частях лекции «NumPy, pandas и SciPy» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
NumPy
Python поначалу разочаровывает: список из миллиона чисел занимает десятки мегабайт, а цикл по нему выполняется очень долго. Причины, рассмотренные в главе про объекты и память, сводятся к одному: каждое число в списке является отдельным объектом со своей обёрткой, размещённым где-то в куче.
Решением является NumPy. Идея заключается в том, чтобы хранить числа так, как их хранит C, то есть подряд, одного типа, без обёрток, а операции над ними передавать скомпилированному коду, работающему сразу над всем массивом. Выигрыш достигает сотен раз. На NumPy построен научный стек: SciPy, pandas, scikit-learn и библиотеки машинного обучения используют массивы NumPy.
Полная документация: numpy.org/doc.
NumPy решает две задачи:
- хранить многомерные массивы (в том числе матрицы);
- быстро считать математические функции сразу от всего массива.
Основой библиотеки является один объект, ndarray.
Отличия массива от списка:
- длина массива, заданная в момент создания, остаётся неизменной, тогда как список растёт динамически;
- все элементы массива одного типа;
- операции пишутся сразу над массивом целиком, без цикла.
Отсюда следуют две сильные стороны NumPy: векторизация и broadcasting.
import sys
import numpy as np
lst = [float(i) for i in range(10**6)]
print(sys.getsizeof(lst) + sum(sys.getsizeof(v) for v in lst))
print(np.array(lst).nbytes)
32448728
8000000
Список из миллиона вещественных чисел вместе с объектами-числами занимает около 32,4 МБ: 8,4 МБ приходится на массив ссылок самого списка, 24 МБ — на объекты float по 24 байта. Массив NumPy хранит те же числа подряд, по 8 байт на число, и занимает ровно 8 МБ.
Устройство массива
Массив состоит из буфера данных и заголовка, описывающего, как этот буфер читать: тип элементов dtype, форму shape — длину по каждой оси — и шаги strides, то есть сдвиги в байтах при увеличении индекса по каждой оси на единицу.
m = np.arange(12.0).reshape(3, 4)
print(m.dtype, m.shape, m.ndim, m.strides, m.itemsize, m.nbytes)
t = m.T
print(t.shape, t.strides, np.shares_memory(m, t))
float64 (3, 4) 2 (32, 8) 8 96
(4, 3) (8, 32) True
Матрица 3×4 из float64 записана по строкам: переход к следующему столбцу сдвигает адрес на 8 байт, к следующей строке — на 32 байта, поэтому адрес элемента m[i, j] равен началу буфера плюс 32·i плюс 8·j. Транспонирование не переставляет числа в памяти, а меняет шаги местами и возвращает представление — новый заголовок над тем же буфером. Метод reshape тоже возвращает представление, если новую форму можно описать шагами над тем же буфером, а иначе копирует данные:
np.shares_memory(m.reshape(2, 6), m), np.shares_memory(m.T.reshape(12), m)
(True, False)
Столбцы матрицы m не лежат в буфере подряд, поэтому вытянуть транспонированную матрицу в вектор без копирования нельзя.
Способы создания массивов
Массив может быть получен тремя способами: преобразованием из обычной структуры Python, генерацией встроенной функцией или чтением с диска. Все три способа встречаются примерно одинаково часто.
Конвертация из структур Python
np.array([1, 2, 3, 4, 5])
array([1, 2, 3, 4, 5])
При конвертации можно задавать тип данных с помощью аргумента dtype:
np.array([1, 2, 3, 4, 5], dtype=np.float32)
array([1., 2., 3., 4., 5.], dtype=float32)
Аналогичное преобразование:
np.float32([1, 2, 3, 4, 5])
array([1., 2., 3., 4., 5.], dtype=float32)
Генерация массивов
- arange работает как аналог range из Python, но принимает и нецелочисленный шаг;
- linspace равномерно разбивает отрезок на n − 1 интервал, включая оба конца;
- logspace разбивает отрезок по логарифмической шкале;
- zeros создаёт массив заданной размерности, заполненный нулями;
- ones создаёт массив заданной размерности, заполненный единицами;
- empty создаёт массив заданной размерности, не инициализированный никаким значением, то есть заполненный прежним содержимым памяти.
np.arange(0, 5, 0.5)
array([0. , 0.5, 1. , 1.5, 2. , 2.5, 3. , 3.5, 4. , 4.5])
np.linspace(0, 5, 11)
array([0. , 0.5, 1. , 1.5, 2. , 2.5, 3. , 3.5, 4. , 4.5, 5. ])
np.logspace(0, 9, 10, base=2)
array([ 1., 2., 4., 8., 16., 32., 64., 128., 256., 512.])
np.zeros((2, 2))
array([[0., 0.],
[0., 0.]])
np.ones((2, 2))
array([[1., 1.],
[1., 1.]])
np.empty((2, 2))
array([[1., 1.],
[1., 1.]])
Значения в массиве np.empty — то, что осталось в выделенной памяти; здесь это единицы из только что освобождённого массива. Пользоваться таким массивом можно лишь при немедленной записи всех его элементов.
np.diag([1, 2, 3])
array([[1, 0, 0],
[0, 2, 0],
[0, 0, 3]])
С дробным шагом число точек arange зависит от округления. Число точек равно округлённому вверх частному (0,8 − 0,5) / 0,1, которое из-за двоичного округления чуть больше трёх, поэтому сетка содержит четыре точки, а последняя из них чуть меньше 0,8 и печатается как 0.8:
print(np.arange(0.5, 0.8, 0.1))
print(np.arange(0.5, 0.8, 0.1)[-1], np.linspace(0.5, 0.8, 4)[-1])
[0.5 0.6 0.7 0.8]
0.7999999999999999 0.8
Правую границу, которую arange по определению исключает, сетка фактически содержит. Когда известно число точек, сетку на отрезке строят функцией linspace: она включает обе границы точно.
Случайные числа даёт генератор np.random.default_rng. Зерно, переданное явно, делает расчёт воспроизводимым, а методы генератора normal, uniform, integers задают распределение. Функции np.random.rand и np.random.seed относятся к старому интерфейсу с глобальным состоянием и сохранены для совместимости.
rng = np.random.default_rng(42)
rng.normal(0.0, 1.0, size=3)
array([ 0.30471708, -1.03998411, 0.7504512 ])
Размеры массива хранятся в поле shape, а число измерений — в поле ndim.
array = np.ones((2, 3))
print(f"форма {array.shape}, число измерений {array.ndim}")
array
форма (2, 3), число измерений 2
array([[1., 1., 1.],
[1., 1., 1.]])
# диагональная матрица 3×3 и куб 5×5×5
print(np.diag([1, 2, 3]).shape, np.diag([1, 2, 3]).ndim)
print(np.zeros((5, 5, 5)).shape, np.zeros((5, 5, 5)).ndim)
(3, 3) 2
(5, 5, 5) 3
Метод reshape изменяет форму массива, не изменяя самих данных.
array = np.arange(0, 6, 0.5)
array = array.reshape((2, 6))
array
array([[0. , 0.5, 1. , 1.5, 2. , 2.5],
[3. , 3.5, 4. , 4.5, 5. , 5.5]])
Многомерный массив разворачивается в вектор функцией ravel.
array = np.ravel(array)
array
array([0. , 0.5, 1. , 1.5, 2. , 2.5, 3. , 3.5, 4. , 4.5, 5. , 5.5])
# ravel вытягивает матрицу в вектор, reshape задаёт форму (1, 4)
print(np.ravel(np.diag([1, 2])))
print(np.reshape(np.diag([1, 2]), [1, 4]))
[1 0 0 2]
[[1 0 0 2]]
Индексация
В NumPy применяется привычная индексация Python, включая отрицательные индексы и срезы, записываемые так же, как для списка.
print(array[0])
print(array[-1])
print(array[1:-1])
print(array[1:-1:2])
print(array[::-1])
0.0
5.5
[0.5 1. 1.5 2. 2.5 3. 3.5 4. 4.5 5. ]
[0.5 1.5 2.5 3.5 4.5]
[5.5 5. 4.5 4. 3.5 3. 2.5 2. 1.5 1. 0.5 0. ]
print(array.shape)
(12,)
None, или np.newaxis, вставляет новую ось длины 1:
print(array[None, 0:, None].ndim, array[None, 0:, None].shape)
3 (1, 12, 1)
Индексы многомерного массива перечисляются через запятую в одних квадратных скобках: вместо matrix[i][j] пишут matrix[i, j]. Запись matrix[i][j] тоже работает, но сначала создаёт промежуточный массив-строку.
Массив, подставленный вместо индекса, может быть и списком номеров, и булевой маской:
array[[0, 2, 4, 6, 8, 10]]
array([0., 1., 2., 3., 4., 5.])
array[[True, False, True, False, True, False, True, False, True, False, True, False]]
array([0., 1., 2., 3., 4., 5.])
# массив формы (1, 3) и вектор формы (3,) равны лишь после добавления оси
x = np.array([[1, 2, 3]])
y = np.array([1, 2, 3])
print(x.shape, y.shape)
print(np.array_equal(x, y))
print(np.array_equal(x, y[None, :]))
(1, 3) (3,)
False
True
Условия соединяются поэлементными операторами &, | и ~ и заключаются в скобки: слова and, or и not требуют одного логического значения и к массивам не применяются.
x = np.arange(10)
x[(x % 2 == 0) & (x > 5)]
array([6, 8])
y = x[x > 5]
y *= 2
print(y)
print(x)
x[x > 5] *= 2
print(x)
[12 14 16 18]
[0 1 2 3 4 5 6 7 8 9]
[ 0 1 2 3 4 5 12 14 16 18]
Срез массива в NumPy является представлением тех же данных, а не их копией: изменение среза наподобие x[2:5] приводит к изменению исходного массива. Отбор по маске или по списку индексов всегда возвращает копию, и изменение отобранного исходный массив не затрагивает. Присваивание по маске x[x > 5] *= 2, напротив, записывает прямо в исходный массив. Общую память двух массивов проверяет функция np.shares_memory; когда требуются собственные данные, применяется метод copy.
x = np.arange(10)
np.shares_memory(x, x[::2]), np.shares_memory(x, x[[0, 2]]), np.shares_memory(x, x.copy())
(True, False, False)
Сохранение и чтение массивов в бинарном формате
Функция np.save записывает массив в файл .npy: заголовок с типом и формой, затем содержимое буфера без потери точности. np.load читает его обратно, а с аргументом mmap_mode="r" не загружает файл целиком, а отображает его в память, так что с диска читаются только нужные части. Несколько массивов сохраняются в архив .npz функциями np.savez и np.savez_compressed.
np.save("out.npy", x)
with open("out.npy", "rb") as f:
print(f.read(64))
y = np.load("out.npy")
print(y)
b"\x93NUMPY\x01\x00v\x00{'descr': '<i8', 'fortran_order': False, 'shape': (10,"
[0 1 2 3 4 5 6 7 8 9]
Чтение текстовых файлов
Текстовые таблицы читают функции loadtxt и genfromtxt. Для примера записывается короткий журнал измерений: время t, напряжение U и ток I, причём два показания пропущены.
with open("log.csv", "w") as f:
f.write("t,U,I\n0.0,1.02,0.51\n0.5,,0.49\n1.0,1.05,\n1.5,1.03,0.50\n")
loadtxt ожидает полные строки и на пропущенном значении останавливается с ошибкой:
try:
np.loadtxt("log.csv", delimiter=",", skiprows=1)
except ValueError as err:
print("ValueError:", err)
ValueError: could not convert string '' to float64 at row 1, column 2.
genfromtxt подставляет на место пропусков nan, а с names=True берёт имена столбцов из первой строки и возвращает структурированный массив, в котором строка запрашивается по номеру, а столбец — по названию.
log = np.genfromtxt("log.csv", delimiter=",", names=True)
log
array([(0. , 1.02, 0.51), (0.5, nan, 0.49), (1. , 1.05, nan),
(1.5, 1.03, 0.5 )],
dtype=[('t', '<f8'), ('U', '<f8'), ('I', '<f8')])
print(log["U"])
print(log[0])
[1.02 nan 1.05 1.03]
(0.0, 1.02, 0.51)
Строки в начале и в конце файла пропускаются аргументами skip_header и skip_footer, а столбцы отбираются через usecols.
np.genfromtxt("log.csv", delimiter=",", skip_header=1, usecols=(1, 2))
array([[1.02, 0.51],
[ nan, 0.49],
[1.05, nan],
[1.03, 0.5 ]])
Операции в NumPy производятся над массивами одинаковой формы целиком, без цикла. Мощность в каждый момент времени — поэлементное произведение двух столбцов:
P = log["U"] * log["I"]
print(P)
print(np.mean(P), np.nanmean(P))
[0.5202 nan nan 0.515 ]
nan 0.5176000000000001
Пропуск в любом из сомножителей даёт nan в произведении, а np.mean от массива с nan тоже равна nan; функции с приставкой nan — nanmean, nansum, nanmax — пропуски не учитывают.
Broadcasting
Broadcasting снимает требование одинаковой формы и разрешает арифметику над массивами разных, но согласованных между собой размерностей. Простейшим случаем является умножение вектора на число.
2 * np.arange(1, 4)
array([2, 4, 6])
Правило согласования размерностей:
In order to broadcast, the size of the trailing axes for both arrays in an operation must either be the same size or one of them must be one.
Таким образом, длины осей, отсчитываемых с конца, должны либо совпадать, либо одна из них должна быть равна единице, и тогда ось длины 1 растягивается до длины другого операнда без копирования данных. Если количество размерностей не совпадает, к массиву меньшей размерности слева дописываются оси длины 1, не занимающие памяти:
| Операнды | Результат |
|---|---|
| (4, 3) и (3,) | (4, 3) |
| (4, 1) и (3,) | (4, 3) |
| (2, 3, 4) и (4,) | (2, 3, 4) |
| (4, 3) и (4,) | ошибка |
К каждой строке матрицы прибавляется один и тот же вектор:
np.array([[0, 0, 0], [10, 10, 10], [20, 20, 20], [30, 30, 30]]) + np.arange(3)
array([[ 0, 1, 2],
[10, 11, 12],
[20, 21, 22],
[30, 31, 32]])
Со столбцами такой приём не работает: вектор из четырёх элементов не согласуется с матрицей по последней оси. Поэтому вектору сначала добавляется ось:
np.arange(4)[:, np.newaxis]
array([[0],
[1],
[2],
[3]])
После этого он прибавляется к каждому столбцу:
np.arange(4)[:, np.newaxis] + np.array([[0, 0, 0], [10, 10, 10], [20, 20, 20], [30, 30, 30]])
array([[ 0, 0, 0],
[11, 11, 11],
[22, 22, 22],
[33, 33, 33]])
Тот же приём даёт попарные разности координат N частиц: r[:, None, :] - r[None, :, :] имеет форму (N, N, 3), и матрица попарных расстояний вычисляется без цикла.
r = np.random.default_rng(0).random((4, 3)) # координаты четырёх частиц
d = r[:, None, :] - r[None, :, :] # форма (4, 4, 3)
dist = np.sqrt((d**2).sum(axis=-1))
dist.round(3)
array([[0. , 1.2 , 0.682, 0.623],
[1.2 , 0. , 0.701, 1.293],
[0.682, 0.701, 0. , 0.639],
[0.623, 1.293, 0.639, 0. ]])
Операнды broadcasting не копируются, но результат и промежуточные массивы занимают полную форму: массив разностей формы (N, N, 3) из float64 при N = 10 000 занимает 2,2 ГиБ. Такие расчёты разбивают на блоки или переписывают через матричное произведение.
Кроме того, в NumPy имеются сводные операции над массивами: np.min, np.max, np.sum, np.mean и другие. Для примера генерируется тысяча измерений трёх каналов: средние каналов 1, 5 и −2, нормальный шум с отклонением 0,1.
rng = np.random.default_rng(42)
data = rng.normal([1.0, 5.0, -2.0], 0.1, size=(1000, 3))
print(data.mean())
print(data.mean(axis=0))
print(data.std(axis=0, ddof=1))
1.330781043301899
[ 0.99917285 4.99693758 -2.0037673 ]
[0.10139425 0.09984559 0.10112884]
Среднее без аргумента сворачивает весь массив в одно число, а axis=0 сворачивает измерения и даёт по числу на канал; аргумент ddof=1 делает отклонение выборочным.
Операции
Почти каждая сводная операция имеет аргумент axis, задающий номер оси, вдоль которой она вычисляется. Без него операция обрабатывает весь массив целиком и возвращает одно число, а с ним сворачивает только указанную ось, оставляя остальные нетронутыми.
x = np.arange(40).reshape(5, 2, 4)
print(x)
[[[ 0 1 2 3]
[ 4 5 6 7]]
[[ 8 9 10 11]
[12 13 14 15]]
[[16 17 18 19]
[20 21 22 23]]
[[24 25 26 27]
[28 29 30 31]]
[[32 33 34 35]
[36 37 38 39]]]
print(x.mean())
print(np.mean(x))
19.5
19.5
x.mean(axis=0)
array([[16., 17., 18., 19.],
[20., 21., 22., 23.]])
x.mean(axis=1)
array([[ 2., 3., 4., 5.],
[10., 11., 12., 13.],
[18., 19., 20., 21.],
[26., 27., 28., 29.],
[34., 35., 36., 37.]])
x.mean(axis=2)
array([[ 1.5, 5.5],
[ 9.5, 13.5],
[17.5, 21.5],
[25.5, 29.5],
[33.5, 37.5]])
x.mean(axis=(0, 2))
array([17.5, 21.5])
x.mean(axis=(0, 1, 2))
np.float64(19.5)
Конкатенация многомерных массивов
Объединение массивов выполняют функции np.concatenate, np.hstack, np.vstack, np.dstack, различающиеся только осью объединения.
x = np.arange(10).reshape(5, 2)
y = np.arange(100, 120).reshape(5, 4)
np.hstack((x, y))
array([[ 0, 1, 100, 101, 102, 103],
[ 2, 3, 104, 105, 106, 107],
[ 4, 5, 108, 109, 110, 111],
[ 6, 7, 112, 113, 114, 115],
[ 8, 9, 116, 117, 118, 119]])
Массивы объединяются, только если их формы совпадают по всем осям, кроме оси объединения: матрицы 2×3 и 2×2 складываются по горизонтали, но не по вертикали.
x = np.ones([2, 3])
y = np.zeros([2, 2])
print(np.hstack((x, y)).shape)
try:
np.vstack((x, y))
except ValueError as err:
print("ValueError:", err)
(2, 5)
ValueError: all the input array dimensions except for the concatenation axis must match exactly, but along dimension 1, the array at index 0 has size 3 and the array at index 1 has size 2
p = np.arange(1).reshape([1, 1, 1, 1])
print("vstack: ", np.vstack((p, p)).shape)
print("hstack: ", np.hstack((p, p)).shape)
print("dstack: ", np.dstack((p, p)).shape)
print("concatenate: ", np.concatenate((p, p), axis=3).shape)
vstack: (2, 1, 1, 1)
hstack: (1, 2, 1, 1)
dstack: (1, 1, 2, 1)
concatenate: (1, 1, 1, 2)
Типы
От типа массива зависят и занимаемая память, и диапазон представимых значений. С версии 2.0 NumPy отвергает число Python, не помещающееся в тип, уже в конструкторе массива, но явное приведение astype и арифметика над целыми массивами переполняются без сообщений; такое переполнение является классическим источником неверных результатов.
x = [1, 2, 70000]
np.array(x, dtype=np.float32)
array([1.e+00, 2.e+00, 7.e+04], dtype=float32)
try:
np.array(x, dtype=np.uint16)
except OverflowError as err:
print("OverflowError:", err)
OverflowError: Python integer 70000 out of bounds for uint16
np.array(70000).astype(np.uint16)
array(4464, dtype=uint16)
uint16 хранит остаток по модулю \( 2^{16} \), а \( 70000 - 65536 = 4464 \). Так же ведёт себя арифметика: сумма массива uint8 и числа 100 остаётся uint8, и 200 + 100 превращается в 44.
np.array([200, 250], dtype=np.uint8) + 100
array([44, 94], dtype=uint8)
Ни одна из этих ошибок не приводит к исключению и ничего не выводит. Вещественные числа ограничены точностью: мантисса float32 содержит 24 двоичных разряда, поэтому \( 2^{24} + 1 \) во float32 непредставимо.
np.float32(16777216) + np.float32(1)
np.float32(1.6777216e+07)
При смешении строк и чисел массив получает строковый тип:
np.array(x, dtype=np.str_)
array(['1', '2', '70000'], dtype='<U5')
Функциональное программирование
NumPy предоставляет несколько способов поэлементного применения обычной функции Python к массиву, и разница в скорости между ними поучительна.
def f(value):
return np.sqrt(value)
print(np.apply_along_axis(f, 0, np.arange(10)))
[0. 1. 1.41421356 1.73205081 2. 2.23606798
2.44948974 2.64575131 2.82842712 3. ]
vf = np.vectorize(f)
%%timeit
vf(np.arange(100000))
51.6 ms ± 2.52 ms per loop (mean ± std. dev. of 7 runs, 10 loops each)
%%timeit
np.apply_along_axis(f, 0, np.arange(100000))
93.8 μs ± 1.06 μs per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
%%timeit
np.array([f(v) for v in np.arange(100000)])
55 ms ± 1.53 ms per loop (mean ± std. dev. of 7 runs, 10 loops each)
Разница в сотни раз выглядит убедительно, однако выводы из неё были бы поспешными. np.vectorize и списковое включение вызывают f сто тысяч раз, и их время составляет стоимость ста тысяч вызовов функции Python. В то же время apply_along_axis с axis=0 на одномерном массиве вызывает f один раз, передавая в неё весь массив целиком, так что измерен здесь один векторный np.sqrt, а не поэлементный обход.
Прежде чем доверять отношению времён, необходимо разобраться, что делает каждая из сравниваемых версий. np.vectorize не векторизует, а лишь оборачивает цикл, и ускорения от него ожидать не приходится.
Pandas
Pandas читает данные, приводит их в порядок, вычисляет по ним сводки и строит графики. Если NumPy предоставляет массив чисел, то pandas предоставляет таблицу с именованными столбцами и индексом, размечающим строки. Каждый столбец хранится отдельным массивом NumPy или, для строк, массивом Arrow, поэтому операции над столбцом выполняются векторно.
Слайды к главе. Таблицы pandas, отбор строк и копирование при записи, группировка и объединение таблиц, пропуски и временные ряды изложены также в четвёртой и пятой частях лекции «NumPy, pandas и SciPy» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
import pandas as pd
df = pd.read_csv("titanic.csv")
df.shape
(891, 12)
Файл titanic.csv взят из учебника pandas для начинающих (каталог doc/data репозитория pandas-dev/pandas): 891 пассажир «Титаника», 12 столбцов, разделитель — запятая. Файлы, сохранённые в русской локали, обычно записаны с разделителем «;» и десятичной запятой и читаются с аргументами sep=";" и decimal=","; без второго числовые столбцы окажутся строковыми.
df[["Survived", "Pclass", "Sex", "Age", "Fare"]].head(3)
Survived Pclass Sex Age Fare
0 0 3 male 22.0 7.2500
1 1 1 female 38.0 71.2833
2 1 3 female 26.0 7.9250
df.info()
<class 'pandas.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 PassengerId 891 non-null int64
1 Survived 891 non-null int64
2 Pclass 891 non-null int64
3 Name 891 non-null str
4 Sex 891 non-null str
5 Age 714 non-null float64
6 SibSp 891 non-null int64
7 Parch 891 non-null int64
8 Ticket 891 non-null str
9 Fare 891 non-null float64
10 Cabin 204 non-null str
11 Embarked 889 non-null str
dtypes: float64(2), int64(5), str(5)
memory usage: 118.7 KB
Метод info перечисляет столбцы с числом непустых значений и типом. Строковые столбцы pandas 3.0 хранит в отдельном типе str, а не в object, как прежние версии. Из числа непустых значений сразу видны пропуски: возраст известен у 714 пассажиров, номер каюты — у 204, порт посадки — у 889.
Отбор строк и столбцов
Строки отбираются маской, как в NumPy: сравнение столбца даёт Series из значений bool, условия соединяются операторами & и | и заключаются в скобки.
mask = (df["Sex"] == "female") & (df["Age"] > 30)
mask.sum()
np.int64(103)
women = df[mask]
women[["Name", "Age", "Pclass"]].head(3)
Name Age Pclass
1 Cumings, Mrs. John Bradley (Florence Briggs Th... 38.0 1
3 Futrelle, Mrs. Jacques Heath (Lily May Peel) 35.0 1
11 Bonnell, Miss Elizabeth 58.0 1
Индексатор loc обращается к строке по метке индекса:
df.loc[78]
PassengerId 79
Survived 1
Pclass 2
Name Caldwell, Master Alden Gates
Sex male
Age 0.83
SibSp 0
Parch 2
Ticket 248738
Fare 29.0
Cabin NaN
Embarked S
Name: 78, dtype: object
Метод describe даёт сводку по числовым столбцам, а для строковых — число значений, число различных, самое частое и его частоту.
df[["Age", "SibSp", "Parch", "Fare"]].describe().round(2)
Age SibSp Parch Fare
count 714.00 891.00 891.00 891.00
mean 29.70 0.52 0.38 32.20
std 14.53 1.10 0.81 49.69
min 0.42 0.00 0.00 0.00
25% 20.12 0.00 0.00 7.91
50% 28.00 0.00 0.00 14.45
75% 38.00 1.00 0.00 31.00
max 80.00 8.00 6.00 512.33
df[["Sex", "Cabin"]].describe()
Sex Cabin
count 891 204
unique 2 147
top male G6
freq 577 4
Индексация
Для отбора строк есть два индексатора. loc работает с метками индекса и именами столбцов, и срез по меткам включает правую границу; iloc работает с номерами позиций, как индексация NumPy, и правая граница среза не включается. После сортировки метка, приписанная строке, сохраняется и перестаёт совпадать с её номером по порядку.
s = df.sort_values("Age")
s[["Name", "Age"]].head(3)
Name Age
803 Thomas, Master Assad Alexander 0.42
755 Hamalainen, Master Viljo 0.67
644 Baclini, Miss Eugenie 0.75
s.loc[78, "Age"], s.iloc[78]["Age"]
(np.float64(0.83), np.float64(15.0))
После сортировки по возрасту s.loc[78] по-прежнему обращается к пассажиру с меткой 78, а s.iloc[78] — к семьдесят девятой по возрасту строке. Метод reset_index перенумеровывает строки заново.
df.loc[[78, 79, 100], ["Age", "Cabin"]]
Age Cabin
78 0.83 NaN
79 30.00 NaN
100 28.00 NaN
Метод query принимает условие строкой, в которой допускаются and и or:
df.query("Pclass == 1 and Age < 18").shape
(12, 12)
Копирование при записи
До версии 3.0 результат индексации в pandas был то представлением, то копией в зависимости от операции, и запись в него то меняла исходную таблицу, то нет; pandas предупреждал об этом SettingWithCopyWarning. С версии 3.0 действует единое правило копирования при записи (Copy-on-Write): любой объект, полученный индексацией или методом, ведёт себя как копия, а изменить таблицу можно только операцией над ней самой.
sub = df.loc[[78, 79, 100], ["Age", "Fare"]]
sub["Age"] = 3
sub
Age Fare
78 3 29.0000
79 3 12.4750
100 3 7.8958
df.loc[[78, 79, 100], ["Age", "Fare"]]
Age Fare
78 0.83 29.0000
79 30.00 12.4750
100 28.00 7.8958
Запись в sub исходную таблицу не изменила, и защитный вызов .copy() для этого не требуется. Цепочка присваиваний df[маска]["Fare"] = 0 никогда не меняет таблицу: первый шаг создаёт новый объект, и запись идёт в него. Обнаружив такую цепочку, pandas выдаёт предупреждение ChainedAssignmentError. Пример выполняется на копии таблицы t, чтобы не изменять df:
t = df.copy()
t[t["Age"] > 60]["Fare"] = 0
(t.loc[t["Age"] > 60, "Fare"] == 0).sum()
<ipython-input-79-652a0f7e26bc>:2: ChainedAssignmentError: A value is being set on a copy of a DataFrame or Series through chained assignment.
Such chained assignment never works to update the original DataFrame or Series, because the intermediate object on which we are setting values always behaves as a copy (due to Copy-on-Write).
Try using '.loc[row_indexer, col_indexer] = value' instead, to perform the assignment in a single step.
See the documentation for a more detailed explanation: https://pandas.pydata.org/pandas-docs/stable/user_guide/copy_on_write.html#chained-assignment
t[t["Age"] > 60]["Fare"] = 0
np.int64(0)
t.loc[t["Age"] > 60, "Fare"] = 0
(t.loc[t["Age"] > 60, "Fare"] == 0).sum()
np.int64(22)
Та же запись одной операцией t.loc[маска, "Fare"] = 0 изменяет таблицу: нулями стали все 22 значения. Для старого кода существен обратный порядок шагов: запись df["Fare"][маска] = 0 до версии 3.0 меняла таблицу, а теперь, как и любая цепочка, её не меняет.
Выборка по маске, как и в NumPy, сразу копирует строки. Результаты операций, которые прежде возвращали представление, — столбец df["Fare"], срез строк df[:10], reset_index, rename — данные заранее не копируют: новый объект использует память исходного, пока в один из них не выполнена запись, и только тогда копируются затронутые данные.
Столбцы отбираются названием или списком названий в []. Если передаётся название одного столбца, то возвращается объект класса pandas.Series, а если список названий столбцов, то pandas.DataFrame. Series и DataFrame имеют много общих методов, работающих одинаково в обоих случаях.
df["Age"].head(5)
0 22.0
1 38.0
2 26.0
3 35.0
4 35.0
Name: Age, dtype: float64
df[["Age"]].head(5)
Age
0 22.0
1 38.0
2 26.0
3 35.0
4 35.0
pd.Series
Одномерный срез таблицы является pd.Series, столбцом значений, снабжённым индексом. Массив NumPy из него даёт метод to_numpy(); атрибут values у строкового столбца в pandas 3.0 возвращает не массив NumPy, а массив Arrow. Обычно извлекать массив не требуется: вместе с ним теряется индекс.
df["Age"].head(5).to_numpy()
array([22., 38., 26., 35., 35.])
Индекс извлекается отдельно:
df["Age"].head(5).index
RangeIndex(start=0, stop=5, step=1)
Создаётся Series так же, как np.array, только индекс задаётся явно.
pd.Series([1, 2, 3], index=["Red", "Green", "Blue"])
Red 1
Green 2
Blue 3
dtype: int64
pd.Series(1, index=["Red", "Green", "Blue"])
Red 1
Green 1
Blue 1
dtype: int64
Series разворачивается обратно в DataFrame:
s = pd.Series([1, 2, 3], index=["Red", "Green", "Blue"])
s.to_frame("Values")
Values
Red 1
Green 2
Blue 3
s.loc["Red"], s.iloc[0]
(np.int64(1), np.int64(1))
Объединение таблиц
Метод merge объединяет две таблицы по значениям ключевых столбцов, как соединение в SQL. Аргумент how задаёт, какие строки попадут в результат: inner — только строки, ключ которых есть в обеих таблицах, left — все строки левой таблицы, а там, где пары нет, столбцы правой заполняются NaN, right и outer — все строки правой и обеих. К пассажирам по коду порта посадки присоединяется справочник портов:
ports = pd.DataFrame({"Embarked": ["C", "Q", "S"],
"Port": ["Cherbourg", "Queenstown", "Southampton"]})
m = df.merge(ports, on="Embarked", how="left", validate="m:1", indicator=True)
m["_merge"].value_counts()
_merge
both 889
left_only 2
right_only 0
Name: count, dtype: int64
m.loc[m["_merge"] == "left_only", ["PassengerId", "Name", "Port"]]
PassengerId Name Port
61 62 Icard, Miss Amelie NaN
829 830 Stone, Mrs. George Nelson (Martha Evelyn) NaN
Аргумент validate="m:1" проверяет, что ключ в правой таблице уникален: при дубликате merge завершается ошибкой MergeError вместо того, чтобы без предупреждения размножить строки. Аргумент indicator=True добавляет столбец _merge, показывающий источник строки: у двух пассажиров порт посадки не указан, и пары в справочнике у них нет.
Метод join объединяет таблицы по индексу:
df1 = df[["Age", "Parch"]]
df2 = df[["Ticket", "Fare"]]
df1.join(df2).head(3)
Age Parch Ticket Fare
0 22.0 0 A/5 21171 7.2500
1 38.0 0 PC 17599 71.2833
2 26.0 0 STON/O2. 3101282 7.9250
pd.concat склеивает таблицы одинаковой структуры, например результаты двух серий измерений, одну под другой:
pd.concat([df.head(2), df.tail(2)])[["PassengerId", "Name"]]
PassengerId Name
0 1 Braund, Mr. Owen Harris
1 2 Cumings, Mrs. John Bradley (Florence Briggs Th...
889 890 Behr, Mr. Karl Howell
890 891 Dooley, Mr. Patrick
Группировка
Средний возраст пассажира по классам каюты может быть вычислен напрямую тремя почти одинаковыми строками. Такой подход не рекомендуется: классов может оказаться тридцать. Для этой задачи предназначен groupby, разбивающий таблицу на группы.
print("Pclass 1: ", df[df["Pclass"] == 1]["Age"].mean())
print("Pclass 2: ", df[df["Pclass"] == 2]["Age"].mean())
print("Pclass 3: ", df[df["Pclass"] == 3]["Age"].mean())
Pclass 1: 38.233440860215055
Pclass 2: 29.87763005780347
Pclass 3: 25.14061971830986
df.groupby("Pclass")[["Age"]].mean()
Age
Pclass
1 38.233441
2 29.877630
3 25.140620
Группировка устроена по схеме «разбиение — применение — объединение». Сам по себе groupby ничего не вычисляет, а возвращает объект DataFrameGroupBy, хранящий разбиение и ожидающий сводной операции; результаты операции для групп объединяются в таблицу, индексом которой служат значения ключа.
df.groupby(["Survived", "Pclass"])["PassengerId"].count()
Survived Pclass
0 1 80
2 97
3 372
1 1 136
2 87
3 119
Name: PassengerId, dtype: int64
df.groupby(["Survived", "Pclass"])[["PassengerId", "Cabin"]].count()
PassengerId Cabin
Survived Pclass
0 1 80 59
2 97 3
3 372 6
1 1 136 117
2 87 13
3 119 6
Метод count считает непустые значения столбца, поэтому для Cabin счётчики меньше: каюта известна в основном у пассажиров первого класса. Число строк группы независимо от пропусков даёт метод size. Метод agg применяет к группам несколько сводных функций сразу:
df.groupby("Pclass")["Fare"].agg(["mean", "median", "max"]).round(2)
mean median max
Pclass
1 84.15 60.29 512.33
2 20.66 14.25 73.50
3 13.68 8.05 69.55
Сводная таблица pivot_table раскладывает свёртку по двум ключам — по строкам и по столбцам, а функция pd.cut разбивает непрерывную величину на интервалы, которые затем служат ключом группировки:
df.pivot_table(values="Survived", index="Sex", columns="Pclass").round(2)
Pclass 1 2 3
Sex
female 0.97 0.92 0.50
male 0.37 0.16 0.14
age = pd.cut(df["Age"], [0, 12, 18, 40, 80])
df.groupby(age)["Survived"].agg(["mean", "size"]).round(2)
mean size
Age
(0, 12] 0.58 69
(12, 18] 0.43 70
(18, 40] 0.39 425
(40, 80] 0.37 150
Метод transform возвращает результат свёртки для каждой строки исходной таблицы; так пропущенный возраст заполняют медианой группы:
med = df.groupby("Pclass")["Age"].transform("median")
df["Age"].isna().sum(), df["Age"].fillna(med).isna().sum()
(np.int64(177), np.int64(0))
Временные ряды
Показания приборов почти всегда поступают с меткой времени, проставленной системой сбора. Для примера генерируется синтетический журнал установки за один час: давление p в нанопаскалях и ток пучка I в миллиамперах, опрос с шагом от 1,5 до 2,5 с, всплеск давления в 12:40, около процента пропущенных показаний тока и трёхминутная пауза записи с 12:20.
rng = np.random.default_rng(7)
dt = rng.uniform(1.5, 2.5, 1800) # шаг опроса, с
time = pd.Timestamp("2026-10-02 12:00:00") + pd.to_timedelta(np.cumsum(dt), unit="s")
sec = (time - time[0]).total_seconds().to_numpy()
p = 40 + 1.0 * rng.standard_normal(time.size) # фон 40 нПа
burst = (sec > 2400) & (sec < 2460) # всплеск давления
p[burst] += 400 * np.exp(-(sec[burst] - 2400) / 15)
I = 150 * np.exp(-sec / 36000) + 0.2 * rng.standard_normal(time.size)
I[rng.random(time.size) < 0.01] = np.nan # пропущенные показания
raw = pd.DataFrame({"time": time, "p": p.round(2), "I": I.round(2)})
gap = (raw["time"] >= "2026-10-02 12:20:00") & (raw["time"] < "2026-10-02 12:23:00")
raw[~gap].to_csv("vacuum.csv", index=False, date_format="%Y-%m-%d %H:%M:%S.%f")
Если при чтении указать столбец времени в parse_dates и сделать его индексом, таблица получает индекс DatetimeIndex и операции, недоступные обычным числам.
log = pd.read_csv("vacuum.csv", parse_dates=["time"], index_col="time")
log.head(3)
p I
time
2026-10-02 12:00:02.125095 41.38 149.88
2026-10-02 12:00:04.522309 39.51 150.28
2026-10-02 12:00:06.797994 39.23 150.05
log.index.dtype, log.index.to_series().diff().max()
(dtype('<M8[us]'), Timedelta('0 days 00:03:04.381713'))
В pandas 3.0 даты, прочитанные из строк, по умолчанию хранятся с микросекундным разрешением. Разность соседних меток показывает самую длинную паузу записи — около трёх минут. Срез по строкам дат выбирает интервал времени и, как всякий срез по меткам, включает правую границу целиком: строка "2026-10-02 12:30" обозначает всю минуту.
log.loc["2026-10-02 12:30":"2026-10-02 12:30"].shape
(29, 2)
Метод resample пересчитывает ряд на равномерную сетку с заданным шагом и сворачивает значения внутри каждого интервала, причём для разных столбцов свёртки могут быть разными. Псевдонимы интервалов месяца, квартала и года записываются в pandas 3.0 как ME, QE и YE; прежние M, Q и Y вызывают ошибку.
log.resample("10min").agg({"p": "max", "I": "mean"}).round(1)
p I
time
2026-10-02 12:00:00 42.7 148.8
2026-10-02 12:10:00 42.8 146.3
2026-10-02 12:20:00 42.6 143.5
2026-10-02 12:30:00 43.2 141.5
2026-10-02 12:40:00 434.2 139.2
2026-10-02 12:50:00 42.4 136.9
Всплеск давления виден в интервале с 12:40, а ток убывает со временем жизни пучка.
Скользящие окна
Скользящее окно (rolling) сглаживает зашумлённый ряд: для каждой точки вычисляется среднее (сумма, максимум) по окну из неё самой и предшествующих показаний. Окно задаётся числом точек или длительностью, например "1min", и тогда неравномерный шаг показаний учитывается автоматически. Поэтому сглаженный ряд запаздывает относительно исходного на половину окна; аргумент center=True располагает окно симметрично вокруг точки.
roll = log["p"].rolling("1min").mean()
roll.idxmax(), log["p"].rolling("1min", center=True).mean().idxmax()
(Timestamp('2026-10-02 12:41:01.270118'),
Timestamp('2026-10-02 12:40:30.310722'))
Максимум правостороннего минутного среднего приходится на момент, когда в окне оказывается весь всплеск, почти через минуту после его начала, а максимум центрированного — на середину всплеска. Для журнала установки это разница в моменте события после сглаживания.
Работа со строками
Строковые столбцы имеют аксессор .str, через который к каждому элементу применяются строковые методы и регулярные выражения. Ниже из полного имени пассажира извлекаются обращение (Mr, Mrs, Miss, Master…) и личное имя; в файле pandas после обращения точка стоит не всегда, поэтому она в выражении необязательна.
parts = df["Name"].str.extract(r",\s*(?:the\s+)?(?P<title>[^\s.]+)\.?\s+(?P<name>.*)")
parts.head(3)
title name
0 Mr Owen Harris
1 Mrs John Bradley (Florence Briggs Thayer)
2 Miss Laina
parts["title"].value_counts().head(5)
title
Mr 517
Miss 182
Mrs 125
Master 40
Dr 7
Name: count, dtype: int64
Пропущенные значения
В реальных данных пропуски присутствуют всегда: прибор не сработал, поле анкеты осталось пустым. Pandas обозначает их как NaN в вещественных и строковых столбцах, pd.NA — в целых и логических столбцах с поддержкой пропусков (Int64, boolean), NaT — в датах.
df.isna().sum()
PassengerId 0
Survived 0
Pclass 0
Name 0
Sex 0
Age 177
SibSp 0
Parch 0
Ticket 0
Fare 0
Cabin 687
Embarked 2
dtype: int64
Строки с пропуском удаляются методом dropna, а пропуски заполняются значением методом fillna:
df["Cabin"].fillna("unknown").head(5)
0 unknown
1 C85
2 unknown
3 C123
4 unknown
Name: Cabin, dtype: str
df.dropna(subset=["Age"]).shape
(714, 12)
Сводные операции по умолчанию пропускают NaN: средний возраст вычисляется по 714 известным значениям, а не по 891 пассажиру. Это удобно, но скрывает масштаб пропусков. Удаление строк с пропуском смещает выборку, если пропуски связаны с другими признаками, как здесь — с классом каюты:
df["Age"].isna().groupby(df["Pclass"]).mean().round(3)
Pclass
1 0.139
2 0.060
3 0.277
Name: Age, dtype: float64
Методы ffill и bfill переносят соседнее значение вперёд или назад, а interpolate заполняет пропуск по соседним точкам; они предназначены для упорядоченных рядов, таких как журнал установки. С method="time" интерполяция учитывает неравномерный шаг меток времени.
print(log["I"].isna().sum())
print(log["I"].ffill().isna().sum(), log["I"].interpolate(method="time").isna().sum())
17
0 0
Функция apply
Когда готовой векторной операции не нашлось, остаётся apply, применяющий заданную функцию к каждой строке (axis=1) или к каждому столбцу. Внутри работает обычный цикл Python со всеми издержками, рассмотренными в главе про производительность, поэтому перед написанием apply следует ещё раз поискать векторное решение. Размер семьи пассажира вычисляется обоими способами:
def family_size(row):
return row["SibSp"] + row["Parch"] + 1
(df.apply(family_size, axis=1) == df["SibSp"] + df["Parch"] + 1).all()
np.True_
%timeit df.apply(family_size, axis=1)
2 ms ± 45.7 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit df["SibSp"] + df["Parch"] + 1
36.6 μs ± 655 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
Повторяющиеся строковые значения экономнее хранить в типе category: столбец содержит целые коды и словарь значений. Формат файла тоже влияет на скорость: CSV — текст без типов, который приходится разбирать при каждом чтении, а Parquet хранит столбцы в двоичном виде с типами и сжатием и позволяет читать только нужные столбцы. На той же виртуальной машине таблица из миллиона строк занимает в CSV 41 МиБ и читается 163 мс, в Parquet — 16 МиБ и 21 мс.
Визуализация
Метод plot() строит ряд как есть, а resample("1min").mean().plot() сначала усредняет его по минутным интервалам и даёт сглаженную кривую. Построению графиков посвящена глава «Визуализация на Python».
ax = log["p"].plot(figsize=(8, 3), ylabel="p, нПа")
ax = log["I"].resample("1min").mean().plot(figsize=(8, 3), ylabel="I, мА")
SciPy
NumPy сам по себе почти ничего не вычисляет: он хранит числа, уложенные подряд, и выполняет над ними арифметические операции.
SciPy является библиотекой численных методов, построенной поверх NumPy. NumPy отвечает за структуру данных, то есть за быстрый многомерный массив и базовые операции над ним, а SciPy добавляет готовые алгоритмы: интегрирование, решение дифференциальных уравнений, оптимизацию и подгонку кривых, интерполяцию, линейную алгебру, обработку сигналов, спектральный анализ. Прежде чем реализовывать численный метод самостоятельно, целесообразно поискать его в SciPy: почти наверняка он уже реализован поверх проверенных десятилетиями FORTRAN- и C-библиотек (QUADPACK, LAPACK, MINPACK, ODEPACK). Код при этом остаётся коротким, а выполняется со скоростью компилируемого.
SciPy организована в подмодули по областям: scipy.integrate, scipy.optimize, scipy.linalg и так далее. Импортировать библиотеку целиком не принято, импортируется нужный подмодуль.
import numpy as np # NumPy понадобится везде
from scipy import optimize # импортируем конкретный подмодуль
Листинги главы выполняются подряд, в одном сеансе интерпретатора: numpy импортирован как np один раз, а имена, введённые в одном листинге, доступны в следующих. Числа в комментариях и распечатках получены на виртуальной машине под Python 3.12 с NumPy 2.5 и SciPy 1.18, на которой записаны демонстрации лекции «NumPy, pandas и SciPy».
Слайды к главе. Физические константы, интегралы и задача Коши, поиск минимума и корня, подгонка кривых с погрешностями параметров на примере измерения эмиттанса и интерполяция изложены также в шестой части лекции «NumPy, pandas и SciPy» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
scipy.constants — физические константы
В scipy.constants собраны фундаментальные физические константы в системе СИ по данным CODATA, что избавляет от необходимости перепечатывать значения из справочника и исключает опечатки в восьмом знаке. SciPy 1.18 содержит рекомендованные значения CODATA 2022.
from scipy import constants
print(constants.c) # скорость света в вакууме, м/с
print(constants.h) # постоянная Планка, Дж·с
print(constants.hbar) # приведённая постоянная Планка, Дж·с
print(constants.e) # элементарный заряд, Кл
print(constants.k) # постоянная Больцмана, Дж/К
print(constants.epsilon_0) # электрическая постоянная, Ф/м
print(constants.m_e) # масса электрона, кг
Скорость света, а после переопределения единиц СИ в 2019 году также постоянная Планка, постоянная Больцмана и элементарный заряд точны по определению; точна и приведённая постоянная Планка, выражающаяся через постоянную Планка. Масса электрона и электрическая постоянная определяются измерениями и известны с погрешностью.
Помимо «именованных» констант имеется полный словарь physical_constants, возвращающий по названию кортеж (значение, единицы, погрешность); у точных констант погрешность равна нулю. Поиск нужного ключа удобно выполнять функцией find.
print(constants.find('Bohr')) # все константы, в названии которых есть 'Bohr'
value, unit, uncertainty = constants.physical_constants['proton mass']
print(value, unit, uncertainty) # 1.67262192595e-27 kg 5.2e-37
entry = constants.physical_constants['Planck constant']
print(entry) # (6.62607015e-34, 'J Hz^-1', 0.0)
Там же находятся множители, переводящие одни единицы в другие: constants.eV хранит электронвольт в джоулях, constants.angstrom — ангстрем в метрах, рядом префиксы constants.milli, constants.femto и т. п. Формулы записываются в СИ, а входные данные задаются в привычных единицах.
E = 13.6 * constants.eV # энергия ионизации водорода в джоулях
lam = constants.h * constants.c / E # длина волны соответствующего фотона, м
print(lam / constants.nano) # ≈ 91.2 нм — граница серии Лаймана
print(constants.convert_temperature(300, 'Kelvin', 'Celsius')) # 26.850000000000023
Последняя строка печатает 26.850000000000023, а не 26,85: десятичная дробь 273,15 представима в двоичной арифметике лишь приближённо, и разность 300 − 273,15 наследует ошибку её представления.
scipy.integrate — интегрирование и ОДУ
Подмодуль scipy.integrate вычисляет определённые интегралы и интегрирует обыкновенные дифференциальные уравнения.
Определённые интегралы вычисляет функция quad, реализующая адаптивную квадратуру из QUADPACK. Она принимает функцию и пределы, в том числе бесконечные, и возвращает пару из значения интеграла и оценки его абсолютной погрешности. Интервал интегрирования дробится, пока оценка не станет меньше абсолютного допуска epsabs или относительного допуска epsrel, умноженного на модуль интеграла; по умолчанию оба допуска равны \(1{,}49 \cdot 10^{-8}\). В качестве примера рассмотрим интеграл, возникающий при выводе закона Стефана—Больцмана из формулы Планка. Интегрирование спектральной плотности излучения по частотам после замены \(x = h\nu/kT\) приводит к интегралу
\[ I = \int_0^\infty \frac{x^3 dx}{e^x - 1} = \frac{\pi^4}{15}, \]
через который постоянная Стефана—Больцмана выражается как \(\sigma = 2\pi k^4 I/(h^3 c^2)\).
from scipy import integrate
# Интеграл ∫ x³/(eˣ − 1) dx от 0 до ∞; аналитический ответ — π⁴/15.
# Числитель и знаменатель умножены на e⁻ˣ, чтобы eˣ не переполнялся при больших x
f = lambda x: x**3 * np.exp(-x) / (1 - np.exp(-x))
value, error = integrate.quad(f, 0, np.inf)
print(value, np.pi**4 / 15) # 6.493939402266831 6.493939402266828
print(error) # 2.628470539040253e-09 — оценка погрешности
# постоянная Стефана—Больцмана, Вт/(м²·К⁴), и её значение в scipy.constants
sigma_sb = 2 * np.pi * constants.k**4 / (constants.h**3 * constants.c**2) * value
print(sigma_sb, constants.sigma) # 5.670374419184433e-08 5.6703744191844314e-08
Фактическая ошибка интеграла, около \(3 \cdot 10^{-15}\), почти на шесть порядков меньше оценки \(2{,}6 \cdot 10^{-9}\): оценка погрешности quad обычно пессимистична. Постоянная Стефана—Больцмана, вычисленная по интегралу, отличается от constants.sigma лишь в шестнадцатом знаке, на уровне округления float64; в SciPy она вычислена из точных констант по формуле \(2\pi^5 k^4/(15 h^3 c^2)\).
Множитель \(e^{-x}\) в числителе и знаменателе введён не случайно. Наибольшее число float64 близко к \(1{,}8 \cdot 10^{308}\), поэтому \(e^x\) переполняется уже при \(x > 709{,}78\), а на бесконечном интервале quad вычисляет подынтегральную функцию и в точках порядка тысяч. Без этой предосторожности результат зависит от вида подынтегральной функции.
naive = lambda x: x**3 / (np.exp(x) - 1) # исходная запись
print(integrate.quad(naive, 0, np.inf)) # (6.49393940226683, 2.628470028924825e-09)
debye = lambda x: x**4 * np.exp(x) / (np.exp(x) - 1)**2 # интеграл равен 4π⁴/15
print(integrate.quad(debye, 0, np.inf)) # (nan, nan)
В исходной записи NumPy возвращает при больших \(x\) бесконечность и печатает предупреждение RuntimeWarning: overflow encountered in exp, а результат остаётся верным лишь потому, что конечное число, делённое на бесконечность, даёт ноль. В интеграле \(\int_0^\infty x^4 e^x (e^x - 1)^{-2} dx = 4\pi^4/15\), входящем в закон Дебая для теплоёмкости кристалла при низких температурах, бесконечность возникает и в числителе, и в знаменателе. Отношение двух бесконечностей равно nan, и quad возвращает (nan, nan) с предупреждениями о переполнении и об ошибке округления, не позволяющей достичь заданной точности, тогда как та же функция в записи \(x^4 e^{-x}/(1 - e^{-x})^2\) даёт 25,97575760906732 при точном значении 25,975757609067312. Поэтому запись, устойчивая к переполнению, необходима и там, где исходная запись даёт верный ответ: верным он оказывается лишь при частном виде подынтегральной функции.
Экспериментальные данные обычно представлены таблицей отсчётов; для них предусмотрены integrate.simpson(y, x=x) и integrate.trapezoid(y, x=x), работающие непосредственно по узлам сетки.
Основным инструментом для ОДУ является solve_ivp (initial value problem, задача Коши). Он интегрирует систему уравнений первого порядка dy/dt = f(t, y); уравнение более высокого порядка предварительно сводится к системе. Для затухающего гармонического осциллятора x'' + 2γx' + ω₀²x = 0 введём вектор состояния y = [x, v] и получим систему первого порядка: x' = v, v' = −2γv − ω₀²x.
from scipy.integrate import solve_ivp
omega0 = 2 * np.pi # собственная частота, рад/с
gamma = 0.3 # коэффициент затухания, 1/с
def rhs(t, y, gamma, omega0):
x, v = y # y = [координата, скорость]
return [v, -2 * gamma * v - omega0**2 * x]
sol = solve_ivp(rhs, t_span=(0, 10), y0=[1.0, 0.0], # x(0)=1, v(0)=0
args=(gamma, omega0), # параметры модели
t_eval=np.linspace(0, 10, 501)) # где выдать решение
t = sol.t
x, v = sol.y # sol.y имеет форму (2, 501): строки — компоненты решения
print(sol.success, sol.nfev) # True 428: интегрирование дошло до конца
Параметры модели передаются в правую часть через аргумент args, а не читаются из глобальных переменных: solve_ivp вызывает rhs(t, y, gamma, omega0), что позволяет проинтегрировать ту же функцию с другими параметрами без изменения её кода. Способы передачи параметров в интеграторы рассмотрены в главе «Функции». Аргумент t_eval задаёт лишь моменты, в которые сохраняется решение: шаг интегрирования метод выбирает сам, а значения в заданные моменты получает интерполяцией внутри шага. Поле nfev содержит число вычислений правой части и позволяет сравнивать стоимость расчёта.
По умолчанию используется явный метод Рунге—Кутты RK45 пятого порядка, подбирающий шаг так, чтобы оценка локальной ошибки, полученная по вложенной формуле четвёртого порядка, оставалась меньше atol + rtol·|y|. Допуски по умолчанию, rtol=1e-3 и atol=1e-6, обеспечивают лишь около трёх верных знаков. Оценим фактическую ошибку. При \(\gamma < \omega_0\) уравнение осциллятора имеет точное решение \(x(t) = e^{-\gamma t}\left(\cos\omega t + \frac{\gamma}{\omega}\sin\omega t\right)\), где \(\omega = \sqrt{\omega_0^2 - \gamma^2}\), и с ним можно сравнить решения, полученные с разными допусками и методами.
w = np.sqrt(omega0**2 - gamma**2) # частота затухающих колебаний, рад/с
exact = np.exp(-gamma * t) * (np.cos(w * t) + gamma / w * np.sin(w * t))
for method, tol in (('RK45', {}), # допуски по умолчанию
('RK45', {'rtol': 1e-8, 'atol': 1e-10}),
('DOP853', {'rtol': 1e-10, 'atol': 1e-12})):
s = solve_ivp(rhs, (0, 10), [1.0, 0.0], method=method,
args=(gamma, omega0), t_eval=t, **tol)
print(method, tol, s.nfev, f'{np.abs(s.y[0] - exact).max():.1e}')
RK45 {} 428 2.2e-03
RK45 {'rtol': 1e-08, 'atol': 1e-10} 4796 1.0e-08
DOP853 {'rtol': 1e-10, 'atol': 1e-12} 2954 1.1e-10
С допусками по умолчанию метод вычисляет правую часть 428 раз, и наибольшая ошибка координаты составляет \(2{,}2 \cdot 10^{-3}\) при начальном отклонении 1. С rtol=1e-8 и atol=1e-10 ошибка уменьшается до \(1{,}0 \cdot 10^{-8}\) ценой 4796 вычислений. Метод восьмого порядка DOP853, рекомендуемый документацией для расчётов высокой точности, с ещё более строгими допусками достигает \(1{,}1 \cdot 10^{-10}\) за 2954 вычисления. Таким образом, для расчёта, сравниваемого с измерением, допуски необходимо задавать явно, а при высоких требованиях к точности метод высокого порядка оказывается выгоднее.
Для жёстких систем, где временные масштабы различаются на порядки (химическая кинетика, цепочки распадов), шаг явного метода ограничен условием устойчивости по самому быстрому масштабу, и расчёт становится медленным. В этом случае применяются неявные методы: method='Radau', неявный метод Рунге—Кутты пятого порядка, и method='BDF', формулы дифференцирования назад переменного порядка. Метод LSODA из ODEPACK сам определяет жёсткость задачи и переключается между методами Адамса и BDF.
scipy.optimize — минимизация, корни, подгонка кривых
В scipy.optimize решаются три типовые задачи обработки эксперимента: поиск минимума функции, поиск корня уравнения и подгонка модели к данным.
Минимизацией занимается функция minimize. Найдём равновесное межатомное расстояние в потенциале Леннард-Джонса V(r) = 4ε[(σ/r)¹² − (σ/r)⁶] (в безразмерных единицах ε = σ = 1).
from scipy import optimize
def lj(r):
return 4 * (r**-12 - r**-6) # потенциал Леннард-Джонса
res = optimize.minimize(lj, x0=1.5) # x0 — начальное приближение
print(res.x) # положение минимума: [1.12246209]
print(2**(1/6)) # аналитический ответ: r = 2^(1/6)
print(res.fun) # значение в минимуме: ≈ -1.0 (глубина ямы)
minimize работает и с функциями многих переменных, и тогда x0 становится массивом. Без ограничений по умолчанию применяется квазиньютоновский метод BFGS, при заданных границах переменных — L-BFGS-B, при ограничениях общего вида — SLSQP; для негладких функций имеет смысл попробовать method='Nelder-Mead', не использующий производных. Необходимо помнить, что найденный минимум является локальным: метод сходится к одному из минимумов, обычно ближайшему к x0, и глобального минимума не гарантирует.
Корни уравнения f(x) = 0 на отрезке, на концах которого функция имеет разные знаки, надёжно находит brentq. Метод Брента сочетает деление отрезка пополам с интерполяцией, и смена знака на концах обеспечивает его гарантированную сходимость. Выведем постоянную закона смещения Вина. Спектральная плотность излучения по длинам волн пропорциональна \(\lambda^{-5}/(e^{hc/\lambda kT} - 1)\); приравняв нулю её производную и введя \(x = hc/(\lambda kT)\), получим трансцендентное уравнение \((x - 5)e^x + 5 = 0\). У него есть тривиальный корень \(x = 0\), поэтому отрезок поиска выбран так, чтобы исключить его.
from scipy import constants
f = lambda x: (x - 5) * np.exp(x) + 5
x_max = optimize.brentq(f, 1, 10) # корень на отрезке [1, 10]: f(1) < 0 < f(10)
print(x_max) # 4.965114231744276
# Постоянная Вина b из λ_max·T = hc/(x_max·k)
b = constants.h * constants.c / (x_max * constants.k)
print(b, constants.Wien) # 0.0028977719551851727 0.0028977719551851727
Вычисленная постоянная Вина совпадает с constants.Wien во всех знаках: SciPy вычисляет её по той же формуле из точных констант. Тот же корень даёт более общий интерфейс optimize.root_scalar(f, bracket=(1, 10)), а для систем нелинейных уравнений предназначен optimize.root, принимающий вектор невязок.
Подгонка модели и погрешности параметров
Наиболее востребованной в лаборатории функцией является curve_fit, выполняющая подгонку параметров модели к данным методом наименьших квадратов. Сгенерируем точки экспоненциального распада с шумом и восстановим параметры.
rng = np.random.default_rng(42)
# «Эксперимент»: N(t) = N₀·exp(−t/τ) с N₀ = 10, τ = 1.5 плюс шум измерений
t = np.linspace(0, 5, 50)
data = 10 * np.exp(-t / 1.5) + rng.normal(0, 0.3, t.size)
def model(t, n0, tau): # первый аргумент — независимая переменная,
return n0 * np.exp(-t / tau) # остальные — подгоняемые параметры
popt, pcov = optimize.curve_fit(model, t, data, p0=(5, 1)) # p0 — стартовая точка
n0, tau = popt
perr = np.sqrt(np.diag(pcov)) # стандартные погрешности параметров
print(n0, tau) # ≈ 9.876 и ≈ 1.534 при истинных 10 и 1.5
print(perr) # [0.11241755 0.02603728]
curve_fit возвращает оптимальные параметры popt и ковариационную матрицу pcov: корни её диагональных элементов дают погрешности параметров для отчёта, а внедиагональные элементы — ковариации между параметрами. Восстановленные \(N_0 = 9{,}88 \pm 0{,}11\) и \(\tau = 1{,}534 \pm 0{,}026\) согласуются с истинными 10 и 1,5 в пределах полутора погрешностей. Задача без ограничений решается методом Левенберга—Марквардта из MINPACK, а при заданных границах параметров (bounds) — методом доверительной области 'trf'. Сами погрешности основаны на линейном приближении модели вблизи оптимума.
Без начального приближения p0 все параметры начинаются с единицы. В примере выше такое приближение тоже привело бы к верному ответу, однако значение по умолчанию не учитывает ни физического смысла параметров, ни выбранных единиц. Если записать те же моменты времени в наносекундах, время жизни станет равным 1500 нс и превысит стартовое значение на три порядка.
t_ns = t * 1e3 # те же моменты времени в наносекундах
popt_ns, pcov_ns = optimize.curve_fit(model, t_ns, data) # p0 = (1, 1)
print(popt_ns, np.sqrt(np.diag(pcov_ns))) # [10.09141512 1. ] [inf inf]
popt_ns, pcov_ns = optimize.curve_fit(model, t_ns, data, p0=(5, 1000))
print(popt_ns) # [ 9.87635832 1534.20618922]
При τ = 1 нс множитель \(e^{-t/\tau}\) уже во второй точке, t ≈ 102 нс, меньше \(10^{-44}\), а в первой точке, t = 0, от τ не зависит, поэтому производная модели по τ во всех точках практически равна нулю. Метод остаётся в стартовой точке по τ, подогнав лишь \(N_0\) к первому измерению, а SciPy выдаёт предупреждение OptimizeWarning: Covariance of the parameters could not be estimated и бесконечные погрешности. С приближением, выбранным по смыслу задачи, получается прежний ответ в новых единицах. Поэтому для нелинейной модели p0 задаётся явно.
Смысл погрешностей в pcov определяют аргументы sigma и absolute_sigma. Без sigma все точки считаются равноценными, а pcov масштабируется по разбросу остатков вокруг модели. С sigma минимизируется взвешенная сумма квадратов
\[ \chi^2 = \sum_{i=1}^{M} \left(\frac{y_i - f(x_i)}{\sigma_i}\right)^2, \]
однако по умолчанию, при absolute_sigma=False, учитываются лишь относительные значения sigma: ковариационная матрица умножается на приведённый \(\chi^2\), то есть на \(\chi^2/(M - N)\), где \(M\) — число точек, а \(N\) — число параметров. Погрешности тогда описывают разброс точек вокруг модели, а не точность прибора. При absolute_sigma=True значения sigma считаются стандартными ошибками измерений, и pcov выражает именно их, а приведённый \(\chi^2\), близкий к единице, подтверждает согласие модели и оценки ошибок с данными. Если ошибки измерений известны, они передаются через sigma= вместе с absolute_sigma=True. Разницу между режимами наглядно показывает измерение из физики ускорителей.
Подгонка настоящего эксперимента: измерение эмиттанса
На ускорителе измеряется эмиттанс пучка, площадь, занимаемая им в фазовой плоскости «координата — угол», делённая на π. Частицы пучка занимают в этой плоскости эллипс \(\gamma x^2 + 2\alpha x x' + \beta x'^2 = \varepsilon\) площадью \(\pi\varepsilon\); коэффициенты эллипса \(\alpha, \beta, \gamma\) называются параметрами Твисса и связаны соотношением \(\beta\gamma - \alpha^2 = 1\), а поперечный размер пучка равен \(\sigma = \sqrt{\varepsilon\beta}\). Эмиттанс определяет, до какого размера пучок может быть сфокусирован, и потому является основной мерой его качества.
Углы частиц напрямую не измеряются, измерить можно только поперечный размер пучка на люминофорном экране. Решение даёт метод квадрупольного сканирования: изменяя силу квадрупольной линзы перед экраном, снимают зависимость размера пучка от этой силы. В тонколинзовом приближении линза с оптической силой \(k = 1/f\) (нормализованный градиент, умноженный на длину линзы, в 1/м), а за ней промежуток длиной \(l\) до экрана дают матрицу перехода с элементами \(R_{11} = 1 - kl\) и \(R_{12} = l\), а квадрат размера на экране выражается через параметры Твисса \(\alpha_0, \beta_0, \gamma_0\) в месте линзы:
\[ \sigma^2(k) = \varepsilon\left(R_{11}^2\beta_0 - 2R_{11}R_{12}\alpha_0 + R_{12}^2\gamma_0\right), \qquad \gamma_0 = \frac{1+\alpha_0^2}{\beta_0}. \]
Это парабола по \(k\), и три её коэффициента однозначно определяют три искомые величины. Задача сводится к подгонке средствами curve_fit. Модельный скан ниже совпадает со сканом из демонстрации лекции: расстояние до экрана 1,2 м, 25 значений \(k\) от −1,5 до 1,5 1/м, погрешность измерения размера 20 мкм, истинные \(\varepsilon = 0{,}12\) мкм (0,12 мм·мрад), \(\beta_0 = 6{,}94\) м и \(\alpha_0 = -1{,}69\).
l = 1.2 # расстояние «линза → экран», м
def sigma2(k, eps, beta0, alpha0):
gamma0 = (1 + alpha0**2) / beta0
R11, R12 = 1 - k * l, l
return eps * (R11**2 * beta0 - 2 * R11 * R12 * alpha0 + R12**2 * gamma0)
true = (0.12e-6, 6.94, -1.69) # истинные ε (м·рад), β0 (м) и α0
rng = np.random.default_rng(42)
k = np.linspace(-1.5, 1.5, 25) # сила линзы в скане, 1/м
sigma_meas = 20e-6 # погрешность измерения размера, 20 мкм
meas = np.sqrt(sigma2(k, *true)) + rng.normal(0, sigma_meas, k.size) # размеры, м
Модель записана для \(\sigma^2\), поэтому кажется естественным возвести измерения в квадрат и подогнать параболу. Сравним такую подгонку с подгонкой, в которой измерениям возвращён их собственный вес.
# наивно: подгоняем квадраты
popt, pcov = optimize.curve_fit(sigma2, k, meas**2, p0=(1e-6, 5.0, -1.0))
# правильно: та же модель, но точки взвешены своими погрешностями;
# погрешность квадрата: d(sigma^2) = 2*sigma*d(sigma)
w = 2 * meas * sigma_meas
popt_w, pcov_w = optimize.curve_fit(sigma2, k, meas**2, p0=(1e-6, 5.0, -1.0),
sigma=w, absolute_sigma=True)
for name, p, c in (('без весов', popt, pcov), ('с весами', popt_w, pcov_w)):
e = np.sqrt(np.diag(c))
print(f'{name:10} eps = {p[0] * 1e6:.3f} ± {e[0] * 1e6:.3f} мкм '
f'beta0 = {p[1]:.2f} ± {e[1]:.2f} м alpha0 = {p[2]:.2f} ± {e[2]:.2f}')
без весов eps = 0.126 ± 0.045 мкм beta0 = 6.58 ± 2.35 м alpha0 = -1.61 ± 0.64
с весами eps = 0.119 ± 0.009 мкм beta0 = 6.97 ± 0.51 м alpha0 = -1.71 ± 0.13
Оба ответа верны в пределах своих погрешностей, однако погрешность эмиттанса различается в пять раз: 36 % против 7 %. Возведение в квадрат нелинейно, и ошибки оно растягивает неодинаково: погрешность квадрата \(2\sigma \cdot d\sigma\) велика у широкого пучка и мала в перетяжке, где пучок узкий. Подгонка без весов приписывает всем точкам одинаковую погрешность, поэтому результат определяют точки с большим размером пучка, а точки перетяжки почти не влияют на него. Между тем информацию об эмиттансе несёт как раз перетяжка, и наивная подгонка почти не учитывает самые ценные измерения.
Проверим согласие модели с данными и роль absolute_sigma: вычислим приведённый \(\chi^2\) и повторим взвешенную подгонку без absolute_sigma.
M, N = k.size, popt_w.size # число точек и параметров
chi2 = np.sum(((meas**2 - sigma2(k, *popt_w)) / w)**2)
print(f'chi2/(M - N) = {chi2 / (M - N):.2f}')
# тот же вызов без absolute_sigma: pcov умножается на chi2/(M - N)
_, pcov_rel = optimize.curve_fit(sigma2, k, meas**2, p0=(1e-6, 5.0, -1.0), sigma=w)
print(np.allclose(pcov_rel, pcov_w * chi2 / (M - N)))
print(f'погрешность eps без absolute_sigma: {np.sqrt(pcov_rel[0, 0]) * 1e6:.3f} мкм')
corr = pcov_w[0, 1] / np.sqrt(pcov_w[0, 0] * pcov_w[1, 1])
print(f'корреляция eps и beta0: {corr:.2f}')
chi2/(M - N) = 0.74
True
погрешность eps без absolute_sigma: 0.007 мкм
корреляция eps и beta0: -0.99
Приведённый \(\chi^2\) равен 0,74 и для 22 степеней свободы согласуется с единицей, поэтому заданная ошибка 20 мкм не противоречит данным. Без absolute_sigma=True погрешность эмиттанса была бы 0,007 мкм: curve_fit умножил бы ковариационную матрицу на 0,74, чтобы приведённый \(\chi^2\) стал равен единице, и погрешности всех параметров уменьшились бы в \(1/\sqrt{0{,}74} \approx 1{,}16\) раза, описывая разброс точек вокруг модели, а не заданную ошибку измерений. Коэффициент корреляции \(\varepsilon\) и \(\beta_0\), равный −0,99, показывает, что параметры определяются совместно: для величины, вычисляемой из нескольких параметров, необходима вся матрица pcov, а не только её диагональ.
Найдём, наконец, перетяжку, то есть наименьший размер пучка в скане. Минимум параболы по \(R_{11}\) равен \(\sigma_{\min}^2 = \varepsilon l^2/\beta_0\) и достигается при \(R_{11} = l\alpha_0/\beta_0\), то есть при \(k = 1/l - \alpha_0/\beta_0\): для истинных параметров \(\sigma_{\min} = l\sqrt{\varepsilon/\beta_0} = 0{,}158\) мм при \(k = 1{,}08\) 1/м. Сравним с перетяжкой, восстановленной двумя подгонками, на плотной сетке по \(k\).
kk = np.linspace(-1.5, 1.5, 301) # плотная сетка по k, 1/м
for name, p in (('без весов', popt), ('с весами', popt_w), ('модель', true)):
s = np.sqrt(sigma2(kk, *p)) * 1e3 # размер пучка, мм
print(f'{name:10} перетяжка {s.min():.3f} мм при k = {kk[s.argmin()]:.2f} 1/м')
без весов перетяжка 0.166 мм при k = 1.08 1/м
с весами перетяжка 0.157 мм при k = 1.08 1/м
модель перетяжка 0.158 мм при k = 1.08 1/м
Подгонка без весов хуже всего описывает именно точки у перетяжки, несущие информацию об эмиттансе. График такого скана с отрезками погрешностей и кривой модели построен в главе «Визуализация на Python».
Отсюда общее правило: преобразование данных, «выпрямляющее» модель, изменяет и веса точек. Тот же эффект даёт подгонка экспоненты через логарифмирование: log(y) превращает модель в прямую, однако делает равномерный шум неравномерным, и результат смещается. Если преобразование неизбежно, погрешности необходимо пересчитывать вместе с данными и передавать их в sigma=; другой путь состоит в подгонке модели в исходных величинах, например самого размера \(\sigma(k)\) с постоянной погрешностью 20 мкм.
На линейном ускорителе инжектора ЦКП «СКИФ» эмиттанс измеряется так же, только вместо тонколинзового приближения расчёт размера ведётся полной моделью ускорителя, а подгонка выполняется методом COBYQA (Constrained Optimization BY Quadratic Approximations), не требующим производных целевой функции, что удобно, когда каждое её вычисление представляет собой запуск программы моделирования. На выходе первой ускоряющей структуры измерен эмиттанс \(1{,}54 \pm 0{,}08\) мкм при энергии \(36{,}4 \pm 1{,}8\) МэВ, на выходе ускорителя \(0{,}12 \pm 0{,}01\) мкм при \(197{,}9 \pm 9{,}9\) МэВ. Каждый параметр приведён с погрешностью. Подгонка без погрешностей в физике эксперимента считается незаконченной работой, а curve_fit возвращает их в pcov.
scipy.interpolate — интерполяция табличных данных
Экспериментальные данные представлены таблицей, а значение требуется в произвольной точке между узлами. scipy.interpolate строит по таблице непрерывную функцию, например калибровочную кривую (термопара: напряжение → температура). Кусочно-линейную интерполяцию, соединяющую соседние узлы отрезками, выполняет функция NumPy np.interp, а кубический сплайн строит класс CubicSpline.
from scipy import interpolate
# Калибровка термопары: напряжение (мВ) -> температура (°C)
voltage = np.array([0.0, 1.0, 2.0, 3.0, 4.0, 5.0])
temp = np.array([0.0, 25.3, 50.1, 76.4, 101.8, 128.0])
spl = interpolate.CubicSpline(voltage, temp) # кубический сплайн
print(np.interp(2.5, voltage, temp), spl(2.5)) # 63.25 63.20875
print(spl(np.linspace(0, 5, 11))) # интерполянт принимает и массивы
print(spl.derivative()(2.5)) # 26.518055555555563, °C/мВ
Кусочно-линейная интерполяция не добавляет к данным ничего, кроме отрезков. Кубический сплайн состоит из кубических полиномов, сшитых в узлах с непрерывными первой и второй производными, и обеспечивает гладкую кривую. Метод derivative возвращает производную сплайна как новую функцию: наклон калибровочной кривой при 2,5 мВ равен 26,5 °C/мВ, что соответствует чувствительности термопары около 38 мкВ/°C.
print(np.interp(6.0, voltage, temp), spl(6.0)) # 128.0 158.0866666666666
print(interpolate.CubicSpline(voltage, temp, extrapolate=False)(6.0)) # nan
За пределами таблицы np.interp возвращает крайнее значение, а CubicSpline по умолчанию продолжает крайний полином: при 6 мВ получается 128,0 и 158,1 °C соответственно, и ни одна из функций не сообщает о выходе за таблицу. Экстраполяция опасна и требует осознанного решения; сплайн, построенный с extrapolate=False, возвращает за таблицей nan. Класс interp1d, встречающийся в старом коде, отнесён в документации SciPy к устаревшим (legacy); за пределами таблицы он по умолчанию возбуждает исключение ValueError. Для новых программ документация рекомендует np.interp, CubicSpline и make_interp_spline, причём последняя по умолчанию также экстраполирует.
Поскольку на каждом участке сплайн совпадает с полиномом, его можно аналитически дифференцировать и интегрировать; это позволяет, например, получить из таблицы координат скорость.
# Координата свободно падающего тела, измеренная в 11 моментах времени
t = np.linspace(0, 2, 11)
x = 0.5 * 9.81 * t**2
spl = interpolate.CubicSpline(t, x)
v = spl.derivative() # v(t) = dx/dt — тоже готовая функция
print(v(1.0)) # ≈ 9.81 — скорость через секунду падения
Интерполяция проводит кривую точно через все точки, включая испорченные шумом. Для зашумлённых данных применяется сглаживание (interpolate.make_smoothing_spline) или подгонка модели через curve_fit.
scipy.linalg — линейная алгебра
scipy.linalg покрывает и расширяет numpy.linalg: решение систем линейных уравнений, разложения матриц (LU, QR, SVD, Холецкого), собственные значения, матричные функции наподобие expm, считающей экспоненту от матрицы. Решим систему уравнений Кирхгофа для схемы с тремя контурами.
from scipy import linalg
# Метод контурных токов: R @ i = v
R = np.array([[ 11., -5., 0.],
[ -5., 18., -3.],
[ 0., -3., 9.]]) # матрица сопротивлений, Ом
v = np.array([10., 0., 0.]) # ЭДС в контурах, В
i = linalg.solve(R, v) # контурные токи, А
print(i)
print(R @ i) # проверка: получаем обратно v
linalg.solve(A, b) быстрее и численно устойчивее, чем linalg.inv(A) @ b; явное вычисление обратной матрицы почти никогда не требуется.
Второй задачей являются собственные значения, дающие в механике нормальные моды, а в квантовой механике уровни энергии. Рассмотрим два одинаковых груза массы m на пружинах жёсткости k, связанные пружиной kc; уравнения движения имеют вид ẍ = −(K/m)x, а квадраты частот нормальных мод совпадают с собственными значениями матрицы K/m.
m, k, kc = 1.0, 1.0, 0.5
K = np.array([[k + kc, -kc],
[-kc, k + kc]]) # матрица жёсткости связанных осцилляторов
evals, evecs = linalg.eigh(K / m) # eigh — для симметричных (эрмитовых) матриц
omega = np.sqrt(evals) # частоты нормальных мод
print(omega) # [1.0, 1.414...]: √(k/m) и √((k+2kc)/m)
print(evecs) # столбцы — моды: синфазная (1,1) и противофазная (1,-1)
Для симметричных и эрмитовых матриц лучше использовать eigh, а не общий eig: он быстрее, гарантированно возвращает вещественные собственные значения в порядке возрастания и ортонормированные собственные векторы. Гамильтонианы в матричном представлении относятся к этому случаю.
scipy.signal — обработка сигналов
scipy.signal очищает и анализирует данные с АЦП, осциллографа или детектора. Три типовые операции: фильтрация, оценка спектра, поиск пиков.
Смоделируем измерение, в котором полезный сигнал 5 Гц закрыт широкополосным шумом, и подавим шум низкочастотным фильтром Баттерворта.
from scipy import signal
rng = np.random.default_rng(0)
fs = 1000 # частота дискретизации, Гц
t = np.arange(0, 2, 1 / fs) # 2 секунды записи
clean = np.sin(2 * np.pi * 5 * t) # полезный сигнал 5 Гц
noisy = clean + 0.8 * rng.normal(size=t.size)
# НЧ-фильтр Баттерворта 4-го порядка, частота среза 20 Гц
b, a = signal.butter(4, 20, btype='low', fs=fs)
filtered = signal.filtfilt(b, a, noisy) # прогон вперёд и назад:
# нулевой фазовый сдвиг
filtfilt пропускает сигнал через фильтр дважды (вперёд и назад), поэтому не вносит фазовой задержки, и форма и положение пиков не искажаются.
Спектральную плотность мощности оценивают методом Уэлча, усредняющим спектры по перекрывающимся окнам, что снижает разброс оценки по сравнению с одиночным БПФ.
freqs, psd = signal.welch(noisy, fs=fs, nperseg=512)
print(freqs[np.argmax(psd)]) # ≈ 5.9 Гц — пик вблизи частоты сигнала
# (разрешение по частоте здесь fs/nperseg ≈ 2 Гц)
Пики (спектральные линии, импульсы детектора) находит find_peaks с настраиваемыми критериями (минимальная высота, расстояние между пиками, ширина).
peaks, props = signal.find_peaks(filtered, height=0.5, distance=100)
print(t[peaks]) # моменты максимумов синусоиды: шаг ≈ 0.2 с
print(props['peak_heights'])
scipy.fft — быстрое преобразование Фурье
Спектральный анализ напрямую выполняется через scipy.fft, заменивший старый scipy.fftpack. Для вещественных сигналов (а измеренные сигналы вещественны) предпочтительнее использовать rfft, возвращающий только физически осмысленную половину спектра, от нуля до частоты Найквиста fs/2.
Задача состоит в том, чтобы найти в зашумлённой записи скрытые периодические составляющие.
from scipy.fft import rfft, rfftfreq
rng = np.random.default_rng(1)
fs = 1000 # частота дискретизации, Гц
t = np.arange(0, 1, 1 / fs) # 1 секунда записи, N = 1000 отсчётов
x = (np.sin(2 * np.pi * 50 * t) # компонента 50 Гц, амплитуда 1
+ 0.5 * np.sin(2 * np.pi * 120 * t) # компонента 120 Гц, амплитуда 0.5
+ rng.normal(0, 0.5, t.size)) # белый шум
spectrum = rfft(x) # комплексный спектр
freqs = rfftfreq(t.size, 1 / fs) # сетка частот: 0 ... fs/2 = 500 Гц
amp = 2 / t.size * np.abs(spectrum) # нормировка на амплитудный спектр
print(freqs[np.argmax(amp)]) # 50.0 — главный пик
print(amp[freqs == 50], amp[freqs == 120]) # ≈ 1.0 и ≈ 0.5 — амплитуды нашлись
Разрешение по частоте равно 1/T, где T — длительность записи (здесь 1 Гц). Всё, что выше частоты Найквиста fs/2, «заворачивается» вниз (алиасинг), поэтому сигнал перед оцифровкой должен быть отфильтрован. Множитель 2/N преобразует модуль БПФ в амплитуды гармоник. Обратное преобразование выполняет irfft, для комплексных сигналов служит пара fft/ifft, имеются и многомерные версии (fft2, fftn), например для дифракционных картин.
Прочие возможности SciPy
Остальные подмодули:
scipy.statsсодержит распределения, статистические тесты, генерацию случайных величин;scipy.sparseхранит разреженные матрицы (гамильтонианы больших систем, сеточные задачи);scipy.specialсобрал специальные функции: Бесселя, Лежандра, эрмитовы полиномы, гамма-функцию;scipy.ndimageзанимается обработкой изображений (данные с ПЗС-камер);scipy.spatialпокрывает вычислительную геометрию: kd-деревья, триангуляции, ближайших соседей.
Если задача сформулирована в стандартных терминах (задача Коши, наименьшие квадраты, собственные значения), в SciPy почти наверняка найдётся готовая функция нужной точности и скорости. Таким образом, остаётся задать явно точность и смысл результата: допуски solve_ivp по умолчанию дают около трёх верных знаков, погрешности параметров curve_fit зависят от весов и аргумента absolute_sigma, а преобразование данных меняет веса точек.
Полезные ссылки
- Документация SciPy — справочник по всем подмодулям, у каждой функции есть примеры;
- Scientific Python Lectures (бывшие SciPy Lecture Notes) — подробный курс по научному Python: NumPy, SciPy, Matplotlib и продвинутые темы;
- SciPy Cookbook — рецепты для типовых задач: от подгонки данных до решения уравнений в частных производных.
Визуализация на Python
Массивы NumPy и таблицы pandas хранят измерения, SciPy подгоняет модель и возвращает параметры с погрешностями; следующим шагом является визуальный контроль. Две тысячи отсчётов, выведенные в терминал, не дают представления о сигнале, тогда как на графике сразу видны и искажённый фронт импульса, и наводка от сети, и точка, выпадающая из общего ряда.
В настоящей главе рассматриваются библиотеки, которых физику обычно достаточно. Matplotlib строит статическое изображение для статьи и отчёта. Методы plot таблиц pandas и библиотека seaborn строят статистические графики прямо из таблицы. Plotly добавляет интерактивность, ценную при разборе сырых данных: подсказку с точными числами при наведении курсора, масштабирование, много измерений на одном полотне. HoloViews предлагает описывать данные вместо того, чтобы строить график.
Все данные, показанные ниже, вычислены непосредственно в листингах, так что код главы выполняется подряд, от первой строки до последней. Листинги выполнены на одной машине — виртуальной машине под Python 3.12 с Matplotlib 3.11, seaborn 0.13, Plotly 7.1 и HoloViews 1.23, на которой записаны демонстрации лекции «Визуализация данных на Python». Рисунки главы построены этими листингами, а страницы Plotly сняты в браузере.
Слайды к главе. Назначение графика, устройство фигуры Matplotlib, оформление рисунков для статьи, поля и палитры, статистические графики и интерактивные графики Plotly и HoloViews изложены также в лекции «Визуализация данных на Python» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Назначение графика
Сводные статистики не заменяют взгляда на данные. Это наглядно показал статистик Ф. Энскомб в 1973 году: четыре набора по 11 точек с одинаковыми средними, дисперсиями, корреляцией и прямой регрессии устроены совершенно по-разному.
import numpy as np
import matplotlib.pyplot as plt
x = np.array([10, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5], dtype=float)
x4 = np.array([8, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8], dtype=float)
ys = {'I': [8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68],
'II': [9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74],
'III': [7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73],
'IV': [6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89]}
fig, axes = plt.subplots(1, 4, figsize=(12, 3.2), sharey=True)
print('набор ср. x ср. y дисп. x дисп. y корр. наклон сдвиг')
for ax, (name, y) in zip(axes, ys.items()):
xs, y = (x4 if name == 'IV' else x), np.array(y)
slope, shift = np.polyfit(xs, y, 1)
r = np.corrcoef(xs, y)[0, 1]
print(f'{name:>5} {xs.mean():6.2f} {y.mean():6.2f} {xs.var(ddof=1):8.2f} '
f'{y.var(ddof=1):8.2f} {r:6.3f} {slope:7.3f} {shift:6.2f}')
ax.scatter(xs, y, s=18)
grid = np.array([3.0, 20.0])
ax.plot(grid, slope * grid + shift, color='crimson', lw=1)
ax.set_title(name)
ax.set_xlabel('x')
axes[0].set_ylabel('y')
fig.tight_layout()
fig.savefig('anscombe.png', dpi=150)
набор ср. x ср. y дисп. x дисп. y корр. наклон сдвиг
I 9.00 7.50 11.00 4.13 0.816 0.500 3.00
II 9.00 7.50 11.00 4.13 0.816 0.500 3.00
III 9.00 7.50 11.00 4.12 0.816 0.500 3.00
IV 9.00 7.50 11.00 4.12 0.817 0.500 3.00
У всех четырёх наборов совпадают средние 9,00 и 7,50, дисперсия x, равная 11,00, наклон 0,500 и сдвиг 3,00; дисперсия y равна 4,12–4,13, корреляция — 0,816–0,817. Рисунок же показывает четыре разные картины. В первом наборе — линейная зависимость с шумом, во втором — гладкая нелинейная кривая. В третьем десять точек из одиннадцати лежат точно на прямой с меньшим наклоном, около 0,35, а одиннадцатая, при x = 13, отстоит от неё вверх и смещает к себе прямую регрессии. В четвёртом наклон задаёт единственная точка. В 2017 году Дж. Мэтейка и Дж. Фицморис построили набор Datasaurus Dozen, где облака точек самой разной формы, вплоть до рисунка динозавра, имеют одинаковые до сотых средние, стандартные отклонения и корреляцию. Поэтому график является первым шагом анализа, а не последним: он показывает, какие статистики имеют смысл.
Вид графика выбирается по задаче.
| Задача | Вид графика | Функция |
|---|---|---|
| распределение величины | гистограмма, ящик с усами | hist, boxplot |
| зависимость y(x) | линия | plot |
| связь двух величин | точечная диаграмма | scatter |
| измерения с погрешностью | точки с отрезками погрешностей | errorbar |
| поле на сетке | цветовая карта, изолинии | imshow, contour |
| много параметров | параллельные координаты | Plotly |
Несколько правил делают график честным. Ось подписывается величиной и единицами измерения: «Ток пучка, мА». Масштаб выбирается по смыслу: логарифмический — для величин, меняющихся на порядки, например для спектров и профилей пучка, линейный — для остальных; ось столбцовой диаграммы начинается с нуля, поскольку длина столбца и есть величина, а обрезанная ось преувеличивает разницу в разы. Панели, которые сравнивают между собой, получают общие шкалы. Две величины с разными единицами, например давление и ток, строят на двух осях одна под другой с общей шкалой времени, а не на двух шкалах y одних осей: соотношение независимых шкал выбирается произвольно и может создать видимость связи. Круговые и объёмные диаграммы сравнивать трудно, поскольку длину глаз оценивает точнее, чем угол и площадь. Наконец, на графике нет ничего, что не несёт данных: объём, тени и лишние рамки отвлекают и искажают. Э. Тафти называет это отношением «чернил данных» ко всем чернилам рисунка, которое должно быть возможно большим.
Matplotlib
Matplotlib имеет два интерфейса. Первый из них, pyplot, унаследованный от MATLAB, хранит скрытую «текущую фигуру», в которую и добавляют команды наподобие plt.plot. Второй представляет фигуру и оси явными объектами, названными в коде своими именами. Предпочтителен второй: в нём видно, к каким осям относится каждый вызов, и код, растущий вместе с задачей, не нарушается, когда фигур становится несколько.
Фигура Figure — весь холст с полями и общим заголовком; именно она записывается в файл. Оси Axes — прямоугольник с координатами, отведённый под сам график, и на одной фигуре их может быть несколько. Шкалы XAxis и YAxis отвечают за пределы, деления и подписи. Всё нарисованное — линии, текст, прямоугольники — является художниками (Artist), и каждый метод осей возвращает созданный объект для последующей настройки.
Первый пример — осциллограмма, записанная с цилиндра Фарадея, то есть импульс тока пучка на фоне шума оцифровки.
rng = np.random.default_rng(42)
t = np.linspace(0, 10, 2000) # время, мкс
current = 4.2 * np.exp(-((t - 3.5) / 0.45) ** 2) # импульс тока пучка, мА
current += rng.normal(0, 0.10, t.size) # шум оцифровки
fig, ax = plt.subplots(figsize=(7, 3))
ax.plot(t, current, lw=0.8)
ax.set_xlabel('Время, мкс')
ax.set_ylabel('Ток пучка, мА')
ax.grid(alpha=0.3)
fig.tight_layout()
fig.savefig('waveform.png', dpi=300)
subplots возвращает пару из фигуры и осей. Построение выполняется в осях, сохранение — для фигуры. Вызов tight_layout подбирает поля так, чтобы подписи у осей не срезались краем. savefig записывает файл, а plt.show() открывает окно и блокирует скрипт до его закрытия. Если нужно и то и другое, savefig вызывается раньше show: после закрытия окна pyplot забывает фигуру, и plt.savefig записывает уже новую, пустую. На машине без экрана, например на сервере или в контейнере, Matplotlib выбирает бэкенд Agg: plt.show() там ничего не покажет, и графики сохраняются в файлы.
Сырой сигнал редко показывают отдельно: рядом помещают сглаженную кривую, а найденный максимум подписывают стрелкой.
from scipy.signal import savgol_filter
smooth = savgol_filter(current, 101, 3) # окно 101 отсчёт, полином 3-й степени
top = smooth.argmax()
fig, ax = plt.subplots(figsize=(7, 3))
ax.plot(t, current, lw=0.6, alpha=0.4, label='сырой сигнал')
ax.plot(t, smooth, lw=1.6, color='crimson', label='после Савицкого—Голея')
ax.annotate(f'{smooth[top]:.2f} мА при {t[top]:.2f} мкс',
xy=(t[top], smooth[top]), xytext=(t[top] + 1.0, smooth[top] - 0.5),
arrowprops={'arrowstyle': '->'})
ax.set_xlabel('Время, мкс')
ax.set_ylabel('Ток пучка, мА')
ax.legend(loc='center right')
fig.tight_layout()
fig.savefig('waveform-smooth.png', dpi=300)
Две кривые, наложенные в одних осях, различают толщиной, прозрачностью и цветом, а метод legend собирает подписи, переданные параметром label. Метод annotate размещает надпись со стрелкой, протянутой от точки xytext к точке xy на самом графике.
Форматы файлов
Формат файла определяется расширением имени. PNG — растр: число точек равно размеру фигуры в дюймах, умноженному на плотность dpi, и фигура 7 × 3 дюйма при 300 точках на дюйм даёт 2100 × 900 точек; для слайдов и веба достаточно 150–300 точек на дюйм. SVG и PDF — векторные форматы, не теряющие чёткости при увеличении; PDF вставляется в статью, в том числе в LaTeX. По умолчанию Matplotlib записывает текст в SVG кривыми, и подписи правятся в редакторе как текст только при rcParams['svg.fonttype'] = 'none'; в PDF встраиваются шрифты Type 3, а для издательств, требующих шрифтов TrueType, задают rcParams['pdf.fonttype'] = 42. Шумная кривая из двух тысяч отсчётов в векторном файле хранится как две тысячи вершин, и с ростом числа точек векторный файл быстро растёт. Плотное облако точек растеризуют аргументом rasterized=True: точки сохраняются растром, а оси и подписи остаются векторными, и PDF со ста тысячами точек уменьшается в десятки раз.
Подписи с формулами и погрешности
Следующий пример — скан по параметру. Изменяя оптическую силу квадрупольной линзы k = 1/f перед экраном, снимают размер пучка, а по параболе, восстановленной подгонкой, вычисляют эмиттанс; сам метод рассмотрен в главе про SciPy. Измерения, снабжённые погрешностями, изображает errorbar.
l = 1.2 # расстояние «линза — экран», м
eps, beta0, alpha0 = 0.12e-6, 6.94, -1.69 # эмиттанс, м·рад, и параметры Твисса
gamma0 = (1 + alpha0 ** 2) / beta0
def beam_size(k):
"""Размер пучка на экране, м, при оптической силе тонкой линзы k = 1/f."""
R11, R12 = 1 - k * l, l
return np.sqrt(eps * (R11**2 * beta0 - 2*R11*R12*alpha0 + R12**2*gamma0))
k = np.linspace(-1.5, 1.5, 25) # сила линзы в скане, 1/м
meas = beam_size(k) + rng.normal(0, 20e-6, k.size) # ошибка измерения 20 мкм
kk = np.linspace(-1.5, 1.5, 301) # плотная сетка для кривой модели
fig, ax = plt.subplots(figsize=(6, 3.4))
ax.errorbar(k, meas * 1e3, yerr=0.02, fmt='o', ms=4, capsize=3, label='экран')
ax.plot(kk, beam_size(kk) * 1e3, color='crimson', label='модель')
ax.set_xlabel(r'Сила линзы $k$, м$^{-1}$')
ax.set_ylabel(r'Размер пучка $\sigma$, мм')
ax.legend()
fig.tight_layout()
fig.savefig('quadscan.png', dpi=300)
i = beam_size(kk).argmin()
print(f'минимум модели: {beam_size(kk)[i] * 1e3:.3f} мм при k = {kk[i]:.2f} 1/м')
минимум модели: 0.158 мм при k = 1.08 1/м
Подписи осей поддерживают подмножество TeX, заключённое в знаки доллара. Его набирает mathtext, встроенный в Matplotlib и не требующий установленного LaTeX, поэтому индексы, степени и греческие буквы записываются привычным образом. Строку с формулой помечают префиксом r, иначе обратный слеш будет обработан Python раньше Matplotlib. Полный LaTeX включает параметр text.usetex, но тогда на машине должен быть установлен TeX, а для русских подписей в text.latex.preamble подключают пакеты fontenc с кодировкой T2A, inputenc и babel: с преамбулой по умолчанию LaTeX кириллицу не обрабатывает, и сохранение завершается ошибкой.
Параметр yerr задаёт половину отрезка погрешности, fmt — маркер без соединяющей линии, capsize — поперечные засечки. Отрезок может означать стандартное отклонение, стандартную ошибку среднего или доверительный интервал, поэтому подпись рисунка в статье называет, что именно изображено. Модель рисуется по плотной сетке: кривая через 25 точек скана была бы ломаной, а её наименьшая точка — лишь ближайшим к минимуму узлом. Минимум модели, 0,158 мм при k ≈ 1,08 1/м, лежит между узлами скана, взятыми с шагом 0,125 1/м, и потому эмиттанс восстанавливают подгонкой параболы, а не по наименьшему измерению.
В русскоязычной статье десятичный разделитель на осях — запятая, а Matplotlib по умолчанию ставит точку, как и рисунки этой главы. Запятую ставит параметр axes.formatter.use_locale = True после установки русской локали вызовом locale.setlocale(locale.LC_NUMERIC, 'ru_RU.UTF-8'); локаль при этом должна быть установлена в системе.
Поля и палитры
Двумерный массив отображает imshow, окрашивающий каждую ячейку по её значению. Пример — матрица отклика замкнутой орбиты из главы о коррекции орбиты: элемент матрицы определяется бета-функциями в мониторе и корректоре и разностью их бетатронных фаз.
n_bpm, n_cor, nu = 64, 48, 8.42
phi_b = np.sort(rng.uniform(0, 2 * np.pi * nu, n_bpm)) # фазы мониторов
phi_c = np.sort(rng.uniform(0, 2 * np.pi * nu, n_cor)) # фазы корректоров
beta_b = rng.uniform(4.0, 24.0, n_bpm) # бета-функция, м
beta_c = rng.uniform(4.0, 24.0, n_cor)
dphi = np.abs(phi_b[:, None] - phi_c[None, :])
R = (np.sqrt(beta_b[:, None] * beta_c[None, :]) / (2 * np.sin(np.pi * nu))
* np.cos(dphi - np.pi * nu))
print(R.shape)
lim = np.abs(R).max()
fig, ax = plt.subplots(figsize=(5.5, 4.5))
im = ax.imshow(R, cmap='RdBu_r', vmin=-lim, vmax=lim, aspect='auto')
fig.colorbar(im, ax=ax, label=r'$R_{ij}$, мм/мрад')
ax.set_xlabel('Номер корректора $j$')
ax.set_ylabel('Номер монитора $i$')
fig.tight_layout()
fig.savefig('response.png', dpi=300)
(64, 48)
Палитру выбирают по смыслу величины. Для знакопостоянной величины подходит последовательная палитра, светлота которой меняется монотонно: viridis, принятая в Matplotlib по умолчанию с версии 2.0, magma или cividis. Такие палитры различимы и в чёрно-белой печати, и людьми с нарушениями цветового зрения. Для величины, меняющей знак, как элементы матрицы отклика, подходит расходящаяся палитра со светлым центром, такая как RdBu_r, и границы vmin и vmax задаются симметричными, иначе светлый центр сместится с нуля и изображение будет вводить в заблуждение. Симметричные границы задаёт и нормировка CenteredNorm, а TwoSlopeNorm(vcenter=0) помещает ноль в центр палитры и при несимметричном диапазоне. Категории без порядка кодируют качественной палитрой, например tab10. Радужная палитра jet, унаследованная от старых пакетов, неравномерна по светлоте: светлее всего в ней промежуточные значения, окрашенные голубым и жёлтым, а не наибольшие, поэтому на плавно меняющейся величине появляются ложные границы, а настоящие перепады теряются. Величины с большим динамическим диапазоном — профили пучка, спектры — показывают с логарифмической нормировкой LogNorm.
Ячейки у imshow равны между собой, а физическая сетка часто неравномерна, и для неё применяют pcolormesh, принимающий сами координаты узлов. Физические границы изображения задаются параметром extent, и номера пикселей на осях сменяются метрами, а origin='lower' помещает начало координат внизу, как принято в физике. Изолинии и заполненные уровни строят contour и contourf, векторное поле — quiver и streamplot. Цветовая шкала colorbar с подписью величины и единиц обязательна: без неё цвет не переводится в число.
Рисунок для статьи
Фигуру для статьи строят сразу в размере колонки журнала, например 8,6 см, или 3,4 дюйма, в журналах Американского физического общества, со шрифтом, близким к шрифту текста: большая фигура, уменьшенная при вёрстке, превращает подписи в нечитаемо мелкие. Повторяющиеся настройки выносятся в rcParams один раз на весь скрипт, в файл стиля, подключаемый plt.style.use, или в контекст plt.rc_context, действующий внутри одного блока.
style = {
'figure.figsize': (3.4, 2.4), # колонка журнала APS, 8,6 см
'font.size': 9,
'axes.grid': True,
'grid.alpha': 0.3,
'savefig.dpi': 300,
}
with plt.rc_context(style): # на весь скрипт: plt.rcParams.update(style)
fig, (up, down) = plt.subplots(2, 1, sharex=True, figsize=(3.4, 4),
layout='constrained')
up.plot(t, current, lw=0.6)
up.set_ylabel('Ток, мА')
down.plot(t, smooth, color='crimson')
down.set_ylabel('Сглажено, мА')
down.set_xlabel('Время, мкс')
fig.align_ylabels()
fig.savefig('report.pdf') # вектор, не теряющий чёткости при печати
Параметр sharex=True связывает оси подграфиков, и подписи по времени печатаются только под нижним. Параметр layout='constrained' раскладывает оси и подписи без наложений и в пределах фигуры, а align_ylabels выравнивает подписи соседних осей. Обрезка полей bbox_inches='tight' здесь не нужна: она сохраняет прямоугольник, охватывающий элементы фигуры, с полем 0,1 дюйма, и размер файла перестаёт совпадать с заданным — фигура шириной 3,4 дюйма с раскладкой constrained сохраняется шириной около 3,52 дюйма, и при вставке в колонку рисунок вместе со шрифтом уменьшается на 3 %. Для печати сохраняют векторный формат, PDF или SVG; растровый PNG с плотностью 300 точек на дюйм предназначен для слайдов и веба. Все рисунки статьи удобнее строить одним скриптом: правка стиля тогда обновляет весь набор сразу.
Анимация
Matplotlib строит и анимацию. FuncAnimation вызывает функцию для каждого кадра; функция меняет данные уже созданных художников — set_ydata у линии, set_data у точек, set_array у изображения, — что намного быстрее, чем строить график заново. Готовая анимация сохраняется методом save: GIF записывает библиотека Pillow, устанавливаемая вместе с Matplotlib, а MP4 — программа ffmpeg, которую устанавливают отдельно.
from matplotlib.animation import FuncAnimation
xg = np.linspace(-10, 10, 400)
def packet(x, s):
"""Гауссов волновой пакет, смещённый на s."""
return np.exp(-((x - s) / 2) ** 2) * np.cos(3 * (x - s))
fig, ax = plt.subplots(figsize=(6, 2.5))
line, = ax.plot(xg, packet(xg, -5.0))
ax.set_xlabel('Координата x, мкм')
ax.set_ylabel('Амплитуда, отн. ед.')
def update(i):
line.set_ydata(packet(xg, -5.0 + 0.25 * i))
return (line,)
anim = FuncAnimation(fig, update, frames=40, interval=50)
anim.save('packet.gif', writer='pillow', fps=20)
ax.plot возвращает список линий, отсюда запятая в line, =. В блокноте Jupyter анимацию показывает вызов HTML(anim.to_jshtml()) из модуля IPython.display или параметр rcParams['animation.html'] = 'jshtml'; без них при бэкенде inline, принятом в Jupyter по умолчанию, под ячейкой выводится только неподвижный кадр. Для физика анимация — способ показать эволюцию: волновой пакет во времени, огибающую пучка вдоль тракта, распределение частиц по шагам расчёта.
Статистические графики
Методы plot таблиц и столбцов pandas вызывают Matplotlib и возвращают его оси, поэтому дальнейшее оформление — логарифмический масштаб, подписи, пределы — выполняется методами этих осей. Пример — пассажиры «Титаника» из файла titanic.csv, рассмотренного в главе «NumPy и pandas».
import pandas as pd
df = pd.read_csv('titanic.csv')
ax = df.plot.scatter(x='Age', y='Fare', s=8, alpha=0.5, figsize=(6, 3))
ax.set_yscale('log')
ax.set_xlabel('Возраст, лет')
ax.set_ylabel('Плата за проезд, £')
print((df['Fare'] == 0).sum(), ((df['Fare'] == 0) & df['Age'].notna()).sum())
15 7
На логарифмической оси нулевые значения не изображаются: у 15 пассажиров плата за проезд равна нулю, и точки семи из них, с известным возрастом, исчезают с графика без предупреждения. То же происходит с нулевыми каналами спектра, построенного в логарифмическом масштабе.
Библиотека seaborn строит статистические графики поверх Matplotlib прямо из таблицы: столбцы задаются именами, а аргумент hue разбивает данные на группы по ещё одному столбцу и сам строит легенду.
pip install seaborn
import seaborn as sns
print(df.pivot_table(values='Survived', index='Sex', columns='Pclass').round(2))
data = df.assign(пол=df['Sex'].map({'female': 'женщины', 'male': 'мужчины'}),
выжил=df['Survived'].map({0: 'нет', 1: 'да'}))
fig, (left, right) = plt.subplots(1, 2, figsize=(11, 3.6))
sns.barplot(data, x='Pclass', y='Survived', hue='пол',
errorbar=('ci', 95), seed=0, ax=left)
sns.histplot(data, x='Age', hue='выжил', multiple='stack', bins=16, ax=right)
left.set(xlabel='Класс каюты', ylabel='Доля выживших')
right.set(xlabel='Возраст, лет', ylabel='Число пассажиров')
fig.tight_layout()
fig.savefig('titanic.png', dpi=150)
Pclass 1 2 3
Sex
female 0.97 0.92 0.50
male 0.37 0.16 0.14
Функция barplot по умолчанию показывает среднее с 95-процентным доверительным интервалом, вычисленным бутстрепом по 1000 повторных выборок; аргумент seed делает интервал воспроизводимым. Слева видно, что выжили 97 % женщин первого класса и 14 % мужчин третьего, а самый широкий интервал — у женщин третьего класса. Справа — гистограмма возраста, разбитая по исходу: в первом интервале, от 0,42 до 5,4 года, то есть среди детей не старше пяти лет, выжил 31 из 44, а больше всего пассажиров в возрасте 20–25 лет. Средствами одного Matplotlib те же графики потребовали бы группировки, расчёта интервалов и легенды вручную. Распределения seaborn строит функциями histplot, kdeplot, boxplot и violinplot, связь двух величин — scatterplot и regplot; heatmap показывает матрицу, например корреляций, а pairplot — все пары столбцов таблицы.
Plotly
При самостоятельном разборе данных требуется подвести курсор и прочитать точное число, выделить рамкой фрагмент и увеличить его, скрыть лишнюю кривую щелчком по легенде. Эти возможности предоставляет Plotly, строящий график в браузере поверх библиотеки plotly.js.
Слайды к главе. Plotly, HoloViews, анимация и выбор инструмента изложены также в шестой части лекции «Визуализация данных на Python» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
pip install plotly
Пример — огибающая пучка, вычисленная вдоль тракта. Данные даёт уравнение Капчинского—Владимирского, выведенное в отдельной главе, а тракт состоит из пяти соленоидов, расставленных через полметра.
import numpy as np
from scipy.integrate import solve_ivp
gamma = 1 + 2.0 / 0.511 # пучок 2 МэВ
beta = np.sqrt(1 - gamma ** -2)
perv = 2 * 100.0 / (17045 * (beta * gamma) ** 3) # первеанс при токе 100 А
eps = 1e-6 # эмиттанс, м·рад
z_lens = np.arange(0.5, 3.0, 0.5) # пять соленоидов через 0.5 м
z = np.linspace(0, 3, 400) # сетка вдоль тракта, м
def envelope(k):
"""Радиус пучка a(z), м, при жёсткостях соленоидов k."""
def rhs(s, y):
ks = (k * np.exp(-((s - z_lens) / 0.06) ** 2)).sum()
a, ap = y
return [ap, -ks * a + perv / a + eps ** 2 / a ** 3]
return solve_ivp(rhs, (0, 3), [5e-3, 0.0], t_eval=z, max_step=0.005).y[0]
a = envelope(np.full(5, 25.0)) * 1e3 # огибающая, мм
print(f'{a.min():.2f} {a.max():.2f}')
2.36 7.13
Первое изображение собирается вручную из объектов graph_objects, дающих полный контроль над каждой линией.
import plotly.graph_objects as go
fig = go.Figure()
fig.add_scatter(x=z, y=a, name='верх', line={'color': 'crimson', 'simplify': False},
hovertemplate='z = %{x:.2f} м<br>a = %{y:.2f} мм<extra></extra>')
fig.add_scatter(x=z, y=-a, name='низ', line={'color': 'crimson', 'simplify': False},
fill='tonexty', fillcolor='rgba(220,20,60,0.15)',
hoverinfo='skip')
for zi in z_lens:
fig.add_vline(x=zi, line_dash='dot', line_color='gray')
fig.update_layout(xaxis_title='z, м', yaxis_title='Радиус пучка, мм',
showlegend=False, height=350)
fig.write_html('envelope.html', include_plotlyjs='cdn')
Параметр simplify линии отключает её упрощение: по умолчанию plotly.js при отрисовке выбрасывает точки, почти лежащие на одной прямой, и плавная огибающая из четырёхсот точек становится заметно ломаной. Параметр hovertemplate задаёт содержимое всплывающей подсказки: %{x} и %{y} подставляют координаты точки, а <extra></extra> убирает служебную рамку с именем кривой. Метод write_html создаёт рядом самодостаточный файл, открываемый в любом браузере без Python. С ключом include_plotlyjs='cdn' страница загружает plotly.js из сети и занимает десятки килобайт, а со значением True библиотека встраивается внутрь, и файл разрастается до нескольких мегабайт, зато открывается без сети. В браузере при наведении курсора всплывает подсказка с положением и радиусом, прямоугольник, выделенный курсором, растягивается на всё поле, а двойной щелчок возвращает исходный масштаб. Масштабирование колесом мыши у двумерных графиков Plotly по умолчанию выключено и включается аргументом config={'scrollZoom': True} метода write_html. Статичный PNG или PDF из фигуры Plotly сохраняет метод write_image; в Plotly 7 он требует пакета kaleido версии 1 и установленного браузера Chrome.
Скан по параметру удобно показывать картой, поэтому расчёт выполняется для сорока одной жёсткости соленоидов, а полученные огибающие объединяются в один двумерный массив.
k_grid = np.linspace(15.0, 35.0, 41)
scan = np.array([envelope(np.full(5, k)) for k in k_grid]) * 1e3
heat = go.Figure(go.Heatmap(
x=z, y=k_grid, z=scan, colorscale='Viridis',
colorbar={'title': 'a, мм'},
hovertemplate='z = %{x:.2f} м<br>k = %{y:.1f} 1/м²'
'<br>a = %{z:.2f} мм<extra></extra>'))
heat.update_layout(xaxis_title='z, м',
yaxis_title='Жёсткость соленоидов k, 1/м²', height=380)
heat.write_html('scan.html', include_plotlyjs='cdn')
При наведении курсора на точку карты читаются три числа: положение вдоль тракта, жёсткость линз и радиус пучка; в Matplotlib для того же пришлось бы обращаться к массиву по индексам. Изображение, сохранённое в HTML, остаётся интерактивным и после закрытия Python, и такими картами удобно искать рабочую точку установки.
Миллион точек Plotly отрисовывает медленно: обычный Scatter рисуется в SVG, и каждая точка становится отдельным элементом страницы. Для больших массивов предусмотрен Scattergl, рисующий точки растром средствами WebGL на видеокарте; px.scatter сам переходит на него, когда точек больше тысячи.
Когда осей требуется больше трёх, применяют параллельные координаты, где каждая переменная получает свою вертикальную ось, а один опыт превращается в ломаную, пересекающую все оси сразу. Пример — триста случайных настроек тракта, каждая из которых оценивается по среднеквадратичному отклонению радиуса от целевых четырёх миллиметров.
import pandas as pd
import plotly.express as px
rng = np.random.default_rng(1)
trials = rng.uniform(18.0, 32.0, size=(300, 5)) # 300 случайных настроек
loss = np.array([np.sqrt(np.mean((envelope(k) - 4e-3) ** 2)) * 1e3
for k in trials]) # отклонение от 4 мм, мм
runs = pd.DataFrame(trials, columns=[f'k{i}' for i in range(1, 6)])
runs['loss'] = loss
labels = {f'k{i}': f'k{i}, 1/м²' for i in range(1, 6)} | {'loss': 'отклонение, мм'}
par = px.parallel_coordinates(runs, color='loss', labels=labels,
color_continuous_scale='Blues_r')
par.write_html('parallel.html', include_plotlyjs='cdn')
print(f'лучшая настройка: {loss.min():.2f} мм, худшая: {loss.max():.2f} мм')
лучшая настройка: 1.18 мм, худшая: 3.18 мм
Изображение ниже построено теми же параллельными координатами Plotly на настоящей задаче: тысяча прогонов оптимизации оптики линейного ускорителя инжектора ЦКП «СКИФ».
Тысяча строк по восемь чисел в виде таблицы нечитаема, а на параллельных координатах читается. Подписи оставлены такими, какими их вывела программа оптимизации. Крайняя левая ось, Objective Value, несёт значение целевой функции, заключённое между 0,461 и 17,752, а остальные отведены под добавки к токам квадруполей — каналы MG-LA1:QLD1-Iadd, MG-LA1:QLF1-Iadd, MG-LA2:QLD2-Iadd и так далее. Цветом закодирована та же целевая функция, и тёмные линии отмечают удачные прогоны. Там, где жгут линий сливается в узкую полосу, параметр является определяющим, и в эту полосу необходимо попасть. Там, где линии распределены по оси равномерно, параметр на результат почти не влияет, и его отдают оптимизатору целиком. Удачные сочетания видны, поскольку тёмные ломаные идут пучком. В браузере оси перетаскиваются курсором, а по каждой выделяется диапазон, и на экране остаются только прогоны, прошедшие отбор.
HoloViews
Matplotlib строит то, что ему указано, и потому требует расписывать каждый шаг, от подписи оси до заданного вручную цвета.
HoloViews построен на принципе «аннотировать данные, а не строить график». Пользователь описывает семантику данных, то есть что является аргументом, что значением и в каких они единицах, а библиотека сама выбирает представление. Один и тот же объект, собранный однажды, отрисовывается разными бэкендами: интерактивным bokeh, matplotlib или plotly.
pip install holoviews bokeh
Основой является элемент, контейнер с данными, знающий свой тип визуализации. hv.Curve задаёт непрерывную зависимость, hv.Scatter показывает дискретные измерения, hv.Image отображает величину на регулярной сетке. Измерениям задают удобочитаемые подписи и единицы, попадающие затем на оси и во всплывающие подсказки.
import numpy as np
import holoviews as hv
hv.extension('bokeh', 'matplotlib') # первый бэкенд — основной
rng = np.random.default_rng(42)
t = np.linspace(0, 10, 2000)
current = 4.2 * np.exp(-((t - 3.5) / 0.45) ** 2) + rng.normal(0, 0.10, t.size)
dim_t = hv.Dimension('t', label='Время', unit='мкс')
dim_i = hv.Dimension('I', label='Ток пучка', unit='мА')
wave = hv.Curve((t, current), dim_t, dim_i)
wave
В Jupyter объект, возвращённый последней строкой ячейки, отображается автоматически, так что вызывать функцию построения не требуется. С бэкендом bokeh панорамирование, масштабирование и подсказки доступны сразу, и подозрительный выброс, замеченный на графике, рассматривается вблизи без перестроения изображения.
hv.Points внешне похож на Scatter, однако семантика у него иная: обе координаты выступают независимыми измерениями, а точки просто располагаются на плоскости, как частицы на фазовой плоскости. Готовые элементы комбинируются операторами, из которых + размещает графики рядом, а * накладывает их в одних осях.
x = rng.normal(0, 1.0, 2000) # координата частиц, мм
xp = rng.normal(0, 0.3, 2000) # угол, мрад
phase = hv.Points((x, xp), ['x', "x'"])
grid = np.linspace(-3, 3, 200)
xx, yy = np.meshgrid(grid, grid)
spot = hv.Image(np.exp(-2 * (xx ** 2 + yy ** 2) / 1.2 ** 2), # пятно на экране
bounds=(-3, -3, 3, 3), kdims=['x', 'y'], vdims='I')
sparse = hv.Scatter((t[::200], current[::200]), dim_t, dim_i)
overlay = wave * sparse # в одних осях
layout = (wave + phase + spot).cols(3) # рядом, в три колонки
Совмещение работает благодаря тому, что каждый элемент самодостаточен: HoloViews определяет, что измерения у wave и sparse совпали, и сам выравнивает оси, подписи и легенду. Число колонок в компоновке задаёт метод .cols(), вызываемый на готовом объекте.
В Matplotlib скан по параметру превращается в цикл, объединяющий десяток подграфиков в одну фигуру, а HoloMap превращает тот же параметр в слайдер. Он принимает словарь, где каждому значению параметра сопоставлен элемент HoloViews, а не массив.
# модель тракта (z_lens, perv, eps, z) взята из раздела про Plotly
dim_z = hv.Dimension('z', label='Положение', unit='м')
dim_a = hv.Dimension('a', label='Радиус пучка', unit='мм')
def curve(k):
"""Огибающая пучка при жёсткости всех соленоидов k."""
def rhs(s, y):
ks = (k * np.exp(-((s - z_lens) / 0.06) ** 2)).sum()
a, ap = y
return [ap, -ks * a + perv / a + eps ** 2 / a ** 3]
a = solve_ivp(rhs, (0, 3), [5e-3, 0.0], t_eval=z, max_step=0.005).y[0]
return hv.Curve((z, a * 1e3), dim_z, dim_a)
hmap = hv.HoloMap({k: curve(k) for k in [20, 25, 30, 35]}, kdims='k')
hv.save(hmap, 'envelope-scan.html') # слайдер работает и без Python
static = hmap.overlay('k').opts(fig_inches=(8, 3.2), aspect=2.5, fontscale=0.8,
legend_position='right', backend='matplotlib')
hv.save(static, 'envelope-hv.png', backend='matplotlib', dpi=150)
dmap = hv.DynamicMap(curve, kdims='k').redim.range(k=(15.0, 35.0))
HoloMap вычисляет все кадры заранее и хранит их в памяти, зато сохраняется в самодостаточный HTML, который можно передать коллеге; библиотеки BokehJS и Panel страница загружает из сети. Метод overlay('k') накладывает кадры в одних осях, и тот же объект через бэкенд matplotlib сохраняется статичным рисунком; подписи «Положение (м)» и «Радиус пучка (мм)» HoloViews составил сам из описания измерений. DynamicMap вычисляет кадр по движению слайдера, что необходимо, когда параметр непрерывен или каждый расчёт дорог. Однако пересчёт кадра требует запущенного ядра Python: hv.save записывает в файл лишь несколько заранее вычисленных кадров, по умолчанию три значения параметра.
Оформление отделено от семантики и задаётся методом .opts() поверх готового объекта.
overlay.opts(
hv.opts.Curve(width=650, height=280, color='black'),
hv.opts.Scatter(size=7, color='crimson'),
)
# logz — логарифмическая шкала цвета, нужная пучкам и спектрам
# с большим динамическим диапазоном
spot.opts(width=380, height=340, cmap='inferno', colorbar=True, logz=True)
Часть опций зависит от бэкенда: ширина width и высота height заданы в пикселях у bokeh, а у matplotlib вместо них используются fig_inches и aspect. Полный список опций элемента выводит hv.help(hv.Curve).
Вокруг HoloViews сформировалась экосистема HoloViz. Пакет hvPlot после одного импорта добавляет к таблицам pandas метод .hvplot, заменяющий встроенный df.plot(); возвращает он обычные объекты HoloViews со всеми слайдерами и наложениями. Для десятков миллионов точек, например макрочастиц расчёта, служит пакет Datashader: операция rasterize агрегирует изображение в Python, и в браузер передаётся только растр. Библиотека Panel связывает графики, виджеты и текст в единый интерфейс, превращаемый командой panel serve app.py в веб-приложение, и мониторинг установки становится страницей в браузере без единой строки JavaScript.
Выбор инструмента
| Задача | Инструмент |
|---|---|
| рисунок для статьи | Matplotlib |
| статистика из таблицы | seaborn, методы plot pandas |
| разбор сырых данных | Plotly, HoloViews в Jupyter |
| скан по параметру | HoloMap, DynamicMap |
| таблица pandas в браузере | hvPlot: df.hvplot() |
| панель мониторинга установки | Panel: panel serve app.py |
Таким образом, для статьи и отчёта рисунок строится в Matplotlib сразу в размере колонки, с подписями величин и единиц и в векторном формате; статистические сводки по таблице быстрее получить средствами seaborn; для разбора сырых данных и передачи коллегам служат интерактивные страницы Plotly и HoloViews. Во всех случаях вид графика, масштаб осей и палитра выбираются по смыслу данных.
Полезные ссылки
- Галерея matplotlib, где изображение подбирается визуально, а код берётся готовым;
- Scientific Visualization: Python + Matplotlib Николя Ружье, книга про графики, предназначенные для научных статей;
- seaborn.pydata.org, руководство и галерея статистических графиков;
- plotly.com/python, справочник по типам графиков с разобранными примерами;
- holoviews.org и holoviz.org, документация HoloViews и обзор всей экосистемы;
- F. J. Anscombe. Graphs in Statistical Analysis // The American Statistician, 1973, т. 27, № 1 — статья с квартетом Энскомба;
- F. Crameri, G. E. Shephard, P. J. Heron. The misuse of colour in science communication // Nature Communications, 2020, т. 11 — о радужных палитрах и выборе палитры по смыслу величины;
- Уравнение огибающей и коррекция орбиты, главы этой книги, откуда взяты данные для примеров.
Машинное обучение в физических исследованиях
В предыдущих главах рассмотрены обработка массивов данных с помощью NumPy и pandas, численные методы SciPy и визуализация результатов. Следующим шагом является автоматическое извлечение из данных закономерностей с помощью моделей, классифицирующих события, предсказывающих значения физических величин и находящих структуру там, где визуальный анализ уже не позволяет её обнаружить.
Слайды к главе. Материал раздела изложен также в лекции «Машинное обучение» (постановка задачи, ближайшие соседи и линейная регрессия, классификация и метрики, ансамбли деревьев, обучение без учителя, нейронные сети, конвейер scikit-learn) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Назначение раздела
Физика имеет дело с огромными объёмами данных, накопленных установками за годы работы: результаты коллайдера, астрономические наблюдения, численное моделирование. Без инструментов, выделяющих закономерности автоматически, извлечение из них полезной информации становится всё более трудной задачей.
Методы машинного обучения позволяют:
- Находить закономерности в больших наборах собранных данных
- Классифицировать физические объекты и явления
- Предсказывать поведение систем на основе известных данных
- Оптимизировать экспериментальные установки и процессы
Содержание раздела
- Основные понятия, где вводится терминология и рассматриваются типы задач машинного обучения
- Классические алгоритмы, от метода ближайших соседей до градиентного бустинга и кластеризации
- Нейронные сети, то есть модель нейрона, обратное распространение ошибки, оптимизаторы и регуляризация
- Инструменты, прежде всего библиотека scikit-learn, с помощью которой всё перечисленное может быть опробовано на практике
За каждым методом стоит своя математика и своя интуиция; рецепты без объяснения в настоящем разделе не приводятся.
Важное замечание
Раздел не требует глубокого знания машинного обучения. Предполагается, что читатель:
- Знаком с математическим анализом и линейной алгеброй в объёме первого курса
- Владеет программированием хотя бы на базовом уровне
- Готов экспериментировать и искать решения
Расширенная версия
В настоящем разделе собрана основа. Расширенная версия этого материала, дополненная практическими заданиями, в которых алгоритмы реализуются самостоятельно, вышла отдельной книгой «Базовые методы ИИ в физических исследованиях». Готовые рецепты обучения всех основных моделей, от линейной регрессии до нейронных сетей, собраны в сборнике рецептов по машинному обучению.
Таким образом, машинное обучение является таким же рабочим инструментом физика, как освоенный на первом курсе метод наименьших квадратов или преобразование Фурье.
Основные понятия машинного обучения
Терминология, сложившаяся в машинном обучении стихийно, затрудняет понимание: одни и те же понятия называются по-разному, а за привычными словами наподобие «модель» или «обучение», заимствованными из обихода, стоит не совсем то, что принято в физике.
Для физика рассматриваемый материал знаком под другими названиями. Задача обучения модели сводится к задаче оптимизации, функция потерь представляет собой минимизируемый функционал, а регуляризация является способом сделать некорректную задачу корректной.
Слайды к главе. Термины, типы задач, типы признаков и устройство модели изложены также в первой части лекции «Машинное обучение»; слайды лекции доступны на сайте книги и в PDF.
Основные термины
- Искусственным интеллектом (AI) называют систему, способную принимать решения на основе восприятия окружающего мира.
- Машинное обучение (ML) составляет подраздел AI и обозначает систему, принимающую решения на основе накопленного опыта (данных) и текущего состояния мира.
- Глубокое обучение (DL) составляет подраздел ML, основанный на использовании глубоких нейронных сетей (Neural Networks, NN).
- Data Science — дисциплина, объединяющая сбор, обработку, анализ и извлечение знаний из данных.
- Big Data обозначает обработку и анализ данных, масштаб которых не позволяет работать с ними в стандартных инструментах (например, в Excel).
Термины, связанные с данными
- Датасетом, или выборкой (Dataset), называют набор данных, поданный алгоритму на вход.
- Признак, или фича (Feature, X), обозначает характеристику или измеряемый параметр объекта.
- Целевая переменная, она же метка или класс (Label, Target, y), задаёт значение, которое требуется предсказать по признакам объекта.
- Законом природы (в контексте ML) называют скрытую взаимосвязь между признаками и целевой переменной, восстанавливаемую моделью. Формально это отображение из пространства признаков
Xв пространство метокy.
Типы задач машинного обучения
Задачи ML делятся по тому, имеется ли у объектов разметка (метка y) и какова она; разметку проставляет человек или даёт моделирование.
1. Обучение с учителем (Supervised Learning)
Имеется размеченная обучающая выборка, где каждому объекту сопоставлена правильная метка y. Целью является восстановление закона природы X -> y.
Пример. Отбор событий на детекторе (сигнал / фон): модель обучается на событиях, смоделированных методом Монте-Карло, для каждого из которых известно, сигнал это или фон, и затем применяется к зарегистрированным событиям.
2. Обучение без учителя (Unsupervised Learning)
Разметка y отсутствует или не используется. Алгоритм ищет структуры, закономерности и связи в самих данных.
Пример. Разбиение зарегистрированных событий на группы по форме сигнала, когда заранее неизвестно, сколько различных процессов в них присутствует.
Основные типы задач
Внутри этих двух парадигм выделяют несколько типовых постановок.
Классификация (Classification)
- Цель: отнести объект к одному из заранее заданных классов.
- Особенность: множество меток
yконечно и часто невелико. - Подвиды: бинарная (2 класса) и многоклассовая (>2 классов).
- Пример: определение болезни по симптомам (болен/здоров), распознавание цифр, написанных от руки.
Регрессия (Regression)
- Цель: предсказать непрерывную числовую величину.
- Особенность: Метка
yпринимает вещественные значения. - Пример: восстановление энергии частицы по зарегистрированному отклику калориметра, прогноз температуры на завтра.
Кластеризация (Clustering)
- Цель: разбить данные на группы (кластеры) так, чтобы объекты внутри одной группы были похожи, а объекты из разных групп отличались.
- Особенность: заранее проставленные метки отсутствуют (обучение без учителя).
- Пример: поиск групп однотипных событий в данных, накопленных установкой, группировка спектров по форме линий.
Снижение размерности (Dimensionality Reduction)
- Цель: уменьшить количество признаков, перейдя в пространство меньшей размерности и сохранив при этом важные структуры данных (близкие объекты должны остаться близкими).
- Применение: визуализация данных (например, 3D -> 2D), борьба с «проклятием размерности», сжатие данных.
Ранжирование (Ranking)
- Цель: упорядочить объекты (например, документы или товары) по их релевантности запросу или предпочтениям пользователя.
- Пример: выдача результатов поиска, рекомендательные системы.
Генерация (Generation)
- Цель: создавать новые объекты (изображения, текст, музыку), похожие на объекты обучающей выборки, но не совпадающие ни с одним из них.
- Пример: генерация реалистичных лиц, написание текстов в стиле определённого автора.
Типы признаков (Features)
От типа признака зависит как выбор модели, так и способ предобработки, применяемой к данным.
- Бинарные: выбор из двух вариантов (да/нет, кот/не кот).
- Номинальные (категориальные): конечное множество без порядка (цвета, марки машин).
- Порядковые (ординальные): конечное упорядоченное множество (оценки: плохо/удовлетворительно/хорошо/отлично).
- Числовые (вещественные): непрерывные величины (рост, цена, расстояние).
Типы признаков допускают преобразование: если числовой признак разбить на интервалы с заранее выбранными границами, получится порядковый.
Устройство модели
Моделью машинного обучения называют параметрическую функцию (или «чёрный ящик»), отображающую пространство признаков X в пространство ответов y, то есть Model: X -> y.
Внутренние настройки модели называют параметрами, а их подбор по данным — обучением. Параметры изменяются так, чтобы предсказания на обучающей выборке как можно ближе сходились с заранее проставленными метками (или, если метки отсутствуют, чтобы модель выявила скрытую структуру).
Величины, которые задаются до обучения и самим обучением не подбираются, — число соседей, коэффициент регуляризации, глубина дерева, скорость обучения — называют гиперпараметрами; их подбирают отдельно, по качеству модели на отложенной выборке.
На качество обученной модели влияют качество собранных данных, выбор алгоритма, его гиперпараметры и аккуратность процедуры обучения.
В следующей главе осуществляется переход от общих понятий к конкретным алгоритмам, начиная с самого наглядного, метода ближайших соседей.
Классические алгоритмы машинного обучения
В настоящей главе рассматриваются классические алгоритмы машинного обучения: метод ближайших соседей, линейная и логистическая регрессии, деревья решений и построенные на их основе ансамбли (случайный лес, градиентный бустинг), а также методы понижения размерности и кластеризации. Разделы, опирающиеся друг на друга, целесообразно читать по порядку. Изложение носит конспективный характер: строгие выкладки приведены у Хасти [29] и Бишопа [30], рецепты, доведённые до работающего кода, — у Жерона [32].
Слайды к главе. Метод ближайших соседей и масштаб признаков, метод наименьших квадратов, градиентный спуск и регуляризация изложены также во второй части лекции «Машинное обучение» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Метод k-ближайших соседей (KNN)
Постановка задачи
Рассмотрим задачу классификации животных по двум признакам.
- Длина усов
- Длина хвоста
Для каждого объекта обучающей выборки известна метка, кот или пёс; необходимо построить модель, определяющую класс животного по новым измерениям.
На плоскости точки каждого класса группируются в своей области пространства признаков.
Гипотеза о компактности
В основе метода KNN лежит гипотеза о компактности.
Объекты одного класса расположены «близко» друг к другу в пространстве признаков, а объекты разных классов «далеко».
Гипотеза сводит классификацию к поиску близких объектов, уже размеченных в обучающей выборке.
Алгоритм KNN
Определение:
K-ближайших соседей (K Nearest Neighbors, KNN) — один из простейших алгоритмов классификации.
Алгоритм предсказания:
- Для нового объекта вычислить расстояние до всех объектов обучающей выборки
- Выбрать \(K\) объектов с наименьшим расстоянием
- Присвоить объекту класс, чаще всего встречающийся среди \(K\) соседей (голосование большинства)
Гиперпараметр:
\(K\) — количество соседей, участвующих в голосовании.
- При малом \(K\) модель чувствительна к шуму и выбросам
- При большом \(K\) граница решений становится более гладкой, но может потерять локальные особенности
Метрики расстояния
Понятие «близости» определяется выбранной метрикой; ниже \(d\) — число признаков.
Манхэттенское расстояние
$$d(\mathbf{x}, \mathbf{\hat{x}}) = \sum_{i=1}^{d} |x_i - \hat{x}_i|$$
Евклидово расстояние
$$d(\mathbf{x}, \mathbf{\hat{x}}) = \sqrt{\sum_{i=1}^{d} (x_i - \hat{x}_i)^2}$$
Косинусное расстояние
$$d(\mathbf{x}, \mathbf{\hat{x}}) = 1 - \frac{\sum_{i=1}^{d} x_i \hat{x}i}{\sqrt{\sum{i=1}^{d} x_i^2} \cdot \sqrt{\sum_{i=1}^{d} \hat{x}_i^2}}$$
Преимущество косинусного расстояния: оно измеряет угол между векторами, а не абсолютную разницу значений, и потому применимо там, где важна ориентация вектора признаков, а его длина не имеет значения.
Проблемы и решения
1. Зависимость от масштаба признаков
Проблема:
Если признаки имеют разные масштабы (например, 29 признаков ∈ [0, 1], а один ∈ [0, 1000]), то в вычисленном расстоянии будет доминировать признак с большим масштабом.
Решением является нормализация признаков.
- Минимакс-нормализация приводит все значения к диапазону [0, 1]
- Стандартизация приводит их к нулевому математическому ожиданию и единичной дисперсии (\(\mu = 0, \sigma = 1\))
2. Вычислительная сложность
Проблема:
При большом объёме обучающей выборки (\(N\) объектов) поиск ближайших соседей требует \(O(N)\) операций сравнения на каждый объект.
Решением являются структуры данных, ускоряющие поиск.
- kD-tree (k-dimensional tree) строит дерево разбиения пространства, на каждом уровне разделяющее данные по одному признаку
- Ball tree — иерархическая структура из гиперсфер
- HNSW (Hierarchical Navigable Small World) — графовая структура для приближённого поиска ближайших соседей
- FRiS-Stolp отбирает эталоны, заменяющие собой целые группы объектов
3. Улучшение голосования
Вместо простого подсчёта соседей каждого класса можно применить взвешенное голосование: вес соседа обратно пропорционален расстоянию до него.
$$\text{вес}_i = \frac{1}{d(\mathbf{x}, \mathbf{x}_i)} \quad \text{или} \quad \text{вес}_i = e^{-d(\mathbf{x}, \mathbf{x}_i)}$$
Свойства модели KNN
| Аспект | Описание |
|---|---|
| Обучение | Отсутствует в классическом смысле: модель запоминает всю выборку |
| Предсказание | Вычислительно затратно: расстояния считаются до всех запомненных объектов |
| Параметры | Отсутствуют: модель не хранит обученных чисел |
| Гиперпараметры | \(K\) (количество соседей), тип метрики расстояния, стратегия взвешивания |
| Интерпретируемость | Высокая: решение принимается по конкретным соседним объектам |
Метод FRiS-Stolp для отбора эталонов
Для сокращения вычислительной сложности можно оставить подмножество наиболее информативных объектов — эталонов (столпов).
Критерий качества эталона:
Эталон считается хорошим при выполнении двух условий:
- Объекты его класса лежат как можно ближе к нему
- Объекты чужих классов лежат как можно дальше
Функция FRiS: $$\text{FRiS}(z, a_i, b_i) = \frac{r_2 - r_1}{r_2 + r_1}$$
где \(r_1\) — расстояние до ближайшего объекта своего класса, \(r_2\) — до ближайшего объекта чужого класса.
В следующих разделах рассматриваются линейная регрессия, метрики качества моделей машинного обучения и деревья решений.
Линейная регрессия
Постановка задачи
Линейная регрессия решает задачу предсказания непрерывной целевой переменной \(y\) по одной или нескольким входным переменным (признакам) \(x\), измеренным для того же объекта.
В простейшем одномерном случае модель имеет вид
$$\hat{y} = w_1 x + w_0$$
где \(w_1\) означает вес признака (наклон прямой), а \(w_0\) — смещение (bias, свободный член).
Модель предполагает, что истинная зависимость имеет вид
$$y = w_1 x + w_0 + \varepsilon$$
где \(\varepsilon\) — случайная ошибка (шум).
Цель обучения: найти такие параметры \(w_0, w_1, \dots, w_k\), чтобы предсказания модели \(\hat{y}\) оказались максимально близки к значениям \(y\) обучающей выборки.
Функции ошибки
-
SSE (Sum of Squared Errors), сумма квадратов ошибок, $$\text{SSE} = \sum_{i=1}^{N} (y_i - \hat{y}_i)^2 = |\text{error}|_2^2$$
-
MSE (Mean Squared Error), среднеквадратичная ошибка, $$\text{MSE} = \frac{1}{N} \sum_{i=1}^{N} (y_i - \hat{y}_i)^2$$
-
MAE (Mean Absolute Error), средняя абсолютная ошибка, $$\text{MAE} = \frac{1}{N} \sum_{i=1}^{N} |y_i - \hat{y}_i|$$
В линейной регрессии чаще используется MSE, дифференцируемая всюду и приводящая к аналитическому решению.
Матричная форма
Для многомерного случая (\(k\) признаков) модель записывается как
$$y_i = w_1 x_{1,i} + w_2 x_{2,i} + \dots + w_k x_{k,i} + w_0$$
Смещение \(w_0\) включается в вектор весов путём добавления фиктивного признака \(x_0 = 1\) ко всем объектам.
В матричной форме модель имеет следующий вид.
$$\mathbf{y} = \mathbf{X} \mathbf{w}$$
где
- \(\mathbf{y} = \begin{bmatrix} y_1 \ \vdots \ y_N \end{bmatrix}\) — вектор целевых значений,
- \(\mathbf{X} = \begin{bmatrix} x_{1,1} & \cdots & x_{1,k} & 1 \ \vdots & \ddots & \vdots & \vdots \ x_{N,1} & \cdots & x_{N,k} & 1 \end{bmatrix}\) — матрица объектов-признаков (с добавленным столбцом единиц),
- \(\mathbf{w} = \begin{bmatrix} w_1 \ \vdots \ w_k \ w_0 \end{bmatrix}\) — вектор весов.
Оптимизационная задача:
$$\hat{\mathbf{w}} = \arg\min_{\mathbf{w}} |\mathbf{X}\mathbf{w} - \mathbf{y}|_2^2$$
Аналитическое решение методом наименьших квадратов (МНК)
Квадратичная функция потерь записывается следующим образом.
$$Q(\mathbf{w}) = |\mathbf{y} - \mathbf{X}\mathbf{w}|_2^2 = (\mathbf{y} - \mathbf{X}\mathbf{w})^T (\mathbf{y} - \mathbf{X}\mathbf{w})$$
Для нахождения минимума приравняем градиент к нулю.
$$\nabla_{\mathbf{w}} Q(\mathbf{w}) = -2\mathbf{X}^T\mathbf{y} + 2\mathbf{X}^T\mathbf{X}\mathbf{w} = 0$$
Отсюда получаем аналитическое решение.
$$\hat{\mathbf{w}} = (\mathbf{X}^T \mathbf{X})^{-1} \mathbf{X}^T \mathbf{y}$$
Проблемы аналитического решения
На практике этой формулой почти не пользуются по двум причинам.
-
Матрица \(\mathbf{X}^T \mathbf{X}\) может быть необратима.
- При линейной зависимости признаков (коллинеарность),
- Когда число признаков \(k\) превышает число объектов \(N\) (бесконечное множество решений).
-
Вычислительная сложность. Обращение матрицы имеет сложность \(O(k^3)\); при большом числе признаков это недопустимо долго.
Поэтому библиотеки решают задачу без явного обращения матрицы, через QR- или SVD-разложение: так устроены numpy.linalg.lstsq и LinearRegression из scikit-learn. Такое решение и устойчивее: число обусловленности \(\mathbf{X}^T \mathbf{X}\) равно квадрату числа обусловленности \(\mathbf{X}\), и явное обращение теряет вдвое больше значащих цифр.
Градиентный спуск
Когда аналитическое решение неприменимо или неэффективно, применяется итеративный метод оптимизации — градиентный спуск.
Алгоритм:
- Инициализировать веса случайными значениями \(\mathbf{w} \gets \text{random}()\)
- Повторять до сходимости $$\mathbf{w} \gets \mathbf{w} - \alpha \nabla_{\mathbf{w}} Q(\mathbf{w})$$
где
- \(\alpha\) — скорость обучения (learning rate),
- \(\nabla_{\mathbf{w}} Q(\mathbf{w})\) — градиент функции потерь.
Для функции потерь MSE градиент вычисляется как
$$\nabla_{\mathbf{w}} Q(\mathbf{w}) = \frac{2}{N} \mathbf{X}^T (\mathbf{X}\mathbf{w} - \mathbf{y})$$
Варианты градиентного спуска
Варианты различаются числом объектов, используемых для вычисления градиента на каждой итерации.
- Полный градиентный спуск (Batch GD): градиент вычисляется по всей выборке.
- Стохастический градиентный спуск (SGD). Градиент вычисляется по одному случайному объекту.
- Мини-батч градиентный спуск. Градиент вычисляется по небольшой случайной подвыборке (батчу).
Проблемы и улучшения
- Локальные минимумы. Для выпуклых функций (как MSE) проблемы нет: любой локальный минимум является глобальным.
- Выбор скорости обучения \(\alpha\).
- Слишком большая \(\alpha\) приводит к расходимости алгоритма,
- Слишком маленькая \(\alpha\) делает обучение слишком медленным.
- Решением является адаптивное уменьшение \(\alpha\) по мере обучения.
- Для квадратичной функции потерь граница известна точно. Матрица вторых производных MSE равна \(\mathbf{H} = \frac{2}{N}\mathbf{X}^T \mathbf{X}\), и вдоль её собственного вектора с собственным значением \(\lambda\) отклонение от минимума на каждом шаге умножается на \(1 - \alpha\lambda\). Следовательно, спуск сходится лишь при \(\alpha < 2/\lambda_{max}\), а число шагов определяется отношением \(\lambda_{max}/\lambda_{min}\); стандартизация признаков это отношение уменьшает.
- Momentum (инерция). $$\mathbf{v} \gets \rho \mathbf{v} + \alpha \nabla_{\mathbf{w}} Q(\mathbf{w}), \quad \mathbf{w} \gets \mathbf{w} - \mathbf{v}$$ где \(\rho \in (0, 1)\) — коэффициент инерции. Скорость, накопленная на предыдущих шагах, ускоряет сходимость и позволяет «проскакивать» пологие участки.
Проблемы линейной регрессии и их решения
1. Отсутствие линейной зависимости
Если истинная зависимость нелинейна, модель, проводящая через данные прямую, будет давать плохие предсказания.
Пример. Предсказание стоимости склада по длине и ширине. Линейная модель $$\text{цена} = w_1 \cdot \text{длина} + w_2 \cdot \text{ширина} + w_0$$ не учитывает, что значение имеет площадь (\(\text{длина} \times \text{ширина}\)). Решением является новый признак «площадь», произведение сторон.
2. Коллинеарность признаков
Если признаки линейно зависимы (\(x_2 = 2x_1\)), веса становятся неустойчивыми и неинтерпретируемыми.
$$y = 6x_1 + 8x_2 + 5 = 0x_1 + 11x_2 + 5 = 22x_1 + 0x_2 + 5 = \dots$$
Решение. Удаление признаков, дублирующих друг друга (анализ корреляции, методы отбора признаков).
3. Выбросы
Выбросы сильно влияют на MSE из-за квадратичного штрафа.
Решения.
- Фильтрация выбросов на этапе предобработки,
- Использование более устойчивых функций потерь (например, MAE или Huber loss).
4. Шумные признаки и переобучение
Если в модели присутствуют нерелевантные признаки, модель может выучить большие веса и для них, что приведёт к переобучению.
Решением является регуляризация.
Регуляризация
Регуляризация добавляет в функцию потерь штраф, растущий вместе с весами.
L2-регуляризация (Ridge)
$$Q_{\text{reg}}(\mathbf{w}) = \frac{1}{N} |\mathbf{X}\mathbf{w} - \mathbf{y}|_2^2 + \lambda |\mathbf{w}|_2^2$$
- «Выравнивает» веса, уменьшая их по модулю,
- Даёт более стабильное решение на линейно связанных признаках,
- Аналитическое решение имеет вид \(\hat{\mathbf{w}} = (\mathbf{X}^T \mathbf{X} + N\lambda \mathbf{I})^{-1} \mathbf{X}^T \mathbf{y}\). Множитель \(N\) появляется из-за \(1/N\) при первом слагаемом; если записывать потери без нормировки на объём выборки, останется просто \(\lambda \mathbf{I}\).
- Представляет собой регуляризацию Тихонова, знакомую по обратным задачам физики.
L1-регуляризация (Lasso)
$$Q_{\text{reg}}(\mathbf{w}) = \frac{1}{N} |\mathbf{X}\mathbf{w} - \mathbf{y}|_2^2 + \lambda |\mathbf{w}|_1$$
- Также уменьшает веса,
- Обнуляет веса нерелевантных признаков, выполняя автоматический отбор признаков.
Параметр регуляризации \(\lambda\)
- при \(\lambda = 0\) получается обычная линейная регрессия,
- при \(\lambda \to \infty\) все веса стремятся к нулю,
- Оптимальное значение \(\lambda\) подбирается на отложенной валидационной выборке.
Параметры и гиперпараметры
| Тип | Примеры |
|---|---|
| Параметры модели | Веса \(\mathbf{w}\), найденные в процессе обучения |
| Гиперпараметры | Величины, заданные до обучения: скорость \(\alpha\), тип и коэффициент регуляризации \(\lambda\), начальное приближение, использование momentum, размер батча |
Оценка качества модели
По самим предсказаниям невозможно определить, хороши они или нет; для этого необходимы четыре составляющие.
- Метрики ошибки. MSE, MAE на тестовой выборке.
- Базовое сравнение. Сравнение с «наивной» моделью \(\hat{y} = \text{mean}(\mathbf{y})\).
- Разделение выборки. Разбиение на обучающую и тестовую части (train/test split).
- Кросс-валидация. Более надёжная оценка, усреднённая по нескольким разбиениям.
В следующих разделах рассматриваются логистическая регрессия (классификация), метрики качества для задач классификации и деревья решений.
Логистическая регрессия и деревья решений
В настоящем разделе рассматриваются два метода классификации, логистическая регрессия и деревья решений, и метрики качества классификатора. Доля правильных ответов (accuracy) может вводить в заблуждение, и полагаться на неё в одиночку нельзя.
Слайды к главе. Логистическая регрессия, метрики качества, выбор порога и деревья решений изложены также в третьей части лекции «Машинное обучение»; слайды лекции доступны на сайте книги и в PDF.
Линейные классификаторы и логистическая регрессия
От линейной функции к вероятности
Линейный классификатор строит решающую границу в виде гиперплоскости: для объекта с признаками \(x\) модель вычисляет линейную комбинацию
$$ f(x) = w_1 x_1 + w_2 x_2 + ... + w_0 = w^T x $$
В простейшем случае класс определяется знаком функции. $$ \hat{y}_i = \text{sign}(f(x_i)) = \begin{cases} 1, & f(x_i) \geq 0 \ -1, & f(x_i) < 0 \end{cases} $$
Для многих задач требуется вероятность принадлежности к классу, а \(f(x)\) лежит в диапазоне \((-\infty, +\infty)\), тогда как вероятность \(p\) должна лежать в диапазоне \([0, 1]\).
Линейный отклик преобразуется в вероятность следующим образом.
- Рассмотрим вероятность положительного класса \(p_+ = P(y=1|x)\).
- Преобразуем вероятность в шанс (odds). $$ \text{odds} = \frac{p_+}{1 - p_+} \in [0, +\infty) $$
- Прологарифмируем шанс, чтобы получить диапазон \((-\infty, +\infty)\). $$ \log(\text{odds}) = \log\left(\frac{p_+}{1 - p_+}\right) = f(x) $$
Выразим вероятность \(p_+\) из этого уравнения. $$ \frac{p_+}{1 - p_+} = e^{f(x)} \implies p_+ = e^{f(x)} - p_+ e^{f(x)} \implies p_+(1 + e^{f(x)}) = e^{f(x)} $$
Итоговая формула для вероятности (сигмоида). $$ p_+ = \frac{e^{f(x)}}{1 + e^{f(x)}} = \frac{1}{1 + e^{-f(x)}} = \sigma(f(x)) $$
Таким образом, логистическая регрессия моделирует вероятность класса сигмоидой от линейной комбинации признаков.
Понятие отступа (Margin)
Для анализа качества классификации вводится отступ (margin) \(i\)-го объекта.
$$ M_i = y_i f(x_i) = y_i w^T x_i $$
где \(y_i \in \lbrace -1, +1 \rbrace\) — истинная метка класса.
Интерпретация отступа:
- при \(M_i > 0\) объект классифицирован верно (\(y_i = \hat{y}_i\))
- при \(M_i \leq 0\) объект классифицирован неверно (\(y_i \neq \hat{y}_i\))
Примеры:
| \(y_i\) | \(f(x_i)\) | \(M_i = y_i f(x_i)\) | Результат |
|---|---|---|---|
| +1 | +6 | +6 | Верно, уверенно |
| +1 | -6 | -6 | Ошибка |
| -1 | -6 | +6 | Верно, уверенно |
| -1 | +6 | -6 | Ошибка |
Чем больше положительный отступ, тем увереннее модель относит объект к правильному классу. Отступ лежит в основе многих функций потерь, включая log loss.
Задача оптимизации через Log Loss
Для обучения модели необходимо подобрать веса \(w\), максимизирующие правдоподобие данных, в предположении, что объекты независимы и одинаково распределены (i.i.d.).
Вероятность верного предсказания на объекте \(i\) с меткой \(y_i \in \lbrace -1, 1 \rbrace\). $$ P(y_i | x_i, w) = \sigma(y_i w^T x_i) = \sigma(M_i) $$
Функция правдоподобия для всей выборки имеет вид $$ P(Y | X, w) = \prod_{i=1}^{N} \sigma(y_i w^T x_i) \to \max $$
Для удобства оптимизации перейдём к логарифму правдоподобия. $$ \sum_{i=1}^{N} \log \sigma(y_i w^T x_i) \to \max $$
Подставив определение сигмоиды \(\sigma(z) = \frac{1}{1 + e^{-z}}\), получим $$ \sum_{i=1}^{N} \log \frac{1}{1 + e^{-y_i w^T x_i}} = - \sum_{i=1}^{N} \log (1 + e^{-y_i w^T x_i}) \to \max $$
Задача максимизации логарифма правдоподобия равносильна минимизации функции потерь Log Loss. $$ \mathcal{L}(w) = \sum_{i=1}^{N} \log (1 + e^{-y_i w^T x_i}) = \sum_{i=1}^{N} \log (1 + e^{-M_i}) \to \min $$
Связь с отступом: Функция log loss штрафует малые и отрицательные отступы: при \(M_i \to +\infty\) потери стремятся к нулю, а при \(M_i \to -\infty\) растут линейно.
Log loss минимизируется тем же градиентным спуском, что и MSE в линейной регрессии, а защита от переобучения обеспечивается той же регуляризацией, L1 или L2.
Метрики качества классификации
Выбор метрики важен, особенно при сильном дисбалансе классов.
Accuracy и её ограничения
Accuracy (доля правильных ответов). $$ \text{Accuracy} = \frac{\text{Число верных предсказаний}}{\text{Общее число объектов}} $$
Проблема. Accuracy может вводить в заблуждение на данных, состоящих почти целиком из одного класса.
- Пример с диагностикой редкой болезни.
- 100 000 здоровых, 10 больных.
- Если классификатор всегда предсказывает «здоров», Accuracy = \(100000 / 100010 \approx 99.99%\).
- Модель бесполезна: она не находит ни одного больного.
Матрица ошибок (Confusion Matrix)
Для детального анализа используется матрица ошибок, сводящая предсказания и реальность в четыре числа.
| Предсказано: 1 (Больной) | Предсказано: 0 (Здоровый) | |
|---|---|---|
| Реально: 1 (Больной) | TP (True Positive) | FN (False Negative) |
| Реально: 0 (Здоровый) | FP (False Positive) | TN (True Negative) |
- TP — число больных, отнесённых к больным.
- TN — число здоровых, отнесённых к здоровым.
- FP — число здоровых, отнесённых к больным (ошибка I рода).
- FN — число больных, отнесённых к здоровым (ошибка II рода).
$$ \text{Accuracy} = \frac{TP + TN}{TP + TN + FP + FN} $$
Precision и Recall
Для задач с дисбалансом классов чаще используются Precision и Recall, вычисленные по положительному классу.
- Precision (точность) показывает, какая доля объектов, отнесённых к положительным, действительно положительна. $$ \text{Precision} = \frac{TP}{TP + FP} $$
- Recall (полнота) показывает, какую долю объектов, действительно относящихся к положительному классу, модель обнаружила. $$ \text{Recall} = \frac{TP}{TP + FN} $$
При отборе событий в физике эти величины известны под другими названиями: recall называют эффективностью отбора, а precision — чистотой выборки.
Пример 1. Модель нашла 1 больного из 10 и не ошиблась на здоровых.
- Precision = \(1 / (0 + 1) = 1\) (все найденные действительно больные).
- Recall = \(1 / (1 + 9) = 0.1\) (найдена лишь десятая часть больных).
Пример 2. Поменяем целевой класс и будем искать здоровых (100 000 здоровых, 10 больных).
- Precision = \(100000 / (100000 + 9) \approx 0.99991\)
- Recall = \(100000 / (100000 + 0) = 1\)
Предсказания те же, а метрики выглядят превосходно: выбор положительного класса меняет смысл чисел, и указывать его необходимо всегда.
F-мера (F-score)
Для баланса между Precision и Recall используется гармоническое среднее, \(F_\beta\)-мера.
$$ F_\beta = (\beta^2 + 1) \frac{\text{Precision} \times \text{Recall}}{\beta^2 \text{Precision} + \text{Recall}} $$
Наиболее популярна F1-мера (\(\beta = 1\)). $$ F_1 = 2 \frac{\text{Precision} \times \text{Recall}}{\text{Precision} + \text{Recall}} $$
ROC-кривая и AUC
Многие классификаторы (включая логистическую регрессию) выдают вероятность \(p_+ \in [0, 1]\), и порог, отделяющий один класс от другого, можно варьировать.
- TPR (True Positive Rate) совпадает с Recall. $$ \text{TPR} = \frac{TP}{TP + FN} $$
- FPR (False Positive Rate) — доля здоровых, ошибочно отнесённых к больным. $$ \text{FPR} = \frac{FP}{FP + TN} $$
ROC-кривая (Receiver Operating Characteristic) показывает зависимость TPR от FPR при всех порогах.
AUC (Area Under Curve) — площадь под ROC-кривой.
- AUC = 1 соответствует идеальному классификатору.
- AUC = 0.5 соответствует случайному угадыванию.
- Чем больше AUC, тем лучше классификатор ранжирует объекты (отделяет положительный класс от отрицательного).
AUC имеет простой вероятностный смысл: это вероятность того, что случайно выбранный положительный объект получит от модели большую оценку, чем случайно выбранный отрицательный.
Выбор порога определяется целью измерения. При поиске сигнала порог выбирают по наибольшей ожидаемой значимости, в простейшем случае \(S/\sqrt{B}\), где \(S\) и \(B\) — числа отобранных сигнальных и фоновых событий; при малой доле сигнала такой критерий требует прежде всего подавления фона, то есть чистоты. При измерении сечения минимизируют погрешность: статистическую, \(\sqrt{S + B}/S\), вместе с систематическими погрешностями эффективности и доли фона.
Деревья решений (Decision Trees)
Дерево решений — непараметрический метод, строящий цепочку правил, применяемых к объекту последовательно.
Принцип построения
Предположим, что имеется один признак, по которому объекты сортируются и выбирается порог \(t\), разделяющий выборку на две части, \(L\) (left) и \(R\) (right).
Формально для признака \(x_i\) и порога \(t_j\) это записывается следующим образом. $$ Q \xrightarrow{x_i < t_j} \begin{cases} L \ R \end{cases} $$
Разделение должно уменьшить разнородность (гетерогенность) в дочерних узлах; его качество оценивается функцией $$ G(x_i, t_j) = \frac{|L|}{|Q|} H(L) + \frac{|R|}{|Q|} H(R) $$ где \(H(R)\) — функция неопределённости (impurity) в узле.
Критерии неопределённости
Пусть \(p_0\) и \(p_1\) — доли объектов классов 0 и 1 в узле.
- Misclassification (доля ошибок). $$ H(R) = 1 - \max(p_0, p_1) $$
- Entropy (энтропия). $$ H(R) = -p_0 \log_2 p_0 - p_1 \log_2 p_1 = - \sum_k p_k \log_2 p_k $$
- Gini (индекс Джини). $$ H(R) = 1 - p_0^2 - p_1^2 = 1 - \sum_k p_k^2 $$
Критерии остановки (регуляризация)
Если не ограничивать рост дерева, оно переобучится, запомнив каждый объект. Правила остановки следующие.
- Ограничить максимальную глубину дерева.
- Ограничить минимальное количество объектов в узле, разрешённое для дальнейшего деления.
- Ограничить минимальное количество объектов в листе.
- Pruning (обрезка). Построить большое дерево, а затем удалить ветви, не дающие прироста качества на валидации.
Плюсы и минусы деревьев решений
Основным достоинством дерева является интерпретируемость его решения: обученная модель изображается схемой, и специалист, не знакомый с машинным обучением, способен понять, почему предсказание получилось именно таким. Для физического эксперимента это существенно: решение модели необходимо проверить и обосновать, и прозрачная схема правил такую проверку упрощает; непрозрачные ансамбли и сети в опубликованных анализах также применяются, но их эффективность и доля фона проверяются на контрольных выборках. Дерево нечувствительно к масштабу признаков, нормировать данные не требуется, некоторые реализации обрабатывают таблицу с пропущенными значениями, а настраиваемых параметров немного.
Недостатки вытекают из того же устройства: дерево разбивает пространство признаков плоскостями, перпендикулярными осям, поэтому наклонную границу между классами приближает ступенчатой линией. Оно подстраивается под шум: достаточно увеличить глубину дерева, и обучающая выборка будет запомнена целиком. Оно нестабильно: сдвиг нескольких точек полностью перестраивает структуру дерева.
Наиболее важным для физика является то, что дерево не экстраполирует. За пределами диапазона обучающих данных оно возвращает константу, поскольку дальше крайнего разбиения информации у него нет. Если модель обучена на токах до 2 кА, на 3 кА она предскажет то же, что на 2, и не предупредит об этом.
Итоги по классификации
Линейная модель переходит от метки к вероятности; её качество оценивается метриками Precision, Recall, F1 и ROC-AUC. Ключевым понятием является отступ (margin), связывающий линейный отклик модели с качеством классификации и лежащий в основе log loss.
Одиночное дерево решений является сравнительно слабой моделью, однако из деревьев строятся ансамбли — случайный лес и градиентный бустинг, которым посвящён следующий раздел.
Деревья. Случайный лес. Градиентный бустинг
Введение
Одиночное дерево нестабильно и склонно к переобучению, тогда как ансамбли деревьев на протяжении многих лет удерживают первое место на табличных данных. В настоящем разделе рассматриваются регрессионные деревья, разложение ошибки на смещение и разброс (bias-variance) и два способа объединения моделей: бэггинг (Bagging) со случайным лесом (Random Forest) и бустинг (Boosting), включая градиентный.
Слайды к главе. Разложение ошибки на смещение и разброс, бэггинг и случайный лес, градиентный бустинг изложены также в четвёртой части лекции «Машинное обучение»; слайды лекции доступны на сайте книги и в PDF.
1. Деревья решений
Регрессия
Для регрессии критерий разбиения тот же, меняется только мера неоднородности в узле.
- \(G = \frac{|L|}{|Q|} H(L) + \frac{|R|}{|Q|} H(R)\)
- MSE (среднеквадратичная ошибка) даёт \(H_R = \frac{1}{N} \sum_{i}^{N} (y_m - y_i)^2\), где \(y_m\) — среднее значение.
- MAE (средняя абсолютная ошибка) даёт \(H_R = \frac{1}{N} \sum_{i}^{N} |y_m - y_i|\), где \(y_m\) — медиана.
Оптимизация
- Сложность подготовки составляет \(O(N \cdot \log N \cdot d)\), где \(d\) — количество признаков, \(N\) — количество объектов: все признаки необходимо отсортировать перед вычислением ошибки на каждом разбиении.
- Сложность ошибки составляет \(O(N)\).
- Сложность нахождения оптимального разбиения составляет \(O(N^2 d)\).
Пересчёт ошибок можно ускорить: переход от суммы квадратов отклонений для \(N\) объектов к сумме для \(N-1\) объектов выполняется за \(O(1)\) по формулам преобразования сумм. Применяются и эвристики, например случайный набор признаков в каждой вершине.
2. Смещение и Разброс (Bias-Variance)
Разложение ошибки
Рассмотрим модель зависимости истинных значений от функции. $$y = f(x) + \varepsilon$$ Здесь
- \(y\) — истинные значения;
- \(f(x)\) — закон природы;
- \(\varepsilon\) — ошибка измерения (\(\varepsilon \sim N(0, \sigma^2)\), математическое ожидание \(M\varepsilon = 0\)).
Таким образом, \(y \sim N(f(x), \sigma^2)\), математическое ожидание \(My = f(x)\).
Рассмотрим семейство функций-регрессоров \(b = b(x)\), приближающих \(f(x)\). В конкретной точке множество регрессоров даст множество значений, а у \(b(x)\) имеются математическое ожидание и дисперсия.
Разложение среднеквадратичной ошибки (MSE) имеет следующий вид. $$MSE = M(y - b)^2 = M(y^2) + M(b^2) - 2M(by)$$
Используя свойства дисперсии \(Var(x) = Dx = M(x - Mx)^2 = Mx^2 - M[x]^2\), получаем следующее.
- \(My^2 = Dy + M[y]^2 = \sigma^2 + f^2\)
- \(Mb^2 = Db + M[b]^2\)
- \(Mby = M(f + \varepsilon)b = Mfb + M\varepsilon b = fMb + M\varepsilon Mb = fMb\)
Подставляя в формулу MSE, получаем $$MSE = \sigma^2 + f^2 + Db + M[b]^2 - 2fM[b] = (f - M[b])^2 + Db + \sigma^2$$
Здесь
- \((f - M[b]) = \text{bias}\) (смещение);
- \(Db = \text{variance}\) (разброс);
- \(\sigma^2\) — неустранимая ошибка.
Итоговое разложение имеет следующий вид. $$MSE = \text{bias}^2 + \text{variance} + \sigma^2$$
Влияние сложности модели
Два слагаемых разложения действуют в противоположных направлениях: сложная модель подстраивается под конкретную выборку и накапливает variance, простая не достигает закона природы и накапливает bias. Между этими крайностями приходится выбирать; неустранимую \(\sigma^2\) не компенсирует ни одна модель, поскольку это шум измерения в самих данных.
3. Ансамбли моделей
Мудрость толпы
На ярмарке проводился конкурс: требовалось на глаз угадать вес туши быка. Ф. Гальтон, описавший конкурс в 1907 году, разобрал около 800 карточек; бык весил 1198 фунтов, а среднее арифметическое всех догадок составило 1197 фунтов.
Каждый участник ошибался в свою сторону, опираясь на собственный «независимый» опыт, и при усреднении ошибки компенсировали друг друга. Так же ведёт себя случайная погрешность, усреднённая по серии измерений; на этом основана идея ансамблей.
Бэггинг (Bagging)
Предсказания нескольких классификаторов или регрессоров усредняются, а чтобы обеспечить моделям разный «опыт», их обучают на разных данных. Подвыборки формируются методом Bootstrap: элементы общей выборки выбираются случайно, и один и тот же элемент может попасть в подвыборку несколько раз.
Пусть \(b_1(x), ..., b_n(x)\) — модели регрессии, обученные на разных подвыборках, \(f(x)\) — функция истинных значений. Квадратичная ошибка \(i\)-й модели равна \(\varepsilon_i^2(x) = (b_i(x) - f(x))^2\). Если усреднить ошибку всех моделей, получим \(\frac{1}{n} M_x [\sum \varepsilon_i^2(x)]\).
Предположим, что ошибки несмещены (\(M_x \varepsilon_i(x) = 0\)) и некоррелированы (\(M_x \varepsilon_i(x)\varepsilon_j(x) = 0\) при \(i \neq j\)). Построим новую модель. $$a(x) = \frac{1}{n} \sum_{i}^{n} b_i(x)$$
Тогда среднеквадратичная ошибка новой модели равна $$M_x \left( \frac{1}{n} \sum_{i}^{n} b_i(x) - f(x) \right)^2 = M_x \left( \frac{1}{n} \sum_{i}^{n} \varepsilon_i(x) \right)^2 = \frac{1}{n^2} M_x \sum_{i}^{n} \varepsilon_i^2(x)$$
Вывод. Бэггинг снижает variance в ошибке (то есть ослабляет переобучение) в \(n\) раз, только если ошибки некоррелированы. При корреляции ошибок \(\rho\) дисперсия среднего из \(n\) моделей равна \(\rho\sigma^2 + (1 - \rho)\sigma^2/n\) и с ростом \(n\) стремится к \(\rho\sigma^2\); деревья, обученные на подвыборках одной выборки, ошибаются похоже, и в демонстрации лекции «Машинное обучение» лес из 100 деревьев уменьшил разброс одиночного дерева лишь вдвое. Модели «в среднем» ошибаются одинаково, но в разные стороны, а выбросы попадают лишь в часть подвыборок.
Случайный лес (Random Forest)
Метод развивает идею бэггинга применительно к деревьям.
- Деревья обучаются на разных подвыборках.
- Для повышения некоррелированности деревьев при построении узла наилучшее разбиение ищется не по всем признакам, а лишь по случайно выбранной их части.
Гиперпараметры леса: число деревьев плюс гиперпараметры одного дерева. Ответы деревьев объединяются усреднением: в регрессии усредняются предсказанные значения, в классификации — вероятности классов (так устроен RandomForestClassifier в scikit-learn; в исходной работе Л. Бреймана деревья голосовали большинством).
Случайный лес является удобной моделью «по умолчанию»: он точен, устойчив к выбросам, менее одиночного дерева склонен к переобучению, распараллеливается (деревья независимы, каждое вычисляется на своём ядре) и, как правило, хорошо работает с настройками по умолчанию.
Платой являются прозрачность и ресурсы: лес из сотен деревьев не поддаётся визуальному прочтению, требует большого объёма памяти, плохо обрабатывает разреженные признаки и, как и одиночное дерево, не экстраполирует за пределы обучающих данных.
4. Бустинг
AdaBoost и решающие пни
В бустинге объекты, на которых ансамбль ошибся, получают больший вес на следующем шаге, и каждая новая модель в первую очередь исправляет ошибки предшественников. Базовые модели намеренно выбираются слабыми, часто это «пни» (decision stumps), деревья глубиной 1.
Градиентный бустинг на примере
Задача. Предсказать цену товара по возрасту (в днях). Предположим, что имеется только один признак.
Шаг 1. Начальное приближение — среднее по всей выборке. Цены равны 700, 800, 600, 400, 300. Среднее даёт \((700+800+600+400+300) / 5 = 560\).
Вычислим остатки — разность цены и приближения.
| Возраст (дней) | Цена | Приближение | Остаток |
|---|---|---|---|
| 25 | 700 | 560 | 140 |
| 50 | 800 | 560 | 240 |
| 75 | 600 | 560 | 40 |
| 80 | 400 | 560 | -160 |
| 100 | 300 | 560 | -260 |
Шаг 2. Построим регрессионное дерево, предсказывающее остатки. Разбиение выполняется по признаку Возраст >= 80.
- Ветка 1 (Age < 80) даёт остатки 140, 240, 40 со средним 140.
- Ветка 2 (Age >= 80) даёт остатки -160, -260 со средним -210.
Шаг 3. Прибавим предсказание дерева к приближению (можно с коэффициентом, в примере без него).
| Возраст | Цена | Приближение №1 | Остаток №1 | Выход дерева №1 | Приближение №2 | Остаток №2 |
|---|---|---|---|---|---|---|
| 25 | 700 | 560 | 140 | 140 | 700 | 0 |
| 50 | 800 | 560 | 240 | 140 | 700 | 100 |
| 75 | 600 | 560 | 40 | 140 | 700 | -100 |
| 80 | 400 | 560 | -160 | -210 | 350 | 50 |
| 100 | 300 | 560 | -260 | -210 | 350 | -50 |
Далее процедура повторяется: строится следующее дерево, корректируется приближение, вычисляются новые остатки.
Формализация градиентного бустинга
На \(t\)-м шаге модель представляет собой сумму функций, накопленных к этому моменту. $$f(x) = \sum_{i=0}^{t-1} f_i(x)$$
Параметры нового шага находятся через минимизацию функции потерь \(L\). $$\rho_t, \theta_t = \arg\min_{\rho, \theta} M_{x,y} [L(y, f(x) + \rho h(x, \theta))]$$ где \(f_t(x) = \rho_t h(x, \theta_t)\).
Остаток на \(i\)-м элементе, он же градиент, равен $$r_{i,t} = - \left[ \frac{\nabla L(y_i, f(x_i))}{\nabla f(x_i)} \right]$$ Этот остаток является целью дерева, строящегося на следующем шаге.
- Параметры дерева находятся как \(\theta_t = \arg\min_{\theta} \sum_{i}^{n} (r_{i,t} - h(x_i, \theta))^2\)
- Параметры «линейной регрессии», то есть шага, находятся как \(\rho_t = \arg\min_{\rho} \sum_{i}^{n} L(y_i, f(x_i) + \rho h(x_i, \theta_t))\)
Случай MSE. Для среднеквадратичной ошибки остаток равен разнице между истинным значением и предсказанием. $$r_{i,t} = - \frac{\nabla L}{\nabla f} = 2(y_i - f(x_i)) \rightarrow \text{разница между истинным значением и предсказанием}$$
Сравнение градиентного бустинга и бэггинга
Оба метода строят ансамбль деревьев, но устроены противоположно: в бэггинге деревья независимы, в бустинге они выстроены в цепочку.
По точности бустинг обычно превосходит бэггинг и случайный лес, поэтому стал первым выбором для табличных данных. Однако он сильнее склонен к переобучению, и тестовая выборка обязательна. Причина в той же цепочке: каждое дерево исправляет ошибки предыдущих, и если дерево в начале цепочки подстроилось под шум, исправить это последующие деревья уже не смогут.
Поэтому деревья в бустинге намеренно делают неглубокими, три-четыре уровня, не больше. Сила ансамбля заключается в количестве деревьев, а не в сложности каждого.
Бустинг плохо распараллеливается: деревья строятся последовательно, и распараллелить можно лишь построение одного дерева. Деревья случайного леса вычисляются одновременно на всех ядрах, и на большой выборке разница во времени обучения оказывается решающей. При этом бустинг не привязан к деревьям: базовой моделью может быть и линейная, однако сумма линейных моделей остаётся линейной, поэтому градиентный бустинг почти всегда строят из деревьев.
Понижение размерности. Кластеризация
В настоящем разделе рассматриваются две задачи обучения без учителя. Первая — сжать признаковое пространство, сохранив структуру данных; для этого применяются метод главных компонент (PCA) и t-SNE. Вторая — разделить на группы объекты, не размеченные заранее; здесь используются k-средних, иерархическая кластеризация и DBSCAN.
Слайды к главе. Метод главных компонент, t-SNE, k-средних, иерархическая кластеризация и DBSCAN изложены также в пятой части лекции «Машинное обучение»; слайды лекции доступны на сайте книги и в PDF.
1. Понижение размерности
Основная идея
Понижение размерности должно сохранить расстояния между точками при переходе к пространству меньшей размерности: соседи в пространстве высокой размерности должны остаться соседями и после сжатия, а удалённые друг от друга точки — удалёнными.
Метод главных компонент (PCA)
Простое отбрасывание одной из осей почти всегда является плохим решением: в худшем случае облако точек, спроецированное на оставшиеся оси, схлопнется в одну точку.
Основная концепция:
- Предполагается, что облако данных описывается эллипсом, вытянутым вдоль главных направлений.
- Меняется базис пространства.
- Отрезается «новая ось» с минимальной дисперсией.
- Чтобы вычислить «потерянную информацию», дисперсия отрезанной оси делится на сумму дисперсий по всем осям.
Вычисления. Ковариация признаков вычисляется по формуле $$cov(X_i, X_j) = M[(X_i - M[X_i])(X_j - M[X_j])] = M[X_i X_j] - M[X_i]M[X_j]$$
Выборку можно сместить так, чтобы математическое ожидание \(M[X_i] = 0\). В матричном виде ковариация записывается следующим образом. $$cov(X) = \frac{1}{N} X^T X$$
Свойства.
- Ковариация симметрична.
- Ковариация признака с самим собой равна его дисперсии.
- Направление оси с максимальной дисперсией совпадает с собственным вектором, отвечающим максимальному собственному значению.
- Собственное значение здесь равно дисперсии.
Ограничения PCA.
- Признаки, измеренные в разных единицах, необходимо стандартизировать, иначе признак, выраженный в больших единицах, будет доминировать; признаки одной природы, например яркости пикселей или отсчёты спектра, стандартизации не требуют.
- Не работает со сложными структурами, не похожими на эллипс.
t-SNE (t-Distributed Stochastic Neighbor Embedding)
Механическая аналогия.
- Данные из пространства размерности \(D\) помещаются в пространство меньшей размерности \(m\) (отображение).
- Объекты «прибиваются гвоздями» к своим местам.
- Объекты в пространстве \(m\) соединяются пружинами, сила которых зависит от того, насколько расстояние в пространстве \(m\) отличается от расстояния в пространстве \(D\).
- Система «отпускается» (гвозди убираются).
Динамика.
- Если точки в пространстве \(m\) дальше, чем в пространстве \(D\), то они притягиваются.
- Если точки в пространстве \(m\) ближе, чем в пространстве \(D\), то они отталкиваются.
Математическое описание. Пусть \(|x_i - x_j|\) — расстояние в исходном пространстве, \(|y_i - y_j|\) — расстояние в пространстве отображения.
Условное сходство через Гауссово распределение записывается следующим образом. $$p_{j|i} = \frac{e^{-|x_i - x_j|^2 / 2\sigma_i^2}}{\sum_{k \neq i} e^{-|x_i - x_k|^2 / 2\sigma_i^2}}$$ где \(\sigma_i^2\) — дисперсия распределения Гаусса вокруг точки \(x_i\), у каждой точки своя, подобранная под плотность окрестности.
Симметричное сходство даёт $$p_{ji} = \frac{p_{j|i} + p_{i|j}}{2N}$$
В пространстве меньшей размерности используется не Гауссово распределение, а распределение Стьюдента с одной степенью свободы (t-distribution), утяжелённое на хвостах. $$q_{ij} = \frac{t(|y_i - y_j|)}{\sum_{k \neq l} t(|y_k - y_l|)}, \text{ где } t(x) = \frac{1}{1 + x^2}$$
Нормировка выполняется по всем парам сразу, а не по соседям одной точки, поскольку только так \(Q\) остаётся симметричным совместным распределением, как и \(P\).
Оптимизация. Матрица сходства в отображении приближается к матрице исходного пространства путём минимизации расстояния Кульбака-Лейблера. $$KL(P||Q) = \sum_{i,j} p_{ij} \log \frac{p_{ij}}{q_{ij}} \to \min$$
Минимизация выполняется градиентным спуском, а сам градиент даёт равнодействующую всех сил, приложенных к точке. $$\frac{\partial KL(P||Q)}{\partial y_i} = 4 \sum_j (p_{ij} - q_{ij}),(y_i - y_j),\bigl(1 + |y_i - y_j|^2\bigr)^{-1}$$ Все вычисления выполняются в пространстве отображения: разность \(y_i - y_j\) задаёт направление силы, знак \(p_{ij} - q_{ij}\) — притяжение или отталкивание, а величина пропорциональна \(|p_{ij} - q_{ij}| \cdot t(|y_i - y_j|) \cdot |y_i - y_j|\). Исходные координаты \(x\) в градиент не входят, поскольку они уже учтены в \(p_{ij}\).
Обоснование выбора t-distribution. При понижении размерности максимальные расстояния «меняются», и если использовать распределение Гаусса, то точки на плоскости расположатся очень скученно (crowding problem).
Особенности t-SNE.
- Работает со сложными структурами.
- Новые данные спроецировать невозможно: требуется либо полное переобучение, либо дополнительные приёмы (например, k-nn).
- Вычисления длительны. Можно использовать не все точки, а только ближайших соседей.
- Если брать мало соседей, t-SNE больше учитывает локальные паттерны.
- Если брать много соседей, t-SNE больше учитывает глобальные паттерны.
2. Кластеризация
k-средних (k-means)
Наиболее распространённый метод кластеризации; с него почти всегда начинают, поскольку он быстр, хотя и требует заранее заданного числа кластеров и предполагает кластеры примерно шарообразными и сопоставимого размера.
Алгоритм.
- Задать количество кластеров.
- Случайным образом разместить точки (центроиды) в пространстве.
- Для каждой точки определить, к какому центроиду она ближе.
- Переместить каждый центроид в «центр масс» точек, приписанных ему на предыдущем шаге.
- Повторять пункты 3-4 фиксированное число раз, или пока перемещение центроидов не станет достаточно малым (алгоритм сойдётся).
Особенности и ограничения:
- Необходимо задавать количество кластеров, а для его подбора рассматривается сумма квадратов расстояний от точек до своих центров. Как только с ростом числа кластеров она перестаёт резко падать, можно останавливаться.
- Чувствителен к начальному расположению центроидов.
- Имеются ограничения на форму кластеров.
- Результат зависит от начальных центров, поэтому расчёт повторяют с разными начальными центрами (в scikit-learn — параметр
n_init) и выбирают разбиение с наименьшей суммой квадратов расстояний.
Агломеративная (иерархическая) кластеризация
Число кластеров заранее знать не требуется: метод строит всё дерево слияний, а разрез на нужном уровне выполняется впоследствии по построенной диаграмме. Платой является вычислительная сложность, из-за которой метод плохо масштабируется на большие выборки.
Алгоритм «снизу-вверх» устроен следующим образом.
- Сначала каждая точка образует отдельный кластер.
- Вычисляются попарные расстояния между кластерами; способ их вычисления задаёт связь (linkage): по ближайшим точкам, по самым удалённым, по среднему расстоянию или по приросту суммы квадратов отклонений от центров (метод Уорда, применяемый в scikit-learn по умолчанию).
- Пара ближайших кластеров объединяется в новый.
- Пункты 2-3 повторяются, пока все точки не будут объединены в один кластер.
DBSCAN
DBSCAN является единственным из трёх методов, помечающим точки, не относящиеся ни к одному кластеру. Кластеры он ищет как области повышенной плотности, поэтому находит кластеры произвольной формы, а их число определяет самостоятельно. Явно выделенные выбросы являются готовым инструментом поиска аномалий в данных с установки.
У метода два гиперпараметра, радиус окрестности \(\varepsilon\) и минимальное
число точек \(m\) в этом радиусе, причём сама точка тоже учитывается
(в scikit-learn это eps и min_samples).
Соседями точки считаются все точки, которые лежат от неё не дальше \(\varepsilon\).
Алгоритм.
- Выбирается случайная точка.
- Если у неё меньше \(m\) точек в окрестности радиуса \(\varepsilon\), то она помечается как потенциальный выброс (noise point), и выбирается другая точка.
- Если точек в окрестности радиуса \(\varepsilon\) не меньше \(m\), выполняется следующее.
- Заводится новый кластер, и точка (core point) помещается в него.
- Если сосед оказался потенциальным выбросом или у него мало соседей, то это край кластера (border point). Он заносится в кластер, и осуществляется переход к другому соседу.
- Если у соседа достаточно собственных соседей, то он добавляется в кластер (core point), а его соседи заносятся в очередь обхода.
- Пункты 1-3 повторяются.
- Точки, так и не попавшие ни в один кластер, остаются выбросами, и это не «ещё один кластер». В scikit-learn они получают метку \(-1\), и общего между ними только то, что плотности вокруг каждой не хватило.
Выбор между тремя методами осуществляется следующим образом: если число кластеров известно и ожидаются компактные группы — k-средних; если число неизвестно, а выборка небольшая — агломеративная; если кластеры имеют сложную форму или необходимо отделить выбросы — DBSCAN.
Итоги по понижению размерности и кластеризации
Обе задачи решаются без учителя и необходимы, когда о данных ещё ничего не известно. PCA и t-SNE позволяют визуально оценить многомерную выборку; k-средних, агломеративная кластеризация и DBSCAN разделяют её на группы. Размеченного правильного ответа здесь нет, и сверять результат приходится с физическим смыслом.
Нейронным сетям посвящена следующая глава.
Нейронные сети
Классические алгоритмы хорошо работают с признаками, сформулированными человеком, будь то размер пучка, ток корректора или энергия события. Однако если признаки необходимо извлекать из сырого сигнала, из снимка, полученного камерой, из осциллограммы или спектра, их приходится конструировать вручную, и качество ограничивается изобретательностью физика. Нейронные сети выучивают признаки самостоятельно.
В настоящей главе рассматриваются математическая модель нейрона и функции активации, построение из нейронов многослойной сети и её обучение методом обратного распространения ошибки (backpropagation), а далее — оптимизаторы (SGD, Adam, RMSProp), нормализация данных и весов и регуляризация, позволяющая бороться с переобучением. Материал, изложенный здесь в одной главе, подробно рассмотрен у Гудфеллоу [31], а доведён до работающего кода — у Жерона [32].
Слайды к главе. Нейрон и задача XOR, обратное распространение ошибки и проверка градиента, оптимизаторы, инициализация и регуляризация изложены также в шестой части лекции «Машинное обучение» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
1. Нейрон и функции активации
Математический нейрон
Математический нейрон подобен биологическому: он принимает входные сигналы, взвешивает их и пропускает полученную сумму через выбранную функцию активации.
Рассмотрим пример, в котором по трём признакам необходимо предсказать, сдаст ли студент экзамен.
- \(X_1\) показывает, задавал ли студент вопросы на лекциях (1/0).
- \(X_2\) показывает, попал ли он к лектору на экзамене (1/0).
- \(X_3\) показывает, сдал ли он лабораторные работы (1/0).
Логика задачи следующая.
- Если студент попал к лектору, то он сдаст экзамен только при условии, что задавал вопросы и сдал лабораторные работы.
- Если студент не попал к лектору, то для сдачи достаточно либо задавать вопросы, либо сдать лабораторные работы.
Модель нейрона вычисляет взвешенную сумму входов. $$S = W_1X_1 + W_2X_2 + W_3X_3$$
Выход нейрона \(Y\) определяется пороговой функцией активации. $$f(x) = \begin{cases} 1, & x \ge 0.5 \ 0, & x < 0.5 \end{cases}$$
Для такой простой логики подходят веса \(W_1 = 0.5, W_2 = -0.5, W_3 = 0.5\). Тогда для входа \((1, 1, 1)\) получаем \(0.5 \cdot 1 - 0.5 \cdot 1 + 0.5 \cdot 1 = 0.5 \ge 0.5 \rightarrow\) сдал (1).
Проблема одного слоя
Один слой проводит в пространстве признаков единственную разделяющую плоскость. Поэтому задачу, классы которой не разделяются плоскостью, персептрон не решает: например, экзамен сдают те, кто либо задавал вопросы, либо сдал лабораторные работы, но не то и другое одновременно, — это XOR, и никакая прямая \(W_1X_1 + W_3X_3 = c\) такие классы не разделит; лучшая прямая верно классифицирует лишь три угла квадрата из четырёх.
Скрытые слои
Скрытые слои располагаются между входом и выходом. Слой \(Z\) строит новое признаковое пространство, в котором прежде неразделимая задача решается одной плоскостью, проведённой уже в нём. $$Z_1 = f(W_{11,1}X_1 + W_{12,1}X_2 + \dots)$$ $$Y_1 = f(W_{21,1}Z_1 + W_{22,1}Z_2 + \dots)$$
Функции активации
Для обучения сети методом градиентного спуска функции активации должны быть дифференцируемы.
- Пороговая функция. Она ближе всего к биологической модели, но для обучения не подходит: в точке порога она не дифференцируема, а всюду вне её производная равна нулю, и градиент отсутствует.
- Сигмоида: Дифференцируемая функция. $$\sigma(x) = \frac{1}{1 + e^{-x}}$$ Производная сигмоиды имеет следующий вид. $$\frac{d\sigma(x)}{dx} = \sigma(x)(1 - \sigma(x))$$
2. Обучение нейронной сети
Обучение одного нейрона
Обучение одного нейрона с сигмоидальной функцией активации ничем не отличается от обучения логистической регрессии, а обучаемыми параметрами здесь являются веса \(W\).
Метод обратного распространения ошибки (Backpropagation)
Для пересчёта весов в многослойной сети необходимо знать ошибку, приписанную каждому нейрону; для выходного слоя \(Y_1\) она вычисляется непосредственно, а для скрытых слоёв \(Z\) требуется метод обратного распространения.
Цепное правило (Chain Rule): $$\frac{dz}{dx} = \frac{dz}{dy} \cdot \frac{dy}{dx}$$
Пример вычисления градиента: Пусть задана функция \(f(x, y, z) = (x + y)z\).
- \(q = x + y\), откуда \(\frac{dq}{dx} = 1, \frac{dq}{dy} = 1\).
- \(f = zq\), откуда \(\frac{df}{dq} = z, \frac{df}{dz} = q\).
- Итоговые градиенты дают \(\frac{df}{dx} = \frac{df}{dq} \cdot \frac{dq}{dx} = z \cdot 1\).
Обновление весов: Ошибкой называется разность между полученным выходом (actual) и ожидаемым (expected). $$err = actual - expected$$ Для сигмоиды градиент веса включает производную функции активации. $$weights_delta = err \cdot \sigma(x) \cdot (1 - \sigma(x))$$ Здесь \(x\) — взвешенная сумма входов нейрона, а формула относится к квадратичной функции потерь; для log loss с сигмоидой на выходе множитель \(\sigma(x)(1 - \sigma(x))\) сокращается, и ошибка выхода равна просто \(actual - expected\).
Обновление веса с learning rate (\(lr\)) записывается следующим образом. $$weight_{new} = weight_{old} - output \cdot weights_delta \cdot lr$$ где \(output\) — выход нейрона предыдущего слоя, подаваемый на этот вес.
Ошибка для скрытых слоёв распределяется пропорционально весам, связывающим их с последующим слоем. $$err_{hidden} = weight \cdot weights_delta$$
Собственную реализацию обратного распространения необходимо проверять независимым способом: градиент, вычисленный по цепному правилу, сравнивается для каждого параметра с центральной разностью \((L(w + h) - L(w - h))/2h\) при малом \(h\). Ошибка в одном множителе цепного правила часто не останавливает обучение, а лишь замедляет его или уводит в сторону, поэтому по ходу обучения её трудно заметить.
Проблемы сигмоиды
Сигмоида дифференцируема и удобна, однако у неё имеются три недостатка, из-за которых в глубоких сетях её практически вытеснил ReLU.
- На хвостах производная близка к нулю, и в глубокой сети градиент затухает, не доходя до нижних слоёв.
- Выход всегда положителен, поэтому градиенты весов одного нейрона, смещённые в одну сторону, приводят к зигзагообразному ходу обучения.
- Вычисление экспоненты является дорогостоящим.
3. Оптимизаторы
Для минимизации функции потерь, выбранной под задачу, применяются различные варианты градиентного спуска.
SGD (Stochastic Gradient Descent)
Базовый метод записывается следующим образом. $$x_{t+1} = x_t - \alpha f'(x_t)$$ где \(\alpha\) — learning rate.
SGD with Momentum
Накапливает инерцию движения, сглаживая колебания. $$v_{t+1} = \rho v_t + \alpha f'(x_t)$$ $$x_{t+1} = x_t - v_{t+1}$$
Nesterov Momentum
Версия momentum, вычисляющая градиент в точке, в которую инерция сдвинет параметры, и потому реже проскакивающая минимум. $$v_{t+1} = \rho v_t - \alpha f'(x_t + \rho v_t)$$ $$x_{t+1} = x_t + v_{t+1}$$
Adagrad (Adaptive Gradient)
Адаптирует learning rate для каждого параметра индивидуально, вследствие чего веса, сдвинутые сильно, изменяются меньше. $$cache_{t+1} = cache_t + f'(x_t)^2$$ $$x_{t+1} = x_t - \frac{\alpha f'(x_t)}{\sqrt{cache_{t+1}} + \epsilon}$$ Проблема: \(cache \to \infty\), что может остановить обучение.
RMSProp
Сглаживает изменения кеша, забывая старые значения (экспоненциальное скользящее среднее). $$cache_{t+1} = \beta cache_t + (1 - \beta) f'(x_t)^2, \quad \beta \in [0, 1]$$ $$x_{t+1} = x_t - \frac{\alpha f'(x_t)}{\sqrt{cache_{t+1}} + \epsilon}$$
Adam
Комбинация RMSProp и Momentum записывается следующим образом. $$v_{t+1} = \gamma v_t + (1 - \gamma) f'(x_t)$$ $$cache_{t+1} = \beta cache_t + (1 - \beta) f'(x_t)^2$$ Оба накопителя стартуют с нуля, поэтому на первых шагах они занижены, и перед их использованием вводится поправка на смещение. $$\hat{v}{t+1} = \frac{v{t+1}}{1 - \gamma^{t+1}}, \qquad \widehat{cache}{t+1} = \frac{cache{t+1}}{1 - \beta^{t+1}}$$ Обновление выполняется уже по исправленным величинам; без этой поправки Adam сводится к RMSProp, дополненному инерцией. $$x_{t+1} = x_t - \frac{\alpha \hat{v}{t+1}}{\sqrt{\widehat{cache}{t+1}} + \epsilon}$$ В качестве отправной точки обычно выбирают Adam или Nesterov momentum: с ними сеть, собранная из типовых слоёв, в большинстве случаев обучается без ручного подбора.
4. Нормализация и инициализация
Нормализация данных
Признаки перед подачей в сеть приводятся к сопоставимым масштабам, и причин тому три.
- Технические ограничения точности дробных чисел.
- Без нормализации страдают L1 и L2 регуляризация.
- Ускоряется обучение. В нейронных сетях это критично, так как каждый слой отображает данные в новое пространство признаков, и при изменении весов смещается распределение признаков, получаемых на выходе слоя.
Инициализация весов
Два очевидных способа заполнить веса перед обучением не работают.
- Нули: сеть не обучается, все нейроны слоя одинаковы и получают один и тот же градиент.
- Константа: то же самое, слой вырождается в один нейрон.
- Случайные значения: работают, однако масштаб необходимо подобрать так, чтобы слой не изменял дисперсию проходящего через него сигнала.
Для сохранения дисперсии выведем соотношение, связывающее веса линейного слоя; веса и входы считаем независимыми и имеющими нулевые средние.
$$D(s) = D\left(\sum_{i=1}^{n} w_i x_i\right) = \sum_{i=1}^{n} D(w_i x_i) = n D(w) D(x)$$
Чтобы \(D(s) = D(x)\), необходимо выполнение условия
$$D(w) = \frac{1}{n}$$
Если взять случайные значения и умножить их на \(\frac{1}{\sqrt{n}}\) (или использовать распределение с дисперсией \(1/n\)), получается инициализация ЛеКуна, сохраняющая дисперсию только в прямом проходе, поскольку она учитывает лишь число входов. Инициализация Ксавье (Glorot и Bengio) выравнивает прямой и обратный проходы одновременно и использует \(D(w) = 2/(n_{in} + n_{out})\). Для ReLU половина выходов обнуляется, поэтому дисперсия весов берётся вдвое больше; такой вариант называется инициализацией Хе (He), и именно он применяется для слоёв с ReLU. По умолчанию фреймворки используют другое: Keras у Dense и Conv2D — glorot_uniform (Ксавье), PyTorch у nn.Linear и nn.Conv2d — kaiming_uniform_(a=√5), что даёт равномерное распределение с \(D(w) = 1/(3n)\), втрое меньше инициализации ЛеКуна. Следовательно, инициализацию под ReLU обычно приходится задавать явно.
Batch Normalization
Нормирует активации, вычисленные внутри одного батча; в исходной работе слой располагали перед функцией активации, чтобы распределение входов, приходящих в каждый слой, не смещалось по мере обучения (internal covariate shift). Объяснение, предложенное авторами, впоследствии было оспорено, однако слой работает.
Формула нормализации имеет следующий вид. $$\hat{x}_i = \frac{x_i - \mu}{\sqrt{\sigma^2 + \varepsilon}}$$ где \(\mu\) и \(\sigma^2\) — матожидание и дисперсия в батче.
Далее применяется масштабирующее преобразование с обучаемыми параметрами \(\gamma, \beta\). $$y_i = \gamma \hat{x}_i + \beta$$
На инференсе, когда сеть только вычисляет предсказание, батча может не быть, поэтому вместо статистик батча используются скользящие средние, накопленные при обучении. $$\mu_{t+1} = \alpha \times \mu_{batch} + (1 - \alpha) \mu_t$$ $$\sigma^2_{t+1} = \alpha \times \sigma^2_{batch} + (1 - \alpha) \sigma^2_t$$
Batch normalization ускоряет сходимость сети и позволяет использовать больший learning rate.
5. Регуляризация
L1 и L2 регуляризация
Штраф, добавленный к функции потерь за большие веса, позволяет бороться с переобучением.
- L2: \(|W|_2^2 = \sum w^2\)
- L1: \(|W|_1 = \sum |w|\)
- Elastic Net: Комбинация L1 и L2.
Dropout
Случайным образом «выключает» часть нейронов в процессе обучения, причём на каждой итерации выключаются разные нейроны.
- Интерпретация: обучение ансамбля прореженных сетей с общими весами, которые на инференсе приближённо усредняются; приём родствен бэггингу.
- На инференсе. Все нейроны включены, и масштаб сигнала должен совпадать с обучением. В исходной работе для этого выходы домножались на долю оставленных нейронов уже при выводе; в современных реализациях поступают наоборот — при обучении делят на эту долю (inverted dropout), поэтому
model.eval()в PyTorch иtraining=Falseв Keras просто отключают слой без дополнительных пересчётов.
Аугментация
Искусственное расширение обучающей выборки даёт те же примеры, повёрнутые, сдвинутые и зашумлённые, вследствие чего сеть перестаёт опираться на случайные особенности предъявленных ей изображений, и качество растёт как на тестовой выборке, так и на реальных данных.
6. Остаточные связи
Остаточные связи (residual connections) регуляризацией не являются: они решают задачу оптимизации. В очень глубоких сетях градиент может не доходить до нижних слоёв, и с ростом глубины растёт ошибка уже на обучающей выборке; сложение признаков, взятых в обход нескольких слоёв (skip connection), позволяет донести градиент до нижних слоёв.
7. Заключение
Таким образом, модель нейрона, прохождение градиента через сеть, различия оптимизаторов, нормализация и регуляризация представляют собой минимум, без которого работа с готовыми фреймворками превращается в перебор настроек наугад.
Расширенная версия раздела, включая задачи компьютерного зрения (Computer Vision), — книга «Базовые методы ИИ в физических исследованиях». В следующей главе эти модели обучаются средствами scikit-learn: интерфейс у них общий, а готовые рецепты для сетей прямого распространения собраны в отдельном сборнике.
Инструменты: scikit-learn
Стандартом де-факто для классического машинного обучения в Python является библиотека scikit-learn (sklearn), построенная поверх NumPy и SciPy, принимающая также таблицы pandas и охватывающая весь конвейер обработки данных.
датасет → разбиение → предобработка → обучение → метрики → подбор гиперпараметров → сохранение модели
NumPy и pandas рассмотрены в главе NumPy и pandas, построение графиков — в главе Визуализация на Python. В настоящей главе конвейер рассматривается по шагам на одном сквозном примере — классификации сортов вина по химическому составу.
Слайды к главе. Единый интерфейс, разбиение и утечка данных, Pipeline, кросс-валидация, подбор гиперпараметров и сохранение модели изложены также в седьмой части лекции «Машинное обучение» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Установка библиотеки осуществляется следующей командой.
pip install scikit-learn
Единый API и методы fit / predict / transform
Основной причиной популярности scikit-learn является единообразный интерфейс. Все объекты библиотеки делятся на два типа.
- Модели (estimators) обучаются предсказывать целевую величину; к ним относятся
KNeighborsClassifier,LinearRegression,RandomForestClassifier,MLPClassifier... - Преобразователи (transformers) подготавливают входные данные; к ним относятся
StandardScaler,OneHotEncoder,PCA...
Объекты обоих типов имеют одинаковый набор методов.
fit(X, y)обучает объект: модель подбирает параметры, а преобразователь запоминает статистики, вычисленные по выборке (например, среднее и дисперсию каждого признака);predict(X)предсказывает метки для новых объектов, которых модель не видела;predict_proba(X)предсказывает вероятности, приписываемые классам (у классификаторов);transform(X)преобразует входные данные (у преобразователей);fit_transform(X)обучает и преобразует одним вызовом.
Замена одного алгоритма другим сводится к изменению одной строки кода: kNN, случайный лес и нейронная сеть обучаются и вызываются одинаково. Все алгоритмы, рассмотренные в предыдущих главах, реализованы в scikit-learn.
Используемые библиотеки
Импортируем всё, что потребуется в этой главе.
import numpy as np
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split, cross_val_score, GridSearchCV, StratifiedKFold
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.neighbors import KNeighborsClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
accuracy_score,
precision_score,
recall_score,
f1_score,
confusion_matrix,
classification_report,
roc_auc_score,
)
Датасеты
В sklearn.datasets выделяются три семейства функций.
load_*возвращает небольшие учебные датасеты, входящие в состав библиотеки, такие какload_iris,load_wine,load_breast_cancer,load_digits;fetch_*возвращает большие датасеты, загружаемые из интернета при первом обращении, такие какfetch_california_housing,fetch_openml;make_*представляет собой генераторы синтетических данных для экспериментов, такие какmake_classification,make_regression,make_blobs.
Рассмотрим датасет Wine, содержащий 178 образцов вина трёх сортов (три класса), каждый из которых описан 13 числовыми признаками химического состава: содержание алкоголя, яблочной кислоты, магния, фенолов, интенсивность цвета и так далее. Задача заключается в определении сорта винограда по химическому анализу.
# as_frame=True возвращает данные в виде pandas.DataFrame
wine = load_wine(as_frame=True)
data = wine.frame # признаки + целевая переменная в одной таблице
X = wine.data # матрица объекты-признаки, shape (178, 13)
y = wine.target # метки классов: 0, 1, 2
print(data.shape) # размерность
print(wine.target_names) # названия сортов
data.head() # первые пять строк: данные всегда просматриваются вручную
Разбиение выборки через train_test_split
Качество модели нельзя оценивать на тех же данных, на которых она обучалась, иначе измеряется способность запоминать, а не обобщать, поэтому в первую очередь откладывается тестовая выборка.
X_train, X_test, y_train, y_test = train_test_split(
X, y,
test_size=0.2, # 20% объектов — в тест
random_state=42, # фиксируем случайность для воспроизводимости
stratify=y, # сохраняем соотношение классов в обеих частях
)
Параметр stratify=y важен при дисбалансе классов, поскольку гарантирует совпадение долей классов в обучающей и тестовой выборках. Отложенная тестовая выборка не используется до финальной оценки: она представляет данные, которых модель не видела.
Предобработка
Масштабирование признаков
Как показано в главе про классические алгоритмы, методы, опирающиеся на расстояния (kNN, k-means) и на градиентный спуск (линейные модели, нейронные сети), чувствительны к масштабу признаков. В датасете Wine содержание пролина измеряется сотнями и тысячами (СКО 315), а нефлаваноидных фенолов — десятыми долями (СКО 0,12), поэтому без стандартизации расстояние определяется одним пролином, и признаки, подаваемые модели, необходимо стандартизировать.
scaler = StandardScaler()
# обучаем scaler ТОЛЬКО на обучающей выборке...
X_train_scaled = scaler.fit_transform(X_train)
# ...а тест лишь преобразуем уже выученными статистиками
X_test_scaled = scaler.transform(X_test)
StandardScaler приводит каждый признак к нулевому среднему и единичной дисперсии; среди альтернатив — MinMaxScaler (нормализация, приводящая признак к диапазону [0, 1]) и RobustScaler (устойчивый к выбросам).
fit вызывается только на обучающей выборке. Если обучить scaler на всей выборке, статистики тестовой части попадут в обучение, что называется утечкой данных (data leakage) и может завысить оценку качества. Для среднего и дисперсии признаков эффект обычно мал, а опасны шаги, использующие метки: отбор признаков по всей выборке находит закономерность даже в чистом шуме.
Кодирование категориальных признаков
В Wine все признаки числовые, но в реальных данных часто встречаются категориальные (тип детектора, режим установки), а модели работают с числами, поэтому категории необходимо закодировать.
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder
# OneHotEncoder: каждая категория -> отдельный бинарный признак
# подходит для номинальных признаков без порядка
encoder = OneHotEncoder(handle_unknown="ignore")
# OrdinalEncoder: категории -> целые числа 0, 1, 2, ...
# для порядковых признаков порядок задаётся явно, иначе категории
# сортируются по алфавиту: отлично < плохо < хорошо
ordinal = OrdinalEncoder(categories=[["плохо", "хорошо", "отлично"]])
Для применения разных преобразований к разным столбцам (масштабирования числовых и кодирования категориальных) используется ColumnTransformer из sklearn.compose.
Обучение модели
Обучим два классификатора из главы про классические алгоритмы — метод ближайших соседей и случайный лес.
# kNN: голосование K ближайших соседей, требует масштабирования
knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train_scaled, y_train)
# случайный лес: ансамбль деревьев, к масштабу нечувствителен
forest = RandomForestClassifier(n_estimators=200, random_state=42)
forest.fit(X_train, y_train)
# предсказания на тестовой выборке
y_pred_knn = knn.predict(X_test_scaled)
y_pred_forest = forest.predict(X_test)
Обучение сводится к одному вызову fit, а гиперпараметры модели (число соседей n_neighbors, число деревьев n_estimators) задаются в конструкторе.
Pipeline
Пара scaler + модель встречается настолько часто, что для неё предусмотрен отдельный класс Pipeline, объединяющий цепочку преобразований и финальную модель в один объект с тем же API.
model = Pipeline(steps=[
("scaler", StandardScaler()), # шаг 1: стандартизация
("knn", KNeighborsClassifier(n_neighbors=5)), # шаг 2: классификатор
])
# fit сам обучит scaler на train и передаст преобразованные данные в kNN
model.fit(X_train, y_train)
# predict сам преобразует тест выученным scaler'ом и предскажет
y_pred = model.predict(X_test)
Pipeline решает сразу три задачи.
- код становится короче, а вероятность ошибки в нём уменьшается;
- исключается утечка данных: преобразователи, стоящие в цепочке, всегда обучаются только на обучающей выборке;
- весь собранный конвейер можно передать в кросс-валидацию и подбор гиперпараметров как единое целое, а затем сохранить одним файлом.
Метрики качества
Классификация
Теория метрик рассмотрена в разделе про логистическую регрессию; здесь вызываются готовые функции.
print(f"Accuracy: {accuracy_score(y_test, y_pred):.3f}")
# у нас три класса, поэтому указываем способ усреднения:
# average="macro" — среднее по классам без учёта их размера
print(f"Precision: {precision_score(y_test, y_pred, average='macro'):.3f}")
print(f"Recall: {recall_score(y_test, y_pred, average='macro'):.3f}")
print(f"F1: {f1_score(y_test, y_pred, average='macro'):.3f}")
# матрица ошибок: строки — истинные классы, столбцы — предсказанные
print(confusion_matrix(y_test, y_pred))
# сводный отчёт по всем метрикам для каждого класса
print(classification_report(y_test, y_pred, target_names=wine.target_names))
Напомним смысл метрик.
- Accuracy представляет собой долю правильных ответов и вводит в заблуждение при дисбалансе классов;
- Precision показывает, какая доля объектов, отнесённых к положительным, действительно положительна;
- Recall показывает, какую долю действительно положительных объектов модель обнаружила;
- F1 представляет собой гармоническое среднее Precision и Recall;
- ROC-AUC — площадь под ROC-кривой, то есть качество ранжирования объектов по вероятностям.
ROC-AUC вычисляется по предсказанным вероятностям, а не по меткам; для многоклассовой задачи указывается стратегия «один против остальных».
y_proba = model.predict_proba(X_test) # вероятности классов, shape (n, 3)
print(f"ROC-AUC: {roc_auc_score(y_test, y_proba, multi_class='ovr'):.3f}")
Регрессия
Для регрессии метрики сравнивают предсказанное число с истинным. Классификация вина здесь не подходит, поэтому рассмотрим другой встроенный набор данных, в котором по показателям, измеренным у пациента, модель предсказывает степень развития заболевания за год.
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
# отдельные имена, чтобы не затереть сквозной пример с вином
X_reg, y_reg = load_diabetes(return_X_y=True)
X_reg_tr, X_reg_te, y_reg_tr, y_reg_te = train_test_split(
X_reg, y_reg, test_size=0.2, random_state=42)
regressor = Ridge(alpha=1.0).fit(X_reg_tr, y_reg_tr)
y_reg_pred = regressor.predict(X_reg_te)
mae = mean_absolute_error(y_reg_te, y_reg_pred) # средняя абсолютная ошибка
mse = mean_squared_error(y_reg_te, y_reg_pred) # среднеквадратичная ошибка
rmse = np.sqrt(mse) # корень из MSE, в единицах величины
r2 = r2_score(y_reg_te, y_reg_pred) # коэффициент детерминации R^2
print(f"MAE: {mae:.1f}")
print(f"RMSE: {rmse:.1f}")
print(f"R^2: {r2:.3f}")
MAE: 46.1
RMSE: 55.5
R^2: 0.419
- MAE более устойчива к выбросам и измеряется в тех же единицах, что и целевая величина;
- MSE сильнее штрафует крупные ошибки (квадратичный штраф);
- R² показывает, какую долю дисперсии данных объясняет модель, причём 1 соответствует идеальной модели, 0 — предсказанию средним, а значения меньше 0 — результату хуже среднего.
Кросс-валидация
Одно разбиение train/test даёт одну случайную оценку качества, поэтому более надёжной является кросс-валидация. Выборка делится на \(k\) частей (фолдов), модель \(k\) раз обучается на \(k-1\) частях и проверяется на оставшейся, а полученные оценки усредняются.
# стратифицированные фолды сохраняют соотношение классов
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
# передаём Pipeline целиком — предобработка честно обучается внутри каждого фолда
scores = cross_val_score(model, X_train, y_train, cv=cv, scoring="f1_macro")
print(f"F1 по фолдам: {scores}")
print(f"Среднее: {scores.mean():.3f} +- {scores.std():.3f}")
F1 по фолдам: [0.89355742 1. 0.96658312 0.92951496 0.96658312]
Среднее: 0.951 +- 0.036
Разброс оценок по фолдам не менее важен, чем среднее, поскольку большая дисперсия является признаком нестабильной модели или слишком малой выборки.
Подбор гиперпараметров через GridSearchCV
Гиперпараметры (число соседей \(K\), глубина деревьев, коэффициент регуляризации) не выучиваются моделью, а подбираются отдельно. GridSearchCV перебирает все комбинации из заданной сетки, оценивая каждую кросс-валидацией.
param_grid = {
"knn__n_neighbors": [1, 3, 5, 7, 9, 15], # имя шага в Pipeline + "__" + имя параметра
"knn__weights": ["uniform", "distance"], # обычное или взвешенное голосование
}
search = GridSearchCV(
model, # наш Pipeline: scaler + kNN
param_grid,
cv=cv, # схема кросс-валидации
scoring="f1_macro", # метрика для сравнения комбинаций
n_jobs=-1, # задействовать все ядра процессора
)
search.fit(X_train, y_train)
print(f"Лучшие параметры: {search.best_params_}")
print(f"Лучший CV F1: {search.best_score_:.3f}")
# лучшая модель уже переобучена на всём train — финальная проверка на тесте
best_model = search.best_estimator_
y_pred = best_model.predict(X_test)
print(f"F1 на тесте: {f1_score(y_test, y_pred, average='macro'):.3f}")
Лучшие параметры: {'knn__n_neighbors': 15, 'knn__weights': 'uniform'}
Лучший CV F1: 0.959
F1 на тесте: 1.000
Отложенная тестовая выборка не участвовала ни в обучении, ни в подборе гиперпараметров, а использовалась только в финальной оценке; именно так должен быть построен протокол эксперимента. При большой сетке вместо полного перебора можно использовать RandomizedSearchCV, выполняющий случайный поиск по тем же параметрам.
Отметим, что выбор в этом примере менее однозначен, чем выглядит. При каждом K обычное и взвешенное голосование дают одинаковые оценки, и uniform выбран лишь потому, что при равных оценках GridSearchCV берёт первую комбинацию сетки; K = 7 и K = 15 различаются на 0,001 при разбросе по фолдам около 0,04. Значение F1 = 1,000 на 36 тестовых образцах означает лишь отсутствие ошибок: одна ошибка снизила бы его примерно до 0,97.
Сохранение модели через joblib
Обученную модель не требуется переобучать при каждом запуске: её сохраняют на диск. Для моделей scikit-learn обычно применяют joblib, который умеет сжимать файл и отображать большие массивы NumPy в память при загрузке.
import joblib
# сохраняем весь Pipeline: и scaler, и модель, одним файлом
joblib.dump(best_model, "wine_knn.joblib")
# ... позже, в другом скрипте или сервисе
loaded = joblib.load("wine_knn.joblib")
prediction = loaded.predict(X_test) # сырые признаки — предобработка внутри
Модели необходимо загружать только из доверенных источников: joblib-файл, как и pickle, при загрузке может выполнить произвольный код; более безопасным форматом является skops.io, загружающий только типы, признанные доверенными. Кроме того, необходимо фиксировать версию scikit-learn среди зависимостей проекта, как описано в главе «От скрипта к приложению», поскольку модель, сохранённая одной версией библиотеки, не обязательно загрузится другой; при несовпадении версий scikit-learn выдаёт предупреждение InconsistentVersionWarning.
Дальнейшее изучение
Таким образом, конвейер — датасет, разбиение, стандартизация, обучение через единый API, Pipeline, метрики и кросс-валидация, подбор гиперпараметров, сохранение модели — является одним и тем же для любой задачи; меняются только данные и модель.
Готовые ноутбуки-рецепты по всем основным моделям, включая линейную и логистическую регрессию, деревья и случайный лес, наивный Байес, kNN, SVM, k-means, DBSCAN, PCA и нейронные сети прямого распространения, собраны в отдельном сборнике рецептов по машинному обучению. Каждый рецепт построен единообразно: по цепочке от библиотеки к датасету, предобработке, обучению, метрикам и графикам.
С чего начинать оптимизацию
Python обладает всеми достоинствами, кроме скорости. Интерпретация, динамическая типизация, объектная модель — всё, что делает язык удобным, обходится дорого. Наивный цикл на Python выполняется в десятки и сотни раз медленнее того же кода на C. Для скрипта, запускаемого раз в день, это несущественно, а для обработки терабайта данных с детектора или моделирования миллиона частиц разница составляет часы против недель.
Медленный код на Python почти всегда можно ускорить, не переписывая его целиком на C++. В настоящем разделе последовательно рассматриваются следующие темы:
- глава «Причины низкой скорости Python» объясняет, откуда берётся разница с C, и вводит инструменты измерения времени:
cProfile,line_profiler,py-spy,timeit; - глава «Оптимизация средствами самого Python» собирает приёмы, не требующие ничего, кроме самого языка: выбор структуры данных, встроенные функции, измерение и экономия памяти;
- глава «Скорость выполнения программ» последовательно ускоряет один и тот же расчёт: сначала приёмами самого языка, затем с помощью Numba и Cython и в завершение NumPy, а на расчёте пространственного заряда пучка показывает выигрыш от JIT-компиляции и параллелизма;
- глава «Многопоточность и GIL» объясняет, почему потоки в обычной сборке CPython не ускоряют вычисления, что представляет собой глобальная блокировка интерпретатора и в каких случаях помогают процессы и сборка Python без GIL;
- глава «Асинхронность» рассматривает цикл событий и
asyncio, опираясь на корутины из главы «Итераторы, генераторы и корутины», и показывает, как ожидать тысячи одновременно запущенных операций ввода-вывода; - глава «CUDA и вычисления на GPU» показывает, когда и как перенести расчёт на видеокарту с помощью CuPy и Numba;
- глава «Кластеры и воспроизводимое окружение для расчётов» переносит расчёт на вычислительный кластер: планировщик Slurm, массивы задач для независимых расчётов, MPI из Python для связанных, образы Apptainer для воспроизводимого окружения и настройка машин кодом с помощью Ansible.
Оптимизацию не проводят вслепую. Интуиция почти всегда ошибается относительно того, где программа проводит время; достоверно это показывает только профилировщик.
Слайды к главе. Основной материал раздела изложен также в лекции «Оптимизация и параллельные вычисления» (причины медленности, измерение и профилирование, приёмы языка, память, Numba и Cython, NumPy и BLAS, потоки, процессы, сборка Python без GIL и видеокарта) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Причины низкой скорости Python
Гибкость Python препятствует многим оптимизациям, поскольку всякая оптимизация опирается на предположения и заранее оговорённые ограничения. Чем меньше компилятору позволено считать заранее известным, тем меньше у него возможностей. Рассмотрим три основные причины.
Слайды к главе. Причины медленности Python и способы измерения времени изложены также в первой и второй частях лекции «Оптимизация и параллельные вычисления» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
1. Динамическая типизация
Тип значения, связанного с именем, становится известен только во время исполнения. Во-первых, интерпретатор проверяет типы на каждом шаге, и эти проверки, повторяющиеся миллионы раз, требуют времени. Во-вторых, он не знает заранее, с какими данными работает, и потому обязан исполнять написанный код почти буквально: заранее вычисляются лишь выражения из литералов, например 60 * 60 * 24, и отбрасываются ветви с постоянным условием, такие как if False, а выражение с именами вычислить заранее нельзя, поскольку любое имя может быть переопределено.
2. Изменяемость всего и вся
В Python почти всё может быть изменено во время исполнения: встроенные имена, тело уже определённой функции, даже локальные переменные чужого кадра стека.
import builtins
print(len("abc"))
len = lambda obj: "mock!"
print(len("abc"))
len = builtins.len
3
mock!
def my_func(a, b):
return a + b
print(my_func(1, 2))
def new_func(a, b):
return a * b
my_func.__code__ = new_func.__code__
print(my_func(1, 2))
3
2
import sys
import ctypes
def change_local_variable():
# берём объект предыдущего кадра стека у вызывающей стороны
frame = sys._getframe(1)
frame.f_locals['my_var'] = "hello"
# Force update
ctypes.pythonapi.PyFrame_LocalsToFast(ctypes.py_object(frame),
ctypes.c_int(0))
def do_smth():
my_var = 1
change_local_variable()
print(my_var)
do_smth()
hello
Строки с ctypes нужны только в Python до 3.12 включительно. Начиная с 3.13 действует PEP 667: атрибут f_locals возвращает прокси-объект, запись в который сразу попадает в переменные кадра, а функция PyFrame_LocalsToFast сохранилась в C API лишь для совместимости и ничего не делает. Пример по-прежнему печатает hello, а запись в чужой кадр сводится к одной строке.
Поэтому интерпретатор не может отделить от цикла первую итерацию, на которой проверка i == 0 истинна: он не знает, не будут ли по ходу выполнения переопределены имена range и len. Оптимизацию, которую выполнил бы любой компилятор C, приходится выполнять вручную.
def do1():
a = [-1] * 1000
for i in range(len(a)):
if i == 0:
a[i] = 1
else:
a[i] = i
def do2():
a = [-1] * 1000
a[0] = 1
for i in range(1, len(a)):
a[i] = i
%timeit -n100 do1()
%timeit -n100 do2()
12.6 μs ± 253 ns per loop (mean ± std. dev. of 7 runs, 100 loops each)
9.57 μs ± 89.7 ns per loop (mean ± std. dev. of 7 runs, 100 loops each)
3. CPython
Третьей причиной является сама эталонная реализация языка, написанная давно.
- CPython начинали писать задолго до многоядерных процессоров.
- Производительность никогда не была его главной целью.
- Совместимость с C API ограничивает изменения внутреннего устройства.
Компилятор CPython переводит исходный текст в байт-код, а цикл интерпретатора выполняет инструкции по одной: для выражения a + b это загрузка двух имён и инструкция BINARY_OP, внутри которой выясняются типы операндов и вызывается нужная реализация сложения. Каждая инструкция — ветвь кода на C с проверками, работой со счётчиками ссылок и созданием объектов-результатов.
Начиная с версии 3.11 CPython заметно ускорился: специализирующий адаптивный интерпретатор (PEP 659) подменяет общие инструкции быстрыми вариантами для встреченных типов и вместе с другими изменениями дал в среднем около 25 % на наборе тестов pyperformance, см. раздел Faster CPython. В версии 3.13 появились экспериментальный JIT-компилятор (PEP 744, по умолчанию выключен) и сборка без глобальной блокировки интерпретатора (PEP 703), которая с версии 3.14 поддерживается официально (PEP 779) и рассматривается в главе «Многопоточность и GIL». С мая 2025 года проект Faster CPython развивается сообществом без прежнего финансирования Microsoft.
Момент оптимизации
Premature optimization is the root of all evil
Фразу Кнута обычно понимают следующим образом: сначала пишется работающий код, а быстрым он делается позднее, когда функциональность готова. Следствие: производительность остаётся той, какая получилась случайно, пока кто-либо не обнаружит легко исправимое место, ускоряющее программу без переделки половины кода.
Если требуется быстрая программа, о скорости необходимо думать с самого начала, а прототип делать быстрым, иногда даже быстрее финальной версии. Начать с производительного решения и поддерживать его дешевле, чем ускорять написанное медленно.
Обратной крайностью является «большой комок грязи», архитектура, не продуманная вовсе.
If you think good architecture is expensive, try bad architecture.
Подробнее об этом написано в эссе Фута и Йодера и в статье Википедии.
Три правила оптимизации
- Не делать
- Делать это позже
- Делать это оптимально
Противоречия с предыдущим разделом нет: думать о производительности необходимо с самого начала, а переписывать код ради скорости — лишь тогда, когда измерения профилировщика показали, что это требуется. Самой быстрой оптимизацией является та, которую не пришлось выполнять, поскольку программа и так укладывается в отведённое время.
Порядок оптимизации
Программисты тратят чудовищно много времени, размышляя о скорости некритичных частей программы, и эти попытки ускорения оказываются вредны, если учесть отладку и сопровождение. Про мелкую эффективность надо забыть в 97 % случаев: преждевременная оптимизация — корень всех зол. Но нельзя упускать возможности в тех критических 3 %.
Д. Кнут, Structured Programming with go to Statements, ACM Computing Surveys, 1974
Основная задача заключается в поиске места, к которому имеет смысл прикладывать усилия. Этому служат три правила.
Правило 1. Профилирование кода
Угадывать, какая часть программы работает дольше всего, бесполезно: профилировщик отвечает на этот вопрос точно, интуиция — почти никогда.
Количественно цену неверного выбора выражает закон Амдала. Если доля \(p\) времени работы программы ускорена в \(s\) раз, вся программа ускоряется в
\[ S = \frac{1}{(1 - p) + p / s} \]
раз. Функция, занимающая 1 % времени и ускоренная в десять раз, даёт выигрыш около одного процента; даже бесконечно быстрая часть, занимающая 90 % времени, ускоряет программу лишь в десять раз. Тот же закон ограничивает ускорение параллельной программы на многих процессах; эта постановка вместе с законом Густафсона рассмотрена в главе «Кластеры и воспроизводимое окружение для расчётов».
Правило 2. Сохранение корректности
Оптимизация легко нарушает корректность кода незаметно, оставляя результат правдоподобным, но неверным. Прежде чем переписывать фрагмент ради скорости, необходимо покрыть его тестами.
Правило 3. Замер после правки
Выигрыш подтверждается замером на тех же данных, что и до правки, и без профилировщика: профилировщик сам замедляет программу, причём по-разному для разных конструкций, и сравнение двух версий под ним может ввести в заблуждение. Пример такой ловушки разобран в главе «Скорость выполнения программ».
Профилирование
Базовый набор входит в стандартную поставку: cProfile собирает профиль по функциям, а pstats разбирает и сортирует собранное. Профиль удобно сохранить в файл и затем вывести функции с наибольшим собственным временем (tottime):
python3 -m cProfile -o prof.out matrix.py
python3 -c "import pstats; pstats.Stats('prof.out').strip_dirs().sort_stats('tottime').print_stats(2)"
Для программы из главы «Скорость выполнения программ», шестнадцать раз перемножающей матрицы 64×64, начало отчёта выглядит так:
66668 function calls (66640 primitive calls) in 0.309 seconds
Ordered by: internal time
List reduced from 134 to 2 due to restriction <2>
ncalls tottime percall cumtime percall filename:lineno(function)
16 0.294 0.018 0.294 0.018 matrix.py:23(matrix_product)
8192 0.004 0.000 0.010 0.000 random.py:291(randrange)
Столбец ncalls — число вызовов, tottime — время в самой функции без вложенных вызовов, cumtime — вместе с ними. Метод strip_dirs убирает из имён файлов каталоги. Здесь 95 % времени приходится на matrix_product, и ускорять имеет смысл только её. Сторонний пакет SnakeViz показывает тот же профиль диаграммой в браузере.
cProfile — детерминированный профилировщик: он перехватывает каждый вызов и возврат, поэтому знает точное число вызовов, но заметно замедляет программу и ничего не сообщает о времени отдельных строк. Для других задач служат ещё два инструмента.
- line_profiler профилирует построчно: функция отмечается декоратором
@profile, а программа запускается командойkernprof -l -v script.py. Пример построчного профиля приведён в главе «Скорость выполнения программ». - py-spy — сэмплирующий профилировщик: он по умолчанию сто раз в секунду считывает стек работающей программы снаружи, из памяти процесса, почти не замедляя её, и снимает профиль с уже запущенной программы, не изменяя её код. Это необходимо, когда расчёт продолжается третьи сутки и перезапуск недопустим. Команда
py-spy dump --pid Nпечатает текущий стек процесса,py-spy top --pid N— непрерывно обновляемую сводку,py-spy record -o profile.svg --pid Nзаписывает flame graph. В Linux подключение к процессу, запущенному не из py-spy, требует прав root (sudo) или значенияkernel.yama.ptrace_scope = 0. Для долгого расчётаbeam.py, на каждом шаге вычисляющего силы пространственного заряда,py-spy dumpпоказывает, что процесс занят функциейspace_charge:
Process 12524: python3 beam.py
Python v3.12.3 (/usr/bin/python3.12)
Thread 12524 (active+gil)
space_charge (beam.py:11)
simulate (beam.py:19)
<module> (beam.py:23)
Расход памяти показывает модуль tracemalloc из стандартной библиотеки, рассмотренный в главе «Оптимизация средствами самого Python».
Измерение времени
Когда требуется измерить время одной функции, а не снимать полный профиль, применяется модуль timeit из стандартной библиотеки. Из командной строки он запускается так:
python3 -m timeit -s "from rev import reverse_loop, s" "reverse_loop(s)"
Ключ -s задаёт подготовку, которая в замер не входит. Число запусков модуль подбирает сам, так чтобы прогон длился не меньше 0,2 секунды, повторяет прогон пять раз и печатает лучшее время одного запуска: 500000 loops, best of 5: 527 nsec per loop. Берётся именно минимум: более медленные прогоны замедлены не самим кодом, а другими процессами.
Из программы вызывается функция timeit.timeit:
import timeit
setup = '''
s='abcdefghijklmnopqrstuvwxyz'
def reverse_0(s: str) -> str:
reversed_output = ''
s_length = len(s)
for i in range(s_length-1, 0-1, -1):
reversed_output = reversed_output + s[i]
return reversed_output
def reverse_5(s: str) -> str:
return s[::-1]
'''
timeit.timeit('reverse_0(s)', setup, number=10000)
0.005110418002004735
timeit.timeit('reverse_5(s)', setup, number=10000)
0.000419921001594048
Функция timeit измеряет время по time.perf_counter, на время измерения отключает сборщик мусора и возвращает суммарное время N запусков, а не усреднённое по ним; timeit.repeat возвращает список таких сумм по нескольким прогонам. Отключение сборщика мусора делает замеры стабильнее, но если код создаёт много объектов и сборка мусора входит в его цену, сборщик включают первой строкой подготовки: gc.enable().
Код передан строками, поскольку внутри timeit устроен как шаблонная строка, принимающая параметры пользователя, и накладные расходы на вызов функции-обёртки из измерения исключаются. Настоящие функции timeit также принимает, однако в измерение тогда попадает и их вызов.
В IPython для той же цели предусмотрена магическая команда %timeit, выводящая, в отличие от функции, среднее время и стандартное отклонение, вычисленное по семи прогонам.
def reverse_0(s: str) -> str:
reversed_output = ''
s_length = len(s)
for i in range(s_length-1, 0-1, -1):
reversed_output = reversed_output + s[i]
return reversed_output
%timeit -n100 reverse_0('abcdefghijklmnopqrstuvwxyz')
519 ns ± 60.2 ns per loop (mean ± std. dev. of 7 runs, 100 loops each)
Все замеры этой главы и следующих двух выполнены на виртуальной машине с двумя ядрами под Python 3.12, на которой записаны демонстрации лекции «Оптимизация и параллельные вычисления»; на другой машине числа будут иными.
В следующей главе рассматривается, чего можно достичь средствами самого языка, не подключая сторонних инструментов, а за ней следует глава про компиляторы и векторизацию.
Оптимизация средствами самого Python
Глава опирается на главу «Причины низкой скорости Python»: прежде чем ускорять, необходимо измерить, а прежде чем измерять, необходимо понимать, откуда берётся медлительность.
В настоящей главе рассматриваются приёмы, не требующие ничего, кроме самого языка; компиляторы и векторизация рассматриваются в следующей главе. Выигрыш обычно скромнее, зато цена нулевая: код остаётся обычным Python, доступным для чтения любому коллеге.
Слайды к главе. Приёмы языка и экономия памяти изложены также в третьей и четвёртой частях лекции «Оптимизация и параллельные вычисления» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Объекты оптимизации
Оптимизация не сводится к правке кода, так как уровней, пригодных для ускорения уже написанной программы, несколько.
1. Общая архитектура
Устройство системы в целом: какие данные она обрабатывает, каким способом, в каком объёме и где их хранит.
2. Алгоритмы и структуры данных
Выбор алгоритма и структуры данных под конкретную обработку.
3. Реализация (код)
Способ записи выбранного алгоритма на языке.
4. Оптимизации во время компиляции
Преобразования, которые компилятор или JIT способен выполнить над уже написанным кодом.
5. Оптимизации во время исполнения
Настройки, которые можно изменить в уже работающей программе, включая кеши, ленивые вычисления и специализацию под найденный профилировщиком горячий путь.
Ниже рассматриваются уровни 3–5, хотя у первых двух потенциал ускорения наибольший, как и цена ошибки: переделывать выбранную архитектуру посреди работы дорого.
Оптимизировать можно не только скорость, но и память, место на диске и число обращений к нему, сетевой трафик, потребление энергии; в настоящей главе рассматриваются только скорость и память.
За оптимизацию всегда приходится платить.
- Она отнимает время без гарантии, что потраченные часы принесут результат.
- Система в целом становится сложнее, а код, написанный ради нескольких процентов, — менее понятным.
- Легко выиграть в скорости и крупно проиграть в памяти.
Рекомендации по написанию кода на Python
Третий уровень, реализация: дюжина рекомендаций, каждая с замером, выполненным на одной машине. Выигрыш дают не все.
Совет 1. Встроенные функции
Подсчитаем количество элементов в заранее созданном списке.
one_million_elements = [i for i in range(1000000)]
def calc_total(elements):
total = 0
for item in elements:
total += 1
%timeit calc_total(one_million_elements)
9.67 ms ± 130 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit len(one_million_elements)
12.4 ns ± 0.0762 ns per loop (mean ± std. dev. of 7 runs, 100,000,000 loops each)
Пример является учебным, однако если необходимое уже присутствует в builtins, почти всегда быстрее использовать готовое: встроенные функции, написанные на C, обходятся без цикла на уровне интерпретатора.
Совет 2. Правильная фильтрация
Отберём из списка нечётные элементы, в соответствии с предыдущей рекомендацией использовав встроенный filter.
def my_filter1(elements):
result = []
for item in elements:
if item % 2:
result.append(item)
return result
def my_filter2(elements):
return list(filter(lambda x: x % 2, elements))
%timeit my_filter1(one_million_elements)
11.8 ms ± 63.6 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit my_filter2(one_million_elements)
22.9 ms ± 66.6 μs per loop (mean ± std. dev. of 7 runs, 10 loops each)
Замедление объясняется накладными расходами: filter создаёт итератор, к каждому элементу применяется Python-функция lambda, а полученный итератор ещё необходимо преобразовать в список.
Запишем то же самое выражением, создающим требуемый список сразу.
def my_filter3(elements):
return [item for item in elements if item % 2]
%timeit my_filter3(one_million_elements)
10.6 ms ± 40 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
one_million_elements_str = [str(i) for i in range(1000000)]
def str_filter1(elements):
return [item for item in elements if item.isdigit()]
def str_filter2(elements):
return list(filter(str.isdigit, elements))
%timeit str_filter1(one_million_elements_str)
13.4 ms ± 16.4 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit str_filter2(one_million_elements_str)
12.6 ms ± 242 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
builtins и генераторы не ускоряют код сами по себе: достаточно было заменить lambda на метод str.isdigit, написанный на C, и filter оказался быстрее. Каждый конкретный случай проверяется замером.
Совет 3. Правильная проверка вхождений
Разница между
inпо списку и по множеству разобрана в главе «Сложность операций с коллекциями». Здесь рассматриваются цена построения множества и расход памяти.
Запишем код, проверяющий наличие элемента.
def check_in1(elements, number):
for item in elements:
if item == number:
return True
return False
%timeit check_in1(one_million_elements, 500000)
3.56 ms ± 13.2 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit 500000 in one_million_elements
2.02 ms ± 4.06 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Однако время поиска зависит от положения элемента: список просматривается последовательно, пока не будет найдено заданное значение.
%timeit 42 in one_million_elements
159 ns ± 1.72 ns per loop (mean ± std. dev. of 7 runs, 10,000,000 loops each)
Для такой задачи в Python предусмотрено множество set, проверка вхождения в которое осуществляется по хешу, то есть за \(O(1)\) вместо \(O(n)\).
one_million_elements_set = set(one_million_elements)
%timeit 500000 in one_million_elements_set
11.3 ns ± 0.00214 ns per loop (mean ± std. dev. of 7 runs, 100,000,000 loops each)
%timeit 42 in one_million_elements_set
8.08 ns ± 0.00693 ns per loop (mean ± std. dev. of 7 runs, 100,000,000 loops each)
За это приходится платить временем на построение множества.
%timeit set(one_million_elements)
11 ms ± 23.8 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Платить приходится и памятью, поскольку множество содержит хеш-таблицу с запасом, а не уложенные подряд элементы. Строить его ради одной проверки бессмысленно, а ради миллиона проверок необходимо.
Совет 4. Сортировка
import random
data = [random.random() for _ in range(1_000_000)]
%timeit sorted(data)
128 ms ± 199 μs per loop (mean ± std. dev. of 7 runs, 10 loops each)
%timeit (lambda a: a.sort())(data[:])
128 ms ± 191 μs per loop (mean ± std. dev. of 7 runs, 10 loops each)
Данные взяты случайные, и это существенно: на уже отсортированном списке Timsort вырождается в один линейный проход, и время сортировки снижается примерно в семь раз (18 мс против 128 мс). Копирование выполняют оба варианта: sorted создаёт копию внутри себя, а во втором варианте её создаёт срез, стоимость которого составляет около 2 мс. Поэтому на случайных данных варианты совпадают по времени в пределах погрешности: алгоритм один и тот же, и копию делают оба. Метод sort выигрывает, когда исходный порядок не нужен и сортируется сам список, без копии: тогда не тратятся ни время на копирование, ни память под второй список.
Совет 5. Условия if
Условие в if можно записать по-разному, и выбор записи влияет на время, затрачиваемое в цикле.
count = 100000
def check_false1(flag):
for i in range(count):
if flag == False:
pass
def check_false2(flag):
for i in range(count):
if flag is False:
pass
def check_false3(flag):
for i in range(count):
if not flag:
pass
%timeit check_false1(True)
1.14 ms ± 25.9 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit check_false2(True)
888 μs ± 1.31 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit check_false3(True)
775 μs ± 799 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
Сравним три варианта проверки на пустоту и определим, какой из них быстрее.
if len(elements) == 0:if elements == []:if not elements:
def check_empty1(elements):
for i in range(count):
if len(elements) == 0:
pass
def check_empty2(elements):
for i in range(count):
if elements == []:
pass
def check_empty2_new(elements):
for i in range(count):
if elements == list():
pass
def check_empty3(elements):
for i in range(count):
if not elements:
pass
%timeit check_empty1(one_million_elements)
1.78 ms ± 600 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit check_empty2(one_million_elements)
1.78 ms ± 1.45 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit check_empty2_new(one_million_elements)
2.57 ms ± 11.5 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit check_empty3(one_million_elements)
1.02 ms ± 401 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
Самым быстрым оказался и самый идиоматичный вариант if not elements, рекомендуемый любым руководством по стилю. Такое совпадение встречается нечасто.
Совет 6. Спрашивать разрешения или обрабатывать последствия
Предположим, что код должен работать как с объектами, у которых требуемый атрибут есть, так и с объектами, у которых его нет.
class Foo:
attr1 = 'hello'
foo = Foo()
def check_attr1(obj):
for i in range(count):
if hasattr(obj, 'attr1'):
obj.attr1
def check_attr2(obj):
for i in range(count):
try:
obj.attr1
except AttributeError:
pass
%timeit check_attr1(foo)
2.56 ms ± 13.1 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit check_attr2(foo)
1.49 ms ± 28.5 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
Разница становится ещё больше, если атрибутов, требующих проверки, несколько.
Предположим теперь, что у объектов, поступающих в функцию, требуемый атрибут в основном отсутствует.
class Bar:
pass
bar = Bar()
%timeit check_attr1(bar)
1.85 ms ± 668 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit check_attr2(bar)
16.3 ms ± 74.2 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Исключение, возбуждённое один раз, обходится дёшево, а сто тысяч раз подряд — дорого. Выбор между hasattr и try/except определяется тем, какая ситуация встречается чаще.
Совет 7. Особенности определения словаря и списка
Словарь и список можно объявить двумя способами, дающими одинаковый результат.
def create_list1():
for i in range(count):
a = []
def create_list2():
for i in range(count):
a = list()
def create_dict1():
for i in range(count):
a = {}
def create_dict2():
for i in range(count):
a = dict()
def create_list3():
new_list = list
for i in range(count):
a = new_list()
Способы через [] и {} быстрее list() и dict() соответственно.
%timeit create_list1()
1.45 ms ± 2.44 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit create_list2()
2.2 ms ± 5.1 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit create_dict1()
1.53 ms ± 36.4 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit create_dict2()
2.35 ms ± 68.4 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Разница обусловлена в основном вызовом: литерал компилируется в одну инструкцию BUILD_LIST, тогда как list() требует найти имя и вызвать тип через общий механизм вызова. Поиск имени в версиях 3.11 и новее обходится дёшево благодаря специализированной инструкции, поэтому вызов через локальную переменную почти не быстрее:
%timeit create_list3()
2.18 ms ± 12.2 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Различие в составе инструкций показывает байт-код, разобранный модулем dis.
import dis
dis.dis("[]")
0 0 RESUME 0
1 2 BUILD_LIST 0
4 RETURN_VALUE
import dis
dis.dis("list()")
0 0 RESUME 0
1 2 PUSH_NULL
4 LOAD_NAME 0 (list)
6 CALL 0
14 RETURN_VALUE
Совет 8. Вызов функции
Если вызова функции можно избежать, его следует избежать: на каждый вызов создаётся кадр стека, и затраты времени на него заметны.
def square(num):
return num ** 2
%timeit [square(num) for num in range(10000)]
307 μs ± 2.64 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit [num ** 2 for num in range(10000)]
215 μs ± 1.27 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
Совет 9. Отказ от активной работы с глобальными переменными
count = 100000
some_global = 0
def work_with_global():
global some_global
for i in range(count):
some_global += 1
def work_with_local():
some_local = 0
for i in range(count):
some_local += 1
%timeit work_with_global()
2.34 ms ± 56.2 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit work_with_local()
1.5 ms ± 4.68 μs per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
some_global = 0
def work_with_global_optimized():
global some_global
some_local = some_global
for i in range(count):
some_local += 1
some_global = some_local
%timeit work_with_global_optimized()
1.5 ms ± 496 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
Совет 10. Специализированные библиотеки для математики
Численные расчёты нецелесообразно записывать циклами на Python, поскольку для этого существуют библиотеки на C и Фортране, дающие разницу в десятки раз.
def list_slow():
a = range(10000)
return [i ** 2 for i in a]
%timeit list_slow()
214 μs ± 859 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
import numpy as np
def list_fast():
a = np.arange(10000)
return a ** 2
%timeit list_fast()
5.57 μs ± 15.9 ns per loop (mean ± std. dev. of 7 runs, 100,000 loops each)
Приёмы ценой читаемости
Приёмы, приведённые ниже, ухудшают читаемость кода ради нескольких процентов; применять их имеет смысл только в том случае, если профилировщик показал, что эти проценты необходимы.
Совет 11. Множественное присваивание
def create_variables1():
for i in range(10000):
a = 0
b = 1
c = 2
d = 3
e = 4
f = 5
g = 6
h = 7
i = 8
j = 9
def create_variables2():
for i in range(10000):
a, b, c, d, e, f, g, h, i, j = 0, 1, 2, 3, 4, 5, 6, 7, 8, 9
%timeit create_variables1()
174 μs ± 239 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
%timeit create_variables2()
149 μs ± 1.37 μs per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
Объявление в одну строку быстрее: распаковка кортежа обходится дешевле десяти отдельных присваиваний. Однако читаемость такой строки крайне низка, и выигрыш в 25 микросекунд на десять тысяч итераций её не оправдывает.
Совет 12. Поиск функций и атрибутов
Поиск атрибута в Python не является бесплатным: за ним стоит __getattribute__, а если тот не нашёл атрибута, то и __getattr__. Естественным решением представляется найти атрибут один раз и сохранить его в локальную переменную, не разыскивая заново на каждой итерации. Функции ниже копируют список поэлементно: первая вызывает метод append на каждой итерации, вторая заранее сохраняет его в локальную переменную.
def copy_append(elements):
result = []
for item in elements:
result.append(item)
return result
def copy_cached(elements):
result = []
append = result.append
for item in elements:
append(item)
return result
%timeit copy_append(one_million_elements)
6.18 ms ± 12.5 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%timeit copy_cached(one_million_elements)
7.7 ms ± 10.6 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Рекомендация, годами переходящая из одной подборки об оптимизации в другую, проигрывает: начиная с версии 3.11 CPython специализирует вызов метода списка в байт-коде, и обычный result.append(item) оказывается быстрее вызова через заранее сохранённую ссылку.
Подобные рекомендации необходимо проверять замером на используемой версии интерпретатора.
Прочее
Три проекта за пределами CPython решают ту же задачу иначе.
- nimpy позволяет вызывать функции на языке Nim из Python.
- Pythran предлагает ещё один подход к компиляции Python-кода.
- Pyston — альтернативный интерпретатор с JIT-компилятором, начатый в Dropbox; с 2022 года проект не развивается. Действующей альтернативой CPython с JIT-компилятором остаётся PyPy.
Оптимизация памяти
Расчёт, не помещающийся в оперативную память, не выполняется вовсе или многократно замедляется: выделение памяти завершается ошибкой MemoryError, а при подкачке данные читаются с диска.
Измерение памяти
Измерение памяти в Python затруднено, и первый способ, подсказанный документацией, вводит в заблуждение.
import sys
print(sys.getsizeof([i for i in range(1000000)]))
print(sys.getsizeof([i for i in range(100000)]))
8448728
800984
На первый взгляд, всё работает корректно. Однако рассмотрим полученные числа внимательнее.
class SomeClass:
def __init__(self, i):
self.i = i
self.j = i * 2
sys.getsizeof([SomeClass(i) for i in range(1000000)])
8448728
Список объектов SomeClass занимает столько же, сколько список целых чисел: sys.getsizeof измеряет размер самого списка, то есть массива указателей, а не объектов, на которые эти указатели ведут, и надёжно работает только для простых типов и встроенных структур, размещённых в непрерывном участке памяти.
Остаётся воспользоваться трассировкой выделений памяти. В стандартной библиотеке для этого предусмотрен модуль tracemalloc: он учитывает каждое выделение памяти интерпретатором, в том числе буферы массивов NumPy, и сообщает текущий и пиковый объём. Определим вспомогательную функцию, возвращающую объём памяти, выделенной при создании объекта:
import tracemalloc
def traced_mib(make):
"""Объём памяти, выделенной при вызове make(), в МиБ."""
tracemalloc.start()
obj = make()
size = tracemalloc.get_traced_memory()[0]
tracemalloc.stop()
return round(size / 2**20, 1)
traced_mib(lambda: [SomeClass(i) for i in range(1000000)])
145.4
traced_mib(lambda: [n for n in range(1000000)])
38.6
Вместе с объектами список экземпляров SomeClass занимает 145 МиБ, почти в двадцать раз больше, чем показывает getsizeof, а список целых чисел — 38,6 МиБ, почти впятеро больше: каждое число является отдельным объектом (sys.getsizeof(1) даёт 28 байт, а аллокатор выделяет под него 32), к которому добавляется 8-байтовая ссылка из списка.
Пакет memory_profiler с магической командой %memit, встречающийся в старых руководствах, с 2022 года не сопровождается и требует отдельной установки. Он наблюдает потребление памяти процессом целиком в отдельные моменты времени, и его результаты заметно меняются от запуска к запуску: интерпретатор и аллокатор удерживают освобождённые страницы про запас и размещают в них новые объекты.
Утечки памяти в Python
Подсчёт ссылок, циклические ссылки и поколенческий сборщик разбирались в главе «Объекты и память»; там же рассмотрена ловушка с изменяемым аргументом по умолчанию. Здесь речь идёт о том, что утекает в долго живущей программе.
В смысле C++ утечек в Python почти нет: объект освобождается, как только на него не остаётся ссылок, а недостижимые циклы находит сборщик мусора; потерять память можно разве что нарушив счётчик ссылок в расширении, написанном на C. Подробнее об этом рассказано в разборе устройства сборщика.
Долгоживущие бесполезные объекты получить легко, и на практике утечкой обычно называют именно их. Классических способов три: изменяемый аргумент по умолчанию, забытая переменная, живущая всё время работы длинной функции, и заведённый на атрибуте класса кеш, из которого ничего не удаляется.
def mutable_argument(arr=[]):
arr.append(42)
return arr
def unused_variable_in_long_process(arg1, arg2, arg3, unused_variable):
pass
class ClassCaching:
cache = {} # общий на весь класс, а не на экземпляр
def calc(self, arg):
result = self.cache.get(arg)
if result is not None:
return result
result = do_calc(arg)
self.cache[arg] = result # записи отсюда никто не удаляет
return result
В старых версиях Python (2.7 и все версии до 3.4) сборщик не умел разбирать циклические ссылки между объектами с __del__, и образованные ими циклы существовали до конца работы программы.
Array
Модуль array хранит числа примитивных типов подряд, без отдельного объекта на каждый элемент.
import array
traced_mib(lambda: array.array('q', range(10000000)))
78.1
Полный список кодов типов приведён в документации.
np.array
np.array устроен аналогично, с фиксированным типом и уложенными подряд элементами, и занимает существенно меньше памяти, чем стандартный список. В отличие от array, он поддерживает вычисления.
np.arange(10000000).nbytes / 2**20
76.2939453125
traced_mib(lambda: np.arange(10000000))
76.3
tracemalloc учитывает и буфер массива NumPy, а точный размер данных известен и без замеров: атрибут nbytes возвращает len * itemsize.
tuple vs list
Кортеж несколько компактнее списка: ему не требуется запас под рост. Разница невелика, зато видно, во что обходится списковое включение, создающее список с запасом места под будущие append.
sys.getsizeof([i for i in one_million_elements])
8448728
sys.getsizeof(tuple(one_million_elements))
8000040
sys.getsizeof(list(one_million_elements))
8000056
Slots
Атрибут __slots__ отменяет у экземпляров словарь __dict__ и размещает объявленные поля в фиксированных ячейках, за счёт чего экономится память.
class SomeClass:
def __init__(self, i):
self.a = i
self.b = 2 * i
self.c = 3 * i
self.d = 4 * i
self.e = 5 * i
traced_mib(lambda: [SomeClass(i) for i in range(1000000)])
259.8
class SomeClassSlots:
__slots__ = ('a', 'b', 'c', 'd', 'e',)
def __init__(self, i):
self.a = i
self.b = 2 * i
self.c = 3 * i
self.d = 4 * i
self.e = 5 * i
traced_mib(lambda: [SomeClassSlots(i) for i in range(1000000)])
229.3
Экономия здесь около 12 %: большую часть памяти занимают пять целых чисел каждого экземпляра, а не сам экземпляр. Чем меньше памяти занимают значения полей, тем заметнее выигрыш от __slots__.
Обычно __slots__ ускоряет и обращение к атрибуту, но не всегда.
d1 = SomeClass(0)
d2 = SomeClassSlots(0)
def attr_work(obj):
count = 0
for i in range(10000):
count += obj.a + obj.b + obj.c + obj.d + obj.e
%timeit attr_work(d1)
265 μs ± 886 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
%timeit attr_work(d2)
260 μs ± 760 ns per loop (mean ± std. dev. of 7 runs, 1,000 loops each)
Здесь разница оказалась в пределах шума: современный CPython кеширует поиск атрибута и в обычном __dict__.
С наследованием __slots__ неудобен: указывать его приходится в каждом классе иерархии, иначе __dict__ возвращается и экономия исчезает.
bitarray
Пакет bitarray хранит булевы значения по одному биту на элемент, а не по указателю на объект, и на десяти миллионах флагов разница заметна.
import bitarray.util as bu
bu.zeros(10000000).nbytes / 2**20
1.1920928955078125
traced_mib(lambda: [False for i in range(10000000)])
85.0
Платой является время: упакованный флаг необходимо извлечь из байта.
range и вычисление вместо хранения
Иногда последовательность не требуется хранить: range не держит элементы в памяти, а вычисляет требуемый по индексу, и len также вычисляется по формуле.
a = range(1, 100000, 3)
print(a[10])
print(len(a))
31
33333
Тот же приём, вычисление вместо хранения, применим и к более сложным последовательностям, а промежуточным вариантом служит расчёт, сохраняющий в кеше наиболее часто запрашиваемые значения.
Другой полезный инструментарий
Для исследования памяти полезны ещё два инструмента, работающих с живой кучей.
- objgraph строит граф ссылок и помогает установить, какой объект удерживает другой объект живым.
- guppy3 собирает подробную статистику по куче.
Резюме
- Оптимизировать имеет смысл только измеренное: интуиция о том, где программа проводит время, систематически ошибается, поэтому сначала применяется профилировщик, затем вносятся правки.
- Оптимизация всегда имеет цену, отнимая время разработки, читаемость кода, а иногда и корректность, поэтому, прежде чем ускорять, необходимо убедиться, что медленная работа действительно составляет проблему.
- Самый дешёвый выигрыш обычно даёт не микрооптимизация, а смена структуры данных или алгоритма, когда замена списка на множество в проверке вхождения меняет \(O(n)\) на \(O(1)\).
- Для памяти существуют свои средства, такие как
__slots__,arrayи генераторы вместо списков, не ускоряющие код, зато позволяющие обработать данные, которые иначе не поместились бы. - Сначала правильно, потом быстро. Ускоренный неверный расчёт остаётся неверным.
Скорость выполнения программ
В настоящей главе рассматривается последовательное ускорение одной задачи, при котором результат проверяется и измеряется на каждом шаге.
В качестве задачи выбрано умножение матриц — операция, встречающаяся в любом физическом расчёте, на которой видны все типичные способы оптимизации.
Начнём с наивной реализации на чистом Python, измерим её, найдём с помощью профилировщика узкое место, а затем последовательно применим четыре подхода: приёмы самого языка, компиляцию через Numba, компиляцию через Cython и готовую библиотеку. Разница между первой и последней версией составит несколько порядков. Все замеры выполнены в IPython на одной машине — виртуальной машине с двумя ядрами под Python 3.12, на которой записаны демонстрации лекции «Оптимизация и параллельные вычисления».
Слайды к главе. Компиляция через Numba и Cython, пространственный заряд и NumPy изложены также в пятой и шестой частях лекции «Оптимизация и параллельные вычисления» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Класс Matrix
Матрица описана как список списков с парой конструкторов:
import random
class Matrix(list):
@classmethod
def zeros(cls, shape):
n_rows, n_cols = shape
return cls([[0] * n_cols for i in range(n_rows)])
@classmethod
def random(cls, shape):
M, (n_rows, n_cols) = cls(), shape
for i in range(n_rows):
M.append([random.randint(-255, 255)
for j in range(n_cols)])
return M
def transpose(self):
return self.__class__(zip(*self))
@property
def shape(self):
return ((0, 0) if not self else
(len(self), len(self[0])))
def matrix_product(X, Y):
"""Вычисляет матричное произведение X и Y.
>>> X = Matrix([[1], [2], [3]])
>>> Y = Matrix([[4, 5, 6]])
>>> matrix_product(X, Y)
[[4, 5, 6], [8, 10, 12], [12, 15, 18]]
>>> matrix_product(Y, X)
[[32]]
"""
n_xrows, n_xcols = X.shape
n_yrows, n_ycols = Y.shape
# верим, что с размерностями всё хорошо
Z = Matrix.zeros((n_xrows, n_ycols))
for i in range(n_xrows):
for j in range(n_xcols):
for k in range(n_ycols):
Z[i][k] += X[i][j] * Y[j][k]
return Z
Примеры из строки документации проверяются модулем doctest: он выполняет каждую строку с приглашением >>> и сравнивает напечатанное с ожидаемым.
import doctest
test = doctest.DocTestFinder().find(matrix_product, globs=globals())[0]
doctest.DocTestRunner().run(test)
TestResults(failed=0, attempted=4)
Все четыре проверки прошли. Корректность проверяется и после каждого шага ускорения: быстрая, но неверная функция бесполезна. Для этого результат первой версии сохраняется как эталон, и каждая следующая версия сравнивается с ним.
Измерение времени выполнения
Скорость измеряется магической командой %timeit, описанной в главе «Причины низкой скорости Python».
shape = 64, 64
X, Y = Matrix.random(shape), Matrix.random(shape)
reference = matrix_product(X, Y)
%timeit matrix_product(X, Y)
17.7 ms ± 17.6 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Умножение двух матриц 64×64 занимает около 18 миллисекунд: за секунду выполняется лишь около 56 таких умножений. Найдём причину.
Определим вспомогательную функцию bench, генерирующую случайные матрицы указанного размера и n_iter раз перемножающую их в цикле.
def bench(shape=(64, 64), n_iter=16):
X = Matrix.random(shape)
Y = Matrix.random(shape)
for _ in range(n_iter):
matrix_product(X, Y)
Рассмотрим происходящее подробнее с помощью line_profiler, описанного в той же главе. Пакет устанавливается отдельно (pip install line_profiler), а в IPython подключается как расширение: команда %lprun -f функция выражение выполняет выражение и печатает время каждой строки указанной функции.
%load_ext line_profiler
%lprun -f matrix_product bench()
Timer unit: 1e-09 s
Total time: 1.27521 s
File: <ipython-input-2-29ee3956b63c>
Function: matrix_product at line 1
Line # Hits Time Per Hit % Time Line Contents
==============================================================
1 def matrix_product(X, Y):
2 """Вычисляет матричное произведение X и Y.
3
4 >>> X = Matrix([[1], [2], [3]])
5 >>> Y = Matrix([[4, 5, 6]])
6 >>> matrix_product(X, Y)
7 [[4, 5, 6], [8, 10, 12], [12, 15, 18]]
8 >>> matrix_product(Y, X)
9 [[32]]
10 """
11 16 21915.0 1369.7 0.0 n_xrows, n_xcols = X.shape
12 16 11210.0 700.6 0.0 n_yrows, n_ycols = Y.shape
13 # верим, что с размерностями всё хорошо
14 16 79334.0 4958.4 0.0 Z = Matrix.zeros((n_xrows, n_ycols))
15 1040 117873.0 113.3 0.0 for i in range(n_xrows):
16 66560 7629317.0 114.6 0.6 for j in range(n_xcols):
17 4259840 487990774.0 114.6 38.3 for k in range(n_ycols):
18 4194304 779354293.0 185.8 61.1 Z[i][k] += X[i][j] * Y[j][k]
19 16 9794.0 612.1 0.0 return Z
Время в отчёте дано в наносекундах (Timer unit: 1e-09 s). Почти всё оно приходится на две строки внутреннего цикла: тело Z[i][k] += X[i][j] * Y[j][k] и сам цикл for k, выполненные по четыре миллиона раз. Под профилировщиком функция работает в несколько раз медленнее, чем без него, поэтому абсолютные значения из отчёта не сравнивают с замерами %timeit, сравнивают только доли.
Ускорение средствами языка
Операция list.__getitem__ не является бесплатной, поэтому поменяем местами вложенные циклы for и будем накапливать сумму в локальной переменной, чтобы код выполнял меньше обращений по индексу.
def matrix_product(X, Y):
n_xrows, n_xcols = X.shape
n_yrows, n_ycols = Y.shape
Z = Matrix.zeros((n_xrows, n_ycols))
for i in range(n_xrows):
Xi = X[i]
for k in range(n_ycols):
acc = 0
for j in range(n_xcols):
acc += Xi[j] * Y[j][k]
Z[i][k] = acc
return Z
assert matrix_product(X, Y) == reference
%timeit matrix_product(X, Y)
11.2 ms ± 6.02 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%lprun -f matrix_product bench()
Timer unit: 1e-09 s
Total time: 1.20595 s
File: <ipython-input-7-003c7298659e>
Function: matrix_product at line 1
Line # Hits Time Per Hit % Time Line Contents
==============================================================
1 def matrix_product(X, Y):
2 16 22251.0 1390.7 0.0 n_xrows, n_xcols = X.shape
3 16 11126.0 695.4 0.0 n_yrows, n_ycols = Y.shape
4 16 79626.0 4976.6 0.0 Z = Matrix.zeros((n_xrows, n_ycols))
5 1040 120653.0 116.0 0.0 for i in range(n_xrows):
6 1024 148625.0 145.1 0.0 Xi = X[i]
7 66560 7746232.0 116.4 0.6 for k in range(n_ycols):
8 65536 8092070.0 123.5 0.7 acc = 0
9 4259840 493775272.0 115.9 40.9 for j in range(n_xcols):
10 4194304 686977762.0 163.8 57.0 acc += Xi[j] * Y[j][k]
11 65536 8971998.0 136.9 0.7 Z[i][k] = acc
12 16 8211.0 513.2 0.0 return Z
Время сократилось примерно на треть, однако заметная доля по-прежнему уходит на строку внутреннего цикла for j in range(n_xcols): на каждой итерации интерпретатор получает следующее число из range и связывает его с именем. Заменим внутренний цикл выражением sum по генератору.
def matrix_product(X, Y):
n_xrows, n_xcols = X.shape
n_yrows, n_ycols = Y.shape
Z = Matrix.zeros((n_xrows, n_ycols))
for i in range(n_xrows):
Xi, Zi = X[i], Z[i]
for k in range(n_ycols):
Zi[k] = sum(Xi[j] * Y[j][k] for j in range(n_xcols))
return Z
assert matrix_product(X, Y) == reference
%timeit matrix_product(X, Y)
12.4 ms ± 331 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%lprun -f matrix_product bench()
Timer unit: 1e-09 s
Total time: 0.793878 s
File: <ipython-input-9-a5e1d26d5e4a>
Function: matrix_product at line 1
Line # Hits Time Per Hit % Time Line Contents
==============================================================
1 def matrix_product(X, Y):
2 16 17875.0 1117.2 0.0 n_xrows, n_xcols = X.shape
3 16 10917.0 682.3 0.0 n_yrows, n_ycols = Y.shape
4 16 70000.0 4375.0 0.0 Z = Matrix.zeros((n_xrows, n_ycols))
5 1040 118811.0 114.2 0.0 for i in range(n_xrows):
6 1024 164327.0 160.5 0.0 Xi, Zi = X[i], Z[i]
7 66560 7997148.0 120.1 1.0 for k in range(n_ycols):
8 65536 785492252.0 11985.7 98.9 Zi[k] = sum(Xi[j] * Y[j][k] for j in range(n_xcols))
9 16 6457.0 403.6 0.0 return Z
Под профилировщиком эта версия выглядит быстрее предыдущей, но доверять этому нельзя: строки генераторного выражения line_profiler не отслеживает и своих накладных расходов на них не начисляет. Замер %timeit без профилировщика показывает обратное: функция стала медленнее. Тело генератора по-прежнему исполняется интерпретатором для каждого элемента, а к нему добавляется возобновление генератора. Отсюда правило: версии сравнивают замером без профилировщика, а профилировщик применяют для поиска места, требующего внимания.
Обращения по индексу во внутреннем цикле убирает транспонирование второй матрицы: строки X и строки транспонированной Y перебираются парами через zip.
def matrix_product(X, Y):
Yt = Y.transpose()
return Matrix([[sum(x * y for x, y in zip(Xi, Ytk)) for Ytk in Yt]
for Xi in X])
assert matrix_product(X, Y) == reference
%timeit matrix_product(X, Y)
8.99 ms ± 15.4 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Генератор остаётся и здесь. Ускорение даёт только перенос всего внутреннего цикла в код на C: функция operator.mul, применённая через map, и sum работают без единой инструкции байт-кода на элемент, а в Python 3.12 и новее для скалярного произведения есть готовая функция math.sumprod.
import operator
def matrix_product(X, Y):
Yt = Y.transpose()
return Matrix([[sum(map(operator.mul, Xi, Ytk)) for Ytk in Yt]
for Xi in X])
assert matrix_product(X, Y) == reference
%timeit matrix_product(X, Y)
6.38 ms ± 7.01 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
import math
def matrix_product(X, Y):
Yt = Y.transpose()
return Matrix([[math.sumprod(Xi, Ytk) for Ytk in Yt] for Xi in X])
assert matrix_product(X, Y) == reference
%timeit matrix_product(X, Y)
3.25 ms ± 10.9 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Приёмы самого языка ускорили умножение в несколько раз, однако каждое число по-прежнему остаётся объектом, а каждое умножение проходит через общий механизм выбора операции по типам. Дальше этот путь не ведёт.
Numba
Списки Python Numba поддерживает лишь частично: однородный плоский список принимается с предупреждением об устаревании этого механизма, а список списков, как в классе Matrix, и список с элементами разных типов приводят к ошибке TypeError. Для генерации машинного кода необходим массив известного типа, поэтому перепишем matrix_product через ndarray, хранящий числа одного типа подряд.
import numba
import numpy as np
@numba.njit
def jit_matrix_product(X, Y):
n_xrows, n_xcols = X.shape
n_yrows, n_ycols = Y.shape
Z = np.zeros((n_xrows, n_ycols), dtype=X.dtype)
for i in range(n_xrows):
for k in range(n_ycols):
for j in range(n_xcols):
Z[i, k] += X[i, j] * Y[j, k]
return Z
Декоратор @numba.njit компилирует функцию при первом вызове под типы аргументов. Матрицы создаются генератором случайных чисел NumPy, integers которого по умолчанию возвращает 64-битные целые на любой платформе.
import time
rng = np.random.default_rng(0)
Xa = rng.integers(-255, 255, shape)
Ya = rng.integers(-255, 255, shape)
t0 = time.perf_counter()
jit_matrix_product(Xa, Ya) # первый вызов: компиляция
print(f"первый вызов: {time.perf_counter() - t0:.3f} с")
assert (jit_matrix_product(np.array(X), np.array(Y)) == np.array(reference)).all()
%timeit jit_matrix_product(Xa, Ya)
первый вызов: 0.165 с
79.7 μs ± 53.1 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
Первый вызов длится в тысячи раз дольше последующих: в него входит компиляция. Команда %timeit без ключей сначала подбирает число запусков, и компиляция приходится на этот подбор, а не на замер. Если же число запусков задано ключом -n или время одного вызова измеряется вручную, компиляция попадает в результат: среднее завышается, среднеквадратичное отклонение превышает само среднее, а IPython предупреждает, что самый медленный прогон оказался во много раз дольше самого быстрого. Поэтому функцию Numba перед замерами вызывают один раз. Параметр cache=True сохраняет скомпилированный код на диск, и при следующем запуске программы компиляция не повторяется.
Настоящая задача: пространственный заряд
Умножение матриц является учебным примером; рассмотрим, что Numba даёт на реальной задаче. В коде REDPIC, которому посвящена отдельная глава, пучок представлен ансамблем макрочастиц, а наиболее затратной функцией расчёта является суммирование кулоновских сил между частицами. Это эффект пространственного заряда, из-за которого сильноточный пучок расталкивает сам себя:
\[ \vec F_i = \sum_{j \ne i} \frac{\vec r_i - \vec r_j}{|\vec r_i - \vec r_j|^3}. \]
Каждая частица взаимодействует с каждой, поэтому сложность составляет \(O(N^2)\), где \(N\) — число частиц. Цикл, записанный напрямую, допускает и JIT-компиляцию, и распараллеливание, поскольку слагаемые для разных \(i\) вычисляются независимо.
import numpy as np
from numba import njit, prange
def space_charge(x, y, z, Fx, Fy, Fz):
for i in range(len(x)):
for j in range(len(x)):
if i != j:
r3 = ((x[j]-x[i])**2 + (y[j]-y[i])**2 + (z[j]-z[i])**2)**1.5
Fx[i] += (x[i]-x[j]) / r3
Fy[i] += (y[i]-y[j]) / r3
Fz[i] += (z[i]-z[j]) / r3
Для параллельной версии достаточно заменить внешний range на prange: таким образом Numba узнаёт, какой из вложенных циклов можно распределить по ядрам:
def space_charge_par(x, y, z, Fx, Fy, Fz):
for i in prange(len(x)): # <-- единственное отличие
for j in range(len(x)):
if i != j:
r3 = ((x[j]-x[i])**2 + (y[j]-y[i])**2 + (z[j]-z[i])**2)**1.5
Fx[i] += (x[i]-x[j]) / r3
Fy[i] += (y[i]-y[j]) / r3
Fz[i] += (z[i]-z[j]) / r3
jit_version = njit(space_charge) # JIT
par_version = njit(parallel=True)(space_charge_par) # JIT + ядра CPU
Запись njit(func) вместо @njit над определением удобна, когда одну функцию необходимо измерить в нескольких режимах: исходный код один, обёрток несколько. Функция space_charge без обёртки работает и со списками, и с массивами NumPy; измерим её в обоих случаях вместе с двумя скомпилированными версиями. Обе версии Numba компилируются заранее, вызовом на двух частицах, чтобы компиляция не попала в замер.
def clock(f, n, lists=False):
"""Время одного вызова f для n случайных частиц, мс."""
rng = np.random.default_rng(0)
x, y, z = rng.random((3, n))
F = np.zeros((3, n))
if lists:
x, y, z, F = x.tolist(), y.tolist(), z.tolist(), F.tolist()
t0 = time.perf_counter()
f(x, y, z, *F)
return (time.perf_counter() - t0) * 1e3
warm = np.random.default_rng(1).random((3, 2))
jit_version(*warm, *np.zeros((3, 2)))
par_version(*warm, *np.zeros((3, 2)))
print(" N списки, мс массивы, мс @njit, мс parallel, мс")
for n in (256, 512, 1024, 2048, 4096):
tl = f"{clock(space_charge, n, lists=True):11.1f}" if n <= 2048 else f"{'—':>11}"
ta = f"{clock(space_charge, n):12.1f}" if n <= 1024 else f"{'—':>12}"
print(f"{n:5d} {tl} {ta} {clock(jit_version, n):10.2f} "
f"{clock(par_version, n):13.2f}")
N списки, мс массивы, мс @njit, мс parallel, мс
256 12.4 64.4 0.41 0.23
512 51.6 276.5 1.64 0.88
1024 233.4 1108.5 6.52 3.35
2048 841.5 — 26.10 13.28
4096 — — 106.91 53.39
Из таблицы следуют три вывода.
Квадратичность видна в числах. При каждом удвоении \(N\) время растёт вчетверо, что и означает \(O(N^2)\). JIT-компиляция сложность не меняет: она сокращает время в десятки раз, но кривая остаётся квадратичной. Ускорение констант и улучшение асимптотики являются разными вещами.
Один декоратор даёт ускорение примерно в тридцать раз относительно цикла Python над списками и более чем в сто раз относительно того же цикла над массивами NumPy. Цикл над массивами в Python медленнее, чем над списками: каждое обращение x[j] создаёт объект numpy.float64, арифметика над которым дороже, чем над float. Переписывать не потребовалось ни одной строки: функция как была написана на Python, так и осталась.
Параллелизм на двух ядрах виртуальной машины добавляет ещё вдвое; на десятиядерном процессоре Apple M4 та же версия опережает последовательную в 4–5 раз, но не в десять. Часть ядер такого процессора производительные, часть — энергоэффективные; к этому добавляются накладные расходы на распределение работы, поглощающие на малых \(N\) почти весь выигрыш. Линейного масштабирования по числу ядер на практике почти не встречается.
С точки зрения физики важно следующее. Расчёт с 4096 макрочастицами на чистом Python занимает несколько секунд на один вызов функции, а в моделировании таких вызовов десятки тысяч, по одному на каждый шаг интегрирования. При двадцати тысячах шагов это около двадцати часов счёта против получаса у версии с @njit. Именно эта разница делает возможным численное моделирование динамики пучка на обычном сервере, без суперкомпьютера.
Cython
Второй путь к машинному коду — Cython, язык, представляющий собой Python с объявлениями типов C: код транслируется в C и компилируется в модуль расширения. Ручной работы больше, однако и контроля больше. В IPython ячейку компилирует магическая команда %%cython, вне IPython — команда cythonize -i файл.pyx; в обоих случаях нужен компилятор C, а в Python 3.12 и новее — ещё и пакет setuptools.
%load_ext cython
Скомпилируем без изменений версию с перестановкой циклов и накопителем, работающую со списками.
%%cython
def cy_matrix_product(X, Y):
n_xrows, n_xcols = len(X), len(X[0])
n_ycols = len(Y[0])
Z = [[0] * n_ycols for i in range(n_xrows)]
for i in range(n_xrows):
Xi = X[i]
for k in range(n_ycols):
acc = 0
for j in range(n_xcols):
acc += Xi[j] * Y[j][k]
Z[i][k] = acc
return Z
assert cy_matrix_product(X, Y) == reference
%timeit cy_matrix_product(X, Y)
9.44 ms ± 14.9 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Без объявлений типов Cython ускоряет код лишь на полтора десятка процентов (9,4 мс против 11,2 мс у той же функции на Python): каждая операция по-прежнему выполняется через C API интерпретатора, с объектами чисел и проверкой типов. Перепишем функцию для массивов NumPy, пока без типов.
%%cython
import numpy as np
def cy_matrix_product(X, Y):
n_xrows, n_xcols = X.shape
n_yrows, n_ycols = Y.shape
Z = np.zeros((n_xrows, n_ycols), dtype=X.dtype)
for i in range(n_xrows):
for k in range(n_ycols):
for j in range(n_xcols):
Z[i, k] += X[i, j] * Y[j, k]
return Z
%timeit cy_matrix_product(Xa, Ya)
68.8 ms ± 1.52 ms per loop (mean ± std. dev. of 7 runs, 10 loops each)
Результат ухудшился: каждое обращение X[i, j] к массиву из скомпилированного кода по-прежнему идёт через Python и создаёт объект числа. Объявим типы. Современный способ работы с массивами в Cython — типизированные представления памяти (memoryviews): запись const long long[:, ::1] объявляет двумерный непрерывный массив 64-битных целых, доступный только для чтения. Такой код не требует cimport numpy и заголовков NumPy при сборке и принимает любой объект с буферным протоколом.
%%cython
import numpy as np
def cy_matrix_product(const long long[:, ::1] X, const long long[:, ::1] Y):
cdef Py_ssize_t n = X.shape[0], m = X.shape[1], p = Y.shape[1]
cdef Py_ssize_t i, j, k
cdef long long acc
Z = np.zeros((n, p), dtype=np.int64)
cdef long long[:, ::1] Zv = Z
for i in range(n):
for k in range(p):
acc = 0
for j in range(m):
acc += X[i, j] * Y[j, k]
Zv[i, k] = acc
return Z
assert (cy_matrix_product(Xa, Ya) == jit_matrix_product(Xa, Ya)).all()
%timeit cy_matrix_product(Xa, Ya)
122 μs ± 73.9 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
Объявленные типы позволяют Cython обращаться к числам напрямую, без объектов, и функция ускоряется в сотни раз по сравнению с версией без типов и в 27 раз — по сравнению с самой быстрой версией на чистом Python, использующей math.sumprod. Переменные цикла i, j, k объявлены типом Py_ssize_t, и цикл по range превращается в обычный цикл на C. В старых руководствах вместо представлений памяти встречается буферный синтаксис np.ndarray[np.int64_t, ndim=2] с cimport numpy; он работает, но документация Cython рекомендует представления памяти.
Отключим проверку выхода за границы массива и поддержку отрицательных индексов. Проверку переполнения целых отключать не требуется: в Cython она и так выключена по умолчанию.
%%cython
import numpy as np
cimport cython
@cython.boundscheck(False)
@cython.wraparound(False)
def cy_matrix_product(const long long[:, ::1] X, const long long[:, ::1] Y):
cdef Py_ssize_t n = X.shape[0], m = X.shape[1], p = Y.shape[1]
cdef Py_ssize_t i, j, k
cdef long long acc
Z = np.zeros((n, p), dtype=np.int64)
cdef long long[:, ::1] Zv = Z
for i in range(n):
for k in range(p):
acc = 0
for j in range(m):
acc += X[i, j] * Y[j, k]
Zv[i, k] = acc
return Z
assert (cy_matrix_product(Xa, Ya) == jit_matrix_product(Xa, Ya)).all()
%timeit cy_matrix_product(Xa, Ya)
70.9 μs ± 83.3 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
Взамен ошибка в индексе перестанет возбуждать IndexError и приведёт к обращению в чужую память без какого-либо сообщения, поэтому границы такого цикла необходимо выверять вручную. Какие строки по-прежнему обращаются к C API интерпретатора, показывает HTML-отчёт: %%cython -a в IPython или cython -a файл.pyx в терминале отмечают такие строки жёлтым.
NumPy
Xf, Yf = Xa.astype(np.float64), Ya.astype(np.float64)
%timeit Xf @ Yf
21 μs ± 689 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
%timeit Xf.dot(Yf)
21 μs ± 657 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
%timeit Xa @ Ya
79 μs ± 109 ns per loop (mean ± std. dev. of 7 runs, 10,000 loops each)
Оператор @ вызывает функцию np.matmul, а X.dot(Y) — функцию np.dot. Для двумерных массивов их результаты совпадают, и обе функции передают вычисление одной и той же процедуре BLAS — библиотеки линейной алгебры, использующей векторные инструкции процессора и оптимально работающей с кешем, — поэтому совпадают и замеры. Различия проявляются в других случаях: matmul не допускает умножения на скаляр и для массивов большей размерности перемножает стопки матриц, тогда как dot суммирует произведения по последней оси первого аргумента и предпоследней оси второго.
Тип данных на входе определяет больше, чем выбор между dot и @. BLAS поддерживает только вещественные и комплексные типы; на целых матрицах NumPy выполняет расчёт собственным циклом, без блочной обработки и без нескольких ядер, и тратит на то же умножение в несколько раз больше времени, а с ростом размера матриц разрыв увеличивается.
Наивная реализация на чистом Python вычисляла произведение матриц 64×64 около 18 миллисекунд, NumPy с BLAS справляется за 21 микросекунду: ускорение более чем в восемьсот раз без единой строки на C со стороны разработчика.
Прежде чем компилировать Python, имеет смысл попытаться не писать циклы вообще. Numba и Cython необходимы там, где задача не векторизуется; в остальных случаях правильно применённый NumPy опережает их без сборки и объявленных типов.
Многопоточность и GIL
Следующим шагом после профилирования, векторизации и JIT-компиляции является использование всех ядер процессора, а не одного. В Python это непросто, и рассмотрение необходимо начать с основ: что представляет собой процесс, что представляет собой поток и почему в обычной сборке CPython потоки не ускоряют вычисления.
Листинги главы выполнены в IPython на той же виртуальной машине с двумя ядрами под Python 3.12, что и в предыдущих главах; на ней же записаны демонстрации лекции «Оптимизация и параллельные вычисления». Сценарии раздела о сборке без GIL запущены на этой машине интерпретатором CPython 3.14 в свободнопоточной сборке. На машине с другим числом ядер числа будут иными.
Слайды к главе. Процессы и потоки, глобальная блокировка интерпретатора, пул процессов и сборка Python без GIL изложены также в седьмой части лекции «Оптимизация и параллельные вычисления» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Необходимый минимум: процессы и потоки
Процесс
Процесс — запущенная программа, и операционная система выделяет каждому процессу собственное, изолированное от остальных состояние:
- виртуальное адресное пространство, то есть собственную память, скрытую от остальных процессов;
- системные ресурсы, например открытые файловые дескрипторы.
Несколько задач, которые необходимо выполнять одновременно, можно распределить по разным процессам. Процессы, разведённые по своим адресным пространствам, не мешают друг другу, однако и обмен данными между ними затруднён: общей памяти у них нет.
Поток
Поток исполняется независимо от других потоков, как и процесс, но существует внутри процесса и разделяет с ним адресное пространство и системные ресурсы. Собственными у каждого потока остаются указатель на исполняемую инструкцию, значения регистров и стек вызовов. Два потока одного процесса могут свободно работать с общими данными, поскольку они видят одни и те же объекты, размещённые в общей памяти.
Это удобно до тех пор, пока два потока не обратятся к одним данным одновременно: в этом случае возникают гонки, о которых сказано ниже.
Порядком исполнения как процессов, так и потоков распоряжается операционная система, поочерёдно выделяющая каждому кванты времени порядка миллисекунды, то есть миллионы тактов процессора.
Модуль threading
Поток в Python является обычным системным потоком, и его исполнением управляет операционная система, а не интерпретатор. Создать поток можно классом Thread, объявленным в модуле стандартной библиотеки threading.
import time
from threading import Thread
def countdown(n):
for i in range(n):
print(n - i - 1, "left")
time.sleep(1)
t = Thread(target=countdown, args=(3,))
t.start()
2 left
1 left
0 left
Другой способ создать поток — наследование.
class CountdownThread(Thread):
def __init__(self, n):
super().__init__()
self.n = n
def run(self): # вызывается методом start
for i in range(self.n):
print(self.n - i - 1, "left")
time.sleep(1)
t = CountdownThread(3)
t.start()
2 left
1 left
0 left
Этот подход ограничивает повторное использование кода: функциональность, заключённая в класс CountdownThread, доступна только в отдельном потоке.
У потока есть имя. По умолчанию оно имеет вид Thread-N, где N — порядковый номер, а начиная с Python 3.10 у потока с функцией в target к номеру добавляется имя этой функции. Имя, заданное разработчиком, лучше читается в журналах.
Thread().name
'Thread-3'
Thread(target=countdown).name
'Thread-4 (countdown)'
Thread(name="NumberCruncher").name
'NumberCruncher'
У каждого запущенного потока есть идентификатор ident — ненулевое число, уникальное среди работающих потоков; после завершения потока тот же идентификатор может получить другой поток. Номер, присвоенный потоку операционной системой, хранит атрибут native_id (с Python 3.8).
t = Thread()
t.start()
t.ident, t.native_id
(271580801397120, 39650)
Дождаться завершения потока позволяет метод join: вызывающий поток блокируется, пока t не завершит работу; повторный join на уже завершившемся потоке возвращается мгновенно.
t = Thread(target=time.sleep, args=(5, ))
t.start()
t.join() # блокирует на 5 секунд
t.join() # выполняется мгновенно
Проверить, жив ли поток, можно методом is_alive.
t = Thread(target=time.sleep, args=(5, ))
t.start()
t.is_alive() # False через 5 секунд
True
Поток, созданный с аргументом daemon=True, называется демоном: при выходе из интерпретатора он уничтожается автоматически, а не удерживает программу от завершения до окончания своей работы.
t = Thread(target=time.sleep, args=(5,), daemon=True)
t.start()
t.daemon
True
Встроенного способа принудительно завершить поток в Python нет, и это осознанное решение. Корректное завершение почти всегда означает освобождение ресурсов: поток мог открыть файл, дескриптор которого необходимо закрыть, или захватить примитив синхронизации, который необходимо освободить. Принудительное завершение оставило бы всё это в неопределённом состоянии, поэтому запрос на завершение передаётся потоку флагом, выставленным снаружи.
class Task:
def __init__(self):
self._running = True
def terminate(self):
self._running = False
def run(self, n):
while self._running:
...
Набор примитивов синхронизации в модуле threading стандартный:
Lock, обычный мьютекс, обеспечивающий эксклюзивный доступ к разделяемому состоянию.RLock, рекурсивный мьютекс, разрешающий потоку, владеющему мьютексом, захватывать его более одного раза.Semaphore, вариация мьютекса, захватываемая не более фиксированного числа раз.BoundedSemaphore, семафор, следящий за тем, чтобы его захватывали и освобождали одинаковое число раз.Condition, условная переменная: поток ожидает в методеwait, пока другой поток не сообщит методомnotifyоб изменении общего состояния.Event, событие: флаг, установки которого методомsetпотоки ожидают в методеwait.Barrier, барьер: потоки ожидают у него, пока барьера не достигнет заданное число потоков, и затем продолжают работу вместе.
Блокировки, семафоры и условные переменные реализуют единый интерфейс:
- метод
acquireзахватывает примитив синхронизации, - а метод
releaseосвобождает его.
У событий и барьеров интерфейс собственный, поскольку они ничего не захватывают.
from threading import Lock
class SharedCounter:
def __init__(self, value):
self._value = value
self._lock = Lock()
def increment(self, delta=1):
with self._lock:
self._value += delta
def get(self):
return self._value
Захват и освобождение удобнее записывать блоком with: блокировка освобождается и тогда, когда внутри блока возникает исключение. При явных вызовах acquire и release исключение между ними, например при попытке прибавить к числу строку, оставило бы блокировку захваченной, и следующий вызов increment в любом потоке ожидал бы её бесконечно.
Модуль queue
Обмен данными между потоками с ручной расстановкой мьютексов неудобен. Обычно применяется готовая очередь; модуль queue реализует несколько потокобезопасных вариантов.
Queue, очередь FIFO,LifoQueue, очередь LIFO, то есть стек,PriorityQueue, очередь с приоритетом: элементы, обычно пары (priority, item), выдаются не в порядке поступления, а по возрастанию приоритета.
Все методы, изменяющие состояние, работают под мьютексом. Queue хранит элементы в deque, а LifoQueue и PriorityQueue — в обычном списке, защищённом тем же мьютексом.
Классическая схема «производитель-потребитель» на очереди приведена ниже.
def worker(q):
while True:
item = q.get() # блокирующе ждёт следующий
do_something(item) # элемент
q.task_done() # уведомляет очередь о выполнении
def master(q):
for item in source():
q.put(item)
# блокирующе ждёт, пока все элементы
# очереди не будут обработаны
q.join()
Модуль concurrent.futures
Модуль concurrent.futures предоставляет абстрактный класс Executor и его реализацию над пулом потоков, ThreadPoolExecutor. Интерфейс исполнителя состоит из трёх методов.
from concurrent.futures import *
executor = ThreadPoolExecutor(max_workers=4)
executor.submit(print, "Hello, world!")
Hello, world!
<Future at 0xf700558a6270 state=finished returned NoneType>
list(executor.map(print, ["Knock?", "Knock!"]))
Knock?
Knock!
[None, None]
executor.shutdown()
Исполнители поддерживают протокол менеджеров контекста: пул, открытый в with, закрывать вручную не требуется.
with ThreadPoolExecutor(max_workers=4) as executor:
...
Метод Executor.submit возвращает объект Future, обёртку над ещё не завершённым вычислением.
С Future можно выполнить следующие действия.
with ThreadPoolExecutor(max_workers=4) as executor:
f = executor.submit(sorted, [4, 3, 1, 2])
- Запросить статус вычисления:
f.running(), f.done(), f.cancelled()
(False, True, False)
- Блокирующе дождаться результата вычисления:
print(f.result())
[1, 2, 3, 4]
print(f.exception())
None
- Добавить функцию, вызываемую после завершения вычисления:
f.add_done_callback(print)
<Future at 0xf7005422bb90 state=finished returned list>
Исключение, возникшее в задаче, вызывающий поток не прерывает: оно сохраняется в объекте Future, метод exception возвращает его, а result возбуждает повторно.
with ThreadPoolExecutor(max_workers=4) as executor:
f = executor.submit(int, "x")
print(repr(f.exception()))
ValueError("invalid literal for int() with base 10: 'x'")
Поэтому результат каждой задачи необходимо запросить: иначе ошибка так и останется в объекте Future незамеченной.
Пример с модулем concurrent.futures: integrate
Проверим это на вычислительной задаче: численное интегрирование методом прямоугольников, циклом по заданному разбиению отрезка.
import math
def integrate(f, a, b, *, n_iter=1000):
acc = 0
step = (b - a) / n_iter
for i in range(n_iter):
acc += f(a + i * step) * step
return acc
integrate(math.cos, 0.0, math.pi / 2)
1.0007851925466296
Нижний предел здесь и далее записан вещественным числом 0.0. При целом 0 выражение a + i * step складывает целое число с вещественным, а такое сложение специализирующий интерпретатор CPython 3.12 не ускоряет: на машине главы расчёт с n_iter=10**6 занимает 41 мс вместо 32 мс. Параллельные версии ниже получают вещественные границы частей, и целый предел поставил бы последовательную версию в невыгодное положение.
Параллельная версия делит отрезок на n_jobs частей и передаёт каждую пулу потоков; пул создаётся в блоке with и закрывается при выходе из функции.
from functools import partial
def integrate_async(f, a, b, *, n_jobs, n_iter=1000):
with ThreadPoolExecutor(max_workers=n_jobs) as executor:
spawn = partial(executor.submit, integrate, f,
n_iter=n_iter // n_jobs)
step = (b - a) / n_jobs
fs = [spawn(a + i * step, a + (i + 1) * step)
for i in range(n_jobs)]
return sum(f.result() for f in as_completed(fs))
integrate_async(math.cos, 0.0, math.pi / 2, n_jobs=2)
1.0007851925466305
Параллелизм и конкурентность
Различим два понятия. Конкурентностью называется способность программы вести несколько задач одновременно, переключаясь между ними, а параллелизмом — одновременное выполнение задач на нескольких ядрах. Конкурентная программа может выполняться и на одном ядре, параллельная — только на нескольких. Сравним производительность последовательной и параллельной версий integrate магической командой timeit.
%%timeit -n100
integrate(math.cos, 0.0, math.pi / 2, n_iter=10**6)
31.8 ms ± 213 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%%timeit -n100
integrate_async(math.cos, 0.0, math.pi / 2, n_iter=10**6, n_jobs=2)
31.9 ms ± 243 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Глобальная блокировка интерпретатора
Два потока вместо одного не дали никакого выигрыша: 31,9 мс против 31,8 мс у последовательной версии, хотя на двух ядрах можно было ожидать двукратного ускорения. Причиной является GIL (global interpreter lock, глобальная блокировка интерпретатора).
GIL представляет собой мьютекс, гарантирующий, что в каждый момент времени байт-код исполняет только один поток. Внутреннее состояние интерпретатора (в первую очередь счётчики ссылок у каждого объекта) не защищено от одновременного доступа, и глобальная блокировка является самым простым способом не позволить двум потокам одновременно нарушить его целостность. Поток, ожидающий блокировку, по истечении интервала переключения требует её освободить, и потоки исполняют байт-код по очереди; интервал по умолчанию составляет 5 мс.
import sys
sys.getswitchinterval()
0.005
Следствие: в обычной сборке CPython потоки не ускоряют вычисления на чистом Python. Сколько бы их ни было, байт-код исполняется по очереди, а к вычислениям добавляются накладные расходы на переключение, из-за которых многопоточная версия иногда оказывается даже медленнее однопоточной. Таким образом, потоки обычной сборки обеспечивают конкурентность, но не параллелизм.
Влияние GIL на разные задачи
Мешает ли GIL, зависит от того, чем занята программа.
Если программа вычисляет на чистом Python, потоки бесполезны. Обойти GIL можно несколькими путями, и все они рассматриваются ниже: перейти к отдельным процессам, у каждого из которых свой интерпретатор со своим GIL; перейти к скомпилированному коду, способному освобождать GIL; наконец, воспользоваться сборкой интерпретатора без GIL.
Если программа ожидает, то есть читает файл, получает данные по сети, опрашивает прибор, на время ожидания поток освобождает GIL, и остальные потоки работают. Для такой нагрузки потоки подходят, и проигрыша от блокировки нет.
NumPy на длинных операциях также освобождает GIL: пока перемножаются большие матрицы, интерпретатор свободен для остальных потоков. Поэтому многопоточность в сочетании с NumPy работает лучше, чем можно было бы ожидать.
Оговорка «в обычной сборке CPython» существенна: начиная с версии 3.13 интерпретатор собирается и вовсе без глобальной блокировки. Этой сборке посвящён раздел «Сборка Python без GIL» в конце главы, а до него всё изложенное относится к обычной сборке.
C и Cython: освобождение GIL
Скомпилированный код может освободить GIL явно, на то время, пока он не обращается к объектам Python. В Cython для этого предусмотрен блок with nogil, внутри которого допустимы только типы C, зато остальные потоки работают параллельно.
%load_ext Cython
%%cython
from libc.math cimport cos
def integrate(f, double a, double b, long n_iter):
cdef double acc = 0
cdef double step=(b-a)/n_iter
cdef long i
with nogil:
for i in range(n_iter):
acc += cos(a + i * step) * step
return acc
Первый аргумент здесь оставлен только ради совместимости с integrate_async, а сама функция жёстко привязана к cos: вызвать функцию Python f внутри with nogil невозможно.
%%timeit -n100
integrate_async(math.cos, 0.0, math.pi / 2, n_iter=10**6, n_jobs=2)
1.79 ms ± 32.9 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Те же два потока, тот же integrate_async, и 1,79 мс вместо 31,9. Этот выигрыш является составным. Потоков два, поэтому на снятие GIL приходится не более двукратного ускорения; остальное, примерно девятикратное, обеспечила компиляция в машинный код. Отсюда порядок действий: сначала применяется Cython, и только затем распараллеливается уже скомпилированный код.
О замерах ниже. Ячейка выше переопределила имя
integrate: теперь под ним находится скомпилированная Cython-версия, жёстко привязанная кcos. Разделы о процессах и оjoblibиспользуют чистую Python-версию, которую следующий раздел записывает в модульworkers.py, поэтому для их повторения перезапускать блокнот не требуется.
Модуль multiprocessing
Процессы как способ обойти GIL
Поскольку глобальная блокировка одна на интерпретатор, самым прямым способом её обхода является запуск нескольких интерпретаторов. Именно это и обеспечивают процессы: у каждого свой GIL, друг другу они не мешают, и на восьми ядрах восемь процессов вычисляют одновременно.
Платой является изоляция. Процессы не разделяют память, поэтому всё, что необходимо передать между ними, приходится сериализовать и копировать. Для расчёта, в котором каждому процессу передаётся часть работы и забирается число, это несущественно; для задачи с большим общим состоянием накладные расходы на пересылку могут поглотить весь выигрыш.
За работу с процессами отвечает модуль multiprocessing, устроенный аналогично threading. Функция, которую выполняет дочерний процесс, передаётся ему по имени и должна импортироваться из модуля: при методах запуска spawn (macOS, Windows) и forkserver (Linux начиная с Python 3.14) функция из ячейки блокнота в дочернем процессе не находится, и он завершается ошибкой AttributeError. Поэтому функции примеров этого раздела записываются в файл workers.py и импортируются из него; туда же помещена чистая Python-версия integrate для следующих разделов.
%%writefile workers.py
import time
def countdown(n):
for i in range(n):
print(n - i - 1, "left")
time.sleep(1)
def ponger(conn):
conn.send("pong")
def integrate(f, a, b, *, n_iter=1000):
acc = 0
step = (b - a) / n_iter
for i in range(n_iter):
acc += f(a + i * step) * step
return acc
Writing workers.py
import multiprocessing as mp
from workers import countdown, ponger, integrate
После импорта имя integrate снова указывает на чистую Python-версию.
p = mp.Process(target=countdown, args=(5, ))
p.start()
4 left
3 left
2 left
1 left
0 left
Примитивы синхронизации те же: мьютексы, семафоры, условные переменные. Для обмена данными между процессами предусмотрен Pipe, соединение двух процессов поверх сокетов.
parent_conn, child_conn = mp.Pipe()
p = mp.Process(target=ponger, args=(child_conn, ))
p.start()
parent_conn.recv()
'pong'
p.join()
Методы запуска процессов
Способ создания дочернего процесса задаёт метод запуска. Метод fork копирует родительский процесс целиком, вместе с его памятью и уже определёнными функциями. Метод spawn запускает новый интерпретатор, который импортирует главный модуль программы и получает функцию и аргументы в сериализованном виде. Метод forkserver при первом обращении запускает однопоточный процесс-сервер, а рабочие процессы порождает копированием этого сервера. По умолчанию в Windows и, начиная с Python 3.8, в macOS используется spawn, в Linux до версии 3.13 включительно — fork, а начиная с 3.14 — forkserver.
mp.get_start_method()
'fork'
Смена метода по умолчанию в Linux объясняется потоками. Копия процесса наследует блокировки, захваченные другими его потоками, но не сами эти потоки, и может навсегда остановиться на такой блокировке; начиная с Python 3.12 вызов fork в процессе с несколькими потоками сопровождается предупреждением DeprecationWarning. Метод выбирается функцией mp.set_start_method в начале программы или передаётся пулу явно: ProcessPoolExecutor(mp_context=mp.get_context("spawn")). При spawn и forkserver главный модуль программы импортируется в каждом рабочем процессе заново. Поэтому в сценарии создание процессов помещают под проверку if __name__ == "__main__":, иначе рабочий процесс, импортируя модуль, попытается снова создать дочерние процессы, и программа завершится ошибкой RuntimeError.
Оценим цену запуска. На машине главы, под Python 3.12 и 3.14, пул из двух процессов запускается методом fork за 1–4 мс, методом spawn — за 16–28 мс; forkserver тратит 19–28 мс на первый запуск, пока стартует сервер, а следующие пулы порождает за 3–6 мс.
Процессы и производительность
Реализация integrate_async на пуле потоков работала долго; рассмотрим пул процессов. ProcessPoolExecutor имеет тот же интерфейс, что и пул потоков, а функция integrate теперь импортирована из модуля workers.py.
from concurrent.futures import ProcessPoolExecutor
def integrate_async(executor, f, a, b, *, n_jobs, n_iter=1000):
spawn = partial(executor.submit, integrate, f,
n_iter=n_iter // n_jobs)
step = (b - a) / n_jobs
fs=[spawn(a + i * step, a + (i + 1) * step)
for i in range(n_jobs)]
return sum(f.result() for f in as_completed(fs))
Пул принимается аргументом, а не создаётся внутри: пул, созданный внутри измеряемой функции, превратил бы замер вычислений в замер запуска процессов. Кроме того, ProcessPoolExecutor, оставленный без закрытия, оставляет процессы работающими, и за сотню итераций %%timeit их число на машине станет значительным. Поэтому пул открывается блоком with и прогревается первым вызовом, а последовательная и параллельная версии измеряются в одном прогоне.
with ProcessPoolExecutor(max_workers=2) as executor:
integrate_async(executor, math.cos, 0.0, math.pi / 2,
n_iter=10**6, n_jobs=2) # прогрев
%timeit -n5 integrate(math.cos, 0.0, math.pi / 2, n_iter=10**6)
%timeit -n5 integrate_async(executor, math.cos, 0.0, math.pi / 2, \
n_iter=10**6, n_jobs=2)
31.8 ms ± 88.3 μs per loop (mean ± std. dev. of 7 runs, 5 loops each)
19.9 ms ± 709 μs per loop (mean ± std. dev. of 7 runs, 5 loops each)
Последовательный расчёт занимает 31,8 мс, а два процесса — 19,9 мс, то есть в 1,6 раза меньше: у каждого процесса свой GIL, и оба ядра заняты вычислениями. До двукратного ускорения недостаёт накладных расходов: задачи и результаты пересылаются между процессами, и при расчёте длительностью в десятки миллисекунд эти расходы заметны.
Передача функции и аргументов
Функция и её аргументы передаются рабочему процессу сериализацией модулем pickle, а результат возвращается тем же путём. Функция при этом сериализуется по имени модуля и функции, поэтому в пуле выполняются функции верхнего уровня импортируемого модуля, а lambda и вложенная функция не сериализуются. Ошибка возникает не в момент вызова submit: сериализацию выполняет служебный поток пула, и исключение сохраняется в объекте Future до вызова result.
with ProcessPoolExecutor(max_workers=2) as executor:
f = executor.submit(lambda x: x * x, 3) # submit исключения не возбуждает
try:
f.result() # ошибка сериализации возбуждается здесь
except Exception as exc:
print(type(exc).__name__, exc)
PicklingError Can't pickle <function <lambda> at 0xf700564b99e0>: attribute lookup <lambda> on __main__ failed
Для lambda модуль pickle возбуждает PicklingError, а для вложенной функции до Python 3.13 включительно — AttributeError, начиная с 3.14 — тоже PicklingError. Без вызова result такая ошибка осталась бы незамеченной: блок with закрыл бы пул без сообщений.
Пул подынтерпретаторов
В Python 3.14 появился промежуточный вариант между пулом потоков и пулом процессов — InterpreterPoolExecutor из того же модуля concurrent.futures. Его рабочие потоки исполняют задачи в изолированных подынтерпретаторах одного процесса, и у каждого подынтерпретатора собственный GIL, поэтому вычисления на чистом Python выполняются параллельно и в обычной сборке. Общих изменяемых объектов у подынтерпретаторов нет: функция, аргументы и результат копируются из одного интерпретатора в другой. Функции без замыканий и без обращений к глобальным именам передаются непосредственно, остальные — через pickle, и такие функции, как и для пула процессов, должны импортироваться из модуля. Модуль расширения, не поддерживающий подынтерпретаторы, в них не импортируется: попытка завершается ошибкой ImportError.
Пакет joblib
Пакет joblib предоставляет параллельный аналог цикла for для независимых итераций, которые необходимо распределить по ядрам. Выбор между потоками и процессами задаётся аргументом backend конструктора: по умолчанию, начиная с версии 0.12, используется loky — собственный пул процессов joblib, сохраняемый между вызовами, а "threading" и "multiprocessing" указываются явно. Функция integrate в этом разделе — по-прежнему чистая Python-версия из workers.py.
from joblib import Parallel, delayed
def integrate_async(f, a, b, *, n_jobs, n_iter=1000, backend=None):
step = (b - a) / n_jobs
with Parallel(n_jobs=n_jobs, backend=backend) as parallel:
fs = (delayed(integrate)(f, a + i * step,
a + (i + 1) * step,
n_iter=n_iter // n_jobs)
for i in range(n_jobs))
return sum(parallel(fs)) # пул существует только внутри одного вызова
%%timeit -n100
integrate_async(math.cos, 0.0, math.pi / 2, n_iter=10**6, n_jobs=2, backend="threading")
45 ms ± 426 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
%%timeit -n100
integrate_async(math.cos, 0.0, math.pi / 2, n_iter=10**6, n_jobs=2, backend="multiprocessing")
41.6 ms ± 405 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Бэкенд по умолчанию запускает рабочие процессы при первом вызове, поэтому перед замером выполняется прогрев.
integrate_async(math.cos, 0.0, math.pi / 2, n_iter=10**6, n_jobs=2) # прогрев: запуск процессов loky
1.0000007853979973
%%timeit -n100
integrate_async(math.cos, 0.0, math.pi / 2, n_iter=10**6, n_jobs=2)
23.4 ms ± 396 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Сам по себе joblib ничего не ускоряет. На потоках работа упирается в тот же GIL, и к 31,8 мс последовательного расчёта добавляются расходы самого joblib: получается 45 мс. Бэкенд "multiprocessing" при каждом вызове integrate_async заново запускает и останавливает рабочие процессы: 41,6 мс против 19,9 мс у заранее запущенного пула из предыдущего раздела, то есть больше половины времени замера уходит на запуск и остановку. Бэкенд по умолчанию, loky, сохраняет процессы между вызовами и на двух процессах даёт ускорение — 23,4 мс против 31,8 мс; от ProcessPoolExecutor его отделяют накладные расходы joblib на каждый вызов.
JIT-компилятор numba
Numba из главы «Скорость выполнения программ» освобождает GIL только по запросу. Обычная функция @jit(nopython=True) без parallel=True удерживает GIL всё время вызова; чтобы несколько потоков Python выполняли её одновременно, её компилируют с параметром nogil=True. Покажем разницу на том же интеграле, записанном для Numba.
from numba import jit, prange
def cos_sum(a, b, n_iter):
acc = 0.0
step = (b - a) / n_iter
for i in range(n_iter):
acc += math.cos(a + i * step) * step
return acc
held = jit(nopython=True)(cos_sum) # удерживает GIL
released = jit(nopython=True, nogil=True)(cos_sum) # освобождает GIL
def in_two_threads(func, a, b, n_iter):
mid = (a + b) / 2
with ThreadPoolExecutor(max_workers=2) as executor:
fs = [executor.submit(func, a, mid, n_iter // 2),
executor.submit(func, mid, b, n_iter // 2)]
return sum(f.result() for f in fs)
for func in (held, released):
func(0.0, 1.0, 10) # компиляция для вещественных a и b
%timeit -n100 held(0.0, math.pi / 2, 10**6)
%timeit -n100 in_two_threads(held, 0.0, math.pi / 2, 10**6)
%timeit -n100 in_two_threads(released, 0.0, math.pi / 2, 10**6)
2.96 ms ± 20 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
3.1 ms ± 22.9 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
1.81 ms ± 60.4 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Функция без nogil=True в двух потоках выполняется не быстрее, чем в одном: 3,1 мс против 2,96 мс, поскольку GIL удерживается всё время вызова и потоки работают по очереди. С nogil=True потоки вычисляют одновременно, и время сокращается до 1,81 мс.
Параметр parallel=True избавляет и от потоков Python: декоратор @jit(nopython=True, parallel=True) компилирует функцию в машинный код, а цикл prange распределяет по ядрам сама Numba, без участия GIL.
@jit(nopython=True, parallel=True, fastmath=True)
def integrate(a, b, n_iter=1000):
acc = 0
step = (b - a) / n_iter
for i in prange(n_iter):
acc += math.cos(a + i * step) * step
return acc
integrate(0.0, math.pi / 2, n_iter=10**6) # компиляция при первом вызове
1.0000007853979516
%%timeit -n100
integrate(0.0, math.pi / 2, n_iter=10**6)
1.83 ms ± 95.1 μs per loop (mean ± std. dev. of 7 runs, 100 loops each)
Цикл prange той же длины занимает 1,83 мс, столько же, сколько два потока с nogil=True: на двух ядрах параллелизм дал меньше двух раз, а основной выигрыш перед чистым Python с его 31,8 мс по-прежнему обеспечивает компиляция.
Сборка Python без GIL
Начиная с версии 3.13 интерпретатор CPython собирается и без глобальной блокировки (PEP 703). Такая сборка называется свободнопоточной (free-threaded), устанавливается рядом с обычной, и её исполняемый файл имеет суффикс t: python3.13t, python3.14t. В 3.13 сборка была экспериментальной, в 3.14 она поддерживается официально (PEP 779), но по умолчанию по-прежнему устанавливается обычная сборка. Потоки свободнопоточной сборки исполняют байт-код одновременно на всех ядрах, и вычисления на чистом Python распараллеливаются без процессов и без компиляции.
!python3.14t -VV
Python 3.14.8 free-threading build (main, Oct 1 2026, 21:01:11) [Clang 22.1.3 ]
Саму сборку определяют строка «free-threading build» в выводе python -VV и значение sysconfig.get_config_var("Py_GIL_DISABLED"), равное 1. Включена ли блокировка в работающем процессе, сообщает функция sys._is_gil_enabled() (с Python 3.13): в свободнопоточной сборке она возвращает False, если GIL не включён ключом -X gil=1, переменной окружения PYTHON_GIL=1 или импортом неподготовленного расширения.
!python3.14t -c "import sys, sysconfig; print(sysconfig.get_config_var('Py_GIL_DISABLED'), sys._is_gil_enabled())"
!PYTHON_GIL=1 python3.14t -c "import sys; print(sys._is_gil_enabled())"
1 False
True
Рассмотрим тот же интеграл на чистом Python в одном и в двух потоках. Сценарий ft.py печатает состояние блокировки и лучшее время из трёх запусков.
%%writefile ft.py
import math
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from workers import integrate
def integrate_threads(f, a, b, *, n_jobs, n_iter):
step = (b - a) / n_jobs
with ThreadPoolExecutor(max_workers=n_jobs) as executor:
fs = [executor.submit(integrate, f, a + i * step, a + (i + 1) * step,
n_iter=n_iter // n_jobs)
for i in range(n_jobs)]
return sum(f.result() for f in fs)
print("GIL включён:", sys._is_gil_enabled())
for n_jobs in (1, 2):
times = []
for _ in range(3):
t0 = time.perf_counter()
integrate_threads(math.cos, 0.0, math.pi / 2, n_jobs=n_jobs, n_iter=10**7)
times.append(time.perf_counter() - t0)
print(f"потоков: {n_jobs}, время {min(times):.2f} с")
Writing ft.py
!python3.14t -X gil=1 ft.py
GIL включён: True
потоков: 1, время 0.38 с
потоков: 2, время 0.38 с
!python3.14t ft.py
GIL включён: False
потоков: 1, время 0.38 с
потоков: 2, время 0.21 с
С включённой блокировкой два потока считают столько же, сколько один, — 0,38 с, а без неё — 0,21 с, в 1,8 раза быстрее: потоки исполняют байт-код одновременно на двух ядрах. Однопоточное время здесь нельзя сравнивать с замерами Python 3.12 выше: различаются и версия интерпретатора, и параметры его сборки, а цена отказа от GIL, о которой сказано ниже, относится к двум сборкам одной версии.
Отсутствие GIL не делает программу потокобезопасной. Встроенные типы — список, словарь, множество — защищены собственными внутренними блокировками, и их одновременное изменение не нарушает целостности объектов. Однако составное действие над общими данными, например counter += 1, по-прежнему состоит из чтения, сложения и записи, и эти шаги двух потоков могут перемежаться. Проверим это на счётчике, который два потока увеличивают по миллиону раз.
%%writefile race.py
import threading
counter = 0
lock = threading.Lock()
def bump(n, guarded):
global counter
for _ in range(n):
if guarded:
with lock:
counter += 1
else:
counter += 1
for guarded in (False, True):
counter = 0
threads = [threading.Thread(target=bump, args=(10**6, guarded)) for _ in range(2)]
for t in threads:
t.start()
for t in threads:
t.join()
print("с Lock:" if guarded else "без Lock:", counter)
Writing race.py
!python3.14t race.py
без Lock: 1037029
с Lock: 2000000
Без Lock потеряно 962 971 увеличение из 2 000 000, почти половина: чтение, сложение и запись одного потока перемежаются с теми же шагами другого, и результат одного из них затирается. С Lock результат точный. Свободнопоточная сборка требует той же синхронизации доступа к общим данным, что и любая многопоточная программа.
Модули расширения на C должны объявить, что не полагаются на GIL: в C для этого служит слот Py_mod_gil при инициализации модуля, в Cython начиная с версии 3.1 — директива freethreading_compatible. При импорте модуля без такого объявления свободнопоточный интерпретатор снова включает блокировку для всего процесса и выводит предупреждение RuntimeWarning, в котором сказано, что оставить GIL выключенным на свой риск позволяют PYTHON_GIL=0 и -X gil=0. NumPy выпускает пакеты wheel для свободнопоточной сборки с версии 2.1, Numba — с версии 0.65, и обе библиотеки называют эту поддержку экспериментальной.
Платой за отказ от блокировки являются потери на однопоточном коде — по руководству по свободнопоточной сборке Python 3.14 в среднем от 1 % на macOS с процессором aarch64 до 8 % на Linux с x86-64 на наборе тестов pyperformance (в обзоре изменений 3.14 — «примерно 5–10 %», в 3.13 — около 40 %), — повышенный расход памяти и неготовность части C-расширений, написанных в расчёте на то, что блокировка защитит их сама. Таким образом, сборка без GIL позволяет распараллелить потоками код на чистом Python, но требует и потокобезопасной программы, и подготовленных расширений.
Резюме
Перед выбором инструмента необходимо ответить на один вопрос: программа вычисляет или ожидает?
Если программа ожидает сети, диска, прибора, ответа пользователя, используются потоки. GIL на время ожидания освобождается, потоки дёшевы, и десятки одновременных ожиданий обходятся почти бесплатно. Если ожиданий предстоят тысячи, требуется перейти к асинхронности, рассматриваемой в следующей главе.
Если программа вычисляет, потоки в обычной сборке CPython не помогут, сколько бы их ни было. Существует четыре пути: вынести расчёт в отдельные процессы через multiprocessing или ProcessPoolExecutor, где у каждого свой интерпретатор и свой GIL; перейти к скомпилированному коду на Cython, Numba или C, способному освобождать GIL; поручить расчёт NumPy, освобождающему блокировку самостоятельно, что обычно проще всего; наконец, начиная с Python 3.14 потоки на чистом Python распараллеливает официально поддерживаемая свободнопоточная сборка, если к ней готовы используемые расширения.
Прежде чем распараллеливать, необходимо измерить. Часто узкое место находится не там, где предполагалось, и одна правка алгоритма даёт больше, чем любое количество потоков.
Асинхронность
Сколько бы потоков ни было запущено, в обычной сборке CPython GIL пропускает через интерпретатор только один из них (о сборке без GIL — в главе «Многопоточность и GIL»), а запускать больше одновременно вычисляющих процессов, чем ядер, не имеет смысла.
Существует класс задач, в которых процессор не является узким местом. Программа, скачивающая тысячу файлов или опрашивающая сотню приборов по сети, почти всё время ожидает. Запрос, отправленный по сети, ушёл, ответ не пришёл, работы нет. Выделять под каждое такое ожидание отдельный поток расточительно, поскольку поток, отданный под простой, требует памяти и переключений контекста, а полезной работы не выполняет.
Асинхронность поручает одному потоку тысячу ожиданий сразу: пока один запрос ожидает ответа, выполняется другой. Механику обеспечивают генераторы и корутины, разобранные в главе «Итераторы, генераторы и корутины»: планировщику необходима функция, способная приостановиться и продолжить с того же места.
Слайды к главе. Основы асинхронности изложены также в пятой части лекции «Итераторы, генераторы и корутины» (цикл событий на генераторах, async и await, задачи и тайм-ауты, асинхронная итерация) с демонстрациями в интерактивной оболочке; слайды лекции доступны на сайте книги и в PDF.
Работа с разными типами задач
Долгое время природу нагрузки внутри программы можно было не учитывать, поскольку приложения писались большими и монолитными, а проблемы с производительностью решались грубой силой: добавленными потоками, дополнительными процессами или ещё одной машиной, установленной в стойку.
Сегодня одних процессов и потоков недостаточно, и выбор инструмента начинается с вопроса, чем занята программа. Задачи разделяют на три типа:
-
CPU bound-задачи. Задачи, требующие интенсивного использования процессора, среди которых сложные математические модели, обучение нейронных сетей, рендеринг графики и вычисление хешей.
-
I/O bound-задачи (non-RAM I/O bound). Задачи, в которых основная часть работы приходится на ввод/вывод информации I/O или input/output, относящиеся в основном к работе с файловой системой и с сетью.
-
Memory bound-задачи (RAM I/O bound). Задачи с интенсивной работой с оперативной памятью, возникающие, как правило, в сложных математических моделях. Из-за медленной работы с оперативной памятью всё больше моделей обрабатывается на видеокартах, устроенных иначе. Другим примером служит обработка огромного объёма данных в Map-Reduce-системах, например таких как Spark, выполняющаяся тем быстрее, чем больше оперативной памяти.
Подробнее об этом рассказано в англоязычных статьях о значении терминов CPU bound и I/O bound и о производительности.
Из-за массового перехода на микросервисы количество сетевого взаимодействия между системами многократно возросло, а вместе с ним и нагрузка, приходящаяся на базы данных. Проблемы работы с сетью или с доступом к БД относятся к I/O bound-задачам, сводящимся к ожиданию ответа на запрос, отправленный во внешнюю систему. Такой класс задач в монолитных системах решался пулом потоков, thread pool, которого с ростом сетевой нагрузки между множеством сервисов стало недостаточно.
Классическим ответом на I/O bound-нагрузку является добавление ресурсов, однако приобретать серверы вместо того, чтобы разбираться с кодом, способны лишь компании с большими бюджетами. В лаборатории этот путь закрыт, и остаётся писать код, рассчитанный на такую нагрузку.
Рассмотрим приложение, обращающееся к некоторому сайту-агрегатору за данными по фильмам и сохраняющее полученное в БД (ссылка на сайт вымышленная):
import requests
def do_some_logic(data):
pass
def save_to_database(data):
pass
data = requests.get('https://data.aggregator.com/films')
processed_data = do_some_logic(data)
save_to_database(processed_data)
Код линейный, и пока запрос один, проблем нет, однако как только приложению приходится обслуживать многих клиентов одновременно, время ответа возрастает. Бо́льшую часть времени интерпретатор не выполняет ничего полезного, а ожидает запроса от клиента, ожидает ответа от внешнего сайта, ожидает записи, подтверждённой базой. А клиенты в это время ожидают его.
Схема выполнения программы:
Тип задачи в каждой ячейке:
Интуитивно представляется, что время распределено между ячейками примерно поровну, однако в действительности картина иная:
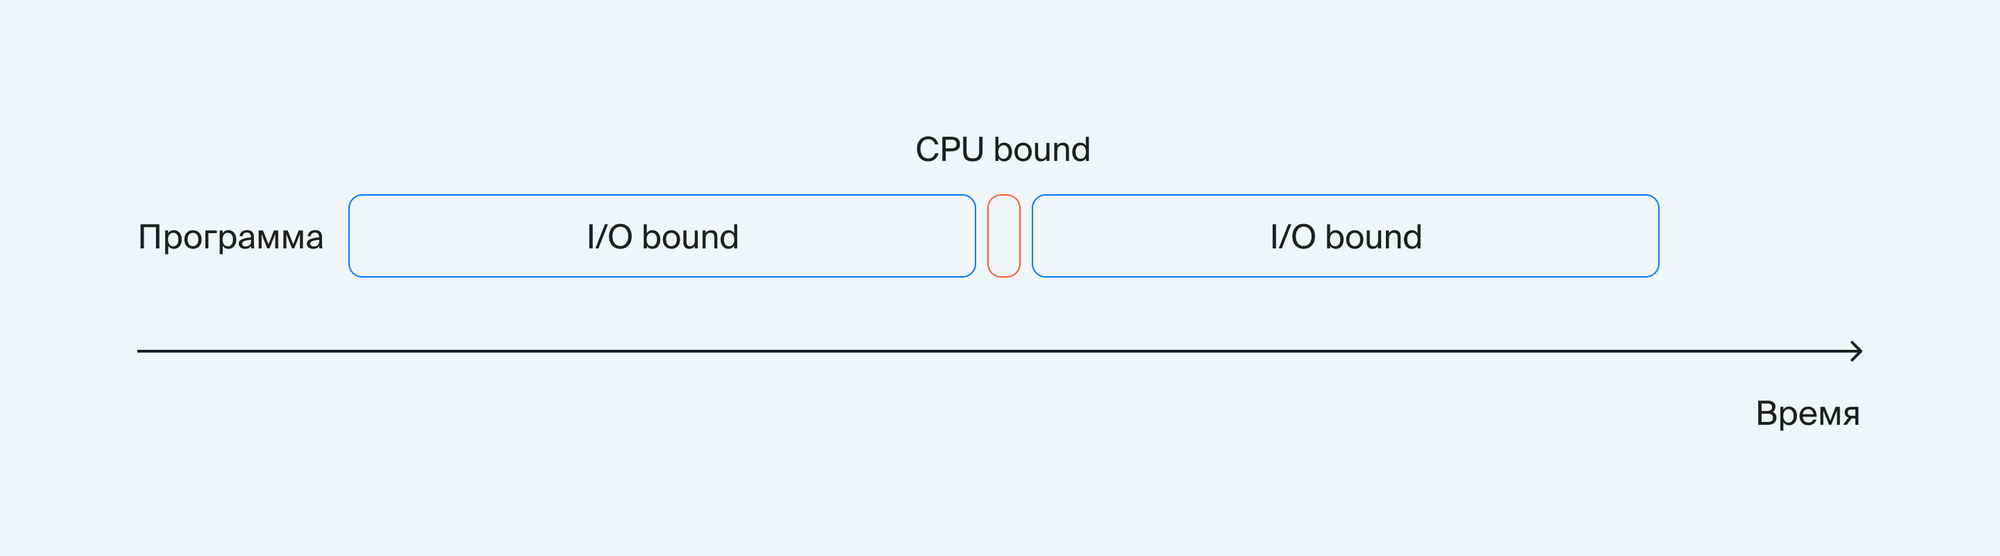
Бо́льшую часть времени программа ожидает ввода/вывода, а полезная работа теряется на этом фоне.
Код можно распараллелить на процессы и потоки. Это поможет, но ненадолго: расходы ресурсов сервера возрастут, а число процессов и потоков ограничено, поскольку закончится либо оперативная память под потоки, либо ядра под процессы. Добавляется GIL, пропускающий через интерпретатор только один поток за раз: массовый параллелизм на потоках он делает бессмысленным и добавляет собственные накладные расходы, пусть и небольшие.
Выполнение программы с потоками:
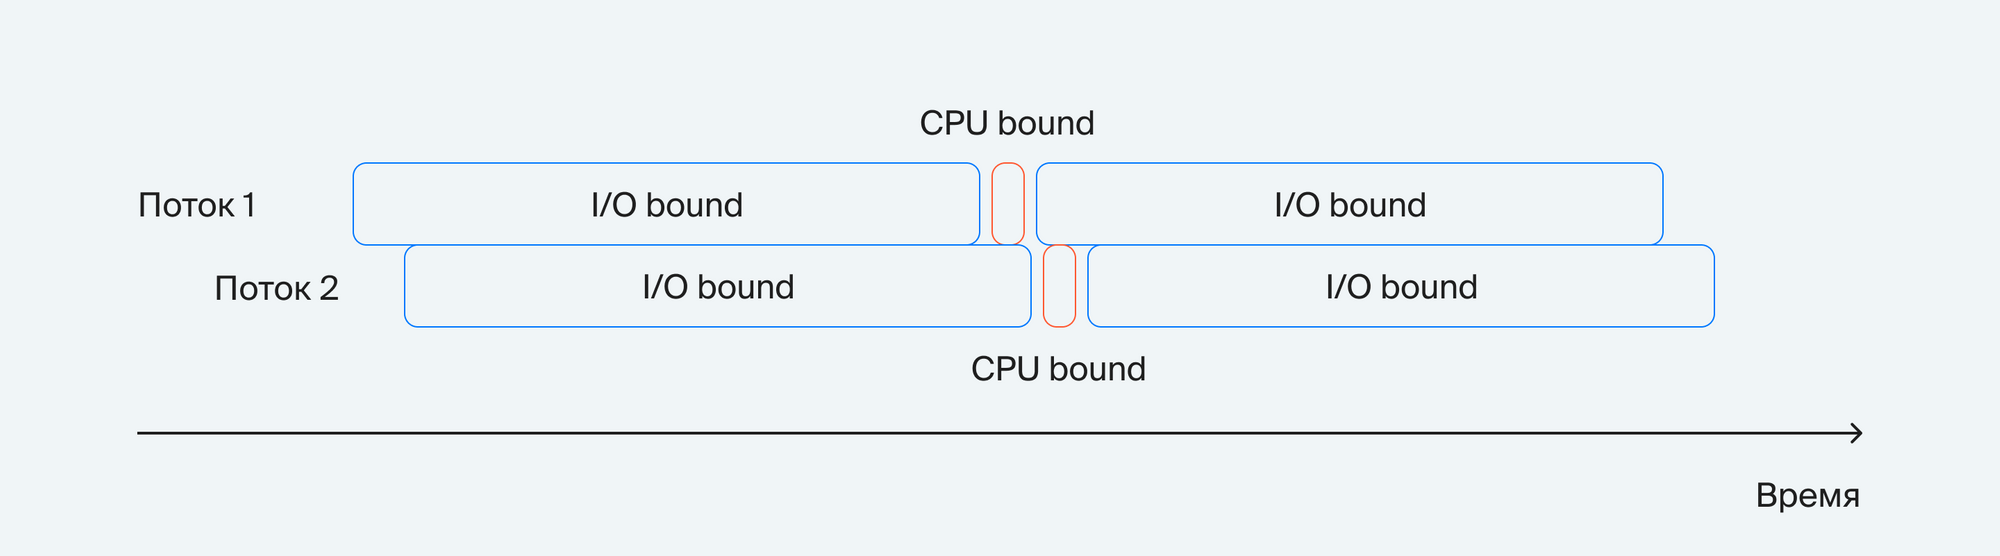
На I/O bound-задачах два потока работают почти вдвое лучше. Однако два потока, обращающиеся к одним и тем же данным, порождают проблему «состояния гонок», а многопоточный код требует от разработчика большей внимательности, чем линейный. Кроме того, создать неограниченное число потоков невозможно: памяти под каждый стек они потребляют несравнимо больше, чем корутины.
Интерпретатор по-прежнему бо́льшую часть времени ничего не выполняет, а лишь запрашивает у операционной системы, завершилась ли операция ввода-вывода, запущенная минуту назад. Процессы и потоки этого не меняют. Простаивать будет каждый из них, зато добавятся накладные расходы на переключение контекста и на память, выделенную под стеки, из-за чего положение может даже ухудшиться.
Решение состоит не в увеличении числа исполнителей, а в том, чтобы один исполнитель не простаивал. Эту задачу решает асинхронный код.
Event-loop
Цикл событий является ядром асинхронных программ в Python. Разберём простую реализацию, предложенную Дэвидом Бизли (David Beazley) в 2009 году: в ней отсутствуют конструкции, которыми с тех пор дополнились промышленные реализации, и устройство просматривается полностью. Код Бизли приведён к современной версии Python.
Архитектура цикла событий:
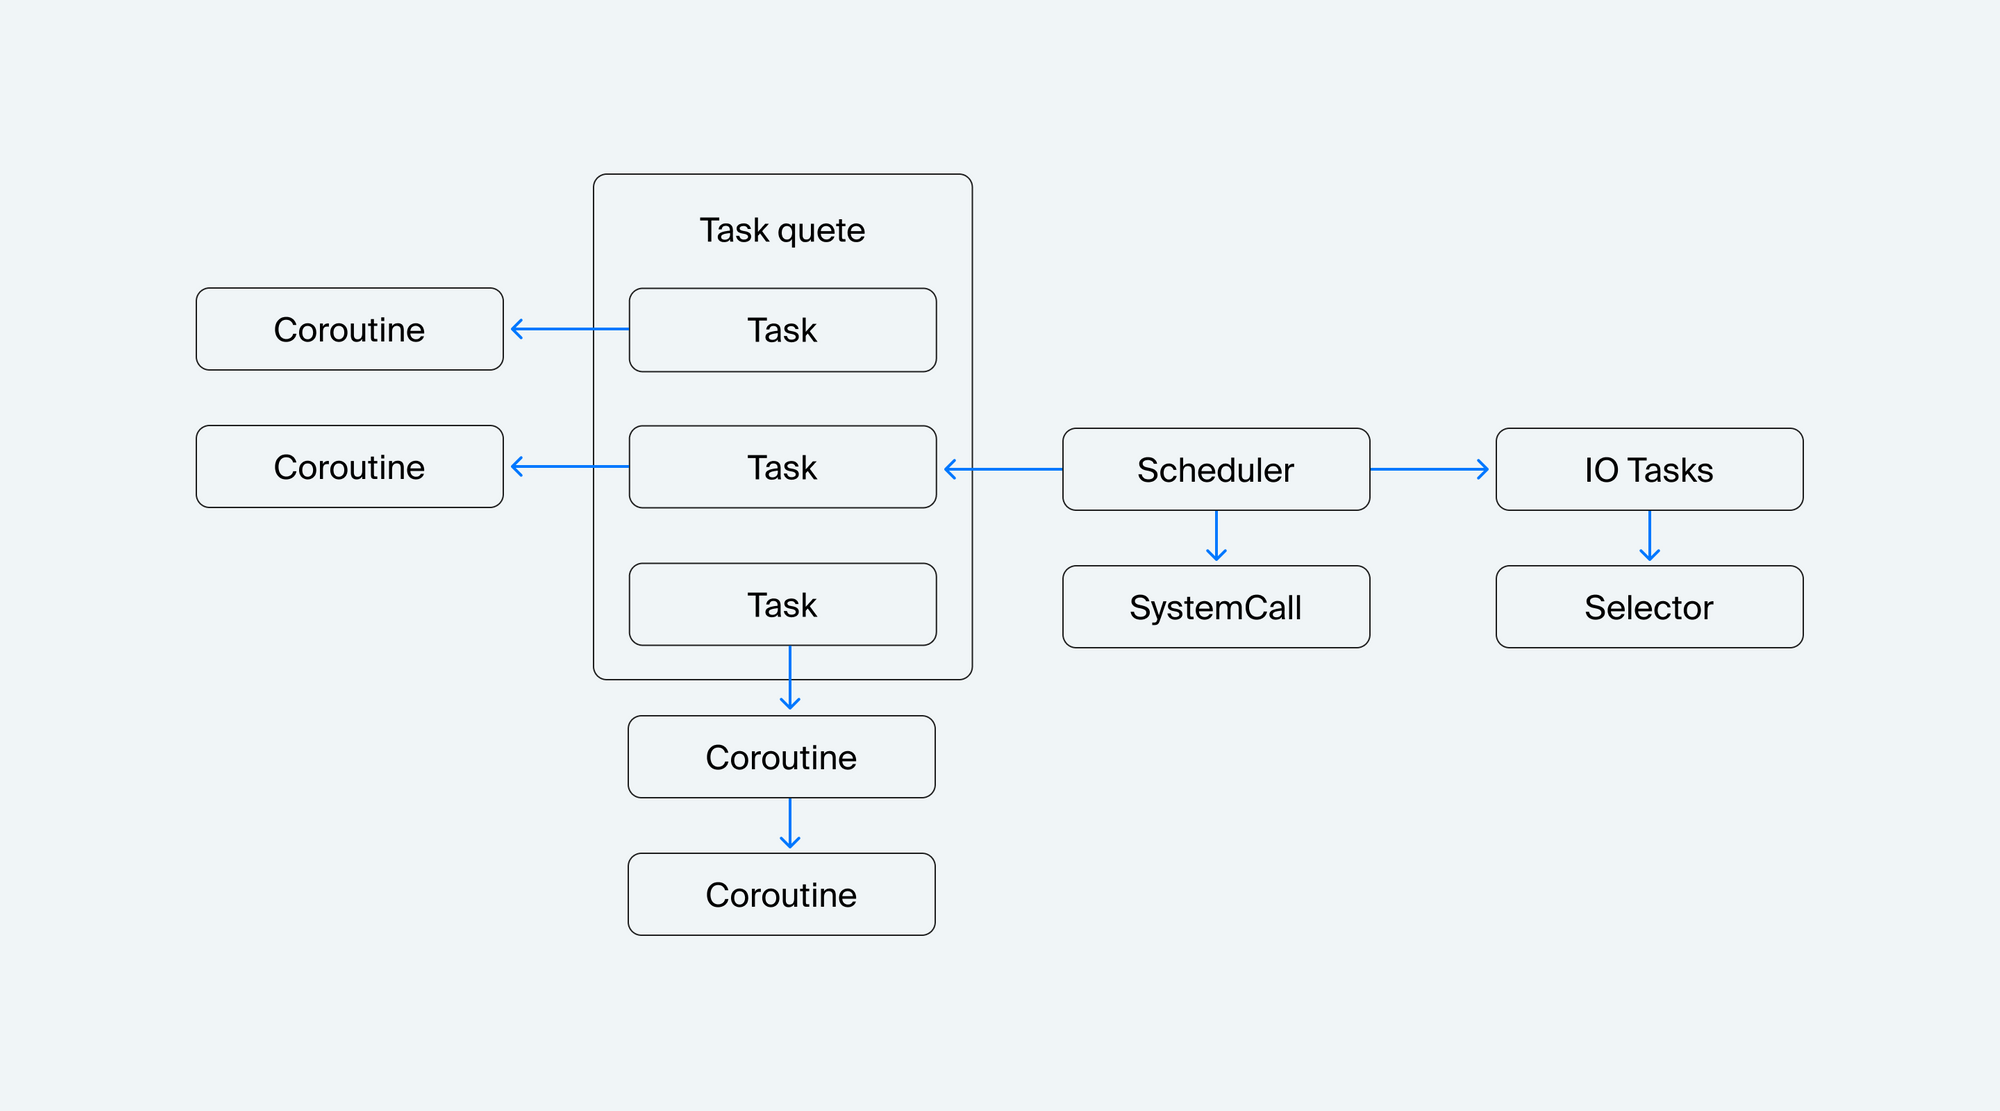
Рассмотрим блоки:
- Планировщик (Scheduler). Корень всей программы. Обрабатывает задачи, собранные в очереди, и следит за их правильным переключением между собой.
- Очередь задач (Task queue). Здесь накапливаются новые задачи, поставленные на исполнение.
- Задача (Task). Основной блок работы цикла событий. В задачах хранится информация о выполняемой корутине. Способна обрабатывать цепочку вложенных корутин.
- Корутина (Coroutine). Исполняемый код, которым оперирует планировщик задач.
- Системный вызов (SystemCall). Блоки кода, расширяющие функциональность планировщика.
- Корутина для выполнения работы с I/O (I/O-tasks). В планировщик добавляется специальная задача (Task), предназначенная для обработки I/O-событий от ОС.
- Селектор (Selector). Он принимает события от ОС и передаёт работу корутинам, ожидающим обработки I/O-сообщений.
Планировщик принимает задачи и справедливо обрабатывает накопленный список.
from __future__ import annotations
from collections import deque
from collections.abc import Generator
class Scheduler:
def __init__(self):
self.ready = deque()
self.task_map = {}
def add_task(self, coroutine: Generator) -> int:
new_task = Task(coroutine)
self.task_map[new_task.tid] = new_task
self.schedule(new_task)
return new_task.tid
def exit(self, task: Task):
del self.task_map[task.tid]
def schedule(self, task: Task):
self.ready.append(task)
def _run_once(self):
task = self.ready.popleft()
try:
result = task.run()
except StopIteration:
self.exit(task)
return
self.schedule(task)
def event_loop(self):
while self.task_map:
self._run_once()
Вся работа происходит в функции event_loop(), извлекающей задачи одну за другой. В функции _run_once() осуществляется обработка одной итерации цикла событий, где поочерёдно извлекаются и запускаются задачи, поставленные в очередь. Если задача не завершилась, то она возвращается в очередь self.ready. Очередь — collections.deque: планировщик работает в одном потоке, и синхронизированная queue.Queue с блокирующим get здесь не нужна. Выполненные задачи удаляет из планировщика функция exit().
Задачу добавляет функция add_task(): она принимает корутину и создаёт с ней задачу в планировщике. Уже созданную задачу ставит в планировщик функция schedule().
Устройство задачи:
import types
from collections.abc import Generator
class Task:
task_id = 0
def __init__(self, target: Generator):
Task.task_id += 1
self.tid = Task.task_id # Task ID
self.target = target # Target coroutine
self.sendval = None # Value to send
self.stack = [] # Call stack
# Run a task until it hits the next yield statement
def run(self):
while True:
try:
result = self.target.send(self.sendval)
if isinstance(result, types.GeneratorType):
self.stack.append(self.target)
self.sendval = None
self.target = result
else:
if not self.stack:
return
self.sendval = result
self.target = self.stack.pop()
except StopIteration:
if not self.stack:
raise
self.sendval = None
self.target = self.stack.pop()
Задача представляет собой обёртку вокруг корутины. У каждой задачи есть свой id, учитываемый в планировщике в словаре task_map. По его заполненности планировщик определяет, остались ли невыполненные задачи.
Задача выполняет корутины методом run(). Пусть имеется корутина, вызывающая другую корутину, а та вызывает третью:
def square(x):
yield x * x
def add(x, y):
yield from square(x + y)
def main():
result = yield add(1, 2)
print(result)
yield
Это несколько изменённый код Бизли из его выступления. Выполним эту цепочку корутин внутри Task.
task = Task(main())
task.run()
9
Аналогично выполняются и остальные корутины, вложенные в цепочку. Остаётся научить планировщик работать с вводом-выводом.
Для этого ему потребуется селектор, обёртка над механизмом операционной системы, способным ожидать событий одновременно на многих файловых дескрипторах, зарегистрированных программой.
import logging
from collections import deque
from collections.abc import Generator
from selectors import DefaultSelector, EVENT_READ, EVENT_WRITE
logger = logging.getLogger(__name__)
class Scheduler:
def __init__(self):
self.ready = deque()
self.selector = DefaultSelector()
self.task_map = {}
def add_task(self, coroutine: Generator) -> int:
new_task = Task(coroutine)
self.task_map[new_task.tid] = new_task
self.schedule(new_task)
return new_task.tid
def exit(self, task: Task):
logger.info('Task %d terminated', task.tid)
del self.task_map[task.tid]
# I/O waiting
def wait_for_read(self, task: Task, fd: int):
try:
key = self.selector.get_key(fd)
except KeyError:
self.selector.register(fd, EVENT_READ, (task, None))
else:
mask, (reader, writer) = key.events, key.data
self.selector.modify(fd, mask | EVENT_READ, (task, writer))
def wait_for_write(self, task: Task, fd: int):
try:
key = self.selector.get_key(fd)
except KeyError:
self.selector.register(fd, EVENT_WRITE, (None, task))
else:
mask, (reader, writer) = key.events, key.data
self.selector.modify(fd, mask | EVENT_WRITE, (reader, task))
def _remove_reader(self, fd: int):
try:
key = self.selector.get_key(fd)
except KeyError:
pass
else:
mask, (reader, writer) = key.events, key.data
mask &= ~EVENT_READ
if not mask:
self.selector.unregister(fd)
else:
self.selector.modify(fd, mask, (None, writer))
def _remove_writer(self, fd: int):
try:
key = self.selector.get_key(fd)
except KeyError:
pass
else:
mask, (reader, writer) = key.events, key.data
mask &= ~EVENT_WRITE
if not mask:
self.selector.unregister(fd)
else:
self.selector.modify(fd, mask, (reader, None))
def io_poll(self, timeout: float | None):
if not self.selector.get_map():
return # ожидающих ввода-вывода нет: блокироваться не на чем
events = self.selector.select(timeout)
for key, mask in events:
fileobj, (reader, writer) = key.fileobj, key.data
if mask & EVENT_READ and reader is not None:
self.schedule(reader)
self._remove_reader(fileobj)
if mask & EVENT_WRITE and writer is not None:
self.schedule(writer)
self._remove_writer(fileobj)
def io_task(self) -> Generator:
while True:
if not self.ready:
self.io_poll(None)
else:
self.io_poll(0)
yield
def schedule(self, task: Task):
self.ready.append(task)
def _run_once(self):
task = self.ready.popleft()
try:
result = task.run()
except StopIteration:
self.exit(task)
return
self.schedule(task)
def event_loop(self):
self.add_task(self.io_task())
while len(self.task_map) > 1: # кроме самой io_task
self._run_once()
Перед стартом цикла событий планировщик создаёт одну особую, бесконечную задачу io_task. Её бесконечный цикл забирает у селектора накопившиеся события и немедленно возвращает управление планировщику. Цикл событий работает, пока кроме io_task остаются другие задачи; сама она никогда не завершается, поэтому условие while self.task_map не остановилось бы никогда.
Если очередь задач пуста, селектор ожидает событий без тайм-аута, до появления новых. В противном случае тайм-аут равен 0, чтобы сразу забрать все события, накопленные операционной системой. Когда ни один дескриптор не зарегистрирован, io_poll сразу возвращается: ожидание без тайм-аута на пустом селекторе заблокировало бы программу навсегда.
Поступившие из селектора события обрабатываются, а отработанные файловые дескрипторы удаляются. Одна и та же задача может ожидать присланных данных и одновременно пытаться записать свои, поэтому в поле data хранится кортеж (reader, writer).
event_loop предоставляет интерфейс для работы с сокетами, четыре метода:
wait_for_read,wait_for_write,_remove_reader,_remove_writer.
Эти методы позволяют работать с циклом событий, встроенным в ОС.
Основным назначением цикла событий является переключение корутин, а обращаются ли те к сети, к диску или ничего не ожидают, для него безразлично.
Остаётся конструкция SystemCall. Цикл событий напоминает работу ОС, и механизм прерываний, передающий управление наверх, заимствован у неё: в асинхронном коде прерывание обеспечивает yield. После переключения контекста может вызываться системная функция, запрошенная корутиной. Например, для создания новых задач:
class SystemCall:
def handle(self, sched: Scheduler, task: Task):
pass
class NewTask(SystemCall):
def __init__(self, target: Generator):
self.target = target
def handle(self, sched: Scheduler, task: Task):
tid = sched.add_task(self.target)
task.sendval = tid
sched.schedule(task)
В Scheduler добавляется фрагмент:
class Scheduler:
...
def _run_once(self):
task = self.ready.get()
try:
result = task.run()
if isinstance(result, SystemCall):
result.handle(self, task)
return
except StopIteration:
self.exit(task)
return
self.schedule(task)
А в Task — условие при выполнении корутин:
class Task:
...
def run(self):
while True:
try:
result = self.target.send(self.sendval)
if isinstance(result, SystemCall):
return result
...
NewTask предоставляет интерфейс для создания новых задач в цикле событий и абстрагирует клиентский код. Это эмуляция защищённой среды ОС, предоставляющей безопасные методы для работы с ядром, чтобы клиентский код не мешал другим программам, запущенным в системе. Аналогичным образом можно реализовать KillTask или WaitTask.
Последней проблемой являются блокирующие операции. Пока запущенная операция не завершится, цикл событий останавливается вместе с ней. Решается это на уровне сокетов: вызов socket.setblocking(False) переводит сокет в неблокирующий режим, и вместо ожидания он немедленно сообщает, что данных пока нет. Ожидать их будет селектор, сразу за всех.
Asyncio
asyncio является основной встроенной библиотекой для асинхронного программирования.
С версии Python 3.5 в языке присутствует синтаксис async/await (PEP 492). Он предоставляет «нативные» корутины — отдельную сущность языка, а не повторно использованный генератор: вызов async def возвращает объект типа coroutine, перебрать который циклом for нельзя, а await допустим только внутри async def. Разделение позволило отличать корутины от генераторов на уровне синтаксиса и типов; в Python 3.6 к ним добавились асинхронные генераторы (PEP 525) и асинхронные включения (PEP 530), а генераторные корутины с декоратором @asyncio.coroutine удалены в Python 3.11.
Простая программа с async/await:
import random
import asyncio
async def func():
r = random.random()
await asyncio.sleep(r)
return r
async def value():
result = await func()
print(result)
if __name__ == '__main__':
asyncio.run(value())
Функция asyncio.run создаёт планировщик задач, устроенный по разобранным выше принципам, и закрывает его по завершении. Переключением между корутинами управляет await.
Основные функции asyncio:
gather(*aws)запускает переданные корутины как задачи и ожидает все, возвращая результаты в порядке аргументов; корутины передаются отдельными аргументами, список — через распаковкуgather(*coros), иначе возникаетTypeError. Выполнение конкурентное: ожидания перекрываются в одном потоке.sleepприостанавливает корутину на определённое количество секунд, отдавая управление циклу событий.wait_for(aw, timeout)ограничивает время ожидания одного объекта и отменяет его по истечении (с Python 3.11 для этого служитasyncio.timeout);waitожидает набор задач по условиюreturn_whenи с Python 3.11 принимает только задачи иFuture, но не корутины.
Основные функции event_loop:
get_event_loopвозвращает цикл событий текущего потока; с Python 3.12 вызов без текущего цикла выдаётDeprecationWarningи создаёт цикл, а если цикл уже снят, например послеasyncio.run, возбуждаетRuntimeError; в 3.14 неявное создание цикла убрано. Внутри корутины цикл получают функциейget_running_loop, а в новом коде вместо связкиget_event_loopиrun_until_completeиспользуется одна строкаasyncio.run(...).run_until_completeвыполняет цикл до завершения переданной корутины илиFuture;asyncio.run(Python 3.7) — точка входа программы: создаёт цикл, выполняет корутину и закрывает цикл.shutdown_asyncgensзакрывает незавершённые асинхронные генераторы вызовомaclose;asyncio.runвызывает его сам, а при ручном управлении циклом о нём часто забывают.call_soonставит обычную функцию (не корутину) в очередь на ближайшую итерацию цикла и не ожидает её выполнения. Поставленная таким образом функция может бесконечно переставлять саму себя.
Ключевым отличием asyncio от предложенной реализации является то, что asyncio работает на функциях обратного вызова, колбэках (callback). Этот механизм распределяет время между задачами справедливее. Каждая корутина встаёт в очередь и дожидается исполнения, тогда как в простом планировщике переключения не произойдёт, пока вся цепочка корутин не выполнится, а остальные задачи, поставленные в очередь, всё это время простаивают. Недостатком колбэков является callback hell, когда после вызова каждой функции необходимо вызвать ещё одну функцию и ещё одну:
func1.add_callback(
func2.add_callback(
func3.add_callback(func4)
)
)
Синтаксис async/await позволяет этого избежать.
await func4()
await func3()
await func2()
await func1()
Это возможно благодаря классу Future, скрывающему колбэки и делающему код линейным. Создавать Future вручную в современном коде почти не приходится: это выполняют create_task и gather.
Задачи, тайм-ауты и группы задач
Корутины выполняются одновременно, только если каждая обёрнута в задачу (Task): последовательные await a() и await b() выполняют их по очереди. Задачи создают gather, create_task и группы задач.
Средство asyncio | Назначение |
|---|---|
run(main()) | цикл событий для программы |
await gather(a, b, c) | одновременное ожидание; результаты в порядке аргументов |
create_task(c) | запуск корутины в фоне; ссылку на задачу сохраняют |
TaskGroup() (Python 3.11) | группа задач; при ошибке одной отменяются остальные |
timeout(s) (Python 3.11) | ограничение времени блока: TimeoutError |
to_thread(f, ...) (Python 3.9) | блокирующая функция в отдельном потоке |
create_task ставит корутину в цикл событий и возвращает объект Task, который можно ожидать позже; ссылку на задачу сохраняют, иначе её может уничтожить сборщик мусора. С Python 3.11 предпочтительна группа задач TaskGroup: задачи, созданные в блоке async with, ожидаются при выходе из блока, а ошибка одной из них отменяет остальные и выходит наружу как ExceptionGroup, которую разбирает конструкция except*. После выхода из блока незавершённых задач не остаётся. Опрос нескольких приборов с отказом одного:
import asyncio
async def poll(name, delay):
await asyncio.sleep(delay)
return name, delay
async def broken(name, delay):
await asyncio.sleep(delay)
raise ConnectionError(f'{name}: нет ответа')
async def survey():
try:
async with asyncio.TaskGroup() as tg:
a = tg.create_task(poll('A', 0.3))
tg.create_task(broken('B', 0.1))
except* ConnectionError as eg:
print('ошибки:', [str(e) for e in eg.exceptions])
print('A отменена:', a.cancelled())
asyncio.run(survey())
ошибки: ['B: нет ответа']
A отменена: True
asyncio.timeout ограничивает время блока: при превышении отменяется текущая задача, а вместе с ней — задачи, которые она ожидает через gather или TaskGroup, и блок завершается TimeoutError.
async def limited():
try:
async with asyncio.timeout(0.6):
return await asyncio.gather(poll('A', 0.3), poll('C', 0.8))
except TimeoutError:
return 'тайм-аут 0,6 с'
asyncio.run(limited()) # 'тайм-аут 0,6 с'
Блокирующую функцию из синхронной библиотеки, которую нельзя ожидать, выполняют в отдельном потоке через asyncio.to_thread, не останавливая цикл событий. Так же поступают с чтением и записью обычных файлов: асинхронного доступа к ним у asyncio нет, и даже сторонние пакеты вроде aiofiles работают через пул потоков. Общее время опроса нескольких приборов с общим тайм-аутом равно времени самого медленного прибора, а не сумме задержек.
Асинхронная итерация
Протокол итерации имеет асинхронный вариант для источников, следующий элемент которых приходится ожидать: сообщений из сети, отсчётов прибора, строк из базы данных.
| Синхронно | Асинхронно |
|---|---|
__iter__, __next__ | __aiter__, __anext__ |
StopIteration | StopAsyncIteration |
for, with | async for, async with |
iter(), next() | aiter(), anext() (Python 3.10) |
def с yield | async def с yield (Python 3.6) |
Асинхронный итерируемый объект определяет __aiter__, асинхронный итератор — __anext__, возвращающий ожидаемый объект, а окончание сообщается исключением StopAsyncIteration. Цикл async for вызывает эти методы и ожидает результат __anext__; если источник при этом ожидает данных, цикл событий тем временем выполняет другие задачи, а источник без await управление не отдаёт. Асинхронный генератор (PEP 525) — функция async def с yield — реализует протокол автоматически, как обычный генератор реализует синхронный.
async def readings(dt, n):
for i in range(n):
await asyncio.sleep(dt)
yield round((i + 1) * dt, 1)
async def consume():
async for t in readings(0.1, 3):
print('отсчёт', t) # отсчёт 0.1, отсчёт 0.2, отсчёт 0.3
asyncio.run(consume())
Поток отсчётов прибора, поступающих с заданным интервалом, описывается асинхронным генератором, а потребитель обрабатывает отсчёты по мере поступления, не блокируя опрос других устройств. Асинхронное включение [x async for x in source] собирает элементы асинхронного источника внутри async def.
Асинхронные фреймворки
Поверх asyncio (а иногда и в обход него) сформировалась экосистема. Физику она необходима, когда вокруг готового расчёта требуется построить сервис: принимать данные с прибора, передавать результаты коллегам, обращаться к базе лаборатории. Ниже приведены три характерных представителя.
Twisted
Один из старейших асинхронных фреймворков, построенный на собственной реализации event-loop.
Основные концепции:
- Protocol, описание получения и отправки данных
- Factory, управление созданием объектов протокола
- Reactor, собственная реализация event-loop
- Deferred-объекты, цепочки обратных вызовов
Пример Deferred-объекта:
from twisted.internet import defer
def toint(data):
return int(data)
def increment_number(data):
return data + 1
def print_result(data):
print(data)
def handleFailure(f):
print("OOPS!")
def get_deferred():
d = defer.Deferred()
return d.addCallbacks(toint, handleFailure)\
.addCallbacks(increment_number, handleFailure)\
.addCallback(print_result)
Aiohttp
Асинхронные HTTP-клиент и сервер, построенные поверх asyncio.
Пример приложения:
import aiohttp
from aiohttp import web
async def get_phrase():
async with aiohttp.ClientSession() as session:
async with session.get('https://fish-text.ru/get',
params={'type': 'title'}) as response:
result = await response.json(content_type='text/html; charset=utf-8')
return result.get('text')
async def index_handler(request):
return web.Response(text=await get_phrase())
async def response_signal(request, response):
response.text = response.text.upper()
return response
async def make_app():
app = web.Application()
app.on_response_prepare.append(response_signal)
app.add_routes([web.get('/', index_handler)])
return app
web.run_app(make_app())
FastAPI
Современный фреймворк для быстрой разработки API, построенный на Starlette и Pydantic.
Простой пример API:
from fastapi import FastAPI
from pydantic import BaseModel, Field
app = FastAPI(title="Простые математические операции")
class Add(BaseModel):
first_number: int = Field(title='Первое слагаемое')
second_number: int = Field(0, title='Второе слагаемое')
class Result(BaseModel):
result: int = Field(title='Результат')
@app.post("/add", response_model=Result)
async def create_item(item: Add):
return {
'result': item.first_number + item.second_number
}
Резюме
Асинхронность не является универсальным ускорителем; это инструмент, предназначенный для задач, в которых программа ожидает. Для расчётов она бесполезна. Одна корутина, надолго занявшая процессор, остановит весь цикл событий вместе с очередью, накопленной к этому моменту: поток по-прежнему один.
Выбор инструмента определяется следующим образом:
- задача ожидает сеть или прибор — применяется асинхронность, выигрыш может составлять десятки раз; чтение и запись файлов выносятся в поток через
asyncio.to_thread, поскольку асинхронного доступа к обычным файлам уasyncioнет; - задача вычисляет — применяются процессы (
multiprocessing), векторизация NumPy или компиляция, разобранные в предыдущих главах; - и то и другое — применяется цикл событий для ожиданий в сочетании с пулом процессов для расчётов через
loop.run_in_executor.
В асинхронном коде не должно быть блокирующих вызовов. Одна time.sleep() или синхронный запрос к базе останавливает не свою корутину, а всю программу.
CUDA и вычисления на GPU
В главе «Скорость выполнения программ» рассматривалось ускорение умножения матриц на CPU: перестановка циклов, компиляция кода через Numba и Cython и, в завершение, вызов NumPy, давший микросекунды вместо десятков миллисекунд, затраченных наивным циклом. В главе про GIL было установлено, что потоки в обычной сборке CPython упираются в глобальную блокировку, а процессы и свободнопоточная сборка ограничены числом ядер: процессов, занятых вычислениями, имеет смысл держать столько, сколько ядер, то есть восемь-шестнадцать. Это предел CPU.
В той же машине установлена видеокарта. У современного GPU тысячи ядер, а пиковая производительность составляет десятки терафлопс против единиц у процессора. Если задача сводится к одной операции, повторяющейся над миллионами чисел (а в физике это почти всегда так), GPU даёт ускорение в 10–100 раз. Настоящая глава посвящена тому, как получить это ускорение из Python.
Видеокарты на машине, где выполнялись листинги книги, нет. Листинги CuPy и ядра Numba записаны для видеокарты; ядро в симуляторе CUDA и пример с дрейфом частиц, в котором вместо CuPy импортирован NumPy, выполнены на процессоре той же виртуальной машины под Python 3.12 с Numba 0.68 и NumPy 2.5, и их выводы приведены по этому прогону.
Слайды к главе. Устройство видеокарты, модель CUDA, ядро Numba в симуляторе и пример с дрейфом изложены также в седьмой части лекции «Оптимизация и параллельные вычисления» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Назначение видеокарты в расчётах
GPU был создан для игр: необходимо независимо вычислить цвет каждого из миллионов пикселей 60 раз в секунду. Схема «одна формула на миллионах независимых элементов» встречается не только в пикселях:
- Моделирование частиц. Метод частиц в ячейках (PIC), молекулярная динамика, трекинг пучка в ускорителе оперируют миллионами частиц, и каждая на каждом шаге движется по уравнениям, одинаковым для всех.
- Сеточные задачи. Уравнения теплопроводности, Пуассона, Максвелла, Навье–Стокса, решаемые на разностных сетках: значение в каждом узле пересчитывается по шаблону, определяемому разностной схемой.
- Обработка данных детекторов. Реконструкция треков, фильтрация изображений, томография сводятся к конвейерам, выполняющим однотипные операции над массивами, снятыми с детектора. Триггерные фермы, установленные на LHC, давно вычисляют на GPU.
- Монте-Карло. Транспорт излучения, генерация событий: миллионы независимых историй, разыгранных по одному алгоритму.
- Нейросети. Обучение сводится к миллиардам умножений матриц; без GPU глубокое обучение не состоялось бы.
Общим для этих задач является массовый параллелизм данных. Много элементов, над каждым выполняется одинаковая и относительно простая работа, и элементы друг от друга почти не зависят. Под этот профиль GPU и предназначен.
Чем GPU отличается от CPU
CPU оптимизирован под латентность, то есть под выполнение одной цепочки инструкций за минимальное время. Ради этого в ядре предусмотрены предсказатель переходов, внеочередное исполнение и большие кеши. GPU оптимизирован под пропускную способность, то есть под выполнение максимального объёма работы в секунду, пусть каждая операция, взятая отдельно, и потребует больше времени. Ядра простые, зато их тысячи.
| CPU | GPU | |
|---|---|---|
| Ядер | 4–64 сложных | тысячи простых (у RTX 4090 их 16 384) |
| Частота | 3–5 ГГц | 1–2,5 ГГц |
| Логика ядра | предсказание переходов, внеочередное исполнение | максимально простая |
| Скрытие задержек памяти | большие кеши | тысячи нитей: пока одни ждут память, считают другие |
| Полоса памяти | ~50–100 ГБ/с (DDR5) | от сотен ГБ/с до единиц ТБ/с (GDDR6X, HBM) |
| Оптимизирован под | латентность одной задачи | суммарную пропускную способность |
| Идеальная нагрузка | ветвистая, последовательная | однотипная над большими массивами |
SIMT и warp
Ядра GPU не полностью независимы. Нити (threads) исполняются группами по 32, и группа называется warp. Все нити warp'а в каждый момент выполняют одну и ту же инструкцию над разными данными. Модель называется SIMT (Single Instruction, Multiple Threads). От SIMD, где одна инструкция применяется к вектору данных, она отличается тем, что нить здесь является самостоятельным потоком управления и может перейти по собственной ветке; отсюда возникает дивергенция, о которой сказано ниже.
Если внутри warp'а код ветвится (if), и часть нитей перешла по одной ветке, а часть по другой, GPU выполнит обе ветки по очереди, отключая нити, не принадлежащие текущей ветке. Это называется дивергенцией warp'а. Ветвление, одинаковое для всех нитей warp'а, дивергенции не вызывает, но сильно ветвящийся код, в котором соседние нити идут разными путями, ускоряется плохо; хорошей GPU-программой является та, в которой 32 соседние нити выполняют одно и то же.
Иерархия памяти
Память GPU устроена ступенями, и разница между ними составляет порядки:
- Регистры, отведённые каждой нити отдельно, доступ за ~1 такт. Локальные переменные, объявленные в ядре-функции (kernel, определение ниже), размещаются здесь.
- Разделяемая память (shared memory), общая для блока нитей, около 100 КБ, приходящихся на мультипроцессор, доступ за ~10–30 тактов. Это кеш, управляемый вручную: сюда заранее загружается фрагмент данных, читаемый блоком многократно.
- Глобальная память, гигабайты, установленные на видеокарте. Видна всем нитям, полоса огромная (сотни ГБ/с), но латентность достигает сотен тактов.
GPU скрывает латентность глобальной памяти не кешами, как CPU, а числом запущенных нитей. Пока один warp ожидает данные из памяти, мультипроцессор исполняет другие. Поэтому нитей запускается существенно больше, чем физических ядер: десятки тысяч и миллионы здесь являются нормой.
Полосу глобальной памяти определяет и порядок обращений. Обращения нитей одного warp'а к глобальной памяти объединяются (coalescing) в минимальное число 32-байтных транзакций: 32 соседним четырёхбайтным числам достаточно четырёх транзакций, а при чтении с большим шагом каждой нити требуется собственная транзакция, и полоса расходуется впустую. Поэтому данные располагают так, чтобы соседние нити обращались к соседним элементам массива.
Модель CUDA
CUDA является платформой NVIDIA для вычислений общего назначения на GPU. Её терминология используется во всех инструментах для GPU.
- Host объединяет CPU и оперативную память, а Device объединяет GPU и его память. У них разные адресные пространства; данные из одного необходимо явно копировать в другой.
- Ядром (kernel) называется функция, которую host отправляет на исполнение в device. Она исполняется одновременно тысячами нитей, и каждая нить выполняет один и тот же код, но обрабатывает свой элемент данных.
- Нити организованы в двухуровневую иерархию: сетка (grid) → блоки (blocks) → нити (threads).
Grid (сетка — весь запуск ядра)
├── Block 0 ── [нить 0][нить 1] ... [нить 255]
├── Block 1 ── [нить 0][нить 1] ... [нить 255]
├── Block 2 ── [нить 0][нить 1] ... [нить 255]
└── ...
глобальный индекс нити = blockIdx.x * blockDim.x + threadIdx.x
Блок целиком попадает на один мультипроцессор, поэтому его нити могут взаимодействовать через разделяемую память и синхронизироваться между собой. Блоки же друг о друге ничего не знают, и планировщик распределяет блоки по свободным мультипроцессорам произвольным образом. Поэтому одна и та же программа масштабируется и на видеокарту ноутбука с 20 мультипроцессорами, и на серверную со 130.
Внутри ядра нить в первую очередь определяет свой индекс. У неё есть номер блока blockIdx, размер блока blockDim и номер внутри блока threadIdx. Глобальный индекс собирается из этих трёх чисел, которые предоставляет среда исполнения.
i = blockIdx.x * blockDim.x + threadIdx.x
Например, нить номер 5 в блоке номер 3 при блоках по 256 нитей получит i = 3 * 256 + 5 = 773 и будет обрабатывать 773-й элемент. Цикл for i in range(n), привычный по CPU-коду, на GPU исчезает: вместо него запускается n нитей, и каждая выполняет одну итерацию.
Главное правило: данные должны жить на GPU
У GPU собственная память, и соединена она с host'ом шиной PCIe, полоса которой составляет 16–64 ГБ/с в зависимости от поколения (x16, с третьего по пятое). Полоса памяти самого GPU — от сотен гигабайт до нескольких терабайт в секунду: в руководстве NVIDIA по оптимизации приведены 16 ГБ/с у PCIe x16 третьего поколения против 898 ГБ/с у памяти Tesla V100. Копирование массива host → device часто обходится дороже всех вычислений над ним. Насколько дороже, определяется количеством арифметики, приходящейся на каждый переданный байт.
Оценим это на гигабайте данных, размещённом на host'е. Пересылка через PCIe третьего поколения займёт около 60 мс. Поэлементная операция вида \(y = 2x\) прочитает и запишет два гигабайта по внутренней полосе GPU и завершится примерно за 2 мс. Вычисление примерно в тридцать раз дешевле пересылки, и передавать массив туда и обратно ради одной такой операции бессмысленно. Умножение матриц представляет собой противоположный случай. Гигабайт float32 — это матрица \(16384 \times 16384\), её умножение требует \(2n^3 \approx 8{,}8 \cdot 10^{12}\) операций с плавающей точкой и при производительности около десяти терафлопс занимает около секунды, тогда как пересылка обеих матриц и результата — около 0,2 с.
Таким образом, разница определяется отношением работы к данным: умножение матриц выполняет \(O(n^3)\) работы над \(O(n^2)\) данных, а поэлементная операция — \(O(n)\) работы над \(O(n)\) данных. Чем выше это отношение, тем меньшую долю времени занимает копирование в начале расчёта.
Отсюда вытекает типичная ошибка:
плохо: [CPU: данные] → GPU → шаг → [CPU] → GPU → шаг → [CPU] → ...
хорошо: [CPU: данные] → GPU → шаг → шаг → шаг → ... → [CPU: результат]
Правильная схема: скопировать входные данные на устройство один раз, выполнить там всю цепочку вычислений (все шаги по времени, все итерации) и забрать назад только результат, а лучше диагностику, вычисленную непосредственно на карте: энергию, спектр, изображение. Если в цикле по шагам присутствует копирование туда и обратно, ускорения не будет.
CuPy: NumPy на видеокарте
Самым коротким путём к GPU из Python является CuPy. Это реализация интерфейса NumPy поверх CUDA, предоставляющая те же ndarray, sum, dot, fft, linalg, только массивы размещаются в памяти видеокарты, а операции над ними выполняет GPU.
import cupy as cp
x = cp.arange(10**7, dtype=cp.float32) # массив рождается сразу в памяти GPU
y = cp.sin(x) ** 2 + cp.cos(x) ** 2 # считает GPU, host только раздаёт команды
s = y.sum() # редукция тоже на GPU, результат — 0-мерный массив
y_host = cp.asnumpy(y) # явное копирование device → host (в NumPy-массив)
x_gpu = cp.asarray(y_host) # и обратно, host → device
Разработчик, владеющий векторизованным NumPy-кодом, уже владеет программированием GPU. В большинстве скриптов достаточно заменить import numpy as np на import cupy as cp.
Проверим это на умножении матриц.
import numpy as np
import cupy as cp
from time import perf_counter
n = 4096
A = np.random.rand(n, n).astype(np.float32)
B = np.random.rand(n, n).astype(np.float32)
# --- CPU ---
t0 = perf_counter()
C = A @ B
t_cpu = perf_counter() - t0
# --- GPU ---
A_gpu = cp.asarray(A) # копируем данные на видеокарту один раз
B_gpu = cp.asarray(B)
C_gpu = A_gpu @ B_gpu # прогрев: первый вызов инициализирует cuBLAS
cp.cuda.Stream.null.synchronize()
t0 = perf_counter()
C_gpu = A_gpu @ B_gpu
cp.cuda.Stream.null.synchronize() # дожидаемся, пока GPU реально досчитает
t_gpu = perf_counter() - t0
print(f"CPU: {t_cpu:.3f} c, GPU: {t_gpu:.4f} c, ускорение x{t_cpu / t_gpu:.0f}")
На бесплатной T4, предоставляемой в Colab, это даёт ускорение в один-два порядка относительно NumPy, притом что сам NumPy уже упирается в предел процессора. Умножение матриц float32 CuPy передаёт готовой библиотеке NVIDIA cuBLAS, поэтому первый вызов создаёт её контекст.
Два замечания относительно замеров на карте:
- Запуск ядер асинхронный. Вызов
A_gpu @ B_gpuставит работу в очередь GPU и возвращается немедленно. Если измерить время безcp.cuda.Stream.null.synchronize(), получатся микросекунды — время постановки в очередь, а не вычислений. Синхронизация происходит и неявно, при копировании результата на host или вызовеfloat(s), поэтому обычный код работает корректно; в бенчмарках синхронизация выполняется явно. - Первый вызов уходит на прогрев. При первом обращении CuPy компилирует поэлементные ядра и редукции под конкретную видеокарту, на что уходят доли секунды, а такие библиотеки, как cuBLAS, создают свой контекст. Замер выполняется со второго раза (как и у Numba).
Оба условия обеспечивает функция cupyx.profiler.benchmark: перед замером она выполняет прогрев, по умолчанию десять вызовов, и учитывает время работы GPU, синхронизируя потоки выполнения CUDA.
Функция cp.get_array_module(x) возвращает numpy или cupy в зависимости от того, где размещён массив x, и позволяет писать библиотечные функции, одинаково работающие и на CPU, и на GPU.
Numba CUDA: собственное ядро
CuPy покрывает всё, что выражается операциями над целыми массивами. Иногда алгоритм в них не укладывается: нестандартная поэлементная логика или собственный обход данных. В главе «Скорость выполнения программ» в такой ситуации применялся декоратор @numba.njit к функции с циклами. У Numba есть и второй бэкенд: декоратор @cuda.jit компилирует Python-функцию в CUDA-ядро.
Начиная с Numba 0.61 встроенный numba.cuda объявлен устаревшим, и поддержка CUDA перешла в пакет NVIDIA numba-cuda. В 2026 году numba-cuda переведён в режим сопровождения: до конца жизни CUDA 13 в нём исправляются только уязвимости и критические ошибки, а новые возможности NVIDIA развивает в пакете numba-cuda-mlir, совместимом с ядрами numba-cuda. Для большинства программ переход сводится к замене импорта from numba import cuda на from numba_cuda_mlir import cuda; код, использующий API расширения Numba, требует переработки, поскольку numba-cuda-mlir порождает код через MLIR, а не через LLVM IR. Пакет устанавливается командой pip install "numba-cuda-mlir[cu13]" (для CUDA 12 — [cu12]) и работает с видеокартами вычислительной способности не ниже 7.0. Примеры главы используют from numba import cuda, который предоставляют и встроенная цель Numba, и numba-cuda.
Каноническим примером является сложение векторов.
import numpy as np
from numba import cuda
@cuda.jit
def add_kernel(a, b, out):
i = cuda.grid(1) # глобальный индекс нити в одномерной сетке
if i < out.size: # нитей запущено чуть больше, чем элементов
out[i] = a[i] + b[i] # каждая нить обрабатывает ровно один элемент
n = 10_000_000
a = np.random.rand(n).astype(np.float32)
b = np.random.rand(n).astype(np.float32)
# явно переносим данные на device и заводим там массив под результат
d_a = cuda.to_device(a)
d_b = cuda.to_device(b)
d_out = cuda.device_array_like(d_a)
# конфигурация запуска: сколько нитей в блоке и сколько блоков в сетке
threads_per_block = 256
blocks_per_grid = (n + threads_per_block - 1) // threads_per_block # округление вверх
add_kernel[blocks_per_grid, threads_per_block](d_a, d_b, d_out)
cuda.synchronize() # дожидаемся завершения (запуск, как всегда, асинхронный)
out = d_out.copy_to_host() # забираем результат на CPU
Разберём по шагам:
- Тело ядра содержит код одной нити. Циклов по элементам нет: параллелизм создаётся миллионами запущенных нитей.
cuda.grid(1)является сокращением дляcuda.blockIdx.x * cuda.blockDim.x + cuda.threadIdx.x, формулы глобального индекса. - Проверка
if i < out.sizeобязательна. Число запущенных нитей кратно размеру блока, поэтому дляn = 10^7при блоках по 256 запустится 39 063 блока, то есть 10 000 128 нитей, на 128 больше, чем элементов. Лишние нити без проверки обратились бы за границу массива. threads_per_blockобычно выбирается в диапазоне 128–512 (максимум 1024, предпочтительно кратно 32, размеру warp'а). Точное значение подбирается замерами; для начала 256 является хорошим выбором.blocks_per_gridвычисляется из размера задачи: классическая формула округления вверх(n + tpb - 1) // tpb.- Конфигурация в квадратных скобках
kernel[blocks, threads](...)сообщает CUDA через Numba, сколько нитей запустить. - Ядро ничего не возвращает, а способно только записывать в переданные ему массивы, поэтому
d_outсоздаётся заранее.
Если передать в ядро обычные NumPy-массивы, Numba скопирует их на GPU и обратно самостоятельно, что удобно для первых проб, но в цикле по шагам приводит к той же ошибке с копированием. Явные cuda.to_device / copy_to_host позволяют контролировать трафик через PCIe. Ядра Numba принимают и массивы CuPy.
Внутри @cuda.jit-функции доступно ограниченное подмножество Python: числа, арифметика, циклы, условия, обращение к массивам, математика из math. Списки, словари и создание массивов недоступны, как и в nopython-режиме обычной Numba, только ограничения строже.
Симулятор CUDA
Проверить формулу индекса и логику ядра без видеокарты позволяет симулятор CUDA, входящий в Numba. Он включается переменной окружения NUMBA_ENABLE_CUDASIM=1, заданной до импорта Numba. Ядро в симуляторе выполняет на процессоре интерпретатор Python: блоки — по одному, а нити блока — отдельными потоками. Внутри такого ядра допустимы print и отладчик pdb, а обращение за границу массива возбуждает исключение IndexError с номерами нити и блока, тогда как на видеокарте такая ошибка может остаться незамеченной. Операции уровня warp симулятор не поддерживает, типы аргументов и переменных не проверяет, поэтому в нём отлаживают ядро, которое уже компилируется для видеокарты; о скорости вычислений на видеокарте симулятор ничего не говорит.
Рассмотрим ядро сложения векторов, в котором каждая нить дополнительно записывает номер своего блока и свой номер в блоке; элементов 10, нитей в блоке 4.
# kernel.py
import numpy as np
from numba import cuda
@cuda.jit
def add_kernel(a, b, out, block, thread):
i = cuda.grid(1)
if i < out.size:
out[i] = a[i] + b[i]
block[i], thread[i] = cuda.blockIdx.x, cuda.threadIdx.x # кто обработал элемент
n, tpb = 10, 4
bpg = (n + tpb - 1) // tpb
a = np.arange(n, dtype=np.float32)
b = np.full(n, 10, dtype=np.float32)
out = np.zeros(n, dtype=np.float32)
block, thread = np.zeros(n, np.int32), np.zeros(n, np.int32)
add_kernel[bpg, tpb](a, b, out, block, thread)
print("блоков:", bpg, "| нитей:", bpg * tpb)
print("i ", *range(n))
print("блок ", *block)
print("нить ", *thread)
print("out ", *out.astype(int))
python3 -c "from numba import cuda; print(cuda.is_available())"
NUMBA_ENABLE_CUDASIM=1 python3 kernel.py
False
блоков: 3 | нитей: 12
i 0 1 2 3 4 5 6 7 8 9
блок 0 0 0 0 1 1 1 1 2 2
нить 0 1 2 3 0 1 2 3 0 1
out 10 11 12 13 14 15 16 17 18 19
На машине без видеокарты cuda.is_available() возвращает False, и запуск ядра без симулятора завершается ошибкой CudaSupportError. В симуляторе ядро отрабатывает, и таблица подтверждает формулу индекса: элемент 9 обрабатывает нить 1 блока 2, \(2 \cdot 4 + 1 = 9\), а нити 2 и 3 последнего блока не проходят проверку i < out.size и простаивают. Массивы NumPy здесь переданы в ядро напрямую: для такой проверки это допустимо, хотя в расчёте данные, как сказано выше, переносят на устройство явно.
Двумерные сетки
Сетки и блоки бывают не только одномерными. Для матриц, изображений с детекторов и разностных сеток удобны двумерные: нить получает пару индексов и обрабатывает свой узел. Ядро, вычисляющее дискретный лапласиан для уравнений теплопроводности и Пуассона:
@cuda.jit
def laplace_kernel(u, out):
j, i = cuda.grid(2) # x — столбец: соседние нити читают соседние адреса
if 0 < i < u.shape[0] - 1 and 0 < j < u.shape[1] - 1: # только внутренние узлы
out[i, j] = (u[i + 1, j] + u[i - 1, j] +
u[i, j + 1] + u[i, j - 1] - 4 * u[i, j])
threads_2d = (16, 16) # блок 16x16 = 256 нитей
blocks_2d = ((ny + 15) // 16, (nx + 15) // 16) # по x — ny столбцов, по y — nx строк
laplace_kernel[blocks_2d, threads_2d](d_u, d_lap)
Порядок индексов выбран не случайно: нити warp'а идут подряд по координате x, которую cuda.grid(2) возвращает первой, а в массиве NumPy подряд лежат элементы одной строки. Поэтому столбец берётся из x, и соседние нити читают соседние адреса. Каждая нить читает пять соседних узлов и записывает один, а GPU повторяет это для всех узлов сетки. Явная разностная схема для двумерной теплопроводности отсюда получается в один шаг: u += alpha * dt / h**2 * lap.
Пример из физики: дрейф частиц в скрещенных полях
Рассмотрим облако из пяти миллионов электронов в скрещенных полях \( \vec{E} = (E_0, 0, 0) \) и \( \vec{B} = (0, 0, B_0) \) и проинтегрируем их движение схемой Бориса, стандартной в вычислительной физике плазмы (родственная ей схема применялась в примере REDPIC). Согласно теории, помимо ларморовского вращения облако как целое дрейфует поперёк обоих полей со скоростью \( E_0 / B_0 \), не зависящей ни от заряда, ни от массы.
Число шагов выбрано так, чтобы расчёт длился целое число ларморовских периодов: период электрона в поле 10 мТл составляет \(T_c = 2\pi m / (|q| B_0) \approx 3{,}57\) нс, и шесть периодов при шаге 10 пс дают 2144 шага. Облако начинает движение со средней скоростью, равной нулю, поэтому его центр движется по циклоиде, и средняя скорость совпадает со скоростью дрейфа только за целое число периодов. При 2000 шагах, то есть 5,6 периода, тот же расчёт дал скорость \(-1{,}017 \cdot 10^5\) м/с, по модулю на 1,7 % больше теоретической, а при 2144 шагах расхождение составляет 0,02 %.
import cupy as cp # с "import numpy as cp" тот же код считает на CPU
# --- параметры задачи (СИ) ---
q, m = -1.602e-19, 9.109e-31 # заряд и масса электрона
E0, B0 = 1e3, 1e-2 # поля: В/м и Тл
dt, n_steps = 1e-11, 2144 # шаг 10 пс; 21,4 нс — шесть ларморовских периодов по 3,57 нс
N = 5_000_000 # пять миллионов частиц
# --- начальное состояние: облако ~1 мм с тепловым разбросом скоростей ---
# все массивы создаются сразу в памяти GPU и живут там до конца расчёта
rng = cp.random.default_rng(42)
x = rng.standard_normal(N, dtype=cp.float32) * 1e-3 # м
y = rng.standard_normal(N, dtype=cp.float32) * 1e-3
vx = rng.standard_normal(N, dtype=cp.float32) * 1e5 # м/с
vy = rng.standard_normal(N, dtype=cp.float32) * 1e5
y0 = float(y.mean()) # начальный центр облака
# --- константы схемы Бориса: обычные числа, считаются один раз на CPU ---
h = q * dt / (2 * m) # q·dt/2m
t = h * B0 # tan(θ/2) поворота в магнитном поле за шаг
s = 2 * t / (1 + t * t)
for step in range(n_steps):
vx += h * E0 # полшага разгона электрическим полем
px = vx + vy * t # поворот скорости вокруг B:
py = vy - vx * t # промежуточный вектор v'
vx, vy = vx + py * s, vy - px * s # поворот на угол θ ≈ ω_c·dt без изменения модуля скорости
vx += h * E0 # ещё полшага разгона
x += vx * dt # сдвигаем частицы
y += vy * dt
# --- диагностика: на host уходят только два числа, не массивы ---
v_drift = (float(y.mean()) - y0) / (n_steps * dt) # float() неявно синхронизирует GPU
energy = float(0.5 * m * (vx**2 + vy**2).mean())
print(f"скорость дрейфа: {v_drift:.3e} м/с (теория: {-E0 / B0:.3e})")
print(f"средняя кинетическая энергия: {energy:.3e} Дж")
скорость дрейфа: -9.998e+04 м/с (теория: -1.000e+05)
средняя кинетическая энергия: 9.105e-21 Дж
Вывод получен на процессоре: в листинге вместо CuPy импортирован NumPy, и расчёт занял 17 с. Генератор случайных чисел CuPy выдаёт другую последовательность, поэтому на видеокарте последние знаки будут иными. Скорость дрейфа отличается от теоретической на 0,02 %, а средняя кинетическая энергия совпадает с начальной энергией теплового движения \( m\sigma^2 \approx 9{,}11 \cdot 10^{-21} \) Дж, где \( \sigma = 10^5 \) м/с — разброс каждой компоненты скорости: за целое число ларморовских периодов скорость каждой частицы возвращается к начальной.
Четыре существенных момента:
- Данные создаются на GPU (
cp.random) и не покидают его все 2144 шага. На host передаются два числа диагностики, вычисленные там же; только в этот момент host дожидается GPU. - Физика умещается в несколько строк массивных операций. Каждая арифметическая операция над массивами выполняется отдельным CUDA-ядром над пятью миллионами элементов, строка цикла — одним–четырьмя ядрами. Сам цикл по шагам остаётся на CPU: 2144 итерации дёшевы, дорогая работа выполняется внутри.
- Тот же код работает на CPU. Замена первой строки даёт NumPy-версию, пригодную для отладки на ноутбуке без видеокарты. На GPU она выполняется в десятки раз быстрее.
- float32. Для такой задачи одинарной точности достаточно, а на игровых и облачных картах она в десятки раз быстрее двойной (об этом сказано ниже).
Заготовку можно развивать: неоднородные поля (поле зависит от координаты частицы, но это по-прежнему поэлементные операции), потери и рождение частиц (маски), самосогласованное поле (гистограмма зарядов + Пуассон через cp.fft). Всё это остаётся в рамках CuPy.
Границы применимости GPU
Ситуации, в которых GPU бесполезен или вреден:
- Малые данные. Запуск ядра занимает ~5–10 микросекунд, а копирование через PCIe обходится ещё дороже. Если работы меньше чем на миллисекунду, накладные расходы поглотят выигрыш. Массивы из тысячи элементов NumPy сложит быстрее.
- Ветвистая логика. Из-за дивергенции warp'ов код, в котором каждый элемент обрабатывается по-своему (деревья решений, разбор текста, сложные
if-каскады), параллелится плохо. - Последовательные зависимости. Если шаг
i+1невозможно начать без результата шагаi, а внутри шага работы мало, параллелить нечего. Одна частица на миллиард шагов остаётся задачей для CPU и Numba. Однако миллион независимых траекторий по миллиарду шагов является идеальной задачей для GPU; в физике часто распараллеливают по ансамблю или по параметрам, а не по времени. - Двойная точность на игровых картах. GeForce вычисляет float64 в 32–64 раза медленнее float32, так как блоки FP64 там почти отсутствуют. Полноценный FP64 (половина от FP32) присутствует только у вычислительных карт наподобие A100/H100. Если задаче (небесная механика, длинное интегрирование, плохо обусловленная алгебра) требуется двойная точность, её необходимо измерить отдельно.
- Задачи про ожидание, а не про вычисления. Если программа ожидает сеть или диск, имеет смысл обратиться к главе про асинхронность; GPU не поможет.
Прежде чем переписывать на GPU, необходимо выполнить профилирование (см. главу про профилирование) и оценить арифметическую интенсивность, то есть число операций, приходящихся на каждый байт данных. Умножение матриц подходит отлично, а поэлементное сложение уже упирается в память, а не в вычислители.
Работа без собственной видеокарты
Логику ядер Numba проверяет на процессоре симулятор CUDA, а код на CuPy — замена CuPy на NumPy, как в примере с дрейфом; скорость видеокарты, однако, измеряется только на видеокарте. Бесплатный GPU предоставляется в Google Colab:
- Создаётся новый блокнот (это обычный Jupyter в облаке).
- В меню Среда выполнения → Сменить среду выполнения (Runtime → Change runtime type) выбирается T4 GPU и сохраняется.
- Проверяется наличие карты.
!nvidia-smi
Команда покажет модель GPU (обычно Tesla T4 с 16 ГБ памяти), версию драйвера и загрузку. CuPy, Numba и PyTorch в Colab уже установлены, и все примеры главы запускаются там без pip install. На бесплатном тарифе сессия живёт несколько часов и при простое отключается; для учёбы и прототипов этого достаточно. Похожий бесплатный GPU предоставляют Kaggle Notebooks, а для серьёзных расчётов у института, скорее всего, есть кластер с вычислительными картами, о котором целесообразно узнать у научного руководителя. Карту на таком кластере запрашивают у планировщика (sbatch --gres=gpu:1), а расчёт в образе Apptainer получает доступ к драйверу хоста ключом --nv; работа с кластером рассмотрена в главе «Кластеры и воспроизводимое окружение для расчётов».
Экосистема: не CUDA единой
Писать ядра вручную требуется редко. Вокруг CUDA сформировался слой библиотек. PyTorch и JAX предоставляют NumPy на видеокарте в сочетании с автоматическим дифференцированием и JIT-компиляцией. Физики используют их как вычислительный бэкенд, не только для нейросетей. Перенос тензора на карту умещается в одно .to("cuda"), а jax.jit и jax.vmap компилируют и векторизуют целые модели. Библиотеки RAPIDS (cuDF, cuML) переносят на GPU pandas и scikit-learn, когда узким местом является не физика, а обработка таблиц с установки. В основе всех этих библиотек лежат те же ядра, сетки и блоки, поэтому модель CUDA пригодится в любой из них. Если пределы Python окажутся достигнуты, остаётся CUDA C++ с теми же концепциями.
Итог: лестница ускорения
Материал раздела про ускорение программ сводится к лестнице ускорения. Когда код работает медленно, достаточно пройти по ступеням сверху вниз и остановиться, как только скорость стала достаточной:
- Профилирование. Пока
line_profilerне показал, куда уходит время, оптимизация на глаз является гаданием. - Проверка алгоритма. Никакое аппаратное обеспечение не компенсирует \( O(n^2) \) там, где существует \( O(n \log n) \).
- Векторизация. NumPy вместо циклов обычно даёт первый и самый дешёвый порядок ускорения.
- Компиляция. Numba или Cython — для логики, не уложившейся в массивные операции.
- Распараллеливание на CPU. Процессы или свободнопоточная сборка Python 3.14 — для вычислений на чистом Python, потоки — для кода, освобождающего GIL (NumPy, Numba с
nogil=True), и для ожидания; асинхронность — когда одновременных ожиданий тысячи. - Перенос на GPU. Однотипная работа над большими массивами — CuPy, собственная поэлементная логика — ядра Numba CUDA (numba-cuda или numba-cuda-mlir). Два правила: данные живут на GPU, замеры — с явной синхронизацией.
- Кластер. Независимые расчёты — массивом задач планировщика, связанные — процессами MPI, окружение — в образе Apptainer; этой ступени посвящена следующая глава, «Кластеры и воспроизводимое окружение для расчётов».
Тот же векторизованный стиль, ускоривший в начале раздела код на CPU, почти без изменений переносится на видеокарту.
Полезные ссылки
- CUDA C++ Programming Guide, первоисточник: модель исполнения, иерархия памяти, все детали.
- Документация CuPy, включая таблицу соответствия функций NumPy ↔ CuPy и советы по производительности.
- Документация numba-cuda, справочник по
@cuda.jit: ядра, разделяемая память, атомарные операции, симулятор. - numba-cuda-mlir, преемник numba-cuda: установка и руководство по переходу.
- NVIDIA Deep Learning Institute, курс «Fundamentals of Accelerated Computing with CUDA Python» про Numba и CuPy.
Кластеры и воспроизводимое окружение для расчётов
Глава «CUDA и вычисления на GPU» подводит итог разделу лестницей ускорения. Её первые ступени — профилирование, проверка алгоритма, векторизация, компиляция, распараллеливание на процессоре и перенос на видеокарту — используют ресурсы одной машины всё полнее, а последней ступени, кластеру, посвящена настоящая глава. Расчёт, которому одной машины недостаточно, переносится на вычислительный кластер — набор машин с общей файловой системой и быстрой сетью, ресурсы которого распределяет планировщик. Типичных случаев два. В первом расчёт состоит из сотен независимых частей: скан параметров магнитной оптики, серия Монте-Карло детектора с разными зёрнами, обработка тысяч файлов с установки. Во втором один расчёт настолько велик, что его приходится делить между процессами на разных узлах, и процессы обмениваются данными на каждом шаге: задачи электродинамики, расчёт пучка с пространственным зарядом, решение уравнения Пуассона на большой сетке.
Перенос на кластер ставит ещё две задачи, о которых на рабочем компьютере задумываться не приходится. Окружение расчёта — версии Python, NumPy и системных библиотек — на узлах кластера иное, и результат, полученный на рабочем компьютере, должен воспроизводиться там без изменений. Машины, на которых выполняются расчёты, — узлы кластера, стенды, компьютеры сбора данных — необходимо настраивать одинаково и повторяемо, иначе через год никто не скажет, чем одна машина отличается от другой.
В настоящей главе рассматриваются планировщик Slurm и устройство кластера, массивы задач для независимых расчётов, библиотека MPI и её привязка к Python mpi4py для связанных расчётов, контейнеры Apptainer для воспроизводимого окружения и система управления конфигурацией Ansible; в завершение кратко описаны Kubernetes и Terraform и пределы их применимости к физическим расчётам. Сквозным примером служат расчёты ускорительной лаборатории: скан токов квадрупольного дублета, Монте-Карло эффективности сцинтилляционного счётчика и расчёт электростатического потенциала в камере. Листинги на Python выполнены на macOS под Python 3.12 с NumPy 2.5.3, mpi4py 4.1.2 и Open MPI 5.0.11 из колеса PyPI. Демонстрации лекции «Кластеры и воспроизводимое окружение для расчётов» записаны на виртуальной машине с Ubuntu 24.04 (процессор ARM64, два ядра), на которой развёрнут одноузловой учебный кластер, далее называемый стендом: Slurm 23.11.4, Open MPI 4.1.6 из пакетов Ubuntu, NumPy 2.5.3 и mpi4py 4.1.2 в окружении Python 3.12.3, Apptainer 1.5.4 и ansible-core 2.21.4. На стенде выполнены пакетные скрипты, команды Slurm и Apptainer и плейбуки главы, а числа со ссылкой на демонстрацию к лекции взяты из этих записей.
Слайды к главе. Планировщик и Slurm, массивы задач, MPI из Python, образы Apptainer, Ansible, Kubernetes и Terraform изложены также в лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Вычислительный кластер и планировщик
Слайды к главе. Устройство кластера, планировщик и очередь, резервирование и заполнение промежутков изложены также в первой части лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Устройство кластера
Вычислительный кластер состоит из машин нескольких назначений. Узел входа (login node) является точкой подключения пользователей по ssh: на нём редактируют программы, собирают их и ставят задачи в очередь, но не считают. Вычислительные узлы выполняют задачи; на крупных кластерах их сотни и тысячи, часть из них оснащена видеокартами. На управляющем узле работает планировщик: он принимает задачи, ведёт очередь и следит за состоянием узлов. Все узлы видят общую файловую систему. Обычно она представлена двумя областями: домашним каталогом с небольшой квотой и резервными копиями и рабочей областью (scratch) — большой и быстрой, без резервных копий и с периодической очисткой. Для небольших кластеров применяется NFS, для крупных — параллельные файловые системы наподобие Lustre. Узлы соединены быстрой сетью (InfiniBand или Ethernet с RDMA), по которой процессы одного расчёта обмениваются данными. Программное обеспечение на узлах обычно подключается модулями окружения (module load gcc openmpi), что позволяет держать на кластере несколько версий компиляторов и библиотек одновременно.
Различают два режима использования. HPC (high-performance computing) — плотно связанные расчёты, один расчёт занимает много узлов, и процессы обмениваются данными на каждом шаге; для них важны быстрая сеть и одновременный запуск всех процессов. HTC (high-throughput computing) — множество независимых задач, каждая на одном-двух ядрах; для них важна пропускная способность очереди. Физика высоких энергий исторически опирается на HTC — обработку событий детектора, — а расчёты плазмы и пучков с самосогласованным полем требуют HPC.
Планировщик и очередь
Ресурсы кластера распределяет планировщик (batch scheduler, менеджер ресурсов). Пользователь не выбирает узел сам: он отправляет задачу — скрипт и запрос ресурсов, то есть число ядер, объём памяти, лимит времени, число узлов и видеокарт. Планировщик ставит задачу в очередь и запускает её, когда запрошенные ресурсы освобождаются; на время работы задачи они принадлежат только ей. Порядок запуска определяется приоритетом, в котором учитываются время ожидания, размер задачи и справедливая доля (fair-share): пользователь, много считавший в последние дни, ждёт дольше. Лимит времени является обещанием пользователя: задача, превысившая его, снимается.
Наиболее распространённым планировщиком в научных вычислениях является Slurm, разработанный в Ливерморской национальной лаборатории имени Лоуренса с 2002 года [56] и развиваемый компанией SchedMD; в декабре 2025 года SchedMD купила компания NVIDIA, объявившая, что Slurm останется открытым программным обеспечением, не привязанным к оборудованию одного производителя. Применяются также OpenPBS и PBS Pro, HTCondor (массовая обработка, в том числе в CERN) и LSF. Kubernetes, о котором сказано в конце главы, распределяет ресурсы между долгоживущими службами и для пакетных расчётов на кластере используется реже.
Резервирование и заполнение промежутков
Простейшая очередь запускает задачи строго по порядку (FIFO). Её недостаток виден, когда в очереди находится большая задача: пока для неё освобождаются ядра, остальные ядра простаивают, хотя следом за ней ждут небольшие задачи. Планировщики поэтому применяют заполнение промежутков (backfill). В схеме EASY первой задаче очереди резервируется ближайший момент, когда для неё освободится достаточно ядер, а следующие задачи запускаются раньше неё при условии, что по запрошенному лимиту времени они закончатся до резерва или займут ядра, которые резерву не нужны. Существенно, что планировщик знает только лимит, а не фактическую длительность задачи. Slurm поступает осторожнее: задачу с меньшим приоритетом он запускает раньше, только если она не сдвигает ожидаемого старта ни одной из более приоритетных задач (консервативная схема), а ожидаемое время старта задачи, ждущей в очереди, сообщает команда squeue --start.
Рассмотрим модель: восемь задач поставлены в очередь на 8 ядер одновременно, у каждой заданы число ядер, фактическая длительность и лимит. Третий вариант отличается от второго единственной задачей H, которая запросила 120 минут «с запасом» вместо достаточных ей 20.
CORES = 8
JOBS = [("A", 4, 60, 60), ("B", 8, 30, 40), ("C", 2, 20, 30), ("D", 2, 50, 60),
("E", 4, 10, 15), ("F", 1, 40, 45), ("G", 6, 30, 35), ("H", 2, 15, 20)]
def simulate(jobs, backfill):
"""Старт и конец каждой задачи; все задачи поставлены в очередь в момент 0."""
queue, running, start, t = list(jobs), [], {}, 0
while queue or running:
free = CORES - sum(r[2] for r in running)
while queue and queue[0][1] <= free: # голова очереди помещается
name, cores, run, limit = queue.pop(0)
running.append((t + run, t + limit, cores))
start[name], free = t, free - cores
if backfill and queue: # резерв для головы очереди
avail = free
for _, end_limit, cores in sorted(running, key=lambda r: r[1]):
avail += cores
if avail >= queue[0][1]:
reserve, spare = end_limit, avail - queue[0][1]
break
for job in list(queue[1:]):
name, cores, run, limit = job
in_time = t + limit <= reserve
if cores <= free and (in_time or cores <= spare):
queue.remove(job)
running.append((t + run, t + limit, cores))
start[name], free = t, free - cores
spare -= 0 if in_time else cores
t = min(r[0] for r in running) # следующее завершение
running = [r for r in running if r[0] > t]
return {n: (start[n], start[n] + run) for n, _, run, _ in jobs}
padded = [(n, c, r, 120 if n == "H" else lim) for n, c, r, lim in JOBS]
print("вариант ожидание, мин конец, мин загрузка старт H, мин")
for title, jobs, bf in [("FIFO", JOBS, False), ("backfill", JOBS, True),
("backfill, H просит 120", padded, True)]:
s = simulate(jobs, bf)
wait = sum(v[0] for v in s.values()) / len(s)
end = max(v[1] for v in s.values())
busy = sum(c * r for _, c, r, _ in jobs) / (CORES * end)
print(f"{title:<22} {wait:13.1f} {end:11d} {busy:9.0%} {s['H'][0]:13d}")
вариант ожидание, мин конец, мин загрузка старт H, мин
FIFO 88.8 170 67% 140
backfill 45.0 130 88% 20
backfill, H просит 120 58.8 145 78% 130
Большая задача B, занимающая все 8 ядер, в обоих случаях стартует в 60 минут, когда завершается задача A, но при заполнении промежутков задачи C, D и H успевают выполниться до неё. Среднее ожидание сокращается с 88,8 до 45,0 минуты, загрузка ядер растёт с 67 до 88 %. Если же задача H запрашивает 120 минут, она уже не помещается в промежуток до резерва и стартует на 110 минут позже. Таким образом, точный лимит времени выгоден прежде всего самому пользователю. Для системы в целом завышенные оценки обходятся дешевле, чем можно ожидать: моделирование заполнения промежутков на нагрузке машин IBM SP2 привело к неожиданному результату — при оценках, завышенных в несколько раз, средние показатели очереди даже улучшаются [62]. Проигрывает же задача, запросившая лишнее.
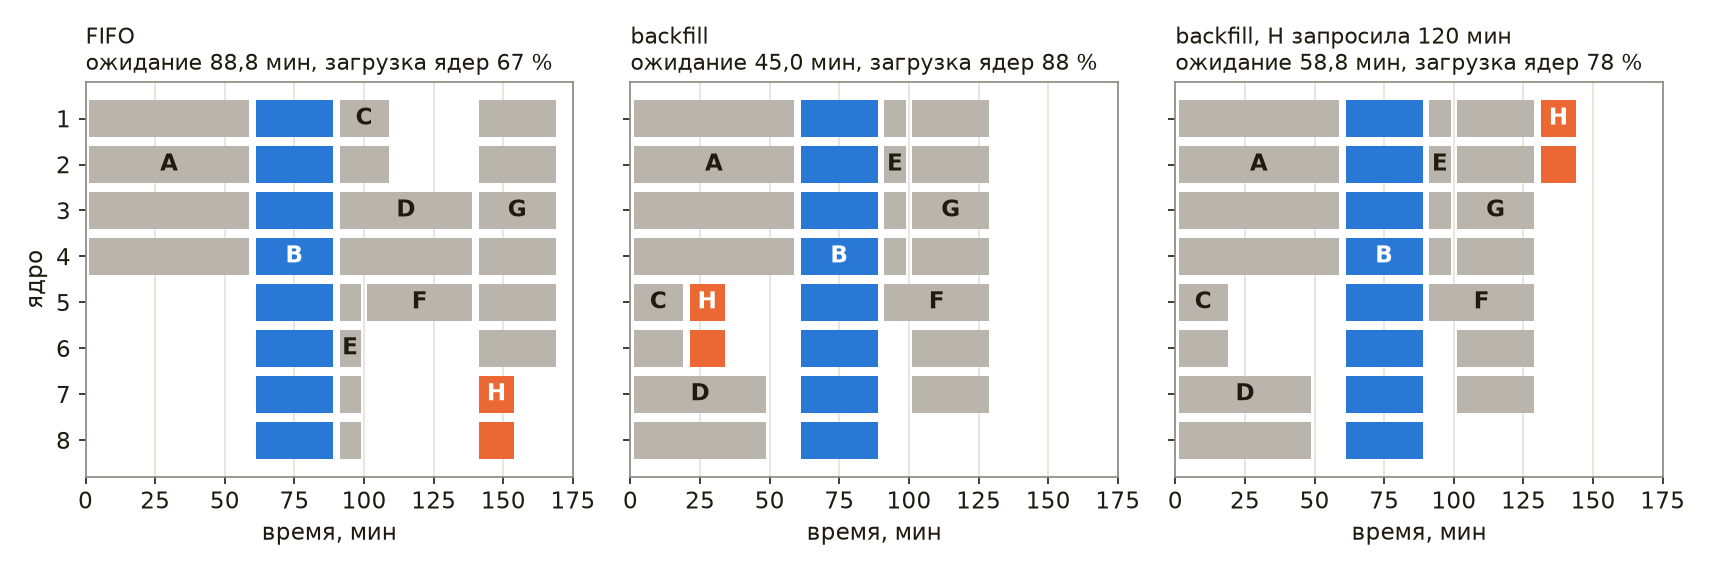
Slurm
Слайды к главе. Службы и команды Slurm, пакетный скрипт, ресурсы и лимиты, учёт изложены также во второй части лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Устройство и команды
Slurm состоит из нескольких служб. Контроллер slurmctld ведёт очередь, планирует запуск и следит за состоянием узлов. На каждом вычислительном узле работает slurmd, который запускает процессы задачи через вспомогательную программу slurmstepd. Подлинность сообщений между ними обеспечивает служба munge, использующая общий ключ, одинаковый на всех узлах. Необязательная служба slurmdbd записывает учёт выполненных задач в базу MySQL или MariaDB. Узлы объединяются в разделы (partitions), которые выполняют роль очередей с собственными лимитами: короткие отладочные задачи, длинные расчёты, узлы с видеокартами.
В терминологии Slurm задача (job) представляет собой выделение ресурсов, шаг (step) — запуск программы внутри выделения командой srun, а процессы шага (tasks) — экземпляры этой программы; у задачи из одного шага на одном ядре все три понятия совпадают, у расчёта MPI на нескольких узлах — нет. Пользователь работает с кластером следующими командами.
| Команда | Назначение |
|---|---|
sinfo | состояние разделов и узлов |
squeue | очередь: задачи, их состояние и причина ожидания |
sbatch скрипт | постановка пакетной задачи |
srun программа | запуск шага; вне выделения — выделение и запуск сразу |
salloc | выделение ресурсов для интерактивной работы |
scancel номер | снятие задачи |
scontrol show job номер | подробные сведения о задаче или узле |
sacct | учёт завершённых задач |
Состояние задачи обозначается кратким кодом: PD — ожидает (с причиной, например Resources — ресурсы заняты, Priority — впереди более приоритетные задачи, Dependency — ждёт другую задачу), R — выполняется, CG — завершается, CD — завершена успешно, F — завершилась с ошибкой, CA — снята, TO — превысила лимит времени, OOM — превысила память.
Пакетный скрипт
Задача описывается скриптом командной оболочки, в начале которого строки #SBATCH задают запрос ресурсов. Для оболочки эти строки являются комментариями, а sbatch читает из них параметры, как если бы они были переданы в командной строке.
#!/bin/bash
#SBATCH --job-name=hello
#SBATCH --cpus-per-task=1
#SBATCH --mem=100M
#SBATCH --time=00:01:00
#SBATCH --output=hello-%j.out
# Первая задача: что планировщик выделил и что видит процесс
echo "задача $SLURM_JOB_ID, узел $SLURMD_NODENAME, раздел $SLURM_JOB_PARTITION"
echo "ядер: $SLURM_CPUS_ON_NODE, память: $SLURM_MEM_PER_NODE МБ"
python3 -c 'import os; print("доступны ядра:", sorted(os.sched_getaffinity(0)))'
sleep 5
Задача ставится в очередь командой sbatch hello.sh, которая печатает её номер; %j в имени файла вывода заменяется этим номером. Переменные окружения SLURM_JOB_ID, SLURMD_NODENAME, SLURM_CPUS_ON_NODE, SLURM_MEM_PER_NODE сообщают программе, что ей выделено. По умолчанию задача наследует окружение командной оболочки, из которой её поставили (--export=ALL), поэтому python3 в задаче тот же, что был найден при постановке, — например, интерпретатор виртуального окружения. Последняя строка Python показывает ядра, на которых процессу разрешено выполняться: при включённом ограничении ядер планировщик оставляет задаче ровно одно ядро из двух, даже если узел свободен.
В демонстрации к лекции на стенде, конфигурация которого приведена ниже, эти команды дали следующий вывод:
sinfo
sbatch slurm/hello.sh
sleep 6; cat hello-*.out
PARTITION AVAIL TIMELIMIT NODES STATE NODELIST
main* up 1:00:00 1 idle lab
Submitted batch job 60
задача 60, узел lab, раздел main
ядер: 1, память: 100 МБ
доступны ядра: [0]
Команда sinfo показывает единственный раздел main (звёздочка отмечает раздел по умолчанию) с лимитом времени 1 ч и свободным узлом lab. Задача получила одно ядро и 100 МБ памяти, как и запрошено, а её процессу разрешено выполняться только на ядре 0.
Стенду соответствует следующая конфигурация одноузлового кластера: узел lab с двумя ядрами в одном сокете, которому для задач отведено 3000 МБ из 3,9 ГБ памяти машины, один раздел main с лимитом времени 1 ч, ограничение ядер и памяти через cgroups и журнал завершения задач в текстовом файле. Строку описания узла удобно получить командой slurmd -C, которая печатает конфигурацию оборудования в формате slurm.conf, и уменьшить в ней RealMemory, оставив часть памяти системе.
ClusterName=lab
SlurmctldHost=lab
SlurmUser=slurm
AuthType=auth/munge
SlurmctldPidFile=/run/slurmctld/slurmctld.pid
SlurmdPidFile=/run/slurm/slurmd.pid
StateSaveLocation=/var/lib/slurm/slurmctld
SlurmdSpoolDir=/var/lib/slurm/slurmd
SlurmctldLogFile=/var/log/slurm/slurmctld.log
SlurmdLogFile=/var/log/slurm/slurmd.log
SchedulerType=sched/backfill
SelectType=select/cons_tres
SelectTypeParameters=CR_Core_Memory
DefMemPerCPU=500
ProctrackType=proctrack/cgroup
TaskPlugin=task/cgroup,task/affinity
JobAcctGatherType=jobacct_gather/cgroup
JobCompType=jobcomp/filetxt
JobCompLoc=/var/log/slurm/jobcomp.log
MpiDefault=none
ReturnToService=2
NodeName=lab CPUs=2 CoresPerSocket=2 RealMemory=3000 State=UNKNOWN
PartitionName=main Nodes=lab Default=YES MaxTime=01:00:00 State=UP
Параметр SelectTypeParameters=CR_Core_Memory заставляет планировщик распределять ядра и память, а DefMemPerCPU задаёт память по умолчанию для задач, в которых она не запрошена; без него такая задача получила бы всю память узла, и вторая задача ждала бы, хотя ядро для неё свободно. Файл cgroup.conf рядом включает ограничения строками CgroupPlugin=cgroup/v2, ConstrainCores=yes, ConstrainRAMSpace=yes и ConstrainSwapSpace=yes.
Ресурсы, лимиты и учёт
Запрос ресурсов различает процессы и потоки. Параметр --ntasks задаёт число процессов — его используют программы MPI; --cpus-per-task — число ядер на процесс, то есть потоки OpenMP или библиотеки BLAS, которой пользуется NumPy. Число потоков необходимо согласовать с запросом явно, например export OMP_NUM_THREADS=$SLURM_CPUS_PER_TASK. Библиотека OpenBLAS, с которой собраны колёса NumPy для Linux, и среда OpenMP компилятора GCC по умолчанию запускают столько потоков, сколько ядер разрешено процессу: при ограничении ядер через cgroups это выделенные задаче ядра, а без такого ограничения — все ядра узла, и потоки задачи занимают ядра чужих задач. Функция os.cpu_count() возвращает число ядер узла в любом случае, поэтому пул процессов multiprocessing, размер которого в Python 3.12 выбирается по ней, делит между процессами одно выделенное ядро; число разрешённых ядер даёт len(os.sched_getaffinity(0)), а в Python 3.13 — функция os.process_cpu_count(). Память запрашивается на узел (--mem) или на ядро (--mem-per-cpu).
Выделение обеспечивается механизмом cgroups ядра Linux, описанным в главе «Внутреннее устройство Linux»: процессы задачи помещаются в отдельную группу с ограничением ядер (cpuset) и памяти (memory.max). Процесс, превысивший память, завершается ядром по нехватке памяти, а задача получает состояние OUT_OF_MEMORY; задача, превысившая лимит времени, снимается с состоянием TIMEOUT. Запрос, превышающий возможности раздела в целом, например четыре ядра в разделе из одного двухъядерного узла, как на стенде, при значении по умолчанию EnforcePartLimits=NO не отклоняется: задача принимается и остаётся в очереди с причиной PartitionConfig, пока её не снимут или не изменят конфигурацию раздела. Значения ANY и ALL заставляют контроллер отклонять такую задачу сразу при постановке, как и задачи, превышающие ограничения раздела по размеру и времени. Если же ядер в разделе достаточно, но ни на одном узле их нет в нужном числе, задача отклоняется при постановке при любом значении параметра: «CPU count per node can not be satisfied». Запрос «с запасом» выполним, но обходится дорого: задача дольше ждёт освобождения ресурсов, не помещается в промежутки и занимает место, которое могли бы использовать другие.
В демонстрации к лекции на стенде с двумя ядрами задача, запросившая четыре ядра, была принята и осталась в очереди, а из двух следующих задач по два ядра одна выполнялась, а другая ждала освобождения ресурсов (ключ --wrap превращает строку команды в пакетный скрипт):
sbatch -c 4 --wrap hostname
for i in 1 2; do sbatch -c 2 --wrap 'sleep 10'; done
squeue -o '%.5i %.8j %.2t %.6M %R'
Submitted batch job 61
Submitted batch job 62
Submitted batch job 63
JOBID NAME ST TIME NODELIST(REASON)
63 wrap PD 0:00 (Resources)
61 wrap PD 0:00 (PartitionConfig)
62 wrap R 0:00 lab
После снятия ожидающих задач командой scancel -t PD -u student в очередь поставлена задача, которой запрошено 200 МБ памяти, а сценарий hog.py занимает память блоками по 50 МиБ:
sbatch --mem=200M --wrap 'python3 hog.py 400'
sleep 12; cat slurm-*.out | tail -4 | fold -sw 78
Submitted batch job 64
занято 100 МиБ
занято 150 МиБ
Killed
slurmstepd-lab: error: Detected 1 oom_kill event in StepId=64.batch. Some of
the step tasks have been OOM Killed.
Процесс завершён ядром при попытке занять четвёртый блок: вместе с самим интерпретатором он превысил бы запрошенный объём. Завершённые задачи контроллер показывает ещё MinJobAge секунд (по умолчанию 300 с), и команда squeue -t all выводит их итоговые состояния:
squeue -t all -o '%.5i %.8j %.14T %.6M'
JOBID NAME STATE TIME
61 wrap CANCELLED 0:00
63 wrap CANCELLED 0:00
62 wrap COMPLETED 0:10
60 hello COMPLETED 0:05
64 wrap OUT_OF_MEMORY 0:00
Подбирать запрос по измерениям позволяет учёт. Команда sacct показывает для завершённых задач номер, состояние, время старта и длительность, код завершения и пиковую память (MaxRSS), по которой выбирают --mem; среди дополнительных программ из исходных текстов Slurm (каталог contribs) есть сценарий seff, сравнивающий запрошенное с использованным, — многие центры его устанавливают, в пакеты Ubuntu он не входит. Запрашивают обычно с запасом, например на 20 % больше измеренной памяти и в полтора раза больше измеренного времени. Такой учёт ведёт служба slurmdbd с базой данных. На небольшом кластере или стенде без неё задачи записываются только в журнал завершения (JobCompType=jobcomp/filetxt): одна строка на задачу с её состоянием и временами, без сведений о шагах и памяти. Команда sacct -c читает этот журнал, но в Slurm 23.11 — только от имени root и пользователя, под которым работает контроллер (SlurmUser): загружая модуль журнала, она открывает файл на дописывание, и у обычного пользователя завершается сообщением «sacct: fatal: open /var/log/slurm/jobcomp.log: Permission denied», хотя читать журнал разрешено всем. Поэтому на стенде для просмотра последних задач достаточно команды squeue -t all, а сценарий timeline.py из демонстрации к лекции строит диаграмму массива задач, читая журнал напрямую.
Правила общего кластера
Кластер разделяют десятки пользователей, и у всех центров коллективного пользования похожие правила. На узле входа не выполняют расчёты: их отправляют в очередь, а для интерактивной работы запрашивают узел командой salloc или srun --pty bash. Сессию tmux на узле входа, описанную в главе «Инструменты Linux», используют для интерактивной работы, а не для многочасового счёта. Данные расчёта размещают в рабочей области, а результаты своевременно забирают, поскольку рабочую область чистят. Тысячи мелких задач по несколько секунд не ставят по отдельности: их объединяют в массив, а работу — в порции, рассчитанные на минуты, поскольку каждая задача проходит через планировщик и между завершением одной задачи и запуском следующей проходит порядка секунды (в демонстрации к лекции — от 1 до 3 с). Квоты ограничивают не только объём файлов, но и их число, поэтому миллион маленьких файлов результата хуже одного файла HDF5. Окружение берут из модулей кластера или переносят своё — виртуальным окружением либо образом контейнера, о котором сказано ниже.
Массивы задач и сканы параметров
Слайды к главе. Массивы задач, скан токов дублета со сбором по зависимости и зёрна генератора изложены также в третьей части лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Массив задач
Большая часть расчётов в лаборатории состоит из независимых частей: точки скана параметров, серии Монте-Карло с разными зёрнами, файлы запусков установки. Для них в Slurm предусмотрен массив задач, который позволяет поставить в очередь множество однотипных задач одной командой: строка #SBATCH --array=0-11 превращает один скрипт в двенадцать задач, каждая из которых получает свой номер в переменной SLURM_ARRAY_TASK_ID. Отображение номера на параметр выполняет сама программа — по формуле или по строке таблицы параметров. Суффикс %2 (--array=0-11%2) ограничивает число одновременно выполняемых задач массива, а в имени файла вывода %A заменяется номером массива и %a — номером задачи в нём. Задачи массива независимы, и порядок их выполнения не гарантирован. Наибольший номер задачи определяется параметром MaxArraySize конфигурации, по умолчанию равным 1001, то есть допустимы номера от 0 до 1000.
#!/bin/bash
#SBATCH --job-name=scan
#SBATCH --array=0-11
#SBATCH --cpus-per-task=1
#SBATCH --mem=300M
#SBATCH --time=00:05:00
#SBATCH --output=logs/scan-%A_%a.out
# Строка k двумерного скана токов дублета: I_F = 2k А, I_D = 0…24 А
python3 scan_point.py "$SLURM_ARRAY_TASK_ID" results/
Начиная с версии 23.02 Slurm сам создаёт недостающий каталог для файлов вывода; в более ранних версиях задача с несуществующим каталогом в пути вывода завершается ошибкой, и каталоги logs и results на таких кластерах необходимо создавать заранее. Результаты всех задач собирает отдельная задача, которой задана зависимость: sbatch --dependency=afterok:ID collect.sh запускает сбор после успешного завершения всех задач массива с номером ID; номер удобно получить при постановке массива ключом --parsable, печатающим только его. Программа сбора проверяет, что ни одна точка не пропущена, — задача массива может завершиться по нехватке памяти или по лимиту времени, и её результат тогда отсутствует.
Скан токов дублета
Рассмотрим подбор токов квадрупольного дублета, проводящего пучок электронов с кинетической энергией 5 МэВ через коллиматор радиусом 3 мм. Магнитная жёсткость пучка составляет \(B\rho = p/e \approx 0{,}0183\) Тл·м. Линзы QF и QD длиной 0,1 м считаются тонкими; градиент пропорционален току, \(G = g I\) с \(g = 0{,}02\) Тл/(м·А), и оптическая сила линзы равна \(1/f = G L_q / (B\rho)\). Линза QF фокусирует пучок по \(x\) и дефокусирует по \(y\), линза QD — наоборот. Пучок на входе гауссов, с эмиттансом 1 мм·мрад в каждой плоскости, функциями Твисса \(\beta = 2\) м, \(\alpha = -1\) и разбросом импульса 2 %; из-за разброса импульса сила линз у разных частиц различна, и доля прошедших частиц определяется методом Монте-Карло, а не по формулам для огибающей.
import numpy as np
T, MC2 = 5.0, 0.51099895 # кинетическая энергия и mc², МэВ
BRHO = np.sqrt(T**2 + 2 * T * MC2) * 1e6 / 299_792_458.0 # жёсткость, Тл·м
L0, D, L1, LQ, G = 0.5, 0.3, 1.5, 0.1, 0.02 # м, м, м, м, Тл/(м·А)
A, EMIT, BETA, ALPHA, DP = 3e-3, 1e-6, 2.0, -1.0, 0.02
def transmission(i_f, i_d, n, rng):
"""Доля частиц, прошедших коллиматор радиусом A после дублета QF–QD."""
u = rng.standard_normal((5, n))
x, y = np.sqrt(EMIT * BETA) * u[0], np.sqrt(EMIT * BETA) * u[2]
xp = np.sqrt(EMIT / BETA) * (u[1] - ALPHA * u[0])
yp = np.sqrt(EMIT / BETA) * (u[3] - ALPHA * u[2])
kf = G * i_f * LQ / BRHO / (1 + DP * u[4]) # 1/f линз с учётом разброса импульса
kd = G * i_d * LQ / BRHO / (1 + DP * u[4])
x, y = x + L0 * xp, y + L0 * yp
xp, yp = xp - kf * x, yp + kf * y # QF: фокусирует по x
x, y = x + D * xp, y + D * yp
xp, yp = xp + kd * x, yp - kd * y # QD: фокусирует по y
x, y = x + L1 * xp, y + L1 * yp
return np.count_nonzero(x * x + y * y < A * A) / n
print(f"Bρ = {BRHO:.4f} Тл·м; ток QF 18 А, 10⁶ частиц на точку")
for i_d in range(15, 24):
p = transmission(18.0, float(i_d), 10**6, np.random.default_rng([2026, i_d]))
print(f"I_D = {i_d} А: прошло {100 * p:5.2f} % ± {100 * np.sqrt(p * (1 - p) / 1e6):.2f} %")
Bρ = 0.0183 Тл·м; ток QF 18 А, 10⁶ частиц на точку
I_D = 15 А: прошло 73.59 % ± 0.04 %
I_D = 16 А: прошло 84.01 % ± 0.04 %
I_D = 17 А: прошло 91.74 % ± 0.03 %
I_D = 18 А: прошло 94.59 % ± 0.02 %
I_D = 19 А: прошло 94.73 % ± 0.02 %
I_D = 20 А: прошло 93.72 % ± 0.02 %
I_D = 21 А: прошло 89.71 % ± 0.03 %
I_D = 22 А: прошло 81.05 % ± 0.04 %
I_D = 23 А: прошло 70.19 % ± 0.05 %
Функция переносит частицы через дрейф, линзу QF, промежуток, линзу QD и дрейф до коллиматора и возвращает долю частиц внутри апертуры; погрешность оценки равна \(\sqrt{p(1-p)/N}\). При токе QF 18 А наибольшая доля, около 94,7 %, достигается при токе QD 18–19 А. Одна строка скана из девяти точек вычисляется за доли секунды, а полная карта по двум токам с \(4 \cdot 10^{6}\) частиц в точке — строка за строкой — оказывается естественной работой для массива: задача \(k\) вычисляет строку с током QF \(2k\) А и 25 значениями тока QD и записывает её в файл results/row-KK.json.
В демонстрации к лекции массив из 12 таких задач и задача сбора поставлены в очередь стенда так:
J=$(sbatch --parsable slurm/scan.sh); echo $J
squeue -o '%.10i %.6j %.2t %.6M %R'
sbatch -d afterok:$J slurm/collect.sh
79
JOBID NAME ST TIME NODELIST(REASON)
79_[2-11] scan PD 0:00 (Resources)
79_0 scan R 0:01 lab
79_1 scan R 0:01 lab
Submitted batch job 82
Две задачи массива выполняются, остальные десять ждут освобождения ядер и показаны одной строкой; задача сбора поставлена с зависимостью от массива (-d — краткая форма --dependency). Каждая задача считала от 2,8 до 3,0 с, в сумме 35 с, программа сбора нашла все 12 строк, и наибольшая доля прошедших частиц, 94,78 %, получена при токах QF 18 А и QD 19 А. По журналу завершения задачи шли парами: первая пара — с 0 до 3 с от постановки массива, вторая — с 6 до 9 с, последняя — с 19 до 22 с, и одновременно выполнялось не более двух задач. Промежутки между парами, 3 с после первой и около 1 с далее, приходятся на задержку планировщика между завершением одних задач и запуском следующих, поэтому 35 с счёта заняли на двух ядрах 22 с, а не около 18. Таким образом, при задачах длительностью в несколько секунд задержка планировщика сравнима со счётом. Журнал хранит время с точностью до секунды, так что длительности на диаграмме округлены.
Зёрна генератора
Задачи массива Монте-Карло должны получать независимые последовательности случайных чисел, и способ задания зерна влияет на результат сильнее, чем может показаться. Скопированный в каждую задачу сценарий с фиксированным зерном даёт одинаковые результаты во всех задачах. Зерно, взятое из текущего времени с точностью до секунды, на кластере повторяется, поскольку задачи массива стартуют почти одновременно: в демонстрации к лекции они стартовали парами в одну и ту же секунду. Надёжный способ в NumPy состоит в передаче генератору последовательности из общего зерна расчёта и номера задачи: np.random.default_rng([seed, k]) строит по ней с помощью SeedSequence независимые потоки и при этом остаётся воспроизводимым.
Оценим последствия на модели. Пусть восемь задач считают эффективность сцинтилляционного счётчика NaI(Tl) размером 2″×2″ для точечного изотропного источника на оси на расстоянии 10 см, по 200 000 квантов каждая, а линейный коэффициент ослабления в кристалле принят равным 0,29 1/см, что близко к значению для γ-квантов 662 кэВ, около 0,28 1/см. Квант регистрируется, если он входит в кристалл через переднюю грань и взаимодействует на пути \(L\) внутри него с вероятностью \(1 - e^{-\mu L}\). Точное значение эффективности вычисляется квадратурой по косинусу угла вылета, и с ним сравнивается среднее по восьми задачам.
import statistics
import numpy as np
R, T, H, MU = 2.54, 5.08, 10.0, 0.29 # кристалл 2″×2″, источник в 10 см, μ в 1/см
C0 = H / np.hypot(H, R) # cosθ направления на край передней грани
def path(c):
"""Путь кванта в кристалле при cosθ = c > C0: выход через заднюю грань или боковую."""
tan = np.sqrt(1 - c * c) / c
z = np.where((H + T) * tan <= R, H + T, R / np.maximum(tan, 1e-300))
return (z - H) / c
def efficiency(seed, n=200_000):
rng = np.random.default_rng(seed)
c = rng.uniform(-1, 1, n) # изотропный источник
p = 1 - np.exp(-MU * path(c[c > C0])) # вероятность взаимодействия
return np.count_nonzero(rng.random(p.size) < p) / n
cgrid = np.linspace(C0, 1, 2_000_001)[1:]
exact = 0.5 * (1 - C0) * np.mean(1 - np.exp(-MU * path(cgrid)))
starts = [1759651200 + s for s in (0, 0, 0, 1, 1, 1, 1, 2)] # старт задач, с
ways = {"одно зерно 42": [42] * 8, "зерно = время старта": starts,
"[зерно скана, номер]": [[20261005, k] for k in range(8)]}
print(f"квадратура {100 * exact:.4f} %")
for name, seeds in ways.items():
eff = [efficiency(s) for s in seeds]
m, sem = statistics.fmean(eff), statistics.stdev(eff) / 8**0.5
dev = f"{(m - exact) / sem:+.1f} σ" if sem else "погрешность 0"
print(f"{name:<21} различных {len(set(eff))}, среднее {100 * m:.4f} %, {dev}")
квадратура 0.8808 %
одно зерно 42 различных 1, среднее 0.8890 %, погрешность 0
зерно = время старта различных 3, среднее 0.8672 %, -2.5 σ
[зерно скана, номер] различных 8, среднее 0.8776 %, -0.5 σ
При одинаковом зерне восемь задач дают один и тот же результат, разброс между ними равен нулю, и погрешность, оценённая по разбросу, тоже равна нулю — хотя истинная погрешность одной задачи около 0,02 %. При зерне из времени старта различных результатов только три: задачи, стартовавшие в одну секунду, повторяют друг друга, погрешность занижена, и среднее отклоняется от точного значения на 2,5 погрешности. Последовательность из общего зерна и номера задачи даёт восемь независимых результатов, и отклонение среднего (−0,5 погрешности) согласуется со статистикой. Таким образом, зерно задачи необходимо выводить из её номера, а не из времени, и записывать в файл результата вместе с версиями Python и NumPy.
Версии существенны. Политика совместимости NumPy гарантирует одинаковую последовательность чисел для одного и того же зерна при одной сборке библиотеки, в одном окружении и на одной машине; между версиями и платформами в редких случаях возможны отличия, а методы распределений объекта Generator могут меняться сильнее, чем потоки битовых генераторов. В демонстрациях к лекции сборки NumPy 2.5.3 для macOS и для Linux на процессорах ARM64 дали одинаковые числа и в этой модели, и в расчётах скана и эффективности счётчика, однако политика совместимости этого не обещает. Воспроизводимость результата на другом компьютере поэтому обеспечивается не только зерном, но и зафиксированным окружением, которому посвящён раздел о контейнерах.
MPI из Python
Слайды к главе. Модель передачи сообщений, обмен точка-точка, коллективные операции, разбиение области, ускорение и запуск под Slurm изложены также в четвёртой части лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Модель передачи сообщений
Массив задач подходит для независимых расчётов. Если же части расчёта обмениваются данными на каждом шаге, как при решении уравнения поля на сетке, разделённой между узлами, необходима модель с явной передачей данных между процессами. Стандартом такой модели является MPI (Message Passing Interface) [57]. Программа MPI запускается в нескольких экземплярах одновременно — обычно одна и та же программа (модель SPMD), — и каждый процесс получает свой номер, ранг, в коммуникаторе COMM_WORLD, объединяющем все процессы. Общей памяти у процессов нет: данные передаются сообщениями, и процессы могут находиться на разных узлах. Распространены две реализации стандарта — Open MPI и MPICH, обе свободные. В июне 2025 года утверждён стандарт MPI 5.0, впервые определивший единый двоичный интерфейс (ABI): программа, собранная с одной реализацией, поддерживающей этот интерфейс, может работать с другой такой реализацией.
Привязкой Python к MPI является пакет mpi4py [58]. Начиная с версии 4.1 (2025 год) он распространяется на PyPI готовыми колёсами для Linux и macOS, которые работают как с системными Open MPI и MPICH, так и с колёсами openmpi и mpich, устанавливаемыми рядом в то же виртуальное окружение. Программа запускается командой mpiexec -n 2 python3 программа.py; модуль multiprocessing из главы «Многопоточность и GIL» тоже запускает несколько процессов, но только на одной машине и без средств обмена между узлами.
Обмен точка-точка
Каждое сообщение имеет отправителя, получателя и метку. В mpi4py методы со строчной буквы (send, recv) передают произвольный объект Python, сериализуя его модулем pickle, а методы с прописной (Send, Recv) передают содержимое буфера — например, массива NumPy — без сериализации; приёмный буфер нужного размера и типа создаётся заранее.
# mpiexec -n 2
import numpy as np
from mpi4py import MPI
comm = MPI.COMM_WORLD
rank = comm.Get_rank()
if rank == 0:
comm.send({"run": 42, "currents": [18.0, 19.0]}, dest=1, tag=1) # объект: pickle
data = np.arange(5, dtype=np.float64)
comm.Send(data, dest=1, tag=2) # буфер NumPy
total = comm.recv(source=1, tag=3)
print(f"процесс 0 из {comm.Get_size()}: процесс 1 вернул сумму {total}")
else:
params = comm.recv(source=0, tag=1)
buf = np.empty(5, dtype=np.float64) # приёмный буфер заранее нужного размера
comm.Recv(buf, source=0, tag=2)
comm.send(float(buf.sum()) + params["run"], dest=0, tag=3)
процесс 0 из 2: процесс 1 вернул сумму 52.0
Процесс 0 отправляет словарь параметров и массив, процесс 1 возвращает сумму элементов массива, увеличенную на номер запуска из словаря: \(0 + 1 + 2 + 3 + 4 + 42 = 52\). Обмен блокирующий: recv ждёт сообщения, а send большого сообщения может ждать, пока получатель не начнёт приём. Поэтому два процесса, которые одновременно отправляют друг другу большие сообщения и лишь затем принимают, могут заблокировать друг друга навсегда; встречный обмен записывают одной операцией Sendrecv или неблокирующими Isend и Irecv с последующим ожиданием.
Цена сообщения складывается из задержки и времени передачи данных. В демонстрации к лекции два процесса на двух ядрах стенда обменивались сообщениями разного размера: передача 8 байт буферным методом заняла около 0,4 мкс, 1 МиБ — около 36 мкс (29 ГБ/с через общую память), а те же данные, переданные через pickle, — 4,3 и 179 мкс соответственно. Арифметическая операция над числом занимает доли наносекунды, поэтому параллельная программа тем эффективнее, чем реже она обменивается данными и чем крупнее её сообщения; между узлами кластера задержка выше — от единиц микросекунд в специализированных сетях до десятков микросекунд в обычном Ethernet.
Коллективные операции
Операции, в которых участвуют все процессы коммуникатора, называются коллективными: bcast рассылает объект от одного процесса всем, scatter раздаёт части, gather собирает результаты на одном процессе, reduce объединяет значения операцией (сумма, максимум), allreduce делает результат доступным всем, Barrier синхронизирует процессы. Реализации выполняют их деревом обменов за число шагов порядка \(\log_2 p\). Коллективную операцию обязаны вызвать все процессы коммуникатора в одном и том же порядке; процесс, пропустивший вызов, оставляет остальных в ожидании.
Рассмотрим распределение Монте-Карло между процессами. Если генератор каждого процесса зависит от его ранга, результат меняется с числом процессов и не воспроизводится на другом числе узлов. Работу поэтому делят на порции с собственными зёрнами, а процессы получают порции по кругу; результат тогда от числа процессов не зависит.
# mpiexec -n 2
import numpy as np
from mpi4py import MPI
comm = MPI.COMM_WORLD
rank, size = comm.Get_rank(), comm.Get_size()
cfg = {"seed": 20261005, "chunks": 16, "n": 500_000} if rank == 0 else None
cfg = comm.bcast(cfg, root=0) # параметры — от процесса 0 всем
def hits(chunk):
"""Порция Монте-Карло: доля точек в четверти круга, зерно — номер порции."""
rng = np.random.default_rng([cfg["seed"], chunk])
x, y = rng.random(cfg["n"]), rng.random(cfg["n"])
return int(np.count_nonzero(x * x + y * y < 1.0))
mine = list(range(rank, cfg["chunks"], size)) # порции процесса: rank, rank + size, …
local = sum(hits(c) for c in mine)
total = comm.reduce(local, op=MPI.SUM, root=0)
counts = comm.gather(len(mine), root=0)
if rank == 0:
n = cfg["chunks"] * cfg["n"]
print(f"процессов {size}, порций по процессам {counts}")
print(f"попаданий {total} из {n}, π ≈ {4 * total / n:.5f}")
процессов 2, порций по процессам [8, 8]
попаданий 6283553 из 8000000, π ≈ 3.14178
Тот же листинг, запущенный на одном процессе, печатает «порций по процессам [16]» и то же число попаданий 6283553. В демонстрации к лекции тем же способом распределён расчёт эффективности счётчика: 64 порции по \(2 \cdot 10^{6}\) квантов дали одинаковое число зарегистрированных квантов, 1 128 023, на одном и на двух процессах, а время сократилось с 0,49 до 0,26 с.
Разбиение области
Связанная задача требует обмена на каждом шаге. Рассмотрим потенциал в квадратной камере, верхняя стенка которой находится под потенциалом 1000 В, а остальные заземлены. Внутри камеры потенциал удовлетворяет уравнению Лапласа, и на сетке его можно найти итерациями Якоби: новое значение в узле равно среднему значений в четырёх соседних узлах. Точное значение в центре известно: сложив четыре поворота задачи, получим камеру, все стенки которой находятся под потенциалом 1000 В, и потенциал в центре такой камеры равен 1000 В, следовательно, в исходной задаче он равен \(V_0/4 = 250\) В.
Сетка делится между процессами полосами строк. Процессу для обновления его крайних строк необходимы строки соседа, поэтому у каждой полосы есть две теневые строки — копии граничных строк соседей, — которые обновляются обменом перед каждой итерацией. У крайних процессов вместо соседа указывается MPI.PROC_NULL, и обмен с ним ничего не делает.
# mpiexec -n 2
import numpy as np
from mpi4py import MPI
comm = MPI.COMM_WORLD
rank, size = comm.Get_rank(), comm.Get_size()
N, ITERS, V0 = 51, 6000, 1000.0 # сетка N×N, верхняя стенка под 1000 В
def sweep(u, iters, exchange=lambda a: None):
new = u.copy()
for _ in range(iters):
exchange(u) # обновить теневые строки
new[1:-1, 1:-1] = 0.25 * (u[:-2, 1:-1] + u[2:, 1:-1] + u[1:-1, :-2] + u[1:-1, 2:])
u, new = new, u
return u
rows = np.array_split(np.arange(N), size)[rank] # полоса строк процесса
u = np.zeros((rows.size + 2, N + 2))
if rank == 0:
u[0, :] = V0 # граница процесса 0 — верхняя стенка
up = rank - 1 if rank > 0 else MPI.PROC_NULL
down = rank + 1 if rank < size - 1 else MPI.PROC_NULL
def exchange(a):
comm.Sendrecv(a[1, :], dest=up, recvbuf=a[-1, :], source=down)
comm.Sendrecv(a[-2, :], dest=down, recvbuf=a[0, :], source=up)
parts = comm.gather(sweep(u, ITERS, exchange)[1:-1], root=0)
if rank == 0:
ref = np.zeros((N + 2, N + 2))
ref[0, :] = V0
ref = sweep(ref, ITERS) # тот же расчёт на одном процессе
full = np.vstack(parts)
c = N // 2
print(f"полос {size}, строки по процессам {[p.shape[0] for p in parts]}")
print(f"φ в центре {full[c, c + 1]:.2f} В, точное значение {V0 / 4:.2f} В")
print(f"наибольшее расхождение с одним процессом {np.abs(full - ref[1:-1]).max():.1e} В")
полос 2, строки по процессам [26, 25]
φ в центре 249.99 В, точное значение 250.00 В
наибольшее расхождение с одним процессом 0.0e+00 В
Первая операция Sendrecv отправляет первую собственную строку соседу сверху и принимает в нижнюю теневую строку первую строку соседа снизу; вторая выполняет встречный обмен. Строки двумерного массива NumPy лежат в памяти подряд, поэтому срезы a[1, :] и a[-1, :] служат буферами без копирования. Итерации Якоби поточечны: значение в каждом узле вычисляется по тем же четырём числам, что и в последовательной программе, поэтому параллельный результат совпадает с последовательным до последнего бита. Это свойство удобно для проверки: расхождение, отличное от нуля, указывает на ошибку в обмене, а не на округление. Для методов, где порядок суммирования зависит от разбиения, — например, при вычислении скалярного произведения для сопряжённых градиентов — результат отличается в последних знаках, и сравнение проводят с допуском.
Ускорение и закон Амдала
Ускорение параллельной программы на \(p\) процессах определяется как \(S = T_1 / T_p\), а эффективность — как \(E = S / p\). Если доля \(f\) времени работы программы не распараллеливается, закон Амдала [60], уже встречавшийся в главе «Причины низкой скорости Python» для ускорения части программы, ограничивает ускорение величиной
\[ S(p) \le \frac{1}{f + (1 - f)/p}, \]
и при \(f = 5\) % ускорение не превысит 20 при любом числе процессов. Закон Густафсона [61] рассматривает другую постановку: задача растёт вместе с числом процессов так, что время её решения остаётся прежним, и масштабированное ускорение \(S = p - f(p - 1)\), где \(f\) — последовательная доля времени расчёта на \(p\) процессах, растёт почти линейно. Для физика вторая постановка часто естественнее: больше узлов означает более подробную сетку или больше частиц, а не тот же расчёт быстрее. По измеренному ускорению последовательную долю оценивает метрика Карпа—Флэтта [65]
\[ e = \frac{1/S - 1/p}{1 - 1/p}, \]
рост которой с числом процессов указывает на накладные расходы обмена, а не на исходно последовательную часть программы.
В демонстрации к лекции расчёт потенциала выполнялся на двух ядрах стенда для сеток разного размера при постоянном объёме работы около \(4 \cdot 10^{8}\) обновлений узлов; время — лучшее из трёх повторов.
| \(N\) | Итераций | \(T_1\), с | \(T_2\), с | Ускорение | Эффективность |
|---|---|---|---|---|---|
| 101 | 39 211 | 0,77 | 0,49 | 1,56 | 0,78 |
| 201 | 9900 | 0,67 | 0,37 | 1,83 | 0,92 |
| 401 | 2487 | 0,62 | 0,34 | 1,85 | 0,92 |
| 801 | 623 | 0,72 | 0,38 | 1,88 | 0,94 |
| 1601 | 156 | 0,81 | 0,46 | 1,76 | 0,88 |
На малой сетке каждая итерация содержит мало работы, а обмен и накладные расходы Python на итерацию остаются прежними, и ускорение составляет 1,56; на сетке 51×51 из листинга оно в той же демонстрации было 0,96, то есть параллельный расчёт оказался медленнее последовательного. С ростом сетки счёт на итерацию растёт как \(N^2/p\), а обмен — только как \(N\), и ускорение растёт до 1,83–1,88. На самой большой сетке скорость обоих процессов ограничивает общая пропускная способность памяти, и ускорение снова падает, до 1,76. На рабочем компьютере, где выполнены листинги главы, тот же ряд дал при \(N = 801\) ускорение 2,01, то есть эффективность чуть больше единицы: половина сетки помещается в кеш процессора лучше, чем целая.
Запуск под Slurm
На кластере программа MPI запускается внутри выделения Slurm. Документация Slurm называет предпочтительным прямой запуск процессов командой srun: Slurm сам создаёт процессы, сообщает им ранги через интерфейс PMIx и учитывает их в учёте и при привязке к ядрам. Для Open MPI тип интерфейса задаётся ключом --mpi=pmix или параметром MpiDefault=pmix конфигурации; список доступных интерфейсов печатает srun --mpi=list. Команда mpirun Open MPI внутри выделения также работает: она получает список выделенных узлов от Slurm и запускает процессы его средствами. Запуск через ssh в обход планировщика документация не рекомендует, поскольку такие процессы выпадают из учёта и ограничений.
#!/bin/bash
#SBATCH --job-name=laplace
#SBATCH --ntasks=2
#SBATCH --mem-per-cpu=300M
#SBATCH --time=00:05:00
#SBATCH --output=laplace-%j.out
# Один расчёт MPI двумя способами запуска внутри одного выделения
echo "== srun"
srun --mpi=pmix python3 laplace.py 801 400
echo "== mpirun"
mpirun python3 laplace.py 801 400
Здесь --ntasks=2 запрашивает два процесса, каждый с одним ядром; программе с потоками внутри процесса дополнительно задают --cpus-per-task. На кластере с несколькими узлами к запросу добавляют --nodes, а для процессов, которые должны находиться на одном узле, — --ntasks-per-node.
В демонстрации к лекции список интерфейсов на стенде выглядел так:
srun --mpi=list
MPI plugin types are...
none
pmix
pmi2
cray_shasta
specific pmix plugin versions available: pmix_v5
Задача 92 с приведённым скриптом, поставленная командой sbatch --wait slurm/laplace.sh, которая возвращает управление только после завершения задачи, выполнила оба запуска. В обоих результат совпал с последовательным расчётом до бита, а ускорение составило 1,93 при запуске через srun и 1,87 через mpirun; в четырёх других прогонах того же скрипта оба способа давали от 1,86 до 1,89, так что разница между ними лежит в пределах разброса.
Воспроизводимое окружение
Слайды к главе. Источники невоспроизводимости, Apptainer, файл определения и запуск образа без прав администратора изложены также в пятой части лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Источники невоспроизводимости
Результат расчёта зависит не только от кода и входных данных. На него влияют версии интерпретатора и библиотек; реализация BLAS, к которой обращается NumPy (OpenBLAS и MKL суммируют в разном порядке, и результат может отличаться в последних знаках, в том числе в зависимости от числа потоков); системные библиотеки и операционная система узла; переменные окружения наподобие OMP_NUM_THREADS; зёрна генераторов; в редких случаях — архитектура процессора. Расчёт, который на рабочем компьютере автора давал одни числа, на узле кластера через год может дать другие, и причину приходится искать долго.
Фиксация окружения выполняется на нескольких уровнях. Простейший уровень представляет собой список зависимостей с точными версиями, а лучше — с контрольными суммами (pip freeze, файл блокировки менеджера пакетов, установка с --require-hashes). Следующий — окружение conda с описанием в environment.yml, включающее и библиотеки, написанные не на Python. На кластере доступны модули, собранные администраторами. Наиболее полную фиксацию обеспечивает образ контейнера: в нём зафиксировано всё, кроме ядра операционной системы и драйверов устройств. Образ и файл, по которому он собран, хранят рядом с результатом и публикуют вместе со статьёй — к этой мысли глава «Docker» подводит в разделе о контейнерах в науке.
Apptainer
На общих кластерах Docker обычно не устанавливают. Его служба работает от имени root, а пользователь, которому разрешено к ней обращаться, фактически получает права root на узле: документация Docker прямо указывает, что группа docker даёт привилегии уровня root. В демонстрации к лекции обычный пользователь стенда, не входящий в эту группу, обратиться к службе Docker не смог:
docker run --rm python:3.12-slim python3 -V 2>&1 | fold -sw 78
ls -l /var/run/docker.sock
permission denied while trying to connect to the docker API at
unix:///var/run/docker.sock
srw-rw---- 1 root docker 0 Oct 5 13:42 /var/run/docker.sock
Для вычислительных центров был создан Apptainer, до 2021 года называвшийся Singularity [59]. Проект Singularity был начат в Национальной лаборатории имени Лоуренса в Беркли в 2015 году; в ноябре 2021 года сообщество перевело его в Linux Foundation под именем Apptainer, а компания Sylabs продолжает развивать ответвление SingularityCE.
Apptainer отличается от Docker в нескольких отношениях, существенных для кластера. Службы нет: команда apptainer запускает процесс контейнера сама и от имени того же пользователя, с тем же идентификатором внутри контейнера, поэтому файлы, созданные расчётом, принадлежат пользователю, а не root. По умолчанию в контейнер подключаются домашний каталог, текущий каталог, /tmp и /var/tmp, /proc, /sys, /dev, а также файлы /etc/hosts и /etc/localtime, так что программа видит свои данные без дополнительных настроек. Образ формата SIF представляет собой один неизменяемый файл со сжатой файловой системой squashfs, который можно скопировать на кластер, подписать и проверить подпись. Видеокарта становится доступна ключом --nv, подключающим в контейнер драйвер хоста. Программа MPI в контейнере обычно запускается по гибридной схеме: процессы создаёт srun или mpirun хоста, а библиотека MPI внутри образа должна быть совместима с MPI и сетью кластера.
В Ubuntu 24.04 создание пространств имён непривилегированным пользователем ограничено политикой AppArmor; пакет Apptainer для этой версии устанавливает профиль, разрешающий их своей программе запуска, и обычный пользователь запускает образ без прав администратора. Apptainer 1.5 позволяет собирать образ по файлу определения и обычному пользователю: сборка без прав root выполняется в режиме fakeroot, который опирается на те же пространства имён пользователя. Права root или членство в группе docker требуются лишь для сборки из образа локальной службы Docker, как в примере ниже, поскольку Apptainer обращается к ней через её сокет. Запуск образа прав администратора не требует.
Файл определения
Образ собирается по файлу определения (definition file). Заголовок указывает источник базового образа: Bootstrap: docker — реестр образов, Bootstrap: docker-daemon — образ в локальной службе Docker, Bootstrap: localimage — существующий файл SIF. Разделы задают файлы, копируемые в образ (%files), команды сборки (%post), переменные окружения (%environment), программу запуска (%runscript), проверку образа (%test), метки и справку.
Bootstrap: docker-daemon
From: python:3.12-slim
%labels
Title mc-detector
Version 1.0
%help
Монте-Карло эффективности сцинтилляционного счётчика (NumPy 2.5.3).
Запуск: apptainer run mc.sif ЧИСЛО_КВАНТОВ [ФАЙЛ_РЕЗУЛЬТАТА] [ЗЕРНО]
%files
numpy-2.5.3-cp312-cp312-manylinux_2_27_aarch64.manylinux_2_28_aarch64.whl /opt/wheels/
detector.py /opt/mc/
mc_detector.py /opt/mc/
%post
python3 -m pip install --no-index --no-cache-dir /opt/wheels/numpy-*.whl
rm -rf /opt/wheels
%environment
export PYTHONDONTWRITEBYTECODE=1
%runscript
exec python3 /opt/mc/mc_detector.py "$@"
%test
python3 -c "import numpy; print('numpy', numpy.__version__)"
Образ строится на базе python:3.12-slim из локальной службы Docker, поэтому сборка не обращается к сети. NumPy устанавливается из заранее скачанного колеса с точной версией, а не из интернета, и программа расчёта копируется в образ; раздел %runscript делает образ исполняемым: apptainer run mc.sif 2000000 запускает расчёт с аргументом. Файл определения сохраняется внутри SIF и выводится командой apptainer inspect --deffile mc.sif, так что описание сборки неотделимо от образа. Для полной воспроизводимости базовый образ из реестра (Bootstrap: docker) указывают не тегом, а дайджестом (From: python@sha256:…): тег 3.12-slim со временем начинает указывать на новую сборку. Агент docker-daemon принимает только имя с тегом, и тогда базовый образ определяется тем, что хранится в локальной службе Docker; в образе стенда тег 3.12-slim дал Python 3.12.14 на Debian 13. В демонстрации к лекции сборка от root выполнила проверку раздела %test, напечатавшую «numpy 2.5.3», и записала образ mc.sif размером 63 МиБ.
Запуск образа
apptainer build mc.sif mc.def # сборка (здесь — от root)
apptainer run mc.sif 2000000 # раздел %runscript
apptainer exec mc.sif python3 -c 'import numpy; print(numpy.__version__)'
apptainer run -B $PWD/data:/data mc.sif 2e6 /data/mc.json # привязка каталога
apptainer exec --containall mc.sif ls ~ # без домашнего каталога хоста
srun --mem=300M apptainer run mc.sif 2000000 # тот же образ под Slurm
Команда exec выполняет в контейнере произвольную команду, run — программу раздела %runscript, shell открывает командную оболочку. Ключ -B (--bind) подключает каталог хоста по указанному пути контейнера; так в контейнер передают данные и рабочую область. Ключ --contain подставляет вместо домашнего каталога, /tmp и /var/tmp хоста пустые временные каталоги, а --containall вдобавок изолирует процессы и межпроцессное взаимодействие и не передаёт в контейнер переменные окружения хоста; так проверяют, не зависит ли расчёт от случайных файлов в домашнем каталоге и от окружения. Под Slurm образ запускается командой srun apptainer … внутри задачи, и ограничения cgroups действуют на процесс контейнера так же, как на любой другой.
В демонстрации к лекции образ запускался от имени обычного пользователя стенда:
apptainer run mc.sif 2000000
python3 mc_detector.py 2000000 | head -3
apptainer exec mc.sif grep PRETTY /etc/os-release
id -un; apptainer exec mc.sif id -un
Python 3.12.14, NumPy 2.5.3, зерно 20261005
испущено 2000000, зарегистрировано 17529
эффективность 0.8764 % ± 0.0066 %, квадратура 0.8808 %
отклонение -0.66 σ, время 0.04 с
Python 3.12.3, NumPy 2.5.3, зерно 20261005
испущено 2000000, зарегистрировано 17529
эффективность 0.8764 % ± 0.0066 %, квадратура 0.8808 %
PRETTY_NAME="Debian GNU/Linux 13 (trixie)"
student
student
Расчёт в образе, где работают Python 3.12.14 и Debian 13, и тот же сценарий в окружении стенда с Python 3.12.3 зарегистрировали одно и то же число квантов: версия NumPy в образе и на стенде одна и та же. Внутри контейнера процесс принадлежит тому же пользователю, что и снаружи, поэтому файл, записанный в привязанный каталог командой apptainer run -B $PWD/data:/data mc.sif 2e6 /data/mc.json, принадлежит этому пользователю, а не root.
Перенос образа имеет пределы. Образ, собранный для архитектуры x86-64, не запускается на узлах ARM (aarch64), и наоборот, — архитектура указывается в имени колеса NumPy в файле определения. Ядро и драйверы видеокарты берутся с хоста. Библиотеку MPI в образе необходимо согласовать с реализацией MPI на кластере, иначе процессы не свяжутся через быструю сеть. Таким образом, образ Apptainer фиксирует пользовательскую часть окружения, а совместимость с аппаратурой кластера остаётся заботой того, кто образ собирает.
Управление конфигурацией
Слайды к главе. Конфигурация как код, инвентарь, плейбук, идемпотентность и роли Ansible изложены также в шестой части лекции «Кластеры и воспроизводимое окружение для расчётов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Конфигурация как код
Машины, настроенные вручную, со временем расходятся. Один администратор обновил пакет на половине узлов, другой исправил конфигурационный файл прямо на сервере и забыл перенести исправление на остальные, третий переименовал машины, а сценарий выкатки о новых именах не знает. Это явление называют дрейфом конфигурации, и оно приводит к авариям, причину которых долго ищут: на одних узлах расчёт работает, на других — нет. Управление конфигурацией описывает желаемое состояние машин кодом — какие пакеты установлены, какие файлы и с каким содержимым лежат, какие службы запущены, — хранит этот код в git, проверяет его ревью и пробным прогоном и применяет одинаково ко всем машинам [64]. Важнейшим свойством такого кода является идемпотентность: повторное применение к машине, которая уже находится в описанном состоянии, ничего не меняет. Для лаборатории это означает, что стенд, машину сбора данных или узел кластера можно пересоздать за минуты, а машины учебного класса гарантированно настроены одинаково.
Распространены четыре системы управления конфигурацией.
| Система | Описание конфигурации | Агент на узле | Модель | Состояние на 2026 год |
|---|---|---|---|---|
| Ansible | YAML и шаблоны Jinja2 | нет, нужен Python | push по SSH; есть ansible-pull | Red Hat; ansible-core 2.21 |
| Salt | YAML и Jinja2 | миньон, постоянное соединение с мастером | шина сообщений ZeroMQ; есть salt-ssh | VMware с 2020 года, затем Broadcom |
| Chef | Ruby DSL | Chef Infra Client | pull: клиент сам загружает описание и применяет его | Progress Software |
| Puppet | язык Puppet, данные Hiera в YAML | агент | pull: сервер собирает каталог, агент применяет его | Perforce, новые сборки с 2025 года — по лицензионному соглашению; открытое ответвление OpenVox (январь 2025 года) |
Различие моделей существенно. В модели push управляющая машина подключается к узлам и выполняет на них действия; так работает Ansible. В модели pull агент на узле сам по расписанию обращается к серверу и приводит узел в соответствие с описанием; так работают Chef и Puppet. Клиент Chef загружает с сервера описание, сам собирает и применяет его, а сервер Puppet собирает для узла каталог желаемого состояния, который применяет агент. Для небольшого числа машин без постоянной инфраструктуры Ansible проще: ему достаточно доступа по SSH и интерпретатора Python на узлах [63]; ansible-core 2.21 поддерживает Python 3.9–3.14 на узлах и 3.12–3.14 на управляющей машине.
Инвентарь и плейбук
Ansible узнаёт об управляемых машинах из инвентаря — списка узлов, объединённых в группы, с переменными для групп и узлов. Учебный стенд состоит из одного узла, которым Ansible управляет на той же машине (подключение local вместо SSH).
# Узлы стенда; файлы демонстраций пишутся в stand_root, а не в корень
[cluster]
lab ansible_connection=local
[cluster:vars]
ansible_python_interpreter="{{ ansible_playbook_python }}"
stand_root=/tmp/l21rec/stand
slurm_partition=main
Переменные раздела [cluster:vars] действуют на все узлы группы. Переменная ansible_python_interpreter задаёт интерпретатор, которым модули выполняются на узле; здесь это тот же Python, которым запущен сам Ansible (ansible_playbook_python), — виртуальное окружение ansible-core на стенде.
Действие над узлом выполняет модуль: ping проверяет связь, setup собирает факты об узле (число ядер, объём памяти, семейство ОС), command выполняет команду, file, copy и template управляют файлами, apt, systemd_service, pip и user — пакетами, службами, пакетами Python и пользователями. Разовая команда вызывает один модуль для группы узлов: ansible cluster -m ping или ansible cluster -m setup -a filter=ansible_processor_vcpus. В демонстрации к лекции факт ansible_processor_vcpus стенда равен 2, а проверка связи и разовая команда без указания модуля дали такой вывод:
ansible cluster -m ping
ansible cluster -a nproc
lab | SUCCESS => {
"changed": false,
"ping": "pong"
}
lab | CHANGED | rc=0 >>
2
Модулем по умолчанию является command: без ключа -m вызывается именно он, и он всегда сообщает об изменении (CHANGED), поскольку не может знать, что сделала команда.
Последовательность действий записывается плейбуком. Плейбук состоит из одного или нескольких сценариев (plays), каждый из которых относится к группе узлов и содержит задачи; задача вызывает модуль с параметрами, описывающими желаемое состояние. Следующий плейбук создаёт каталог конфигурации Slurm и два файла из шаблонов, а при изменении любого из файлов вызывает обработчик перезапуска служб.
# Плейбук демонстрации: конфигурация узла Slurm в каталоге stand_root (на стенде — /tmp/l21rec/stand)
- name: Конфигурация узла Slurm
hosts: cluster
gather_facts: false
vars:
slurm_cluster: lab
slurm_host: lab
slurm_cpus: 2
slurm_cores_per_socket: 2
slurm_mem_mb: 3000
tasks:
- name: Каталог конфигурации
ansible.builtin.file:
path: "{{ stand_root }}/etc/slurm"
state: directory
mode: "0755"
- name: Файлы конфигурации из шаблонов
ansible.builtin.template:
src: "{{ item.src }}"
dest: "{{ stand_root }}/etc/slurm/{{ item.dest }}"
mode: "0644"
loop:
- {src: slurm.j2, dest: slurm.conf}
- {src: cgroup.j2, dest: cgroup.conf}
loop_control:
label: "{{ item.dest }}"
notify: Перезапуск Slurm
handlers:
- name: Перезапуск Slurm
ansible.builtin.debug:
msg: перезапуск slurmctld и slurmd
Модуль file с параметром state: directory проверяет, существует ли каталог с нужными правами, и создаёт его только при необходимости; модуль template подставляет переменные в шаблон Jinja2 и заменяет файл, только если результат отличается от существующего. Поэтому каждая задача сообщает, изменила ли она что-нибудь: changed или ok. Обработчик (handler) выполняется один раз в конце сценария и только в том случае, если хотя бы одна задача, уведомившая его ключом notify, сообщила об изменении; таким образом, служба перезапускается лишь при изменении её конфигурации. В учебном плейбуке обработчик только печатает сообщение, а в плейбуке настоящего стенда он перезапускает службы модулем systemd_service. Ниже приведены выводы первого и повторного применения плейбука; команда tr -s ' *\n' в конце сжимает повторяющиеся пробелы, звёздочки заголовков и пустые строки, чтобы вывод помещался в окно шириной 80 символов.
ansible-playbook stand.yml | tr -s ' *\n'
PLAY [Конфигурация узла Slurm] *
TASK [Каталог конфигурации] *
changed: [lab]
TASK [Файлы конфигурации из шаблонов] *
changed: [lab] => (item=slurm.conf)
changed: [lab] => (item=cgroup.conf)
RUNNING HANDLER [Перезапуск Slurm] *
ok: [lab] => {
"msg": "перезапуск slurmctld и slurmd"
}
PLAY RECAP *
lab : ok=3 changed=2 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0
ansible-playbook stand.yml | tr -s ' *\n' | tail -3
ok: [lab] => (item=cgroup.conf)
PLAY RECAP *
lab : ok=2 changed=0 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0
Первое применение создало каталог и оба файла (changed=2) и вызвало обработчик. Повторное ничего не изменило (changed=0), и обработчик не вызывался. Перед применением выполняют пробный прогон: ключ --check (-C) выполняет плейбук, не изменяя узел, и сообщает, что было бы изменено, а --diff (-D) показывает, как изменятся файлы. В демонстрации к лекции пробный прогон перед первым применением вывел те же строки и тот же итог ok=3 changed=2, но ничего не создал: следующее за ним применение снова сообщило о создании каталога и обоих файлов. Модули command и shell выполняют произвольные команды и поэтому неидемпотентны: при каждом прогоне они сообщают об изменении и в пробном прогоне не выполняются. Их делают идемпотентными параметрами creates и removes — команда выполняется, только если указанного файла нет (или он есть), — либо условием changed_when.
Роли и шаблоны
Плейбук, выросший до десятков задач, разбивают на роли — каталоги стандартной структуры: tasks (задачи), handlers (обработчики), templates (шаблоны Jinja2), files (файлы для копирования), defaults (значения переменных по умолчанию), vars (переменные роли) и meta (зависимости). Роль подключается одной строкой roles: [slurm_node] и может применяться в разных плейбуках с разными значениями переменных. Переменные Ansible задаются во многих местах, и порядок их старшинства в документации насчитывает 22 уровня: значения по умолчанию из defaults роли — второй снизу, переменные инвентаря, сценария и роли — выше, а переменные, переданные в командной строке ключом -e, имеют высший приоритет. Поэтому в defaults помещают разумные значения, которые пользователь роли переопределяет. Так, роль slurm_node по умолчанию пишет файлы в системные каталоги (stand_root в defaults пуст), но в демонстрации переменная группы из инвентаря старше значения по умолчанию, и роль пишет их во временный каталог /tmp/l21rec/stand; плейбук настоящего стенда снова задаёт пустое stand_root переменной сценария, которая старше переменных инвентаря.
Шаблон роли slurm_node формирует slurm.conf из переменных; строка с описанием узла выглядит так:
NodeName={{ slurm_host }} CPUs={{ slurm_cpus }} CoresPerSocket={{ slurm_cores_per_socket }} RealMemory={{ slurm_mem_mb }} State=UNKNOWN
Изменение переменной в пробном прогоне с показом различий — команда ansible-playbook site.yml -e slurm_mem_mb=2800 -CD, где site.yml подключает роль, — показывает ровно одну изменившуюся строку и вызов обработчика (приведён фрагмент вывода записи; две строки заголовка различий с путями файлов опущены):
TASK [slurm_node : Файлы конфигурации из шаблонов] *
@@ -22,3 +22,3 @@
ReturnToService=2
-NodeName=lab CPUs=2 CoresPerSocket=2 RealMemory=3000 State=UNKNOWN
+NodeName=lab CPUs=2 CoresPerSocket=2 RealMemory=2800 State=UNKNOWN
PartitionName=main Nodes=lab Default=YES MaxTime=01:00:00 State=UP
changed: [lab] => (item=slurm.conf)
ok: [lab] => (item=cgroup.conf)
RUNNING HANDLER [slurm_node : Перезапуск Slurm] *
Итог этого прогона — ok=3 changed=1 skipped=2: пропущены задача и обработчик роли, которые управляют службами systemd и в демонстрации отключены переменной manage_services.
Из той же роли собран плейбук, настраивающий учебный стенд целиком: установка пакетов Slurm, munge, Open MPI и Apptainer из локального каталога файлов .deb (стенд не имеет доступа к сети), проверка ключа munge, роль slurm_node с перезапуском служб, установка mpi4py в виртуальное окружение из локальных колёс и создание учебного пользователя.
# Стенд лекции 21 одним плейбуком (только на стенде, от root):
# пакеты из локального каталога, munge, Slurm, mpi4py в /opt/l9venv, пользователь student
- name: Стенд лекции 21
hosts: cluster
gather_facts: false
become: true
vars:
debs_dir: /root/l21/debs
wheels_dir: /root/l21/wheels
stand_root: ""
manage_services: true
pre_tasks:
- name: Пакеты Slurm, munge, Open MPI, Apptainer из каталога .deb
ansible.builtin.shell: >
apt-get install -y --no-install-recommends {{ debs_dir }}/*.deb
args:
creates: /usr/sbin/slurmctld-wlm
- name: Ключ munge создан при установке
ansible.builtin.stat:
path: /etc/munge/munge.key
register: munge_key
- name: Ключ munge на месте
ansible.builtin.assert:
that: munge_key.stat.exists and munge_key.stat.pw_name == "munge"
quiet: true
roles:
- slurm_node
tasks:
- name: mpi4py в /opt/l9venv из локальных колёс
ansible.builtin.pip:
name: mpi4py==4.1.2
virtualenv: /opt/l9venv
environment: # не extra_args: с ними пробный прогон всегда сообщает об изменении
PIP_NO_INDEX: "1"
PIP_FIND_LINKS: "{{ wheels_dir }}"
- name: Пользователь student для задач
ansible.builtin.user:
name: student
shell: /bin/bash
create_home: true
Установка пакетов записана через модуль shell, поскольку модуль apt принимает только один локальный файл .deb; идемпотентность обеспечивает параметр creates: если программа slurmctld уже установлена, задача пропускается. Каталог колёс передаётся pip переменными окружения, а не параметром extra_args: с extra_args модуль pip в пробном прогоне всегда сообщает об изменении. Повторный прогон плейбука на настроенном стенде, в том числе в режиме --check, не должен сообщать ни об одном изменении; это и есть проверка того, что стенд находится в описанном состоянии. В демонстрации к лекции пробный прогон завершился итогом ok=8 changed=0.
Kubernetes и Terraform
Слайды к главе. Kubernetes, Terraform и принципы инфраструктуры как кода изложены также в седьмой части лекции «Кластеры и воспроизводимое окружение для расчётов»; слайды лекции доступны на сайте книги и в PDF.
Kubernetes
Kubernetes представляет собой систему управления контейнерами на кластере, ориентированную прежде всего на долгоживущие службы. Минимальная единица — под (pod), один или несколько контейнеров с общей сетью и томами; вспомогательные контейнеры пода (sidecar) получили собственную поддержку, стабильную с версии 1.33 (апрель 2025 года). Объект Deployment поддерживает заданное число одинаковых подов и выкатывает новые версии, Service даёт подам постоянное имя и адрес, Job и CronJob выполняют пакетные задачи до завершения. Управляющий уровень кластера (control plane) состоит из сервера API (kube-apiserver), через который проходят все запросы, хранилища состояния etcd, планировщика, выбирающего узел для пода, и менеджера контроллеров. На каждом узле kubelet запускает контейнеры и перезапускает их при отказе пробы живости, а kube-proxy настраивает в ядре правила для адресов служб. Пользователь описывает желаемое состояние, а контроллеры постоянно приводят к нему фактическое; собственные типы объектов с собственными контроллерами (операторами) позволяют управлять через Kubernetes практически чем угодно.
Для физической лаборатории Kubernetes уместен там, где работают службы: JupyterHub для сотрудников, веб-доступ к данным установки, архив и мониторинг, конвейеры обработки. Пакетные задачи в нём тоже выполняются, а для очередей с приоритетами и справедливой долей существуют расширения (например, Kueue и Volcano). Плотно связанные расчёты MPI, точное распределение ядер и видеокарт, учёт ресурсов по пользователям и проектам традиционно остаются за Slurm. Для кластера лаборатории из нескольких узлов Kubernetes избыточен, а на суперкомпьютере коллективного пользования, как правило, недоступен.
Terraform и OpenTofu
Если вычислительные ресурсы арендуются в облаке, машины, диски и сети тоже описывают кодом. Terraform описывает облачные ресурсы на языке HCL; команда terraform init загружает провайдеры — отдельные программы на Go для конкретного облака, — terraform plan сравнивает описание с фактическим состоянием и показывает, что будет создано, изменено и удалено, terraform apply выполняет изменения, terraform destroy удаляет ресурсы. Связь между кодом и созданными ресурсами обеспечивает файл состояния (terraform.tfstate); при работе нескольких человек его держат в общем хранилище с блокировкой. Повторяющиеся описания оформляют модулями. В 2023 году компания HashiCorp перевела Terraform на лицензию Business Source License, после чего сообщество под эгидой Linux Foundation создало открытое ответвление OpenTofu (общедоступно с января 2024 года, лицензия MPL 2.0); с февраля 2025 года HashiCorp принадлежит IBM. Для физика Terraform полезен, когда под расчёт или учебный класс на время поднимаются облачные машины; на собственном оборудовании лаборатории он не нужен.
Инфраструктура как код и её пределы
Ansible, Terraform и файлы определения образов реализуют один подход — инфраструктуру как код: описание хранится в git, изменения проходят ревью и пробный прогон (plan, --check), применяются автоматически и повторяемо. Различают изменяемую инфраструктуру, в которой работающие машины приводятся к новому состоянию (так работает Ansible), и неизменяемую, в которой вместо изменения создаётся новый экземпляр из нового образа (образ контейнера, образ виртуальной машины, файл SIF). Неизменяемость упрощает воспроизведение и откат, но требует пересборки образа при каждом изменении.
У подхода есть цена. Инструменты требуют освоения, и описание, в котором разбирается один человек, не лучше ручной настройки. Инструменты меняют лицензии и владельцев: смена лицензии Terraform в 2023 году и объявленный в 2024 году перевод новых сборок Puppet под лицензионное соглашение вызвали появление ответвлений OpenTofu и OpenVox. Доступ к внешним реестрам пакетов и образов может прекратиться. Поэтому копии пакетов, колёс и образов, необходимых для расчёта, хранят у себя: учебный стенд, использованный в этой главе, устанавливался целиком из заранее скачанных и проверенных по контрольным суммам файлов, без доступа к сети.
Итоги
Расчёт переносится на кластер в несколько шагов. Независимые части ставятся в очередь массивом задач, ресурсы запрашиваются по измерениям, а зерно каждой задачи выводится из её номера. Связанный расчёт делится между процессами MPI так, чтобы обмена было мало относительно счёта, а ускорение измеряется и сравнивается с законом Амдала. Окружение расчёта фиксируется образом Apptainer, который запускается на узлах без прав администратора, а описание образа хранится вместе с результатом. Машины, на которых всё это работает, описываются кодом с пробным прогоном и повтором без изменений. Каждый из этих шагов обеспечивает одно и то же свойство — возможность получить тот же результат снова, на другой машине и через годы.
Полезные ссылки
- Документация Slurm: быстрый старт для пользователей,
sbatch,srun, массивы задач, руководство по MPI. - MPI for Python: установка, учебник, справочник.
- Стандарт MPI 5.0 и документация Open MPI и MPICH.
- Документация Apptainer: файлы определения, привязка каталогов, GPU и MPI.
- Документация Ansible: плейбуки, роли, порядок старшинства переменных.
- Kubernetes и OpenTofu.
Коды и скрипты
Всё, изложенное в предыдущих частях, объединяется в настоящей части.
В ней разбираются реальные программы, а не примеры, придуманные для учебника: почти все они выполняют физические расчёты в институтах СО РАН, а последняя, веб-сервис без физического содержания, приведена ради одной архитектуры. Каждая из программ имеет свою историю и свои компромиссы, продиктованные задачей: в одном случае важнее скорость, в другом точность, в третьем возможность объяснить результат коллеге спустя год.
Сначала решается уравнение огибающей пучка, после чего та же задача рассматривается с другой стороны, через генетический алгоритм. Далее разбирается разностная схема для динамики частиц в электрических и магнитных полях. Показано, как матрица отклика и нейронная сеть совместно осуществляют коррекцию орбиты в ускорителе. Кодом строится трёхмерная модель установки, собранная из типовых элементов. Рассматриваются цифровой двойник ускорителя, мультиагентный помощник оператора и ограничения автономного исследователя на языковых моделях. В заключение разбирается устройство асинхронного веб-сервиса, поскольку данные эксперимента сегодня чаще передаются по HTTP, чем копируются на внешний носитель.
Эти главы можно читать как собрание приёмов, позволяющее увидеть, из чего состоит чужой рабочий код, однако полезнее читать их критически, отмечая, что следовало бы сделать иначе. Ни одна из этих программ не является идеальной. Идеальных программ в науке не бывает, бывают работающие.
Слайды к главе. Материал глав части, кроме последней, изложен также в лекции «Разбор реальных кодов» (огибающая пучка и генетический алгоритм, динамика макрочастиц, коррекция орбиты, схема установки и цифровой двойник, системы на языковых моделях в пультовой, общие уроки и итоговый проект) с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Уравнение огибающей Капчинского—Владимирского для пучка заряженных частиц
В настоящей главе сначала рассматривается теория, а затем на Python выполняется расчёт огибающей электронного пучка в линейном ускорителе, состоящем из соленоидов и резонаторов. Выкладки следуют классическим монографиям по физике пучков заряженных частиц [35, 36]; подробности, опущенные здесь, приведены там.
Слайды к главе. Уравнение огибающей в коде библиотеки KENV, устройство пакета и проверка результата решателя изложены также в первой части лекции «Разбор реальных кодов» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Уравнения Максвелла
Объёмная плотность тока пучка \(\jmath = \rho\upsilon\), где \(\rho\) — объёмная плотность заряда, \(\upsilon\) — скорость пучка. Запишем дифференциальные уравнения Максвелла. $$ \nabla \vec{D} = 4\pi\rho, $$ $$ \nabla\times \vec{H} = \frac{4\pi\vec{\jmath}}{c}, $$ где \(\vec{D}\) — индукция электрического поля, \(\vec{H}\) — напряжённость магнитного поля, \(c\) — скорость света. Используем теорему Стокса об интегрировании дифференциальных форм, чтобы получить уравнения Максвелла, записанные в интегральной форме. $$ \oint\limits_{\partial V} \vec{D}\vec{dS} = 4\pi\int\limits_V\rho{dV}, $$ $$ \oint\limits_{\partial S} \vec{H}\vec{dl} = \frac{4\pi}{c}\int\limits_S\vec{\jmath}\vec{dS}. $$
Найдём \(D_r\) для цилиндрического пучка радиуса \(a\), заполненного зарядом с постоянной плотностью \(\rho_0\). $$ D_r = \frac{4\pi}{r}\int\limits^r_0\rho(\xi)\xi d\xi = \begin{equation*} \begin{cases} \displaystyle 2\pi\rho_0 r, r < a, \ \displaystyle \frac{2\pi\rho_0 a^2}{r}, r > a. \end{cases} \end{equation*} $$
Учитывая, что в вакууме \(D = E\), \(H = B\), \(E\) — напряжённость электрического поля, \(B\) — индукция магнитного поля, и в плоском пространстве в декартовой системе координат \(H_\alpha = \beta D_r\), где \(\displaystyle\beta = \frac{\upsilon}{c}\), радиальная компонента силы \(F_r\) из силы Лоренца \(\vec{F} = e\vec{E} + \displaystyle\frac{e}{c}\vec{\upsilon}\times\vec{B}\) записывается так. $$ F_r = eE_r - \frac{e\upsilon_z B_\alpha}{c} = eE_r(1-\displaystyle \frac{\upsilon^2}{c^2}) = \displaystyle \frac{eE_r}{\gamma^2}. $$ Полезно выразить поле через ток $$ I = \rho_0\upsilon\pi a^2, $$ тогда $$ E_r = \begin{equation*} \begin{cases} \displaystyle \frac{2 I r}{a^2\upsilon}, r < a, \ \displaystyle \frac{2 I}{r\upsilon}, r > a. \end{cases} \end{equation*} $$
Уравнения движения
Второй закон Ньютона \(\dot p_r = F_r\), используем параксиальное приближение, считая \(\gamma = const\). $$ \gamma m \ddot r = \displaystyle \frac{eE_r}{\gamma^2} = \displaystyle \frac{2 I e}{\gamma^2 a^2 \upsilon} r, $$ получено линейное уравнение, однако, поскольку движутся все частицы сразу, необходимо учесть, что \(a = a(t)\). Решение линейного уравнения, выписанного выше, можно представить как линейное преобразование фазовой плоскости, а поскольку отрезок на фазовой плоскости при невырожденном линейном преобразовании переходит в отрезок, его можно охарактеризовать одной точкой. Поэтому выберем крайнюю точку \(r = a\), которая и представляет крайнюю траекторию. $$ \gamma m \ddot r = \displaystyle \frac{2 I e}{\gamma^2 a \upsilon}. $$ Перейдём к дифференцированию по \(z\), учитывая, что \(\displaystyle dt = \frac{dz}{v}\), и тогда $$ a'' = \displaystyle \frac{e}{a}\frac{2I}{m\gamma^3\upsilon^3}. $$ Введём характерный альфвеновский ток \(I_a = \displaystyle \frac{mc^3}{e} \approx\) 17 кА, и тогда $$ a'' = \displaystyle \frac{2I}{I_a (\beta\gamma)^3} \frac{1}{a}. $$ Учтём внешнюю фокусировку, предполагая суперпозицию полей (что верно не всегда: в нелинейных средах суперпозиция не выполняется), и получим $$ a'' + k(z)a - \displaystyle \frac{2I}{I_a (\beta\gamma)^3} \frac{1}{a} = 0, $$ что напоминает уравнение огибающей $$ w'' + kw - \displaystyle \frac{1}{w^3} = 0 ,$$ где \( w =\displaystyle \sqrt \beta .\)
Уравнения огибающей для эллиптического пучка с распределением Капчинского—Владимирского с внешней фокусировкой линейными полями
Запишем распределение Капчинского—Владимирского. $$ f = A\delta(1 - \displaystyle\frac{\beta_x x'^2 + 2\alpha_x x x' + \gamma_x x^2}{\epsilon_x} - \displaystyle\frac{\beta_y y'^2 + 2\alpha_y y y' + \gamma_y y^2}{\epsilon_y} ), $$ где \(A\) — нормировочная постоянная, задаваемая полным числом частиц, а квадратичная форма \(\beta_x x'^2 + 2\alpha_x x x' + \gamma_x x^2\) и аналогичная форма по \(y\), стоящие под дельта-функцией, представляют собой инварианты Куранта—Снайдера, отнесённые к эмиттансам \(\epsilon_x\) и \(\epsilon_y\); дельта-функция помещает все частицы на поверхность постоянного инварианта. Полуоси эллипса равны $$ a = \sqrt{\epsilon_x \beta_x}, b = \sqrt{\epsilon_y \beta_y}. $$ Поле получается линейно внутри заряженного эллиптического цилиндра. $$ E_x = \displaystyle \frac{4I}{\upsilon}\frac{x}{a(a+b)}, $$ $$ E_y = \displaystyle \frac{4I}{\upsilon}\frac{y}{b(a+b)}. $$ Проверим, что \(\nabla \vec{E} = 4\pi\rho:\) $$ \displaystyle I = \rho \upsilon \pi ab, $$ $$ \nabla \vec{E} = \displaystyle \frac{4I(a+b)}{\upsilon(a+b)ab} = \displaystyle \frac{4I}{\upsilon ab} = 4\pi\rho. $$ Так как поля линейные, они складываются с полями фокусирующей линзы, рассчитанными отдельно. Подставим в уравнение огибающей \(\displaystyle a = \sqrt \epsilon_x w_x, b = \sqrt \epsilon_y w_y:\) $$ a'' + k_{xt} a - \frac{\epsilon_x^2}{a^3} = 0, $$ где \(k_{xt} = k_x - k_{xsc}\) — полная жёсткость, \(k_x\) — жёсткость линзы, а \(\displaystyle k_{xsc} = \frac{4I}{I_a (\beta\gamma)^3}\frac{1}{a(a+b)}.\) В итоге получаем систему уравнений, связанных через пространственный заряд. $$ \begin{equation*} \begin{cases} \displaystyle a'' + k_xa - \frac{4I}{I_a (\beta\gamma)^3}\frac{1}{(a+b)} - \frac{\epsilon_x^2}{a^3} = 0 , \\ \displaystyle b'' + k_yb - \frac{4I}{I_a (\beta\gamma)^3}\frac{1}{(a+b)} - \frac{\epsilon_y^2}{b^3} = 0. \end{cases} \end{equation*} $$
Количественный критерий применимости приближения ламинарности течения
Эта система учитывает два эффекта, мешающих сфокусировать пучок в точку: конечность эмиттанса и пространственный заряд. В уравнение они входят соседними членами, поэтому допускают непосредственное сравнение. При малом токе \(I\) отталкивание слабое, при большом — сильное, и тогда эмиттансом можно пренебречь, а течение считать ламинарным. Количественным критерием ламинарности является сравнение этих двух членов. $$ \displaystyle \sqrt{\frac{2I}{I_a(\beta\gamma)^3}} \gg \sqrt{\frac{\epsilon_x}{\beta_x}}. $$ Видно, что пространственный заряд сильнее сказывается там, где \(\beta_x\)-функция больше, а вблизи фокуса его влияние пренебрежимо мало.
Теорема Буша
Теорема Буша связывает угловую скорость заряженной частицы, движущейся в аксиально-симметричном магнитном поле, с магнитным потоком через окружность, проведённую через точку, где находится частица, с центром на оси.
Рассмотрим заряд \(q\), движущийся в магнитном поле \(\vec B = (B_r,0,B_z)\). Приравняем \(\theta\)-составляющую силы Лоренца к производной момента импульса по времени, делённой на \(r\). $$ F_\theta = -q(\dot r B_z - \dot z B_r) = \frac{d}{rdt}(\gamma m r^2 \dot \theta). $$ Поток, пронизывающий площадь, охваченную окружностью радиуса \(r\), центр которой расположен на оси, а сама она проходит через точку, в которой расположен заряд, записывается в виде \(\psi = \int\limits^r_0 2\pi r B_z dr\). Когда частица перемещается на \(\vec{dl} = (dr,dz)\), скорость изменения потока, охваченного этой окружностью, можно найти из второго уравнения Максвелла \(\nabla \vec{B} = 0.\) Таким образом, $$ \dot\psi = 2\pi r (-B_r \dot z + B_z \dot r). $$ После интегрирования по времени отсюда получаем $$ \dot \theta = (-\frac{q}{2\pi \gamma m r^2})(\psi - \psi_0). $$
Уравнение параксиального луча
Чтобы вывести уравнение параксиального луча для системы с аксиальной симметрией при уже сделанных допущениях, приравняем силу радиального ускорения электрическим и магнитным силам внешних полей. Здесь \(\gamma = \gamma(t).\) $$ \frac{d}{dt}(\gamma m \dot r) - \gamma m r (\dot \theta)^2 = q(E_r + r\dot \theta B_z). $$ Применим теорему Буша и независимость \(B_z\) от \(r:\) $$ -\dot \theta = \frac{q}{2\gamma m}(B_z - \frac{\psi_0}{\pi r^2}). $$ Исключим \(\dot \theta\) и подставим \(\displaystyle \dot \gamma \approx \frac {\beta q E_z }{mc}\). $$ \ddot r + \frac{\beta q E_z}{\gamma m c} \dot r + \frac{q^2 B^2_z}{4\gamma ^2 m^2} r - \frac{ q^2 \psi^2_0}{4\pi^2\gamma^2 m^2} (\frac{1}{r^3}) - \frac{q E_r}{\gamma m } = 0. $$
Уравнение огибающей для круглого и эллиптического пучка
Учитывая, что $$ \dot r = \beta c r', $$ $$ \ddot r = r'' (\dot z)^2 + r'\ddot z \approx r'' \beta^2 c^2 + r' \beta' \beta c^2. $$ Если же в области пучка зарядов нет, то, разлагая в ряд Тейлора в окрестности оси и оставляя только первый член, с учётом $$\nabla \vec{E} = 0$$ получаем $$ E_r = -0.5 r E'_z \approx - 0.5 r \gamma'' mc^2/q. $$ Теперь можно окончательно записать уравнение огибающей круглого пучка радиуса \(r\), взятого с распределением Капчинского—Владимирского, при внешней фокусировке линейными полями. $$ \displaystyle r'' + \frac{1}{\beta^2\gamma} \gamma' r' + \frac{1}{2\beta^2\gamma}\gamma''r + kr - \frac{2I}{I_a (\beta\gamma)^3}\frac{1}{r} - \frac{\epsilon^2}{r^3} = 0 ; $$ и для эллиптического пучка $$ \begin{equation*} \begin{cases} \displaystyle a'' + \frac{1}{\beta^2\gamma} \gamma' a' + \frac{1}{2\beta^2\gamma}\gamma''a + k_xa - \frac{4I}{I_a (\beta\gamma)^3}\frac{1}{(a+b)} - \frac{\epsilon_x^2}{a^3} = 0 , \\ \displaystyle b'' + \frac{1}{\beta^2\gamma} \gamma' b' + \frac{1}{2\beta^2\gamma}\gamma''b + k_yb - \frac{4I}{I_a (\beta\gamma)^3}\frac{1}{(a+b)} - \frac{\epsilon_y^2}{b^3} = 0. \end{cases} \end{equation*} $$
Магнитные линзы
Фокусировка пучка осуществляется соленоидами и магнитными квадрупольными линзами.
Соленоиды
\(k_x = k_y = k_s\) — жёсткость соленоида. $$ k_s = \left ( \frac{eB_z}{2m_ec\beta\gamma} \right )^2 = \left ( \frac{e B_z}{2\beta\gamma\cdot 0.511\cdot 10^6 e \cdot \mathrm{volt}/c} \right )^2 = \left ( \frac{cB_z[\mathrm{T}]}{2\beta\gamma\cdot 0.511\cdot 10^6 \cdot \mathrm{volt}} \right )^2. $$
Квадруполи
\(k_q = \displaystyle\frac{eG}{p}\) — жёсткость квадруполя, где \(G = \displaystyle\frac{\partial B_x}{\partial y} = \displaystyle\frac{\partial B_y}{\partial x}\) — градиент магнитного поля, причём \(k_x = k_q, k_y = -k_q.\) $$ k_q = \left ( \frac{eG}{m_ec\beta\gamma} \right ) = \left ( \frac{eG}{\beta\gamma\cdot 0.511\cdot 10^6 e \cdot \mathrm{volt}/c} \right ) = \left ( \frac{cG}{\beta\gamma\cdot 0.511\cdot 10^6 \cdot \mathrm{volt}} \right ). $$
Продольная динамика пучка
Продольную динамику удобно рассчитывать отдельно от поперечной, находя сначала энергию пучка как функцию \(z\), а затем подставляя её в уравнение огибающей в виде готовой функции. Скорость электрона достаточно близка к скорости света, поэтому его продольная координата \(z \approx ct\), а импульс \(p_z \approx \gamma mc\), и тогда
$$ \frac{d\gamma}{dz} \approx \frac{eE_z}{mc^2}, $$
откуда задача сводится к однократному интегрированию \(E_z(z)\) вдоль тракта. Численные значения подставляются в разделе с расчётом на Python.
Решение уравнения огибающей для эллиптического пучка с фокусирующими элементами
Уравнение огибающей эллиптического пучка с полуосями \(a, b\) и распределением Капчинского—Владимирского при внешней фокусировке линейными полями, выведенное выше, имеет следующий вид. $$ \begin{equation*} \begin{cases} \displaystyle a'' + \frac{1}{\beta^2\gamma} \gamma' a' + \frac{1}{2\beta^2\gamma}\gamma''a + k_qa - \frac{2P}{(a+b)} - \frac{\epsilon_x^2}{a^3} = 0 , \\ \displaystyle b'' + \frac{1}{\beta^2\gamma} \gamma' b' + \frac{1}{2\beta^2\gamma}\gamma''b - k_qb - \frac{2P}{(a+b)} - \frac{\epsilon_y^2}{b^3} = 0. \end{cases} \end{equation*} $$
Пусть \(\displaystyle x = \frac{da}{dz}, y = \frac{db}{dz}, \displaystyle \frac{d\gamma }{dz}\approx \frac{e E_z}{m c^2},\) тогда $$ \begin{matrix} \displaystyle \frac{dx}{dz}= - \frac{1}{\beta^2\gamma} \gamma' a' - \frac{1}{2\beta^2\gamma}\gamma''a - k_qa + \frac{2P}{(a+b)} + \frac{\epsilon_x^2}{a^3}\\ \displaystyle\frac{da}{dz} = x\\ \displaystyle \frac{dy}{dz}= - \frac{1}{\beta^2\gamma} \gamma' b' - \frac{1}{2\beta^2\gamma}\gamma''b + k_qb + \frac{2P}{(a+b)} + \frac{\epsilon_y^2}{b^3}\\ \displaystyle\frac{db}{dz} = y \end{matrix}. $$ Пусть
$$ \vec X = \begin{bmatrix} x \\ a \\ y \\ b \end{bmatrix}, $$
теперь составим дифференциальное уравнение \(X' = F(X)\).
Уравнение траектории для одной частицы
Векторный потенциал в соленоиде имеет только одну компоненту и выражается через заданное на оси поле \(B_z(z)\). $$ A_\phi (z,r)=\sum_{n=0}^{\infty} \dfrac{(-1)^n}{n!(n+1)!} B_z^{(2n)}(z)\left(\dfrac{r}{2}\right)^{2n+1}. $$ Здесь \(B_z^{(2n)}\) — производная порядка \(2n\) от поля на оси, так что нулевой член даёт \(A_\phi = B_z(z),r/2\), из которого дальше и получается параксиальное приближение. Следовательно, лагранжиан в цилиндрической системе координат имеет вид $$ L = -mc^2(1-\beta^2)^{1/2} + \dfrac{e}{c}A_\phi r \dot\phi. $$ Из аксиальной симметрии следует существование интеграла движения, связанного с обобщённым импульсом. $$ P_\phi = \gamma mr^2\dot\phi + \dfrac{e}{c} r A_\phi = \gamma mr^2\dot\phi_0. $$ Продифференцировав по \(z\), получим $$ \phi' - \phi_0' = -\dfrac{e}{pc}\dfrac{A_\phi}{r}. $$ И в параксиальном приближении $$ \phi' - \phi_0' = -\dfrac{e}{2pc}B_z(z). $$ Откуда $$ \delta \phi = -\int\dfrac{e}{2pc}B_z(z)dz. $$ Тогда и уравнения траектории в приведённых координатах принимают следующий вид. $$ \begin{equation*} \begin{cases} \displaystyle \tilde x'' + \frac{1}{\beta^2\gamma} \gamma'\tilde x' + \frac{1}{2\beta^2\gamma}\gamma''\tilde x + k_s \tilde x = 0 , \\ \displaystyle \tilde y'' + \frac{1}{\beta^2\gamma} \gamma'\tilde y' + \frac{1}{2\beta^2\gamma}\gamma''\tilde y +k_s \tilde y = 0, \end{cases} \end{equation*} $$
Расчёт в Python
Подключим библиотеки и настроим оформление графиков. Построение графиков осуществляется средствами HoloViews поверх matplotlib, в векторном формате и с широкими осями, поскольку все иллюстрации главы представляют собой протяжённые графики вдоль тракта.
import numpy as np
import holoviews as hv
hv.extension('matplotlib')
%output size=200 backend='matplotlib' fig='svg'
%opts Curve Scatter Area [fontsize={'title':14, 'xlabel':14, 'ylabel':14, 'ticks':14, 'legend': 14}]
%opts Area Curve [aspect=3 show_grid=True]
%opts Area (linewidth=1 alpha=0.25)
%opts Curve (linewidth=2 alpha=0.5)
import warnings
warnings.filterwarnings('ignore')


Зададим область счёта и шаг сетки вдоль оси ускорителя, от 0.7 до 15 метров с шагом 5 мм: на характерную ширину поля соленоида такой шаг даёт десятки точек, что позволяет безопасно интерполировать по ней.
dz = 0.005 # m
z_min = 0.7
z_max = 15
z = np.arange(z_min,z_max,dz) # m
Ускоритель представляется последовательностью элементов — соленоидов и ускоряющих зазоров — на общей оси. Каждый элемент характеризуется четырьмя параметрами: положением центра, максимумом поля, файлом с профилем поля вдоль оси и именем.
class Element:
def __init__(self, z0, MaxField, filename, name):
self.z0 = z0
self.MaxField = MaxField
self.filename = filename
self.name = name
Первыми задаются фокусирующие соленоиды. В таблице ниже первая колонка задаёт положение центра в метрах, вторая — максимум поля на оси в теслах. Три соленоида работают на полном поле (0.03 Тл), три практически выключены (1 мТл). Профиль \(B_z(z)\) у всех соленоидов один и тот же и хранится в общем файле: соленоиды одинаковы и различаются только током.
Bz_beamline = {}
for z0, B0, filename, name in [
# m T Unique name
[ 0.95, 0.001, 'input/fields/B_z(z).dat', 'Sol. 1' ],
[ 2.1, 0.03, 'input/fields/B_z(z).dat', 'Sol. 2' ],
[ 2.9077, 0.001, 'input/fields/B_z(z).dat', 'Sol. 3' ],
[ 4.0024, 0.03, 'input/fields/B_z(z).dat', 'Sol. 4' ],
[ 5.642, 0.03, 'input/fields/B_z(z).dat', 'Sol. 5' ],
[ 6.760, 0.001, 'input/fields/B_z(z).dat', 'Sol. 6' ],
]:
Bz_beamline[name] = Element(z0, B0, filename, name)
Элементы, собранные в словарь по имени, доступны напрямую: к любому из них можно обратиться по ключу.
Bz_beamline['Sol. 3'].z0
2.9077
Аналогично описываются ускоряющие резонаторы. Шесть резонаторов, каждый по −0.9 МВ/м, расположены через 1.382 метра во второй половине тракта; до седьмого метра пучок с входной энергией 2 МэВ только транспортируется, ускорение начинается дальше.
Ez_beamline = {}
for z0, E0, filename, name in [
# m MV/m Unique name
[ 7.456, -0.9, 'input/fields/E_z(z).dat', 'Cavity 3'],
[ 8.838, -0.9, 'input/fields/E_z(z).dat', 'Cavity 4'],
[ 10.220, -0.9, 'input/fields/E_z(z).dat', 'Cavity 5'],
[ 11.602, -0.9, 'input/fields/E_z(z).dat', 'Cavity 6'],
[ 12.984, -0.9, 'input/fields/E_z(z).dat', 'Cavity 7'],
[ 14.366, -0.9, 'input/fields/E_z(z).dat', 'Cavity 8'],
]:
Ez_beamline[name] = Element(z0, E0, filename, name)
Считывание профилей фокусирующего и ускоряющего поля
Профиль поля одного элемента хранится в текстовом файле в виде двух колонок: смещения от центра элемента и значения поля в долях максимума. Приведённая ниже функция проходит по всем элементам линейки, сдвигает профиль в положение элемента, умножает его на максимальное поле элемента и суммирует вклады в один массив на общей сетке.
FieldFiles представляет собой простейший кеш: файл читается с диска один раз, а не по разу на каждый соленоид. fill_value=(0, 0) вместе с bounds_error=False заставляет интерполятор возвращать ноль за пределами профиля вместо возбуждения ошибки; без этого было бы невозможно суммировать элементы, разнесённые по тракту.
from scipy import interpolate
FieldFiles = {} # buffer for field files
def read_field(beamline, z):
global FieldFiles
F = 0
for element in beamline.values():
if not (element.filename in FieldFiles):
print('Reading ' + element.filename)
FieldFiles[element.filename] = np.loadtxt(element.filename)
M = FieldFiles[element.filename]
z_data = M[:,0]
F_data = M[:,1]
f = interpolate.interp1d(
element.z0+z_data, element.MaxField*F_data,
fill_value=(0, 0), bounds_error=False
)
F = F + f(z)
return F
Рассчитаем суммарное поле шести соленоидов.
Bz = read_field(Bz_beamline, z)
Reading input/fields/B_z(z).dat
Строка «Reading …» напечатана один раз на шесть соленоидов, следовательно, кеш работает.
Решателю дифференциальных уравнений требуется не массив, а функция: он самостоятельно выбирает точки, в которых запрашивается поле, и эти точки не обязаны совпадать с узлами сетки. Поэтому массив Bz преобразуется в функцию Bz(z).
Bz = interpolate.interp1d(z, Bz, fill_value=(0, 0), bounds_error=False)
Проверим значение Bz вблизи центра второго соленоида.
Bz(2.11111)
array(0.02984419)
Получено около 30 мТл, что близко к максимуму второго соленоида, настроенного на 0.03 Тл, как и должно быть в 11 миллиметрах от его центра.
График суммарного поля \(B_z(z)\) позволяет убедиться, что соседние соленоиды не накладываются друг на друга и что в тракте не осталось протяжённых участков без фокусировки.
dim_z = hv.Dimension('z', unit='m', range=(0,z_max))
dim_Bz = hv.Dimension('Bz', unit='T', label='$B_z$')
z_Bz = hv.Area((z,Bz(z)), kdims=dim_z, vdims=dim_Bz)
z_Bz

С ускоряющим полем поступаем аналогично: профиль считывается из файла, вклады шести резонаторов суммируются, результат оборачивается в интерполянт и выводится на график. Функция read_field применима как к магнитному, так и к электрическому полю.
Ez = 1*read_field(Ez_beamline, z)
Ez = interpolate.interp1d(z, Ez, fill_value=(0, 0), bounds_error=False)
dim_Ez = hv.Dimension('Ez', unit='MV/m', label=r'$E_z$')
z_Ez = hv.Area((z,Ez(z)), kdims=dim_z, vdims=dim_Ez)
z_Ez

Продольная динамика пучка: расчёт
Энергия пучка рассчитывается независимо от огибающей, а в уравнение огибающей подставляется готовая функция \(\gamma(z)\). Скорость электрона близка к скорости света, поэтому \(z \approx ct\) и \(p_z \approx \gamma mc\), откуда следует
$$ \frac{d\gamma}{dz} \approx \frac{eE_z}{mc^2}, $$
и задача сводится к однократному интегрированию \(E_z(z)\).
Энергия на входе составляет 2 МэВ; релятивистский фактор при этом равен около 4.9. mc — энергия покоя электрона в мегаэлектронвольтах, поэтому энергии и импульсы далее выражаются в тех же единицах.
mc = 0.511 # MeV, энергия покоя электрона
#p_z = 2.459 # MeV/c
E_0 = 2.000 # MeV
gamma_0 = E_0/mc + 1 # Начальный релятивистский фактор пучка
#gamma_0 = p_z/mc
Интегрирование выполняется функцией cumulative_trapezoid: она вычисляет накопленную сумму трапеций и даёт \(\gamma\) во всех точках сетки, кроме первой. Знак минус перед Ez компенсирует знак поля в резонаторах (-0.9 МВ/м), так что энергия по тракту растёт.
from scipy import integrate
gamma = gamma_0 + integrate.cumulative_trapezoid(-Ez(z)/mc, z)
dim_gamma = hv.Dimension('gamma', label=r'$\gamma$', range=(0,None))
z_gamma = hv.Curve((z,gamma), kdims=dim_z, vdims=dim_gamma)
Совместим на одном рисунке энергию и ускоряющее поле, что позволяет увидеть, где пучок набирает энергию.
(z_gamma + z_Ez).cols(1)
IuNzI3MjMgNDM4LjQ0Mjg1IA0KTCA2NTIuNzI3MjMgLTAgDQpMIDAgLTAgDQp6DQoiIHN0eWxlPSJmaWxsOiNmZmZmZmY7Ii8+DQogIDwvZz4NCiAgPGcgaWQ9ImF4ZXNfMSI+DQogICA8ZyBpZD0icGF0Y2hfMiI+DQogICAgPHBhdGggZD0iTSAxNjYuMDI1NTc4IDE4NC40NTg4MDEgDQpMIDY0NS41MjcyMyAxODQuNDU4ODAxIA0KTCA2NDUuNTI3MjMgMjQuNjI0OTE3IA0KTCAxNjYuMDI1NTc4IDI0LjYyNDkxNyANCnoNCiIgc3R5bGU9ImZpbGw6I2ZmZmZmZjsiLz4NCiAgIDwvZz4NCiAgIDxnIGlkPSJsaW5lMmRfMSI+DQogICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3A5NmM3MjQxODUzKSIgZD0iTSAxODguNDgyMjM5IDkyLjgxNTk3OCANCkwgMzk2LjQyNjEyMiA5Mi43MTMyNTUgDQpMIDM5Ny43MDQ3OTMgOTIuNDc0MDYzIA0KTCAzOTguNjYzNzk2IDkyLjA4MDQ1MiANCkwgMzk5Ljc4MjYzMyA5MS4zNTA0NjcgDQpMIDQwMS4yMjExMzggOTAuMTA2MTI2IA0KTCA0MDMuOTM4MzE0IDg3LjM5MDA1OCANCkwgNDA4LjA5Mzk5NSA4My4yNjkwMjUgDQpMIDQwOS4zNzI2NjYgODIuMzA0NzE1IA0KTCA0MTAuMzMxNjcgODEuODQ4NTI0IA0KTCA0MTEuNDUwNTA3IDgxLjU5MTQ3NyANCkwgNDEzLjIwODY4IDgxLjQ3NDgzNCANCkwgNDE4Ljk2MjY5OSA4MS40NTA2MzQgDQpMIDQ0MC41NDAyNzQgODEuMzU0MDgxIA0KTCA0NDEuODE4OTQ1IDgxLjEyNzI0OCANCkwgNDQyLjc3Nzk0OCA4MC43NDgxNjQgDQpMIDQ0My44OTY3ODUgODAuMDMzNTUzIA0KTCA0NDUuMzM1MjkgNzguODAwNzQxIA0KTCA0NDguMDUyNDY2IDc2LjA5MDI1MyANCkwgNDUyLjIwODE0NyA3MS45NTk2NDMgDQpMIDQ1My40ODY4MTggNzAuOTc4NzQ4IA0KTCA0NTQuNDQ1ODIyIDcwLjUwNTg4NyANCkwgNDU1LjU2NDY1OSA3MC4yMzUxNjYgDQpMIDQ1Ny4xNjI5OTggNzAuMTE1ODI5IA0KTCA0NjEuOTU4MDE0IDcwLjA4NTQzNiANCkwgNDg0LjgxNDI2IDY5Ljk3OTU0MyANCkwgNDg2LjA5MjkzMSA2OS43MzQwMzkgDQpMIDQ4Ny4wNTE5MzQgNjkuMzMzMTM0IA0KTCA0ODguMTcwNzcxIDY4LjU5NTU3NiANCkwgNDg5LjYwOTI3NiA2Ny4zNDU3MDMgDQpMIDQ5Mi40ODYyODYgNjQuNDYyODM1IA0KTCA0OTYuNDgyMTMzIDYwLjUxMDk4NiANCkwgNDk3Ljc2MDgwNCA1OS41NTUyNjEgDQpMIDQ5OC43MTk4MDcgNTkuMTA3Mzg0IA0KTCA0OTkuODM4NjQ1IDU4Ljg1NzAzMiANCkwgNTAxLjU5NjgxNyA1OC43NDM5NTUgDQpMIDUwNy41MTA2NzEgNTguNzIwNTIgDQpMIDUyOC45Mjg0MTIgNTguNjIwOTEgDQpMIDUzMC4yMDcwODMgNTguMzg4MDMxIA0KTCA1MzEuMTY2MDg2IDU4LjAwMTcxMSANCkwgNTMyLjI4NDkyMyA1Ny4yNzkzNzEgDQpMIDUzMy43MjM0MjggNTYuMDQwNzcgDQpMIDUzNi40NDA2MDQgNTMuMzI3NDg4IA0KTCA1NDAuNTk2Mjg1IDQ5LjIwMTU2IA0KTCA1NDEuODc0OTU2IDQ4LjIyODk0MyANCkwgNTQyLjgzMzk1OSA0Ny43NjQ0MTcgDQpMIDU0My45NTI3OTcgNDcuNTAwNTQ1IA0KTCA1NDUuNzEwOTY5IDQ3LjM4MDMyMyANCkwgNTUxLjMwNTE1NSA0Ny4zNTUzNSANCkwgNTczLjIwMjM5NyA0Ny4yNDYwOSANCkwgNTc0LjQ4MTA2OCA0Ni45OTQwNzEgDQpMIDU3NS40NDAwNzIgNDYuNTg1ODQyIA0KTCA1NzYuNTU4OTA5IDQ1Ljg0MDcxOSANCkwgNTc3Ljk5NzQxNCA0NC41ODUzMTUgDQpMIDU4MC44NzQ0MjQgNDEuNjk5ODQgDQpMIDU4NC44NzAyNzEgMzcuNzUzMTI5IA0KTCA1ODYuMTQ4OTQyIDM2LjgwNTk5NCANCkwgNTg3LjEwNzk0NSAzNi4zNjY0MDQgDQpMIDU4OC4yMjY3ODIgMzYuMTIyNTM3IA0KTCA1ODkuOTg0OTU1IDM2LjAxMjgyNSANCkwgNTk2LjA1ODY0MyAzNS45OTAyNjEgDQpMIDYxNy4zMTY1NDkgMzUuODg3NTM3IA0KTCA2MTguNTk1MjIgMzUuNjQ4MzQ2IA0KTCA2MTkuNTU0MjI0IDM1LjI1NDczNSANCkwgNjIwLjY3MzA2MSAzNC41MjQ3NSANCkwgNjIyLjExMTU2NiAzMy4yODA0MDkgDQpMIDYyNC44Mjg3NDIgMzAuNTY0MzQxIA0KTCA2MjguOTg0NDIzIDI2LjQ0MzMwOCANCkwgNjMwLjI2MzA5NCAyNS40Nzg5OTggDQpMIDYzMS4yMjIwOTcgMjUuMDIyODA3IA0KTCA2MzIuMzQwOTM0IDI0Ljc2NTc2IA0KTCA2MzQuMDk5MTA3IDI0LjY0OTExNyANCkwgNjM5Ljg1MzEyNyAyNC42MjQ5MTcgDQpMIDY0NS4yODc0NzkgMjQuNjI0OTE3IA0KTCA2NDUuMjg3NDc5IDI0LjYyNDkxNyANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6IzMwYTJkYTtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLW9wYWNpdHk6MC41O3N0cm9rZS13aWR0aDoyOyIvPg0KICAgPC9nPg0KICAgPGcgaWQ9Im1hdHBsb3RsaWIuYXhpc18xIj4NCiAgICA8ZyBpZD0ieHRpY2tfMSI+DQogICAgIDxnIGlkPSJsaW5lMmRfMiI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDk2YzcyNDE4NTMpIiBkPSJNIDE2Ni4wMjU1NzggMTg0LjQ1ODgwMSANCkwgMTY2LjAyNTU3OCAyNC42MjQ5MTcgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF8zIj4NCiAgICAgIDxkZWZzPg0KICAgICAgIDxwYXRoIGQ9Ik0gMCAwIA0KTCAwIDMuNSANCiIgaWQ9Im0xOTJiN2RiNzc0IiBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgIDwvZGVmcz4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIxNjYuMDI1NTc4IiB4bGluazpocmVmPSIjbTE5MmI3ZGI3NzQiIHk9IjE4NC40NTg4MDEiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8xIj4NCiAgICAgIDwhLS0gMCAtLT4NCiAgICAgIDxkZWZzPg0KICAgICAgIDxwYXRoIGQ9Ik0gMzEuNzgxMjUgNjYuNDA2MjUgDQpRIDI0LjE3MTg3NSA2Ni40MDYyNSAyMC4zMjgxMjUgNTguOTA2MjUgDQpRIDE2LjUgNTEuNDIxODc1IDE2LjUgMzYuMzc1IA0KUSAxNi41IDIxLjM5MDYyNSAyMC4zMjgxMjUgMTMuODkwNjI1IA0KUSAyNC4xNzE4NzUgNi4zOTA2MjUgMzEuNzgxMjUgNi4zOTA2MjUgDQpRIDM5LjQ1MzEyNSA2LjM5MDYyNSA0My4yODEyNSAxMy44OTA2MjUgDQpRIDQ3LjEyNSAyMS4zOTA2MjUgNDcuMTI1IDM2LjM3NSANClEgNDcuMTI1IDUxLjQyMTg3NSA0My4yODEyNSA1OC45MDYyNSANClEgMzkuNDUzMTI1IDY2LjQwNjI1IDMxLjc4MTI1IDY2LjQwNjI1IA0Keg0KTSAzMS43ODEyNSA3NC4yMTg3NSANClEgNDQuMDQ2ODc1IDc0LjIxODc1IDUwLjUxNTYyNSA2NC41MTU2MjUgDQpRIDU2Ljk4NDM3NSA1NC44MjgxMjUgNTYuOTg0Mzc1IDM2LjM3NSANClEgNTYuOTg0Mzc1IDE3Ljk2ODc1IDUwLjUxNTYyNSA4LjI2NTYyNSANClEgNDQuMDQ2ODc1IC0xLjQyMTg3NSAzMS43ODEyNSAtMS40MjE4NzUgDQpRIDE5LjUzMTI1IC0xLjQyMTg3NSAxMy4wNjI1IDguMjY1NjI1IA0KUSA2LjU5Mzc1IDE3Ljk2ODc1IDYuNTkzNzUgMzYuMzc1IA0KUSA2LjU5Mzc1IDU0LjgyODEyNSAxMy4wNjI1IDY0LjUxNTYyNSANClEgMTkuNTMxMjUgNzQuMjE4NzUgMzEuNzgxMjUgNzQuMjE4NzUgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTQ4Ii8+DQogICAgICA8L2RlZnM+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxNjEuNTcxODI4IDIwMi4wOTY2MTQpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDgiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieHRpY2tfMiI+DQogICAgIDxnIGlkPSJsaW5lMmRfNCI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDk2YzcyNDE4NTMpIiBkPSJNIDIyOS45NTkxMzIgMTg0LjQ1ODgwMSANCkwgMjI5Ljk1OTEzMiAyNC42MjQ5MTcgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF81Ij4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIyMjkuOTU5MTMyIiB4bGluazpocmVmPSIjbTE5MmI3ZGI3NzQiIHk9IjE4NC40NTg4MDEiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8yIj4NCiAgICAgIDwhLS0gMiAtLT4NCiAgICAgIDxkZWZzPg0KICAgICAgIDxwYXRoIGQ9Ik0gMTkuMTg3NSA4LjI5Njg3NSANCkwgNTMuNjA5Mzc1IDguMjk2ODc1IA0KTCA1My42MDkzNzUgMCANCkwgNy4zMjgxMjUgMCANCkwgNy4zMjgxMjUgOC4yOTY4NzUgDQpRIDEyLjkzNzUgMTQuMTA5Mzc1IDIyLjYyNSAyMy44OTA2MjUgDQpRIDMyLjMyODEyNSAzMy42ODc1IDM0LjgxMjUgMzYuNTMxMjUgDQpRIDM5LjU0Njg3NSA0MS44NDM3NSA0MS40MjE4NzUgNDUuNTMxMjUgDQpRIDQzLjMxMjUgNDkuMjE4NzUgNDMuMzEyNSA1Mi43ODEyNSANClEgNDMuMzEyNSA1OC41OTM3NSAzOS4yMzQzNzUgNjIuMjUgDQpRIDM1LjE1NjI1IDY1LjkyMTg3NSAyOC42MDkzNzUgNjUuOTIxODc1IA0KUSAyMy45Njg3NSA2NS45MjE4NzUgMTguODEyNSA2NC4zMTI1IA0KUSAxMy42NzE4NzUgNjIuNzAzMTI1IDcuODEyNSA1OS40MjE4NzUgDQpMIDcuODEyNSA2OS4zOTA2MjUgDQpRIDEzLjc2NTYyNSA3MS43ODEyNSAxOC45Mzc1IDczIA0KUSAyNC4xMjUgNzQuMjE4NzUgMjguNDIxODc1IDc0LjIxODc1IA0KUSAzOS43NSA3NC4yMTg3NSA0Ni40ODQzNzUgNjguNTQ2ODc1IA0KUSA1My4yMTg3NSA2Mi44OTA2MjUgNTMuMjE4NzUgNTMuNDIxODc1IA0KUSA1My4yMTg3NSA0OC45MjE4NzUgNTEuNTMxMjUgNDQuODkwNjI1IA0KUSA0OS44NTkzNzUgNDAuODc1IDQ1LjQwNjI1IDM1LjQwNjI1IA0KUSA0NC4xODc1IDMzLjk4NDM3NSAzNy42NDA2MjUgMjcuMjE4NzUgDQpRIDMxLjEwOTM3NSAyMC40NTMxMjUgMTkuMTg3NSA4LjI5Njg3NSANCnoNCiIgaWQ9IkRlamFWdVNhbnMtNTAiLz4NCiAgICAgIDwvZGVmcz4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDIyNS41MDUzODIgMjAyLjA5NjYxNClzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy01MCIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgIDxnIGlkPSJ4dGlja18zIj4NCiAgICAgPGcgaWQ9ImxpbmUyZF82Ij4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwOTZjNzI0MTg1MykiIGQ9Ik0gMjkzLjg5MjY4NSAxODQuNDU4ODAxIA0KTCAyOTMuODkyNjg1IDI0LjYyNDkxNyANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzciPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjI5My44OTI2ODUiIHhsaW5rOmhyZWY9IiNtMTkyYjdkYjc3NCIgeT0iMTg0LjQ1ODgwMSIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzMiPg0KICAgICAgPCEtLSA0IC0tPg0KICAgICAgPGRlZnM+DQogICAgICAgPHBhdGggZD0iTSAzNy43OTY4NzUgNjQuMzEyNSANCkwgMTIuODkwNjI1IDI1LjM5MDYyNSANCkwgMzcuNzk2ODc1IDI1LjM5MDYyNSANCnoNCk0gMzUuMjAzMTI1IDcyLjkwNjI1IA0KTCA0Ny42MDkzNzUgNzIuOTA2MjUgDQpMIDQ3LjYwOTM3NSAyNS4zOTA2MjUgDQpMIDU4LjAxNTYyNSAyNS4zOTA2MjUgDQpMIDU4LjAxNTYyNSAxNy4xODc1IA0KTCA0Ny42MDkzNzUgMTcuMTg3NSANCkwgNDcuNjA5Mzc1IDAgDQpMIDM3Ljc5Njg3NSAwIA0KTCAzNy43OTY4NzUgMTcuMTg3NSANCkwgNC44OTA2MjUgMTcuMTg3NSANCkwgNC44OTA2MjUgMjYuNzAzMTI1IA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy01MiIvPg0KICAgICAgPC9kZWZzPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMjg5LjQzODkzNSAyMDIuMDk2NjE0KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTUyIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inh0aWNrXzQiPg0KICAgICA8ZyBpZD0ibGluZTJkXzgiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3A5NmM3MjQxODUzKSIgZD0iTSAzNTcuODI2MjM5IDE4NC40NTg4MDEgDQpMIDM1Ny44MjYyMzkgMjQuNjI0OTE3IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfOSI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iMzU3LjgyNjIzOSIgeGxpbms6aHJlZj0iI20xOTJiN2RiNzc0IiB5PSIxODQuNDU4ODAxIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfNCI+DQogICAgICA8IS0tIDYgLS0+DQogICAgICA8ZGVmcz4NCiAgICAgICA8cGF0aCBkPSJNIDMzLjAxNTYyNSA0MC4zNzUgDQpRIDI2LjM3NSA0MC4zNzUgMjIuNDg0Mzc1IDM1LjgyODEyNSANClEgMTguNjA5Mzc1IDMxLjI5Njg3NSAxOC42MDkzNzUgMjMuMzkwNjI1IA0KUSAxOC42MDkzNzUgMTUuNTMxMjUgMjIuNDg0Mzc1IDEwLjk1MzEyNSANClEgMjYuMzc1IDYuMzkwNjI1IDMzLjAxNTYyNSA2LjM5MDYyNSANClEgMzkuNjU2MjUgNi4zOTA2MjUgNDMuNTMxMjUgMTAuOTUzMTI1IA0KUSA0Ny40MDYyNSAxNS41MzEyNSA0Ny40MDYyNSAyMy4zOTA2MjUgDQpRIDQ3LjQwNjI1IDMxLjI5Njg3NSA0My41MzEyNSAzNS44MjgxMjUgDQpRIDM5LjY1NjI1IDQwLjM3NSAzMy4wMTU2MjUgNDAuMzc1IA0Keg0KTSA1Mi41OTM3NSA3MS4yOTY4NzUgDQpMIDUyLjU5Mzc1IDYyLjMxMjUgDQpRIDQ4Ljg3NSA2NC4wNjI1IDQ1LjA5Mzc1IDY0Ljk4NDM3NSANClEgNDEuMzEyNSA2NS45MjE4NzUgMzcuNTkzNzUgNjUuOTIxODc1IA0KUSAyNy44MjgxMjUgNjUuOTIxODc1IDIyLjY3MTg3NSA1OS4zMjgxMjUgDQpRIDE3LjUzMTI1IDUyLjczNDM3NSAxNi43OTY4NzUgMzkuNDA2MjUgDQpRIDE5LjY3MTg3NSA0My42NTYyNSAyNC4wMTU2MjUgNDUuOTIxODc1IA0KUSAyOC4zNzUgNDguMTg3NSAzMy41OTM3NSA0OC4xODc1IA0KUSA0NC41NzgxMjUgNDguMTg3NSA1MC45NTMxMjUgNDEuNTE1NjI1IA0KUSA1Ny4zMjgxMjUgMzQuODU5Mzc1IDU3LjMyODEyNSAyMy4zOTA2MjUgDQpRIDU3LjMyODEyNSAxMi4xNTYyNSA1MC42ODc1IDUuMzU5Mzc1IA0KUSA0NC4wNDY4NzUgLTEuNDIxODc1IDMzLjAxNTYyNSAtMS40MjE4NzUgDQpRIDIwLjM1OTM3NSAtMS40MjE4NzUgMTMuNjcxODc1IDguMjY1NjI1IA0KUSA2Ljk4NDM3NSAxNy45Njg3NSA2Ljk4NDM3NSAzNi4zNzUgDQpRIDYuOTg0Mzc1IDUzLjY1NjI1IDE1LjE4NzUgNjMuOTM3NSANClEgMjMuMzkwNjI1IDc0LjIxODc1IDM3LjIwMzEyNSA3NC4yMTg3NSANClEgNDAuOTIxODc1IDc0LjIxODc1IDQ0LjcwMzEyNSA3My40ODQzNzUgDQpRIDQ4LjQ4NDM3NSA3Mi43NSA1Mi41OTM3NSA3MS4yOTY4NzUgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTU0Ii8+DQogICAgICA8L2RlZnM+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgzNTMuMzcyNDg5IDIwMi4wOTY2MTQpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNTQiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieHRpY2tfNSI+DQogICAgIDxnIGlkPSJsaW5lMmRfMTAiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3A5NmM3MjQxODUzKSIgZD0iTSA0MjEuNzU5NzkyIDE4NC40NTg4MDEgDQpMIDQyMS43NTk3OTIgMjQuNjI0OTE3IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfMTEiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjQyMS43NTk3OTIiIHhsaW5rOmhyZWY9IiNtMTkyYjdkYjc3NCIgeT0iMTg0LjQ1ODgwMSIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzUiPg0KICAgICAgPCEtLSA4IC0tPg0KICAgICAgPGRlZnM+DQogICAgICAgPHBhdGggZD0iTSAzMS43ODEyNSAzNC42MjUgDQpRIDI0Ljc1IDM0LjYyNSAyMC43MTg3NSAzMC44NTkzNzUgDQpRIDE2LjcwMzEyNSAyNy4wOTM3NSAxNi43MDMxMjUgMjAuNTE1NjI1IA0KUSAxNi43MDMxMjUgMTMuOTIxODc1IDIwLjcxODc1IDEwLjE1NjI1IA0KUSAyNC43NSA2LjM5MDYyNSAzMS43ODEyNSA2LjM5MDYyNSANClEgMzguODEyNSA2LjM5MDYyNSA0Mi44NTkzNzUgMTAuMTcxODc1IA0KUSA0Ni45MjE4NzUgMTMuOTY4NzUgNDYuOTIxODc1IDIwLjUxNTYyNSANClEgNDYuOTIxODc1IDI3LjA5Mzc1IDQyLjg5MDYyNSAzMC44NTkzNzUgDQpRIDM4Ljg3NSAzNC42MjUgMzEuNzgxMjUgMzQuNjI1IA0Keg0KTSAyMS45MjE4NzUgMzguODEyNSANClEgMTUuNTc4MTI1IDQwLjM3NSAxMi4wMzEyNSA0NC43MTg3NSANClEgOC41IDQ5LjA3ODEyNSA4LjUgNTUuMzI4MTI1IA0KUSA4LjUgNjQuMDYyNSAxNC43MTg3NSA2OS4xNDA2MjUgDQpRIDIwLjk1MzEyNSA3NC4yMTg3NSAzMS43ODEyNSA3NC4yMTg3NSANClEgNDIuNjcxODc1IDc0LjIxODc1IDQ4Ljg3NSA2OS4xNDA2MjUgDQpRIDU1LjA3ODEyNSA2NC4wNjI1IDU1LjA3ODEyNSA1NS4zMjgxMjUgDQpRIDU1LjA3ODEyNSA0OS4wNzgxMjUgNTEuNTMxMjUgNDQuNzE4NzUgDQpRIDQ4IDQwLjM3NSA0MS43MDMxMjUgMzguODEyNSANClEgNDguODI4MTI1IDM3LjE1NjI1IDUyLjc5Njg3NSAzMi4zMTI1IA0KUSA1Ni43ODEyNSAyNy40ODQzNzUgNTYuNzgxMjUgMjAuNTE1NjI1IA0KUSA1Ni43ODEyNSA5LjkwNjI1IDUwLjMxMjUgNC4yMzQzNzUgDQpRIDQzLjg0Mzc1IC0xLjQyMTg3NSAzMS43ODEyNSAtMS40MjE4NzUgDQpRIDE5LjczNDM3NSAtMS40MjE4NzUgMTMuMjUgNC4yMzQzNzUgDQpRIDYuNzgxMjUgOS45MDYyNSA2Ljc4MTI1IDIwLjUxNTYyNSANClEgNi43ODEyNSAyNy40ODQzNzUgMTAuNzgxMjUgMzIuMzEyNSANClEgMTQuNzk2ODc1IDM3LjE1NjI1IDIxLjkyMTg3NSAzOC44MTI1IA0Keg0KTSAxOC4zMTI1IDU0LjM5MDYyNSANClEgMTguMzEyNSA0OC43MzQzNzUgMjEuODQzNzUgNDUuNTYyNSANClEgMjUuMzkwNjI1IDQyLjM5MDYyNSAzMS43ODEyNSA0Mi4zOTA2MjUgDQpRIDM4LjE0MDYyNSA0Mi4zOTA2MjUgNDEuNzE4NzUgNDUuNTYyNSANClEgNDUuMzEyNSA0OC43MzQzNzUgNDUuMzEyNSA1NC4zOTA2MjUgDQpRIDQ1LjMxMjUgNjAuMDYyNSA0MS43MTg3NSA2My4yMzQzNzUgDQpRIDM4LjE0MDYyNSA2Ni40MDYyNSAzMS43ODEyNSA2Ni40MDYyNSANClEgMjUuMzkwNjI1IDY2LjQwNjI1IDIxLjg0Mzc1IDYzLjIzNDM3NSANClEgMTguMzEyNSA2MC4wNjI1IDE4LjMxMjUgNTQuMzkwNjI1IA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy01NiIvPg0KICAgICAgPC9kZWZzPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNDE3LjMwNjA0MiAyMDIuMDk2NjE0KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTU2Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inh0aWNrXzYiPg0KICAgICA8ZyBpZD0ibGluZTJkXzEyIj4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwOTZjNzI0MTg1MykiIGQ9Ik0gNDg1LjY5MzM0NiAxODQuNDU4ODAxIA0KTCA0ODUuNjkzMzQ2IDI0LjYyNDkxNyANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzEzIj4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSI0ODUuNjkzMzQ2IiB4bGluazpocmVmPSIjbTE5MmI3ZGI3NzQiIHk9IjE4NC40NTg4MDEiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF82Ij4NCiAgICAgIDwhLS0gMTAgLS0+DQogICAgICA8ZGVmcz4NCiAgICAgICA8cGF0aCBkPSJNIDEyLjQwNjI1IDguMjk2ODc1IA0KTCAyOC41MTU2MjUgOC4yOTY4NzUgDQpMIDI4LjUxNTYyNSA2My45MjE4NzUgDQpMIDEwLjk4NDM3NSA2MC40MDYyNSANCkwgMTAuOTg0Mzc1IDY5LjM5MDYyNSANCkwgMjguNDIxODc1IDcyLjkwNjI1IA0KTCAzOC4yODEyNSA3Mi45MDYyNSANCkwgMzguMjgxMjUgOC4yOTY4NzUgDQpMIDU0LjM5MDYyNSA4LjI5Njg3NSANCkwgNTQuMzkwNjI1IDAgDQpMIDEyLjQwNjI1IDAgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTQ5Ii8+DQogICAgICA8L2RlZnM+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSg0NzYuNzg1ODQ2IDIwMi4wOTY2MTQpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDkiLz4NCiAgICAgICA8dXNlIHg9IjYzLjYyMzA0NyIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDgiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieHRpY2tfNyI+DQogICAgIDxnIGlkPSJsaW5lMmRfMTQiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3A5NmM3MjQxODUzKSIgZD0iTSA1NDkuNjI2ODk5IDE4NC40NTg4MDEgDQpMIDU0OS42MjY4OTkgMjQuNjI0OTE3IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfMTUiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjU0OS42MjY4OTkiIHhsaW5rOmhyZWY9IiNtMTkyYjdkYjc3NCIgeT0iMTg0LjQ1ODgwMSIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzciPg0KICAgICAgPCEtLSAxMiAtLT4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDU0MC43MTkzOTkgMjAyLjA5NjYxNClzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00OSIvPg0KICAgICAgIDx1c2UgeD0iNjMuNjIzMDQ3IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy01MCIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgIDxnIGlkPSJ4dGlja184Ij4NCiAgICAgPGcgaWQ9ImxpbmUyZF8xNiI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDk2YzcyNDE4NTMpIiBkPSJNIDYxMy41NjA0NTMgMTg0LjQ1ODgwMSANCkwgNjEzLjU2MDQ1MyAyNC42MjQ5MTcgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF8xNyI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iNjEzLjU2MDQ1MyIgeGxpbms6aHJlZj0iI20xOTJiN2RiNzc0IiB5PSIxODQuNDU4ODAxIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfOCI+DQogICAgICA8IS0tIDE0IC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNjA0LjY1Mjk1MyAyMDIuMDk2NjE0KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ5Ii8+DQogICAgICAgPHVzZSB4PSI2My42MjMwNDciIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTUyIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9InRleHRfOSI+DQogICAgIDwhLS0geiAobSkgLS0+DQogICAgIDxkZWZzPg0KICAgICAgPHBhdGggZD0iTSA1LjUxNTYyNSA1NC42ODc1IA0KTCA0OC4xODc1IDU0LjY4NzUgDQpMIDQ4LjE4NzUgNDYuNDg0Mzc1IA0KTCAxNC40MDYyNSA3LjE3MTg3NSANCkwgNDguMTg3NSA3LjE3MTg3NSANCkwgNDguMTg3NSAwIA0KTCA0LjI5Njg3NSAwIA0KTCA0LjI5Njg3NSA4LjIwMzEyNSANCkwgMzguMDkzNzUgNDcuNTE1NjI1IA0KTCA1LjUxNTYyNSA0Ny41MTU2MjUgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTEyMiIvPg0KICAgICAgPHBhdGggaWQ9IkRlamFWdVNhbnMtMzIiLz4NCiAgICAgIDxwYXRoIGQ9Ik0gMzEgNzUuODc1IA0KUSAyNC40Njg3NSA2NC42NTYyNSAyMS4yODEyNSA1My42NTYyNSANClEgMTguMTA5Mzc1IDQyLjY3MTg3NSAxOC4xMDkzNzUgMzEuMzkwNjI1IA0KUSAxOC4xMDkzNzUgMjAuMTI1IDIxLjMxMjUgOS4wNjI1IA0KUSAyNC41MTU2MjUgLTIgMzEgLTEzLjE4NzUgDQpMIDIzLjE4NzUgLTEzLjE4NzUgDQpRIDE1Ljg3NSAtMS43MDMxMjUgMTIuMjM0Mzc1IDkuMzc1IA0KUSA4LjU5Mzc1IDIwLjQ1MzEyNSA4LjU5Mzc1IDMxLjM5MDYyNSANClEgOC41OTM3NSA0Mi4yODEyNSAxMi4yMDMxMjUgNTMuMzEyNSANClEgMTUuODI4MTI1IDY0LjM1OTM3NSAyMy4xODc1IDc1Ljg3NSANCnoNCiIgaWQ9IkRlamFWdVNhbnMtNDAiLz4NCiAgICAgIDxwYXRoIGQ9Ik0gNTIgNDQuMTg3NSANClEgNTUuMzc1IDUwLjI1IDYwLjA2MjUgNTMuMTI1IA0KUSA2NC43NSA1NiA3MS4wOTM3NSA1NiANClEgNzkuNjQwNjI1IDU2IDg0LjI4MTI1IDUwLjAxNTYyNSANClEgODguOTIxODc1IDQ0LjA0Njg3NSA4OC45MjE4NzUgMzMuMDE1NjI1IA0KTCA4OC45MjE4NzUgMCANCkwgNzkuODkwNjI1IDAgDQpMIDc5Ljg5MDYyNSAzMi43MTg3NSANClEgNzkuODkwNjI1IDQwLjU3ODEyNSA3Ny4wOTM3NSA0NC4zNzUgDQpRIDc0LjMxMjUgNDguMTg3NSA2OC42MDkzNzUgNDguMTg3NSANClEgNjEuNjI1IDQ4LjE4NzUgNTcuNTYyNSA0My41NDY4NzUgDQpRIDUzLjUxNTYyNSAzOC45MjE4NzUgNTMuNTE1NjI1IDMwLjkwNjI1IA0KTCA1My41MTU2MjUgMCANCkwgNDQuNDg0Mzc1IDAgDQpMIDQ0LjQ4NDM3NSAzMi43MTg3NSANClEgNDQuNDg0Mzc1IDQwLjYyNSA0MS43MDMxMjUgNDQuNDA2MjUgDQpRIDM4LjkyMTg3NSA0OC4xODc1IDMzLjEwOTM3NSA0OC4xODc1IA0KUSAyNi4yMTg3NSA0OC4xODc1IDIyLjE1NjI1IDQzLjUzMTI1IA0KUSAxOC4xMDkzNzUgMzguODc1IDE4LjEwOTM3NSAzMC45MDYyNSANCkwgMTguMTA5Mzc1IDAgDQpMIDkuMDc4MTI1IDAgDQpMIDkuMDc4MTI1IDU0LjY4NzUgDQpMIDE4LjEwOTM3NSA1NC42ODc1IA0KTCAxOC4xMDkzNzUgNDYuMTg3NSANClEgMjEuMTg3NSA1MS4yMTg3NSAyNS40ODQzNzUgNTMuNjA5Mzc1IA0KUSAyOS43ODEyNSA1NiAzNS42ODc1IDU2IA0KUSA0MS42NTYyNSA1NiA0NS44MjgxMjUgNTIuOTY4NzUgDQpRIDUwIDQ5Ljk1MzEyNSA1MiA0NC4xODc1IA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy0xMDkiLz4NCiAgICAgIDxwYXRoIGQ9Ik0gOC4wMTU2MjUgNzUuODc1IA0KTCAxNS44MjgxMjUgNzUuODc1IA0KUSAyMy4xNDA2MjUgNjQuMzU5Mzc1IDI2Ljc4MTI1IDUzLjMxMjUgDQpRIDMwLjQyMTg3NSA0Mi4yODEyNSAzMC40MjE4NzUgMzEuMzkwNjI1IA0KUSAzMC40MjE4NzUgMjAuNDUzMTI1IDI2Ljc4MTI1IDkuMzc1IA0KUSAyMy4xNDA2MjUgLTEuNzAzMTI1IDE1LjgyODEyNSAtMTMuMTg3NSANCkwgOC4wMTU2MjUgLTEzLjE4NzUgDQpRIDE0LjUgLTIgMTcuNzAzMTI1IDkuMDYyNSANClEgMjAuOTA2MjUgMjAuMTI1IDIwLjkwNjI1IDMxLjM5MDYyNSANClEgMjAuOTA2MjUgNDIuNjcxODc1IDE3LjcwMzEyNSA1My42NTYyNSANClEgMTQuNSA2NC42NTYyNSA4LjAxNTYyNSA3NS44NzUgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTQxIi8+DQogICAgIDwvZGVmcz4NCiAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMzg3LjU5NzE4NSAyMTkuNjQ1OTg5KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtMTIyIi8+DQogICAgICA8dXNlIHg9IjUyLjQ5MDIzNCIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtMzIiLz4NCiAgICAgIDx1c2UgeD0iODQuMjc3MzQ0IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00MCIvPg0KICAgICAgPHVzZSB4PSIxMjMuMjkxMDE2IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy0xMDkiLz4NCiAgICAgIDx1c2UgeD0iMjIwLjcwMzEyNSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDEiLz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgIDwvZz4NCiAgIDxnIGlkPSJtYXRwbG90bGliLmF4aXNfMiI+DQogICAgPGcgaWQ9Inl0aWNrXzEiPg0KICAgICA8ZyBpZD0ibGluZTJkXzE4Ij4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwOTZjNzI0MTg1MykiIGQ9Ik0gMTY2LjAyNTU3OCAxODQuNDU4ODAxIA0KTCA2NDUuNTI3MjMgMTg0LjQ1ODgwMSANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzE5Ij4NCiAgICAgIDxkZWZzPg0KICAgICAgIDxwYXRoIGQ9Ik0gMCAwIA0KTCAtMy41IDAgDQoiIGlkPSJtZTE4NDliNDA1MCIgc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgICA8L2RlZnM+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iMTY2LjAyNTU3OCIgeGxpbms6aHJlZj0iI21lMTg0OWI0MDUwIiB5PSIxODQuNDU4ODAxIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfMTAiPg0KICAgICAgPCEtLSAwIC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMTUwLjExODA3OCAxODkuNzc3NzA4KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ4Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inl0aWNrXzIiPg0KICAgICA8ZyBpZD0ibGluZTJkXzIwIj4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwOTZjNzI0MTg1MykiIGQ9Ik0gMTY2LjAyNTU3OCAxNDcuMTU5MzMzIA0KTCA2NDUuNTI3MjMgMTQ3LjE1OTMzMyANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzIxIj4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIxNjYuMDI1NTc4IiB4bGluazpocmVmPSIjbWUxODQ5YjQwNTAiIHk9IjE0Ny4xNTkzMzMiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8xMSI+DQogICAgICA8IS0tIDIgLS0+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxNTAuMTE4MDc4IDE1Mi40NzgyMzkpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNTAiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieXRpY2tfMyI+DQogICAgIDxnIGlkPSJsaW5lMmRfMjIiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3A5NmM3MjQxODUzKSIgZD0iTSAxNjYuMDI1NTc4IDEwOS44NTk4NjQgDQpMIDY0NS41MjcyMyAxMDkuODU5ODY0IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfMjMiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjE2Ni4wMjU1NzgiIHhsaW5rOmhyZWY9IiNtZTE4NDliNDA1MCIgeT0iMTA5Ljg1OTg2NCIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzEyIj4NCiAgICAgIDwhLS0gNCAtLT4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDE1MC4xMTgwNzggMTE1LjE3ODc3MSlzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy01MiIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgIDxnIGlkPSJ5dGlja180Ij4NCiAgICAgPGcgaWQ9ImxpbmUyZF8yNCI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDk2YzcyNDE4NTMpIiBkPSJNIDE2Ni4wMjU1NzggNzIuNTYwMzk2IA0KTCA2NDUuNTI3MjMgNzIuNTYwMzk2IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfMjUiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjE2Ni4wMjU1NzgiIHhsaW5rOmhyZWY9IiNtZTE4NDliNDA1MCIgeT0iNzIuNTYwMzk2Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfMTMiPg0KICAgICAgPCEtLSA2IC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMTUwLjExODA3OCA3Ny44NzkzMDIpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNTQiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieXRpY2tfNSI+DQogICAgIDxnIGlkPSJsaW5lMmRfMjYiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3A5NmM3MjQxODUzKSIgZD0iTSAxNjYuMDI1NTc4IDM1LjI2MDkyOCANCkwgNjQ1LjUyNzIzIDM1LjI2MDkyOCANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzI3Ij4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIxNjYuMDI1NTc4IiB4bGluazpocmVmPSIjbWUxODQ5YjQwNTAiIHk9IjM1LjI2MDkyOCIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzE0Ij4NCiAgICAgIDwhLS0gOCAtLT4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDE1MC4xMTgwNzggNDAuNTc5ODM0KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTU2Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9InRleHRfMTUiPg0KICAgICA8IS0tICRcZ2FtbWEkIC0tPg0KICAgICA8ZGVmcz4NCiAgICAgIDxwYXRoIGQ9Ik0gMjMuMjk2ODc1IDQ2LjA5Mzc1IA0KTCAyOC43MTg3NSAxMi4zMTI1IA0KTCA1NCA1NC42ODc1IA0KTCA2My41MzEyNSA1NC42ODc1IA0KTCAzMC44MTI1IDAgDQpMIDI2Ljc2NTYyNSAtMjAuNzk2ODc1IA0KTCAxNy43ODEyNSAtMjAuNzk2ODc1IA0KTCAyMS44MjgxMjUgMCANCkwgMTUuNDM3NSA0MC44MjgxMjUgDQpRIDE0LjQ1MzEyNSA0Ni45Njg3NSA5LjgxMjUgNDYuOTY4NzUgDQpMIDcuNDIxODc1IDQ2Ljk2ODc1IA0KTCA4Ljg5MDYyNSA1NC42ODc1IA0KTCAxMi4zMTI1IDU0LjY4NzUgDQpRIDIxLjkyMTg3NSA1NC42ODc1IDIzLjI5Njg3NSA0Ni4wOTM3NSANCnoNCiIgaWQ9IkRlamFWdVNhbnMtT2JsaXF1ZS05NDciLz4NCiAgICAgPC9kZWZzPg0KICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxNDMuMTc4MDc4IDEwOC43NDE4NTkpcm90YXRlKC05MClzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICA8dXNlIHRyYW5zZm9ybT0idHJhbnNsYXRlKDAgMC4zMTI1KSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtT2JsaXF1ZS05NDciLz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgIDwvZz4NCiAgIDxnIGlkPSJwYXRjaF8zIj4NCiAgICA8cGF0aCBkPSJNIDE2Ni4wMjU1NzggMTg0LjQ1ODgwMSANCkwgMTY2LjAyNTU3OCAyNC42MjQ5MTcgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS1saW5lam9pbjptaXRlcjtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgPC9nPg0KICAgPGcgaWQ9InBhdGNoXzQiPg0KICAgIDxwYXRoIGQ9Ik0gMTY2LjAyNTU3OCAxODQuNDU4ODAxIA0KTCA2NDUuNTI3MjMgMTg0LjQ1ODgwMSANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6IzAwMDAwMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLWxpbmVqb2luOm1pdGVyO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICA8L2c+DQogICA8ZyBpZD0idGV4dF8xNiI+DQogICAgPCEtLSBBIC0tPg0KICAgIDxkZWZzPg0KICAgICA8cGF0aCBkPSJNIDUzLjQyMTg3NSAxMy4yODEyNSANCkwgMjQuMDMxMjUgMTMuMjgxMjUgDQpMIDE5LjM5MDYyNSAwIA0KTCAwLjQ4NDM3NSAwIA0KTCAyNy40ODQzNzUgNzIuOTA2MjUgDQpMIDQ5LjkwNjI1IDcyLjkwNjI1IA0KTCA3Ni45MDYyNSAwIA0KTCA1OC4wMTU2MjUgMCANCnoNCk0gMjguNzE4NzUgMjYuODEyNSANCkwgNDguNjg3NSAyNi44MTI1IA0KTCAzOC43MTg3NSA1NS44MTI1IA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy1Cb2xkLTY1Ii8+DQogICAgPC9kZWZzPg0KICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDE0LjQgMjguNjU2NTYzKXNjYWxlKDAuMTggLTAuMTgpIj4NCiAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy1Cb2xkLTY1Ii8+DQogICAgPC9nPg0KICAgPC9nPg0KICA8L2c+DQogIDxnIGlkPSJheGVzXzIiPg0KICAgPGcgaWQ9InBhdGNoXzUiPg0KICAgIDxwYXRoIGQ9Ik0gMTY2LjAyNTU3OCAzOTIuMjQyODUgDQpMIDY0NS41MjcyMyAzOTIuMjQyODUgDQpMIDY0NS41MjcyMyAyMzIuNDA4OTY2IA0KTCAxNjYuMDI1NTc4IDIzMi40MDg5NjYgDQp6DQoiIHN0eWxlPSJmaWxsOiNmZmZmZmY7Ii8+DQogICA8L2c+DQogICA8ZyBpZD0iUG9seUNvbGxlY3Rpb25fMSI+DQogICAgPGRlZnM+DQogICAgIDxwYXRoIGQ9Ik0gMTg4LjQwMjMyMiAtMjA2LjAzMzg4NCANCkwgMTg4LjQwMjMyMiAtMjA2LjAzMzg4NCANCkwgMTg4LjU2MjE1NiAtMjA2LjAzMzg4NCANCkwgMTg4LjcyMTk5IC0yMDYuMDMzODg0IA0KTCAxODguODgxODI0IC0yMDYuMDMzODg0IA0KTCAxODkuMDQxNjU3IC0yMDYuMDMzODg0IA0KTCAxODkuMjAxNDkxIC0yMDYuMDMzODg0IA0KTCAxODkuMzYxMzI1IC0yMDYuMDMzODg0IA0KTCAxODkuNTIxMTU5IC0yMDYuMDMzODg0IA0KTCAxODkuNjgwOTkzIC0yMDYuMDMzODg0IA0KTCAxODkuODQwODI3IC0yMDYuMDMzODg0IA0KTCAxOTAuMDAwNjYxIC0yMDYuMDMzODg0IA0KTCAxOTAuMTYwNDk1IC0yMDYuMDMzODg0IA0KTCAxOTAuMzIwMzI4IC0yMDYuMDMzODg0IA0KTCAxOTAuNDgwMTYyIC0yMDYuMDMzODg0IA0KTCAxOTAuNjM5OTk2IC0yMDYuMDMzODg0IA0KTCAxOTAuNzk5ODMgLTIwNi4wMzM4ODQgDQpMIDE5MC45NTk2NjQgLTIwNi4wMzM4ODQgDQpMIDE5MS4xMTk0OTggLTIwNi4wMzM4ODQgDQpMIDE5MS4yNzkzMzIgLTIwNi4wMzM4ODQgDQpMIDE5MS40MzkxNjYgLTIwNi4wMzM4ODQgDQpMIDE5MS41OTkgLTIwNi4wMzM4ODQgDQpMIDE5MS43NTg4MzMgLTIwNi4wMzM4ODQgDQpMIDE5MS45MTg2NjcgLTIwNi4wMzM4ODQgDQpMIDE5Mi4wNzg1MDEgLTIwNi4wMzM4ODQgDQpMIDE5Mi4yMzgzMzUgLTIwNi4wMzM4ODQgDQpMIDE5Mi4zOTgxNjkgLTIwNi4wMzM4ODQgDQpMIDE5Mi41NTgwMDMgLTIwNi4wMzM4ODQgDQpMIDE5Mi43MTc4MzcgLTIwNi4wMzM4ODQgDQpMIDE5Mi44Nzc2NzEgLTIwNi4wMzM4ODQgDQpMIDE5My4wMzc1MDQgLTIwNi4wMzM4ODQgDQpMIDE5My4xOTczMzggLTIwNi4wMzM4ODQgDQpMIDE5My4zNTcxNzIgLTIwNi4wMzM4ODQgDQpMIDE5My41MTcwMDYgLTIwNi4wMzM4ODQgDQpMIDE5My42NzY4NCAtMjA2LjAzMzg4NCANCkwgMTkzLjgzNjY3NCAtMjA2LjAzMzg4NCANCkwgMTkzLjk5NjUwOCAtMjA2LjAzMzg4NCANCkwgMTk0LjE1NjM0MiAtMjA2LjAzMzg4NCANCkwgMTk0LjMxNjE3NiAtMjA2LjAzMzg4NCANCkwgMTk0LjQ3NjAwOSAtMjA2LjAzMzg4NCANCkwgMTk0LjYzNTg0MyAtMjA2LjAzMzg4NCANCkwgMTk0Ljc5NTY3NyAtMjA2LjAzMzg4NCANCkwgMTk0Ljk1NTUxMSAtMjA2LjAzMzg4NCANCkwgMTk1LjExNTM0NSAtMjA2LjAzMzg4NCANCkwgMTk1LjI3NTE3OSAtMjA2LjAzMzg4NCANCkwgMTk1LjQzNTAxMyAtMjA2LjAzMzg4NCANCkwgMTk1LjU5NDg0NyAtMjA2LjAzMzg4NCANCkwgMTk1Ljc1NDY4MSAtMjA2LjAzMzg4NCANCkwgMTk1LjkxNDUxNCAtMjA2LjAzMzg4NCANCkwgMTk2LjA3NDM0OCAtMjA2LjAzMzg4NCANCkwgMTk2LjIzNDE4MiAtMjA2LjAzMzg4NCANCkwgMTk2LjM5NDAxNiAtMjA2LjAzMzg4NCANCkwgMTk2LjU1Mzg1IC0yMDYuMDMzODg0IA0KTCAxOTYuNzEzNjg0IC0yMDYuMDMzODg0IA0KTCAxOTYuODczNTE4IC0yMDYuMDMzODg0IA0KTCAxOTcuMDMzMzUyIC0yMDYuMDMzODg0IA0KTCAxOTcuMTkzMTg1IC0yMDYuMDMzODg0IA0KTCAxOTcuMzUzMDE5IC0yMDYuMDMzODg0IA0KTCAxOTcuNTEyODUzIC0yMDYuMDMzODg0IA0KTCAxOTcuNjcyNjg3IC0yMDYuMDMzODg0IA0KTCAxOTcuODMyNTIxIC0yMDYuMDMzODg0IA0KTCAxOTcuOTkyMzU1IC0yMDYuMDMzODg0IA0KTCAxOTguMTUyMTg5IC0yMDYuMDMzODg0IA0KTCAxOTguMzEyMDIzIC0yMDYuMDMzODg0IA0KTCAxOTguNDcxODU3IC0yMDYuMDMzODg0IA0KTCAxOTguNjMxNjkgLTIwNi4wMzM4ODQgDQpMIDE5OC43OTE1MjQgLTIwNi4wMzM4ODQgDQpMIDE5OC45NTEzNTggLTIwNi4wMzM4ODQgDQpMIDE5OS4xMTExOTIgLTIwNi4wMzM4ODQgDQpMIDE5OS4yNzEwMjYgLTIwNi4wMzM4ODQgDQpMIDE5OS40MzA4NiAtMjA2LjAzMzg4NCANCkwgMTk5LjU5MDY5NCAtMjA2LjAzMzg4NCANCkwgMTk5Ljc1MDUyOCAtMjA2LjAzMzg4NCANCkwgMTk5LjkxMDM2MSAtMjA2LjAzMzg4NCANCkwgMjAwLjA3MDE5NSAtMjA2LjAzMzg4NCANCkwgMjAwLjIzMDAyOSAtMjA2LjAzMzg4NCANCkwgMjAwLjM4OTg2MyAtMjA2LjAzMzg4NCANCkwgMjAwLjU0OTY5NyAtMjA2LjAzMzg4NCANCkwgMjAwLjcwOTUzMSAtMjA2LjAzMzg4NCANCkwgMjAwLjg2OTM2NSAtMjA2LjAzMzg4NCANCkwgMjAxLjAyOTE5OSAtMjA2LjAzMzg4NCANCkwgMjAxLjE4OTAzMyAtMjA2LjAzMzg4NCANCkwgMjAxLjM0ODg2NiAtMjA2LjAzMzg4NCANCkwgMjAxLjUwODcgLTIwNi4wMzM4ODQgDQpMIDIwMS42Njg1MzQgLTIwNi4wMzM4ODQgDQpMIDIwMS44MjgzNjggLTIwNi4wMzM4ODQgDQpMIDIwMS45ODgyMDIgLTIwNi4wMzM4ODQgDQpMIDIwMi4xNDgwMzYgLTIwNi4wMzM4ODQgDQpMIDIwMi4zMDc4NyAtMjA2LjAzMzg4NCANCkwgMjAyLjQ2NzcwNCAtMjA2LjAzMzg4NCANCkwgMjAyLjYyNzUzOCAtMjA2LjAzMzg4NCANCkwgMjAyLjc4NzM3MSAtMjA2LjAzMzg4NCANCkwgMjAyLjk0NzIwNSAtMjA2LjAzMzg4NCANCkwgMjAzLjEwNzAzOSAtMjA2LjAzMzg4NCANCkwgMjAzLjI2Njg3MyAtMjA2LjAzMzg4NCANCkwgMjAzLjQyNjcwNyAtMjA2LjAzMzg4NCANCkwgMjAzLjU4NjU0MSAtMjA2LjAzMzg4NCANCkwgMjAzLjc0NjM3NSAtMjA2LjAzMzg4NCANCkwgMjAzLjkwNjIwOSAtMjA2LjAzMzg4NCANCkwgMjA0LjA2NjA0MiAtMjA2LjAzMzg4NCANCkwgMjA0LjIyNTg3NiAtMjA2LjAzMzg4NCANCkwgMjA0LjM4NTcxIC0yMDYuMDMzODg0IA0KTCAyMDQuNTQ1NTQ0IC0yMDYuMDMzODg0IA0KTCAyMDQuNzA1Mzc4IC0yMDYuMDMzODg0IA0KTCAyMDQuODY1MjEyIC0yMDYuMDMzODg0IA0KTCAyMDUuMDI1MDQ2IC0yMDYuMDMzODg0IA0KTCAyMDUuMTg0ODggLTIwNi4wMzM4ODQgDQpMIDIwNS4zNDQ3MTQgLTIwNi4wMzM4ODQgDQpMIDIwNS41MDQ1NDcgLTIwNi4wMzM4ODQgDQpMIDIwNS42NjQzODEgLTIwNi4wMzM4ODQgDQpMIDIwNS44MjQyMTUgLTIwNi4wMzM4ODQgDQpMIDIwNS45ODQwNDkgLTIwNi4wMzM4ODQgDQpMIDIwNi4xNDM4ODMgLTIwNi4wMzM4ODQgDQpMIDIwNi4zMDM3MTcgLTIwNi4wMzM4ODQgDQpMIDIwNi40NjM1NTEgLTIwNi4wMzM4ODQgDQpMIDIwNi42MjMzODUgLTIwNi4wMzM4ODQgDQpMIDIwNi43ODMyMTggLTIwNi4wMzM4ODQgDQpMIDIwNi45NDMwNTIgLTIwNi4wMzM4ODQgDQpMIDIwNy4xMDI4ODYgLTIwNi4wMzM4ODQgDQpMIDIwNy4yNjI3MiAtMjA2LjAzMzg4NCANCkwgMjA3LjQyMjU1NCAtMjA2LjAzMzg4NCANCkwgMjA3LjU4MjM4OCAtMjA2LjAzMzg4NCANCkwgMjA3Ljc0MjIyMiAtMjA2LjAzMzg4NCANCkwgMjA3LjkwMjA1NiAtMjA2LjAzMzg4NCANCkwgMjA4LjA2MTg5IC0yMDYuMDMzODg0IA0KTCAyMDguMjIxNzIzIC0yMDYuMDMzODg0IA0KTCAyMDguMzgxNTU3IC0yMDYuMDMzODg0IA0KTCAyMDguNTQxMzkxIC0yMDYuMDMzODg0IA0KTCAyMDguNzAxMjI1IC0yMDYuMDMzODg0IA0KTCAyMDguODYxMDU5IC0yMDYuMDMzODg0IA0KTCAyMDkuMDIwODkzIC0yMDYuMDMzODg0IA0KTCAyMDkuMTgwNzI3IC0yMDYuMDMzODg0IA0KTCAyMDkuMzQwNTYxIC0yMDYuMDMzODg0IA0KTCAyMDkuNTAwMzk1IC0yMDYuMDMzODg0IA0KTCAyMDkuNjYwMjI4IC0yMDYuMDMzODg0IA0KTCAyMDkuODIwMDYyIC0yMDYuMDMzODg0IA0KTCAyMDkuOTc5ODk2IC0yMDYuMDMzODg0IA0KTCAyMTAuMTM5NzMgLTIwNi4wMzM4ODQgDQpMIDIxMC4yOTk1NjQgLTIwNi4wMzM4ODQgDQpMIDIxMC40NTkzOTggLTIwNi4wMzM4ODQgDQpMIDIxMC42MTkyMzIgLTIwNi4wMzM4ODQgDQpMIDIxMC43NzkwNjYgLTIwNi4wMzM4ODQgDQpMIDIxMC45Mzg4OTkgLTIwNi4wMzM4ODQgDQpMIDIxMS4wOTg3MzMgLTIwNi4wMzM4ODQgDQpMIDIxMS4yNTg1NjcgLTIwNi4wMzM4ODQgDQpMIDIxMS40MTg0MDEgLTIwNi4wMzM4ODQgDQpMIDIxMS41NzgyMzUgLTIwNi4wMzM4ODQgDQpMIDIxMS43MzgwNjkgLTIwNi4wMzM4ODQgDQpMIDIxMS44OTc5MDMgLTIwNi4wMzM4ODQgDQpMIDIxMi4wNTc3MzcgLTIwNi4wMzM4ODQgDQpMIDIxMi4yMTc1NzEgLTIwNi4wMzM4ODQgDQpMIDIxMi4zNzc0MDQgLTIwNi4wMzM4ODQgDQpMIDIxMi41MzcyMzggLTIwNi4wMzM4ODQgDQpMIDIxMi42OTcwNzIgLTIwNi4wMzM4ODQgDQpMIDIxMi44NTY5MDYgLTIwNi4wMzM4ODQgDQpMIDIxMy4wMTY3NCAtMjA2LjAzMzg4NCANCkwgMjEzLjE3NjU3NCAtMjA2LjAzMzg4NCANCkwgMjEzLjMzNjQwOCAtMjA2LjAzMzg4NCANCkwgMjEzLjQ5NjI0MiAtMjA2LjAzMzg4NCANCkwgMjEzLjY1NjA3NiAtMjA2LjAzMzg4NCANCkwgMjEzLjgxNTkwOSAtMjA2LjAzMzg4NCANCkwgMjEzLjk3NTc0MyAtMjA2LjAzMzg4NCANCkwgMjE0LjEzNTU3NyAtMjA2LjAzMzg4NCANCkwgMjE0LjI5NTQxMSAtMjA2LjAzMzg4NCANCkwgMjE0LjQ1NTI0NSAtMjA2LjAzMzg4NCANCkwgMjE0LjYxNTA3OSAtMjA2LjAzMzg4NCANCkwgMjE0Ljc3NDkxMyAtMjA2LjAzMzg4NCANCkwgMjE0LjkzNDc0NyAtMjA2LjAzMzg4NCANCkwgMjE1LjA5NDU4IC0yMDYuMDMzODg0IA0KTCAyMTUuMjU0NDE0IC0yMDYuMDMzODg0IA0KTCAyMTUuNDE0MjQ4IC0yMDYuMDMzODg0IA0KTCAyMTUuNTc0MDgyIC0yMDYuMDMzODg0IA0KTCAyMTUuNzMzOTE2IC0yMDYuMDMzODg0IA0KTCAyMTUuODkzNzUgLTIwNi4wMzM4ODQgDQpMIDIxNi4wNTM1ODQgLTIwNi4wMzM4ODQgDQpMIDIxNi4yMTM0MTggLTIwNi4wMzM4ODQgDQpMIDIxNi4zNzMyNTIgLTIwNi4wMzM4ODQgDQpMIDIxNi41MzMwODUgLTIwNi4wMzM4ODQgDQpMIDIxNi42OTI5MTkgLTIwNi4wMzM4ODQgDQpMIDIxNi44NTI3NTMgLTIwNi4wMzM4ODQgDQpMIDIxNy4wMTI1ODcgLTIwNi4wMzM4ODQgDQpMIDIxNy4xNzI0MjEgLTIwNi4wMzM4ODQgDQpMIDIxNy4zMzIyNTUgLTIwNi4wMzM4ODQgDQpMIDIxNy40OTIwODkgLTIwNi4wMzM4ODQgDQpMIDIxNy42NTE5MjMgLTIwNi4wMzM4ODQgDQpMIDIxNy44MTE3NTYgLTIwNi4wMzM4ODQgDQpMIDIxNy45NzE1OSAtMjA2LjAzMzg4NCANCkwgMjE4LjEzMTQyNCAtMjA2LjAzMzg4NCANCkwgMjE4LjI5MTI1OCAtMjA2LjAzMzg4NCANCkwgMjE4LjQ1MTA5MiAtMjA2LjAzMzg4NCANCkwgMjE4LjYxMDkyNiAtMjA2LjAzMzg4NCANCkwgMjE4Ljc3MDc2IC0yMDYuMDMzODg0IA0KTCAyMTguOTMwNTk0IC0yMDYuMDMzODg0IA0KTCAyMTkuMDkwNDI4IC0yMDYuMDMzODg0IA0KTCAyMTkuMjUwMjYxIC0yMDYuMDMzODg0IA0KTCAyMTkuNDEwMDk1IC0yMDYuMDMzODg0IA0KTCAyMTkuNTY5OTI5IC0yMDYuMDMzODg0IA0KTCAyMTkuNzI5NzYzIC0yMDYuMDMzODg0IA0KTCAyMTkuODg5NTk3IC0yMDYuMDMzODg0IA0KTCAyMjAuMDQ5NDMxIC0yMDYuMDMzODg0IA0KTCAyMjAuMjA5MjY1IC0yMDYuMDMzODg0IA0KTCAyMjAuMzY5MDk5IC0yMDYuMDMzODg0IA0KTCAyMjAuNTI4OTMzIC0yMDYuMDMzODg0IA0KTCAyMjAuNjg4NzY2IC0yMDYuMDMzODg0IA0KTCAyMjAuODQ4NiAtMjA2LjAzMzg4NCANCkwgMjIxLjAwODQzNCAtMjA2LjAzMzg4NCANCkwgMjIxLjE2ODI2OCAtMjA2LjAzMzg4NCANCkwgMjIxLjMyODEwMiAtMjA2LjAzMzg4NCANCkwgMjIxLjQ4NzkzNiAtMjA2LjAzMzg4NCANCkwgMjIxLjY0Nzc3IC0yMDYuMDMzODg0IA0KTCAyMjEuODA3NjA0IC0yMDYuMDMzODg0IA0KTCAyMjEuOTY3NDM3IC0yMDYuMDMzODg0IA0KTCAyMjIuMTI3MjcxIC0yMDYuMDMzODg0IA0KTCAyMjIuMjg3MTA1IC0yMDYuMDMzODg0IA0KTCAyMjIuNDQ2OTM5IC0yMDYuMDMzODg0IA0KTCAyMjIuNjA2NzczIC0yMDYuMDMzODg0IA0KTCAyMjIuNzY2NjA3IC0yMDYuMDMzODg0IA0KTCAyMjIuOTI2NDQxIC0yMDYuMDMzODg0IA0KTCAyMjMuMDg2Mjc1IC0yMDYuMDMzODg0IA0KTCAyMjMuMjQ2MTA5IC0yMDYuMDMzODg0IA0KTCAyMjMuNDA1OTQyIC0yMDYuMDMzODg0IA0KTCAyMjMuNTY1Nzc2IC0yMDYuMDMzODg0IA0KTCAyMjMuNzI1NjEgLTIwNi4wMzM4ODQgDQpMIDIyMy44ODU0NDQgLTIwNi4wMzM4ODQgDQpMIDIyNC4wNDUyNzggLTIwNi4wMzM4ODQgDQpMIDIyNC4yMDUxMTIgLTIwNi4wMzM4ODQgDQpMIDIyNC4zNjQ5NDYgLTIwNi4wMzM4ODQgDQpMIDIyNC41MjQ3OCAtMjA2LjAzMzg4NCANCkwgMjI0LjY4NDYxMyAtMjA2LjAzMzg4NCANCkwgMjI0Ljg0NDQ0NyAtMjA2LjAzMzg4NCANCkwgMjI1LjAwNDI4MSAtMjA2LjAzMzg4NCANCkwgMjI1LjE2NDExNSAtMjA2LjAzMzg4NCANCkwgMjI1LjMyMzk0OSAtMjA2LjAzMzg4NCANCkwgMjI1LjQ4Mzc4MyAtMjA2LjAzMzg4NCANCkwgMjI1LjY0MzYxNyAtMjA2LjAzMzg4NCANCkwgMjI1LjgwMzQ1MSAtMjA2LjAzMzg4NCANCkwgMjI1Ljk2MzI4NSAtMjA2LjAzMzg4NCANCkwgMjI2LjEyMzExOCAtMjA2LjAzMzg4NCANCkwgMjI2LjI4Mjk1MiAtMjA2LjAzMzg4NCANCkwgMjI2LjQ0Mjc4NiAtMjA2LjAzMzg4NCANCkwgMjI2LjYwMjYyIC0yMDYuMDMzODg0IA0KTCAyMjYuNzYyNDU0IC0yMDYuMDMzODg0IA0KTCAyMjYuOTIyMjg4IC0yMDYuMDMzODg0IA0KTCAyMjcuMDgyMTIyIC0yMDYuMDMzODg0IA0KTCAyMjcuMjQxOTU2IC0yMDYuMDMzODg0IA0KTCAyMjcuNDAxNzkgLTIwNi4wMzM4ODQgDQpMIDIyNy41NjE2MjMgLTIwNi4wMzM4ODQgDQpMIDIyNy43MjE0NTcgLTIwNi4wMzM4ODQgDQpMIDIyNy44ODEyOTEgLTIwNi4wMzM4ODQgDQpMIDIyOC4wNDExMjUgLTIwNi4wMzM4ODQgDQpMIDIyOC4yMDA5NTkgLTIwNi4wMzM4ODQgDQpMIDIyOC4zNjA3OTMgLTIwNi4wMzM4ODQgDQpMIDIyOC41MjA2MjcgLTIwNi4wMzM4ODQgDQpMIDIyOC42ODA0NjEgLTIwNi4wMzM4ODQgDQpMIDIyOC44NDAyOTQgLTIwNi4wMzM4ODQgDQpMIDIyOS4wMDAxMjggLTIwNi4wMzM4ODQgDQpMIDIyOS4xNTk5NjIgLTIwNi4wMzM4ODQgDQpMIDIyOS4zMTk3OTYgLTIwNi4wMzM4ODQgDQpMIDIyOS40Nzk2MyAtMjA2LjAzMzg4NCANCkwgMjI5LjYzOTQ2NCAtMjA2LjAzMzg4NCANCkwgMjI5Ljc5OTI5OCAtMjA2LjAzMzg4NCANCkwgMjI5Ljk1OTEzMiAtMjA2LjAzMzg4NCANCkwgMjMwLjExODk2NiAtMjA2LjAzMzg4NCANCkwgMjMwLjI3ODc5OSAtMjA2LjAzMzg4NCANCkwgMjMwLjQzODYzMyAtMjA2LjAzMzg4NCANCkwgMjMwLjU5ODQ2NyAtMjA2LjAzMzg4NCANCkwgMjMwLjc1ODMwMSAtMjA2LjAzMzg4NCANCkwgMjMwLjkxODEzNSAtMjA2LjAzMzg4NCANCkwgMjMxLjA3Nzk2OSAtMjA2LjAzMzg4NCANCkwgMjMxLjIzNzgwMyAtMjA2LjAzMzg4NCANCkwgMjMxLjM5NzYzNyAtMjA2LjAzMzg4NCANCkwgMjMxLjU1NzQ3MSAtMjA2LjAzMzg4NCANCkwgMjMxLjcxNzMwNCAtMjA2LjAzMzg4NCANCkwgMjMxLjg3NzEzOCAtMjA2LjAzMzg4NCANCkwgMjMyLjAzNjk3MiAtMjA2LjAzMzg4NCANCkwgMjMyLjE5NjgwNiAtMjA2LjAzMzg4NCANCkwgMjMyLjM1NjY0IC0yMDYuMDMzODg0IA0KTCAyMzIuNTE2NDc0IC0yMDYuMDMzODg0IA0KTCAyMzIuNjc2MzA4IC0yMDYuMDMzODg0IA0KTCAyMzIuODM2MTQyIC0yMDYuMDMzODg0IA0KTCAyMzIuOTk1OTc1IC0yMDYuMDMzODg0IA0KTCAyMzMuMTU1ODA5IC0yMDYuMDMzODg0IA0KTCAyMzMuMzE1NjQzIC0yMDYuMDMzODg0IA0KTCAyMzMuNDc1NDc3IC0yMDYuMDMzODg0IA0KTCAyMzMuNjM1MzExIC0yMDYuMDMzODg0IA0KTCAyMzMuNzk1MTQ1IC0yMDYuMDMzODg0IA0KTCAyMzMuOTU0OTc5IC0yMDYuMDMzODg0IA0KTCAyMzQuMTE0ODEzIC0yMDYuMDMzODg0IA0KTCAyMzQuMjc0NjQ3IC0yMDYuMDMzODg0IA0KTCAyMzQuNDM0NDggLTIwNi4wMzM4ODQgDQpMIDIzNC41OTQzMTQgLTIwNi4wMzM4ODQgDQpMIDIzNC43NTQxNDggLTIwNi4wMzM4ODQgDQpMIDIzNC45MTM5ODIgLTIwNi4wMzM4ODQgDQpMIDIzNS4wNzM4MTYgLTIwNi4wMzM4ODQgDQpMIDIzNS4yMzM2NSAtMjA2LjAzMzg4NCANCkwgMjM1LjM5MzQ4NCAtMjA2LjAzMzg4NCANCkwgMjM1LjU1MzMxOCAtMjA2LjAzMzg4NCANCkwgMjM1LjcxMzE1MSAtMjA2LjAzMzg4NCANCkwgMjM1Ljg3Mjk4NSAtMjA2LjAzMzg4NCANCkwgMjM2LjAzMjgxOSAtMjA2LjAzMzg4NCANCkwgMjM2LjE5MjY1MyAtMjA2LjAzMzg4NCANCkwgMjM2LjM1MjQ4NyAtMjA2LjAzMzg4NCANCkwgMjM2LjUxMjMyMSAtMjA2LjAzMzg4NCANCkwgMjM2LjY3MjE1NSAtMjA2LjAzMzg4NCANCkwgMjM2LjgzMTk4OSAtMjA2LjAzMzg4NCANCkwgMjM2Ljk5MTgyMyAtMjA2LjAzMzg4NCANCkwgMjM3LjE1MTY1NiAtMjA2LjAzMzg4NCANCkwgMjM3LjMxMTQ5IC0yMDYuMDMzODg0IA0KTCAyMzcuNDcxMzI0IC0yMDYuMDMzODg0IA0KTCAyMzcuNjMxMTU4IC0yMDYuMDMzODg0IA0KTCAyMzcuNzkwOTkyIC0yMDYuMDMzODg0IA0KTCAyMzcuOTUwODI2IC0yMDYuMDMzODg0IA0KTCAyMzguMTEwNjYgLTIwNi4wMzM4ODQgDQpMIDIzOC4yNzA0OTQgLTIwNi4wMzM4ODQgDQpMIDIzOC40MzAzMjggLTIwNi4wMzM4ODQgDQpMIDIzOC41OTAxNjEgLTIwNi4wMzM4ODQgDQpMIDIzOC43NDk5OTUgLTIwNi4wMzM4ODQgDQpMIDIzOC45MDk4MjkgLTIwNi4wMzM4ODQgDQpMIDIzOS4wNjk2NjMgLTIwNi4wMzM4ODQgDQpMIDIzOS4yMjk0OTcgLTIwNi4wMzM4ODQgDQpMIDIzOS4zODkzMzEgLTIwNi4wMzM4ODQgDQpMIDIzOS41NDkxNjUgLTIwNi4wMzM4ODQgDQpMIDIzOS43MDg5OTkgLTIwNi4wMzM4ODQgDQpMIDIzOS44Njg4MzIgLTIwNi4wMzM4ODQgDQpMIDI0MC4wMjg2NjYgLTIwNi4wMzM4ODQgDQpMIDI0MC4xODg1IC0yMDYuMDMzODg0IA0KTCAyNDAuMzQ4MzM0IC0yMDYuMDMzODg0IA0KTCAyNDAuNTA4MTY4IC0yMDYuMDMzODg0IA0KTCAyNDAuNjY4MDAyIC0yMDYuMDMzODg0IA0KTCAyNDAuODI3ODM2IC0yMDYuMDMzODg0IA0KTCAyNDAuOTg3NjcgLTIwNi4wMzM4ODQgDQpMIDI0MS4xNDc1MDQgLTIwNi4wMzM4ODQgDQpMIDI0MS4zMDczMzcgLTIwNi4wMzM4ODQgDQpMIDI0MS40NjcxNzEgLTIwNi4wMzM4ODQgDQpMIDI0MS42MjcwMDUgLTIwNi4wMzM4ODQgDQpMIDI0MS43ODY4MzkgLTIwNi4wMzM4ODQgDQpMIDI0MS45NDY2NzMgLTIwNi4wMzM4ODQgDQpMIDI0Mi4xMDY1MDcgLTIwNi4wMzM4ODQgDQpMIDI0Mi4yNjYzNDEgLTIwNi4wMzM4ODQgDQpMIDI0Mi40MjYxNzUgLTIwNi4wMzM4ODQgDQpMIDI0Mi41ODYwMDggLTIwNi4wMzM4ODQgDQpMIDI0Mi43NDU4NDIgLTIwNi4wMzM4ODQgDQpMIDI0Mi45MDU2NzYgLTIwNi4wMzM4ODQgDQpMIDI0My4wNjU1MSAtMjA2LjAzMzg4NCANCkwgMjQzLjIyNTM0NCAtMjA2LjAzMzg4NCANCkwgMjQzLjM4NTE3OCAtMjA2LjAzMzg4NCANCkwgMjQzLjU0NTAxMiAtMjA2LjAzMzg4NCANCkwgMjQzLjcwNDg0NiAtMjA2LjAzMzg4NCANCkwgMjQzLjg2NDY4IC0yMDYuMDMzODg0IA0KTCAyNDQuMDI0NTEzIC0yMDYuMDMzODg0IA0KTCAyNDQuMTg0MzQ3IC0yMDYuMDMzODg0IA0KTCAyNDQuMzQ0MTgxIC0yMDYuMDMzODg0IA0KTCAyNDQuNTA0MDE1IC0yMDYuMDMzODg0IA0KTCAyNDQuNjYzODQ5IC0yMDYuMDMzODg0IA0KTCAyNDQuODIzNjgzIC0yMDYuMDMzODg0IA0KTCAyNDQuOTgzNTE3IC0yMDYuMDMzODg0IA0KTCAyNDUuMTQzMzUxIC0yMDYuMDMzODg0IA0KTCAyNDUuMzAzMTg1IC0yMDYuMDMzODg0IA0KTCAyNDUuNDYzMDE4IC0yMDYuMDMzODg0IA0KTCAyNDUuNjIyODUyIC0yMDYuMDMzODg0IA0KTCAyNDUuNzgyNjg2IC0yMDYuMDMzODg0IA0KTCAyNDUuOTQyNTIgLTIwNi4wMzM4ODQgDQpMIDI0Ni4xMDIzNTQgLTIwNi4wMzM4ODQgDQpMIDI0Ni4yNjIxODggLTIwNi4wMzM4ODQgDQpMIDI0Ni40MjIwMjIgLTIwNi4wMzM4ODQgDQpMIDI0Ni41ODE4NTYgLTIwNi4wMzM4ODQgDQpMIDI0Ni43NDE2ODkgLTIwNi4wMzM4ODQgDQpMIDI0Ni45MDE1MjMgLTIwNi4wMzM4ODQgDQpMIDI0Ny4wNjEzNTcgLTIwNi4wMzM4ODQgDQpMIDI0Ny4yMjExOTEgLTIwNi4wMzM4ODQgDQpMIDI0Ny4zODEwMjUgLTIwNi4wMzM4ODQgDQpMIDI0Ny41NDA4NTkgLTIwNi4wMzM4ODQgDQpMIDI0Ny43MDA2OTMgLTIwNi4wMzM4ODQgDQpMIDI0Ny44NjA1MjcgLTIwNi4wMzM4ODQgDQpMIDI0OC4wMjAzNjEgLTIwNi4wMzM4ODQgDQpMIDI0OC4xODAxOTQgLTIwNi4wMzM4ODQgDQpMIDI0OC4zNDAwMjggLTIwNi4wMzM4ODQgDQpMIDI0OC40OTk4NjIgLTIwNi4wMzM4ODQgDQpMIDI0OC42NTk2OTYgLTIwNi4wMzM4ODQgDQpMIDI0OC44MTk1MyAtMjA2LjAzMzg4NCANCkwgMjQ4Ljk3OTM2NCAtMjA2LjAzMzg4NCANCkwgMjQ5LjEzOTE5OCAtMjA2LjAzMzg4NCANCkwgMjQ5LjI5OTAzMiAtMjA2LjAzMzg4NCANCkwgMjQ5LjQ1ODg2NiAtMjA2LjAzMzg4NCANCkwgMjQ5LjYxODY5OSAtMjA2LjAzMzg4NCANCkwgMjQ5Ljc3ODUzMyAtMjA2LjAzMzg4NCANCkwgMjQ5LjkzODM2NyAtMjA2LjAzMzg4NCANCkwgMjUwLjA5ODIwMSAtMjA2LjAzMzg4NCANCkwgMjUwLjI1ODAzNSAtMjA2LjAzMzg4NCANCkwgMjUwLjQxNzg2OSAtMjA2LjAzMzg4NCANCkwgMjUwLjU3NzcwMyAtMjA2LjAzMzg4NCANCkwgMjUwLjczNzUzNyAtMjA2LjAzMzg4NCANCkwgMjUwLjg5NzM3IC0yMDYuMDMzODg0IA0KTCAyNTEuMDU3MjA0IC0yMDYuMDMzODg0IA0KTCAyNTEuMjE3MDM4IC0yMDYuMDMzODg0IA0KTCAyNTEuMzc2ODcyIC0yMDYuMDMzODg0IA0KTCAyNTEuNTM2NzA2IC0yMDYuMDMzODg0IA0KTCAyNTEuNjk2NTQgLTIwNi4wMzM4ODQgDQpMIDI1MS44NTYzNzQgLTIwNi4wMzM4ODQgDQpMIDI1Mi4wMTYyMDggLTIwNi4wMzM4ODQgDQpMIDI1Mi4xNzYwNDIgLTIwNi4wMzM4ODQgDQpMIDI1Mi4zMzU4NzUgLTIwNi4wMzM4ODQgDQpMIDI1Mi40OTU3MDkgLTIwNi4wMzM4ODQgDQpMIDI1Mi42NTU1NDMgLTIwNi4wMzM4ODQgDQpMIDI1Mi44MTUzNzcgLTIwNi4wMzM4ODQgDQpMIDI1Mi45NzUyMTEgLTIwNi4wMzM4ODQgDQpMIDI1My4xMzUwNDUgLTIwNi4wMzM4ODQgDQpMIDI1My4yOTQ4NzkgLTIwNi4wMzM4ODQgDQpMIDI1My40NTQ3MTMgLTIwNi4wMzM4ODQgDQpMIDI1My42MTQ1NDYgLTIwNi4wMzM4ODQgDQpMIDI1My43NzQzOCAtMjA2LjAzMzg4NCANCkwgMjUzLjkzNDIxNCAtMjA2LjAzMzg4NCANCkwgMjU0LjA5NDA0OCAtMjA2LjAzMzg4NCANCkwgMjU0LjI1Mzg4MiAtMjA2LjAzMzg4NCANCkwgMjU0LjQxMzcxNiAtMjA2LjAzMzg4NCANCkwgMjU0LjU3MzU1IC0yMDYuMDMzODg0IA0KTCAyNTQuNzMzMzg0IC0yMDYuMDMzODg0IA0KTCAyNTQuODkzMjE4IC0yMDYuMDMzODg0IA0KTCAyNTUuMDUzMDUxIC0yMDYuMDMzODg0IA0KTCAyNTUuMjEyODg1IC0yMDYuMDMzODg0IA0KTCAyNTUuMzcyNzE5IC0yMDYuMDMzODg0IA0KTCAyNTUuNTMyNTUzIC0yMDYuMDMzODg0IA0KTCAyNTUuNjkyMzg3IC0yMDYuMDMzODg0IA0KTCAyNTUuODUyMjIxIC0yMDYuMDMzODg0IA0KTCAyNTYuMDEyMDU1IC0yMDYuMDMzODg0IA0KTCAyNTYuMTcxODg5IC0yMDYuMDMzODg0IA0KTCAyNTYuMzMxNzIzIC0yMDYuMDMzODg0IA0KTCAyNTYuNDkxNTU2IC0yMDYuMDMzODg0IA0KTCAyNTYuNjUxMzkgLTIwNi4wMzM4ODQgDQpMIDI1Ni44MTEyMjQgLTIwNi4wMzM4ODQgDQpMIDI1Ni45NzEwNTggLTIwNi4wMzM4ODQgDQpMIDI1Ny4xMzA4OTIgLTIwNi4wMzM4ODQgDQpMIDI1Ny4yOTA3MjYgLTIwNi4wMzM4ODQgDQpMIDI1Ny40NTA1NiAtMjA2LjAzMzg4NCANCkwgMjU3LjYxMDM5NCAtMjA2LjAzMzg4NCANCkwgMjU3Ljc3MDIyNyAtMjA2LjAzMzg4NCANCkwgMjU3LjkzMDA2MSAtMjA2LjAzMzg4NCANCkwgMjU4LjA4OTg5NSAtMjA2LjAzMzg4NCANCkwgMjU4LjI0OTcyOSAtMjA2LjAzMzg4NCANCkwgMjU4LjQwOTU2MyAtMjA2LjAzMzg4NCANCkwgMjU4LjU2OTM5NyAtMjA2LjAzMzg4NCANCkwgMjU4LjcyOTIzMSAtMjA2LjAzMzg4NCANCkwgMjU4Ljg4OTA2NSAtMjA2LjAzMzg4NCANCkwgMjU5LjA0ODg5OSAtMjA2LjAzMzg4NCANCkwgMjU5LjIwODczMiAtMjA2LjAzMzg4NCANCkwgMjU5LjM2ODU2NiAtMjA2LjAzMzg4NCANCkwgMjU5LjUyODQgLTIwNi4wMzM4ODQgDQpMIDI1OS42ODgyMzQgLTIwNi4wMzM4ODQgDQpMIDI1OS44NDgwNjggLTIwNi4wMzM4ODQgDQpMIDI2MC4wMDc5MDIgLTIwNi4wMzM4ODQgDQpMIDI2MC4xNjc3MzYgLTIwNi4wMzM4ODQgDQpMIDI2MC4zMjc1NyAtMjA2LjAzMzg4NCANCkwgMjYwLjQ4NzQwMyAtMjA2LjAzMzg4NCANCkwgMjYwLjY0NzIzNyAtMjA2LjAzMzg4NCANCkwgMjYwLjgwNzA3MSAtMjA2LjAzMzg4NCANCkwgMjYwLjk2NjkwNSAtMjA2LjAzMzg4NCANCkwgMjYxLjEyNjczOSAtMjA2LjAzMzg4NCANCkwgMjYxLjI4NjU3MyAtMjA2LjAzMzg4NCANCkwgMjYxLjQ0NjQwNyAtMjA2LjAzMzg4NCANCkwgMjYxLjYwNjI0MSAtMjA2LjAzMzg4NCANCkwgMjYxLjc2NjA3NSAtMjA2LjAzMzg4NCANCkwgMjYxLjkyNTkwOCAtMjA2LjAzMzg4NCANCkwgMjYyLjA4NTc0MiAtMjA2LjAzMzg4NCANCkwgMjYyLjI0NTU3NiAtMjA2LjAzMzg4NCANCkwgMjYyLjQwNTQxIC0yMDYuMDMzODg0IA0KTCAyNjIuNTY1MjQ0IC0yMDYuMDMzODg0IA0KTCAyNjIuNzI1MDc4IC0yMDYuMDMzODg0IA0KTCAyNjIuODg0OTEyIC0yMDYuMDMzODg0IA0KTCAyNjMuMDQ0NzQ2IC0yMDYuMDMzODg0IA0KTCAyNjMuMjA0NTggLTIwNi4wMzM4ODQgDQpMIDI2My4zNjQ0MTMgLTIwNi4wMzM4ODQgDQpMIDI2My41MjQyNDcgLTIwNi4wMzM4ODQgDQpMIDI2My42ODQwODEgLTIwNi4wMzM4ODQgDQpMIDI2My44NDM5MTUgLTIwNi4wMzM4ODQgDQpMIDI2NC4wMDM3NDkgLTIwNi4wMzM4ODQgDQpMIDI2NC4xNjM1ODMgLTIwNi4wMzM4ODQgDQpMIDI2NC4zMjM0MTcgLTIwNi4wMzM4ODQgDQpMIDI2NC40ODMyNTEgLTIwNi4wMzM4ODQgDQpMIDI2NC42NDMwODQgLTIwNi4wMzM4ODQgDQpMIDI2NC44MDI5MTggLTIwNi4wMzM4ODQgDQpMIDI2NC45NjI3NTIgLTIwNi4wMzM4ODQgDQpMIDI2NS4xMjI1ODYgLTIwNi4wMzM4ODQgDQpMIDI2NS4yODI0MiAtMjA2LjAzMzg4NCANCkwgMjY1LjQ0MjI1NCAtMjA2LjAzMzg4NCANCkwgMjY1LjYwMjA4OCAtMjA2LjAzMzg4NCANCkwgMjY1Ljc2MTkyMiAtMjA2LjAzMzg4NCANCkwgMjY1LjkyMTc1NiAtMjA2LjAzMzg4NCANCkwgMjY2LjA4MTU4OSAtMjA2LjAzMzg4NCANCkwgMjY2LjI0MTQyMyAtMjA2LjAzMzg4NCANCkwgMjY2LjQwMTI1NyAtMjA2LjAzMzg4NCANCkwgMjY2LjU2MTA5MSAtMjA2LjAzMzg4NCANCkwgMjY2LjcyMDkyNSAtMjA2LjAzMzg4NCANCkwgMjY2Ljg4MDc1OSAtMjA2LjAzMzg4NCANCkwgMjY3LjA0MDU5MyAtMjA2LjAzMzg4NCANCkwgMjY3LjIwMDQyNyAtMjA2LjAzMzg4NCANCkwgMjY3LjM2MDI2MSAtMjA2LjAzMzg4NCANCkwgMjY3LjUyMDA5NCAtMjA2LjAzMzg4NCANCkwgMjY3LjY3OTkyOCAtMjA2LjAzMzg4NCANCkwgMjY3LjgzOTc2MiAtMjA2LjAzMzg4NCANCkwgMjY3Ljk5OTU5NiAtMjA2LjAzMzg4NCANCkwgMjY4LjE1OTQzIC0yMDYuMDMzODg0IA0KTCAyNjguMzE5MjY0IC0yMDYuMDMzODg0IA0KTCAyNjguNDc5MDk4IC0yMDYuMDMzODg0IA0KTCAyNjguNjM4OTMyIC0yMDYuMDMzODg0IA0KTCAyNjguNzk4NzY1IC0yMDYuMDMzODg0IA0KTCAyNjguOTU4NTk5IC0yMDYuMDMzODg0IA0KTCAyNjkuMTE4NDMzIC0yMDYuMDMzODg0IA0KTCAyNjkuMjc4MjY3IC0yMDYuMDMzODg0IA0KTCAyNjkuNDM4MTAxIC0yMDYuMDMzODg0IA0KTCAyNjkuNTk3OTM1IC0yMDYuMDMzODg0IA0KTCAyNjkuNzU3NzY5IC0yMDYuMDMzODg0IA0KTCAyNjkuOTE3NjAzIC0yMDYuMDMzODg0IA0KTCAyNzAuMDc3NDM3IC0yMDYuMDMzODg0IA0KTCAyNzAuMjM3MjcgLTIwNi4wMzM4ODQgDQpMIDI3MC4zOTcxMDQgLTIwNi4wMzM4ODQgDQpMIDI3MC41NTY5MzggLTIwNi4wMzM4ODQgDQpMIDI3MC43MTY3NzIgLTIwNi4wMzM4ODQgDQpMIDI3MC44NzY2MDYgLTIwNi4wMzM4ODQgDQpMIDI3MS4wMzY0NCAtMjA2LjAzMzg4NCANCkwgMjcxLjE5NjI3NCAtMjA2LjAzMzg4NCANCkwgMjcxLjM1NjEwOCAtMjA2LjAzMzg4NCANCkwgMjcxLjUxNTk0MSAtMjA2LjAzMzg4NCANCkwgMjcxLjY3NTc3NSAtMjA2LjAzMzg4NCANCkwgMjcxLjgzNTYwOSAtMjA2LjAzMzg4NCANCkwgMjcxLjk5NTQ0MyAtMjA2LjAzMzg4NCANCkwgMjcyLjE1NTI3NyAtMjA2LjAzMzg4NCANCkwgMjcyLjMxNTExMSAtMjA2LjAzMzg4NCANCkwgMjcyLjQ3NDk0NSAtMjA2LjAzMzg4NCANCkwgMjcyLjYzNDc3OSAtMjA2LjAzMzg4NCANCkwgMjcyLjc5NDYxMyAtMjA2LjAzMzg4NCANCkwgMjcyLjk1NDQ0NiAtMjA2LjAzMzg4NCANCkwgMjczLjExNDI4IC0yMDYuMDMzODg0IA0KTCAyNzMuMjc0MTE0IC0yMDYuMDMzODg0IA0KTCAyNzMuNDMzOTQ4IC0yMDYuMDMzODg0IA0KTCAyNzMuNTkzNzgyIC0yMDYuMDMzODg0IA0KTCAyNzMuNzUzNjE2IC0yMDYuMDMzODg0IA0KTCAyNzMuOTEzNDUgLTIwNi4wMzM4ODQgDQpMIDI3NC4wNzMyODQgLTIwNi4wMzM4ODQgDQpMIDI3NC4yMzMxMTggLTIwNi4wMzM4ODQgDQpMIDI3NC4zOTI5NTEgLTIwNi4wMzM4ODQgDQpMIDI3NC41NTI3ODUgLTIwNi4wMzM4ODQgDQpMIDI3NC43MTI2MTkgLTIwNi4wMzM4ODQgDQpMIDI3NC44NzI0NTMgLTIwNi4wMzM4ODQgDQpMIDI3NS4wMzIyODcgLTIwNi4wMzM4ODQgDQpMIDI3NS4xOTIxMjEgLTIwNi4wMzM4ODQgDQpMIDI3NS4zNTE5NTUgLTIwNi4wMzM4ODQgDQpMIDI3NS41MTE3ODkgLTIwNi4wMzM4ODQgDQpMIDI3NS42NzE2MjIgLTIwNi4wMzM4ODQgDQpMIDI3NS44MzE0NTYgLTIwNi4wMzM4ODQgDQpMIDI3NS45OTEyOSAtMjA2LjAzMzg4NCANCkwgMjc2LjE1MTEyNCAtMjA2LjAzMzg4NCANCkwgMjc2LjMxMDk1OCAtMjA2LjAzMzg4NCANCkwgMjc2LjQ3MDc5MiAtMjA2LjAzMzg4NCANCkwgMjc2LjYzMDYyNiAtMjA2LjAzMzg4NCANCkwgMjc2Ljc5MDQ2IC0yMDYuMDMzODg0IA0KTCAyNzYuOTUwMjk0IC0yMDYuMDMzODg0IA0KTCAyNzcuMTEwMTI3IC0yMDYuMDMzODg0IA0KTCAyNzcuMjY5OTYxIC0yMDYuMDMzODg0IA0KTCAyNzcuNDI5Nzk1IC0yMDYuMDMzODg0IA0KTCAyNzcuNTg5NjI5IC0yMDYuMDMzODg0IA0KTCAyNzcuNzQ5NDYzIC0yMDYuMDMzODg0IA0KTCAyNzcuOTA5Mjk3IC0yMDYuMDMzODg0IA0KTCAyNzguMDY5MTMxIC0yMDYuMDMzODg0IA0KTCAyNzguMjI4OTY1IC0yMDYuMDMzODg0IA0KTCAyNzguMzg4Nzk4IC0yMDYuMDMzODg0IA0KTCAyNzguNTQ4NjMyIC0yMDYuMDMzODg0IA0KTCAyNzguNzA4NDY2IC0yMDYuMDMzODg0IA0KTCAyNzguODY4MyAtMjA2LjAzMzg4NCANCkwgMjc5LjAyODEzNCAtMjA2LjAzMzg4NCANCkwgMjc5LjE4Nzk2OCAtMjA2LjAzMzg4NCANCkwgMjc5LjM0NzgwMiAtMjA2LjAzMzg4NCANCkwgMjc5LjUwNzYzNiAtMjA2LjAzMzg4NCANCkwgMjc5LjY2NzQ3IC0yMDYuMDMzODg0IA0KTCAyNzkuODI3MzAzIC0yMDYuMDMzODg0IA0KTCAyNzkuOTg3MTM3IC0yMDYuMDMzODg0IA0KTCAyODAuMTQ2OTcxIC0yMDYuMDMzODg0IA0KTCAyODAuMzA2ODA1IC0yMDYuMDMzODg0IA0KTCAyODAuNDY2NjM5IC0yMDYuMDMzODg0IA0KTCAyODAuNjI2NDczIC0yMDYuMDMzODg0IA0KTCAyODAuNzg2MzA3IC0yMDYuMDMzODg0IA0KTCAyODAuOTQ2MTQxIC0yMDYuMDMzODg0IA0KTCAyODEuMTA1OTc1IC0yMDYuMDMzODg0IA0KTCAyODEuMjY1ODA4IC0yMDYuMDMzODg0IA0KTCAyODEuNDI1NjQyIC0yMDYuMDMzODg0IA0KTCAyODEuNTg1NDc2IC0yMDYuMDMzODg0IA0KTCAyODEuNzQ1MzEgLTIwNi4wMzM4ODQgDQpMIDI4MS45MDUxNDQgLTIwNi4wMzM4ODQgDQpMIDI4Mi4wNjQ5NzggLTIwNi4wMzM4ODQgDQpMIDI4Mi4yMjQ4MTIgLTIwNi4wMzM4ODQgDQpMIDI4Mi4zODQ2NDYgLTIwNi4wMzM4ODQgDQpMIDI4Mi41NDQ0NzkgLTIwNi4wMzM4ODQgDQpMIDI4Mi43MDQzMTMgLTIwNi4wMzM4ODQgDQpMIDI4Mi44NjQxNDcgLTIwNi4wMzM4ODQgDQpMIDI4My4wMjM5ODEgLTIwNi4wMzM4ODQgDQpMIDI4My4xODM4MTUgLTIwNi4wMzM4ODQgDQpMIDI4My4zNDM2NDkgLTIwNi4wMzM4ODQgDQpMIDI4My41MDM0ODMgLTIwNi4wMzM4ODQgDQpMIDI4My42NjMzMTcgLTIwNi4wMzM4ODQgDQpMIDI4My44MjMxNTEgLTIwNi4wMzM4ODQgDQpMIDI4My45ODI5ODQgLTIwNi4wMzM4ODQgDQpMIDI4NC4xNDI4MTggLTIwNi4wMzM4ODQgDQpMIDI4NC4zMDI2NTIgLTIwNi4wMzM4ODQgDQpMIDI4NC40NjI0ODYgLTIwNi4wMzM4ODQgDQpMIDI4NC42MjIzMiAtMjA2LjAzMzg4NCANCkwgMjg0Ljc4MjE1NCAtMjA2LjAzMzg4NCANCkwgMjg0Ljk0MTk4OCAtMjA2LjAzMzg4NCANCkwgMjg1LjEwMTgyMiAtMjA2LjAzMzg4NCANCkwgMjg1LjI2MTY1NSAtMjA2LjAzMzg4NCANCkwgMjg1LjQyMTQ4OSAtMjA2LjAzMzg4NCANCkwgMjg1LjU4MTMyMyAtMjA2LjAzMzg4NCANCkwgMjg1Ljc0MTE1NyAtMjA2LjAzMzg4NCANCkwgMjg1LjkwMDk5MSAtMjA2LjAzMzg4NCANCkwgMjg2LjA2MDgyNSAtMjA2LjAzMzg4NCANCkwgMjg2LjIyMDY1OSAtMjA2LjAzMzg4NCANCkwgMjg2LjM4MDQ5MyAtMjA2LjAzMzg4NCANCkwgMjg2LjU0MDMyNyAtMjA2LjAzMzg4NCANCkwgMjg2LjcwMDE2IC0yMDYuMDMzODg0IA0KTCAyODYuODU5OTk0IC0yMDYuMDMzODg0IA0KTCAyODcuMDE5ODI4IC0yMDYuMDMzODg0IA0KTCAyODcuMTc5NjYyIC0yMDYuMDMzODg0IA0KTCAyODcuMzM5NDk2IC0yMDYuMDMzODg0IA0KTCAyODcuNDk5MzMgLTIwNi4wMzM4ODQgDQpMIDI4Ny42NTkxNjQgLTIwNi4wMzM4ODQgDQpMIDI4Ny44MTg5OTggLTIwNi4wMzM4ODQgDQpMIDI4Ny45Nzg4MzIgLTIwNi4wMzM4ODQgDQpMIDI4OC4xMzg2NjUgLTIwNi4wMzM4ODQgDQpMIDI4OC4yOTg0OTkgLTIwNi4wMzM4ODQgDQpMIDI4OC40NTgzMzMgLTIwNi4wMzM4ODQgDQpMIDI4OC42MTgxNjcgLTIwNi4wMzM4ODQgDQpMIDI4OC43NzgwMDEgLTIwNi4wMzM4ODQgDQpMIDI4OC45Mzc4MzUgLTIwNi4wMzM4ODQgDQpMIDI4OS4wOTc2NjkgLTIwNi4wMzM4ODQgDQpMIDI4OS4yNTc1MDMgLTIwNi4wMzM4ODQgDQpMIDI4OS40MTczMzYgLTIwNi4wMzM4ODQgDQpMIDI4OS41NzcxNyAtMjA2LjAzMzg4NCANCkwgMjg5LjczNzAwNCAtMjA2LjAzMzg4NCANCkwgMjg5Ljg5NjgzOCAtMjA2LjAzMzg4NCANCkwgMjkwLjA1NjY3MiAtMjA2LjAzMzg4NCANCkwgMjkwLjIxNjUwNiAtMjA2LjAzMzg4NCANCkwgMjkwLjM3NjM0IC0yMDYuMDMzODg0IA0KTCAyOTAuNTM2MTc0IC0yMDYuMDMzODg0IA0KTCAyOTAuNjk2MDA4IC0yMDYuMDMzODg0IA0KTCAyOTAuODU1ODQxIC0yMDYuMDMzODg0IA0KTCAyOTEuMDE1Njc1IC0yMDYuMDMzODg0IA0KTCAyOTEuMTc1NTA5IC0yMDYuMDMzODg0IA0KTCAyOTEuMzM1MzQzIC0yMDYuMDMzODg0IA0KTCAyOTEuNDk1MTc3IC0yMDYuMDMzODg0IA0KTCAyOTEuNjU1MDExIC0yMDYuMDMzODg0IA0KTCAyOTEuODE0ODQ1IC0yMDYuMDMzODg0IA0KTCAyOTEuOTc0Njc5IC0yMDYuMDMzODg0IA0KTCAyOTIuMTM0NTEzIC0yMDYuMDMzODg0IA0KTCAyOTIuMjk0MzQ2IC0yMDYuMDMzODg0IA0KTCAyOTIuNDU0MTggLTIwNi4wMzM4ODQgDQpMIDI5Mi42MTQwMTQgLTIwNi4wMzM4ODQgDQpMIDI5Mi43NzM4NDggLTIwNi4wMzM4ODQgDQpMIDI5Mi45MzM2ODIgLTIwNi4wMzM4ODQgDQpMIDI5My4wOTM1MTYgLTIwNi4wMzM4ODQgDQpMIDI5My4yNTMzNSAtMjA2LjAzMzg4NCANCkwgMjkzLjQxMzE4NCAtMjA2LjAzMzg4NCANCkwgMjkzLjU3MzAxNyAtMjA2LjAzMzg4NCANCkwgMjkzLjczMjg1MSAtMjA2LjAzMzg4NCANCkwgMjkzLjg5MjY4NSAtMjA2LjAzMzg4NCANCkwgMjk0LjA1MjUxOSAtMjA2LjAzMzg4NCANCkwgMjk0LjIxMjM1MyAtMjA2LjAzMzg4NCANCkwgMjk0LjM3MjE4NyAtMjA2LjAzMzg4NCANCkwgMjk0LjUzMjAyMSAtMjA2LjAzMzg4NCANCkwgMjk0LjY5MTg1NSAtMjA2LjAzMzg4NCANCkwgMjk0Ljg1MTY4OSAtMjA2LjAzMzg4NCANCkwgMjk1LjAxMTUyMiAtMjA2LjAzMzg4NCANCkwgMjk1LjE3MTM1NiAtMjA2LjAzMzg4NCANCkwgMjk1LjMzMTE5IC0yMDYuMDMzODg0IA0KTCAyOTUuNDkxMDI0IC0yMDYuMDMzODg0IA0KTCAyOTUuNjUwODU4IC0yMDYuMDMzODg0IA0KTCAyOTUuODEwNjkyIC0yMDYuMDMzODg0IA0KTCAyOTUuOTcwNTI2IC0yMDYuMDMzODg0IA0KTCAyOTYuMTMwMzYgLTIwNi4wMzM4ODQgDQpMIDI5Ni4yOTAxOTMgLTIwNi4wMzM4ODQgDQpMIDI5Ni40NTAwMjcgLTIwNi4wMzM4ODQgDQpMIDI5Ni42MDk4NjEgLTIwNi4wMzM4ODQgDQpMIDI5Ni43Njk2OTUgLTIwNi4wMzM4ODQgDQpMIDI5Ni45Mjk1MjkgLTIwNi4wMzM4ODQgDQpMIDI5Ny4wODkzNjMgLTIwNi4wMzM4ODQgDQpMIDI5Ny4yNDkxOTcgLTIwNi4wMzM4ODQgDQpMIDI5Ny40MDkwMzEgLTIwNi4wMzM4ODQgDQpMIDI5Ny41Njg4NjUgLTIwNi4wMzM4ODQgDQpMIDI5Ny43Mjg2OTggLTIwNi4wMzM4ODQgDQpMIDI5Ny44ODg1MzIgLTIwNi4wMzM4ODQgDQpMIDI5OC4wNDgzNjYgLTIwNi4wMzM4ODQgDQpMIDI5OC4yMDgyIC0yMDYuMDMzODg0IA0KTCAyOTguMzY4MDM0IC0yMDYuMDMzODg0IA0KTCAyOTguNTI3ODY4IC0yMDYuMDMzODg0IA0KTCAyOTguNjg3NzAyIC0yMDYuMDMzODg0IA0KTCAyOTguODQ3NTM2IC0yMDYuMDMzODg0IA0KTCAyOTkuMDA3MzcgLTIwNi4wMzM4ODQgDQpMIDI5OS4xNjcyMDMgLTIwNi4wMzM4ODQgDQpMIDI5OS4zMjcwMzcgLTIwNi4wMzM4ODQgDQpMIDI5OS40ODY4NzEgLTIwNi4wMzM4ODQgDQpMIDI5OS42NDY3MDUgLTIwNi4wMzM4ODQgDQpMIDI5OS44MDY1MzkgLTIwNi4wMzM4ODQgDQpMIDI5OS45NjYzNzMgLTIwNi4wMzM4ODQgDQpMIDMwMC4xMjYyMDcgLTIwNi4wMzM4ODQgDQpMIDMwMC4yODYwNDEgLTIwNi4wMzM4ODQgDQpMIDMwMC40NDU4NzQgLTIwNi4wMzM4ODQgDQpMIDMwMC42MDU3MDggLTIwNi4wMzM4ODQgDQpMIDMwMC43NjU1NDIgLTIwNi4wMzM4ODQgDQpMIDMwMC45MjUzNzYgLTIwNi4wMzM4ODQgDQpMIDMwMS4wODUyMSAtMjA2LjAzMzg4NCANCkwgMzAxLjI0NTA0NCAtMjA2LjAzMzg4NCANCkwgMzAxLjQwNDg3OCAtMjA2LjAzMzg4NCANCkwgMzAxLjU2NDcxMiAtMjA2LjAzMzg4NCANCkwgMzAxLjcyNDU0NiAtMjA2LjAzMzg4NCANCkwgMzAxLjg4NDM3OSAtMjA2LjAzMzg4NCANCkwgMzAyLjA0NDIxMyAtMjA2LjAzMzg4NCANCkwgMzAyLjIwNDA0NyAtMjA2LjAzMzg4NCANCkwgMzAyLjM2Mzg4MSAtMjA2LjAzMzg4NCANCkwgMzAyLjUyMzcxNSAtMjA2LjAzMzg4NCANCkwgMzAyLjY4MzU0OSAtMjA2LjAzMzg4NCANCkwgMzAyLjg0MzM4MyAtMjA2LjAzMzg4NCANCkwgMzAzLjAwMzIxNyAtMjA2LjAzMzg4NCANCkwgMzAzLjE2MzA1IC0yMDYuMDMzODg0IA0KTCAzMDMuMzIyODg0IC0yMDYuMDMzODg0IA0KTCAzMDMuNDgyNzE4IC0yMDYuMDMzODg0IA0KTCAzMDMuNjQyNTUyIC0yMDYuMDMzODg0IA0KTCAzMDMuODAyMzg2IC0yMDYuMDMzODg0IA0KTCAzMDMuOTYyMjIgLTIwNi4wMzM4ODQgDQpMIDMwNC4xMjIwNTQgLTIwNi4wMzM4ODQgDQpMIDMwNC4yODE4ODggLTIwNi4wMzM4ODQgDQpMIDMwNC40NDE3MjIgLTIwNi4wMzM4ODQgDQpMIDMwNC42MDE1NTUgLTIwNi4wMzM4ODQgDQpMIDMwNC43NjEzODkgLTIwNi4wMzM4ODQgDQpMIDMwNC45MjEyMjMgLTIwNi4wMzM4ODQgDQpMIDMwNS4wODEwNTcgLTIwNi4wMzM4ODQgDQpMIDMwNS4yNDA4OTEgLTIwNi4wMzM4ODQgDQpMIDMwNS40MDA3MjUgLTIwNi4wMzM4ODQgDQpMIDMwNS41NjA1NTkgLTIwNi4wMzM4ODQgDQpMIDMwNS43MjAzOTMgLTIwNi4wMzM4ODQgDQpMIDMwNS44ODAyMjcgLTIwNi4wMzM4ODQgDQpMIDMwNi4wNDAwNiAtMjA2LjAzMzg4NCANCkwgMzA2LjE5OTg5NCAtMjA2LjAzMzg4NCANCkwgMzA2LjM1OTcyOCAtMjA2LjAzMzg4NCANCkwgMzA2LjUxOTU2MiAtMjA2LjAzMzg4NCANCkwgMzA2LjY3OTM5NiAtMjA2LjAzMzg4NCANCkwgMzA2LjgzOTIzIC0yMDYuMDMzODg0IA0KTCAzMDYuOTk5MDY0IC0yMDYuMDMzODg0IA0KTCAzMDcuMTU4ODk4IC0yMDYuMDMzODg0IA0KTCAzMDcuMzE4NzMxIC0yMDYuMDMzODg0IA0KTCAzMDcuNDc4NTY1IC0yMDYuMDMzODg0IA0KTCAzMDcuNjM4Mzk5IC0yMDYuMDMzODg0IA0KTCAzMDcuNzk4MjMzIC0yMDYuMDMzODg0IA0KTCAzMDcuOTU4MDY3IC0yMDYuMDMzODg0IA0KTCAzMDguMTE3OTAxIC0yMDYuMDMzODg0IA0KTCAzMDguMjc3NzM1IC0yMDYuMDMzODg0IA0KTCAzMDguNDM3NTY5IC0yMDYuMDMzODg0IA0KTCAzMDguNTk3NDAzIC0yMDYuMDMzODg0IA0KTCAzMDguNzU3MjM2IC0yMDYuMDMzODg0IA0KTCAzMDguOTE3MDcgLTIwNi4wMzM4ODQgDQpMIDMwOS4wNzY5MDQgLTIwNi4wMzM4ODQgDQpMIDMwOS4yMzY3MzggLTIwNi4wMzM4ODQgDQpMIDMwOS4zOTY1NzIgLTIwNi4wMzM4ODQgDQpMIDMwOS41NTY0MDYgLTIwNi4wMzM4ODQgDQpMIDMwOS43MTYyNCAtMjA2LjAzMzg4NCANCkwgMzA5Ljg3NjA3NCAtMjA2LjAzMzg4NCANCkwgMzEwLjAzNTkwOCAtMjA2LjAzMzg4NCANCkwgMzEwLjE5NTc0MSAtMjA2LjAzMzg4NCANCkwgMzEwLjM1NTU3NSAtMjA2LjAzMzg4NCANCkwgMzEwLjUxNTQwOSAtMjA2LjAzMzg4NCANCkwgMzEwLjY3NTI0MyAtMjA2LjAzMzg4NCANCkwgMzEwLjgzNTA3NyAtMjA2LjAzMzg4NCANCkwgMzEwLjk5NDkxMSAtMjA2LjAzMzg4NCANCkwgMzExLjE1NDc0NSAtMjA2LjAzMzg4NCANCkwgMzExLjMxNDU3OSAtMjA2LjAzMzg4NCANCkwgMzExLjQ3NDQxMiAtMjA2LjAzMzg4NCANCkwgMzExLjYzNDI0NiAtMjA2LjAzMzg4NCANCkwgMzExLjc5NDA4IC0yMDYuMDMzODg0IA0KTCAzMTEuOTUzOTE0IC0yMDYuMDMzODg0IA0KTCAzMTIuMTEzNzQ4IC0yMDYuMDMzODg0IA0KTCAzMTIuMjczNTgyIC0yMDYuMDMzODg0IA0KTCAzMTIuNDMzNDE2IC0yMDYuMDMzODg0IA0KTCAzMTIuNTkzMjUgLTIwNi4wMzM4ODQgDQpMIDMxMi43NTMwODQgLTIwNi4wMzM4ODQgDQpMIDMxMi45MTI5MTcgLTIwNi4wMzM4ODQgDQpMIDMxMy4wNzI3NTEgLTIwNi4wMzM4ODQgDQpMIDMxMy4yMzI1ODUgLTIwNi4wMzM4ODQgDQpMIDMxMy4zOTI0MTkgLTIwNi4wMzM4ODQgDQpMIDMxMy41NTIyNTMgLTIwNi4wMzM4ODQgDQpMIDMxMy43MTIwODcgLTIwNi4wMzM4ODQgDQpMIDMxMy44NzE5MjEgLTIwNi4wMzM4ODQgDQpMIDMxNC4wMzE3NTUgLTIwNi4wMzM4ODQgDQpMIDMxNC4xOTE1ODggLTIwNi4wMzM4ODQgDQpMIDMxNC4zNTE0MjIgLTIwNi4wMzM4ODQgDQpMIDMxNC41MTEyNTYgLTIwNi4wMzM4ODQgDQpMIDMxNC42NzEwOSAtMjA2LjAzMzg4NCANCkwgMzE0LjgzMDkyNCAtMjA2LjAzMzg4NCANCkwgMzE0Ljk5MDc1OCAtMjA2LjAzMzg4NCANCkwgMzE1LjE1MDU5MiAtMjA2LjAzMzg4NCANCkwgMzE1LjMxMDQyNiAtMjA2LjAzMzg4NCANCkwgMzE1LjQ3MDI2IC0yMDYuMDMzODg0IA0KTCAzMTUuNjMwMDkzIC0yMDYuMDMzODg0IA0KTCAzMTUuNzg5OTI3IC0yMDYuMDMzODg0IA0KTCAzMTUuOTQ5NzYxIC0yMDYuMDMzODg0IA0KTCAzMTYuMTA5NTk1IC0yMDYuMDMzODg0IA0KTCAzMTYuMjY5NDI5IC0yMDYuMDMzODg0IA0KTCAzMTYuNDI5MjYzIC0yMDYuMDMzODg0IA0KTCAzMTYuNTg5MDk3IC0yMDYuMDMzODg0IA0KTCAzMTYuNzQ4OTMxIC0yMDYuMDMzODg0IA0KTCAzMTYuOTA4NzY1IC0yMDYuMDMzODg0IA0KTCAzMTcuMDY4NTk4IC0yMDYuMDMzODg0IA0KTCAzMTcuMjI4NDMyIC0yMDYuMDMzODg0IA0KTCAzMTcuMzg4MjY2IC0yMDYuMDMzODg0IA0KTCAzMTcuNTQ4MSAtMjA2LjAzMzg4NCANCkwgMzE3LjcwNzkzNCAtMjA2LjAzMzg4NCANCkwgMzE3Ljg2Nzc2OCAtMjA2LjAzMzg4NCANCkwgMzE4LjAyNzYwMiAtMjA2LjAzMzg4NCANCkwgMzE4LjE4NzQzNiAtMjA2LjAzMzg4NCANCkwgMzE4LjM0NzI2OSAtMjA2LjAzMzg4NCANCkwgMzE4LjUwNzEwMyAtMjA2LjAzMzg4NCANCkwgMzE4LjY2NjkzNyAtMjA2LjAzMzg4NCANCkwgMzE4LjgyNjc3MSAtMjA2LjAzMzg4NCANCkwgMzE4Ljk4NjYwNSAtMjA2LjAzMzg4NCANCkwgMzE5LjE0NjQzOSAtMjA2LjAzMzg4NCANCkwgMzE5LjMwNjI3MyAtMjA2LjAzMzg4NCANCkwgMzE5LjQ2NjEwNyAtMjA2LjAzMzg4NCANCkwgMzE5LjYyNTk0MSAtMjA2LjAzMzg4NCANCkwgMzE5Ljc4NTc3NCAtMjA2LjAzMzg4NCANCkwgMzE5Ljk0NTYwOCAtMjA2LjAzMzg4NCANCkwgMzIwLjEwNTQ0MiAtMjA2LjAzMzg4NCANCkwgMzIwLjI2NTI3NiAtMjA2LjAzMzg4NCANCkwgMzIwLjQyNTExIC0yMDYuMDMzODg0IA0KTCAzMjAuNTg0OTQ0IC0yMDYuMDMzODg0IA0KTCAzMjAuNzQ0Nzc4IC0yMDYuMDMzODg0IA0KTCAzMjAuOTA0NjEyIC0yMDYuMDMzODg0IA0KTCAzMjEuMDY0NDQ1IC0yMDYuMDMzODg0IA0KTCAzMjEuMjI0Mjc5IC0yMDYuMDMzODg0IA0KTCAzMjEuMzg0MTEzIC0yMDYuMDMzODg0IA0KTCAzMjEuNTQzOTQ3IC0yMDYuMDMzODg0IA0KTCAzMjEuNzAzNzgxIC0yMDYuMDMzODg0IA0KTCAzMjEuODYzNjE1IC0yMDYuMDMzODg0IA0KTCAzMjIuMDIzNDQ5IC0yMDYuMDMzODg0IA0KTCAzMjIuMTgzMjgzIC0yMDYuMDMzODg0IA0KTCAzMjIuMzQzMTE3IC0yMDYuMDMzODg0IA0KTCAzMjIuNTAyOTUgLTIwNi4wMzM4ODQgDQpMIDMyMi42NjI3ODQgLTIwNi4wMzM4ODQgDQpMIDMyMi44MjI2MTggLTIwNi4wMzM4ODQgDQpMIDMyMi45ODI0NTIgLTIwNi4wMzM4ODQgDQpMIDMyMy4xNDIyODYgLTIwNi4wMzM4ODQgDQpMIDMyMy4zMDIxMiAtMjA2LjAzMzg4NCANCkwgMzIzLjQ2MTk1NCAtMjA2LjAzMzg4NCANCkwgMzIzLjYyMTc4OCAtMjA2LjAzMzg4NCANCkwgMzIzLjc4MTYyMiAtMjA2LjAzMzg4NCANCkwgMzIzLjk0MTQ1NSAtMjA2LjAzMzg4NCANCkwgMzI0LjEwMTI4OSAtMjA2LjAzMzg4NCANCkwgMzI0LjI2MTEyMyAtMjA2LjAzMzg4NCANCkwgMzI0LjQyMDk1NyAtMjA2LjAzMzg4NCANCkwgMzI0LjU4MDc5MSAtMjA2LjAzMzg4NCANCkwgMzI0Ljc0MDYyNSAtMjA2LjAzMzg4NCANCkwgMzI0LjkwMDQ1OSAtMjA2LjAzMzg4NCANCkwgMzI1LjA2MDI5MyAtMjA2LjAzMzg4NCANCkwgMzI1LjIyMDEyNiAtMjA2LjAzMzg4NCANCkwgMzI1LjM3OTk2IC0yMDYuMDMzODg0IA0KTCAzMjUuNTM5Nzk0IC0yMDYuMDMzODg0IA0KTCAzMjUuNjk5NjI4IC0yMDYuMDMzODg0IA0KTCAzMjUuODU5NDYyIC0yMDYuMDMzODg0IA0KTCAzMjYuMDE5Mjk2IC0yMDYuMDMzODg0IA0KTCAzMjYuMTc5MTMgLTIwNi4wMzM4ODQgDQpMIDMyNi4zMzg5NjQgLTIwNi4wMzM4ODQgDQpMIDMyNi40OTg3OTggLTIwNi4wMzM4ODQgDQpMIDMyNi42NTg2MzEgLTIwNi4wMzM4ODQgDQpMIDMyNi44MTg0NjUgLTIwNi4wMzM4ODQgDQpMIDMyNi45NzgyOTkgLTIwNi4wMzM4ODQgDQpMIDMyNy4xMzgxMzMgLTIwNi4wMzM4ODQgDQpMIDMyNy4yOTc5NjcgLTIwNi4wMzM4ODQgDQpMIDMyNy40NTc4MDEgLTIwNi4wMzM4ODQgDQpMIDMyNy42MTc2MzUgLTIwNi4wMzM4ODQgDQpMIDMyNy43Nzc0NjkgLTIwNi4wMzM4ODQgDQpMIDMyNy45MzczMDMgLTIwNi4wMzM4ODQgDQpMIDMyOC4wOTcxMzYgLTIwNi4wMzM4ODQgDQpMIDMyOC4yNTY5NyAtMjA2LjAzMzg4NCANCkwgMzI4LjQxNjgwNCAtMjA2LjAzMzg4NCANCkwgMzI4LjU3NjYzOCAtMjA2LjAzMzg4NCANCkwgMzI4LjczNjQ3MiAtMjA2LjAzMzg4NCANCkwgMzI4Ljg5NjMwNiAtMjA2LjAzMzg4NCANCkwgMzI5LjA1NjE0IC0yMDYuMDMzODg0IA0KTCAzMjkuMjE1OTc0IC0yMDYuMDMzODg0IA0KTCAzMjkuMzc1ODA3IC0yMDYuMDMzODg0IA0KTCAzMjkuNTM1NjQxIC0yMDYuMDMzODg0IA0KTCAzMjkuNjk1NDc1IC0yMDYuMDMzODg0IA0KTCAzMjkuODU1MzA5IC0yMDYuMDMzODg0IA0KTCAzMzAuMDE1MTQzIC0yMDYuMDMzODg0IA0KTCAzMzAuMTc0OTc3IC0yMDYuMDMzODg0IA0KTCAzMzAuMzM0ODExIC0yMDYuMDMzODg0IA0KTCAzMzAuNDk0NjQ1IC0yMDYuMDMzODg0IA0KTCAzMzAuNjU0NDc5IC0yMDYuMDMzODg0IA0KTCAzMzAuODE0MzEyIC0yMDYuMDMzODg0IA0KTCAzMzAuOTc0MTQ2IC0yMDYuMDMzODg0IA0KTCAzMzEuMTMzOTggLTIwNi4wMzM4ODQgDQpMIDMzMS4yOTM4MTQgLTIwNi4wMzM4ODQgDQpMIDMzMS40NTM2NDggLTIwNi4wMzM4ODQgDQpMIDMzMS42MTM0ODIgLTIwNi4wMzM4ODQgDQpMIDMzMS43NzMzMTYgLTIwNi4wMzM4ODQgDQpMIDMzMS45MzMxNSAtMjA2LjAzMzg4NCANCkwgMzMyLjA5Mjk4MyAtMjA2LjAzMzg4NCANCkwgMzMyLjI1MjgxNyAtMjA2LjAzMzg4NCANCkwgMzMyLjQxMjY1MSAtMjA2LjAzMzg4NCANCkwgMzMyLjU3MjQ4NSAtMjA2LjAzMzg4NCANCkwgMzMyLjczMjMxOSAtMjA2LjAzMzg4NCANCkwgMzMyLjg5MjE1MyAtMjA2LjAzMzg4NCANCkwgMzMzLjA1MTk4NyAtMjA2LjAzMzg4NCANCkwgMzMzLjIxMTgyMSAtMjA2LjAzMzg4NCANCkwgMzMzLjM3MTY1NSAtMjA2LjAzMzg4NCANCkwgMzMzLjUzMTQ4OCAtMjA2LjAzMzg4NCANCkwgMzMzLjY5MTMyMiAtMjA2LjAzMzg4NCANCkwgMzMzLjg1MTE1NiAtMjA2LjAzMzg4NCANCkwgMzM0LjAxMDk5IC0yMDYuMDMzODg0IA0KTCAzMzQuMTcwODI0IC0yMDYuMDMzODg0IA0KTCAzMzQuMzMwNjU4IC0yMDYuMDMzODg0IA0KTCAzMzQuNDkwNDkyIC0yMDYuMDMzODg0IA0KTCAzMzQuNjUwMzI2IC0yMDYuMDMzODg0IA0KTCAzMzQuODEwMTYgLTIwNi4wMzM4ODQgDQpMIDMzNC45Njk5OTMgLTIwNi4wMzM4ODQgDQpMIDMzNS4xMjk4MjcgLTIwNi4wMzM4ODQgDQpMIDMzNS4yODk2NjEgLTIwNi4wMzM4ODQgDQpMIDMzNS40NDk0OTUgLTIwNi4wMzM4ODQgDQpMIDMzNS42MDkzMjkgLTIwNi4wMzM4ODQgDQpMIDMzNS43NjkxNjMgLTIwNi4wMzM4ODQgDQpMIDMzNS45Mjg5OTcgLTIwNi4wMzM4ODQgDQpMIDMzNi4wODg4MzEgLTIwNi4wMzM4ODQgDQpMIDMzNi4yNDg2NjQgLTIwNi4wMzM4ODQgDQpMIDMzNi40MDg0OTggLTIwNi4wMzM4ODQgDQpMIDMzNi41NjgzMzIgLTIwNi4wMzM4ODQgDQpMIDMzNi43MjgxNjYgLTIwNi4wMzM4ODQgDQpMIDMzNi44ODggLTIwNi4wMzM4ODQgDQpMIDMzNy4wNDc4MzQgLTIwNi4wMzM4ODQgDQpMIDMzNy4yMDc2NjggLTIwNi4wMzM4ODQgDQpMIDMzNy4zNjc1MDIgLTIwNi4wMzM4ODQgDQpMIDMzNy41MjczMzYgLTIwNi4wMzM4ODQgDQpMIDMzNy42ODcxNjkgLTIwNi4wMzM4ODQgDQpMIDMzNy44NDcwMDMgLTIwNi4wMzM4ODQgDQpMIDMzOC4wMDY4MzcgLTIwNi4wMzM4ODQgDQpMIDMzOC4xNjY2NzEgLTIwNi4wMzM4ODQgDQpMIDMzOC4zMjY1MDUgLTIwNi4wMzM4ODQgDQpMIDMzOC40ODYzMzkgLTIwNi4wMzM4ODQgDQpMIDMzOC42NDYxNzMgLTIwNi4wMzM4ODQgDQpMIDMzOC44MDYwMDcgLTIwNi4wMzM4ODQgDQpMIDMzOC45NjU4NCAtMjA2LjAzMzg4NCANCkwgMzM5LjEyNTY3NCAtMjA2LjAzMzg4NCANCkwgMzM5LjI4NTUwOCAtMjA2LjAzMzg4NCANCkwgMzM5LjQ0NTM0MiAtMjA2LjAzMzg4NCANCkwgMzM5LjYwNTE3NiAtMjA2LjAzMzg4NCANCkwgMzM5Ljc2NTAxIC0yMDYuMDMzODg0IA0KTCAzMzkuOTI0ODQ0IC0yMDYuMDMzODg0IA0KTCAzNDAuMDg0Njc4IC0yMDYuMDMzODg0IA0KTCAzNDAuMjQ0NTEyIC0yMDYuMDMzODg0IA0KTCAzNDAuNDA0MzQ1IC0yMDYuMDMzODg0IA0KTCAzNDAuNTY0MTc5IC0yMDYuMDMzODg0IA0KTCAzNDAuNzI0MDEzIC0yMDYuMDMzODg0IA0KTCAzNDAuODgzODQ3IC0yMDYuMDMzODg0IA0KTCAzNDEuMDQzNjgxIC0yMDYuMDMzODg0IA0KTCAzNDEuMjAzNTE1IC0yMDYuMDMzODg0IA0KTCAzNDEuMzYzMzQ5IC0yMDYuMDMzODg0IA0KTCAzNDEuNTIzMTgzIC0yMDYuMDMzODg0IA0KTCAzNDEuNjgzMDE3IC0yMDYuMDMzODg0IA0KTCAzNDEuODQyODUgLTIwNi4wMzM4ODQgDQpMIDM0Mi4wMDI2ODQgLTIwNi4wMzM4ODQgDQpMIDM0Mi4xNjI1MTggLTIwNi4wMzM4ODQgDQpMIDM0Mi4zMjIzNTIgLTIwNi4wMzM4ODQgDQpMIDM0Mi40ODIxODYgLTIwNi4wMzM4ODQgDQpMIDM0Mi42NDIwMiAtMjA2LjAzMzg4NCANCkwgMzQyLjgwMTg1NCAtMjA2LjAzMzg4NCANCkwgMzQyLjk2MTY4OCAtMjA2LjAzMzg4NCANCkwgMzQzLjEyMTUyMSAtMjA2LjAzMzg4NCANCkwgMzQzLjI4MTM1NSAtMjA2LjAzMzg4NCANCkwgMzQzLjQ0MTE4OSAtMjA2LjAzMzg4NCANCkwgMzQzLjYwMTAyMyAtMjA2LjAzMzg4NCANCkwgMzQzLjc2MDg1NyAtMjA2LjAzMzg4NCANCkwgMzQzLjkyMDY5MSAtMjA2LjAzMzg4NCANCkwgMzQ0LjA4MDUyNSAtMjA2LjAzMzg4NCANCkwgMzQ0LjI0MDM1OSAtMjA2LjAzMzg4NCANCkwgMzQ0LjQwMDE5MyAtMjA2LjAzMzg4NCANCkwgMzQ0LjU2MDAyNiAtMjA2LjAzMzg4NCANCkwgMzQ0LjcxOTg2IC0yMDYuMDMzODg0IA0KTCAzNDQuODc5Njk0IC0yMDYuMDMzODg0IA0KTCAzNDUuMDM5NTI4IC0yMDYuMDMzODg0IA0KTCAzNDUuMTk5MzYyIC0yMDYuMDMzODg0IA0KTCAzNDUuMzU5MTk2IC0yMDYuMDMzODg0IA0KTCAzNDUuNTE5MDMgLTIwNi4wMzM4ODQgDQpMIDM0NS42Nzg4NjQgLTIwNi4wMzM4ODQgDQpMIDM0NS44Mzg2OTcgLTIwNi4wMzM4ODQgDQpMIDM0NS45OTg1MzEgLTIwNi4wMzM4ODQgDQpMIDM0Ni4xNTgzNjUgLTIwNi4wMzM4ODQgDQpMIDM0Ni4zMTgxOTkgLTIwNi4wMzM4ODQgDQpMIDM0Ni40NzgwMzMgLTIwNi4wMzM4ODQgDQpMIDM0Ni42Mzc4NjcgLTIwNi4wMzM4ODQgDQpMIDM0Ni43OTc3MDEgLTIwNi4wMzM4ODQgDQpMIDM0Ni45NTc1MzUgLTIwNi4wMzM4ODQgDQpMIDM0Ny4xMTczNjkgLTIwNi4wMzM4ODQgDQpMIDM0Ny4yNzcyMDIgLTIwNi4wMzM4ODQgDQpMIDM0Ny40MzcwMzYgLTIwNi4wMzM4ODQgDQpMIDM0Ny41OTY4NyAtMjA2LjAzMzg4NCANCkwgMzQ3Ljc1NjcwNCAtMjA2LjAzMzg4NCANCkwgMzQ3LjkxNjUzOCAtMjA2LjAzMzg4NCANCkwgMzQ4LjA3NjM3MiAtMjA2LjAzMzg4NCANCkwgMzQ4LjIzNjIwNiAtMjA2LjAzMzg4NCANCkwgMzQ4LjM5NjA0IC0yMDYuMDMzODg0IA0KTCAzNDguNTU1ODc0IC0yMDYuMDMzODg0IA0KTCAzNDguNzE1NzA3IC0yMDYuMDMzODg0IA0KTCAzNDguODc1NTQxIC0yMDYuMDMzODg0IA0KTCAzNDkuMDM1Mzc1IC0yMDYuMDMzODg0IA0KTCAzNDkuMTk1MjA5IC0yMDYuMDMzODg0IA0KTCAzNDkuMzU1MDQzIC0yMDYuMDMzODg0IA0KTCAzNDkuNTE0ODc3IC0yMDYuMDMzODg0IA0KTCAzNDkuNjc0NzExIC0yMDYuMDMzODg0IA0KTCAzNDkuODM0NTQ1IC0yMDYuMDMzODg0IA0KTCAzNDkuOTk0Mzc4IC0yMDYuMDMzODg0IA0KTCAzNTAuMTU0MjEyIC0yMDYuMDMzODg0IA0KTCAzNTAuMzE0MDQ2IC0yMDYuMDMzODg0IA0KTCAzNTAuNDczODggLTIwNi4wMzM4ODQgDQpMIDM1MC42MzM3MTQgLTIwNi4wMzM4ODQgDQpMIDM1MC43OTM1NDggLTIwNi4wMzM4ODQgDQpMIDM1MC45NTMzODIgLTIwNi4wMzM4ODQgDQpMIDM1MS4xMTMyMTYgLTIwNi4wMzM4ODQgDQpMIDM1MS4yNzMwNSAtMjA2LjAzMzg4NCANCkwgMzUxLjQzMjg4MyAtMjA2LjAzMzg4NCANCkwgMzUxLjU5MjcxNyAtMjA2LjAzMzg4NCANCkwgMzUxLjc1MjU1MSAtMjA2LjAzMzg4NCANCkwgMzUxLjkxMjM4NSAtMjA2LjAzMzg4NCANCkwgMzUyLjA3MjIxOSAtMjA2LjAzMzg4NCANCkwgMzUyLjIzMjA1MyAtMjA2LjAzMzg4NCANCkwgMzUyLjM5MTg4NyAtMjA2LjAzMzg4NCANCkwgMzUyLjU1MTcyMSAtMjA2LjAzMzg4NCANCkwgMzUyLjcxMTU1NSAtMjA2LjAzMzg4NCANCkwgMzUyLjg3MTM4OCAtMjA2LjAzMzg4NCANCkwgMzUzLjAzMTIyMiAtMjA2LjAzMzg4NCANCkwgMzUzLjE5MTA1NiAtMjA2LjAzMzg4NCANCkwgMzUzLjM1MDg5IC0yMDYuMDMzODg0IA0KTCAzNTMuNTEwNzI0IC0yMDYuMDMzODg0IA0KTCAzNTMuNjcwNTU4IC0yMDYuMDMzODg0IA0KTCAzNTMuODMwMzkyIC0yMDYuMDMzODg0IA0KTCAzNTMuOTkwMjI2IC0yMDYuMDMzODg0IA0KTCAzNTQuMTUwMDU5IC0yMDYuMDMzODg0IA0KTCAzNTQuMzA5ODkzIC0yMDYuMDMzODg0IA0KTCAzNTQuNDY5NzI3IC0yMDYuMDMzODg0IA0KTCAzNTQuNjI5NTYxIC0yMDYuMDMzODg0IA0KTCAzNTQuNzg5Mzk1IC0yMDYuMDMzODg0IA0KTCAzNTQuOTQ5MjI5IC0yMDYuMDMzODg0IA0KTCAzNTUuMTA5MDYzIC0yMDYuMDMzODg0IA0KTCAzNTUuMjY4ODk3IC0yMDYuMDMzODg0IA0KTCAzNTUuNDI4NzMxIC0yMDYuMDMzODg0IA0KTCAzNTUuNTg4NTY0IC0yMDYuMDMzODg0IA0KTCAzNTUuNzQ4Mzk4IC0yMDYuMDMzODg0IA0KTCAzNTUuOTA4MjMyIC0yMDYuMDMzODg0IA0KTCAzNTYuMDY4MDY2IC0yMDYuMDMzODg0IA0KTCAzNTYuMjI3OSAtMjA2LjAzMzg4NCANCkwgMzU2LjM4NzczNCAtMjA2LjAzMzg4NCANCkwgMzU2LjU0NzU2OCAtMjA2LjAzMzg4NCANCkwgMzU2LjcwNzQwMiAtMjA2LjAzMzg4NCANCkwgMzU2Ljg2NzIzNSAtMjA2LjAzMzg4NCANCkwgMzU3LjAyNzA2OSAtMjA2LjAzMzg4NCANCkwgMzU3LjE4NjkwMyAtMjA2LjAzMzg4NCANCkwgMzU3LjM0NjczNyAtMjA2LjAzMzg4NCANCkwgMzU3LjUwNjU3MSAtMjA2LjAzMzg4NCANCkwgMzU3LjY2NjQwNSAtMjA2LjAzMzg4NCANCkwgMzU3LjgyNjIzOSAtMjA2LjAzMzg4NCANCkwgMzU3Ljk4NjA3MyAtMjA2LjAzMzg4NCANCkwgMzU4LjE0NTkwNyAtMjA2LjAzMzg4NCANCkwgMzU4LjMwNTc0IC0yMDYuMDMzODg0IA0KTCAzNTguNDY1NTc0IC0yMDYuMDMzODg0IA0KTCAzNTguNjI1NDA4IC0yMDYuMDMzODg0IA0KTCAzNTguNzg1MjQyIC0yMDYuMDMzODg0IA0KTCAzNTguOTQ1MDc2IC0yMDYuMDMzODg0IA0KTCAzNTkuMTA0OTEgLTIwNi4wMzM4ODQgDQpMIDM1OS4yNjQ3NDQgLTIwNi4wMzM4ODQgDQpMIDM1OS40MjQ1NzggLTIwNi4wMzM4ODQgDQpMIDM1OS41ODQ0MTIgLTIwNi4wMzM4ODQgDQpMIDM1OS43NDQyNDUgLTIwNi4wMzM4ODQgDQpMIDM1OS45MDQwNzkgLTIwNi4wMzM4ODQgDQpMIDM2MC4wNjM5MTMgLTIwNi4wMzM4ODQgDQpMIDM2MC4yMjM3NDcgLTIwNi4wMzM4ODQgDQpMIDM2MC4zODM1ODEgLTIwNi4wMzM4ODQgDQpMIDM2MC41NDM0MTUgLTIwNi4wMzM4ODQgDQpMIDM2MC43MDMyNDkgLTIwNi4wMzM4ODQgDQpMIDM2MC44NjMwODMgLTIwNi4wMzM4ODQgDQpMIDM2MS4wMjI5MTYgLTIwNi4wMzM4ODQgDQpMIDM2MS4xODI3NSAtMjA2LjAzMzg4NCANCkwgMzYxLjM0MjU4NCAtMjA2LjAzMzg4NCANCkwgMzYxLjUwMjQxOCAtMjA2LjAzMzg4NCANCkwgMzYxLjY2MjI1MiAtMjA2LjAzMzg4NCANCkwgMzYxLjgyMjA4NiAtMjA2LjAzMzg4NCANCkwgMzYxLjk4MTkyIC0yMDYuMDMzODg0IA0KTCAzNjIuMTQxNzU0IC0yMDYuMDMzODg0IA0KTCAzNjIuMzAxNTg4IC0yMDYuMDMzODg0IA0KTCAzNjIuNDYxNDIxIC0yMDYuMDMzODg0IA0KTCAzNjIuNjIxMjU1IC0yMDYuMDMzODg0IA0KTCAzNjIuNzgxMDg5IC0yMDYuMDMzODg0IA0KTCAzNjIuOTQwOTIzIC0yMDYuMDMzODg0IA0KTCAzNjMuMTAwNzU3IC0yMDYuMDMzODg0IA0KTCAzNjMuMjYwNTkxIC0yMDYuMDMzODg0IA0KTCAzNjMuNDIwNDI1IC0yMDYuMDMzODg0IA0KTCAzNjMuNTgwMjU5IC0yMDYuMDMzODg0IA0KTCAzNjMuNzQwMDkyIC0yMDYuMDMzODg0IA0KTCAzNjMuODk5OTI2IC0yMDYuMDMzODg0IA0KTCAzNjQuMDU5NzYgLTIwNi4wMzM4ODQgDQpMIDM2NC4yMTk1OTQgLTIwNi4wMzM4ODQgDQpMIDM2NC4zNzk0MjggLTIwNi4wMzM4ODQgDQpMIDM2NC41MzkyNjIgLTIwNi4wMzM4ODQgDQpMIDM2NC42OTkwOTYgLTIwNi4wMzM4ODQgDQpMIDM2NC44NTg5MyAtMjA2LjAzMzg4NCANCkwgMzY1LjAxODc2NCAtMjA2LjAzMzg4NCANCkwgMzY1LjE3ODU5NyAtMjA2LjAzMzg4NCANCkwgMzY1LjMzODQzMSAtMjA2LjAzMzg4NCANCkwgMzY1LjQ5ODI2NSAtMjA2LjAzMzg4NCANCkwgMzY1LjY1ODA5OSAtMjA2LjAzMzg4NCANCkwgMzY1LjgxNzkzMyAtMjA2LjAzMzg4NCANCkwgMzY1Ljk3Nzc2NyAtMjA2LjAzMzg4NCANCkwgMzY2LjEzNzYwMSAtMjA2LjAzMzg4NCANCkwgMzY2LjI5NzQzNSAtMjA2LjAzMzg4NCANCkwgMzY2LjQ1NzI2OSAtMjA2LjAzMzg4NCANCkwgMzY2LjYxNzEwMiAtMjA2LjAzMzg4NCANCkwgMzY2Ljc3NjkzNiAtMjA2LjAzMzg4NCANCkwgMzY2LjkzNjc3IC0yMDYuMDMzODg0IA0KTCAzNjcuMDk2NjA0IC0yMDYuMDMzODg0IA0KTCAzNjcuMjU2NDM4IC0yMDYuMDMzODg0IA0KTCAzNjcuNDE2MjcyIC0yMDYuMDMzODg0IA0KTCAzNjcuNTc2MTA2IC0yMDYuMDMzODg0IA0KTCAzNjcuNzM1OTQgLTIwNi4wMzM4ODQgDQpMIDM2Ny44OTU3NzMgLTIwNi4wMzM4ODQgDQpMIDM2OC4wNTU2MDcgLTIwNi4wMzM4ODQgDQpMIDM2OC4yMTU0NDEgLTIwNi4wMzM4ODQgDQpMIDM2OC4zNzUyNzUgLTIwNi4wMzM4ODQgDQpMIDM2OC41MzUxMDkgLTIwNi4wMzM4ODQgDQpMIDM2OC42OTQ5NDMgLTIwNi4wMzM4ODQgDQpMIDM2OC44NTQ3NzcgLTIwNi4wMzM4ODQgDQpMIDM2OS4wMTQ2MTEgLTIwNi4wMzM4ODQgDQpMIDM2OS4xNzQ0NDUgLTIwNi4wMzM4ODQgDQpMIDM2OS4zMzQyNzggLTIwNi4wMzM4ODQgDQpMIDM2OS40OTQxMTIgLTIwNi4wMzM4ODQgDQpMIDM2OS42NTM5NDYgLTIwNi4wMzM4ODQgDQpMIDM2OS44MTM3OCAtMjA2LjAzMzg4NCANCkwgMzY5Ljk3MzYxNCAtMjA2LjAzMzg4NCANCkwgMzcwLjEzMzQ0OCAtMjA2LjAzMzg4NCANCkwgMzcwLjI5MzI4MiAtMjA2LjAzMzg4NCANCkwgMzcwLjQ1MzExNiAtMjA2LjAzMzg4NCANCkwgMzcwLjYxMjk1IC0yMDYuMDMzODg0IA0KTCAzNzAuNzcyNzgzIC0yMDYuMDMzODg0IA0KTCAzNzAuOTMyNjE3IC0yMDYuMDMzODg0IA0KTCAzNzEuMDkyNDUxIC0yMDYuMDMzODg0IA0KTCAzNzEuMjUyMjg1IC0yMDYuMDMzODg0IA0KTCAzNzEuNDEyMTE5IC0yMDYuMDMzODg0IA0KTCAzNzEuNTcxOTUzIC0yMDYuMDMzODg0IA0KTCAzNzEuNzMxNzg3IC0yMDYuMDMzODg0IA0KTCAzNzEuODkxNjIxIC0yMDYuMDMzODg0IA0KTCAzNzIuMDUxNDU0IC0yMDYuMDMzODg0IA0KTCAzNzIuMjExMjg4IC0yMDYuMDMzODg0IA0KTCAzNzIuMzcxMTIyIC0yMDYuMDMzODg0IA0KTCAzNzIuNTMwOTU2IC0yMDYuMDMzODg0IA0KTCAzNzIuNjkwNzkgLTIwNi4wMzM4ODQgDQpMIDM3Mi44NTA2MjQgLTIwNi4wMzM4ODQgDQpMIDM3My4wMTA0NTggLTIwNi4wMzM4ODQgDQpMIDM3My4xNzAyOTIgLTIwNi4wMzM4ODQgDQpMIDM3My4zMzAxMjYgLTIwNi4wMzM4ODQgDQpMIDM3My40ODk5NTkgLTIwNi4wMzM4ODQgDQpMIDM3My42NDk3OTMgLTIwNi4wMzM4ODQgDQpMIDM3My44MDk2MjcgLTIwNi4wMzM4ODQgDQpMIDM3My45Njk0NjEgLTIwNi4wMzM4ODQgDQpMIDM3NC4xMjkyOTUgLTIwNi4wMzM4ODQgDQpMIDM3NC4yODkxMjkgLTIwNi4wMzM4ODQgDQpMIDM3NC40NDg5NjMgLTIwNi4wMzM4ODQgDQpMIDM3NC42MDg3OTcgLTIwNi4wMzM4ODQgDQpMIDM3NC43Njg2MyAtMjA2LjAzMzg4NCANCkwgMzc0LjkyODQ2NCAtMjA2LjAzMzg4NCANCkwgMzc1LjA4ODI5OCAtMjA2LjAzMzg4NCANCkwgMzc1LjI0ODEzMiAtMjA2LjAzMzg4NCANCkwgMzc1LjQwNzk2NiAtMjA2LjAzMzg4NCANCkwgMzc1LjU2NzggLTIwNi4wMzM4ODQgDQpMIDM3NS43Mjc2MzQgLTIwNi4wMzM4ODQgDQpMIDM3NS44ODc0NjggLTIwNi4wMzM4ODQgDQpMIDM3Ni4wNDczMDIgLTIwNi4wMzM4ODQgDQpMIDM3Ni4yMDcxMzUgLTIwNi4wMzM4ODQgDQpMIDM3Ni4zNjY5NjkgLTIwNi4wMzM4ODQgDQpMIDM3Ni41MjY4MDMgLTIwNi4wMzM4ODQgDQpMIDM3Ni42ODY2MzcgLTIwNi4wMzM4ODQgDQpMIDM3Ni44NDY0NzEgLTIwNi4wMzM4ODQgDQpMIDM3Ny4wMDYzMDUgLTIwNi4wMzM4ODQgDQpMIDM3Ny4xNjYxMzkgLTIwNi4wMzM4ODQgDQpMIDM3Ny4zMjU5NzMgLTIwNi4wMzM4ODQgDQpMIDM3Ny40ODU4MDcgLTIwNi4wMzM4ODQgDQpMIDM3Ny42NDU2NCAtMjA2LjAzMzg4NCANCkwgMzc3LjgwNTQ3NCAtMjA2LjAzMzg4NCANCkwgMzc3Ljk2NTMwOCAtMjA2LjAzMzg4NCANCkwgMzc4LjEyNTE0MiAtMjA2LjAzMzg4NCANCkwgMzc4LjI4NDk3NiAtMjA2LjAzMzg4NCANCkwgMzc4LjQ0NDgxIC0yMDYuMDMzODg0IA0KTCAzNzguNjA0NjQ0IC0yMDYuMDMzODg0IA0KTCAzNzguNzY0NDc4IC0yMDYuMDMzODg0IA0KTCAzNzguOTI0MzExIC0yMDYuMDMzODg0IA0KTCAzNzkuMDg0MTQ1IC0yMDYuMDMzODg0IA0KTCAzNzkuMjQzOTc5IC0yMDYuMDMzODg0IA0KTCAzNzkuNDAzODEzIC0yMDYuMDMzODg0IA0KTCAzNzkuNTYzNjQ3IC0yMDYuMDMzODg0IA0KTCAzNzkuNzIzNDgxIC0yMDYuMDMzODg0IA0KTCAzNzkuODgzMzE1IC0yMDYuMDMzODg0IA0KTCAzODAuMDQzMTQ5IC0yMDYuMDMzODg0IA0KTCAzODAuMjAyOTgzIC0yMDYuMDMzODg0IA0KTCAzODAuMzYyODE2IC0yMDYuMDMzODg0IA0KTCAzODAuNTIyNjUgLTIwNi4wMzM4ODQgDQpMIDM4MC42ODI0ODQgLTIwNi4wMzM4ODQgDQpMIDM4MC44NDIzMTggLTIwNi4wMzM4ODQgDQpMIDM4MS4wMDIxNTIgLTIwNi4wMzM4ODQgDQpMIDM4MS4xNjE5ODYgLTIwNi4wMzM4ODQgDQpMIDM4MS4zMjE4MiAtMjA2LjAzMzg4NCANCkwgMzgxLjQ4MTY1NCAtMjA2LjAzMzg4NCANCkwgMzgxLjY0MTQ4NyAtMjA2LjAzMzg4NCANCkwgMzgxLjgwMTMyMSAtMjA2LjAzMzg4NCANCkwgMzgxLjk2MTE1NSAtMjA2LjAzMzg4NCANCkwgMzgyLjEyMDk4OSAtMjA2LjAzMzg4NCANCkwgMzgyLjI4MDgyMyAtMjA2LjAzMzg4NCANCkwgMzgyLjQ0MDY1NyAtMjA2LjAzMzg4NCANCkwgMzgyLjYwMDQ5MSAtMjA2LjAzMzg4NCANCkwgMzgyLjc2MDMyNSAtMjA2LjAzMzg4NCANCkwgMzgyLjkyMDE1OSAtMjA2LjAzMzg4NCANCkwgMzgzLjA3OTk5MiAtMjA2LjAzMzg4NCANCkwgMzgzLjIzOTgyNiAtMjA2LjAzMzg4NCANCkwgMzgzLjM5OTY2IC0yMDYuMDMzODg0IA0KTCAzODMuNTU5NDk0IC0yMDYuMDMzODg0IA0KTCAzODMuNzE5MzI4IC0yMDYuMDMzODg0IA0KTCAzODMuODc5MTYyIC0yMDYuMDMzODg0IA0KTCAzODQuMDM4OTk2IC0yMDYuMDMzODg0IA0KTCAzODQuMTk4ODMgLTIwNi4wMzM4ODQgDQpMIDM4NC4zNTg2NjQgLTIwNi4wMzM4ODQgDQpMIDM4NC41MTg0OTcgLTIwNi4wMzM4ODQgDQpMIDM4NC42NzgzMzEgLTIwNi4wMzM4ODQgDQpMIDM4NC44MzgxNjUgLTIwNi4wMzM4ODQgDQpMIDM4NC45OTc5OTkgLTIwNi4wMzM4ODQgDQpMIDM4NS4xNTc4MzMgLTIwNi4wMzM4ODQgDQpMIDM4NS4zMTc2NjcgLTIwNi4wMzM4ODQgDQpMIDM4NS40Nzc1MDEgLTIwNi4wMzM4ODQgDQpMIDM4NS42MzczMzUgLTIwNi4wMzM4ODQgDQpMIDM4NS43OTcxNjggLTIwNi4wMzM4ODQgDQpMIDM4NS45NTcwMDIgLTIwNi4wMzM4ODQgDQpMIDM4Ni4xMTY4MzYgLTIwNi4wMzM4ODQgDQpMIDM4Ni4yNzY2NyAtMjA2LjAzMzg4NCANCkwgMzg2LjQzNjUwNCAtMjA2LjAzMzg4NCANCkwgMzg2LjU5NjMzOCAtMjA2LjAzMzg4NCANCkwgMzg2Ljc1NjE3MiAtMjA2LjAzMzg4NCANCkwgMzg2LjkxNjAwNiAtMjA2LjAzMzg4NCANCkwgMzg3LjA3NTg0IC0yMDYuMDMzODg0IA0KTCAzODcuMjM1NjczIC0yMDYuMDMzODg0IA0KTCAzODcuMzk1NTA3IC0yMDYuMDMzODg0IA0KTCAzODcuNTU1MzQxIC0yMDYuMDMzODg0IA0KTCAzODcuNzE1MTc1IC0yMDYuMDMzODg0IA0KTCAzODcuODc1MDA5IC0yMDYuMDMzODg0IA0KTCAzODguMDM0ODQzIC0yMDYuMDMzODg0IA0KTCAzODguMTk0Njc3IC0yMDYuMDMzODg0IA0KTCAzODguMzU0NTExIC0yMDYuMDMzODg0IA0KTCAzODguNTE0MzQ1IC0yMDYuMDMzODg0IA0KTCAzODguNjc0MTc4IC0yMDYuMDMzODg0IA0KTCAzODguODM0MDEyIC0yMDYuMDMzODg0IA0KTCAzODguOTkzODQ2IC0yMDYuMDMzODg0IA0KTCAzODkuMTUzNjggLTIwNi4wMzM4ODQgDQpMIDM4OS4zMTM1MTQgLTIwNi4wMzM4ODQgDQpMIDM4OS40NzMzNDggLTIwNi4wMzM4ODQgDQpMIDM4OS42MzMxODIgLTIwNi4wMzM4ODQgDQpMIDM4OS43OTMwMTYgLTIwNi4wMzM4ODQgDQpMIDM4OS45NTI4NDkgLTIwNi4wMzM4ODQgDQpMIDM5MC4xMTI2ODMgLTIwNi4wMzM4ODQgDQpMIDM5MC4yNzI1MTcgLTIwNi4wMzM4ODQgDQpMIDM5MC40MzIzNTEgLTIwNi4wMzM4ODQgDQpMIDM5MC41OTIxODUgLTIwNi4wMzM4ODQgDQpMIDM5MC43NTIwMTkgLTIwNi4wMzM4ODQgDQpMIDM5MC45MTE4NTMgLTIwNi4wMzM4ODQgDQpMIDM5MS4wNzE2ODcgLTIwNi4wMzM4ODQgDQpMIDM5MS4yMzE1MjEgLTIwNi4wMzM4ODQgDQpMIDM5MS4zOTEzNTQgLTIwNi4wMzM4ODQgDQpMIDM5MS41NTExODggLTIwNi4wMzM4ODQgDQpMIDM5MS43MTEwMjIgLTIwNi4wMzM4ODQgDQpMIDM5MS44NzA4NTYgLTIwNi4wMzM4ODQgDQpMIDM5Mi4wMzA2OSAtMjA2LjAzMzg4NCANCkwgMzkyLjE5MDUyNCAtMjA2LjAzMzg4NCANCkwgMzkyLjM1MDM1OCAtMjA2LjAzMzg4NCANCkwgMzkyLjUxMDE5MiAtMjA2LjAzMzg4NCANCkwgMzkyLjY3MDAyNSAtMjA2LjAzMzg4NCANCkwgMzkyLjgyOTg1OSAtMjA1LjU4MjcxNCANCkwgMzkyLjk4OTY5MyAtMjA1LjUxNjM2NyANCkwgMzkzLjE0OTUyNyAtMjA1LjQzMDg3NCANCkwgMzkzLjMwOTM2MSAtMjA1LjMzMzA4NCANCkwgMzkzLjQ2OTE5NSAtMjA1LjIyMjQ3NSANCkwgMzkzLjYyOTAyOSAtMjA1LjA4MTcwOSANCkwgMzkzLjc4ODg2MyAtMjA0LjkyMTc3MiANCkwgMzkzLjk0ODY5NyAtMjA0Ljc0MDIwMyANCkwgMzk0LjEwODUzIC0yMDQuNTEwNzcyIA0KTCAzOTQuMjY4MzY0IC0yMDQuMjUxMjIgDQpMIDM5NC40MjgxOTggLTIwMy45NTUzNDEgDQpMIDM5NC41ODgwMzIgLTIwMy41ODU1MTUgDQpMIDM5NC43NDc4NjYgLTIwMy4xNjc5MjYgDQpMIDM5NC45MDc3IC0yMDIuNjg4ODI0IA0KTCAzOTUuMDY3NTM0IC0yMDIuMDk2MDE0IA0KTCAzOTUuMjI3MzY4IC0yMDEuNDI4NzIyIA0KTCAzOTUuMzg3MjAyIC0yMDAuNjU5NDIgDQpMIDM5NS41NDcwMzUgLTE5OS43MTgyNTkgDQpMIDM5NS43MDY4NjkgLTE5OC42NjMxMzEgDQpMIDM5NS44NjY3MDMgLTE5Ny40NDI3NiANCkwgMzk2LjAyNjUzNyAtMTk1Ljk3MDYyNiANCkwgMzk2LjE4NjM3MSAtMTk0LjMzMDM1OCANCkwgMzk2LjM0NjIwNSAtMTkyLjQzMzc0NyANCkwgMzk2LjUwNjAzOSAtMTkwLjE4OTQyIA0KTCAzOTYuNjY1ODczIC0xODcuNzEzMzkyIA0KTCAzOTYuODI1NzA2IC0xODQuODcwOSANCkwgMzk2Ljk4NTU0IC0xODEuNTk1Njk4IA0KTCAzOTcuMTQ1Mzc0IC0xNzguMDM1NTk1IA0KTCAzOTcuMzA1MjA4IC0xNzQuMDE4NTUgDQpMIDM5Ny40NjUwNDIgLTE2OS41NTQ1MzcgDQpMIDM5Ny42MjQ4NzYgLTE2NC44MDM5NzcgDQpMIDM5Ny43ODQ3MSAtMTU5LjYwOTQzOCANCkwgMzk3Ljk0NDU0NCAtMTU0LjA4NTg1NCANCkwgMzk4LjEwNDM3OCAtMTQ4LjM2MjQgDQpMIDM5OC4yNjQyMTEgLTE0Mi4zNzcwMTUgDQpMIDM5OC40MjQwNDUgLTEzNi4yOTYxOTQgDQpMIDM5OC41ODM4NzkgLTEzMC4xNzQ4NCANCkwgMzk4Ljc0MzcxMyAtMTI0LjA4NjY1MSANCkwgMzk4LjkwMzU0NyAtMTE4LjEyNjE5OSANCkwgMzk5LjA2MzM4MSAtMTEyLjI3NzM3MyANCkwgMzk5LjIyMzIxNSAtMTA2LjcwNjk0MiANCkwgMzk5LjM4MzA0OSAtMTAxLjM3OTg1NSANCkwgMzk5LjU0Mjg4MiAtOTYuMjQ5Njk2IA0KTCAzOTkuNzAyNzE2IC05MS41MTYxNzQgDQpMIDM5OS44NjI1NSAtODcuMDQ2OTM0IA0KTCA0MDAuMDIyMzg0IC04Mi43OTgzNTggDQpMIDQwMC4xODIyMTggLTc4Ljk3NTA3NyANCkwgNDAwLjM0MjA1MiAtNzUuMzk2ODAxIA0KTCA0MDAuNTAxODg2IC03Mi4wMzM2NDMgDQpMIDQwMC42NjE3MiAtNjkuMDgxNTA4IA0KTCA0MDAuODIxNTU0IC02Ni4zMzcxMzcgDQpMIDQwMC45ODEzODcgLTYzLjc4NjMwNiANCkwgNDAxLjE0MTIyMSAtNjEuNjAxNDU4IA0KTCA0MDEuMzAxMDU1IC01OS41NzkwNDYgDQpMIDQwMS40NjA4ODkgLTU3LjcyNTk0NSANCkwgNDAxLjYyMDcyMyAtNTYuMTYwODg5IA0KTCA0MDEuNzgwNTU3IC01NC43MjIxMDMgDQpMIDQwMS45NDAzOTEgLTUzLjQyMzA3MyANCkwgNDAyLjEwMDIyNSAtNTIuMzM0OTM5IA0KTCA0MDIuMjYwMDU5IC01MS4zNDE0NDMgDQpMIDQwMi40MTk4OTIgLTUwLjQ1NzMwMyANCkwgNDAyLjU3OTcyNiAtNDkuNzIzMjYxIA0KTCA0MDIuNzM5NTYgLTQ5LjA1ODc3OCANCkwgNDAyLjg5OTM5NCAtNDguNDc3OTAyIA0KTCA0MDMuMDU5MjI4IC00OC4wMDIyOTIgDQpMIDQwMy4yMTkwNjIgLTQ3LjU3ODI0MyANCkwgNDAzLjM3ODg5NiAtNDcuMjE4ODQ2IA0KTCA0MDMuNTM4NzMgLTQ2LjkzNTE5MyANCkwgNDAzLjY5ODU2MyAtNDYuNjkxMTk0IA0KTCA0MDMuODU4Mzk3IC00Ni40OTkyMiANCkwgNDA0LjAxODIzMSAtNDYuMzY1NjMzIA0KTCA0MDQuMTc4MDY1IC00Ni4yNjUxNDcgDQpMIDQwNC4zMzc4OTkgLTQ2LjIxMDkwMSANCkwgNDA0LjQ5NzczMyAtNDYuMjA4MDcxIA0KTCA0MDQuNjU3NTY3IC00Ni4yMzY3OTMgDQpMIDQwNC44MTc0MDEgLTQ2LjMxMjYwMSANCkwgNDA0Ljk3NzIzNSAtNDYuNDQwNjEgDQpMIDQwNS4xMzcwNjggLTQ2LjYwMzI4NyANCkwgNDA1LjI5NjkwMiAtNDYuODIyMDggDQpMIDQwNS40NTY3MzYgLTQ3LjEwMjMxMyANCkwgNDA1LjYxNjU3IC00Ny40MjU5NTUgDQpMIDQwNS43NzY0MDQgLTQ3LjgyNTA1NSANCkwgNDA1LjkzNjIzOCAtNDguMzAzMDMxIA0KTCA0MDYuMDk2MDcyIC00OC44Mzk1NTMgDQpMIDQwNi4yNTU5MDYgLTQ5LjQ4NTAxNyANCkwgNDA2LjQxNTczOSAtNTAuMjM4MDMgDQpMIDQwNi41NzU1NzMgLTUxLjA3Mzc5IA0KTCA0MDYuNzM1NDA3IC01Mi4wNzIyNDEgDQpMIDQwNi44OTUyNDEgLTUzLjIxOTk5IA0KTCA0MDcuMDU1MDc1IC01NC40ODY2ODcgDQpMIDQwNy4yMTQ5MDkgLTU1Ljk5OTM4IA0KTCA0MDcuMzc0NzQzIC01Ny43MTg3NTMgDQpMIDQwNy41MzQ1NzcgLTU5LjYwODQwOCANCkwgNDA3LjY5NDQxMSAtNjEuODYzMjQ2IA0KTCA0MDcuODU0MjQ0IC02NC4zOTU0ODggDQpMIDQwOC4wMTQwNzggLTY3LjE2NDI4MSANCkwgNDA4LjE3MzkxMiAtNzAuNDUwNTkyIA0KTCA0MDguMzMzNzQ2IC03NC4wODA2MzcgDQpMIDQwOC40OTM1OCAtNzguMDE1MzIgDQpMIDQwOC42NTM0MTQgLTgyLjYwMzgxMSANCkwgNDA4LjgxMzI0OCAtODcuNTUzMzYgDQpMIDQwOC45NzMwODIgLTkyLjgzOTMzOSANCkwgNDA5LjEzMjkxNiAtOTguNzc3NTI2IA0KTCA0MDkuMjkyNzQ5IC0xMDQuOTgzNDE1IA0KTCA0MDkuNDUyNTgzIC0xMTEuNDY4MzcgDQpMIDQwOS42MTI0MTcgLTExOC4zMDY3MTIgDQpMIDQwOS43NzIyNTEgLTEyNS4yMTEzODUgDQpMIDQwOS45MzIwODUgLTEzMi4xODMyODIgDQpMIDQxMC4wOTE5MTkgLTEzOS4wMjY1MTUgDQpMIDQxMC4yNTE3NTMgLTE0NS43MDA1MTkgDQpMIDQxMC40MTE1ODcgLTE1Mi4xNTk0MzcgDQpMIDQxMC41NzE0MiAtMTU4LjEwMjExNSANCkwgNDEwLjczMTI1NCAtMTYzLjcyNTg1IA0KTCA0MTAuODkxMDg4IC0xNjguOTQyMDQ3IA0KTCA0MTEuMDUwOTIyIC0xNzMuNTIyNDAxIA0KTCA0MTEuMjEwNzU2IC0xNzcuNzU5OTY2IA0KTCA0MTEuMzcwNTkgLTE4MS41NTMzOSANCkwgNDExLjUzMDQyNCAtMTg0Ljc5MjQ3MSANCkwgNDExLjY5MDI1OCAtMTg3Ljc0MjQ5NyANCkwgNDExLjg1MDA5MiAtMTkwLjMxMzI2NiANCkwgNDEyLjAwOTkyNSAtMTkyLjQ4MDMzNCANCkwgNDEyLjE2OTc1OSAtMTk0LjQzNDI1NiANCkwgNDEyLjMyOTU5MyAtMTk2LjEwNDA5NyANCkwgNDEyLjQ4OTQyNyAtMTk3LjUwNjEyNSANCkwgNDEyLjY0OTI2MSAtMTk4Ljc2MjEzNyANCkwgNDEyLjgwOTA5NSAtMTk5LjgyMDMxOCANCkwgNDEyLjk2ODkyOSAtMjAwLjcxMDIxNiANCkwgNDEzLjEyODc2MyAtMjAxLjUwNDE3NSANCkwgNDEzLjI4ODU5NyAtMjAyLjE2NTY4MiANCkwgNDEzLjQ0ODQzIC0yMDIuNzI0NzE3IA0KTCA0MTMuNjA4MjY0IC0yMDMuMjIyMjMgDQpMIDQxMy43NjgwOTggLTIwMy42MzI5OTUgDQpMIDQxMy45Mjc5MzIgLTIwMy45ODE4NjggDQpMIDQxNC4wODc3NjYgLTIwNC4yOTE1OTcgDQpMIDQxNC4yNDc2IC0yMDQuNTQ1MzI4IA0KTCA0MTQuNDA3NDM0IC0yMDQuNzYyNjQ1IA0KTCA0MTQuNTY3MjY4IC0yMDQuOTU1NDQ5IA0KTCA0MTQuNzI3MTAxIC0yMDUuMTEyMDggDQpMIDQxNC44ODY5MzUgLTIwNS4yNDY5NjcgDQpMIDQxNS4wNDY3NjkgLTIwNS4zNjYzNjQgDQpMIDQxNS4yMDY2MDMgLTIwNS40NjI3MTkgDQpMIDQxNS4zNjY0MzcgLTIwNS41NDY1NTQgDQpMIDQxNS41MjYyNzEgLTIwNS42MjA4MjggDQpMIDQxNS42ODYxMDUgLTIwNS42ODAxMDkgDQpMIDQxNS44NDU5MzkgLTIwNS43MzE5NDQgDQpMIDQxNi4wMDU3NzMgLTIwNS43Nzc3NDUgDQpMIDQxNi4xNjU2MDYgLTIwNS44MTQxOTMgDQpMIDQxNi4zMjU0NCAtMjA1Ljg0NjQyNyANCkwgNDE2LjQ4NTI3NCAtMjA1Ljg3NDk5NyANCkwgNDE2LjY0NTEwOCAtMjA1Ljg5NzQ1MyANCkwgNDE2LjgwNDk0MiAtMjA2LjAzMzg4NCANCkwgNDE2Ljk2NDc3NiAtMjA2LjAzMzg4NCANCkwgNDE3LjEyNDYxIC0yMDYuMDMzODg0IA0KTCA0MTcuMjg0NDQ0IC0yMDYuMDMzODg0IA0KTCA0MTcuNDQ0Mjc3IC0yMDYuMDMzODg0IA0KTCA0MTcuNjA0MTExIC0yMDYuMDMzODg0IA0KTCA0MTcuNzYzOTQ1IC0yMDYuMDMzODg0IA0KTCA0MTcuOTIzNzc5IC0yMDYuMDMzODg0IA0KTCA0MTguMDgzNjEzIC0yMDYuMDMzODg0IA0KTCA0MTguMjQzNDQ3IC0yMDYuMDMzODg0IA0KTCA0MTguNDAzMjgxIC0yMDYuMDMzODg0IA0KTCA0MTguNTYzMTE1IC0yMDYuMDMzODg0IA0KTCA0MTguNzIyOTQ5IC0yMDYuMDMzODg0IA0KTCA0MTguODgyNzgyIC0yMDYuMDMzODg0IA0KTCA0MTkuMDQyNjE2IC0yMDYuMDMzODg0IA0KTCA0MTkuMjAyNDUgLTIwNi4wMzM4ODQgDQpMIDQxOS4zNjIyODQgLTIwNi4wMzM4ODQgDQpMIDQxOS41MjIxMTggLTIwNi4wMzM4ODQgDQpMIDQxOS42ODE5NTIgLTIwNi4wMzM4ODQgDQpMIDQxOS44NDE3ODYgLTIwNi4wMzM4ODQgDQpMIDQyMC4wMDE2MiAtMjA2LjAzMzg4NCANCkwgNDIwLjE2MTQ1NCAtMjA2LjAzMzg4NCANCkwgNDIwLjMyMTI4NyAtMjA2LjAzMzg4NCANCkwgNDIwLjQ4MTEyMSAtMjA2LjAzMzg4NCANCkwgNDIwLjY0MDk1NSAtMjA2LjAzMzg4NCANCkwgNDIwLjgwMDc4OSAtMjA2LjAzMzg4NCANCkwgNDIwLjk2MDYyMyAtMjA2LjAzMzg4NCANCkwgNDIxLjEyMDQ1NyAtMjA2LjAzMzg4NCANCkwgNDIxLjI4MDI5MSAtMjA2LjAzMzg4NCANCkwgNDIxLjQ0MDEyNSAtMjA2LjAzMzg4NCANCkwgNDIxLjU5OTk1OCAtMjA2LjAzMzg4NCANCkwgNDIxLjc1OTc5MiAtMjA2LjAzMzg4NCANCkwgNDIxLjkxOTYyNiAtMjA2LjAzMzg4NCANCkwgNDIyLjA3OTQ2IC0yMDYuMDMzODg0IA0KTCA0MjIuMjM5Mjk0IC0yMDYuMDMzODg0IA0KTCA0MjIuMzk5MTI4IC0yMDYuMDMzODg0IA0KTCA0MjIuNTU4OTYyIC0yMDYuMDMzODg0IA0KTCA0MjIuNzE4Nzk2IC0yMDYuMDMzODg0IA0KTCA0MjIuODc4NjMgLTIwNi4wMzM4ODQgDQpMIDQyMy4wMzg0NjMgLTIwNi4wMzM4ODQgDQpMIDQyMy4xOTgyOTcgLTIwNi4wMzM4ODQgDQpMIDQyMy4zNTgxMzEgLTIwNi4wMzM4ODQgDQpMIDQyMy41MTc5NjUgLTIwNi4wMzM4ODQgDQpMIDQyMy42Nzc3OTkgLTIwNi4wMzM4ODQgDQpMIDQyMy44Mzc2MzMgLTIwNi4wMzM4ODQgDQpMIDQyMy45OTc0NjcgLTIwNi4wMzM4ODQgDQpMIDQyNC4xNTczMDEgLTIwNi4wMzM4ODQgDQpMIDQyNC4zMTcxMzQgLTIwNi4wMzM4ODQgDQpMIDQyNC40NzY5NjggLTIwNi4wMzM4ODQgDQpMIDQyNC42MzY4MDIgLTIwNi4wMzM4ODQgDQpMIDQyNC43OTY2MzYgLTIwNi4wMzM4ODQgDQpMIDQyNC45NTY0NyAtMjA2LjAzMzg4NCANCkwgNDI1LjExNjMwNCAtMjA2LjAzMzg4NCANCkwgNDI1LjI3NjEzOCAtMjA2LjAzMzg4NCANCkwgNDI1LjQzNTk3MiAtMjA2LjAzMzg4NCANCkwgNDI1LjU5NTgwNiAtMjA2LjAzMzg4NCANCkwgNDI1Ljc1NTYzOSAtMjA2LjAzMzg4NCANCkwgNDI1LjkxNTQ3MyAtMjA2LjAzMzg4NCANCkwgNDI2LjA3NTMwNyAtMjA2LjAzMzg4NCANCkwgNDI2LjIzNTE0MSAtMjA2LjAzMzg4NCANCkwgNDI2LjM5NDk3NSAtMjA2LjAzMzg4NCANCkwgNDI2LjU1NDgwOSAtMjA2LjAzMzg4NCANCkwgNDI2LjcxNDY0MyAtMjA2LjAzMzg4NCANCkwgNDI2Ljg3NDQ3NyAtMjA2LjAzMzg4NCANCkwgNDI3LjAzNDMxMSAtMjA2LjAzMzg4NCANCkwgNDI3LjE5NDE0NCAtMjA2LjAzMzg4NCANCkwgNDI3LjM1Mzk3OCAtMjA2LjAzMzg4NCANCkwgNDI3LjUxMzgxMiAtMjA2LjAzMzg4NCANCkwgNDI3LjY3MzY0NiAtMjA2LjAzMzg4NCANCkwgNDI3LjgzMzQ4IC0yMDYuMDMzODg0IA0KTCA0MjcuOTkzMzE0IC0yMDYuMDMzODg0IA0KTCA0MjguMTUzMTQ4IC0yMDYuMDMzODg0IA0KTCA0MjguMzEyOTgyIC0yMDYuMDMzODg0IA0KTCA0MjguNDcyODE1IC0yMDYuMDMzODg0IA0KTCA0MjguNjMyNjQ5IC0yMDYuMDMzODg0IA0KTCA0MjguNzkyNDgzIC0yMDYuMDMzODg0IA0KTCA0MjguOTUyMzE3IC0yMDYuMDMzODg0IA0KTCA0MjkuMTEyMTUxIC0yMDYuMDMzODg0IA0KTCA0MjkuMjcxOTg1IC0yMDYuMDMzODg0IA0KTCA0MjkuNDMxODE5IC0yMDYuMDMzODg0IA0KTCA0MjkuNTkxNjUzIC0yMDYuMDMzODg0IA0KTCA0MjkuNzUxNDg3IC0yMDYuMDMzODg0IA0KTCA0MjkuOTExMzIgLTIwNi4wMzM4ODQgDQpMIDQzMC4wNzExNTQgLTIwNi4wMzM4ODQgDQpMIDQzMC4yMzA5ODggLTIwNi4wMzM4ODQgDQpMIDQzMC4zOTA4MjIgLTIwNi4wMzM4ODQgDQpMIDQzMC41NTA2NTYgLTIwNi4wMzM4ODQgDQpMIDQzMC43MTA0OSAtMjA2LjAzMzg4NCANCkwgNDMwLjg3MDMyNCAtMjA2LjAzMzg4NCANCkwgNDMxLjAzMDE1OCAtMjA2LjAzMzg4NCANCkwgNDMxLjE4OTk5MiAtMjA2LjAzMzg4NCANCkwgNDMxLjM0OTgyNSAtMjA2LjAzMzg4NCANCkwgNDMxLjUwOTY1OSAtMjA2LjAzMzg4NCANCkwgNDMxLjY2OTQ5MyAtMjA2LjAzMzg4NCANCkwgNDMxLjgyOTMyNyAtMjA2LjAzMzg4NCANCkwgNDMxLjk4OTE2MSAtMjA2LjAzMzg4NCANCkwgNDMyLjE0ODk5NSAtMjA2LjAzMzg4NCANCkwgNDMyLjMwODgyOSAtMjA2LjAzMzg4NCANCkwgNDMyLjQ2ODY2MyAtMjA2LjAzMzg4NCANCkwgNDMyLjYyODQ5NiAtMjA2LjAzMzg4NCANCkwgNDMyLjc4ODMzIC0yMDYuMDMzODg0IA0KTCA0MzIuOTQ4MTY0IC0yMDYuMDMzODg0IA0KTCA0MzMuMTA3OTk4IC0yMDYuMDMzODg0IA0KTCA0MzMuMjY3ODMyIC0yMDYuMDMzODg0IA0KTCA0MzMuNDI3NjY2IC0yMDYuMDMzODg0IA0KTCA0MzMuNTg3NSAtMjA2LjAzMzg4NCANCkwgNDMzLjc0NzMzNCAtMjA2LjAzMzg4NCANCkwgNDMzLjkwNzE2OCAtMjA2LjAzMzg4NCANCkwgNDM0LjA2NzAwMSAtMjA2LjAzMzg4NCANCkwgNDM0LjIyNjgzNSAtMjA2LjAzMzg4NCANCkwgNDM0LjM4NjY2OSAtMjA2LjAzMzg4NCANCkwgNDM0LjU0NjUwMyAtMjA2LjAzMzg4NCANCkwgNDM0LjcwNjMzNyAtMjA2LjAzMzg4NCANCkwgNDM0Ljg2NjE3MSAtMjA2LjAzMzg4NCANCkwgNDM1LjAyNjAwNSAtMjA2LjAzMzg4NCANCkwgNDM1LjE4NTgzOSAtMjA2LjAzMzg4NCANCkwgNDM1LjM0NTY3MiAtMjA2LjAzMzg4NCANCkwgNDM1LjUwNTUwNiAtMjA2LjAzMzg4NCANCkwgNDM1LjY2NTM0IC0yMDYuMDMzODg0IA0KTCA0MzUuODI1MTc0IC0yMDYuMDMzODg0IA0KTCA0MzUuOTg1MDA4IC0yMDYuMDMzODg0IA0KTCA0MzYuMTQ0ODQyIC0yMDYuMDMzODg0IA0KTCA0MzYuMzA0Njc2IC0yMDYuMDMzODg0IA0KTCA0MzYuNDY0NTEgLTIwNi4wMzM4ODQgDQpMIDQzNi42MjQzNDQgLTIwNi4wMzM4ODQgDQpMIDQzNi43ODQxNzcgLTIwNi4wMzM4ODQgDQpMIDQzNi45NDQwMTEgLTIwNS42MDkyMTcgDQpMIDQzNy4xMDM4NDUgLTIwNS41NDI5NjEgDQpMIDQzNy4yNjM2NzkgLTIwNS40NjUwNzEgDQpMIDQzNy40MjM1MTMgLTIwNS4zNzczMjcgDQpMIDQzNy41ODMzNDcgLTIwNS4yNjY3MTkgDQpMIDQzNy43NDMxODEgLTIwNS4xMzgzMyANCkwgNDM3LjkwMzAxNSAtMjA0Ljk5NDQgDQpMIDQzOC4wNjI4NDkgLTIwNC44MTI4MzEgDQpMIDQzOC4yMjI2ODIgLTIwNC42MDM2NzYgDQpMIDQzOC4zODI1MTYgLTIwNC4zNjk1NzEgDQpMIDQzOC41NDIzNSAtMjA0LjA3MzY5MyANCkwgNDM4LjcwMjE4NCAtMjAzLjczNjIyOCANCkwgNDM4Ljg2MjAxOCAtMjAzLjM1OTQ0NCANCkwgNDM5LjAyMTg1MiAtMjAyLjg4MDQ2NSANCkwgNDM5LjE4MTY4NiAtMjAyLjMzOTEzIA0KTCA0MzkuMzQxNTIgLTIwMS43MzEzNCANCkwgNDM5LjUwMTM1MyAtMjAwLjk2NzE0MSANCkwgNDM5LjY2MTE4NyAtMjAwLjEwNjUzMiANCkwgNDM5LjgyMTAyMSAtMTk5LjEzNTg0OSANCkwgNDM5Ljk4MDg1NSAtMTk3LjkzMDkwOSANCkwgNDQwLjE0MDY4OSAtMTk2LjU4MTEzOCANCkwgNDQwLjMwMDUyMyAtMTk1LjA1NDg1OCANCkwgNDQwLjQ2MDM1NyAtMTkzLjE5MjM5MSANCkwgNDQwLjYyMDE5MSAtMTkxLjEyMzUwMSANCkwgNDQwLjc4MDAyNSAtMTg4Ljc4ODMwNiANCkwgNDQwLjkzOTg1OCAtMTg2LjAwNzg5NCANCkwgNDQxLjA5OTY5MiAtMTgyLjk1OTcxNSANCkwgNDQxLjI1OTUyNiAtMTc5LjU0OTY2MyANCkwgNDQxLjQxOTM2IC0xNzUuNjI1MzY4IA0KTCA0NDEuNTc5MTk0IC0xNzEuNDA1NTI5IA0KTCA0NDEuNzM5MDI4IC0xNjYuNzc4MDI0IA0KTCA0NDEuODk4ODYyIC0xNjEuNjg3MjQ3IA0KTCA0NDIuMDU4Njk2IC0xNTYuMzUxMjA5IA0KTCA0NDIuMjE4NTI5IC0xNTAuNjg3ODM2IA0KTCA0NDIuMzc4MzYzIC0xNDQuNzcxMTYyIA0KTCA0NDIuNTM4MTk3IC0xMzguNzQ3MTk0IA0KTCA0NDIuNjk4MDMxIC0xMzIuNjE5NzAyIA0KTCA0NDIuODU3ODY1IC0xMjYuNTIxOTIzIA0KTCA0NDMuMDE3Njk5IC0xMjAuNDgxNzk1IA0KTCA0NDMuMTc3NTMzIC0xMTQuNTkyODM2IA0KTCA0NDMuMzM3MzY3IC0xMDguOTM1MTIxIA0KTCA0NDMuNDk3MjAxIC0xMDMuNDQ4NzMgDQpMIDQ0My42NTcwMzQgLTk4LjI3NjU1MSANCkwgNDQzLjgxNjg2OCAtOTMuNDA5NTg2IA0KTCA0NDMuOTc2NzAyIC04OC43NTgyNjYgDQpMIDQ0NC4xMzY1MzYgLTg0LjQ3OTkyOSANCkwgNDQ0LjI5NjM3IC04MC41MDQzOTIgDQpMIDQ0NC40NTYyMDQgLTc2Ljc0ODA2NSANCkwgNDQ0LjYxNjAzOCAtNzMuMzY5OTE0IA0KTCA0NDQuNzc1ODcyIC03MC4yNjIzNTkgDQpMIDQ0NC45MzU3MDYgLTY3LjM1ODE3MyANCkwgNDQ1LjA5NTUzOSAtNjQuODA1NTY4IA0KTCA0NDUuMjU1MzczIC02Mi40NzU0MDEgDQpMIDQ0NS40MTUyMDcgLTYwLjMyMDI4MiANCkwgNDQ1LjU3NTA0MSAtNTguNDY3MTc4IA0KTCA0NDUuNzM0ODc1IC01Ni43ODM5MTMgDQpMIDQ0NS44OTQ3MDkgLTU1LjI0MTcxNiANCkwgNDQ2LjA1NDU0MyAtNTMuOTQyNjg0IA0KTCA0NDYuMjE0Mzc3IC01Mi43NjUyMDYgDQpMIDQ0Ni4zNzQyMSAtNTEuNjk1MTAyIA0KTCA0NDYuNTM0MDQ0IC01MC44MTA5NjIgDQpMIDQ0Ni42OTM4NzggLTUwLjAxMTIxNCANCkwgNDQ2Ljg1MzcxMiAtNDkuMjkxMjg1IA0KTCA0NDcuMDEzNTQ2IC00OC43MTAyNDkgDQpMIDQ0Ny4xNzMzOCAtNDguMTg2OTkzIA0KTCA0NDcuMzMzMjE0IC00Ny43MjUyNTYgDQpMIDQ0Ny40OTMwNDggLTQ3LjM2MjU5OCANCkwgNDQ3LjY1Mjg4MiAtNDcuMDQzNDQ3IA0KTCA0NDcuODEyNzE1IC00Ni43NzI4MzYgDQpMIDQ0Ny45NzI1NDkgLTQ2LjU3NjAyIA0KTCA0NDguMTMyMzgzIC00Ni40MTQwNDYgDQpMIDQ0OC4yOTIyMTcgLTQ2LjI5MzAyMiANCkwgNDQ4LjQ1MjA1MSAtNDYuMjMyNTkgDQpMIDQ0OC42MTE4ODUgLTQ2LjIwMzgyIA0KTCA0NDguNzcxNzE5IC00Ni4yMTQ0NDkgDQpMIDQ0OC45MzE1NTMgLTQ2LjI4MjI4MSANCkwgNDQ5LjA5MTM4NyAtNDYuMzgyODk1IA0KTCA0NDkuMjUxMjIgLTQ2LjUyNzE1OSANCkwgNDQ5LjQxMTA1NCAtNDYuNzM0NTcyIA0KTCA0NDkuNTcwODg4IC00Ni45ODEyNCANCkwgNDQ5LjczMDcyMiAtNDcuMjgzOTQ1IA0KTCA0NDkuODkwNTU2IC00Ny42NjUzOTkgDQpMIDQ1MC4wNTAzOSAtNDguMDk4NDMxIA0KTCA0NTAuMjEwMjI0IC00OC42MDk5MzkgDQpMIDQ1MC4zNzAwNTggLTQ5LjIyNjgyNSANCkwgNDUwLjUyOTg5MSAtNDkuOTE1Nzk1IA0KTCA0NTAuNjg5NzI1IC01MC43MjEzOTMgDQpMIDQ1MC44NDk1NTkgLTUxLjY3Mjg3IA0KTCA0NTEuMDA5MzkzIC01Mi43Mjc0ODYgDQpMIDQ1MS4xNjkyMjcgLTUzLjk1ODc0NyANCkwgNDUxLjMyOTA2MSAtNTUuMzk0MzA3IA0KTCA0NTEuNDg4ODk1IC01Ni45NzgzNjQgDQpMIDQ1MS42NDg3MjkgLTU4LjgyOTMyNCANCkwgNDUxLjgwODU2MyAtNjAuOTYxMzE3IA0KTCA0NTEuOTY4Mzk2IC02My4zMDI0NDkgDQpMIDQ1Mi4xMjgyMyAtNjYuMDM1MDQgDQpMIDQ1Mi4yODgwNjQgLTY5LjEzNjA3NCANCkwgNDUyLjQ0Nzg5OCAtNzIuNTE2Mjg2IA0KTCA0NTIuNjA3NzMyIC03Ni40MjcxMzkgDQpMIDQ1Mi43Njc1NjYgLTgwLjc2ODQxOCANCkwgNDUyLjkyNzQgLTg1LjQ0MDIyOCANCkwgNDUzLjA4NzIzNCAtOTAuNzIzMDU4IA0KTCA0NTMuMjQ3MDY3IC05Ni40MDIyNTUgDQpMIDQ1My40MDY5MDEgLTEwMi4zODk0MyANCkwgNDUzLjU2NjczNSAtMTA4Ljg3NDM4NSANCkwgNDUzLjcyNjU2OSAtMTE1LjU2NzY5NiANCkwgNDUzLjg4NjQwMyAtMTIyLjQyMjY0NSANCkwgNDU0LjA0NjIzNyAtMTI5LjM5NDUyNiANCkwgNDU0LjIwNjA3MSAtMTM2LjI5MjI2MiANCkwgNDU0LjM2NTkwNSAtMTQzLjExNjk1NCANCkwgNDU0LjUyNTczOSAtMTQ5LjU3NTg3MyANCkwgNDU0LjY4NTU3MiAtMTU1Ljc0NDQ3MyANCkwgNDU0Ljg0NTQwNiAtMTYxLjYzODU3OSANCkwgNDU1LjAwNTI0IC0xNjYuODU1NTU4IA0KTCA0NTUuMTY1MDc0IC0xNzEuNzIzNzU0IA0KTCA0NTUuMzI0OTA4IC0xNzYuMjIwMzczIA0KTCA0NTUuNDg0NzQyIC0xODAuMDM2MDE0IA0KTCA0NTUuNjQ0NTc2IC0xODMuNTM0OTE3IA0KTCA0NTUuODA0NDEgLTE4Ni42Nzg3NyANCkwgNDU1Ljk2NDI0NCAtMTg5LjI4NDk2NyANCkwgNDU2LjEyNDA3NyAtMTkxLjY0ODIzNiANCkwgNDU2LjI4MzkxMSAtMTkzLjcyODQ4MSANCkwgNDU2LjQ0Mzc0NSAtMTk1LjQzNjE2MSANCkwgNDU2LjYwMzU3OSAtMTk2Ljk3MzMxMSANCkwgNDU2Ljc2MzQxMyAtMTk4LjMwNTM0NSANCkwgNDU2LjkyMzI0NyAtMTk5LjM5NzA0NSANCkwgNDU3LjA4MzA4MSAtMjAwLjM3NTIzNSANCkwgNDU3LjI0MjkxNSAtMjAxLjIxMjY4OCANCkwgNDU3LjQwMjc0OCAtMjAxLjkwMTA4IA0KTCA0NTcuNTYyNTgyIC0yMDIuNTE2MDk1IA0KTCA0NTcuNzIyNDE2IC0yMDMuMDM3NjUgDQpMIDQ1Ny44ODIyNSAtMjAzLjQ2ODY4OSANCkwgNDU4LjA0MjA4NCAtMjAzLjg1MjgzOCANCkwgNDU4LjIwMTkxOCAtMjA0LjE3NTQxMyANCkwgNDU4LjM2MTc1MiAtMjA0LjQ0MzgzNiANCkwgNDU4LjUyMTU4NiAtMjA0LjY4Mjg0MSANCkwgNDU4LjY4MTQyIC0yMDQuODgyMzUxIA0KTCA0NTguODQxMjUzIC0yMDUuMDQ5NDI4IA0KTCA0NTkuMDAxMDg3IC0yMDUuMTk3ODc5IA0KTCA0NTkuMTYwOTIxIC0yMDUuMzIwNTk4IA0KTCA0NTkuMzIwNzU1IC0yMDUuNDI0MTc3IA0KTCA0NTkuNDgwNTg5IC0yMDUuNTE2MjA4IA0KTCA0NTkuNjQwNDIzIC0yMDUuNTkyMDcyIA0KTCA0NTkuODAwMjU3IC0yMDUuNjU2Mzk3IA0KTCA0NTkuOTYwMDkxIC0yMDUuNzEzMzYxIA0KTCA0NjAuMTE5OTI0IC0yMDUuNzU5ODE3IA0KTCA0NjAuMjc5NzU4IC0yMDUuNzk5NjE0IA0KTCA0NjAuNDM5NTkyIC0yMDUuODM0OTEgDQpMIDQ2MC41OTk0MjYgLTIwNS44NjM3MDMgDQpMIDQ2MC43NTkyNiAtMjA1Ljg4ODQ3MSANCkwgNDYwLjkxOTA5NCAtMjA2LjAzMzg4NCANCkwgNDYxLjA3ODkyOCAtMjA2LjAzMzg4NCANCkwgNDYxLjIzODc2MiAtMjA2LjAzMzg4NCANCkwgNDYxLjM5ODU5NiAtMjA2LjAzMzg4NCANCkwgNDYxLjU1ODQyOSAtMjA2LjAzMzg4NCANCkwgNDYxLjcxODI2MyAtMjA2LjAzMzg4NCANCkwgNDYxLjg3ODA5NyAtMjA2LjAzMzg4NCANCkwgNDYyLjAzNzkzMSAtMjA2LjAzMzg4NCANCkwgNDYyLjE5Nzc2NSAtMjA2LjAzMzg4NCANCkwgNDYyLjM1NzU5OSAtMjA2LjAzMzg4NCANCkwgNDYyLjUxNzQzMyAtMjA2LjAzMzg4NCANCkwgNDYyLjY3NzI2NyAtMjA2LjAzMzg4NCANCkwgNDYyLjgzNzEwMSAtMjA2LjAzMzg4NCANCkwgNDYyLjk5NjkzNCAtMjA2LjAzMzg4NCANCkwgNDYzLjE1Njc2OCAtMjA2LjAzMzg4NCANCkwgNDYzLjMxNjYwMiAtMjA2LjAzMzg4NCANCkwgNDYzLjQ3NjQzNiAtMjA2LjAzMzg4NCANCkwgNDYzLjYzNjI3IC0yMDYuMDMzODg0IA0KTCA0NjMuNzk2MTA0IC0yMDYuMDMzODg0IA0KTCA0NjMuOTU1OTM4IC0yMDYuMDMzODg0IA0KTCA0NjQuMTE1NzcyIC0yMDYuMDMzODg0IA0KTCA0NjQuMjc1NjA1IC0yMDYuMDMzODg0IA0KTCA0NjQuNDM1NDM5IC0yMDYuMDMzODg0IA0KTCA0NjQuNTk1MjczIC0yMDYuMDMzODg0IA0KTCA0NjQuNzU1MTA3IC0yMDYuMDMzODg0IA0KTCA0NjQuOTE0OTQxIC0yMDYuMDMzODg0IA0KTCA0NjUuMDc0Nzc1IC0yMDYuMDMzODg0IA0KTCA0NjUuMjM0NjA5IC0yMDYuMDMzODg0IA0KTCA0NjUuMzk0NDQzIC0yMDYuMDMzODg0IA0KTCA0NjUuNTU0Mjc3IC0yMDYuMDMzODg0IA0KTCA0NjUuNzE0MTEgLTIwNi4wMzM4ODQgDQpMIDQ2NS44NzM5NDQgLTIwNi4wMzM4ODQgDQpMIDQ2Ni4wMzM3NzggLTIwNi4wMzM4ODQgDQpMIDQ2Ni4xOTM2MTIgLTIwNi4wMzM4ODQgDQpMIDQ2Ni4zNTM0NDYgLTIwNi4wMzM4ODQgDQpMIDQ2Ni41MTMyOCAtMjA2LjAzMzg4NCANCkwgNDY2LjY3MzExNCAtMjA2LjAzMzg4NCANCkwgNDY2LjgzMjk0OCAtMjA2LjAzMzg4NCANCkwgNDY2Ljk5Mjc4MiAtMjA2LjAzMzg4NCANCkwgNDY3LjE1MjYxNSAtMjA2LjAzMzg4NCANCkwgNDY3LjMxMjQ0OSAtMjA2LjAzMzg4NCANCkwgNDY3LjQ3MjI4MyAtMjA2LjAzMzg4NCANCkwgNDY3LjYzMjExNyAtMjA2LjAzMzg4NCANCkwgNDY3Ljc5MTk1MSAtMjA2LjAzMzg4NCANCkwgNDY3Ljk1MTc4NSAtMjA2LjAzMzg4NCANCkwgNDY4LjExMTYxOSAtMjA2LjAzMzg4NCANCkwgNDY4LjI3MTQ1MyAtMjA2LjAzMzg4NCANCkwgNDY4LjQzMTI4NiAtMjA2LjAzMzg4NCANCkwgNDY4LjU5MTEyIC0yMDYuMDMzODg0IA0KTCA0NjguNzUwOTU0IC0yMDYuMDMzODg0IA0KTCA0NjguOTEwNzg4IC0yMDYuMDMzODg0IA0KTCA0NjkuMDcwNjIyIC0yMDYuMDMzODg0IA0KTCA0NjkuMjMwNDU2IC0yMDYuMDMzODg0IA0KTCA0NjkuMzkwMjkgLTIwNi4wMzM4ODQgDQpMIDQ2OS41NTAxMjQgLTIwNi4wMzM4ODQgDQpMIDQ2OS43MDk5NTggLTIwNi4wMzM4ODQgDQpMIDQ2OS44Njk3OTEgLTIwNi4wMzM4ODQgDQpMIDQ3MC4wMjk2MjUgLTIwNi4wMzM4ODQgDQpMIDQ3MC4xODk0NTkgLTIwNi4wMzM4ODQgDQpMIDQ3MC4zNDkyOTMgLTIwNi4wMzM4ODQgDQpMIDQ3MC41MDkxMjcgLTIwNi4wMzM4ODQgDQpMIDQ3MC42Njg5NjEgLTIwNi4wMzM4ODQgDQpMIDQ3MC44Mjg3OTUgLTIwNi4wMzM4ODQgDQpMIDQ3MC45ODg2MjkgLTIwNi4wMzM4ODQgDQpMIDQ3MS4xNDg0NjIgLTIwNi4wMzM4ODQgDQpMIDQ3MS4zMDgyOTYgLTIwNi4wMzM4ODQgDQpMIDQ3MS40NjgxMyAtMjA2LjAzMzg4NCANCkwgNDcxLjYyNzk2NCAtMjA2LjAzMzg4NCANCkwgNDcxLjc4Nzc5OCAtMjA2LjAzMzg4NCANCkwgNDcxLjk0NzYzMiAtMjA2LjAzMzg4NCANCkwgNDcyLjEwNzQ2NiAtMjA2LjAzMzg4NCANCkwgNDcyLjI2NzMgLTIwNi4wMzM4ODQgDQpMIDQ3Mi40MjcxMzQgLTIwNi4wMzM4ODQgDQpMIDQ3Mi41ODY5NjcgLTIwNi4wMzM4ODQgDQpMIDQ3Mi43NDY4MDEgLTIwNi4wMzM4ODQgDQpMIDQ3Mi45MDY2MzUgLTIwNi4wMzM4ODQgDQpMIDQ3My4wNjY0NjkgLTIwNi4wMzM4ODQgDQpMIDQ3My4yMjYzMDMgLTIwNi4wMzM4ODQgDQpMIDQ3My4zODYxMzcgLTIwNi4wMzM4ODQgDQpMIDQ3My41NDU5NzEgLTIwNi4wMzM4ODQgDQpMIDQ3My43MDU4MDUgLTIwNi4wMzM4ODQgDQpMIDQ3My44NjU2MzkgLTIwNi4wMzM4ODQgDQpMIDQ3NC4wMjU0NzIgLTIwNi4wMzM4ODQgDQpMIDQ3NC4xODUzMDYgLTIwNi4wMzM4ODQgDQpMIDQ3NC4zNDUxNCAtMjA2LjAzMzg4NCANCkwgNDc0LjUwNDk3NCAtMjA2LjAzMzg4NCANCkwgNDc0LjY2NDgwOCAtMjA2LjAzMzg4NCANCkwgNDc0LjgyNDY0MiAtMjA2LjAzMzg4NCANCkwgNDc0Ljk4NDQ3NiAtMjA2LjAzMzg4NCANCkwgNDc1LjE0NDMxIC0yMDYuMDMzODg0IA0KTCA0NzUuMzA0MTQzIC0yMDYuMDMzODg0IA0KTCA0NzUuNDYzOTc3IC0yMDYuMDMzODg0IA0KTCA0NzUuNjIzODExIC0yMDYuMDMzODg0IA0KTCA0NzUuNzgzNjQ1IC0yMDYuMDMzODg0IA0KTCA0NzUuOTQzNDc5IC0yMDYuMDMzODg0IA0KTCA0NzYuMTAzMzEzIC0yMDYuMDMzODg0IA0KTCA0NzYuMjYzMTQ3IC0yMDYuMDMzODg0IA0KTCA0NzYuNDIyOTgxIC0yMDYuMDMzODg0IA0KTCA0NzYuNTgyODE1IC0yMDYuMDMzODg0IA0KTCA0NzYuNzQyNjQ4IC0yMDYuMDMzODg0IA0KTCA0NzYuOTAyNDgyIC0yMDYuMDMzODg0IA0KTCA0NzcuMDYyMzE2IC0yMDYuMDMzODg0IA0KTCA0NzcuMjIyMTUgLTIwNi4wMzM4ODQgDQpMIDQ3Ny4zODE5ODQgLTIwNi4wMzM4ODQgDQpMIDQ3Ny41NDE4MTggLTIwNi4wMzM4ODQgDQpMIDQ3Ny43MDE2NTIgLTIwNi4wMzM4ODQgDQpMIDQ3Ny44NjE0ODYgLTIwNi4wMzM4ODQgDQpMIDQ3OC4wMjEzMTkgLTIwNi4wMzM4ODQgDQpMIDQ3OC4xODExNTMgLTIwNi4wMzM4ODQgDQpMIDQ3OC4zNDA5ODcgLTIwNi4wMzM4ODQgDQpMIDQ3OC41MDA4MjEgLTIwNi4wMzM4ODQgDQpMIDQ3OC42NjA2NTUgLTIwNi4wMzM4ODQgDQpMIDQ3OC44MjA0ODkgLTIwNi4wMzM4ODQgDQpMIDQ3OC45ODAzMjMgLTIwNi4wMzM4ODQgDQpMIDQ3OS4xNDAxNTcgLTIwNi4wMzM4ODQgDQpMIDQ3OS4yOTk5OTEgLTIwNi4wMzM4ODQgDQpMIDQ3OS40NTk4MjQgLTIwNi4wMzM4ODQgDQpMIDQ3OS42MTk2NTggLTIwNi4wMzM4ODQgDQpMIDQ3OS43Nzk0OTIgLTIwNi4wMzM4ODQgDQpMIDQ3OS45MzkzMjYgLTIwNi4wMzM4ODQgDQpMIDQ4MC4wOTkxNiAtMjA2LjAzMzg4NCANCkwgNDgwLjI1ODk5NCAtMjA2LjAzMzg4NCANCkwgNDgwLjQxODgyOCAtMjA2LjAzMzg4NCANCkwgNDgwLjU3ODY2MiAtMjA2LjAzMzg4NCANCkwgNDgwLjczODQ5NiAtMjA2LjAzMzg4NCANCkwgNDgwLjg5ODMyOSAtMjA2LjAzMzg4NCANCkwgNDgxLjA1ODE2MyAtMjA2LjAzMzg4NCANCkwgNDgxLjIxNzk5NyAtMjA1LjU2OTQ2MyANCkwgNDgxLjM3NzgzMSAtMjA1LjQ5OTI2OCANCkwgNDgxLjUzNzY2NSAtMjA1LjQxMzc3NSANCkwgNDgxLjY5NzQ5OSAtMjA1LjMxMDk2MiANCkwgNDgxLjg1NzMzMyAtMjA1LjE5NDk1MSANCkwgNDgyLjAxNzE2NyAtMjA1LjA1MzM5OCANCkwgNDgyLjE3NyAtMjA0Ljg4NTQ1OSANCkwgNDgyLjMzNjgzNCAtMjA0LjY5NjU4IA0KTCA0ODIuNDk2NjY4IC0yMDQuNDY0MzIgDQpMIDQ4Mi42NTY1MDIgLTIwNC4xOTIwNDQgDQpMIDQ4Mi44MTYzMzYgLTIwMy44ODY5NDIgDQpMIDQ4Mi45NzYxNyAtMjAzLjUxMDE1OCANCkwgNDgzLjEzNjAwNCAtMjAzLjA3MjEwNiANCkwgNDgzLjI5NTgzOCAtMjAyLjU4MjI0NiANCkwgNDgzLjQ1NTY3MiAtMjAxLjk3NDQ1NiANCkwgNDgzLjYxNTUwNSAtMjAxLjI3NDg2MiANCkwgNDgzLjc3NTMzOSAtMjAwLjQ5NDgwNSANCkwgNDgzLjkzNTE3MyAtMTk5LjUyNDEyMyANCkwgNDg0LjA5NTAwNyAtMTk4LjQxOTA1OCANCkwgNDg0LjI1NDg0MSAtMTk3LjE5MTY1IA0KTCA0ODQuNDE0Njc1IC0xOTUuNjY1MzcgDQpMIDQ4NC41NzQ1MDkgLTE5My45NTEwMzYgDQpMIDQ4NC43MzQzNDMgLTE5Mi4wNTQ0MjQgDQpMIDQ4NC44OTQxNzYgLTE4OS43MjIzNzcgDQpMIDQ4NS4wNTQwMSAtMTg3LjE0NDg4NyANCkwgNDg1LjIxMzg0NCAtMTg0LjMwMjM5NiANCkwgNDg1LjM3MzY3OCAtMTgwLjkxMzY4MSANCkwgNDg1LjUzMzUxMiAtMTc3LjIzMjE4NiANCkwgNDg1LjY5MzM0NiAtMTczLjIxNTE0MSANCkwgNDg1Ljg1MzE4IC0xNjguNjI5MDMzIA0KTCA0ODYuMDEzMDE0IC0xNjMuNzY1MDczIA0KTCA0ODYuMTcyODQ4IC0xNTguNTcwNTMzIA0KTCA0ODYuMzMyNjgxIC0xNTIuOTUzMTkyIA0KTCA0ODYuNDkyNTE1IC0xNDcuMTY1MzI2IA0KTCA0ODYuNjUyMzQ5IC0xNDEuMTc5OTQxIA0KTCA0ODYuODEyMTgzIC0xMzUuMDcwNzAyIA0KTCA0ODYuOTcyMDE3IC0xMjguOTU3MjExIA0KTCA0ODcuMTMxODUxIC0xMjIuODY5MDA2IA0KTCA0ODcuMjkxNjg1IC0xMTYuOTQ4NDE3IA0KTCA0ODcuNDUxNTE5IC0xMTEuMTYzMyANCkwgNDg3LjYxMTM1MyAtMTA1LjU5Mjg1MyANCkwgNDg3Ljc3MTE4NiAtMTAwLjM0NTQyNSANCkwgNDg3LjkzMTAyIC05NS4zMDI5OTggDQpMIDQ4OC4wOTA4NTQgLTkwLjU2OTQ3NiANCkwgNDg4LjI1MDY4OCAtODYuMTkxMjYgDQpMIDQ4OC40MTA1MjIgLTgyLjAzMzcwOCANCkwgNDg4LjU3MDM1NiAtNzguMjEwNDI3IA0KTCA0ODguNzMwMTkgLTc0LjcyMTE3OCANCkwgNDg4Ljg5MDAyNCAtNzEuNDQzMjEgDQpMIDQ4OS4wNDk4NTcgLTY4LjQ5MTA3NCANCkwgNDg5LjIwOTY5MSAtNjUuODI2NjE5IA0KTCA0ODkuMzY5NTI1IC02My4zNDkzNDMgDQpMIDQ4OS41MjkzNTkgLTYxLjE2NDQ5NSANCkwgNDg5LjY4OTE5MyAtNTkuMjA4NDI5IA0KTCA0ODkuODQ5MDI3IC01Ny40MDY5MzUgDQpMIDQ5MC4wMDg4NjEgLTU1Ljg0OTM3OCANCkwgNDkwLjE2ODY5NSAtNTQuNDYyMjk3IA0KTCA0OTAuMzI4NTI5IC01My4xOTU0NzIgDQpMIDQ5MC40ODgzNjIgLTUyLjExOTgwNyANCkwgNDkwLjY0ODE5NiAtNTEuMTY0NjIyIA0KTCA0OTAuODA4MDMgLTUwLjI5OTE5OCANCkwgNDkwLjk2Nzg2NCAtNDkuNTc5MjY5IA0KTCA0OTEuMTI3Njk4IC00OC45NDI1OTYgDQpMIDQ5MS4yODc1MzIgLTQ4LjM3MTY5NCANCkwgNDkxLjQ0NzM2NiAtNDcuOTA5OTQxIA0KTCA0OTEuNjA3MiAtNDcuNTA2MzY3IA0KTCA0OTEuNzY3MDM0IC00Ny4xNTE2ODUgDQpMIDQ5MS45MjY4NjcgLTQ2Ljg4MTA3NCANCkwgNDkyLjA4NjcwMSAtNDYuNjUyODAzIA0KTCA0OTIuMjQ2NTM1IC00Ni40NjI0NTkgDQpMIDQ5Mi40MDYzNjkgLTQ2LjM0MTQxOSANCkwgNDkyLjU2NjIwMyAtNDYuMjU0Mjk1IA0KTCA0OTIuNzI2MDM3IC00Ni4yIA0KTCA0OTIuODg1ODcxIC00Ni4yMTAxOTcgDQpMIDQ5My4wNDU3MDUgLTQ2LjI1MTk2MSANCkwgNDkzLjIwNTUzOCAtNDYuMzI3NzY5IA0KTCA0OTMuMzY1MzcyIC00Ni40Njk0NiANCkwgNDkzLjUyNTIwNiAtNDYuNjQ3MDQ5IA0KTCA0OTMuNjg1MDQgLTQ2Ljg2NTg0MiANCkwgNDkzLjg0NDg3NCAtNDcuMTYyODczIA0KTCA0OTQuMDA0NzA4IC00Ny41MDU3NTkgDQpMIDQ5NC4xNjQ1NDIgLTQ3LjkwNDg1OCANCkwgNDk0LjMyNDM3NiAtNDguNDA1MzM5IA0KTCA0OTQuNDg0MjEgLTQ4Ljk2ODY0OSANCkwgNDk0LjY0NDA0MyAtNDkuNjE0MTEzIA0KTCA0OTQuODAzODc3IC01MC4zOTkxNTcgDQpMIDQ5NC45NjM3MTEgLTUxLjI3MzQ4MyANCkwgNDk1LjEyMzU0NSAtNTIuMjcxOTUgDQpMIDQ5NS4yODMzNzkgLTUzLjQ2NjI0NCANCkwgNDk1LjQ0MzIxMyAtNTQuNzg5MjMyIA0KTCA0OTUuNjAzMDQ3IC01Ni4zMDE5MjQgDQpMIDQ5NS43NjI4ODEgLTU4LjA4ODk1NCANCkwgNDk1LjkyMjcxNCAtNjAuMDU5Mzg4IA0KTCA0OTYuMDgyNTQ4IC02Mi4zMTQyMjYgDQpMIDQ5Ni4yNDIzODIgLTY0Ljk0MiANCkwgNDk2LjQwMjIxNiAtNjcuODIxNTU2IA0KTCA0OTYuNTYyMDUgLTcxLjEwNzg1MSANCkwgNDk2LjcyMTg4NCAtNzQuODYyODA0IA0KTCA0OTYuODgxNzE4IC03OC45MzMwMjUgDQpMIDQ5Ny4wNDE1NTIgLTgzLjUyMTQ5OSANCkwgNDk3LjIwMTM4NiAtODguNjA5OTI2IA0KTCA0OTcuMzYxMjE5IC05NC4wMjY5ODMgDQpMIDQ5Ny41MjEwNTMgLTk5Ljk2NTE1NCANCkwgNDk3LjY4MDg4NyAtMTA2LjI4MDQxNiANCkwgNDk3Ljg0MDcyMSAtMTEyLjgyODY2NCANCkwgNDk4LjAwMDU1NSAtMTE5LjY3NjIyOSANCkwgNDk4LjE2MDM4OSAtMTI2LjYwNTc3MSANCkwgNDk4LjMyMDIyMyAtMTMzLjU1ODAwOSANCkwgNDk4LjQ4MDA1NyAtMTQwLjM5MzYzNCANCkwgNDk4LjYzOTg5MSAtMTQ2Ljk5MjMwOSANCkwgNDk4Ljc5OTcyNCAtMTUzLjM4NjgzMSANCkwgNDk4Ljk1OTU1OCAtMTU5LjI4MDkzNiANCkwgNDk5LjExOTM5MiAtMTY0Ljc2OTA4NiANCkwgNDk5LjI3OTIyNiAtMTY5LjkyNTEyMiANCkwgNDk5LjQzOTA2IC0xNzQuNDIxNzI1IA0KTCA0OTkuNTk4ODk0IC0xNzguNTE4NjM4IA0KTCA0OTkuNzU4NzI4IC0xODIuMjc3Mzc5IA0KTCA0OTkuOTE4NTYyIC0xODUuNDIxMjMyIA0KTCA1MDAuMDc4Mzk1IC0xODguMjU2NjQzIA0KTCA1MDAuMjM4MjI5IC0xOTAuODE2MTM5IA0KTCA1MDAuMzk4MDYzIC0xOTIuODk2MzgzIA0KTCA1MDAuNTU3ODk3IC0xOTQuNzY4MjI1IA0KTCA1MDAuNzE3NzMxIC0xOTYuNDM4MDY2IA0KTCA1MDAuODc3NTY1IC0xOTcuNzcyNTMyIA0KTCA1MDEuMDM3Mzk5IC0xOTguOTczNzczIA0KTCA1MDEuMTk3MjMzIC0yMDAuMDMxOTU1IA0KTCA1MDEuMzU3MDY3IC0yMDAuODc3NzA3IA0KTCA1MDEuNTE2OSAtMjAxLjYzNjQ3NyANCkwgNTAxLjY3NjczNCAtMjAyLjI5Nzk4NCANCkwgNTAxLjgzNjU2OCAtMjAyLjgyOTAyOCANCkwgNTAxLjk5NjQwMiAtMjAzLjMwNDM4MyANCkwgNTAyLjE1NjIzNiAtMjAzLjcxNTE0OCANCkwgNTAyLjMxNjA3IC0yMDQuMDQ2MzgzIA0KTCA1MDIuNDc1OTA0IC0yMDQuMzQyMzQzIA0KTCA1MDIuNjM1NzM4IC0yMDQuNTk2MDc1IA0KTCA1MDIuNzk1NTcxIC0yMDQuODAyNTQ3IA0KTCA1MDIuOTU1NDA1IC0yMDQuOTg2Nzc1IA0KTCA1MDMuMTE1MjM5IC0yMDUuMTQzNDA2IA0KTCA1MDMuMjc1MDczIC0yMDUuMjcxNTExIA0KTCA1MDMuNDM0OTA3IC0yMDUuMzg1NjM1IA0KTCA1MDMuNTk0NzQxIC0yMDUuNDgxOTkgDQpMIDUwMy43NTQ1NzUgLTIwNS41NjE3MjYgDQpMIDUwMy45MTQ0MDkgLTIwNS42MzI2ODUgDQpMIDUwNC4wNzQyNDMgLTIwNS42OTE5NjUgDQpMIDUwNC4yMzQwNzYgLTIwNS43NDEyMzUgDQpMIDUwNC4zOTM5MSAtMjA1Ljc4NTAzNSANCkwgNTA0LjU1Mzc0NCAtMjA1LjgyMTQ4MiANCkwgNTA0LjcxMzU3OCAtMjA1Ljg1MjE4NiANCkwgNTA0Ljg3MzQxMiAtMjA1Ljg3OTQ4OCANCkwgNTA1LjAzMzI0NiAtMjA1LjkwMTk0NCANCkwgNTA1LjE5MzA4IC0yMDYuMDMzODg0IA0KTCA1MDUuMzUyOTE0IC0yMDYuMDMzODg0IA0KTCA1MDUuNTEyNzQ4IC0yMDYuMDMzODg0IA0KTCA1MDUuNjcyNTgxIC0yMDYuMDMzODg0IA0KTCA1MDUuODMyNDE1IC0yMDYuMDMzODg0IA0KTCA1MDUuOTkyMjQ5IC0yMDYuMDMzODg0IA0KTCA1MDYuMTUyMDgzIC0yMDYuMDMzODg0IA0KTCA1MDYuMzExOTE3IC0yMDYuMDMzODg0IA0KTCA1MDYuNDcxNzUxIC0yMDYuMDMzODg0IA0KTCA1MDYuNjMxNTg1IC0yMDYuMDMzODg0IA0KTCA1MDYuNzkxNDE5IC0yMDYuMDMzODg0IA0KTCA1MDYuOTUxMjUyIC0yMDYuMDMzODg0IA0KTCA1MDcuMTExMDg2IC0yMDYuMDMzODg0IA0KTCA1MDcuMjcwOTIgLTIwNi4wMzM4ODQgDQpMIDUwNy40MzA3NTQgLTIwNi4wMzM4ODQgDQpMIDUwNy41OTA1ODggLTIwNi4wMzM4ODQgDQpMIDUwNy43NTA0MjIgLTIwNi4wMzM4ODQgDQpMIDUwNy45MTAyNTYgLTIwNi4wMzM4ODQgDQpMIDUwOC4wNzAwOSAtMjA2LjAzMzg4NCANCkwgNTA4LjIyOTkyNCAtMjA2LjAzMzg4NCANCkwgNTA4LjM4OTc1NyAtMjA2LjAzMzg4NCANCkwgNTA4LjU0OTU5MSAtMjA2LjAzMzg4NCANCkwgNTA4LjcwOTQyNSAtMjA2LjAzMzg4NCANCkwgNTA4Ljg2OTI1OSAtMjA2LjAzMzg4NCANCkwgNTA5LjAyOTA5MyAtMjA2LjAzMzg4NCANCkwgNTA5LjE4ODkyNyAtMjA2LjAzMzg4NCANCkwgNTA5LjM0ODc2MSAtMjA2LjAzMzg4NCANCkwgNTA5LjUwODU5NSAtMjA2LjAzMzg4NCANCkwgNTA5LjY2ODQyOSAtMjA2LjAzMzg4NCANCkwgNTA5LjgyODI2MiAtMjA2LjAzMzg4NCANCkwgNTA5Ljk4ODA5NiAtMjA2LjAzMzg4NCANCkwgNTEwLjE0NzkzIC0yMDYuMDMzODg0IA0KTCA1MTAuMzA3NzY0IC0yMDYuMDMzODg0IA0KTCA1MTAuNDY3NTk4IC0yMDYuMDMzODg0IA0KTCA1MTAuNjI3NDMyIC0yMDYuMDMzODg0IA0KTCA1MTAuNzg3MjY2IC0yMDYuMDMzODg0IA0KTCA1MTAuOTQ3MSAtMjA2LjAzMzg4NCANCkwgNTExLjEwNjkzMyAtMjA2LjAzMzg4NCANCkwgNTExLjI2Njc2NyAtMjA2LjAzMzg4NCANCkwgNTExLjQyNjYwMSAtMjA2LjAzMzg4NCANCkwgNTExLjU4NjQzNSAtMjA2LjAzMzg4NCANCkwgNTExLjc0NjI2OSAtMjA2LjAzMzg4NCANCkwgNTExLjkwNjEwMyAtMjA2LjAzMzg4NCANCkwgNTEyLjA2NTkzNyAtMjA2LjAzMzg4NCANCkwgNTEyLjIyNTc3MSAtMjA2LjAzMzg4NCANCkwgNTEyLjM4NTYwNSAtMjA2LjAzMzg4NCANCkwgNTEyLjU0NTQzOCAtMjA2LjAzMzg4NCANCkwgNTEyLjcwNTI3MiAtMjA2LjAzMzg4NCANCkwgNTEyLjg2NTEwNiAtMjA2LjAzMzg4NCANCkwgNTEzLjAyNDk0IC0yMDYuMDMzODg0IA0KTCA1MTMuMTg0Nzc0IC0yMDYuMDMzODg0IA0KTCA1MTMuMzQ0NjA4IC0yMDYuMDMzODg0IA0KTCA1MTMuNTA0NDQyIC0yMDYuMDMzODg0IA0KTCA1MTMuNjY0Mjc2IC0yMDYuMDMzODg0IA0KTCA1MTMuODI0MTA5IC0yMDYuMDMzODg0IA0KTCA1MTMuOTgzOTQzIC0yMDYuMDMzODg0IA0KTCA1MTQuMTQzNzc3IC0yMDYuMDMzODg0IA0KTCA1MTQuMzAzNjExIC0yMDYuMDMzODg0IA0KTCA1MTQuNDYzNDQ1IC0yMDYuMDMzODg0IA0KTCA1MTQuNjIzMjc5IC0yMDYuMDMzODg0IA0KTCA1MTQuNzgzMTEzIC0yMDYuMDMzODg0IA0KTCA1MTQuOTQyOTQ3IC0yMDYuMDMzODg0IA0KTCA1MTUuMTAyNzgxIC0yMDYuMDMzODg0IA0KTCA1MTUuMjYyNjE0IC0yMDYuMDMzODg0IA0KTCA1MTUuNDIyNDQ4IC0yMDYuMDMzODg0IA0KTCA1MTUuNTgyMjgyIC0yMDYuMDMzODg0IA0KTCA1MTUuNzQyMTE2IC0yMDYuMDMzODg0IA0KTCA1MTUuOTAxOTUgLTIwNi4wMzM4ODQgDQpMIDUxNi4wNjE3ODQgLTIwNi4wMzM4ODQgDQpMIDUxNi4yMjE2MTggLTIwNi4wMzM4ODQgDQpMIDUxNi4zODE0NTIgLTIwNi4wMzM4ODQgDQpMIDUxNi41NDEyODYgLTIwNi4wMzM4ODQgDQpMIDUxNi43MDExMTkgLTIwNi4wMzM4ODQgDQpMIDUxNi44NjA5NTMgLTIwNi4wMzM4ODQgDQpMIDUxNy4wMjA3ODcgLTIwNi4wMzM4ODQgDQpMIDUxNy4xODA2MjEgLTIwNi4wMzM4ODQgDQpMIDUxNy4zNDA0NTUgLTIwNi4wMzM4ODQgDQpMIDUxNy41MDAyODkgLTIwNi4wMzM4ODQgDQpMIDUxNy42NjAxMjMgLTIwNi4wMzM4ODQgDQpMIDUxNy44MTk5NTcgLTIwNi4wMzM4ODQgDQpMIDUxNy45Nzk3OSAtMjA2LjAzMzg4NCANCkwgNTE4LjEzOTYyNCAtMjA2LjAzMzg4NCANCkwgNTE4LjI5OTQ1OCAtMjA2LjAzMzg4NCANCkwgNTE4LjQ1OTI5MiAtMjA2LjAzMzg4NCANCkwgNTE4LjYxOTEyNiAtMjA2LjAzMzg4NCANCkwgNTE4Ljc3ODk2IC0yMDYuMDMzODg0IA0KTCA1MTguOTM4Nzk0IC0yMDYuMDMzODg0IA0KTCA1MTkuMDk4NjI4IC0yMDYuMDMzODg0IA0KTCA1MTkuMjU4NDYyIC0yMDYuMDMzODg0IA0KTCA1MTkuNDE4Mjk1IC0yMDYuMDMzODg0IA0KTCA1MTkuNTc4MTI5IC0yMDYuMDMzODg0IA0KTCA1MTkuNzM3OTYzIC0yMDYuMDMzODg0IA0KTCA1MTkuODk3Nzk3IC0yMDYuMDMzODg0IA0KTCA1MjAuMDU3NjMxIC0yMDYuMDMzODg0IA0KTCA1MjAuMjE3NDY1IC0yMDYuMDMzODg0IA0KTCA1MjAuMzc3Mjk5IC0yMDYuMDMzODg0IA0KTCA1MjAuNTM3MTMzIC0yMDYuMDMzODg0IA0KTCA1MjAuNjk2OTY2IC0yMDYuMDMzODg0IA0KTCA1MjAuODU2OCAtMjA2LjAzMzg4NCANCkwgNTIxLjAxNjYzNCAtMjA2LjAzMzg4NCANCkwgNTIxLjE3NjQ2OCAtMjA2LjAzMzg4NCANCkwgNTIxLjMzNjMwMiAtMjA2LjAzMzg4NCANCkwgNTIxLjQ5NjEzNiAtMjA2LjAzMzg4NCANCkwgNTIxLjY1NTk3IC0yMDYuMDMzODg0IA0KTCA1MjEuODE1ODA0IC0yMDYuMDMzODg0IA0KTCA1MjEuOTc1NjM4IC0yMDYuMDMzODg0IA0KTCA1MjIuMTM1NDcxIC0yMDYuMDMzODg0IA0KTCA1MjIuMjk1MzA1IC0yMDYuMDMzODg0IA0KTCA1MjIuNDU1MTM5IC0yMDYuMDMzODg0IA0KTCA1MjIuNjE0OTczIC0yMDYuMDMzODg0IA0KTCA1MjIuNzc0ODA3IC0yMDYuMDMzODg0IA0KTCA1MjIuOTM0NjQxIC0yMDYuMDMzODg0IA0KTCA1MjMuMDk0NDc1IC0yMDYuMDMzODg0IA0KTCA1MjMuMjU0MzA5IC0yMDYuMDMzODg0IA0KTCA1MjMuNDE0MTQzIC0yMDYuMDMzODg0IA0KTCA1MjMuNTczOTc2IC0yMDYuMDMzODg0IA0KTCA1MjMuNzMzODEgLTIwNi4wMzM4ODQgDQpMIDUyMy44OTM2NDQgLTIwNi4wMzM4ODQgDQpMIDUyNC4wNTM0NzggLTIwNi4wMzM4ODQgDQpMIDUyNC4yMTMzMTIgLTIwNi4wMzM4ODQgDQpMIDUyNC4zNzMxNDYgLTIwNi4wMzM4ODQgDQpMIDUyNC41MzI5OCAtMjA2LjAzMzg4NCANCkwgNTI0LjY5MjgxNCAtMjA2LjAzMzg4NCANCkwgNTI0Ljg1MjY0NyAtMjA2LjAzMzg4NCANCkwgNTI1LjAxMjQ4MSAtMjA2LjAzMzg4NCANCkwgNTI1LjE3MjMxNSAtMjA2LjAzMzg4NCANCkwgNTI1LjMzMjE0OSAtMjA1LjU5NTk2NiANCkwgNTI1LjQ5MTk4MyAtMjA1LjUyOTcxIA0KTCA1MjUuNjUxODE3IC0yMDUuNDQ3OTcyIA0KTCA1MjUuODExNjUxIC0yMDUuMzU1MjA2IA0KTCA1MjUuOTcxNDg1IC0yMDUuMjQ0NTk3IA0KTCA1MjYuMTMxMzE5IC0yMDUuMTEwMDE5IA0KTCA1MjYuMjkxMTUyIC0yMDQuOTU4MDg2IA0KTCA1MjYuNDUwOTg2IC0yMDQuNzc2NTE3IA0KTCA1MjYuNjEwODIgLTIwNC41NTcyMjQgDQpMIDUyNi43NzA2NTQgLTIwNC4zMTAzOTYgDQpMIDUyNi45MzA0ODggLTIwNC4wMTQ1MTcgDQpMIDUyNy4wOTAzMjIgLTIwMy42NjA4NzIgDQpMIDUyNy4yNTAxNTYgLTIwMy4yNjM3NDYgDQpMIDUyNy40MDk5OSAtMjAyLjc4NDY0NSANCkwgNTI3LjU2OTgyNCAtMjAyLjIxNzU3MiANCkwgNTI3LjcyOTY1NyAtMjAxLjU4MjU4MyANCkwgNTI3Ljg4OTQ5MSAtMjAwLjgxMzI4IA0KTCA1MjguMDQ5MzI1IC0xOTkuOTEyMzk2IA0KTCA1MjguMjA5MTU5IC0xOTguOTA3MjA2IA0KTCA1MjguMzY4OTkzIC0xOTcuNjg2ODM0IA0KTCA1MjguNTI4ODI3IC0xOTYuMjc1ODgyIA0KTCA1MjguNjg4NjYxIC0xOTQuNzA5NjggDQpMIDUyOC44NDg0OTUgLTE5Mi44MTMwNjkgDQpMIDUyOS4wMDgzMjggLTE5MC42NTY0NiANCkwgNTI5LjE2ODE2MiAtMTg4LjI4MTg5NiANCkwgNTI5LjMyNzk5NiAtMTg1LjQzOTM4OSANCkwgNTI5LjQ4NzgzIC0xODIuMjc3Njk5IA0KTCA1MjkuNjQ3NjY0IC0xNzguODM5MDA0IA0KTCA1MjkuODA3NDk4IC0xNzQuODIxOTU5IA0KTCA1MjkuOTY3MzMyIC0xNzAuNDgwMDI1IA0KTCA1MzAuMTI3MTY2IC0xNjUuODQyODgyIA0KTCA1MzAuMjg3IC0xNjAuNjQ4MzQzIA0KTCA1MzAuNDQ2ODMzIC0xNTUuMjE4NTMyIA0KTCA1MzAuNjA2NjY3IC0xNDkuNTU1MTQzIA0KTCA1MzAuNzY2NTAxIC0xNDMuNTc0MTA1IA0KTCA1MzAuOTI2MzM1IC0xMzcuNTIxNzAyIA0KTCA1MzEuMDg2MTY5IC0xMzEuMzk0MTk0IA0KTCA1MzEuMjQ2MDAzIC0xMjUuMzA0Mjc5IA0KTCA1MzEuNDA1ODM3IC0xMTkuMzAzOTk3IA0KTCA1MzEuNTY1NjcxIC0xMTMuNDE1MDM4IA0KTCA1MzEuNzI1NTA0IC0xMDcuODIxMDMyIA0KTCA1MzEuODg1MzM4IC0xMDIuNDE0MyANCkwgNTMyLjA0NTE3MiAtOTcuMjQyMTIxIA0KTCA1MzIuMjA1MDA2IC05Mi40NjI4ODggDQpMIDUzMi4zNjQ4NCAtODcuOTAyNjA4IA0KTCA1MzIuNTI0Njc0IC04My42MjQyNTUgDQpMIDUzMi42ODQ1MDggLTc5LjczOTc0MiANCkwgNTMyLjg0NDM0MiAtNzYuMDcyNDQxIA0KTCA1MzMuMDA0MTc2IC03Mi42OTQyNzUgDQpMIDUzMy4xNjQwMDkgLTY5LjY3MTk0MSANCkwgNTMzLjMyMzg0MyAtNjYuODQ3NjU1IA0KTCA1MzMuNDgzNjc3IC02NC4yOTUwNjYgDQpMIDUzMy42NDM1MTEgLTYyLjAzODQyMSANCkwgNTMzLjgwMzM0NSAtNTkuOTQ5NjYyIA0KTCA1MzMuOTYzMTc5IC01OC4wOTY1NjEgDQpMIDUzNC4xMjMwMTMgLTU2LjQ3MjQwMyANCkwgNTM0LjI4Mjg0NyAtNTQuOTgxODkzIA0KTCA1MzQuNDQyNjgxIC01My42ODI4NzkgDQpMIDUzNC42MDI1MTQgLTUyLjU1MDA3NCANCkwgNTM0Ljc2MjM0OCAtNTEuNTE4MjY0IA0KTCA1MzQuOTIyMTgyIC01MC42MzQxMjUgDQpMIDUzNS4wODIwMTYgLTQ5Ljg2NzIzOCANCkwgNTM1LjI0MTg1IC00OS4xNzQ5NTkgDQpMIDUzNS40MDE2ODQgLTQ4LjU5NDA2OCANCkwgNTM1LjU2MTUxOCAtNDguMDk0NjQzIA0KTCA1MzUuNzIxMzUyIC00Ny42NTAxMzUgDQpMIDUzNS44ODExODUgLTQ3LjI5MDcyMiANCkwgNTM2LjA0MTAxOSAtNDYuOTg5MzI4IA0KTCA1MzYuMjAwODUzIC00Ni43Mjk1ODYgDQpMIDUzNi4zNjA2ODcgLTQ2LjUzNzYyOCANCkwgNTM2LjUyMDUyMSAtNDYuMzg5ODQ4IA0KTCA1MzYuNjgwMzU1IC00Ni4yNzYgDQpMIDUzNi44NDAxODkgLTQ2LjIyMTc1MyANCkwgNTM3LjAwMDAyMyAtNDYuMjA1OTQ2IA0KTCA1MzcuMTU5ODU3IC00Ni4yMjE2MjUgDQpMIDUzNy4zMTk2OSAtNDYuMjk3NDMzIA0KTCA1MzcuNDc5NTI0IC00Ni40MTE3NDUgDQpMIDUzNy42MzkzNTggLTQ2LjU1OTU0MSANCkwgNTM3Ljc5OTE5MiAtNDYuNzc4MzM0IA0KTCA1MzcuOTU5MDI2IC00Ny4wNDE3ODQgDQpMIDUzOC4xMTg4NiAtNDcuMzQ2MTM2IA0KTCA1MzguMjc4Njk0IC00Ny43NDUyMzUgDQpMIDUzOC40Mzg1MjggLTQ4LjIwMDcyMyANCkwgNTM4LjU5ODM2MSAtNDguNzEyMjQ3IA0KTCA1MzguNzU4MTk1IC00OS4zNTU5MjEgDQpMIDUzOC45MTgwMjkgLTUwLjA3NjkyIA0KTCA1MzkuMDc3ODYzIC01MC44ODI1MDIgDQpMIDUzOS4yMzc2OTcgLTUxLjg3MjU2NCANCkwgNTM5LjM5NzUzMSAtNTIuOTczNzIyIA0KTCA1MzkuNTU3MzY1IC01NC4yMDQ5ODUgDQpMIDUzOS43MTcxOTkgLTU1LjY5Njg1MSANCkwgNTM5Ljg3NzAzMyAtNTcuMzQ4NTY1IA0KTCA1NDAuMDM2ODY2IC01OS4xOTk1MjggDQpMIDU0MC4xOTY3IC02MS40MTIyOTcgDQpMIDU0MC4zNTY1MzQgLTYzLjg0ODk3NiANCkwgNTQwLjUxNjM2OCAtNjYuNTgxNTY3IA0KTCA1NDAuNjc2MjAyIC02OS43OTMzMTcgDQpMIDU0MC44MzYwMzYgLTczLjI5ODQ3IA0KTCA1NDAuOTk1ODcgLTc3LjIwOTMwNiANCkwgNTQxLjE1NTcwNCAtODEuNjg2MTA2IA0KTCA1NDEuMzE1NTM4IC04Ni40OTY3OTQgDQpMIDU0MS40NzUzNzEgLTkxLjc3OTYyNCANCkwgNTQxLjYzNTIwNSAtOTcuNTg5ODgzIA0KTCA1NDEuNzk1MDM5IC0xMDMuNjg2NDE1IA0KTCA1NDEuOTU0ODczIC0xMTAuMTcxMzcgDQpMIDU0Mi4xMTQ3MDcgLTExNi45MzcxOTYgDQpMIDU0Mi4yNzQ1NDEgLTEyMy44MTcwMTUgDQpMIDU0Mi40MzQzNzUgLTEzMC43ODg4OTYgDQpMIDU0Mi41OTQyMDkgLTEzNy42NTkzODEgDQpMIDU0Mi43NTQwNDIgLTE0NC40MDg3MjkgDQpMIDU0Mi45MTM4NzYgLTE1MC44Njc2NjMgDQpMIDU0My4wNzM3MSAtMTU2LjkyMzI5NCANCkwgNTQzLjIzMzU0NCAtMTYyLjY4MjYxNCANCkwgNTQzLjM5MzM3OCAtMTY3Ljg5ODgxIA0KTCA1NDMuNTUzMjEyIC0xNzIuNjIzMDc4IA0KTCA1NDMuNzEzMDQ2IC0xNzcuMDAxMjc4IA0KTCA1NDMuODcyODggLTE4MC43OTQ3MDIgDQpMIDU0NC4wMzI3MTQgLTE4NC4xNjM2OTQgDQpMIDU0NC4xOTI1NDcgLTE4Ny4yMjgzMzUgDQpMIDU0NC4zNTIzODEgLTE4OS43OTkxMTMgDQpMIDU0NC41MTIyMTUgLTE5Mi4wNjQyODUgDQpMIDU0NC42NzIwNDkgLTE5NC4xMDAyODggDQpMIDU0NC44MzE4ODMgLTE5NS43NzAxMjkgDQpMIDU0NC45OTE3MTcgLTE5Ny4yMzk3MTggDQpMIDU0NS4xNTE1NTEgLTE5OC41NTA1MDEgDQpMIDU0NS4zMTEzODUgLTE5OS42MDg2ODIgDQpMIDU0NS40NzEyMTggLTIwMC41NDI3MjUgDQpMIDU0NS42MzEwNTIgLTIwMS4zNzE4NzQgDQpMIDU0NS43OTA4ODYgLTIwMi4wMzMzODEgDQpMIDU0NS45NTA3MiAtMjAyLjYyMDQwNiANCkwgNTQ2LjExMDU1NCAtMjAzLjE0MDA3NyANCkwgNTQ2LjI3MDM4OCAtMjAzLjU1MDg0MiANCkwgNTQ2LjQzMDIyMiAtMjAzLjkxNzM1MyANCkwgNTQ2LjU5MDA1NiAtMjA0LjIzOTkyOCANCkwgNTQ2Ljc0OTg5IC0yMDQuNDk0NTgyIA0KTCA1NDYuOTA5NzIzIC0yMDQuNzIyNzQzIA0KTCA1NDcuMDY5NTU3IC0yMDQuOTIyMjUzIA0KTCA1NDcuMjI5MzkxIC0yMDUuMDgwNzU0IA0KTCA1NDcuMzg5MjI1IC0yMDUuMjIyNDIzIA0KTCA1NDcuNTQ5MDU5IC0yMDUuMzQ1MTQyIA0KTCA1NDcuNzA4ODkzIC0yMDUuNDQzNDQ4IA0KTCA1NDcuODY4NzI3IC0yMDUuNTMxMzgxIA0KTCA1NDguMDI4NTYxIC0yMDUuNjA3MjQ0IA0KTCA1NDguMTg4Mzk1IC0yMDUuNjY4MjUzIA0KTCA1NDguMzQ4MjI4IC0yMDUuNzIyNjUyIA0KTCA1NDguNTA4MDYyIC0yMDUuNzY5MTA4IA0KTCA1NDguNjY3ODk2IC0yMDUuODA2OTAzIA0KTCA1NDguODI3NzMgLTIwNS44NDA2NjkgDQpMIDU0OC45ODc1NjQgLTIwNS44Njk0NjIgDQpMIDU0OS4xNDczOTggLTIwNS44OTI5NjIgDQpMIDU0OS4zMDcyMzIgLTIwNi4wMzM4ODQgDQpMIDU0OS40NjcwNjYgLTIwNi4wMzM4ODQgDQpMIDU0OS42MjY4OTkgLTIwNi4wMzM4ODQgDQpMIDU0OS43ODY3MzMgLTIwNi4wMzM4ODQgDQpMIDU0OS45NDY1NjcgLTIwNi4wMzM4ODQgDQpMIDU1MC4xMDY0MDEgLTIwNi4wMzM4ODQgDQpMIDU1MC4yNjYyMzUgLTIwNi4wMzM4ODQgDQpMIDU1MC40MjYwNjkgLTIwNi4wMzM4ODQgDQpMIDU1MC41ODU5MDMgLTIwNi4wMzM4ODQgDQpMIDU1MC43NDU3MzcgLTIwNi4wMzM4ODQgDQpMIDU1MC45MDU1NzEgLTIwNi4wMzM4ODQgDQpMIDU1MS4wNjU0MDQgLTIwNi4wMzM4ODQgDQpMIDU1MS4yMjUyMzggLTIwNi4wMzM4ODQgDQpMIDU1MS4zODUwNzIgLTIwNi4wMzM4ODQgDQpMIDU1MS41NDQ5MDYgLTIwNi4wMzM4ODQgDQpMIDU1MS43MDQ3NCAtMjA2LjAzMzg4NCANCkwgNTUxLjg2NDU3NCAtMjA2LjAzMzg4NCANCkwgNTUyLjAyNDQwOCAtMjA2LjAzMzg4NCANCkwgNTUyLjE4NDI0MiAtMjA2LjAzMzg4NCANCkwgNTUyLjM0NDA3NiAtMjA2LjAzMzg4NCANCkwgNTUyLjUwMzkwOSAtMjA2LjAzMzg4NCANCkwgNTUyLjY2Mzc0MyAtMjA2LjAzMzg4NCANCkwgNTUyLjgyMzU3NyAtMjA2LjAzMzg4NCANCkwgNTUyLjk4MzQxMSAtMjA2LjAzMzg4NCANCkwgNTUzLjE0MzI0NSAtMjA2LjAzMzg4NCANCkwgNTUzLjMwMzA3OSAtMjA2LjAzMzg4NCANCkwgNTUzLjQ2MjkxMyAtMjA2LjAzMzg4NCANCkwgNTUzLjYyMjc0NyAtMjA2LjAzMzg4NCANCkwgNTUzLjc4MjU4IC0yMDYuMDMzODg0IA0KTCA1NTMuOTQyNDE0IC0yMDYuMDMzODg0IA0KTCA1NTQuMTAyMjQ4IC0yMDYuMDMzODg0IA0KTCA1NTQuMjYyMDgyIC0yMDYuMDMzODg0IA0KTCA1NTQuNDIxOTE2IC0yMDYuMDMzODg0IA0KTCA1NTQuNTgxNzUgLTIwNi4wMzM4ODQgDQpMIDU1NC43NDE1ODQgLTIwNi4wMzM4ODQgDQpMIDU1NC45MDE0MTggLTIwNi4wMzM4ODQgDQpMIDU1NS4wNjEyNTIgLTIwNi4wMzM4ODQgDQpMIDU1NS4yMjEwODUgLTIwNi4wMzM4ODQgDQpMIDU1NS4zODA5MTkgLTIwNi4wMzM4ODQgDQpMIDU1NS41NDA3NTMgLTIwNi4wMzM4ODQgDQpMIDU1NS43MDA1ODcgLTIwNi4wMzM4ODQgDQpMIDU1NS44NjA0MjEgLTIwNi4wMzM4ODQgDQpMIDU1Ni4wMjAyNTUgLTIwNi4wMzM4ODQgDQpMIDU1Ni4xODAwODkgLTIwNi4wMzM4ODQgDQpMIDU1Ni4zMzk5MjMgLTIwNi4wMzM4ODQgDQpMIDU1Ni40OTk3NTYgLTIwNi4wMzM4ODQgDQpMIDU1Ni42NTk1OSAtMjA2LjAzMzg4NCANCkwgNTU2LjgxOTQyNCAtMjA2LjAzMzg4NCANCkwgNTU2Ljk3OTI1OCAtMjA2LjAzMzg4NCANCkwgNTU3LjEzOTA5MiAtMjA2LjAzMzg4NCANCkwgNTU3LjI5ODkyNiAtMjA2LjAzMzg4NCANCkwgNTU3LjQ1ODc2IC0yMDYuMDMzODg0IA0KTCA1NTcuNjE4NTk0IC0yMDYuMDMzODg0IA0KTCA1NTcuNzc4NDI4IC0yMDYuMDMzODg0IA0KTCA1NTcuOTM4MjYxIC0yMDYuMDMzODg0IA0KTCA1NTguMDk4MDk1IC0yMDYuMDMzODg0IA0KTCA1NTguMjU3OTI5IC0yMDYuMDMzODg0IA0KTCA1NTguNDE3NzYzIC0yMDYuMDMzODg0IA0KTCA1NTguNTc3NTk3IC0yMDYuMDMzODg0IA0KTCA1NTguNzM3NDMxIC0yMDYuMDMzODg0IA0KTCA1NTguODk3MjY1IC0yMDYuMDMzODg0IA0KTCA1NTkuMDU3MDk5IC0yMDYuMDMzODg0IA0KTCA1NTkuMjE2OTMzIC0yMDYuMDMzODg0IA0KTCA1NTkuMzc2NzY2IC0yMDYuMDMzODg0IA0KTCA1NTkuNTM2NiAtMjA2LjAzMzg4NCANCkwgNTU5LjY5NjQzNCAtMjA2LjAzMzg4NCANCkwgNTU5Ljg1NjI2OCAtMjA2LjAzMzg4NCANCkwgNTYwLjAxNjEwMiAtMjA2LjAzMzg4NCANCkwgNTYwLjE3NTkzNiAtMjA2LjAzMzg4NCANCkwgNTYwLjMzNTc3IC0yMDYuMDMzODg0IA0KTCA1NjAuNDk1NjA0IC0yMDYuMDMzODg0IA0KTCA1NjAuNjU1NDM3IC0yMDYuMDMzODg0IA0KTCA1NjAuODE1MjcxIC0yMDYuMDMzODg0IA0KTCA1NjAuOTc1MTA1IC0yMDYuMDMzODg0IA0KTCA1NjEuMTM0OTM5IC0yMDYuMDMzODg0IA0KTCA1NjEuMjk0NzczIC0yMDYuMDMzODg0IA0KTCA1NjEuNDU0NjA3IC0yMDYuMDMzODg0IA0KTCA1NjEuNjE0NDQxIC0yMDYuMDMzODg0IA0KTCA1NjEuNzc0Mjc1IC0yMDYuMDMzODg0IA0KTCA1NjEuOTM0MTA5IC0yMDYuMDMzODg0IA0KTCA1NjIuMDkzOTQyIC0yMDYuMDMzODg0IA0KTCA1NjIuMjUzNzc2IC0yMDYuMDMzODg0IA0KTCA1NjIuNDEzNjEgLTIwNi4wMzM4ODQgDQpMIDU2Mi41NzM0NDQgLTIwNi4wMzM4ODQgDQpMIDU2Mi43MzMyNzggLTIwNi4wMzM4ODQgDQpMIDU2Mi44OTMxMTIgLTIwNi4wMzM4ODQgDQpMIDU2My4wNTI5NDYgLTIwNi4wMzM4ODQgDQpMIDU2My4yMTI3OCAtMjA2LjAzMzg4NCANCkwgNTYzLjM3MjYxMyAtMjA2LjAzMzg4NCANCkwgNTYzLjUzMjQ0NyAtMjA2LjAzMzg4NCANCkwgNTYzLjY5MjI4MSAtMjA2LjAzMzg4NCANCkwgNTYzLjg1MjExNSAtMjA2LjAzMzg4NCANCkwgNTY0LjAxMTk0OSAtMjA2LjAzMzg4NCANCkwgNTY0LjE3MTc4MyAtMjA2LjAzMzg4NCANCkwgNTY0LjMzMTYxNyAtMjA2LjAzMzg4NCANCkwgNTY0LjQ5MTQ1MSAtMjA2LjAzMzg4NCANCkwgNTY0LjY1MTI4NSAtMjA2LjAzMzg4NCANCkwgNTY0LjgxMTExOCAtMjA2LjAzMzg4NCANCkwgNTY0Ljk3MDk1MiAtMjA2LjAzMzg4NCANCkwgNTY1LjEzMDc4NiAtMjA2LjAzMzg4NCANCkwgNTY1LjI5MDYyIC0yMDYuMDMzODg0IA0KTCA1NjUuNDUwNDU0IC0yMDYuMDMzODg0IA0KTCA1NjUuNjEwMjg4IC0yMDYuMDMzODg0IA0KTCA1NjUuNzcwMTIyIC0yMDYuMDMzODg0IA0KTCA1NjUuOTI5OTU2IC0yMDYuMDMzODg0IA0KTCA1NjYuMDg5NzkgLTIwNi4wMzM4ODQgDQpMIDU2Ni4yNDk2MjMgLTIwNi4wMzM4ODQgDQpMIDU2Ni40MDk0NTcgLTIwNi4wMzM4ODQgDQpMIDU2Ni41NjkyOTEgLTIwNi4wMzM4ODQgDQpMIDU2Ni43MjkxMjUgLTIwNi4wMzM4ODQgDQpMIDU2Ni44ODg5NTkgLTIwNi4wMzM4ODQgDQpMIDU2Ny4wNDg3OTMgLTIwNi4wMzM4ODQgDQpMIDU2Ny4yMDg2MjcgLTIwNi4wMzM4ODQgDQpMIDU2Ny4zNjg0NjEgLTIwNi4wMzM4ODQgDQpMIDU2Ny41MjgyOTQgLTIwNi4wMzM4ODQgDQpMIDU2Ny42ODgxMjggLTIwNi4wMzM4ODQgDQpMIDU2Ny44NDc5NjIgLTIwNi4wMzM4ODQgDQpMIDU2OC4wMDc3OTYgLTIwNi4wMzM4ODQgDQpMIDU2OC4xNjc2MyAtMjA2LjAzMzg4NCANCkwgNTY4LjMyNzQ2NCAtMjA2LjAzMzg4NCANCkwgNTY4LjQ4NzI5OCAtMjA2LjAzMzg4NCANCkwgNTY4LjY0NzEzMiAtMjA2LjAzMzg4NCANCkwgNTY4LjgwNjk2NiAtMjA2LjAzMzg4NCANCkwgNTY4Ljk2Njc5OSAtMjA2LjAzMzg4NCANCkwgNTY5LjEyNjYzMyAtMjA2LjAzMzg4NCANCkwgNTY5LjI4NjQ2NyAtMjA2LjAzMzg4NCANCkwgNTY5LjQ0NjMwMSAtMjA2LjAzMzg4NCANCkwgNTY5LjYwNjEzNSAtMjA1LjU1NjIxMiANCkwgNTY5Ljc2NTk2OSAtMjA1LjQ4MjE3IA0KTCA1NjkuOTI1ODAzIC0yMDUuMzk2Njc2IA0KTCA1NzAuMDg1NjM3IC0yMDUuMjg4ODQgDQpMIDU3MC4yNDU0NzEgLTIwNS4xNjY2NCANCkwgNTcwLjQwNTMwNCAtMjA1LjAyNTA4OCANCkwgNTcwLjU2NTEzOCAtMjA0Ljg0OTE0NSANCkwgNTcwLjcyNDk3MiAtMjA0LjY1MDEyOCANCkwgNTcwLjg4NDgwNiAtMjA0LjQxNzg2OCANCkwgNTcxLjA0NDY0IC0yMDQuMTMyODY4IA0KTCA1NzEuMjA0NDc0IC0yMDMuODExNTg1IA0KTCA1NzEuMzY0MzA4IC0yMDMuNDM0ODAxIA0KTCA1NzEuNTI0MTQyIC0yMDIuOTc2Mjg1IA0KTCA1NzEuNjgzOTc1IC0yMDIuNDYwNjg3IA0KTCA1NzEuODQzODA5IC0yMDEuODUyODk4IA0KTCA1NzIuMDAzNjQzIC0yMDEuMTIxMDAyIA0KTCA1NzIuMTYzNDc3IC0yMDAuMzAwNjY5IA0KTCA1NzIuMzIzMzExIC0xOTkuMzI5OTg2IA0KTCA1NzIuNDgzMTQ1IC0xOTguMTc0OTgzIA0KTCA1NzIuNjQyOTc5IC0xOTYuODg2Mzk0IA0KTCA1NzIuODAyODEzIC0xOTUuMzYwMTE2IA0KTCA1NzIuOTYyNjQ3IC0xOTMuNTcxNzEyIA0KTCA1NzMuMTIyNDggLTE5MS41OTA1NDEgDQpMIDU3My4yODIzMTQgLTE4OS4yNTUzMzQgDQpMIDU3My40NDIxNDggLTE4Ni41NzYzOTggDQpMIDU3My42MDE5ODIgLTE4My42NDE3MzIgDQpMIDU3My43NjE4MTYgLTE4MC4yMzE2OCANCkwgNTczLjkyMTY1IC0xNzYuNDI4Nzc3IA0KTCA1NzQuMDgxNDg0IC0xNzIuMzMxMDM0IA0KTCA1NzQuMjQxMzE4IC0xNjcuNzAzNTI4IA0KTCA1NzQuNDAxMTUxIC0xNjIuNzI2MTUyIA0KTCA1NzQuNTYwOTg1IC0xNTcuNDgzODg3IA0KTCA1NzQuNzIwODE5IC0xNTEuODIwNTE0IA0KTCA1NzQuODgwNjUzIC0xNDUuOTY4MjM2IA0KTCA1NzUuMDQwNDg3IC0xMzkuOTcyNzAyIA0KTCA1NzUuMjAwMzIxIC0xMzMuODQ1MTk0IA0KTCA1NzUuMzYwMTU1IC0xMjcuNzM5NTY3IA0KTCA1NzUuNTE5OTg5IC0xMjEuNjU5NTc3IA0KTCA1NzUuNjc5ODIzIC0xMTUuNzcwNjM0IA0KTCA1NzUuODM5NjU2IC0xMTAuMDQ5MjEgDQpMIDU3NS45OTk0OSAtMTA0LjQ4MzE1OSANCkwgNTc2LjE1OTMyNCAtOTkuMzEwOTggDQpMIDU3Ni4zMTkxNTggLTk0LjM1NjI4NCANCkwgNTc2LjQ3ODk5MiAtODkuNjIyNzYzIA0KTCA1NzYuNjM4ODI2IC04NS4zMzU1ODcgDQpMIDU3Ni43OTg2NiAtODEuMjY5MDQyIA0KTCA1NzYuOTU4NDk0IC03Ny40NDU3NzcgDQpMIDU3Ny4xMTgzMjggLTc0LjA0NTUzOCANCkwgNTc3LjI3ODE2MSAtNzAuODUyNzkyIA0KTCA1NzcuNDM3OTk1IC02Ny45MDA2NTcgDQpMIDU3Ny41OTc4MjkgLTY1LjMxNjEwMiANCkwgNTc3Ljc1NzY2MyAtNjIuOTEyMzY0IA0KTCA1NzcuOTE3NDk3IC02MC43Mjc1MzIgDQpMIDU3OC4wNzczMzEgLTU4LjgzNzgxMyANCkwgNTc4LjIzNzE2NSAtNTcuMDk1NDI0IA0KTCA1NzguMzk2OTk5IC01NS41Mzc4NjcgDQpMIDU3OC41NTY4MzIgLTU0LjIwMjQ5IA0KTCA1NzguNzE2NjY2IC01Mi45ODAzMzkgDQpMIDU3OC44NzY1IC01MS45MDQ2NzQgDQpMIDU3OS4wMzYzMzQgLTUwLjk4Nzc4NCANCkwgNTc5LjE5NjE2OCAtNTAuMTU1MjA2IA0KTCA1NzkuMzU2MDAyIC00OS40MzUyNzcgDQpMIDU3OS41MTU4MzYgLTQ4LjgyNjQzMSANCkwgNTc5LjY3NTY3IC00OC4yNzkzNDQgDQpMIDU3OS44MzU1MDQgLTQ3LjgxNzU5IA0KTCA1NzkuOTk1MzM3IC00Ny40MzQ0NzQgDQpMIDU4MC4xNTUxNzEgLTQ3LjA5NzU4MiANCkwgNTgwLjMxNTAwNSAtNDYuODI2OTU1IA0KTCA1ODAuNDc0ODM5IC00Ni42MTQ0MTEgDQpMIDU4MC42MzQ2NzMgLTQ2LjQzODI2MSANCkwgNTgwLjc5NDUwNyAtNDYuMzE3MjIgDQpMIDU4MC45NTQzNDEgLTQ2LjI0MzQ0MiANCkwgNTgxLjExNDE3NSAtNDYuMjAxNzU4IA0KTCA1ODEuMjc0MDA4IC00Ni4yMTIzMjMgDQpMIDU4MS40MzM4NDIgLTQ2LjI2NzEyOSANCkwgNTgxLjU5MzY3NiAtNDYuMzU0MDQ2IA0KTCA1ODEuNzUzNTEgLTQ2LjQ5ODMwOSANCkwgNTgxLjkxMzM0NCAtNDYuNjkwODEgDQpMIDU4Mi4wNzMxNzggLTQ2LjkyMDY5NiANCkwgNTgyLjIzMzAxMiAtNDcuMjIzNDAxIA0KTCA1ODIuMzkyODQ2IC00Ny41ODU1OTUgDQpMIDU4Mi41NTI2OCAtNDcuOTk2MTIyIA0KTCA1ODIuNzEyNTEzIC00OC41MDc2NDcgDQpMIDU4Mi44NzIzNDcgLTQ5LjA5NzcyOSANCkwgNTgzLjAzMjE4MSAtNDkuNzU0NjY4IA0KTCA1ODMuMTkyMDE1IC01MC41NjAyNjcgDQpMIDU4My4zNTE4NDkgLTUxLjQ3MzE2IA0KTCA1ODMuNTExNjgzIC01Mi40ODEyMzQgDQpMIDU4My42NzE1MTcgLTUzLjcxMjQ5NSANCkwgNTgzLjgzMTM1MSAtNTUuMDkxNzc2IA0KTCA1ODMuOTkxMTg1IC01Ni42MDgxNzkgDQpMIDU4NC4xNTEwMTggLTU4LjQ1OTEzOSANCkwgNTg0LjMxMDg1MiAtNjAuNTEwMzUyIA0KTCA1ODQuNDcwNjg2IC02Mi43NjUxOTEgDQpMIDU4NC42MzA1MiAtNjUuNDg4NTI4IA0KTCA1ODQuNzkwMzU0IC02OC40Nzg4MTUgDQpMIDU4NC45NTAxODggLTcxLjc2NTExIA0KTCA1ODUuMTEwMDIyIC03NS42NDQ5NzIgDQpMIDU4NS4yNjk4NTYgLTc5Ljg1MDcxMyANCkwgNTg1LjQyOTY4OSAtODQuNDM5MjA0IA0KTCA1ODUuNTg5NTIzIC04OS42NjY0OTIgDQpMIDU4NS43NDkzNTcgLTk1LjIxNDYxMSANCkwgNTg1LjkwOTE5MSAtMTAxLjE1MjgxNCANCkwgNTg2LjA2OTAyNSAtMTA3LjU3NzQwMSANCkwgNTg2LjIyODg1OSAtMTE0LjE5ODE4IA0KTCA1ODYuMzg4NjkzIC0xMjEuMDQ1NzI5IA0KTCA1ODYuNTQ4NTI3IC0xMjguMDAwMTQgDQpMIDU4Ni43MDgzNjEgLTEzNC45MjUxMjcgDQpMIDU4Ni44NjgxOTQgLTE0MS43NjA3NTIgDQpMIDU4Ny4wMjgwMjggLTE0OC4yODQwOTkgDQpMIDU4Ny4xODc4NjIgLTE1NC41NjU2NTIgDQpMIDU4Ny4zNDc2OTYgLTE2MC40NTk3NDIgDQpMIDU4Ny41MDc1MyAtMTY1LjgxMjMzOCANCkwgNTg3LjY2NzM2NCAtMTcwLjgyNDQ0NiANCkwgNTg3LjgyNzE5OCAtMTc1LjMyMTA0OSANCkwgNTg3Ljk4NzAzMiAtMTc5LjI3NzMyNiANCkwgNTg4LjE0Njg2NiAtMTgyLjkwNjE1NiANCkwgNTg4LjMwNjY5OSAtMTg2LjA1MDAwOSANCkwgNTg4LjQ2NjUzMyAtMTg4Ljc3MDgwNSANCkwgNTg4LjYyNjM2NyAtMTkxLjIzMjE4NyANCkwgNTg4Ljc4NjIwMSAtMTkzLjMxMjQzMyANCkwgNTg4Ljk0NjAzNSAtMTk1LjEwMjE5MyANCkwgNTg5LjEwNTg2OSAtMTk2LjcwNjkwNSANCkwgNTg5LjI2NTcwMyAtMTk4LjAzODkzOSANCkwgNTg5LjQyNTUzNyAtMTk5LjE4NTQwOSANCkwgNTg5LjU4NTM3IC0yMDAuMjA3NzQ0IA0KTCA1ODkuNzQ1MjA0IC0yMDEuMDQ1MTk3IA0KTCA1ODkuOTA1MDM4IC0yMDEuNzY4Nzc4IA0KTCA1OTAuMDY0ODcyIC0yMDIuNDExNzg0IA0KTCA1OTAuMjI0NzA2IC0yMDIuOTMzMzM4IA0KTCA1OTAuMzg0NTQgLTIwMy4zODY1MzYgDQpMIDU5MC41NDQzNzQgLTIwMy43ODgzMjMgDQpMIDU5MC43MDQyMDggLTIwNC4xMTA4OTggDQpMIDU5MC44NjQwNDIgLTIwNC4zOTMwOSANCkwgNTkxLjAyMzg3NSAtMjA0LjY0MjkzOSANCkwgNTkxLjE4MzcwOSAtMjA0Ljg0MjQ0OSANCkwgNTkxLjM0MzU0MyAtMjA1LjAxODEwMSANCkwgNTkxLjUwMzM3NyAtMjA1LjE3MzMzNSANCkwgNTkxLjY2MzIxMSAtMjA1LjI5NjA1NCANCkwgNTkxLjgyMzA0NSAtMjA1LjQwNDkwNiANCkwgNTkxLjk4Mjg3OSAtMjA1LjUwMTAzNiANCkwgNTkyLjE0MjcxMyAtMjA1LjU3Njg5OSANCkwgNTkyLjMwMjU0NiAtMjA1LjY0NDU0MSANCkwgNTkyLjQ2MjM4IC0yMDUuNzAzODIxIA0KTCA1OTIuNjIyMjE0IC0yMDUuNzUwNTI2IA0KTCA1OTIuNzgyMDQ4IC0yMDUuNzkyMzI0IA0KTCA1OTIuOTQxODgyIC0yMDUuODI4NzcyIA0KTCA1OTMuMTAxNzE2IC0yMDUuODU3OTQ1IA0KTCA1OTMuMjYxNTUgLTIwNS44ODM5OCANCkwgNTkzLjQyMTM4NCAtMjA2LjAzMzg4NCANCkwgNTkzLjU4MTIxOCAtMjA2LjAzMzg4NCANCkwgNTkzLjc0MTA1MSAtMjA2LjAzMzg4NCANCkwgNTkzLjkwMDg4NSAtMjA2LjAzMzg4NCANCkwgNTk0LjA2MDcxOSAtMjA2LjAzMzg4NCANCkwgNTk0LjIyMDU1MyAtMjA2LjAzMzg4NCANCkwgNTk0LjM4MDM4NyAtMjA2LjAzMzg4NCANCkwgNTk0LjU0MDIyMSAtMjA2LjAzMzg4NCANCkwgNTk0LjcwMDA1NSAtMjA2LjAzMzg4NCANCkwgNTk0Ljg1OTg4OSAtMjA2LjAzMzg4NCANCkwgNTk1LjAxOTcyMyAtMjA2LjAzMzg4NCANCkwgNTk1LjE3OTU1NiAtMjA2LjAzMzg4NCANCkwgNTk1LjMzOTM5IC0yMDYuMDMzODg0IA0KTCA1OTUuNDk5MjI0IC0yMDYuMDMzODg0IA0KTCA1OTUuNjU5MDU4IC0yMDYuMDMzODg0IA0KTCA1OTUuODE4ODkyIC0yMDYuMDMzODg0IA0KTCA1OTUuOTc4NzI2IC0yMDYuMDMzODg0IA0KTCA1OTYuMTM4NTYgLTIwNi4wMzM4ODQgDQpMIDU5Ni4yOTgzOTQgLTIwNi4wMzM4ODQgDQpMIDU5Ni40NTgyMjcgLTIwNi4wMzM4ODQgDQpMIDU5Ni42MTgwNjEgLTIwNi4wMzM4ODQgDQpMIDU5Ni43Nzc4OTUgLTIwNi4wMzM4ODQgDQpMIDU5Ni45Mzc3MjkgLTIwNi4wMzM4ODQgDQpMIDU5Ny4wOTc1NjMgLTIwNi4wMzM4ODQgDQpMIDU5Ny4yNTczOTcgLTIwNi4wMzM4ODQgDQpMIDU5Ny40MTcyMzEgLTIwNi4wMzM4ODQgDQpMIDU5Ny41NzcwNjUgLTIwNi4wMzM4ODQgDQpMIDU5Ny43MzY4OTkgLTIwNi4wMzM4ODQgDQpMIDU5Ny44OTY3MzIgLTIwNi4wMzM4ODQgDQpMIDU5OC4wNTY1NjYgLTIwNi4wMzM4ODQgDQpMIDU5OC4yMTY0IC0yMDYuMDMzODg0IA0KTCA1OTguMzc2MjM0IC0yMDYuMDMzODg0IA0KTCA1OTguNTM2MDY4IC0yMDYuMDMzODg0IA0KTCA1OTguNjk1OTAyIC0yMDYuMDMzODg0IA0KTCA1OTguODU1NzM2IC0yMDYuMDMzODg0IA0KTCA1OTkuMDE1NTcgLTIwNi4wMzM4ODQgDQpMIDU5OS4xNzU0MDMgLTIwNi4wMzM4ODQgDQpMIDU5OS4zMzUyMzcgLTIwNi4wMzM4ODQgDQpMIDU5OS40OTUwNzEgLTIwNi4wMzM4ODQgDQpMIDU5OS42NTQ5MDUgLTIwNi4wMzM4ODQgDQpMIDU5OS44MTQ3MzkgLTIwNi4wMzM4ODQgDQpMIDU5OS45NzQ1NzMgLTIwNi4wMzM4ODQgDQpMIDYwMC4xMzQ0MDcgLTIwNi4wMzM4ODQgDQpMIDYwMC4yOTQyNDEgLTIwNi4wMzM4ODQgDQpMIDYwMC40NTQwNzUgLTIwNi4wMzM4ODQgDQpMIDYwMC42MTM5MDggLTIwNi4wMzM4ODQgDQpMIDYwMC43NzM3NDIgLTIwNi4wMzM4ODQgDQpMIDYwMC45MzM1NzYgLTIwNi4wMzM4ODQgDQpMIDYwMS4wOTM0MSAtMjA2LjAzMzg4NCANCkwgNjAxLjI1MzI0NCAtMjA2LjAzMzg4NCANCkwgNjAxLjQxMzA3OCAtMjA2LjAzMzg4NCANCkwgNjAxLjU3MjkxMiAtMjA2LjAzMzg4NCANCkwgNjAxLjczMjc0NiAtMjA2LjAzMzg4NCANCkwgNjAxLjg5MjU4IC0yMDYuMDMzODg0IA0KTCA2MDIuMDUyNDEzIC0yMDYuMDMzODg0IA0KTCA2MDIuMjEyMjQ3IC0yMDYuMDMzODg0IA0KTCA2MDIuMzcyMDgxIC0yMDYuMDMzODg0IA0KTCA2MDIuNTMxOTE1IC0yMDYuMDMzODg0IA0KTCA2MDIuNjkxNzQ5IC0yMDYuMDMzODg0IA0KTCA2MDIuODUxNTgzIC0yMDYuMDMzODg0IA0KTCA2MDMuMDExNDE3IC0yMDYuMDMzODg0IA0KTCA2MDMuMTcxMjUxIC0yMDYuMDMzODg0IA0KTCA2MDMuMzMxMDg0IC0yMDYuMDMzODg0IA0KTCA2MDMuNDkwOTE4IC0yMDYuMDMzODg0IA0KTCA2MDMuNjUwNzUyIC0yMDYuMDMzODg0IA0KTCA2MDMuODEwNTg2IC0yMDYuMDMzODg0IA0KTCA2MDMuOTcwNDIgLTIwNi4wMzM4ODQgDQpMIDYwNC4xMzAyNTQgLTIwNi4wMzM4ODQgDQpMIDYwNC4yOTAwODggLTIwNi4wMzM4ODQgDQpMIDYwNC40NDk5MjIgLTIwNi4wMzM4ODQgDQpMIDYwNC42MDk3NTYgLTIwNi4wMzM4ODQgDQpMIDYwNC43Njk1ODkgLTIwNi4wMzM4ODQgDQpMIDYwNC45Mjk0MjMgLTIwNi4wMzM4ODQgDQpMIDYwNS4wODkyNTcgLTIwNi4wMzM4ODQgDQpMIDYwNS4yNDkwOTEgLTIwNi4wMzM4ODQgDQpMIDYwNS40MDg5MjUgLTIwNi4wMzM4ODQgDQpMIDYwNS41Njg3NTkgLTIwNi4wMzM4ODQgDQpMIDYwNS43Mjg1OTMgLTIwNi4wMzM4ODQgDQpMIDYwNS44ODg0MjcgLTIwNi4wMzM4ODQgDQpMIDYwNi4wNDgyNjEgLTIwNi4wMzM4ODQgDQpMIDYwNi4yMDgwOTQgLTIwNi4wMzM4ODQgDQpMIDYwNi4zNjc5MjggLTIwNi4wMzM4ODQgDQpMIDYwNi41Mjc3NjIgLTIwNi4wMzM4ODQgDQpMIDYwNi42ODc1OTYgLTIwNi4wMzM4ODQgDQpMIDYwNi44NDc0MyAtMjA2LjAzMzg4NCANCkwgNjA3LjAwNzI2NCAtMjA2LjAzMzg4NCANCkwgNjA3LjE2NzA5OCAtMjA2LjAzMzg4NCANCkwgNjA3LjMyNjkzMiAtMjA2LjAzMzg4NCANCkwgNjA3LjQ4Njc2NSAtMjA2LjAzMzg4NCANCkwgNjA3LjY0NjU5OSAtMjA2LjAzMzg4NCANCkwgNjA3LjgwNjQzMyAtMjA2LjAzMzg4NCANCkwgNjA3Ljk2NjI2NyAtMjA2LjAzMzg4NCANCkwgNjA4LjEyNjEwMSAtMjA2LjAzMzg4NCANCkwgNjA4LjI4NTkzNSAtMjA2LjAzMzg4NCANCkwgNjA4LjQ0NTc2OSAtMjA2LjAzMzg4NCANCkwgNjA4LjYwNTYwMyAtMjA2LjAzMzg4NCANCkwgNjA4Ljc2NTQzNyAtMjA2LjAzMzg4NCANCkwgNjA4LjkyNTI3IC0yMDYuMDMzODg0IA0KTCA2MDkuMDg1MTA0IC0yMDYuMDMzODg0IA0KTCA2MDkuMjQ0OTM4IC0yMDYuMDMzODg0IA0KTCA2MDkuNDA0NzcyIC0yMDYuMDMzODg0IA0KTCA2MDkuNTY0NjA2IC0yMDYuMDMzODg0IA0KTCA2MDkuNzI0NDQgLTIwNi4wMzM4ODQgDQpMIDYwOS44ODQyNzQgLTIwNi4wMzM4ODQgDQpMIDYxMC4wNDQxMDggLTIwNi4wMzM4ODQgDQpMIDYxMC4yMDM5NDEgLTIwNi4wMzM4ODQgDQpMIDYxMC4zNjM3NzUgLTIwNi4wMzM4ODQgDQpMIDYxMC41MjM2MDkgLTIwNi4wMzM4ODQgDQpMIDYxMC42ODM0NDMgLTIwNi4wMzM4ODQgDQpMIDYxMC44NDMyNzcgLTIwNi4wMzM4ODQgDQpMIDYxMS4wMDMxMTEgLTIwNi4wMzM4ODQgDQpMIDYxMS4xNjI5NDUgLTIwNi4wMzM4ODQgDQpMIDYxMS4zMjI3NzkgLTIwNi4wMzM4ODQgDQpMIDYxMS40ODI2MTMgLTIwNi4wMzM4ODQgDQpMIDYxMS42NDI0NDYgLTIwNi4wMzM4ODQgDQpMIDYxMS44MDIyOCAtMjA2LjAzMzg4NCANCkwgNjExLjk2MjExNCAtMjA2LjAzMzg4NCANCkwgNjEyLjEyMTk0OCAtMjA2LjAzMzg4NCANCkwgNjEyLjI4MTc4MiAtMjA2LjAzMzg4NCANCkwgNjEyLjQ0MTYxNiAtMjA2LjAzMzg4NCANCkwgNjEyLjYwMTQ1IC0yMDYuMDMzODg0IA0KTCA2MTIuNzYxMjg0IC0yMDYuMDMzODg0IA0KTCA2MTIuOTIxMTE4IC0yMDYuMDMzODg0IA0KTCA2MTMuMDgwOTUxIC0yMDYuMDMzODg0IA0KTCA2MTMuMjQwNzg1IC0yMDYuMDMzODg0IA0KTCA2MTMuNDAwNjE5IC0yMDYuMDMzODg0IA0KTCA2MTMuNTYwNDUzIC0yMDYuMDMzODg0IA0KTCA2MTMuNzIwMjg3IC0yMDUuNTgyNzE0IA0KTCA2MTMuODgwMTIxIC0yMDUuNTE2MzY3IA0KTCA2MTQuMDM5OTU1IC0yMDUuNDMwODc0IA0KTCA2MTQuMTk5Nzg5IC0yMDUuMzMzMDg0IA0KTCA2MTQuMzU5NjIyIC0yMDUuMjIyNDc1IA0KTCA2MTQuNTE5NDU2IC0yMDUuMDgxNzA5IA0KTCA2MTQuNjc5MjkgLTIwNC45MjE3NzIgDQpMIDYxNC44MzkxMjQgLTIwNC43NDAyMDMgDQpMIDYxNC45OTg5NTggLTIwNC41MTA3NzIgDQpMIDYxNS4xNTg3OTIgLTIwNC4yNTEyMiANCkwgNjE1LjMxODYyNiAtMjAzLjk1NTM0MSANCkwgNjE1LjQ3ODQ2IC0yMDMuNTg1NTE1IA0KTCA2MTUuNjM4Mjk0IC0yMDMuMTY3OTI2IA0KTCA2MTUuNzk4MTI3IC0yMDIuNjg4ODI0IA0KTCA2MTUuOTU3OTYxIC0yMDIuMDk2MDE0IA0KTCA2MTYuMTE3Nzk1IC0yMDEuNDI4NzIyIA0KTCA2MTYuMjc3NjI5IC0yMDAuNjU5NDIgDQpMIDYxNi40Mzc0NjMgLTE5OS43MTgyNTkgDQpMIDYxNi41OTcyOTcgLTE5OC42NjMxMzEgDQpMIDYxNi43NTcxMzEgLTE5Ny40NDI3NiANCkwgNjE2LjkxNjk2NSAtMTk1Ljk3MDYyNiANCkwgNjE3LjA3Njc5OCAtMTk0LjMzMDM1OCANCkwgNjE3LjIzNjYzMiAtMTkyLjQzMzc0NyANCkwgNjE3LjM5NjQ2NiAtMTkwLjE4OTQyIA0KTCA2MTcuNTU2MyAtMTg3LjcxMzM5MiANCkwgNjE3LjcxNjEzNCAtMTg0Ljg3MDkgDQpMIDYxNy44NzU5NjggLTE4MS41OTU2OTggDQpMIDYxOC4wMzU4MDIgLTE3OC4wMzU1OTUgDQpMIDYxOC4xOTU2MzYgLTE3NC4wMTg1NSANCkwgNjE4LjM1NTQ3IC0xNjkuNTU0NTM3IA0KTCA2MTguNTE1MzAzIC0xNjQuODAzOTc3IA0KTCA2MTguNjc1MTM3IC0xNTkuNjA5NDM4IA0KTCA2MTguODM0OTcxIC0xNTQuMDg1ODU0IA0KTCA2MTguOTk0ODA1IC0xNDguMzYyNCANCkwgNjE5LjE1NDYzOSAtMTQyLjM3NzAxNSANCkwgNjE5LjMxNDQ3MyAtMTM2LjI5NjE5NCANCkwgNjE5LjQ3NDMwNyAtMTMwLjE3NDg0IA0KTCA2MTkuNjM0MTQxIC0xMjQuMDg2NjUxIA0KTCA2MTkuNzkzOTc1IC0xMTguMTI2MTk5IA0KTCA2MTkuOTUzODA4IC0xMTIuMjc3MzczIA0KTCA2MjAuMTEzNjQyIC0xMDYuNzA2OTQyIA0KTCA2MjAuMjczNDc2IC0xMDEuMzc5ODU1IA0KTCA2MjAuNDMzMzEgLTk2LjI0OTY5NiANCkwgNjIwLjU5MzE0NCAtOTEuNTE2MTc0IA0KTCA2MjAuNzUyOTc4IC04Ny4wNDY5MzQgDQpMIDYyMC45MTI4MTIgLTgyLjc5ODM1OCANCkwgNjIxLjA3MjY0NiAtNzguOTc1MDc3IA0KTCA2MjEuMjMyNDc5IC03NS4zOTY4MDEgDQpMIDYyMS4zOTIzMTMgLTcyLjAzMzY0MyANCkwgNjIxLjU1MjE0NyAtNjkuMDgxNTA4IA0KTCA2MjEuNzExOTgxIC02Ni4zMzcxMzcgDQpMIDYyMS44NzE4MTUgLTYzLjc4NjMwNiANCkwgNjIyLjAzMTY0OSAtNjEuNjAxNDU4IA0KTCA2MjIuMTkxNDgzIC01OS41NzkwNDYgDQpMIDYyMi4zNTEzMTcgLTU3LjcyNTk0NSANCkwgNjIyLjUxMTE1MSAtNTYuMTYwODg5IA0KTCA2MjIuNjcwOTg0IC01NC43MjIxMDMgDQpMIDYyMi44MzA4MTggLTUzLjQyMzA3MyANCkwgNjIyLjk5MDY1MiAtNTIuMzM0OTM5IA0KTCA2MjMuMTUwNDg2IC01MS4zNDE0NDMgDQpMIDYyMy4zMTAzMiAtNTAuNDU3MzAzIA0KTCA2MjMuNDcwMTU0IC00OS43MjMyNjEgDQpMIDYyMy42Mjk5ODggLTQ5LjA1ODc3OCANCkwgNjIzLjc4OTgyMiAtNDguNDc3OTAyIA0KTCA2MjMuOTQ5NjU1IC00OC4wMDIyOTIgDQpMIDYyNC4xMDk0ODkgLTQ3LjU3ODI0MyANCkwgNjI0LjI2OTMyMyAtNDcuMjE4ODQ2IA0KTCA2MjQuNDI5MTU3IC00Ni45MzUxOTMgDQpMIDYyNC41ODg5OTEgLTQ2LjY5MTE5NCANCkwgNjI0Ljc0ODgyNSAtNDYuNDk5MjIgDQpMIDYyNC45MDg2NTkgLTQ2LjM2NTYzMyANCkwgNjI1LjA2ODQ5MyAtNDYuMjY1MTQ3IA0KTCA2MjUuMjI4MzI3IC00Ni4yMTA5MDEgDQpMIDYyNS4zODgxNiAtNDYuMjA4MDcxIA0KTCA2MjUuNTQ3OTk0IC00Ni4yMzY3OTMgDQpMIDYyNS43MDc4MjggLTQ2LjMxMjYwMSANCkwgNjI1Ljg2NzY2MiAtNDYuNDQwNjEgDQpMIDYyNi4wMjc0OTYgLTQ2LjYwMzI4NyANCkwgNjI2LjE4NzMzIC00Ni44MjIwOCANCkwgNjI2LjM0NzE2NCAtNDcuMTAyMzEzIA0KTCA2MjYuNTA2OTk4IC00Ny40MjU5NTUgDQpMIDYyNi42NjY4MzIgLTQ3LjgyNTA1NSANCkwgNjI2LjgyNjY2NSAtNDguMzAzMDMxIA0KTCA2MjYuOTg2NDk5IC00OC44Mzk1NTMgDQpMIDYyNy4xNDYzMzMgLTQ5LjQ4NTAxNyANCkwgNjI3LjMwNjE2NyAtNTAuMjM4MDMgDQpMIDYyNy40NjYwMDEgLTUxLjA3Mzc5IA0KTCA2MjcuNjI1ODM1IC01Mi4wNzIyNDEgDQpMIDYyNy43ODU2NjkgLTUzLjIxOTk5IA0KTCA2MjcuOTQ1NTAzIC01NC40ODY2ODcgDQpMIDYyOC4xMDUzMzYgLTU1Ljk5OTM4IA0KTCA2MjguMjY1MTcgLTU3LjcxODc1MyANCkwgNjI4LjQyNTAwNCAtNTkuNjA4NDA4IA0KTCA2MjguNTg0ODM4IC02MS44NjMyNDYgDQpMIDYyOC43NDQ2NzIgLTY0LjM5NTQ4OCANCkwgNjI4LjkwNDUwNiAtNjcuMTY0MjgxIA0KTCA2MjkuMDY0MzQgLTcwLjQ1MDU5MiANCkwgNjI5LjIyNDE3NCAtNzQuMDgwNjM3IA0KTCA2MjkuMzg0MDA4IC03OC4wMTUzMiANCkwgNjI5LjU0Mzg0MSAtODIuNjAzODExIA0KTCA2MjkuNzAzNjc1IC04Ny41NTMzNiANCkwgNjI5Ljg2MzUwOSAtOTIuODM5MzM5IA0KTCA2MzAuMDIzMzQzIC05OC43Nzc1MjYgDQpMIDYzMC4xODMxNzcgLTEwNC45ODM0MTUgDQpMIDYzMC4zNDMwMTEgLTExMS40NjgzNyANCkwgNjMwLjUwMjg0NSAtMTE4LjMwNjcxMiANCkwgNjMwLjY2MjY3OSAtMTI1LjIxMTM4NSANCkwgNjMwLjgyMjUxMyAtMTMyLjE4MzI4MiANCkwgNjMwLjk4MjM0NiAtMTM5LjAyNjUxNSANCkwgNjMxLjE0MjE4IC0xNDUuNzAwNTE5IA0KTCA2MzEuMzAyMDE0IC0xNTIuMTU5NDM3IA0KTCA2MzEuNDYxODQ4IC0xNTguMTAyMTE1IA0KTCA2MzEuNjIxNjgyIC0xNjMuNzI1ODUgDQpMIDYzMS43ODE1MTYgLTE2OC45NDIwNDcgDQpMIDYzMS45NDEzNSAtMTczLjUyMjQwMSANCkwgNjMyLjEwMTE4NCAtMTc3Ljc1OTk2NiANCkwgNjMyLjI2MTAxNyAtMTgxLjU1MzM5IA0KTCA2MzIuNDIwODUxIC0xODQuNzkyNDcxIA0KTCA2MzIuNTgwNjg1IC0xODcuNzQyNDk3IA0KTCA2MzIuNzQwNTE5IC0xOTAuMzEzMjY2IA0KTCA2MzIuOTAwMzUzIC0xOTIuNDgwMzM0IA0KTCA2MzMuMDYwMTg3IC0xOTQuNDM0MjU2IA0KTCA2MzMuMjIwMDIxIC0xOTYuMTA0MDk3IA0KTCA2MzMuMzc5ODU1IC0xOTcuNTA2MTI1IA0KTCA2MzMuNTM5Njg5IC0xOTguNzYyMTM3IA0KTCA2MzMuNjk5NTIyIC0xOTkuODIwMzE4IA0KTCA2MzMuODU5MzU2IC0yMDAuNzEwMjE2IA0KTCA2MzQuMDE5MTkgLTIwMS41MDQxNzUgDQpMIDYzNC4xNzkwMjQgLTIwMi4xNjU2ODIgDQpMIDYzNC4zMzg4NTggLTIwMi43MjQ3MTcgDQpMIDYzNC40OTg2OTIgLTIwMy4yMjIyMyANCkwgNjM0LjY1ODUyNiAtMjAzLjYzMjk5NSANCkwgNjM0LjgxODM2IC0yMDMuOTgxODY4IA0KTCA2MzQuOTc4MTkzIC0yMDQuMjkxNTk3IA0KTCA2MzUuMTM4MDI3IC0yMDQuNTQ1MzI4IA0KTCA2MzUuMjk3ODYxIC0yMDQuNzYyNjQ1IA0KTCA2MzUuNDU3Njk1IC0yMDQuOTU1NDQ5IA0KTCA2MzUuNjE3NTI5IC0yMDUuMTEyMDggDQpMIDYzNS43NzczNjMgLTIwNS4yNDY5NjcgDQpMIDYzNS45MzcxOTcgLTIwNS4zNjYzNjQgDQpMIDYzNi4wOTcwMzEgLTIwNS40NjI3MTkgDQpMIDYzNi4yNTY4NjUgLTIwNS41NDY1NTQgDQpMIDYzNi40MTY2OTggLTIwNS42MjA4MjggDQpMIDYzNi41NzY1MzIgLTIwNS42ODAxMDkgDQpMIDYzNi43MzYzNjYgLTIwNS43MzE5NDQgDQpMIDYzNi44OTYyIC0yMDUuNzc3NzQ1IA0KTCA2MzcuMDU2MDM0IC0yMDUuODE0MTkzIA0KTCA2MzcuMjE1ODY4IC0yMDUuODQ2NDI3IA0KTCA2MzcuMzc1NzAyIC0yMDUuODc0OTk3IA0KTCA2MzcuNTM1NTM2IC0yMDUuODk3NDUzIA0KTCA2MzcuNjk1MzcgLTIwNi4wMzM4ODQgDQpMIDYzNy44NTUyMDMgLTIwNi4wMzM4ODQgDQpMIDYzOC4wMTUwMzcgLTIwNi4wMzM4ODQgDQpMIDYzOC4xNzQ4NzEgLTIwNi4wMzM4ODQgDQpMIDYzOC4zMzQ3MDUgLTIwNi4wMzM4ODQgDQpMIDYzOC40OTQ1MzkgLTIwNi4wMzM4ODQgDQpMIDYzOC42NTQzNzMgLTIwNi4wMzM4ODQgDQpMIDYzOC44MTQyMDcgLTIwNi4wMzM4ODQgDQpMIDYzOC45NzQwNDEgLTIwNi4wMzM4ODQgDQpMIDYzOS4xMzM4NzQgLTIwNi4wMzM4ODQgDQpMIDYzOS4yOTM3MDggLTIwNi4wMzM4ODQgDQpMIDYzOS40NTM1NDIgLTIwNi4wMzM4ODQgDQpMIDYzOS42MTMzNzYgLTIwNi4wMzM4ODQgDQpMIDYzOS43NzMyMSAtMjA2LjAzMzg4NCANCkwgNjM5LjkzMzA0NCAtMjA2LjAzMzg4NCANCkwgNjQwLjA5Mjg3OCAtMjA2LjAzMzg4NCANCkwgNjQwLjI1MjcxMiAtMjA2LjAzMzg4NCANCkwgNjQwLjQxMjU0NiAtMjA2LjAzMzg4NCANCkwgNjQwLjU3MjM3OSAtMjA2LjAzMzg4NCANCkwgNjQwLjczMjIxMyAtMjA2LjAzMzg4NCANCkwgNjQwLjg5MjA0NyAtMjA2LjAzMzg4NCANCkwgNjQxLjA1MTg4MSAtMjA2LjAzMzg4NCANCkwgNjQxLjIxMTcxNSAtMjA2LjAzMzg4NCANCkwgNjQxLjM3MTU0OSAtMjA2LjAzMzg4NCANCkwgNjQxLjUzMTM4MyAtMjA2LjAzMzg4NCANCkwgNjQxLjY5MTIxNyAtMjA2LjAzMzg4NCANCkwgNjQxLjg1MTA1IC0yMDYuMDMzODg0IA0KTCA2NDIuMDEwODg0IC0yMDYuMDMzODg0IA0KTCA2NDIuMTcwNzE4IC0yMDYuMDMzODg0IA0KTCA2NDIuMzMwNTUyIC0yMDYuMDMzODg0IA0KTCA2NDIuNDkwMzg2IC0yMDYuMDMzODg0IA0KTCA2NDIuNjUwMjIgLTIwNi4wMzM4ODQgDQpMIDY0Mi44MTAwNTQgLTIwNi4wMzM4ODQgDQpMIDY0Mi45Njk4ODggLTIwNi4wMzM4ODQgDQpMIDY0My4xMjk3MjIgLTIwNi4wMzM4ODQgDQpMIDY0My4yODk1NTUgLTIwNi4wMzM4ODQgDQpMIDY0My40NDkzODkgLTIwNi4wMzM4ODQgDQpMIDY0My42MDkyMjMgLTIwNi4wMzM4ODQgDQpMIDY0My43NjkwNTcgLTIwNi4wMzM4ODQgDQpMIDY0My45Mjg4OTEgLTIwNi4wMzM4ODQgDQpMIDY0NC4wODg3MjUgLTIwNi4wMzM4ODQgDQpMIDY0NC4yNDg1NTkgLTIwNi4wMzM4ODQgDQpMIDY0NC40MDgzOTMgLTIwNi4wMzM4ODQgDQpMIDY0NC41NjgyMjcgLTIwNi4wMzM4ODQgDQpMIDY0NC43MjgwNiAtMjA2LjAzMzg4NCANCkwgNjQ0Ljg4Nzg5NCAtMjA2LjAzMzg4NCANCkwgNjQ1LjA0NzcyOCAtMjA2LjAzMzg4NCANCkwgNjQ1LjIwNzU2MiAtMjA2LjAzMzg4NCANCkwgNjQ1LjM2NzM5NiAtMjA2LjAzMzg4NCANCkwgNjQ1LjM2NzM5NiAtMjA2LjAzMzg4NCANCkwgNjQ1LjM2NzM5NiAtMjA2LjAzMzg4NCANCkwgNjQ1LjIwNzU2MiAtMjA2LjAzMzg4NCANCkwgNjQ1LjA0NzcyOCAtMjA2LjAzMzg4NCANCkwgNjQ0Ljg4Nzg5NCAtMjA2LjAzMzg4NCANCkwgNjQ0LjcyODA2IC0yMDYuMDMzODg0IA0KTCA2NDQuNTY4MjI3IC0yMDYuMDMzODg0IA0KTCA2NDQuNDA4MzkzIC0yMDYuMDMzODg0IA0KTCA2NDQuMjQ4NTU5IC0yMDYuMDMzODg0IA0KTCA2NDQuMDg4NzI1IC0yMDYuMDMzODg0IA0KTCA2NDMuOTI4ODkxIC0yMDYuMDMzODg0IA0KTCA2NDMuNzY5MDU3IC0yMDYuMDMzODg0IA0KTCA2NDMuNjA5MjIzIC0yMDYuMDMzODg0IA0KTCA2NDMuNDQ5Mzg5IC0yMDYuMDMzODg0IA0KTCA2NDMuMjg5NTU1IC0yMDYuMDMzODg0IA0KTCA2NDMuMTI5NzIyIC0yMDYuMDMzODg0IA0KTCA2NDIuOTY5ODg4IC0yMDYuMDMzODg0IA0KTCA2NDIuODEwMDU0IC0yMDYuMDMzODg0IA0KTCA2NDIuNjUwMjIgLTIwNi4wMzM4ODQgDQpMIDY0Mi40OTAzODYgLTIwNi4wMzM4ODQgDQpMIDY0Mi4zMzA1NTIgLTIwNi4wMzM4ODQgDQpMIDY0Mi4xNzA3MTggLTIwNi4wMzM4ODQgDQpMIDY0Mi4wMTA4ODQgLTIwNi4wMzM4ODQgDQpMIDY0MS44NTEwNSAtMjA2LjAzMzg4NCANCkwgNjQxLjY5MTIxNyAtMjA2LjAzMzg4NCANCkwgNjQxLjUzMTM4MyAtMjA2LjAzMzg4NCANCkwgNjQxLjM3MTU0OSAtMjA2LjAzMzg4NCANCkwgNjQxLjIxMTcxNSAtMjA2LjAzMzg4NCANCkwgNjQxLjA1MTg4MSAtMjA2LjAzMzg4NCANCkwgNjQwLjg5MjA0NyAtMjA2LjAzMzg4NCANCkwgNjQwLjczMjIxMyAtMjA2LjAzMzg4NCANCkwgNjQwLjU3MjM3OSAtMjA2LjAzMzg4NCANCkwgNjQwLjQxMjU0NiAtMjA2LjAzMzg4NCANCkwgNjQwLjI1MjcxMiAtMjA2LjAzMzg4NCANCkwgNjQwLjA5Mjg3OCAtMjA2LjAzMzg4NCANCkwgNjM5LjkzMzA0NCAtMjA2LjAzMzg4NCANCkwgNjM5Ljc3MzIxIC0yMDYuMDMzODg0IA0KTCA2MzkuNjEzMzc2IC0yMDYuMDMzODg0IA0KTCA2MzkuNDUzNTQyIC0yMDYuMDMzODg0IA0KTCA2MzkuMjkzNzA4IC0yMDYuMDMzODg0IA0KTCA2MzkuMTMzODc0IC0yMDYuMDMzODg0IA0KTCA2MzguOTc0MDQxIC0yMDYuMDMzODg0IA0KTCA2MzguODE0MjA3IC0yMDYuMDMzODg0IA0KTCA2MzguNjU0MzczIC0yMDYuMDMzODg0IA0KTCA2MzguNDk0NTM5IC0yMDYuMDMzODg0IA0KTCA2MzguMzM0NzA1IC0yMDYuMDMzODg0IA0KTCA2MzguMTc0ODcxIC0yMDYuMDMzODg0IA0KTCA2MzguMDE1MDM3IC0yMDYuMDMzODg0IA0KTCA2MzcuODU1MjAzIC0yMDYuMDMzODg0IA0KTCA2MzcuNjk1MzcgLTIwNi4wMzM4ODQgDQpMIDYzNy41MzU1MzYgLTIwNi4wMzM4ODQgDQpMIDYzNy4zNzU3MDIgLTIwNi4wMzM4ODQgDQpMIDYzNy4yMTU4NjggLTIwNi4wMzM4ODQgDQpMIDYzNy4wNTYwMzQgLTIwNi4wMzM4ODQgDQpMIDYzNi44OTYyIC0yMDYuMDMzODg0IA0KTCA2MzYuNzM2MzY2IC0yMDYuMDMzODg0IA0KTCA2MzYuNTc2NTMyIC0yMDYuMDMzODg0IA0KTCA2MzYuNDE2Njk4IC0yMDYuMDMzODg0IA0KTCA2MzYuMjU2ODY1IC0yMDYuMDMzODg0IA0KTCA2MzYuMDk3MDMxIC0yMDYuMDMzODg0IA0KTCA2MzUuOTM3MTk3IC0yMDYuMDMzODg0IA0KTCA2MzUuNzc3MzYzIC0yMDYuMDMzODg0IA0KTCA2MzUuNjE3NTI5IC0yMDYuMDMzODg0IA0KTCA2MzUuNDU3Njk1IC0yMDYuMDMzODg0IA0KTCA2MzUuMjk3ODYxIC0yMDYuMDMzODg0IA0KTCA2MzUuMTM4MDI3IC0yMDYuMDMzODg0IA0KTCA2MzQuOTc4MTkzIC0yMDYuMDMzODg0IA0KTCA2MzQuODE4MzYgLTIwNi4wMzM4ODQgDQpMIDYzNC42NTg1MjYgLTIwNi4wMzM4ODQgDQpMIDYzNC40OTg2OTIgLTIwNi4wMzM4ODQgDQpMIDYzNC4zMzg4NTggLTIwNi4wMzM4ODQgDQpMIDYzNC4xNzkwMjQgLTIwNi4wMzM4ODQgDQpMIDYzNC4wMTkxOSAtMjA2LjAzMzg4NCANCkwgNjMzLjg1OTM1NiAtMjA2LjAzMzg4NCANCkwgNjMzLjY5OTUyMiAtMjA2LjAzMzg4NCANCkwgNjMzLjUzOTY4OSAtMjA2LjAzMzg4NCANCkwgNjMzLjM3OTg1NSAtMjA2LjAzMzg4NCANCkwgNjMzLjIyMDAyMSAtMjA2LjAzMzg4NCANCkwgNjMzLjA2MDE4NyAtMjA2LjAzMzg4NCANCkwgNjMyLjkwMDM1MyAtMjA2LjAzMzg4NCANCkwgNjMyLjc0MDUxOSAtMjA2LjAzMzg4NCANCkwgNjMyLjU4MDY4NSAtMjA2LjAzMzg4NCANCkwgNjMyLjQyMDg1MSAtMjA2LjAzMzg4NCANCkwgNjMyLjI2MTAxNyAtMjA2LjAzMzg4NCANCkwgNjMyLjEwMTE4NCAtMjA2LjAzMzg4NCANCkwgNjMxLjk0MTM1IC0yMDYuMDMzODg0IA0KTCA2MzEuNzgxNTE2IC0yMDYuMDMzODg0IA0KTCA2MzEuNjIxNjgyIC0yMDYuMDMzODg0IA0KTCA2MzEuNDYxODQ4IC0yMDYuMDMzODg0IA0KTCA2MzEuMzAyMDE0IC0yMDYuMDMzODg0IA0KTCA2MzEuMTQyMTggLTIwNi4wMzM4ODQgDQpMIDYzMC45ODIzNDYgLTIwNi4wMzM4ODQgDQpMIDYzMC44MjI1MTMgLTIwNi4wMzM4ODQgDQpMIDYzMC42NjI2NzkgLTIwNi4wMzM4ODQgDQpMIDYzMC41MDI4NDUgLTIwNi4wMzM4ODQgDQpMIDYzMC4zNDMwMTEgLTIwNi4wMzM4ODQgDQpMIDYzMC4xODMxNzcgLTIwNi4wMzM4ODQgDQpMIDYzMC4wMjMzNDMgLTIwNi4wMzM4ODQgDQpMIDYyOS44NjM1MDkgLTIwNi4wMzM4ODQgDQpMIDYyOS43MDM2NzUgLTIwNi4wMzM4ODQgDQpMIDYyOS41NDM4NDEgLTIwNi4wMzM4ODQgDQpMIDYyOS4zODQwMDggLTIwNi4wMzM4ODQgDQpMIDYyOS4yMjQxNzQgLTIwNi4wMzM4ODQgDQpMIDYyOS4wNjQzNCAtMjA2LjAzMzg4NCANCkwgNjI4LjkwNDUwNiAtMjA2LjAzMzg4NCANCkwgNjI4Ljc0NDY3MiAtMjA2LjAzMzg4NCANCkwgNjI4LjU4NDgzOCAtMjA2LjAzMzg4NCANCkwgNjI4LjQyNTAwNCAtMjA2LjAzMzg4NCANCkwgNjI4LjI2NTE3IC0yMDYuMDMzODg0IA0KTCA2MjguMTA1MzM2IC0yMDYuMDMzODg0IA0KTCA2MjcuOTQ1NTAzIC0yMDYuMDMzODg0IA0KTCA2MjcuNzg1NjY5IC0yMDYuMDMzODg0IA0KTCA2MjcuNjI1ODM1IC0yMDYuMDMzODg0IA0KTCA2MjcuNDY2MDAxIC0yMDYuMDMzODg0IA0KTCA2MjcuMzA2MTY3IC0yMDYuMDMzODg0IA0KTCA2MjcuMTQ2MzMzIC0yMDYuMDMzODg0IA0KTCA2MjYuOTg2NDk5IC0yMDYuMDMzODg0IA0KTCA2MjYuODI2NjY1IC0yMDYuMDMzODg0IA0KTCA2MjYuNjY2ODMyIC0yMDYuMDMzODg0IA0KTCA2MjYuNTA2OTk4IC0yMDYuMDMzODg0IA0KTCA2MjYuMzQ3MTY0IC0yMDYuMDMzODg0IA0KTCA2MjYuMTg3MzMgLTIwNi4wMzM4ODQgDQpMIDYyNi4wMjc0OTYgLTIwNi4wMzM4ODQgDQpMIDYyNS44Njc2NjIgLTIwNi4wMzM4ODQgDQpMIDYyNS43MDc4MjggLTIwNi4wMzM4ODQgDQpMIDYyNS41NDc5OTQgLTIwNi4wMzM4ODQgDQpMIDYyNS4zODgxNiAtMjA2LjAzMzg4NCANCkwgNjI1LjIyODMyNyAtMjA2LjAzMzg4NCANCkwgNjI1LjA2ODQ5MyAtMjA2LjAzMzg4NCANCkwgNjI0LjkwODY1OSAtMjA2LjAzMzg4NCANCkwgNjI0Ljc0ODgyNSAtMjA2LjAzMzg4NCANCkwgNjI0LjU4ODk5MSAtMjA2LjAzMzg4NCANCkwgNjI0LjQyOTE1NyAtMjA2LjAzMzg4NCANCkwgNjI0LjI2OTMyMyAtMjA2LjAzMzg4NCANCkwgNjI0LjEwOTQ4OSAtMjA2LjAzMzg4NCANCkwgNjIzLjk0OTY1NSAtMjA2LjAzMzg4NCANCkwgNjIzLjc4OTgyMiAtMjA2LjAzMzg4NCANCkwgNjIzLjYyOTk4OCAtMjA2LjAzMzg4NCANCkwgNjIzLjQ3MDE1NCAtMjA2LjAzMzg4NCANCkwgNjIzLjMxMDMyIC0yMDYuMDMzODg0IA0KTCA2MjMuMTUwNDg2IC0yMDYuMDMzODg0IA0KTCA2MjIuOTkwNjUyIC0yMDYuMDMzODg0IA0KTCA2MjIuODMwODE4IC0yMDYuMDMzODg0IA0KTCA2MjIuNjcwOTg0IC0yMDYuMDMzODg0IA0KTCA2MjIuNTExMTUxIC0yMDYuMDMzODg0IA0KTCA2MjIuMzUxMzE3IC0yMDYuMDMzODg0IA0KTCA2MjIuMTkxNDgzIC0yMDYuMDMzODg0IA0KTCA2MjIuMDMxNjQ5IC0yMDYuMDMzODg0IA0KTCA2MjEuODcxODE1IC0yMDYuMDMzODg0IA0KTCA2MjEuNzExOTgxIC0yMDYuMDMzODg0IA0KTCA2MjEuNTUyMTQ3IC0yMDYuMDMzODg0IA0KTCA2MjEuMzkyMzEzIC0yMDYuMDMzODg0IA0KTCA2MjEuMjMyNDc5IC0yMDYuMDMzODg0IA0KTCA2MjEuMDcyNjQ2IC0yMDYuMDMzODg0IA0KTCA2MjAuOTEyODEyIC0yMDYuMDMzODg0IA0KTCA2MjAuNzUyOTc4IC0yMDYuMDMzODg0IA0KTCA2MjAuNTkzMTQ0IC0yMDYuMDMzODg0IA0KTCA2MjAuNDMzMzEgLTIwNi4wMzM4ODQgDQpMIDYyMC4yNzM0NzYgLTIwNi4wMzM4ODQgDQpMIDYyMC4xMTM2NDIgLTIwNi4wMzM4ODQgDQpMIDYxOS45NTM4MDggLTIwNi4wMzM4ODQgDQpMIDYxOS43OTM5NzUgLTIwNi4wMzM4ODQgDQpMIDYxOS42MzQxNDEgLTIwNi4wMzM4ODQgDQpMIDYxOS40NzQzMDcgLTIwNi4wMzM4ODQgDQpMIDYxOS4zMTQ0NzMgLTIwNi4wMzM4ODQgDQpMIDYxOS4xNTQ2MzkgLTIwNi4wMzM4ODQgDQpMIDYxOC45OTQ4MDUgLTIwNi4wMzM4ODQgDQpMIDYxOC44MzQ5NzEgLTIwNi4wMzM4ODQgDQpMIDYxOC42NzUxMzcgLTIwNi4wMzM4ODQgDQpMIDYxOC41MTUzMDMgLTIwNi4wMzM4ODQgDQpMIDYxOC4zNTU0NyAtMjA2LjAzMzg4NCANCkwgNjE4LjE5NTYzNiAtMjA2LjAzMzg4NCANCkwgNjE4LjAzNTgwMiAtMjA2LjAzMzg4NCANCkwgNjE3Ljg3NTk2OCAtMjA2LjAzMzg4NCANCkwgNjE3LjcxNjEzNCAtMjA2LjAzMzg4NCANCkwgNjE3LjU1NjMgLTIwNi4wMzM4ODQgDQpMIDYxNy4zOTY0NjYgLTIwNi4wMzM4ODQgDQpMIDYxNy4yMzY2MzIgLTIwNi4wMzM4ODQgDQpMIDYxNy4wNzY3OTggLTIwNi4wMzM4ODQgDQpMIDYxNi45MTY5NjUgLTIwNi4wMzM4ODQgDQpMIDYxNi43NTcxMzEgLTIwNi4wMzM4ODQgDQpMIDYxNi41OTcyOTcgLTIwNi4wMzM4ODQgDQpMIDYxNi40Mzc0NjMgLTIwNi4wMzM4ODQgDQpMIDYxNi4yNzc2MjkgLTIwNi4wMzM4ODQgDQpMIDYxNi4xMTc3OTUgLTIwNi4wMzM4ODQgDQpMIDYxNS45NTc5NjEgLTIwNi4wMzM4ODQgDQpMIDYxNS43OTgxMjcgLTIwNi4wMzM4ODQgDQpMIDYxNS42MzgyOTQgLTIwNi4wMzM4ODQgDQpMIDYxNS40Nzg0NiAtMjA2LjAzMzg4NCANCkwgNjE1LjMxODYyNiAtMjA2LjAzMzg4NCANCkwgNjE1LjE1ODc5MiAtMjA2LjAzMzg4NCANCkwgNjE0Ljk5ODk1OCAtMjA2LjAzMzg4NCANCkwgNjE0LjgzOTEyNCAtMjA2LjAzMzg4NCANCkwgNjE0LjY3OTI5IC0yMDYuMDMzODg0IA0KTCA2MTQuNTE5NDU2IC0yMDYuMDMzODg0IA0KTCA2MTQuMzU5NjIyIC0yMDYuMDMzODg0IA0KTCA2MTQuMTk5Nzg5IC0yMDYuMDMzODg0IA0KTCA2MTQuMDM5OTU1IC0yMDYuMDMzODg0IA0KTCA2MTMuODgwMTIxIC0yMDYuMDMzODg0IA0KTCA2MTMuNzIwMjg3IC0yMDYuMDMzODg0IA0KTCA2MTMuNTYwNDUzIC0yMDYuMDMzODg0IA0KTCA2MTMuNDAwNjE5IC0yMDYuMDMzODg0IA0KTCA2MTMuMjQwNzg1IC0yMDYuMDMzODg0IA0KTCA2MTMuMDgwOTUxIC0yMDYuMDMzODg0IA0KTCA2MTIuOTIxMTE4IC0yMDYuMDMzODg0IA0KTCA2MTIuNzYxMjg0IC0yMDYuMDMzODg0IA0KTCA2MTIuNjAxNDUgLTIwNi4wMzM4ODQgDQpMIDYxMi40NDE2MTYgLTIwNi4wMzM4ODQgDQpMIDYxMi4yODE3ODIgLTIwNi4wMzM4ODQgDQpMIDYxMi4xMjE5NDggLTIwNi4wMzM4ODQgDQpMIDYxMS45NjIxMTQgLTIwNi4wMzM4ODQgDQpMIDYxMS44MDIyOCAtMjA2LjAzMzg4NCANCkwgNjExLjY0MjQ0NiAtMjA2LjAzMzg4NCANCkwgNjExLjQ4MjYxMyAtMjA2LjAzMzg4NCANCkwgNjExLjMyMjc3OSAtMjA2LjAzMzg4NCANCkwgNjExLjE2Mjk0NSAtMjA2LjAzMzg4NCANCkwgNjExLjAwMzExMSAtMjA2LjAzMzg4NCANCkwgNjEwLjg0MzI3NyAtMjA2LjAzMzg4NCANCkwgNjEwLjY4MzQ0MyAtMjA2LjAzMzg4NCANCkwgNjEwLjUyMzYwOSAtMjA2LjAzMzg4NCANCkwgNjEwLjM2Mzc3NSAtMjA2LjAzMzg4NCANCkwgNjEwLjIwMzk0MSAtMjA2LjAzMzg4NCANCkwgNjEwLjA0NDEwOCAtMjA2LjAzMzg4NCANCkwgNjA5Ljg4NDI3NCAtMjA2LjAzMzg4NCANCkwgNjA5LjcyNDQ0IC0yMDYuMDMzODg0IA0KTCA2MDkuNTY0NjA2IC0yMDYuMDMzODg0IA0KTCA2MDkuNDA0NzcyIC0yMDYuMDMzODg0IA0KTCA2MDkuMjQ0OTM4IC0yMDYuMDMzODg0IA0KTCA2MDkuMDg1MTA0IC0yMDYuMDMzODg0IA0KTCA2MDguOTI1MjcgLTIwNi4wMzM4ODQgDQpMIDYwOC43NjU0MzcgLTIwNi4wMzM4ODQgDQpMIDYwOC42MDU2MDMgLTIwNi4wMzM4ODQgDQpMIDYwOC40NDU3NjkgLTIwNi4wMzM4ODQgDQpMIDYwOC4yODU5MzUgLTIwNi4wMzM4ODQgDQpMIDYwOC4xMjYxMDEgLTIwNi4wMzM4ODQgDQpMIDYwNy45NjYyNjcgLTIwNi4wMzM4ODQgDQpMIDYwNy44MDY0MzMgLTIwNi4wMzM4ODQgDQpMIDYwNy42NDY1OTkgLTIwNi4wMzM4ODQgDQpMIDYwNy40ODY3NjUgLTIwNi4wMzM4ODQgDQpMIDYwNy4zMjY5MzIgLTIwNi4wMzM4ODQgDQpMIDYwNy4xNjcwOTggLTIwNi4wMzM4ODQgDQpMIDYwNy4wMDcyNjQgLTIwNi4wMzM4ODQgDQpMIDYwNi44NDc0MyAtMjA2LjAzMzg4NCANCkwgNjA2LjY4NzU5NiAtMjA2LjAzMzg4NCANCkwgNjA2LjUyNzc2MiAtMjA2LjAzMzg4NCANCkwgNjA2LjM2NzkyOCAtMjA2LjAzMzg4NCANCkwgNjA2LjIwODA5NCAtMjA2LjAzMzg4NCANCkwgNjA2LjA0ODI2MSAtMjA2LjAzMzg4NCANCkwgNjA1Ljg4ODQyNyAtMjA2LjAzMzg4NCANCkwgNjA1LjcyODU5MyAtMjA2LjAzMzg4NCANCkwgNjA1LjU2ODc1OSAtMjA2LjAzMzg4NCANCkwgNjA1LjQwODkyNSAtMjA2LjAzMzg4NCANCkwgNjA1LjI0OTA5MSAtMjA2LjAzMzg4NCANCkwgNjA1LjA4OTI1NyAtMjA2LjAzMzg4NCANCkwgNjA0LjkyOTQyMyAtMjA2LjAzMzg4NCANCkwgNjA0Ljc2OTU4OSAtMjA2LjAzMzg4NCANCkwgNjA0LjYwOTc1NiAtMjA2LjAzMzg4NCANCkwgNjA0LjQ0OTkyMiAtMjA2LjAzMzg4NCANCkwgNjA0LjI5MDA4OCAtMjA2LjAzMzg4NCANCkwgNjA0LjEzMDI1NCAtMjA2LjAzMzg4NCANCkwgNjAzLjk3MDQyIC0yMDYuMDMzODg0IA0KTCA2MDMuODEwNTg2IC0yMDYuMDMzODg0IA0KTCA2MDMuNjUwNzUyIC0yMDYuMDMzODg0IA0KTCA2MDMuNDkwOTE4IC0yMDYuMDMzODg0IA0KTCA2MDMuMzMxMDg0IC0yMDYuMDMzODg0IA0KTCA2MDMuMTcxMjUxIC0yMDYuMDMzODg0IA0KTCA2MDMuMDExNDE3IC0yMDYuMDMzODg0IA0KTCA2MDIuODUxNTgzIC0yMDYuMDMzODg0IA0KTCA2MDIuNjkxNzQ5IC0yMDYuMDMzODg0IA0KTCA2MDIuNTMxOTE1IC0yMDYuMDMzODg0IA0KTCA2MDIuMzcyMDgxIC0yMDYuMDMzODg0IA0KTCA2MDIuMjEyMjQ3IC0yMDYuMDMzODg0IA0KTCA2MDIuMDUyNDEzIC0yMDYuMDMzODg0IA0KTCA2MDEuODkyNTggLTIwNi4wMzM4ODQgDQpMIDYwMS43MzI3NDYgLTIwNi4wMzM4ODQgDQpMIDYwMS41NzI5MTIgLTIwNi4wMzM4ODQgDQpMIDYwMS40MTMwNzggLTIwNi4wMzM4ODQgDQpMIDYwMS4yNTMyNDQgLTIwNi4wMzM4ODQgDQpMIDYwMS4wOTM0MSAtMjA2LjAzMzg4NCANCkwgNjAwLjkzMzU3NiAtMjA2LjAzMzg4NCANCkwgNjAwLjc3Mzc0MiAtMjA2LjAzMzg4NCANCkwgNjAwLjYxMzkwOCAtMjA2LjAzMzg4NCANCkwgNjAwLjQ1NDA3NSAtMjA2LjAzMzg4NCANCkwgNjAwLjI5NDI0MSAtMjA2LjAzMzg4NCANCkwgNjAwLjEzNDQwNyAtMjA2LjAzMzg4NCANCkwgNTk5Ljk3NDU3MyAtMjA2LjAzMzg4NCANCkwgNTk5LjgxNDczOSAtMjA2LjAzMzg4NCANCkwgNTk5LjY1NDkwNSAtMjA2LjAzMzg4NCANCkwgNTk5LjQ5NTA3MSAtMjA2LjAzMzg4NCANCkwgNTk5LjMzNTIzNyAtMjA2LjAzMzg4NCANCkwgNTk5LjE3NTQwMyAtMjA2LjAzMzg4NCANCkwgNTk5LjAxNTU3IC0yMDYuMDMzODg0IA0KTCA1OTguODU1NzM2IC0yMDYuMDMzODg0IA0KTCA1OTguNjk1OTAyIC0yMDYuMDMzODg0IA0KTCA1OTguNTM2MDY4IC0yMDYuMDMzODg0IA0KTCA1OTguMzc2MjM0IC0yMDYuMDMzODg0IA0KTCA1OTguMjE2NCAtMjA2LjAzMzg4NCANCkwgNTk4LjA1NjU2NiAtMjA2LjAzMzg4NCANCkwgNTk3Ljg5NjczMiAtMjA2LjAzMzg4NCANCkwgNTk3LjczNjg5OSAtMjA2LjAzMzg4NCANCkwgNTk3LjU3NzA2NSAtMjA2LjAzMzg4NCANCkwgNTk3LjQxNzIzMSAtMjA2LjAzMzg4NCANCkwgNTk3LjI1NzM5NyAtMjA2LjAzMzg4NCANCkwgNTk3LjA5NzU2MyAtMjA2LjAzMzg4NCANCkwgNTk2LjkzNzcyOSAtMjA2LjAzMzg4NCANCkwgNTk2Ljc3Nzg5NSAtMjA2LjAzMzg4NCANCkwgNTk2LjYxODA2MSAtMjA2LjAzMzg4NCANCkwgNTk2LjQ1ODIyNyAtMjA2LjAzMzg4NCANCkwgNTk2LjI5ODM5NCAtMjA2LjAzMzg4NCANCkwgNTk2LjEzODU2IC0yMDYuMDMzODg0IA0KTCA1OTUuOTc4NzI2IC0yMDYuMDMzODg0IA0KTCA1OTUuODE4ODkyIC0yMDYuMDMzODg0IA0KTCA1OTUuNjU5MDU4IC0yMDYuMDMzODg0IA0KTCA1OTUuNDk5MjI0IC0yMDYuMDMzODg0IA0KTCA1OTUuMzM5MzkgLTIwNi4wMzM4ODQgDQpMIDU5NS4xNzk1NTYgLTIwNi4wMzM4ODQgDQpMIDU5NS4wMTk3MjMgLTIwNi4wMzM4ODQgDQpMIDU5NC44NTk4ODkgLTIwNi4wMzM4ODQgDQpMIDU5NC43MDAwNTUgLTIwNi4wMzM4ODQgDQpMIDU5NC41NDAyMjEgLTIwNi4wMzM4ODQgDQpMIDU5NC4zODAzODcgLTIwNi4wMzM4ODQgDQpMIDU5NC4yMjA1NTMgLTIwNi4wMzM4ODQgDQpMIDU5NC4wNjA3MTkgLTIwNi4wMzM4ODQgDQpMIDU5My45MDA4ODUgLTIwNi4wMzM4ODQgDQpMIDU5My43NDEwNTEgLTIwNi4wMzM4ODQgDQpMIDU5My41ODEyMTggLTIwNi4wMzM4ODQgDQpMIDU5My40MjEzODQgLTIwNi4wMzM4ODQgDQpMIDU5My4yNjE1NSAtMjA2LjAzMzg4NCANCkwgNTkzLjEwMTcxNiAtMjA2LjAzMzg4NCANCkwgNTkyLjk0MTg4MiAtMjA2LjAzMzg4NCANCkwgNTkyLjc4MjA0OCAtMjA2LjAzMzg4NCANCkwgNTkyLjYyMjIxNCAtMjA2LjAzMzg4NCANCkwgNTkyLjQ2MjM4IC0yMDYuMDMzODg0IA0KTCA1OTIuMzAyNTQ2IC0yMDYuMDMzODg0IA0KTCA1OTIuMTQyNzEzIC0yMDYuMDMzODg0IA0KTCA1OTEuOTgyODc5IC0yMDYuMDMzODg0IA0KTCA1OTEuODIzMDQ1IC0yMDYuMDMzODg0IA0KTCA1OTEuNjYzMjExIC0yMDYuMDMzODg0IA0KTCA1OTEuNTAzMzc3IC0yMDYuMDMzODg0IA0KTCA1OTEuMzQzNTQzIC0yMDYuMDMzODg0IA0KTCA1OTEuMTgzNzA5IC0yMDYuMDMzODg0IA0KTCA1OTEuMDIzODc1IC0yMDYuMDMzODg0IA0KTCA1OTAuODY0MDQyIC0yMDYuMDMzODg0IA0KTCA1OTAuNzA0MjA4IC0yMDYuMDMzODg0IA0KTCA1OTAuNTQ0Mzc0IC0yMDYuMDMzODg0IA0KTCA1OTAuMzg0NTQgLTIwNi4wMzM4ODQgDQpMIDU5MC4yMjQ3MDYgLTIwNi4wMzM4ODQgDQpMIDU5MC4wNjQ4NzIgLTIwNi4wMzM4ODQgDQpMIDU4OS45MDUwMzggLTIwNi4wMzM4ODQgDQpMIDU4OS43NDUyMDQgLTIwNi4wMzM4ODQgDQpMIDU4OS41ODUzNyAtMjA2LjAzMzg4NCANCkwgNTg5LjQyNTUzNyAtMjA2LjAzMzg4NCANCkwgNTg5LjI2NTcwMyAtMjA2LjAzMzg4NCANCkwgNTg5LjEwNTg2OSAtMjA2LjAzMzg4NCANCkwgNTg4Ljk0NjAzNSAtMjA2LjAzMzg4NCANCkwgNTg4Ljc4NjIwMSAtMjA2LjAzMzg4NCANCkwgNTg4LjYyNjM2NyAtMjA2LjAzMzg4NCANCkwgNTg4LjQ2NjUzMyAtMjA2LjAzMzg4NCANCkwgNTg4LjMwNjY5OSAtMjA2LjAzMzg4NCANCkwgNTg4LjE0Njg2NiAtMjA2LjAzMzg4NCANCkwgNTg3Ljk4NzAzMiAtMjA2LjAzMzg4NCANCkwgNTg3LjgyNzE5OCAtMjA2LjAzMzg4NCANCkwgNTg3LjY2NzM2NCAtMjA2LjAzMzg4NCANCkwgNTg3LjUwNzUzIC0yMDYuMDMzODg0IA0KTCA1ODcuMzQ3Njk2IC0yMDYuMDMzODg0IA0KTCA1ODcuMTg3ODYyIC0yMDYuMDMzODg0IA0KTCA1ODcuMDI4MDI4IC0yMDYuMDMzODg0IA0KTCA1ODYuODY4MTk0IC0yMDYuMDMzODg0IA0KTCA1ODYuNzA4MzYxIC0yMDYuMDMzODg0IA0KTCA1ODYuNTQ4NTI3IC0yMDYuMDMzODg0IA0KTCA1ODYuMzg4NjkzIC0yMDYuMDMzODg0IA0KTCA1ODYuMjI4ODU5IC0yMDYuMDMzODg0IA0KTCA1ODYuMDY5MDI1IC0yMDYuMDMzODg0IA0KTCA1ODUuOTA5MTkxIC0yMDYuMDMzODg0IA0KTCA1ODUuNzQ5MzU3IC0yMDYuMDMzODg0IA0KTCA1ODUuNTg5NTIzIC0yMDYuMDMzODg0IA0KTCA1ODUuNDI5Njg5IC0yMDYuMDMzODg0IA0KTCA1ODUuMjY5ODU2IC0yMDYuMDMzODg0IA0KTCA1ODUuMTEwMDIyIC0yMDYuMDMzODg0IA0KTCA1ODQuOTUwMTg4IC0yMDYuMDMzODg0IA0KTCA1ODQuNzkwMzU0IC0yMDYuMDMzODg0IA0KTCA1ODQuNjMwNTIgLTIwNi4wMzM4ODQgDQpMIDU4NC40NzA2ODYgLTIwNi4wMzM4ODQgDQpMIDU4NC4zMTA4NTIgLTIwNi4wMzM4ODQgDQpMIDU4NC4xNTEwMTggLTIwNi4wMzM4ODQgDQpMIDU4My45OTExODUgLTIwNi4wMzM4ODQgDQpMIDU4My44MzEzNTEgLTIwNi4wMzM4ODQgDQpMIDU4My42NzE1MTcgLTIwNi4wMzM4ODQgDQpMIDU4My41MTE2ODMgLTIwNi4wMzM4ODQgDQpMIDU4My4zNTE4NDkgLTIwNi4wMzM4ODQgDQpMIDU4My4xOTIwMTUgLTIwNi4wMzM4ODQgDQpMIDU4My4wMzIxODEgLTIwNi4wMzM4ODQgDQpMIDU4Mi44NzIzNDcgLTIwNi4wMzM4ODQgDQpMIDU4Mi43MTI1MTMgLTIwNi4wMzM4ODQgDQpMIDU4Mi41NTI2OCAtMjA2LjAzMzg4NCANCkwgNTgyLjM5Mjg0NiAtMjA2LjAzMzg4NCANCkwgNTgyLjIzMzAxMiAtMjA2LjAzMzg4NCANCkwgNTgyLjA3MzE3OCAtMjA2LjAzMzg4NCANCkwgNTgxLjkxMzM0NCAtMjA2LjAzMzg4NCANCkwgNTgxLjc1MzUxIC0yMDYuMDMzODg0IA0KTCA1ODEuNTkzNjc2IC0yMDYuMDMzODg0IA0KTCA1ODEuNDMzODQyIC0yMDYuMDMzODg0IA0KTCA1ODEuMjc0MDA4IC0yMDYuMDMzODg0IA0KTCA1ODEuMTE0MTc1IC0yMDYuMDMzODg0IA0KTCA1ODAuOTU0MzQxIC0yMDYuMDMzODg0IA0KTCA1ODAuNzk0NTA3IC0yMDYuMDMzODg0IA0KTCA1ODAuNjM0NjczIC0yMDYuMDMzODg0IA0KTCA1ODAuNDc0ODM5IC0yMDYuMDMzODg0IA0KTCA1ODAuMzE1MDA1IC0yMDYuMDMzODg0IA0KTCA1ODAuMTU1MTcxIC0yMDYuMDMzODg0IA0KTCA1NzkuOTk1MzM3IC0yMDYuMDMzODg0IA0KTCA1NzkuODM1NTA0IC0yMDYuMDMzODg0IA0KTCA1NzkuNjc1NjcgLTIwNi4wMzM4ODQgDQpMIDU3OS41MTU4MzYgLTIwNi4wMzM4ODQgDQpMIDU3OS4zNTYwMDIgLTIwNi4wMzM4ODQgDQpMIDU3OS4xOTYxNjggLTIwNi4wMzM4ODQgDQpMIDU3OS4wMzYzMzQgLTIwNi4wMzM4ODQgDQpMIDU3OC44NzY1IC0yMDYuMDMzODg0IA0KTCA1NzguNzE2NjY2IC0yMDYuMDMzODg0IA0KTCA1NzguNTU2ODMyIC0yMDYuMDMzODg0IA0KTCA1NzguMzk2OTk5IC0yMDYuMDMzODg0IA0KTCA1NzguMjM3MTY1IC0yMDYuMDMzODg0IA0KTCA1NzguMDc3MzMxIC0yMDYuMDMzODg0IA0KTCA1NzcuOTE3NDk3IC0yMDYuMDMzODg0IA0KTCA1NzcuNzU3NjYzIC0yMDYuMDMzODg0IA0KTCA1NzcuNTk3ODI5IC0yMDYuMDMzODg0IA0KTCA1NzcuNDM3OTk1IC0yMDYuMDMzODg0IA0KTCA1NzcuMjc4MTYxIC0yMDYuMDMzODg0IA0KTCA1NzcuMTE4MzI4IC0yMDYuMDMzODg0IA0KTCA1NzYuOTU4NDk0IC0yMDYuMDMzODg0IA0KTCA1NzYuNzk4NjYgLTIwNi4wMzM4ODQgDQpMIDU3Ni42Mzg4MjYgLTIwNi4wMzM4ODQgDQpMIDU3Ni40Nzg5OTIgLTIwNi4wMzM4ODQgDQpMIDU3Ni4zMTkxNTggLTIwNi4wMzM4ODQgDQpMIDU3Ni4xNTkzMjQgLTIwNi4wMzM4ODQgDQpMIDU3NS45OTk0OSAtMjA2LjAzMzg4NCANCkwgNTc1LjgzOTY1NiAtMjA2LjAzMzg4NCANCkwgNTc1LjY3OTgyMyAtMjA2LjAzMzg4NCANCkwgNTc1LjUxOTk4OSAtMjA2LjAzMzg4NCANCkwgNTc1LjM2MDE1NSAtMjA2LjAzMzg4NCANCkwgNTc1LjIwMDMyMSAtMjA2LjAzMzg4NCANCkwgNTc1LjA0MDQ4NyAtMjA2LjAzMzg4NCANCkwgNTc0Ljg4MDY1MyAtMjA2LjAzMzg4NCANCkwgNTc0LjcyMDgxOSAtMjA2LjAzMzg4NCANCkwgNTc0LjU2MDk4NSAtMjA2LjAzMzg4NCANCkwgNTc0LjQwMTE1MSAtMjA2LjAzMzg4NCANCkwgNTc0LjI0MTMxOCAtMjA2LjAzMzg4NCANCkwgNTc0LjA4MTQ4NCAtMjA2LjAzMzg4NCANCkwgNTczLjkyMTY1IC0yMDYuMDMzODg0IA0KTCA1NzMuNzYxODE2IC0yMDYuMDMzODg0IA0KTCA1NzMuNjAxOTgyIC0yMDYuMDMzODg0IA0KTCA1NzMuNDQyMTQ4IC0yMDYuMDMzODg0IA0KTCA1NzMuMjgyMzE0IC0yMDYuMDMzODg0IA0KTCA1NzMuMTIyNDggLTIwNi4wMzM4ODQgDQpMIDU3Mi45NjI2NDcgLTIwNi4wMzM4ODQgDQpMIDU3Mi44MDI4MTMgLTIwNi4wMzM4ODQgDQpMIDU3Mi42NDI5NzkgLTIwNi4wMzM4ODQgDQpMIDU3Mi40ODMxNDUgLTIwNi4wMzM4ODQgDQpMIDU3Mi4zMjMzMTEgLTIwNi4wMzM4ODQgDQpMIDU3Mi4xNjM0NzcgLTIwNi4wMzM4ODQgDQpMIDU3Mi4wMDM2NDMgLTIwNi4wMzM4ODQgDQpMIDU3MS44NDM4MDkgLTIwNi4wMzM4ODQgDQpMIDU3MS42ODM5NzUgLTIwNi4wMzM4ODQgDQpMIDU3MS41MjQxNDIgLTIwNi4wMzM4ODQgDQpMIDU3MS4zNjQzMDggLTIwNi4wMzM4ODQgDQpMIDU3MS4yMDQ0NzQgLTIwNi4wMzM4ODQgDQpMIDU3MS4wNDQ2NCAtMjA2LjAzMzg4NCANCkwgNTcwLjg4NDgwNiAtMjA2LjAzMzg4NCANCkwgNTcwLjcyNDk3MiAtMjA2LjAzMzg4NCANCkwgNTcwLjU2NTEzOCAtMjA2LjAzMzg4NCANCkwgNTcwLjQwNTMwNCAtMjA2LjAzMzg4NCANCkwgNTcwLjI0NTQ3MSAtMjA2LjAzMzg4NCANCkwgNTcwLjA4NTYzNyAtMjA2LjAzMzg4NCANCkwgNTY5LjkyNTgwMyAtMjA2LjAzMzg4NCANCkwgNTY5Ljc2NTk2OSAtMjA2LjAzMzg4NCANCkwgNTY5LjYwNjEzNSAtMjA2LjAzMzg4NCANCkwgNTY5LjQ0NjMwMSAtMjA2LjAzMzg4NCANCkwgNTY5LjI4NjQ2NyAtMjA2LjAzMzg4NCANCkwgNTY5LjEyNjYzMyAtMjA2LjAzMzg4NCANCkwgNTY4Ljk2Njc5OSAtMjA2LjAzMzg4NCANCkwgNTY4LjgwNjk2NiAtMjA2LjAzMzg4NCANCkwgNTY4LjY0NzEzMiAtMjA2LjAzMzg4NCANCkwgNTY4LjQ4NzI5OCAtMjA2LjAzMzg4NCANCkwgNTY4LjMyNzQ2NCAtMjA2LjAzMzg4NCANCkwgNTY4LjE2NzYzIC0yMDYuMDMzODg0IA0KTCA1NjguMDA3Nzk2IC0yMDYuMDMzODg0IA0KTCA1NjcuODQ3OTYyIC0yMDYuMDMzODg0IA0KTCA1NjcuNjg4MTI4IC0yMDYuMDMzODg0IA0KTCA1NjcuNTI4Mjk0IC0yMDYuMDMzODg0IA0KTCA1NjcuMzY4NDYxIC0yMDYuMDMzODg0IA0KTCA1NjcuMjA4NjI3IC0yMDYuMDMzODg0IA0KTCA1NjcuMDQ4NzkzIC0yMDYuMDMzODg0IA0KTCA1NjYuODg4OTU5IC0yMDYuMDMzODg0IA0KTCA1NjYuNzI5MTI1IC0yMDYuMDMzODg0IA0KTCA1NjYuNTY5MjkxIC0yMDYuMDMzODg0IA0KTCA1NjYuNDA5NDU3IC0yMDYuMDMzODg0IA0KTCA1NjYuMjQ5NjIzIC0yMDYuMDMzODg0IA0KTCA1NjYuMDg5NzkgLTIwNi4wMzM4ODQgDQpMIDU2NS45Mjk5NTYgLTIwNi4wMzM4ODQgDQpMIDU2NS43NzAxMjIgLTIwNi4wMzM4ODQgDQpMIDU2NS42MTAyODggLTIwNi4wMzM4ODQgDQpMIDU2NS40NTA0NTQgLTIwNi4wMzM4ODQgDQpMIDU2NS4yOTA2MiAtMjA2LjAzMzg4NCANCkwgNTY1LjEzMDc4NiAtMjA2LjAzMzg4NCANCkwgNTY0Ljk3MDk1MiAtMjA2LjAzMzg4NCANCkwgNTY0LjgxMTExOCAtMjA2LjAzMzg4NCANCkwgNTY0LjY1MTI4NSAtMjA2LjAzMzg4NCANCkwgNTY0LjQ5MTQ1MSAtMjA2LjAzMzg4NCANCkwgNTY0LjMzMTYxNyAtMjA2LjAzMzg4NCANCkwgNTY0LjE3MTc4MyAtMjA2LjAzMzg4NCANCkwgNTY0LjAxMTk0OSAtMjA2LjAzMzg4NCANCkwgNTYzLjg1MjExNSAtMjA2LjAzMzg4NCANCkwgNTYzLjY5MjI4MSAtMjA2LjAzMzg4NCANCkwgNTYzLjUzMjQ0NyAtMjA2LjAzMzg4NCANCkwgNTYzLjM3MjYxMyAtMjA2LjAzMzg4NCANCkwgNTYzLjIxMjc4IC0yMDYuMDMzODg0IA0KTCA1NjMuMDUyOTQ2IC0yMDYuMDMzODg0IA0KTCA1NjIuODkzMTEyIC0yMDYuMDMzODg0IA0KTCA1NjIuNzMzMjc4IC0yMDYuMDMzODg0IA0KTCA1NjIuNTczNDQ0IC0yMDYuMDMzODg0IA0KTCA1NjIuNDEzNjEgLTIwNi4wMzM4ODQgDQpMIDU2Mi4yNTM3NzYgLTIwNi4wMzM4ODQgDQpMIDU2Mi4wOTM5NDIgLTIwNi4wMzM4ODQgDQpMIDU2MS45MzQxMDkgLTIwNi4wMzM4ODQgDQpMIDU2MS43NzQyNzUgLTIwNi4wMzM4ODQgDQpMIDU2MS42MTQ0NDEgLTIwNi4wMzM4ODQgDQpMIDU2MS40NTQ2MDcgLTIwNi4wMzM4ODQgDQpMIDU2MS4yOTQ3NzMgLTIwNi4wMzM4ODQgDQpMIDU2MS4xMzQ5MzkgLTIwNi4wMzM4ODQgDQpMIDU2MC45NzUxMDUgLTIwNi4wMzM4ODQgDQpMIDU2MC44MTUyNzEgLTIwNi4wMzM4ODQgDQpMIDU2MC42NTU0MzcgLTIwNi4wMzM4ODQgDQpMIDU2MC40OTU2MDQgLTIwNi4wMzM4ODQgDQpMIDU2MC4zMzU3NyAtMjA2LjAzMzg4NCANCkwgNTYwLjE3NTkzNiAtMjA2LjAzMzg4NCANCkwgNTYwLjAxNjEwMiAtMjA2LjAzMzg4NCANCkwgNTU5Ljg1NjI2OCAtMjA2LjAzMzg4NCANCkwgNTU5LjY5NjQzNCAtMjA2LjAzMzg4NCANCkwgNTU5LjUzNjYgLTIwNi4wMzM4ODQgDQpMIDU1OS4zNzY3NjYgLTIwNi4wMzM4ODQgDQpMIDU1OS4yMTY5MzMgLTIwNi4wMzM4ODQgDQpMIDU1OS4wNTcwOTkgLTIwNi4wMzM4ODQgDQpMIDU1OC44OTcyNjUgLTIwNi4wMzM4ODQgDQpMIDU1OC43Mzc0MzEgLTIwNi4wMzM4ODQgDQpMIDU1OC41Nzc1OTcgLTIwNi4wMzM4ODQgDQpMIDU1OC40MTc3NjMgLTIwNi4wMzM4ODQgDQpMIDU1OC4yNTc5MjkgLTIwNi4wMzM4ODQgDQpMIDU1OC4wOTgwOTUgLTIwNi4wMzM4ODQgDQpMIDU1Ny45MzgyNjEgLTIwNi4wMzM4ODQgDQpMIDU1Ny43Nzg0MjggLTIwNi4wMzM4ODQgDQpMIDU1Ny42MTg1OTQgLTIwNi4wMzM4ODQgDQpMIDU1Ny40NTg3NiAtMjA2LjAzMzg4NCANCkwgNTU3LjI5ODkyNiAtMjA2LjAzMzg4NCANCkwgNTU3LjEzOTA5MiAtMjA2LjAzMzg4NCANCkwgNTU2Ljk3OTI1OCAtMjA2LjAzMzg4NCANCkwgNTU2LjgxOTQyNCAtMjA2LjAzMzg4NCANCkwgNTU2LjY1OTU5IC0yMDYuMDMzODg0IA0KTCA1NTYuNDk5NzU2IC0yMDYuMDMzODg0IA0KTCA1NTYuMzM5OTIzIC0yMDYuMDMzODg0IA0KTCA1NTYuMTgwMDg5IC0yMDYuMDMzODg0IA0KTCA1NTYuMDIwMjU1IC0yMDYuMDMzODg0IA0KTCA1NTUuODYwNDIxIC0yMDYuMDMzODg0IA0KTCA1NTUuNzAwNTg3IC0yMDYuMDMzODg0IA0KTCA1NTUuNTQwNzUzIC0yMDYuMDMzODg0IA0KTCA1NTUuMzgwOTE5IC0yMDYuMDMzODg0IA0KTCA1NTUuMjIxMDg1IC0yMDYuMDMzODg0IA0KTCA1NTUuMDYxMjUyIC0yMDYuMDMzODg0IA0KTCA1NTQuOTAxNDE4IC0yMDYuMDMzODg0IA0KTCA1NTQuNzQxNTg0IC0yMDYuMDMzODg0IA0KTCA1NTQuNTgxNzUgLTIwNi4wMzM4ODQgDQpMIDU1NC40MjE5MTYgLTIwNi4wMzM4ODQgDQpMIDU1NC4yNjIwODIgLTIwNi4wMzM4ODQgDQpMIDU1NC4xMDIyNDggLTIwNi4wMzM4ODQgDQpMIDU1My45NDI0MTQgLTIwNi4wMzM4ODQgDQpMIDU1My43ODI1OCAtMjA2LjAzMzg4NCANCkwgNTUzLjYyMjc0NyAtMjA2LjAzMzg4NCANCkwgNTUzLjQ2MjkxMyAtMjA2LjAzMzg4NCANCkwgNTUzLjMwMzA3OSAtMjA2LjAzMzg4NCANCkwgNTUzLjE0MzI0NSAtMjA2LjAzMzg4NCANCkwgNTUyLjk4MzQxMSAtMjA2LjAzMzg4NCANCkwgNTUyLjgyMzU3NyAtMjA2LjAzMzg4NCANCkwgNTUyLjY2Mzc0MyAtMjA2LjAzMzg4NCANCkwgNTUyLjUwMzkwOSAtMjA2LjAzMzg4NCANCkwgNTUyLjM0NDA3NiAtMjA2LjAzMzg4NCANCkwgNTUyLjE4NDI0MiAtMjA2LjAzMzg4NCANCkwgNTUyLjAyNDQwOCAtMjA2LjAzMzg4NCANCkwgNTUxLjg2NDU3NCAtMjA2LjAzMzg4NCANCkwgNTUxLjcwNDc0IC0yMDYuMDMzODg0IA0KTCA1NTEuNTQ0OTA2IC0yMDYuMDMzODg0IA0KTCA1NTEuMzg1MDcyIC0yMDYuMDMzODg0IA0KTCA1NTEuMjI1MjM4IC0yMDYuMDMzODg0IA0KTCA1NTEuMDY1NDA0IC0yMDYuMDMzODg0IA0KTCA1NTAuOTA1NTcxIC0yMDYuMDMzODg0IA0KTCA1NTAuNzQ1NzM3IC0yMDYuMDMzODg0IA0KTCA1NTAuNTg1OTAzIC0yMDYuMDMzODg0IA0KTCA1NTAuNDI2MDY5IC0yMDYuMDMzODg0IA0KTCA1NTAuMjY2MjM1IC0yMDYuMDMzODg0IA0KTCA1NTAuMTA2NDAxIC0yMDYuMDMzODg0IA0KTCA1NDkuOTQ2NTY3IC0yMDYuMDMzODg0IA0KTCA1NDkuNzg2NzMzIC0yMDYuMDMzODg0IA0KTCA1NDkuNjI2ODk5IC0yMDYuMDMzODg0IA0KTCA1NDkuNDY3MDY2IC0yMDYuMDMzODg0IA0KTCA1NDkuMzA3MjMyIC0yMDYuMDMzODg0IA0KTCA1NDkuMTQ3Mzk4IC0yMDYuMDMzODg0IA0KTCA1NDguOTg3NTY0IC0yMDYuMDMzODg0IA0KTCA1NDguODI3NzMgLTIwNi4wMzM4ODQgDQpMIDU0OC42Njc4OTYgLTIwNi4wMzM4ODQgDQpMIDU0OC41MDgwNjIgLTIwNi4wMzM4ODQgDQpMIDU0OC4zNDgyMjggLTIwNi4wMzM4ODQgDQpMIDU0OC4xODgzOTUgLTIwNi4wMzM4ODQgDQpMIDU0OC4wMjg1NjEgLTIwNi4wMzM4ODQgDQpMIDU0Ny44Njg3MjcgLTIwNi4wMzM4ODQgDQpMIDU0Ny43MDg4OTMgLTIwNi4wMzM4ODQgDQpMIDU0Ny41NDkwNTkgLTIwNi4wMzM4ODQgDQpMIDU0Ny4zODkyMjUgLTIwNi4wMzM4ODQgDQpMIDU0Ny4yMjkzOTEgLTIwNi4wMzM4ODQgDQpMIDU0Ny4wNjk1NTcgLTIwNi4wMzM4ODQgDQpMIDU0Ni45MDk3MjMgLTIwNi4wMzM4ODQgDQpMIDU0Ni43NDk4OSAtMjA2LjAzMzg4NCANCkwgNTQ2LjU5MDA1NiAtMjA2LjAzMzg4NCANCkwgNTQ2LjQzMDIyMiAtMjA2LjAzMzg4NCANCkwgNTQ2LjI3MDM4OCAtMjA2LjAzMzg4NCANCkwgNTQ2LjExMDU1NCAtMjA2LjAzMzg4NCANCkwgNTQ1Ljk1MDcyIC0yMDYuMDMzODg0IA0KTCA1NDUuNzkwODg2IC0yMDYuMDMzODg0IA0KTCA1NDUuNjMxMDUyIC0yMDYuMDMzODg0IA0KTCA1NDUuNDcxMjE4IC0yMDYuMDMzODg0IA0KTCA1NDUuMzExMzg1IC0yMDYuMDMzODg0IA0KTCA1NDUuMTUxNTUxIC0yMDYuMDMzODg0IA0KTCA1NDQuOTkxNzE3IC0yMDYuMDMzODg0IA0KTCA1NDQuODMxODgzIC0yMDYuMDMzODg0IA0KTCA1NDQuNjcyMDQ5IC0yMDYuMDMzODg0IA0KTCA1NDQuNTEyMjE1IC0yMDYuMDMzODg0IA0KTCA1NDQuMzUyMzgxIC0yMDYuMDMzODg0IA0KTCA1NDQuMTkyNTQ3IC0yMDYuMDMzODg0IA0KTCA1NDQuMDMyNzE0IC0yMDYuMDMzODg0IA0KTCA1NDMuODcyODggLTIwNi4wMzM4ODQgDQpMIDU0My43MTMwNDYgLTIwNi4wMzM4ODQgDQpMIDU0My41NTMyMTIgLTIwNi4wMzM4ODQgDQpMIDU0My4zOTMzNzggLTIwNi4wMzM4ODQgDQpMIDU0My4yMzM1NDQgLTIwNi4wMzM4ODQgDQpMIDU0My4wNzM3MSAtMjA2LjAzMzg4NCANCkwgNTQyLjkxMzg3NiAtMjA2LjAzMzg4NCANCkwgNTQyLjc1NDA0MiAtMjA2LjAzMzg4NCANCkwgNTQyLjU5NDIwOSAtMjA2LjAzMzg4NCANCkwgNTQyLjQzNDM3NSAtMjA2LjAzMzg4NCANCkwgNTQyLjI3NDU0MSAtMjA2LjAzMzg4NCANCkwgNTQyLjExNDcwNyAtMjA2LjAzMzg4NCANCkwgNTQxLjk1NDg3MyAtMjA2LjAzMzg4NCANCkwgNTQxLjc5NTAzOSAtMjA2LjAzMzg4NCANCkwgNTQxLjYzNTIwNSAtMjA2LjAzMzg4NCANCkwgNTQxLjQ3NTM3MSAtMjA2LjAzMzg4NCANCkwgNTQxLjMxNTUzOCAtMjA2LjAzMzg4NCANCkwgNTQxLjE1NTcwNCAtMjA2LjAzMzg4NCANCkwgNTQwLjk5NTg3IC0yMDYuMDMzODg0IA0KTCA1NDAuODM2MDM2IC0yMDYuMDMzODg0IA0KTCA1NDAuNjc2MjAyIC0yMDYuMDMzODg0IA0KTCA1NDAuNTE2MzY4IC0yMDYuMDMzODg0IA0KTCA1NDAuMzU2NTM0IC0yMDYuMDMzODg0IA0KTCA1NDAuMTk2NyAtMjA2LjAzMzg4NCANCkwgNTQwLjAzNjg2NiAtMjA2LjAzMzg4NCANCkwgNTM5Ljg3NzAzMyAtMjA2LjAzMzg4NCANCkwgNTM5LjcxNzE5OSAtMjA2LjAzMzg4NCANCkwgNTM5LjU1NzM2NSAtMjA2LjAzMzg4NCANCkwgNTM5LjM5NzUzMSAtMjA2LjAzMzg4NCANCkwgNTM5LjIzNzY5NyAtMjA2LjAzMzg4NCANCkwgNTM5LjA3Nzg2MyAtMjA2LjAzMzg4NCANCkwgNTM4LjkxODAyOSAtMjA2LjAzMzg4NCANCkwgNTM4Ljc1ODE5NSAtMjA2LjAzMzg4NCANCkwgNTM4LjU5ODM2MSAtMjA2LjAzMzg4NCANCkwgNTM4LjQzODUyOCAtMjA2LjAzMzg4NCANCkwgNTM4LjI3ODY5NCAtMjA2LjAzMzg4NCANCkwgNTM4LjExODg2IC0yMDYuMDMzODg0IA0KTCA1MzcuOTU5MDI2IC0yMDYuMDMzODg0IA0KTCA1MzcuNzk5MTkyIC0yMDYuMDMzODg0IA0KTCA1MzcuNjM5MzU4IC0yMDYuMDMzODg0IA0KTCA1MzcuNDc5NTI0IC0yMDYuMDMzODg0IA0KTCA1MzcuMzE5NjkgLTIwNi4wMzM4ODQgDQpMIDUzNy4xNTk4NTcgLTIwNi4wMzM4ODQgDQpMIDUzNy4wMDAwMjMgLTIwNi4wMzM4ODQgDQpMIDUzNi44NDAxODkgLTIwNi4wMzM4ODQgDQpMIDUzNi42ODAzNTUgLTIwNi4wMzM4ODQgDQpMIDUzNi41MjA1MjEgLTIwNi4wMzM4ODQgDQpMIDUzNi4zNjA2ODcgLTIwNi4wMzM4ODQgDQpMIDUzNi4yMDA4NTMgLTIwNi4wMzM4ODQgDQpMIDUzNi4wNDEwMTkgLTIwNi4wMzM4ODQgDQpMIDUzNS44ODExODUgLTIwNi4wMzM4ODQgDQpMIDUzNS43MjEzNTIgLTIwNi4wMzM4ODQgDQpMIDUzNS41NjE1MTggLTIwNi4wMzM4ODQgDQpMIDUzNS40MDE2ODQgLTIwNi4wMzM4ODQgDQpMIDUzNS4yNDE4NSAtMjA2LjAzMzg4NCANCkwgNTM1LjA4MjAxNiAtMjA2LjAzMzg4NCANCkwgNTM0LjkyMjE4MiAtMjA2LjAzMzg4NCANCkwgNTM0Ljc2MjM0OCAtMjA2LjAzMzg4NCANCkwgNTM0LjYwMjUxNCAtMjA2LjAzMzg4NCANCkwgNTM0LjQ0MjY4MSAtMjA2LjAzMzg4NCANCkwgNTM0LjI4Mjg0NyAtMjA2LjAzMzg4NCANCkwgNTM0LjEyMzAxMyAtMjA2LjAzMzg4NCANCkwgNTMzLjk2MzE3OSAtMjA2LjAzMzg4NCANCkwgNTMzLjgwMzM0NSAtMjA2LjAzMzg4NCANCkwgNTMzLjY0MzUxMSAtMjA2LjAzMzg4NCANCkwgNTMzLjQ4MzY3NyAtMjA2LjAzMzg4NCANCkwgNTMzLjMyMzg0MyAtMjA2LjAzMzg4NCANCkwgNTMzLjE2NDAwOSAtMjA2LjAzMzg4NCANCkwgNTMzLjAwNDE3NiAtMjA2LjAzMzg4NCANCkwgNTMyLjg0NDM0MiAtMjA2LjAzMzg4NCANCkwgNTMyLjY4NDUwOCAtMjA2LjAzMzg4NCANCkwgNTMyLjUyNDY3NCAtMjA2LjAzMzg4NCANCkwgNTMyLjM2NDg0IC0yMDYuMDMzODg0IA0KTCA1MzIuMjA1MDA2IC0yMDYuMDMzODg0IA0KTCA1MzIuMDQ1MTcyIC0yMDYuMDMzODg0IA0KTCA1MzEuODg1MzM4IC0yMDYuMDMzODg0IA0KTCA1MzEuNzI1NTA0IC0yMDYuMDMzODg0IA0KTCA1MzEuNTY1NjcxIC0yMDYuMDMzODg0IA0KTCA1MzEuNDA1ODM3IC0yMDYuMDMzODg0IA0KTCA1MzEuMjQ2MDAzIC0yMDYuMDMzODg0IA0KTCA1MzEuMDg2MTY5IC0yMDYuMDMzODg0IA0KTCA1MzAuOTI2MzM1IC0yMDYuMDMzODg0IA0KTCA1MzAuNzY2NTAxIC0yMDYuMDMzODg0IA0KTCA1MzAuNjA2NjY3IC0yMDYuMDMzODg0IA0KTCA1MzAuNDQ2ODMzIC0yMDYuMDMzODg0IA0KTCA1MzAuMjg3IC0yMDYuMDMzODg0IA0KTCA1MzAuMTI3MTY2IC0yMDYuMDMzODg0IA0KTCA1MjkuOTY3MzMyIC0yMDYuMDMzODg0IA0KTCA1MjkuODA3NDk4IC0yMDYuMDMzODg0IA0KTCA1MjkuNjQ3NjY0IC0yMDYuMDMzODg0IA0KTCA1MjkuNDg3ODMgLTIwNi4wMzM4ODQgDQpMIDUyOS4zMjc5OTYgLTIwNi4wMzM4ODQgDQpMIDUyOS4xNjgxNjIgLTIwNi4wMzM4ODQgDQpMIDUyOS4wMDgzMjggLTIwNi4wMzM4ODQgDQpMIDUyOC44NDg0OTUgLTIwNi4wMzM4ODQgDQpMIDUyOC42ODg2NjEgLTIwNi4wMzM4ODQgDQpMIDUyOC41Mjg4MjcgLTIwNi4wMzM4ODQgDQpMIDUyOC4zNjg5OTMgLTIwNi4wMzM4ODQgDQpMIDUyOC4yMDkxNTkgLTIwNi4wMzM4ODQgDQpMIDUyOC4wNDkzMjUgLTIwNi4wMzM4ODQgDQpMIDUyNy44ODk0OTEgLTIwNi4wMzM4ODQgDQpMIDUyNy43Mjk2NTcgLTIwNi4wMzM4ODQgDQpMIDUyNy41Njk4MjQgLTIwNi4wMzM4ODQgDQpMIDUyNy40MDk5OSAtMjA2LjAzMzg4NCANCkwgNTI3LjI1MDE1NiAtMjA2LjAzMzg4NCANCkwgNTI3LjA5MDMyMiAtMjA2LjAzMzg4NCANCkwgNTI2LjkzMDQ4OCAtMjA2LjAzMzg4NCANCkwgNTI2Ljc3MDY1NCAtMjA2LjAzMzg4NCANCkwgNTI2LjYxMDgyIC0yMDYuMDMzODg0IA0KTCA1MjYuNDUwOTg2IC0yMDYuMDMzODg0IA0KTCA1MjYuMjkxMTUyIC0yMDYuMDMzODg0IA0KTCA1MjYuMTMxMzE5IC0yMDYuMDMzODg0IA0KTCA1MjUuOTcxNDg1IC0yMDYuMDMzODg0IA0KTCA1MjUuODExNjUxIC0yMDYuMDMzODg0IA0KTCA1MjUuNjUxODE3IC0yMDYuMDMzODg0IA0KTCA1MjUuNDkxOTgzIC0yMDYuMDMzODg0IA0KTCA1MjUuMzMyMTQ5IC0yMDYuMDMzODg0IA0KTCA1MjUuMTcyMzE1IC0yMDYuMDMzODg0IA0KTCA1MjUuMDEyNDgxIC0yMDYuMDMzODg0IA0KTCA1MjQuODUyNjQ3IC0yMDYuMDMzODg0IA0KTCA1MjQuNjkyODE0IC0yMDYuMDMzODg0IA0KTCA1MjQuNTMyOTggLTIwNi4wMzM4ODQgDQpMIDUyNC4zNzMxNDYgLTIwNi4wMzM4ODQgDQpMIDUyNC4yMTMzMTIgLTIwNi4wMzM4ODQgDQpMIDUyNC4wNTM0NzggLTIwNi4wMzM4ODQgDQpMIDUyMy44OTM2NDQgLTIwNi4wMzM4ODQgDQpMIDUyMy43MzM4MSAtMjA2LjAzMzg4NCANCkwgNTIzLjU3Mzk3NiAtMjA2LjAzMzg4NCANCkwgNTIzLjQxNDE0MyAtMjA2LjAzMzg4NCANCkwgNTIzLjI1NDMwOSAtMjA2LjAzMzg4NCANCkwgNTIzLjA5NDQ3NSAtMjA2LjAzMzg4NCANCkwgNTIyLjkzNDY0MSAtMjA2LjAzMzg4NCANCkwgNTIyLjc3NDgwNyAtMjA2LjAzMzg4NCANCkwgNTIyLjYxNDk3MyAtMjA2LjAzMzg4NCANCkwgNTIyLjQ1NTEzOSAtMjA2LjAzMzg4NCANCkwgNTIyLjI5NTMwNSAtMjA2LjAzMzg4NCANCkwgNTIyLjEzNTQ3MSAtMjA2LjAzMzg4NCANCkwgNTIxLjk3NTYzOCAtMjA2LjAzMzg4NCANCkwgNTIxLjgxNTgwNCAtMjA2LjAzMzg4NCANCkwgNTIxLjY1NTk3IC0yMDYuMDMzODg0IA0KTCA1MjEuNDk2MTM2IC0yMDYuMDMzODg0IA0KTCA1MjEuMzM2MzAyIC0yMDYuMDMzODg0IA0KTCA1MjEuMTc2NDY4IC0yMDYuMDMzODg0IA0KTCA1MjEuMDE2NjM0IC0yMDYuMDMzODg0IA0KTCA1MjAuODU2OCAtMjA2LjAzMzg4NCANCkwgNTIwLjY5Njk2NiAtMjA2LjAzMzg4NCANCkwgNTIwLjUzNzEzMyAtMjA2LjAzMzg4NCANCkwgNTIwLjM3NzI5OSAtMjA2LjAzMzg4NCANCkwgNTIwLjIxNzQ2NSAtMjA2LjAzMzg4NCANCkwgNTIwLjA1NzYzMSAtMjA2LjAzMzg4NCANCkwgNTE5Ljg5Nzc5NyAtMjA2LjAzMzg4NCANCkwgNTE5LjczNzk2MyAtMjA2LjAzMzg4NCANCkwgNTE5LjU3ODEyOSAtMjA2LjAzMzg4NCANCkwgNTE5LjQxODI5NSAtMjA2LjAzMzg4NCANCkwgNTE5LjI1ODQ2MiAtMjA2LjAzMzg4NCANCkwgNTE5LjA5ODYyOCAtMjA2LjAzMzg4NCANCkwgNTE4LjkzODc5NCAtMjA2LjAzMzg4NCANCkwgNTE4Ljc3ODk2IC0yMDYuMDMzODg0IA0KTCA1MTguNjE5MTI2IC0yMDYuMDMzODg0IA0KTCA1MTguNDU5MjkyIC0yMDYuMDMzODg0IA0KTCA1MTguMjk5NDU4IC0yMDYuMDMzODg0IA0KTCA1MTguMTM5NjI0IC0yMDYuMDMzODg0IA0KTCA1MTcuOTc5NzkgLTIwNi4wMzM4ODQgDQpMIDUxNy44MTk5NTcgLTIwNi4wMzM4ODQgDQpMIDUxNy42NjAxMjMgLTIwNi4wMzM4ODQgDQpMIDUxNy41MDAyODkgLTIwNi4wMzM4ODQgDQpMIDUxNy4zNDA0NTUgLTIwNi4wMzM4ODQgDQpMIDUxNy4xODA2MjEgLTIwNi4wMzM4ODQgDQpMIDUxNy4wMjA3ODcgLTIwNi4wMzM4ODQgDQpMIDUxNi44NjA5NTMgLTIwNi4wMzM4ODQgDQpMIDUxNi43MDExMTkgLTIwNi4wMzM4ODQgDQpMIDUxNi41NDEyODYgLTIwNi4wMzM4ODQgDQpMIDUxNi4zODE0NTIgLTIwNi4wMzM4ODQgDQpMIDUxNi4yMjE2MTggLTIwNi4wMzM4ODQgDQpMIDUxNi4wNjE3ODQgLTIwNi4wMzM4ODQgDQpMIDUxNS45MDE5NSAtMjA2LjAzMzg4NCANCkwgNTE1Ljc0MjExNiAtMjA2LjAzMzg4NCANCkwgNTE1LjU4MjI4MiAtMjA2LjAzMzg4NCANCkwgNTE1LjQyMjQ0OCAtMjA2LjAzMzg4NCANCkwgNTE1LjI2MjYxNCAtMjA2LjAzMzg4NCANCkwgNTE1LjEwMjc4MSAtMjA2LjAzMzg4NCANCkwgNTE0Ljk0Mjk0NyAtMjA2LjAzMzg4NCANCkwgNTE0Ljc4MzExMyAtMjA2LjAzMzg4NCANCkwgNTE0LjYyMzI3OSAtMjA2LjAzMzg4NCANCkwgNTE0LjQ2MzQ0NSAtMjA2LjAzMzg4NCANCkwgNTE0LjMwMzYxMSAtMjA2LjAzMzg4NCANCkwgNTE0LjE0Mzc3NyAtMjA2LjAzMzg4NCANCkwgNTEzLjk4Mzk0MyAtMjA2LjAzMzg4NCANCkwgNTEzLjgyNDEwOSAtMjA2LjAzMzg4NCANCkwgNTEzLjY2NDI3NiAtMjA2LjAzMzg4NCANCkwgNTEzLjUwNDQ0MiAtMjA2LjAzMzg4NCANCkwgNTEzLjM0NDYwOCAtMjA2LjAzMzg4NCANCkwgNTEzLjE4NDc3NCAtMjA2LjAzMzg4NCANCkwgNTEzLjAyNDk0IC0yMDYuMDMzODg0IA0KTCA1MTIuODY1MTA2IC0yMDYuMDMzODg0IA0KTCA1MTIuNzA1MjcyIC0yMDYuMDMzODg0IA0KTCA1MTIuNTQ1NDM4IC0yMDYuMDMzODg0IA0KTCA1MTIuMzg1NjA1IC0yMDYuMDMzODg0IA0KTCA1MTIuMjI1NzcxIC0yMDYuMDMzODg0IA0KTCA1MTIuMDY1OTM3IC0yMDYuMDMzODg0IA0KTCA1MTEuOTA2MTAzIC0yMDYuMDMzODg0IA0KTCA1MTEuNzQ2MjY5IC0yMDYuMDMzODg0IA0KTCA1MTEuNTg2NDM1IC0yMDYuMDMzODg0IA0KTCA1MTEuNDI2NjAxIC0yMDYuMDMzODg0IA0KTCA1MTEuMjY2NzY3IC0yMDYuMDMzODg0IA0KTCA1MTEuMTA2OTMzIC0yMDYuMDMzODg0IA0KTCA1MTAuOTQ3MSAtMjA2LjAzMzg4NCANCkwgNTEwLjc4NzI2NiAtMjA2LjAzMzg4NCANCkwgNTEwLjYyNzQzMiAtMjA2LjAzMzg4NCANCkwgNTEwLjQ2NzU5OCAtMjA2LjAzMzg4NCANCkwgNTEwLjMwNzc2NCAtMjA2LjAzMzg4NCANCkwgNTEwLjE0NzkzIC0yMDYuMDMzODg0IA0KTCA1MDkuOTg4MDk2IC0yMDYuMDMzODg0IA0KTCA1MDkuODI4MjYyIC0yMDYuMDMzODg0IA0KTCA1MDkuNjY4NDI5IC0yMDYuMDMzODg0IA0KTCA1MDkuNTA4NTk1IC0yMDYuMDMzODg0IA0KTCA1MDkuMzQ4NzYxIC0yMDYuMDMzODg0IA0KTCA1MDkuMTg4OTI3IC0yMDYuMDMzODg0IA0KTCA1MDkuMDI5MDkzIC0yMDYuMDMzODg0IA0KTCA1MDguODY5MjU5IC0yMDYuMDMzODg0IA0KTCA1MDguNzA5NDI1IC0yMDYuMDMzODg0IA0KTCA1MDguNTQ5NTkxIC0yMDYuMDMzODg0IA0KTCA1MDguMzg5NzU3IC0yMDYuMDMzODg0IA0KTCA1MDguMjI5OTI0IC0yMDYuMDMzODg0IA0KTCA1MDguMDcwMDkgLTIwNi4wMzM4ODQgDQpMIDUwNy45MTAyNTYgLTIwNi4wMzM4ODQgDQpMIDUwNy43NTA0MjIgLTIwNi4wMzM4ODQgDQpMIDUwNy41OTA1ODggLTIwNi4wMzM4ODQgDQpMIDUwNy40MzA3NTQgLTIwNi4wMzM4ODQgDQpMIDUwNy4yNzA5MiAtMjA2LjAzMzg4NCANCkwgNTA3LjExMTA4NiAtMjA2LjAzMzg4NCANCkwgNTA2Ljk1MTI1MiAtMjA2LjAzMzg4NCANCkwgNTA2Ljc5MTQxOSAtMjA2LjAzMzg4NCANCkwgNTA2LjYzMTU4NSAtMjA2LjAzMzg4NCANCkwgNTA2LjQ3MTc1MSAtMjA2LjAzMzg4NCANCkwgNTA2LjMxMTkxNyAtMjA2LjAzMzg4NCANCkwgNTA2LjE1MjA4MyAtMjA2LjAzMzg4NCANCkwgNTA1Ljk5MjI0OSAtMjA2LjAzMzg4NCANCkwgNTA1LjgzMjQxNSAtMjA2LjAzMzg4NCANCkwgNTA1LjY3MjU4MSAtMjA2LjAzMzg4NCANCkwgNTA1LjUxMjc0OCAtMjA2LjAzMzg4NCANCkwgNTA1LjM1MjkxNCAtMjA2LjAzMzg4NCANCkwgNTA1LjE5MzA4IC0yMDYuMDMzODg0IA0KTCA1MDUuMDMzMjQ2IC0yMDYuMDMzODg0IA0KTCA1MDQuODczNDEyIC0yMDYuMDMzODg0IA0KTCA1MDQuNzEzNTc4IC0yMDYuMDMzODg0IA0KTCA1MDQuNTUzNzQ0IC0yMDYuMDMzODg0IA0KTCA1MDQuMzkzOTEgLTIwNi4wMzM4ODQgDQpMIDUwNC4yMzQwNzYgLTIwNi4wMzM4ODQgDQpMIDUwNC4wNzQyNDMgLTIwNi4wMzM4ODQgDQpMIDUwMy45MTQ0MDkgLTIwNi4wMzM4ODQgDQpMIDUwMy43NTQ1NzUgLTIwNi4wMzM4ODQgDQpMIDUwMy41OTQ3NDEgLTIwNi4wMzM4ODQgDQpMIDUwMy40MzQ5MDcgLTIwNi4wMzM4ODQgDQpMIDUwMy4yNzUwNzMgLTIwNi4wMzM4ODQgDQpMIDUwMy4xMTUyMzkgLTIwNi4wMzM4ODQgDQpMIDUwMi45NTU0MDUgLTIwNi4wMzM4ODQgDQpMIDUwMi43OTU1NzEgLTIwNi4wMzM4ODQgDQpMIDUwMi42MzU3MzggLTIwNi4wMzM4ODQgDQpMIDUwMi40NzU5MDQgLTIwNi4wMzM4ODQgDQpMIDUwMi4zMTYwNyAtMjA2LjAzMzg4NCANCkwgNTAyLjE1NjIzNiAtMjA2LjAzMzg4NCANCkwgNTAxLjk5NjQwMiAtMjA2LjAzMzg4NCANCkwgNTAxLjgzNjU2OCAtMjA2LjAzMzg4NCANCkwgNTAxLjY3NjczNCAtMjA2LjAzMzg4NCANCkwgNTAxLjUxNjkgLTIwNi4wMzM4ODQgDQpMIDUwMS4zNTcwNjcgLTIwNi4wMzM4ODQgDQpMIDUwMS4xOTcyMzMgLTIwNi4wMzM4ODQgDQpMIDUwMS4wMzczOTkgLTIwNi4wMzM4ODQgDQpMIDUwMC44Nzc1NjUgLTIwNi4wMzM4ODQgDQpMIDUwMC43MTc3MzEgLTIwNi4wMzM4ODQgDQpMIDUwMC41NTc4OTcgLTIwNi4wMzM4ODQgDQpMIDUwMC4zOTgwNjMgLTIwNi4wMzM4ODQgDQpMIDUwMC4yMzgyMjkgLTIwNi4wMzM4ODQgDQpMIDUwMC4wNzgzOTUgLTIwNi4wMzM4ODQgDQpMIDQ5OS45MTg1NjIgLTIwNi4wMzM4ODQgDQpMIDQ5OS43NTg3MjggLTIwNi4wMzM4ODQgDQpMIDQ5OS41OTg4OTQgLTIwNi4wMzM4ODQgDQpMIDQ5OS40MzkwNiAtMjA2LjAzMzg4NCANCkwgNDk5LjI3OTIyNiAtMjA2LjAzMzg4NCANCkwgNDk5LjExOTM5MiAtMjA2LjAzMzg4NCANCkwgNDk4Ljk1OTU1OCAtMjA2LjAzMzg4NCANCkwgNDk4Ljc5OTcyNCAtMjA2LjAzMzg4NCANCkwgNDk4LjYzOTg5MSAtMjA2LjAzMzg4NCANCkwgNDk4LjQ4MDA1NyAtMjA2LjAzMzg4NCANCkwgNDk4LjMyMDIyMyAtMjA2LjAzMzg4NCANCkwgNDk4LjE2MDM4OSAtMjA2LjAzMzg4NCANCkwgNDk4LjAwMDU1NSAtMjA2LjAzMzg4NCANCkwgNDk3Ljg0MDcyMSAtMjA2LjAzMzg4NCANCkwgNDk3LjY4MDg4NyAtMjA2LjAzMzg4NCANCkwgNDk3LjUyMTA1MyAtMjA2LjAzMzg4NCANCkwgNDk3LjM2MTIxOSAtMjA2LjAzMzg4NCANCkwgNDk3LjIwMTM4NiAtMjA2LjAzMzg4NCANCkwgNDk3LjA0MTU1MiAtMjA2LjAzMzg4NCANCkwgNDk2Ljg4MTcxOCAtMjA2LjAzMzg4NCANCkwgNDk2LjcyMTg4NCAtMjA2LjAzMzg4NCANCkwgNDk2LjU2MjA1IC0yMDYuMDMzODg0IA0KTCA0OTYuNDAyMjE2IC0yMDYuMDMzODg0IA0KTCA0OTYuMjQyMzgyIC0yMDYuMDMzODg0IA0KTCA0OTYuMDgyNTQ4IC0yMDYuMDMzODg0IA0KTCA0OTUuOTIyNzE0IC0yMDYuMDMzODg0IA0KTCA0OTUuNzYyODgxIC0yMDYuMDMzODg0IA0KTCA0OTUuNjAzMDQ3IC0yMDYuMDMzODg0IA0KTCA0OTUuNDQzMjEzIC0yMDYuMDMzODg0IA0KTCA0OTUuMjgzMzc5IC0yMDYuMDMzODg0IA0KTCA0OTUuMTIzNTQ1IC0yMDYuMDMzODg0IA0KTCA0OTQuOTYzNzExIC0yMDYuMDMzODg0IA0KTCA0OTQuODAzODc3IC0yMDYuMDMzODg0IA0KTCA0OTQuNjQ0MDQzIC0yMDYuMDMzODg0IA0KTCA0OTQuNDg0MjEgLTIwNi4wMzM4ODQgDQpMIDQ5NC4zMjQzNzYgLTIwNi4wMzM4ODQgDQpMIDQ5NC4xNjQ1NDIgLTIwNi4wMzM4ODQgDQpMIDQ5NC4wMDQ3MDggLTIwNi4wMzM4ODQgDQpMIDQ5My44NDQ4NzQgLTIwNi4wMzM4ODQgDQpMIDQ5My42ODUwNCAtMjA2LjAzMzg4NCANCkwgNDkzLjUyNTIwNiAtMjA2LjAzMzg4NCANCkwgNDkzLjM2NTM3MiAtMjA2LjAzMzg4NCANCkwgNDkzLjIwNTUzOCAtMjA2LjAzMzg4NCANCkwgNDkzLjA0NTcwNSAtMjA2LjAzMzg4NCANCkwgNDkyLjg4NTg3MSAtMjA2LjAzMzg4NCANCkwgNDkyLjcyNjAzNyAtMjA2LjAzMzg4NCANCkwgNDkyLjU2NjIwMyAtMjA2LjAzMzg4NCANCkwgNDkyLjQwNjM2OSAtMjA2LjAzMzg4NCANCkwgNDkyLjI0NjUzNSAtMjA2LjAzMzg4NCANCkwgNDkyLjA4NjcwMSAtMjA2LjAzMzg4NCANCkwgNDkxLjkyNjg2NyAtMjA2LjAzMzg4NCANCkwgNDkxLjc2NzAzNCAtMjA2LjAzMzg4NCANCkwgNDkxLjYwNzIgLTIwNi4wMzM4ODQgDQpMIDQ5MS40NDczNjYgLTIwNi4wMzM4ODQgDQpMIDQ5MS4yODc1MzIgLTIwNi4wMzM4ODQgDQpMIDQ5MS4xMjc2OTggLTIwNi4wMzM4ODQgDQpMIDQ5MC45Njc4NjQgLTIwNi4wMzM4ODQgDQpMIDQ5MC44MDgwMyAtMjA2LjAzMzg4NCANCkwgNDkwLjY0ODE5NiAtMjA2LjAzMzg4NCANCkwgNDkwLjQ4ODM2MiAtMjA2LjAzMzg4NCANCkwgNDkwLjMyODUyOSAtMjA2LjAzMzg4NCANCkwgNDkwLjE2ODY5NSAtMjA2LjAzMzg4NCANCkwgNDkwLjAwODg2MSAtMjA2LjAzMzg4NCANCkwgNDg5Ljg0OTAyNyAtMjA2LjAzMzg4NCANCkwgNDg5LjY4OTE5MyAtMjA2LjAzMzg4NCANCkwgNDg5LjUyOTM1OSAtMjA2LjAzMzg4NCANCkwgNDg5LjM2OTUyNSAtMjA2LjAzMzg4NCANCkwgNDg5LjIwOTY5MSAtMjA2LjAzMzg4NCANCkwgNDg5LjA0OTg1NyAtMjA2LjAzMzg4NCANCkwgNDg4Ljg5MDAyNCAtMjA2LjAzMzg4NCANCkwgNDg4LjczMDE5IC0yMDYuMDMzODg0IA0KTCA0ODguNTcwMzU2IC0yMDYuMDMzODg0IA0KTCA0ODguNDEwNTIyIC0yMDYuMDMzODg0IA0KTCA0ODguMjUwNjg4IC0yMDYuMDMzODg0IA0KTCA0ODguMDkwODU0IC0yMDYuMDMzODg0IA0KTCA0ODcuOTMxMDIgLTIwNi4wMzM4ODQgDQpMIDQ4Ny43NzExODYgLTIwNi4wMzM4ODQgDQpMIDQ4Ny42MTEzNTMgLTIwNi4wMzM4ODQgDQpMIDQ4Ny40NTE1MTkgLTIwNi4wMzM4ODQgDQpMIDQ4Ny4yOTE2ODUgLTIwNi4wMzM4ODQgDQpMIDQ4Ny4xMzE4NTEgLTIwNi4wMzM4ODQgDQpMIDQ4Ni45NzIwMTcgLTIwNi4wMzM4ODQgDQpMIDQ4Ni44MTIxODMgLTIwNi4wMzM4ODQgDQpMIDQ4Ni42NTIzNDkgLTIwNi4wMzM4ODQgDQpMIDQ4Ni40OTI1MTUgLTIwNi4wMzM4ODQgDQpMIDQ4Ni4zMzI2ODEgLTIwNi4wMzM4ODQgDQpMIDQ4Ni4xNzI4NDggLTIwNi4wMzM4ODQgDQpMIDQ4Ni4wMTMwMTQgLTIwNi4wMzM4ODQgDQpMIDQ4NS44NTMxOCAtMjA2LjAzMzg4NCANCkwgNDg1LjY5MzM0NiAtMjA2LjAzMzg4NCANCkwgNDg1LjUzMzUxMiAtMjA2LjAzMzg4NCANCkwgNDg1LjM3MzY3OCAtMjA2LjAzMzg4NCANCkwgNDg1LjIxMzg0NCAtMjA2LjAzMzg4NCANCkwgNDg1LjA1NDAxIC0yMDYuMDMzODg0IA0KTCA0ODQuODk0MTc2IC0yMDYuMDMzODg0IA0KTCA0ODQuNzM0MzQzIC0yMDYuMDMzODg0IA0KTCA0ODQuNTc0NTA5IC0yMDYuMDMzODg0IA0KTCA0ODQuNDE0Njc1IC0yMDYuMDMzODg0IA0KTCA0ODQuMjU0ODQxIC0yMDYuMDMzODg0IA0KTCA0ODQuMDk1MDA3IC0yMDYuMDMzODg0IA0KTCA0ODMuOTM1MTczIC0yMDYuMDMzODg0IA0KTCA0ODMuNzc1MzM5IC0yMDYuMDMzODg0IA0KTCA0ODMuNjE1NTA1IC0yMDYuMDMzODg0IA0KTCA0ODMuNDU1NjcyIC0yMDYuMDMzODg0IA0KTCA0ODMuMjk1ODM4IC0yMDYuMDMzODg0IA0KTCA0ODMuMTM2MDA0IC0yMDYuMDMzODg0IA0KTCA0ODIuOTc2MTcgLTIwNi4wMzM4ODQgDQpMIDQ4Mi44MTYzMzYgLTIwNi4wMzM4ODQgDQpMIDQ4Mi42NTY1MDIgLTIwNi4wMzM4ODQgDQpMIDQ4Mi40OTY2NjggLTIwNi4wMzM4ODQgDQpMIDQ4Mi4zMzY4MzQgLTIwNi4wMzM4ODQgDQpMIDQ4Mi4xNzcgLTIwNi4wMzM4ODQgDQpMIDQ4Mi4wMTcxNjcgLTIwNi4wMzM4ODQgDQpMIDQ4MS44NTczMzMgLTIwNi4wMzM4ODQgDQpMIDQ4MS42OTc0OTkgLTIwNi4wMzM4ODQgDQpMIDQ4MS41Mzc2NjUgLTIwNi4wMzM4ODQgDQpMIDQ4MS4zNzc4MzEgLTIwNi4wMzM4ODQgDQpMIDQ4MS4yMTc5OTcgLTIwNi4wMzM4ODQgDQpMIDQ4MS4wNTgxNjMgLTIwNi4wMzM4ODQgDQpMIDQ4MC44OTgzMjkgLTIwNi4wMzM4ODQgDQpMIDQ4MC43Mzg0OTYgLTIwNi4wMzM4ODQgDQpMIDQ4MC41Nzg2NjIgLTIwNi4wMzM4ODQgDQpMIDQ4MC40MTg4MjggLTIwNi4wMzM4ODQgDQpMIDQ4MC4yNTg5OTQgLTIwNi4wMzM4ODQgDQpMIDQ4MC4wOTkxNiAtMjA2LjAzMzg4NCANCkwgNDc5LjkzOTMyNiAtMjA2LjAzMzg4NCANCkwgNDc5Ljc3OTQ5MiAtMjA2LjAzMzg4NCANCkwgNDc5LjYxOTY1OCAtMjA2LjAzMzg4NCANCkwgNDc5LjQ1OTgyNCAtMjA2LjAzMzg4NCANCkwgNDc5LjI5OTk5MSAtMjA2LjAzMzg4NCANCkwgNDc5LjE0MDE1NyAtMjA2LjAzMzg4NCANCkwgNDc4Ljk4MDMyMyAtMjA2LjAzMzg4NCANCkwgNDc4LjgyMDQ4OSAtMjA2LjAzMzg4NCANCkwgNDc4LjY2MDY1NSAtMjA2LjAzMzg4NCANCkwgNDc4LjUwMDgyMSAtMjA2LjAzMzg4NCANCkwgNDc4LjM0MDk4NyAtMjA2LjAzMzg4NCANCkwgNDc4LjE4MTE1MyAtMjA2LjAzMzg4NCANCkwgNDc4LjAyMTMxOSAtMjA2LjAzMzg4NCANCkwgNDc3Ljg2MTQ4NiAtMjA2LjAzMzg4NCANCkwgNDc3LjcwMTY1MiAtMjA2LjAzMzg4NCANCkwgNDc3LjU0MTgxOCAtMjA2LjAzMzg4NCANCkwgNDc3LjM4MTk4NCAtMjA2LjAzMzg4NCANCkwgNDc3LjIyMjE1IC0yMDYuMDMzODg0IA0KTCA0NzcuMDYyMzE2IC0yMDYuMDMzODg0IA0KTCA0NzYuOTAyNDgyIC0yMDYuMDMzODg0IA0KTCA0NzYuNzQyNjQ4IC0yMDYuMDMzODg0IA0KTCA0NzYuNTgyODE1IC0yMDYuMDMzODg0IA0KTCA0NzYuNDIyOTgxIC0yMDYuMDMzODg0IA0KTCA0NzYuMjYzMTQ3IC0yMDYuMDMzODg0IA0KTCA0NzYuMTAzMzEzIC0yMDYuMDMzODg0IA0KTCA0NzUuOTQzNDc5IC0yMDYuMDMzODg0IA0KTCA0NzUuNzgzNjQ1IC0yMDYuMDMzODg0IA0KTCA0NzUuNjIzODExIC0yMDYuMDMzODg0IA0KTCA0NzUuNDYzOTc3IC0yMDYuMDMzODg0IA0KTCA0NzUuMzA0MTQzIC0yMDYuMDMzODg0IA0KTCA0NzUuMTQ0MzEgLTIwNi4wMzM4ODQgDQpMIDQ3NC45ODQ0NzYgLTIwNi4wMzM4ODQgDQpMIDQ3NC44MjQ2NDIgLTIwNi4wMzM4ODQgDQpMIDQ3NC42NjQ4MDggLTIwNi4wMzM4ODQgDQpMIDQ3NC41MDQ5NzQgLTIwNi4wMzM4ODQgDQpMIDQ3NC4zNDUxNCAtMjA2LjAzMzg4NCANCkwgNDc0LjE4NTMwNiAtMjA2LjAzMzg4NCANCkwgNDc0LjAyNTQ3MiAtMjA2LjAzMzg4NCANCkwgNDczLjg2NTYzOSAtMjA2LjAzMzg4NCANCkwgNDczLjcwNTgwNSAtMjA2LjAzMzg4NCANCkwgNDczLjU0NTk3MSAtMjA2LjAzMzg4NCANCkwgNDczLjM4NjEzNyAtMjA2LjAzMzg4NCANCkwgNDczLjIyNjMwMyAtMjA2LjAzMzg4NCANCkwgNDczLjA2NjQ2OSAtMjA2LjAzMzg4NCANCkwgNDcyLjkwNjYzNSAtMjA2LjAzMzg4NCANCkwgNDcyLjc0NjgwMSAtMjA2LjAzMzg4NCANCkwgNDcyLjU4Njk2NyAtMjA2LjAzMzg4NCANCkwgNDcyLjQyNzEzNCAtMjA2LjAzMzg4NCANCkwgNDcyLjI2NzMgLTIwNi4wMzM4ODQgDQpMIDQ3Mi4xMDc0NjYgLTIwNi4wMzM4ODQgDQpMIDQ3MS45NDc2MzIgLTIwNi4wMzM4ODQgDQpMIDQ3MS43ODc3OTggLTIwNi4wMzM4ODQgDQpMIDQ3MS42Mjc5NjQgLTIwNi4wMzM4ODQgDQpMIDQ3MS40NjgxMyAtMjA2LjAzMzg4NCANCkwgNDcxLjMwODI5NiAtMjA2LjAzMzg4NCANCkwgNDcxLjE0ODQ2MiAtMjA2LjAzMzg4NCANCkwgNDcwLjk4ODYyOSAtMjA2LjAzMzg4NCANCkwgNDcwLjgyODc5NSAtMjA2LjAzMzg4NCANCkwgNDcwLjY2ODk2MSAtMjA2LjAzMzg4NCANCkwgNDcwLjUwOTEyNyAtMjA2LjAzMzg4NCANCkwgNDcwLjM0OTI5MyAtMjA2LjAzMzg4NCANCkwgNDcwLjE4OTQ1OSAtMjA2LjAzMzg4NCANCkwgNDcwLjAyOTYyNSAtMjA2LjAzMzg4NCANCkwgNDY5Ljg2OTc5MSAtMjA2LjAzMzg4NCANCkwgNDY5LjcwOTk1OCAtMjA2LjAzMzg4NCANCkwgNDY5LjU1MDEyNCAtMjA2LjAzMzg4NCANCkwgNDY5LjM5MDI5IC0yMDYuMDMzODg0IA0KTCA0NjkuMjMwNDU2IC0yMDYuMDMzODg0IA0KTCA0NjkuMDcwNjIyIC0yMDYuMDMzODg0IA0KTCA0NjguOTEwNzg4IC0yMDYuMDMzODg0IA0KTCA0NjguNzUwOTU0IC0yMDYuMDMzODg0IA0KTCA0NjguNTkxMTIgLTIwNi4wMzM4ODQgDQpMIDQ2OC40MzEyODYgLTIwNi4wMzM4ODQgDQpMIDQ2OC4yNzE0NTMgLTIwNi4wMzM4ODQgDQpMIDQ2OC4xMTE2MTkgLTIwNi4wMzM4ODQgDQpMIDQ2Ny45NTE3ODUgLTIwNi4wMzM4ODQgDQpMIDQ2Ny43OTE5NTEgLTIwNi4wMzM4ODQgDQpMIDQ2Ny42MzIxMTcgLTIwNi4wMzM4ODQgDQpMIDQ2Ny40NzIyODMgLTIwNi4wMzM4ODQgDQpMIDQ2Ny4zMTI0NDkgLTIwNi4wMzM4ODQgDQpMIDQ2Ny4xNTI2MTUgLTIwNi4wMzM4ODQgDQpMIDQ2Ni45OTI3ODIgLTIwNi4wMzM4ODQgDQpMIDQ2Ni44MzI5NDggLTIwNi4wMzM4ODQgDQpMIDQ2Ni42NzMxMTQgLTIwNi4wMzM4ODQgDQpMIDQ2Ni41MTMyOCAtMjA2LjAzMzg4NCANCkwgNDY2LjM1MzQ0NiAtMjA2LjAzMzg4NCANCkwgNDY2LjE5MzYxMiAtMjA2LjAzMzg4NCANCkwgNDY2LjAzMzc3OCAtMjA2LjAzMzg4NCANCkwgNDY1Ljg3Mzk0NCAtMjA2LjAzMzg4NCANCkwgNDY1LjcxNDExIC0yMDYuMDMzODg0IA0KTCA0NjUuNTU0Mjc3IC0yMDYuMDMzODg0IA0KTCA0NjUuMzk0NDQzIC0yMDYuMDMzODg0IA0KTCA0NjUuMjM0NjA5IC0yMDYuMDMzODg0IA0KTCA0NjUuMDc0Nzc1IC0yMDYuMDMzODg0IA0KTCA0NjQuOTE0OTQxIC0yMDYuMDMzODg0IA0KTCA0NjQuNzU1MTA3IC0yMDYuMDMzODg0IA0KTCA0NjQuNTk1MjczIC0yMDYuMDMzODg0IA0KTCA0NjQuNDM1NDM5IC0yMDYuMDMzODg0IA0KTCA0NjQuMjc1NjA1IC0yMDYuMDMzODg0IA0KTCA0NjQuMTE1NzcyIC0yMDYuMDMzODg0IA0KTCA0NjMuOTU1OTM4IC0yMDYuMDMzODg0IA0KTCA0NjMuNzk2MTA0IC0yMDYuMDMzODg0IA0KTCA0NjMuNjM2MjcgLTIwNi4wMzM4ODQgDQpMIDQ2My40NzY0MzYgLTIwNi4wMzM4ODQgDQpMIDQ2My4zMTY2MDIgLTIwNi4wMzM4ODQgDQpMIDQ2My4xNTY3NjggLTIwNi4wMzM4ODQgDQpMIDQ2Mi45OTY5MzQgLTIwNi4wMzM4ODQgDQpMIDQ2Mi44MzcxMDEgLTIwNi4wMzM4ODQgDQpMIDQ2Mi42NzcyNjcgLTIwNi4wMzM4ODQgDQpMIDQ2Mi41MTc0MzMgLTIwNi4wMzM4ODQgDQpMIDQ2Mi4zNTc1OTkgLTIwNi4wMzM4ODQgDQpMIDQ2Mi4xOTc3NjUgLTIwNi4wMzM4ODQgDQpMIDQ2Mi4wMzc5MzEgLTIwNi4wMzM4ODQgDQpMIDQ2MS44NzgwOTcgLTIwNi4wMzM4ODQgDQpMIDQ2MS43MTgyNjMgLTIwNi4wMzM4ODQgDQpMIDQ2MS41NTg0MjkgLTIwNi4wMzM4ODQgDQpMIDQ2MS4zOTg1OTYgLTIwNi4wMzM4ODQgDQpMIDQ2MS4yMzg3NjIgLTIwNi4wMzM4ODQgDQpMIDQ2MS4wNzg5MjggLTIwNi4wMzM4ODQgDQpMIDQ2MC45MTkwOTQgLTIwNi4wMzM4ODQgDQpMIDQ2MC43NTkyNiAtMjA2LjAzMzg4NCANCkwgNDYwLjU5OTQyNiAtMjA2LjAzMzg4NCANCkwgNDYwLjQzOTU5MiAtMjA2LjAzMzg4NCANCkwgNDYwLjI3OTc1OCAtMjA2LjAzMzg4NCANCkwgNDYwLjExOTkyNCAtMjA2LjAzMzg4NCANCkwgNDU5Ljk2MDA5MSAtMjA2LjAzMzg4NCANCkwgNDU5LjgwMDI1NyAtMjA2LjAzMzg4NCANCkwgNDU5LjY0MDQyMyAtMjA2LjAzMzg4NCANCkwgNDU5LjQ4MDU4OSAtMjA2LjAzMzg4NCANCkwgNDU5LjMyMDc1NSAtMjA2LjAzMzg4NCANCkwgNDU5LjE2MDkyMSAtMjA2LjAzMzg4NCANCkwgNDU5LjAwMTA4NyAtMjA2LjAzMzg4NCANCkwgNDU4Ljg0MTI1MyAtMjA2LjAzMzg4NCANCkwgNDU4LjY4MTQyIC0yMDYuMDMzODg0IA0KTCA0NTguNTIxNTg2IC0yMDYuMDMzODg0IA0KTCA0NTguMzYxNzUyIC0yMDYuMDMzODg0IA0KTCA0NTguMjAxOTE4IC0yMDYuMDMzODg0IA0KTCA0NTguMDQyMDg0IC0yMDYuMDMzODg0IA0KTCA0NTcuODgyMjUgLTIwNi4wMzM4ODQgDQpMIDQ1Ny43MjI0MTYgLTIwNi4wMzM4ODQgDQpMIDQ1Ny41NjI1ODIgLTIwNi4wMzM4ODQgDQpMIDQ1Ny40MDI3NDggLTIwNi4wMzM4ODQgDQpMIDQ1Ny4yNDI5MTUgLTIwNi4wMzM4ODQgDQpMIDQ1Ny4wODMwODEgLTIwNi4wMzM4ODQgDQpMIDQ1Ni45MjMyNDcgLTIwNi4wMzM4ODQgDQpMIDQ1Ni43NjM0MTMgLTIwNi4wMzM4ODQgDQpMIDQ1Ni42MDM1NzkgLTIwNi4wMzM4ODQgDQpMIDQ1Ni40NDM3NDUgLTIwNi4wMzM4ODQgDQpMIDQ1Ni4yODM5MTEgLTIwNi4wMzM4ODQgDQpMIDQ1Ni4xMjQwNzcgLTIwNi4wMzM4ODQgDQpMIDQ1NS45NjQyNDQgLTIwNi4wMzM4ODQgDQpMIDQ1NS44MDQ0MSAtMjA2LjAzMzg4NCANCkwgNDU1LjY0NDU3NiAtMjA2LjAzMzg4NCANCkwgNDU1LjQ4NDc0MiAtMjA2LjAzMzg4NCANCkwgNDU1LjMyNDkwOCAtMjA2LjAzMzg4NCANCkwgNDU1LjE2NTA3NCAtMjA2LjAzMzg4NCANCkwgNDU1LjAwNTI0IC0yMDYuMDMzODg0IA0KTCA0NTQuODQ1NDA2IC0yMDYuMDMzODg0IA0KTCA0NTQuNjg1NTcyIC0yMDYuMDMzODg0IA0KTCA0NTQuNTI1NzM5IC0yMDYuMDMzODg0IA0KTCA0NTQuMzY1OTA1IC0yMDYuMDMzODg0IA0KTCA0NTQuMjA2MDcxIC0yMDYuMDMzODg0IA0KTCA0NTQuMDQ2MjM3IC0yMDYuMDMzODg0IA0KTCA0NTMuODg2NDAzIC0yMDYuMDMzODg0IA0KTCA0NTMuNzI2NTY5IC0yMDYuMDMzODg0IA0KTCA0NTMuNTY2NzM1IC0yMDYuMDMzODg0IA0KTCA0NTMuNDA2OTAxIC0yMDYuMDMzODg0IA0KTCA0NTMuMjQ3MDY3IC0yMDYuMDMzODg0IA0KTCA0NTMuMDg3MjM0IC0yMDYuMDMzODg0IA0KTCA0NTIuOTI3NCAtMjA2LjAzMzg4NCANCkwgNDUyLjc2NzU2NiAtMjA2LjAzMzg4NCANCkwgNDUyLjYwNzczMiAtMjA2LjAzMzg4NCANCkwgNDUyLjQ0Nzg5OCAtMjA2LjAzMzg4NCANCkwgNDUyLjI4ODA2NCAtMjA2LjAzMzg4NCANCkwgNDUyLjEyODIzIC0yMDYuMDMzODg0IA0KTCA0NTEuOTY4Mzk2IC0yMDYuMDMzODg0IA0KTCA0NTEuODA4NTYzIC0yMDYuMDMzODg0IA0KTCA0NTEuNjQ4NzI5IC0yMDYuMDMzODg0IA0KTCA0NTEuNDg4ODk1IC0yMDYuMDMzODg0IA0KTCA0NTEuMzI5MDYxIC0yMDYuMDMzODg0IA0KTCA0NTEuMTY5MjI3IC0yMDYuMDMzODg0IA0KTCA0NTEuMDA5MzkzIC0yMDYuMDMzODg0IA0KTCA0NTAuODQ5NTU5IC0yMDYuMDMzODg0IA0KTCA0NTAuNjg5NzI1IC0yMDYuMDMzODg0IA0KTCA0NTAuNTI5ODkxIC0yMDYuMDMzODg0IA0KTCA0NTAuMzcwMDU4IC0yMDYuMDMzODg0IA0KTCA0NTAuMjEwMjI0IC0yMDYuMDMzODg0IA0KTCA0NTAuMDUwMzkgLTIwNi4wMzM4ODQgDQpMIDQ0OS44OTA1NTYgLTIwNi4wMzM4ODQgDQpMIDQ0OS43MzA3MjIgLTIwNi4wMzM4ODQgDQpMIDQ0OS41NzA4ODggLTIwNi4wMzM4ODQgDQpMIDQ0OS40MTEwNTQgLTIwNi4wMzM4ODQgDQpMIDQ0OS4yNTEyMiAtMjA2LjAzMzg4NCANCkwgNDQ5LjA5MTM4NyAtMjA2LjAzMzg4NCANCkwgNDQ4LjkzMTU1MyAtMjA2LjAzMzg4NCANCkwgNDQ4Ljc3MTcxOSAtMjA2LjAzMzg4NCANCkwgNDQ4LjYxMTg4NSAtMjA2LjAzMzg4NCANCkwgNDQ4LjQ1MjA1MSAtMjA2LjAzMzg4NCANCkwgNDQ4LjI5MjIxNyAtMjA2LjAzMzg4NCANCkwgNDQ4LjEzMjM4MyAtMjA2LjAzMzg4NCANCkwgNDQ3Ljk3MjU0OSAtMjA2LjAzMzg4NCANCkwgNDQ3LjgxMjcxNSAtMjA2LjAzMzg4NCANCkwgNDQ3LjY1Mjg4MiAtMjA2LjAzMzg4NCANCkwgNDQ3LjQ5MzA0OCAtMjA2LjAzMzg4NCANCkwgNDQ3LjMzMzIxNCAtMjA2LjAzMzg4NCANCkwgNDQ3LjE3MzM4IC0yMDYuMDMzODg0IA0KTCA0NDcuMDEzNTQ2IC0yMDYuMDMzODg0IA0KTCA0NDYuODUzNzEyIC0yMDYuMDMzODg0IA0KTCA0NDYuNjkzODc4IC0yMDYuMDMzODg0IA0KTCA0NDYuNTM0MDQ0IC0yMDYuMDMzODg0IA0KTCA0NDYuMzc0MjEgLTIwNi4wMzM4ODQgDQpMIDQ0Ni4yMTQzNzcgLTIwNi4wMzM4ODQgDQpMIDQ0Ni4wNTQ1NDMgLTIwNi4wMzM4ODQgDQpMIDQ0NS44OTQ3MDkgLTIwNi4wMzM4ODQgDQpMIDQ0NS43MzQ4NzUgLTIwNi4wMzM4ODQgDQpMIDQ0NS41NzUwNDEgLTIwNi4wMzM4ODQgDQpMIDQ0NS40MTUyMDcgLTIwNi4wMzM4ODQgDQpMIDQ0NS4yNTUzNzMgLTIwNi4wMzM4ODQgDQpMIDQ0NS4wOTU1MzkgLTIwNi4wMzM4ODQgDQpMIDQ0NC45MzU3MDYgLTIwNi4wMzM4ODQgDQpMIDQ0NC43NzU4NzIgLTIwNi4wMzM4ODQgDQpMIDQ0NC42MTYwMzggLTIwNi4wMzM4ODQgDQpMIDQ0NC40NTYyMDQgLTIwNi4wMzM4ODQgDQpMIDQ0NC4yOTYzNyAtMjA2LjAzMzg4NCANCkwgNDQ0LjEzNjUzNiAtMjA2LjAzMzg4NCANCkwgNDQzLjk3NjcwMiAtMjA2LjAzMzg4NCANCkwgNDQzLjgxNjg2OCAtMjA2LjAzMzg4NCANCkwgNDQzLjY1NzAzNCAtMjA2LjAzMzg4NCANCkwgNDQzLjQ5NzIwMSAtMjA2LjAzMzg4NCANCkwgNDQzLjMzNzM2NyAtMjA2LjAzMzg4NCANCkwgNDQzLjE3NzUzMyAtMjA2LjAzMzg4NCANCkwgNDQzLjAxNzY5OSAtMjA2LjAzMzg4NCANCkwgNDQyLjg1Nzg2NSAtMjA2LjAzMzg4NCANCkwgNDQyLjY5ODAzMSAtMjA2LjAzMzg4NCANCkwgNDQyLjUzODE5NyAtMjA2LjAzMzg4NCANCkwgNDQyLjM3ODM2MyAtMjA2LjAzMzg4NCANCkwgNDQyLjIxODUyOSAtMjA2LjAzMzg4NCANCkwgNDQyLjA1ODY5NiAtMjA2LjAzMzg4NCANCkwgNDQxLjg5ODg2MiAtMjA2LjAzMzg4NCANCkwgNDQxLjczOTAyOCAtMjA2LjAzMzg4NCANCkwgNDQxLjU3OTE5NCAtMjA2LjAzMzg4NCANCkwgNDQxLjQxOTM2IC0yMDYuMDMzODg0IA0KTCA0NDEuMjU5NTI2IC0yMDYuMDMzODg0IA0KTCA0NDEuMDk5NjkyIC0yMDYuMDMzODg0IA0KTCA0NDAuOTM5ODU4IC0yMDYuMDMzODg0IA0KTCA0NDAuNzgwMDI1IC0yMDYuMDMzODg0IA0KTCA0NDAuNjIwMTkxIC0yMDYuMDMzODg0IA0KTCA0NDAuNDYwMzU3IC0yMDYuMDMzODg0IA0KTCA0NDAuMzAwNTIzIC0yMDYuMDMzODg0IA0KTCA0NDAuMTQwNjg5IC0yMDYuMDMzODg0IA0KTCA0MzkuOTgwODU1IC0yMDYuMDMzODg0IA0KTCA0MzkuODIxMDIxIC0yMDYuMDMzODg0IA0KTCA0MzkuNjYxMTg3IC0yMDYuMDMzODg0IA0KTCA0MzkuNTAxMzUzIC0yMDYuMDMzODg0IA0KTCA0MzkuMzQxNTIgLTIwNi4wMzM4ODQgDQpMIDQzOS4xODE2ODYgLTIwNi4wMzM4ODQgDQpMIDQzOS4wMjE4NTIgLTIwNi4wMzM4ODQgDQpMIDQzOC44NjIwMTggLTIwNi4wMzM4ODQgDQpMIDQzOC43MDIxODQgLTIwNi4wMzM4ODQgDQpMIDQzOC41NDIzNSAtMjA2LjAzMzg4NCANCkwgNDM4LjM4MjUxNiAtMjA2LjAzMzg4NCANCkwgNDM4LjIyMjY4MiAtMjA2LjAzMzg4NCANCkwgNDM4LjA2Mjg0OSAtMjA2LjAzMzg4NCANCkwgNDM3LjkwMzAxNSAtMjA2LjAzMzg4NCANCkwgNDM3Ljc0MzE4MSAtMjA2LjAzMzg4NCANCkwgNDM3LjU4MzM0NyAtMjA2LjAzMzg4NCANCkwgNDM3LjQyMzUxMyAtMjA2LjAzMzg4NCANCkwgNDM3LjI2MzY3OSAtMjA2LjAzMzg4NCANCkwgNDM3LjEwMzg0NSAtMjA2LjAzMzg4NCANCkwgNDM2Ljk0NDAxMSAtMjA2LjAzMzg4NCANCkwgNDM2Ljc4NDE3NyAtMjA2LjAzMzg4NCANCkwgNDM2LjYyNDM0NCAtMjA2LjAzMzg4NCANCkwgNDM2LjQ2NDUxIC0yMDYuMDMzODg0IA0KTCA0MzYuMzA0Njc2IC0yMDYuMDMzODg0IA0KTCA0MzYuMTQ0ODQyIC0yMDYuMDMzODg0IA0KTCA0MzUuOTg1MDA4IC0yMDYuMDMzODg0IA0KTCA0MzUuODI1MTc0IC0yMDYuMDMzODg0IA0KTCA0MzUuNjY1MzQgLTIwNi4wMzM4ODQgDQpMIDQzNS41MDU1MDYgLTIwNi4wMzM4ODQgDQpMIDQzNS4zNDU2NzIgLTIwNi4wMzM4ODQgDQpMIDQzNS4xODU4MzkgLTIwNi4wMzM4ODQgDQpMIDQzNS4wMjYwMDUgLTIwNi4wMzM4ODQgDQpMIDQzNC44NjYxNzEgLTIwNi4wMzM4ODQgDQpMIDQzNC43MDYzMzcgLTIwNi4wMzM4ODQgDQpMIDQzNC41NDY1MDMgLTIwNi4wMzM4ODQgDQpMIDQzNC4zODY2NjkgLTIwNi4wMzM4ODQgDQpMIDQzNC4yMjY4MzUgLTIwNi4wMzM4ODQgDQpMIDQzNC4wNjcwMDEgLTIwNi4wMzM4ODQgDQpMIDQzMy45MDcxNjggLTIwNi4wMzM4ODQgDQpMIDQzMy43NDczMzQgLTIwNi4wMzM4ODQgDQpMIDQzMy41ODc1IC0yMDYuMDMzODg0IA0KTCA0MzMuNDI3NjY2IC0yMDYuMDMzODg0IA0KTCA0MzMuMjY3ODMyIC0yMDYuMDMzODg0IA0KTCA0MzMuMTA3OTk4IC0yMDYuMDMzODg0IA0KTCA0MzIuOTQ4MTY0IC0yMDYuMDMzODg0IA0KTCA0MzIuNzg4MzMgLTIwNi4wMzM4ODQgDQpMIDQzMi42Mjg0OTYgLTIwNi4wMzM4ODQgDQpMIDQzMi40Njg2NjMgLTIwNi4wMzM4ODQgDQpMIDQzMi4zMDg4MjkgLTIwNi4wMzM4ODQgDQpMIDQzMi4xNDg5OTUgLTIwNi4wMzM4ODQgDQpMIDQzMS45ODkxNjEgLTIwNi4wMzM4ODQgDQpMIDQzMS44MjkzMjcgLTIwNi4wMzM4ODQgDQpMIDQzMS42Njk0OTMgLTIwNi4wMzM4ODQgDQpMIDQzMS41MDk2NTkgLTIwNi4wMzM4ODQgDQpMIDQzMS4zNDk4MjUgLTIwNi4wMzM4ODQgDQpMIDQzMS4xODk5OTIgLTIwNi4wMzM4ODQgDQpMIDQzMS4wMzAxNTggLTIwNi4wMzM4ODQgDQpMIDQzMC44NzAzMjQgLTIwNi4wMzM4ODQgDQpMIDQzMC43MTA0OSAtMjA2LjAzMzg4NCANCkwgNDMwLjU1MDY1NiAtMjA2LjAzMzg4NCANCkwgNDMwLjM5MDgyMiAtMjA2LjAzMzg4NCANCkwgNDMwLjIzMDk4OCAtMjA2LjAzMzg4NCANCkwgNDMwLjA3MTE1NCAtMjA2LjAzMzg4NCANCkwgNDI5LjkxMTMyIC0yMDYuMDMzODg0IA0KTCA0MjkuNzUxNDg3IC0yMDYuMDMzODg0IA0KTCA0MjkuNTkxNjUzIC0yMDYuMDMzODg0IA0KTCA0MjkuNDMxODE5IC0yMDYuMDMzODg0IA0KTCA0MjkuMjcxOTg1IC0yMDYuMDMzODg0IA0KTCA0MjkuMTEyMTUxIC0yMDYuMDMzODg0IA0KTCA0MjguOTUyMzE3IC0yMDYuMDMzODg0IA0KTCA0MjguNzkyNDgzIC0yMDYuMDMzODg0IA0KTCA0MjguNjMyNjQ5IC0yMDYuMDMzODg0IA0KTCA0MjguNDcyODE1IC0yMDYuMDMzODg0IA0KTCA0MjguMzEyOTgyIC0yMDYuMDMzODg0IA0KTCA0MjguMTUzMTQ4IC0yMDYuMDMzODg0IA0KTCA0MjcuOTkzMzE0IC0yMDYuMDMzODg0IA0KTCA0MjcuODMzNDggLTIwNi4wMzM4ODQgDQpMIDQyNy42NzM2NDYgLTIwNi4wMzM4ODQgDQpMIDQyNy41MTM4MTIgLTIwNi4wMzM4ODQgDQpMIDQyNy4zNTM5NzggLTIwNi4wMzM4ODQgDQpMIDQyNy4xOTQxNDQgLTIwNi4wMzM4ODQgDQpMIDQyNy4wMzQzMTEgLTIwNi4wMzM4ODQgDQpMIDQyNi44NzQ0NzcgLTIwNi4wMzM4ODQgDQpMIDQyNi43MTQ2NDMgLTIwNi4wMzM4ODQgDQpMIDQyNi41NTQ4MDkgLTIwNi4wMzM4ODQgDQpMIDQyNi4zOTQ5NzUgLTIwNi4wMzM4ODQgDQpMIDQyNi4yMzUxNDEgLTIwNi4wMzM4ODQgDQpMIDQyNi4wNzUzMDcgLTIwNi4wMzM4ODQgDQpMIDQyNS45MTU0NzMgLTIwNi4wMzM4ODQgDQpMIDQyNS43NTU2MzkgLTIwNi4wMzM4ODQgDQpMIDQyNS41OTU4MDYgLTIwNi4wMzM4ODQgDQpMIDQyNS40MzU5NzIgLTIwNi4wMzM4ODQgDQpMIDQyNS4yNzYxMzggLTIwNi4wMzM4ODQgDQpMIDQyNS4xMTYzMDQgLTIwNi4wMzM4ODQgDQpMIDQyNC45NTY0NyAtMjA2LjAzMzg4NCANCkwgNDI0Ljc5NjYzNiAtMjA2LjAzMzg4NCANCkwgNDI0LjYzNjgwMiAtMjA2LjAzMzg4NCANCkwgNDI0LjQ3Njk2OCAtMjA2LjAzMzg4NCANCkwgNDI0LjMxNzEzNCAtMjA2LjAzMzg4NCANCkwgNDI0LjE1NzMwMSAtMjA2LjAzMzg4NCANCkwgNDIzLjk5NzQ2NyAtMjA2LjAzMzg4NCANCkwgNDIzLjgzNzYzMyAtMjA2LjAzMzg4NCANCkwgNDIzLjY3Nzc5OSAtMjA2LjAzMzg4NCANCkwgNDIzLjUxNzk2NSAtMjA2LjAzMzg4NCANCkwgNDIzLjM1ODEzMSAtMjA2LjAzMzg4NCANCkwgNDIzLjE5ODI5NyAtMjA2LjAzMzg4NCANCkwgNDIzLjAzODQ2MyAtMjA2LjAzMzg4NCANCkwgNDIyLjg3ODYzIC0yMDYuMDMzODg0IA0KTCA0MjIuNzE4Nzk2IC0yMDYuMDMzODg0IA0KTCA0MjIuNTU4OTYyIC0yMDYuMDMzODg0IA0KTCA0MjIuMzk5MTI4IC0yMDYuMDMzODg0IA0KTCA0MjIuMjM5Mjk0IC0yMDYuMDMzODg0IA0KTCA0MjIuMDc5NDYgLTIwNi4wMzM4ODQgDQpMIDQyMS45MTk2MjYgLTIwNi4wMzM4ODQgDQpMIDQyMS43NTk3OTIgLTIwNi4wMzM4ODQgDQpMIDQyMS41OTk5NTggLTIwNi4wMzM4ODQgDQpMIDQyMS40NDAxMjUgLTIwNi4wMzM4ODQgDQpMIDQyMS4yODAyOTEgLTIwNi4wMzM4ODQgDQpMIDQyMS4xMjA0NTcgLTIwNi4wMzM4ODQgDQpMIDQyMC45NjA2MjMgLTIwNi4wMzM4ODQgDQpMIDQyMC44MDA3ODkgLTIwNi4wMzM4ODQgDQpMIDQyMC42NDA5NTUgLTIwNi4wMzM4ODQgDQpMIDQyMC40ODExMjEgLTIwNi4wMzM4ODQgDQpMIDQyMC4zMjEyODcgLTIwNi4wMzM4ODQgDQpMIDQyMC4xNjE0NTQgLTIwNi4wMzM4ODQgDQpMIDQyMC4wMDE2MiAtMjA2LjAzMzg4NCANCkwgNDE5Ljg0MTc4NiAtMjA2LjAzMzg4NCANCkwgNDE5LjY4MTk1MiAtMjA2LjAzMzg4NCANCkwgNDE5LjUyMjExOCAtMjA2LjAzMzg4NCANCkwgNDE5LjM2MjI4NCAtMjA2LjAzMzg4NCANCkwgNDE5LjIwMjQ1IC0yMDYuMDMzODg0IA0KTCA0MTkuMDQyNjE2IC0yMDYuMDMzODg0IA0KTCA0MTguODgyNzgyIC0yMDYuMDMzODg0IA0KTCA0MTguNzIyOTQ5IC0yMDYuMDMzODg0IA0KTCA0MTguNTYzMTE1IC0yMDYuMDMzODg0IA0KTCA0MTguNDAzMjgxIC0yMDYuMDMzODg0IA0KTCA0MTguMjQzNDQ3IC0yMDYuMDMzODg0IA0KTCA0MTguMDgzNjEzIC0yMDYuMDMzODg0IA0KTCA0MTcuOTIzNzc5IC0yMDYuMDMzODg0IA0KTCA0MTcuNzYzOTQ1IC0yMDYuMDMzODg0IA0KTCA0MTcuNjA0MTExIC0yMDYuMDMzODg0IA0KTCA0MTcuNDQ0Mjc3IC0yMDYuMDMzODg0IA0KTCA0MTcuMjg0NDQ0IC0yMDYuMDMzODg0IA0KTCA0MTcuMTI0NjEgLTIwNi4wMzM4ODQgDQpMIDQxNi45NjQ3NzYgLTIwNi4wMzM4ODQgDQpMIDQxNi44MDQ5NDIgLTIwNi4wMzM4ODQgDQpMIDQxNi42NDUxMDggLTIwNi4wMzM4ODQgDQpMIDQxNi40ODUyNzQgLTIwNi4wMzM4ODQgDQpMIDQxNi4zMjU0NCAtMjA2LjAzMzg4NCANCkwgNDE2LjE2NTYwNiAtMjA2LjAzMzg4NCANCkwgNDE2LjAwNTc3MyAtMjA2LjAzMzg4NCANCkwgNDE1Ljg0NTkzOSAtMjA2LjAzMzg4NCANCkwgNDE1LjY4NjEwNSAtMjA2LjAzMzg4NCANCkwgNDE1LjUyNjI3MSAtMjA2LjAzMzg4NCANCkwgNDE1LjM2NjQzNyAtMjA2LjAzMzg4NCANCkwgNDE1LjIwNjYwMyAtMjA2LjAzMzg4NCANCkwgNDE1LjA0Njc2OSAtMjA2LjAzMzg4NCANCkwgNDE0Ljg4NjkzNSAtMjA2LjAzMzg4NCANCkwgNDE0LjcyNzEwMSAtMjA2LjAzMzg4NCANCkwgNDE0LjU2NzI2OCAtMjA2LjAzMzg4NCANCkwgNDE0LjQwNzQzNCAtMjA2LjAzMzg4NCANCkwgNDE0LjI0NzYgLTIwNi4wMzM4ODQgDQpMIDQxNC4wODc3NjYgLTIwNi4wMzM4ODQgDQpMIDQxMy45Mjc5MzIgLTIwNi4wMzM4ODQgDQpMIDQxMy43NjgwOTggLTIwNi4wMzM4ODQgDQpMIDQxMy42MDgyNjQgLTIwNi4wMzM4ODQgDQpMIDQxMy40NDg0MyAtMjA2LjAzMzg4NCANCkwgNDEzLjI4ODU5NyAtMjA2LjAzMzg4NCANCkwgNDEzLjEyODc2MyAtMjA2LjAzMzg4NCANCkwgNDEyLjk2ODkyOSAtMjA2LjAzMzg4NCANCkwgNDEyLjgwOTA5NSAtMjA2LjAzMzg4NCANCkwgNDEyLjY0OTI2MSAtMjA2LjAzMzg4NCANCkwgNDEyLjQ4OTQyNyAtMjA2LjAzMzg4NCANCkwgNDEyLjMyOTU5MyAtMjA2LjAzMzg4NCANCkwgNDEyLjE2OTc1OSAtMjA2LjAzMzg4NCANCkwgNDEyLjAwOTkyNSAtMjA2LjAzMzg4NCANCkwgNDExLjg1MDA5MiAtMjA2LjAzMzg4NCANCkwgNDExLjY5MDI1OCAtMjA2LjAzMzg4NCANCkwgNDExLjUzMDQyNCAtMjA2LjAzMzg4NCANCkwgNDExLjM3MDU5IC0yMDYuMDMzODg0IA0KTCA0MTEuMjEwNzU2IC0yMDYuMDMzODg0IA0KTCA0MTEuMDUwOTIyIC0yMDYuMDMzODg0IA0KTCA0MTAuODkxMDg4IC0yMDYuMDMzODg0IA0KTCA0MTAuNzMxMjU0IC0yMDYuMDMzODg0IA0KTCA0MTAuNTcxNDIgLTIwNi4wMzM4ODQgDQpMIDQxMC40MTE1ODcgLTIwNi4wMzM4ODQgDQpMIDQxMC4yNTE3NTMgLTIwNi4wMzM4ODQgDQpMIDQxMC4wOTE5MTkgLTIwNi4wMzM4ODQgDQpMIDQwOS45MzIwODUgLTIwNi4wMzM4ODQgDQpMIDQwOS43NzIyNTEgLTIwNi4wMzM4ODQgDQpMIDQwOS42MTI0MTcgLTIwNi4wMzM4ODQgDQpMIDQwOS40NTI1ODMgLTIwNi4wMzM4ODQgDQpMIDQwOS4yOTI3NDkgLTIwNi4wMzM4ODQgDQpMIDQwOS4xMzI5MTYgLTIwNi4wMzM4ODQgDQpMIDQwOC45NzMwODIgLTIwNi4wMzM4ODQgDQpMIDQwOC44MTMyNDggLTIwNi4wMzM4ODQgDQpMIDQwOC42NTM0MTQgLTIwNi4wMzM4ODQgDQpMIDQwOC40OTM1OCAtMjA2LjAzMzg4NCANCkwgNDA4LjMzMzc0NiAtMjA2LjAzMzg4NCANCkwgNDA4LjE3MzkxMiAtMjA2LjAzMzg4NCANCkwgNDA4LjAxNDA3OCAtMjA2LjAzMzg4NCANCkwgNDA3Ljg1NDI0NCAtMjA2LjAzMzg4NCANCkwgNDA3LjY5NDQxMSAtMjA2LjAzMzg4NCANCkwgNDA3LjUzNDU3NyAtMjA2LjAzMzg4NCANCkwgNDA3LjM3NDc0MyAtMjA2LjAzMzg4NCANCkwgNDA3LjIxNDkwOSAtMjA2LjAzMzg4NCANCkwgNDA3LjA1NTA3NSAtMjA2LjAzMzg4NCANCkwgNDA2Ljg5NTI0MSAtMjA2LjAzMzg4NCANCkwgNDA2LjczNTQwNyAtMjA2LjAzMzg4NCANCkwgNDA2LjU3NTU3MyAtMjA2LjAzMzg4NCANCkwgNDA2LjQxNTczOSAtMjA2LjAzMzg4NCANCkwgNDA2LjI1NTkwNiAtMjA2LjAzMzg4NCANCkwgNDA2LjA5NjA3MiAtMjA2LjAzMzg4NCANCkwgNDA1LjkzNjIzOCAtMjA2LjAzMzg4NCANCkwgNDA1Ljc3NjQwNCAtMjA2LjAzMzg4NCANCkwgNDA1LjYxNjU3IC0yMDYuMDMzODg0IA0KTCA0MDUuNDU2NzM2IC0yMDYuMDMzODg0IA0KTCA0MDUuMjk2OTAyIC0yMDYuMDMzODg0IA0KTCA0MDUuMTM3MDY4IC0yMDYuMDMzODg0IA0KTCA0MDQuOTc3MjM1IC0yMDYuMDMzODg0IA0KTCA0MDQuODE3NDAxIC0yMDYuMDMzODg0IA0KTCA0MDQuNjU3NTY3IC0yMDYuMDMzODg0IA0KTCA0MDQuNDk3NzMzIC0yMDYuMDMzODg0IA0KTCA0MDQuMzM3ODk5IC0yMDYuMDMzODg0IA0KTCA0MDQuMTc4MDY1IC0yMDYuMDMzODg0IA0KTCA0MDQuMDE4MjMxIC0yMDYuMDMzODg0IA0KTCA0MDMuODU4Mzk3IC0yMDYuMDMzODg0IA0KTCA0MDMuNjk4NTYzIC0yMDYuMDMzODg0IA0KTCA0MDMuNTM4NzMgLTIwNi4wMzM4ODQgDQpMIDQwMy4zNzg4OTYgLTIwNi4wMzM4ODQgDQpMIDQwMy4yMTkwNjIgLTIwNi4wMzM4ODQgDQpMIDQwMy4wNTkyMjggLTIwNi4wMzM4ODQgDQpMIDQwMi44OTkzOTQgLTIwNi4wMzM4ODQgDQpMIDQwMi43Mzk1NiAtMjA2LjAzMzg4NCANCkwgNDAyLjU3OTcyNiAtMjA2LjAzMzg4NCANCkwgNDAyLjQxOTg5MiAtMjA2LjAzMzg4NCANCkwgNDAyLjI2MDA1OSAtMjA2LjAzMzg4NCANCkwgNDAyLjEwMDIyNSAtMjA2LjAzMzg4NCANCkwgNDAxLjk0MDM5MSAtMjA2LjAzMzg4NCANCkwgNDAxLjc4MDU1NyAtMjA2LjAzMzg4NCANCkwgNDAxLjYyMDcyMyAtMjA2LjAzMzg4NCANCkwgNDAxLjQ2MDg4OSAtMjA2LjAzMzg4NCANCkwgNDAxLjMwMTA1NSAtMjA2LjAzMzg4NCANCkwgNDAxLjE0MTIyMSAtMjA2LjAzMzg4NCANCkwgNDAwLjk4MTM4NyAtMjA2LjAzMzg4NCANCkwgNDAwLjgyMTU1NCAtMjA2LjAzMzg4NCANCkwgNDAwLjY2MTcyIC0yMDYuMDMzODg0IA0KTCA0MDAuNTAxODg2IC0yMDYuMDMzODg0IA0KTCA0MDAuMzQyMDUyIC0yMDYuMDMzODg0IA0KTCA0MDAuMTgyMjE4IC0yMDYuMDMzODg0IA0KTCA0MDAuMDIyMzg0IC0yMDYuMDMzODg0IA0KTCAzOTkuODYyNTUgLTIwNi4wMzM4ODQgDQpMIDM5OS43MDI3MTYgLTIwNi4wMzM4ODQgDQpMIDM5OS41NDI4ODIgLTIwNi4wMzM4ODQgDQpMIDM5OS4zODMwNDkgLTIwNi4wMzM4ODQgDQpMIDM5OS4yMjMyMTUgLTIwNi4wMzM4ODQgDQpMIDM5OS4wNjMzODEgLTIwNi4wMzM4ODQgDQpMIDM5OC45MDM1NDcgLTIwNi4wMzM4ODQgDQpMIDM5OC43NDM3MTMgLTIwNi4wMzM4ODQgDQpMIDM5OC41ODM4NzkgLTIwNi4wMzM4ODQgDQpMIDM5OC40MjQwNDUgLTIwNi4wMzM4ODQgDQpMIDM5OC4yNjQyMTEgLTIwNi4wMzM4ODQgDQpMIDM5OC4xMDQzNzggLTIwNi4wMzM4ODQgDQpMIDM5Ny45NDQ1NDQgLTIwNi4wMzM4ODQgDQpMIDM5Ny43ODQ3MSAtMjA2LjAzMzg4NCANCkwgMzk3LjYyNDg3NiAtMjA2LjAzMzg4NCANCkwgMzk3LjQ2NTA0MiAtMjA2LjAzMzg4NCANCkwgMzk3LjMwNTIwOCAtMjA2LjAzMzg4NCANCkwgMzk3LjE0NTM3NCAtMjA2LjAzMzg4NCANCkwgMzk2Ljk4NTU0IC0yMDYuMDMzODg0IA0KTCAzOTYuODI1NzA2IC0yMDYuMDMzODg0IA0KTCAzOTYuNjY1ODczIC0yMDYuMDMzODg0IA0KTCAzOTYuNTA2MDM5IC0yMDYuMDMzODg0IA0KTCAzOTYuMzQ2MjA1IC0yMDYuMDMzODg0IA0KTCAzOTYuMTg2MzcxIC0yMDYuMDMzODg0IA0KTCAzOTYuMDI2NTM3IC0yMDYuMDMzODg0IA0KTCAzOTUuODY2NzAzIC0yMDYuMDMzODg0IA0KTCAzOTUuNzA2ODY5IC0yMDYuMDMzODg0IA0KTCAzOTUuNTQ3MDM1IC0yMDYuMDMzODg0IA0KTCAzOTUuMzg3MjAyIC0yMDYuMDMzODg0IA0KTCAzOTUuMjI3MzY4IC0yMDYuMDMzODg0IA0KTCAzOTUuMDY3NTM0IC0yMDYuMDMzODg0IA0KTCAzOTQuOTA3NyAtMjA2LjAzMzg4NCANCkwgMzk0Ljc0Nzg2NiAtMjA2LjAzMzg4NCANCkwgMzk0LjU4ODAzMiAtMjA2LjAzMzg4NCANCkwgMzk0LjQyODE5OCAtMjA2LjAzMzg4NCANCkwgMzk0LjI2ODM2NCAtMjA2LjAzMzg4NCANCkwgMzk0LjEwODUzIC0yMDYuMDMzODg0IA0KTCAzOTMuOTQ4Njk3IC0yMDYuMDMzODg0IA0KTCAzOTMuNzg4ODYzIC0yMDYuMDMzODg0IA0KTCAzOTMuNjI5MDI5IC0yMDYuMDMzODg0IA0KTCAzOTMuNDY5MTk1IC0yMDYuMDMzODg0IA0KTCAzOTMuMzA5MzYxIC0yMDYuMDMzODg0IA0KTCAzOTMuMTQ5NTI3IC0yMDYuMDMzODg0IA0KTCAzOTIuOTg5NjkzIC0yMDYuMDMzODg0IA0KTCAzOTIuODI5ODU5IC0yMDYuMDMzODg0IA0KTCAzOTIuNjcwMDI1IC0yMDYuMDMzODg0IA0KTCAzOTIuNTEwMTkyIC0yMDYuMDMzODg0IA0KTCAzOTIuMzUwMzU4IC0yMDYuMDMzODg0IA0KTCAzOTIuMTkwNTI0IC0yMDYuMDMzODg0IA0KTCAzOTIuMDMwNjkgLTIwNi4wMzM4ODQgDQpMIDM5MS44NzA4NTYgLTIwNi4wMzM4ODQgDQpMIDM5MS43MTEwMjIgLTIwNi4wMzM4ODQgDQpMIDM5MS41NTExODggLTIwNi4wMzM4ODQgDQpMIDM5MS4zOTEzNTQgLTIwNi4wMzM4ODQgDQpMIDM5MS4yMzE1MjEgLTIwNi4wMzM4ODQgDQpMIDM5MS4wNzE2ODcgLTIwNi4wMzM4ODQgDQpMIDM5MC45MTE4NTMgLTIwNi4wMzM4ODQgDQpMIDM5MC43NTIwMTkgLTIwNi4wMzM4ODQgDQpMIDM5MC41OTIxODUgLTIwNi4wMzM4ODQgDQpMIDM5MC40MzIzNTEgLTIwNi4wMzM4ODQgDQpMIDM5MC4yNzI1MTcgLTIwNi4wMzM4ODQgDQpMIDM5MC4xMTI2ODMgLTIwNi4wMzM4ODQgDQpMIDM4OS45NTI4NDkgLTIwNi4wMzM4ODQgDQpMIDM4OS43OTMwMTYgLTIwNi4wMzM4ODQgDQpMIDM4OS42MzMxODIgLTIwNi4wMzM4ODQgDQpMIDM4OS40NzMzNDggLTIwNi4wMzM4ODQgDQpMIDM4OS4zMTM1MTQgLTIwNi4wMzM4ODQgDQpMIDM4OS4xNTM2OCAtMjA2LjAzMzg4NCANCkwgMzg4Ljk5Mzg0NiAtMjA2LjAzMzg4NCANCkwgMzg4LjgzNDAxMiAtMjA2LjAzMzg4NCANCkwgMzg4LjY3NDE3OCAtMjA2LjAzMzg4NCANCkwgMzg4LjUxNDM0NSAtMjA2LjAzMzg4NCANCkwgMzg4LjM1NDUxMSAtMjA2LjAzMzg4NCANCkwgMzg4LjE5NDY3NyAtMjA2LjAzMzg4NCANCkwgMzg4LjAzNDg0MyAtMjA2LjAzMzg4NCANCkwgMzg3Ljg3NTAwOSAtMjA2LjAzMzg4NCANCkwgMzg3LjcxNTE3NSAtMjA2LjAzMzg4NCANCkwgMzg3LjU1NTM0MSAtMjA2LjAzMzg4NCANCkwgMzg3LjM5NTUwNyAtMjA2LjAzMzg4NCANCkwgMzg3LjIzNTY3MyAtMjA2LjAzMzg4NCANCkwgMzg3LjA3NTg0IC0yMDYuMDMzODg0IA0KTCAzODYuOTE2MDA2IC0yMDYuMDMzODg0IA0KTCAzODYuNzU2MTcyIC0yMDYuMDMzODg0IA0KTCAzODYuNTk2MzM4IC0yMDYuMDMzODg0IA0KTCAzODYuNDM2NTA0IC0yMDYuMDMzODg0IA0KTCAzODYuMjc2NjcgLTIwNi4wMzM4ODQgDQpMIDM4Ni4xMTY4MzYgLTIwNi4wMzM4ODQgDQpMIDM4NS45NTcwMDIgLTIwNi4wMzM4ODQgDQpMIDM4NS43OTcxNjggLTIwNi4wMzM4ODQgDQpMIDM4NS42MzczMzUgLTIwNi4wMzM4ODQgDQpMIDM4NS40Nzc1MDEgLTIwNi4wMzM4ODQgDQpMIDM4NS4zMTc2NjcgLTIwNi4wMzM4ODQgDQpMIDM4NS4xNTc4MzMgLTIwNi4wMzM4ODQgDQpMIDM4NC45OTc5OTkgLTIwNi4wMzM4ODQgDQpMIDM4NC44MzgxNjUgLTIwNi4wMzM4ODQgDQpMIDM4NC42NzgzMzEgLTIwNi4wMzM4ODQgDQpMIDM4NC41MTg0OTcgLTIwNi4wMzM4ODQgDQpMIDM4NC4zNTg2NjQgLTIwNi4wMzM4ODQgDQpMIDM4NC4xOTg4MyAtMjA2LjAzMzg4NCANCkwgMzg0LjAzODk5NiAtMjA2LjAzMzg4NCANCkwgMzgzLjg3OTE2MiAtMjA2LjAzMzg4NCANCkwgMzgzLjcxOTMyOCAtMjA2LjAzMzg4NCANCkwgMzgzLjU1OTQ5NCAtMjA2LjAzMzg4NCANCkwgMzgzLjM5OTY2IC0yMDYuMDMzODg0IA0KTCAzODMuMjM5ODI2IC0yMDYuMDMzODg0IA0KTCAzODMuMDc5OTkyIC0yMDYuMDMzODg0IA0KTCAzODIuOTIwMTU5IC0yMDYuMDMzODg0IA0KTCAzODIuNzYwMzI1IC0yMDYuMDMzODg0IA0KTCAzODIuNjAwNDkxIC0yMDYuMDMzODg0IA0KTCAzODIuNDQwNjU3IC0yMDYuMDMzODg0IA0KTCAzODIuMjgwODIzIC0yMDYuMDMzODg0IA0KTCAzODIuMTIwOTg5IC0yMDYuMDMzODg0IA0KTCAzODEuOTYxMTU1IC0yMDYuMDMzODg0IA0KTCAzODEuODAxMzIxIC0yMDYuMDMzODg0IA0KTCAzODEuNjQxNDg3IC0yMDYuMDMzODg0IA0KTCAzODEuNDgxNjU0IC0yMDYuMDMzODg0IA0KTCAzODEuMzIxODIgLTIwNi4wMzM4ODQgDQpMIDM4MS4xNjE5ODYgLTIwNi4wMzM4ODQgDQpMIDM4MS4wMDIxNTIgLTIwNi4wMzM4ODQgDQpMIDM4MC44NDIzMTggLTIwNi4wMzM4ODQgDQpMIDM4MC42ODI0ODQgLTIwNi4wMzM4ODQgDQpMIDM4MC41MjI2NSAtMjA2LjAzMzg4NCANCkwgMzgwLjM2MjgxNiAtMjA2LjAzMzg4NCANCkwgMzgwLjIwMjk4MyAtMjA2LjAzMzg4NCANCkwgMzgwLjA0MzE0OSAtMjA2LjAzMzg4NCANCkwgMzc5Ljg4MzMxNSAtMjA2LjAzMzg4NCANCkwgMzc5LjcyMzQ4MSAtMjA2LjAzMzg4NCANCkwgMzc5LjU2MzY0NyAtMjA2LjAzMzg4NCANCkwgMzc5LjQwMzgxMyAtMjA2LjAzMzg4NCANCkwgMzc5LjI0Mzk3OSAtMjA2LjAzMzg4NCANCkwgMzc5LjA4NDE0NSAtMjA2LjAzMzg4NCANCkwgMzc4LjkyNDMxMSAtMjA2LjAzMzg4NCANCkwgMzc4Ljc2NDQ3OCAtMjA2LjAzMzg4NCANCkwgMzc4LjYwNDY0NCAtMjA2LjAzMzg4NCANCkwgMzc4LjQ0NDgxIC0yMDYuMDMzODg0IA0KTCAzNzguMjg0OTc2IC0yMDYuMDMzODg0IA0KTCAzNzguMTI1MTQyIC0yMDYuMDMzODg0IA0KTCAzNzcuOTY1MzA4IC0yMDYuMDMzODg0IA0KTCAzNzcuODA1NDc0IC0yMDYuMDMzODg0IA0KTCAzNzcuNjQ1NjQgLTIwNi4wMzM4ODQgDQpMIDM3Ny40ODU4MDcgLTIwNi4wMzM4ODQgDQpMIDM3Ny4zMjU5NzMgLTIwNi4wMzM4ODQgDQpMIDM3Ny4xNjYxMzkgLTIwNi4wMzM4ODQgDQpMIDM3Ny4wMDYzMDUgLTIwNi4wMzM4ODQgDQpMIDM3Ni44NDY0NzEgLTIwNi4wMzM4ODQgDQpMIDM3Ni42ODY2MzcgLTIwNi4wMzM4ODQgDQpMIDM3Ni41MjY4MDMgLTIwNi4wMzM4ODQgDQpMIDM3Ni4zNjY5NjkgLTIwNi4wMzM4ODQgDQpMIDM3Ni4yMDcxMzUgLTIwNi4wMzM4ODQgDQpMIDM3Ni4wNDczMDIgLTIwNi4wMzM4ODQgDQpMIDM3NS44ODc0NjggLTIwNi4wMzM4ODQgDQpMIDM3NS43Mjc2MzQgLTIwNi4wMzM4ODQgDQpMIDM3NS41Njc4IC0yMDYuMDMzODg0IA0KTCAzNzUuNDA3OTY2IC0yMDYuMDMzODg0IA0KTCAzNzUuMjQ4MTMyIC0yMDYuMDMzODg0IA0KTCAzNzUuMDg4Mjk4IC0yMDYuMDMzODg0IA0KTCAzNzQuOTI4NDY0IC0yMDYuMDMzODg0IA0KTCAzNzQuNzY4NjMgLTIwNi4wMzM4ODQgDQpMIDM3NC42MDg3OTcgLTIwNi4wMzM4ODQgDQpMIDM3NC40NDg5NjMgLTIwNi4wMzM4ODQgDQpMIDM3NC4yODkxMjkgLTIwNi4wMzM4ODQgDQpMIDM3NC4xMjkyOTUgLTIwNi4wMzM4ODQgDQpMIDM3My45Njk0NjEgLTIwNi4wMzM4ODQgDQpMIDM3My44MDk2MjcgLTIwNi4wMzM4ODQgDQpMIDM3My42NDk3OTMgLTIwNi4wMzM4ODQgDQpMIDM3My40ODk5NTkgLTIwNi4wMzM4ODQgDQpMIDM3My4zMzAxMjYgLTIwNi4wMzM4ODQgDQpMIDM3My4xNzAyOTIgLTIwNi4wMzM4ODQgDQpMIDM3My4wMTA0NTggLTIwNi4wMzM4ODQgDQpMIDM3Mi44NTA2MjQgLTIwNi4wMzM4ODQgDQpMIDM3Mi42OTA3OSAtMjA2LjAzMzg4NCANCkwgMzcyLjUzMDk1NiAtMjA2LjAzMzg4NCANCkwgMzcyLjM3MTEyMiAtMjA2LjAzMzg4NCANCkwgMzcyLjIxMTI4OCAtMjA2LjAzMzg4NCANCkwgMzcyLjA1MTQ1NCAtMjA2LjAzMzg4NCANCkwgMzcxLjg5MTYyMSAtMjA2LjAzMzg4NCANCkwgMzcxLjczMTc4NyAtMjA2LjAzMzg4NCANCkwgMzcxLjU3MTk1MyAtMjA2LjAzMzg4NCANCkwgMzcxLjQxMjExOSAtMjA2LjAzMzg4NCANCkwgMzcxLjI1MjI4NSAtMjA2LjAzMzg4NCANCkwgMzcxLjA5MjQ1MSAtMjA2LjAzMzg4NCANCkwgMzcwLjkzMjYxNyAtMjA2LjAzMzg4NCANCkwgMzcwLjc3Mjc4MyAtMjA2LjAzMzg4NCANCkwgMzcwLjYxMjk1IC0yMDYuMDMzODg0IA0KTCAzNzAuNDUzMTE2IC0yMDYuMDMzODg0IA0KTCAzNzAuMjkzMjgyIC0yMDYuMDMzODg0IA0KTCAzNzAuMTMzNDQ4IC0yMDYuMDMzODg0IA0KTCAzNjkuOTczNjE0IC0yMDYuMDMzODg0IA0KTCAzNjkuODEzNzggLTIwNi4wMzM4ODQgDQpMIDM2OS42NTM5NDYgLTIwNi4wMzM4ODQgDQpMIDM2OS40OTQxMTIgLTIwNi4wMzM4ODQgDQpMIDM2OS4zMzQyNzggLTIwNi4wMzM4ODQgDQpMIDM2OS4xNzQ0NDUgLTIwNi4wMzM4ODQgDQpMIDM2OS4wMTQ2MTEgLTIwNi4wMzM4ODQgDQpMIDM2OC44NTQ3NzcgLTIwNi4wMzM4ODQgDQpMIDM2OC42OTQ5NDMgLTIwNi4wMzM4ODQgDQpMIDM2OC41MzUxMDkgLTIwNi4wMzM4ODQgDQpMIDM2OC4zNzUyNzUgLTIwNi4wMzM4ODQgDQpMIDM2OC4yMTU0NDEgLTIwNi4wMzM4ODQgDQpMIDM2OC4wNTU2MDcgLTIwNi4wMzM4ODQgDQpMIDM2Ny44OTU3NzMgLTIwNi4wMzM4ODQgDQpMIDM2Ny43MzU5NCAtMjA2LjAzMzg4NCANCkwgMzY3LjU3NjEwNiAtMjA2LjAzMzg4NCANCkwgMzY3LjQxNjI3MiAtMjA2LjAzMzg4NCANCkwgMzY3LjI1NjQzOCAtMjA2LjAzMzg4NCANCkwgMzY3LjA5NjYwNCAtMjA2LjAzMzg4NCANCkwgMzY2LjkzNjc3IC0yMDYuMDMzODg0IA0KTCAzNjYuNzc2OTM2IC0yMDYuMDMzODg0IA0KTCAzNjYuNjE3MTAyIC0yMDYuMDMzODg0IA0KTCAzNjYuNDU3MjY5IC0yMDYuMDMzODg0IA0KTCAzNjYuMjk3NDM1IC0yMDYuMDMzODg0IA0KTCAzNjYuMTM3NjAxIC0yMDYuMDMzODg0IA0KTCAzNjUuOTc3NzY3IC0yMDYuMDMzODg0IA0KTCAzNjUuODE3OTMzIC0yMDYuMDMzODg0IA0KTCAzNjUuNjU4MDk5IC0yMDYuMDMzODg0IA0KTCAzNjUuNDk4MjY1IC0yMDYuMDMzODg0IA0KTCAzNjUuMzM4NDMxIC0yMDYuMDMzODg0IA0KTCAzNjUuMTc4NTk3IC0yMDYuMDMzODg0IA0KTCAzNjUuMDE4NzY0IC0yMDYuMDMzODg0IA0KTCAzNjQuODU4OTMgLTIwNi4wMzM4ODQgDQpMIDM2NC42OTkwOTYgLTIwNi4wMzM4ODQgDQpMIDM2NC41MzkyNjIgLTIwNi4wMzM4ODQgDQpMIDM2NC4zNzk0MjggLTIwNi4wMzM4ODQgDQpMIDM2NC4yMTk1OTQgLTIwNi4wMzM4ODQgDQpMIDM2NC4wNTk3NiAtMjA2LjAzMzg4NCANCkwgMzYzLjg5OTkyNiAtMjA2LjAzMzg4NCANCkwgMzYzLjc0MDA5MiAtMjA2LjAzMzg4NCANCkwgMzYzLjU4MDI1OSAtMjA2LjAzMzg4NCANCkwgMzYzLjQyMDQyNSAtMjA2LjAzMzg4NCANCkwgMzYzLjI2MDU5MSAtMjA2LjAzMzg4NCANCkwgMzYzLjEwMDc1NyAtMjA2LjAzMzg4NCANCkwgMzYyLjk0MDkyMyAtMjA2LjAzMzg4NCANCkwgMzYyLjc4MTA4OSAtMjA2LjAzMzg4NCANCkwgMzYyLjYyMTI1NSAtMjA2LjAzMzg4NCANCkwgMzYyLjQ2MTQyMSAtMjA2LjAzMzg4NCANCkwgMzYyLjMwMTU4OCAtMjA2LjAzMzg4NCANCkwgMzYyLjE0MTc1NCAtMjA2LjAzMzg4NCANCkwgMzYxLjk4MTkyIC0yMDYuMDMzODg0IA0KTCAzNjEuODIyMDg2IC0yMDYuMDMzODg0IA0KTCAzNjEuNjYyMjUyIC0yMDYuMDMzODg0IA0KTCAzNjEuNTAyNDE4IC0yMDYuMDMzODg0IA0KTCAzNjEuMzQyNTg0IC0yMDYuMDMzODg0IA0KTCAzNjEuMTgyNzUgLTIwNi4wMzM4ODQgDQpMIDM2MS4wMjI5MTYgLTIwNi4wMzM4ODQgDQpMIDM2MC44NjMwODMgLTIwNi4wMzM4ODQgDQpMIDM2MC43MDMyNDkgLTIwNi4wMzM4ODQgDQpMIDM2MC41NDM0MTUgLTIwNi4wMzM4ODQgDQpMIDM2MC4zODM1ODEgLTIwNi4wMzM4ODQgDQpMIDM2MC4yMjM3NDcgLTIwNi4wMzM4ODQgDQpMIDM2MC4wNjM5MTMgLTIwNi4wMzM4ODQgDQpMIDM1OS45MDQwNzkgLTIwNi4wMzM4ODQgDQpMIDM1OS43NDQyNDUgLTIwNi4wMzM4ODQgDQpMIDM1OS41ODQ0MTIgLTIwNi4wMzM4ODQgDQpMIDM1OS40MjQ1NzggLTIwNi4wMzM4ODQgDQpMIDM1OS4yNjQ3NDQgLTIwNi4wMzM4ODQgDQpMIDM1OS4xMDQ5MSAtMjA2LjAzMzg4NCANCkwgMzU4Ljk0NTA3NiAtMjA2LjAzMzg4NCANCkwgMzU4Ljc4NTI0MiAtMjA2LjAzMzg4NCANCkwgMzU4LjYyNTQwOCAtMjA2LjAzMzg4NCANCkwgMzU4LjQ2NTU3NCAtMjA2LjAzMzg4NCANCkwgMzU4LjMwNTc0IC0yMDYuMDMzODg0IA0KTCAzNTguMTQ1OTA3IC0yMDYuMDMzODg0IA0KTCAzNTcuOTg2MDczIC0yMDYuMDMzODg0IA0KTCAzNTcuODI2MjM5IC0yMDYuMDMzODg0IA0KTCAzNTcuNjY2NDA1IC0yMDYuMDMzODg0IA0KTCAzNTcuNTA2NTcxIC0yMDYuMDMzODg0IA0KTCAzNTcuMzQ2NzM3IC0yMDYuMDMzODg0IA0KTCAzNTcuMTg2OTAzIC0yMDYuMDMzODg0IA0KTCAzNTcuMDI3MDY5IC0yMDYuMDMzODg0IA0KTCAzNTYuODY3MjM1IC0yMDYuMDMzODg0IA0KTCAzNTYuNzA3NDAyIC0yMDYuMDMzODg0IA0KTCAzNTYuNTQ3NTY4IC0yMDYuMDMzODg0IA0KTCAzNTYuMzg3NzM0IC0yMDYuMDMzODg0IA0KTCAzNTYuMjI3OSAtMjA2LjAzMzg4NCANCkwgMzU2LjA2ODA2NiAtMjA2LjAzMzg4NCANCkwgMzU1LjkwODIzMiAtMjA2LjAzMzg4NCANCkwgMzU1Ljc0ODM5OCAtMjA2LjAzMzg4NCANCkwgMzU1LjU4ODU2NCAtMjA2LjAzMzg4NCANCkwgMzU1LjQyODczMSAtMjA2LjAzMzg4NCANCkwgMzU1LjI2ODg5NyAtMjA2LjAzMzg4NCANCkwgMzU1LjEwOTA2MyAtMjA2LjAzMzg4NCANCkwgMzU0Ljk0OTIyOSAtMjA2LjAzMzg4NCANCkwgMzU0Ljc4OTM5NSAtMjA2LjAzMzg4NCANCkwgMzU0LjYyOTU2MSAtMjA2LjAzMzg4NCANCkwgMzU0LjQ2OTcyNyAtMjA2LjAzMzg4NCANCkwgMzU0LjMwOTg5MyAtMjA2LjAzMzg4NCANCkwgMzU0LjE1MDA1OSAtMjA2LjAzMzg4NCANCkwgMzUzLjk5MDIyNiAtMjA2LjAzMzg4NCANCkwgMzUzLjgzMDM5MiAtMjA2LjAzMzg4NCANCkwgMzUzLjY3MDU1OCAtMjA2LjAzMzg4NCANCkwgMzUzLjUxMDcyNCAtMjA2LjAzMzg4NCANCkwgMzUzLjM1MDg5IC0yMDYuMDMzODg0IA0KTCAzNTMuMTkxMDU2IC0yMDYuMDMzODg0IA0KTCAzNTMuMDMxMjIyIC0yMDYuMDMzODg0IA0KTCAzNTIuODcxMzg4IC0yMDYuMDMzODg0IA0KTCAzNTIuNzExNTU1IC0yMDYuMDMzODg0IA0KTCAzNTIuNTUxNzIxIC0yMDYuMDMzODg0IA0KTCAzNTIuMzkxODg3IC0yMDYuMDMzODg0IA0KTCAzNTIuMjMyMDUzIC0yMDYuMDMzODg0IA0KTCAzNTIuMDcyMjE5IC0yMDYuMDMzODg0IA0KTCAzNTEuOTEyMzg1IC0yMDYuMDMzODg0IA0KTCAzNTEuNzUyNTUxIC0yMDYuMDMzODg0IA0KTCAzNTEuNTkyNzE3IC0yMDYuMDMzODg0IA0KTCAzNTEuNDMyODgzIC0yMDYuMDMzODg0IA0KTCAzNTEuMjczMDUgLTIwNi4wMzM4ODQgDQpMIDM1MS4xMTMyMTYgLTIwNi4wMzM4ODQgDQpMIDM1MC45NTMzODIgLTIwNi4wMzM4ODQgDQpMIDM1MC43OTM1NDggLTIwNi4wMzM4ODQgDQpMIDM1MC42MzM3MTQgLTIwNi4wMzM4ODQgDQpMIDM1MC40NzM4OCAtMjA2LjAzMzg4NCANCkwgMzUwLjMxNDA0NiAtMjA2LjAzMzg4NCANCkwgMzUwLjE1NDIxMiAtMjA2LjAzMzg4NCANCkwgMzQ5Ljk5NDM3OCAtMjA2LjAzMzg4NCANCkwgMzQ5LjgzNDU0NSAtMjA2LjAzMzg4NCANCkwgMzQ5LjY3NDcxMSAtMjA2LjAzMzg4NCANCkwgMzQ5LjUxNDg3NyAtMjA2LjAzMzg4NCANCkwgMzQ5LjM1NTA0MyAtMjA2LjAzMzg4NCANCkwgMzQ5LjE5NTIwOSAtMjA2LjAzMzg4NCANCkwgMzQ5LjAzNTM3NSAtMjA2LjAzMzg4NCANCkwgMzQ4Ljg3NTU0MSAtMjA2LjAzMzg4NCANCkwgMzQ4LjcxNTcwNyAtMjA2LjAzMzg4NCANCkwgMzQ4LjU1NTg3NCAtMjA2LjAzMzg4NCANCkwgMzQ4LjM5NjA0IC0yMDYuMDMzODg0IA0KTCAzNDguMjM2MjA2IC0yMDYuMDMzODg0IA0KTCAzNDguMDc2MzcyIC0yMDYuMDMzODg0IA0KTCAzNDcuOTE2NTM4IC0yMDYuMDMzODg0IA0KTCAzNDcuNzU2NzA0IC0yMDYuMDMzODg0IA0KTCAzNDcuNTk2ODcgLTIwNi4wMzM4ODQgDQpMIDM0Ny40MzcwMzYgLTIwNi4wMzM4ODQgDQpMIDM0Ny4yNzcyMDIgLTIwNi4wMzM4ODQgDQpMIDM0Ny4xMTczNjkgLTIwNi4wMzM4ODQgDQpMIDM0Ni45NTc1MzUgLTIwNi4wMzM4ODQgDQpMIDM0Ni43OTc3MDEgLTIwNi4wMzM4ODQgDQpMIDM0Ni42Mzc4NjcgLTIwNi4wMzM4ODQgDQpMIDM0Ni40NzgwMzMgLTIwNi4wMzM4ODQgDQpMIDM0Ni4zMTgxOTkgLTIwNi4wMzM4ODQgDQpMIDM0Ni4xNTgzNjUgLTIwNi4wMzM4ODQgDQpMIDM0NS45OTg1MzEgLTIwNi4wMzM4ODQgDQpMIDM0NS44Mzg2OTcgLTIwNi4wMzM4ODQgDQpMIDM0NS42Nzg4NjQgLTIwNi4wMzM4ODQgDQpMIDM0NS41MTkwMyAtMjA2LjAzMzg4NCANCkwgMzQ1LjM1OTE5NiAtMjA2LjAzMzg4NCANCkwgMzQ1LjE5OTM2MiAtMjA2LjAzMzg4NCANCkwgMzQ1LjAzOTUyOCAtMjA2LjAzMzg4NCANCkwgMzQ0Ljg3OTY5NCAtMjA2LjAzMzg4NCANCkwgMzQ0LjcxOTg2IC0yMDYuMDMzODg0IA0KTCAzNDQuNTYwMDI2IC0yMDYuMDMzODg0IA0KTCAzNDQuNDAwMTkzIC0yMDYuMDMzODg0IA0KTCAzNDQuMjQwMzU5IC0yMDYuMDMzODg0IA0KTCAzNDQuMDgwNTI1IC0yMDYuMDMzODg0IA0KTCAzNDMuOTIwNjkxIC0yMDYuMDMzODg0IA0KTCAzNDMuNzYwODU3IC0yMDYuMDMzODg0IA0KTCAzNDMuNjAxMDIzIC0yMDYuMDMzODg0IA0KTCAzNDMuNDQxMTg5IC0yMDYuMDMzODg0IA0KTCAzNDMuMjgxMzU1IC0yMDYuMDMzODg0IA0KTCAzNDMuMTIxNTIxIC0yMDYuMDMzODg0IA0KTCAzNDIuOTYxNjg4IC0yMDYuMDMzODg0IA0KTCAzNDIuODAxODU0IC0yMDYuMDMzODg0IA0KTCAzNDIuNjQyMDIgLTIwNi4wMzM4ODQgDQpMIDM0Mi40ODIxODYgLTIwNi4wMzM4ODQgDQpMIDM0Mi4zMjIzNTIgLTIwNi4wMzM4ODQgDQpMIDM0Mi4xNjI1MTggLTIwNi4wMzM4ODQgDQpMIDM0Mi4wMDI2ODQgLTIwNi4wMzM4ODQgDQpMIDM0MS44NDI4NSAtMjA2LjAzMzg4NCANCkwgMzQxLjY4MzAxNyAtMjA2LjAzMzg4NCANCkwgMzQxLjUyMzE4MyAtMjA2LjAzMzg4NCANCkwgMzQxLjM2MzM0OSAtMjA2LjAzMzg4NCANCkwgMzQxLjIwMzUxNSAtMjA2LjAzMzg4NCANCkwgMzQxLjA0MzY4MSAtMjA2LjAzMzg4NCANCkwgMzQwLjg4Mzg0NyAtMjA2LjAzMzg4NCANCkwgMzQwLjcyNDAxMyAtMjA2LjAzMzg4NCANCkwgMzQwLjU2NDE3OSAtMjA2LjAzMzg4NCANCkwgMzQwLjQwNDM0NSAtMjA2LjAzMzg4NCANCkwgMzQwLjI0NDUxMiAtMjA2LjAzMzg4NCANCkwgMzQwLjA4NDY3OCAtMjA2LjAzMzg4NCANCkwgMzM5LjkyNDg0NCAtMjA2LjAzMzg4NCANCkwgMzM5Ljc2NTAxIC0yMDYuMDMzODg0IA0KTCAzMzkuNjA1MTc2IC0yMDYuMDMzODg0IA0KTCAzMzkuNDQ1MzQyIC0yMDYuMDMzODg0IA0KTCAzMzkuMjg1NTA4IC0yMDYuMDMzODg0IA0KTCAzMzkuMTI1Njc0IC0yMDYuMDMzODg0IA0KTCAzMzguOTY1ODQgLTIwNi4wMzM4ODQgDQpMIDMzOC44MDYwMDcgLTIwNi4wMzM4ODQgDQpMIDMzOC42NDYxNzMgLTIwNi4wMzM4ODQgDQpMIDMzOC40ODYzMzkgLTIwNi4wMzM4ODQgDQpMIDMzOC4zMjY1MDUgLTIwNi4wMzM4ODQgDQpMIDMzOC4xNjY2NzEgLTIwNi4wMzM4ODQgDQpMIDMzOC4wMDY4MzcgLTIwNi4wMzM4ODQgDQpMIDMzNy44NDcwMDMgLTIwNi4wMzM4ODQgDQpMIDMzNy42ODcxNjkgLTIwNi4wMzM4ODQgDQpMIDMzNy41MjczMzYgLTIwNi4wMzM4ODQgDQpMIDMzNy4zNjc1MDIgLTIwNi4wMzM4ODQgDQpMIDMzNy4yMDc2NjggLTIwNi4wMzM4ODQgDQpMIDMzNy4wNDc4MzQgLTIwNi4wMzM4ODQgDQpMIDMzNi44ODggLTIwNi4wMzM4ODQgDQpMIDMzNi43MjgxNjYgLTIwNi4wMzM4ODQgDQpMIDMzNi41NjgzMzIgLTIwNi4wMzM4ODQgDQpMIDMzNi40MDg0OTggLTIwNi4wMzM4ODQgDQpMIDMzNi4yNDg2NjQgLTIwNi4wMzM4ODQgDQpMIDMzNi4wODg4MzEgLTIwNi4wMzM4ODQgDQpMIDMzNS45Mjg5OTcgLTIwNi4wMzM4ODQgDQpMIDMzNS43NjkxNjMgLTIwNi4wMzM4ODQgDQpMIDMzNS42MDkzMjkgLTIwNi4wMzM4ODQgDQpMIDMzNS40NDk0OTUgLTIwNi4wMzM4ODQgDQpMIDMzNS4yODk2NjEgLTIwNi4wMzM4ODQgDQpMIDMzNS4xMjk4MjcgLTIwNi4wMzM4ODQgDQpMIDMzNC45Njk5OTMgLTIwNi4wMzM4ODQgDQpMIDMzNC44MTAxNiAtMjA2LjAzMzg4NCANCkwgMzM0LjY1MDMyNiAtMjA2LjAzMzg4NCANCkwgMzM0LjQ5MDQ5MiAtMjA2LjAzMzg4NCANCkwgMzM0LjMzMDY1OCAtMjA2LjAzMzg4NCANCkwgMzM0LjE3MDgyNCAtMjA2LjAzMzg4NCANCkwgMzM0LjAxMDk5IC0yMDYuMDMzODg0IA0KTCAzMzMuODUxMTU2IC0yMDYuMDMzODg0IA0KTCAzMzMuNjkxMzIyIC0yMDYuMDMzODg0IA0KTCAzMzMuNTMxNDg4IC0yMDYuMDMzODg0IA0KTCAzMzMuMzcxNjU1IC0yMDYuMDMzODg0IA0KTCAzMzMuMjExODIxIC0yMDYuMDMzODg0IA0KTCAzMzMuMDUxOTg3IC0yMDYuMDMzODg0IA0KTCAzMzIuODkyMTUzIC0yMDYuMDMzODg0IA0KTCAzMzIuNzMyMzE5IC0yMDYuMDMzODg0IA0KTCAzMzIuNTcyNDg1IC0yMDYuMDMzODg0IA0KTCAzMzIuNDEyNjUxIC0yMDYuMDMzODg0IA0KTCAzMzIuMjUyODE3IC0yMDYuMDMzODg0IA0KTCAzMzIuMDkyOTgzIC0yMDYuMDMzODg0IA0KTCAzMzEuOTMzMTUgLTIwNi4wMzM4ODQgDQpMIDMzMS43NzMzMTYgLTIwNi4wMzM4ODQgDQpMIDMzMS42MTM0ODIgLTIwNi4wMzM4ODQgDQpMIDMzMS40NTM2NDggLTIwNi4wMzM4ODQgDQpMIDMzMS4yOTM4MTQgLTIwNi4wMzM4ODQgDQpMIDMzMS4xMzM5OCAtMjA2LjAzMzg4NCANCkwgMzMwLjk3NDE0NiAtMjA2LjAzMzg4NCANCkwgMzMwLjgxNDMxMiAtMjA2LjAzMzg4NCANCkwgMzMwLjY1NDQ3OSAtMjA2LjAzMzg4NCANCkwgMzMwLjQ5NDY0NSAtMjA2LjAzMzg4NCANCkwgMzMwLjMzNDgxMSAtMjA2LjAzMzg4NCANCkwgMzMwLjE3NDk3NyAtMjA2LjAzMzg4NCANCkwgMzMwLjAxNTE0MyAtMjA2LjAzMzg4NCANCkwgMzI5Ljg1NTMwOSAtMjA2LjAzMzg4NCANCkwgMzI5LjY5NTQ3NSAtMjA2LjAzMzg4NCANCkwgMzI5LjUzNTY0MSAtMjA2LjAzMzg4NCANCkwgMzI5LjM3NTgwNyAtMjA2LjAzMzg4NCANCkwgMzI5LjIxNTk3NCAtMjA2LjAzMzg4NCANCkwgMzI5LjA1NjE0IC0yMDYuMDMzODg0IA0KTCAzMjguODk2MzA2IC0yMDYuMDMzODg0IA0KTCAzMjguNzM2NDcyIC0yMDYuMDMzODg0IA0KTCAzMjguNTc2NjM4IC0yMDYuMDMzODg0IA0KTCAzMjguNDE2ODA0IC0yMDYuMDMzODg0IA0KTCAzMjguMjU2OTcgLTIwNi4wMzM4ODQgDQpMIDMyOC4wOTcxMzYgLTIwNi4wMzM4ODQgDQpMIDMyNy45MzczMDMgLTIwNi4wMzM4ODQgDQpMIDMyNy43Nzc0NjkgLTIwNi4wMzM4ODQgDQpMIDMyNy42MTc2MzUgLTIwNi4wMzM4ODQgDQpMIDMyNy40NTc4MDEgLTIwNi4wMzM4ODQgDQpMIDMyNy4yOTc5NjcgLTIwNi4wMzM4ODQgDQpMIDMyNy4xMzgxMzMgLTIwNi4wMzM4ODQgDQpMIDMyNi45NzgyOTkgLTIwNi4wMzM4ODQgDQpMIDMyNi44MTg0NjUgLTIwNi4wMzM4ODQgDQpMIDMyNi42NTg2MzEgLTIwNi4wMzM4ODQgDQpMIDMyNi40OTg3OTggLTIwNi4wMzM4ODQgDQpMIDMyNi4zMzg5NjQgLTIwNi4wMzM4ODQgDQpMIDMyNi4xNzkxMyAtMjA2LjAzMzg4NCANCkwgMzI2LjAxOTI5NiAtMjA2LjAzMzg4NCANCkwgMzI1Ljg1OTQ2MiAtMjA2LjAzMzg4NCANCkwgMzI1LjY5OTYyOCAtMjA2LjAzMzg4NCANCkwgMzI1LjUzOTc5NCAtMjA2LjAzMzg4NCANCkwgMzI1LjM3OTk2IC0yMDYuMDMzODg0IA0KTCAzMjUuMjIwMTI2IC0yMDYuMDMzODg0IA0KTCAzMjUuMDYwMjkzIC0yMDYuMDMzODg0IA0KTCAzMjQuOTAwNDU5IC0yMDYuMDMzODg0IA0KTCAzMjQuNzQwNjI1IC0yMDYuMDMzODg0IA0KTCAzMjQuNTgwNzkxIC0yMDYuMDMzODg0IA0KTCAzMjQuNDIwOTU3IC0yMDYuMDMzODg0IA0KTCAzMjQuMjYxMTIzIC0yMDYuMDMzODg0IA0KTCAzMjQuMTAxMjg5IC0yMDYuMDMzODg0IA0KTCAzMjMuOTQxNDU1IC0yMDYuMDMzODg0IA0KTCAzMjMuNzgxNjIyIC0yMDYuMDMzODg0IA0KTCAzMjMuNjIxNzg4IC0yMDYuMDMzODg0IA0KTCAzMjMuNDYxOTU0IC0yMDYuMDMzODg0IA0KTCAzMjMuMzAyMTIgLTIwNi4wMzM4ODQgDQpMIDMyMy4xNDIyODYgLTIwNi4wMzM4ODQgDQpMIDMyMi45ODI0NTIgLTIwNi4wMzM4ODQgDQpMIDMyMi44MjI2MTggLTIwNi4wMzM4ODQgDQpMIDMyMi42NjI3ODQgLTIwNi4wMzM4ODQgDQpMIDMyMi41MDI5NSAtMjA2LjAzMzg4NCANCkwgMzIyLjM0MzExNyAtMjA2LjAzMzg4NCANCkwgMzIyLjE4MzI4MyAtMjA2LjAzMzg4NCANCkwgMzIyLjAyMzQ0OSAtMjA2LjAzMzg4NCANCkwgMzIxLjg2MzYxNSAtMjA2LjAzMzg4NCANCkwgMzIxLjcwMzc4MSAtMjA2LjAzMzg4NCANCkwgMzIxLjU0Mzk0NyAtMjA2LjAzMzg4NCANCkwgMzIxLjM4NDExMyAtMjA2LjAzMzg4NCANCkwgMzIxLjIyNDI3OSAtMjA2LjAzMzg4NCANCkwgMzIxLjA2NDQ0NSAtMjA2LjAzMzg4NCANCkwgMzIwLjkwNDYxMiAtMjA2LjAzMzg4NCANCkwgMzIwLjc0NDc3OCAtMjA2LjAzMzg4NCANCkwgMzIwLjU4NDk0NCAtMjA2LjAzMzg4NCANCkwgMzIwLjQyNTExIC0yMDYuMDMzODg0IA0KTCAzMjAuMjY1Mjc2IC0yMDYuMDMzODg0IA0KTCAzMjAuMTA1NDQyIC0yMDYuMDMzODg0IA0KTCAzMTkuOTQ1NjA4IC0yMDYuMDMzODg0IA0KTCAzMTkuNzg1Nzc0IC0yMDYuMDMzODg0IA0KTCAzMTkuNjI1OTQxIC0yMDYuMDMzODg0IA0KTCAzMTkuNDY2MTA3IC0yMDYuMDMzODg0IA0KTCAzMTkuMzA2MjczIC0yMDYuMDMzODg0IA0KTCAzMTkuMTQ2NDM5IC0yMDYuMDMzODg0IA0KTCAzMTguOTg2NjA1IC0yMDYuMDMzODg0IA0KTCAzMTguODI2NzcxIC0yMDYuMDMzODg0IA0KTCAzMTguNjY2OTM3IC0yMDYuMDMzODg0IA0KTCAzMTguNTA3MTAzIC0yMDYuMDMzODg0IA0KTCAzMTguMzQ3MjY5IC0yMDYuMDMzODg0IA0KTCAzMTguMTg3NDM2IC0yMDYuMDMzODg0IA0KTCAzMTguMDI3NjAyIC0yMDYuMDMzODg0IA0KTCAzMTcuODY3NzY4IC0yMDYuMDMzODg0IA0KTCAzMTcuNzA3OTM0IC0yMDYuMDMzODg0IA0KTCAzMTcuNTQ4MSAtMjA2LjAzMzg4NCANCkwgMzE3LjM4ODI2NiAtMjA2LjAzMzg4NCANCkwgMzE3LjIyODQzMiAtMjA2LjAzMzg4NCANCkwgMzE3LjA2ODU5OCAtMjA2LjAzMzg4NCANCkwgMzE2LjkwODc2NSAtMjA2LjAzMzg4NCANCkwgMzE2Ljc0ODkzMSAtMjA2LjAzMzg4NCANCkwgMzE2LjU4OTA5NyAtMjA2LjAzMzg4NCANCkwgMzE2LjQyOTI2MyAtMjA2LjAzMzg4NCANCkwgMzE2LjI2OTQyOSAtMjA2LjAzMzg4NCANCkwgMzE2LjEwOTU5NSAtMjA2LjAzMzg4NCANCkwgMzE1Ljk0OTc2MSAtMjA2LjAzMzg4NCANCkwgMzE1Ljc4OTkyNyAtMjA2LjAzMzg4NCANCkwgMzE1LjYzMDA5MyAtMjA2LjAzMzg4NCANCkwgMzE1LjQ3MDI2IC0yMDYuMDMzODg0IA0KTCAzMTUuMzEwNDI2IC0yMDYuMDMzODg0IA0KTCAzMTUuMTUwNTkyIC0yMDYuMDMzODg0IA0KTCAzMTQuOTkwNzU4IC0yMDYuMDMzODg0IA0KTCAzMTQuODMwOTI0IC0yMDYuMDMzODg0IA0KTCAzMTQuNjcxMDkgLTIwNi4wMzM4ODQgDQpMIDMxNC41MTEyNTYgLTIwNi4wMzM4ODQgDQpMIDMxNC4zNTE0MjIgLTIwNi4wMzM4ODQgDQpMIDMxNC4xOTE1ODggLTIwNi4wMzM4ODQgDQpMIDMxNC4wMzE3NTUgLTIwNi4wMzM4ODQgDQpMIDMxMy44NzE5MjEgLTIwNi4wMzM4ODQgDQpMIDMxMy43MTIwODcgLTIwNi4wMzM4ODQgDQpMIDMxMy41NTIyNTMgLTIwNi4wMzM4ODQgDQpMIDMxMy4zOTI0MTkgLTIwNi4wMzM4ODQgDQpMIDMxMy4yMzI1ODUgLTIwNi4wMzM4ODQgDQpMIDMxMy4wNzI3NTEgLTIwNi4wMzM4ODQgDQpMIDMxMi45MTI5MTcgLTIwNi4wMzM4ODQgDQpMIDMxMi43NTMwODQgLTIwNi4wMzM4ODQgDQpMIDMxMi41OTMyNSAtMjA2LjAzMzg4NCANCkwgMzEyLjQzMzQxNiAtMjA2LjAzMzg4NCANCkwgMzEyLjI3MzU4MiAtMjA2LjAzMzg4NCANCkwgMzEyLjExMzc0OCAtMjA2LjAzMzg4NCANCkwgMzExLjk1MzkxNCAtMjA2LjAzMzg4NCANCkwgMzExLjc5NDA4IC0yMDYuMDMzODg0IA0KTCAzMTEuNjM0MjQ2IC0yMDYuMDMzODg0IA0KTCAzMTEuNDc0NDEyIC0yMDYuMDMzODg0IA0KTCAzMTEuMzE0NTc5IC0yMDYuMDMzODg0IA0KTCAzMTEuMTU0NzQ1IC0yMDYuMDMzODg0IA0KTCAzMTAuOTk0OTExIC0yMDYuMDMzODg0IA0KTCAzMTAuODM1MDc3IC0yMDYuMDMzODg0IA0KTCAzMTAuNjc1MjQzIC0yMDYuMDMzODg0IA0KTCAzMTAuNTE1NDA5IC0yMDYuMDMzODg0IA0KTCAzMTAuMzU1NTc1IC0yMDYuMDMzODg0IA0KTCAzMTAuMTk1NzQxIC0yMDYuMDMzODg0IA0KTCAzMTAuMDM1OTA4IC0yMDYuMDMzODg0IA0KTCAzMDkuODc2MDc0IC0yMDYuMDMzODg0IA0KTCAzMDkuNzE2MjQgLTIwNi4wMzM4ODQgDQpMIDMwOS41NTY0MDYgLTIwNi4wMzM4ODQgDQpMIDMwOS4zOTY1NzIgLTIwNi4wMzM4ODQgDQpMIDMwOS4yMzY3MzggLTIwNi4wMzM4ODQgDQpMIDMwOS4wNzY5MDQgLTIwNi4wMzM4ODQgDQpMIDMwOC45MTcwNyAtMjA2LjAzMzg4NCANCkwgMzA4Ljc1NzIzNiAtMjA2LjAzMzg4NCANCkwgMzA4LjU5NzQwMyAtMjA2LjAzMzg4NCANCkwgMzA4LjQzNzU2OSAtMjA2LjAzMzg4NCANCkwgMzA4LjI3NzczNSAtMjA2LjAzMzg4NCANCkwgMzA4LjExNzkwMSAtMjA2LjAzMzg4NCANCkwgMzA3Ljk1ODA2NyAtMjA2LjAzMzg4NCANCkwgMzA3Ljc5ODIzMyAtMjA2LjAzMzg4NCANCkwgMzA3LjYzODM5OSAtMjA2LjAzMzg4NCANCkwgMzA3LjQ3ODU2NSAtMjA2LjAzMzg4NCANCkwgMzA3LjMxODczMSAtMjA2LjAzMzg4NCANCkwgMzA3LjE1ODg5OCAtMjA2LjAzMzg4NCANCkwgMzA2Ljk5OTA2NCAtMjA2LjAzMzg4NCANCkwgMzA2LjgzOTIzIC0yMDYuMDMzODg0IA0KTCAzMDYuNjc5Mzk2IC0yMDYuMDMzODg0IA0KTCAzMDYuNTE5NTYyIC0yMDYuMDMzODg0IA0KTCAzMDYuMzU5NzI4IC0yMDYuMDMzODg0IA0KTCAzMDYuMTk5ODk0IC0yMDYuMDMzODg0IA0KTCAzMDYuMDQwMDYgLTIwNi4wMzM4ODQgDQpMIDMwNS44ODAyMjcgLTIwNi4wMzM4ODQgDQpMIDMwNS43MjAzOTMgLTIwNi4wMzM4ODQgDQpMIDMwNS41NjA1NTkgLTIwNi4wMzM4ODQgDQpMIDMwNS40MDA3MjUgLTIwNi4wMzM4ODQgDQpMIDMwNS4yNDA4OTEgLTIwNi4wMzM4ODQgDQpMIDMwNS4wODEwNTcgLTIwNi4wMzM4ODQgDQpMIDMwNC45MjEyMjMgLTIwNi4wMzM4ODQgDQpMIDMwNC43NjEzODkgLTIwNi4wMzM4ODQgDQpMIDMwNC42MDE1NTUgLTIwNi4wMzM4ODQgDQpMIDMwNC40NDE3MjIgLTIwNi4wMzM4ODQgDQpMIDMwNC4yODE4ODggLTIwNi4wMzM4ODQgDQpMIDMwNC4xMjIwNTQgLTIwNi4wMzM4ODQgDQpMIDMwMy45NjIyMiAtMjA2LjAzMzg4NCANCkwgMzAzLjgwMjM4NiAtMjA2LjAzMzg4NCANCkwgMzAzLjY0MjU1MiAtMjA2LjAzMzg4NCANCkwgMzAzLjQ4MjcxOCAtMjA2LjAzMzg4NCANCkwgMzAzLjMyMjg4NCAtMjA2LjAzMzg4NCANCkwgMzAzLjE2MzA1IC0yMDYuMDMzODg0IA0KTCAzMDMuMDAzMjE3IC0yMDYuMDMzODg0IA0KTCAzMDIuODQzMzgzIC0yMDYuMDMzODg0IA0KTCAzMDIuNjgzNTQ5IC0yMDYuMDMzODg0IA0KTCAzMDIuNTIzNzE1IC0yMDYuMDMzODg0IA0KTCAzMDIuMzYzODgxIC0yMDYuMDMzODg0IA0KTCAzMDIuMjA0MDQ3IC0yMDYuMDMzODg0IA0KTCAzMDIuMDQ0MjEzIC0yMDYuMDMzODg0IA0KTCAzMDEuODg0Mzc5IC0yMDYuMDMzODg0IA0KTCAzMDEuNzI0NTQ2IC0yMDYuMDMzODg0IA0KTCAzMDEuNTY0NzEyIC0yMDYuMDMzODg0IA0KTCAzMDEuNDA0ODc4IC0yMDYuMDMzODg0IA0KTCAzMDEuMjQ1MDQ0IC0yMDYuMDMzODg0IA0KTCAzMDEuMDg1MjEgLTIwNi4wMzM4ODQgDQpMIDMwMC45MjUzNzYgLTIwNi4wMzM4ODQgDQpMIDMwMC43NjU1NDIgLTIwNi4wMzM4ODQgDQpMIDMwMC42MDU3MDggLTIwNi4wMzM4ODQgDQpMIDMwMC40NDU4NzQgLTIwNi4wMzM4ODQgDQpMIDMwMC4yODYwNDEgLTIwNi4wMzM4ODQgDQpMIDMwMC4xMjYyMDcgLTIwNi4wMzM4ODQgDQpMIDI5OS45NjYzNzMgLTIwNi4wMzM4ODQgDQpMIDI5OS44MDY1MzkgLTIwNi4wMzM4ODQgDQpMIDI5OS42NDY3MDUgLTIwNi4wMzM4ODQgDQpMIDI5OS40ODY4NzEgLTIwNi4wMzM4ODQgDQpMIDI5OS4zMjcwMzcgLTIwNi4wMzM4ODQgDQpMIDI5OS4xNjcyMDMgLTIwNi4wMzM4ODQgDQpMIDI5OS4wMDczNyAtMjA2LjAzMzg4NCANCkwgMjk4Ljg0NzUzNiAtMjA2LjAzMzg4NCANCkwgMjk4LjY4NzcwMiAtMjA2LjAzMzg4NCANCkwgMjk4LjUyNzg2OCAtMjA2LjAzMzg4NCANCkwgMjk4LjM2ODAzNCAtMjA2LjAzMzg4NCANCkwgMjk4LjIwODIgLTIwNi4wMzM4ODQgDQpMIDI5OC4wNDgzNjYgLTIwNi4wMzM4ODQgDQpMIDI5Ny44ODg1MzIgLTIwNi4wMzM4ODQgDQpMIDI5Ny43Mjg2OTggLTIwNi4wMzM4ODQgDQpMIDI5Ny41Njg4NjUgLTIwNi4wMzM4ODQgDQpMIDI5Ny40MDkwMzEgLTIwNi4wMzM4ODQgDQpMIDI5Ny4yNDkxOTcgLTIwNi4wMzM4ODQgDQpMIDI5Ny4wODkzNjMgLTIwNi4wMzM4ODQgDQpMIDI5Ni45Mjk1MjkgLTIwNi4wMzM4ODQgDQpMIDI5Ni43Njk2OTUgLTIwNi4wMzM4ODQgDQpMIDI5Ni42MDk4NjEgLTIwNi4wMzM4ODQgDQpMIDI5Ni40NTAwMjcgLTIwNi4wMzM4ODQgDQpMIDI5Ni4yOTAxOTMgLTIwNi4wMzM4ODQgDQpMIDI5Ni4xMzAzNiAtMjA2LjAzMzg4NCANCkwgMjk1Ljk3MDUyNiAtMjA2LjAzMzg4NCANCkwgMjk1LjgxMDY5MiAtMjA2LjAzMzg4NCANCkwgMjk1LjY1MDg1OCAtMjA2LjAzMzg4NCANCkwgMjk1LjQ5MTAyNCAtMjA2LjAzMzg4NCANCkwgMjk1LjMzMTE5IC0yMDYuMDMzODg0IA0KTCAyOTUuMTcxMzU2IC0yMDYuMDMzODg0IA0KTCAyOTUuMDExNTIyIC0yMDYuMDMzODg0IA0KTCAyOTQuODUxNjg5IC0yMDYuMDMzODg0IA0KTCAyOTQuNjkxODU1IC0yMDYuMDMzODg0IA0KTCAyOTQuNTMyMDIxIC0yMDYuMDMzODg0IA0KTCAyOTQuMzcyMTg3IC0yMDYuMDMzODg0IA0KTCAyOTQuMjEyMzUzIC0yMDYuMDMzODg0IA0KTCAyOTQuMDUyNTE5IC0yMDYuMDMzODg0IA0KTCAyOTMuODkyNjg1IC0yMDYuMDMzODg0IA0KTCAyOTMuNzMyODUxIC0yMDYuMDMzODg0IA0KTCAyOTMuNTczMDE3IC0yMDYuMDMzODg0IA0KTCAyOTMuNDEzMTg0IC0yMDYuMDMzODg0IA0KTCAyOTMuMjUzMzUgLTIwNi4wMzM4ODQgDQpMIDI5My4wOTM1MTYgLTIwNi4wMzM4ODQgDQpMIDI5Mi45MzM2ODIgLTIwNi4wMzM4ODQgDQpMIDI5Mi43NzM4NDggLTIwNi4wMzM4ODQgDQpMIDI5Mi42MTQwMTQgLTIwNi4wMzM4ODQgDQpMIDI5Mi40NTQxOCAtMjA2LjAzMzg4NCANCkwgMjkyLjI5NDM0NiAtMjA2LjAzMzg4NCANCkwgMjkyLjEzNDUxMyAtMjA2LjAzMzg4NCANCkwgMjkxLjk3NDY3OSAtMjA2LjAzMzg4NCANCkwgMjkxLjgxNDg0NSAtMjA2LjAzMzg4NCANCkwgMjkxLjY1NTAxMSAtMjA2LjAzMzg4NCANCkwgMjkxLjQ5NTE3NyAtMjA2LjAzMzg4NCANCkwgMjkxLjMzNTM0MyAtMjA2LjAzMzg4NCANCkwgMjkxLjE3NTUwOSAtMjA2LjAzMzg4NCANCkwgMjkxLjAxNTY3NSAtMjA2LjAzMzg4NCANCkwgMjkwLjg1NTg0MSAtMjA2LjAzMzg4NCANCkwgMjkwLjY5NjAwOCAtMjA2LjAzMzg4NCANCkwgMjkwLjUzNjE3NCAtMjA2LjAzMzg4NCANCkwgMjkwLjM3NjM0IC0yMDYuMDMzODg0IA0KTCAyOTAuMjE2NTA2IC0yMDYuMDMzODg0IA0KTCAyOTAuMDU2NjcyIC0yMDYuMDMzODg0IA0KTCAyODkuODk2ODM4IC0yMDYuMDMzODg0IA0KTCAyODkuNzM3MDA0IC0yMDYuMDMzODg0IA0KTCAyODkuNTc3MTcgLTIwNi4wMzM4ODQgDQpMIDI4OS40MTczMzYgLTIwNi4wMzM4ODQgDQpMIDI4OS4yNTc1MDMgLTIwNi4wMzM4ODQgDQpMIDI4OS4wOTc2NjkgLTIwNi4wMzM4ODQgDQpMIDI4OC45Mzc4MzUgLTIwNi4wMzM4ODQgDQpMIDI4OC43NzgwMDEgLTIwNi4wMzM4ODQgDQpMIDI4OC42MTgxNjcgLTIwNi4wMzM4ODQgDQpMIDI4OC40NTgzMzMgLTIwNi4wMzM4ODQgDQpMIDI4OC4yOTg0OTkgLTIwNi4wMzM4ODQgDQpMIDI4OC4xMzg2NjUgLTIwNi4wMzM4ODQgDQpMIDI4Ny45Nzg4MzIgLTIwNi4wMzM4ODQgDQpMIDI4Ny44MTg5OTggLTIwNi4wMzM4ODQgDQpMIDI4Ny42NTkxNjQgLTIwNi4wMzM4ODQgDQpMIDI4Ny40OTkzMyAtMjA2LjAzMzg4NCANCkwgMjg3LjMzOTQ5NiAtMjA2LjAzMzg4NCANCkwgMjg3LjE3OTY2MiAtMjA2LjAzMzg4NCANCkwgMjg3LjAxOTgyOCAtMjA2LjAzMzg4NCANCkwgMjg2Ljg1OTk5NCAtMjA2LjAzMzg4NCANCkwgMjg2LjcwMDE2IC0yMDYuMDMzODg0IA0KTCAyODYuNTQwMzI3IC0yMDYuMDMzODg0IA0KTCAyODYuMzgwNDkzIC0yMDYuMDMzODg0IA0KTCAyODYuMjIwNjU5IC0yMDYuMDMzODg0IA0KTCAyODYuMDYwODI1IC0yMDYuMDMzODg0IA0KTCAyODUuOTAwOTkxIC0yMDYuMDMzODg0IA0KTCAyODUuNzQxMTU3IC0yMDYuMDMzODg0IA0KTCAyODUuNTgxMzIzIC0yMDYuMDMzODg0IA0KTCAyODUuNDIxNDg5IC0yMDYuMDMzODg0IA0KTCAyODUuMjYxNjU1IC0yMDYuMDMzODg0IA0KTCAyODUuMTAxODIyIC0yMDYuMDMzODg0IA0KTCAyODQuOTQxOTg4IC0yMDYuMDMzODg0IA0KTCAyODQuNzgyMTU0IC0yMDYuMDMzODg0IA0KTCAyODQuNjIyMzIgLTIwNi4wMzM4ODQgDQpMIDI4NC40NjI0ODYgLTIwNi4wMzM4ODQgDQpMIDI4NC4zMDI2NTIgLTIwNi4wMzM4ODQgDQpMIDI4NC4xNDI4MTggLTIwNi4wMzM4ODQgDQpMIDI4My45ODI5ODQgLTIwNi4wMzM4ODQgDQpMIDI4My44MjMxNTEgLTIwNi4wMzM4ODQgDQpMIDI4My42NjMzMTcgLTIwNi4wMzM4ODQgDQpMIDI4My41MDM0ODMgLTIwNi4wMzM4ODQgDQpMIDI4My4zNDM2NDkgLTIwNi4wMzM4ODQgDQpMIDI4My4xODM4MTUgLTIwNi4wMzM4ODQgDQpMIDI4My4wMjM5ODEgLTIwNi4wMzM4ODQgDQpMIDI4Mi44NjQxNDcgLTIwNi4wMzM4ODQgDQpMIDI4Mi43MDQzMTMgLTIwNi4wMzM4ODQgDQpMIDI4Mi41NDQ0NzkgLTIwNi4wMzM4ODQgDQpMIDI4Mi4zODQ2NDYgLTIwNi4wMzM4ODQgDQpMIDI4Mi4yMjQ4MTIgLTIwNi4wMzM4ODQgDQpMIDI4Mi4wNjQ5NzggLTIwNi4wMzM4ODQgDQpMIDI4MS45MDUxNDQgLTIwNi4wMzM4ODQgDQpMIDI4MS43NDUzMSAtMjA2LjAzMzg4NCANCkwgMjgxLjU4NTQ3NiAtMjA2LjAzMzg4NCANCkwgMjgxLjQyNTY0MiAtMjA2LjAzMzg4NCANCkwgMjgxLjI2NTgwOCAtMjA2LjAzMzg4NCANCkwgMjgxLjEwNTk3NSAtMjA2LjAzMzg4NCANCkwgMjgwLjk0NjE0MSAtMjA2LjAzMzg4NCANCkwgMjgwLjc4NjMwNyAtMjA2LjAzMzg4NCANCkwgMjgwLjYyNjQ3MyAtMjA2LjAzMzg4NCANCkwgMjgwLjQ2NjYzOSAtMjA2LjAzMzg4NCANCkwgMjgwLjMwNjgwNSAtMjA2LjAzMzg4NCANCkwgMjgwLjE0Njk3MSAtMjA2LjAzMzg4NCANCkwgMjc5Ljk4NzEzNyAtMjA2LjAzMzg4NCANCkwgMjc5LjgyNzMwMyAtMjA2LjAzMzg4NCANCkwgMjc5LjY2NzQ3IC0yMDYuMDMzODg0IA0KTCAyNzkuNTA3NjM2IC0yMDYuMDMzODg0IA0KTCAyNzkuMzQ3ODAyIC0yMDYuMDMzODg0IA0KTCAyNzkuMTg3OTY4IC0yMDYuMDMzODg0IA0KTCAyNzkuMDI4MTM0IC0yMDYuMDMzODg0IA0KTCAyNzguODY4MyAtMjA2LjAzMzg4NCANCkwgMjc4LjcwODQ2NiAtMjA2LjAzMzg4NCANCkwgMjc4LjU0ODYzMiAtMjA2LjAzMzg4NCANCkwgMjc4LjM4ODc5OCAtMjA2LjAzMzg4NCANCkwgMjc4LjIyODk2NSAtMjA2LjAzMzg4NCANCkwgMjc4LjA2OTEzMSAtMjA2LjAzMzg4NCANCkwgMjc3LjkwOTI5NyAtMjA2LjAzMzg4NCANCkwgMjc3Ljc0OTQ2MyAtMjA2LjAzMzg4NCANCkwgMjc3LjU4OTYyOSAtMjA2LjAzMzg4NCANCkwgMjc3LjQyOTc5NSAtMjA2LjAzMzg4NCANCkwgMjc3LjI2OTk2MSAtMjA2LjAzMzg4NCANCkwgMjc3LjExMDEyNyAtMjA2LjAzMzg4NCANCkwgMjc2Ljk1MDI5NCAtMjA2LjAzMzg4NCANCkwgMjc2Ljc5MDQ2IC0yMDYuMDMzODg0IA0KTCAyNzYuNjMwNjI2IC0yMDYuMDMzODg0IA0KTCAyNzYuNDcwNzkyIC0yMDYuMDMzODg0IA0KTCAyNzYuMzEwOTU4IC0yMDYuMDMzODg0IA0KTCAyNzYuMTUxMTI0IC0yMDYuMDMzODg0IA0KTCAyNzUuOTkxMjkgLTIwNi4wMzM4ODQgDQpMIDI3NS44MzE0NTYgLTIwNi4wMzM4ODQgDQpMIDI3NS42NzE2MjIgLTIwNi4wMzM4ODQgDQpMIDI3NS41MTE3ODkgLTIwNi4wMzM4ODQgDQpMIDI3NS4zNTE5NTUgLTIwNi4wMzM4ODQgDQpMIDI3NS4xOTIxMjEgLTIwNi4wMzM4ODQgDQpMIDI3NS4wMzIyODcgLTIwNi4wMzM4ODQgDQpMIDI3NC44NzI0NTMgLTIwNi4wMzM4ODQgDQpMIDI3NC43MTI2MTkgLTIwNi4wMzM4ODQgDQpMIDI3NC41NTI3ODUgLTIwNi4wMzM4ODQgDQpMIDI3NC4zOTI5NTEgLTIwNi4wMzM4ODQgDQpMIDI3NC4yMzMxMTggLTIwNi4wMzM4ODQgDQpMIDI3NC4wNzMyODQgLTIwNi4wMzM4ODQgDQpMIDI3My45MTM0NSAtMjA2LjAzMzg4NCANCkwgMjczLjc1MzYxNiAtMjA2LjAzMzg4NCANCkwgMjczLjU5Mzc4MiAtMjA2LjAzMzg4NCANCkwgMjczLjQzMzk0OCAtMjA2LjAzMzg4NCANCkwgMjczLjI3NDExNCAtMjA2LjAzMzg4NCANCkwgMjczLjExNDI4IC0yMDYuMDMzODg0IA0KTCAyNzIuOTU0NDQ2IC0yMDYuMDMzODg0IA0KTCAyNzIuNzk0NjEzIC0yMDYuMDMzODg0IA0KTCAyNzIuNjM0Nzc5IC0yMDYuMDMzODg0IA0KTCAyNzIuNDc0OTQ1IC0yMDYuMDMzODg0IA0KTCAyNzIuMzE1MTExIC0yMDYuMDMzODg0IA0KTCAyNzIuMTU1Mjc3IC0yMDYuMDMzODg0IA0KTCAyNzEuOTk1NDQzIC0yMDYuMDMzODg0IA0KTCAyNzEuODM1NjA5IC0yMDYuMDMzODg0IA0KTCAyNzEuNjc1Nzc1IC0yMDYuMDMzODg0IA0KTCAyNzEuNTE1OTQxIC0yMDYuMDMzODg0IA0KTCAyNzEuMzU2MTA4IC0yMDYuMDMzODg0IA0KTCAyNzEuMTk2Mjc0IC0yMDYuMDMzODg0IA0KTCAyNzEuMDM2NDQgLTIwNi4wMzM4ODQgDQpMIDI3MC44NzY2MDYgLTIwNi4wMzM4ODQgDQpMIDI3MC43MTY3NzIgLTIwNi4wMzM4ODQgDQpMIDI3MC41NTY5MzggLTIwNi4wMzM4ODQgDQpMIDI3MC4zOTcxMDQgLTIwNi4wMzM4ODQgDQpMIDI3MC4yMzcyNyAtMjA2LjAzMzg4NCANCkwgMjcwLjA3NzQzNyAtMjA2LjAzMzg4NCANCkwgMjY5LjkxNzYwMyAtMjA2LjAzMzg4NCANCkwgMjY5Ljc1Nzc2OSAtMjA2LjAzMzg4NCANCkwgMjY5LjU5NzkzNSAtMjA2LjAzMzg4NCANCkwgMjY5LjQzODEwMSAtMjA2LjAzMzg4NCANCkwgMjY5LjI3ODI2NyAtMjA2LjAzMzg4NCANCkwgMjY5LjExODQzMyAtMjA2LjAzMzg4NCANCkwgMjY4Ljk1ODU5OSAtMjA2LjAzMzg4NCANCkwgMjY4Ljc5ODc2NSAtMjA2LjAzMzg4NCANCkwgMjY4LjYzODkzMiAtMjA2LjAzMzg4NCANCkwgMjY4LjQ3OTA5OCAtMjA2LjAzMzg4NCANCkwgMjY4LjMxOTI2NCAtMjA2LjAzMzg4NCANCkwgMjY4LjE1OTQzIC0yMDYuMDMzODg0IA0KTCAyNjcuOTk5NTk2IC0yMDYuMDMzODg0IA0KTCAyNjcuODM5NzYyIC0yMDYuMDMzODg0IA0KTCAyNjcuNjc5OTI4IC0yMDYuMDMzODg0IA0KTCAyNjcuNTIwMDk0IC0yMDYuMDMzODg0IA0KTCAyNjcuMzYwMjYxIC0yMDYuMDMzODg0IA0KTCAyNjcuMjAwNDI3IC0yMDYuMDMzODg0IA0KTCAyNjcuMDQwNTkzIC0yMDYuMDMzODg0IA0KTCAyNjYuODgwNzU5IC0yMDYuMDMzODg0IA0KTCAyNjYuNzIwOTI1IC0yMDYuMDMzODg0IA0KTCAyNjYuNTYxMDkxIC0yMDYuMDMzODg0IA0KTCAyNjYuNDAxMjU3IC0yMDYuMDMzODg0IA0KTCAyNjYuMjQxNDIzIC0yMDYuMDMzODg0IA0KTCAyNjYuMDgxNTg5IC0yMDYuMDMzODg0IA0KTCAyNjUuOTIxNzU2IC0yMDYuMDMzODg0IA0KTCAyNjUuNzYxOTIyIC0yMDYuMDMzODg0IA0KTCAyNjUuNjAyMDg4IC0yMDYuMDMzODg0IA0KTCAyNjUuNDQyMjU0IC0yMDYuMDMzODg0IA0KTCAyNjUuMjgyNDIgLTIwNi4wMzM4ODQgDQpMIDI2NS4xMjI1ODYgLTIwNi4wMzM4ODQgDQpMIDI2NC45NjI3NTIgLTIwNi4wMzM4ODQgDQpMIDI2NC44MDI5MTggLTIwNi4wMzM4ODQgDQpMIDI2NC42NDMwODQgLTIwNi4wMzM4ODQgDQpMIDI2NC40ODMyNTEgLTIwNi4wMzM4ODQgDQpMIDI2NC4zMjM0MTcgLTIwNi4wMzM4ODQgDQpMIDI2NC4xNjM1ODMgLTIwNi4wMzM4ODQgDQpMIDI2NC4wMDM3NDkgLTIwNi4wMzM4ODQgDQpMIDI2My44NDM5MTUgLTIwNi4wMzM4ODQgDQpMIDI2My42ODQwODEgLTIwNi4wMzM4ODQgDQpMIDI2My41MjQyNDcgLTIwNi4wMzM4ODQgDQpMIDI2My4zNjQ0MTMgLTIwNi4wMzM4ODQgDQpMIDI2My4yMDQ1OCAtMjA2LjAzMzg4NCANCkwgMjYzLjA0NDc0NiAtMjA2LjAzMzg4NCANCkwgMjYyLjg4NDkxMiAtMjA2LjAzMzg4NCANCkwgMjYyLjcyNTA3OCAtMjA2LjAzMzg4NCANCkwgMjYyLjU2NTI0NCAtMjA2LjAzMzg4NCANCkwgMjYyLjQwNTQxIC0yMDYuMDMzODg0IA0KTCAyNjIuMjQ1NTc2IC0yMDYuMDMzODg0IA0KTCAyNjIuMDg1NzQyIC0yMDYuMDMzODg0IA0KTCAyNjEuOTI1OTA4IC0yMDYuMDMzODg0IA0KTCAyNjEuNzY2MDc1IC0yMDYuMDMzODg0IA0KTCAyNjEuNjA2MjQxIC0yMDYuMDMzODg0IA0KTCAyNjEuNDQ2NDA3IC0yMDYuMDMzODg0IA0KTCAyNjEuMjg2NTczIC0yMDYuMDMzODg0IA0KTCAyNjEuMTI2NzM5IC0yMDYuMDMzODg0IA0KTCAyNjAuOTY2OTA1IC0yMDYuMDMzODg0IA0KTCAyNjAuODA3MDcxIC0yMDYuMDMzODg0IA0KTCAyNjAuNjQ3MjM3IC0yMDYuMDMzODg0IA0KTCAyNjAuNDg3NDAzIC0yMDYuMDMzODg0IA0KTCAyNjAuMzI3NTcgLTIwNi4wMzM4ODQgDQpMIDI2MC4xNjc3MzYgLTIwNi4wMzM4ODQgDQpMIDI2MC4wMDc5MDIgLTIwNi4wMzM4ODQgDQpMIDI1OS44NDgwNjggLTIwNi4wMzM4ODQgDQpMIDI1OS42ODgyMzQgLTIwNi4wMzM4ODQgDQpMIDI1OS41Mjg0IC0yMDYuMDMzODg0IA0KTCAyNTkuMzY4NTY2IC0yMDYuMDMzODg0IA0KTCAyNTkuMjA4NzMyIC0yMDYuMDMzODg0IA0KTCAyNTkuMDQ4ODk5IC0yMDYuMDMzODg0IA0KTCAyNTguODg5MDY1IC0yMDYuMDMzODg0IA0KTCAyNTguNzI5MjMxIC0yMDYuMDMzODg0IA0KTCAyNTguNTY5Mzk3IC0yMDYuMDMzODg0IA0KTCAyNTguNDA5NTYzIC0yMDYuMDMzODg0IA0KTCAyNTguMjQ5NzI5IC0yMDYuMDMzODg0IA0KTCAyNTguMDg5ODk1IC0yMDYuMDMzODg0IA0KTCAyNTcuOTMwMDYxIC0yMDYuMDMzODg0IA0KTCAyNTcuNzcwMjI3IC0yMDYuMDMzODg0IA0KTCAyNTcuNjEwMzk0IC0yMDYuMDMzODg0IA0KTCAyNTcuNDUwNTYgLTIwNi4wMzM4ODQgDQpMIDI1Ny4yOTA3MjYgLTIwNi4wMzM4ODQgDQpMIDI1Ny4xMzA4OTIgLTIwNi4wMzM4ODQgDQpMIDI1Ni45NzEwNTggLTIwNi4wMzM4ODQgDQpMIDI1Ni44MTEyMjQgLTIwNi4wMzM4ODQgDQpMIDI1Ni42NTEzOSAtMjA2LjAzMzg4NCANCkwgMjU2LjQ5MTU1NiAtMjA2LjAzMzg4NCANCkwgMjU2LjMzMTcyMyAtMjA2LjAzMzg4NCANCkwgMjU2LjE3MTg4OSAtMjA2LjAzMzg4NCANCkwgMjU2LjAxMjA1NSAtMjA2LjAzMzg4NCANCkwgMjU1Ljg1MjIyMSAtMjA2LjAzMzg4NCANCkwgMjU1LjY5MjM4NyAtMjA2LjAzMzg4NCANCkwgMjU1LjUzMjU1MyAtMjA2LjAzMzg4NCANCkwgMjU1LjM3MjcxOSAtMjA2LjAzMzg4NCANCkwgMjU1LjIxMjg4NSAtMjA2LjAzMzg4NCANCkwgMjU1LjA1MzA1MSAtMjA2LjAzMzg4NCANCkwgMjU0Ljg5MzIxOCAtMjA2LjAzMzg4NCANCkwgMjU0LjczMzM4NCAtMjA2LjAzMzg4NCANCkwgMjU0LjU3MzU1IC0yMDYuMDMzODg0IA0KTCAyNTQuNDEzNzE2IC0yMDYuMDMzODg0IA0KTCAyNTQuMjUzODgyIC0yMDYuMDMzODg0IA0KTCAyNTQuMDk0MDQ4IC0yMDYuMDMzODg0IA0KTCAyNTMuOTM0MjE0IC0yMDYuMDMzODg0IA0KTCAyNTMuNzc0MzggLTIwNi4wMzM4ODQgDQpMIDI1My42MTQ1NDYgLTIwNi4wMzM4ODQgDQpMIDI1My40NTQ3MTMgLTIwNi4wMzM4ODQgDQpMIDI1My4yOTQ4NzkgLTIwNi4wMzM4ODQgDQpMIDI1My4xMzUwNDUgLTIwNi4wMzM4ODQgDQpMIDI1Mi45NzUyMTEgLTIwNi4wMzM4ODQgDQpMIDI1Mi44MTUzNzcgLTIwNi4wMzM4ODQgDQpMIDI1Mi42NTU1NDMgLTIwNi4wMzM4ODQgDQpMIDI1Mi40OTU3MDkgLTIwNi4wMzM4ODQgDQpMIDI1Mi4zMzU4NzUgLTIwNi4wMzM4ODQgDQpMIDI1Mi4xNzYwNDIgLTIwNi4wMzM4ODQgDQpMIDI1Mi4wMTYyMDggLTIwNi4wMzM4ODQgDQpMIDI1MS44NTYzNzQgLTIwNi4wMzM4ODQgDQpMIDI1MS42OTY1NCAtMjA2LjAzMzg4NCANCkwgMjUxLjUzNjcwNiAtMjA2LjAzMzg4NCANCkwgMjUxLjM3Njg3MiAtMjA2LjAzMzg4NCANCkwgMjUxLjIxNzAzOCAtMjA2LjAzMzg4NCANCkwgMjUxLjA1NzIwNCAtMjA2LjAzMzg4NCANCkwgMjUwLjg5NzM3IC0yMDYuMDMzODg0IA0KTCAyNTAuNzM3NTM3IC0yMDYuMDMzODg0IA0KTCAyNTAuNTc3NzAzIC0yMDYuMDMzODg0IA0KTCAyNTAuNDE3ODY5IC0yMDYuMDMzODg0IA0KTCAyNTAuMjU4MDM1IC0yMDYuMDMzODg0IA0KTCAyNTAuMDk4MjAxIC0yMDYuMDMzODg0IA0KTCAyNDkuOTM4MzY3IC0yMDYuMDMzODg0IA0KTCAyNDkuNzc4NTMzIC0yMDYuMDMzODg0IA0KTCAyNDkuNjE4Njk5IC0yMDYuMDMzODg0IA0KTCAyNDkuNDU4ODY2IC0yMDYuMDMzODg0IA0KTCAyNDkuMjk5MDMyIC0yMDYuMDMzODg0IA0KTCAyNDkuMTM5MTk4IC0yMDYuMDMzODg0IA0KTCAyNDguOTc5MzY0IC0yMDYuMDMzODg0IA0KTCAyNDguODE5NTMgLTIwNi4wMzM4ODQgDQpMIDI0OC42NTk2OTYgLTIwNi4wMzM4ODQgDQpMIDI0OC40OTk4NjIgLTIwNi4wMzM4ODQgDQpMIDI0OC4zNDAwMjggLTIwNi4wMzM4ODQgDQpMIDI0OC4xODAxOTQgLTIwNi4wMzM4ODQgDQpMIDI0OC4wMjAzNjEgLTIwNi4wMzM4ODQgDQpMIDI0Ny44NjA1MjcgLTIwNi4wMzM4ODQgDQpMIDI0Ny43MDA2OTMgLTIwNi4wMzM4ODQgDQpMIDI0Ny41NDA4NTkgLTIwNi4wMzM4ODQgDQpMIDI0Ny4zODEwMjUgLTIwNi4wMzM4ODQgDQpMIDI0Ny4yMjExOTEgLTIwNi4wMzM4ODQgDQpMIDI0Ny4wNjEzNTcgLTIwNi4wMzM4ODQgDQpMIDI0Ni45MDE1MjMgLTIwNi4wMzM4ODQgDQpMIDI0Ni43NDE2ODkgLTIwNi4wMzM4ODQgDQpMIDI0Ni41ODE4NTYgLTIwNi4wMzM4ODQgDQpMIDI0Ni40MjIwMjIgLTIwNi4wMzM4ODQgDQpMIDI0Ni4yNjIxODggLTIwNi4wMzM4ODQgDQpMIDI0Ni4xMDIzNTQgLTIwNi4wMzM4ODQgDQpMIDI0NS45NDI1MiAtMjA2LjAzMzg4NCANCkwgMjQ1Ljc4MjY4NiAtMjA2LjAzMzg4NCANCkwgMjQ1LjYyMjg1MiAtMjA2LjAzMzg4NCANCkwgMjQ1LjQ2MzAxOCAtMjA2LjAzMzg4NCANCkwgMjQ1LjMwMzE4NSAtMjA2LjAzMzg4NCANCkwgMjQ1LjE0MzM1MSAtMjA2LjAzMzg4NCANCkwgMjQ0Ljk4MzUxNyAtMjA2LjAzMzg4NCANCkwgMjQ0LjgyMzY4MyAtMjA2LjAzMzg4NCANCkwgMjQ0LjY2Mzg0OSAtMjA2LjAzMzg4NCANCkwgMjQ0LjUwNDAxNSAtMjA2LjAzMzg4NCANCkwgMjQ0LjM0NDE4MSAtMjA2LjAzMzg4NCANCkwgMjQ0LjE4NDM0NyAtMjA2LjAzMzg4NCANCkwgMjQ0LjAyNDUxMyAtMjA2LjAzMzg4NCANCkwgMjQzLjg2NDY4IC0yMDYuMDMzODg0IA0KTCAyNDMuNzA0ODQ2IC0yMDYuMDMzODg0IA0KTCAyNDMuNTQ1MDEyIC0yMDYuMDMzODg0IA0KTCAyNDMuMzg1MTc4IC0yMDYuMDMzODg0IA0KTCAyNDMuMjI1MzQ0IC0yMDYuMDMzODg0IA0KTCAyNDMuMDY1NTEgLTIwNi4wMzM4ODQgDQpMIDI0Mi45MDU2NzYgLTIwNi4wMzM4ODQgDQpMIDI0Mi43NDU4NDIgLTIwNi4wMzM4ODQgDQpMIDI0Mi41ODYwMDggLTIwNi4wMzM4ODQgDQpMIDI0Mi40MjYxNzUgLTIwNi4wMzM4ODQgDQpMIDI0Mi4yNjYzNDEgLTIwNi4wMzM4ODQgDQpMIDI0Mi4xMDY1MDcgLTIwNi4wMzM4ODQgDQpMIDI0MS45NDY2NzMgLTIwNi4wMzM4ODQgDQpMIDI0MS43ODY4MzkgLTIwNi4wMzM4ODQgDQpMIDI0MS42MjcwMDUgLTIwNi4wMzM4ODQgDQpMIDI0MS40NjcxNzEgLTIwNi4wMzM4ODQgDQpMIDI0MS4zMDczMzcgLTIwNi4wMzM4ODQgDQpMIDI0MS4xNDc1MDQgLTIwNi4wMzM4ODQgDQpMIDI0MC45ODc2NyAtMjA2LjAzMzg4NCANCkwgMjQwLjgyNzgzNiAtMjA2LjAzMzg4NCANCkwgMjQwLjY2ODAwMiAtMjA2LjAzMzg4NCANCkwgMjQwLjUwODE2OCAtMjA2LjAzMzg4NCANCkwgMjQwLjM0ODMzNCAtMjA2LjAzMzg4NCANCkwgMjQwLjE4ODUgLTIwNi4wMzM4ODQgDQpMIDI0MC4wMjg2NjYgLTIwNi4wMzM4ODQgDQpMIDIzOS44Njg4MzIgLTIwNi4wMzM4ODQgDQpMIDIzOS43MDg5OTkgLTIwNi4wMzM4ODQgDQpMIDIzOS41NDkxNjUgLTIwNi4wMzM4ODQgDQpMIDIzOS4zODkzMzEgLTIwNi4wMzM4ODQgDQpMIDIzOS4yMjk0OTcgLTIwNi4wMzM4ODQgDQpMIDIzOS4wNjk2NjMgLTIwNi4wMzM4ODQgDQpMIDIzOC45MDk4MjkgLTIwNi4wMzM4ODQgDQpMIDIzOC43NDk5OTUgLTIwNi4wMzM4ODQgDQpMIDIzOC41OTAxNjEgLTIwNi4wMzM4ODQgDQpMIDIzOC40MzAzMjggLTIwNi4wMzM4ODQgDQpMIDIzOC4yNzA0OTQgLTIwNi4wMzM4ODQgDQpMIDIzOC4xMTA2NiAtMjA2LjAzMzg4NCANCkwgMjM3Ljk1MDgyNiAtMjA2LjAzMzg4NCANCkwgMjM3Ljc5MDk5MiAtMjA2LjAzMzg4NCANCkwgMjM3LjYzMTE1OCAtMjA2LjAzMzg4NCANCkwgMjM3LjQ3MTMyNCAtMjA2LjAzMzg4NCANCkwgMjM3LjMxMTQ5IC0yMDYuMDMzODg0IA0KTCAyMzcuMTUxNjU2IC0yMDYuMDMzODg0IA0KTCAyMzYuOTkxODIzIC0yMDYuMDMzODg0IA0KTCAyMzYuODMxOTg5IC0yMDYuMDMzODg0IA0KTCAyMzYuNjcyMTU1IC0yMDYuMDMzODg0IA0KTCAyMzYuNTEyMzIxIC0yMDYuMDMzODg0IA0KTCAyMzYuMzUyNDg3IC0yMDYuMDMzODg0IA0KTCAyMzYuMTkyNjUzIC0yMDYuMDMzODg0IA0KTCAyMzYuMDMyODE5IC0yMDYuMDMzODg0IA0KTCAyMzUuODcyOTg1IC0yMDYuMDMzODg0IA0KTCAyMzUuNzEzMTUxIC0yMDYuMDMzODg0IA0KTCAyMzUuNTUzMzE4IC0yMDYuMDMzODg0IA0KTCAyMzUuMzkzNDg0IC0yMDYuMDMzODg0IA0KTCAyMzUuMjMzNjUgLTIwNi4wMzM4ODQgDQpMIDIzNS4wNzM4MTYgLTIwNi4wMzM4ODQgDQpMIDIzNC45MTM5ODIgLTIwNi4wMzM4ODQgDQpMIDIzNC43NTQxNDggLTIwNi4wMzM4ODQgDQpMIDIzNC41OTQzMTQgLTIwNi4wMzM4ODQgDQpMIDIzNC40MzQ0OCAtMjA2LjAzMzg4NCANCkwgMjM0LjI3NDY0NyAtMjA2LjAzMzg4NCANCkwgMjM0LjExNDgxMyAtMjA2LjAzMzg4NCANCkwgMjMzLjk1NDk3OSAtMjA2LjAzMzg4NCANCkwgMjMzLjc5NTE0NSAtMjA2LjAzMzg4NCANCkwgMjMzLjYzNTMxMSAtMjA2LjAzMzg4NCANCkwgMjMzLjQ3NTQ3NyAtMjA2LjAzMzg4NCANCkwgMjMzLjMxNTY0MyAtMjA2LjAzMzg4NCANCkwgMjMzLjE1NTgwOSAtMjA2LjAzMzg4NCANCkwgMjMyLjk5NTk3NSAtMjA2LjAzMzg4NCANCkwgMjMyLjgzNjE0MiAtMjA2LjAzMzg4NCANCkwgMjMyLjY3NjMwOCAtMjA2LjAzMzg4NCANCkwgMjMyLjUxNjQ3NCAtMjA2LjAzMzg4NCANCkwgMjMyLjM1NjY0IC0yMDYuMDMzODg0IA0KTCAyMzIuMTk2ODA2IC0yMDYuMDMzODg0IA0KTCAyMzIuMDM2OTcyIC0yMDYuMDMzODg0IA0KTCAyMzEuODc3MTM4IC0yMDYuMDMzODg0IA0KTCAyMzEuNzE3MzA0IC0yMDYuMDMzODg0IA0KTCAyMzEuNTU3NDcxIC0yMDYuMDMzODg0IA0KTCAyMzEuMzk3NjM3IC0yMDYuMDMzODg0IA0KTCAyMzEuMjM3ODAzIC0yMDYuMDMzODg0IA0KTCAyMzEuMDc3OTY5IC0yMDYuMDMzODg0IA0KTCAyMzAuOTE4MTM1IC0yMDYuMDMzODg0IA0KTCAyMzAuNzU4MzAxIC0yMDYuMDMzODg0IA0KTCAyMzAuNTk4NDY3IC0yMDYuMDMzODg0IA0KTCAyMzAuNDM4NjMzIC0yMDYuMDMzODg0IA0KTCAyMzAuMjc4Nzk5IC0yMDYuMDMzODg0IA0KTCAyMzAuMTE4OTY2IC0yMDYuMDMzODg0IA0KTCAyMjkuOTU5MTMyIC0yMDYuMDMzODg0IA0KTCAyMjkuNzk5Mjk4IC0yMDYuMDMzODg0IA0KTCAyMjkuNjM5NDY0IC0yMDYuMDMzODg0IA0KTCAyMjkuNDc5NjMgLTIwNi4wMzM4ODQgDQpMIDIyOS4zMTk3OTYgLTIwNi4wMzM4ODQgDQpMIDIyOS4xNTk5NjIgLTIwNi4wMzM4ODQgDQpMIDIyOS4wMDAxMjggLTIwNi4wMzM4ODQgDQpMIDIyOC44NDAyOTQgLTIwNi4wMzM4ODQgDQpMIDIyOC42ODA0NjEgLTIwNi4wMzM4ODQgDQpMIDIyOC41MjA2MjcgLTIwNi4wMzM4ODQgDQpMIDIyOC4zNjA3OTMgLTIwNi4wMzM4ODQgDQpMIDIyOC4yMDA5NTkgLTIwNi4wMzM4ODQgDQpMIDIyOC4wNDExMjUgLTIwNi4wMzM4ODQgDQpMIDIyNy44ODEyOTEgLTIwNi4wMzM4ODQgDQpMIDIyNy43MjE0NTcgLTIwNi4wMzM4ODQgDQpMIDIyNy41NjE2MjMgLTIwNi4wMzM4ODQgDQpMIDIyNy40MDE3OSAtMjA2LjAzMzg4NCANCkwgMjI3LjI0MTk1NiAtMjA2LjAzMzg4NCANCkwgMjI3LjA4MjEyMiAtMjA2LjAzMzg4NCANCkwgMjI2LjkyMjI4OCAtMjA2LjAzMzg4NCANCkwgMjI2Ljc2MjQ1NCAtMjA2LjAzMzg4NCANCkwgMjI2LjYwMjYyIC0yMDYuMDMzODg0IA0KTCAyMjYuNDQyNzg2IC0yMDYuMDMzODg0IA0KTCAyMjYuMjgyOTUyIC0yMDYuMDMzODg0IA0KTCAyMjYuMTIzMTE4IC0yMDYuMDMzODg0IA0KTCAyMjUuOTYzMjg1IC0yMDYuMDMzODg0IA0KTCAyMjUuODAzNDUxIC0yMDYuMDMzODg0IA0KTCAyMjUuNjQzNjE3IC0yMDYuMDMzODg0IA0KTCAyMjUuNDgzNzgzIC0yMDYuMDMzODg0IA0KTCAyMjUuMzIzOTQ5IC0yMDYuMDMzODg0IA0KTCAyMjUuMTY0MTE1IC0yMDYuMDMzODg0IA0KTCAyMjUuMDA0MjgxIC0yMDYuMDMzODg0IA0KTCAyMjQuODQ0NDQ3IC0yMDYuMDMzODg0IA0KTCAyMjQuNjg0NjEzIC0yMDYuMDMzODg0IA0KTCAyMjQuNTI0NzggLTIwNi4wMzM4ODQgDQpMIDIyNC4zNjQ5NDYgLTIwNi4wMzM4ODQgDQpMIDIyNC4yMDUxMTIgLTIwNi4wMzM4ODQgDQpMIDIyNC4wNDUyNzggLTIwNi4wMzM4ODQgDQpMIDIyMy44ODU0NDQgLTIwNi4wMzM4ODQgDQpMIDIyMy43MjU2MSAtMjA2LjAzMzg4NCANCkwgMjIzLjU2NTc3NiAtMjA2LjAzMzg4NCANCkwgMjIzLjQwNTk0MiAtMjA2LjAzMzg4NCANCkwgMjIzLjI0NjEwOSAtMjA2LjAzMzg4NCANCkwgMjIzLjA4NjI3NSAtMjA2LjAzMzg4NCANCkwgMjIyLjkyNjQ0MSAtMjA2LjAzMzg4NCANCkwgMjIyLjc2NjYwNyAtMjA2LjAzMzg4NCANCkwgMjIyLjYwNjc3MyAtMjA2LjAzMzg4NCANCkwgMjIyLjQ0NjkzOSAtMjA2LjAzMzg4NCANCkwgMjIyLjI4NzEwNSAtMjA2LjAzMzg4NCANCkwgMjIyLjEyNzI3MSAtMjA2LjAzMzg4NCANCkwgMjIxLjk2NzQzNyAtMjA2LjAzMzg4NCANCkwgMjIxLjgwNzYwNCAtMjA2LjAzMzg4NCANCkwgMjIxLjY0Nzc3IC0yMDYuMDMzODg0IA0KTCAyMjEuNDg3OTM2IC0yMDYuMDMzODg0IA0KTCAyMjEuMzI4MTAyIC0yMDYuMDMzODg0IA0KTCAyMjEuMTY4MjY4IC0yMDYuMDMzODg0IA0KTCAyMjEuMDA4NDM0IC0yMDYuMDMzODg0IA0KTCAyMjAuODQ4NiAtMjA2LjAzMzg4NCANCkwgMjIwLjY4ODc2NiAtMjA2LjAzMzg4NCANCkwgMjIwLjUyODkzMyAtMjA2LjAzMzg4NCANCkwgMjIwLjM2OTA5OSAtMjA2LjAzMzg4NCANCkwgMjIwLjIwOTI2NSAtMjA2LjAzMzg4NCANCkwgMjIwLjA0OTQzMSAtMjA2LjAzMzg4NCANCkwgMjE5Ljg4OTU5NyAtMjA2LjAzMzg4NCANCkwgMjE5LjcyOTc2MyAtMjA2LjAzMzg4NCANCkwgMjE5LjU2OTkyOSAtMjA2LjAzMzg4NCANCkwgMjE5LjQxMDA5NSAtMjA2LjAzMzg4NCANCkwgMjE5LjI1MDI2MSAtMjA2LjAzMzg4NCANCkwgMjE5LjA5MDQyOCAtMjA2LjAzMzg4NCANCkwgMjE4LjkzMDU5NCAtMjA2LjAzMzg4NCANCkwgMjE4Ljc3MDc2IC0yMDYuMDMzODg0IA0KTCAyMTguNjEwOTI2IC0yMDYuMDMzODg0IA0KTCAyMTguNDUxMDkyIC0yMDYuMDMzODg0IA0KTCAyMTguMjkxMjU4IC0yMDYuMDMzODg0IA0KTCAyMTguMTMxNDI0IC0yMDYuMDMzODg0IA0KTCAyMTcuOTcxNTkgLTIwNi4wMzM4ODQgDQpMIDIxNy44MTE3NTYgLTIwNi4wMzM4ODQgDQpMIDIxNy42NTE5MjMgLTIwNi4wMzM4ODQgDQpMIDIxNy40OTIwODkgLTIwNi4wMzM4ODQgDQpMIDIxNy4zMzIyNTUgLTIwNi4wMzM4ODQgDQpMIDIxNy4xNzI0MjEgLTIwNi4wMzM4ODQgDQpMIDIxNy4wMTI1ODcgLTIwNi4wMzM4ODQgDQpMIDIxNi44NTI3NTMgLTIwNi4wMzM4ODQgDQpMIDIxNi42OTI5MTkgLTIwNi4wMzM4ODQgDQpMIDIxNi41MzMwODUgLTIwNi4wMzM4ODQgDQpMIDIxNi4zNzMyNTIgLTIwNi4wMzM4ODQgDQpMIDIxNi4yMTM0MTggLTIwNi4wMzM4ODQgDQpMIDIxNi4wNTM1ODQgLTIwNi4wMzM4ODQgDQpMIDIxNS44OTM3NSAtMjA2LjAzMzg4NCANCkwgMjE1LjczMzkxNiAtMjA2LjAzMzg4NCANCkwgMjE1LjU3NDA4MiAtMjA2LjAzMzg4NCANCkwgMjE1LjQxNDI0OCAtMjA2LjAzMzg4NCANCkwgMjE1LjI1NDQxNCAtMjA2LjAzMzg4NCANCkwgMjE1LjA5NDU4IC0yMDYuMDMzODg0IA0KTCAyMTQuOTM0NzQ3IC0yMDYuMDMzODg0IA0KTCAyMTQuNzc0OTEzIC0yMDYuMDMzODg0IA0KTCAyMTQuNjE1MDc5IC0yMDYuMDMzODg0IA0KTCAyMTQuNDU1MjQ1IC0yMDYuMDMzODg0IA0KTCAyMTQuMjk1NDExIC0yMDYuMDMzODg0IA0KTCAyMTQuMTM1NTc3IC0yMDYuMDMzODg0IA0KTCAyMTMuOTc1NzQzIC0yMDYuMDMzODg0IA0KTCAyMTMuODE1OTA5IC0yMDYuMDMzODg0IA0KTCAyMTMuNjU2MDc2IC0yMDYuMDMzODg0IA0KTCAyMTMuNDk2MjQyIC0yMDYuMDMzODg0IA0KTCAyMTMuMzM2NDA4IC0yMDYuMDMzODg0IA0KTCAyMTMuMTc2NTc0IC0yMDYuMDMzODg0IA0KTCAyMTMuMDE2NzQgLTIwNi4wMzM4ODQgDQpMIDIxMi44NTY5MDYgLTIwNi4wMzM4ODQgDQpMIDIxMi42OTcwNzIgLTIwNi4wMzM4ODQgDQpMIDIxMi41MzcyMzggLTIwNi4wMzM4ODQgDQpMIDIxMi4zNzc0MDQgLTIwNi4wMzM4ODQgDQpMIDIxMi4yMTc1NzEgLTIwNi4wMzM4ODQgDQpMIDIxMi4wNTc3MzcgLTIwNi4wMzM4ODQgDQpMIDIxMS44OTc5MDMgLTIwNi4wMzM4ODQgDQpMIDIxMS43MzgwNjkgLTIwNi4wMzM4ODQgDQpMIDIxMS41NzgyMzUgLTIwNi4wMzM4ODQgDQpMIDIxMS40MTg0MDEgLTIwNi4wMzM4ODQgDQpMIDIxMS4yNTg1NjcgLTIwNi4wMzM4ODQgDQpMIDIxMS4wOTg3MzMgLTIwNi4wMzM4ODQgDQpMIDIxMC45Mzg4OTkgLTIwNi4wMzM4ODQgDQpMIDIxMC43NzkwNjYgLTIwNi4wMzM4ODQgDQpMIDIxMC42MTkyMzIgLTIwNi4wMzM4ODQgDQpMIDIxMC40NTkzOTggLTIwNi4wMzM4ODQgDQpMIDIxMC4yOTk1NjQgLTIwNi4wMzM4ODQgDQpMIDIxMC4xMzk3MyAtMjA2LjAzMzg4NCANCkwgMjA5Ljk3OTg5NiAtMjA2LjAzMzg4NCANCkwgMjA5LjgyMDA2MiAtMjA2LjAzMzg4NCANCkwgMjA5LjY2MDIyOCAtMjA2LjAzMzg4NCANCkwgMjA5LjUwMDM5NSAtMjA2LjAzMzg4NCANCkwgMjA5LjM0MDU2MSAtMjA2LjAzMzg4NCANCkwgMjA5LjE4MDcyNyAtMjA2LjAzMzg4NCANCkwgMjA5LjAyMDg5MyAtMjA2LjAzMzg4NCANCkwgMjA4Ljg2MTA1OSAtMjA2LjAzMzg4NCANCkwgMjA4LjcwMTIyNSAtMjA2LjAzMzg4NCANCkwgMjA4LjU0MTM5MSAtMjA2LjAzMzg4NCANCkwgMjA4LjM4MTU1NyAtMjA2LjAzMzg4NCANCkwgMjA4LjIyMTcyMyAtMjA2LjAzMzg4NCANCkwgMjA4LjA2MTg5IC0yMDYuMDMzODg0IA0KTCAyMDcuOTAyMDU2IC0yMDYuMDMzODg0IA0KTCAyMDcuNzQyMjIyIC0yMDYuMDMzODg0IA0KTCAyMDcuNTgyMzg4IC0yMDYuMDMzODg0IA0KTCAyMDcuNDIyNTU0IC0yMDYuMDMzODg0IA0KTCAyMDcuMjYyNzIgLTIwNi4wMzM4ODQgDQpMIDIwNy4xMDI4ODYgLTIwNi4wMzM4ODQgDQpMIDIwNi45NDMwNTIgLTIwNi4wMzM4ODQgDQpMIDIwNi43ODMyMTggLTIwNi4wMzM4ODQgDQpMIDIwNi42MjMzODUgLTIwNi4wMzM4ODQgDQpMIDIwNi40NjM1NTEgLTIwNi4wMzM4ODQgDQpMIDIwNi4zMDM3MTcgLTIwNi4wMzM4ODQgDQpMIDIwNi4xNDM4ODMgLTIwNi4wMzM4ODQgDQpMIDIwNS45ODQwNDkgLTIwNi4wMzM4ODQgDQpMIDIwNS44MjQyMTUgLTIwNi4wMzM4ODQgDQpMIDIwNS42NjQzODEgLTIwNi4wMzM4ODQgDQpMIDIwNS41MDQ1NDcgLTIwNi4wMzM4ODQgDQpMIDIwNS4zNDQ3MTQgLTIwNi4wMzM4ODQgDQpMIDIwNS4xODQ4OCAtMjA2LjAzMzg4NCANCkwgMjA1LjAyNTA0NiAtMjA2LjAzMzg4NCANCkwgMjA0Ljg2NTIxMiAtMjA2LjAzMzg4NCANCkwgMjA0LjcwNTM3OCAtMjA2LjAzMzg4NCANCkwgMjA0LjU0NTU0NCAtMjA2LjAzMzg4NCANCkwgMjA0LjM4NTcxIC0yMDYuMDMzODg0IA0KTCAyMDQuMjI1ODc2IC0yMDYuMDMzODg0IA0KTCAyMDQuMDY2MDQyIC0yMDYuMDMzODg0IA0KTCAyMDMuOTA2MjA5IC0yMDYuMDMzODg0IA0KTCAyMDMuNzQ2Mzc1IC0yMDYuMDMzODg0IA0KTCAyMDMuNTg2NTQxIC0yMDYuMDMzODg0IA0KTCAyMDMuNDI2NzA3IC0yMDYuMDMzODg0IA0KTCAyMDMuMjY2ODczIC0yMDYuMDMzODg0IA0KTCAyMDMuMTA3MDM5IC0yMDYuMDMzODg0IA0KTCAyMDIuOTQ3MjA1IC0yMDYuMDMzODg0IA0KTCAyMDIuNzg3MzcxIC0yMDYuMDMzODg0IA0KTCAyMDIuNjI3NTM4IC0yMDYuMDMzODg0IA0KTCAyMDIuNDY3NzA0IC0yMDYuMDMzODg0IA0KTCAyMDIuMzA3ODcgLTIwNi4wMzM4ODQgDQpMIDIwMi4xNDgwMzYgLTIwNi4wMzM4ODQgDQpMIDIwMS45ODgyMDIgLTIwNi4wMzM4ODQgDQpMIDIwMS44MjgzNjggLTIwNi4wMzM4ODQgDQpMIDIwMS42Njg1MzQgLTIwNi4wMzM4ODQgDQpMIDIwMS41MDg3IC0yMDYuMDMzODg0IA0KTCAyMDEuMzQ4ODY2IC0yMDYuMDMzODg0IA0KTCAyMDEuMTg5MDMzIC0yMDYuMDMzODg0IA0KTCAyMDEuMDI5MTk5IC0yMDYuMDMzODg0IA0KTCAyMDAuODY5MzY1IC0yMDYuMDMzODg0IA0KTCAyMDAuNzA5NTMxIC0yMDYuMDMzODg0IA0KTCAyMDAuNTQ5Njk3IC0yMDYuMDMzODg0IA0KTCAyMDAuMzg5ODYzIC0yMDYuMDMzODg0IA0KTCAyMDAuMjMwMDI5IC0yMDYuMDMzODg0IA0KTCAyMDAuMDcwMTk1IC0yMDYuMDMzODg0IA0KTCAxOTkuOTEwMzYxIC0yMDYuMDMzODg0IA0KTCAxOTkuNzUwNTI4IC0yMDYuMDMzODg0IA0KTCAxOTkuNTkwNjk0IC0yMDYuMDMzODg0IA0KTCAxOTkuNDMwODYgLTIwNi4wMzM4ODQgDQpMIDE5OS4yNzEwMjYgLTIwNi4wMzM4ODQgDQpMIDE5OS4xMTExOTIgLTIwNi4wMzM4ODQgDQpMIDE5OC45NTEzNTggLTIwNi4wMzM4ODQgDQpMIDE5OC43OTE1MjQgLTIwNi4wMzM4ODQgDQpMIDE5OC42MzE2OSAtMjA2LjAzMzg4NCANCkwgMTk4LjQ3MTg1NyAtMjA2LjAzMzg4NCANCkwgMTk4LjMxMjAyMyAtMjA2LjAzMzg4NCANCkwgMTk4LjE1MjE4OSAtMjA2LjAzMzg4NCANCkwgMTk3Ljk5MjM1NSAtMjA2LjAzMzg4NCANCkwgMTk3LjgzMjUyMSAtMjA2LjAzMzg4NCANCkwgMTk3LjY3MjY4NyAtMjA2LjAzMzg4NCANCkwgMTk3LjUxMjg1MyAtMjA2LjAzMzg4NCANCkwgMTk3LjM1MzAxOSAtMjA2LjAzMzg4NCANCkwgMTk3LjE5MzE4NSAtMjA2LjAzMzg4NCANCkwgMTk3LjAzMzM1MiAtMjA2LjAzMzg4NCANCkwgMTk2Ljg3MzUxOCAtMjA2LjAzMzg4NCANCkwgMTk2LjcxMzY4NCAtMjA2LjAzMzg4NCANCkwgMTk2LjU1Mzg1IC0yMDYuMDMzODg0IA0KTCAxOTYuMzk0MDE2IC0yMDYuMDMzODg0IA0KTCAxOTYuMjM0MTgyIC0yMDYuMDMzODg0IA0KTCAxOTYuMDc0MzQ4IC0yMDYuMDMzODg0IA0KTCAxOTUuOTE0NTE0IC0yMDYuMDMzODg0IA0KTCAxOTUuNzU0NjgxIC0yMDYuMDMzODg0IA0KTCAxOTUuNTk0ODQ3IC0yMDYuMDMzODg0IA0KTCAxOTUuNDM1MDEzIC0yMDYuMDMzODg0IA0KTCAxOTUuMjc1MTc5IC0yMDYuMDMzODg0IA0KTCAxOTUuMTE1MzQ1IC0yMDYuMDMzODg0IA0KTCAxOTQuOTU1NTExIC0yMDYuMDMzODg0IA0KTCAxOTQuNzk1Njc3IC0yMDYuMDMzODg0IA0KTCAxOTQuNjM1ODQzIC0yMDYuMDMzODg0IA0KTCAxOTQuNDc2MDA5IC0yMDYuMDMzODg0IA0KTCAxOTQuMzE2MTc2IC0yMDYuMDMzODg0IA0KTCAxOTQuMTU2MzQyIC0yMDYuMDMzODg0IA0KTCAxOTMuOTk2NTA4IC0yMDYuMDMzODg0IA0KTCAxOTMuODM2Njc0IC0yMDYuMDMzODg0IA0KTCAxOTMuNjc2ODQgLTIwNi4wMzM4ODQgDQpMIDE5My41MTcwMDYgLTIwNi4wMzM4ODQgDQpMIDE5My4zNTcxNzIgLTIwNi4wMzM4ODQgDQpMIDE5My4xOTczMzggLTIwNi4wMzM4ODQgDQpMIDE5My4wMzc1MDQgLTIwNi4wMzM4ODQgDQpMIDE5Mi44Nzc2NzEgLTIwNi4wMzM4ODQgDQpMIDE5Mi43MTc4MzcgLTIwNi4wMzM4ODQgDQpMIDE5Mi41NTgwMDMgLTIwNi4wMzM4ODQgDQpMIDE5Mi4zOTgxNjkgLTIwNi4wMzM4ODQgDQpMIDE5Mi4yMzgzMzUgLTIwNi4wMzM4ODQgDQpMIDE5Mi4wNzg1MDEgLTIwNi4wMzM4ODQgDQpMIDE5MS45MTg2NjcgLTIwNi4wMzM4ODQgDQpMIDE5MS43NTg4MzMgLTIwNi4wMzM4ODQgDQpMIDE5MS41OTkgLTIwNi4wMzM4ODQgDQpMIDE5MS40MzkxNjYgLTIwNi4wMzM4ODQgDQpMIDE5MS4yNzkzMzIgLTIwNi4wMzM4ODQgDQpMIDE5MS4xMTk0OTggLTIwNi4wMzM4ODQgDQpMIDE5MC45NTk2NjQgLTIwNi4wMzM4ODQgDQpMIDE5MC43OTk4MyAtMjA2LjAzMzg4NCANCkwgMTkwLjYzOTk5NiAtMjA2LjAzMzg4NCANCkwgMTkwLjQ4MDE2MiAtMjA2LjAzMzg4NCANCkwgMTkwLjMyMDMyOCAtMjA2LjAzMzg4NCANCkwgMTkwLjE2MDQ5NSAtMjA2LjAzMzg4NCANCkwgMTkwLjAwMDY2MSAtMjA2LjAzMzg4NCANCkwgMTg5Ljg0MDgyNyAtMjA2LjAzMzg4NCANCkwgMTg5LjY4MDk5MyAtMjA2LjAzMzg4NCANCkwgMTg5LjUyMTE1OSAtMjA2LjAzMzg4NCANCkwgMTg5LjM2MTMyNSAtMjA2LjAzMzg4NCANCkwgMTg5LjIwMTQ5MSAtMjA2LjAzMzg4NCANCkwgMTg5LjA0MTY1NyAtMjA2LjAzMzg4NCANCkwgMTg4Ljg4MTgyNCAtMjA2LjAzMzg4NCANCkwgMTg4LjcyMTk5IC0yMDYuMDMzODg0IA0KTCAxODguNTYyMTU2IC0yMDYuMDMzODg0IA0KTCAxODguNDAyMzIyIC0yMDYuMDMzODg0IA0Keg0KIiBpZD0ibTVlMDk0YWRlYzQiIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utb3BhY2l0eTowLjI1OyIvPg0KICAgIDwvZGVmcz4NCiAgICA8ZyBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIj4NCiAgICAgPHVzZSBzdHlsZT0iZmlsbDojMzBhMmRhO2ZpbGwtb3BhY2l0eTowLjI1O3N0cm9rZTojMDAwMDAwO3N0cm9rZS1vcGFjaXR5OjAuMjU7IiB4PSIwIiB4bGluazpocmVmPSIjbTVlMDk0YWRlYzQiIHk9IjQzOC40NDI4NSIvPg0KICAgIDwvZz4NCiAgIDwvZz4NCiAgIDxnIGlkPSJtYXRwbG90bGliLmF4aXNfMyI+DQogICAgPGcgaWQ9Inh0aWNrXzkiPg0KICAgICA8ZyBpZD0ibGluZTJkXzI4Ij4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwMzhkN2M2MGI2OSkiIGQ9Ik0gMTY2LjAyNTU3OCAzOTIuMjQyODUgDQpMIDE2Ni4wMjU1NzggMjMyLjQwODk2NiANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzI5Ij4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIxNjYuMDI1NTc4IiB4bGluazpocmVmPSIjbTE5MmI3ZGI3NzQiIHk9IjM5Mi4yNDI4NSIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzE3Ij4NCiAgICAgIDwhLS0gMCAtLT4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDE2MS41NzE4MjggNDA5Ljg4MDY2MylzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00OCIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgIDxnIGlkPSJ4dGlja18xMCI+DQogICAgIDxnIGlkPSJsaW5lMmRfMzAiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3AzOGQ3YzYwYjY5KSIgZD0iTSAyMjkuOTU5MTMyIDM5Mi4yNDI4NSANCkwgMjI5Ljk1OTEzMiAyMzIuNDA4OTY2IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfMzEiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjIyOS45NTkxMzIiIHhsaW5rOmhyZWY9IiNtMTkyYjdkYjc3NCIgeT0iMzkyLjI0Mjg1Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfMTgiPg0KICAgICAgPCEtLSAyIC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMjI1LjUwNTM4MiA0MDkuODgwNjYzKXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTUwIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inh0aWNrXzExIj4NCiAgICAgPGcgaWQ9ImxpbmUyZF8zMiI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIiBkPSJNIDI5My44OTI2ODUgMzkyLjI0Mjg1IA0KTCAyOTMuODkyNjg1IDIzMi40MDg5NjYgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF8zMyI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iMjkzLjg5MjY4NSIgeGxpbms6aHJlZj0iI20xOTJiN2RiNzc0IiB5PSIzOTIuMjQyODUiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8xOSI+DQogICAgICA8IS0tIDQgLS0+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgyODkuNDM4OTM1IDQwOS44ODA2NjMpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNTIiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieHRpY2tfMTIiPg0KICAgICA8ZyBpZD0ibGluZTJkXzM0Ij4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwMzhkN2M2MGI2OSkiIGQ9Ik0gMzU3LjgyNjIzOSAzOTIuMjQyODUgDQpMIDM1Ny44MjYyMzkgMjMyLjQwODk2NiANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzM1Ij4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIzNTcuODI2MjM5IiB4bGluazpocmVmPSIjbTE5MmI3ZGI3NzQiIHk9IjM5Mi4yNDI4NSIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzIwIj4NCiAgICAgIDwhLS0gNiAtLT4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDM1My4zNzI0ODkgNDA5Ljg4MDY2MylzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy01NCIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgIDxnIGlkPSJ4dGlja18xMyI+DQogICAgIDxnIGlkPSJsaW5lMmRfMzYiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3AzOGQ3YzYwYjY5KSIgZD0iTSA0MjEuNzU5NzkyIDM5Mi4yNDI4NSANCkwgNDIxLjc1OTc5MiAyMzIuNDA4OTY2IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfMzciPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjQyMS43NTk3OTIiIHhsaW5rOmhyZWY9IiNtMTkyYjdkYjc3NCIgeT0iMzkyLjI0Mjg1Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfMjEiPg0KICAgICAgPCEtLSA4IC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNDE3LjMwNjA0MiA0MDkuODgwNjYzKXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTU2Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inh0aWNrXzE0Ij4NCiAgICAgPGcgaWQ9ImxpbmUyZF8zOCI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIiBkPSJNIDQ4NS42OTMzNDYgMzkyLjI0Mjg1IA0KTCA0ODUuNjkzMzQ2IDIzMi40MDg5NjYgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF8zOSI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iNDg1LjY5MzM0NiIgeGxpbms6aHJlZj0iI20xOTJiN2RiNzc0IiB5PSIzOTIuMjQyODUiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8yMiI+DQogICAgICA8IS0tIDEwIC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNDc2Ljc4NTg0NiA0MDkuODgwNjYzKXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ5Ii8+DQogICAgICAgPHVzZSB4PSI2My42MjMwNDciIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ4Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inh0aWNrXzE1Ij4NCiAgICAgPGcgaWQ9ImxpbmUyZF80MCI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIiBkPSJNIDU0OS42MjY4OTkgMzkyLjI0Mjg1IA0KTCA1NDkuNjI2ODk5IDIzMi40MDg5NjYgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF80MSI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iNTQ5LjYyNjg5OSIgeGxpbms6aHJlZj0iI20xOTJiN2RiNzc0IiB5PSIzOTIuMjQyODUiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8yMyI+DQogICAgICA8IS0tIDEyIC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNTQwLjcxOTM5OSA0MDkuODgwNjYzKXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ5Ii8+DQogICAgICAgPHVzZSB4PSI2My42MjMwNDciIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTUwIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inh0aWNrXzE2Ij4NCiAgICAgPGcgaWQ9ImxpbmUyZF80MiI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIiBkPSJNIDYxMy41NjA0NTMgMzkyLjI0Mjg1IA0KTCA2MTMuNTYwNDUzIDIzMi40MDg5NjYgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF80MyI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iNjEzLjU2MDQ1MyIgeGxpbms6aHJlZj0iI20xOTJiN2RiNzc0IiB5PSIzOTIuMjQyODUiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8yNCI+DQogICAgICA8IS0tIDE0IC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNjA0LjY1Mjk1MyA0MDkuODgwNjYzKXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ5Ii8+DQogICAgICAgPHVzZSB4PSI2My42MjMwNDciIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTUyIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9InRleHRfMjUiPg0KICAgICA8IS0tIHogKG0pIC0tPg0KICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgzODcuNTk3MTg1IDQyNy40MzAwMzgpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy0xMjIiLz4NCiAgICAgIDx1c2UgeD0iNTIuNDkwMjM0IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy0zMiIvPg0KICAgICAgPHVzZSB4PSI4NC4yNzczNDQiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQwIi8+DQogICAgICA8dXNlIHg9IjEyMy4yOTEwMTYiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTEwOSIvPg0KICAgICAgPHVzZSB4PSIyMjAuNzAzMTI1IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00MSIvPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgPC9nPg0KICAgPGcgaWQ9Im1hdHBsb3RsaWIuYXhpc180Ij4NCiAgICA8ZyBpZD0ieXRpY2tfNiI+DQogICAgIDxnIGlkPSJsaW5lMmRfNDQiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3AzOGQ3YzYwYjY5KSIgZD0iTSAxNjYuMDI1NTc4IDM3NC40ODEzOTkgDQpMIDY0NS41MjcyMyAzNzQuNDgxMzk5IA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfNDUiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjE2Ni4wMjU1NzgiIHhsaW5rOmhyZWY9IiNtZTE4NDliNDA1MCIgeT0iMzc0LjQ4MTM5OSIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzI2Ij4NCiAgICAgIDwhLS0g4oiSMC44IC0tPg0KICAgICAgPGRlZnM+DQogICAgICAgPHBhdGggZD0iTSAxMC41OTM3NSAzNS41IA0KTCA3My4xODc1IDM1LjUgDQpMIDczLjE4NzUgMjcuMjAzMTI1IA0KTCAxMC41OTM3NSAyNy4yMDMxMjUgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTg3MjIiLz4NCiAgICAgICA8cGF0aCBkPSJNIDEwLjY4NzUgMTIuNDA2MjUgDQpMIDIxIDEyLjQwNjI1IA0KTCAyMSAwIA0KTCAxMC42ODc1IDAgDQp6DQoiIGlkPSJEZWphVnVTYW5zLTQ2Ii8+DQogICAgICA8L2RlZnM+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxMjUuMDI5NjQxIDM3OS44MDAzMDUpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtODcyMiIvPg0KICAgICAgIDx1c2UgeD0iODMuNzg5MDYyIiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00OCIvPg0KICAgICAgIDx1c2UgeD0iMTQ3LjQxMjEwOSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDYiLz4NCiAgICAgICA8dXNlIHg9IjE3OS4xOTkyMTkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTU2Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inl0aWNrXzciPg0KICAgICA8ZyBpZD0ibGluZTJkXzQ2Ij4NCiAgICAgIDxwYXRoIGNsaXAtcGF0aD0idXJsKCNwMzhkN2M2MGI2OSkiIGQ9Ik0gMTY2LjAyNTU3OCAzMzguOTYzMjkxIA0KTCA2NDUuNTI3MjMgMzM4Ljk2MzI5MSANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6I2IwYjBiMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLXdpZHRoOjAuODsiLz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0ibGluZTJkXzQ3Ij4NCiAgICAgIDxnPg0KICAgICAgIDx1c2Ugc3R5bGU9InN0cm9rZTojMDAwMDAwO3N0cm9rZS13aWR0aDowLjg7IiB4PSIxNjYuMDI1NTc4IiB4bGluazpocmVmPSIjbWUxODQ5YjQwNTAiIHk9IjMzOC45NjMyOTEiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgICA8ZyBpZD0idGV4dF8yNyI+DQogICAgICA8IS0tIOKIkjAuNiAtLT4NCiAgICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDEyNS4wMjk2NDEgMzQ0LjI4MjE5NylzY2FsZSgwLjE0IC0wLjE0KSI+DQogICAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy04NzIyIi8+DQogICAgICAgPHVzZSB4PSI4My43ODkwNjIiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ4Ii8+DQogICAgICAgPHVzZSB4PSIxNDcuNDEyMTA5IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00NiIvPg0KICAgICAgIDx1c2UgeD0iMTc5LjE5OTIxOSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNTQiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0ieXRpY2tfOCI+DQogICAgIDxnIGlkPSJsaW5lMmRfNDgiPg0KICAgICAgPHBhdGggY2xpcC1wYXRoPSJ1cmwoI3AzOGQ3YzYwYjY5KSIgZD0iTSAxNjYuMDI1NTc4IDMwMy40NDUxODMgDQpMIDY0NS41MjcyMyAzMDMuNDQ1MTgzIA0KIiBzdHlsZT0iZmlsbDpub25lO3N0cm9rZTojYjBiMGIwO3N0cm9rZS1saW5lY2FwOnNxdWFyZTtzdHJva2Utd2lkdGg6MC44OyIvPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJsaW5lMmRfNDkiPg0KICAgICAgPGc+DQogICAgICAgPHVzZSBzdHlsZT0ic3Ryb2tlOiMwMDAwMDA7c3Ryb2tlLXdpZHRoOjAuODsiIHg9IjE2Ni4wMjU1NzgiIHhsaW5rOmhyZWY9IiNtZTE4NDliNDA1MCIgeT0iMzAzLjQ0NTE4MyIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgIDxnIGlkPSJ0ZXh0XzI4Ij4NCiAgICAgIDwhLS0g4oiSMC40IC0tPg0KICAgICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMTI1LjAyOTY0MSAzMDguNzY0MDg5KXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgICA8dXNlIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTg3MjIiLz4NCiAgICAgICA8dXNlIHg9IjgzLjc4OTA2MiIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDgiLz4NCiAgICAgICA8dXNlIHg9IjE0Ny40MTIxMDkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ2Ii8+DQogICAgICAgPHVzZSB4PSIxNzkuMTk5MjE5IiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy01MiIvPg0KICAgICAgPC9nPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgIDxnIGlkPSJ5dGlja185Ij4NCiAgICAgPGcgaWQ9ImxpbmUyZF81MCI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIiBkPSJNIDE2Ni4wMjU1NzggMjY3LjkyNzA3NSANCkwgNjQ1LjUyNzIzIDI2Ny45MjcwNzUgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF81MSI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iMTY2LjAyNTU3OCIgeGxpbms6aHJlZj0iI21lMTg0OWI0MDUwIiB5PSIyNjcuOTI3MDc1Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfMjkiPg0KICAgICAgPCEtLSDiiJIwLjIgLS0+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxMjUuMDI5NjQxIDI3My4yNDU5ODEpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtODcyMiIvPg0KICAgICAgIDx1c2UgeD0iODMuNzg5MDYyIiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00OCIvPg0KICAgICAgIDx1c2UgeD0iMTQ3LjQxMjEwOSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDYiLz4NCiAgICAgICA8dXNlIHg9IjE3OS4xOTkyMTkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTUwIi8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICA8L2c+DQogICAgPGcgaWQ9Inl0aWNrXzEwIj4NCiAgICAgPGcgaWQ9ImxpbmUyZF81MiI+DQogICAgICA8cGF0aCBjbGlwLXBhdGg9InVybCgjcDM4ZDdjNjBiNjkpIiBkPSJNIDE2Ni4wMjU1NzggMjMyLjQwODk2NiANCkwgNjQ1LjUyNzIzIDIzMi40MDg5NjYgDQoiIHN0eWxlPSJmaWxsOm5vbmU7c3Ryb2tlOiNiMGIwYjA7c3Ryb2tlLWxpbmVjYXA6c3F1YXJlO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9ImxpbmUyZF81MyI+DQogICAgICA8Zz4NCiAgICAgICA8dXNlIHN0eWxlPSJzdHJva2U6IzAwMDAwMDtzdHJva2Utd2lkdGg6MC44OyIgeD0iMTY2LjAyNTU3OCIgeGxpbms6aHJlZj0iI21lMTg0OWI0MDUwIiB5PSIyMzIuNDA4OTY2Ii8+DQogICAgICA8L2c+DQogICAgIDwvZz4NCiAgICAgPGcgaWQ9InRleHRfMzAiPg0KICAgICAgPCEtLSAwLjAgLS0+DQogICAgICA8ZyB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxMzYuNzYxMjAzIDIzNy43Mjc4NzMpc2NhbGUoMC4xNCAtMC4xNCkiPg0KICAgICAgIDx1c2UgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDgiLz4NCiAgICAgICA8dXNlIHg9IjYzLjYyMzA0NyIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDYiLz4NCiAgICAgICA8dXNlIHg9Ijk1LjQxMDE1NiIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtNDgiLz4NCiAgICAgIDwvZz4NCiAgICAgPC9nPg0KICAgIDwvZz4NCiAgICA8ZyBpZD0idGV4dF8zMSI+DQogICAgIDwhLS0gJEVfeiQgKE1WL20pIC0tPg0KICAgICA8ZGVmcz4NCiAgICAgIDxwYXRoIGQ9Ik0gMTYuODkwNjI1IDcyLjkwNjI1IA0KTCA2Mi45ODQzNzUgNzIuOTA2MjUgDQpMIDYxLjM3NSA2NC41OTM3NSANCkwgMjUuMDkzNzUgNjQuNTkzNzUgDQpMIDIwLjkwNjI1IDQzLjAxNTYyNSANCkwgNTUuNzE4NzUgNDMuMDE1NjI1IA0KTCA1NC4xMDkzNzUgMzQuNzE4NzUgDQpMIDE5LjI4MTI1IDM0LjcxODc1IA0KTCAxNC4yMDMxMjUgOC4yOTY4NzUgDQpMIDUxLjMxMjUgOC4yOTY4NzUgDQpMIDQ5LjcwMzEyNSAwIA0KTCAyLjY4NzUgMCANCnoNCiIgaWQ9IkRlamFWdVNhbnMtT2JsaXF1ZS02OSIvPg0KICAgICAgPHBhdGggZD0iTSAxMS42MjUgNTQuNjg3NSANCkwgNTQuMjk2ODc1IDU0LjY4NzUgDQpMIDUyLjY4NzUgNDYuNDg0Mzc1IA0KTCAxMS41MzEyNSA3LjE3MTg3NSANCkwgNDUuNTE1NjI1IDcuMTcxODc1IA0KTCA0NC4wOTM3NSAwIA0KTCAtMC4yOTY4NzUgMCANCkwgMS4zMTI1IDguMjAzMTI1IA0KTCA0Mi40ODQzNzUgNDcuNTE1NjI1IA0KTCAxMC4yMDMxMjUgNDcuNTE1NjI1IA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy1PYmxpcXVlLTEyMiIvPg0KICAgICAgPHBhdGggZD0iTSA5LjgxMjUgNzIuOTA2MjUgDQpMIDI0LjUxNTYyNSA3Mi45MDYyNSANCkwgNDMuMTA5Mzc1IDIzLjI5Njg3NSANCkwgNjEuODEyNSA3Mi45MDYyNSANCkwgNzYuNTE1NjI1IDcyLjkwNjI1IA0KTCA3Ni41MTU2MjUgMCANCkwgNjYuODkwNjI1IDAgDQpMIDY2Ljg5MDYyNSA2NC4wMTU2MjUgDQpMIDQ4LjA5Mzc1IDE0LjAxNTYyNSANCkwgMzguMTg3NSAxNC4wMTU2MjUgDQpMIDE5LjM5MDYyNSA2NC4wMTU2MjUgDQpMIDE5LjM5MDYyNSAwIA0KTCA5LjgxMjUgMCANCnoNCiIgaWQ9IkRlamFWdVNhbnMtNzciLz4NCiAgICAgIDxwYXRoIGQ9Ik0gMjguNjA5Mzc1IDAgDQpMIDAuNzgxMjUgNzIuOTA2MjUgDQpMIDExLjA3ODEyNSA3Mi45MDYyNSANCkwgMzQuMTg3NSAxMS41MzEyNSANCkwgNTcuMzI4MTI1IDcyLjkwNjI1IA0KTCA2Ny41NzgxMjUgNzIuOTA2MjUgDQpMIDM5Ljc5Njg3NSAwIA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy04NiIvPg0KICAgICAgPHBhdGggZD0iTSAyNS4zOTA2MjUgNzIuOTA2MjUgDQpMIDMzLjY4NzUgNzIuOTA2MjUgDQpMIDguMjk2ODc1IC05LjI4MTI1IA0KTCAwIC05LjI4MTI1IA0Keg0KIiBpZD0iRGVqYVZ1U2Fucy00NyIvPg0KICAgICA8L2RlZnM+DQogICAgIDxnIHRyYW5zZm9ybT0idHJhbnNsYXRlKDExOC4xMTgwNzggMzQ3LjI1NTkwOClyb3RhdGUoLTkwKXNjYWxlKDAuMTQgLTAuMTQpIj4NCiAgICAgIDx1c2UgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMCAwLjEyNSkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLU9ibGlxdWUtNjkiLz4NCiAgICAgIDx1c2UgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoNjMuMTgzNTk0IC0xNi4yODEyNSlzY2FsZSgwLjcpIiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy1PYmxpcXVlLTEyMiIvPg0KICAgICAgPHVzZSB0cmFuc2Zvcm09InRyYW5zbGF0ZSgxMDIuNjYxMTMzIDAuMTI1KSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtMzIiLz4NCiAgICAgIDx1c2UgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMTM0LjQ0ODI0MiAwLjEyNSkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQwIi8+DQogICAgICA8dXNlIHRyYW5zZm9ybT0idHJhbnNsYXRlKDE3My40NjE5MTQgMC4xMjUpIiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy03NyIvPg0KICAgICAgPHVzZSB0cmFuc2Zvcm09InRyYW5zbGF0ZSgyNTkuNzQxMjExIDAuMTI1KSIgeGxpbms6aHJlZj0iI0RlamFWdVNhbnMtODYiLz4NCiAgICAgIDx1c2UgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMzI4LjE0OTQxNCAwLjEyNSkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTQ3Ii8+DQogICAgICA8dXNlIHRyYW5zZm9ybT0idHJhbnNsYXRlKDM2MS44NDA4MiAwLjEyNSkiIHhsaW5rOmhyZWY9IiNEZWphVnVTYW5zLTEwOSIvPg0KICAgICAgPHVzZSB0cmFuc2Zvcm09InRyYW5zbGF0ZSg0NTkuMjUyOTMgMC4xMjUpIiB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy00MSIvPg0KICAgICA8L2c+DQogICAgPC9nPg0KICAgPC9nPg0KICAgPGcgaWQ9InBhdGNoXzYiPg0KICAgIDxwYXRoIGQ9Ik0gMTY2LjAyNTU3OCAzOTIuMjQyODUgDQpMIDE2Ni4wMjU1NzggMjMyLjQwODk2NiANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6IzAwMDAwMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLWxpbmVqb2luOm1pdGVyO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICA8L2c+DQogICA8ZyBpZD0icGF0Y2hfNyI+DQogICAgPHBhdGggZD0iTSAxNjYuMDI1NTc4IDM5Mi4yNDI4NSANCkwgNjQ1LjUyNzIzIDM5Mi4yNDI4NSANCiIgc3R5bGU9ImZpbGw6bm9uZTtzdHJva2U6IzAwMDAwMDtzdHJva2UtbGluZWNhcDpzcXVhcmU7c3Ryb2tlLWxpbmVqb2luOm1pdGVyO3N0cm9rZS13aWR0aDowLjg7Ii8+DQogICA8L2c+DQogICA8ZyBpZD0idGV4dF8zMiI+DQogICAgPCEtLSBCIC0tPg0KICAgIDxkZWZzPg0KICAgICA8cGF0aCBkPSJNIDM4LjM3NSA0NC42NzE4NzUgDQpRIDQyLjgyODEyNSA0NC42NzE4NzUgNDUuMTA5Mzc1IDQ2LjYyNSANClEgNDcuNDA2MjUgNDguNTc4MTI1IDQ3LjQwNjI1IDUyLjM5MDYyNSANClEgNDcuNDA2MjUgNTYuMTU2MjUgNDUuMTA5Mzc1IDU4LjEyNSANClEgNDIuODI4MTI1IDYwLjEwOTM3NSAzOC4zNzUgNjAuMTA5Mzc1IA0KTCAyNy45ODQzNzUgNjAuMTA5Mzc1IA0KTCAyNy45ODQzNzUgNDQuNjcxODc1IA0Keg0KTSAzOS4wMTU2MjUgMTIuNzk2ODc1IA0KUSA0NC42NzE4NzUgMTIuNzk2ODc1IDQ3LjUzMTI1IDE1LjE4NzUgDQpRIDUwLjM5MDYyNSAxNy41NzgxMjUgNTAuMzkwNjI1IDIyLjQwNjI1IA0KUSA1MC4zOTA2MjUgMjcuMTU2MjUgNDcuNTYyNSAyOS41MTU2MjUgDQpRIDQ0LjczNDM3NSAzMS44OTA2MjUgMzkuMDE1NjI1IDMxLjg5MDYyNSANCkwgMjcuOTg0Mzc1IDMxLjg5MDYyNSANCkwgMjcuOTg0Mzc1IDEyLjc5Njg3NSANCnoNCk0gNTYuNSAzOS4wMTU2MjUgDQpRIDYyLjU0Njg3NSAzNy4yNSA2NS44NTkzNzUgMzIuNTE1NjI1IA0KUSA2OS4xODc1IDI3Ljc4MTI1IDY5LjE4NzUgMjAuOTA2MjUgDQpRIDY5LjE4NzUgMTAuMzU5Mzc1IDYyLjA2MjUgNS4xNzE4NzUgDQpRIDU0LjkzNzUgMCA0MC4zNzUgMCANCkwgOS4xODc1IDAgDQpMIDkuMTg3NSA3Mi45MDYyNSANCkwgMzcuNDA2MjUgNzIuOTA2MjUgDQpRIDUyLjU5Mzc1IDcyLjkwNjI1IDU5LjQwNjI1IDY4LjMxMjUgDQpRIDY2LjIxODc1IDYzLjcxODc1IDY2LjIxODc1IDUzLjYwOTM3NSANClEgNjYuMjE4NzUgNDguMjk2ODc1IDYzLjcxODc1IDQ0LjU2MjUgDQpRIDYxLjIzNDM3NSA0MC44MjgxMjUgNTYuNSAzOS4wMTU2MjUgDQp6DQoiIGlkPSJEZWphVnVTYW5zLUJvbGQtNjYiLz4NCiAgICA8L2RlZnM+DQogICAgPGcgdHJhbnNmb3JtPSJ0cmFuc2xhdGUoMTQuNCAyMzYuNDQwNjEyKXNjYWxlKDAuMTggLTAuMTgpIj4NCiAgICAgPHVzZSB4bGluazpocmVmPSIjRGVqYVZ1U2Fucy1Cb2xkLTY2Ii8+DQogICAgPC9nPg0KICAgPC9nPg0KICA8L2c+DQogPC9nPg0KIDxkZWZzPg0KICA8Y2xpcFBhdGggaWQ9InA5NmM3MjQxODUzIj4NCiAgIDxyZWN0IGhlaWdodD0iMTU5LjgzMzg4NCIgd2lkdGg9IjQ3OS41MDE2NTIiIHg9IjE2Ni4wMjU1NzgiIHk9IjI0LjYyNDkxNyIvPg0KICA8L2NsaXBQYXRoPg0KICA8Y2xpcFBhdGggaWQ9InAzOGQ3YzYwYjY5Ij4NCiAgIDxyZWN0IGhlaWdodD0iMTU5LjgzMzg4NCIgd2lkdGg9IjQ3OS41MDE2NTIiIHg9IjE2Ni4wMjU1NzgiIHk9IjIzMi40MDg5NjYiLz4NCiAgPC9jbGlwUGF0aD4NCiA8L2RlZnM+DQo8L3N2Zz4NCg==)
График \(\gamma(z)\) поднимается ступенями, по одной на резонатор, и остаётся постоянным в промежутках, где пучок движется по инерции.
Как и поля, массив gamma преобразуется в функцию. Срез z[1:] используется потому, что интегрирование по трапециям даёт на одну точку меньше, чем содержит сетка.
gamma = interpolate.interp1d(z[1:], gamma, fill_value=(gamma[0], gamma[-1]), bounds_error=False)
#hv.Curve((z,gamma(z)), kdims=dim_z, vdims=dim_gamma)
Решение уравнения огибающей для круглого пучка
Повторим уравнение огибающей для круглого пучка радиуса \(r\) с распределением Капчинского—Владимирского при внешней фокусировке линейными полями. $$ \displaystyle r'' + \frac{1}{\beta^2\gamma} \gamma' r' + \frac{1}{2\beta^2\gamma}\gamma''r + kr - \frac{2I}{I_a (\beta\gamma)^3}\frac{1}{r} - \frac{\epsilon^2}{r^3} = 0. $$
Перейдём к среднеквадратичному радиусу для распределения Капчинского—Владимирского и первеансу \(\displaystyle r_{rms} = \frac{r}{2}\) и \(\displaystyle P = \frac{2I}{I_a\beta^3\gamma^3} \). Получим $$ \displaystyle r_{rms}'' + \frac{1}{\beta^2\gamma} \gamma' r_{rms}' + \frac{1}{2\beta^2\gamma}\gamma''r_{rms} + kr_{rms} - \frac{P}{4r_{rms}} - \frac{\epsilon^2}{16{r_{rms}}^3} = 0. $$
Пусть \(\displaystyle y=\frac{dr_{rms}}{dz}, \displaystyle \frac{d\gamma }{dz}\approx \frac{e E_z}{m c^2}\), тогда $$ \begin{matrix} \displaystyle \frac{dy}{dz}= - \frac{1}{\beta^2\gamma} \gamma' r_{rms}' - \frac{1}{2\beta^2\gamma}\gamma''r_{rms} - kr_{rms} + \frac{P}{4r_{rms}} + \frac{\epsilon^2}{16r_{rms}^3}\\ \displaystyle\frac{dr_{rms}}{dz} = y \end{matrix}. $$ Пусть
$$ \vec X = \begin{bmatrix} y \ r_{rms} \ \end{bmatrix}, $$
теперь составим дифференциальное уравнение \(X' = F(X)\).
Здесь \(k\) — жёсткость соленоида.
$$ k = \left ( \frac{eB_z}{2m_ec\beta\gamma} \right )^2 = \left ( \frac{e B_z}{2\beta\gamma\cdot 0.511\cdot 10^6 e \cdot \mathrm{volt}/c} \right )^2 = \left ( \frac{cB_z[\mathrm{T}]}{2\beta\gamma\cdot 0.511\cdot 10^6 \cdot \mathrm{volt}} \right )^2. $$
Для расчёта потребуется скорость света, входящая в выражение для жёсткости соленоида.
c = 299792458 # (m/s) скорость света
Зададим параметры пучка и начальные условия на входе. Ток составляет 2 кА при альфвеновском токе 17 кА, нормализованный эмиттанс — 180 мм·мрад; на входе в тракт среднеквадратичный радиус равен 27.5 мм, а его производная — 35.4 мрад. Закомментированные значения рядом представляют собой предыдущий вариант: эти четыре числа варьируются при настройке.
I = 2000#2000.000 # A Ток в ускорителе
Ia = 17000 # A Альфвеновский ток
emitt_n = 1.80e-4#1.80e-5 # m нормализованный эмиттанс
R_rms = 27.5e-3 #m r_rms пучка
dR_rmsdz = 35.4e-3 #50e-3 dr_rms/dz пучка ## 50/2*sqrt(2) = 35.4
Правая часть системы реализована функцией dXdz, которая получает вектор состояния X = [dr/dz, r] и координату z, а возвращает его производную. Внутри собираются все члены уравнения огибающей. Здесь P обозначает первеанс, то есть вклад пространственного заряда; emitt — геометрический эмиттанс, полученный из нормализованного делением на \(\beta\gamma\); K — жёсткость соленоида. Первые два члена расширяют пучок, третий его сжимает, а последние два описывают адиабатическое затухание при ускорении и потому требуют не только \(\gamma\), но и её производных, причём вторая вычисляется численно.
from scipy.integrate import odeint
def derivative(f, x, dx):
return (f(x + dx) - f(x - dx)) / (2 * dx)
def dXdz(X, z):
y = X[0]
sigma = X[1]
g = gamma(z)
dgdz = -Ez(z)/mc
d2gdz2 = -derivative(lambda z:Ez(z),z, dz)/mc
beta = np.sqrt(1-1/(g*g))
K = ( c * Bz(z) / (2*0.511e6))**2
emitt = emitt_n/(g*beta) # m
P=2*I/(Ia*beta*beta*beta*g*g*g)
dydz = P/(4*sigma) + emitt*emitt/(sigma*sigma*sigma*16) - K*sigma/(g*beta)**2 - \
dgdz*y/(beta*beta*g) - d2gdz2*sigma/(2*beta*beta*g)
dsigmadz = y
return [dydz, dsigmadz]
Обёртка над odeint подставляет начальные условия и возвращает только среднеквадратичный радиус. Точность ослаблена до rtol = 0.001 вместо стандартных \(1.5\cdot10^{-8}\). Огибающая является гладкой функцией, лишние знаки в ней неразличимы, а расчёт заметно ускоряется; именно за счёт этого библиотеку KENV [48] удаётся вызывать тысячи раз в цикле оптимизации.
def find_sigma(z):
X0 = [dR_rmsdz, R_rms]
sol = odeint(dXdz, X0, z, rtol = 0.001) # rtol - относительная точность (по умолчанию rtol = 1.49012e-8)
sigma = sol[:, 1] # m
return sigma # m
Настроим оформление кривой пучка, запустим решатель и построим огибающую.
%opts Area.Beam [aspect=3 show_grid=True] (color='red' linewidth=1 alpha=0.3)
sigma = find_sigma(z)
dim_sig = hv.Dimension('r_{rms}', label="$r_{rms}$", unit='mm', range=(0,150))
sigma_img = hv.Area((z,sigma*1e3), kdims=[dim_z], vdims=[dim_sig], group='Beam')
sigma_img

На рисунке приведён среднеквадратичный радиус пучка вдоль пятнадцатиметрового тракта: по горизонтали отложена координата в метрах, по вертикали — радиус в миллиметрах. Существенны два обстоятельства. Во-первых, положение максимума огибающей: в этом сечении пучок ближе всего к стенке вакуумной камеры, и если максимум превышает апертуру, часть пучка будет потеряна. Во-вторых, плавность кривой между соленоидами: сильные перетяжки означают, что фокусировка избыточна.
Решатель при этом не проверяет физическую допустимость результата, и в библиотеке KENV, куда вынесен этот расчёт, такой проверки тоже нет. Рассмотрим пример из демонстрации лекции «Разбор реальных кодов»: тракт следующей главы, девять соленоидов с аналитическим профилем поля и пучок 2 МэВ, 2 кА, рассчитан библиотекой при поле 0.2 Тл во всех соленоидах. Функция solve_ivp завершается со статусом успеха и без предупреждений, однако огибающая уходит в отрицательную область, до −11.9 км, и условие \(r > 0\) нарушено в 193 точках из 500. При таком поле угол огибающей далеко выходит за пределы параксиального приближения, а перетяжка много уже шага интегрирования, и решатель перешагивает через ноль. Статус решателя этой ошибки не показывает, и обнаружить её позволяет только проверка \(r > 0\), занимающая одну строку.
Расчёт объёмом в несколько десятков строк выполняется за доли секунды, поэтому уравнение огибающей остаётся рабочим инструментом наряду с PIC-кодами: там, где необходимо перебрать тысячи вариантов настройки соленоидов, ансамбль макрочастиц не может быть рассчитан требуемое число раз. Практическое применение рассматриваемого подхода разбирается в следующей главе.
Оптимизация огибающей пучка заряженных частиц с помощью генетического алгоритма
Задача, обратная расчёту огибающей по заданным полям, сложнее и встречается чаще. Известно, какую огибающую требуется получить, а подобрать необходимо поля соленоидов.
Перебор полей девяти соленоидов вручную занимает весь день, и с каждым дополнительным соленоидом задача становится всё менее выполнимой. Поскольку один расчёт огибающей занимает доли секунды, перебор целесообразно поручить машине.
Генетические алгоритмы работают по аналогии с естественным отбором в природе, а основу генетического алгоритма составляют особь, хромосомы (гены), популяция (набор особей), функции приспособленности, отбора, скрещивания и мутации. На практике процесс выглядит следующим образом: создание первого поколения, оценка, отбор, скрещивание, мутация, новое поколение, оценка, и так далее, пока не будет получен требуемый результат.
DEAP [44] представляет собой фреймворк для работы с генетическими алгоритмами, в котором уже есть множество готовых инструментов.
Слайды к главе. Постановка генетического алгоритма на DEAP, два запуска кода главы на стенде и обратная задача изложены также во второй половине первой части лекции «Разбор реальных кодов» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Создание пучка и ускорителя
Расчёт огибающей из предыдущей главы вынесен в библиотеку kenv, поэтому остаётся собрать установку из готовых частей.
import kenv as kv
Пучок задаётся четырьмя числами, которыми служат энергия 2 МэВ, ток 2 кА, начальный радиус 50 мм при такой же расходимости (rp) и нормализованный эмиттанс 1000 мм·мрад.
beam = kv.Beam(energy=2,
current=2e3,
radius=50e-3,
rp=50e-3,
normalized_emittance=1000e-6)
Ускоритель занимает отрезок от нуля до пяти метров с шагом сетки один сантиметр.
accelerator = kv.Accelerator(0, 5, 0.01)
На этом отрезке равномерно, через полметра, расставлены девять одинаковых соленоидов, пока включённых на одно и то же поле 0.02 Тл; это поле служит начальным приближением, которое алгоритму предстоит улучшить.
Solenoids = [
[ 0.5000, 0.02, 'Bz.dat', 'Sol. 1'],
[ 1.0000, 0.02, 'Bz.dat', 'Sol. 2'],
[ 1.5000, 0.02, 'Bz.dat', 'Sol. 3'],
[ 2.0000, 0.02, 'Bz.dat', 'Sol. 4'],
[ 2.5000, 0.02, 'Bz.dat', 'Sol. 5'],
[ 3.0000, 0.02, 'Bz.dat', 'Sol. 6'],
[ 3.5000, 0.02, 'Bz.dat', 'Sol. 7'],
[ 4.0000, 0.02, 'Bz.dat', 'Sol. 8'],
[ 4.5000, 0.02, 'Bz.dat', 'Sol. 9'],
]
Перечисление преобразуется в элементы линейки.
for z0, B0, filename, name in Solenoids:
accelerator.Bz_beamline[name] = kv.Element(z0, B0, filename, name)
Вызов compile() сшивает профили всех соленоидов в одно поле вдоль тракта, как в предыдущей главе делалось вручную. После этого пучок и ускоритель связываются в расчёт, а track() интегрирует уравнение огибающей от начала до конца.
accelerator.compile()
simulation = kv.Simulation(beam, accelerator)
simulation.track()
График
Прежде чем приступать к оптимизации, необходимо увидеть исходное состояние.
matplotlib
Оформление настраивается заданием широких осей, полупрозрачных заливок и векторного вывода.
import holoviews as hv
hv.extension('matplotlib')
%opts Layout [tight=True]
%output size=150 backend='matplotlib' fig='svg'
%opts Area Curve [aspect=3 show_grid=True]
%opts Area (alpha=0.25)
%opts Curve (alpha=0.5)
%opts Area.Beam [aspect=3 show_grid=True] (color='red' alpha=0.3)
import warnings
warnings.filterwarnings('ignore')
dim_z = hv.Dimension('z', unit='m', range=(accelerator.start, accelerator.stop))
dim_Bz = hv.Dimension('Bz', unit='T', label='Bz', range=(0, 0.1))
dim_Ez = hv.Dimension('Ez', unit='MV/m', label='Ez')
dim_r = hv.Dimension('r', label="Beam r", unit='mm', range=(0, 150))
Строятся две панели: сверху огибающая пучка в миллиметрах, снизу поле соленоидов вдоль тракта. По нижней панели видно, как алгоритм изменил установку, а по верхней — как это отразилось на пучке.
z_Bz= hv.Area((accelerator.parameter,accelerator.Bz(accelerator.parameter)), kdims=[dim_z], vdims=[dim_Bz])
z_r = hv.Area(((accelerator.parameter,simulation.envelope_x(accelerator.parameter)*1e3)), kdims=[dim_z], vdims=[dim_r], group='Beam')
(z_r+z_Bz).cols(1)

Огибающая далека от идеальной, поскольку одинаковые поля соленоидов дают периодическую перетяжку, и вместо плавного сжатия к выходу пучок проходит по тракту волной. Именно эту волну предстоит сгладить генетическим алгоритмом.
Генетический алгоритм
Модельную огибающую построим простейшим способом, проведя параболу через три точки: 150 мм на входе, 50 мм в середине тракта и 30 мм на выходе. Физического смысла эта кривая не имеет и представляет собой техническое задание для алгоритма.
import numpy as np
coefficients = np.polyfit([accelerator.start, (accelerator.start+accelerator.stop)/2, accelerator.stop], [0.15, 0.05, 0.03], 2)
envelope_mod = coefficients[0]*accelerator.parameter**2 + coefficients[1]*accelerator.parameter+ coefficients[2]
z_env = hv.Curve((accelerator.parameter, envelope_mod*1e3), kdims=[dim_z], vdims=[dim_r], label='Envelope_mod', group='Beam')
Полученная кривая приведена ниже.
z_env

Далее используется DEAP.
import random
from deap import creator, base, tools, algorithms
Первым шагом создаются необходимые типы, обычно функция приспособленности (fitness) и особь (individual).
creator.create("FitnessMin", base.Fitness, weights=(-1.0,))
creator.create("Individual", list, fitness=creator.FitnessMin)
Далее необходимо собрать набор инструментов (toolbox), задающий основные параметры алгоритма. Сначала задаются границы, в пределах которых разрешено изменяться полям соленоидов, и размеры эволюции, то есть сто особей в популяции, сто поколений, вероятность скрещивания 0.4 и мутации 0.6.
Sol_B = 0.02 # [T] average Bz in the solenoids
Sol_B_max = 0.05 # [T] max Bz
Sol_B_min = 0.005 # [T] min Bz
Sol_Num = 9 # quantity
CXPB = 0.4 # cross chance
CX_INDPB = 0.6 # вероятность обмена одним геном
MUTPB = 0.6 # Mutation probability
NGEN = 100 # Number of generations
POP = 100 # Number of individuals
TOURN = 3 # Tournament size
В toolbox регистрируются три операции: порождение одного гена (случайное поле около 0.02 Тл), сборка особи из девяти генов и формирование популяции из особей. Особь здесь представляет собой список из девяти чисел, по одному на соленоид.
toolbox = base.Toolbox()
toolbox.register("attr_float", random.gauss, Sol_B, (Sol_B_max - Sol_B_min)/2)
toolbox.register("individual", tools.initRepeat, creator.Individual, toolbox.attr_float, n=Sol_Num)
toolbox.register("population", tools.initRepeat, list, toolbox.individual)
Функция приспособленности является единственным местом, где алгоритм соприкасается с физикой. Она берёт девять чисел из особи, расставляет их по соленоидам, пересобирает ускоритель, заново рассчитывает огибающую и возвращает среднее по тракту расхождение с заданной кривой, в метрах. Чем меньше расхождение, тем лучше, поэтому вес приспособленности выше и задан отрицательным.
def evalution_envelope(individual):
for x in range(Sol_Num):
accelerator.Bz_beamline['Sol. %.d'%(x+1)].max_field = individual[x]
accelerator.compile()
simulation = kv.Simulation(beam, accelerator)
simulation.track()
abs_errors = np.abs(envelope_mod - simulation.envelope_x(accelerator.parameter))
return abs_errors.mean(),
Остаётся указать DEAP операторы скрещивания, мутации и отбора. Скрещивание равномерное, потомок берёт каждый ген у одного из двух родителей; мутация гауссова, к полю соленоида добавляется случайная добавка; отбор турнирный.
toolbox.register("evaluate", evalution_envelope)
toolbox.register("mate", tools.cxUniform, indpb=CX_INDPB)
toolbox.register("mutate", tools.mutGaussian, mu=0, sigma=(Sol_B_max - Sol_B_min)/2, indpb=MUTPB)
toolbox.register("select", tools.selTournament, tournsize=TOURN)
def clip(func):
"""Загоняет поля обратно в коридор после скрещивания и мутации."""
def wrapper(*args, **kwargs):
offspring = func(*args, **kwargs)
for child in offspring:
for i, b in enumerate(child):
child[i] = min(max(b, Sol_B_min), Sol_B_max)
return offspring
return wrapper
Без последней функции объявленные Sol_B_min и Sol_B_max остались бы
комментарием, поскольку мутация гауссовым шумом ничего не знает о коридоре и выведет
поле за паспортный предел источника питания. Само по себе объявление clip ничего
не делает: чтобы ограничение срабатывало после каждой операции над особью, функция
навешивается декоратором на скрещивание и мутацию.
toolbox.decorate("mate", clip)
toolbox.decorate("mutate", clip)
Размер турнира здесь является отдельной константой, а не долей от числа поколений. Турнир задаёт давление отбора: чем он больше, тем увереннее побеждают текущие лидеры и тем быстрее исчезает разнообразие. Три-пять особей представляют собой обычный рабочий выбор, а турнир в треть популяции превращает эволюцию в жадный поиск.
Для наблюдения за эволюцией DEAP ведёт журнал (logbook). Ему поручается вычислять по каждому поколению среднее, разброс, лучшее и худшее значения приспособленности.
stats_fit = tools.Statistics(lambda ind: ind.fitness.values)
mstats = tools.MultiStatistics(fitness=stats_fit)
mstats.register("avg", np.mean)
mstats.register("std", np.std)
mstats.register("min", np.min)
mstats.register("max", np.max)
Запускается eaSimple, реализующий простейшую эволюционную схему: популяция оценивается, отбирается, скрещивается, мутирует, и всё это повторяется сто раз.
population = toolbox.population(n=POP)
pop, logbook = algorithms.eaSimple(population, toolbox, cxpb=CXPB, mutpb=MUTPB, ngen=NGEN, stats=mstats, verbose=True)
fitness
--------------------------------------------------------------------------
gen nevals avg gen max min nevals std
0 100 0.0373577 0 0.0408331 0.0337452 100 0.00113532
1 82 0.0348016 1 0.0379858 0.0299872 82 0.00134257
2 69 0.0317311 2 0.0355503 0.0268419 69 0.00158446
3 70 0.0284586 3 0.0310798 0.0258454 70 0.00116153
4 77 0.0262835 4 0.028602 0.0245999 77 0.00073413
5 72 0.0248689 5 0.0268379 0.0234427 72 0.000541174
6 84 0.0237668 6 0.0256165 0.0221611 84 0.00067109
7 73 0.0225147 7 0.0241554 0.0203067 73 0.000610466
8 88 0.0210856 8 0.0235622 0.0194378 88 0.000755119
9 80 0.0197334 9 0.0209437 0.0190342 80 0.000337098
10 81 0.0191692 10 0.0204253 0.0183268 81 0.00035722
11 75 0.0185557 11 0.019661 0.0178986 75 0.000283725
12 78 0.0181075 12 0.0190688 0.0175483 78 0.00029574
13 72 0.0177022 13 0.018703 0.0172446 72 0.000248748
14 75 0.0174452 14 0.0183427 0.0169873 75 0.000190804
15 70 0.017232 15 0.0178082 0.0169012 70 0.000181106
16 79 0.0170371 16 0.0180127 0.0167734 79 0.000208848
17 80 0.0168772 17 0.0176019 0.0165999 80 0.000167511
18 80 0.0167085 18 0.0175836 0.0164198 80 0.000174468
19 77 0.0165316 19 0.0171106 0.0162831 77 0.000152431
20 76 0.0163782 20 0.0168837 0.0160568 76 0.000171506
21 69 0.0161959 21 0.0170411 0.015828 69 0.000194345
22 77 0.0159477 22 0.0166562 0.0156399 77 0.000157436
23 79 0.0158229 23 0.0184114 0.0155106 79 0.000314105
24 80 0.0156802 24 0.0167603 0.0153466 80 0.000234712
25 72 0.0154841 25 0.0165787 0.0152393 72 0.000184083
26 74 0.0153536 26 0.0160787 0.0150713 74 0.000201229
27 83 0.0152175 27 0.0160113 0.0147709 83 0.000237473
28 79 0.0149943 28 0.0159486 0.014535 79 0.00027873
29 80 0.0147364 29 0.0155165 0.0143068 80 0.000219007
30 78 0.0145096 30 0.0155232 0.01421 78 0.000219074
31 76 0.0143674 31 0.0162176 0.0141153 76 0.000292944
32 77 0.0142465 32 0.0154183 0.0139755 77 0.000228094
33 74 0.0141755 33 0.016872 0.0137429 74 0.000370584
34 65 0.0140263 34 0.0165405 0.0135535 65 0.000369079
35 79 0.0138775 35 0.0165023 0.0134757 79 0.000469816
36 78 0.0136499 36 0.0165048 0.0132913 78 0.00036574
37 77 0.0135281 37 0.0162187 0.0131399 77 0.000370037
38 72 0.0133894 38 0.0161935 0.013018 72 0.000407104
39 74 0.0132855 39 0.0151958 0.0129085 74 0.000356725
40 73 0.0132202 40 0.0158132 0.0127831 73 0.000502361
41 78 0.0131469 41 0.0154469 0.0126621 78 0.000549534
42 72 0.0128525 42 0.0153473 0.0125449 72 0.000371909
43 81 0.0128408 43 0.0143709 0.0124426 81 0.00037498
44 80 0.0128018 44 0.0143546 0.0122802 80 0.00042712
45 76 0.0126884 45 0.0149749 0.0122105 76 0.000484442
46 74 0.0124913 46 0.0141759 0.0121807 74 0.000374844
47 84 0.0124814 47 0.0150409 0.012149 84 0.000478495
48 65 0.012378 48 0.0143345 0.0120466 65 0.000396209
49 77 0.0123797 49 0.0141054 0.0119723 77 0.000465145
50 66 0.0122275 50 0.0136186 0.0119299 66 0.000324548
51 77 0.0122757 51 0.0142704 0.0118622 77 0.000472376
52 74 0.0121928 52 0.0138265 0.0118082 74 0.000460488
53 73 0.0121423 53 0.0145869 0.0117309 73 0.000487374
54 70 0.0120654 54 0.0132641 0.0116092 70 0.000405956
55 77 0.012012 55 0.0137579 0.0115895 77 0.00050723
56 73 0.0118692 56 0.0141939 0.0115563 73 0.000437811
57 83 0.0118798 57 0.0139667 0.0114851 83 0.000426248
58 71 0.0117967 58 0.01344 0.0114796 71 0.000419319
59 72 0.0117301 59 0.0145933 0.0114334 72 0.000445674
60 78 0.0116524 60 0.0135045 0.0113808 78 0.000333071
61 78 0.0116611 61 0.0132638 0.0113299 78 0.000437407
62 78 0.0116445 62 0.0140102 0.0113001 78 0.000467812
63 80 0.0116662 63 0.0138093 0.0112541 80 0.000496356
64 78 0.0115682 64 0.0126411 0.0112403 78 0.000360796
65 73 0.0115044 65 0.0133941 0.0112293 73 0.000428872
66 81 0.0114277 66 0.0134346 0.0112152 81 0.000315043
67 72 0.0114574 67 0.0132544 0.0111495 72 0.000390321
68 81 0.0114764 68 0.0135241 0.0110932 81 0.000486222
69 75 0.011434 69 0.0132443 0.0110874 75 0.000469529
70 74 0.0113903 70 0.0129446 0.0109944 74 0.000420948
71 80 0.0112841 71 0.0132937 0.0109944 80 0.000408004
72 75 0.0112891 72 0.0133998 0.010978 75 0.000465794
73 79 0.0112265 73 0.0122116 0.0109464 79 0.00029769
74 80 0.0112526 74 0.0129213 0.0108979 80 0.000417258
75 71 0.0112418 75 0.0128844 0.0108979 71 0.000447559
76 73 0.0111925 76 0.0138475 0.0108402 73 0.000519714
77 78 0.0111465 77 0.0132176 0.010835 78 0.000422602
78 79 0.0112091 78 0.0133698 0.0107964 79 0.000558782
79 73 0.0110862 79 0.0131931 0.0107964 73 0.000465272
80 67 0.011036 80 0.0127483 0.0107964 67 0.000386788
Средняя приспособленность падает почти монотонно, а разброс std сначала падает, к пятнадцатому поколению достигает минимума и далее немного растёт. Это не признак того, что популяция нашла несколько разных хороших решений, а хвост неудачных мутантов. Вероятность мутации здесь высокая, и часть потомков каждого поколения заведомо оказывается непригодной.
Код главы имеет три недостатка, которых напечатанный журнал не показывает; рассмотрим их по порядку. Первый касается начальной популяции: декоратор clip навешан только на скрещивание и мутацию, а гены первого поколения разыгрываются гауссовыми случайными величинами со средним 20 мТл и стандартным отклонением 22.5 мТл и через коридор не проходят, поэтому около трети из них, в среднем 34 %, лежит вне пределов 5–50 мТл. Второй недостаток состоит в том, что итог берётся из последнего поколения, а eaSimple не сохраняет элиту, и лучшая особь может быть потеряна. Третий — генератор random не инициализируется, и прогон невоспроизводим.
В журнале выше минимум приспособленности не растёт, однако повторный прогон того же кода на полную длину, с профилем поля соленоида из тестовых данных репозитория REDPIC и зерном 1, обнаруживает первые два недостатка: вне коридора оказались 300 генов начальной популяции из 900, минимум по популяции ухудшался в 26 поколениях из ста, и лучшая особь последнего поколения, 0.01163 м, уступает лучшей за прогон, 0.01149 м. Исправление занимает несколько строк: поле разыгрывается из того же распределения, но только внутри коридора, объект HallOfFame позволяет сохранить лучшую особь за весь прогон, а зерно задаётся явно и хранится вместе с результатом.
random.seed(1) # зерно сохраняется вместе с результатом
def field_in_corridor():
"""Поле из того же распределения, но только внутри коридора."""
while True:
b = random.gauss(Sol_B, (Sol_B_max - Sol_B_min)/2)
if Sol_B_min <= b <= Sol_B_max:
return b
toolbox.register("attr_float", field_in_corridor)
toolbox.register("individual", tools.initRepeat, creator.Individual, toolbox.attr_float, n=Sol_Num)
toolbox.register("population", tools.initRepeat, list, toolbox.individual)
hof = tools.HallOfFame(1) # лучшая особь за весь прогон
population = toolbox.population(n=POP)
pop, logbook = algorithms.eaSimple(population, toolbox, cxpb=CXPB, mutpb=MUTPB, ngen=NGEN, stats=mstats, halloffame=hof, verbose=True)
Регистрации individual и population повторяются потому, что запоминают функцию attr_float, действовавшую в момент регистрации. В повторном прогоне с этими правками вне коридора не оказалось ни одного гена, а объект HallOfFame сохранил особь с приспособленностью 0.01081 м из 36-го поколения, потерянную уже в следующем; лучшая особь последнего поколения — 0.01196 м. Ниже, как и в напечатанном прогоне, лучшая особь берётся из последнего поколения; при сохранении элиты ею была бы hof[0].
Извлечём десять лучших особей и сохраним историю эволюции в массивы.
top = tools.selBest(pop, k=10)
gen = np.array(logbook.select("gen"))
fit_min = np.array(logbook.chapters["fitness"].select("min"))
fit_max = np.array(logbook.chapters["fitness"].select("max"))
fit_avg = np.array(logbook.chapters["fitness"].select("avg"))
Лучшая особь берётся из популяции, её поля расставляются по соленоидам, и огибающая рассчитывается ещё раз, уже для графика. Заданная кривая накладывается поверх расчётной, чтобы была видна степень их совпадения.
for x in range(Sol_Num):
accelerator.Bz_beamline['Sol. %.d'%(x+1)].max_field = top[0][x]
accelerator.compile()
simulation = kv.Simulation(beam, accelerator)
simulation.track()
z_Bz_gen= hv.Area((accelerator.parameter,accelerator.Bz(accelerator.parameter)), kdims=[dim_z], vdims=[dim_Bz])
z_r_gen = hv.Area(((accelerator.parameter,simulation.envelope_x(accelerator.parameter)*1e3)), kdims=[dim_z], vdims=[dim_r], group='Beam')
(z_r_gen*z_env+z_Bz_gen).cols(1)

Результаты
Девять соленоидов, сто особей в популяции, сто поколений, и алгоритм подогнал огибающую под заданную, ни разу не потребовав понимания того, как поля соленоидов влияют на пучок. Журнал выше напечатан по восьмидесятое поколение, и к нему приспособленность лучшей особи упала с 0.034 до 0.0108, средняя по популяции с 0.037 до 0.011. Обе вышли на плато задолго до конца: последние двадцать напечатанных поколений не дали практически ничего. Дальнейшее улучшение невозможно, поскольку заданная огибающая физически недостижима с большей точностью.
Задача решается генетическим алгоритмом, а не градиентным спуском, по двум причинам, типичным для вычислительной физики.
- Градиента нет. Целевая функция получается численным интегрированием уравнения огибающей; аналитической производной по полям соленоидов у неё не существует, а численная потребовала бы девяти дополнительных расчётов на каждый шаг.
- Один расчёт дёшев. KENV решает уравнение огибающей за десятки миллисекунд, на порядки быстрее PIC-кода. Поэтому можно позволить себе около восьми тысяч расчётов (100 особей × 100 поколений, из которых
eaSimpleпересчитывает только изменённых особей: в журнале выше от 65 до 88 на поколение), и поэтому эволюционные методы, расточительные по числу вызовов целевой функции, здесь уместны.
Таким образом, метод оптимизации выбирается не только по виду целевой функции, но и по цене одного её вычисления.
Обратная задача. Восстановление огибающей по эксперименту
Подгонка под заданную огибающую остаётся учебной постановкой, тогда как реальная задача является обратной. Имеются измерения, и требуется определить, какой пучок их породил.
На линейном индукционном ускорителе средств наблюдения внутри тракта нет, поэтому измеряется не сама огибающая, а диаметр пучка на выходном экране при разных токах квадрупольной линзы. Получается кривая «размер пучка от силы линзы», и по ней требуется восстановить начальный радиус пучка \(r\), угловой разлёт \(dr/dz\) и нормализованный эмиттанс \(\epsilon_n\).
Постановка для генетического алгоритма меняется незначительно. Особью становится вектор из двенадцати сил соленоидальных линз фокусирующего канала и трёх начальных условий пучка, а функцией приспособленности — среднеквадратичное отклонение расчётной кривой «диаметр от тока квадруполя» от измеренной. Стартовая популяция разыгрывается гауссовыми случайными величинами вокруг ожидаемых значений.
| Параметр | Среднее \(\mu\) | СКО \(\sigma\) |
|---|---|---|
| Поле соленоидов \(B_z\) | 0.04 Тл | 0.02 Тл |
| Начальный радиус \(r\) | 48 мм | 24 мм |
| Угловой разлёт \(dr/dz\) | 38 мрад | 20 мрад |
| Нормализованный эмиттанс \(\epsilon_n\) | 1150 мм·мрад | 500 мм·мрад |
Размер популяции здесь другой, 1500 особей против 100 в прямой задаче, поскольку размерность пространства поиска выросла с 9 до 15 и популяцию необходимо наращивать соответственно, иначе алгоритм останавливается в локальном минимуме. Задача решается за те же 100 поколений.
Для пучка с током 1.5 кА восстановленные значения приведены ниже.
$$ r = 42 \div 49\ \text{мм}, \qquad \frac{dr}{dz} = 35 \div 38\ \text{мрад}, \qquad \epsilon_n = 1125 \div 1215\ \text{мм}\cdot\text{мрад}. $$
Это не погрешности измерения. Это область эквивалентности, множество разных наборов начальных условий, дающих одинаково хорошее согласие с экспериментом в пределах его точности. Единственного решения у обратной задачи здесь нет, и генетический алгоритм это показывает, выдавая не точку, а область.
При решении обратной задачи необходимо проверять единственность решения и, если она отсутствует, приводить в качестве результата область, а не точку. Алгоритм оптимизации всегда возвращает одно число; насколько оно определено данными, обязан понимать исследователь. Запуск оптимизации из нескольких разных начальных приближений и оценка разброса ответов являются проверкой, занимающей минуты.
Проверка результата
Восстановленные начальные условия были подставлены обратно в модель, а полученная огибающая сравнена с результатами двух других программ, PIC-кода ASTRA и программы UltraSAM. На пятнадцатиметровом ускорительном тракте огибающие совпали.
KENV выполняет расчёт настолько быстрее ASTRA и UltraSAM, что поверх него удалось построить интерактивный интерфейс для настройки проводки пучка в реальном времени. На установке это означает меньшее число тестовых импульсов на настройку, больший ресурс установки и больше времени на физику.
Исходный код KENV опубликован как библиотека для Python и зарегистрирован в Реестре программ для ЭВМ (№ 2024611244 от 18.01.2024).
Релятивистская разностная схема для расчёта динамики частиц
Уравнение огибающей, выведенное для пучка как целого, описывает его одной кривой. Там, где существенно поведение отдельных частиц, будь то расслоение по энергии, формирование гало или тонкая структура фазового портрета, требуется иной подход: расчёт ансамбля макрочастиц напрямую, без сведения пучка к усреднённому радиусу.
Рассматриваемая ниже схема возникла в ходе работ по транспортировке сильноточного электронного пучка в линейном индукционном ускорителе ЛИУ-5 [41–43]; физическое обоснование формул изложено там.
Слайды к главе. Разностная схема, устройство пакета REDPIC, его окружение и поведение как библиотеки изложены также во второй части лекции «Разбор реальных кодов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Основные величины
В начальный момент времени \(t\) заданы декартовы координаты \(i\)-й частицы \(\overrightarrow{r_{i}} = (x_i, y_i, z_i)\) и её начальный импульс \(\overrightarrow{p_{i}} = (p_{x_i}, p_{y_i}, p_{z_i})\). Задан минимальный шаг по времени \(\delta t\).
Для удобства обезразмерим физические величины, обозначенные дальше тильдой. \begin{equation} \widetilde{\overrightarrow{r_i}} = \frac{\overrightarrow{r_i}}{c \delta t}, \end{equation} \begin{equation} \widetilde{\overrightarrow{E_i}} = \frac{\overrightarrow{E_i}e}{mc} \delta t, \end{equation} \begin{equation} \widetilde{\overrightarrow{H_i}} = \frac{\overrightarrow{H_i}e}{mc} \delta t, \end{equation} где \(c\) — скорость света, \(e\) — заряд частицы, \(m\) — масса частицы.
Алгоритм
-
Вычисление электрических полей \(\overrightarrow{E_i}\) в точках, занимаемых частицами.
-
Приращение импульса. \begin{equation} \overrightarrow{p_i} = \overrightarrow{p_i} + 2\cdot\overrightarrow{E_i}, \end{equation} где коэффициент означает, что приращение импульса выполняется за весь интервал времени \(2\delta t\).
-
По новым импульсам вычисляются новые скорости. \begin{equation} \overrightarrow{v_i} = \frac{\overrightarrow{p_i}}{\gamma_i}, \end{equation} где \(\gamma_i = \sqrt{1 + \overrightarrow{p_i}^2}.\)
-
По новым скоростям вычисляются новые координаты. \begin{equation} \overrightarrow{r_i} = \overrightarrow{r_i} + 1\cdot\overrightarrow{v_i}, \end{equation} где коэффициент означает, что приращение координаты выполняется за интервал времени \(\delta t.\)
-
Вычисление магнитных полей \(\overrightarrow{H_i}\) в новых точках, занимаемых частицами.
-
Вычисляются новые значения скоростей, полученные после поворота в магнитном поле.
\[ b_1 = 1 - \frac{H_i^2}{\gamma_i^2}, b_2 = 1 + \frac{H_i^2}{\gamma_i^2}, b_3 = 2\cdot \frac{\overrightarrow{v_i}\cdot\overrightarrow{H_i}}{\gamma_i}, \]
\[ \overrightarrow{f_i} = 2\cdot \frac{\overrightarrow{v_i}\times \overrightarrow{H_i}}{\gamma_i}, \]
\begin{equation} \overrightarrow{v_i} = \frac{\overrightarrow{v_i}b_1 + \overrightarrow{f_i} + \frac{\overrightarrow{H_i}}{\gamma_i}b_3}{b_2}. \end{equation}
Все члены здесь построены на векторе поворота \(\overrightarrow{t} = \overrightarrow{H_i}/\gamma_i\), поэтому в \(b_1\) и \(b_2\) входит его квадрат. Это проверка, заложенная в записи схемы: поворот, взятый в таком виде, сохраняет модуль скорости точно, тогда как любая другая степень \(\gamma\) делает выражение неоднородным, и частица начинает набирать или терять энергию в чисто магнитном поле, не совершающем над ней работы.
- По новым скоростям снова вычисляются новые координаты. \begin{equation} \overrightarrow{r_i} = \overrightarrow{r_i} + 1\cdot\overrightarrow{v_i}, \end{equation} где коэффициент означает, что приращение координаты выполняется за интервал времени \(\delta t.\)
- По новым скоростям вычисляются новые импульсы. \begin{equation} \overrightarrow{p_i} = \overrightarrow{v_i}\gamma_i. \end{equation}
Один цикл схемы, собранный из перечисленных шагов, выполняется за интервал времени \(2\delta t.\)
Python
REDPIC оформлен в виде библиотеки: пользователь описывает тракт и пучок и запускает трекинг, а разностная схема выполняется внутри.
import redpic as rp
import numpy as np
import holoviews as hv
hv.extension('matplotlib')
import warnings
warnings.filterwarnings('ignore')
Проверим установленную версию: расчёт, который потребуется воспроизвести через год, помечается версией кода, на которой он получен.
rp.__version__
'0.11.8'
Листинги главы выполнены на этой версии под Python 3.12 с SciPy 1.18 и HoloViews 1.23, на виртуальной машине, на которой записаны демонстрации лекции «Разбор реальных кодов»; профили полей Bz.dat и Ez.dat взяты из каталога tests/functional/test_data/data/fields репозитория REDPIC.
На SciPy 1.15 и новее функция scipy.misc.derivative, которой REDPIC вычисляет вторую производную поля, удалена, и первый же шаг трекинга завершается исключением AttributeError, хотя установка проходит без ошибок: пакет требует scipy>=1.11.2 без верхней границы. Пока пакет обращается к удалённой функции, её заменяет та же центральная разность, которую она вычисляла; такая замена, сделанная и в демонстрации лекции, позволяет выполнить листинги главы без изменений.
from scipy import misc
if not hasattr(misc, "derivative"): # SciPy 1.15 и новее
misc.derivative = lambda f, x, dx=1.0, n=1, **kw: (f(x + dx) - f(x - dx)) / (2 * dx)
Настройки графиков
Фазовые портреты, составленные из десятков тысяч точек, требуют растра с высоким разрешением, а не векторного формата, а сами точки необходимо сделать мелкими и полупрозрачными. В противном случае плотное ядро пучка сольётся в сплошное пятно.
%output size=100 backend='matplotlib' fig='png' dpi=300
%opts Curve Scatter [aspect=3 show_grid=True]
%opts Curve (linewidth=1 alpha=0.7 color='blue')
%opts Scatter (alpha=0.7 s=0.5)
Задаём параметры ускорительного тракта
Тракт, заданный границами по \(z\) и шагом сетки, описывается так же, как в KENV. Расчёт ведётся от 0.7 до 5 метров с шагом один сантиметр.
acc = rp.accelerator.Accelerator(0.7, 5, 0.01)
В тракте расположены два ускоряющих модуля, настроенных на −1.1 МВ/м.
# Unique name, z-position [m], Ez [MV/m], Ez(z) profile
acc.add_accel('Acc. 1', 4.096, -1.1, 'Ez.dat')
acc.add_accel('Acc. 2', 5.944, -1.1, 'Ez.dat')
Кроме того, в тракте расположены семь фокусирующих соленоидов. У первого, намотанного навстречу остальным, поле отрицательно.
# Unique name, z-position [m], Bz [T], Bz(z) profile
acc.add_solenoid('Sol. 1', 0.450, -0.0580, 'Bz.dat')
acc.add_solenoid('Sol. 2', 0.957, 0.0390, 'Bz.dat')
acc.add_solenoid('Sol. 3', 2.107, 0.0250, 'Bz.dat')
acc.add_solenoid('Sol. 4', 2.907, 0.0440, 'Bz.dat')
acc.add_solenoid('Sol. 5', 3.670, 0.0400, 'Bz.dat')
acc.add_solenoid('Sol. 6', 4.570, 0.0595, 'Bz.dat')
acc.add_solenoid('Sol. 7', 5.470, 0.0590, 'Bz.dat')
Три элемента из девяти расположены вне интервала счёта. Это Sol. 1 на 0.450 м, находящийся
до его начала, а также Sol. 7 и Acc. 2 на 5.470 и 5.944 м, вышедшие за его конец.
Профиль поля, заданный для каждого элемента, имеет конечную ширину,
и своими краями он заходит внутрь окна. Однако полностью в расчёт попадает только один
ускоряющий модуль из двух, и приведённые ниже графики, построенные на этом интервале, следует читать с поправкой: за \( z = 5 \) м расчёт не производится.
Метод compile() сшивает профили всех девяти элементов в две функции, \(E_z(z)\) и \(B_z(z)\), которые далее опрашиваются в каждой точке траектории каждой частицы.
acc.compile()
Опишем оси и построим оба поля вдоль тракта. Магнитное поле, измеряемое в теслах, переводится в гауссы умножением на \(10^4\).
dim_z = hv.Dimension('z', unit='m')
dim_Ez = hv.Dimension('Ez', unit='MV/m', label='$E_z$')
dim_Bz = hv.Dimension('Bz', unit='Gs', label='$B_z$')
z = acc.z
z_Ez = hv.Curve((z, acc.Ez(z)), kdims=dim_z, vdims=dim_Ez)
z_Bz = hv.Curve((z, acc.Bz(z)*1e4), kdims=dim_z, vdims=dim_Bz)
(z_Ez + z_Bz).cols(1)

Собранную структуру полезно распечатать целиком: так проще заметить пропущенный или неверно расположенный элемент.
print(acc)
Accelerator structure.
Solenoids:
[ 0.45 m, -0.058 T, Bz.dat, Sol. 1, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 0.957 m, 0.039 T, Bz.dat, Sol. 2, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 2.107 m, 0.025 T, Bz.dat, Sol. 3, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 2.907 m, 0.044 T, Bz.dat, Sol. 4, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 3.67 m, 0.04 T, Bz.dat, Sol. 5, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 4.57 m, 0.0595 T, Bz.dat, Sol. 6, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 5.47 m, 0.059 T, Bz.dat, Sol. 7, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
Accelerating modules:
[ 4.096 m, -1.1 T, Ez.dat, Acc. 1, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
[ 5.944 m, -1.1 T, Ez.dat, Acc. 2, 0.0 m, 0.0 rad, 0.0 m, 0.0 rad]
Quadrupoles:
Correctors x:
Correctors y:
У ускоряющих модулей поле напечатано в теслах, хотя задано оно было в МВ/м.
Это недоработка метода __str__ в библиотеке, который выводит одну и ту же подпись
для соленоидов и для ускоряющих секций. Числа верны, а единицы нет. Печать состояния объекта, написанная наспех, затем читается
годами, и разбираться в чужих единицах, нигде не оговорённых, приходится по исходному коду.
Задаём параметры пучка
В отличие от KENV, где пучок описывался одной огибающей, здесь необходимо задать распределение, по которому разыгрываются макрочастицы; выбрано равномерное по радиусу распределение. Параметры пучка: электроны, энергия 1.32 МэВ, ток 500 А, радиус 48 мм, угловой разброс 70 мрад, нормализованный эмиттанс 200 мм·мрад. Продольный «радиус» 3.5 метра означает, что сгусток значительно длиннее самого тракта, и пучок здесь практически непрерывен, то есть неотличим от постоянного тока.
beam = rp.beam.RadialUniformBeam(
type=rp.constants.electron,
energy = 1.32, # MeV
current = 0.5e3, # A
radius_x = 48e-3, # initial r (m)
radius_y = 48e-3, # initial r (m)
radius_z = 3.5,
radius_xp = 2*35.0e-3, # initial r' (rad)
radius_yp = 2*35.0e-3, # initial r' (rad)
x = 0.0e-3, # horizontal centroid position (m)
xp = 0.0e-3, # horizontal centroid angle (rad)
y = 0, # vertical centroid position (m)
normalized_emittance = 200e-6 # m*rad
)
По этому описанию разыгрывается ансамбль из десяти тысяч макрочастиц. Чем больше частиц, тем меньше статистический шум, различимый в фазовом портрете, и тем дольше рассчитывается каждый шаг.
beam.generate(10_000)
2026-10-03 20:21:48,695 - redpic.beam.base - INFO - Generate a radial-uniform beam with 10000 particles
Пучок хранится в виде обычного датафрейма pandas, где под три координаты и три компоненты импульса отведены шесть колонок, по строке на частицу. Все возможности pandas применимы и здесь, поэтому отфильтровать хвост распределения или вычислить моменты, усреднённые по ансамблю, можно одной строкой.
beam.df
| x | y | z | px | py | pz | |
|---|---|---|---|---|---|---|
| 0 | 0.020430 | 0.032860 | 3.230942 | 0.059147 | 0.095423 | 1.749950 |
| 1 | -0.012114 | -0.007815 | 1.138545 | -0.035132 | -0.021837 | 1.754104 |
| 2 | 0.003465 | -0.001997 | 0.895079 | 0.009593 | -0.004939 | 1.754205 |
| 3 | -0.004838 | -0.038318 | 1.900593 | -0.013970 | -0.112354 | 1.756371 |
| 4 | -0.020100 | -0.011076 | -3.390711 | -0.057724 | -0.032294 | 1.744359 |
| ... | ... | ... | ... | ... | ... | ... |
| 9995 | 0.022497 | 0.010227 | -3.416964 | 0.066272 | 0.029244 | 1.764491 |
| 9996 | -0.011401 | -0.020128 | -0.014672 | -0.032367 | -0.058564 | 1.756180 |
| 9997 | -0.000811 | -0.015630 | -0.385042 | -0.001616 | -0.044973 | 1.761539 |
| 9998 | -0.028093 | -0.023316 | 0.916112 | -0.081342 | -0.067712 | 1.769890 |
| 9999 | 0.013398 | -0.033077 | 1.778448 | 0.039287 | -0.095823 | 1.750987 |
10000 rows × 6 columns
Опишем оси.
dim_x = hv.Dimension('x', unit='m', range=(-0.1, 0.1))
dim_y = hv.Dimension('y', unit='m', range=(-0.1, 0.1))
dim_z = hv.Dimension('z', unit='m', range=(acc.z_start, acc.z_stop))
dim_px = hv.Dimension('px', unit='MeV/c', label='$p_x$')
dim_py = hv.Dimension('py', unit='MeV/c', label='$p_y$')
и соберём четыре проекции, построенные по одному датафрейму: поперечное сечение \(x\)–\(y\), продольный вид \(z\)–\(x\) и два фазовых портрета, \(x\)–\(p_x\) и \(y\)–\(p_y\).
beam_x_y = hv.Scatter(beam.df, kdims=[dim_x, dim_y])
beam_z_x = hv.Scatter(beam.df, kdims=[dim_z, dim_x])
beam_x_px = hv.Scatter(beam.df, kdims=[dim_x, dim_px])
beam_y_py = hv.Scatter(beam.df, kdims=[dim_y, dim_py])
WARNING:param.Scatter: Chart elements should only be supplied a single kdim
2026-10-03 20:21:48,700 - param.Scatter - WARNING - Chart elements should only be supplied a single kdim
WARNING:param.Scatter: Chart elements should only be supplied a single kdim
2026-10-03 20:21:48,701 - param.Scatter - WARNING - Chart elements should only be supplied a single kdim
WARNING:param.Scatter: Chart elements should only be supplied a single kdim
2026-10-03 20:21:48,701 - param.Scatter - WARNING - Chart elements should only be supplied a single kdim
WARNING:param.Scatter: Chart elements should only be supplied a single kdim
2026-10-03 20:21:48,701 - param.Scatter - WARNING - Chart elements should only be supplied a single kdim
Предупреждения HoloViews можно не принимать во внимание: Scatter ожидает одну ключевую размерность, а передаются две; на изображение это не влияет. Отметим, что каждое из них напечатано дважды: вторую копию, с датой и временем, выводит обработчик корневого журнала, который REDPIC настраивает при импорте.
(beam_x_y + beam_z_x + beam_x_px + beam_y_py).cols(2)

В поперечном сечении видно круглое пятно радиусом 48 мм. Фазовые портреты представляют собой наклонные полосы, а не облака; это видно и по числам в таблице, напечатанной сразу после генерации, где у первых же частиц \(p_x/x \approx 2.9\) для всех подряд. Пучок стартует расходящимся, поперечный импульс частицы почти пропорционален её координате, а толщина полосы соответствует эмиттансу, неустранимому никакой фокусировкой.
Параметры сгенерированного пучка распечатаем и сверим с заданными.
print(beam)
Beam parameters:
Type electron
Distribution radial-uniform
Particles 10000
Current 500.0 A
Energy 1.32 MeV
Total momentum 1.7582483413390728 MeV/c
Rel. factor 3.58317555881007
Radius x 48.0 mm
Radius y 48.0 mm
Radius z 3.5 m
Radius x prime 70.0 mrad
Radius y prime 70.0 mrad
Horizontal centroid position 0.0 mm
Vertical centroid position 0.0 mm
Horizontal centroid angle 0.0 mrad
Vertical centroid angle 0.0 mrad
Normalized emittance x 200.0 mm*mrad
Normalized emittance y 200.0 mm*mrad
Запуск моделирования
Полный импульс 1.7582 МэВ/c и \(\gamma = 3.58\) получены пересчётом заданной энергии и точно с ней согласуются.
Свяжем пучок с трактом и запустим трекинг. Внутри track() выполняется схема, выписанная в начале главы: поля, приращение импульса, поворот в магнитном поле и сдвиг координат, рассчитываемые для каждой из десяти тысяч частиц на каждом шаге.
rp_sim = rp.solver.Simulation(beam, acc)
rp_sim.track()
99.5 %
Визуализация результатов моделирования
Индикатор показывает долю отведённого времени счёта, которое REDPIC берёт равным времени пролёта тракта со скоростью света; 99.5 % соответствует последнему шагу. Результат rp_sim.result организован в виде словаря из двадцати кадров, где ключом служит та же доля времени в процентах, от 0 до 95.3, а значением — датафрейм со всеми частицами в этот момент. Это покадровая запись, хранимая целиком в памяти.
Напишем функцию, которая строит один кадр.
def plot(i):
df = rp_sim.result[i]
rp_z_x = hv.Scatter(df, kdims=[dim_z, dim_x], label='redpic')
return rp_z_x
и объединим кадры в HoloMap — интерактивное изображение, управляемое ползунком по времени счёта. Перемещение ползунка позволяет увидеть не только изменение размера пучка, но и перемешивание частиц внутри него и поведение его края.
items = [(i, plot(i)) for i in list(rp_sim.result.keys())]
holomap = hv.HoloMap(items, kdims = [hv.Dimension('t', unit='%')])
hv.output(holomap, widget_location='bottom')
В главах про KENV весь тракт описывался одной кривой и рассчитывался за доли секунды; REDPIC ведёт по близкой геометрии десять тысяч частиц, рассчитываемых поодиночке, и платит за это временем: трекинг на двух ядрах виртуальной машины занимает около 12 с. Взамен он показывает то, чего нет в огибающей: как отдельные частицы уходят из ядра, откуда возникает гало и что происходит с фазовым портретом там, где приближение однородного пучка, положенное в основу огибающей, уже не работает. Структуры и пучки в главах различны, поэтому сравнивать здесь можно порядки времени счёта, а не сами числа.
Таким образом, огибающей целесообразно рассчитывать всё, что возможно, а к макрочастицам переходить только тогда, когда огибающая перестаёт отвечать на поставленный вопрос.
Коррекция равновесной орбиты с применением матрицы отклика и нейронных сетей
Коррекция орбиты является повседневной задачей ускорительного комплекса, решаемой сочетанием линейной алгебры и машинного обучения. NumPy и регрессия разобраны в предыдущих разделах; сингулярное разложение, на котором основана коррекция, рассматривается в настоящей главе.
Слайды к главе. Матрица отклика и SVD с отсечением мод, сеть, обученная на остатках, и повторный запуск кода главы изложены также в третьей части лекции «Разбор реальных кодов» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Постановка задачи
В циклическом ускорителе пучок за оборот проходит через сотни магнитов. В идеальной машине он движется по расчётной равновесной орбите — замкнутой кривой, проходящей через центры всех магнитов. В реальной машине магниты выставлены с ошибками в десятки–сотни микрон, полы здания смещаются с сезонами и приливами, а источники питания, нагруженные круглосуточно, дрейфуют. Каждая ошибка дипольного поля искажает замкнутую орбиту, и пучок, смещённый с оси, начинает блуждать по апертуре, задевая стенки камеры, теряя частицы и ухудшая светимость и качество синхротронного излучения.
Для устранения этих искажений в кольце установлены два набора устройств.
- Мониторы положения пучка (BPM, пикапы) — \(N_{bpm}\) штук, измеряющие отклонение орбиты \(x_i\) в своих точках;
- Дипольные корректоры — \(N_{cor}\) штук, слабые магниты, каждый из которых поворачивает траекторию на угол \(\theta_j\).
Задача коррекции, стоящая перед оператором каждую смену, состоит в следующем: по измеренному вектору отклонений \(\vec{x}\) найти такие углы корректоров \(\vec{\theta}\), при которых орбита окажется как можно ближе к расчётной.
Матрица отклика
Пока отклонения малы, ускоритель остаётся линейной системой. Реакция орбиты на \(j\)-й корректор, включённый в одиночку, описывается матрицей отклика (response matrix).
$$ x_i = \sum_{j} R_{ij},\theta_j, \qquad R_{ij} = \frac{\partial x_i}{\partial \theta_j}. $$
В линейной теории колебаний частицы в фокусирующей структуре элемент матрицы отклика для кольца выражается через параметры магнитной оптики.
$$ R_{ij} = \frac{\sqrt{\beta_i \beta_j}}{2\sin(\pi\nu)}\cos\left(|\varphi_i - \varphi_j| - \pi\nu\right), $$
где \(\beta_i\), \(\beta_j\) — значения бета-функции в точках монитора и корректора, \(\varphi_i\), \(\varphi_j\) — набеги бетатронной фазы, \(\nu\) — бетатронная частота (число колебаний на оборот). Матрицу можно рассчитать по модели оптики, а можно измерить, отклоняя каждый корректор по очереди и записывая отклик всех мониторов. Обычно поступают именно так, одновременно проверяя модель.
Построим модельное кольцо на Python, устроенное по этой же формуле. Отметим, что все листинги главы берут случайные числа из одного генератора rng и выполняются подряд, в одном сеансе интерпретатора: числа в распечатках получены именно так, на Apple M4 с NumPy 2.4 и scikit-learn 1.9. Повторное выполнение отдельного листинга сдвигает состояние генератора и меняет все последующие таблицы, а угол при сорока восьми модах, полученный делением на шум округления, на другой машине будет иным.
import numpy as np
rng = np.random.default_rng(42)
n_bpm, n_cor = 64, 48 # мониторы и корректоры
nu = 8.42 # бетатронная частота кольца
# расставим элементы по кольцу и разыграем бета-функции
phi_bpm = np.sort(rng.uniform(0, 2 * np.pi * nu, n_bpm)) # фазы мониторов
phi_cor = np.sort(rng.uniform(0, 2 * np.pi * nu, n_cor)) # фазы корректоров
beta_bpm = rng.uniform(4.0, 24.0, n_bpm) # бета в мониторах, м
beta_cor = rng.uniform(4.0, 24.0, n_cor) # бета в корректорах, м
def response_matrix(beta_b, phi_b, beta_c, phi_c, nu):
"""Матрица отклика замкнутой орбиты кольца, мм/мрад."""
dphi = np.abs(phi_b[:, None] - phi_c[None, :])
return (np.sqrt(beta_b[:, None] * beta_c[None, :])
/ (2 * np.sin(np.pi * nu))
* np.cos(dphi - np.pi * nu))
R = response_matrix(beta_bpm, phi_bpm, beta_cor, phi_cor, nu)
print(R.shape) # (64, 48)
Внесём в машину нормально распределённые случайные ошибки и рассмотрим полученную орбиту.
# истинные ошибки — как будто от смещений квадруполей
theta_err = rng.normal(0, 0.05, n_cor) # мрад
noise = rng.normal(0, 0.02, n_bpm) # шум мониторов, мм
x_measured = R @ theta_err + noise # измеренная орбита
print(f"СКО орбиты до коррекции: {x_measured.std():.3f} мм")
СКО орбиты до коррекции: 1.539 мм
Коррекция через SVD
Нахождение токов корректоров сводится к решению обратной задачи \(R\vec{\theta} \approx -\vec{x}\). Матрица прямоугольная (\(64 \times 48\)), система переопределена, поэтому решение ищется в смысле наименьших квадратов. Стандартным инструментом в физике ускорителей является сингулярное разложение (SVD).
$$ R = U,\Sigma,V^T, \qquad \vec{\theta} = -V,\Sigma^{-1}U^T \vec{x}. $$
Часть сингулярных чисел \(\sigma_k\) близка к нулю. Соответствующие комбинации корректоров почти не влияют на орбиту в мониторах, и при обращении \(1/\sigma_k\) для таких мод неограниченно растёт, вследствие чего шум мониторов превращается в огромные токи корректоров. Это классическая некорректная обратная задача, и решается она отсечением малых сингулярных чисел.
def svd_correction(R, x, n_modes):
"""Коррекция орбиты с обрезанием SVD-спектра до n_modes мод."""
U, s, Vt = np.linalg.svd(R, full_matrices=False)
s_inv = np.zeros_like(s)
s_inv[:n_modes] = 1.0 / s[:n_modes] # оставляем только сильные моды
return -(Vt.T * s_inv) @ (U.T @ x)
for n_modes in [10, 30, 48]:
theta_corr = svd_correction(R, x_measured, n_modes)
x_after = R @ (theta_err + theta_corr) + rng.normal(0, 0.02, n_bpm)
print(f"мод: {n_modes:2d} | СКО орбиты: {x_after.std():6.3f} мм"
f" | максимальный угол: {np.abs(theta_corr).max():6.3f} мрад")
мод: 10 | СКО орбиты: 0.297 мм | максимальный угол: 0.061 мрад
мод: 30 | СКО орбиты: 0.028 мм | максимальный угол: 0.126 мрад
мод: 48 | СКО орбиты: 0.030 мм | максимальный угол: 1343310628796.820 мрад
Десять мод уменьшают орбиту в пять раз, тридцать — в пятьдесят пять, причём токи корректоров остаются приемлемыми. Все сорок восемь мод орбиту не улучшают (0.030 против 0.028 мм), однако требуемые углы возрастают до \(10^{12}\) мрад.
Происхождение величины \(10^{12}\) видно из спектра. Наибольшее сингулярное число здесь равно 183.6, сорок первое — 0.057, а последние семь лежат в районе \(10^{-14}\), то есть на уровне ошибки округления. Матрица модели вырождена: её ранг равен 41, а не 48. Семь комбинаций корректоров не влияют на орбиту, и деление на малое число оказывается делением на ноль, размытый арифметикой с плавающей точкой.
На реальном кольце измеренная матрица отклика обусловлена плохо, но не вырождена: отношение наибольшего сингулярного числа к наименьшему там составляет \(10^2 - 10^3\), а не \(10^{16}\), как здесь. Усекать спектр всё равно приходится, однако по другой причине.
Число удерживаемых мод является компромиссом между качеством коррекции и величиной токов. Родственный подход даёт регуляризация Тихонова, где вместо жёсткого усечения минимизируется \(|R\theta + x|^2 + \lambda|\theta|^2\).
На действующих машинах эта процедура работает в цикле медленной обратной связи без участия человека: орбита измеряется, умножается на заранее рассчитанную псевдообратную матрицу, токи корректируются, и так многократно в секунду.
Причём здесь нейронные сети
Линейный подход имеет границы применимости.
- при больших искажениях и в сильно нелинейных элементах (секступолях) отклик, предсказанный линейной теорией, расходится с действительным;
- реальная оптика дрейфует, и матрица, измеренная утром, к вечеру уже несколько отличается;
- измерение полной матрицы отклика является длительной процедурой, отнимающей пучковое время.
Нейронная сеть обучается отображению «орбита → корректирующие токи» по данным, не требуя явной модели машины. Обучающая выборка формируется из симуляций с разыгранными ошибками или из архива системы управления, где за годы работы накапливаются миллионы пар «орбита — токи», записанных в реальных условиях.
Построим такой корректор на многослойном перцептроне.
from sklearn.neural_network import MLPRegressor
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
# обучающая выборка: случайные ошибки -> орбиты (с шумом мониторов)
n_samples = 20_000
thetas = rng.normal(0, 0.05, (n_samples, n_cor))
orbits = thetas @ R.T + rng.normal(0, 0.02, (n_samples, n_bpm))
model = make_pipeline(
StandardScaler(),
MLPRegressor(hidden_layer_sizes=(128, 128), activation="relu",
max_iter=200, early_stopping=True, random_state=0),
)
model.fit(orbits, thetas) # учимся восстанавливать ошибки
theta_pred = model.predict(x_measured[None, :])[0]
x_after_nn = R @ (theta_err - theta_pred) + rng.normal(0, 0.02, n_bpm)
print(f"СКО орбиты после нейросетевой коррекции: {x_after_nn.std():.3f} мм")
СКО орбиты после нейросетевой коррекции: 0.151 мм
Значение 0.151 мм в десять раз лучше, чем до коррекции, но в пять раз хуже, чем даёт SVD с тридцатью модами. Это ожидаемо. Модельная машина линейна по построению, а для линейной задачи SVD является точным решением в смысле наименьших квадратов; превзойти его невозможно, и сеть, обученная на тех же данных, может лишь приблизиться к нему, затратив двадцать тысяч примеров и минуту обучения.
Такой тест обязателен. На линейной задаче нейросеть не нужна. Если бы сеть превзошла SVD, это означало бы ошибку в постановке эксперимента. Машинное обучение необходимо там, где линейная модель перестаёт быть точной.
Гибридный корректор. Сеть учится на остатках
Реальная машина линейна лишь приближённо. Корректоры насыщаются, секступоли вносят нелинейный отклик, железо магнитов имеет гистерезис, и после SVD-коррекции в орбите остаётся систематический остаток, не описываемый линейной моделью. Именно он передаётся сети.
Такая конструкция используется на действующих установках; проверим её на модели.
$$ \Delta\theta = \underbrace{\Delta\theta_{\text{SVD}}}{\text{линейная часть}} + \underbrace{\Delta\theta{\text{НС}}}_{\text{поправка на нелинейность}}. $$
Сеть обучается не отображению «орбита → токи» целиком, а только разности между истинной ошибкой и ответом, предложенным SVD. Задача на порядок проще: вместо всей линейной алгебры кольца сеть уточняет почти правильный ответ линейной части. Сети достаточно двух скрытых слоёв 64–32.
Усилим нелинейность: пропустим суммарный угол в каждом корректоре — ошибку вместе с поправкой — через \(\theta_{max}\tanh(\theta/\theta_{max})\) с \(\theta_{max}\) в несколько раз меньше типичной ошибки (\(\sigma = 0.05\) мрад), чтобы линейная модель заведомо перестала быть точной. Это модельная нелинейность, а не предел источника питания: сами поправки здесь не ограничены. Кольцо, матрица отклика R и число удерживаемых мод остаются прежними, заданными в начале главы.
THETA_MAX = 0.01 # масштаб насыщения, мрад
sigma_bpm = 0.02 # шум мониторов, мм
n_modes = 30 # удерживаемых SVD-мод, как и раньше
def machine(theta):
# суммарный угол в корректоре насыщается: отклик уже не линеен
return R @ (THETA_MAX * np.tanh(theta / THETA_MAX))
Псевдообратную матрицу из усечённого спектра рассчитаем один раз заранее: коррекция сводится к умножению на неё, и разложение \(R\) на каждом шаге не требуется.
U, s, Vt = np.linalg.svd(R, full_matrices=False)
s_inv = np.zeros_like(s)
s_inv[:n_modes] = 1.0 / s[:n_modes]
svd_matrix = -(Vt.T * s_inv) @ U.T # то же, что svd_correction, но матрицей
Обучающая выборка строится так же, как раньше, однако целью служит остаток, не устранённый SVD.
n_samples = 20_000
thetas = rng.normal(0, 0.05, (n_samples, n_cor))
orbits = (THETA_MAX * np.tanh(thetas / THETA_MAX)) @ R.T \
+ rng.normal(0, sigma_bpm, (n_samples, n_bpm))
svd_answer = orbits @ svd_matrix.T # что предложил бы SVD
residuals = -thetas - svd_answer # чего ему не хватило
Сеть обучается предсказывать этот остаток по орбите, а шаг коррекции суммирует оба вклада.
net = make_pipeline(
StandardScaler(),
MLPRegressor(hidden_layer_sizes=(64, 32), max_iter=300,
early_stopping=True, random_state=0),
)
net.fit(orbits, residuals)
def hybrid_step(x):
# один шаг коррекции: линейное решение плюс поправка сети
return svd_matrix @ x + net.predict(x[None, :])[0]
Второе решение: коррекция выполняется итеративно. После каждого шага орбита измеряется заново, и следующая поправка рассчитывается по новым данным. Итерации необходимы потому, что модель неточна. Линейное решение приводит орбиту в окрестность нуля, а далее нелинейность становится малой поправкой, с которой линейная модель справляется.
Проведём 100 испытаний со случайными ошибками, генерируемыми заново для каждого, и сравним чистый итеративный SVD с гибридом. В таблице приведены среднее по испытаниям и среднеквадратичный разброс.
def run(step, n_iter=6, n_trials=100):
out = np.zeros((n_trials, n_iter + 1))
for t in range(n_trials):
theta = rng.normal(0, 0.05, n_cor)
for k in range(n_iter + 1):
x = machine(theta) + rng.normal(0, sigma_bpm, n_bpm)
out[t, k] = x.std()
if k < n_iter:
theta = theta + step(x)
return out.mean(0), out.std(0)
svd_mean, svd_std = run(lambda x: svd_matrix @ x) # чистый итеративный SVD
nn_mean, nn_std = run(hybrid_step) # гибрид SVD плюс сеть
print(f"до коррекции {svd_mean[0]:.3f} ± {svd_std[0]:.3f} мм")
print()
print("итер | SVD | гибрид SVD+НС | выигрыш")
for k in range(1, len(svd_mean)):
gain = 100 * (svd_mean[k] - nn_mean[k]) / svd_mean[k]
print(f"{k:4d} | {svd_mean[k]:7.3f} ± {svd_std[k]:5.3f} |"
f" {nn_mean[k]:7.3f} ± {nn_std[k]:5.3f} | {gain:+5.1f}%")
до коррекции 0.308 ± 0.109 мм
итер | SVD | гибрид SVD+НС | выигрыш
1 | 0.271 ± 0.098 | 0.195 ± 0.068 | +28.2%
2 | 0.232 ± 0.083 | 0.192 ± 0.075 | +17.2%
3 | 0.195 ± 0.074 | 0.226 ± 0.079 | -15.7%
4 | 0.160 ± 0.061 | 0.236 ± 0.081 | -47.8%
5 | 0.131 ± 0.049 | 0.244 ± 0.082 | -85.8%
6 | 0.112 ± 0.039 | 0.250 ± 0.087 | -123.7%
Прежняя версия главы приводила здесь таблицу, полученную при ином состоянии генератора (до коррекции 0.306 мм, выигрыш на первой итерации +27.1 %): напечатанный листинг, выполненный подряд, её не воспроизводит, и это расхождение разобрано в лекции. Из таблицы следуют три вывода.
Сеть выигрывает на первых итерациях. На первом шаге гибрид даёт орбиту более чем на четверть лучше, 0.195 против 0.271 мм. Это вклад нелинейности, которую SVD не учитывает, а сеть выучила. На реальной машине выигрыш измеряется не в миллиметрах, а в пучковом времени: каждая итерация коррекции представляет собой отдельный цикл «выставить токи, дождаться стабилизации, измерить орбиту», и сокращение их числа ценнее, чем выигрыш последних микрон.
Начиная с третьей итерации гибрид проигрывает, и разрыв растёт. Чистый SVD к шестой итерации доводит орбиту до 0.112 мм, а гибрид выходит на плато и медленно растёт к 0.250 мм. Плато возникает из-за систематической ошибки сети. Обученная на конечной выборке, она предсказывает остаток с погрешностью, и на каждой итерации эта погрешность вносится в орбиту. Сеть сама становится источником ошибки.
Итеративность решает ту же задачу, что и сеть, и решает её лучше. Два улучшения направлены на одну проблему, поэтому суммировать их бессмысленно. Если сравнить гибрид после трёх итераций (0.226 мм) с однократным SVD (0.271 мм), получилось бы улучшение на 17 %, которое было бы приписано сети, тогда как принадлежит оно итерациям. Вклад каждого улучшения необходимо разделять. В противном случае легко опубликовать результат, который не выдержит попытки воспроизведения.
У гибридного корректора существует оптимальное число итераций, и его необходимо измерить. Здесь это первая-вторая итерация: гибрид даёт 0.195 и 0.192 мм, и разность меньше стандартной ошибки среднего по ста испытаниям, около 0.007 мм, а его преимущество над чистым SVD сокращается с +28.2 % до +17.2 %, чтобы на третьей смениться проигрышем. Останавливаться следует там, где поправка, предсказанная сетью, перестаёт превышать её собственную погрешность.
Величина выигрыша зависит от кольца. Тот же код, выполненный для двадцати других колец с зёрнами генератора от 1 до 20, даёт на первой итерации от −6.8 % до +31.0 %: на двенадцати кольцах из двадцати одного, включая разобранное, выигрыш превышает 10 %, на пяти он положителен, но меньше 5 %, а на четырёх гибрид уступает SVD уже на первом шаге. Таким образом, проигрыш к шестой итерации повторяется на всех кольцах, а выигрыш на первых шагах — нет. Поэтому в таблице приведён разброс, а вывод о методе необходимо проверять на нескольких кольцах; без этого из таких данных можно «доказать» что угодно.
Стоимость одного шага также имеет значение. Один шаг SVD сводится к умножению матрицы \(48\times64\) на вектор и занимает 1.2 мкс на Apple M4; один вызов сети, обёрнутой в scikit-learn, занимает 110 мкс, почти в сто раз дольше. Для медленной обратной связи с частотой в единицы герц это несущественно, а для быстрой (килогерцы) уже существенно, и сеть потребуется вынести из Python в скомпилированный код.
Применимость на реальной установке
На линейном ускорителе инжектора ЦКП «СКИФ» коррекция орбиты выполняется по измеренной матрице отклика, для чего служат 7 датчиков положения пучка, 6 больших и 8 малых рамочных двухкоординатных корректоров. Матрица там измеряется, а не берётся из модели. Каждый корректор по очереди отклоняется на известную величину, и записывается отклик всех пикапов. Процедура длительная, однако одновременно она проверяет модель оптики. Коррекция выполняется итеративно, с повторным измерением матрицы отклика между итерациями. Без неё транспортировка пучка по ускорителю и каналу сопровождается значительными потерями, что обнаруживается при запуске каждой новой машины.
Ниже приведены три обстоятельства, не заметные на модели, но определяющие успех на пульте.
- Выбор числа сингулярных чисел остаётся главным настроечным параметром. При слишком большом числе в решение попадают шумовые компоненты, усиленные делением на малые сингулярные числа, и коррекция ухудшается; при слишком малом коррекция оказывается недостаточной. Число выбирается по минимуму невязки, перебором, как показано выше.
- Ограничения на токи корректоров входят в алгоритм, а не в проверку после него. Источник питания корректора имеет предел в несколько ампер; если ограничение не заложено в постановку задачи, оптимизатор выдаёт неисполнимый ответ, подобный варианту со всеми сорока восемью модами выше.
- Сеть, если она добавляется, инициализируется SVD-решением. Это та же работа по остаткам, что и выше на модели: линейная часть даёт разумное приближение, сеть отвечает за поправку. Декомпозиция обеспечивает и предсказуемую деградацию: если сеть выдаст некорректный результат, останется рабочее SVD-решение. Гибридная схема с ограничениями на токи и SVD-инициализацией проверялась, в частности, на модели накопителя ВЭПП-5, где стоят 16 датчиков положения и 16 корректоров с пределом \(\pm 7\) А.
Нейросетевой корректор всегда работает рядом с классическим, а не вместо него. SVD-коррекция с усечением мод является прозрачным и предсказуемым алгоритмом, сеть — непрозрачным дополнением для режимов, где линейная модель перестаёт работать. Предложенные сетью токи проходят те же ограничения и проверки, что и любые другие.
Задания для самостоятельной работы
- На основе приведённого выше кода построить зависимость СКО орбиты и максимального тока корректора от числа удерживаемых SVD-мод, получив классическую L-кривую регуляризации.
- Усилить нелинейность (снизить \(\theta_{max}\) вдвое) и повторить таблицу из 100 испытаний, определив величину насыщения, при которой преимущество гибрида перестаёт исчезать к третьей итерации.
- Испортить один монитор (умножить его показания на 3) и определить, какой из методов устойчивее к неисправному датчику; обучить сеть на данных, испорченных такими же неисправностями.
- Заложить в коррекцию предел корректора, ограничив предлагаемые углы по \(\pm\theta_{max}\) до подачи на машину, и оценить, насколько это меняет число итераций до выхода на плато.
Полезные ссылки
- S. Y. Lee. Accelerator Physics, теория замкнутой орбиты и коррекции.
- CERN Accelerator School: Orbit correction, лекции по коррекции орбиты и SVD.
- J. Kaiser et al. Bridging the gap between machine learning and particle accelerator physics (PRAB 27, 054601, 2024), применения МО в ускорителях.
- Раздел про машинное обучение и глава про нейронные сети этой книги, где собрана вся использованная здесь математика.
Трёхмерная схема установки кодом
Преимущества программного описания геометрии
Трёхмерная модель установки обычно создаётся вручную в CAD-редакторе; для машиностроения такой подход подходит, а для ускорителя, перестраиваемого каждый сезон, — нет.
Магнитная структура хранится в текстовом файле со списком элементов, снабжённых длинами, градиентами и углами поворота, и этот файл изменяется постоянно: добавляется квадруполь, переносится диагностика, меняется угол, заданный поворотному магниту. Каждое такое изменение означает, что построенная вручную модель устарела, и сотрудник, отвечающий за чертежи, должен вспомнить о необходимости её перестроить. Как правило, этого не происходит.
В библиотеке CadQuery геометрия описывается кодом на Python. Модель размещается в репозитории рядом с расчётом, различия между версиями видны в git diff, сборка чертежа включается в конвейер тестов, запускаемый на каждом коммите, и тело установки строится непосредственно из описания структуры, заданного один раз, а не параллельно ему.
Слайды к главе. Описание структуры данными, конструкторы элементов, расстановка вдоль траектории и проверка геометрии арифметикой изложены также в начале четвёртой части лекции «Разбор реальных кодов» вместе с рисунком схемы, построенным кодом главы; слайды лекции доступны на сайте книги и в PDF.
Структура как данные
Рассмотрим участок тракта, содержащий два квадруполя, дрейфы между ними и два поворотных магнита по 45°.
import numpy as np
import cadquery as cq
# тип элемента, длина в метрах, параметр
LATTICE = [
("drift", 0.30, None), ("quad", 0.20, +1), ("drift", 0.30, None),
("bend", 0.50, np.pi / 4),
("drift", 0.30, None), ("quad", 0.20, -1), ("drift", 0.30, None),
("bend", 0.50, np.pi / 4),
]
В реальном проекте такой список не задаётся вручную, а читается из файла магнитной структуры, по которому работает расчётный код. Здесь он задан явно, чтобы пример был самодостаточным, однако источником геометрии и источником физики служит один и тот же файл, прочитанный дважды разными программами.
Один тип элемента, одна функция
На каждый тип элемента заводится своя функция-конструктор, знающая о создаваемом ею теле и ничего не знающая о соседях.
def drift(length, _):
return cq.Workplane("XY").circle(0.02).extrude(length)
def quad(length, sign):
body = cq.Workplane("XY").rect(0.24, 0.24).extrude(length)
return body.edges("|Z").fillet(0.03) if sign > 0 else body
def bend(length, angle):
r = length / angle # радиус по длине дуги и углу
return (cq.Workplane("XY").rect(0.20, 0.16)
.revolve(np.degrees(angle), (r, 0, 0), (r, 1, 0)))
BUILDERS = {"drift": drift, "quad": quad, "bend": bend}
Тела здесь строятся выдавливанием и вращением плоского контура, а не составлением из примитивов. Дрейф задан окружностью, вытянутой на длину, а поворотный магнит прямоугольником, проведённым вокруг оси на требуемый угол, и геометрия остаётся параметрической: при изменении угла в описании структуры тело перестраивается автоматически.
Словарь BUILDERS в конце заменяет длинную цепочку if, разрастающуюся с каждым новым типом элемента. Добавление секступоля сводится к написанию функции и одной строки в словаре; код расстановки, написанный один раз, изменять не требуется.
Размещение элементов
Элементы расставляются вдоль траектории пучка, изгибающейся на каждом поворотном магните.
Введём две величины: положение начала текущего элемента и направление, задаваемое пучку. Для каждого элемента необходимо знать, куда сместится его конец относительно начала, унаследованного от предыдущего элемента.
def local_step(kind, length, param):
"""Смещение конца элемента относительно начала, в его собственных осях."""
if kind != "bend":
return np.array([0.0, 0.0, length]), 0.0
r = length / param
return np.array([r * (1 - np.cos(param)), 0.0, r * np.sin(param)]), param
Прямой элемент сдвигает пучок вперёд на отведённую ему длину и направления не меняет. Поворотный ведёт пучок по дуге радиуса \(R = L/\theta\), с концом, смещённым вперёд на \(R\sin\theta\) и вбок на \(R(1-\cos\theta)\), а направление доворачивается на \(\theta\).
Остаётся пройти по описанной структуре, поворачивая локальное смещение на накопленный угол.
def build(lattice):
assembly, pos, heading = cq.Assembly(), np.zeros(3), 0.0
for i, (kind, length, param) in enumerate(lattice):
assembly.add(BUILDERS[kind](length, param), name=f"{kind}{i}",
loc=cq.Location(cq.Vector(*pos),
cq.Vector(0, 1, 0), np.degrees(heading)))
step, turn = local_step(kind, length, param)
c, s = np.cos(heading), np.sin(heading)
pos = pos + np.array([c * step[0] + s * step[2], 0.0,
-s * step[0] + c * step[2]])
heading += turn
return assembly, pos, heading
Порядок трёх действий, выполняемых внутри цикла, существен. Сначала элемент ставится в текущее положение с текущим направлением, затем сдвигается положение, и только после этого доворачивается направление. При перестановке двух последних строк каждый элемент, поставленный после поворотного магнита, окажется смещённым.
Проверка
Геометрию, построенную кодом, легко проверить, не открывая просмотрщик. Два поворота по 45° должны развернуть пучок в точности на 90°, а сумма длин элементов, выписанных в структуре, даёт длину траектории.
acc, pos, heading = build(LATTICE)
print("элементов:", len(acc.children))
bb = acc.toCompound().BoundingBox()
print(f"габарит: X {bb.xlen:.2f} м, Z {bb.zlen:.2f} м")
print(f"конец траектории: X {pos[0]:.3f} м, Z {pos[2]:.3f} м")
print(f"поворот: {np.degrees(heading):.1f}°")
assert bb.zmax >= pos[2] and bb.xmax >= pos[0] # тела обязаны накрывать траекторию
элементов: 8
габарит: X 1.32 м, Z 2.10 м
конец траектории: X 1.202 м, Z 2.002 м
поворот: 90.0°
Два поворота по 45° дают в точности 90°, полученная длина составляет 2.60 м, а конец траектории лежит внутри габарита. Таким образом, чертёж покрывается тестом.
assert в последней строке требует, чтобы тела элементов накрывали траекторию, по которой они расставлены. В процессе написания этой главы магнит строился вращением вокруг неверной оси, и обнаружено это было не визуально (изображение выглядело правдоподобно), а по тому, что Z-габарит, измеренный по сборке, составил 1.83 м при конце траектории на 2.002 м. Тело оказалось смещённым относительно пучка.
Готовая сборка выгружается в обменный формат, читаемый любым CAD.
cq.exporters.export(acc.toCompound(), "layout.step")
Выводы
Геометрия остаётся таким же продуктом кода, как график. К ней применимы контроль версий, сборка в конвейере и тесты. Модель, собранная из описания структуры, от него не отстаёт. Построенная вручную отстаёт всегда.
Разбиение на конструкторы повторяет декомпозицию, описанную в главе «От скрипта к приложению». Одна функция, отвечающая за одно тело, ничего не знает о соседях; расстановка не знает, из чего собран квадруполь. Граница проведена там, где ожидаются изменения: новые типы элементов появляются часто, а правило расстановки, записанное однажды, практически никогда не меняется.
Проверяемость важнее наглядности изображения. Ошибка, скрытая в трёхмерной модели, визуально почти не обнаруживается. Установка, выведенная на экран, выглядит правдоподобно, даже если один магнит смещён на полметра. Арифметика — сумма углов, длина траектории и габарит — обнаруживает её сразу.
Полезные ссылки
- Документация CadQuery, описание операций, применимых к телам.
- CQ-editor, редактор с трёхмерным просмотром для отладки.
- build123d, развитие той же идеи, переписанное с другим синтаксисом.
Идея строить трёхмерную схему ускорителя непосредственно из файла магнитной структуры принадлежит А. В. Петренко (ИЯФ СО РАН). Пример, приведённый в этой главе, написан заново и устроен иначе.
Цифровой двойник ускорителя
Задача
Пучковое время является наиболее дефицитным ресурсом в институте. Смена, расписанная на месяцы вперёд, слишком дорога, чтобы расходовать её на отладку скрипта коррекции. Вместе с тем написать скрипт, работающий с оборудованием, без взаимодействия с ним невозможно: пока программа не обратится к системе управления, неизвестно даже, верно ли заданы имена каналов.
Цифровой двойник представляет собой программу, неотличимую от настоящей машины для всех остальных программ. Для проекта Accumulator требуется ферма двойников, то есть десятки виртуальных ускорителей, запущенных одновременно и отвечающих на те же команды, что и оборудование. На такой ферме отрабатываются алгоритмы AI/ML и параллельная оптимизация без какого-либо риска и в обстановке, приближенной к реальной смене.
Ферма собрана из четырёх частей. Физическим ядром служит Elegant, расчётный код динамики пучка. Оболочкой является SCAUT, библиотека, оркеструющая эксперименты на линаке инжектора СКИФ; её слои разобраны в главе «От скрипта к приложению». Внешним интерфейсом выступает EPICS IOC, а тиражирование собранной системы осуществляется контейнерами Docker.
Слайды к главе. Устройство двойника ACCUMULATOR, граница перевода единиц, сканирование с библиотекой SCAUT и ферма двойников изложены также в четвёртой части лекции «Разбор реальных кодов» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
Устройство одного двойника
Двойник реализован не как скрипт, запускающий Elegant, а как сервер, работающий по протоколу EPICS Channel Access с теми же именами каналов и в тех же единицах, что и реальная машина.
┌──────────────────────────────┐
│ Клиент (Python / CS-Studio) │◄────────────┐
└───────────────┬──────────────┘ │
│ caput / caget │ readback PV
▼ │
┌──────────────────────────────┐ │
│ EPICS Channel Access │ │
└───────────────┬──────────────┘ │
│ PV: ACC1:MG-LA1:QLF1:K1 │
▼ │
┌──────────────────────────────┐ │
│ ElegantIOC (pcaspy) │─────────────┘
└───────────────┬──────────────┘◄────────────┐
│ eleput / eleget │ результат
▼ │
┌──────────────────────────────┐ │
│ Elegant (физическое ядро) │─────────────┘
└──────────────────────────────┘
Любой клиент, написанный для настоящей машины, работает с двойником без единой правки. Скрипт коррекции, операторский экран и оптимизатор вызывают caget и caput и не различают, с чем взаимодействуют: с оборудованием или с контейнером, запущенным на ноутбуке.
Сервер построен на библиотеке pcaspy. Точка входа accumulator/main.py разбирает файл структуры и передаёт полученный словарь каналов объекту SimpleServer вместе с префиксом экземпляра, взятым из переменной окружения. Затем запускается цикл, в котором запросы, принимаемые по сети, обрабатываются с частотой, заданной в IOC_REFRESH_RATE. Вся физика вынесена в драйвер ElegantIOC, унаследованный от pcaspy.Driver: он содержит два метода, write и read, вызываемые сервером при каждом обращении к каналу.
Структура вместо списка каналов
Список каналов нигде не задаётся вручную, а выводится из описания магнитной структуры. Файл config.lte описывает линак пятью секциями, первая из которых приведена ниже.
MG-LA1.QLF1: QUAD, L=0.115, K1=-10.115
MG-LA1.D250: DRIFT, L=0.250
MG-LA1.CL2: KICKER
MG-LA1.D150: DRIFT, L=0.100
MG-LA1.QLD1: QUAD, L=0.115, K1=8.67
MG-LA1.D400: DRIFT, L=0.400
BI-LA1.PK3: MONI
MG-LA1.D100: DRIFT, L=0.100
AS-LA1: LINE=(MG-LA1.QLF1, MG-LA1.D250, MG-LA1.CL2, MG-LA1.D150, MG-LA1.QLD1, MG-LA1.D400, BI-LA1.PK3, MG-LA1.D100)
Секции состоят из квадруполей, корректоров, пикапов и дрейфов; длину дрейфа задаёт параметр L, а не имя, и у MG-LA1.D150 в первой секции она равна 0,100 м. Импульс, набираемый пучком, растёт от 38 МэВ/c на первой секции до 182 МэВ/c на пятой, а ускорение обеспечивают четыре резонатора с напряжением 36 МВ и частотой 2856 МГц, записанные тем же синтаксисом. Дрейфы и линии, перечисленные в файле, каналов не порождают: канал создаётся только для элемента, тип которого найден в таблице обработчиков.
Рядом расположена таблица: для каждого типа элемента перечислены параметры, выставляемые наружу, и отмечено, какие из них доступны для записи, а какие только для чтения.
ELEMENT_HANDLERS = {
'QUAD': {
'K1': {'pv_suffix': 'K1', 'is_read_only': False, 'precision': 6, 'scale': 1.0},
'DX': {'pv_suffix': 'DX', 'is_read_only': False, 'precision': 6, 'scale': PK_MONITOR_SCALE_FACTOR},
'betax': {'pv_suffix': 'betax', 'is_read_only': True, 'precision': 6, 'scale': 1.0},
'betay': {'pv_suffix': 'betay', 'is_read_only': True, 'precision': 6, 'scale': 1.0},
...
},
'MONI': {
'Cx': {'pv_suffix': 'Cx', 'is_read_only': True, 'precision': 6, 'scale': PK_MONITOR_SCALE_FACTOR},
'Cy': {'pv_suffix': 'Cy', 'is_read_only': True, 'precision': 6, 'scale': PK_MONITOR_SCALE_FACTOR},
...
},
}
Построчный разбор для каждого распознанного элемента порождает каналы в соответствии с этой таблицей.
etype = tokens[0].upper()
if etype in ELEMENT_HANDLERS:
for param_name, field_def in ELEMENT_HANDLERS[etype].items():
pv_name = get_pv_name(name, field_def['pv_suffix'])
initial_val_ele = parse_param_value(rest, param_name)
...
pvdb[pv_name] = {'type': 'float', 'prec': field_def['precision'],
'value': initial_val_ele * scale}
element_map[pv_name] = {'name': name, 'type': etype,
'param': param_name,
'read_only': field_def['is_read_only'],
'scale': scale}
Для линака из пяти секций получается 116 каналов: семь квадруполей по восемь каналов, пять корректоров по четыре, пять пикапов по четыре, четыре резонатора по два и двенадцать каналов на начальные условия пучка. При добавлении в структуру ещё одного квадруполя восемь новых каналов появляются автоматически, без правки кода. Таким образом, таблица описывает предметную область, а программа её интерпретирует.
Граница, на которой переводятся единицы
Физика и система управления оперируют разными величинами. Внутри расчёта квадруполь описан так, как принято в физике пучков: K1 означает градиент, нормированный на жёсткость. Величиной же, задаваемой с пульта, является ток источника питания в амперах. Перевод между ними осуществляется по формуле
$$ k_1 = 0{,}2998,\frac{G\ [\text{Тл/м}]}{p\ [\text{ГэВ}/c]}, $$
а коэффициент записан в конфигурации вместе с его выводом.
ENERGY_LA1 = 38e-3 # [GeV/c]
# 6 A ~ 6.3 [T/m] & k1 = 0.2998 * G [T/m] / P [GeV/c]
QL_QUAD_SCALE_FACTOR = 1 / 6 * 6.3 * 0.2998
PK_MONITOR_SCALE_FACTOR = 1e3 # m to mm
PV_MAPPING = {
"MG-LA1.QLF1.K1": "MG-LA1:QLF1-Iadd:Set",
"BI-LA1.PK3.Cx": "BI-LA1:PK3-fastAvX:Mea",
}
SCALE_MAPPING = {
"MG-LA1.QLF1.K1": ENERGY_LA1 / QL_QUAD_SCALE_FACTOR,
}
При подстановке чисел коэффициент оказывается равным 0,1207, и значение \( K_1 = -10{,}115 \) соответствует −1,22 А. В скане, записанном на работающей машине, тот же канал держит −1,3 А, то есть двойник и оборудование расходятся на 6 %. Для пересчёта «ток — градиент», построенного по одной опорной точке 6 А ~ 6,3 Тл/м, такая точность является ожидаемой, и на этом уровне сценарии смены уже можно проверять. Для остальных секций в той же конфигурации записаны импульсы 76, 114, 152 и 190 МэВ/c, то есть с шагом 38 МэВ/c, тогда как четыре резонатора по 36 МВ дают 74, 110, 146 и 182 МэВ/c; масштабы секций со второй по пятую расходятся с импульсом структуры на 2,7–4,4 %, и одно из двух значений необходимо привести к другому.
Здесь же решается вторая задача — задача имён. По умолчанию канал называется MG-LA1:QLF1:K1, однако таблица PV_MAPPING переименовывает его в MG-LA1:QLF1-Iadd:Set, то есть так, как этот источник питания назван на пульте. Пикап, измеряющий горизонтальное положение, отвечает на имя BI-LA1:PK3-fastAvX:Mea. Именно эти имена ожидает помощник оператора из следующей главы.
Обработка одного caput
Запись в канал не сохраняет переданное значение, а пересчитывает физику, заложенную в структуру. Метод write приведён ниже в сокращении: проверка того, что канал есть в element_map, запись в журнал перед eleput и обработка исключения опущены.
def write(self, reason, value):
element_info = self.element_map[reason]
if element_info['read_only']:
logger.warning(f"Attempt to write to read-only monitor {reason}")
return False
sim_name = get_sim_name(element_info['name'], element_info['param'])
scale = element_info.get('scale', 1.0)
val_to_write = value / scale
eleput(sim_name, val_to_write)
self.setParam(reason, value)
return True
Сервер находит элемент, указанный в имени канала, проверяет право на запись и делит значение на масштаб, переводя амперы обратно в \( K_1 \). Далее функция eleput, взятая из SCAUT, записывает параметр и заново запускает Elegant, трассирующий пучок через всю структуру. Один вызов caput влечёт полный пересчёт: за ответом стоит решение уравнений движения, а не заранее заготовленная таблица. Обратная функция eleget извлекает рассчитанные величины из файлов результатов, когда клиент читает канал-монитор.
Опущенная обработка исключения существенна. Если eleput завершается ошибкой, метод write записывает её в журнал и возвращает False, то есть запись отклоняется. Чтение устроено иначе: при исключении в eleget метод read записывает ошибку в журнал и возвращает прежнее значение канала, не выставляя ни статуса, ни тревоги, и клиент получает вместо отказа устаревшее число. В EPICS для такого случая предусмотрены статус и тревога канала, которые позволяют клиенту отличить устаревшее значение от рассчитанного, и двойник, неотличимый от машины, должен их выставлять.
Проверка описанного механизма выполняется двумя командами.
# положение пучка на третьем пикапе, миллиметры
caget ACC1:BI-LA1:PK3-fastAvX:Mea
# добавка к току первого квадруполя, амперы
caput ACC1:MG-LA1:QLF1-Iadd:Set -1.3
Ферма
Подгонка двойника представляет собой задачу оптимизации с дорого вычисляемой целевой функцией. Один шаг требует десятков запусков Elegant, и тысяча испытаний, выполненных последовательно, заняла бы сутки. Распараллелить сам Elegant внутри процесса невозможно: он однопоточный и обменивается данными через файлы, размещённые в рабочем каталоге. Однако можно запустить множество его копий, по контейнеру на экземпляр, каждый со своей файловой системой и своим префиксом каналов.
Локальная сеть
┌────────────────────────────────────────────┐
│ Компьютер 1 │
│ ACC1 ACC2 ... ACC30 │◄──────┐
│ │ │
│ Компьютер 2 │ │ ┌───────────────┐
│ ACC31 ACC32 ... ACC60 │◄──────┼───│ Оркестратор │
│ │ │ │ Optuna / ГА │
│ Компьютер 3 │ │ └───────────────┘
│ ACC61 ACC62 ... ACC90 │◄──────┘
└────────────────────────────────────────────┘
Девяносто контейнеров распределены по трём компьютерам, соединённым локальной сетью. Все они запущены из одного образа с разными переменными окружения, что соответствует принципу «артефакт один, конфигурация снаружи», разобранному в главе про асинхронный веб-сервис.
accelerator-1:
image: accumulator:latest
container_name: acc-emulator-1
env_file: accumulator.env
environment:
- 'ACCUMULATOR_PREFIX=ACC1:'
ports: ['8501:8501', '5064:5064', '5065:5065/udp']
Описание из девяноста одинаковых блоков вручную не составляется. Скрипт generate_compose.py, вызванный с числом экземпляров и номером первого из них, распределяет порты с заданным шагом и записывает готовый файл для одного компьютера: python scripts/generate_compose.py --count 30 --start 31 для второго, и так далее. Веб-панель занимает порты 8501, 8502 и далее подряд, а порты Channel Access разнесены с шагом в тысячу, и отсчёт портов в каждом файле начинается заново. С --count 90 в одном файле порты Channel Access экземпляров с 62-го по 90-й вышли бы за 65535 (у девяностого 94064 и 94065), а проверки диапазона генератор не делает. Клиенту, которому необходимы все девяносто экземпляров одновременно, передаётся список адресов в переменной EPICS_CA_NAME_SERVERS: поиск канала широковещательной рассылкой заменяется прямым опросом перечисленных серверов.
Внутри каждого контейнера supervisor поддерживает два процесса, IOC и веб-панель, а образ содержит Elegant 2025.2.0 и набор утилит SDDS, установленных поверх Ubuntu 22.04. Панель, реализованная на Streamlit, читает тот же файл структуры, отображает каналы, сгруппированные по элементам, и позволяет править уставки из графического интерфейса без кода на стороне клиента.
Оркестратор распределяет испытания по свободным экземплярам через очередь.
INSTANCE_POOL = queue.Queue()
for _p in PREFIXES: # ACC1:, ACC2:, ... ACC89:
INSTANCE_POOL.put(_p)
def objective(trial: optuna.Trial) -> float:
prefix = INSTANCE_POOL.get() # ждём свободный экземпляр
try:
values = [trial.suggest_float(p, lo, hi)
for p, (lo, hi) in zip(actuator_pvs, bounds)]
apply_actuators(prefix, actuator_pvs, values, strip=REAL_PREFIX)
...
return float(np.mean(step_losses))
finally:
INSTANCE_POOL.put(prefix) # возвращаем при любом исходе
Очередь здесь передаёт не данные, а право пользоваться ресурсом. Восемьдесят девять префиксов помещаются в пул, а девяностый экземпляр остаётся нетронутым: по нему впоследствии сверяется состояние двойника до подгонки. Число параллельных заданий равно размеру пула, а перебор ограничен тысячей испытаний и тысячей секунд.
Цикл, ради которого всё затевалось
Двойник является звеном цикла, превращающего снятые измерения в уставки. Тетрадь optuna_tuner.ipynb проходит этот цикл целиком.
- Скан на реальной машине. Десять корректоров проходят заданную сетку, семнадцать каналов записываются как отклик, и результат сохраняется в JSON, снятый за 28 шагов.
- Подгонка двойника. Optuna перебирает 26 параметров, девятнадцать сдвигов и углов рассогласования и семь токов квадруполей, добиваясь совпадения отклика двойника с измеренным. Невязка вычисляется как средняя абсолютная разность, нормированная на шум пикапов, а испытание, прерванное ошибкой связи, получает штраф вместо остановки всего перебора; ошибку
elegetна стороне сервера, как сказано выше, этот штраф не обнаруживает. Заведомо неудачные варианты отсекаетMedianPruner, и на каждое испытание берётся десять шагов скана из двадцати восьми. - Коррекция на двойнике. Подогнанной модели в качестве цели задаются бета-функции номинального расчёта, четырнадцать чисел на семи квадруполях, и подбираются токи в пределах ±0,2 А от текущих.
- Перенос на оборудование. Функция
apply_to_acceleratorсначала читает текущие значения, сохраняет прочитанное в файл снимка, печатает таблицу «было, станет, разница» и только после этого, и только при явно переданномdry_run=False, записывает значения в машину. - Проверка. Новый скан подтверждает улучшение.
После второго шага двойник моделирует не «линак вообще», а конкретную машину в конкретный день, со всеми рассогласованиями, зафиксированными в скане. В этом заключается разница между моделью и цифровым двойником.
Настроенный экземпляр получает отдельный префикс ACCT:, номинальный расчёт размещён под префиксом ACCM:, а за ACC: находится настоящая машина. Бета-функции, снятые со всех трёх, сводятся в одну таблицу, в которой видна невязка как до подгонки, так и после неё.
Назначение фермы
Отладка инженерного ПО для пультовой. Программа, готовящаяся к работе в смене, прогоняется на виртуальном ускорителе. Алгоритм коррекции орбиты, разобранный в отдельной главе, проверяется от начала до конца, включая имена каналов, порядок вызовов и поведение при потерянном ответе. Ошибка, найденная на двойнике, обходится в перезапуск контейнера.
Сравнение алгоритмов для исследований. На одном и том же двойнике сопоставляются байесовская оптимизация, эволюционный перебор из главы про генетический алгоритм и обычный случайный поиск. Условия у всех одинаковые, результаты сравнимы, цена ошибки нулевая.
Обучение ML/AI-моделей. Девяносто экземпляров порождают размеченные данные в объёмах, недостижимых на живой установке: каждая пара «уставки — отклик» обходится в один прогон Elegant, а не в часть смены. Выборка, набранная на ферме, покрывает и те режимы, до которых на реальной машине очередь не доходит. На этих данных обучаются модели коррекции орбиты и помощник оператора Сава, которому посвящена следующая глава.
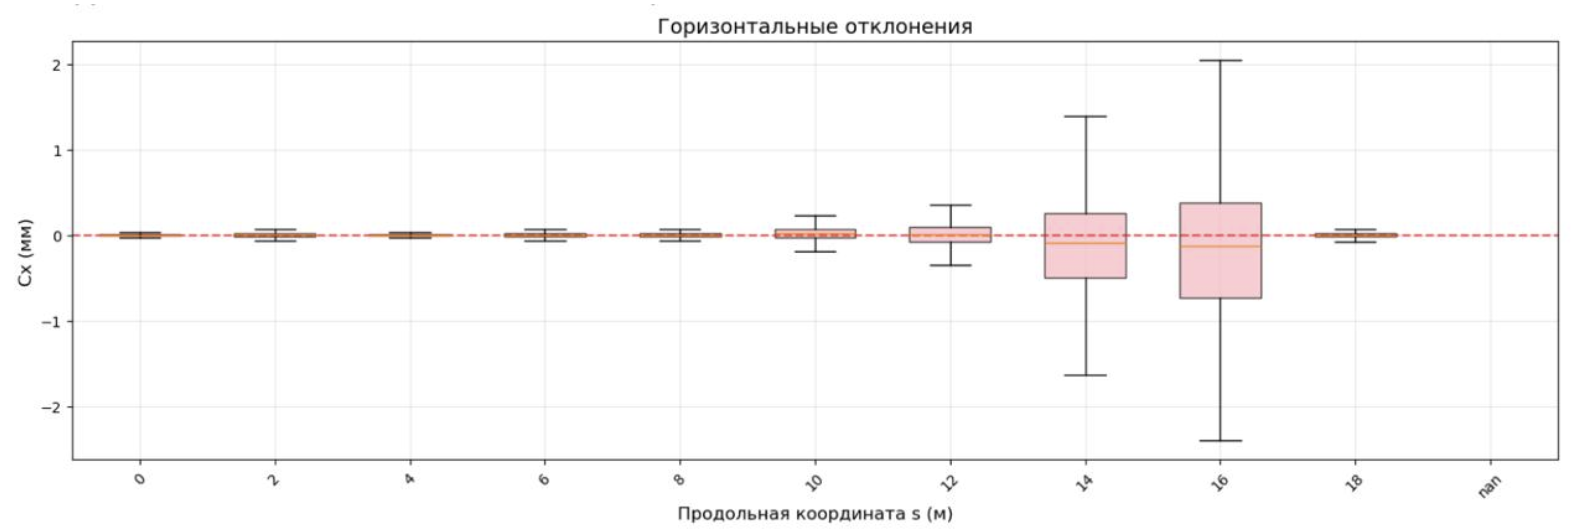
Полезные ссылки
- Accumulator, исходники двойника, разобранного в этой главе.
- SCAUT, библиотека, оркеструющая эксперименты на ускорителе.
- Elegant, код расчёта динамики пучка, положенный в основу двойника.
- EPICS, система управления, протокол которой воспроизводит двойник.
- pcaspy, библиотека, позволяющая написать сервер EPICS на Python.
- Optuna, оптимизатор, с помощью которого двойник подгоняется под машину.
Мультиагентный помощник оператора
Настоящая глава посвящена программе, установленной рядом с действующей машиной и взаимодействующей с оператором на естественном языке.
Слайды к главе. Устройство помощника SAVA, реестр инструментов и конверт записи изложены также в первой половине пятой части лекции «Разбор реальных кодов» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Задача
Оператор, заступивший на смену в пультовой, вынужден работать с тремя массивами сведений, никак между собой не связанными.
Первый массив составляют приборы. Сотни мониторов и тысячи PV-переменных названы по принятому в проекте регламенту наподобие ACC1:BI-LA1:PK3-fastAvX:Mea. Имя, собранное из участка, устройства, измеряемой величины и вида обработки, читается однозначно, однако удерживать в памяти тысячу таких имён невозможно. Для просмотра орбиты требуется знать и имена каналов, и панель, отведённую под них.
Второй массив представляет собой документацию, разбросанную по вики, чертежам, статьям и инструкциям, накопленным за годы проектирования. Ответ на вопрос «как измерить эмиттанс» где-то записан, но для его поиска необходимо вспомнить, в каком документе он находится, а документы, собранные разными коллективами за разные годы, единого оглавления не имеют.
Третий массив — журнал смены, заполняемый вручную. Запись, сделанная в конце дежурства по памяти, всегда короче происходившего, а слово «успешно» в ней остаётся мнением, никем не проверенным.
Начинающему оператору сложно, поскольку три массива сведений приходится удерживать в памяти одновременно, а опытный оператор перегружен рутинными операциями.
SAVA представляет собой разговорный интерфейс к ускорителю, связывающий эти три источника в одном окне. В отличие от остальных программ, рассмотренных в этой части книги, свидетельство о государственной регистрации на неё пока не оформлено.
Устройство системы
Оператор взаимодействует с системой из Telegram-бота, из веб-интерфейса или из терминала. Запрос поступает в роутер — сервис, запрашивающий у языковой модели, какой инструмент требуется в этом случае, и рассылающий команды агентам. Каждый агент выполняет одну задачу и владеет одним хранилищем.
Telegram / Web / CLI
│
│ запрос
▼
┌───────────┐
┌────▶│ Роутер │◀────┐
│ └─────┬─────┘ │
ответ │ │ │ ответ
опрос, │ докумен- │ │ запись
управление │ тация │ │
┌───────┴───┐ ┌────▼──────┐ ┌─┴─────────┐
│Контроллер │ │Консультант│ │ Секретарь │
│ EPICS │ │ RAG │ │ журнал │
└─────┬─────┘ └─────┬─────┘ └─────┬─────┘
│ │ │
┌─────▼─────┐ ┌─────▼─────┐ ┌─────▼─────┐
│ EPICS │ │ Vector │ │ PostgreSQL│
│GetPV/SetPV│ │ Store │ │ │
└─────┬─────┘ └───────────┘ └───────────┘
│
┌─────▼─────┐
│ Ускоритель│
└───────────┘
Ответы, возвращаемые агентами, роутер собирает и передаёт оператору одним сообщением. Агенты обмениваются сообщениями, передаваемыми через очереди Apache Kafka; сама механика очередей рассмотрена в главе про системный дизайн. Журнал смены хранится в PostgreSQL, устройство которого описано в главе про базы данных.
Работа роутера состоит из двух шагов. Сначала модель, получившая историю разговора и список инструментов, называет подходящий; затем вызовы, названные ею, преобразуются в команды, отправляемые агентам. Инструментов, видимых модели, десять, и ещё пять остаются внутренними: график, голос и сводку смены заказывает сама система, не расходуя на них решение модели. Результаты, поступающие от агентов, роутер объединяет в один ответ и отправляет туда, откуда пришёл запрос.
У системы объявлено пять специализаций.
- Консультант осуществляет поиск по документации через RAG и отвечает с указанием источника.
- Секретарь ведёт журнал смены: записывает и то, что выполнила система, и то, что продиктовал оператор.
- Контроллер опрашивает PV и выполняет базовые проверки через EPICS.
- Тренер помогает обучать новых операторов, разбирая с ними учебные ситуации.
- Исследователь помогает анализировать данные и готовить отчёты.
Состав системы объявлен один раз, в реестре. ToolSpec описывает инструмент, видимый языковой модели, а AgentSpec — сервис, исполняющий инструменты. Из реестра выводится всё остальное: схемы, передаваемые модели, маршрутизация «инструмент → агент», список очередей и цели, опрашиваемые мониторингом.
@dataclass(frozen=True)
class ToolSpec:
"""Инструмент: что видит модель и кто его исполняет."""
name: str
schema: dict | None = None # None — внутренний, модели не показывается
writes: bool = False # трогает оборудование
long_running: bool = False
min_role: Role = Role.OPERATOR
Описание инструмента в реестре, sava_lib/registry.py
Инструмент, объявленный без схемы, модели не показывается: график строит и голосом отвечает сама система, а не модель, решившая, что это уместно. Поле min_role задаёт наименьший уровень доступа: knowledge открывает только документацию, observer разрешает наблюдать и задавать вопросы, operator — работать с машиной. Научному руководителю, посетившему смену, требуется чтение, а студенту достаточно документации.
Контроллер: опрос и управление
Агент представляет собой набор функций, помеченных декоратором. Цикл опроса очереди, метрики, повторы и разбор ошибок реализованы в общем AgentRunner, и в самом агенте остаётся только полезная работа.
@runner.tool("GetPV")
def get(ctx: Ctx) -> dict:
"""Читает один PV."""
pv_name = ctx.payload.get("pv_name", "")
ctx.policy.enforce_read(pv_name)
res = get_pv(pv_name, use_monitor=bool(ctx.payload.get("use_monitor", False)))
return {"result": json.dumps(res, ensure_ascii=False)}
@runner.tool("SetPV")
def put(ctx: Ctx) -> dict:
"""Запись одного PV — только по конверту, подтверждённому оператором."""
pv_name = ctx.payload.get("pv_name", "")
value = float(ctx.payload.get("value"))
if not bool(ctx.payload.get("confirmed", False)):
raise PolicyError(f"Запись {pv_name} без подтверждения оператора.")
applied = ctx.writer.put(pv_name, value, confirmed=True)
return {"result": json.dumps({"pv_name": pv_name, "value": applied})}
Чтение и запись переменной EPICS, agents/pv-agent/main.py
Значение, передаваемое оператору, снабжено признаком достоверности: канал, не ответивший вовремя, приводит к ошибке, а не к подставленному значению по умолчанию. Наиболее частый диалог в пультовой выглядит следующим образом. Оператор называет датчики словами, модель преобразует названное в вызовы GetPV, а показания, собранные с обоих каналов, пересказываются на естественном языке.
Оператор: Опроси датчики положения пучка
BI-LA1:PK3-fastAvX:Mea, BI-LA2:PK4-fastAvX:Mea
Sava: -> GetPV("BI-LA1:PK3-fastAvX:Mea") -> 0.15 мм
-> GetPV("BI-LA2:PK4-fastAvX:Mea") -> -0.08 мм
Датчик PK3 показывает смещение 0.15 мм,
PK4: -0.08 мм. Орбита близка к опорной.
Флаг writes, объявленный в реестре, делит инструменты на два класса. Читающему инструменту достаточно проверки политики, а пишущему выдаётся конверт — описание операции, составленное до разговора с оператором и подтверждаемое им целиком, одним «да». В конверте перечислены каналы, границы, назначенные каждому из них, предельное число записей и срок действия.
@dataclass(frozen=True)
class WriteEnvelope:
"""Что операции разрешено записать, в каких границах и сколько раз."""
envelope_id: str
command_id: str
purpose: str # «матрица отклика орбиты»
bounds: tuple[WriteBound, ...]
max_writes: int
ttl_s: float = 1800.0
def check(self, pv: str, value: float) -> None:
"""Проверка одной записи."""
b = self.bound_for(pv)
if b is None:
raise PolicyError(f"{pv} не входит в состав операции «{self.purpose}».")
if value < b.lo or value > b.hi:
raise PolicyError(f"{pv}={value:g} вне границ [{b.lo:g}, {b.hi:g}].")
Конверт записи, sava_lib/write_guard.py
Подтверждается операция целиком, а не каждая запись по отдельности. Одна коррекция орбиты складывается из десятков caput, выполняемых подряд, и оператор, перегруженный вопросами, перестанет их читать уже на пятом. Текст, показываемый оператору перед пуском, называет корректоры и пикапы поимённо, а не «сейчас поправлю орбиту», и рядом с каждым параметром отмечено, взят он из значений по умолчанию или из запроса. Значение, вышедшее за объявленную границу, приводит к отказу, а не к обрезке до допустимого.
Коррекция, состоящая из чтения, расчёта и двух записей, выполняется следующим образом.
Оператор: Орбита в линаке смещена, помоги скорректировать
Sava: -> GetPV("BI-LA1:PK3-fastAvX:Mea") -> 0.15 мм
-> GetPV("BI-LA2:PK4-fastAvX:Mea") -> -0.08 мм
-> CalculateCorrection(0.15, -0.08)
-> {"MG-LA1:CL1:HKICK": 0.5, "MG-LA1:CL2:HKICK": -0.3}
-> SetPV("MG-LA1:CL1:HKICK", 0.5)
-> SetPV("MG-LA1:CL2:HKICK", -0.3)
Коррекция выполнена: MG-LA1:CL1:HKICK=0.5, MG-LA1:CL2:HKICK=-0.3.
Проверьте новые показания датчиков.
Математический аппарат, скрытый за строкой CalculateCorrection, — матрица отклика и разложение по сингулярным числам, рассмотренные в главе про коррекцию равновесной орбиты.
Консультант: поиск по документации
Корпус документации института разбит на фрагменты примерно по пятьсот токенов, снабжённые заголовком и номером страницы, и помещён в векторный индекс. Вопрос оператора проходит пять ступеней.
1. Оператор: «Как измерить эмиттанс?»
│
▼
2. Векторизация запроса
│
▼ Chunk 1: Ma Xiaochao, стр. 45
3. Поиск в Vector Store ─────────────▶ Chunk 2: EPICS Wiki
топ-3 фрагмента Chunk 3: регламент СКИФ
│
▼
4. Добавление контекста в промпт
│
▼
5. Модель отвечает с указанием источника
Третья ступень в репозитории реализована двойной. Плотностной поиск по векторам объединён со списком, найденным классическим BM25, а два порядка слиты по правилу обратного ранга: таким образом, слово, редко встречающееся в корпусе, не теряется среди фрагментов, близких по смыслу. Инструмент, объявленный в реестре, называется FileSearch.
Оператор: Как измерить эмиттанс?
Sava: -> FileSearch("Как измерить эмиттанс?")
Находит: Ma Xiaochao, стр. 45
Ответ: Для измерения эмиттанса используйте метод...
Источник: Ma Xiaochao, стр. 45
Ссылка на источник является обязательной частью ответа. Номер страницы, привязанный к фрагменту ещё при разбиении, передаётся оператору, и тот открывает названное место самостоятельно. Устройство инструментов, предоставляемых языковой модели, описано в главе «Инструментарий».
Сам корпус хранится в объектном хранилище и версионируется, а индекс, построенный по нему, кешируется там же. Подпись кеша складывается из корпуса, модели эмбеддингов и правил разбиения, так что документ, добавленный в корпус, вызывает перестроение индекса, а не незаметное расхождение. Сторож, работающий в фоне, обнаруживает обновление и перечитывает документы без перезапуска агента.
Секретарь: журнал смены
Журнал наполняется из двух источников. Первый — сама система: каждая запись, применённая к оборудованию, попадает в журнал по факту, одной строкой на подтверждённое действие. Слово «успешно» здесь является не мнением модели, а результатом выполнения caput. Второй источник — оператор, сообщающий о том, чего система не наблюдает: о действиях у стойки, о наблюдениях, о переговорах со сменой.
Оператор: Я сделал 2 раза коррекцию орбиты
в линейном ускорителе, запиши!
Sava: -> ActionRecord(
action="Коррекция орбиты",
system="Линейный ускоритель",
details="Выполнено 2 итерации",
result="Успешно")
Записал в журнал: коррекция орбиты линака.
Поле system приводится к закрытому словарю подсистем. Название, полученное от модели, само по себе непригодно: одна и та же подсистема называлась бы то «Орбита», то «Уставки машины», и группировка, собираемая по свободному тексту, нарушилась бы на первой же сотне записей. Поле с именем оператора модель не заполняет — его проставляет система поверх присланных аргументов.
Записи, накопленные в журнале, пронумерованы, и номер служит адресом. По нему разворачивается разбор одного действия: какие каналы затронуты, с каких значений на какие и сколько записей потребовалось. Отдельная сводка, собираемая при заступлении на смену, показывает действия за последние часы, отказы политики и прогоны процедур.
Настройка по шагам
Чтение, запись и проверка образуют цикл. Оператор ведёт настройку словами, а система отрабатывает шаг и показывает полученный результат.
Оператор: Проверь орбиту в линаке по x
Sava: -> GetPV("BI-LA1:PK3-fastAvX:Mea" ... "PK7-fastAvX:Mea")
Макс. отклонение PK5: 207 мкм
Оператор: Сделай коррекцию — используй первые два корректора
Sava: -> GetPV("MG-LA1:CL1:HKICK") -> 0.05
-> GetPV("MG-LA1:CL2:HKICK") -> 0.0
-> SetPV("MG-LA1:CL1:HKICK", 0.03) # было 0.05
-> SetPV("MG-LA1:CL2:HKICK", -0.02) # было 0.0
Коррекция выполнена. Рекомендую проверить результат.
Оператор: Проверь орбиту
Sava: -> GetPV("BI-LA1:PK3-fastAvX:Mea" ... "PK7-fastAvX:Mea")
Результат: макс. отклонение 77 мкм (↓ в 2.7 раза)
За три шага с обратной связью наибольшее отклонение орбиты, 207 мкм на пикапе PK5, уменьшилось до 77 мкм — в 2.7 раза. Прежние уставки корректоров указаны в комментариях: оператор видит, откуда и куда произведён сдвиг, и может вернуть исходное значение. Такие прогоны выполняются на цифровом двойнике. Двойник работает по тому же протоколу Channel Access и с теми же именами каналов, поэтому помощник не отличает его от установки, а цена ошибки при обучении оказывается нулевой. На нём же отрабатывается специализация тренера.
Пока коррекция, запущенная оператором, изменяет уставки корректоров, машина занята. Блокировка, объявленная у агента в реестре, заставляет остальных отвечать «оборудование занято», а не передавать показания, снятые посреди чужой процедуры. Длительная операция отправляет прогресс, и шлюз редактирует одно уже отправленное сообщение, не заполняя чат лентой статусов. Прогон, прерванный на середине, остаётся в таблице открытым, и заступающая смена видит его в сводке отдельной строкой.
Инициатива со стороны системы
Разговор начинает не только человек. Сторож, приставленный к списку каналов, следит за порогами и отправляет оператору сообщение, минуя языковую модель: факт, доставляемый в обход неё, доходит и при недоступном провайдере. Объяснение, составленное моделью, приходит вторым сообщением, и его потеря не является критичной.
Рядом со сторожем работает детектор, обнаруживающий уход внутри порогов — выброс, медленный дрейф или застывшее значение в живом канале. Аномалии, объединённые в инцидент, передаются аналитику, который собирает свидетельства с шины и предлагает гипотезу. Предложение, если оно касается машины, преобразуется в обычное подтверждение, снабжённое числами.
Доступ к системе
Интерфейсов три.
- Telegram-бот — доступ с любого устройства и в любое время. Текст, фото и голос на входе, текст, графики и голос на выходе; кнопки подтверждения расположены здесь же.
- Веб-интерфейс — расширенные возможности: длинные диалоги, графики, встроенные непосредственно в ленту, микрофон.
- CLI — встраивание в скрипты и автоматизацию.
Транспортное ядро у всех трёх общее, поэтому разговор, начатый в боте, продолжается в вебе с того же места. Вход в веб и в терминал осуществляется по одноразовому коду, выданному ботом, и имя оператора в журнале берётся из этого кода, а не из заполненной формы.
Полезные ссылки
- Apache Kafka, шина сообщений, связывающая агентов.
- LangGraph, библиотека, строящая граф рассуждений модели.
- EPICS, система управления, в которую в конечном счёте поступает запись.
- faiss, поиск ближайших соседей, на котором основана векторная часть RAG.
- Глава про цифровой двойник — установка, на которой всё это отработано, а глава про автономного исследователя — соседний случай, в котором языковая модель работает без человека.
Автономный исследователь на языковых моделях
В отличие от помощника оператора, ожидающего подтверждения на каждую запись в оборудование, система, рассматриваемая в настоящей главе, работает без человека в контуре: она самостоятельно выбирает задачу, самостоятельно ставит эксперимент и самостоятельно пишет статью по полученным результатам.
Слайды к главе. Цикл автономного исследователя, шаблон для коррекции орбиты и проверка артефактов прогона по сохранённым данным изложены также во второй половине пятой части лекции «Разбор реальных кодов» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Назначение системы
Автономный исследователь состоит из большой языковой модели и обвязки, выполняющей полный цикл научной работы. Он находит задачу, разрабатывает методику, ставит эксперимент, анализирует полученные числа и оформляет статью. Специализация узкая, ускорительная: коррекция орбиты пучка, управление магнитными элементами, оптимизация параметров, анализ данных измерений.
Основой служит открытая система AI Scientist, описанная в работе Lu et al. (2024) [46] и адаптированная здесь к ускорителям. Адаптация свелась к одному новому шаблону, размещённому рядом с готовыми шаблонами про языковые модели, диффузию и гроккинг. Шаблон, добавленный в форк, содержит постановку задачи, рабочий код, затравочные идеи и каркас статьи. Ничего специфически ускорительного в самой обвязке нет: вся физика сосредоточена в шаблоне, подключаемом по имени каталога.
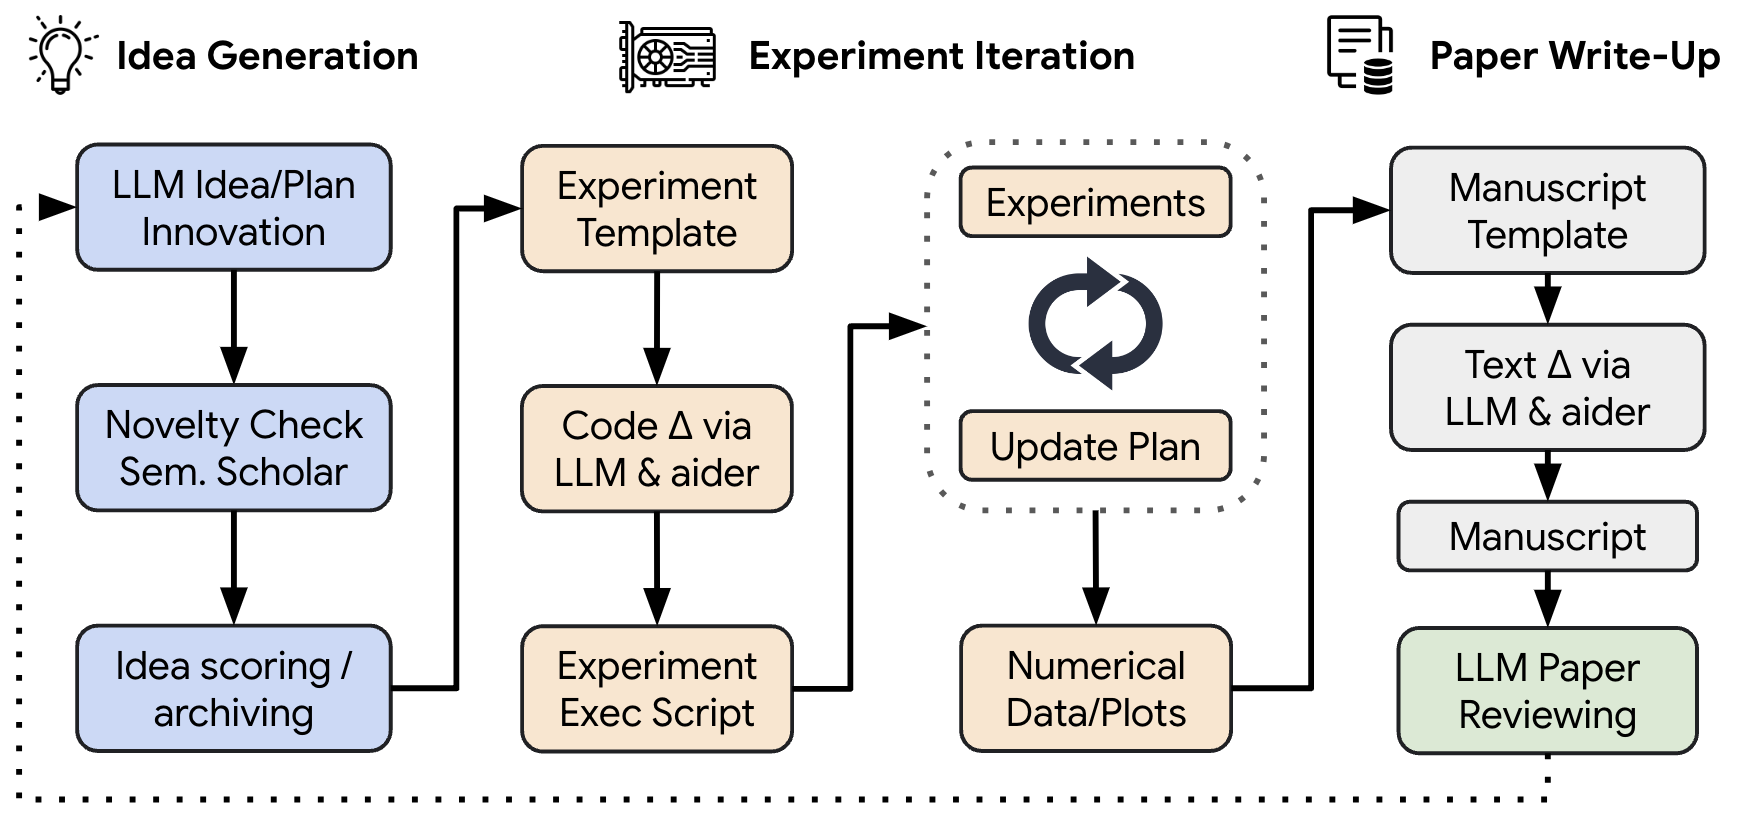
Схема делит работу на три стадии. На первой модель формулирует идею, проверяет её на новизну поиском по литературе и помещает в архив с оценками. На второй идея превращается в код: правки в experiment.py вносит aider, редактор, управляемый моделью, а обвязка запускает переписанный код и возвращает модели напечатанные числа. Третья стадия собирает статью из каркаса LaTeX, после чего отдельный проход рецензирует написанное. Пунктирная стрелка, замыкающая схему, возвращает накопленные идеи в начало, так что следующая идея формулируется с учётом уже проверенных.
Каждая идея, взятая из архива, отрабатывается в отдельном каталоге, куда копируется весь шаблон целиком. Ни один прогон не изменяет исходный каталог, и любой результат, полученный системой, остаётся воспроизводимым: рядом с числами сохраняются и код, приведший к ним, и полная переписка с моделью, записанная построчно.
Постановка задачи
Всё, что системе известно о предметной области, взято из файла prompt.json. Роль и цель, поставленные перед моделью, заданы в нём первыми двумя полями.
System: You are an AI scientist specializing in accelerator physics and
beam dynamics with expertise in machine learning applications for particle
accelerator control systems. Your knowledge spans MAD-X simulations, beam
position monitoring (BPM) systems, and both traditional (SVD-based) and
AI-driven orbit correction methods.
Task: Minimize orbit deviations in the accelerator by optimizing corrector
magnet settings using a combination of numerical optimization and machine
learning techniques.
В том же файле перечислены требования, ограничивающие решение, и среда, в которой рассчитывается орбита.
"technical_requirements": [
"Process beam position data from 16 BPMs (x/y coordinates)",
"Account for hidden misalignment parameters affecting magnetic elements",
"Maintain magnet currents within ±7A operational limits",
"Achieve orbit residuals below 1e-4 m at all BPMs"
],
"simulation_environment": {
"tool": "MAD-X",
"configurations": [
"vepp5_full.seq lattice",
"0.4 GeV electron beam energy",
"Error definitions: ealign with tgauss-distributed displacements"
]
}
Это задача, разобранная в главе про коррекцию равновесной орбиты: 16 датчиков положения, дающих по две координаты, предел корректора \(\pm 7\) А, модель накопителя ВЭПП-5. Разница заключается в том, что ставится она не человеку, а программе.
Смещения магнитных элементов, названные в требованиях «hidden», разыгрываются внутри модели и решателю не сообщаются, поэтому судить о них можно только по орбите, измеряемой в мониторах. Порог в \(10^{-4}\) м записан там же, и по нему система оценивает как свои прогоны, так и базу, рассчитанную заранее.
Сам шаблон представляет собой обычный каталог, размещённый среди прочих.
templates/closed_orbit_correction/
├── prompt.json постановка задачи и системная роль
├── seed_ideas.json пять затравочных идей
├── experiment.py расчёт орбиты и коррекция по SVD
├── plot.py графики по собранным результатам
├── vepp5_full.seq оптика ВЭПП-5, читаемая MAD-X
└── latex/ каркас статьи
Прогон запускается командой python launch_scientist.py --experiment closed_orbit_correction, после чего участие человека не требуется до самого конца. Каталог результатов, названный по метке времени и имени идеи, создаётся в начале работы.
Точка отсчёта
Вместе с постановкой модели выдаётся работающий код, служащий одновременно образцом и базой сравнения. Ускоритель инициализируется через cpymad, пучок электронов задан с энергией 0.43 ГэВ, в постановке округлённой до 0,4 ГэВ, а ошибки расстановки квадруполей разыгрываются директивой ealign с гауссовым распределением, усечённым на двух с половиной сигмах. Орбита снимается в шестнадцати мониторах, отобранных по классу monitor. Коррекция выполнена классически, через псевдообратную матрицу отклика с отсечением малых сингулярных чисел.
def correct_orbit(self):
elem_val_limit = 7
svd_cutoff = 1e-3
target_orbit = np.zeros(2 * self.num_bpms)
matrix = self.calculcate_resp_mat()
inv_mat = np.linalg.pinv(matrix, rcond=svd_cutoff)
madx = self.start_madx()
x, y = self._get_orbit(madx)
current_orbit = np.concatenate((x, y))
tmp_elem_val = -inv_mat.dot(current_orbit - target_orbit)
tmp_elem_val = np.clip(tmp_elem_val, -elem_val_limit, elem_val_limit)
elems_deltas = dict(zip(self.globals.keys(), tmp_elem_val))
self.change_elements(elems_deltas)
x, y = self._get_orbit(madx)
self.stop_madx(madx)
return x, y, elems_deltas
Матрица отклика здесь не берётся из модели, а измеряется: каждый корректор смещается на шаг вверх и вниз, а разность откликов, снятых в мониторах, делится на этот шаг. Так же поступают и на реальной машине. Ограничение np.clip по \(\pm 7\) А расположено внутри алгоритма, до подачи токов, а не в проверке, добавленной после него. Опечатка в имени calculcate_resp_mat оставлена без изменений, поскольку на неё опирается код, написанный системой позже.
Этот файл модель видит целиком, вместе с постановкой. Идеи, предложенные далее, сформулированы в терминах уже написанных методов: «доработать correct_orbit», «добавить в calculcate_resp_mat выбор подмножества корректоров».
Затравочные и новые идеи
Пять затравочных идей содержатся в seed_ideas.json, и модель дополняет их новыми, читая постановку и код. В запрос включается весь архив, накопленный к этому моменту, чтобы новая идея не повторяла предыдущие. Каждая идея описана коротким планом эксперимента и снабжена тремя оценками от одного до десяти: интересность, выполнимость и новизна. Оценки новых идей выставляет сама модель, следуя указанию, включённому в запрос: быть осторожной и реалистичной; затравочные идеи приходят с оценками, записанными автором шаблона.
Сформулированное проходит через три раунда правки, в которых модель перечитывает и улучшает собственный ответ, а когда улучшать нечего, ответ помечается словами I am done. Затем идея проходит проверку на новизну: модель формулирует поисковые запросы, получает по десять статей с аннотациями из Semantic Scholar или OpenAlex и выносит вердикт строкой Decision made: novel. На решение отведено десять раундов, однако обычно достаточно двух-трёх. Идеи, признанные несамостоятельными, до эксперимента не допускаются.
Ниже приведены затравочная идея, взятая в работу, и две идеи по коррекции орбиты, предложенные системой.
| Идея | Int./Feas./Nov. |
|---|---|
| Hybrid SVD-Neural Network Correction Framework (затравочная; описание эксперимента дополнено перед запуском). Каскад: грубая коррекция по SVD, затем нейросеть, обученная на остатках. Сравнить чистые NN и SVD с гибридом. До 100 000 особей и до 10 итераций | 9 / 7 / 8 |
| Genetic Algorithm for Optimizing Orbit Correction. Генетический алгоритм с отбором, скрещиванием и мутацией для настройки корректоров. Сравнить норму \(L_2\) и время счёта с SVD и NN | 9 / 8 / 9 |
| Predictive Control Using LSTM-Based Forecasting. Предсказание положения пучка по истории BPM и упреждающая подстройка корректоров до появления отклонения | 9 / 6 / 9 |
В работу была принята первая из них.
Эксперимент
Идею принимает цикл, отмеряющий системе лимит попыток. Прогонов по умолчанию не более пяти, неудачных заходов подряд не более четырёх, и работа, не завершённая в отведённых рамках, прерывается.
Для гибридной коррекции лимит был увеличен: прогоны отличаются только числом итераций сети, и пяти для такой развёртки недостаточно; рисунок ниже собран из одиннадцати прогонов, от нулевой итерации до десятой.
MAX_ITERS, MAX_RUNS = 4, 10
def perform_experiments(idea, folder_name, coder, baseline_results) -> bool:
current_iter, run = 0, 1
next_prompt = coder_prompt.format(
title=idea["Title"], idea=idea["Experiment"],
max_runs=MAX_RUNS, baseline_results=baseline_results,
)
while run < MAX_RUNS + 1:
if current_iter >= MAX_ITERS:
break
coder_out = coder.run(next_prompt)
if "ALL_COMPLETED" in coder_out:
break
return_code, next_prompt = run_experiment(folder_name, run)
if return_code == 0:
run += 1
current_iter = 0
current_iter += 1
Каждый прогон запускается как python experiment.py --out_dir=run_i, и модель получает обратно либо рассчитанные средние из final_info.json, либо последние полторы тысячи знаков stderr. Завершившийся с ошибкой прогон не прерывает работу, а возвращается модели текстом ошибки, по которому она исправляет код. Каталог неудачного захода при этом удаляется, чтобы незавершённые результаты не попали в статью. Результаты, признанные пригодными, дописываются в notes.txt вместе с описанием прогона, и оттуда их впоследствии берёт стадия написания статьи. Код, исполняемый на этом шаге, написан языковой моделью, поэтому авторы системы рекомендуют изолировать прогон в контейнере, и Dockerfile для этого включён в репозиторий.
По окончании расчёта той же модели поручается переписать plot.py и перечислить в нём прогоны, заслуживающие графика. Заголовки, подписи осей и легенда выбираются на этом шаге, а подробное описание каждого графика заносится в те же заметки.
Код гибридной коррекции система написала самостоятельно по описанию, в котором обучение на остатках после SVD и итеративная коррекция были заданы явно. Сеть в нём обучается не отображению «орбита — токи» целиком, а поправке к решению, найденному через SVD, и эта поправка накапливается по итерациям.
def hybrid_correct_orbit(self, model=None, iterations=0, svd=True):
elem_val_limit = self.corr_limit
x_new, y_new, elems_deltas = self.correct_orbit() # грубая коррекция
R = np.concatenate((x_new, y_new))
if model is None:
return x_new, y_new, elems_deltas
dI_nn_total = np.zeros(len(self.globals)) + list(elems_deltas.values())
for it in range(iterations):
dI_nn = model.predict(R.reshape(1, -1))[0] # поправка по остатку
dI_nn_total += dI_nn
dI_nn_total = np.clip(dI_nn_total, -elem_val_limit, elem_val_limit)
self.change_elements(dict(zip(self.globals.keys(), dI_nn_total)))
madx = self.start_madx()
x_new, y_new = self._get_orbit(madx)
self.stop_madx(madx)
R = np.concatenate((x_new, y_new))
return x_new, y_new, elems_deltas
Обучающая выборка набиралась отдельным прогоном: 100 000 расстроек девяти картин смещений в случайных масштабах, для каждой из которых снят остаток после SVD и рассчитана идеальная добавка по номинальной матрице отклика, измеренной без расстроек. Сеть выбрана простая, MLPRegressor с двумя скрытыми слоями 64 и 32, а обученная модель сохранена в nn_model.joblib и далее только читается. Прогоны с первого по десятый отличаются одним числом — количеством итераций сети, извлечённым из имени каталога.
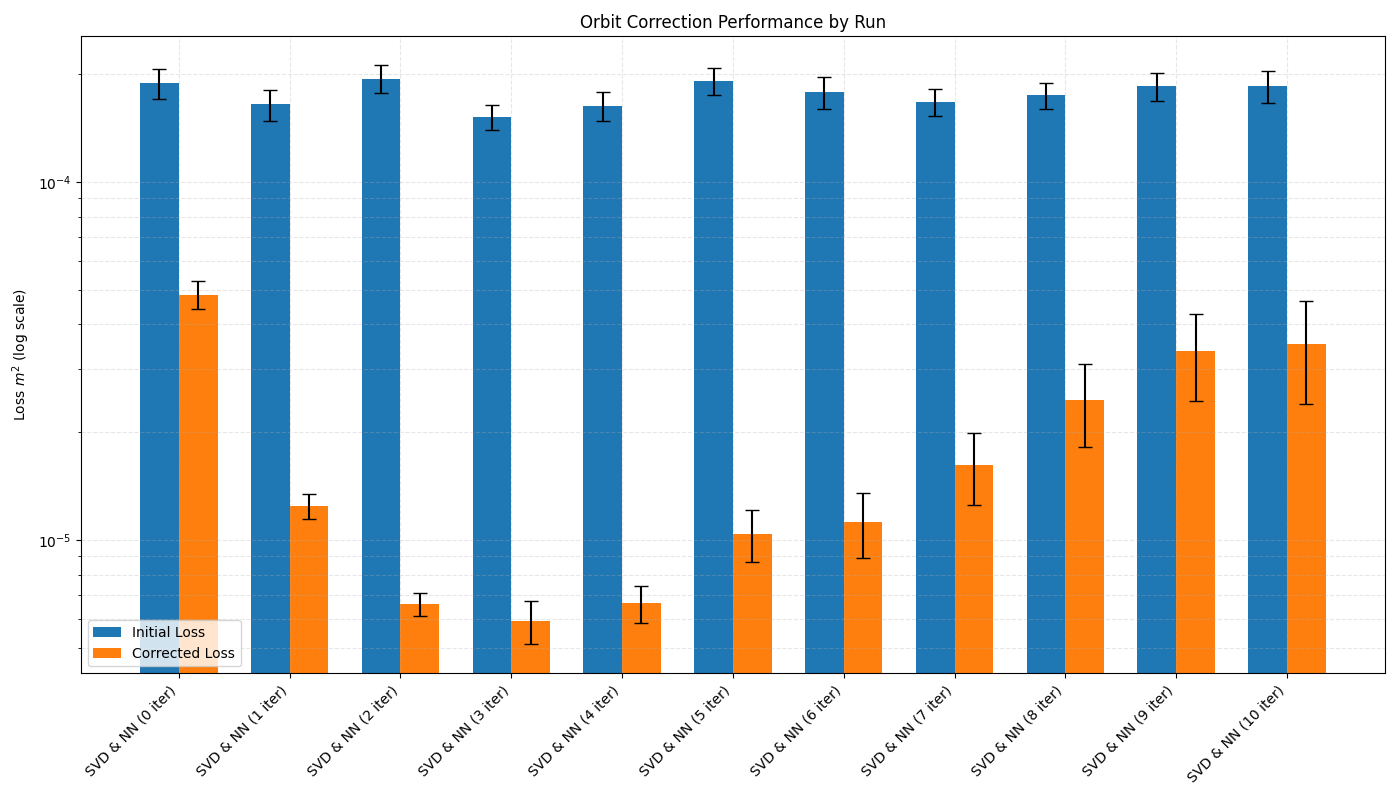
На рисунке приведены одиннадцать пар столбцов, по паре на прогон, шкала логарифмическая. Синий столбец — начальная невязка \(\sum (x_i^2 + y_i^2)\) в м², оранжевый — остаточная, а планки погрешностей, построенные по стандартной ошибке среднего, показывают разброс. В каждом прогоне сто расстроек, но различных значений seed у них девять, те же, что в обучающей выборке: расстройки повторяют девять картин смещений в разных масштабах, а начальная невязка меняется от прогона к прогону от \(1.5 \cdot 10^{-4}\) до \(1.9 \cdot 10^{-4}\) м², поэтому оранжевые столбцы сравнимы между собой лишь приближённо. Нулевая итерация, рассчитанная без сети, соответствует чистому SVD: \(1.9 \cdot 10^{-4}\) м² до коррекции и \(4.8 \cdot 10^{-5}\) после. Три итерации сети дают \(5.9 \cdot 10^{-6}\), что является лучшей точкой на графике. К десятой итерации остаток возвращается к \(3.5 \cdot 10^{-5}\).
Статья и рецензия
Написанием статьи занимается тот же aider, но с другим набором файлов, открытых для правки: код эксперимента, заметки и latex/template.tex. Ссылки, вставляемые в текст, система находит самостоятельно тем же поиском по литературе. Готовый PDF собирается pdflatex, а chktex проверяет разметку. Ошибки сборки, найденные этими программами, возвращаются модели тем же способом, что и ошибки расчёта. Журнал aider позволяет установить и стоимость обеих стадий: эксперимент обошёлся в 0,11 доллара, написание статьи — в 0,85 доллара.
Последним включается рецензент. Статья, преобразованная обратно в простой текст, подаётся модели с формой отзыва в стиле NeurIPS, в которой необходимо выставить оценки за оригинальность, качество, ясность и значимость, дать общую оценку от одного до десяти и вынести решение Accept или Reject. Собирается пять отзывов, которые сводятся мета-рецензентом; температура установлена равной 0.1. Статья про гибридную коррекцию, оценённая собственным рецензентом на 3 из 10, была им же отклонена.
Ограничения и перспективы
Ниже перечислены ограничения, признанные за системой.
- Отсутствие работы с изображениями. Модель читает только числа и текст, а построенные графики не анализирует.
- Неверная реализация идей. Написанный код нередко не соответствует тому, что задумано в описании эксперимента.
- Ошибки в численном анализе. Величины, сравниваемые между собой, модель путает, а выводы по таблицам даются ей плохо.
- Ограниченная физическая интерпретация. Система работает с формой задачи, а не с её содержанием.
Направления, названные для дальнейшей работы: мультимодальные модели, способные читать графики; специализированные модули под предметную область; интеграция с реальными установками; развитие самих языковых моделей, лежащих в основе.
Полезные ссылки
- AI Scientist, исходная система, и статья Lu et al. (2024), arXiv:2408.06292.
- AI Scientist v2, следующая версия, заменившая шаблоны поиском по дереву экспериментов.
- Форк с шаблоном по коррекции орбиты, откуда взяты листинги этой главы.
- MAD-X и cpymad, на которых рассчитывается оптика ВЭПП-5.
- aider, редактор, вносящий правки в код по указаниям модели.
- Глава про коррекцию равновесной орбиты разбирает ту же задачу вручную, а глава про нейронные сети — устройство
MLPRegressor.
Асинхронное API для кинотеатра
Задача каталога фильмов совпадает с задачей электронного журнала эксперимента, портала выдачи данных или системы управления установкой: по идентификатору получить запись, обратившись сначала к кешу, а затем к хранилищу, и отдать её по HTTP, не заставляя при этом ждать остальных клиентов. При замене существительных, когда вместо фильма подставляется выстрел, а вместо жанра тип детектора, получается сервис, отдающий данные, снятые в эксперименте.
Предметная область, посторонняя физике, выбрана намеренно: когда в примере присутствует пучок, внимание сосредотачивается на пучке, а устройство программы остаётся незамеченным. Здесь же рассматривается именно архитектура: слои, асинхронный ввод-вывод, кеш и работа с подключёнными хранилищами. Та же архитектура лежит в основе главы про цифрового двойника, где наружу выставляются каналы EPICS, и главы про помощника оператора, где сервисы взаимодействуют через очереди.
Данные хранятся в полнотекстовом поисковом движке Elasticsearch, а часто запрашиваемые ответы кешируются в Redis, чтобы не обращаться к поиску повторно. Всё взаимодействие с внешними хранилищами асинхронное, и пока один запрос ожидает ответа от базы, сервис обслуживает десятки других, поступивших в ту же секунду. Механика async/await была разобрана в главе про асинхронность.
Структура проекта
Проект разделён на слои. Каждый каталог, названный по отведённой ему роли, отвечает за одну задачу.
project/
├── Dockerfile
├── requirements.txt
├── src/
│ ├── main.py
│ ├── api/
│ │ └── v1/
│ │ └── film.py
│ ├── core/
│ │ ├── config.py
│ │ └── logger.py
│ ├── db/
│ │ ├── elastic.py
│ │ └── redis.py
│ ├── models/
│ │ └── film.py
│ └── services/
│ └── film.py
Такое разделение называется слоистой архитектурой: api знает про services, services — про db и models, но не наоборот. Благодаря этому источник данных заменяется без изменения ни одного обработчика HTTP-запросов: при переходе с Elasticsearch на PostgreSQL правятся слой db и один метод сервиса, _get_film_from_elastic, а api и models остаются прежними. Чтобы изменения затрагивали только db, хранилище скрывается за интерфейсом-репозиторием с методом get_by_id, который сервис получает через Depends. Тогда сервис зависит уже не от хранилища, а от интерфейса, реализация которого из db подставляется извне: зависимости направлены к предметной области, и так устроены луковичная и чистая архитектура [13].
Основные зависимости
aioredis==1.3.1
elasticsearch[async]==7.9.1
fastapi==0.61.1
orjson==3.4.1
uvicorn==0.12.2
uvloop==0.14.0
Ядром служит FastAPI, асинхронный веб-фреймворк, самостоятельно генерирующий документацию к API из аннотаций типов. Запускается он сервером uvicorn, uvloop представляет собой быструю замену стандартного цикла событий, а orjson служит сериализатором JSON, в несколько раз превосходящим стандартный по скорости. Клиенты к Redis и Elasticsearch взяты в асинхронных версиях, поскольку обычные, блокирующие, остановили бы весь цикл событий на всё время выполнения запроса к базе.
Этот список зафиксирован осенью 2020 года, и с тех пор половина перечисленных имён сменилась. aioredis заброшен, а его наследник перенесён внутрь основного клиента, и сегодня пул создаётся через redis.asyncio, где Redis.from_url заменяет create_redis_pool, а срок жизни ключа задаётся аргументом ex= вместо expire=. Обработчики @app.on_event('startup') и @app.on_event('shutdown') в FastAPI помечены устаревшими, и вместо пары обработчиков пишется один менеджер контекста lifespan, передаваемый конструктору приложения. У современного клиента Elasticsearch аргументы get стали именованными, так что вызов выглядит как await es.get(index='movies', id=film_id). В pydantic 2 не осталось ни Config.json_loads/json_dumps, ни parse_raw с .json(): их место заняли model_validate_json и model_dump_json, а подмену сериализатора на orjson берёт на себя ORJSONResponse, передаваемый FastAPI как класс ответа. Разбор слоёв от этого не устаревает; переписывание имён вызовов на современные является упражнением на полчаса.
Конфигурация
core/config.py:
import os
from logging import config as logging_config
from core.logger import LOGGING
logging_config.dictConfig(LOGGING)
PROJECT_NAME = os.getenv('PROJECT_NAME', 'movies')
REDIS_HOST = os.getenv('REDIS_HOST', '127.0.0.1')
REDIS_PORT = int(os.getenv('REDIS_PORT', 6379))
ELASTIC_HOST = os.getenv('ELASTIC_HOST', '127.0.0.1')
ELASTIC_PORT = int(os.getenv('ELASTIC_PORT', 9200))
BASE_DIR = os.path.dirname(os.path.dirname(os.path.abspath(__file__)))
Все настройки читаются из переменных окружения со значениями по умолчанию, подобранными для локальной разработки. Это 12-факторный подход, при котором один и тот же собранный образ приложения работает и на ноутбуке, и в продакшене, а меняются только переменные окружения.
База данных
db/elastic.py:
from typing import Optional
from elasticsearch import AsyncElasticsearch
es: Optional[AsyncElasticsearch] = None
async def get_elastic() -> AsyncElasticsearch:
return es
db/redis.py:
from typing import Optional
from aioredis import Redis
redis: Optional[Redis] = None
async def get_redis() -> Redis:
return redis
Здесь создаются глобальные соединения с хранилищами. Модуль хранит объект клиента, а функции get_elastic()/get_redis() его возвращают; впоследствии эти функции подставляет механизм зависимостей FastAPI, разрешающий их на каждый запрос. Пока приложение не запущено, оба клиента равны None, поэтому тип помечен как Optional.
Основное приложение
main.py:
import logging
import aioredis
import uvicorn
from elasticsearch import AsyncElasticsearch
from fastapi import FastAPI
from fastapi.responses import ORJSONResponse
from api.v1 import film
from core import config
from core.logger import LOGGING
from db import elastic, redis
app = FastAPI(
title=config.PROJECT_NAME,
docs_url='/api/openapi',
openapi_url='/api/openapi.json',
default_response_class=ORJSONResponse,
)
@app.on_event('startup')
async def startup():
redis.redis = await aioredis.create_redis_pool(
(config.REDIS_HOST, config.REDIS_PORT),
minsize=10,
maxsize=20
)
elastic.es = AsyncElasticsearch(
hosts=[f'{config.ELASTIC_HOST}:{config.ELASTIC_PORT}']
)
@app.on_event('shutdown')
async def shutdown():
redis.redis.close()
await redis.redis.wait_closed()
await elastic.es.close()
app.include_router(film.router, prefix='/api/v1/film', tags=['film'])
if __name__ == '__main__':
uvicorn.run('main:app', host='0.0.0.0', port=8000)
Это точка входа. Соединения с базами, созданные в обработчике события startup, закрываются в парном обработчике shutdown: открывать их на каждый запрос было бы расточительно, поэтому используется пул соединений (minsize=10, maxsize=20). Обработчики запросов подключаются роутером с префиксом /api/v1/, а версия, включённая в URL, позволит впоследствии выпустить v2, не нарушая работу уже написанных клиентов.
API слой
api/v1/film.py:
from http import HTTPStatus
from fastapi import APIRouter, Depends, HTTPException
from pydantic import BaseModel
from services.film import FilmService, get_film_service
router = APIRouter()
class Film(BaseModel):
id: str
title: str
@router.get('/{film_id}', response_model=Film)
async def film_details(
film_id: str,
film_service: FilmService = Depends(get_film_service)
) -> Film:
film = await film_service.get_by_id(film_id)
if not film:
raise HTTPException(
status_code=HTTPStatus.NOT_FOUND,
detail='film not found'
)
return Film(id=film.id, title=film.title)
Слой HTTP является тонким: он принимает запрос, вызывает сервис и возвращает ответ или ошибку 404. Бизнес-логика в нём отсутствует.
Строка Depends(get_film_service) осуществляет внедрение зависимостей. FastAPI самостоятельно вызывает get_film_service, а тот получает клиентов Redis и Elasticsearch, созданных при старте. Обработчику не требуется знать, откуда берутся соединения, а в тестах их легко подменить заглушками. Класс Film(BaseModel) описывает формат ответа, а pydantic проверяет типы и добавляет схему в автодокументацию, опубликованную по адресу /api/openapi.
Сервисный слой
services/film.py:
from functools import lru_cache
from typing import Optional
from aioredis import Redis
from elasticsearch import AsyncElasticsearch, NotFoundError
from fastapi import Depends
from db.elastic import get_elastic
from db.redis import get_redis
from models.film import Film
class FilmService:
def __init__(self, redis: Redis, elastic: AsyncElasticsearch):
self.redis = redis
self.elastic = elastic
async def get_by_id(self, film_id: str) -> Optional[Film]:
film = await self._film_from_cache(film_id)
if not film:
film = await self._get_film_from_elastic(film_id)
if not film:
return None
await self._put_film_to_cache(film)
return film
async def _get_film_from_elastic(self, film_id: str) -> Optional[Film]:
try:
doc = await self.elastic.get('movies', film_id)
except NotFoundError:
return None
return Film(**doc['_source'])
async def _film_from_cache(self, film_id: str) -> Optional[Film]:
data = await self.redis.get(film_id)
if not data:
return None
film = Film.parse_raw(data)
return film
async def _put_film_to_cache(self, film: Film):
await self.redis.set(film.id, film.json(), expire=60 * 5)
@lru_cache()
def get_film_service(
redis: Redis = Depends(get_redis),
elastic: AsyncElasticsearch = Depends(get_elastic),
) -> FilmService:
return FilmService(redis, elastic)
В этом слое сосредоточена вся логика. Метод get_by_id реализует шаблон cache-aside: сначала выполняется обращение к кешу, при промахе — к основному хранилищу, после чего найденный результат помещается в кеш на будущее (здесь на 5 минут, expire=60 * 5). Приватные методы с подчёркиванием разделяют три операции: получение из Elasticsearch, получение из кеша и запись в кеш.
Декоратор @lru_cache(), применённый к фабрике сервиса, гарантирует, что объект FilmService создаётся один раз, а не на каждый HTTP-запрос.
Модели
models/film.py:
import orjson
from pydantic import BaseModel
def orjson_dumps(v, *, default):
return orjson.dumps(v, default=default).decode()
class Film(BaseModel):
id: str
title: str
description: str
class Config:
json_loads = orjson.loads
json_dumps = orjson_dumps
Модель является единственным описанием фильма, на которое опираются все слои. Pydantic разбирает по ней ответ, полученный от Elasticsearch, и он же сериализует разобранный объект в кеш и обратно. Класс Config подменяет стандартный модуль json на более быстрый orjson, поскольку на кешируемых ответах сериализация является далеко не самой дешёвой частью запроса.
Моделей здесь две: models.Film с полным набором полей и Film из слоя API всего с двумя. Это не дублирование: первая описывает содержимое хранилища, вторая — контракт, обещанный наружу. Добавление поля в хранилище не нарушает контракт, обещанный клиентам.
Приёмы, заслуживающие заимствования
В примере собраны решения, окупающиеся в любом сервисе, в том числе написанном для собственной установки.
- разделение на слои, при котором API, логика и доступ к данным существуют отдельно и заменяются независимо;
- внедрение зависимостей, когда код не создаёт необходимые соединения сам, а получает их извне, что одновременно делает его тестируемым;
- конфигурация через переменные окружения, не оставляющая в исходниках ни одного адреса или пароля;
- кеширование, самый дешёвый способ ускорить сервис, если данные меняются редко, а запрашиваются часто;
- версионирование API, при котором
/api/v1/появляется с первого дня, чтобы впоследствии не нарушать работу существующих клиентов; - асинхронность, дающая при работе с сетью и базами выигрыш практически без дополнительных затрат.
Запуск осуществляется в контейнерах, где Dockerfile для приложения соседствует с образами Redis и Elasticsearch, связанными через Docker Compose. Устройство такой сборки было разобрано в главе про Docker.
Структура заданий
Теория без практики бесполезна, и далее приведены задания. Каждое из них опирается на свои главы, поэтому выполнять их лучше по мере чтения, а не все разом в конце. Таблица ниже показывает, какие главы необходимы для какого задания.
Почти у каждого задания есть репозиторий, в котором размещена его формулировка и в который удобно сдавать решение форком, как это устроено в главе про Git. Заготовка есть не везде. В задании на ревью размещён код, который предстоит разбирать; в «Деплое стартапа» код разнесён по веткам front_code и my_backend, и свести их вместе означает выполнить первую часть работы. Остальным заданиям заготовка не требуется, поскольку в них настраивается собственное окружение, обрабатываются собственные данные или решаются задачи на внешнем сайте.
Раздел «Требования к сдаче» у каждого задания представляет собой перечень того, без чего работа не принимается.
| Задание | Опирается на главы | Репозиторий |
|---|---|---|
| Ревью чужого кода | Требования к коду, Жизненный цикл ПО | phys-dev/review-code-task |
| Генерация текста | Технические основы, Коллекции | phys-dev/markov-chain-task |
| Установка Arch Linux вручную с RAID1 и UEFI | Процесс загрузки, Файловые системы, Установка Arch Linux | phys-dev/booting-linux-task |
| Окружение и утилиты | Инструменты Linux, Внутреннее устройство Linux | phys-dev/linux-tools-task |
| Долгоиграющие процессы | Внутреннее устройство Linux | phys-dev/linux-structure-task |
| Задачи на Python | Введение в алгоритмы, Сложность операций с коллекциями | phys-dev/python-algo-task |
| Деплой стартапа | От скрипта к приложению, Docker, Компьютерные сети, Веб-технологии, Базы данных, Работа с базами данных, Системный дизайн | phys-dev/kitty-startup-task |
| Итоговый проект | вся книга | свой репозиторий |
Адрес репозитория складывается из https://github.com/ и имени из таблицы.
Все задания, кроме итогового проекта, проверяются по формальным критериям, и решение у них в общих чертах предопределено. В итоговом проекте задача формулируется студентом самостоятельно, и основная сложность в нём не программистская, а постановочная: понять, что требуется вычислить и как проверить, что вычисление выполнено правильно.
Ревью чужого кода
Опирается на главы «Жизненный цикл ПО» и «Требования к коду».
Задание
- Провести ревью предложенного кода, отыскав в нём ошибки, неточности и неэффективные места и дав рекомендации по улучшению.
- Задача не сводится к исправлению ошибок: требуются комментарии и рекомендации.
Требования к сдаче
- Ссылка на форк, в котором замечания оформлены комментариями к строкам кода. Наиболее простой способ: завести в собственном форке ветку с исправлениями и открыть pull request внутри форка, из этой ветки в
main; в диффе GitHub позволяет комментировать каждую строку. Отдельный текстовый файл со списком замечаний не подходит: замечание должно располагаться рядом с кодом. - Замечания разделены на два вида: ошибки, из-за которых программа работает неверно или завершается аварийно, и рекомендации, где код работает, но написан неудачно.
- У каждой ошибки указано, при каких данных она проявится. «Тут может упасть» замечанием не считается.
- У каждой рекомендации указано, что она улучшает: скорость, читаемость или устойчивость к изменениям.
Генерация текста на основе данных
Опирается на главы «Технические основы» и «Коллекции». Цепь Маркова является простейшей языковой моделью, и на ней видно, откуда у больших моделей берутся связность и склонность выдумывать.
Требуется реализовать на цепях Маркова генератор текста: программу, которая читает готовый корпус, запоминает, какое слово за каким встречалось, и выдаёт новый текст, похожий на исходный настолько, насколько позволяет память в одно-два слова.
Логика программы
- Файл с исходным текстом считывается и разбивается на слова.
- Все слова, стоящие рядом, соединяются в пары (или более длинные последовательности).
- На основе этих пар составляется словарь цепочек, содержащий первое слово и все слова, которые могут следовать за ним.
- Стартовое слово выбирается случайно, с единственным требованием: первая буква заглавная, иначе текст начнётся с середины фразы.
- Задаётся длина текста на выходе и формируется результат.
Требования к сдаче
- Программа, принимающая имя файла с исходным текстом и длину результата в словах.
- Сгенерированный текст на двух разных исходных корпусах. Заготовки в репозитории нет, тексты подбираются самостоятельно: подойдёт любая книга с «Проекта Гутенберг» или lib.ru при условии, что авторы различны, а объём составляет не менее сотни тысяч слов. На коротком тексте цепь вырождается в пересказ источника.
- Сравнение цепочек по два и по три слова: короткий ответ на вопрос, что меняется в связности текста и почему.
- Ответ на вопрос, что произойдёт, если слово встретилось в тексте всего один раз и оказалось последним.
Установка Arch Linux вручную с RAID1 и UEFI
Опирается на главы «Процесс загрузки», «Файловые системы» и «Установка Arch Linux».
Условия задания
-
Настройка виртуальной машины.
- Поднять виртуальную машину на localhost
- Первоначально выбрать Legacy BIOS (SeaBIOS) в настройках
- После установки переключить на UEFI
-
Требования к установке.
- Установить Arch Linux полностью вручную, без направляемого установщика
archinstall(штатныеpacstrap,genfstabиarch-chrootиспользовать допускается и рекомендуется) - Использовать программный RAID1 (зеркало)
- Система должна оставаться работоспособной при отказе любого из дисков
- Загрузчик должен работать через UEFI (должна появиться отдельная запись в
efibootmgr)
- Установить Arch Linux полностью вручную, без направляемого установщика
-
Особенности разметки.
- Обязательно выделить отдельный раздел под загрузчик, причём на обоих дисках: прошивка не способна читать ESP с mdraid-метаданными, поэтому его копию и отдельную запись в
efibootmgrнеобходимо создать вручную. Без этого система со второго диска не загрузится - Продемонстрировать работу как в Legacy BIOS, так и в UEFI режиме
- Обязательно выделить отдельный раздел под загрузчик, причём на обоих дисках: прошивка не способна читать ESP с mdraid-метаданными, поэтому его копию и отдельную запись в
Требования к сдаче
- Главное: система загружается с одним диском. Необходимо отключить в настройках виртуальной машины первый диск, загрузиться со второго и показать
cat /proc/mdstat: массив в состоянииdegraded, система работает. Затем требуется вернуть диск и показать, что массив пересобрался. Без этой демонстрации задание не принимается: RAID1, не проверенный на отказ, ничем не лучше одного диска. - Вывод
efibootmgr -vс записью загрузчика, доказывающий, что загрузка осуществляется через UEFI, а не через BIOS. - Отчёт в свободной форме: пошаговое руководство, перечень команд с пояснениями, скриншоты ключевых этапов или их сочетание. Отчёт должен позволять повторить установку.
Настройка окружения и работа с утилитами
Опирается на главы «Инструменты Linux» и «Внутреннее устройство Linux»;
straceиperfв книге только названы, поэтому разбираться с ними необходимо поman perf-record,man perf-reportи по схемам Брендана Грегга.
Условия задания
Настройка окружения
Эта часть книгой не покрывается: рабочее место настраивается каждым студентом самостоятельно по документации выбранных инструментов.
-
Эмулятор терминала.
- Установить и настроить современный эмулятор терминала
- В отчёте указать выбранный эмулятор и доводы, определившие выбор
-
Настройка PS1.
- Оформить приглашение командной строки, выводимое перед каждой командой, в формате
login@your-login-at-nsu: - Использовать три разных цвета для:
- Логина
- Символа @
- Последней части приглашения
- Оформить приглашение командной строки, выводимое перед каждой командой, в формате
-
Установка asciinema.
- Установить утилиту
- Освоить базовые функции, отвечающие за запись скринкастов
Практические задания
-
Работа с gtypist.
- Установить
gtypist - Записать скринкаст, показывающий успешное прохождение упражнения S3
- В кадре должны быть видны:
- Raw speed
- Adjusted speed
- Процент ошибок
- Установить
-
Command line murders.
- Записать скринкаст решения задачи
-
Мониторинг системы.
- Создать виртуальную машину с Ubuntu
- Подключиться по SSH
- Записать скринкаст выполнения команд, проверяющих:
- Число ядер и модель CPU
- Общий размер и свободная оперативная память
- Занятое/свободное место в системе
- Утилизация дисковой подсистемы (IOPS)
- Скорость и утилизация сетевого линка
-
Curl-однострочник.
- Написать однострочник, который раз в секунду обращается с помощью curl по адресу https://storage.mds.yandex.net/ping и выводит для каждого запроса в одну строку только: таймстемп запуска команды, код ответа, время установки tcp-соединения, время установки tls-соединения, time to first byte, и общее время выполнения запроса
- Записать скринкаст работы написанного однострочника
-
Работа с perf.
- Записать
perf recordи просмотретьperf report - В виртуальной машине аппаратные счётчики процессора обычно недоступны, и
perf record, запущенный без аргументов, завершится ошибкой на событииcycles. Достаточно использовать программное событие, поддерживаемое ядром, напримерperf record -e cpu-clock -g …. Если и оно отказывает, доступ к счётчикам ограничивается параметромkernel.perf_event_paranoid: необходимо посмотреть текущее значение черезsysctlи понизить его настолько, насколько требуется, понимая, какие возможности при этом разрешаются - (*) Дополнительное задание.
- Собрать zstd с debug-символами
- Запустить сжатие:
cat /dev/urandom | zstd -19 -f -T4 -v - -o out.zst - Снять perf record с процесса zstd
- Найти в исходниках самую нагруженную функцию
- Записать
Требования к сдаче
- Скринкасты в формате asciinema, по одному на каждый пункт практической части. На записи должен быть виден полученный результат, а не только набор команды. У
gtypistэто итоговые Raw speed, Adjusted speed и процент ошибок, у однострочника сcurl— несколько строк вывода со всеми шестью полями, у мониторинга — ответы на все пять вопросов. - Название выбранного эмулятора терминала и одна фраза, объясняющая выбор.
- Для задания со звёздочкой требуется ссылка на запись
perf report, сделанную с процесса zstd, и имя самой нагруженной функции с указанием, в каком файле исходников она найдена.
Формат отчёта свободный (допускается комбинировать текст, скриншоты и ссылки на опубликованные записи)
Работа с долгоиграющими процессами
Опирается на главы «Внутреннее устройство Linux» и «Инструменты Linux», в которых разобраны процессы, состояния, сигналы и планировщик.
Условия задания
Основная часть
-
Тестовая программа — скрипт с шебангом
#!/usr/bin/bashи бесконечным цикломwhile true; do echo "I am still alive"; sleep 1; done; развёрнутый листинг размещён в репозитории задания. -
Запустить программу
-
Обеспечить её продолжение работы после отключения от сервера
Задание со звездочкой (*)
-
Программа должна продолжать работу в фоне (*)
-
Обеспечить возможность чтения stdout и stderr (*)
-
Перенаправить выводы в соответствующие файлы (*)
Требования к сдаче
- Команда или способ, благодаря которому процесс переживает отключение от сервера, и объяснение, почему он работает: какой сигнал приходит процессу при закрытии сессии и что с ним происходит.
- Вывод
ps, снятый после повторного входа и доказывающий, что процесс жив. - Для задания со звёздочкой: файлы, в которые перенаправлены
stdoutиstderr, и способ прочитать их у работающего процесса, не останавливая его.
Решение задач на Python и анализ сложности
Опирается на главы «Введение в алгоритмы» и «Сложность операций с коллекциями».
Задача: необходимо решить две любые задачи «лёгкого» уровня с сайта CodeRun от Яндекса.
Требования к сдаче
По каждой из двух задач должны быть представлены:
- Ссылка на задачу.
- Исходный код решения на Python.
- Пояснение: подробное описание хода решения.
- Обоснование: объяснение, почему выбран этот алгоритм и эти структуры данных (например, список, словарь, множество).
- Анализ сложности:
- Временная сложность (Big O Notation).
- Пространственная сложность.
Цель: научиться не только писать рабочий код, но и понимать его эффективность.
Деплой стартапа «Котики в мир»
Опирается на главы «От скрипта к приложению», «Docker», «Компьютерные сети», «Веб-технологии», «Базы данных», «Работа с базами данных» и «Системный дизайн».
Контекст проекта
Код в репозитории размещён не в main, а в ветках front_code и my_backend. Сначала необходимо разобраться в их содержимом и свести его вместе.
Моделируется ситуация присоединения к стартапу, в котором:
- Фронтенд-разработчик и бэкенд-разработчик оставили незавершённый код
- Необходимо интегрировать их наработки в рабочую систему
- Проект должен быть готов к промышленному деплою
Технические требования
1. Подготовка репозитория
- Привести Git-репозиторий в порядок
- Слить все рабочие ветки в
main - Организовать код в структурированные директории (frontend, backend, nginx)
2. Docker
- Создать отдельные Docker-образы для бэкенда и фронтенда
- Настроить взаимодействие через
compose.yaml(старое имяdocker-compose.ymlтакже читается) - Обеспечить сборку образов через
docker compose build
Требования к сдаче
1. Состояние репозитория
- Чистая ветка
main - Логичное разделение кода по директориям
- Рабочие Dockerfile для каждого сервиса
2. Запуск системы
- Фронтенд доступен на http://localhost
- Бэкенд отвечает на API-запросы
3. Архитектура
- Наружу опубликован только один порт, 80-й у Nginx. У остальных сервисов в
docker-compose.ymlотсутствует секцияports, присутствует толькоexpose(разница между ними разобрана в главе про Docker). - Проверка осуществляется следующим образом:
docker compose psпоказывает публикацию порта лишь у одного сервиса, аcurlна порт бэкенда с хоста не отвечает. - Между собой сервисы обращаются по именам, которые Compose назначает в созданной им сети, а не по адресам, прописанным вручную.
Итоговый проект
Опирается на всю книгу, прежде всего на главы «Требования к коду», «Жизненный цикл ПО» и «От скрипта к приложению», откуда следуют требования к сборке, тестам и документации. Примеры доведённой до конца работы приведены в части «Разбор реальных кодов».
Формальные требования к выполнению проекта:
- Задача формулируется участниками самостоятельно.
- Требования необходимо разделить на базовые и дополнительные.
- Базовые требования, как правило, связаны друг с другом, и реализовывать их приходится вместе, а из дополнительных выбирается то подмножество, которое возможно выполнить в срок.
- Проект должен быть связан с физикой, а основным языком реализации предполагается Python.
- Работа ведётся командой в два-три человека (исключения возможны).
- Каждый участник отвечает за свою часть.
- Решение задачи предполагает как минимум три этапа:
- Формулировка задачи (срок: последняя неделя ноября). Результатом этапа становится документ, содержащий уточнённую формулировку задачи, а также предполагаемый путь её решения. Рекомендуемый объём этой части документа — 1-2 страницы. Кроме того, документ должен содержать табличное описание оставшихся этапов: сроки, полученная функциональность, разделение ответственности между участниками.
- Реализация базовой функциональности (срок: вторая неделя декабря). На этом этапе должны быть реализованы базовые требования.
- Расширенная функциональность (срок: зачётная неделя). На этом этапе должны быть частично или полностью реализованы дополнительные требования.
Слайды к главе. Этапы и требования итогового проекта вместе с общими уроками разбора восьми программ изложены также в заключительной части лекции «Разбор реальных кодов»; слайды лекции доступны на сайте книги и в PDF.
Требования к сдаче
Артефакты, получаемые по результатам этапов:
- Программный код со сборочными файлами. Код должен собираться без участия IDE. Приветствуется контейнеризация.
- Покрытие тестами.
- Документация на программный интерфейс.
- Примеры, демонстрирующие возможности разработанной программы.
Примечание: все артефакты, включая документацию 1-го этапа, должны быть размещены в системе контроля версий.
Репозитория-заготовки у этого задания нет: репозиторий создаётся участниками самостоятельно, и его устройство входит в состав работы. Устройство репозитория разобрано в главе «Git», конвейер сборки — в главе «Жизненный цикл ПО».
Основы языка
Краткий справочник для читателей, не знакомых с Python. Полностью тема рассматривается в основных главах книги; в печатное издание приложение не вошло.
Приложение представляет собой перевод с сокращениями учебника «Python Numpy Tutorial» курса CS231n Стэнфордского университета; автор — Дж. Джонсон, исходный текст распространяется по лицензии MIT, © 2015 Andrej Karpathy.
Python является высокоуровневым мультипарадигменным языком программирования с динамической типизацией; код на нём часто сравнивают с псевдокодом: сложные идеи выражаются в нескольких строках и легко читаются.
Рекомендуется ознакомиться с PEP 8.
Версии Python и Дзен Python
Поддерживаются версии Python 3.X; поддержка Python 2.7 прекратилась в 2020 году. Весь код в книге рассчитан на Python 3.10 и новее.
Версию Python показывает команда python --version.
!python --version
Python 3.12.3
import this
The Zen of Python, by Tim Peters
Beautiful is better than ugly.
Explicit is better than implicit.
Simple is better than complex.
Complex is better than complicated.
Flat is better than nested.
Sparse is better than dense.
Readability counts.
Special cases aren't special enough to break the rules.
Although practicality beats purity.
Errors should never pass silently.
Unless explicitly silenced.
In the face of ambiguity, refuse the temptation to guess.
There should be one-- and preferably only one --obvious way to do it.
Although that way may not be obvious at first unless you're Dutch.
Now is better than never.
Although never is often better than *right* now.
If the implementation is hard to explain, it's a bad idea.
If the implementation is easy to explain, it may be a good idea.
Namespaces are one honking great idea -- let's do more of those!
Основные типы данных
Числа
Целые и вещественные числа ведут себя так же, как в других языках.
x = 3
print(x, type(x))
3 <class 'int'>
print(x + 1) # Сложение;
print(x - 1) # Вычитание;
print(x * 2) # Умножение;
print(x ** 2) # Возведение в степень;
4
2
6
9
x += 1
print(x) # Выведет "4"
x *= 2
print(x) # Выведет "8"
4
8
y = 2.5
print(type(y)) # Выведет "<class 'float'>"
print(y, y + 1, y * 2, y ** 2) # Выведет "2.5 3.5 5.0 6.25"
<class 'float'>
2.5 3.5 5.0 6.25
В отличие от многих языков, в Python отсутствуют унарные операторы инкремента (x++) и декремента (x--). Целые числа имеют неограниченную точность — отдельного типа для длинных целых, как в Python 2, нет, и int растёт, пока хватает памяти, — кроме того, имеется встроенный тип комплексных чисел; подробности приведены в документации.
Булевы значения
В Python есть все привычные операторы булевой логики, но вместо символов (&&, || и т.д.) используются английские слова.
T, F = True, False
print(type(T)) # Выведет "<class 'bool'>"
<class 'bool'>
Операции:
print(T and F) # Логическое И;
print(T or F) # Логическое ИЛИ;
print(not T) # Логическое НЕ;
print(T != F) # Логическое исключающее ИЛИ;
False
True
False
True
Строки
hello = 'hello' # Строковые литералы можно записывать в одинарных кавычках
world = "world" # или в двойных — это не имеет значения.
print(hello, len(hello))
hello 5
hw = hello + ' ' + world # Конкатенация строк
print(hw) # выведет "hello world"
hello world
hw12 = '%s %s %d' % (hello, world, 12) # форматирование строки в стиле sprintf
print(hw12) # выведет "hello world 12"
hello world 12
Так строки формировались до версии 3.6, и в существующем коде этот стиль ещё встречается, однако новый код пишется с помощью f-строк: перед кавычками ставится буква f, а всё, что стоит внутри строки в фигурных скобках, вычисляется и подставляется на место.
n = 12
print(f'{hello} {world} {n}') # выведет "hello world 12"
hello world 12
Строки обладают большим числом полезных методов.
s = "hello"
print(s.capitalize()) # Первая буква становится заглавной; выведет "Hello"
print(s.upper()) # Перевод строки в верхний регистр; выведет "HELLO"
print(s.rjust(7)) # Выравнивание по правому краю с дополнением пробелами; выведет " hello"
print(s.center(7)) # Центрирование строки с дополнением пробелами; выведет " hello "
print(s.replace('l', '(ell)')) # Замена всех вхождений одной подстроки на другую;
# выведет "he(ell)(ell)o"
print(' world '.strip()) # Удаление пробелов в начале и в конце; выведет "world"
Hello
HELLO
hello
hello
he(ell)(ell)o
world
Список всех строковых методов приведён в документации.
Контейнеры
Встроенные контейнерные типы Python — списки, словари, множества и кортежи.
Списки
Список является аналогом массива, однако его размер можно менять, а элементы могут быть разных типов.
xs = [3, 1, 2] # Создаём список
print(xs, xs[2])
print(xs[-1]) # Отрицательные индексы отсчитываются с конца списка; выведет "2"
[3, 1, 2] 2
2
xs[2] = 'foo' # Списки могут содержать элементы разных типов
print(xs)
[3, 1, 'foo']
xs.append('bar') # Добавляем новый элемент в конец списка
print(xs)
[3, 1, 'foo', 'bar']
x = xs.pop() # Удаляем и возвращаем последний элемент списка
print(x, xs)
bar [3, 1, 'foo']
Подробности о списках приведены в документации.
Срезы
Помимо доступа к отдельным элементам, в Python имеется синтаксис для работы с подсписками — срезы (slicing).
nums = list(range(5)) # range не создаёт список, поэтому оборачиваем в list
print(nums) # Выведет "[0, 1, 2, 3, 4]"
print(nums[2:4]) # Срез с индекса 2 до 4 (не включая); выведет "[2, 3]"
print(nums[2:]) # Срез с индекса 2 до конца; выведет "[2, 3, 4]"
print(nums[:2]) # Срез с начала до индекса 2 (не включая); выведет "[0, 1]"
print(nums[:]) # Срез всего списка; выведет "[0, 1, 2, 3, 4]"
print(nums[:-1]) # Индексы среза могут быть отрицательными; выведет "[0, 1, 2, 3]"
[0, 1, 2, 3, 4]
[2, 3]
[2, 3, 4]
[0, 1]
[0, 1, 2, 3, 4]
[0, 1, 2, 3]
Циклы
Цикл по элементам списка:
animals = ['cat', 'dog', 'monkey']
for animal in animals:
print(animal)
cat
dog
monkey
Если в теле цикла требуется также индекс элемента, применяется встроенная функция enumerate.
animals = ['cat', 'dog', 'monkey']
for idx, animal in enumerate(animals):
print(f'#{idx + 1}: {animal}')
#1: cat
#2: dog
#3: monkey
Списковые включения (list comprehensions)
Часто требуется преобразовать данные одного вида в другой. Простым примером служит код, вычисляющий квадраты чисел.
nums = [0, 1, 2, 3, 4]
squares = []
for x in nums:
squares.append(x ** 2)
print(squares)
[0, 1, 4, 9, 16]
То же самое записывается списковым включением (list comprehension).
nums = [0, 1, 2, 3, 4]
squares = [x ** 2 for x in nums]
print(squares)
[0, 1, 4, 9, 16]
List comprehensions могут содержать и условия.
nums = [0, 1, 2, 3, 4]
even_squares = [x ** 2 for x in nums if x % 2 == 0]
print(even_squares)
[0, 4, 16]
Словари
Словарь хранит пары (ключ, значение), подобно Map в Java или объекту в Javascript.
d = {'cat': 'cute', 'dog': 'furry'} # Создаём новый словарь с данными
print(d['cat']) # Получаем запись из словаря; выведет "cute"
print('cat' in d) # Проверяем, есть ли в словаре ключ; выведет "True"
cute
True
d['fish'] = 'wet' # Добавляем запись в словарь
print(d['fish']) # Выведет "wet"
wet
print(d.get('monkey', 'N/A')) # Получаем элемент со значением по умолчанию; выведет "N/A"
print(d.get('fish', 'N/A')) # Получаем элемент со значением по умолчанию; выведет "wet"
N/A
wet
del d['fish'] # Удаляем элемент из словаря
print(d.get('fish', 'N/A')) # ключа "fish" больше нет; выведет "N/A"
N/A
Подробности о словарях приведены в документации. Итерация по ключам словаря:
d = {'person': 2, 'cat': 4, 'spider': 8}
for animal in d:
legs = d[animal]
print(f'A {animal} has {legs} legs')
A person has 2 legs
A cat has 4 legs
A spider has 8 legs
Словарные включения (dictionary comprehensions) аналогичны списковым, но строят словари.
nums = [0, 1, 2, 3, 4]
even_num_to_square = {x: x ** 2 for x in nums if x % 2 == 0}
print(even_num_to_square)
{0: 0, 2: 4, 4: 16}
Множества
Множество представляет собой неупорядоченную коллекцию различных элементов.
animals = {'cat', 'dog'}
print('cat' in animals) # Проверяем, есть ли элемент в множестве; выведет "True"
print('fish' in animals) # выведет "False"
True
False
animals.add('fish') # Добавляем элемент в множество
print('fish' in animals)
print(len(animals)) # Число элементов в множестве;
True
3
animals.add('cat') # Добавление элемента, который уже есть в множестве, ничего не делает
print(len(animals))
animals.remove('cat') # Удаляем элемент из множества
print(len(animals))
3
2
Циклы. Итерация по множеству синтаксически не отличается от итерации по списку; однако множества неупорядочены, и на порядок обхода полагаться нельзя.
animals = {'cat', 'dog', 'fish'}
for idx, animal in enumerate(animals):
print(f'#{idx + 1}: {animal}')
# Порядок зависит от хеш-сида процесса и от запуска к запуску меняется
Один из возможных порядков:
#1: fish
#2: dog
#3: cat
Множественные включения: как списки и словари, множества строятся с помощью set comprehensions.
from math import sqrt
print({int(sqrt(x)) for x in range(30)})
{0, 1, 2, 3, 4, 5}
Кортежи
Кортеж представляет собой неизменяемый упорядоченный список значений, во многом похожий на обычный список. Одно из важнейших отличий состоит в том, что кортежи можно использовать как ключи в словарях и как элементы множеств, а списки нельзя.
d = {(x, x + 1): x for x in range(10)} # Создаём словарь с ключами-кортежами
t = (5, 6) # Создаём кортеж
print(type(t))
print(d[t])
print(d[(1, 2)])
<class 'tuple'>
5
1
Функции
Функции определяются ключевым словом def.
def sign(x: float) -> str:
"""Function sign.""" # строка документации
if x > 0:
return 'positive'
elif x < 0:
return 'negative'
else:
return 'zero'
for x in [-1, 0, 1]:
print(sign(x))
negative
zero
positive
help(sign)
Help on function sign in module __main__:
sign(x: float) -> str
Function sign.
Функция с необязательными именованными аргументами:
def hello(name: str, loud: bool = False) -> None:
"""Function hello.
If loud is True,
then the name is printed in capital letters.
"""
if loud:
print(f'HELLO, {name.upper()}')
else:
print(f'Hello, {name}!')
hello('Bob')
hello('Fred', loud=True)
Hello, Bob!
HELLO, FRED
help(hello)
Help on function hello in module __main__:
hello(name: str, loud: bool = False) -> None
Function hello.
If loud is True,
then the name is printed in capital letters.
Классы
Определение класса:
class Greeter:
"""Class Greeter.
method greet:
If loud is True,
then the name is printed in capital letters.
"""
# Конструктор
def __init__(self, name):
self.name = name # Создаём переменную экземпляра
# Метод экземпляра
def greet(self, loud: bool = False) -> None:
if loud:
print(f'HELLO, {self.name.upper()}!')
else:
print(f'Hello, {self.name}')
g = Greeter('Fred') # Создаём экземпляр класса Greeter
g.greet() # Вызываем метод экземпляра; выведет "Hello, Fred"
g.greet(loud=True) # Вызываем метод экземпляра; выведет "HELLO, FRED!"
Hello, Fred
HELLO, FRED!
help(Greeter)
Help on class Greeter in module __main__:
class Greeter(builtins.object)
| Greeter(name)
|
| Class Greeter.
|
| method greet:
| If loud is True,
| then the name is printed in capital letters.
|
| Methods defined here:
|
| __init__(self, name)
| Initialize self. See help(type(self)) for accurate signature.
|
| greet(self, loud: bool = False) -> None
| # Метод экземпляра
Внутреннее устройство объектов и стоимость каждой операции рассматриваются в основных главах — «Объекты и память» и «Классы».
Массивы NumPy
Краткий справочник для читателей, не знакомых с Python. Полностью тема рассматривается в основных главах книги; в печатное издание приложение не вошло.
Приложение представляет собой перевод с сокращениями учебника «Python Numpy Tutorial» курса CS231n Стэнфордского университета; автор — Дж. Джонсон, исходный текст распространяется по лицензии MIT, © 2015 Andrej Karpathy.
Слайды к главе. Индексация, broadcasting и типы массивов изложены также во второй и третьей частях лекции «NumPy, pandas и SciPy» с демонстрациями в терминале; слайды лекции доступны на сайте книги и в PDF.
NumPy является основной библиотекой для научных вычислений на Python: она предоставляет высокопроизводительный объект многомерного массива и инструменты для работы с такими массивами.
Прежде всего необходимо импортировать пакет numpy.
import numpy as np
Массивы
Массив NumPy представляет собой сетку значений одного типа, индексируемую кортежем целых чисел; отрицательные индексы отсчитываются от конца. Число измерений массива хранится в поле ndim, а форма (shape) представляет собой кортеж целых чисел с размерами вдоль каждого измерения.
Массивы NumPy могут быть созданы из вложенных списков Python, а обращение к элементам осуществляется через квадратные скобки:
a = np.array([1, 2, 3]) # одномерный массив
print(type(a), a.shape, a[0], a[1], a[2])
a[0] = 5 # изменение элемента
print(a)
<class 'numpy.ndarray'> (3,) 1 2 3
[5 2 3]
b = np.array([[1,2,3],[4,5,6]]) # двумерный массив
print(b)
[[1 2 3]
[4 5 6]]
print(b.shape)
print(b[0, 0], b[0, 1], b[1, 0])
(2, 3)
1 2 4
NumPy также предоставляет большое число функций для создания массивов:
a = np.zeros((2,2)) # массив из нулей
print(a)
[[0. 0.]
[0. 0.]]
b = np.ones((1,2)) # массив из единиц
print(b)
[[1. 1.]]
c = np.full((2,2), 7) # массив, заполненный константой
print(c)
[[7 7]
[7 7]]
d = np.eye(2) # единичная матрица 2×2
print(d)
[[1. 0.]
[0. 1.]]
rng = np.random.default_rng(0) # генератор случайных чисел с зерном 0
e = rng.random((2, 2)) # случайные числа из [0, 1)
print(e)
[[0.63696169 0.26978671]
[0.04097352 0.01652764]]
Индексация массивов
NumPy предоставляет несколько способов индексации массивов.
Срезы. Как и к спискам Python, к массивам NumPy применимы срезы; поскольку массивы многомерны, срез указывается для каждого измерения.
import numpy as np
# двумерный массив формы (3, 4)
# [[ 1 2 3 4]
# [ 5 6 7 8]
# [ 9 10 11 12]]
a = np.array([[1,2,3,4], [5,6,7,8], [9,10,11,12]])
# срез из первых двух строк и столбцов 1 и 2;
# b — массив формы (2, 2):
# [[2 3]
# [6 7]]
b = a[:2, 1:3]
print(b)
[[2 3]
[6 7]]
Срез массива является представлением (view) тех же самых данных, поэтому изменение среза приводит к изменению исходного массива.
print(a[0, 1])
b[0, 0] = 77 # b[0, 0] — те же самые данные, что и a[0, 1]
print(a[0, 1])
2
77
Целочисленную индексацию можно сочетать со срезами, однако в результате получается массив меньшей размерности, чем исходный.
# двумерный массив формы (3, 4)
a = np.array([[1,2,3,4], [5,6,7,8], [9,10,11,12]])
print(a)
[[ 1 2 3 4]
[ 5 6 7 8]
[ 9 10 11 12]]
Существует два способа обращения к средней строке массива: сочетание целочисленной индексации со срезами даёт массив меньшей размерности, тогда как одни только срезы сохраняют число измерений исходного массива.
row_r1 = a[1, :] # одномерное представление второй строки a
row_r2 = a[1:2, :] # двумерное представление второй строки a
row_r3 = a[[1], :] # двумерная копия второй строки a: индекс-список копирует данные
print(row_r1, row_r1.shape)
print(row_r2, row_r2.shape)
print(row_r3, row_r3.shape)
[5 6 7 8] (4,)
[[5 6 7 8]] (1, 4)
[[5 6 7 8]] (1, 4)
# То же различие видно и при обращении к столбцам массива:
col_r1 = a[:, 1]
col_r2 = a[:, 1:2]
print(col_r1, col_r1.shape)
print(col_r2, col_r2.shape)
[ 2 6 10] (3,)
[[ 2]
[ 6]
[10]] (3, 1)
Индексация целочисленными массивами. Срез всегда является подмассивом исходного массива, тогда как индексация целочисленными массивами позволяет формировать произвольные массивы из данных другого массива.
a = np.array([[1,2], [3, 4], [5, 6]])
# Пример индексации целочисленными массивами.
# Возвращаемый массив будет иметь форму (3,)
print(a[[0, 1, 2], [0, 1, 0]])
# то же самое без индексации массивами:
print(np.array([a[0, 0], a[1, 1], a[2, 0]]))
[1 4 5]
[1 4 5]
# При индексации целочисленными массивами можно повторно
# использовать один и тот же элемент исходного массива:
print(a[[0, 0], [1, 1]])
# Эквивалентно предыдущему примеру с целочисленной индексацией
print(np.array([a[0, 1], a[0, 1]]))
[2 2]
[2 2]
Индексация целочисленными массивами позволяет выбрать или изменить один элемент в каждой строке матрицы.
# массив, из которого выбираются элементы
a = np.array([[1,2,3], [4,5,6], [7,8,9], [10, 11, 12]])
print(a)
[[ 1 2 3]
[ 4 5 6]
[ 7 8 9]
[10 11 12]]
# массив индексов
b = np.array([0, 2, 0, 1])
# по одному элементу из каждой строки a по индексам из b
print(a[np.arange(4), b])
[ 1 6 7 11]
# изменение одного элемента в каждой строке a по индексам из b
a[np.arange(4), b] += 10
print(a)
[[11 2 3]
[ 4 5 16]
[17 8 9]
[10 21 12]]
Булева индексация. Этот способ позволяет выбирать произвольные элементы массива; чаще всего он применяется для отбора элементов, удовлетворяющих заданному условию.
import numpy as np
a = np.array([[1,2], [3, 4], [5, 6]])
bool_idx = (a > 2) # маска: массив bool той же формы, что и a,
# True там, где элемент больше 2
print(bool_idx)
[[False False]
[ True True]
[ True True]]
# одномерный массив из элементов a, которым в bool_idx
# соответствует True
print(a[bool_idx])
# то же одним выражением:
print(a[a > 2])
[3 4 5 6]
[3 4 5 6]
Многие детали индексации здесь опущены; полное описание приведено в документации.
Типы данных
Каждый массив NumPy состоит из элементов одного типа; библиотека предоставляет большой набор числовых типов. При создании массива NumPy определяет тип автоматически, однако функции создания массивов, как правило, принимают необязательный аргумент, задающий тип явно.
x = np.array([1, 2]) # тип выбирает NumPy
y = np.array([1.0, 2.0]) # тип выбирает NumPy
z = np.array([1, 2], dtype=np.int64) # тип задан явно
print(x.dtype, y.dtype, z.dtype)
int64 float64 int64
Полное описание типов данных NumPy приведено в документации.
Математические операции над массивами
Базовые математические функции применяются к массивам поэлементно и доступны как в виде перегруженных операторов, так и в виде функций модуля numpy:
x = np.array([[1,2],[3,4]], dtype=np.float64)
y = np.array([[5,6],[7,8]], dtype=np.float64)
# Поэлементная сумма; оба способа дают массив
print(x + y)
print(np.add(x, y))
[[ 6. 8.]
[10. 12.]]
[[ 6. 8.]
[10. 12.]]
# Поэлементная разность; оба способа дают массив
print(x - y)
print(np.subtract(x, y))
[[-4. -4.]
[-4. -4.]]
[[-4. -4.]
[-4. -4.]]
# Поэлементное произведение; оба способа дают массив
print(x * y)
print(np.multiply(x, y))
[[ 5. 12.]
[21. 32.]]
[[ 5. 12.]
[21. 32.]]
# Поэлементное деление; оба способа дают массив
# [[ 0.2 0.33333333]
# [ 0.42857143 0.5 ]]
print(x / y)
print(np.divide(x, y))
[[0.2 0.33333333]
[0.42857143 0.5 ]]
[[0.2 0.33333333]
[0.42857143 0.5 ]]
# Поэлементный квадратный корень; получается массив
# [[ 1. 1.41421356]
# [ 1.73205081 2. ]]
print(np.sqrt(x))
[[1. 1.41421356]
[1.73205081 2. ]]
В отличие от MATLAB, оператор * выполняет поэлементное, а не матричное умножение. Скалярное произведение векторов, произведение матрицы на вектор и перемножение матриц выполняет оператор @ (функция np.matmul); функция dot, доступная и как метод массива, даёт для векторов и матриц тот же результат и встречается в старом коде.
x = np.array([[1,2],[3,4]])
y = np.array([[5,6],[7,8]])
v = np.array([9,10])
w = np.array([11, 12])
# скалярное произведение векторов; все три способа дают 219
print(v @ w)
print(v.dot(w))
print(np.dot(v, w))
219
219
219
# произведение матрицы на вектор — одномерный массив [29 67]
print(x @ v)
print(np.dot(x, v))
[29 67]
[29 67]
# произведение матриц — двумерный массив
print(x @ y)
print(np.dot(x, y))
[[19 22]
[43 50]]
[[19 22]
[43 50]]
Одной из наиболее востребованных функций для вычислений над массивами является sum.
x = np.array([[1,2],[3,4]])
print(np.sum(x)) # сумма всех элементов
print(np.sum(x, axis=0)) # суммы по столбцам
print(np.sum(x, axis=1)) # суммы по строкам
10
[4 6]
[3 7]
Полный список математических функций NumPy приведён в документации.
Помимо вычислений часто требуется изменять форму данных в массивах. Простейшим примером является транспонирование матрицы с помощью атрибута T объекта-массива.
print(x)
print(x.T)
[[1 2]
[3 4]]
[[1 3]
[2 4]]
v = np.array([[1,2,3]])
print(v)
print(v.T)
[[1 2 3]]
[[1]
[2]
[3]]
Broadcasting
Broadcasting (транслирование) представляет собой механизм, позволяющий NumPy выполнять арифметические операции над массивами разной формы. Типичный случай: имеются малый и большой массивы, и малый необходимо многократно использовать в операции над большим.
Предположим, что требуется прибавить постоянный вектор к каждой строке матрицы:
# вектор v прибавляется к каждой строке матрицы x,
# результат записывается в матрицу y
x = np.array([[1,2,3], [4,5,6], [7,8,9], [10, 11, 12]])
v = np.array([1, 0, 1])
y = np.empty_like(x) # пустая матрица той же формы, что и x
# явный цикл по строкам
for i in range(4):
y[i, :] = x[i, :] + v
print(y)
[[ 2 2 4]
[ 5 5 7]
[ 8 8 10]
[11 11 13]]
Такой подход работает, однако при большой матрице x явный цикл на Python выполняется медленно. Прибавление вектора v к каждой строке x равносильно формированию матрицы vv из вертикально уложенных копий v с последующим поэлементным сложением x и vv.
vv = np.tile(v, (4, 1)) # четыре копии v друг под другом
print(vv)
[[1 0 1]
[1 0 1]
[1 0 1]
[1 0 1]]
y = x + vv # поэлементная сумма x и vv
print(y)
[[ 2 2 4]
[ 5 5 7]
[ 8 8 10]
[11 11 13]]
Broadcasting позволяет выполнить это вычисление, не создавая копий v.
# вектор v прибавляется к каждой строке матрицы x,
# результат записывается в матрицу y
x = np.array([[1,2,3], [4,5,6], [7,8,9], [10, 11, 12]])
v = np.array([1, 0, 1])
y = x + v # v прибавляется к каждой строке x через broadcasting
print(y)
[[ 2 2 4]
[ 5 5 7]
[ 8 8 10]
[11 11 13]]
Строка y = x + v выполняется корректно, хотя x имеет форму (4, 3), а v — форму (3,): благодаря broadcasting она выполняется так, как если бы v имел форму (4, 3), каждая его строка являлась копией v, а сложение осуществлялось поэлементно.
Broadcasting двух массивов подчиняется следующим правилам:
- Если массивы имеют разное число измерений, форма массива меньшей размерности дополняется единицами слева, пока обе формы не станут одной длины.
- Два массива называются совместимыми по измерению, если их размеры в этом измерении совпадают или если размер одного из массивов в этом измерении равен 1.
- Broadcasting массивов возможен, если они совместимы по всем измерениям.
- После broadcasting каждый массив ведёт себя так, как будто его форма равна поэлементному максимуму форм двух входных массивов.
- В каждом измерении, где размер одного массива равен 1, а размер другого больше 1, первый массив ведёт себя так, как будто его скопировали вдоль этого измерения.
Иное изложение тех же правил приведено в документации.
Поэлементные функции, поддерживающие broadcasting, называются универсальными (ufunc); полный список приведён в документации.
Ниже приведены несколько применений broadcasting:
# внешнее произведение векторов
v = np.array([1,2,3]) # v имеет форму (3,)
w = np.array([4,5]) # w имеет форму (2,)
# для внешнего произведения v превращается в вектор-столбец формы (3, 1),
# который broadcasting совмещает с w; результат формы (3, 2) —
# внешнее произведение v и w:
print(np.reshape(v, (3, 1)) * w)
[[ 4 5]
[ 8 10]
[12 15]]
# вектор прибавляется к каждой строке матрицы
x = np.array([[1,2,3], [4,5,6]])
# x имеет форму (2, 3), а v — форму (3,), поэтому broadcasting сводит их
# к форме (2, 3):
print(x + v)
[[2 4 6]
[5 7 9]]
# вектор прибавляется к каждому столбцу матрицы
# x имеет форму (2, 3), а w — форму (2,).
# Если транспонировать x, он получит форму (3, 2), и его можно совместить
# с w через broadcasting, получив результат формы (3, 2);
# после обратного транспонирования получается итог формы (2, 3) — матрица x,
# к каждому столбцу которой прибавлен вектор w:
print((x.T + w).T)
[[ 5 6 7]
[ 9 10 11]]
# Другое решение — преобразовать w в вектор формы (2, 1);
# тогда его можно совместить с x через broadcasting напрямую
# и получить тот же результат.
print(x + np.reshape(w, (2, 1)))
[[ 5 6 7]
[ 9 10 11]]
# умножение матрицы на константу:
# x имеет форму (2, 3), NumPy рассматривает скаляр как массив формы (),
# и broadcasting сводит их к форме (2, 3):
print(x * 2)
[[ 2 4 6]
[ 8 10 12]]
Broadcasting, как правило, делает код короче и быстрее, пока промежуточные массивы помещаются в память: массив формы (N, N, 3) из float64 при N = 10 000 занимает 2,2 ГиБ.
Настоящий обзор далеко не полон; остальное приведено в справочнике NumPy.
Графики Matplotlib
Краткий справочник для читателей, не знакомых с Python. Полностью тема рассматривается в основных главах книги; в печатное издание приложение не вошло.
Разделы о функциях
plotиsubplotпереведены с сокращениями из учебника «Python Numpy Tutorial» курса CS231n Стэнфордского университета (автор — Дж. Джонсон; исходный текст распространяется по лицензии MIT, © 2015 Andrej Karpathy). Раздел учебника об изображениях опущен, а разделы о подписях осей, гистограммах, точках с погрешностями и сохранении в файл добавлены.
Слайды к главе. Устройство фигуры Matplotlib, основные виды графиков и сохранение в файл изложены также во второй части лекции «Визуализация данных на Python» с демонстрацией в терминале; слайды лекции доступны на сайте книги и в PDF.
Matplotlib является библиотекой для построения графиков. Ниже рассматривается минимум по модулю matplotlib.pyplot — интерфейсу, аналогичному MATLAB, в котором команды добавляются в скрытую «текущую фигуру». Явный интерфейс с объектами фигуры и осей и подробное рассмотрение визуализации на Python (Matplotlib, seaborn, Plotly, HoloViews) приведены в главе «Визуализация на Python».
import numpy as np
import matplotlib.pyplot as plt
В блокноте Jupyter графики выводятся под ячейкой. В современных версиях Jupyter это поведение включено по умолчанию, а в старых его включала команда IPython %matplotlib inline.
Построение графиков
Основной функцией matplotlib является plot, строящая графики двумерных данных:
x = np.arange(0, 3 * np.pi, 0.1) # координаты точек синусоиды
y = np.sin(x)
plt.plot(x, y) # график средствами matplotlib
Несколько кривых одновременно, с заголовком, легендой и подписями осей:
y_sin = np.sin(x)
y_cos = np.cos(x)
plt.plot(x, y_sin) # обе кривые в одних осях
plt.plot(x, y_cos)
plt.xlabel('x, рад')
plt.ylabel('f(x)')
plt.title('Синус и косинус')
plt.legend(['sin(x)', 'cos(x)'])
В физике график без подписанных осей графиком не считается. На осях всегда должны быть указаны величина и её единицы измерения («t, с», «U, мВ»); за это отвечают plt.xlabel и plt.ylabel. Заголовок задаётся функцией plt.title, а plt.legend выводит легенду со списком кривых и их названий.
Имя кривой удобнее задавать непосредственно в plot через аргумент label: в этом случае plt.legend() вызывается без аргументов, и соответствие кривых и подписей не нарушается. Координатная сетка plt.grid(True) облегчает считывание значений с графика.
plt.plot(x, y_sin, label='sin(x)')
plt.plot(x, y_cos, '--', label='cos(x)') # '--' — штриховая линия
plt.xlabel('x, рад')
plt.ylabel('f(x)')
plt.title('Тригонометрические функции')
plt.legend() # имена кривых возьмутся из label
plt.grid(True) # координатная сетка
Subplots
Функция subplot размещает несколько графиков на одном рисунке:
x = np.arange(0, 3 * np.pi, 0.1) # координаты точек синусоиды и косинусоиды
y_sin = np.sin(x)
y_cos = np.cos(x)
plt.subplot(2, 1, 1) # сетка 2 × 1, активен первый подграфик
plt.plot(x, y_sin)
plt.title('Синус')
plt.subplot(2, 1, 2) # активен второй подграфик
plt.plot(x, y_cos)
plt.title('Косинус')
plt.tight_layout() # поля без наложения подписей
plt.show() # вывод рисунка
Подробнее о функции subplot — в документации.
Гистограммы
Гистограмма строится первой, когда имеется набор повторных измерений: она показывает распределение значений. Ниже генерируются 10 000 «измерений», рассеянных вокруг истинного значения по закону Гаусса, и строится их гистограмма функцией plt.hist.
rng = np.random.default_rng(0) # генератор случайных чисел NumPy
# 10 000 «измерений»: истинное значение 5,0, случайный шум 0,5
values = rng.normal(loc=5.0, scale=0.5, size=10000)
plt.hist(values, bins=50, density=True, alpha=0.7)
plt.xlabel('Измеренное значение')
plt.ylabel('Плотность вероятности')
plt.grid(True)
Аргумент bins задаёт число корзин: при слишком малом значении распределение теряет детали, при слишком большом гистограмма становится шумной. Флаг density=True нормирует гистограмму на единичную площадь, и в этих осях её можно сравнивать с теоретической плотностью вероятности, например с гауссианой. Полупрозрачность alpha необходима, когда несколько распределений накладываются друг на друга.
Точки с погрешностями (errorbar)
Основным графиком в экспериментальной физике являются точки с погрешностями. Его строит plt.errorbar: кроме координат точек она принимает величины ошибок по осям (yerr и xerr) и рисует отрезки погрешностей.
# «Эксперимент»: период маятника в зависимости от длины подвеса
L = np.array([0.2, 0.4, 0.6, 0.8, 1.0]) # длина, м
T = 2 * np.pi * np.sqrt(L / 9.81) # теоретический период, с
T_exp = T + rng.normal(0, 0.03, T.size) # «измеренный» период, с
T_err = np.full_like(T, 0.05) # погрешность измерения, с
plt.errorbar(L, T_exp, yerr=T_err, fmt='o', capsize=3, label='эксперимент')
plt.plot(L, T, '--', label='теория')
plt.xlabel('L, м')
plt.ylabel('T, с')
plt.legend()
plt.grid(True)
Ключ fmt='o' необходим, поскольку экспериментальные точки изображаются маркерами и не соединяются ломаной; рядом проводится теоретическая кривая или аппроксимация. Аргумент capsize задаёт размер засечек на концах отрезков, а xerr добавляет горизонтальные отрезки, если погрешность имеется и по оси x.
Сохранение рисунка в файл
Графики существуют внутри блокнота. Для вставки рисунка в отчёт или статью его сохраняют в файл с помощью plt.savefig; формат определяется расширением имени файла.
plt.plot(x, np.sin(x))
plt.savefig('sine.png', dpi=300, bbox_inches='tight') # растровый формат
plt.savefig('sine.pdf') # векторный формат
PNG является растровым форматом, поэтому для печати необходимо задавать разрешение dpi=300 или выше. PDF и SVG — векторные форматы, не теряющие чёткости при любом увеличении; для статей и дипломов (особенно в LaTeX) предпочтителен pdf. Аргумент bbox_inches='tight' обрезает лишние белые поля вокруг рисунка. В скриптах savefig необходимо вызывать до plt.show(): после показа фигура очищается, и в файл записывается пустой лист.
Полезные ссылки
- в официальной документации Matplotlib удобно начать с раздела Tutorials;
- Галерея примеров — сотни готовых графиков с исходным кодом; зачастую проще найти похожий пример, чем писать с нуля;
- Официальные шпаргалки (cheatsheets) укладывают всю библиотеку на пару страниц;
- Anatomy of a figure показывает, из каких частей состоит рисунок matplotlib и как эти части называются;
- Scientific Visualization: Python + Matplotlib, бесплатная книга Николя Ружье о научной визуализации.
Заключение
Читатель, изучивший пособие до этого места и выполнивший практикум, прошёл путь от подхода «скрипт работает, не трогать» до осознанного инженерного отношения к научному коду.
В пособии были рассмотрены инструменты и помощники, устройство Linux и Python, алгоритмы и структуры данных, практики разработки, обработка данных и обучение моделей, ускорение кода и чтение чужих проектов. Ни одна из тем не закрыта полностью: каждая глава могла бы стать отдельной книгой, а некоторые уже стали; соответствующие издания приведены в списке литературы.
Дальнейшие шаги, которые следует предпринять:
- Писать код каждый день. Навык разработки, как и владение математическим аппаратом, поддерживается только упражнением. Целесообразно автоматизировать рутину, ежедневно отнимающую время: обработку логов, построение графиков к отчётам, запуск расчётов.
- Читать чужой код. Исходники NumPy, SciPy или любого другого используемого инструмента являются лучшей школой стиля.
- Отдавать код на ревью и проводить ревью самостоятельно. Взгляд коллеги экономит недели отладки.
- Публиковать проекты в открытом доступе. Публичный репозиторий с оформленным README и тестами становится резюме и вкладом в научное сообщество.
- Возвращаться к этому пособию. Многие главы (профилирование, базы данных, CUDA) становятся востребованными только при появлении задачи, в которой без них не обойтись.
Наука сегодня основана на программном обеспечении. Телескопы, ускорители, томографы и детекторы управляются кодом, а открытия делаются в данных, которые необходимо уметь обработать. Этим умением и должен обладать читатель настоящего пособия.
Вопросы, опечатки и предложения можно направлять в issues на GitHub.
Литература и статьи
Список не претендует на полноту: по каждой теме этой книги написаны отдельные книги, и здесь названы те, к которым стоит обратиться следующими. Ссылки на документацию и инструменты вынесены в разделы «Полезные ссылки» соответствующих глав — здесь их нет намеренно, потому что адреса в интернете живут меньше, чем бумага.
Инструменты и рабочая среда
- Чакон С. Pro Git / С. Чакон, Б. Штрауб. – 2-е изд. – Apress, 2014. – Режим доступа: https://git-scm.com/book/ru/v2. Дата обращения: 31.08.2026.
- Merkel D. Docker: lightweight Linux containers for consistent development and deployment / D. Merkel // Linux Journal. – 2014. – Vol. 2014, № 239.
- Уорд Б. Внутреннее устройство Linux / Б. Уорд. – 3-е изд. – СПб.: Питер, 2022.
- Керриск М. Linux API. Исчерпывающее руководство / М. Керриск. – СПб.: Питер, 2018.
- Лав Р. Ядро Linux. Описание процесса разработки / Р. Лав. – 3-е изд. – М.: Вильямс, 2013.
Алгоритмы и структуры данных
- Кормен Т. Алгоритмы: построение и анализ / Т. Кормен, Ч. Лейзерсон, Р. Ривест, К. Штайн. – 3-е изд. – М.: Вильямс, 2013.
- Седжвик Р. Программирование на языке Python: учебный курс / Р. Седжвик, К. Уэйн, Р. Дондеро. – М.: Вильямс, 2017.
- Кнут Д. Искусство программирования. Т. 1: Основные алгоритмы / Д. Кнут. – 3-е изд. – М.: Вильямс, 2018; Т. 3: Сортировка и поиск. – 2-е изд. – М.: Вильямс, 2013.
Язык Python
- Лутц М. Изучаем Python / М. Лутц. – 5-е изд. – М.: Диалектика, 2020.
- Рамальо Л. Python. К вершинам мастерства / Л. Рамальо. – 2-е изд. – М.: ДМК Пресс, 2023.
- Слаткин Б. Секреты Python: 90 рекомендаций по написанию эффективного кода / Б. Слаткин. – 2-е изд. – М.: Диалектика, 2020.
- Бизли Д. Python. Книга рецептов / Д. Бизли, Б. Джонс. – М.: ДМК Пресс, 2019.
Инженерные практики
- Мартин Р. Чистая архитектура. Искусство разработки программного обеспечения / Р. Мартин. – СПб.: Питер, 2018.
- Мейер Б. Объектно-ориентированное конструирование программных систем / Б. Мейер. – М.: Русская редакция, 2005.
- Шэллоуэй А. Шаблоны проектирования. Новый подход к объектно-ориентированному анализу и проектированию / А. Шэллоуэй, Дж. Тротт. – М.: Вильямс, 2002.
- Клеппман М. Высоконагруженные приложения. Программирование, масштабирование, поддержка / М. Клеппман. – СПб.: Питер, 2018. – Перевод 1-го изд.; 2-е изд.: Kleppmann M. Designing Data-Intensive Applications / M. Kleppmann, C. Riccomini. – 2nd ed. – O'Reilly Media, 2026.
- Рогов Е. В. PostgreSQL 18 изнутри / Е. В. Рогов. – М.: ДМК Пресс, 2026. – 682 с. – Режим доступа: https://postgrespro.ru/education/books/internals. Дата обращения: 03.10.2026.
- Bradshaw S. MongoDB: the definitive guide / S. Bradshaw, E. Brazil, K. Chodorow. – 3rd ed. – O'Reilly Media, 2019.
- Carlson J. Redis in action / J. Carlson. – Manning, 2013.
- Videla A. RabbitMQ in action: distributed messaging for everyone / A. Videla, J. J. W. Williams. – Manning, 2012.
- Harenslak B. P. Data pipelines with Apache Airflow / B. P. Harenslak, J. de Ruiter. – Manning, 2021.
- Chhajed S. Learning ELK stack / S. Chhajed. – Packt Publishing, 2015.
- Beyer B. Site Reliability Engineering: How Google Runs Production Systems / B. Beyer, C. Jones, J. Petoff, N. R. Murphy. – O'Reilly Media, 2016. – Режим доступа: https://sre.google/sre-book/table-of-contents/. Дата обращения: 03.10.2026.
- Beyer B. The Site Reliability Workbook: Practical Ways to Implement SRE / B. Beyer, N. R. Murphy, D. K. Rensin, K. Kawahara, S. Thorne. – O'Reilly Media, 2018. – Режим доступа: https://sre.google/workbook/table-of-contents/. Дата обращения: 03.10.2026.
- Nygard M. T. Release It! Design and Deploy Production-Ready Software / M. T. Nygard. – 2nd ed. – Pragmatic Bookshelf, 2018.
Данные и машинное обучение
- Virtanen P. SciPy 1.0: fundamental algorithms for scientific computing in Python / P. Virtanen, R. Gommers, T. E. Oliphant [и др.] // Nature Methods. – 2020. – Vol. 17. – P. 261–272.
- McKinney W. pandas: a foundational Python library for data analysis and statistics / W. McKinney // Python for High Performance and Scientific Computing. – 2011.
- Kluyver T. Jupyter Notebooks — a publishing format for reproducible computational workflows / T. Kluyver, B. Ragan-Kelley, F. Pérez [и др.] // Positioning and Power in Academic Publishing. – IOS Press, 2016. – P. 87–90.
- Hastie T. The elements of statistical learning / T. Hastie, R. Tibshirani, J. Friedman. – 2nd ed. – Springer, 2009.
- Bishop C. M. Pattern recognition and machine learning / C. M. Bishop. – Springer, 2006.
- Гудфеллоу Я. Глубокое обучение / Я. Гудфеллоу, И. Бенджио, А. Курвилль. – М.: ДМК Пресс, 2018.
- Жерон О. Прикладное машинное обучение с помощью Scikit-Learn, Keras и TensorFlow / О. Жерон. – 2-е изд. – М.: Диалектика, 2020.
Производительность
- Gorelick M. High performance Python / M. Gorelick, I. Ozsvald. – 2nd ed. – O'Reilly Media, 2020.
- Press W. H. Numerical Recipes: The Art of Scientific Computing / W. H. Press, S. A. Teukolsky, W. T. Vetterling, B. P. Flannery. – 3rd ed. – Cambridge University Press, 2007.
Физика пучков и вычислительные коды
- Lawson J. D. The physics of charged-particle beams / J. D. Lawson. – Oxford: Clarendon Press, 1977.
- Reiser M. Theory and design of charged particle beams / M. Reiser. – Wiley, 1994.
- Birdsall C. K. Plasma physics via computer simulation / C. K. Birdsall, A. B. Langdon. – CRC Press, 2004.
- Ivanov A. V. ULTRASAM-2D code for simulation of electron guns with ultra high precision / A. V. Ivanov, M. A. Tiunov // Proceedings of EPAC-2002. – Paris, 2002. – P. 1634–1636.
- Borland M. Simple method for particle tracking with coherent synchrotron radiation / M. Borland // Physical Review Special Topics — Accelerators and Beams. – 2001. – Vol. 4, № 7.
- Dalesio L. R. EPICS architecture / L. R. Dalesio, A. J. Kozubal, M. R. Kraimer // Proceedings of ICALEPCS'91. – 1991. – P. 278–282.
Работы, на которых построены примеры книги
- Никифоров Д. А. Транспортировка сильноточного электронного пучка в линейном индукционном ускорителе ЛИУ-5 / Д. А. Никифоров, М. Ф. Блинов, В. В. Федоров [и др.] // Письма в журнал «Физика элементарных частиц и атомного ядра». – 2020. – Т. 17, № 2(227). – С. 158–167.
- Nikiforov D. A. Investigation of high current electron beam dynamics in linear induction accelerator for creation of a high-power THz radiation source / D. A. Nikiforov, A. V. Petrenko, S. L. Sinitsky [и др.] // Journal of Instrumentation. – 2021. – Vol. 16, № 11. – P. P11024.
- Никифоров Д. А. Исследование динамики пучка электронов в мощном линейном индукционном ускорителе с фокусировкой на сосредоточенных элементах : дис. … канд. физ.-мат. наук / Д. А. Никифоров. – Новосибирск: ИЯФ СО РАН, 2023. – 94 с.
- De Rainville F.-M. DEAP: a Python framework for evolutionary algorithms / F.-M. De Rainville, F.-A. Fortin, M.-A. Gardner [и др.] // Proceedings of the 14th Annual Conference Companion on Genetic and Evolutionary Computation. – 2012. – P. 85–92.
- Ragonneau T. M. Model-based derivative-free optimization methods and software : PhD thesis / T. M. Ragonneau. – The Hong Kong Polytechnic University, 2022.
- Lu C. The AI Scientist: towards fully automated open-ended scientific discovery / C. Lu, C. Lu, R. T. Lange [и др.]. – 2024. – Режим доступа: https://arxiv.org/abs/2408.06292. Дата обращения: 31.08.2026.
Свидетельства о государственной регистрации программ для ЭВМ
- Федоров В. В. REDPIC : свидетельство о государственной регистрации программы для ЭВМ № 2023688768 от 25.12.2023 / В. В. Федоров, Д. А. Никифоров. – 2023.
- Федоров В. В. KENV : свидетельство о государственной регистрации программы для ЭВМ № 2024611244 от 18.01.2024 / В. В. Федоров, Д. А. Никифоров, А. В. Петренко. – 2024.
- Федоров В. В. SCAUT : свидетельство о государственной регистрации программы для ЭВМ № 2025619977 от 21.04.2025 / В. В. Федоров, Д. А. Никифоров. – 2025.
- Федоров В. В. ACCUMULATOR : свидетельство о государственной регистрации программы для ЭВМ № 2026668488 от 07.07.2026 / В. В. Федоров. – 2026.
Эксплуатация программ
- Pivotto J. Prometheus: Up & Running. Infrastructure and Application Performance Monitoring / J. Pivotto, B. Brazil. – 2nd ed. – O'Reilly Media, 2023.
- Majors C. Observability Engineering: Achieving Production Excellence / C. Majors, L. Fong-Jones, G. Miranda. – O'Reilly Media, 2022.
- Gregg B. Systems Performance: Enterprise and the Cloud / B. Gregg. – 2nd ed. – Addison-Wesley, 2020.
- Davidovič Š. Incident Metrics in SRE: Critically Evaluating MTTR and Friends / Š. Davidovič. – O'Reilly Media, 2021. – Режим доступа: https://sre.google/resources/practices-and-processes/incident-metrics-in-sre/. Дата обращения: 04.10.2026.
- Pinheiro E. Failure Trends in a Large Disk Drive Population / E. Pinheiro, W.-D. Weber, L. A. Barroso // Proceedings of the 5th USENIX Conference on File and Storage Technologies (FAST'07). – San Jose, 2007. – P. 17–29.
Параллельные вычисления и воспроизводимость
- Yoo A. B. SLURM: Simple Linux Utility for Resource Management / A. B. Yoo, M. A. Jette, M. Grondona // Job Scheduling Strategies for Parallel Processing (JSSPP 2003). – Springer, 2003. – (Lecture Notes in Computer Science; vol. 2862). – P. 44–60.
- MPI: A Message-Passing Interface Standard. Version 5.0 / Message Passing Interface Forum. – 2025. – Режим доступа: https://www.mpi-forum.org/docs/mpi-5.0/mpi50-report.pdf. Дата обращения: 05.10.2026.
- Dalcin L. mpi4py: Status Update After 12 Years of Development / L. Dalcin, Y.-L. L. Fang // Computing in Science & Engineering. – 2021. – Vol. 23, № 4. – P. 47–54.
- Kurtzer G. M. Singularity: Scientific containers for mobility of compute / G. M. Kurtzer, V. Sochat, M. W. Bauer // PLoS ONE. – 2017. – Vol. 12, № 5. – P. e0177459.
- Amdahl G. M. Validity of the single processor approach to achieving large scale computing capabilities / G. M. Amdahl // AFIPS Conference Proceedings. – 1967. – Vol. 30. – P. 483–485.
- Gustafson J. L. Reevaluating Amdahl's law / J. L. Gustafson // Communications of the ACM. – 1988. – Vol. 31, № 5. – P. 532–533.
- Mu'alem A. W. Utilization, predictability, workloads, and user runtime estimates in scheduling the IBM SP2 with backfilling / A. W. Mu'alem, D. G. Feitelson // IEEE Transactions on Parallel and Distributed Systems. – 2001. – Vol. 12, № 6. – P. 529–543.
- Meijer B. Ansible: Up and Running. Automating Configuration Management and Deployment the Easy Way / B. Meijer, L. Hochstein, R. Moser. – 3rd ed. – O'Reilly Media, 2022.
- Morris K. Infrastructure as Code: Designing and Delivering Dynamic Systems for the Cloud Age / K. Morris. – 3rd ed. – O'Reilly Media, 2025.
- Karp A. H. Measuring parallel processor performance / A. H. Karp, H. P. Flatt // Communications of the ACM. – 1990. – Vol. 33, № 5. – P. 539–543.